

De vraag naar snelle, hoogwaardige videocontent is nog nooit zo groot geweest. In het huidige medialandschap wordt van kleine nieuwsteams, onafhankelijke contentmakers en evenementenproductieteams verwacht dat ze professionele beelden in realtime vastleggen, bewerken en publiceren, vaak zonder de ondersteuning van een postproductieteam of een gecentraliseerde infrastructuur.
Daarom wordt on-premise AI-zoektechnologie, geleverd via edge-gebaseerde productiesystemen, een must-have, aangezien de hoeveelheid beeldmateriaal explosief toeneemt en de behoefte aan hergebruik toeneemt. Door teams in staat te stellen direct met beeldmateriaal te werken op het moment van opname, elimineren edge-workflows knelpunten en stellen ze makers in staat minder tijd te besteden aan het zoeken naar en beheren van beeldmateriaal, en meer tijd te besteden aan het produceren van de best mogelijke content.
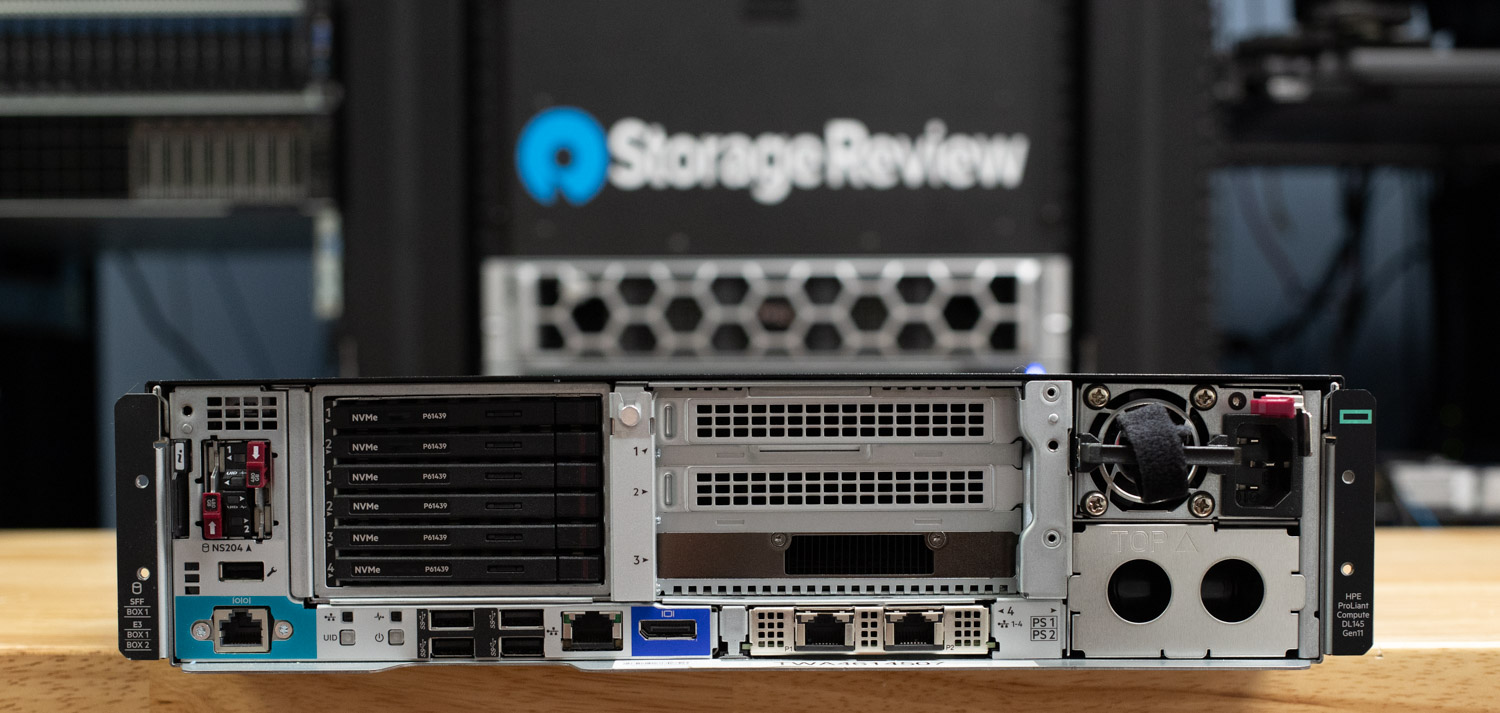
Axle AI , een AI-gestuurd platform voor mediabeheer en -automatisering, is speciaal ontworpen voor deze gedecentraliseerde, snelle workflow. In combinatie met toonaangevende hardware, zoals de HPE ProLiant DL145 Gen11-server, een NVIDIA L4 GPU en Solidigm PCIe Gen5 SSD's, resulteert dit in een krachtige, draagbare productieomgeving. Het biedt professionele, AI-ondersteunde mediafunctionaliteit, zelfs voor de kleinste teams.
Overzicht systeemarchitectuur
De HPE ProLiant DL145 Gen11 edge server is een sterke kandidaat voor Axle AI-implementaties in buiten- en evenementomgevingen waar ruimte, stroomvoorziening en koeling beperkt zijn. Met zijn 2U-ontwerp met een korte diepte van slechts 16 cm (5 inch) is deze server speciaal ontworpen voor draagbaarheid en installatie in krappe ruimtes zoals mobiele racks en flightcases. In tegenstelling tot traditionele enterprise-apparatuur ondersteunt hij een uitgebreid bedrijfstemperatuurbereik van -55 °C tot XNUMX °C, waardoor hij geschikt is voor minder gecontroleerde omgevingen. Ondanks zijn compacte formaat biedt hij functies van enterprise-klasse, zoals redundante stroomvoorziening en opstartbare schijfopties, waardoor hij ideaal is voor teams die een robuuste, edge-geschikte infrastructuur nodig hebben zonder de overhead van full-size hardware.
Wat de CPU betreft, ondersteunt de DL145 AMD EPYC 8004 (Siena)-serie processoren, met ondersteuning voor acht tot 64 cores. Ons testsysteem is uitgerust met de EPYC 8434P, die 48 cores en 96 threads biedt. Met een TDP van 200W biedt deze processor een goede balans tussen efficiëntie en rekenkracht, waardoor hij ideaal is voor intensieve workloads. De processor ondersteunt 96 PCIe 5.0-lanes en biedt zes kanalen DDR5-geheugen, waardoor snelheden tot 4800 MT/s mogelijk zijn met een uitstekende geheugenbandbreedte. Hoewel de minimale vereisten voor Axle AI ten minste 16 CPU-cores en 32 GB RAM vereisen, overtreft onze configuratie deze vereisten ruimschoots met 48 cores en 256 GB DDR5-geheugen.
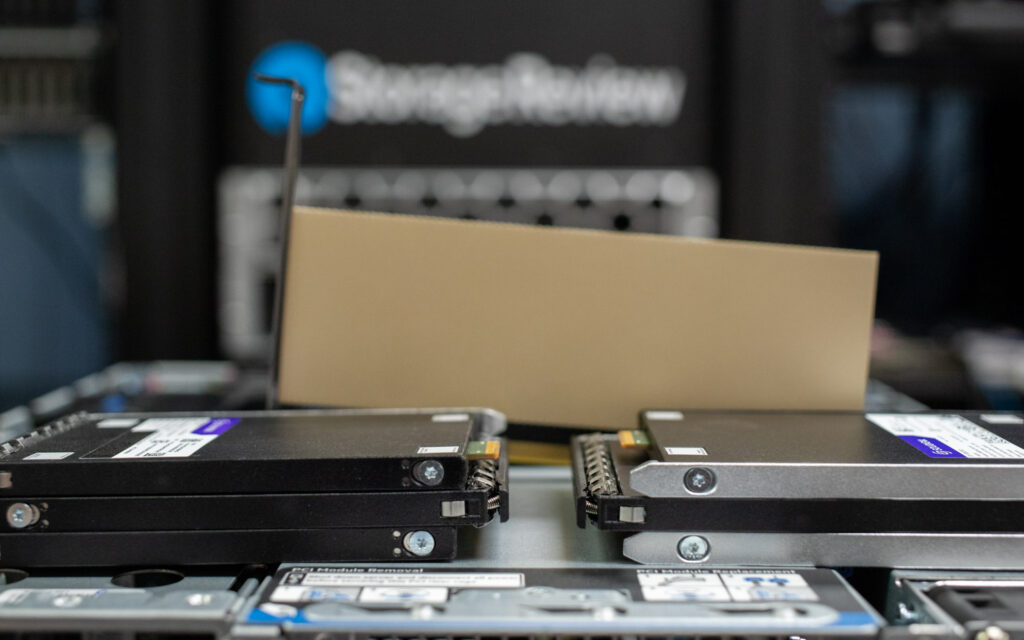
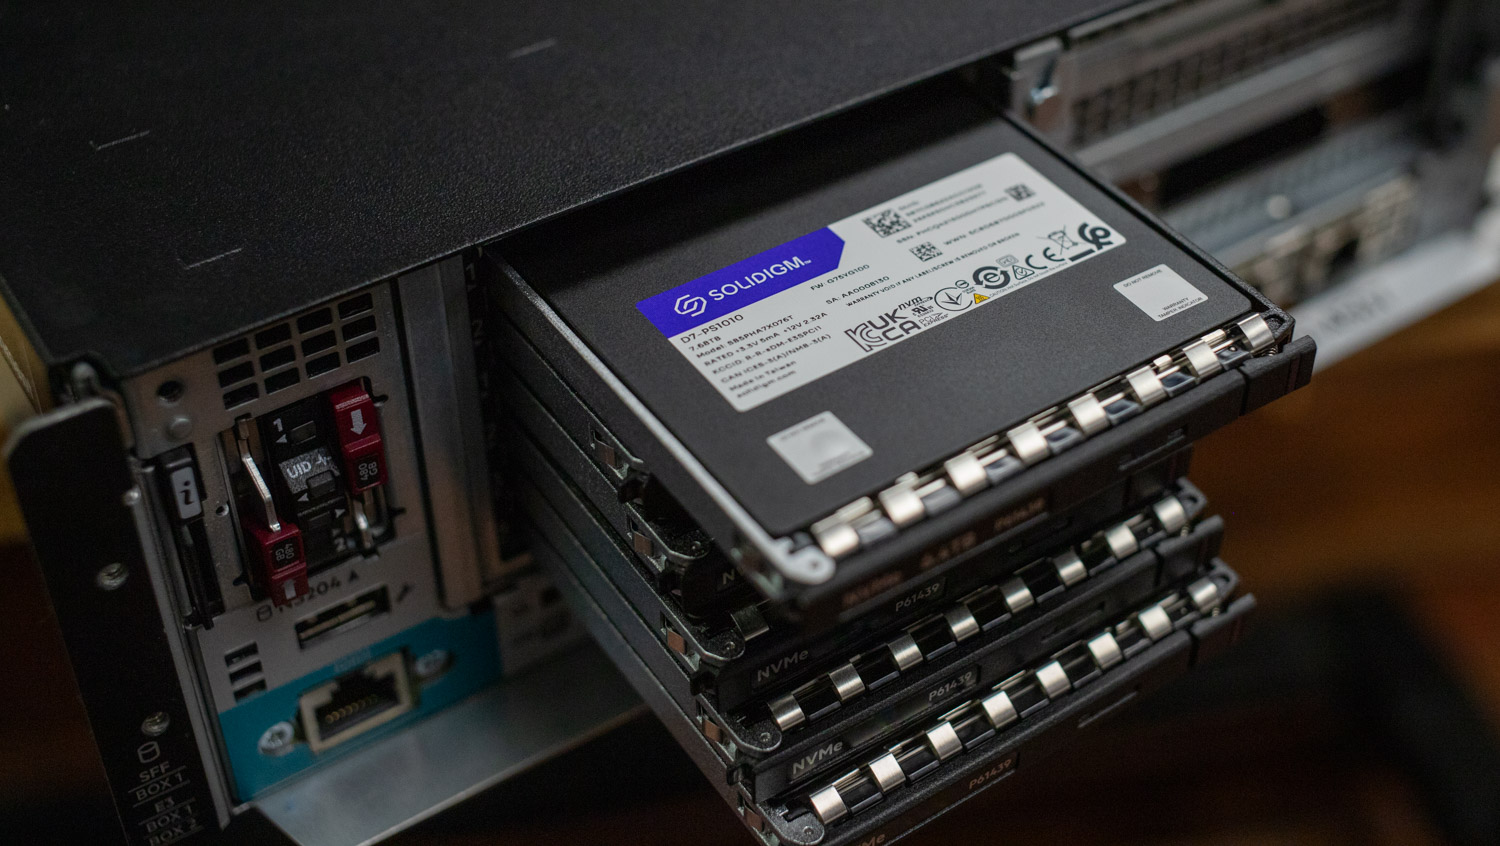
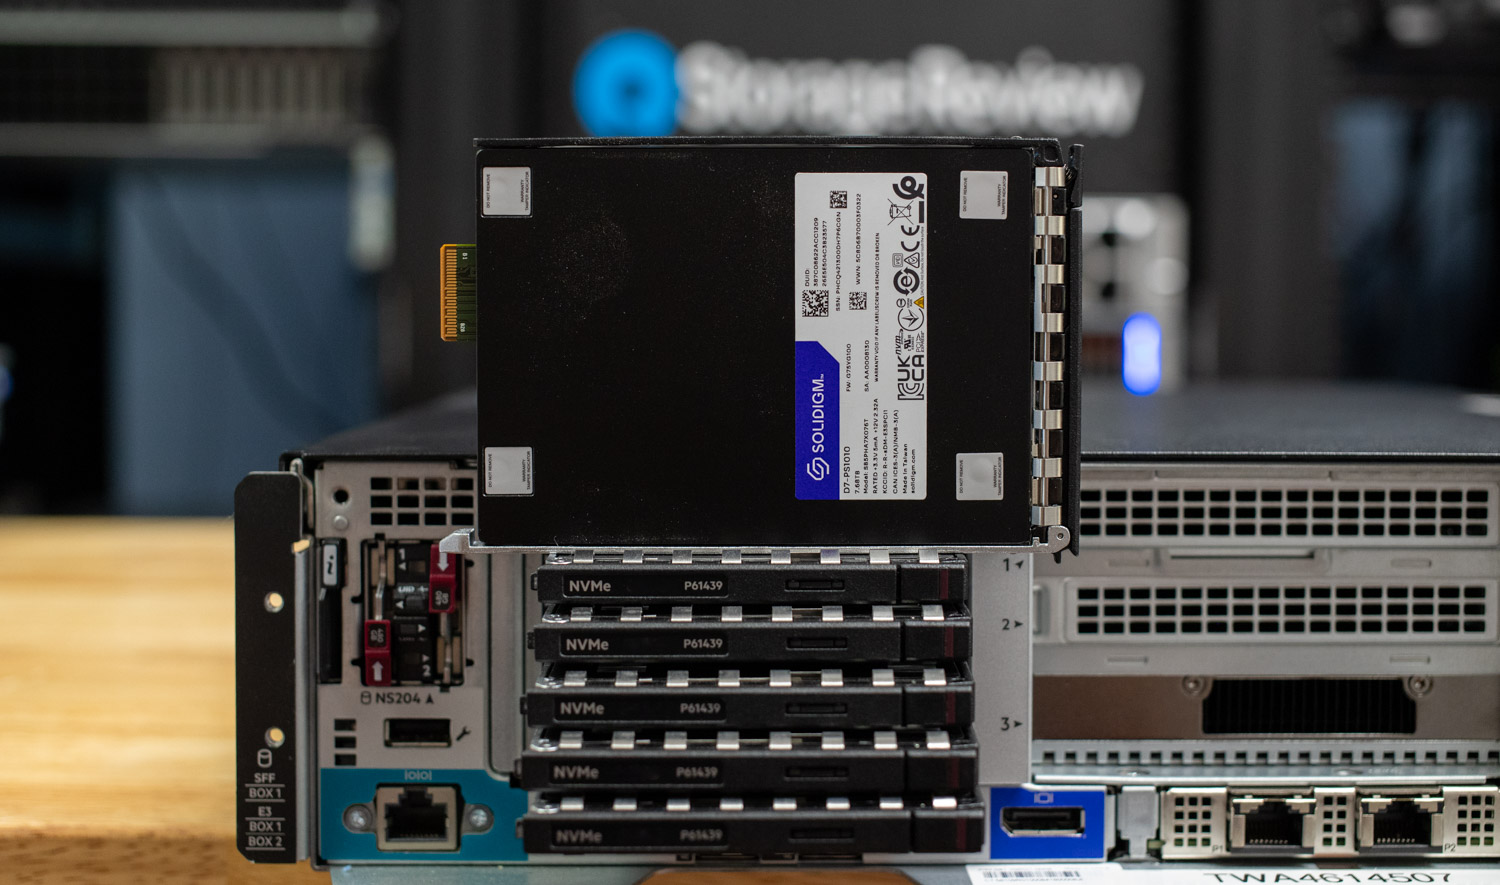
Opslagprestaties zijn cruciaal in elke mediapijplijn en de DL145 ondersteunt maximaal zes EDSFF E3.S NVMe-schijven om aan deze eisen te voldoen. In onze configuratie gebruikten we zes Solidigm D7-PS1010 E3.S SSD's, elk met een capaciteit van 7.68 TB. Deze PCIe 5.0 x4-schijven leveren leessnelheden tot 14,500 MB/s en schrijfsnelheden tot 10,000 MB/s, wat samen bijna 46 TB aan snelle opslag oplevert. Deze SSD's zijn ontworpen voor AI- en mediaworkflows en bieden een indrukwekkende energie-efficiëntie en kunnen in specifieke pijplijnfasen tot 50% hogere doorvoer leveren in vergelijking met conventionele NVMe-schijven. Voor teams die extra capaciteit nodig hebben, kan deze configuratie worden opgeschaald tot 15.36 TB per schijf, wat in totaal 92 TB aan snelle, compacte opslag oplevert in een compacte vormfactor.
De DL145 ondersteunt maximaal drie GPU's met één slot, en in onze configuratie hebben we een enkele NVIDIA L4 ingezet, een energiezuinige accelerator gebouwd op de Ada Lovelace-architectuur. De L4 is ontworpen voor videoverwerking, AI-inferentie, visuele computing en virtualisatieworkloads en levert robuuste prestaties met een stroomverbruik van slechts 72 watt. Hij beschikt over 24 GB GDDR6 VRAM en maakt verbinding via een PCIe 4.0 x16-interface voor zowel stroom als data. Axle AI adviseert minimaal 16 GB VRAM, en de L4 overtreft dit ruimschoots met nog eens 8 GB, waardoor er voldoende ruimte is voor taken met hoge resolutie media en AI-gestuurde bewerkingen.
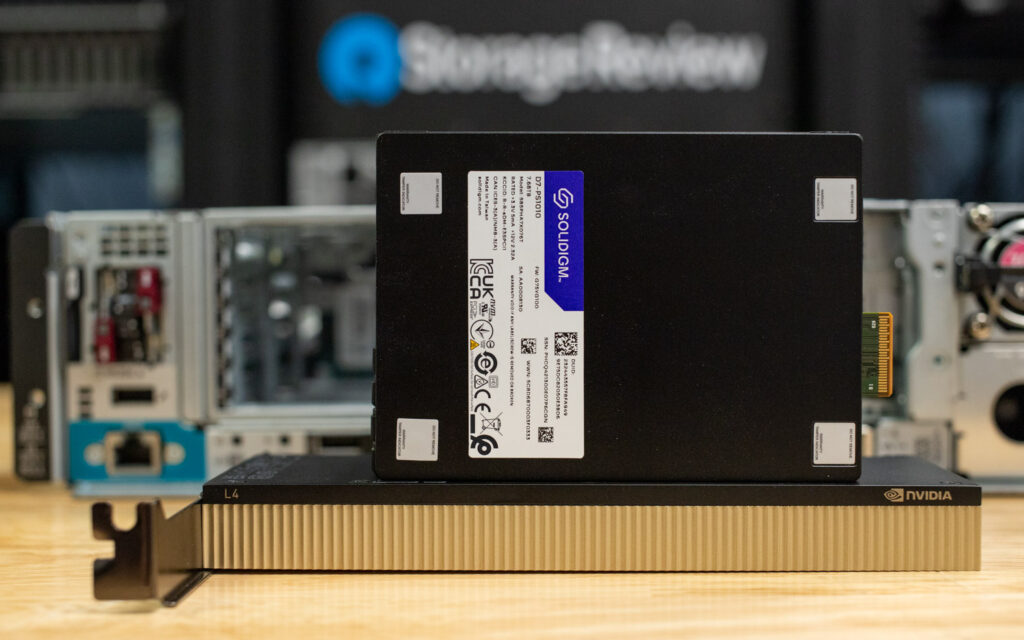
Nvidia L4 single-slot GPU
Voor de applicatielaag hebben we Axle AI MAM en Axle AI Tags geïmplementeerd met behulp van Proxmox Virtual Environment (8.3.5). Het systeem is geconfigureerd met twee speciale virtuele machines: één met Axle AI MAM en één met Axle AI Tags. Deze structuur zorgt voor een duidelijke scheiding tussen mediabeheer en AI-gestuurde metadataverwerking, terwijl naadloze communicatie tussen componenten mogelijk blijft.
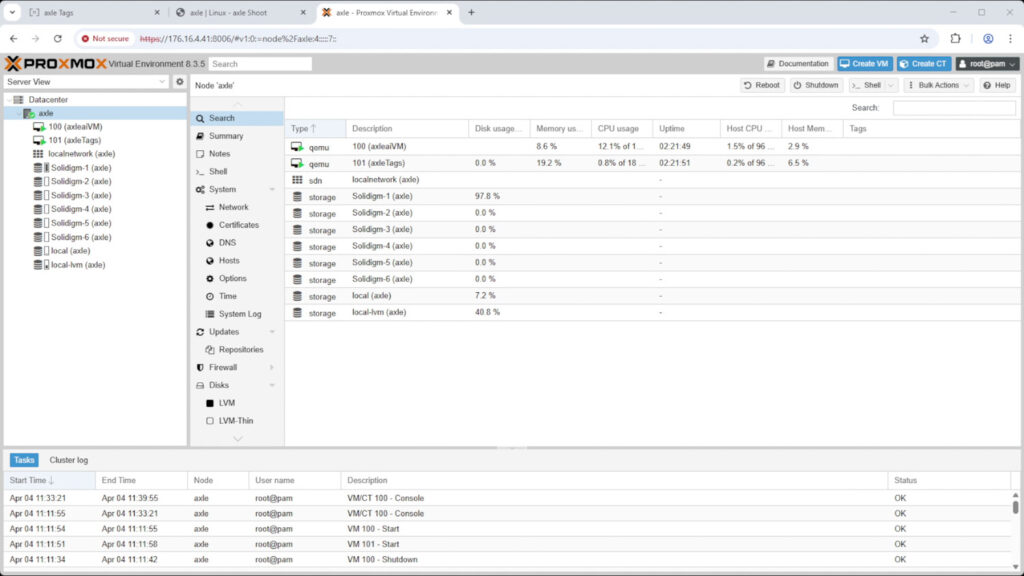
Samenvatting van Proxmox-omgeving en hardware
Axle AI Tags draait samen met MAM en biedt on-premise AI-mogelijkheden, waaronder semantische vectorzoekfunctie, object- en logoherkenning en trainbare gezichtsdetectie. Het wordt geïmplementeerd in een Docker-container en maakt gebruik van de NVIDIA L4 GPU via PCIe pass-through voor efficiënte, realtime inferentie. De browsergebaseerde trainings- en beheerinterface maakt flexibele afstemming mogelijk en het modulaire ontwerp ondersteunt Intel/NVIDIA- of AMD/NVIDIA-hardwareconfiguraties. Hoewel Axle AI Tags volledig geïntegreerd zijn met MAM in onze configuratie, bieden ze ook REST API-compatibiliteit voor gebruik met andere platforms.
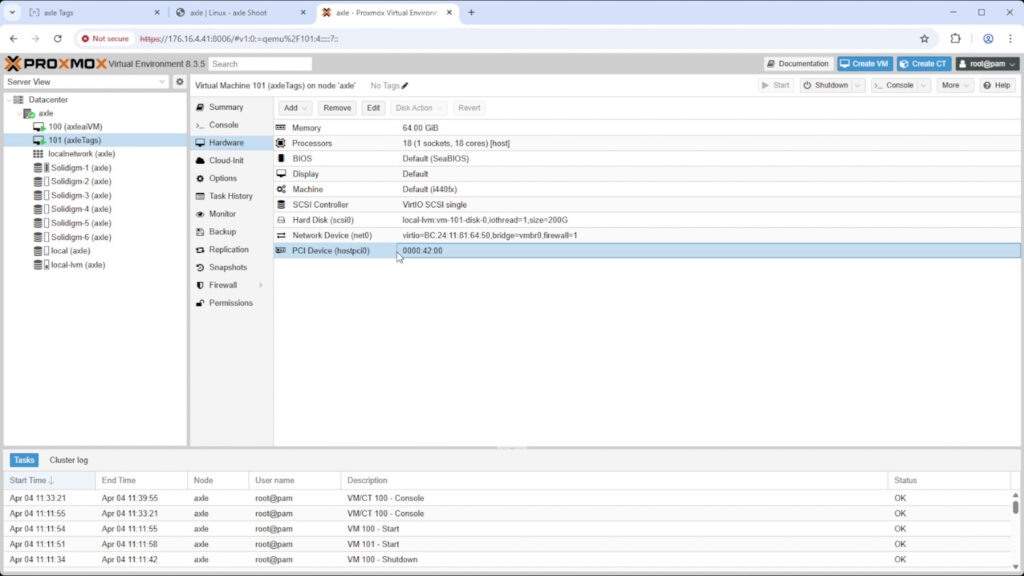
Hardwareconfiguratie van Axle AI Tags virtuele machine
De Solidigm PS1010-schijven zijn geïntegreerd in de Axle AI MAM virtuele machine, wat zorgt voor snelle toegang tot beeldmateriaal met lage latentie. Door de volledige stack te virtualiseren en specifieke rekenresources aan elk onderdeel toe te wijzen, levert deze configuratie een hogere uptime, beter resourcebeheer en ondersteuning voor meerdere gebruikers die veel verder gaat dan wat een enkel werkstation zou kunnen bieden. Dit maakt het ideaal voor een collaboratieve productieomgeving met hoge volumes.
Samen vormen deze componenten een nauw geïntegreerde hardwareoplossing die snelle, lokale, AI-gestuurde mediaworkflows mogelijk maakt. Het is een efficiënt, gebruiksklaar platform voor externe teams die betrouwbare prestaties nodig hebben waar ruimte en vermogen beperkt zijn, maar AI-verwerking essentieel blijft.
HPE ProLiant DL145 Gen11-prestaties
Voordat we in de benchmark duiken, schetst de onderstaande tabel de systeemconfiguratie van de HPE ProLiant DL145 Gen11. Tijdens de tests met Axle AI werd een gevirtualiseerde installatie met Proxmox gebruikt. Vervolgens werd het systeem overgezet naar Ubuntu Server 22.04.5 om de opslagprestaties te meten in onze GDSIO- en FIO-tests.
| HPE ProLiant DL145 Gen 11 | Hardware-overzicht |
|---|---|
| CPU | Enkele AMD EPYC 8434P |
| RAM | 256 GB ECC DDR5 |
| Opslag | 6x Solidigm D7-PS1010 E3s SSD's 7.68 TB |
| Opstartopslag | NS204-poort 2x bezet (480GB Samsung PM9A3 M.2) |
| GPU | Enkele NVIDIA L4 |
| Besturingssysteem | Ubuntu-server 22.04.5 |
Piek synthetische prestaties
De FIO-test is een flexibele en krachtige benchmarktool die wordt gebruikt om de prestaties van opslagapparaten, waaronder SSD's en HDD's, te meten. De test evalueert parameters zoals bandbreedte, IOPS (Input/Output Operations Per Second) en latentie onder verschillende workloads, zoals sequentiële en willekeurige lees-/schrijfbewerkingen. Deze test is ontworpen om piekprestaties vast te leggen en het opslagsysteem te belasten met meerdere workloads, waardoor hij bijzonder nuttig is voor het vergelijken van verschillende apparaten of configuraties. In dit geval werd een volledige oppervlaktetest uitgevoerd, waarbij de volledige capaciteit van de schijven werd getest om een volledig beeld te krijgen van hun duurzame prestatiekenmerken.
In de sequentiële leestest met 128K-blokken leverde het systeem een bandbreedte van 56.4 GB/s en een continue snelheid van 430,000 IOPS met een gemiddelde latentie van 1.78 milliseconden. De sequentiële schrijfprestaties bij dezelfde blokgrootte bereikten 45.4 GB/s, met 346,000 IOPS en een gemiddelde latentie van 2.22 milliseconden. Voor willekeurige leesbewerkingen met 4K-blokken behaalde het systeem een snelheid van 46.6 GB/s met 11.4 miljoen IOPS en een lage gemiddelde latentie van 0.269 milliseconden, wat het hoge doorvoerpotentieel van de NVMe-opslagarray onder intensieve toegangspatronen onderstreept. Willekeurige schrijfbewerkingen bij 4K maten 29.1 GB/s en bereikten 7.1 miljoen IOPS met een gemiddelde latentie van 0.432 milliseconden, wat een solide continue schrijfcapaciteit bevestigt, zelfs bij gefragmenteerde toegang.
| HPE DL145 Gen 11 FIO Benchmark Samenvatting | Bandbreedte – GB/s | IOPS | Gemiddelde latentie |
|---|---|---|---|
| Sequentieel lezen (128K) | 56.4 GB / s | 430k | 1.78 ms |
| Sequentieel schrijven (128K) | 45.4 GB / s | 346k | 2.22 ms |
| Willekeurig lezen (4 KB) | 46.6 GB / s | 11.4M | 0.269 ms |
| Willekeurig schrijven (4K) | 29.1 GB / s | 7.1M | 0.432 ms |
GPU directe opslag
Een van de tests die we op deze testbank hebben uitgevoerd, was de Magnum IO GPU Direct Storage (GDS)-test. GDS is een functie die is ontwikkeld door NVIDIA waarmee GPU's de CPU kunnen omzeilen bij het benaderen van gegevens die zijn opgeslagen op NVMe-schijven of andere snelle opslagapparaten. In plaats van gegevens via de CPU en het systeemgeheugen te routeren, maakt GDS directe communicatie tussen de GPU en het opslagapparaat mogelijk, wat de latentie aanzienlijk vermindert en de gegevensdoorvoer verbetert.
Hoe GPU Direct Storage werkt
Traditioneel, wanneer een GPU gegevens verwerkt die zijn opgeslagen op een NVMe-schijf, moeten de gegevens eerst door de CPU en het systeemgeheugen reizen voordat ze de GPU bereiken. Dit proces introduceert knelpunten, omdat de CPU een tussenpersoon wordt, latentie toevoegt en waardevolle systeembronnen verbruikt. GPU Direct Storage elimineert deze inefficiëntie door de GPU in staat te stellen om rechtstreeks vanaf het opslagapparaat toegang te krijgen tot gegevens via de PCIe-bus. Dit directe pad vermindert de overhead die gepaard gaat met gegevensverplaatsing, wat snellere en efficiëntere gegevensoverdrachten mogelijk maakt.
AI-workloads, met name die met deep learning, zijn zeer data-intensief. Het trainen van grote neurale netwerken vereist het verwerken van terabytes aan data, en elke vertraging in dataoverdracht kan leiden tot onderbenutte GPU's en langere trainingstijden. GPU Direct Storage pakt deze uitdaging aan door ervoor te zorgen dat data zo snel mogelijk naar de GPU wordt geleverd, waardoor inactieve tijd wordt geminimaliseerd en de rekenefficiëntie wordt gemaximaliseerd.
Bovendien is GDS met name gunstig voor workloads die het streamen van grote datasets omvatten, zoals videoverwerking, natuurlijke taalverwerking of realtime-inferentie. Door de afhankelijkheid van de CPU te verminderen, versnelt GDS de databeweging en maakt CPU-bronnen vrij voor andere taken, wat de algehele systeemprestaties verder verbetert.
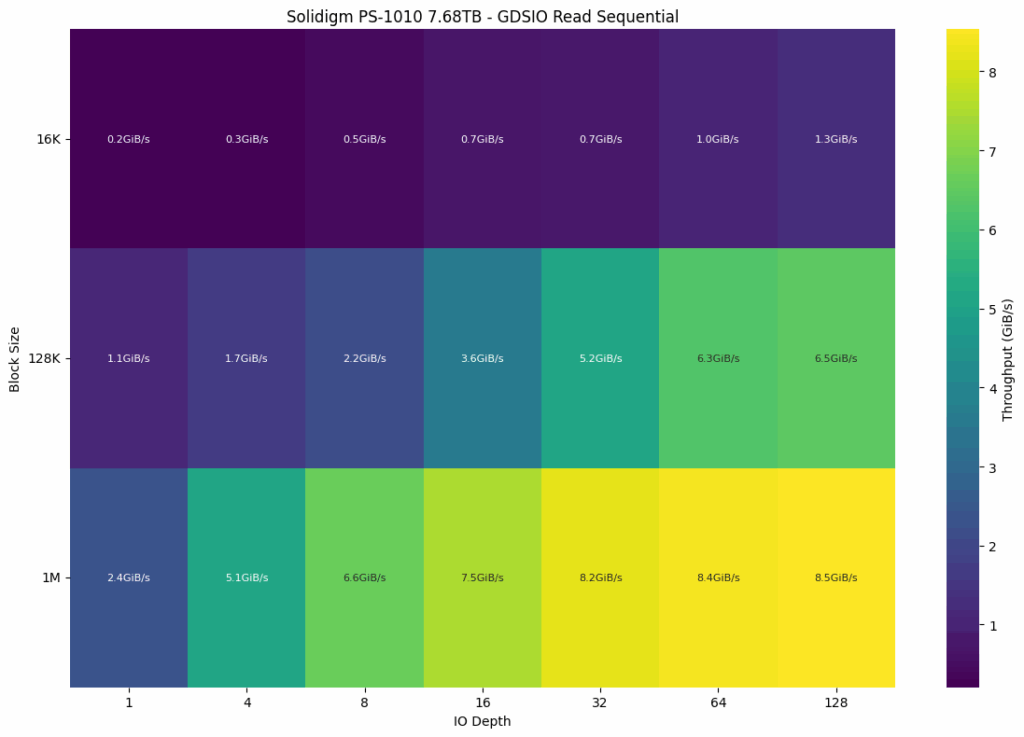
GDSIO Lees Sequentieel
In de sequentiële GDSIO-leestest van de Solidigm PS1010 7.68TB-schijf schaalden de prestaties aanzienlijk met zowel de blokgrootte als de I/O-diepte. Bij de kleinste blokgrootte van 16K begon de doorvoer met slechts 0.2 GiB/s bij een wachtrijdiepte van 1 en steeg geleidelijk tot 1.3 GiB/s bij een diepte van 128, wat wijst op beperkte schaalbaarheid bij die granulariteit. Bij een toename naar 128K-blokken verbeterden de prestaties aanzienlijker, beginnend bij 1.1 GiB/s en oplopend tot 6.5 GiB/s bij de grootste diepte. De beste resultaten werden behaald met een blokgrootte van 1M, waarbij de doorvoer aanvankelijk 2.4 GiB/s bereikte en piekte op 8.5 GiB/s bij een wachtrijdiepte van 128. Dit geeft aan dat het optimale prestatieprofiel van de schijf wordt bereikt met grote sequentiële leesbewerkingen en diepere wachtrijen.
GDSIO Schrijf Sequentieel
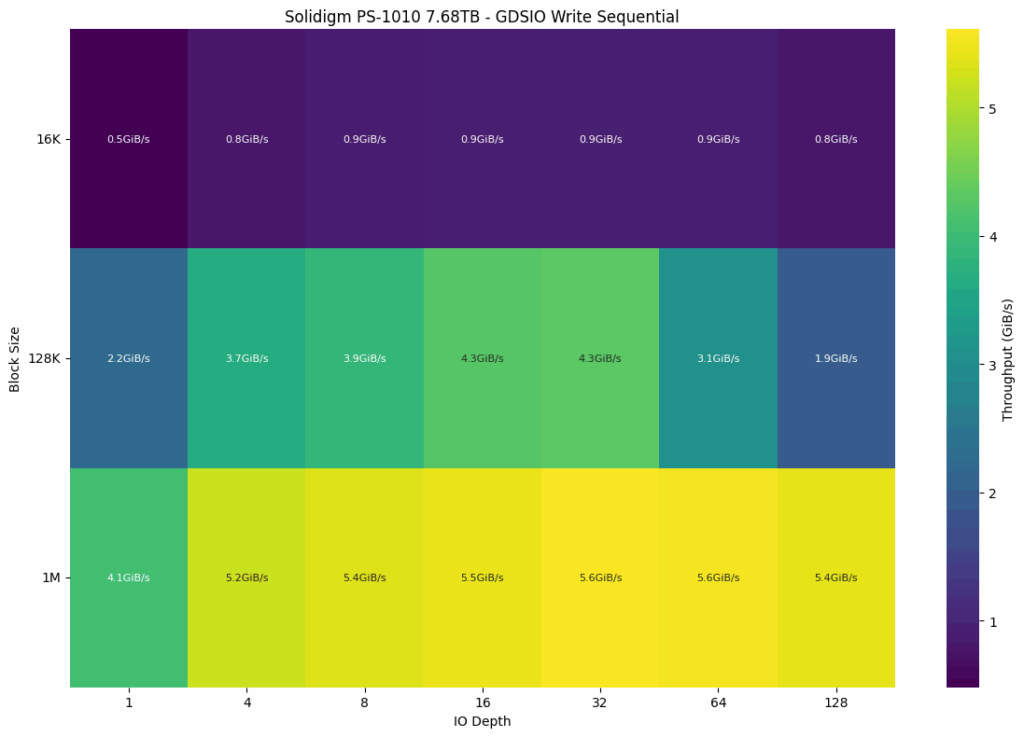
De sequentiële schrijfprestaties op de Solidigm PS1010 vertonen een solide schaalbaarheid bij grotere blokgroottes, maar vertonen enige regressie bij grotere wachtrijdieptes bij middelgrote workloads. Bij de kleinste blokgrootte van 16K begonnen de schrijfsnelheden bij 0.5 GiB/s en piekten ze bescheiden op 0.9 GiB/s van wachtrijdieptes 8 tot en met 64, alvorens licht te dalen tot 0.8 GiB/s op diepte 128. Bij blokken van 128K begonnen de prestaties bij 2.2 GiB/s, verbeterden tot een piek van 4.3 GiB/s op diepte 32 en daalden vervolgens tot slechts 1.9 GiB/s in de diepste wachtrij, wat wijst op mogelijke schrijfverzadiging of -beperking. De beste aanhoudende prestaties werden behaald met blokken van 1M, waarbij de doorvoer netjes opschaalde van 4.1 GiB/s op diepte 1 naar 5.6 GiB/s op diepten 32 en 64, en stabiel bleef tot en met 128.
GDSIO-samenvatting
Deze tabel biedt een duidelijk overzicht van de GDSIO-prestatiegegevens voor latentie en IOPS, verzameld op de Solidigm D7-PS1010 SSD, gemeten bij blokgroottes van 16 kB, 128 kB en 1 MB met een IOPS-diepte van 128. Bij een wachtrijdiepte van 128 schalen latentie en IOPS voorspelbaar mee met de blokgrootte. De leestijd van een blok van 16 kB bedroeg gemiddeld 1.549 ms met 82.3 kB IOPS, terwijl de schrijflatentie 2.429 ms bedroeg met 52.6 kB IOPS. Bij blokken van 128 kB nam de leeslatentie toe tot 2.414 ms (52.9 kB IOPS) en de schrijflatentie tot 8.050 ms (15.9 kB IOPS). Bij 1M bedroeg de leeslatentie 14.643 ms met 8.7K IOPS, en de schrijflatentie steeg naar 23.030 ms met 5.6K IOPS.
| GDSIO-grafiek (gemiddelden van blokgroottes van 16K, 128K, 1M) | HPE DL145 Gen 11 (6 x SolidGAM D7-PS1010 E3s SSD 7.68 TB) |
|---|---|
| (16K blokformaat 128 IO-diepte) Gemiddelde leessnelheid | 1.3 GiB/s (1.549 ms) IOPS: 82.3K |
| (16K blokformaat 128 IO-diepte) Gemiddelde schrijfsnelheid | 0.8 GiB/s (2.429 ms) IOPS: 52.6K |
| (128K blokformaat 128 IO-diepte) Gemiddelde leessnelheid | 6.5 GiB/s (2.414 ms) IOPS: 52.9K |
| (128K blokformaat 128 IO-diepte) Gemiddelde schrijfsnelheid | 1.9 GiB/s (8.050 ms) IOPS: 15.9K |
| (1M blokgrootte 128 IO-diepte) Gemiddelde leessnelheid | 8.5 GiB/s (14.643 ms) IOPS: 8.7K |
| (1M blokgrootte 128 IO-diepte) Gemiddelde schrijfsnelheid | 5.4 GiB/s (23.030 ms) IOPS: 5.6K |
Mediaproductie aan de rand
Wat is Axle AI?
Axle AI is een on-premise AI-gestuurd platform voor media asset management (MAM) dat videoworkflows voor kleine en middelgrote mediateams vereenvoudigt. Het automatiseert belangrijke taken, zoals ingest, tagging en media zoeken, zonder de kosten of complexiteit van traditionele MAM-systemen. Axle AI is ontworpen voor snelheid en gebruiksgemak en stelt teams in staat om content efficiënter te beheren en te leveren, of ze nu op kantoor zijn of op afstand werken.
Het platform ondersteunt de volledige productiepijplijn. Het verwerkt automatisch beeldmateriaal, creëert proxy's, past AI-gestuurde metadata toe met functies zoals objectherkenning, gezichtsdetectie en semantisch zoeken, en integreert met standaard bewerkingstools, waaronder Adobe Premiere Pro en DaVinci Resolve. Dit stelt teams in staat om snel content te vinden, te bewerken en te publiceren zonder knelpunten of vertragingen.
Gebruiksscenario's uit de echte wereld
Axle AI wordt vertrouwd door een breed scala aan mediateams, waaronder omroepen, documentairemakers, afdelingen bedrijfsvideo's, marketingbureaus en producenten van live-evenementen. Deze teams werken vaak op meerdere locaties en hebben betrouwbare toegang tot hun mediabibliotheken nodig zonder dat hiervoor een zware infrastructuur nodig is.
Met Axle AI kunnen gebruikers op afstand samenwerken via een browserinterface die directe toegang biedt tot proxymedia. Editors kunnen direct beginnen met het monteren van beeldmateriaal in hun favoriete non-lineaire bewerkingssystemen (NLE's), terwijl producers en stakeholders clips in realtime beoordelen, taggen of goedkeuren (geen grote bestandsoverdrachten of gespecialiseerde technische vaardigheden vereist).
Of u nu een team van vijf of vijftig personen hebt, Axle AI maakt snellere en efficiëntere workflows mogelijk. De eenvoudige interface, snelle implementatie en compatibiliteit met bestaande opslagsystemen maken het een slimme oplossing voor grootschalige, gedistribueerde mediaproductie.
De enorme vraag naar instant social media heeft het tempo van mediaproductie drastisch verhoogd. Het is een typische "als je niet de eerste bent, ben je de laatste"-mentaliteit, vooral als het gaat om live-evenementen en de contentcreatie eromheen. Mediabedrijven hadden behoefte aan een efficiënte manier om grote hoeveelheden beeldmateriaal te organiseren en snel te bekijken. Tools zoals Axle AI, met de mogelijkheid om op te schalen naar kleine operaties, maken deze workflow praktisch in het veld. In combinatie met de juiste workflow, zoals camera's die proxy's en ruwe beelden tegelijkertijd kunnen opnemen, nemen de mogelijkheden voor efficiëntie toe.
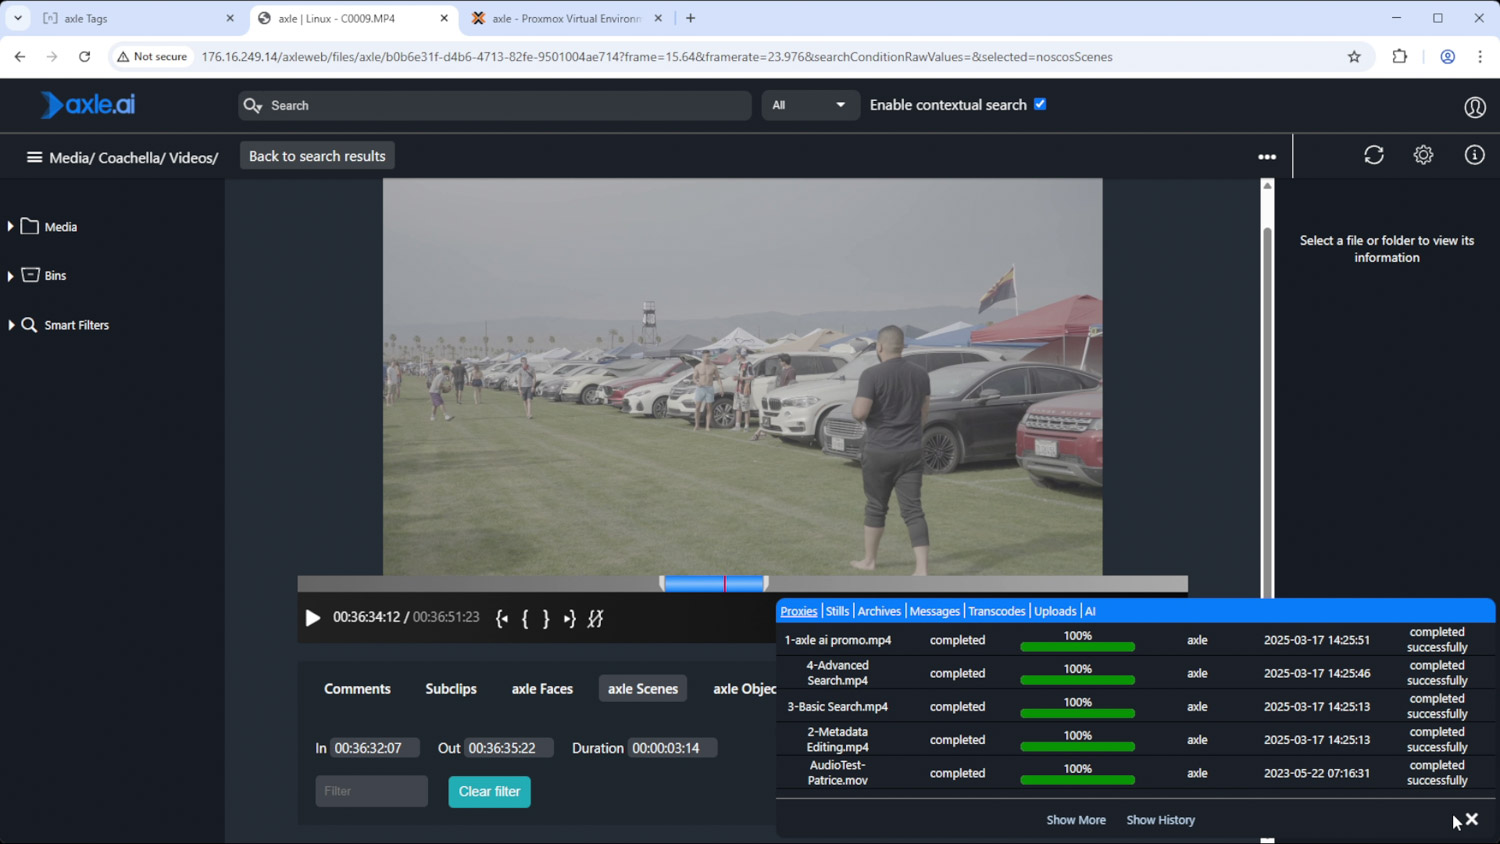
Het opslaan van zowel hoge- als lage-resolutie proxymedia tijdens het vastleggen en direct verwerken van kleinere proxybestanden in Axle AI Tags maakt al het beeldmateriaal vrijwel direct doorzoekbaar. Editors kunnen direct aan de slag dankzij de integratie van Axle AI met de meeste grote NLE's zoals Adobe Premiere Pro, DaVinci Resolve en Avid Media Composer. Dit ontlast het productieteam aanzienlijk, waardoor ze zich kunnen concentreren op andere taken of burn-outs kunnen voorkomen.
Logging is van oudsher een van de meest arbeidsintensieve en vaakst overgeslagen aspecten van een media-captureworkflow. Axle AI logt media automatisch met door AI gegenereerde scènebeschrijvingen in plaats van alleen traditionele metadatavelden, waardoor een editor de inhoud van een clip kan lezen voordat hij de tijd neemt om deze door te nemen. Het biedt ook semantische zoekfuncties, waardoor editors en producers snel relevant materiaal kunnen vinden op basis van concepten en thema's, in plaats van te vertrouwen op specifieke tags.
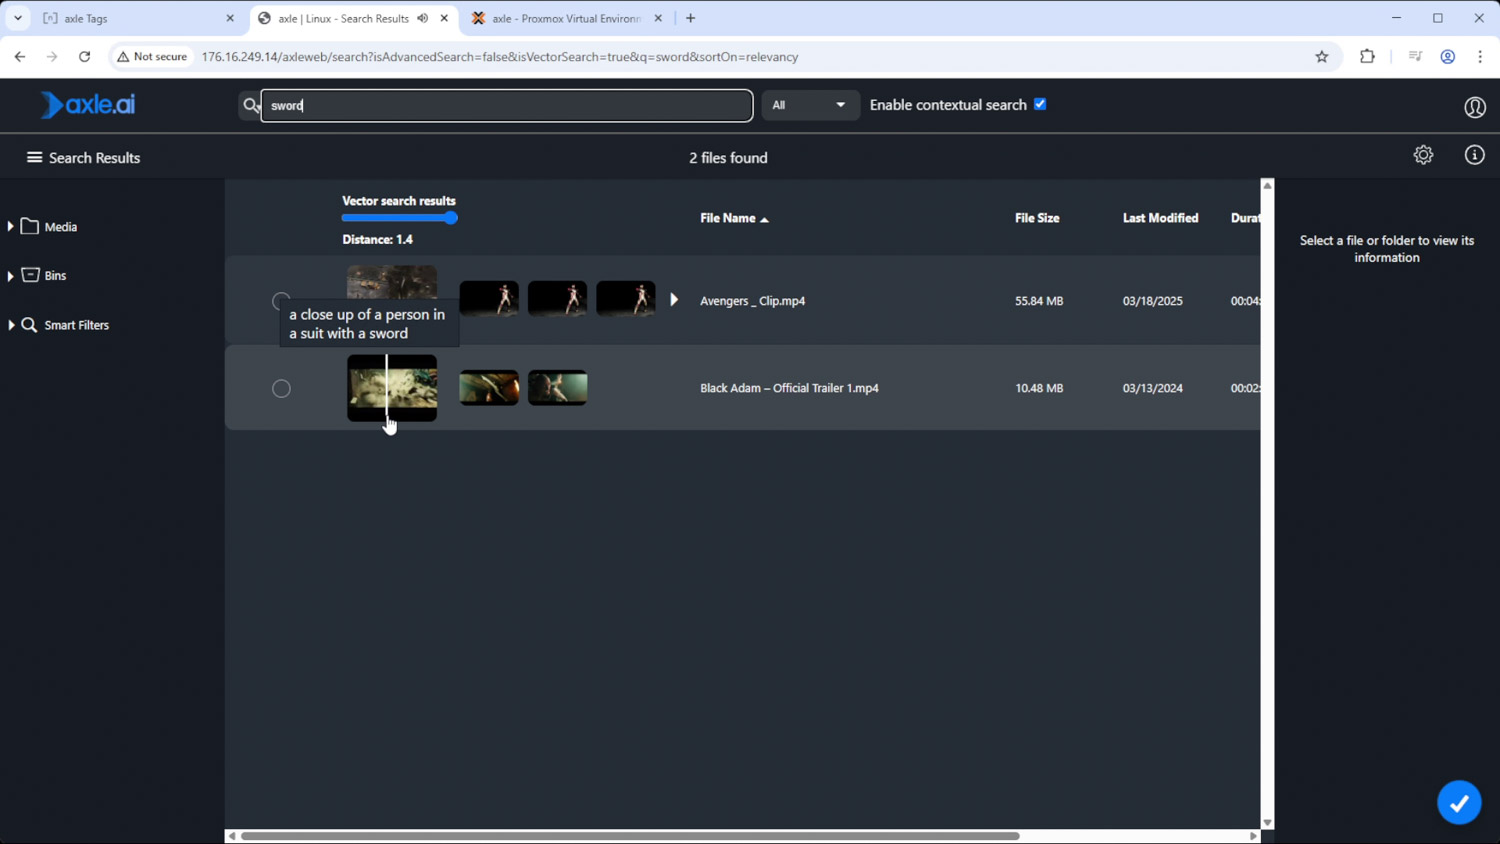
Schaalbaarheid is ook essentieel, aangezien niet alle opdrachten snelle mediaproductie op locatie vereisen. Axle AI kan worden geïnstalleerd op een krachtiger, stationair systeem met toegang tot de backlog van een mediabedrijf via een netwerkshare. Dit stelt editors en producers in staat om sneller relevante media te vinden, of zelfs media te ontdekken die ze mogelijk niet eerder hadden overwogen en die 'verloren' zijn gegaan in de archieven. Contentmakers en omroepen kunnen aanzienlijk profiteren van dit soort backlogindexen, waardoor er meer waarde wordt gecreëerd uit media die anders ongebruikt op een server zouden blijven staan. Hoewel het zeker niet waterdicht is, kan het mediabedrijven een voorsprong geven op enkele van de meest tijdrovende aspecten van het mediacreatieproces.
De HPE ProLiant DL145 Gen11 vormt de hardwarebasis voor deze edge AI-implementatie en levert een indrukwekkende balans tussen rekenkracht, opslagcapaciteit en GPU-versnelling in een compacte behuizing. Aangedreven door een 48-core AMD EPYC 8434P-processor uit de energiezuinige 8004-serie, is dit systeem geoptimaliseerd voor multithreaded workloads met behoud van een laag energieverbruik. De configuratie omvat 256 GB RAM en één NVIDIA L4 GPU, een zeer efficiënte accelerator die zeer geschikt is voor AI-inferentie aan de edge. De opslag is voorzien van zes Solidigm D7-PS1010 E3.S SSD's, elk met een capaciteit van 7.68 TB, die voldoende high-performance flashopslag bieden voor media-assets en metadata-intensieve workloads. Met ondersteuning voor maximaal drie single-wide GPU's en in totaal zes E3.S-schijven is de DL145 Gen11 goed gepositioneerd om te schalen met veeleisende video- en AI-toepassingen. Deze opstelling benadrukt hoe belangrijk het is om moderne hardwarecomponenten, zoals CPU, GPU en SSD's, zorgvuldig te assembleren om uitzonderlijke prestaties mogelijk te maken voor edge-gerichte AI-workflows, zoals de workflows die worden aangestuurd door Axle AI.
Conclusie
Axle AI transformeert de manier waarop videocontent wordt geproduceerd, met name voor teams die realtime werken met beperkte middelen. Door intelligent media asset management te combineren met krachtige inferentietools, maakt Axle AI een niveau van automatisering en responsiviteit mogelijk dat traditionele MAM-systemen niet kunnen evenaren. In combinatie met de HPE ProLiant DL145 Gen11 edge server, NVIDIA L4 GPU en Solidigm Gen5 SSD's biedt de door ons gebouwde installatie een compacte, krachtige omgeving die is geoptimaliseerd voor moderne mediaworkflows. Of deze nu in het veld wordt gebruikt of als onderdeel van een hybride bewerkingspijplijn, deze configuratie biedt een schaalbare en efficiënte manier om videocontent sneller dan ooit te verwerken, te taggen, te doorzoeken en te leveren, zonder in te leveren op kwaliteit of controle. Voor teams die voorop moeten blijven lopen in een snel veranderend contentlandschap, biedt de combinatie van edge-infrastructuur en AI-ondersteunde workflows een aanzienlijk concurrentievoordeel.



 Amazon