

Autor: George Teixeira, dyrektor generalny i prezes DataCore Software
W 2012 roku fraza „big data” jest na ustach wszystkich, tak jak wirtualizacja pięć lat temu. Podobnie jak w przypadku wirtualizacji i przetwarzania w chmurze, panuje duży szum medialny, który przesłania ważniejsze dyskusje na temat wyzwań IT, potrzebnych umiejętności i tego, jak faktycznie zbudować infrastrukturę wspierającą efektywne technologie big data.
Rozpływając się nad cudami wirtualizacji, nie dostrzegli oni nowych wymagań wydajnościowych i ogromnego wzrostu pojemności pamięci masowej niezbędnej do obsługi serwerów i desktopów. Potrzeba wyższej wydajności i ciągłej dostępności miała wysoką cenę, a jej nadwyrężenie budżetowe doprowadziło do opóźnienia lub storpedowania wielu projektów.
Problemy te rozwiązuje się obecnie dzięki wirtualizacji pamięci masowej, która wykorzystuje branżowe innowacje w zakresie wydajności, napędza większą komodyfikację drogiego sprzętu i automatyzuje zarządzanie pamięcią masową za pomocą nowych technologii, takich jak oprogramowanie do automatycznego poziomowania w całym przedsiębiorstwie.
Ta sama dynamika działa tu ponownie, tyle że tym razem w odniesieniu do dużych zbiorów danych.
Firmy zajmujące się analizą biznesową chciałyby, abyś uwierzył, że wystarczy po prostu nałożyć ich platformy analityczne na platformę Hadoop i BINGO – masz aplikację Big Data. W rzeczywistości, produkcyjne wdrożenia Hadoop praktycznie nie istnieją w dużych przedsiębiorstwach. Po prostu niewielu rozumie i potrafi wykorzystać te nowe technologie. Ponadto ekosystem technologii i metodologii wspierających jest wciąż zbyt niedojrzały, co oznacza, że branża przechodzi przez bolesny proces prób i błędów, tak jak pięć lat temu w przypadku wirtualizacji. Ponownie, niedocenianie wymagań dotyczących pamięci masowej staje się główną barierą w procesie wdrażania, ponieważ odwieczna praktyka „rzucania sprzętu na problem” generuje często nie do utrzymania koszty i złożoność.
Mówiąc wprost, big data nie wymaga po prostu dużej pamięci masowej – wymaga dużej, inteligentnej pamięci masowej. Niestety, branża grozi powtórzeniem poważnych błędów z przeszłości!
Zanim przejdę do technologii, pozwólcie, że wskażę na największe wyzwanie, przed którym stoimy, wkraczając w świat big data – musimy wykształcić ludzi, którzy będą napędzać i wdrażać użyteczne systemy big data. Niedawny artykuł w Forbesie wskazał, że nasze szkoły nie nadążają za wymaganiami edukacyjnymi stawianymi przez big data. Myślę, że poniższy fragment dobrze podsumowuje problem: „Mamy do czynienia z ogromnym deficytem osób nie tylko do obsługi big data, ale co ważniejsze, do posiadania wiedzy i umiejętności generowania wartości z danych – radzenia sobie z nieustającym tsunami. Jak agregować i filtrować dane, jak je prezentować, jak je analizować, aby uzyskać wgląd, jak wykorzystywać te spostrzeżenia do wspomagania procesu decyzyjnego, a następnie jak zintegrować to z branżowego punktu widzenia z procesem biznesowym?”
Wróćmy teraz do technologii produktowych, które będą miały znaczenie – zwłaszcza tych związanych z zarządzaniem pamięcią masową w tym nowym paradygmacie.
Jak wszyscy wiemy, nastąpił gwałtowny wzrost ilości danych, a tradycyjne podejścia do skalowania pamięci masowej i przetwarzania danych zaczęły osiągać granice obliczeniowe, operacyjne i ekonomiczne. Potrzebne jest nowe podejście, aby inteligentnie zarządzać dynamicznie rosnącymi zbiorami danych i zaspokajać ich potrzeby w zakresie wydajności i dostępności. Jeszcze kilka lat temu praktycznie niespotykane były rozmowy organizacji o skalowaniu powyżej kilkuset terabajtów, teraz dyskusje dotyczą kilku petabajtów. W przeszłości firmy decydowały się na archiwizację dużej części swoich treści na taśmach. Jednak w dzisiejszym świecie, zdominowanym przez media społecznościowe i oparte na dostępności na żądanie, nie jest to już możliwe. Użytkownicy oczekują teraz natychmiastowego dostępu i nie tolerują opóźnień w przywracaniu danych z wolnych i/lub zdalnych magazynów taśmowych.

Natychmiastowa gratyfikacja to hasło dnia, a wydajność ma kluczowe znaczenie.
Nowe systemy pamięci masowej muszą automatycznie i bez zakłóceń migrować dane z jednej generacji systemu do drugiej, aby skutecznie sprostać wyzwaniom archiwizacji długoterminowej. Problem ten pogłębia również konieczność rozproszenia pamięci masowej pomiędzy wieloma centrami danych, zarówno w celu odzyskiwania danych po awarii, jak i umieszczenia treści bliżej użytkowników, aby zminimalizować opóźnienia i skrócić czas reakcji.
Jest to szczególnie ważne dla wydajności aplikacji krytycznych dla codziennego funkcjonowania firmy, takich jak bazy danych, planowanie zasobów przedsiębiorstwa i inne obciążenia transakcyjne. Oprócz danych generowanych przez te wymagające dużej ilości zasobów aplikacje, działy IT muszą radzić sobie z ogromną skalą nowych mediów, takich jak Facebook i YouTube. Tradycyjne systemy pamięci masowej nie są dobrze dostosowane do rozwiązania tych problemów, co pozostawia architektom IT niewiele wyboru – muszą oni próbować samodzielnie opracowywać rozwiązania lub zmagać się ze złożonymi, nisko wydajnymi systemami.
Systemy pamięci masowej w środowiskach Big Data i chmurowych stanowią poważne wyzwanie, ponieważ zostały zaprojektowane do wdrażania na coraz większych macierzach pamięci masowej, zazwyczaj zlokalizowanych w jednej lokalizacji. Te zaawansowane, zastrzeżone systemy wiązały się z wysokimi kosztami kapitałowymi i operacyjnymi, a także z elastycznością i uzależnieniem od dostawcy. Nie oferowały one wystarczających mechanizmów tworzenia wspólnej, centralnie zarządzanej puli zasobów. To stawiało architekta IT przed koniecznością rozwiązania problemu z wieloma indywidualnymi systemami pamięci masowej, zazwyczaj różnych marek, modeli i modeli, wymagającymi odmiennego podejścia do replikacji między lokalizacjami i pewnego rodzaju niestandardowego zarządzania.
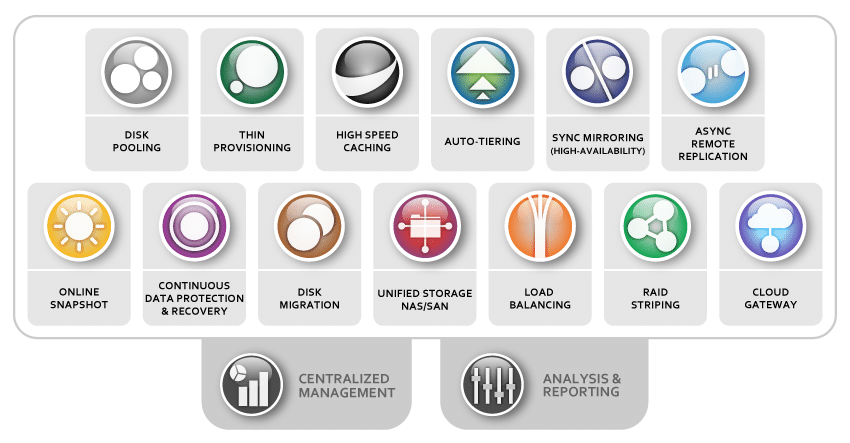
Mając to na uwadze, należy poruszyć cztery główne kwestie:
- Zarządzanie zasobami wirtualnymi i elastyczność: Przekształcenie obecnego krajobrazu monolitycznych, niezależnych rozwiązań w wirtualną pulę zasobów pamięci masowej, która uwzględnia i wykorzystuje szeroką gamę dostępnego obecnie sprzętu i urządzeń pamięci masowej, wymaga inteligentnego oprogramowania. Wysokie koszty kapitałowe i operacyjne: Aby obniżyć koszty operacyjne, niezbędne jest osiągnięcie większej produktywności poprzez automatyzację i scentralizowane zarządzanie. Równie ważne jest umożliwienie firmom większej komodytyzacji i umożliwienie wymienności sprzętu, co ma kluczowe znaczenie dla opłacalnej skalowalności pamięci masowej. Nikogo nie stać na „duże pieniądze”, aby rzucać droższe, „duże” rozwiązania w świecie big data. Hiperwizory, takie jak VMware i Microsoft Hyper-V, otworzyły użytkownikom większą siłę nabywczą. Obecnie korzystanie z serwerów Dell, HP, IBM lub Intel stało się w dużej mierze osobistą preferencją firm. To samo podejście jest wymagane w przypadku pamięci masowej i napędza zapotrzebowanie na hiperwizory.
- Skalowalność wymaga wydajności i ciągłej dostępności: Wraz ze wzrostem pamięci masowej i koniecznością obsługi większej liczby aplikacji, użytkowników i systemów, rosną wymagania dotyczące wyższej wydajności i dostępności. Nie chodzi już o to, ile danych zmieści się w dużej obudowie, ale o to, jak wykorzystać nowe technologie, aby pamięć masowa była szybsza i bardziej responsywna. Podobnie, niezależnie od tego, jak niezawodna może być pojedyncza obudowa pamięci masowej, nie da się jej porównać z wieloma systemami współpracującymi ze sobą w różnych lokalizacjach, aby zapewnić najwyższy poziom ciągłości działania, niezależnie od sprzętu bazowego.
- Pamięć dynamiczna a statyczna: Oczywiste jest również, że nie nadążamy już za optymalizacją danych korporacyjnych pod kątem maksymalnej wydajności i kompromisu między kosztami. Automatyzacja oprogramowania ma obecnie kluczowe znaczenie. Technologie takie jak thin-provisioning, obejmujące wiele urządzeń pamięci masowej, są niezbędne dla zwiększenia wydajności i lepszego wykorzystania zasobów pamięci masowej. Zaawansowane funkcje obejmujące całe przedsiębiorstwo, działające w różnych klasach pamięci masowej i typach urządzeń, stają się koniecznością. Do migracji z jednej klasy pamięci masowej do innej wymagane jest automatyczne warstwowanie pamięci masowej. W rezultacie, zaawansowane hiperwizory pamięci masowej mają kluczowe znaczenie, niezależnie od tego, czy dane i ruch wejścia/wyjścia najlepiej migrować z szybkiej dynamicznej pamięci RAM, dysków SSD, dysków twardych, czy nawet od dostawców pamięci masowej w chmurze.
Intensywne aplikacje wymagają obecnie systemu pamięci masowej, który może początkowo działać na małą skalę, a jednocześnie łatwo skalować się do wielu petabajtów. Musi on szybko obsługiwać treści i obsługiwać rosnące obciążenie tysięcy użytkowników każdego dnia. Musi być również niezwykle łatwy w obsłudze, umożliwiać maksymalną automatyzację i unikać konieczności specjalistycznej wiedzy w zakresie wdrażania i dostrajania. Być może najważniejsze jest to, że musi zmienić paradygmat pamięci masowej z wbudowanej w pojedynczą macierz lub lokalizację na rozproszony, ale centralnie zarządzany system, który może aktywnie przechowywać, pobierać i dystrybuować treści wszędzie tam, gdzie są potrzebne. Dobra wiadomość jest taka, że hiperwizory pamięci masowej, takie jak SANsymphony-V firmy DataCore, oferują łatwe w obsłudze, skalowalne rozwiązanie dla architektów IT, którzy muszą radzić sobie z dużymi ilościami danych przetwarzanych w nowoczesnej firmie.
Tak, Big Data oferuje ogromny potencjał. Tylko upewnijmy się, że tym razem zadbamy o odpowiednią pamięć masową, aby uniknąć powtórzenia wielkich błędów z przeszłości.
George Teixeira jest dyrektorem generalnym i prezesem DataCore Software . Platforma oprogramowania jako infrastruktury firmy rozwiązuje poważny problem blokujący inicjatywy wirtualizacyjne, eliminując bariery związane z pamięcią masową, które sprawiają, że wirtualizacja jest zbyt trudna i kosztowna. Kontakt z autorem możliwy jest pod adresem George.Teixeira@DataCore.com.


 Amazon