

Firma Meta zaprezentowała swoją najnowszą innowację w dziedzinie sztucznej inteligencji – Llama 4 – zbiór modeli, które zwiększają możliwości multimodalnej inteligencji. Llama 4 opiera się na architekturze Mixture-of-Experts (MoE), która oferuje wyjątkową wydajność i efektywność.
Zrozumienie modeli MoE i rzadkości
Modele typu „mikstura ekspertów” (MoE) znacząco różnią się od tradycyjnych modeli gęstych, w których cały model przetwarza każdy element wejściowy. W modelach MoE dla każdego elementu wejściowego aktywowany jest tylko podzbiór wszystkich parametrów, nazywany „ekspertami”. Ta selektywna aktywacja zależy od charakterystyki elementu wejściowego, umożliwiając modelowi dynamiczną alokację zasobów i zwiększenie wydajności.
Rzadkość jest kluczowym pojęciem w modelach MoE, wskazującym na stosunek nieaktywnych parametrów do określonego parametru wejściowego. Modele MoE mogą znacząco obniżyć koszty obliczeniowe poprzez wykorzystanie rzadkości przy jednoczesnym zachowaniu lub zwiększeniu wydajności.
Poznaj rodzinę Llama 4: Scout, Maverick i Behemoth
Pakiet Llama 4 składa się z trzech modeli: Llama 4 Scout, Llama 4 Maverick i Llama 4 Behemoth. Każdy model został zaprojektowany z myślą o różnych zastosowaniach i wymaganiach.
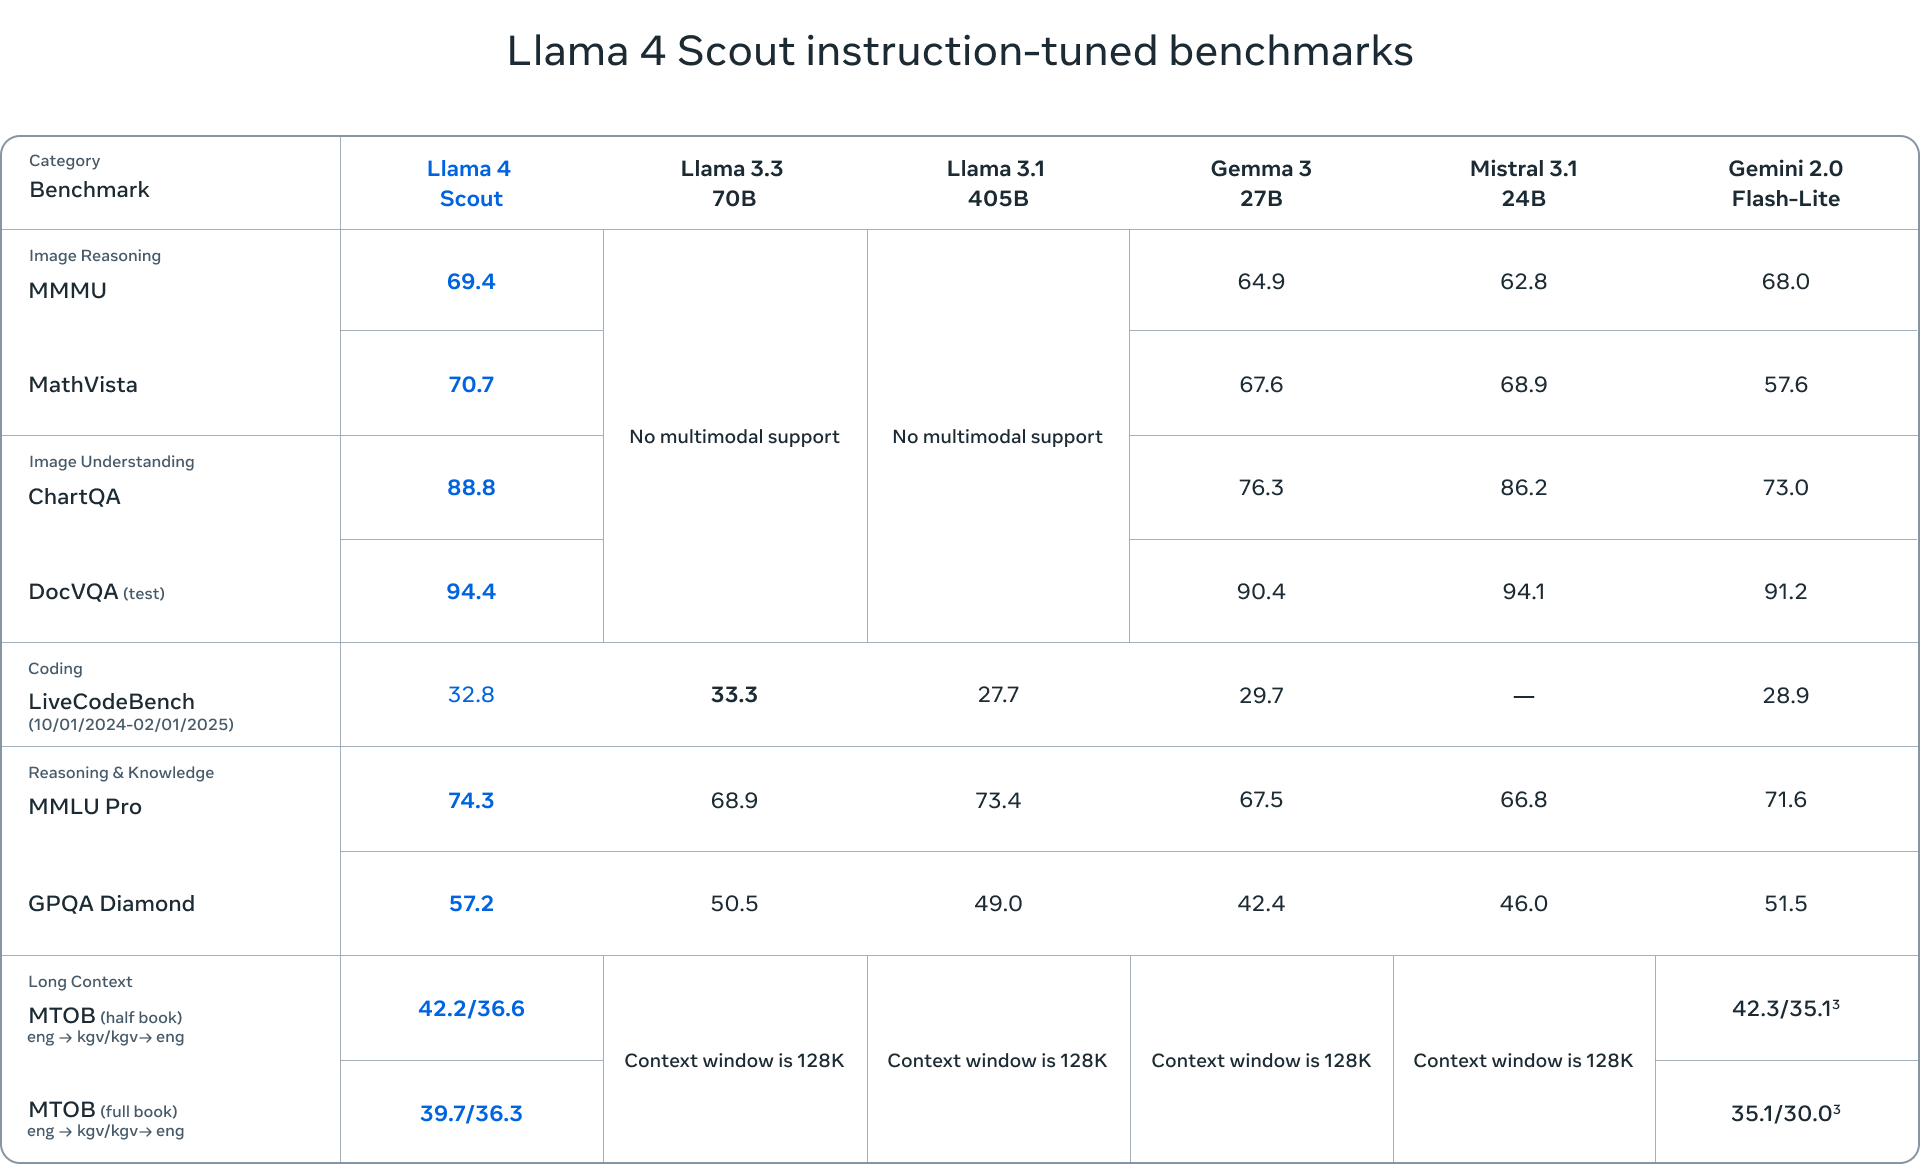
- Llama 4 Scout to kompaktowy model z 17 miliardami aktywnych parametrów i 109 miliardami parametrów całkowitych w 16 kategoriach. Jest zoptymalizowany pod kątem wydajności i może działać na jednym procesorze graficznym NVIDIA H100 (FP4 Quantized). Scout oferuje imponujące okno kontekstowe o pojemności 10 milionów tokenów, co czyni go idealnym rozwiązaniem dla aplikacji wymagających zrozumienia długiego kontekstu.
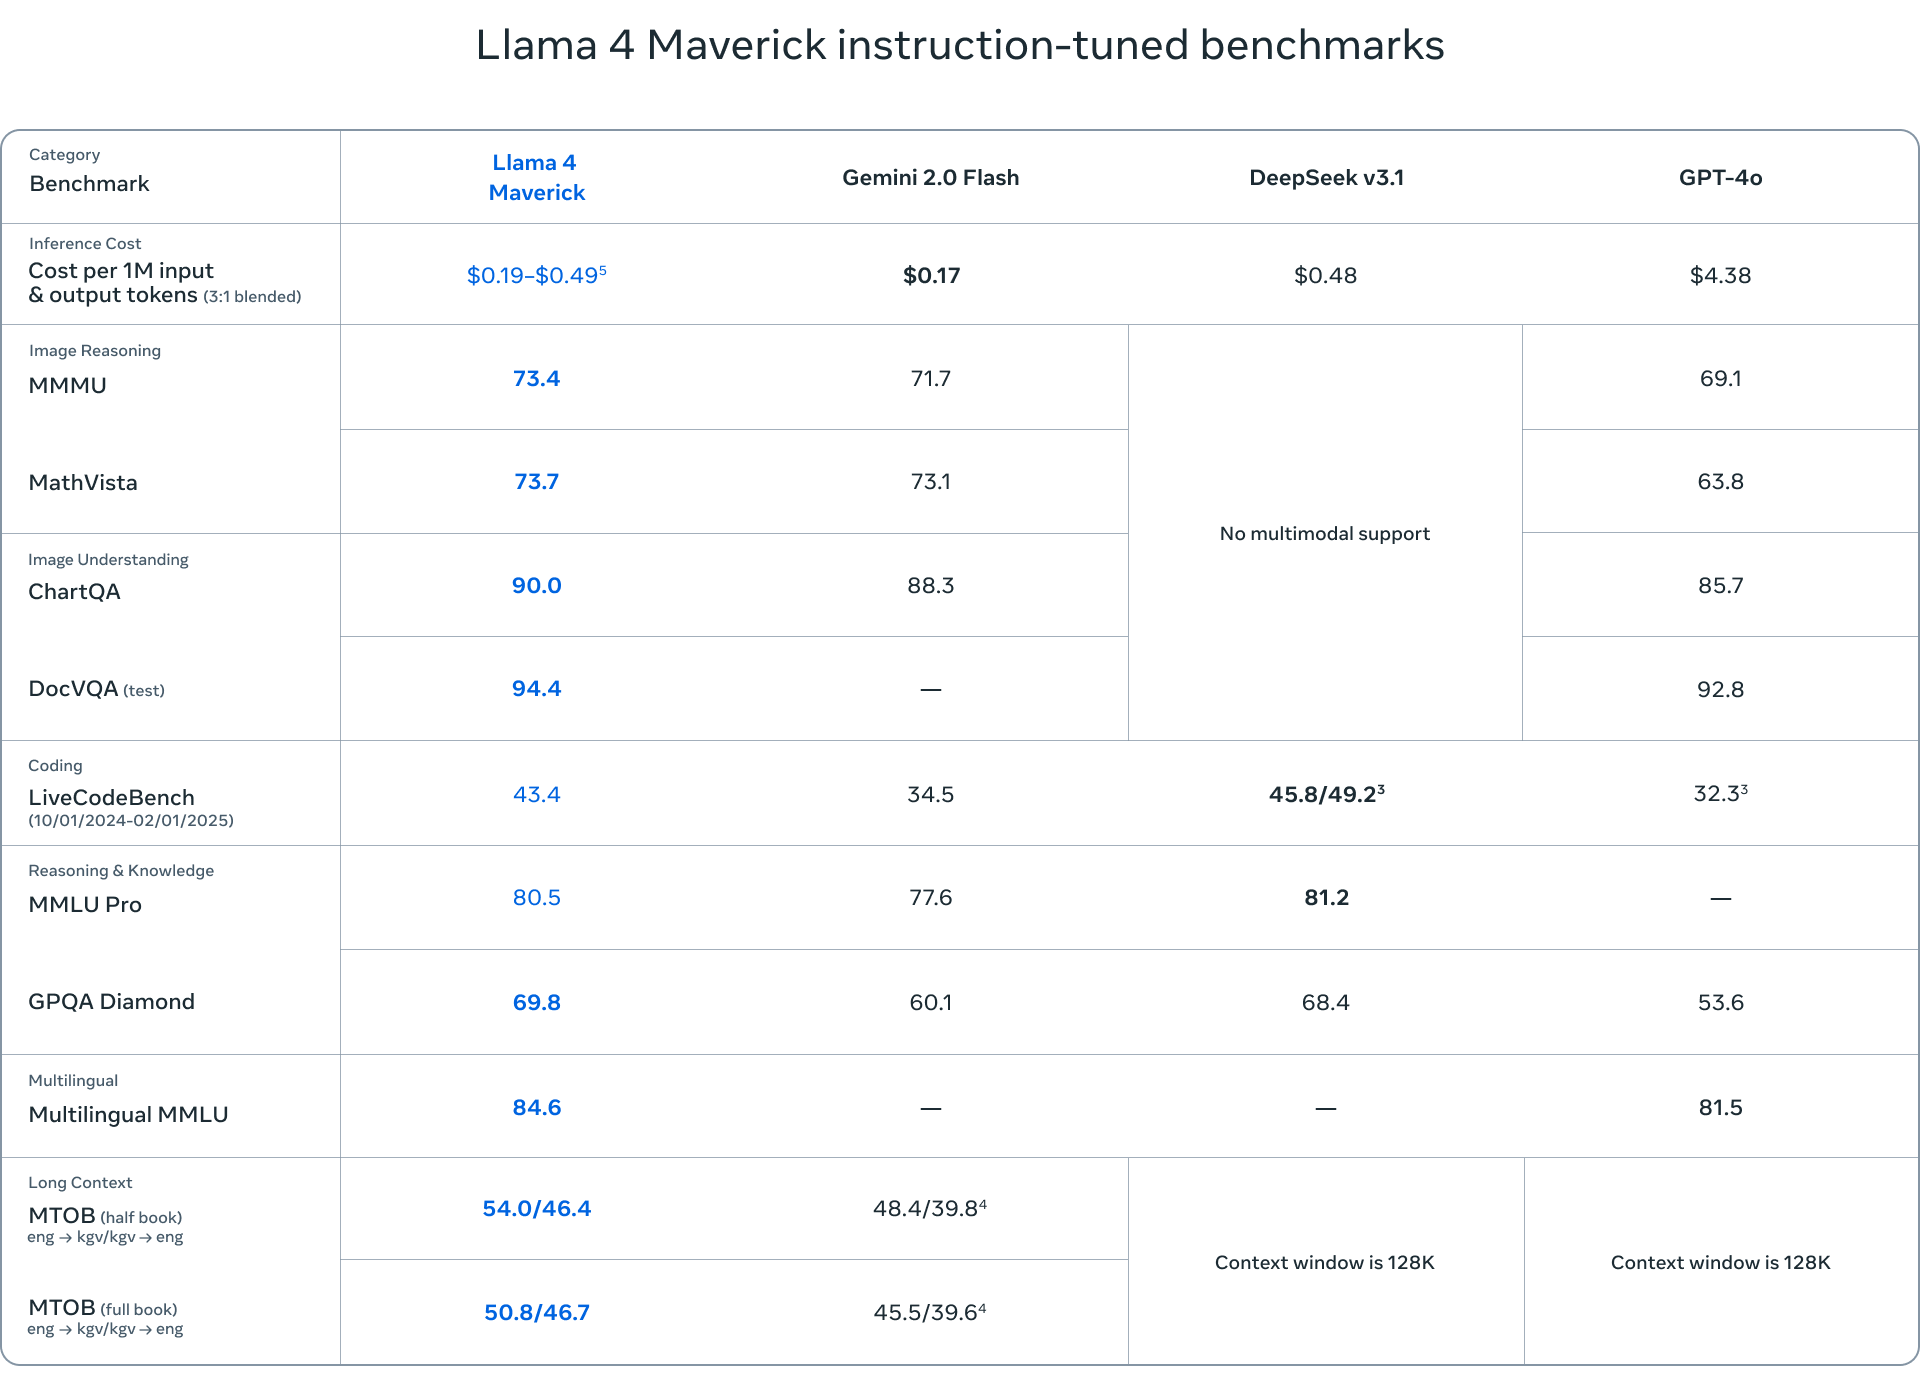
- Llama 4 Maverick to bardziej rozbudowany model z tymi samymi 17 miliardami aktywnych parametrów, ale z 128 ekspertami, co daje łącznie 400 miliardów parametrów. Maverick wyróżnia się w zakresie rozumienia multimodalnego, zadań wielojęzycznych i kodowania, przewyższając konkurencję, taką jak GPT-4o i Gemini 2.0 Flash.
- Llama 4 Behemoth to największy model w pakiecie, z 288 miliardami aktywnych parametrów i prawie 2 bilionami parametrów ogółem, analizowanych przez 16 ekspertów. Choć Behemoth wciąż znajduje się w fazie testów, zademonstrował już najwyższą wydajność w różnych testach porównawczych, przewyższając modele takie jak GPT-4.5 i Claude Sonnet 3.7.
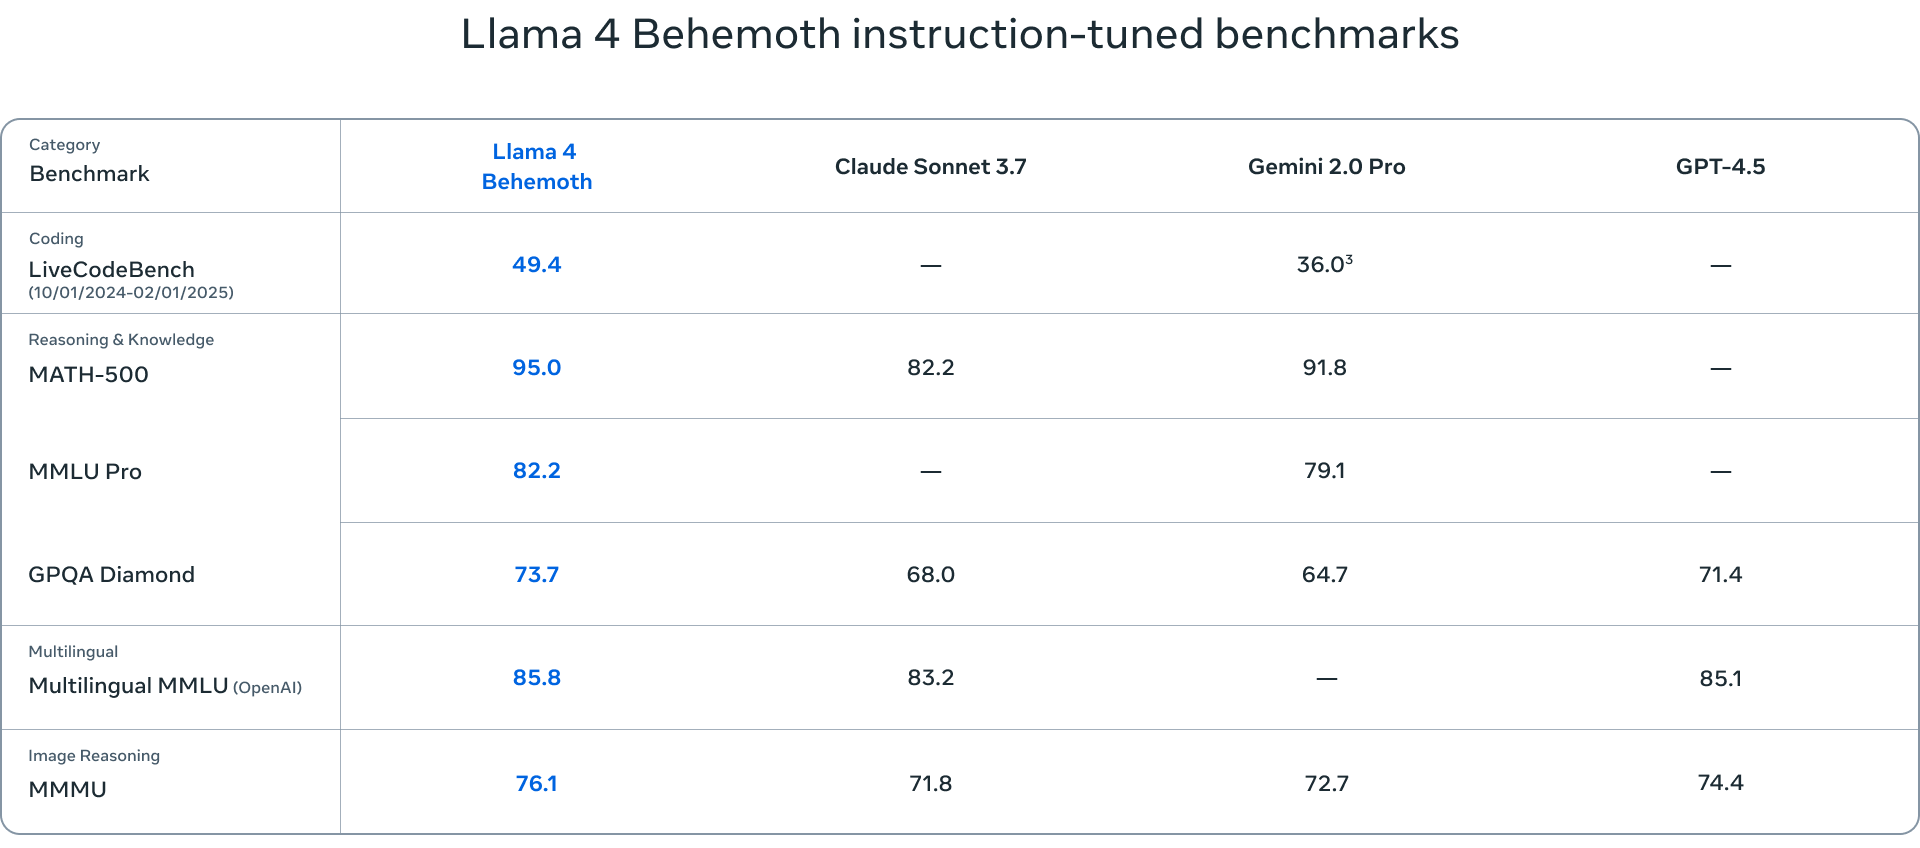
Testy porównawcze użyte do oceny modeli Llama 4 obejmują szereg zadań, w tym rozumienie języka (MMLU – Massive Multitask Language Understanding, GPQA – Google-Proof Question Answering), rozwiązywanie problemów matematycznych (MATH – Mathematical Problem-Solving, MathVista – benchmark rozwiązywania problemów matematycznych w kontekstach wizualnych) oraz rozumienie multimodalne (MMMU – Massive Multimodal Multitask Understanding). Te standardowe testy porównawcze zapewniają kompleksową ocenę możliwości modeli i pomagają zidentyfikować obszary, w których są one najlepsze lub wymagają dalszego udoskonalenia.
Rola modeli nauczycieli w Llama 4
Model nauczyciela to duży, wstępnie wytrenowany model, który kieruje mniejszymi modelami, przekazując im swoją wiedzę i możliwości poprzez destylację. W przypadku Llama 4, Behemoth pełni rolę modelu nauczyciela, przekazując swoją wiedzę zarówno Scoutowi, jak i Maverickowi. Proces destylacji polega na trenowaniu mniejszych modeli, aby naśladowały zachowanie modelu nauczyciela, umożliwiając im uczenie się na podstawie jego mocnych i słabych stron. Takie podejście pozwala mniejszym modelom osiągać imponującą wydajność, a jednocześnie być bardziej wydajnymi i skalowalnymi.
Implikacje i przyszłe kierunki
Premiera Llama 4 stanowi kamień milowy w rozwoju sztucznej inteligencji (AI), niosąc ze sobą dalekosiężne implikacje dla badań, rozwoju i zastosowań. Tradycyjnie modele Llama były katalizatorem dalszych badań, inspirując różnorodne badania i innowacje. Oczekuje się, że premiera Llama 4 będzie kontynuacją tego trendu, umożliwiając naukowcom rozwijanie i dopracowywanie modeli w celu rozwiązywania złożonych zadań i wyzwań.
Wiele modeli zostało dopracowanych i zbudowanych na bazie modeli Llama, co dowodzi wszechstronności i potencjału architektury Llama. Wersja Llama 4 prawdopodobnie przyspieszy ten trend, ponieważ badacze i programiści wykorzystają te modele do tworzenia nowych i innowacyjnych aplikacji. Jest to istotne, ponieważ Llama 4 to solidna wersja modelu, która umożliwi szeroki zakres działań badawczo-rozwojowych.
Warto zauważyć, że modele Llama 4, podobnie jak ich poprzednicy, nie myślą. Dlatego przyszłe wersje serii Llama 4 mogłyby zostać potencjalnie wytrenowane w zakresie rozumowania, co jeszcze bardziej poprawiłoby ich wydajność.


 Amazon