

Infrastruktury AI są znane z intensywnego wykorzystania zasobów, a przedsiębiorstwa nieustannie zmagają się z wyzwaniem optymalizacji wykorzystania GPU. Firma Dell Technologies, za pośrednictwem swojej platformy AI Factory, stawia czoła temu wyzwaniu, integrując niedawno przejęte przez firmę NVIDIA rozwiązanie do koordynacji, Run:ai . W niedawnym wpisie na blogu firmy Dell , firma podkreśliła, jak Run:ai maksymalizuje wykorzystanie zasobów i przyspiesza rezultaty AI, zmieniając sposób, w jaki przedsiębiorstwa wdrażają i zarządzają zasobami GPU na dużą skalę.
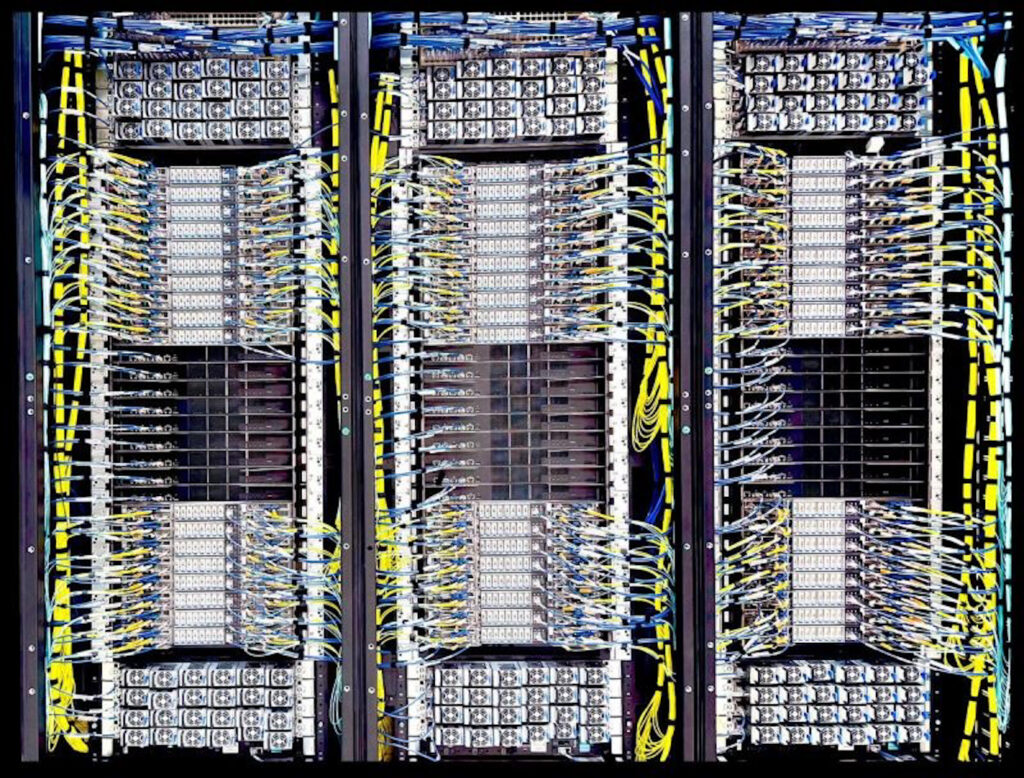
Klaster Dell NVL72
Czym właściwie jest Run:ai?
Run:ai to platforma orkiestracji oparta na Kubernetesie, zaprojektowana specjalnie dla obciążeń skoncentrowanych na GPU. Założona w 2018 roku, Run:ai zyskała popularność, rozwiązując powszechny problem branżowy: nieefektywne wykorzystanie GPU. Tradycyjnie GPU przypisane do obciążeń AI często pozostają bezczynne lub niewykorzystane. Run:ai rozwiązuje ten problem poprzez dynamiczne łączenie i inteligentne planowanie zasobów GPU, umożliwiając częściową alokację GPU, wydajne wdrożenia multi-GPU oraz płynne zarządzanie w środowiskach hybrydowych, chmurowych i lokalnych.
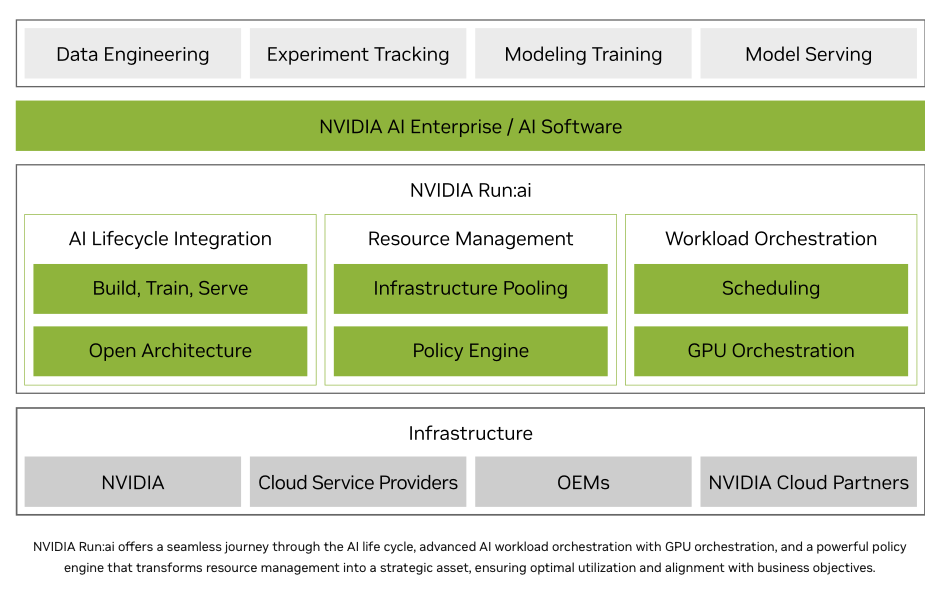
Dostrzegając potencjał Run:ai w zakresie radykalnej transformacji infrastruktury AI, NVIDIA sfinalizowała przejęcie firmy w grudniu 2024 roku za około 700 milionów dolarów. Co ciekawe, NVIDIA zobowiązała się do udostępnienia Run:ai w formie open source, sygnalizując w ten sposób zamiar wspierania szerokiej adopcji ekosystemu poza swoimi platformami sprzętowymi. Oczekuje się, że ten krok dodatkowo przyspieszy innowacje i wzrost wydajności w całej branży.
Dla osób poszukujących głębszej perspektywy technicznej w zakresie zarządzania zasobami, dokumentacja firmy NVIDIA szczegółowo opisuje, jak Run:ai jest niezbędny do koordynacji obciążeń w systemach GB200 NVL72. Dokument wskazuje na istotną lukę: Kubernetes nie rozpoznaje natywnie architektury MNNVL firmy NVIDIA, co utrudnia zarządzanie i harmonogramowanie obciążeń w tych wysokowydajnych domenach. Run:ai eliminuje tę złożoność, automatycznie wykrywając domeny NVLink i upraszczając przesyłanie rozproszonych obciążeń. Gwarantuje to prawidłowe rozmieszczenie kontenerów na węzłach z połączeniami NVLink, eliminując potrzebę dogłębnej wiedzy sprzętowej lub ręcznej konfiguracji dla każdego zadania. Te możliwości pokazują, jak platforma usprawnia operacje w gęstych środowiskach szkoleniowych, umożliwiając organizacjom pełne wykorzystanie potencjału zaawansowanych konfiguracji sprzętowych, takich jak GB200 NVL72.
Dlaczego to ma znaczenie dla przedsiębiorstwa
Dla organizacji obsługujących obciążenia intensywnie wykorzystujące GPU, zwłaszcza te wykorzystujące generatywną sztuczną inteligencję i duże modele językowe, niedostateczne wykorzystanie GPU stanowi poważne ryzyko: marnotrawstwo inwestycji. Run:ai bezpośrednio rozwiązuje te problemy, a NVIDIA informuje, że organizacje korzystające z platformy mogą odnotować nawet pięciokrotną poprawę wykorzystania GPU.
Ten poziom optymalizacji nie tylko zwiększa zwrot z inwestycji (ROI), ale także fundamentalnie zmienia wydajność operacyjną. Zespoły, które wcześniej borykały się z ograniczeniami zasobów i złożonymi procesami planowania, dysponują teraz narzędziami umożliwiającymi jednoczesne wdrażanie większej liczby modeli, szybkie skalowanie i bardziej agresywne eksperymentowanie – a wszystko to bez dodatkowych nakładów inwestycyjnych na sprzęt. Chociaż te metodologie są powszechne w dużych wdrożeniach HPC, poziom wydajności wymagany do maksymalizacji wykorzystania GPU jest mniej powszechny w przedsiębiorstwach.
Szeroki rozpęd branży
Kilku dużych dostawców infrastruktury decyduje się na wdrożenie tej platformy, co świadczy o rosnącym zainteresowaniu branżą IT w przedsiębiorstwach.
Firma Dell kontynuuje rozbudowę swojej platformy AI Factory, której sercem są technologie firmy NVIDIA, w tym Run:ai. Wykorzystanie Run:ai przez firmę Dell pokazuje, jak przedsiębiorstwa mogą przejść od wyizolowanej, ręcznej alokacji zasobów do bardziej dynamicznego, zautomatyzowanego harmonogramowania, które zwiększa wydajność w środowiskach wielodostępnych.
HPE oferuje Run:ai w ramach swojego GreenLake Marketplace, integrując je z platformą Ezmeral, aby umożliwić zaawansowane harmonogramowanie GPU, alokację cząstkową i koordynację infrastruktury hybrydowej. Dzięki temu klienci mogą wdrażać i zarządzać obciążeniami AI z większą precyzją i skalowalnością.
Cisco integruje Run:ai ze swoimi serwerami UCS X-Series i platformą operacji chmurowych Intersight. Ich rozwiązanie kładzie nacisk na zarządzanie limitami, dzielone współdzielenie GPU i monitorowanie w czasie rzeczywistym, aby wspierać wdrożenia AI na dużą skalę w środowisku lokalnym.
Wyróżniliśmy tylko kilku partnerów Run:ai. NVIDIA ma obszerną listę logotypów, jak widać powyżej. Wiodący producenci OEM i dostawcy platform chmurowych na całym świecie współpracują z Run:ai, dążąc do dostarczania bardziej innowacyjnych i wydajnych rozwiązań infrastruktury AI.



 Amazon