

Firma Supermicro ogłosiła zwiększenie mocy produkcyjnych w obudowach rack oraz ulepszenie funkcji bezpośredniego chłodzenia cieczą, aby zapewnić obsługę nadchodzących platform NVIDIA Vera Rubin NVL72 i NVIDIA HGX Rubin NVL8. Firma dąży do skrócenia czasu wdrażania infrastruktury AI o wysokiej gęstości, łącząc wewnętrzne projektowanie i produkcję w USA z podejściem Data Center Building Block Solutions (DCBBS) oraz kompleksowym zestawem technologii chłodzenia cieczą.
Prezes Supermicro, Charles Liang, podkreślił, że współpraca firmy z firmą NVIDIA i jej metodologia projektowania opartego na modułach konstrukcyjnych (BIM) mają na celu przyspieszenie wdrażania zaawansowanych platform AI. Podkreślił również rozbudowaną bazę produkcyjną Supermicro i jej doświadczenie w zakresie chłodzenia cieczą jako kluczowe czynniki umożliwiające wydajne, niezawodne i masowe wdrożenia systemów Vera Rubin i Rubin w środowiskach hiperskalowych i korporacyjnych.
Flagowy produkt w skali rack: NVIDIA Vera Rubin NVL72 SuperCluster
W najwyższej klasie, Supermicro będzie obsługiwać NVIDIA Vera Rubin NVL72 SuperCluster. Ten system o rozmiarach rack integruje 72 procesory graficzne NVIDIA Rubin i 36 procesorów NVIDIA Vera, a także karty NVIDIA ConnectX-9 SuperNIC i procesory DPU NVIDIA BlueField-4. Platforma wykorzystuje NVIDIA NVLink 6 do zapewnienia spójności wewnątrz racka. Została zaprojektowana z myślą o skalowaniu w poziomie w oparciu o NVIDIA Quantum-X800 InfiniBand i NVIDIA Spectrum-X Ethernet, co wpisuje się w obecny trend w branży, jakim jest projektowanie rack-as-a-system do trenowania, wnioskowania i agentowej sztucznej inteligencji na dużą skalę.
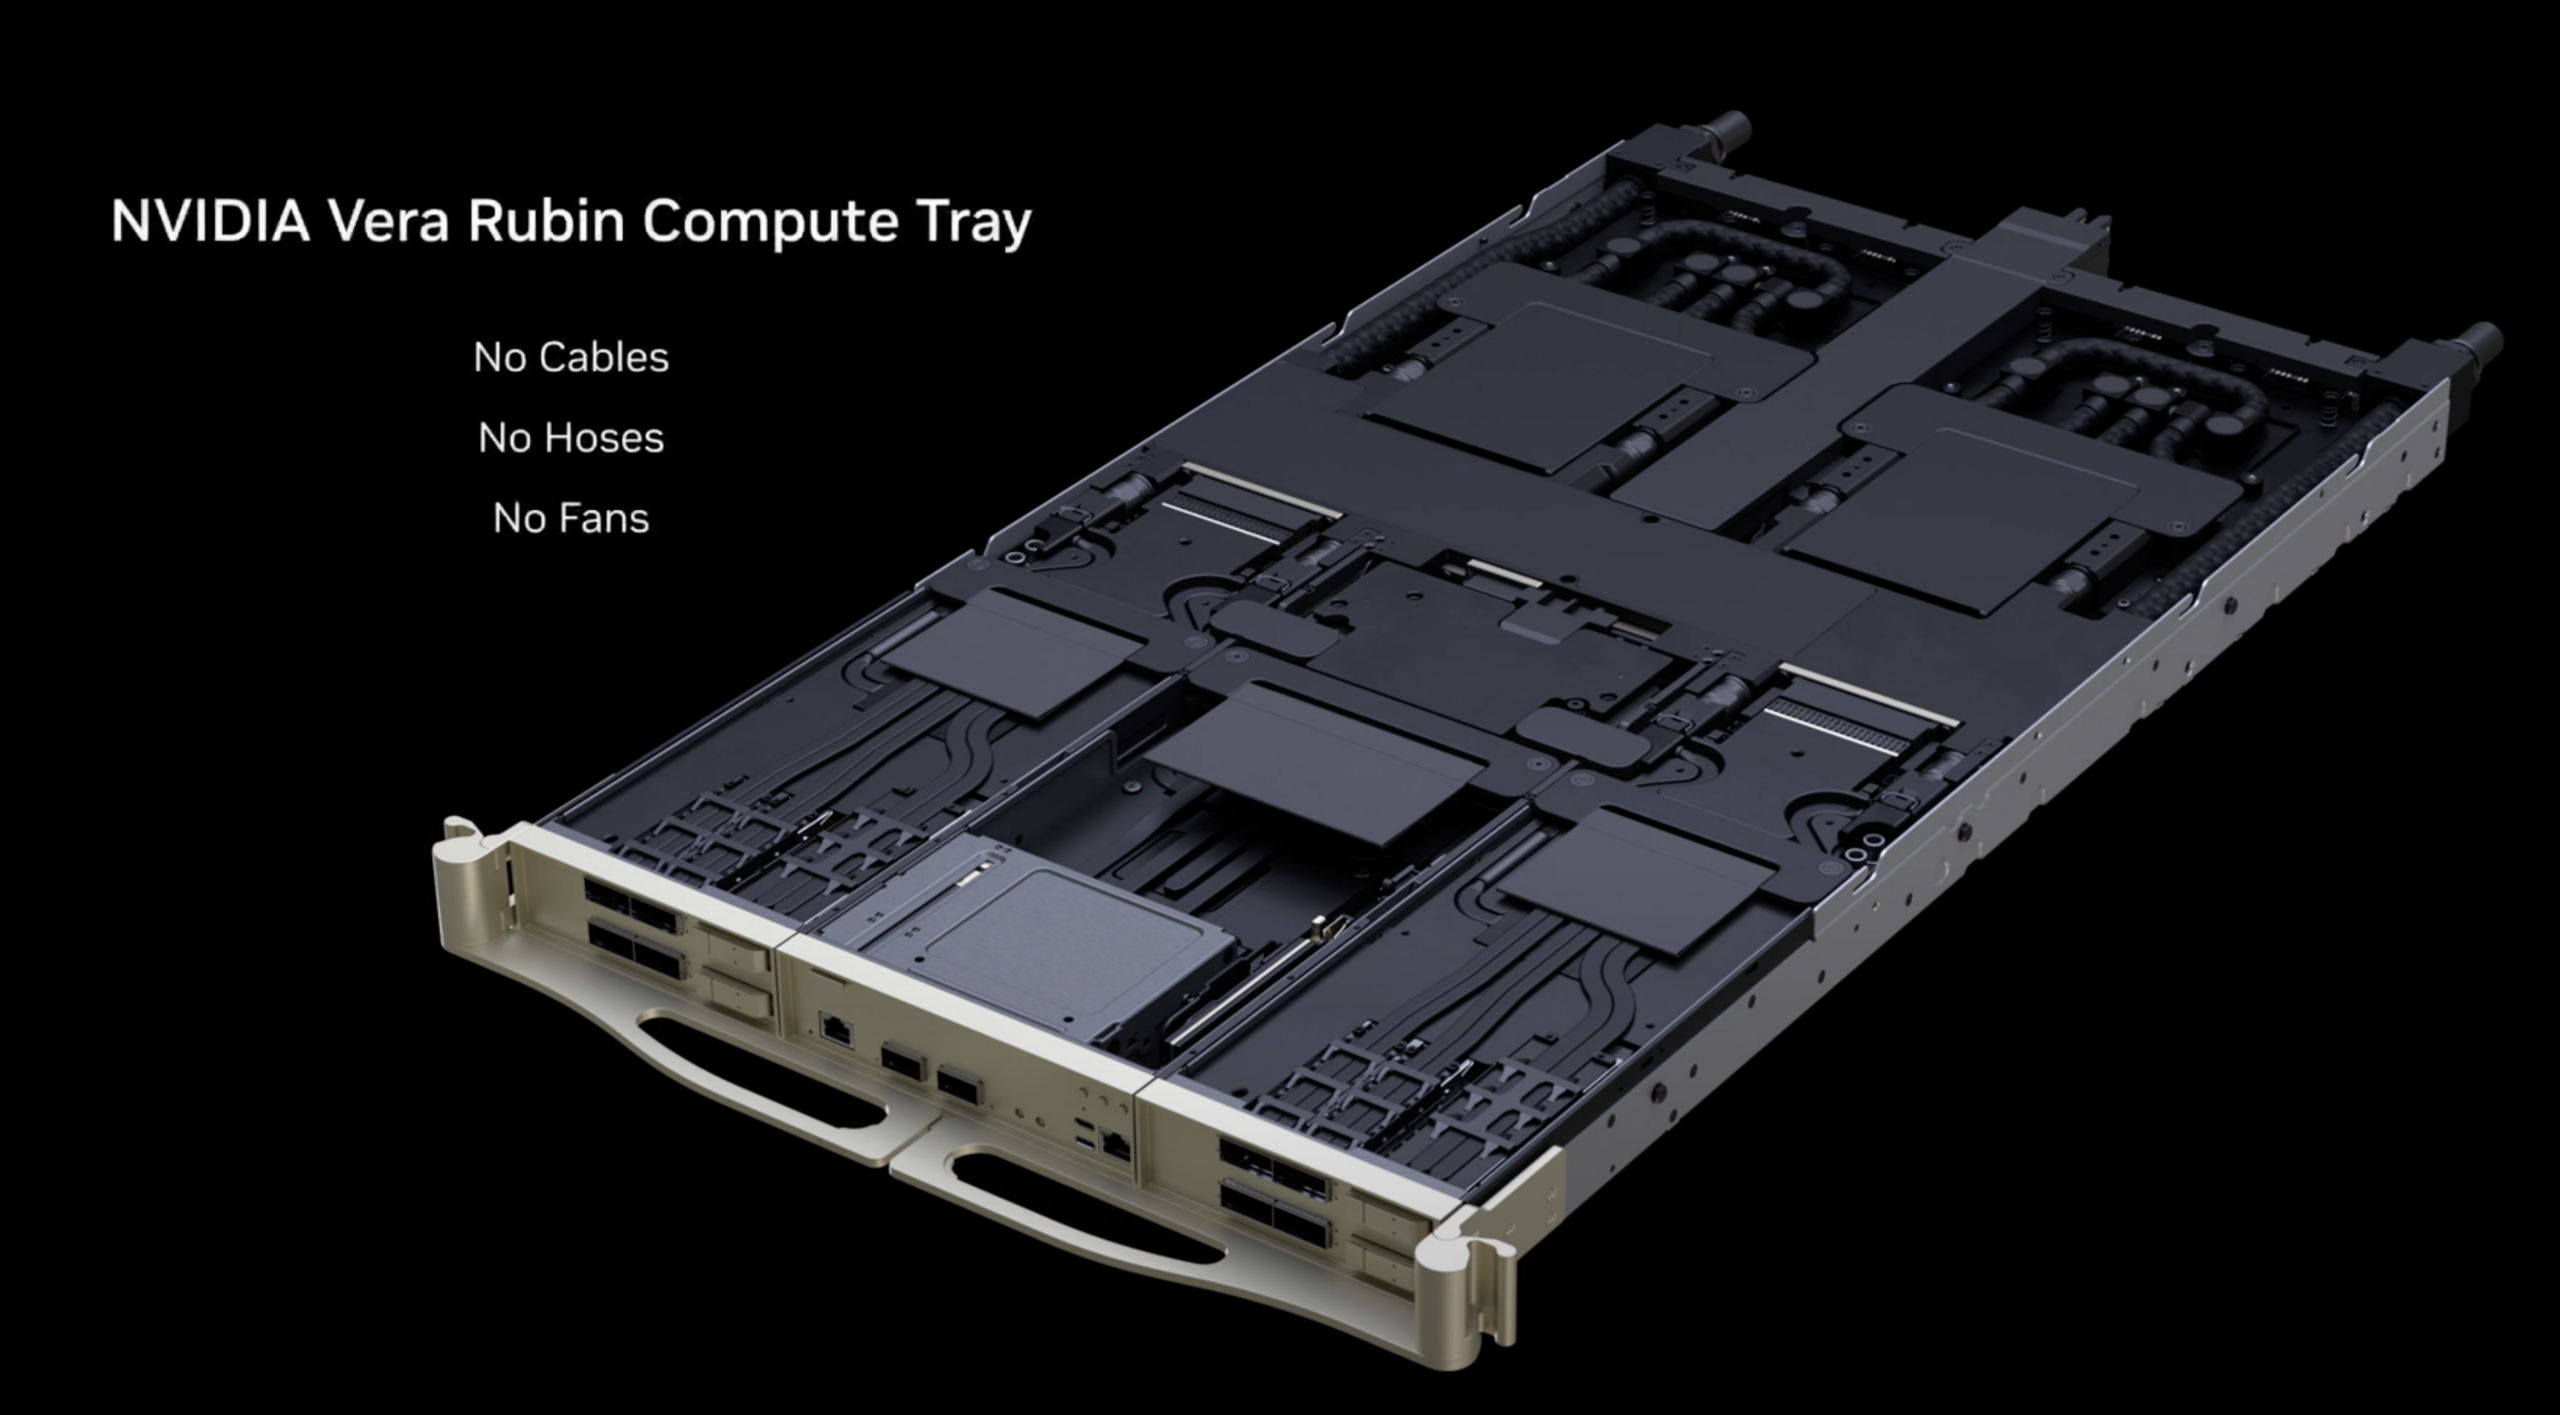
NVIDIA ocenia konfigurację NVL72 na 3.6 eksaflopów wydajności NVFP4, wspieranej przez przepustowość HBM4 na poziomie 1.4 PB/s i 75 TB szybkiej pamięci. Implementacja Supermicro opiera się na architekturze stelażowej NVIDIA MGX trzeciej generacji, kładąc nacisk na łatwość serwisowania, niezawodność i dostępność, aby zapewnić ciągłą pracę klastra.
Chłodzenie jest kluczowe dla projektu. Supermicro wdraża udoskonalony system chłodzenia cieczą o skali centrum danych z rzędowymi jednostkami dystrybucji chłodziwa (CDU). Celem jest umożliwienie skalowalnego chłodzenia ciepłą wodą, które zmniejsza zużycie energii i wody, jednocześnie zachowując gęstość i przewidywalną wydajność przy dużych obciążeniach AI.
Kompaktowa, gęsta instalacja obliczeniowa: chłodzona cieczą karta graficzna NVIDIA HGX Rubin NVL8 w obudowie 2U
Dla przedsiębiorstw i dostawców usług poszukujących bardziej modułowego rozwiązania, Supermicro zaprezentowało również chłodzone cieczą systemy NVIDIA HGX Rubin NVL8 o wysokości 2U. Ta platforma z 8 procesorami graficznymi (GPU) jest przeznaczona do zadań związanych ze sztuczną inteligencją (AI) i obliczeniami o wysokiej wydajności (HPC), a NVIDIA deklaruje wydajność NVFP4 na poziomie 400 petaflopów. Platforma charakteryzuje się przepustowością 176 TB/s w standardzie HBM4 i 28.8 TB/s w standardzie NVLink, a także łącznością sieciową NVIDIA ConnectX-9 o przepustowości 1600 Gb/s za pośrednictwem kart SuperNIC.
Supermicro oferuje konstrukcję rackową, która ma zapewnić elastyczność wdrożenia, z opcjami konfiguracji obejmującymi flagowe procesory x86, w tym procesory Intel Xeon i AMD EPYC nowej generacji. Firma podkreśliła również konstrukcję magistrali 2U o wysokiej gęstości, umożliwiającą integrację z rackiem, w połączeniu z technologią bezpośredniego chłodzenia cieczą (DLC) Supermicro, która zapewnia wyższą, stałą moc bez utraty łatwości serwisowania.
Funkcje platformy Vera Rubin
Obsługa platformy Supermicro jest zgodna z kilkoma kluczowymi możliwościami ery Very Rubin, które mają bezpośredni wpływ na projektowanie klastrów i planowanie operacyjne, w tym:
- NVIDIA NVLink 6 to szybka magistrala połączeniowa, która zapewnia większą przepustowość i niższe opóźnienia w komunikacji między procesorami graficznymi (GPU) i procesorami (CPU). Jest to szczególnie istotne w przypadku trenowania i wnioskowania w bardzo dużych modelach obejmujących dużą liczbę ekspertów, gdzie wzorce komunikacji mogą wpływać na wydajność w dużej skali.
- Procesor NVIDIA Vera wykorzystuje rdzenie ARM zaprojektowane przez firmę NVIDIA i, jak twierdzi producent, zapewnia dwukrotnie większą wydajność w porównaniu z poprzednią generacją. Procesor obsługuje wielowątkowość przestrzenną z 88 rdzeniami i 176 wątkami, a także przepustowość pamięci LPDDR5X na poziomie 1.2 TB/s i większą pojemność pamięci. Vera zwiększa również sprzężenie CPU-GPU dzięki przepustowości NVLink-C2C na poziomie 1.8 TB/s dla GPU, co jest określane jako dwukrotnie wyższe niż w poprzedniej generacji.
- Silnik Transformer Engine trzeciej generacji firmy NVIDIA koncentruje się na akceleracji o długim kontekście i wąskiej precyzji, co stało się kluczowe w obliczu przesunięcia się nowoczesnego wnioskowania w kierunku trwałych sesji, potoków wieloagentowych i wyższej współbieżności. Platforma wykorzystuje również technologię przetwarzania poufnego trzeciej generacji, opisaną jako przetwarzanie poufne w skali szafy serwerowej z ujednoliconym, zaufanym środowiskiem wykonawczym na poziomie procesora graficznego, które chroni i izoluje modele, dane i monity. Dla operatorów wdrażających sztuczną inteligencję w regulowanych przepływach pracy, przetwarzanie poufne i izolacja granic wykonywania GPU stają się coraz ważniejszymi kryteriami wyboru platformy.
- Poprawę niezawodności zapewnia silnik RAS drugiej generacji, który obejmuje zaawansowane monitorowanie stanu i kontrole w czasie rzeczywistym, aby skrócić przestoje. W środowiskach o dużej gęstości chłodzenia cieczą, wykrywanie usterek i łatwość serwisowania są kluczowe, ponieważ okresy konserwacji są kosztowne, a tolerancja operacyjna na niestabilność jest niska.
Sieci: fotonika Ethernet Spectrum-X i przepustowość w skali szafy
Supermicro powiązało również obsługę platformy Rubin z układem fotonicznym Spectrum-X Ethernet firmy NVIDIA, zbudowanym na bazie układu ASIC Spectrum-6 Ethernet. NVIDIA określa przełączanie na poziomie 102.4 Tb/s w 3-nm procesie technologicznym TSMC, z optyką 200G SerDes w pakiecie i w pełni współdzielonymi buforami.
Deklarowanym celem jest poprawa wydajności i stabilności operacyjnej w porównaniu z tradycyjnymi, podłączanymi elementami optycznymi. NVIDIA deklaruje 5-krotnie wyższą sprawność energetyczną, 10-krotnie wyższą niezawodność i 5-krotnie dłuższy czas sprawności aplikacji. NVIDIA wymieniła wiele modeli przełączników, w tym chłodzony cieczą SN6800 (CPO 409.6 Tb/s z 512 portami 800G), SN6810 (CPO 102.4 Tb/s z 128 portami 800G) oraz SN6600 (przełączana optyka, 128 portów 800G, dostępna w konfiguracji chłodzonej powietrzem lub cieczą). Dla operatorów centrów danych te projekty wskazują na konieczność stosowania struktur Ethernet 800G o wyższej gęstości i lepszych parametrach zasilania i chłodzenia, co staje się coraz bardziej istotne, ponieważ moc obliczeniowa sieci front-end staje się mierzalną częścią budżetów szaf rack.
Integracja pamięci masowej dla fabryk AI
W obszarze pamięci masowej, Supermicro podkreśliło uzupełniające rozwiązania oparte na swoim petaskalowym serwerze pamięci masowej all-flash i systemach JBOF. Platformy te obsługują jednostki przetwarzania danych NVIDIA BlueField-4 oraz szereg rozwiązań do zarządzania danymi, dostosowując pamięć masową i sieć do tej samej, skalowalnej, akcelerowanej architektury wykorzystywanej przez warstwę obliczeniową.
Mimo że firma Supermicro nie podała w tym ogłoszeniu danych dotyczących wydajności platform pamięci masowej, nacisk położony na integrację wskazuje na ciągły ruch w kierunku sprawdzonych projektów pełnego stosu, w których obliczenia, sieć i pamięć masowa są wspólnie kwalifikowane do wdrożeń fabrycznych AI.
Skala produkcji i czas wdrożenia
Motywem przewodnim ogłoszenia jest wydajność produkcji i szybkość wdrażania. Rozbudowane zaplecze i stos chłodzenia cieczą firmy Supermicro zostały zaprojektowane z myślą o usprawnieniu produkcji i dostaw w pełni chłodzonych cieczą platform Vera Rubin i Rubin. Jednocześnie modułowa architektura DCBBS umożliwia szybką konfigurację, walidację i skalowanie. Dla klientów technicznych z sektora przedsiębiorstw czynnikiem decydującym jest nie tyle pojedyncza specyfikacja obudowy, co przewidywalność dostaw, powtarzalność konstrukcji szaf oraz skrócenie czasu od odbioru sprzętu do stabilnej produkcji.
Supermicro zakłada, że w miarę jak chłodzenie cieczą stanie się standardem w przypadku systemów AI najwyższej klasy, dostawcy potrafiący uprzemysłowić produkcję i walidację w skali rackowej będą najlepiej przygotowani do obsługi wdrożeń na dużą skalę bez konieczności wydłużania cykli integracji.


 Amazon