

Firma WhiteFiber ujawniła wstępne wyniki prac badawczo-rozwojowych nad projektem Redwood, rozproszoną architekturą superklastra GPU, zaprojektowaną do działania w geograficznie oddzielonych centrach danych. Zapowiedziany w zeszłym tygodniu test zapewnił przepustowość 111.2 Tb/s na 83 km ciemnego światłowodu, z gwarantowanym opóźnieniem transmisji danych wynoszącym 0.9 ms.
Firma WhiteFiber twierdzi, że opóźnienie mieści się w granicach 8% fizycznej granicy propagacji światła przesyłanego światłowodem na taką odległość. W teście firma wykorzystała tylko część dostępnego pasma światłowodowego, co, jak twierdzi, jest już mniej więcej dwukrotnie większe niż w przypadku porównywalnych opublikowanych testów terenowych z pełnym pasmem. Firma planuje wykorzystać pełne pasmo przed planowanym wprowadzeniem na rynek w trzecim kwartale 2026 roku.
Prace zostały wykonane we współpracy z firmami DriveNets i WEKA. DriveNets zapewnia infrastrukturę sztucznej inteligencji opartą na sieci Ethernet między obiektami, natomiast WEKA NeuralMesh dostarcza infrastrukturę pamięci masowej i pamięci obejmującej klaster. Firma WhiteFiber złożyła wnioski patentowe związane z wdrożeniem.
Traktowanie wielu witryn jako jednego klastra GPU
Architektura ma na celu umożliwienie dwóm centrom danych funkcjonowania jako jeden logiczny superklaster GPU, a nie dwa niezależnie działające klastry połączone konwencjonalnym łączem DCI. To rozróżnienie jest istotne w przypadku obciążeń związanych z trenowaniem i wnioskowaniem AI, gdzie synchronizacja między GPU i GPU, zbiorcze operacje i dostęp do współdzielonej infrastruktury danych mogą decydować o użytecznej skali klastra.
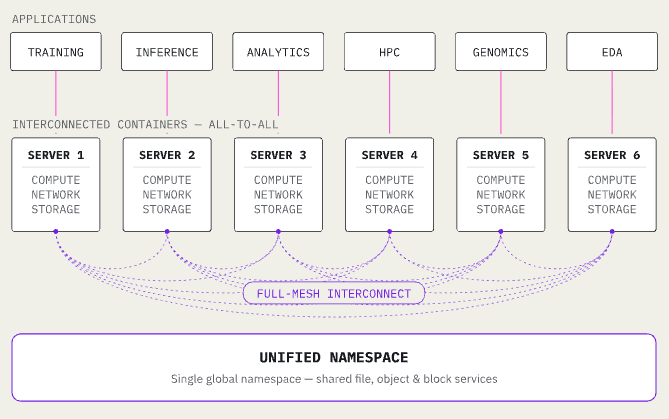
WhiteFiber pozycjonuje platformę pod kątem obciążeń, które przekraczają wymagania pojedynczej lokalizacji w zakresie dostępnego zasilania, chłodzenia, przestrzeni, odporności konstrukcji lub suwerenności danych. Firma dostrzega również zastosowania w przetwarzaniu brzegowym, telekomunikacji i suwerennych wdrożeniach sztucznej inteligencji.
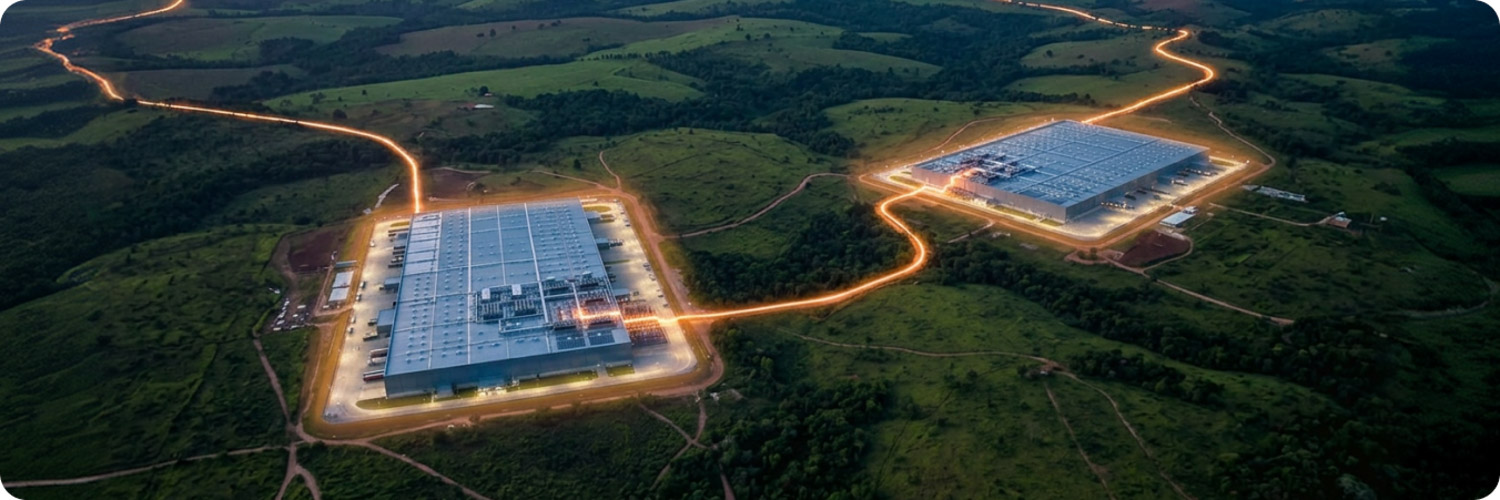
Towarzyszące ogłoszenie firmy DriveNets identyfikuje sprzęt: infrastruktura łączy dwa klastry GPU WhiteFiber NVIDIA H200 oddalone od siebie o 84 kilometry (52 mile). DriveNets opisuje to wdrożenie jako pierwszy w branży komercyjny, skalowalny superklastr AI o dużym zasięgu, przetestowany w skali produkcyjnej, a nie laboratoryjnej. W ramach walidacji firmy porównały wydajność między szafami w jednej lokalizacji z wydajnością między szafami w obu lokalizacjach, a szczegóły metodologii zawarto w białej księdze DriveNets.
Projektowanie sieci szkieletowych DriveNets
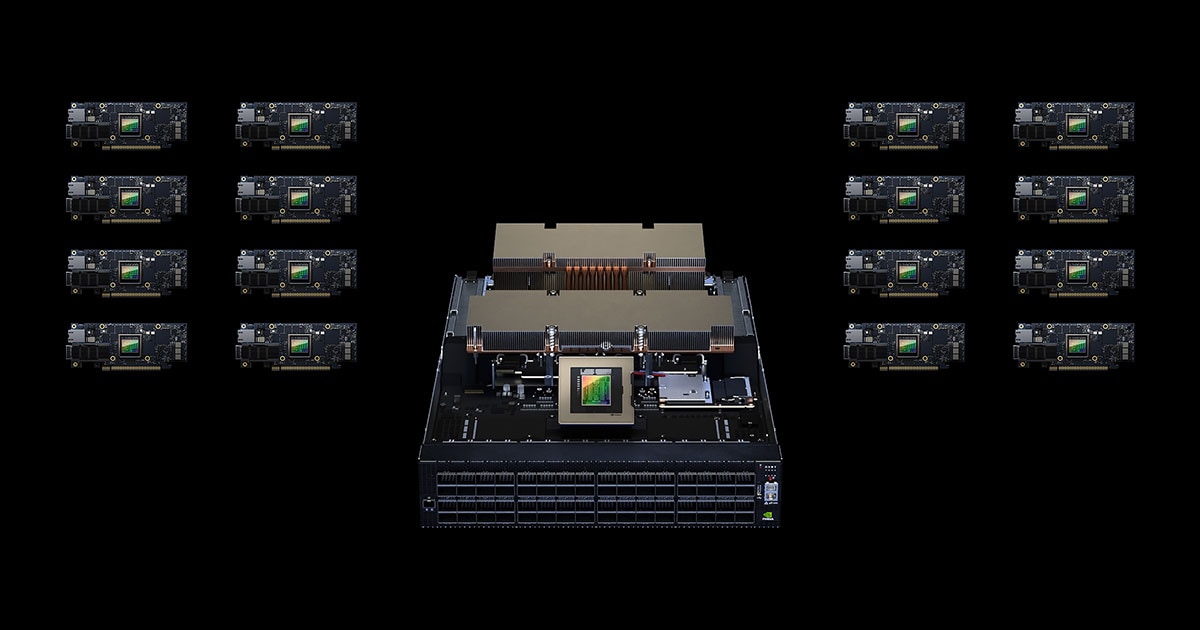
Środowisko międzylokalizacyjne wykorzystuje redundantne ciemne światłowody i infrastrukturę DriveNets AI Fabric do przesyłania ruchu GPU i pamięci masowej. Architektura DriveNets charakteryzuje się planową strukturą Ethernet, stworzoną z myślą o przewidywalnej, rozproszonej komunikacji AI, a nie tradycyjnym, dalekosiężnym rozszerzeniu Ethernet.
Projekt rozszerza infrastrukturę AI na różne lokalizacje za pomocą technologii Fabric Scheduled Ethernet firmy DriveNets, działającej na przełącznikach 9300F, 5300R i 5301R. Podejście to łączy równoważenie obciążenia oparte na komórkach, kompleksowe wirtualne kolejkowanie wyjść (VQ ...
Łącznie mechanizmy te mają na celu zachowanie przewidywalnego zachowania komunikacji zbiorowej na odległość, przy jednoczesnym wsparciu ujednoliconej infrastruktury obliczeniowej i pamięci masowej. Izolacja wielodostępna jest częścią deklarowanego celu projektowego.
Rezultatem jest architektura, która traktuje trasę światłowodową jako część struktury AI, a nie tylko połączenie transportowe między lokalizacjami. Celem jest zmniejszenie operacyjnego znaczenia fizycznej granicy centrum danych dla obciążeń uruchamianych w klastrze.
Odrębne podejście od NVIDIA Spectrum-XGS
Platforma testowa WhiteFiber różni się od NVIDIA Spectrum-XGS Ethernet. Prace te wpisują się jednak w szersze dążenie branży do „skalowania wszerz” infrastruktury AI.
Podczas konferencji Hot Chips 2025, prezes NVIDIA, Jensen Huang, opisał potrzebę połączenia centrów danych w miastach, krajach i na kontynentach, tworząc wielkoskalowe fabryki sztucznej inteligencji. Rozwiązanie Spectrum-XGS firmy NVIDIA wykorzystuje kontrolę przeciążenia z uwzględnieniem odległości, precyzyjne zarządzanie opóźnieniami oraz telemetrię, aby poprawić przewidywalność rozproszonej komunikacji GPU. CoreWeave jest jednym z pierwszych rozwiązań wskazanych przez NVIDIA.
Firma WhiteFiber dostarczyła bardziej szczegółowe dane z wczesnych testów terenowych niż NVIDIA ujawniła publicznie dla wdrożeń Spectrum-XGS. Test na 83 km wykazał przepustowość 111.2 Tb/s i opóźnienie w obie strony 0.9 ms, chociaż systemy wykorzystują różne architektury, a ich wyniki nie są bezpośrednio porównywalne.
Szkolenia rozproszone wykraczają poza pojedynczą placówkę
Oświadczenie firmy WhiteFiber pojawia się w momencie, gdy inni dostawcy usług w chmurze i infrastruktury badają architektury uczenia i wnioskowania AI w wielu lokalizacjach.
Oracle Cloud Infrastructure i NVIDIA opublikowały prace wykorzystujące platformę NeMo Framework i platformę Megatron-Core do przeprowadzania szkoleń LLM w centrach danych oddalonych od siebie o około 1,000 km. NVIDIA odnotowała ponad 96-procentową skalowalność szkoleń dzięki hierarchicznej, redukcyjnej i podzielonej na fragmenty komunikacji między centrami danych. Praca ta jest przede wszystkim demonstracją oprogramowania i systemów, a nie testem porównawczym transportu w skali metropolitalnej.
Google opracował również technologię TPU Multislice, umożliwiającą wielu segmentom TPU działanie jako większe, rozproszone środowisko szkoleniowe w sieci centrów danych i połączeniach optycznych. Google poinformował, że szkolenie Gemini wykorzystywało wiele centrów danych, a platforma została zaprojektowana z myślą o zarządzaniu partycjonowaniem obciążeń i odpornością na dużą skalę.
WhiteFiber zamierza wprowadzić podobną, wielostanowiskową konstrukcję do infrastruktury chmurowej GPU, ze szczególnym naciskiem na łączność metropolitalną o wysokiej przepustowości i niskich opóźnieniach. Firma planuje udostępnić dalsze szczegóły dotyczące architektury i dostępności w miarę wdrażania komercyjnego w trzecim kwartale 2026 roku.


 Amazon