

Nie jest tajemnicą, że uwielbiamy ogromną gęstość dysków SSD Solidigm U.2 NVMe o pojemności 61.44 TB. Przeprowadziliśmy liczne testy wytrzymałości i wydajności, dokonaliśmy odkryć naukowych i wynieśliśmy rekordowe obliczenia na nowe, niezwykłe wyżyny. Dlatego, w obliczu szaleństwa na punkcie sztucznej inteligencji, które rozkręca się wokół nas w zawrotnym tempie, kolejnym logicznym krokiem było sprawdzenie, jak dyski Solidigm NVMe sprawdzają się w dynamicznym świecie sztucznej inteligencji w 2024 roku.
Zrozumienie korzyści płynących z ekstremalnej gęstości pamięci masowej
Dyski SSD QLC firmy Solidigm o pojemności 61.44 TB wyróżniają się imponującą pojemnością, umożliwiając centrom danych umieszczenie większej ilości danych na mniejszej liczbie dysków. Ta ekstremalna gęstość jest szczególnie korzystna w serwerach AI, gdzie zbiory danych rosną wykładniczo, a wydajne rozwiązania pamięci masowej mają kluczowe znaczenie. Dzięki tym dyskom SSD o dużej pojemności centra danych mogą zmniejszyć liczbę dysków fizycznych, zajmowaną powierzchnię, zużycie energii i uprościć konserwację.
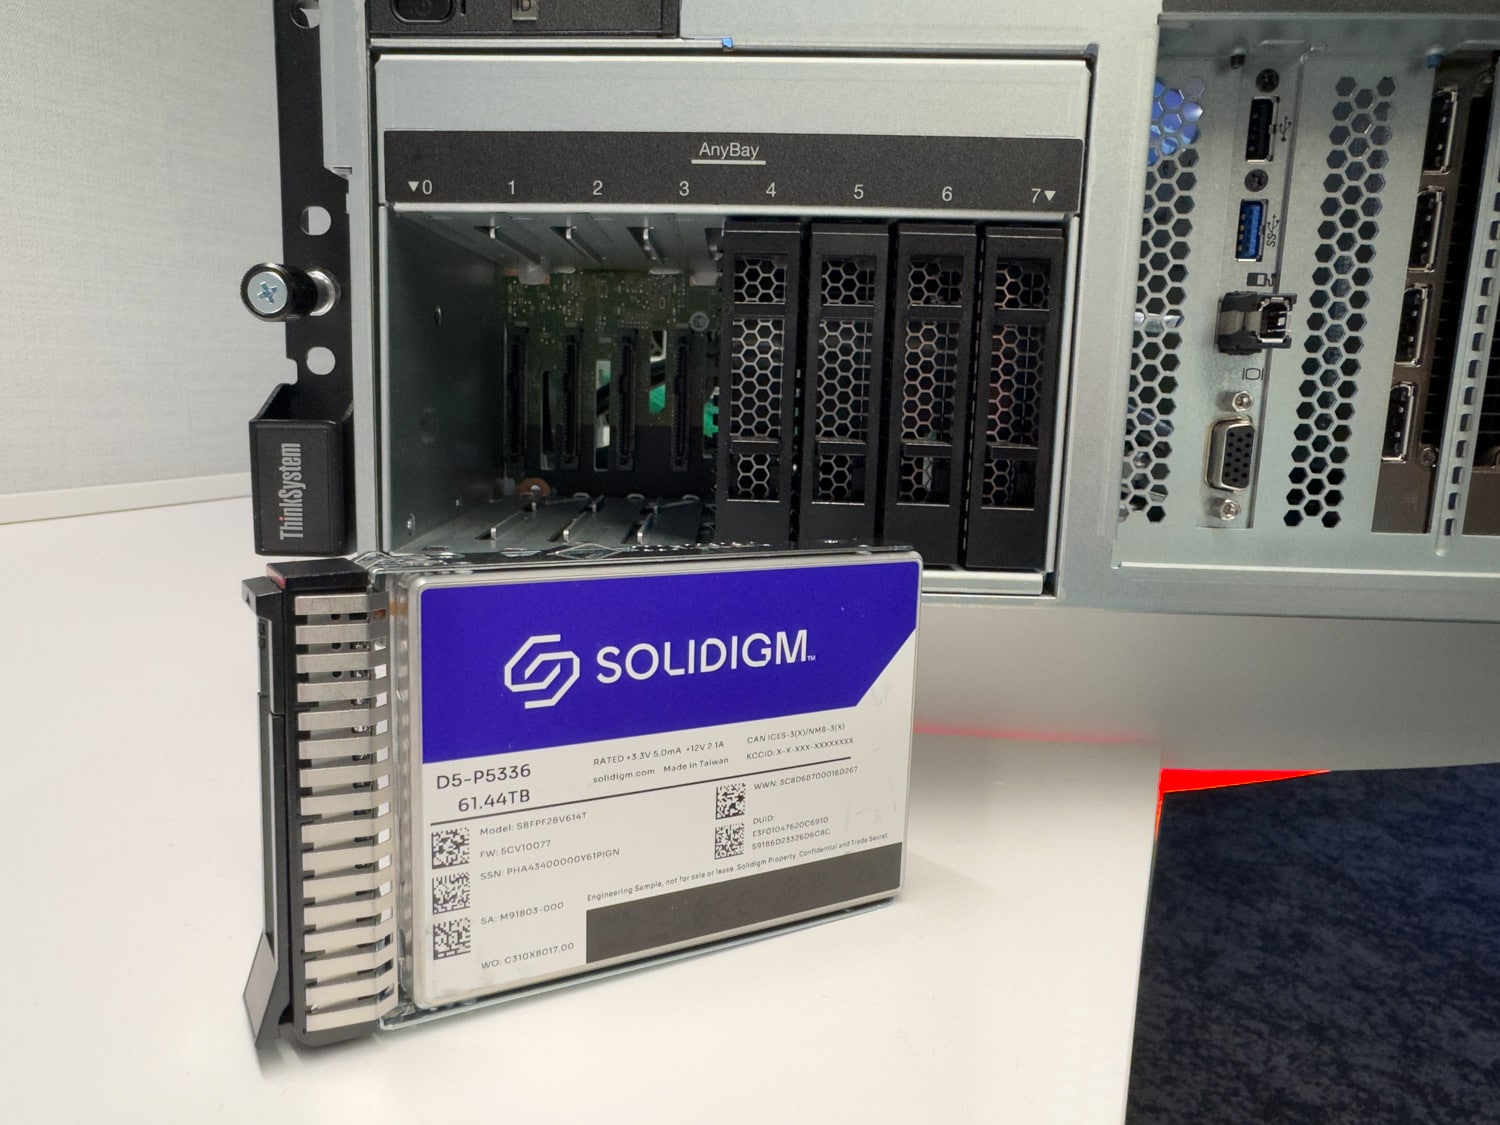
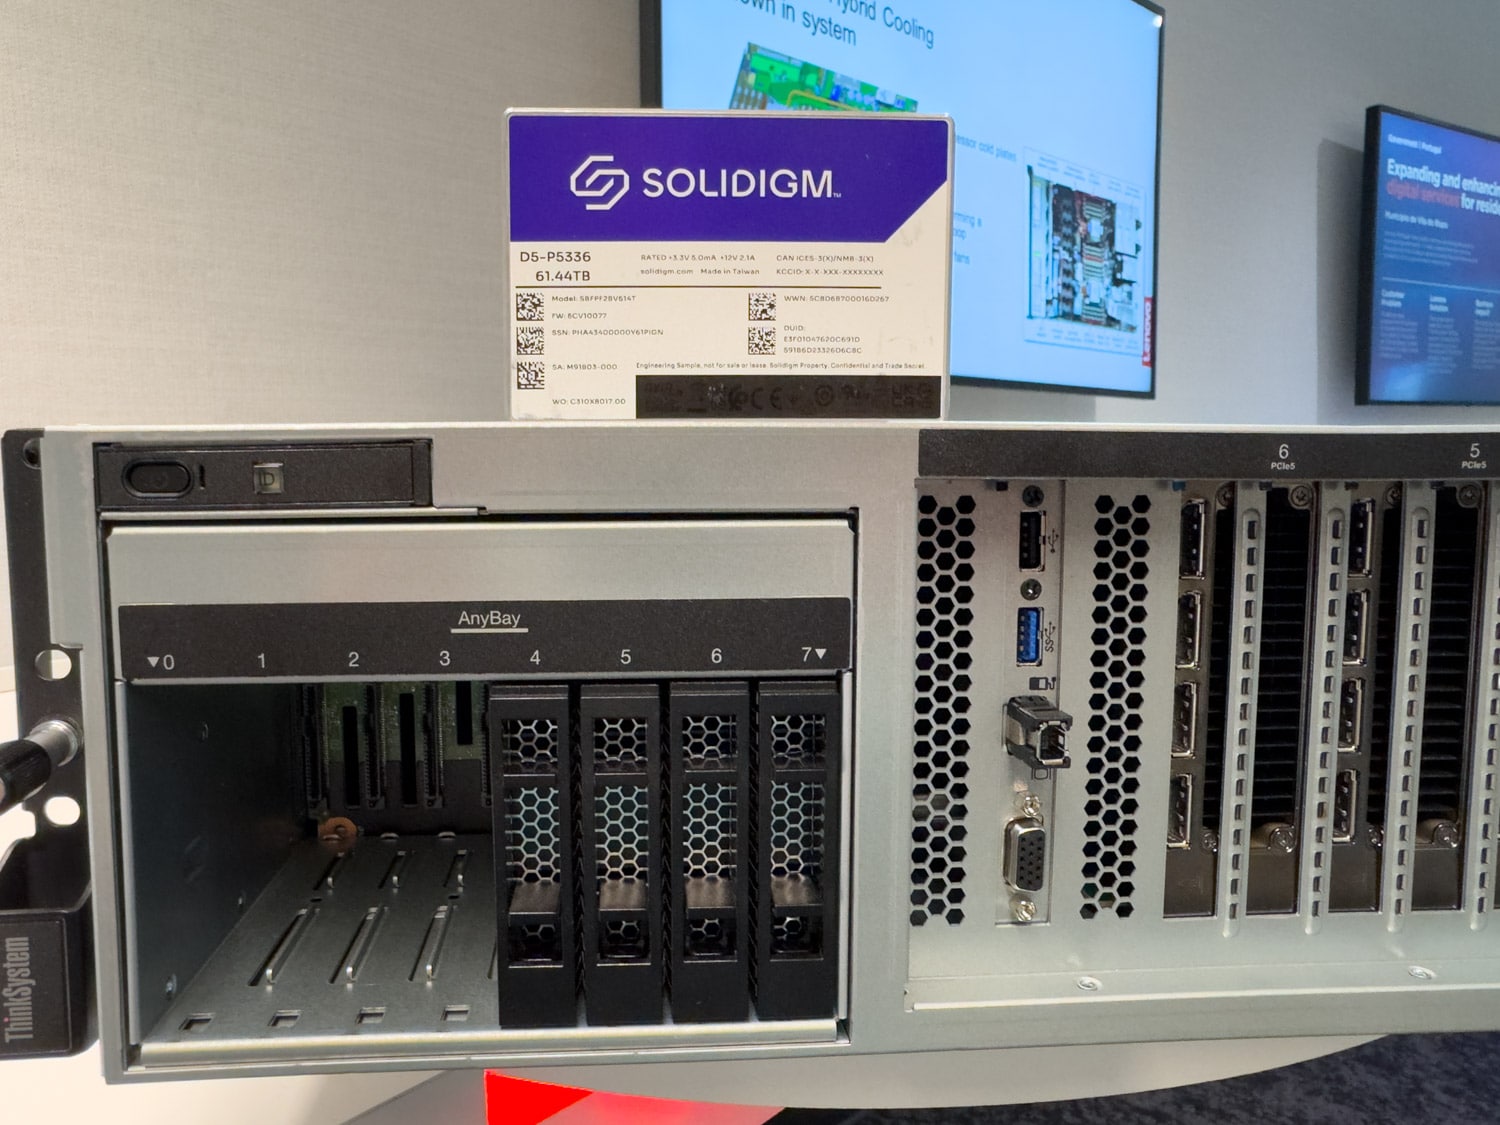
Widok z przodu Lenovo ThinkSystem SR675 V3 z dyskiem SSD Solidigm
Ograniczona liczba linii PCIe w serwerach GPU
Jednym z głównych wyzwań w nowoczesnych serwerach GPU jest ograniczona liczba dostępnych linii PCIe po tym, jak GPU otrzymają swoją część. Procesory GPU, kluczowe dla obciążeń AI, wymagają znacznej przepustowości PCIe, co często pozostawia ograniczone linie dla innych komponentów, w tym urządzeń pamięci masowej i sieci. To ograniczenie sprawia, że optymalizacja wykorzystania dostępnych linii PCIe jest niezbędna. Dyski SSD QLC firmy Solidigm o pojemności 61.44 TB oferują rozwiązanie, zapewniając ogromną pojemność pamięci masowej w jednym dysku, zmniejszając potrzebę stosowania wielu dysków i oszczędzając linie PCIe dla GPU i innych niezbędnych komponentów.
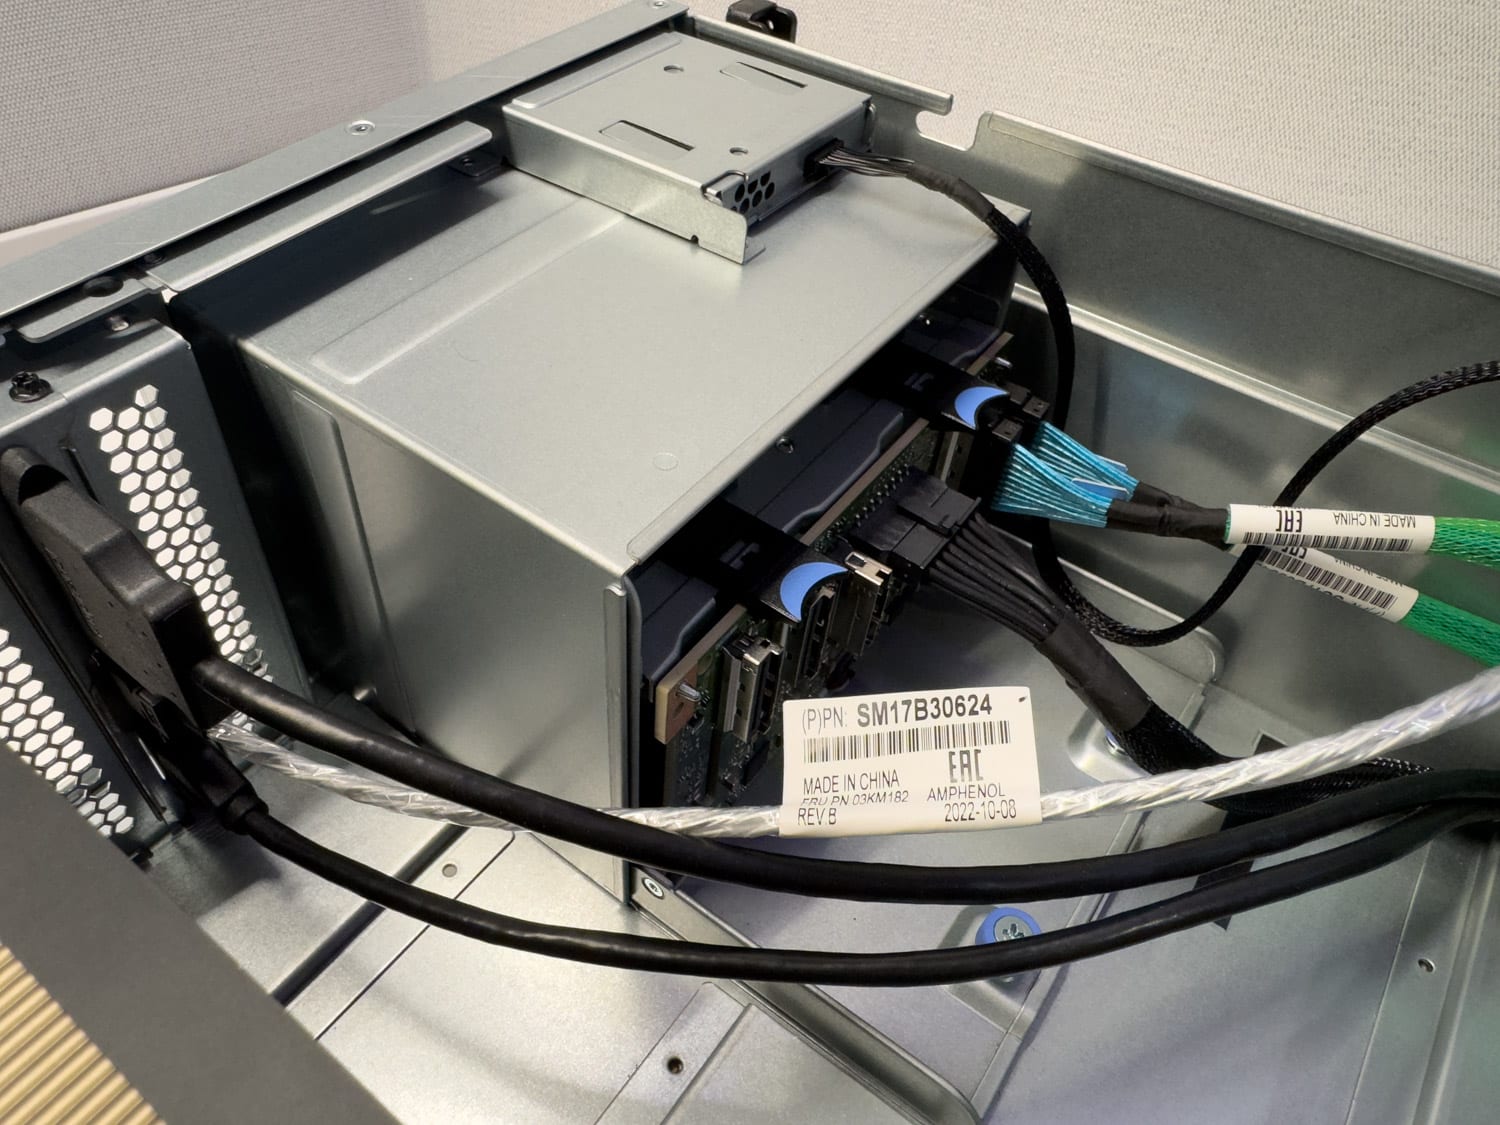
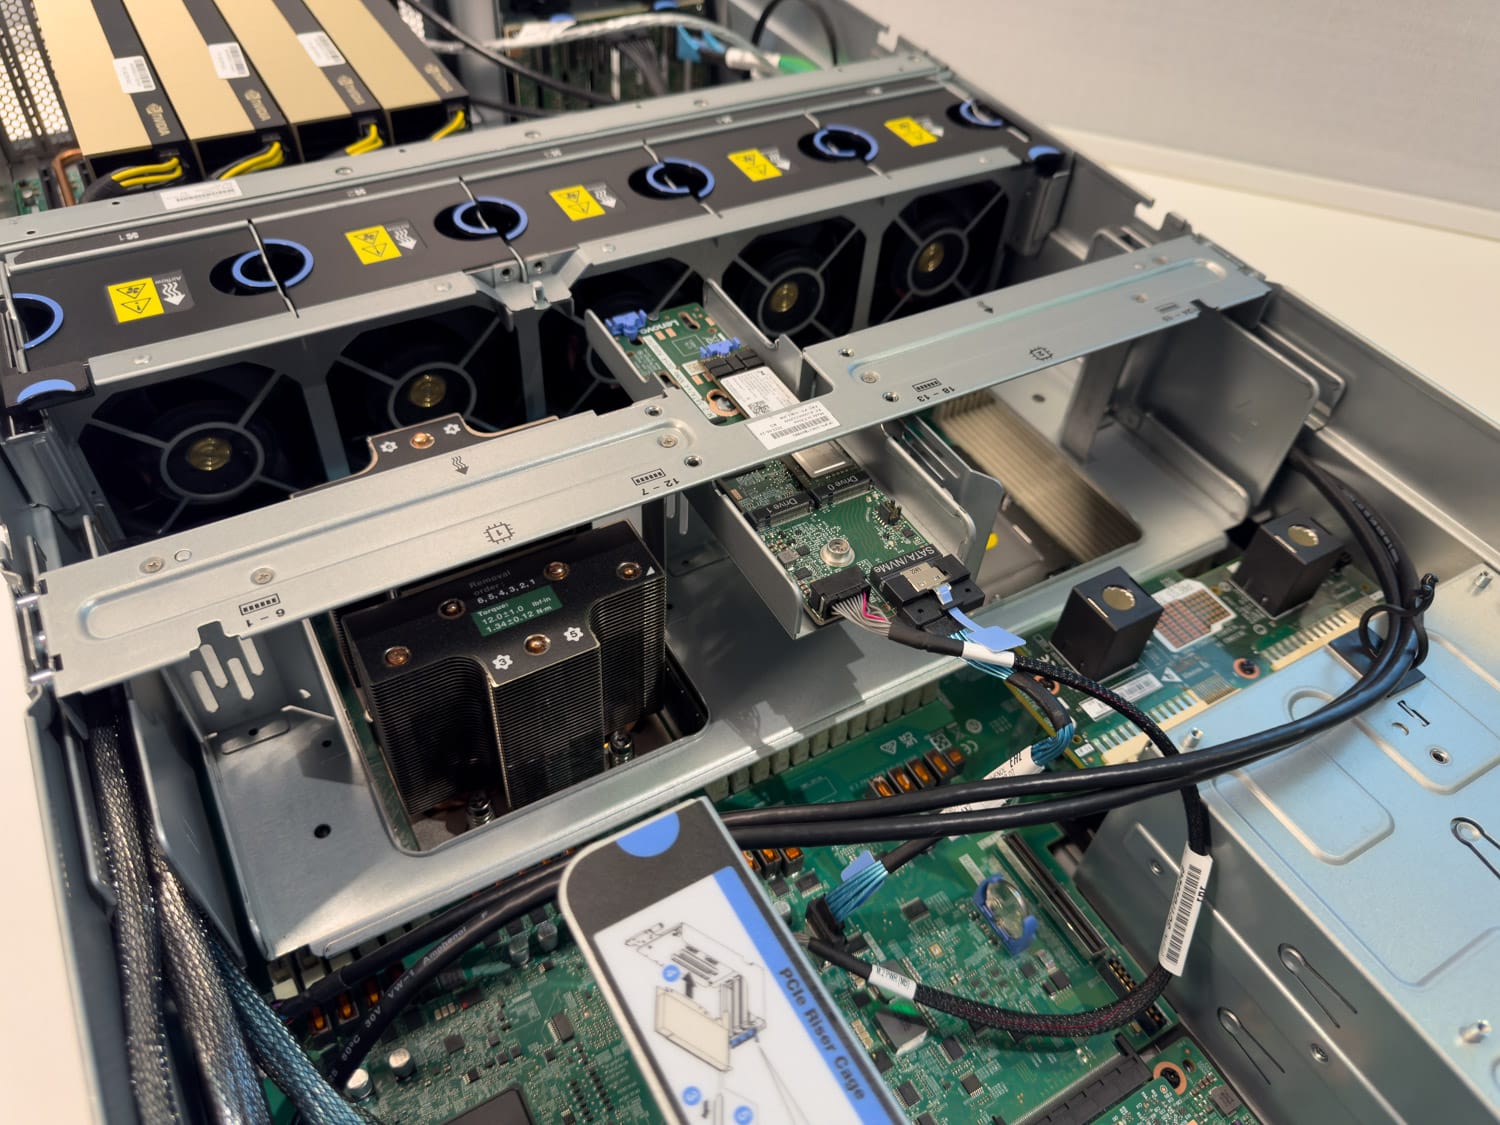
Widok wnętrza obudowy dysku Lenovo ThinkSystem SR675 V3 od góry
Obciążenia AI i wymagania dotyczące pamięci masowej
Obciążenia AI można ogólnie podzielić na trzy fazy: przygotowanie danych, trenowanie i dostrajanie oraz wnioskowanie. Każda faza ma unikalne wymagania dotyczące pamięci masowej, a dyski SSD o dużej pojemności firmy Solidigm mogą znacząco poprawić wydajność i efektywność na każdym z tych etapów. Wdrożenie dysków QLC o dużej pojemności, takich jak Solidigm D5-P5336, przynosi korzyści wszystkim obciążeniom AI. Większość korzyści dotyczy zarówno przygotowywania danych, trenowania i dostrajania, jak i wnioskowania.
Przygotowywanie danych
Przygotowanie danych stanowi fundament każdego projektu AI i obejmuje gromadzenie, czyszczenie, transformację i rozbudowę danych. Ten etap wymaga dużej ilości miejsca na dane, ponieważ zbiory surowych danych mogą być ogromne. Dyski SSD QLC Solidigm o pojemności 61.44 TB mogą przechowywać rozległe dane surowe bez obniżania wydajności. Co więcej, wysokie prędkości sekwencyjnego odczytu i zapisu tych dysków SSD zapewniają szybki dostęp do danych, przyspieszając proces przygotowania. W zakresie przygotowania danych dyski SSD QLC Soidigm o pojemności 61.44 TB spełniają wszystkie powyższe wymagania, oferując takie korzyści, jak:
- Ogromna pojemność pamięci masowej: Efektywne przetwarzanie dużych zbiorów danych.
- Wysokie prędkości sekwencyjne: Szybki dostęp do danych i ich przetwarzanie.
- Zmniejszone opóźnienie: Zminimalizowanie opóźnień w pobieraniu danych, co zwiększa wydajność przepływu pracy.
Szkolenia i dostrajanie
Trenowanie modeli AI to intensywny proces, który polega na wprowadzaniu rozległych zbiorów danych do sieci neuronowych w celu dostosowania wag i odchyleń. Ta faza jest wymagająca obliczeniowo i wymaga wysokiej liczby operacji wejścia/wyjścia na sekundę (IOPS) oraz pamięci masowej o niskim opóźnieniu, aby nadążyć za szybką wymianą danych między pamięcią masową a procesorami graficznymi. Dyski SSD firmy Solidigm wyróżniają się pod tym względem, oferując wysoką wydajność i trwałość. Ekstremalna gęstość tych dysków SSD pozwala na wykorzystanie bardziej rozbudowanych zbiorów danych w treningu, co potencjalnie prowadzi do tworzenia dokładniejszych modeli. Aby sprostać wymaganiom dotyczącym treningu i precyzyjnego dostrajania, dyski SSD Solidigm oferują następujące funkcje:
- Wysokie IOPS: Obsługuje szybką wymianę danych niezbędną do szkoleń.
- Trwałość: Technologia QLC zoptymalizowana pod kątem obciążeń wymagających dużej liczby operacji odczytu/zapisu, idealna do powtarzających się cykli szkoleniowych.
- Skalowalność: Rozszerz pamięć masową bez konieczności dodawania dysków fizycznych, zachowując efektywne wykorzystanie linii PCIe.
Wnioskowanie
Po przeszkoleniu modele sztucznej inteligencji są wdrażane w celu formułowania prognoz lub podejmowania decyzji w oparciu o nowe dane, co nazywa się wnioskowaniem. Ta faza często wymaga szybkiego dostępu do wstępnie przetworzonych danych i efektywnej obsługi zwiększonej liczby żądań odczytu. Dyski SSD Solidigm QLC o pojemności 61.44 TB zapewniają niezbędną wydajność odczytu i niskie opóźnienia, gwarantując płynne i szybkie wykonywanie operacji wnioskowania. Dyski SSD Solidigm przewyższają je pod względem wydajności i niskich opóźnień, oferując następujące korzyści:
- Szybka wydajność odczytu: Zapewnia szybki dostęp do danych w celu wyciągania wniosków w czasie rzeczywistym.
- Małe opóźnienia: Istotne dla aplikacji wymagających natychmiastowej reakcji.
- Wysoka pojemność: Efektywne przechowywanie obszernych danych wnioskowania i wyników historycznych.
Technologia QLC oferuje znaczące korzyści dla aplikacji wnioskowania, w tym dużą pojemność pamięci masowej, opłacalność, dużą prędkość odczytu, efektywne wykorzystanie PCIe, trwałość i usprawniony przepływ pracy. Te zalety łącznie zwiększają wydajność, skalowalność i opłacalność zadań wnioskowania, czyniąc dyski QLC idealnym wyborem dla nowoczesnych wdrożeń sztucznej inteligencji i uczenia maszynowego.
Dlaczego ważne jest, aby umieścić dużą pamięć masową jak najbliżej procesora graficznego?
W przypadku sztucznej inteligencji i uczenia maszynowego bliskość pamięci masowej do procesora graficznego (GPU) może znacząco wpłynąć na wydajność. Projektowanie centrum danych AI wymaga starannego rozważenia wielu czynników, aby zapewnić optymalną funkcjonalność i wydajność. Dlatego kluczowe jest posiadanie rozbudowanej pamięci masowej, zlokalizowanej jak najbliżej procesora graficznego (GPU). Jak niedawno analizowaliśmy, dostęp do rozbudowanego rozwiązania pamięci masowej podłączonej do sieci (NAS) zaczyna stawać się narzędziem „wszystko w jednym”, ale poleganie wyłącznie na nim może nie zawsze być optymalnym wyborem.
Opóźnienie i przepustowość
Głównym powodem umieszczania dużej pamięci masowej blisko GPU jest minimalizacja opóźnień i maksymalizacja przepustowości. Obciążenia AI, szczególnie podczas treningu, wymagają częstego i masowego transferu danych między pamięcią masową a GPU. Wysokie opóźnienia mogą ograniczać cały proces, wydłużając czas treningu i obniżając wydajność.
W obciążeniach AI, gdzie szybka dostępność danych ma kluczowe znaczenie, niskie opóźnienia zapewniają szybkie otrzymywanie danych przez procesory graficzne (GPU), co skraca czas przestoju i zwiększa ogólną wydajność obliczeniową. W fazie szkolenia, ogromne ilości danych muszą być stale przesyłane do procesora graficznego (GPU) w celu przetworzenia. Minimalizując opóźnienia, DAS zapewnia spełnienie wymagań aplikacji AI dotyczących dużej szybkości, co przekłada się na krótszy czas szkolenia i bardziej wydajne przepływy pracy.
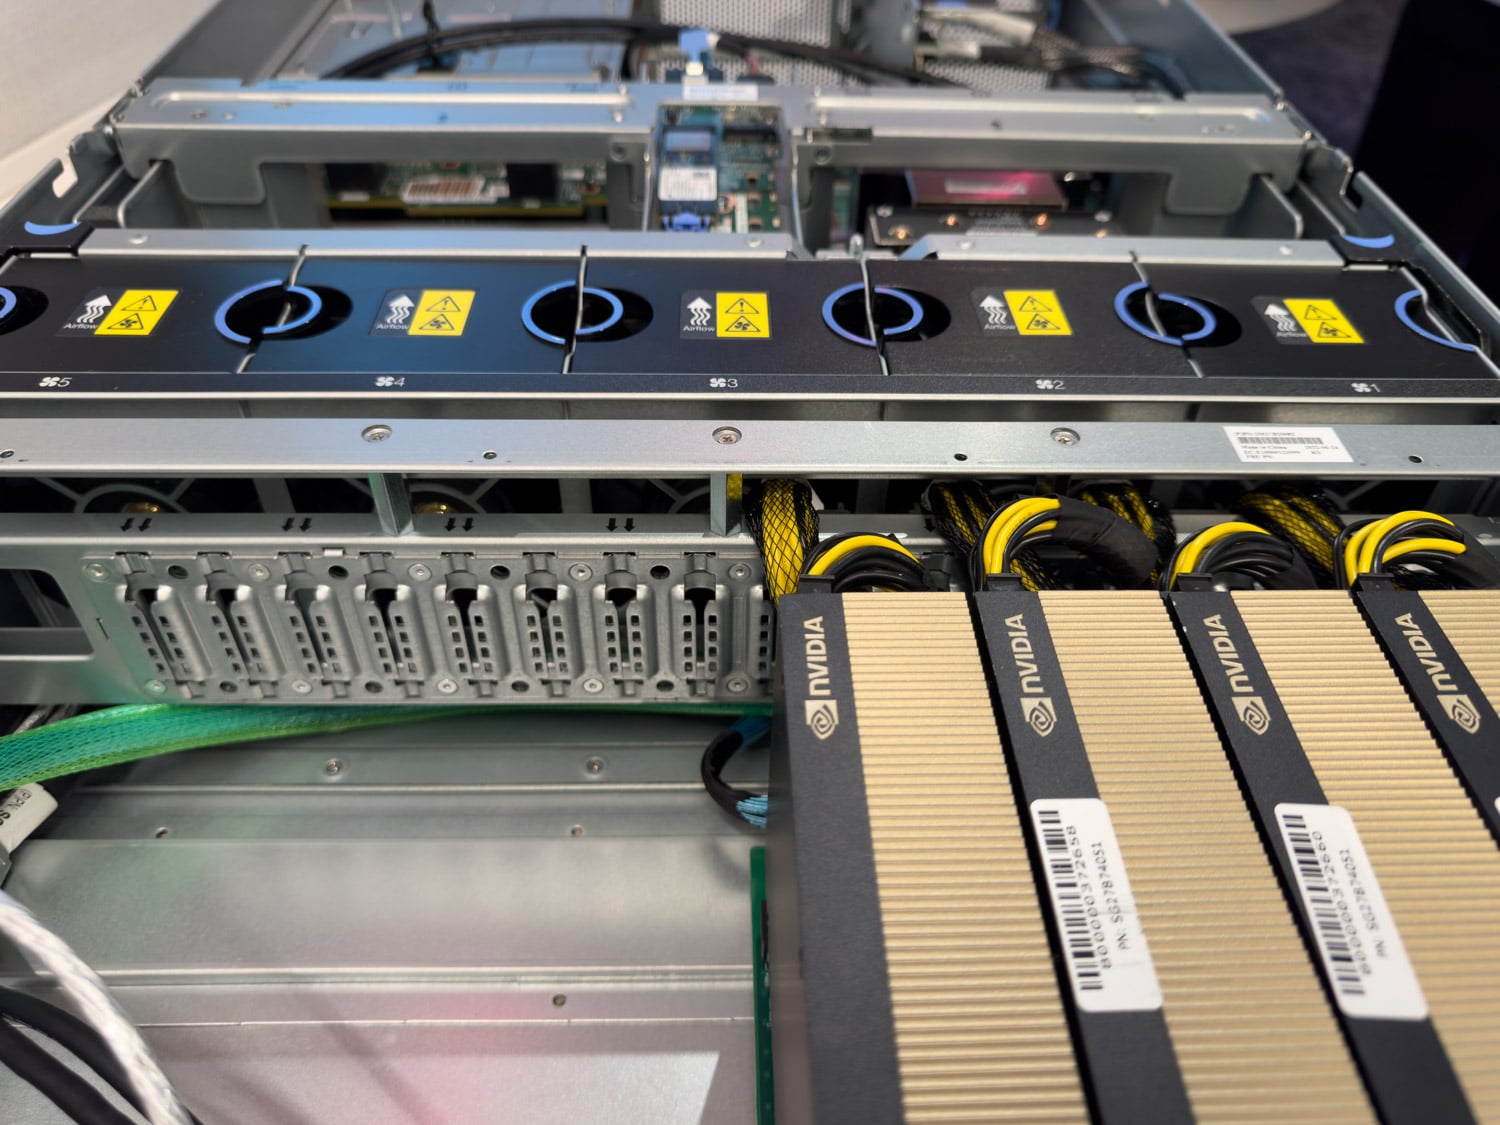
Widok wnętrza Lenovo ThinkSystem SR675 V3, zobacz GPU
Przepustowość danych i wydajność wejścia/wyjścia
Lokalne dyski SSD NVMe doskonale radzą sobie z obsługą dużej liczby operacji wejścia/wyjścia na sekundę (IOPS), co jest kluczowe dla obciążeń AI wymagających dużej intensywności odczytu i zapisu. W fazie szkolenia modele AI wymagają szybkiego dostępu do rozległych repozytoriów danych, co wymusza konieczność stosowania rozwiązań pamięci masowej, które będą w stanie sprostać wysokiemu zapotrzebowaniu na transakcje danych.
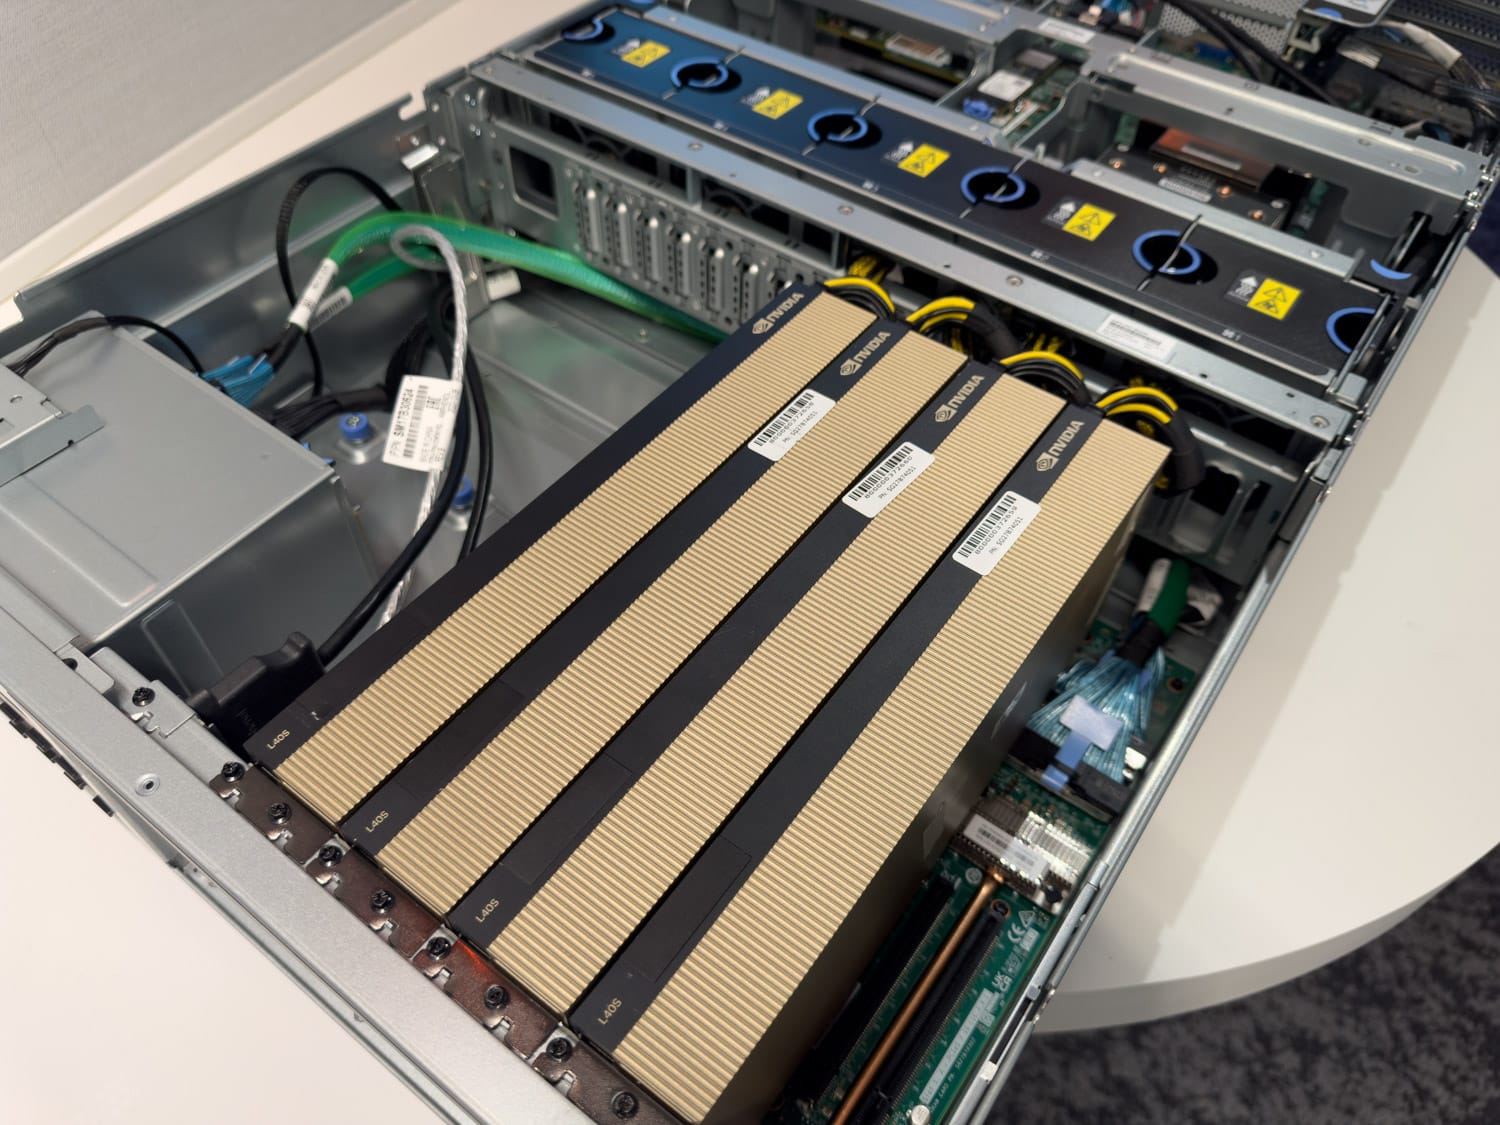
Widok z góry na procesory graficzne NVIDIA L40S
Dysk Solidigm D5-P5336, zaprojektowany z myślą o scenariuszach wymagających dużej pojemności i wysokiej wydajności, zapewnia wyjątkową wydajność IOPS, umożliwiając szybsze pobieranie i zapisywanie danych. Dzięki temu procesory graficzne (GPU) pozostają zajęte obliczeniami, a nie oczekiwaniem na dane, co maksymalizuje wydajność i skraca czas uczenia. Wysoka wydajność IOPS lokalnych dysków SSD NVMe sprawia, że idealnie nadają się one do wymagających środowisk aplikacji AI, gdzie szybki dostęp do danych i ich przetwarzanie są niezbędne dla optymalnej wydajności.
Zarządzanie danymi
Chociaż w niektórych scenariuszach posiadanie dużej ilości pamięci masowej podłączonej bezpośrednio do GPU upraszcza zarządzanie danymi, dodaje to niezbędną warstwę zarządzania danymi do przechowywania danych na serwerze GPU. W idealnym świecie GPU jest zajęte przetwarzaniem danych, a CPU korzysta z sieci, aby zapisywać punkty kontrolne lub pobierać nowe dane. Dyski Solidigm o pojemności 61.44 TB pomagają zmniejszyć liczbę potrzebnych transakcji danych. Można to również uwzględnić, stosując uproszczoną konfigurację sieci i rozproszone systemy plików. To proste podejście może usprawnić przepływy pracy i zmniejszyć ryzyko błędów lub opóźnień związanych z danymi.
Widok z przodu Lenovo ThinkSystem SR675 V3
Załóżmy, że pracujesz na jednym serwerze, dostrajając modele, które mieszczą się w kilku lokalnie podłączonych procesorach graficznych. W takim przypadku masz przewagę lokalnej pamięci masowej, którą łatwiej skonfigurować i zarządzać niż sieciowymi rozwiązaniami pamięci masowej. Konfigurowanie, administrowanie i konserwacja sieciowej pamięci masowej może być skomplikowane i czasochłonne, często wymagając specjalistycznej wiedzy i dodatkowej infrastruktury. Z kolei lokalne rozwiązania pamięci masowej, takie jak dyski SSD NVMe, są łatwiejsze do zintegrowania z istniejącymi konfiguracjami serwerów.
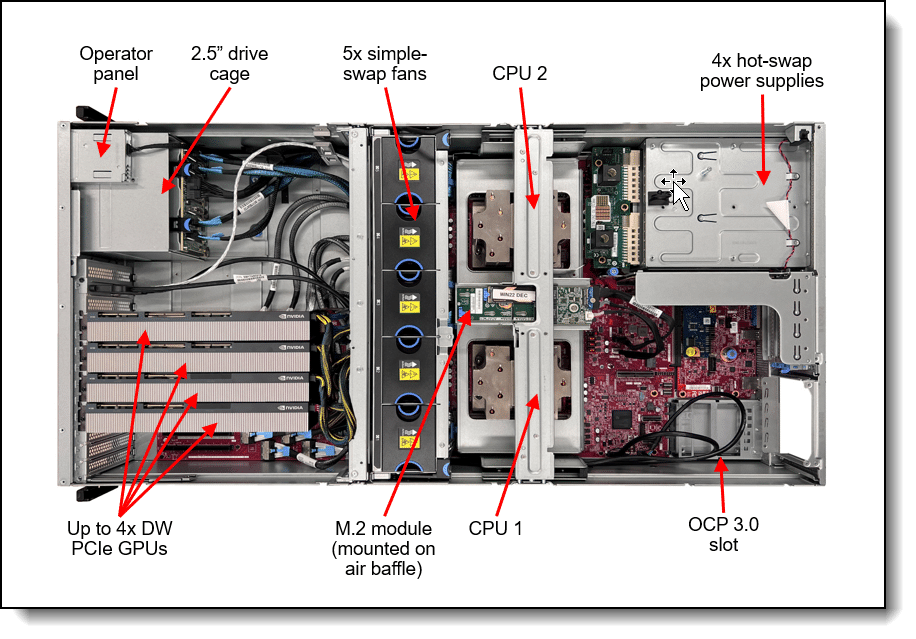
Schemat Lenovo ThinkSystem SR675 V3
Ta prostota konfiguracji i konserwacji pozwala zespołom IT skupić się bardziej na optymalizacji obciążeń AI, niż na skomplikowanych kwestiach zarządzania sieciową pamięcią masową. W rezultacie wdrażanie i zarządzanie pamięcią masową dla aplikacji AI staje się prostsze i bardziej wydajne dzięki lokalnym dyskom SSD NVMe.
Koszt i skalowalność
Rozwiązania NAS można skalować poziomo poprzez dodawanie kolejnych urządzeń pamięci masowej, ale wiążą się one również z kosztami związanymi z infrastrukturą sieciową i potencjalnymi wąskimi gardłami wydajności. Z kolei inwestycja w lokalną pamięć masową o dużej pojemności może przynieść natychmiastowe korzyści w zakresie wydajności bez konieczności przeprowadzania rozległych modernizacji sieci.
Lokalne rozwiązania pamięci masowej są często bardziej ekonomiczne niż sieciowe systemy pamięci masowej (NAS), ponieważ eliminują potrzebę stosowania drogiego sprzętu sieciowego i skomplikowanych konfiguracji. Konfiguracja i utrzymanie NAS wiąże się ze znacznymi inwestycjami w sprzęt sieciowy, taki jak szybkie przełączniki i routery, a także z ciągłymi kosztami zarządzania i konserwacji sieci.
Lokalne dyski SSD o dużej pojemności, zintegrowane bezpośrednio z serwerem, służą jako obszar przejściowy, zmniejszając potrzebę dodatkowej infrastruktury. Ta bezpośrednia integracja obniża koszty sprzętu i upraszcza proces konfiguracji, czyniąc go bardziej przyjaznym dla budżetu organizacji, które chcą zoptymalizować swoje obciążenia AI bez ponoszenia wysokich kosztów.
Aby dokładnie ocenić wydajność dysków SSD Solidigm QLC o pojemności 61.44 TB w konfiguracji serwera AI, przeprowadzimy testy porównawcze czterech dysków SSD Solidigm P5336 o pojemności 61.44 TB zainstalowanych w systemie Lenovo ThinkSystem SR675 V3. Ta konfiguracja serwera obejmuje również zestaw czterech procesorów graficznych NVIDIA L40S. Narzędziem testowym użytym w tym celu jest GDSIO, specjalistyczne narzędzie przeznaczone do pomiaru wydajności pamięci masowej w środowiskach pamięci masowej z bezpośrednim dostępem do GPU (GDS). Przeanalizowaliśmy dwie konfiguracje: wydajność jednego procesora graficznego dla jednego dysku oraz wydajność jednego procesora graficznego dla czterech dysków skonfigurowanych w RAID0.
Widok z góry na Lenovo ThinkSystem SR675 V3 z czterema procesorami graficznymi L40S
Zostań z nami. W kolejnych sekcjach omówimy specyfikę testów i sposób, w jaki odzwierciedlają one różne etapy procesu AI.
Parametry testowe
Proces benchmarkingu obejmuje różne parametry testowe, które symulują różne etapy procesu AI. Parametry te obejmują io_sizes, threads i transfer_type, z których każdy dobierany jest w celu reprezentowania konkretnych aspektów obciążeń AI.
1. Rozmiary IO:
- 4K, 128K, 256K, 512K, 1M, 4M, 16M, 64M, 128M: Te zróżnicowane rozmiary wejść/wyjść pomagają symulować różne wzorce transferu danych. Mniejsze rozmiary wejść/wyjść (128 KB, 256 KB, 512 KB) odzwierciedlają scenariusze, w których często uzyskuje się dostęp do małych fragmentów danych, co jest typowe na etapach przygotowywania danych. Większe rozmiary wejść/wyjść (1 MB, 4 MB, 16 MB, 64 MB, 128 MB) reprezentują masowe transfery danych, często występujące na etapach szkolenia i wnioskowania, gdzie przenoszone są całe partie danych.
2. Wątki:
- 1, 4, 16, 32: Liczba wątków reprezentuje poziom współbieżności dostępu do danych. Pojedynczy wątek testuje wydajność bazową, podczas gdy większa liczba wątków (4, 16, 32) symuluje bardziej intensywne, równoległe przetwarzanie danych, podobne do tego, które ma miejsce podczas sesji szkoleniowych na dużą skalę, gdzie wiele strumieni danych jest obsługiwanych jednocześnie.
3. Typy transferów:
- Pamięć masowa->GPU (GDS): Ten typ transferu wykorzystuje technologię GPU Direct Storage (GDS), umożliwiając bezpośredni transfer danych między dyskami SSD a procesorami graficznymi, z pominięciem procesora głównego. Ta konfiguracja idealnie nadaje się do testowania wydajności bezpośrednich ścieżek danych i minimalizacji opóźnień, co odzwierciedla scenariusze wnioskowania w czasie rzeczywistym.
- Pamięć masowa->CPU->GPU: Ta tradycyjna ścieżka transferu danych polega na przeniesieniu danych z pamięci masowej do procesora przed przesłaniem ich do procesora graficznego (GPU). Ta metoda symuluje scenariusze, w których przetwarzanie pośrednie lub buforowanie może odbywać się na poziomie procesora, co jest oczekiwane w fazie przygotowywania danych. Można argumentować, że ta ścieżka danych odzwierciedlałaby wydajność niezależnie od producenta procesora graficznego (GPU).
- Pamięć masowa->PAGE_CACHE->CPU->GPU: Ta ścieżka wykorzystuje pamięć podręczną stron do transferu danych, gdzie dane są najpierw buforowane w pamięci, a następnie przetwarzane przez procesor, a następnie przesyłane do procesora graficznego (GPU). Ta konfiguracja jest przydatna do testowania wpływu mechanizmów buforowania i przepustowości pamięci na ogólną wydajność, co jest istotne podczas szkolenia, gdy dane mogą być wstępnie przetwarzane i buforowane w celu zwiększenia wydajności. Można by argumentować, że ta ścieżka danych odzwierciedlałaby wydajność niezależnie od producenta procesora graficznego (GPU).
Naśladowanie etapów procesu AI
Testy porównawcze mają odzwierciedlać różne etapy procesu sztucznej inteligencji, gwarantując, że uzyskane wskaźniki wydajności są istotne i kompleksowe.
Przygotowywanie danych:
- Rozmiary IO: Mniejsze (128 KB, 256 KB, 512 KB)
- Wątki: 1, 4
- Rodzaje transferów: „Pamięć masowa->CPU->GPU”, „Pamięć masowa->PAGE_CACHE->CPU->GPU”
- Cel: Oceń, w jaki sposób dyski SSD radzą sobie z częstymi, niewielkimi transferami danych i obciążeniem procesora, co ma krytyczne znaczenie podczas faz pobierania, czyszczenia i rozszerzania danych.
Szkolenie i dostrajanie:
- Rozmiary IO: Średnie do dużych (1M, 4M, 16M)
- Wątki: 4, 16, 32
- Rodzaje transferów: „Pamięć masowa->GPU (GDS)”, „Pamięć masowa->CPU->GPU”
- Cel: Oceń wydajność w warunkach dużej przepustowości danych z wieloma równoczesnymi strumieniami danych, odzwierciedlającymi intensywną obróbkę danych wymaganą podczas trenowania i dostrajania modelu.
Wnioskowanie:
- Rozmiary IO: Duży do bardzo dużego (16M, 64M, 128M) i 4K
- Wątki: 1, 4, 16
- Rodzaje transferów: Pamięć masowa->GPU (GDS)
- Cel: Zmierz wydajność bezpośrednich, masowych transferów danych do GPU, co ma kluczowe znaczenie dla aplikacji wnioskowania w czasie rzeczywistym, w których priorytetem jest szybki dostęp do danych i minimalne opóźnienie. Technologia 4K została zaprojektowana z myślą o śledzeniu przeszukiwań bazy danych RAG.
Zmieniając te parametry i testując różne konfiguracje, możemy uzyskać szczegółowy profil wydajności dysków SSD Solidigm QLC o pojemności 61.44 TB w środowisku serwerów AI o wysokiej wydajności, dostarczając informacji na temat ich przydatności i optymalizacji pod kątem różnych obciążeń AI. Przeanalizowaliśmy dane, przeprowadzając ponad 1200 testów w ciągu kilku tygodni.
Konfiguracja serwera
- Lenovo ThinkSystem SR675 V3
- Procesor AMD EPYC 9254 24-rdzeniowy
- 6 x 64 GB DDR5, całkowita pojemność 384 GB
- 4X procesory graficzne NVIDIA L40S
- 4 dyski SSD Solidigm P5336 QLC NVMe o pojemności 61.44 TB
- Ubuntu Server 22.04
- Wersja sterownika NVIDIA: 535.171.04
- Wersja CUDA: 12.2
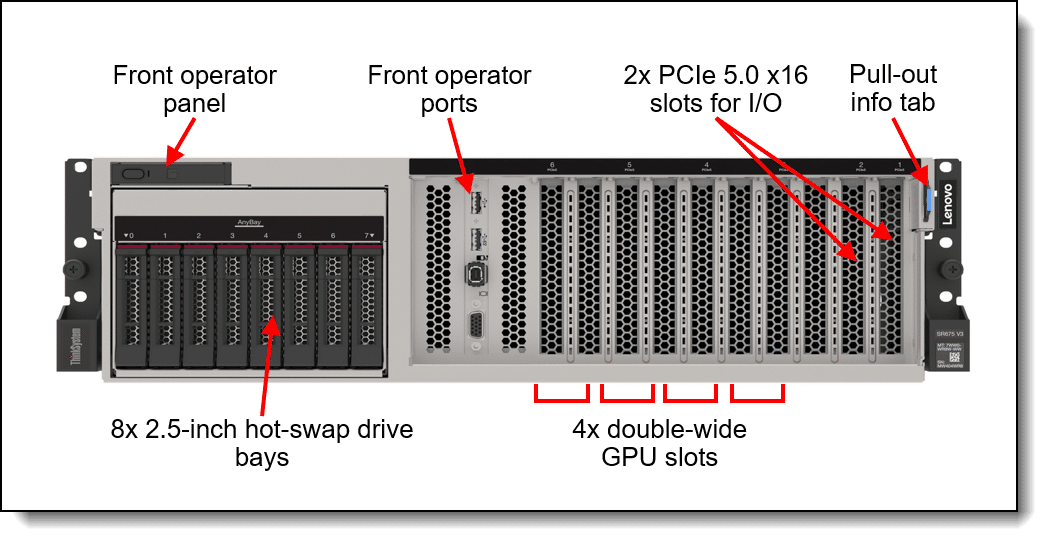
Lenovo ThinkSystem SR675 V3 widok z przodu
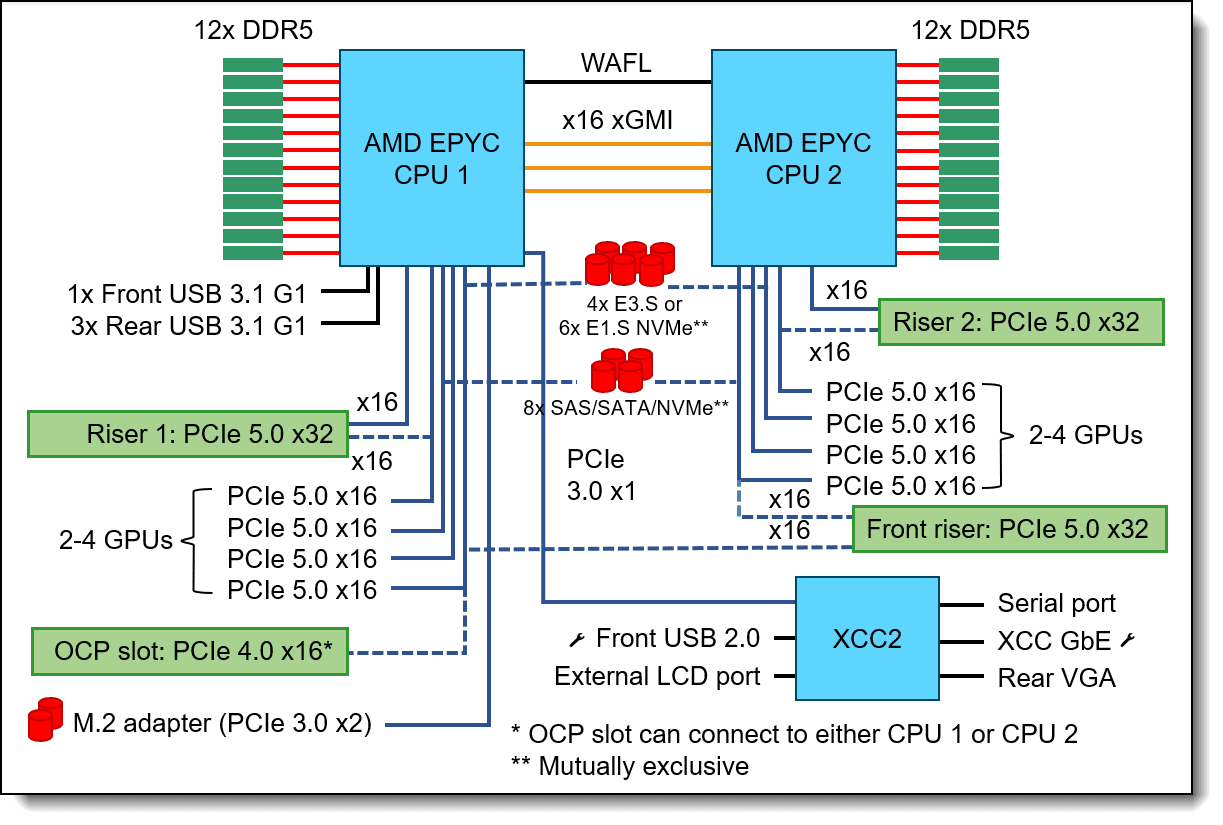
Architektura Lenovo ThinkSystem SR675 V3
Wyniki testu
Najpierw przyjrzyjmy się obciążeniom związanym z trenowaniem i wnioskowaniem. Rozmiar wejścia/wyjścia GPU Direct 1024 KB reprezentuje ładowanie modelu, ładowanie danych treningowych do GPU oraz inne duże zadania wnioskowania wsadowego, takie jak przetwarzanie obrazów czy wideo.
| 4Napęd | Typ we/wy | Rodzaj transferu | Threads | Rozmiar zestawu danych (KiB) | Rozmiar wejścia/wyjścia (KiB) | Przepustowość (GiB/s) | Średnie opóźnienie (usecs) |
|---|---|---|---|---|---|---|---|
| NAPISZ | GPUD | 8 | 777,375,744 | 1024 | 12.31 | 634.55 | |
| CZYTAĆ | GPUD | 8 | 579,439,616 | 1024 | 9.30 | 840.37 | |
| RANDWRITE | GPUD | 8 | 751,927,296 | 1024 | 12.04 | 648.67 | |
| ODCZYT RANDOWY | GPUD | 8 | 653,832,192 | 1024 | 10.50 | 743.89 |
Następnie przyjrzymy się mniejszym rozmiarom operacji wejścia/wyjścia, na przykład dla obciążeń typu RAG, w których szybki, losowy dostęp do danych 4k do bazy danych RAG przechowywanej na dysku. Wydajne, losowe operacje wejścia/wyjścia są niezbędne w scenariuszach, w których obciążenia inferencyjne muszą uzyskiwać dostęp do danych w sposób niesekwencyjny, na przykład w systemach rekomendacji lub aplikacjach wyszukiwawczych. Konfiguracja RAID0 charakteryzuje się dobrą wydajnością w przypadku operacji sekwencyjnych i losowych, co jest kluczowe dla aplikacji AI, które obejmują mieszankę wzorców dostępu, takich jak RAG. Wartości opóźnienia odczytu są wyjątkowo niskie, zwłaszcza w GPUD tryb.
Wybrano tutaj 8 wątków roboczych, które nie obciążają w pełni dysku SSD, ale zapewniają bardziej reprezentatywny obraz tego, co można zaobserwować w obciążeniu typu RAG. Zapewnia to kontekst gotowej aplikacji z perspektywy GPU, z ograniczoną liczbą przetworzonych wątków i większą głębokością kolejki. Warto zauważyć, że pokazuje to, iż istnieje jeszcze większa wydajność, którą można osiągnąć poprzez dalsze optymalizacje oprogramowania.
| 4Napęd | Typ we/wy | Rodzaj transferu | Threads | Rozmiar zestawu danych (KiB) | Rozmiar wejścia/wyjścia (KiB) | Przepustowość (GiB/s) | Średnie opóźnienie (usecs) |
|---|---|---|---|---|---|---|---|
| NAPISZ | GPUD | 8 | 69,929,336 | 4 | 1.12 | 27.32 | |
| CZYTAĆ | GPUD | 8 | 37,096,856 | 4 | 0.59 | 51.52 | |
| RANDWRITE | GPUD | 8 | 57,083,336 | 4 | 0.91 | 33.42 | |
| ODCZYT RANDOWY | GPUD | 8 | 27,226,364 | 4 | 0.44 | 70.07 |
Jeśli nie korzystasz z GPU Direct z powodu nieobsługiwanych bibliotek lub procesorów graficznych, oto dwa typy, jeśli wykorzystujesz procesor do transferu danych. W tym konkretnym serwerze, Lenovo ThinkSystem SR675 V3, ponieważ wszystkie urządzenia PCIe przechodzą przez główny układ procesora, mamy porównywalną przepustowość, ale odczuwamy spadek opóźnień. Możemy oczekiwać poprawy w systemie z przełącznikami PCIe.
| 4Napęd | Typ we/wy | Rodzaj transferu | Threads | Rozmiar zestawu danych (KiB) | Rozmiar wejścia/wyjścia (KiB) | Przepustowość (GiB/s) | Średnie opóźnienie (usecs) |
|---|---|---|---|---|---|---|---|
| NAPISZ | CPU_GPU | 8 | 767,126,528 | 1024 | 12.24 | 638.05 | |
| CZYTAĆ | CPU_GPU | 8 | 660,889,600 | 1024 | 10.58 | 738.75 | |
| RANDWRITE | CPU_GPU | 8 | 752,763,904 | 1024 | 12.02 | 649.76 | |
| ODCZYT RANDOWY | CPU_GPU | 8 | 656,329,728 | 1024 | 10.47 | 746.26 | |
| NAPISZ | CPU_GPU | 8 | 69,498,220 | 4 | 1.11 | 27.47 | |
| CZYTAĆ | CPU_GPU | 8 | 36,634,680 | 4 | 0.58 | 52.31 |
Tabela wskazuje na wysokie wskaźniki przepustowości dla operacji odczytu, szczególnie w przypadku GPUD typ transferu. Na przykład operacje odczytu w GPUD W trybie tym przepustowość sięga ponad 10.5 GiB/s. Jest to korzystne dla obciążeń AI, które często wymagają szybkiego dostępu do danych w celu trenowania dużych modeli.
Zrównoważona wydajność między operacjami losowymi i sekwencyjnymi sprawia, że ta konfiguracja nadaje się do zadań inferencyjnych, które często wymagają połączenia tych wzorców dostępu. Chociaż wartości opóźnień nie są ekstremalnie niskie, nadal mieszczą się w akceptowalnych granicach dla wielu aplikacji inferencyjnych.
Dodatkowo obserwujemy imponującą przepustowość, z operacjami zapisu sięgającymi 12.31 GiB/s i operacjami odczytu do 9.30 GiB/s. Ta wysoka przepustowość jest korzystna dla obciążeń AI wymagających szybkiego dostępu do danych w celu trenowania modeli i wnioskowania.
Odczyty sekwencyjne i optymalizacja
Przechodząc do rozmiaru wejścia/wyjścia 128M i przechodząc przez wątki robocze, możemy zobaczyć wynik optymalizacji obciążenia dla rozwiązania pamięci masowej.
| Rodzaj transferu | Threads | Przepustowość (GiB/s) | Opóźnienie (usec) |
|---|---|---|---|
| Pamięć masowa->CPU->GPU | 16 | 25.134916 | 79528.88255 |
| Pamięć masowa->CPU->GPU | 4 | 25.134903 | 19887.66948 |
| Pamięć masowa->CPU->GPU | 32 | 25.12613 | 159296.2804 |
| Pamięć masowa->GPU (GDS) | 4 | 25.057484 | 19946.07198 |
| Pamięć masowa->GPU (GDS) | 16 | 25.044871 | 79770.6007 |
| Pamięć masowa->GPU (GDS) | 32 | 25.031055 | 159478.8246 |
| Pamięć masowa->PAGE_CACHE->CPU->GPU | 16 | 24.493948 | 109958.4447 |
| Pamięć masowa->PAGE_CACHE->CPU->GPU | 32 | 24.126103 | 291792.8345 |
| Pamięć masowa->GPU (GDS) | 1 | 23.305366 | 5362.611458 |
| Pamięć masowa->PAGE_CACHE->CPU->GPU | 4 | 21.906704 | 22815.52797 |
| Pamięć masowa->CPU->GPU | 1 | 15.27233 | 8182.667969 |
| Pamięć masowa->PAGE_CACHE->CPU->GPU | 1 | 6.016992 | 20760.22778 |
Prawidłowe napisanie aplikacji, która będzie współpracować z pamięcią masową, jest kwestią priorytetową i musi zostać wzięte pod uwagę przez przedsiębiorstwa, które chcą zmaksymalizować swoje inwestycje w procesory GPU.
Bezpośrednio GPU
Dzięki wyodrębnieniu wydajności GPU Direct we wszystkich testach, możemy uzyskać ogólny pogląd na to, jak technologia NVIDIA się sprawdza.
| Typ we/wy | Rodzaj transferu | Threads | Rozmiar zestawu danych (KiB) | Rozmiar wejścia/wyjścia (KiB) | Przepustowość (GiB/s) | Średnie opóźnienie (usecs) |
|---|---|---|---|---|---|---|
| NAPISZ | GPUD | 8 | 777,375,744 | 1024 | 12.31 | 634.55 |
| CZYTAĆ | GPUD | 8 | 579,439,616 | 1024 | 9.30 | 840.37 |
| RANDWRITE | GPUD | 8 | 751,927,296 | 1024 | 12.04 | 648.67 |
| ODCZYT RANDOWY | GPUD | 8 | 653,832,192 | 1024 | 10.50 | 743.89 |
| NAPISZ | GPUD | 8 | 69,929,336 | 4 | 1.12 | 27.32 |
| CZYTAĆ | GPUD | 8 | 37,096,856 | 4 | 0.59 | 51.52 |
| RANDWRITE | GPUD | 8 | 8,522,752 | 4 | 0.14 | 224.05 |
| ODCZYT RANDOWY | GPUD | 8 | 21,161,116 | 4 | 0.34 | 89.99 |
| RANDWRITE | GPUD | 8 | 57,083,336 | 4 | 0.91 | 33.42 |
| ODCZYT RANDOWY | GPUD | 8 | 27,226,364 | 4 | 0.44 | 70.07 |
Myśli końcowe
Ponieważ niniejszy artykuł koncentruje się na dysku Solidigm P5336 o pojemności 61.44 TB, cofnijmy się o krok i omówmy debatę dotyczącą dysków TLC i QLC, dotyczącą wydajności i pojemności. Przyglądając się innym produktom z portfolio Solidigm, takim jak linia D7, wykorzystująca pamięć TLC 3D NAND, pojemność jest ograniczona kosztem wydajności. W naszych testach, a konkretnie w przypadku dysków Solidigm o pojemności 61.44 TB, obserwujemy łączną wydajność przepustowości, która pozwala na zasilanie procesorów graficznych danymi przy niskich opóźnieniach. Słyszymy opinie od producentów ODM i OEM o zapotrzebowaniu na coraz większą ilość pamięci masowej jak najbliżej procesora graficznego, a dysk Solidigm D5-P5336 wydaje się spełniać te wymagania. Ponieważ w serwerach GPU zazwyczaj dostępna jest ograniczona liczba zatok NVMe, gęste dyski Solidigm znajdują się na szczycie listy lokalnych pamięci masowych dla serwerów GPU.
Ostatecznie, ogromna pojemność pamięci masowej oferowana przez te dyski, wraz z procesorami graficznymi, to tylko część rozwiązania; muszą one nadal działać wydajnie. Po zsumowaniu wydajności pojedynczego dysku na kilka dysków, staje się jasne, że wystarczająca przepustowość jest dostępna nawet dla najbardziej wymagających zadań. W przypadku konfiguracji RAID0 z czterema dyskami i wykorzystaniem GDSIO, łączna przepustowość dla operacji zapisu może sięgać 12.31 GiB/s, a dla operacji odczytu – 25.13 GiB/s.
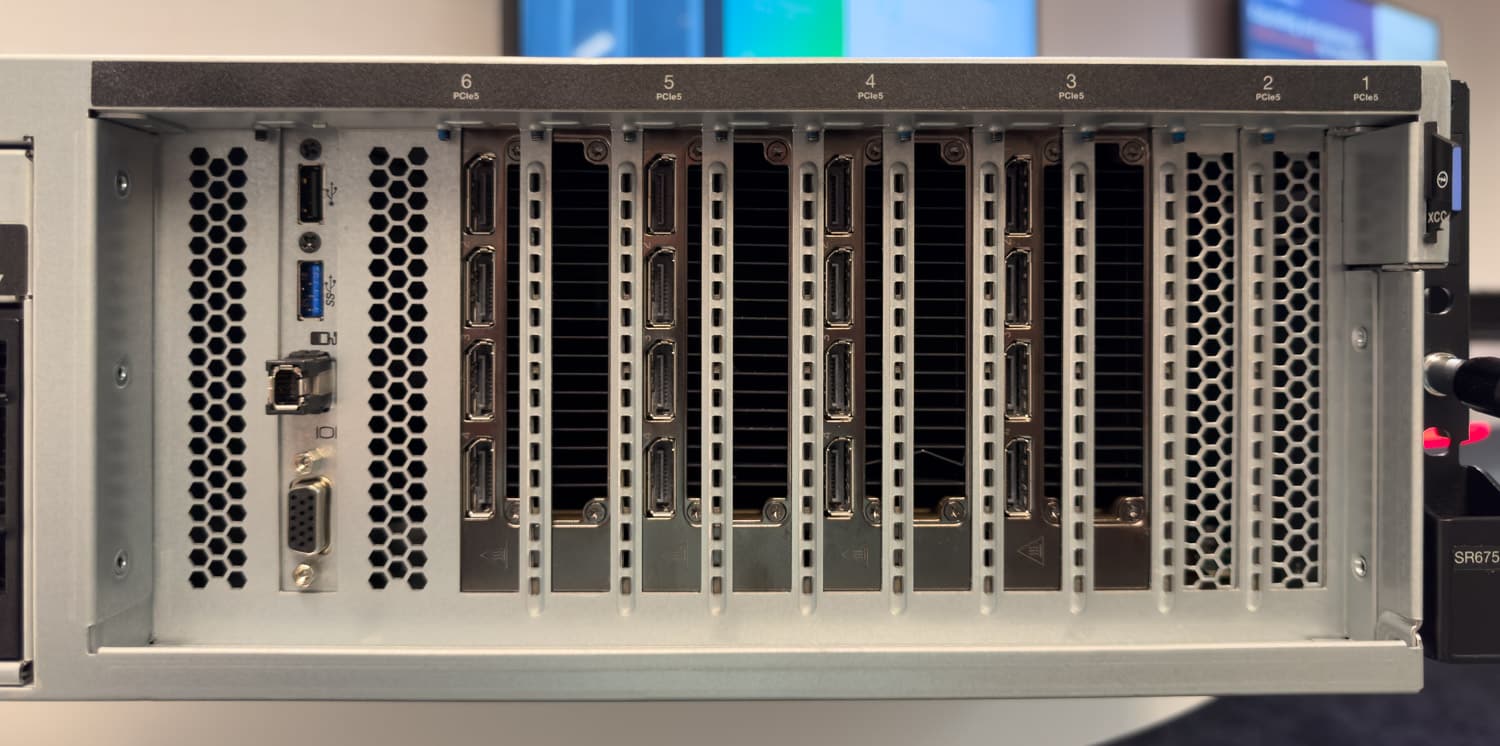
Lenovo ThinkSystem SR675 V3 – widok z tyłu dla kart graficznych
Ten poziom przepustowości jest więcej niż wystarczający nawet do najbardziej wymagających zadań AI, takich jak trenowanie dużych modeli głębokiego uczenia na ogromnych zbiorach danych czy wnioskowanie w czasie rzeczywistym na strumieniach wideo o wysokiej rozdzielczości. Możliwość skalowania wydajności poprzez dodawanie kolejnych dysków do macierzy RAID0 sprawia, że jest to atrakcyjny wybór dla aplikacji AI, w których szybki i wydajny dostęp do danych ma kluczowe znaczenie.
Należy jednak pamiętać, że konfiguracje RAID0, mimo że oferują wysoką wydajność, nie zapewniają redundancji danych. Dlatego kluczowe jest wdrożenie odpowiednich strategii tworzenia kopii zapasowych i ochrony danych, aby zapobiec ich utracie w przypadku awarii dysku.
Kolejnym wyjątkowym czynnikiem w dzisiejszych centrach danych jest zasilanie. Ponieważ serwery AI pobierają więcej energii niż kiedykolwiek wcześniej i nic nie wskazuje na to, że ten trend się utrzyma, całkowita dostępna moc stanowi jedno z największych wąskich gardeł dla tych, którzy chcą wprowadzić procesory graficzne (GPU) do swoich centrów danych. Oznacza to, że jeszcze bardziej koncentrujemy się na oszczędzaniu każdego możliwego wata. Jeśli uda się uzyskać więcej TB na wat, możemy zaobserwować interesujące procesy myślowe związane z całkowitym kosztem posiadania (TCO) i kosztami infrastruktury. Nawet usunięcie tych dysków z serwera GPU i umieszczenie ich w serwerze pamięci masowej o skali rackowej może zapewnić ogromną przepustowość przy ekstremalnych pojemnościach.
Integracja dysków SSD Solidigm D5-P5336 QLC o pojemności 61.44 TB z serwerami AI z ograniczoną liczbą gniazd NVMe stanowi znaczący postęp w rozwiązywaniu problemów z pamięcią masową współczesnych obciążeń AI. Ich ekstremalna gęstość, parametry wydajnościowe i stosunek TB/wat sprawiają, że idealnie nadają się do przygotowywania danych, trenowania i dostrajania, a także wnioskowania. Dzięki optymalizacji wykorzystania linii PCIe i zapewnieniu rozwiązań pamięci masowej o dużej pojemności, te dyski SSD pozwalają nowoczesnej fabryce AI skupić się na opracowywaniu i wdrażaniu bardziej zaawansowanych i dokładnych modeli, napędzając innowacje w obszarze AI.
Strona Lenovo ThinkSystem SR675 V3
Niniejszy raport jest sponsorowany przez firmę Solidigm. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej ocenie rozpatrywanego produktu/produktów.


 Amazon