

Nie jesteśmy nowicjuszami w przekraczaniu granic obliczeń, ale tym razem mierzymy się z Pi(e). Tuż po zeszłorocznym teście 100 bilionów cyfr, postanowiliśmy go podkręcić i rozszerzyć znane cyfry Pi do 105 bilionów cyfr. To 105 000 000 000 000 liczb po 3. Wprowadziliśmy kilka aktualizacji platformy w porównaniu z zeszłorocznym testem, odkryliśmy kilka zaskakujących rzeczy i nauczyliśmy się kilku nowych rzeczy – w tym 105 bilionowej cyfry Pi;6!
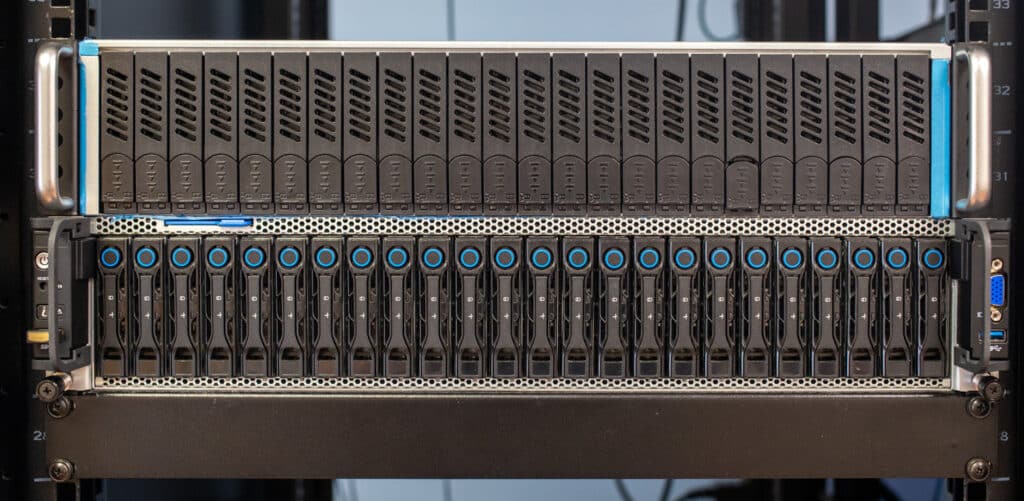
Osiągając rekord świata w obliczeniach liczby Pi do 105 bilionów cyfr, laboratorium StorageReview podkreśliło niesamowite możliwości współczesnego sprzętu. To przedsięwzięcie, napędzane najnowocześniejszym systemem 2P 128-rdzeniowym AMD EPYC Bergamo, wyposażonym w 1.5 TB pamięci DRAM i prawie petabajt dysków SSD Solidigm QLC, stanowi przełomowe osiągnięcie w dziedzinie technologii obliczeniowych i pamięci masowej.
Wyzwanie
W 100 bilionowym cyfrowym biegu napotkaliśmy kilka ograniczeń technologicznych. Na przykład platforma serwerowa obsługiwała tylko 16 dysków SSD NVMe w przednich slotach. Chociaż dysponowaliśmy dużą mocą obliczeniową, obliczenia te wymagały ogromnej ilości pamięci masowej w trakcie procesu i po stronie zaplecza, gdy generowany był końcowy plik TXT.
Aby rozwiązać problem z pamięcią masową, ostatnio skorzystaliśmy z adapterów PCIe NVME, aby zmieścić kolejne trzy dyski SSD. Następnie, jako wyjście, wykorzystaliśmy serwer pamięci masowej z dyskami twardymi w RAID0, z udostępnionym iSCSI, połączonym z serwerem obliczeniowym. Tym razem chcieliśmy nadać serwerowi nieco bardziej „korporacyjny” charakter, więc zaprosiliśmy do pomocy kilku znajomych. Co ciekawe, dodanie kilku dysków SSD NVMe do serwera nie jest tak proste, jak mogłoby się wydawać.
Sprzęt
Sercem tego monumentalnego zadania był dwuprocesorowy system AMD EPYC 9754 Bergamo, oferujący po 128 rdzeni każdy. Procesory AMD, znane z wyjątkowej wydajności w zadaniach obliczeniowych o wysokiej złożoności (AI, HPC, Big Data Analytics) , zapewniły niezbędną moc obliczeniową. Uzupełnieniem było 1.5 TB pamięci DRAM, zapewniającej szybkie przetwarzanie i transfer danych. Jednocześnie, prawie petabajt pamięci masowej Solidigm QLC oferował bezprecedensową pojemność i niezawodność.
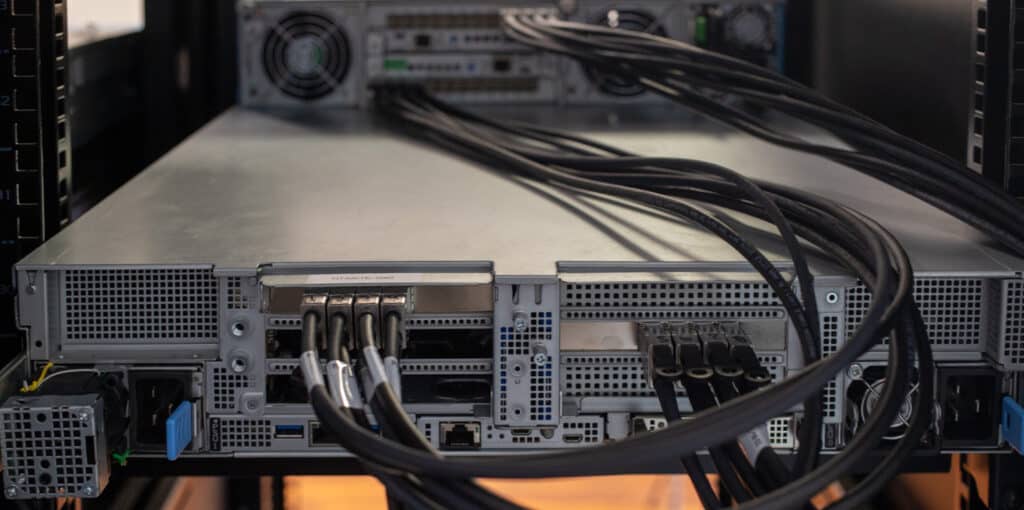
Nasza podstawowa platforma pozostała taka sama jak w zeszłym roku (obudowa QCT), ale wymieniliśmy procesory na układy AMD EPYC 9754 Bergamo. Chcieliśmy osiągnąć większą szybkość i dokładność obliczeń, unikając jednocześnie wykorzystywania pamięci masowej do obliczeń, co oznaczało konieczność skorzystania z kabli szeregowych (SerialCables) w celu zapewnienia JBOF. To samo w sobie stanowiło pewne wyzwanie, które szczegółowo opiszemy poniżej.
| Parametr | Wartość: |
|---|---|
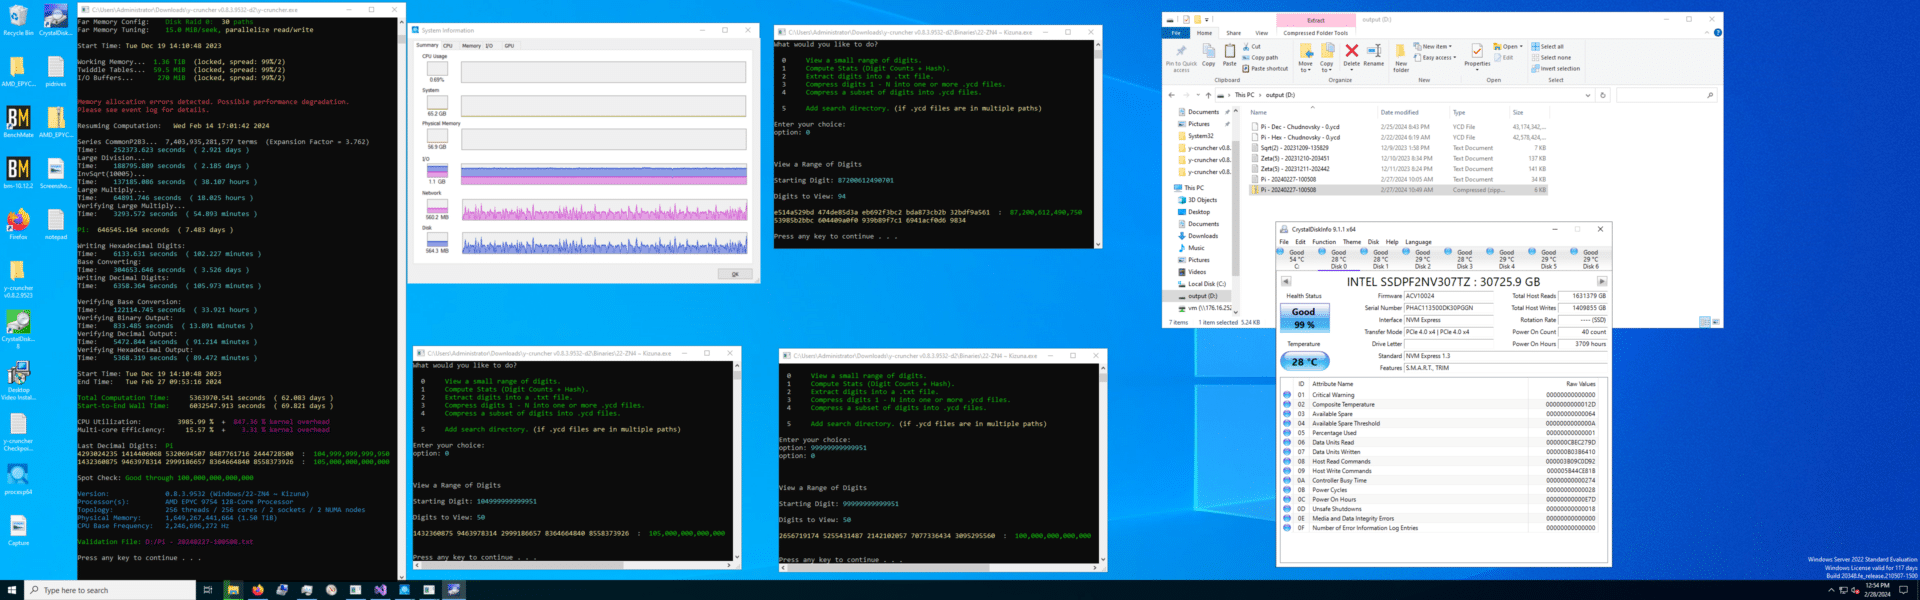
| Data rozpoczęcia | Wt. 19 grudnia 2023 14:10:48 |
| Data zakończenia | Wt. 27 lut 2024 09:53:16 |
| Całkowity czas obliczeń | 6 032 547,913 sekund / 62.08 dni |
| Czas ściany od początku do końca | 6 032 547,913 sekund / 69.82 dni |
Okres obliczeniowy: 14 grudnia 2023 r. – 27 lutego 2024 r., trwający 75 dni.
- PROCESOR: Dwa procesory AMD Epyc 9754 Bergamo, 256 rdzeni, z funkcją jednoczesnego przetwarzania wielowątkowego (SMT) wyłączoną w BIOS-ie.
- Pamięć: 1.5 TB pamięci RAM DDR5.
- Przechowywanie: 36 dysków SSD Solidigm D5-P5316 o pojemności 30.72 TB.
- 24 dyski SSD Solidigm D5-P5316 o pojemności 30.72 TB w obudowie JBOF SerialCables
- 12 dysków SSD Solidigm D5-P5316 o pojemności 30.72 TB w serwerze podłączonym bezpośrednio.
- System operacyjny: Windows Server 2022 (21H2).
Droga do 105 bilionów
| Parametr | Wartość: |
|---|---|
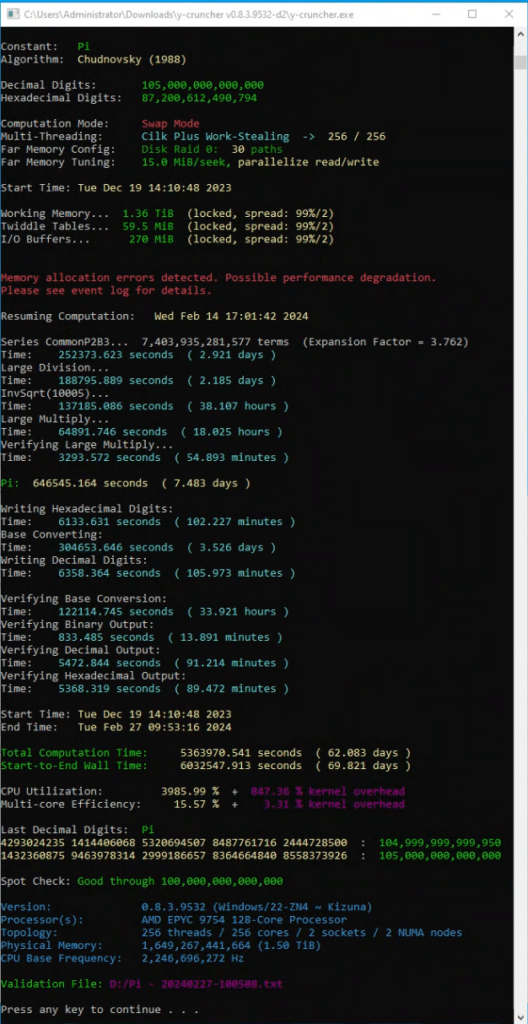
| stały | Pi |
| Algorytm | Chudnowski (1988) |
| Cyfry dziesiętne | 105,000,000,000,000 |
| Cyfry szesnastkowe | 87,200,612,490,794 |
| Tryb wątkowy | Cilk Plus Kradzież pracy -> 256 / 256 |
| Pamięć robocza | 534 615 969 510 896 (1.36 TiB) |
| suma pamięci | 534 615 969 510 896 (1.36 TiB) |
| Największy logiczny punkt kontrolny | 534 615 969 510 896 (144 TiB) |
| Logiczne szczytowe wykorzystanie dysku | 534 615 969 510 896 (486 TiB) |
| Odczytane bajty dysku logicznego | 38 717 269 572 788 080 (39.8 PiB) |
| Zapisane bajty dysku logicznego | 38 717 269 572 788 080 (34.4 PiB) |
Napotkane wyzwania
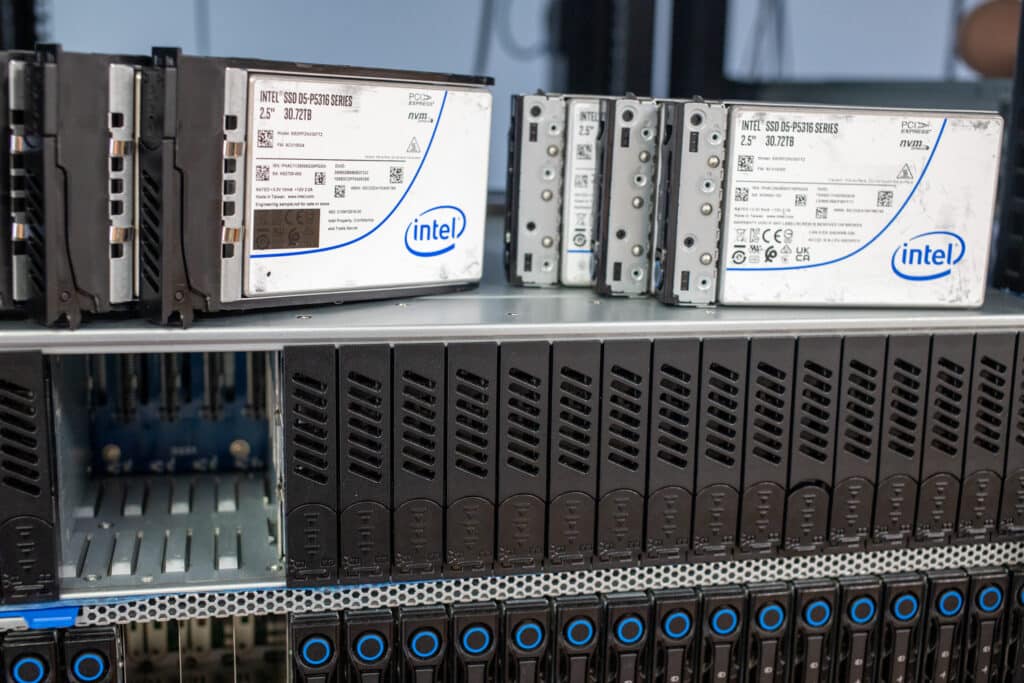
Nowym elementem tego testu, niezbędnym do rozszerzenia dostępnej pamięci masowej procesorów, było dodanie modułu JBOF NVMe. Nasza platforma testowa oferowała 16 zatok NVMe, a pozostałe osiem było podłączonych tylko do SATA. Chociaż w naszym teście 100 bilionów wykorzystaliśmy trzy wewnętrzne adaptery PCIe U.2, aby rozszerzyć liczbę dysków NVMe do 19, nie było to optymalne rozwiązanie. W tym powtórzeniu dodaliśmy 24-zatokowy moduł JBOF U.2 Serial Cables , co znacząco pomogło na dwa sposoby: zwiększyło przestrzeń wymiany obliczeniowej i wewnętrzną pamięć plików wyjściowych. Koniec z szalonym serwerem pamięci masowej RAID0 HDD!
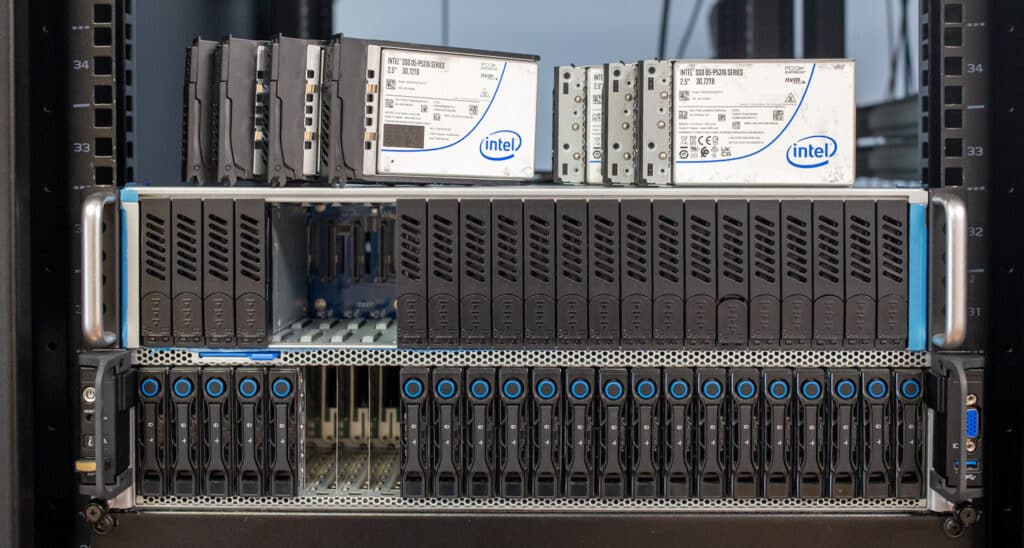
Rozwiązanie JBOF Serial Cables z 24 zatokami pozwoliło nam niemal podwoić liczbę dysków w porównaniu z pierwotnym rozwiązaniem. Przydzieliliśmy 30 dysków do przestrzeni wymiany Y-Crunker, pozostawiając 6 dysków SSD na wolumin wyjściowy RAID5 Storage Spaces. Ogromną zaletą tego podejścia była faza wyjściowa, gdzie nie byliśmy ograniczeni przez prędkość pojedynczego połączenia 10 Gb/s, jak w pierwszej iteracji 100T Pi. Chociaż rozwiązanie JBOF rozwiązało problem całkowitej liczby dysków, wprowadziło jedno ograniczenie: wydajność poszczególnych dysków.
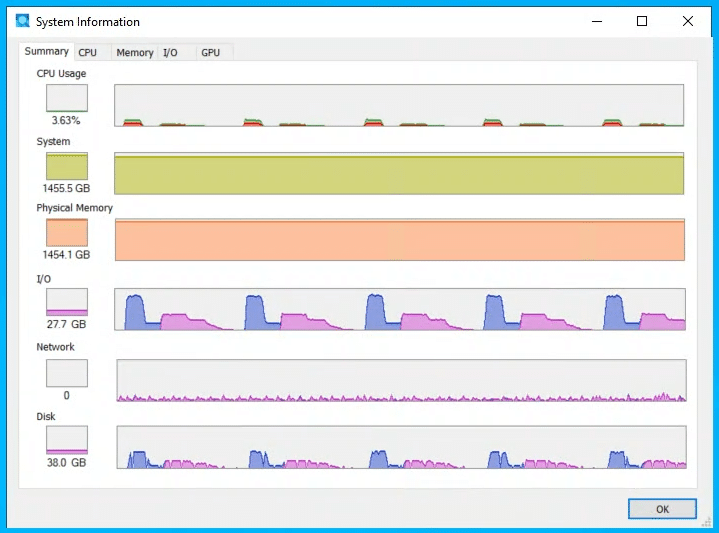
W serwerze z bezpośrednio podłączonymi dyskami SSD U.2 na dysk przypadają cztery linie PCIe. Jeśli każdy dysk jest podłączony bezpośrednio do płyty głównej, daje to 96 linii PCIe dla 24 dysków SSD. Całkowita przepustowość JBOF jest ograniczona liczbą linii PCIe, które może połączyć z hostem.
W tym przypadku użyliśmy dwóch kart hosta przełącznika PCIe, dzieląc sieć JBOF na dwie grupy po 12 dysków SSD. Każda grupa 12 dysków SSD współdzieliła 16 linii PCIe. Chociaż nadal oferowała znaczne korzyści w podłączaniu dysków SSD do naszego hosta, zdarzały się sytuacje, w których dyski wymiany przesyłane przez sieć JBOF pozostawały w tyle za dyskami podłączonymi bezpośrednio do serwera. Nie jest to wina sieci JBOF. To tylko ograniczenie techniczne, a raczej ograniczenie liczby linii PCIe, z którymi może pracować serwer.
Spostrzegawczy czytelnicy mogą się zastanawiać, dlaczego w tym teście zatrzymaliśmy się na 36 dyskach SSD, zamiast zwiększyć ich liczbę do 40. To zabawna historia. Adresowalna przestrzeń PCIe ma swoje ograniczenia w wielu serwerach. W naszym przypadku, przy liczbie 38 dysków, ostatni dysk SSD przejął adres PCIe chipsetu USB i straciliśmy kontrolę nad serwerem. Dla bezpieczeństwa zredukowaliśmy liczbę dysków SSD do 36, aby nadal móc wejść do BIOS-u lub zalogować się do serwera. Przesuwanie granic prowadzi do zaskakujących odkryć.
Wgląd diagnostyczny i rozwiązanie
Pierwszym z dwóch głównych wyzwań, z jakimi się spotkaliśmy, była wydajność. Odkryliśmy, że prawo Amdahla działa. Pojawił się osobliwy problem, gdy y-cruncher zdawał się „zawieszać” na naszym 256-rdzeniowym systemie AMD Bergamo podczas operacji w trybie dużej wymiany. To zawieszenie, charakteryzujące się brakiem aktywności wejścia/wyjścia procesora i dysku, podważało konwencjonalne oczekiwania dotyczące działania oprogramowania. Doprowadziło to do dogłębnego zbadania zawiłości obliczeń równoległych i interakcji sprzętowych.
Proces wykrywania wykazał, że program nie zawieszał się, lecz działał w bardzo ograniczonym zakresie, wykonując zadania jednowątkowe w rozbudowanej konfiguracji 256-rdzeniowej. To nietypowe zachowanie wywołało pytania o potencjalny wpływ prawa Amdahla, zwłaszcza że operacje te nie były intensywne obliczeniowo i nie powinny powodować znacznych opóźnień w systemie wyposażonym w 1.5 TB pamięci RAM.
Śledztwo przybrało nieoczekiwany obrót, gdy problem został powtórzony na komputerze stacjonarnym, co uwypukliło poważne konsekwencje prawa Amdahla nawet w mniej rozbudowanych systemach. Doprowadziło to do głębszej analizy przyczyn leżących u jego podstaw, która ujawniła zagrożenie dla procesora specyficzne dla architektury Zen4, związane z superwyrównaniem i jego wpływem na wzorce dostępu do pamięci.
Problem ten pogłębiał się na procesorach AMD z powodu pętli w kodzie, która ze względu na swoją prostotę powinna była wykonywać się znacznie szybciej niż zaobserwowano. Podstawową przyczyną wydawało się nieefektywne zarządzanie aliasingiem pamięci przez jednostkę ładującą pamięć (load-store) AMD. Rozwiązanie tego złożonego problemu wymagało zarówno złagodzenia zagrożenia związanego z superwyrównaniem poprzez wektoryzację pętli za pomocą AVX512, jak i wyeliminowania spowolnienia spowodowanego prawem Amdahla poprzez ulepszony paralelizm. To kompleksowe podejście nie tylko rozwiązało bezpośredni problem, ale także doprowadziło do znaczącej optymalizacji procesów obliczeniowych y-crunchera, ustanawiając precedens dla podobnych wyzwań w środowiskach obliczeń o wysokiej wydajności.
Kolejny problem wystąpił w końcowych etapach obliczeń, które nieoczekiwanie się zatrzymywały i nie dostarczały żadnych informacji o przyczynie awarii. Alexander Yee uzyskał zdalny dostęp i po raz pierwszy od ponad dekady, utworzenie rekordu Pi wymagało bezpośredniej interwencji programisty.
Nie braliśmy udziału w tym procesie diagnostycznym, ale wystąpił krytyczny błąd arytmetyki zmiennoprzecinkowej w ścieżce kodu AVX512 algorytmu mnożenia N63. Alexander był w stanie zdalnie zdiagnozować problem , dostarczyć poprawiony plik binarny i wznowić działanie od punktu kontrolnego, co zakończyło się pomyślnym wykonaniem obliczeń po wdrożeniu kluczowych poprawek oprogramowania.
Refleksje i dalszy rozwój
To przedsięwzięcie ilustruje złożoność i nieprzewidywalność obliczeń o wysokiej wydajności. Rozwiązanie tych problemów ustanowiło nowy rekord obliczeniowy dla Pi i dostarczyło cennych informacji na temat metodologii tworzenia i testowania oprogramowania. Najnowsza wersja y-cruncher, v0.8.4, zawiera poprawki zidentyfikowanych problemów, obiecując większą stabilność przyszłych obliczeń.
Obliczenie liczby Pi do 105 bilionów cyfr było nie lada wyzwaniem. Wymagało skrupulatnego planowania, optymalizacji i wykonania. Wykorzystując połączenie oprogramowania open source i zastrzeżonego, zespół StorageReview zoptymalizował proces algorytmiczny, aby w pełni wykorzystać możliwości sprzętu, skracając czas obliczeń i zwiększając wydajność.
Dzięki spektakularnej wydajności odczytu PCIe Gen4 i wiodącej w branży pojemności do 61.44 TB, dyski SSD Solidigm QLC zapewniają niesamowite rezultaty. „Wyobraźcie sobie, co te dyski mogą umożliwić w zastosowaniach wymagających wysokiej wydajności obliczeniowej lub wymagających intensywnej sztucznej inteligencji” – powiedział Greg Matson, wiceprezes ds. planowania strategicznego i marketingu w Solidigm. „Jesteśmy podekscytowani, że dyski SSD Solidigm mogły wesprzeć drugą rekordową próbę Storagereview w obliczeniu liczby pi. Ich wysiłki dowodzą prawdziwych możliwości dysków Solidigm, otwierając świat możliwości dla aplikacji AI intensywnie przetwarzających dane”.
Wniosek
Przebieg do 105 bilionów cyfr liczby Pi był znacznie bardziej złożony, niż się spodziewaliśmy. Po namyśle powinniśmy byli spodziewać się nowych problemów; w końcu wykonujemy obliczenia, których nigdy wcześniej nie wykonywano. Ale po wykonaniu 100 bilionów obliczeń w konfiguracji bardziej przypominającej „taśmę klejącą i siatkę drucianą”, myśleliśmy, że to już koniec. Ostatecznie, doprowadzenie tego zestawu do mety wymagało wspólnego wysiłku.
Choć cieszymy się z naszych partnerów z tego rekordowego wyniku, musimy zadać sobie pytanie: „Co to w ogóle oznacza?”. Pięć bilionów cyfr liczby Pi więcej prawdopodobnie nie zrobi wielkiej różnicy w matematyce. Mimo to, możemy wyznaczyć granicę między obciążeniami obliczeniowymi a potrzebą nowoczesnego sprzętu bazowego do ich obsługi. Zasadniczo, to ćwiczenie pokazuje, że odpowiedni sprzęt ma ogromne znaczenie, niezależnie od tego, czy chodzi o klaster korporacyjnego centrum danych, czy dużą instalację HPC.
W obliczeniach dla liczby Pi byliśmy całkowicie ograniczeni przez pojemność pamięci masowej. Szybsze procesory pomogą przyspieszyć obliczenia, ale czynnikiem ograniczającym wiele nowych rekordów świata jest ilość pamięci lokalnej w systemie. W tym teście ponownie wykorzystaliśmy dyski SSD Solidigm D5-P5316 o pojemności 30.72 TB , które pozwoliły nam uzyskać nieco ponad 1.1 PB surowej pamięci flash w systemie. Tylko dzięki tym dyskom SSD udało nam się pobić poprzednie rekordy i osiągnąć 105 bilionów cyfr liczby Pi.
Rodzi to jednak ciekawe pytanie. Wielu naszych obserwatorów wie, że Solidigm oferuje dyski SSD o pojemności 61.44 TB w modelu D5-P5336 i do 30.72 TB w modelu D5-P5430 , dostępne w różnych formatach i pojemnościach. Przeprowadziliśmy testy tych dysków i opublikowaliśmy wiele postów w mediach społecznościowych prezentujących te niezwykle gęste dyski. Biorąc pod uwagę, że 32 z tych dysków SSD mają pojemność zbliżoną do 2 PB, można się zastanawiać, jak długo te 105 bilionów cyfr liczby Pi utrzyma się na szczycie listy największych dysków na świecie. Chcielibyśmy wierzyć, że niedługo.
Największe znane cyfry dziesiętne liczby Pi
1432360875 9463978314 2999186657 8364664840 8558373926: Cyfry do 105 000 000 000 000


 Amazon