

Pi reprezentuje stosunek obwodu koła do jego średnicy i ma nieskończoną liczbę cyfr dziesiętnych, które nigdy się nie powtarzają ani nie kończą. Obliczenie nieskończonej liczby Pi to nie tylko ekscytujące zadanie dla matematyków; to także sposób na poddanie mocy obliczeniowej i pojemności pamięci masowej ostatecznemu testowi wytrzymałości. Do tej pory chmura Google'a była światowym rekordzistą w największym rozwiązaniu liczby Pi, wynoszącym 100 bilionów cyfr. Do dziś StorageReview dorównało temu wynikowi, i to w ułamku czasu.
Pi na niebie, ponad chmurami
W zeszłym roku Emma Haruka Iwao, rzeczniczka Google Cloud Developer Advocate, ogłosiła, że wraz ze swoim zespołem obliczyła liczbę Pi do 100 bilionów cyfr, bijąc swój poprzedni rekord z 2019 roku, wynoszący 31.4 biliona cyfr. Użyli programu o nazwie y-cruncher, działającego na platformie Compute Engine w Google Cloud. Jego ukończenie zajęło około 158 dni i pozwoliło na przetworzenie około 82 petabajtów danych. Ostatecznie, ta operacja wiązałaby się również z ogromnym wydatkiem na przetwarzanie i przechowywanie danych w chmurze, a dodatkowo rosłaby potrzeba organizacji, aby przenieść określone obciążenia z powrotem do lokalnych systemów, co dało nam ciekawy pomysł…
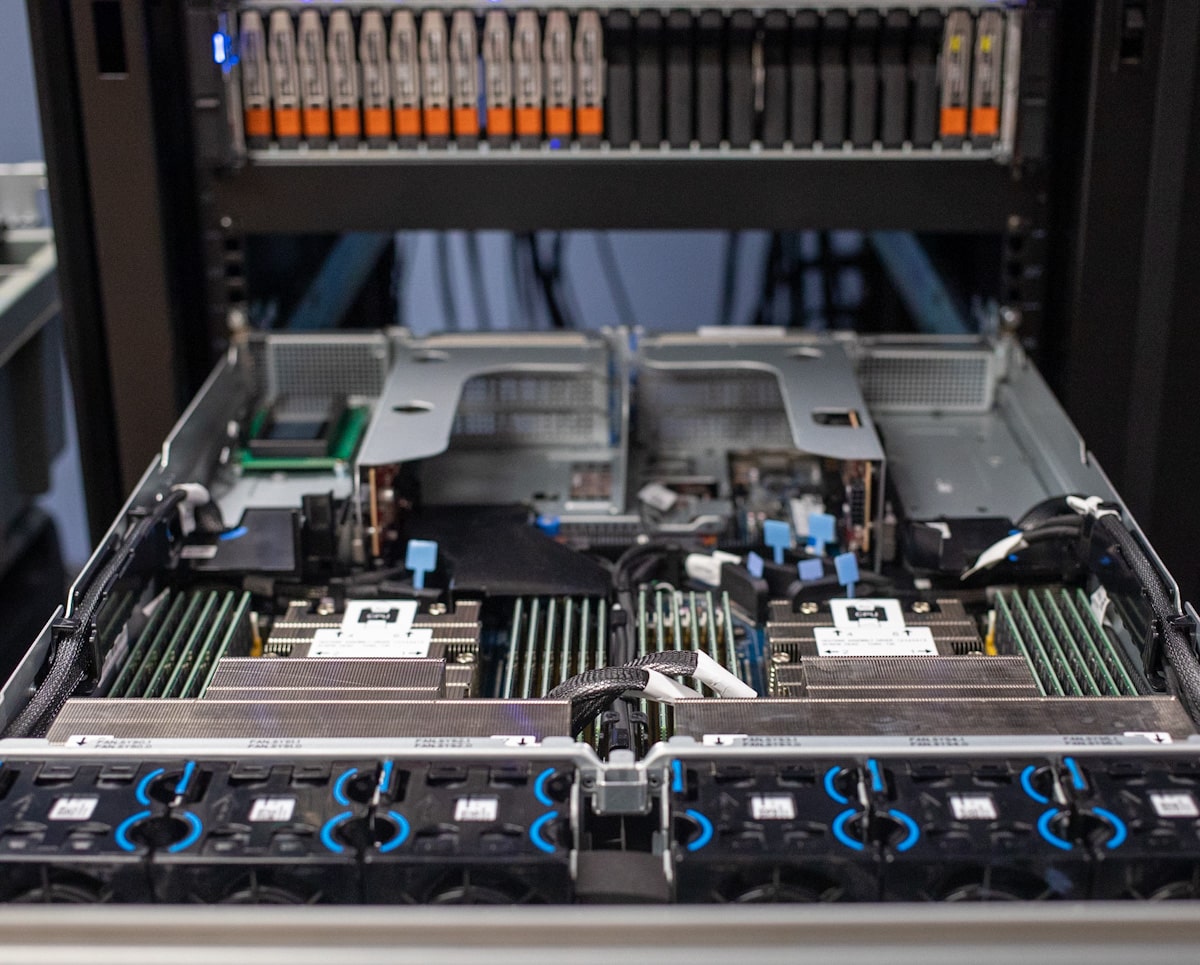
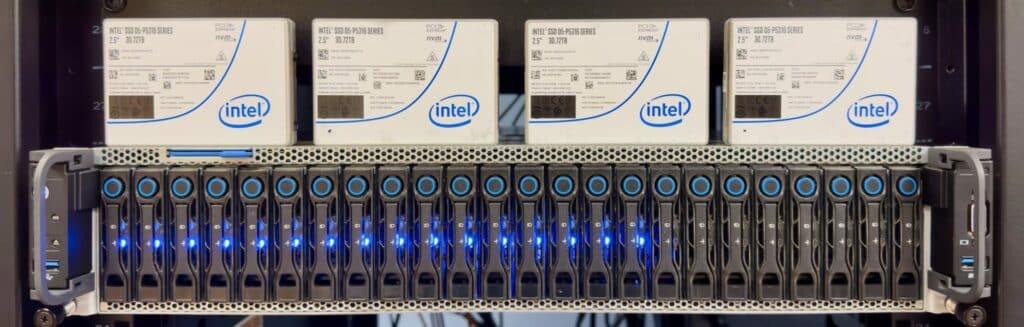
Byliśmy pod wrażeniem osiągnięć Emmy i Google Cloud, ale zastanawialiśmy się również, czy moglibyśmy zrobić to szybciej i przy niższych kosztach całkowitych. W StorageReview.com mamy dostęp do jednych z najnowszych i najlepszych rozwiązań sprzętowych w branży, w tym procesorów AMD EPYC czwartej generacji , dysków SSD Solidigm P5316 i ogromnych ilości baterii litowych . Jak na idealne połączenie przystało, zbudowaliśmy serwer o wysokiej wydajności z pamięcią flash QLC o pojemności nieco poniżej 600 TB i unikalnym, wysoce dostępnym rozwiązaniem zasilania.
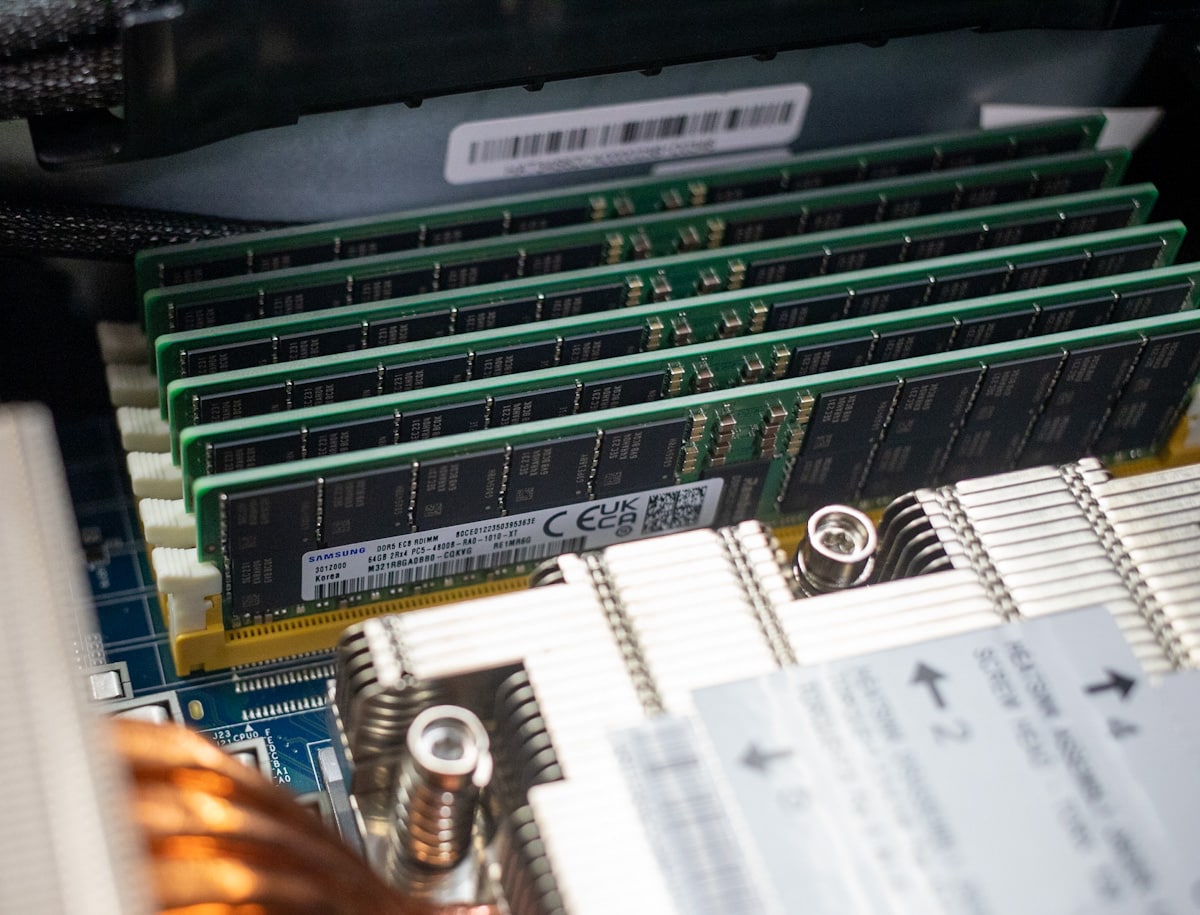
Oto specyfikacje naszego systemu obliczeniowego:
- 2 x AMD EPYC 9654 (96 rdzeni, 2.4 GHz, boost 3.7 GHz)
- 24 moduły DIMM DDR5-4800 o pojemności 64 GB, łącznie 1.5 TB
- 19 x Dyski SSD Solidigm QLC P5316 o pojemności 30.72 TB
- Windows Server 2022 Standard 21H2
- Program: y-cruncher przez Aleksandra Yee
Mimo że całkowity koszt sprzętu może wydawać się ekstremalny, koszt jego zakupu stanowi zaledwie ułamek kosztów uruchomienia tego samego zadania w chmurze przez sześć miesięcy.
Centrum danych: zaprojektowane przez szaleńców
Jednym z pierwszych pytań, które pojawiły się podczas projektowania platformy do tego testu, było: „Jak przedstawić ciągły wolumin wystarczająco duży, aby zapisać plik tekstowy ze 100 bilionami cyfr liczby Pi?” (To z pewnością dosłowny cytat, który powiedzieliśmy bez wahania). Matematyka jest dość prosta: 1 cyfra liczby Pi = 1 bajt, a mając 100 bilionów cyfr dziesiętnych, potrzebowaliśmy 100 TB na to i dodatkowe 83 TB na 83 biliony cyfr szesnastkowych, które również trzeba było obliczyć. Na szczęście to StorageReview i jeśli jest coś, co potrafimy robić, to przechowywanie dużej ilości danych z nadmiernym obciążeniem.
Niestety, nawet Kevin nie ma jeszcze pendrive'a o pojemności 183 TB na swoim pęku kluczy wielkości woźnego. Po przeanalizowaniu i przetestowaniu różnych metod w laboratorium oraz zbadaniu wielu sposobów mapowania NAS-a lub udziału plików, zauważyliśmy, że y-cruncher preferuje bezpośrednią kontrolę wejścia/wyjścia (Direct IO) nad dyskami, z którymi pracuje; nie tylko nad dyskami wymiany, ale także nad katalogiem wyjściowym plików. Przydzielenie y-cruncherowi woluminu, do którego może wysyłać polecenia SCSI, było naszą jedyną opcją, ponieważ zapewniało optymalną wydajność.
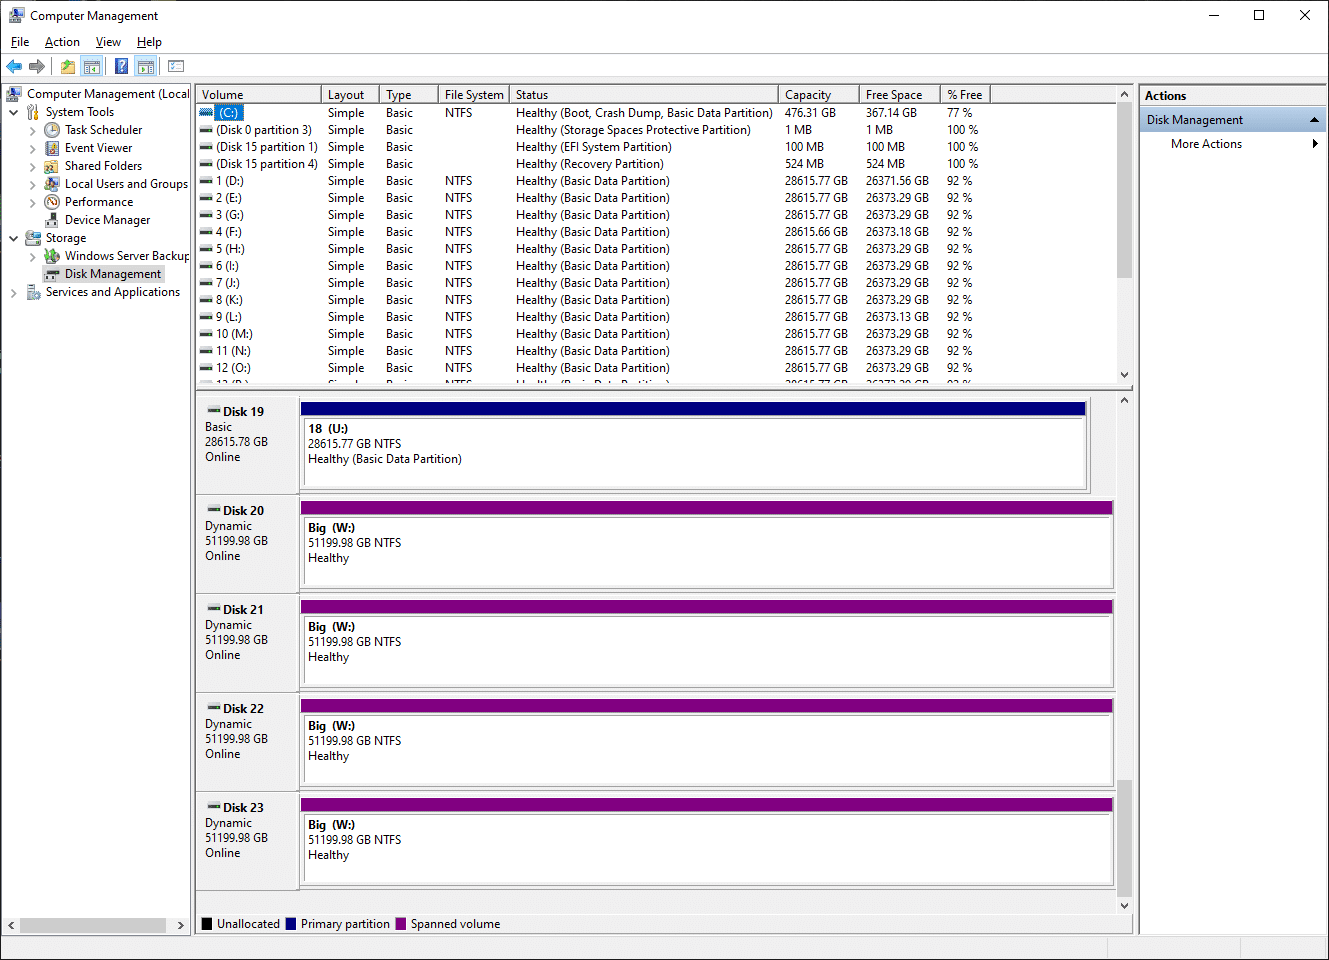
Jedynym logicznym rozwiązaniem było zatem użycie docelowego iSCSI serwera pamięci masowej Supermicro do przechowywania plików wyjściowych, które były zbyt duże, aby zmieścić się na pojedynczym woluminie na lokalnym hoście obliczeniowym. Platforma ta była bardziej tradycyjna pod względem pamięci masowej o dużej pojemności, hostując „zaledwie” 200 TB na czterech 50-terabajtowych jednostkach LUN, które rozłożyliśmy na naszej platformie obliczeniowej.
Choć RAID 0 może budzić pewne wątpliwości, na naszą obronę należy dodać, że pamięć masowa serwera plików została wydzielona z lustrzanej puli przestrzeni dyskowej systemu Windows, co zapewniało redundancję na hoście zdalnym. Następnie była ona przesyłana wielościeżkowo przez dwuportowy interfejs 10G, bezpośrednio podłączona i połączona przewodowo między oboma serwerami. Usunięcie przełącznika z tego równania było celowe, ponieważ platforma Pi została zaprojektowana do działania całkowicie niezależnie na wypadek, gdyby główne laboratorium miało zostać wyłączone.
Chociaż ochrona zasilania nie zawsze stanowi istotną kwestię w laboratorium StorageReview, projekt tej skali (trwający miesiące) wymagał ekstremalnych środków, aby zapewnić nieprzerwaną pracę. Wykorzystaliśmy trzy przenośne elektrownie EcoFlow Delta Pro , każda o mocy wyjściowej 3600 W i akumulatorze 3600 Wh.
Serwer AMD Genoa wykorzystywał dwa zasilacze UPS, w tym jeden Eaton 5PX podłączony do jednego Delta Pro, aby zredukować opóźnienie przełączania z EcoFlow podczas awarii. Serwer plików miał dedykowany jeden Delta Pro, a drugi Eaton 5PX G2 do opóźnień transferu.
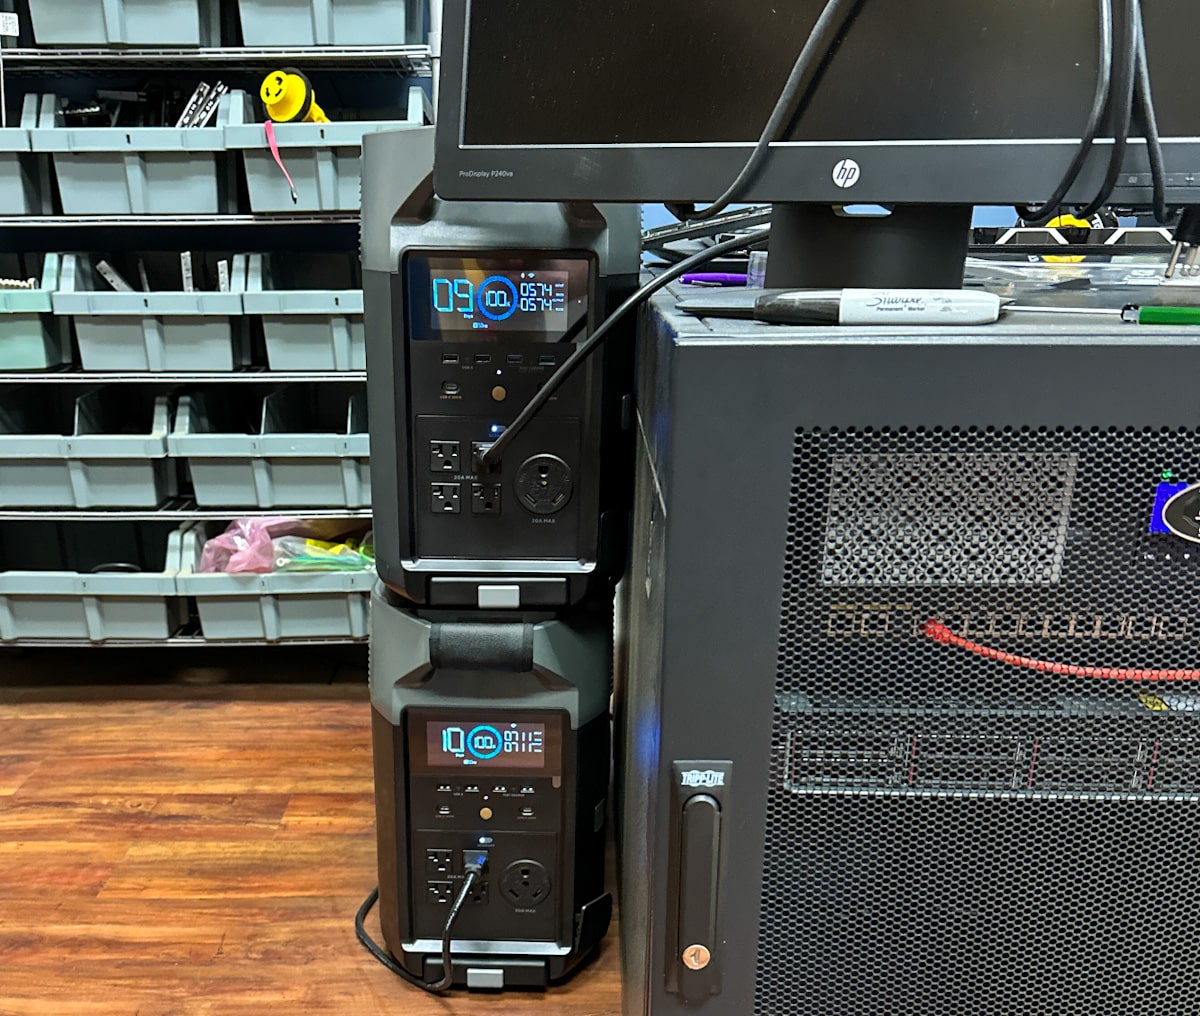
Krótko mówiąc, stworzyliśmy UPS na sterydach, łącząc zalety przenośnych elektrowni o dużej pojemności z niezawodnością nowoczesnych systemów zasilania awaryjnego klasy centrów danych. W szczytowym momencie obciążenia obliczeniowego, czas pracy na baterii wynosił od 4 do 8 godzin. Podczas pracy 100T Pi mieliśmy liczne burze, ale mogliśmy spać spokojnie, wiedząc, że Pi pozostanie sprawne.
Mięso, ziemniaki i pi. Mnóstwo, mnóstwo pi…
Rozpoczęliśmy obliczenia w czwartek, 9 lutego 2023 r. o godz. 17:40:47 czasu wschodniego (EST), a zakończyliśmy je w poniedziałek, 10 kwietnia 2023 r. o godz. 05:27:37 czasu wschodniego (EST). Upływający czas obliczeń Pi wyniósł 54 dni, 17 godzin, 35 minut i 48.96 sekundy, a całkowity czas od początku do końca, wliczając zapis i walidację, wyniósł 59 dni, 10 godzin, 46 minut i 49.55 sekundy.
Całkowity rozmiar dostępnej pamięci masowej wyniósł 530.1 TB, nie licząc docelowego iSCSI o pojemności 200 TB dla zapisu. Oto kilka najważniejszych danych z liczników z pliku walidacyjnego y-cruncher, dostępnego do pobrania i weryfikacji.
Księga Liczb
Data rozpoczęcia: czw. 9 lut 2023 17:40:47
Model pracy:
- Stała: Pi
- Algorytm: Chudnovsky (1988)
- Cyfry dziesiętne: 100 000 000 000 000
- Cyfry szesnastkowe: 83 048 202 372 185
- Pamięć robocza: 1 512 978 804 672 (1.38 TiB)
- Całkowita pamięć: 1 514 478 305 280 (1.38 TiB)
Liczniki dysków logicznych:
- Największy logiczny punkt kontrolny: 150 215 548 774 568 (137 TiB)
- Logiczne szczytowe wykorzystanie dysku: 514 540 112 731 728 (468 TiB)
- Całkowita liczba odczytanych bajtów dysku logicznego: 40 187 439 132 182 512 (35.7 PiB)
- Całkowita liczba zapisanych bajtów na dysku logicznym: 35 439 733 386 707 040 (31.5 PiB)
Liczby nie kłamią:
- Całkowity czas obliczeń: 4728948.966 sekund
- Czas ściany od początku do końca: 5136409.559 sekund
- Ostatnie cyfry po przecinku:
- 4658718895 1242883556 4671544483 9873493812 1206904813: 100 000 000 000 000
- 2656719174 5255431487 2142102057 7077336434 3095295560: 100 000 000 000 000
Data zakończenia: pon. 10 kwietnia 05:27:37 2023 r
Dziesięć cyfr liczby Pi prowadzących do 100 bilionów to 3095295560.
Obliczyliśmy Pi do 100 bilionów cyfr w około jedną trzecią czasu, częściowo dzięki wykorzystaniu lokalnej przestrzeni wymiany w porównaniu z metodą Google. To pokazuje niesamowitą wydajność, gęstość i efektywność lokalnie podłączonych dysków SSD Solidigm P5316 QLC i oczywiście procesorów AMD EPYC 4. generacji.
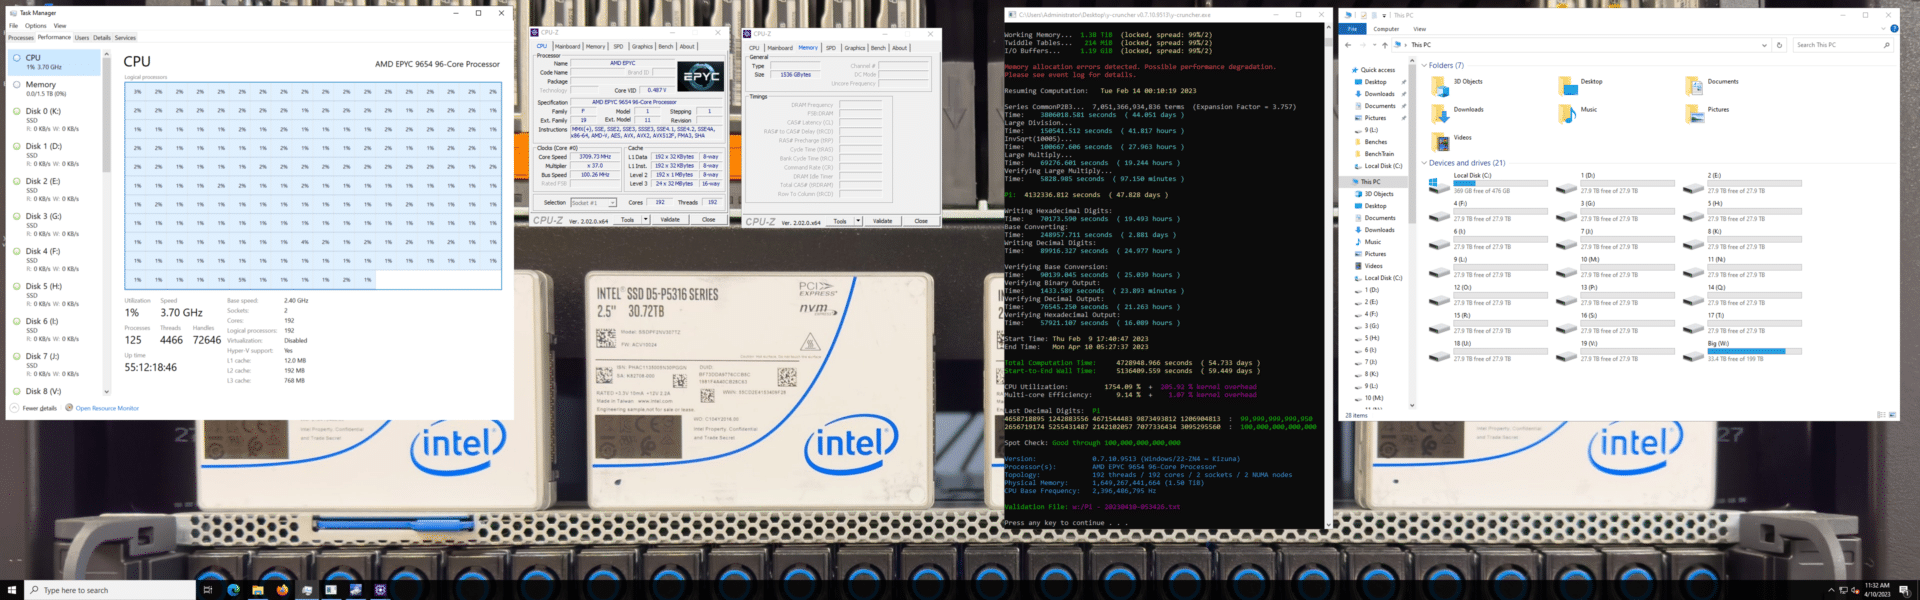
Pamięć lokalna była integralną częścią tego testu szybkości. Chociaż test Google'a pozwalał na wykorzystanie niemal nieograniczonej ilości pamięci masowej, był on ograniczony do interfejsu sieciowego 100 GB. Dziwne, że 100 GB to wolno, ale w skali naszego testu staje się to ogromnym wąskim gardłem. Podczas serii zapisów w pamięci wymiany zmierzyliśmy skumulowane prędkości transferu danych do dysków SSD Solidigm P5316 QLC przekraczające 38 GB/s.
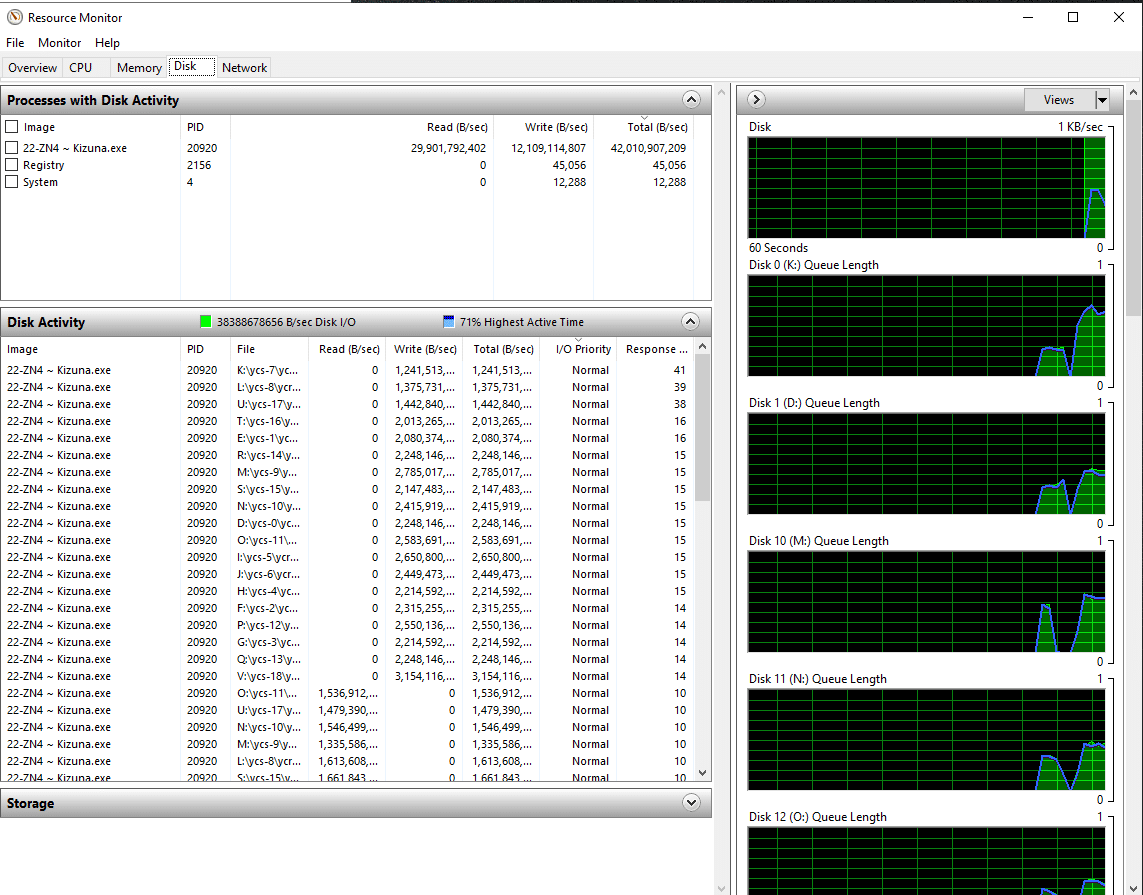
Prędkości odczytu były jeszcze wyższe. W kategoriach sieciowych, do przesłania takiej ilości danych potrzebne byłyby liczne łącza 400 Gb/s (redundancja). Choć nie jest to niemożliwe, wiele środowisk chmurowych po prostu nie jest zaprojektowanych do obsługi takiego poziomu przepustowości. Instancje Oracle Bare Metal Dense I/O prawdopodobnie są najbliższe tej skali prędkości obliczeniowej, ale są one ograniczone do ośmiu dysków SSD NVMe i łącznej pojemności 54.4 TB.
Pamięć flash Solidigm QLC zapewniająca wydajność, wytrzymałość i gęstość
Aby umożliwić przeprowadzenie tak istotnych obliczeń, potrzebowaliśmy dużej ilości miejsca, i to jak najszybciej. Tryb wymiany to funkcja w y-cruncher, która umożliwia wykonywanie obliczeń z wykorzystaniem dysku, co jest niezbędne do wykonywania dużych obliczeń, których nie da się zmieścić w pamięci głównej. Równoległe korzystanie z wielu dysków jest niezbędne dla uzyskania lepszej wydajności, a aby ją jeszcze bardziej zwiększyć, można zastosować dyski SSD. Jednak w przeszłości nie było to zalecane, ponieważ teoretyczna analiza ich zużycia podczas zapisu nie jest zachęcająca.
Użycie trybu wymiany y-crunchera, zamiast polegania na pliku stronicowania systemu operacyjnego, jest niezbędne, ponieważ wzorce dostępu do pamięci w y-cruncherze nie są bezpośrednio przyjazne dla dysku. Na szczęście tryb wymiany y-crunchera został zaprojektowany tak, aby obejść to ograniczenie poprzez minimalizację przeszukiwania dysku i wykorzystanie sekwencyjnego dostępu do dysku. Tryb wymiany y-crunchera został użyty w konfiguracji RAID 0 z 19 dyskami, co zapewniło aplikacji bezpośredni dostęp do dysków NVMe (IO), zapewniając optymalną wydajność.
Dyski SSD Solidigm P5316, których użyliśmy w naszym teście, wykorzystują interfejs PCIe Gen4 i są wyposażone w 144-warstwową pamięć flash QLC NAND. Oferują one wyjątkową wydajność, z prędkością odczytu sekwencyjnego do 7 GB/s i prędkością zapisu sekwencyjnego do 3.6 GB/s.
Dyski SSD QLC są cenione za możliwość obniżenia kosztów bez utraty pojemności pamięci masowej i wysokiej wydajności. Dzięki temu technologia dysków SSD QLC jest korzystna w wielu sytuacjach biznesowych. Na przykład firma VAST Data stosuje te dyski w swoich produktach, aby wyeliminować konieczność stosowania dysków twardych. Jednocześnie firma Pliops wykorzystuje kartę akceleratora z dyskami QLC, aby szybko i ekonomicznie rozwiązać ten problem.
Te dyski znajdują się w naszym laboratorium od końca 2021 roku i poddaliśmy je licznym testom, ale ten był jednym z najbardziej intensywnych i obszernych testów do tej pory. Spośród 19 użytych przez nas dysków, wszystkie były w 99–100% sprawne na początku obliczeń.
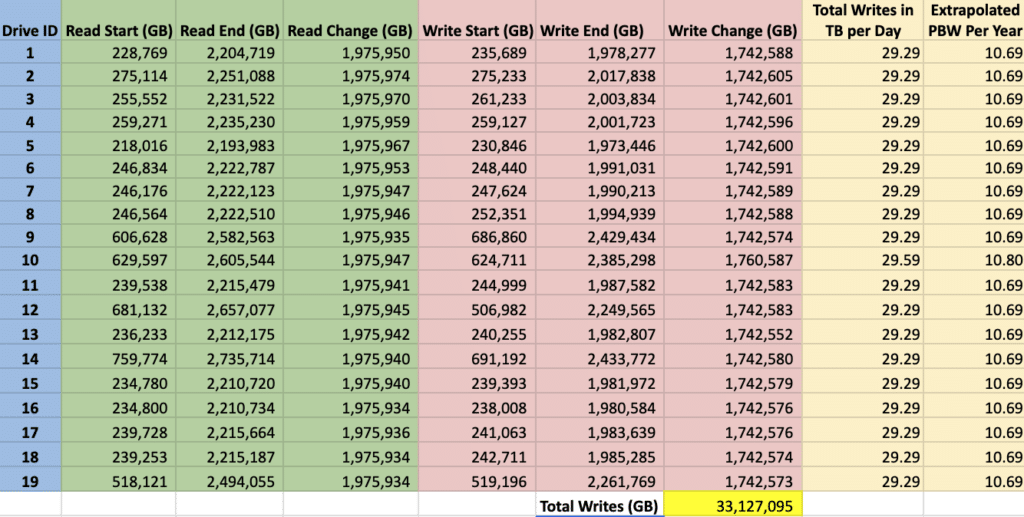
W ciągu 54.5 dnia trwania tych obliczeń, łącznie zapisaliśmy na dyskach 33 127 095 GB, czyli około 1 742 500 GB na dysk. Przeliczając to na dzienne nadwyżki w naszym teście, daje to nieco ponad 29 TB na dysk dziennie.
Ekstrapolacja symulowanego obciążenia długoterminowego wynosi około 10.69 PB zapisu danych na dysk rocznie. Solidigm podaje wytrzymałość dysku P5316 na 22.9 PBW dla obciążeń losowych i 104.6 PBW dla obciążeń sekwencyjnych. Ponieważ obciążenie Pi pozostawało w trybie burst przez cały czas bez nadmiernego obciążenia pamięci flash, działało bardzo sekwencyjnie, plasując obciążenie w górnym zakresie spektrum wytrzymałości Solidigm.
Oznacza to, że można je poddawać podobnemu obciążeniu przez prawie dekadę, zanim się wyczerpią. Imponujące, mówiąc delikatnie, biorąc pod uwagę, że to pamięć NAND QLC, a gwarancja na dysk wynosi pięć lat. Każdy, kto obawia się zużycia tych dysków, może wykorzystać ten przypadek użycia jako kolejny dowód na to, że QLC jest gotowy do pracy w przedsiębiorstwie.
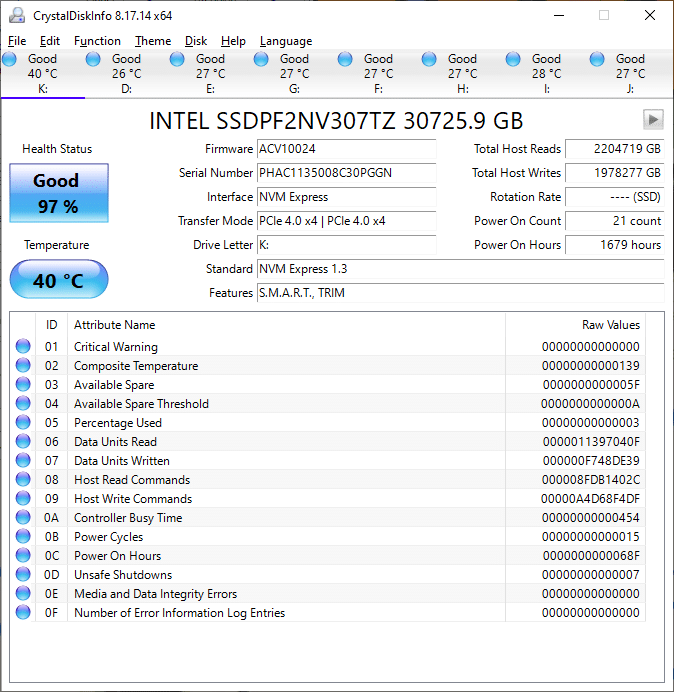
Pod koniec 59.5-dniowego testu stan kondycji wszystkich dysków serwera wynosił 97–98%. Nie odnotowaliśmy znaczącego spadku wytrzymałości tych dysków.
Epickie procesory AMD EPYC
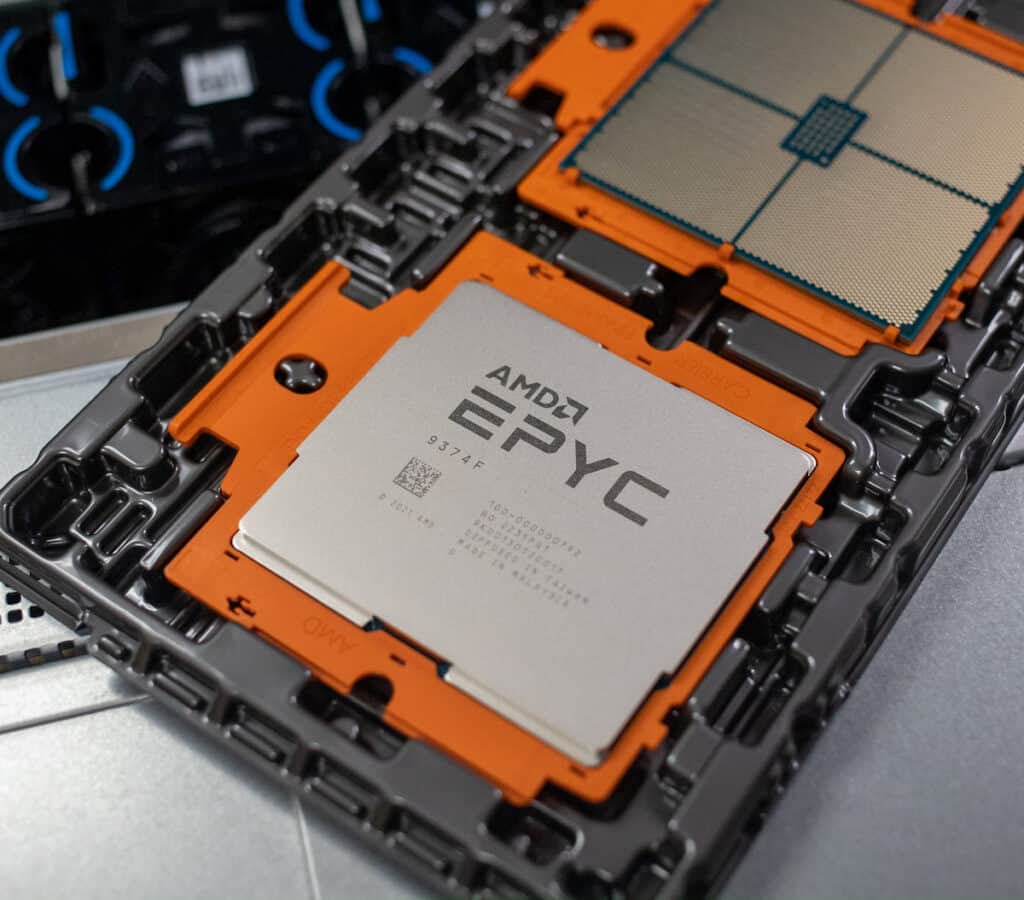
Procesory AMD EPYC czwartej generacji oparte są na mikroarchitekturze Zen 4 i procesie technologicznym 5 nm, co czyni je pierwszymi w branży procesorami x86 5 nm dla centrów danych. Obsługują do 12 kanałów pamięci DDR5, AVX-512 VNNI oraz instrukcje BFloat16, co zapewnia wyższą wydajność w aplikacjach AI i ML. Oferują do 30% wyższą wydajność na rdzeń niż procesory Intel Ice Lake i do dwóch razy wyższą wydajność niż poprzednia generacja procesorów AMD EPYC Milan.
Strojenie stanowiło istotną część tego testu, ponieważ intensywnie testowaliśmy i iterowaliśmy mniejsze, wcześniej przechowywane rekordy obliczeń Pi, takie jak 1 miliard i 10 miliardów. Dzięki dostrojeniu BIOS-u i wykorzystaniu 10 miliardów czasu wykonania jako metryki, udało nam się uzyskać znaczną poprawę wydajności dla tego obciążenia. Dało nam to znaczącą przewagę nad wykorzystaniem zasobów chmury, ponieważ mieliśmy szczegółową kontrolę nad platformą, aby zoptymalizować ją pod kątem naszej aplikacji, co nie jest możliwe w przypadku gotowych instancji chmurowych.
Zaczęliśmy od wyłączenia SMT w BIOS-ie i zauważyliśmy kilka % poprawy czasu wykonywania mniejszych testów. Kolejną opcją, którą rozważaliśmy, były stany C. Zauważyliśmy, że podczas uruchamiania y-crunchera procesor dość często przechodził z trybu C do trybu C o niższym poborze mocy, wykonując różne procesy.
Dostosowanie ustawień BIOS-u, w tym wyłączenie SMT i kontrolowanie stanów C, w połączeniu z pewnymi poprawkami wydajności systemu operacyjnego, było kluczowym czynnikiem wpływającym na poprawę wydajności w tym obciążeniu. Wielkie podziękowania dla Alexandra Yee z y-Crunchera i przyjaciela ze świata overclockingu, Forksa, za pomoc w zwróceniu uwagi na pewne poprawki i ustawienia zarówno w systemie Windows, jak i w y-Cruncherze, które pomogły w sfinalizowaniu tego testu.
Pi; 100T Speed Run, 100%. Co teraz?
No cóż, moi drodzy, kończąc ten Pi-lgrimage, poświęćmy chwilę na rozkoszowanie się chwałą obliczenia oszałamiających 100 bilionów cyfr liczby Pi w zaledwie 54 krótkie dni! Dzięki programowi y-cruncher, herkulesowej mocy procesorów AMD EPYC 4. generacji i błyskawicznym dyskom SSD Solidigm P5316 QLC, byliśmy świadkami osiągnięcia, które zawstydzi wasz kalkulator.
Przesuwając granice surowej mocy obliczeniowej komputera i pojemności pamięci masowej o rozmiarach oceanu, nasz zaufany zespół lokalnie podłączonych dysków flash QLC naprawdę miał swój czas, by zabłysnąć. Dyski SSD Solidigm P5316, dzięki swojej wyjątkowej wytrzymałości i wydajności, są niczym superbohaterowie w świecie biznesu. Nie zapominajmy też o naszych przenośnych stacjach zasilania i solidnym sprzęcie do podtrzymywania zasilania, które zapewniają, że nasz Pi-rade nie przestawał działać – nawet gdy Matka Natura próbowała pokrzyżować nam plany.
Żegnając się z tym rekordowym widowiskiem z Pi, oddajmy hołd nieskończonym możliwościom, jakie otwierają przed nami światy matematyki i informatyki. Na zdrowie!


 Amazon