

Punkty kontrolne mają kluczowe znaczenie dla trenowania modelu AI, zapewniając odporność, wydajność oraz możliwość wznawiania lub dostrajania treningu na podstawie zapisanych stanów. Jednak wymagania współczesnych obciążeń AI, z coraz bardziej złożonymi modelami i obszernymi zbiorami danych treningowych, wykorzystują możliwości pamięci masowej do granic możliwości.
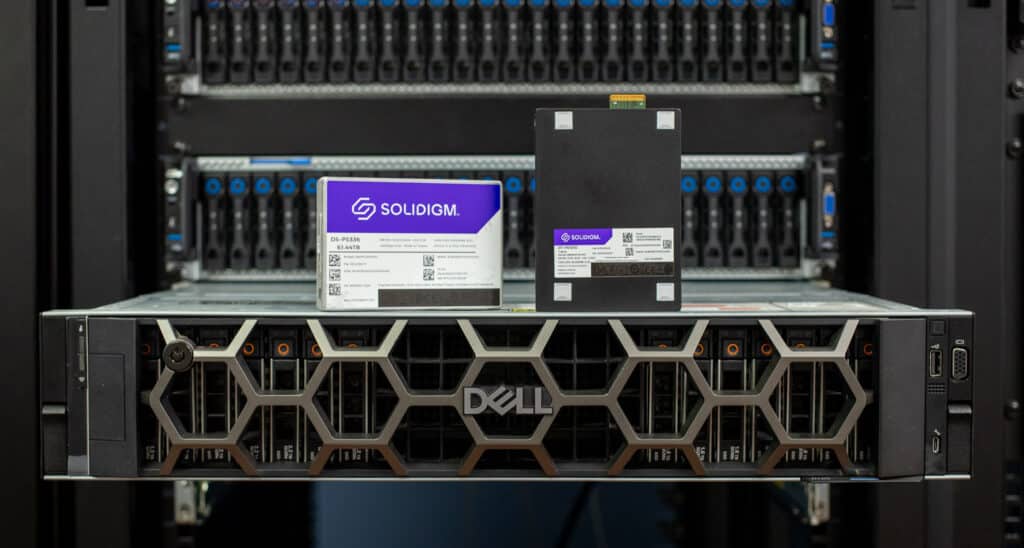
Rola punktów kontrolnych w przepływach pracy AI
Punkty kontrolne w trenowaniu sztucznej inteligencji to kluczowy proces, który polega na okresowym zapisywaniu pełnego stanu modelu podczas trenowania. Stan ten obejmuje wagi i parametry modelu, stany optymalizatorów, harmonogramy tempa uczenia oraz metadane treningowe. Punkty kontrolne tworzą kompleksowy obraz procesu trenowania w określonych odstępach czasu, zapewniając ciągłość treningu i możliwość odzyskiwania danych w przypadku przerw.
Punkty kontrolne są zazwyczaj wyznaczane w odstępach iteracyjnych (np. co tysiąc kroków treningowych). Współczesne szkolenia LLM, które mogą trwać tygodnie lub miesiące i pochłaniać ogromne zasoby obliczeniowe, w dużej mierze opierają się na tych punktach kontrolnych jako zabezpieczeniu przed potencjalnymi awariami. Na przykład, trenowanie modelu takiego jak klasa GPT-4 może generować punkty kontrolne o rozmiarze od kilkuset gigabajtów do wielu terabajtów, w zależności od rozmiaru modelu i konfiguracji treningowej.
Proces szkoleniowy wygenerowany przez DALL-E
Podstawowy cel punktów kontrolnych wykracza poza samą funkcję tworzenia kopii zapasowych. Stanowią one kluczowy mechanizm odporności na awarie podczas treningu, umożliwiając wznowienie treningu od ostatniego zapisanego stanu, zamiast rozpoczynania go od zera w przypadku awarii systemu, przerw w dostawie prądu lub problemów ze sprzętem. Ponadto punkty kontrolne są nieocenione w analizie modelu, umożliwiając badaczom badanie ewolucji modelu na różnych etapach treningu i potencjalne przywracanie do poprzednich stanów w przypadku wykrycia spadku wydajności.
Wzorce zapisu podczas tworzenia punktów kontrolnych są szczególnie interesujące z perspektywy pamięci masowej. Po uruchomieniu punktu kontrolnego system musi zapisać ogromne ilości danych w trybie burst. Tworzy to charakterystyczny profil wejścia/wyjścia, charakteryzujący się okresami stosunkowo niskiej aktywności pamięci masowej podczas obliczeń treningowych, po których następują intensywne operacje zapisu o dużej przepustowości podczas tworzenia punktów kontrolnych. Te operacje zapisu są zazwyczaj sekwencyjne i mogą znacząco skorzystać z systemów pamięci masowej zoptymalizowanych pod kątem sekwencyjnych zapisów o dużej przepustowości.
Różne strategie paralelizmu w uczeniu rozproszonym mogą znacząco wpływać na zachowanie punktów kontrolnych. Strategie te wpływają na moment wystąpienia punktów kontrolnych podczas treningu oraz na to, która część modelu jest przez nie obsługiwana. W nowoczesnych systemach uczenia rozproszonego wiele procesorów GPU może jednocześnie zapisywać różne fragmenty tej samej warstwy, tworząc złożone wzorce wejścia/wyjścia. Ta możliwość równoległego zapisu jest kluczowa dla wydajności, ale wymaga starannej koordynacji i niezawodnych systemów pamięci masowej, które mogą obsługiwać jednoczesne operacje zapisu, zachowując jednocześnie spójność danych. System pamięci masowej musi być w stanie efektywnie zarządzać tymi jednoczesnymi zapisami, ponieważ każde wąskie gardło w tym procesie może skutkować opóźnieniami w ogólnym uczeniu.
Powolne tworzenie punktów kontrolnych może powodować znaczne wąskie gardła w szkoleniu, ponieważ cały proces szkolenia musi zostać wstrzymany na czas zapisu punktu kontrolnego do pamięci masowej. Na przykład, w dużej konfiguracji szkoleniowej, jeśli tworzenie punktów kontrolnych zajmuje 30 minut co kilka godzin, może to skutkować kilkoma godzinami skumulowanego przestoju w całym okresie szkolenia. Ma to bezpośredni wpływ na efektywność szkolenia i zwiększa koszty operacyjne, szczególnie w środowiskach chmurowych, gdzie zasoby obliczeniowe są rozliczane na podstawie czasu.
Dzięki szybszemu tworzeniu punktów kontrolnych zespoły mogą sobie pozwolić na częstsze tworzenie punktów kontrolnych, co zmniejsza maksymalną potencjalną utratę danych w przypadku awarii. Pozwala to na bardziej agresywne podejście do treningu i lepsze cykle iteracji eksperymentalnych. Co więcej, szybkie ładowanie punktów kontrolnych ułatwia szybsze eksperymentowanie z różnymi konfiguracjami treningowymi i architekturami modeli, ponieważ badacze mogą łatwiej przywrócić poprzednie stany i wypróbować alternatywne podejścia.
Zdolność systemu pamięci masowej do efektywnej obsługi operacji punktów kontrolnych staje się kluczowym czynnikiem w całej infrastrukturze szkoleniowej. Wysokowydajne rozwiązania pamięci masowej, które potrafią obsługiwać zarówno wzorce zapisu w punktach kontrolnych, jak i ciągłe operacje odczytu/zapisu w trakcie szkolenia, mogą znacząco wpłynąć na całkowity czas i koszt szkolenia dużych modeli językowych. Dlatego też parametry wydajnościowe podsystemu pamięci masowej, szczególnie w zakresie obsługi dużych, sekwencyjnych operacji zapisu i utrzymywania stałej, wysokiej przepustowości, są kluczowymi czynnikami branymi pod uwagę przy projektowaniu infrastruktury szkoleniowej LLM.
W tym raporcie chcieliśmy ocenić wydajność dysków SSD w zakresie obsługi punktów kontrolnych przez sztuczną inteligencję, porównując zalety najnowszych dysków SSD Gen5 w sytuacjach, gdy szybkość obsługi punktów kontrolnych ma kluczowe znaczenie, z największymi dyskami SSD QLC na rynku, które mogą przechowywać ogromną liczbę punktów kontrolnych, co może okazać się korzystniejsze dla trenowanego modelu.
Wydajność punktu kontrolnego – testy porównawcze z DLIO
Aby ocenić rzeczywistą wydajność dysku SSD Solidigm w środowiskach szkoleniowych AI, wykorzystaliśmy narzędzie testowe Data and Learning Input/Output (DLIO) . Opracowane przez Argonne National Laboratory, narzędzie DLIO zostało zaprojektowane specjalnie do testowania wzorców wejścia/wyjścia w obciążeniach głębokiego uczenia. Dostarcza ono informacji o tym, jak systemy pamięci masowej radzą sobie z punktami kontrolnymi, pobieraniem danych i wyzwaniami związanymi z trenowaniem modeli.
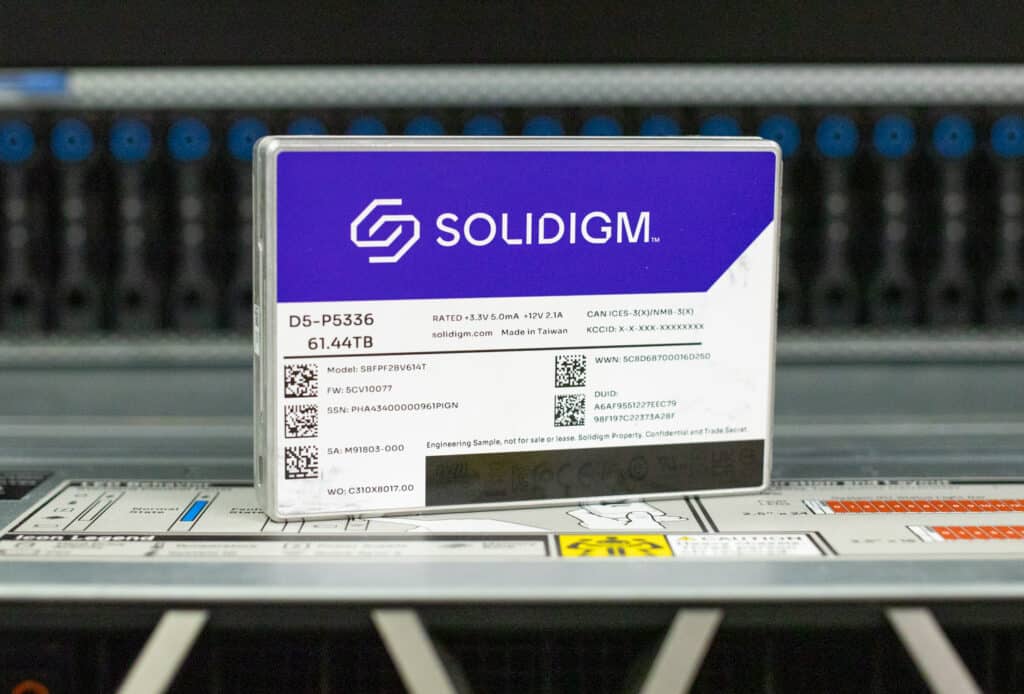
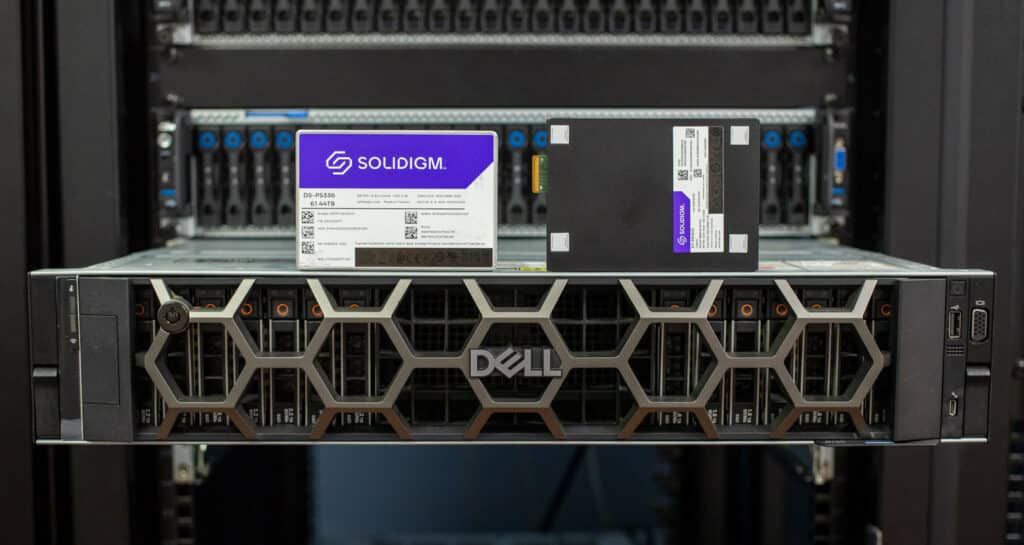
Współpracując z DLIO, chcieliśmy zmierzyć przepustowość, opóźnienie i niezawodność dysku w scenariuszach intensywnej obsługi punktów kontrolnych. Chociaż test przeprowadzono na dysku D5-P5336 o pojemności 61.44 TB, wstępne dane dotyczące wydajności wykazały, że wersja Solidigm D5-P5336 o pojemności 122 TB oferuje podobny profil wydajności. Uwzględniliśmy również wyniki z dysku D7-PS1010 opartego na technologii TLC, aby pokazać zalety PCIe Gen5 w tym teście. Wybraliśmy te dwa dyski, aby pokazać oba kąty widzenia punktów kontrolnych – jeden z nich oznaczał najszybszy możliwy czas obsługi punktów kontrolnych, a drugi – przechowywanie największej liczby punktów kontrolnych na jednym dysku SSD.
Platformą wybraną do tych badań był nasz Dell PowerEdge R760 z systemem Ubuntu 22.04.02 LTS. Wykorzystaliśmy test porównawczy DLIO w wersji 2.0 z 13 sierpnia 2024 roku. Poniżej przedstawiono konfigurację naszego systemu:
- 2 x Intel Xeon Gold 6430 (32-rdzeniowy, 2.1 GHz)
- 16 x 64 GB DDR5-4400
- Dysk SSD Dell BOSS 480 GB
- Kable szeregowe Gen5 JBOF
- 7.68 TB Solidigm D7-PS1010
- 61.44 TB Solidigm D5-P5336
Aby zapewnić, że nasze testy porównawcze odzwierciedlają rzeczywiste scenariusze, oparliśmy je na architekturze modelu LLAMA 3.1 405B, implementując punkty kontrolne za pomocą funkcji torch.save() w celu przechwytywania parametrów modelu, stanów optymalizatorów i stanów warstw. Nasza konfiguracja symulowała system z 8 procesorami graficznymi, implementując hybrydową strategię paralelizmu z 4-kierunkowym przetwarzaniem równoległym tensorów i 2-kierunkowym przetwarzaniem równoległym potoków, rozłożonymi na osiem procesorów graficznych. Taka konfiguracja skutkowała rozmiarami punktów kontrolnych na poziomie 1,636 GB, co jest reprezentatywne dla współczesnych wymagań dotyczących trenowania modeli języków programowania.
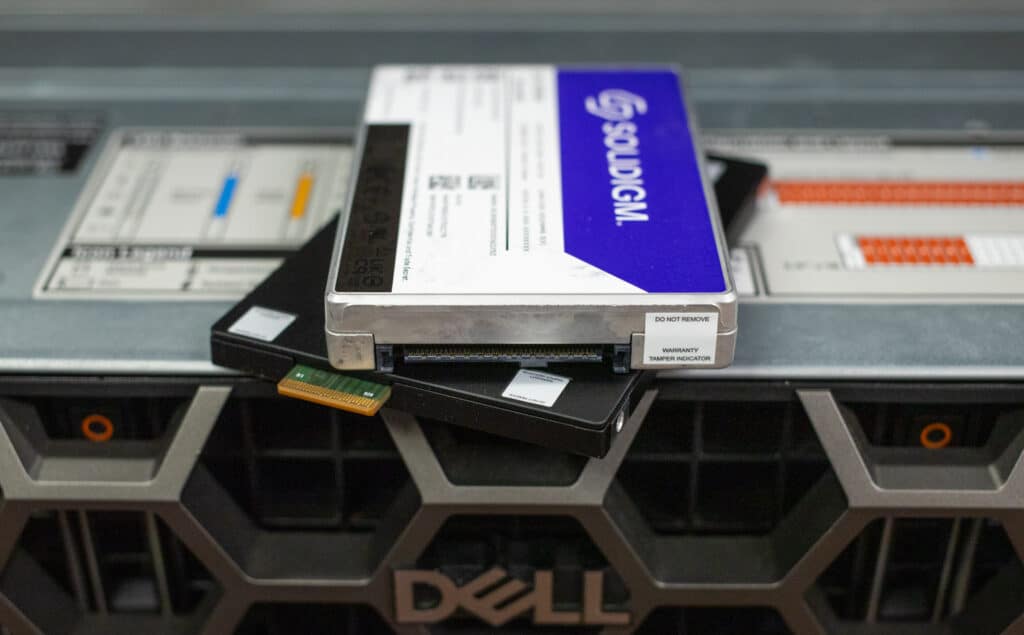
Nasz proces testowania obciążenia punktów kontrolnych DLIO polegał na zapełnieniu każdego dysku do podobnego poziomu wykorzystania. W przypadku dysku Solidigm D5-P5336 o pojemności 61.44 TB, każdy przebieg obejmował 33 interwały punktów kontrolnych, co łącznie dało 54 TB. Mniejszy dysk D7-PS1010 o pojemności 7.68 TB bez problemu mieścił trzy interwały punktów kontrolnych, zajmując łącznie 4.9 TB. Jeden dodatkowy punkt kontrolny zmieścił się w dysku D7-PS1010, choć jego wykorzystanie było nieco wyższe niż oczekiwaliśmy.
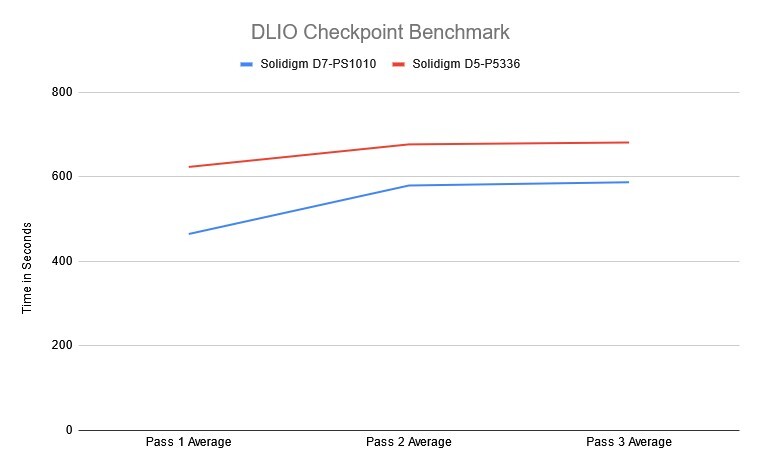
Obciążenie punktów kontrolnych DLIO dało interesujące wyniki, gdy porównaliśmy dysk Gen4 QLC o pojemności 61.44 TB D5-P5536 z dyskiem Gen5 TLC o pojemności 7.68 TB D7-PS1010. Podczas pierwszego przebiegu, wraz z zapełnianiem się dysków, zaobserwowaliśmy większą różnicę w wydajności między dwoma modelami dysków SSD. Szybszy Gen5 PS1010 ukończył każdy punkt kontrolny średnio w 464 sekundy, w porównaniu do 623 sekund w przypadku Gen4 P5336. W drugim i trzecim przebiegu różnica zmniejszyła się do 579 i 587 sekund w przypadku PS1010 oraz 676 i 680 sekund w przypadku P5336.
Dla firm, którym zależy na jak najmniejszych odstępach między punktami kontrolnymi, oparty na technologii TLC dysk Gen5 PS1010 oferuje przewagę w postaci najszybszego czasu realizacji. Jeśli celem jest ekonomiczne utrzymanie wielu punktów kontrolnych, dysk Gen4 P5336 oparty na technologii QLC idealnie się do tego nadaje. Zmierzyliśmy różnicę w średnim czasie realizacji punktów kontrolnych mniejszą niż 17% między oboma dyskami podczas drugiego i trzeciego przebiegu.
Przepustowość pamięci masowej GPUDirect
Chociaż DLIO pokazuje wydajność pamięci flash w przepływie pracy AI, obciążenie jest w całości oparte na zapisie, aż do momentu przywrócenia punktu kontrolnego. Aby uzyskać pełniejszy obraz dysków Solidigm D7-PS1010 i D5-P5336 w obciążeniach AI, uwzględniliśmy pomiary przepustowości odczytu za pomocą GDSIO.
Jak działa bezpośrednie przechowywanie danych GPU
Tradycyjnie, gdy procesor graficzny (GPU) przetwarza dane przechowywane na dysku NVMe, dane muszą najpierw przejść przez procesor (CPU) i pamięć systemową, zanim dotrą do procesora graficznego (GPU). Proces ten wprowadza wąskie gardła, ponieważ procesor (CPU) staje się pośrednikiem, zwiększając opóźnienia i zużywając cenne zasoby systemowe. Technologia GPU Direct Storage eliminuje ten problem, umożliwiając procesorowi graficznemu bezpośredni dostęp do danych z urządzenia pamięci masowej za pośrednictwem magistrali PCIe. Ta bezpośrednia ścieżka zmniejsza obciążenie związane z przesyłaniem danych, umożliwiając szybsze i bardziej wydajne przesyłanie danych.
Obciążenia sztucznej inteligencji, zwłaszcza te wykorzystujące uczenie głębokie, charakteryzują się wysoką intensywnością przetwarzania danych. Trenowanie dużych sieci neuronowych wymaga przetwarzania terabajtów danych, a każde opóźnienie w transferze danych może prowadzić do niewykorzystania procesorów graficznych (GPU) i wydłużenia czasu trenowania. Technologia GPU Direct Storage rozwiązuje ten problem, zapewniając jak najszybsze dostarczanie danych do procesora graficznego (GPU), minimalizując czas przestoju i maksymalizując wydajność obliczeniową.
Podobnie jak w przypadku testu DLIO, celem jest lepsze zrozumienie i scharakteryzowanie różnic między szybkimi dyskami SSD Gen5 a dyskami QLC o dużej pojemności. Nie każde obciążenie związane ze sztuczną inteligencją jest takie samo, a każdy dysk oferuje różne korzyści, w zależności od potrzeb.
Macierz konfiguracji testowej
Na naszej platformie testowej przeprowadziliśmy systematyczne testy każdej kombinacji następujących parametrów przy użyciu karty NVIDIA L4:
- Rozmiary bloków: 1 MB, 128 KB, 64 KB, 16 KB, 8 KB
- Liczba wątków: 128, 64, 32, 16, 8, 4, 1
- Liczba zadań: 16
- Wielkości partii: 16
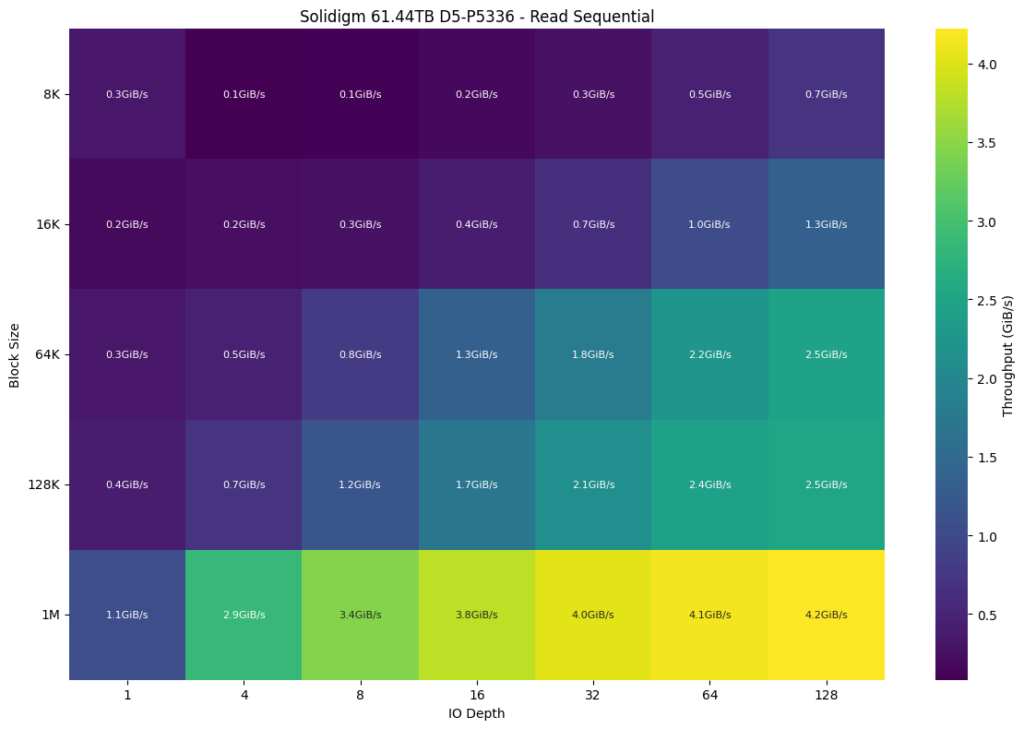
Najpierw przyjrzeliśmy się układowi D5-P5336 opartemu na procesorze QLC, który osiągnął maksymalną przepustowość 4.2 GiB/s przy rozmiarze transferu 1 MB i głębokości IO 128. Wpływ rozmiarów bloków spowodował znaczny wzrost przepustowości, z 8 KB do 1 MB. Korzyści płynące ze zwiększonej głębokości IO zaczęły zanikać przy 32, gdzie obciążenia zaczęły się stabilizować.
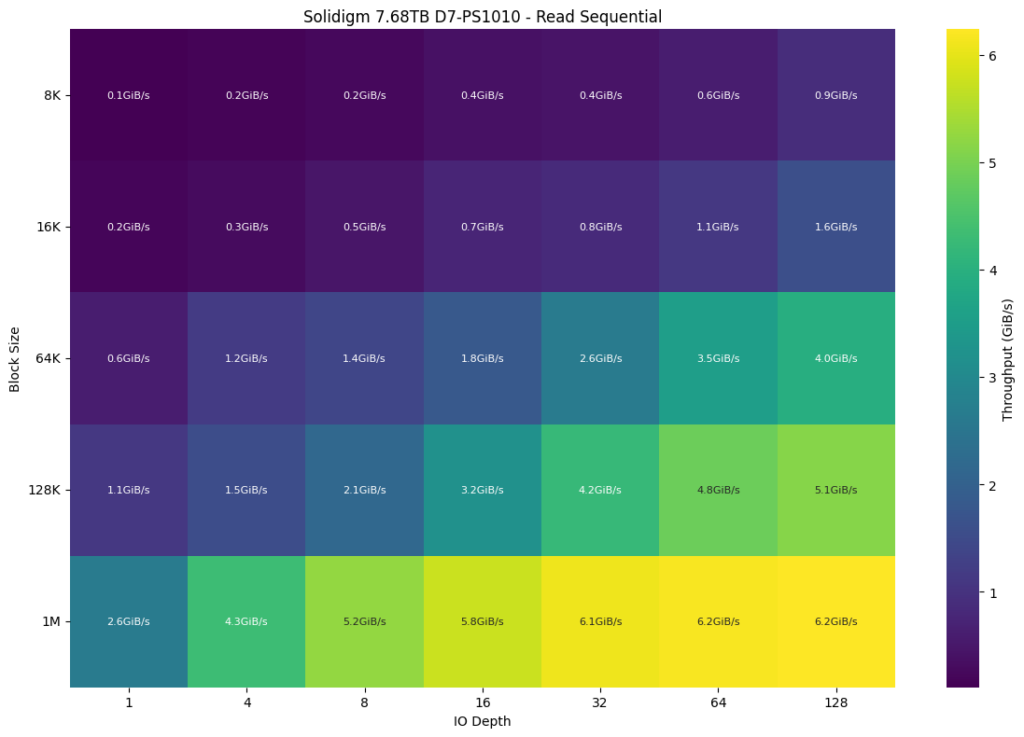
Następnie przyjrzymy się Gen5 PS-1010, który może skalować się do 6.2 GiB/s przy rozmiarze bloku 1 MB i głębokości IO 128. Pod każdym względem przewyższył on P5336 oparty na Gen4, a w przypadku niektórych obciążeń zaobserwowano znaczny wzrost. Jednym z istotnych obszarów poprawy był rozmiar bloku 128 KB, gdzie przy głębokości IO 64 i 128, PS1010 oferował dwukrotnie większą przepustowość odczytu niż P5336.
Należy zauważyć, że oba dyski SSD zostały przetestowane z użyciem procesora NVIDIA L4. Podczas gdy model Gen4 D5-P5336 plasuje się na lub blisko najwyższej półki, procesory graficzne NVIDIA z wyższych modeli, takie jak H100, wykazały wyższą wydajność w przypadku modelu D7-PS1010. Prędkość dysku jest dla niektórych klientów decydującym czynnikiem, podczas gdy dla innych priorytetem jest ogólna gęstość. Solidigm oferuje rozwiązania dla obu tych kategorii, oferując dyski SSD QLC i TLC.
Wniosek
Wraz ze wzrostem skali i złożoności szkoleń AI, infrastruktura pamięci masowej musi nie tylko dotrzymywać kroku, ale także nadawać tempo. Nasze testy z dwoma bardzo różnymi dyskami SSD pokazują, jak ważne jest dopasowanie rozwiązań pamięci masowej do konkretnych priorytetów szkoleniowych, takich jak minimalizacja opóźnień w punktach kontrolnych lub maksymalizacja gęstości punktów kontrolnych w celu zapewnienia ekonomicznej skalowalności.
W naszej ocenie przetestowaliśmy dyski Solidigm D5-P5336 (61.44 TB) i D7-PS1010 (7.68 TB) w realistycznych warunkach treningu AI, wykorzystując test porównawczy DLIO oraz rozbudowany hybrydowo-równoległy proces tworzenia punktów kontrolnych LLM. Rejestrowaliśmy metryki odzwierciedlające wydajność zapisu w punktach kontrolnych w wielu przebiegach podczas zapełniania dysków, co uwydatniło różnice w czasie ukończenia operacji między dyskami D5-P5336 z procesorem QLC Gen4 a D7-PS1010 z procesorem TLC Gen5.
Podczas gdy D7-PS1010 zapewniał najszybsze możliwe zapisy w punktach kontrolnych, D5-P5336 wykazał się przekonującą opłacalnością i korzyściami w zakresie pojemności przy jedynie niewielkim spadku wydajności. Przeanalizowaliśmy również przepustowość odczytu z GPU Direct Storage z GDSIO za pośrednictwem procesora graficznego NVIDIA L4. Stwierdziliśmy, że Solidigm D5-P5336 oferował przepustowość odczytu do 4.2 GiB/s przy rozmiarze transferu 1 MB, podczas gdy D7-PS1010 oferował znaczny wzrost do 6.2 GiB/s. Jeszcze lepszą wydajność można uzyskać, wykorzystując jeszcze większy procesor graficzny, taki jak NVIDIA L40s lub H100/H200.
Patrząc w przyszłość, bezprecedensowa pojemność dysku SSD Solidigm D5-P5336 o pojemności 122 TB ma szansę zmienić oblicze szkoleń i wdrażania sztucznej inteligencji. Wraz ze wzrostem rozmiarów modeli i wymagań dotyczących punktów kontrolnych, te ogromne dyski otwierają drzwi do nowych poziomów wydajności i elastyczności, umożliwiając realizację strategii szkoleniowych, które wcześniej były poza zasięgiem. Wiodąca pozycja Solidigm w dziedzinie rozwiązań SSD o dużej pojemności umożliwia organizacjom przechowywanie większej ilości danych i punktów kontrolnych na mniejszej liczbie dysków oraz pomaga w przygotowaniu infrastruktury na kolejną falę złożoności sztucznej inteligencji.
Dysk SSD Solidigm D5-P5336 o pojemności 122 TB
Niniejszy raport jest sponsorowany przez firmę Solidigm. Wszystkie poglądy i opinie wyrażone w niniejszym raporcie opierają się na naszej obiektywnej ocenie rozpatrywanego produktu/produktów.


 Amazon