

Niemal co tydzień słyszymy od dostawców IT o wpływie ich rozwiązań na organizacje zajmujące się sztuczną inteligencją, uczeniem głębokim, uczeniem maszynowym czy inteligencją brzegową. Problemem jest jednak brak istotnych informacji na temat wpływu tych rozwiązań na wydajność każdego z tych zadań. Niedawno postanowiliśmy sprawdzić, czy możemy coś z tym zrobić, nawiązując współpracę z byteLAKE, polskim producentem rozwiązań AI i HPC. Głównym celem jest ocena wpływu pamięci masowej i GPU na obciążenia AI.
Wpływ pamięci masowej na sztuczną inteligencję
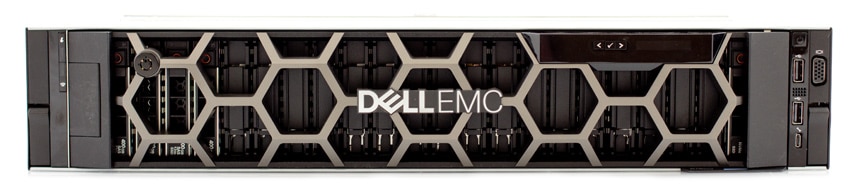
Początkowo chcieliśmy zbadać popularny pogląd, że pamięć lokalna wpływa na wydajność modeli AI. W naszym laboratorium wykorzystaliśmy jeden z serwerów Dell EMC PowerEdge R740xd , skonfigurowany z dwoma procesorami Intel Xeon Gold 6130 i 256 GB pamięci DRAM. Przeprowadziliśmy test byteLAKE AI, wykorzystując trzy różne alternatywne pamięci lokalne. Do testu użyliśmy starszego dysku SSD KIOXIA PX04S oraz znacznie szybszych dysków Samsung 983 ZET i Intel Optane 900P.
Podczas benchmarku analizowaliśmy wydajność procesu uczenia się sztucznej inteligencji (AI). W testach uruchomiliśmy proces uczenia w scenariuszu rzeczywistym. W tym przypadku testy były częścią procedury treningowej w jednym z produktów byteLAKE: EWA Guard . Opiera się on na najnowszym modelu detekcji w czasie rzeczywistym YOLO (You Only Look Once). Model składa się z pojedynczej warstwy wejściowej, 22 warstw splotu, 5 warstw pulowania, 2 warstw routera, pojedynczej warstwy reorganizacji oraz pojedynczej warstwy detekcji.
Jako podstawową miarę wydajności wykorzystaliśmy czas wykonania treningu dla 5000 epok. Testy porównawcze powtórzono trzykrotnie dla każdej konfiguracji pamięci masowej, a wartości średnie przedstawiono poniżej.
Wyniki:
- KIOXIA 98h 24m
- Samsung 98h 44
- Intel 98h 42
Jak wyraźnie wynika z danych, pamięć lokalna nie miała wpływu na wydajność. Testy obejmowały dyski od SATA SSD po najnowszy i najnowocześniejszy dysk Optane, bez jakiegokolwiek wpływu. Mimo to pamięć masowa może odgrywać ważniejszą rolę w zakresie transferu danych, ale z punktu widzenia obliczeń dla sztucznej inteligencji, w tym przypadku nie zaobserwowano żadnego wpływu.
Wpływ GPU i pamięci masowej na sztuczną inteligencję
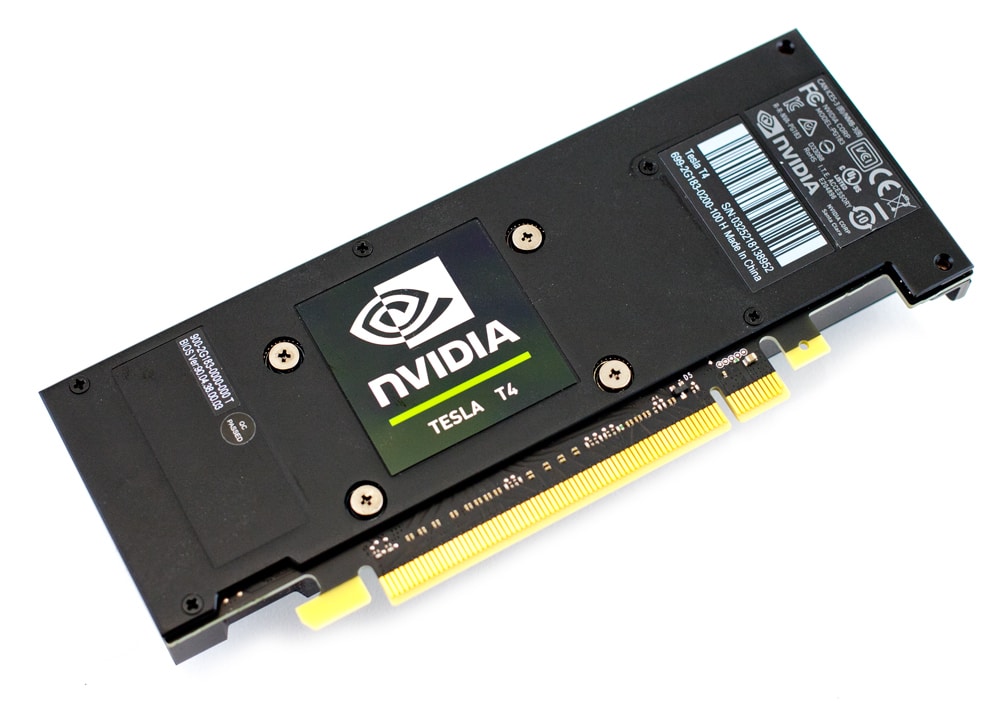
Mając dane o pamięci masowej, dodaliśmy do serwera PowerEdge pojedynczą kartę NVIDIA T4, aby ocenić wpływ procesora graficznego na sztuczną inteligencję. Do tego testu uruchomiliśmy również te same trzy konfiguracje pamięci masowej.
Wyniki:
- KIOXIA 4h 30
- Samsung 4 godz. 28 min
- Intel 4 godz. 27 min
Zgodnie z oczekiwaniami, GPU miało wpływ, wręcz wykładniczy, zapewniając 22-krotną poprawę. W związku z tym, że GPU przyspiesza ogólną wydajność sztucznej inteligencji, niektórzy sądzili, że szybsza pamięć masowa może mieć znaczenie. Tak się jednak nie stało, ponieważ dysk SATA był zgodny z szybkim NVMe.
wnioski
W tych testach stwierdziliśmy, że użycie szybszych urządzeń pamięci masowej nie poprawia wydajności uczenia. Głównym powodem jest złożona struktura modelu sztucznej inteligencji. Czas uczenia się jest dłuższy niż czas odczytu danych. Innymi słowy, czas uczenia się z wykorzystaniem bieżącej partii obrazów jest dłuższy niż czas potrzebny na odczytanie kolejnej. W rezultacie operacje pamięci masowej są ukryte za obliczeniami sztucznej inteligencji.
Podczas dodawania karty graficznej NVIDIA T4 istniała obawa, że szybsze przetwarzanie przez sztuczną inteligencję wpłynie na wydajność pamięci masowej. W tym teście tak się jednak nie stało, ponieważ nawet z kartą T4 model sztucznej inteligencji nadal charakteryzował się większym komponentem uczenia się i nie wymagał szczególnie szybkiej pamięci masowej.
Chociaż konieczne są dalsze badania wpływu poszczególnych komponentów i systemów na sztuczną inteligencję, uważamy, że te wstępne dane będą przydatne i stanowić dobry punkt wyjścia do dyskusji. Potrzebujemy danych aplikacyjnych, aby lepiej zrozumieć, gdzie znajdują się odpowiednie dźwignie z punktu widzenia IT i gdzie wydatki budżetowe mogą przynieść największe rezultaty. Oczywiście w dużej mierze zależy to również od tego, gdzie te działania mają miejsce – czy w centrum danych, czy na brzegu sieci. Na razie z zadowoleniem przyjmujemy zaangażowanie byteLAKE i innych podmiotów działających na czele sztucznej inteligencji, które pomogą nam dostarczyć użytecznych danych, które pomogą odpowiedzieć na te palące pytania.
To nasz pierwszy test sztucznej inteligencji (AI), ale nie ostatni. Mariusz Kolanko, współzałożyciel byteLAKE, poinformował, że firma pracuje nad produktem o nazwie CFD Suite (AI for Computational Fluid Dynamics – CFD) przyspieszającym solvery, w którym proces głębokiego uczenia (deep learning) wymaga dużej ilości danych w każdej epoce szkolenia. Model ten może w rzeczywistości generować większe obciążenie pamięci masowej do trenowania modeli w obszarze Big Data i może mieć wpływ na wydajność samych procesów głębokiego uczenia. Ostatecznie, jak w przypadku każdej aplikacji, kluczowe jest zrozumienie, że aplikacja musi przypisać odpowiednie zasoby do centrum danych. AI ewidentnie nie jest rozwiązaniem uniwersalnym.



 Amazon