

NVIDIA och Google Cloud använde Google Cloud Next i Las Vegas för att skissera en ny fas av sitt långvariga ingenjörssamarbete, där de introducerade uppdateringar av Google Cloud AI Hypercomputer-plattformen för att skala agentisk och fysisk AI för produktionsmiljöer. Företagen fortsätter att gemensamt designa infrastruktur som omfattar kisel, system, nätverk och programvara för att stödja alltmer komplexa AI-arbetsbelastningar, inklusive autonoma agenter, robotik och digitala tvillingar.
Vera Rubin-baserad A5X-infrastruktur riktar in sig på storskaliga AI-fabriker
Google Cloud introducerade A5X bare-metal-instanser byggda på NVIDIA Vera Rubin NVL72 rackskalasystem. Dessa system är utformade för att avsevärt förbättra inferensekonomin och effektiviteten, vilket ger upp till 10 gånger lägre kostnad per token och 10 gånger högre tokengenomströmning per megawatt än föregående generation.
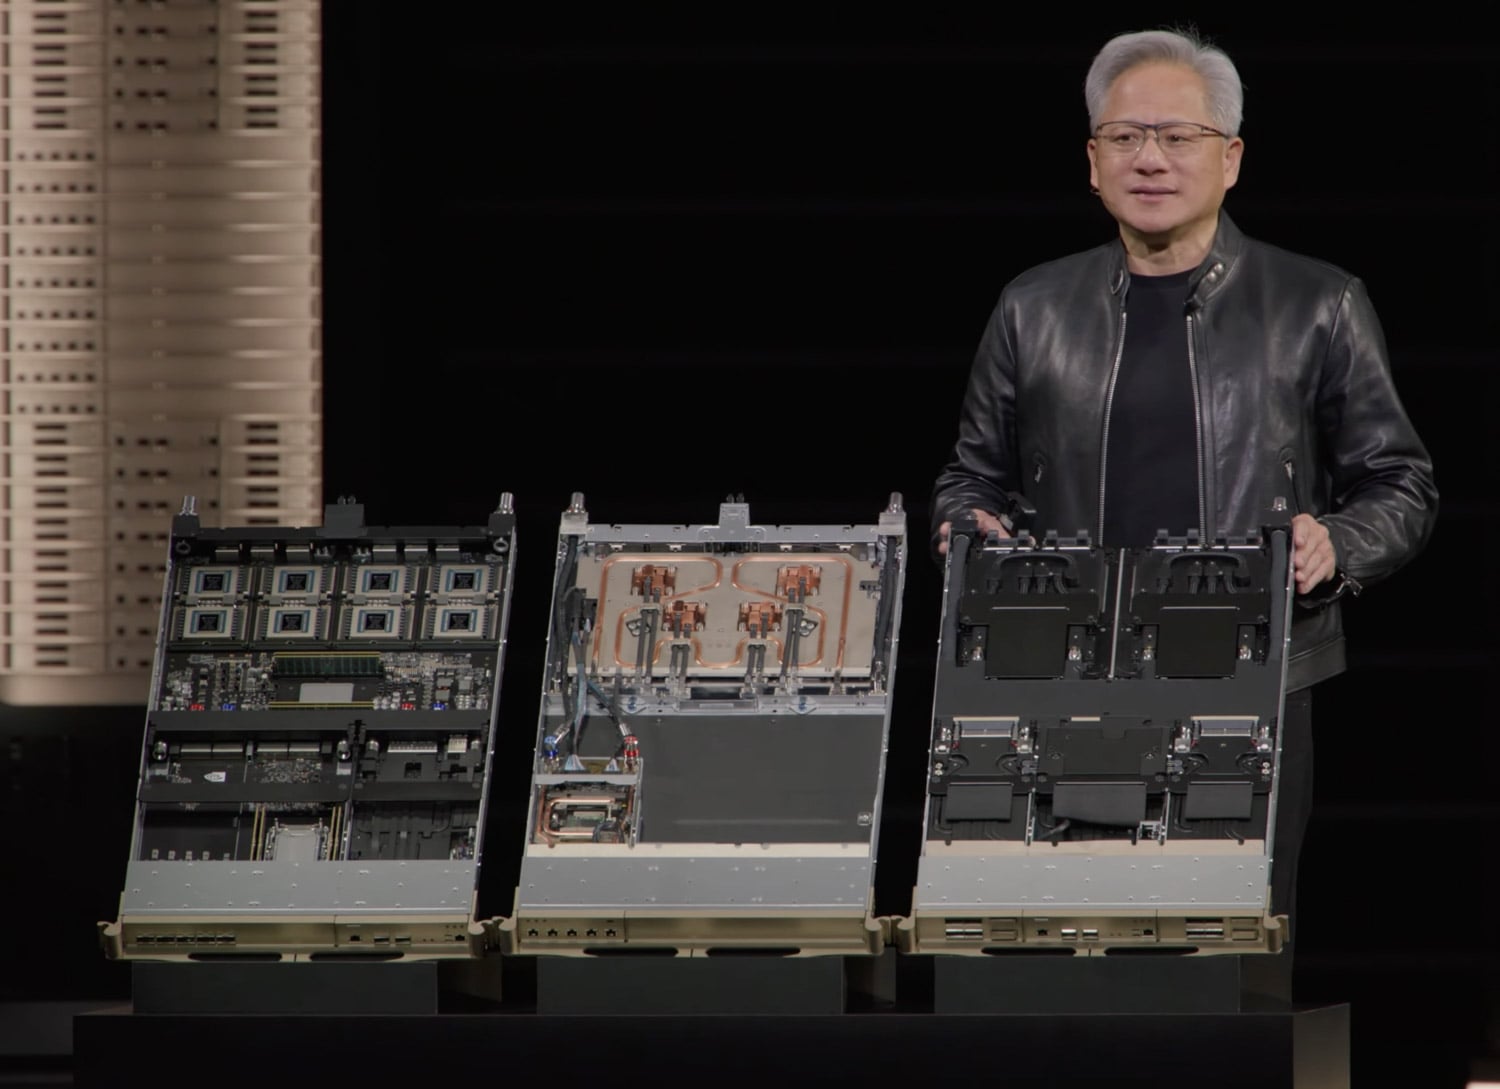
A5X-plattformen integrerar NVIDIA ConnectX-9 SuperNIC med Googles nästa generations Virgo-nätverksstack. Denna arkitektur möjliggör klusterskalning till 80 000 Rubin-GPU:er inom en enda plats och till 960 000 GPU:er över flera platser. Designen riktar sig mot hyperskaliga AI-tränings- och inferensmiljöer där nätverksprestanda och optimering på systemnivå är avgörande.
Google Cloud betonade att tätt integrerad infrastruktur och hanterade AI-tjänster krävs för att stödja nästa våg av AI-arbetsbelastningar. Den kombinerade stacken gör det möjligt för kunder att träna, finjustera och driftsätta modeller med fokus på prestanda, effektivitet och operativ skalbarhet.
Bred Blackwell-portfölj möjliggör rätt acceleration
Google Cloud presenterade också sin portfölj av NVIDIA Blackwell-baserade instanser, som spänner över ett brett spektrum av distributionsstorlekar och prestandaprofiler. Erbjudandena inkluderar A4 VMs baserade på NVIDIA HGX B200-system, A4X- och A4X Max-konfigurationer byggda på GB200- och GB300 NVL72-plattformarna, och fraktionerad GPU-åtkomst via G4-instanser med RTX PRO 6000 Blackwell Server Edition GPU: er.
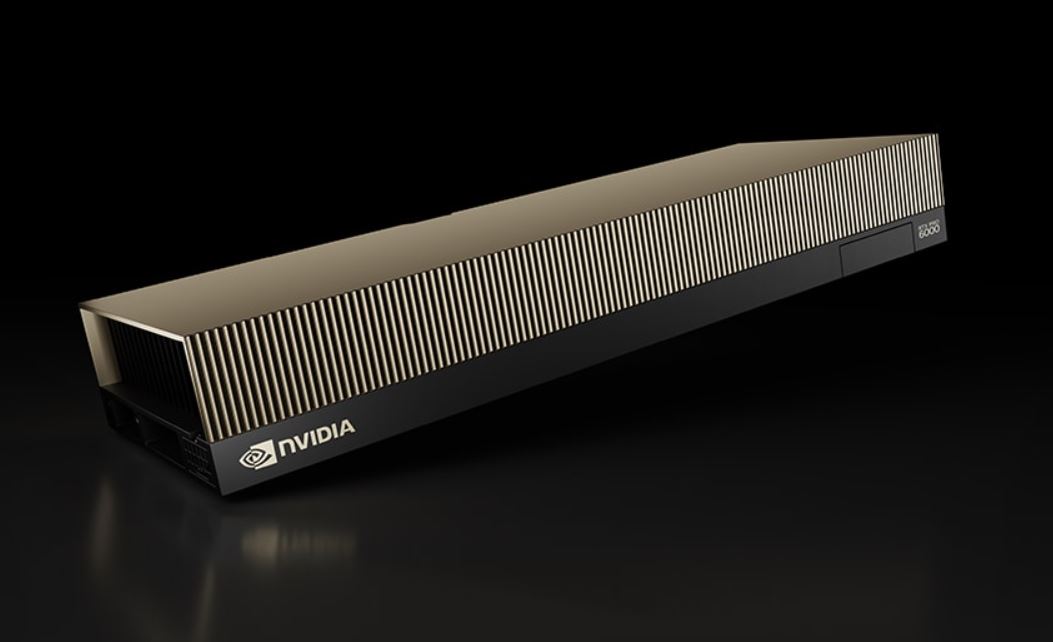
Detta sortiment gör det möjligt för organisationer att anpassa infrastrukturen till arbetsbelastningskraven. Konfigurationerna sträcker sig från fraktionerade GPU:er för lättare inferensuppgifter till fullständiga NVL72-rack med 72 GPU:er sammankopplade via femte generationens NVLink- och NVLink Switch-teknik. I den övre delen av segmentet kan implementeringar skalas upp till tiotusentals GPU:er för stormodellsträning och distribuerad inferens.
Dessa system är utformade för att stödja en rad olika AI-arbetsbelastningar, inklusive expertmixmodeller (MoE), multimodal inferens, storskalig databehandling och simuleringsarbetsbelastningar för robotik och fysisk AI.
Tidiga användare använder redan plattformen. Thinking Machines Lab använder GB300 NVL72 -baserade A4X Max-instanser för att skala utbildning för sitt Tinker API, medan OpenAI kör storskaliga inferensarbetsbelastningar, inklusive ChatGPT, på GB200- och GB300-baserade instanser på Google Cloud.
Konfidentiell AI utökas till Blackwell GPU:er
Google Cloud utökar konfidentiella databehandlingsfunktioner till sin AI-infrastruktur. Gemini-modeller som körs på NVIDIA Blackwell- och Blackwell Ultra-grafikprocessorer finns nu tillgängliga som förhandsvisning på Google Distributed Cloud, vilket gör det möjligt för organisationer att distribuera modeller närmare känsliga datakällor.
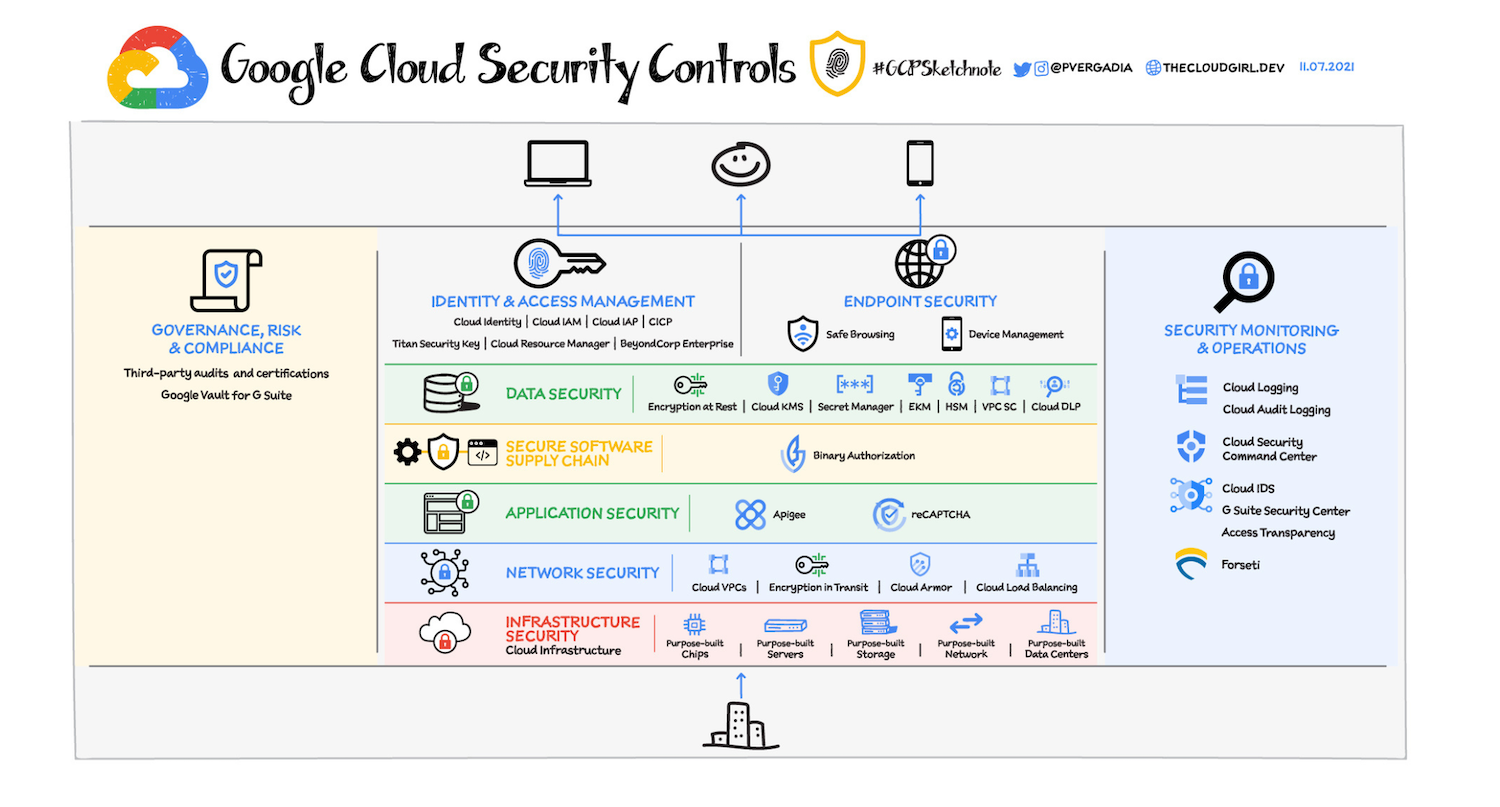
NVIDIA Confidential Computing möjliggör krypterade exekveringsmiljöer där prompter och finjustering av data förblir skyddade från obehörig åtkomst, inklusive från molnoperatörer. Denna funktion kommer också till miljöer med flera hyresgäster genom Confidential G4 VMs med RTX PRO 6000 Blackwell GPU:er.
Detta markerar den första implementeringen av konfidentiell databehandling för Blackwell GPU:er i det publika molnet, med inriktning på reglerade branscher som kräver strikt dataskydd samtidigt som åtkomst till högpresterande AI-infrastruktur bibehålls.
Öppna modeller och hanterade RL-pipelines för Agentic AI
Plattformen stöder ett brett modellekosystem, inklusive Googles Gemini- och Gemma-modeller och NVIDIAs öppna Nemotron-modeller. NVIDIA Nemotron 3 Super är nu integrerad med Gemini Enterprise Agent Platform, vilket gör det möjligt för utvecklare att bygga och driftsätta resonemangsdrivna agentarbetsflöden.
Google Cloud introducerar även Managed Training Clusters med ett API för förstärkningsinlärning byggt på NVIDIA NeMo. Denna tjänst automatiserar klusterprovisionering, jobborkestrering och felhantering, vilket möjliggör storskalig RL-utbildning. Målet är att minska driftskomplexiteten och låta team fokusera på modellbeteende och optimering.
CrowdStrike använder NVIDIA NeMo-verktyg, inklusive Data Designer, Automodel och Megatron Bridge, för att generera syntetisk data och finjustera domänspecifika cybersäkerhetsmodeller. Dessa arbetsflöden körs på Blackwell-baserad infrastruktur, vilket accelererar hotdetektering och responspipelines.
Utökade industriella och fysiska AI-arbetsbelastningar
Den gemensamma plattformen riktar sig även mot industriella och fysiska AI-användningsfall. Applikationer från Cadence och Siemens Digital Industries Software finns nu tillgängliga på Google Cloud med NVIDIA-acceleration, vilket stöder design-, simulerings- och tillverkningsarbetsflöden inom branscher som halvledare, fordonsindustrin, flyg- och rymdindustrin och tung utrustning.
NVIDIA Omniverse-bibliotek och Isaac Sim finns tillgängliga på Google Cloud Marketplace, vilket möjliggör utveckling av fysiskt noggranna digitala tvillingar och robotsimuleringspipelines. Dessa verktyg gör det möjligt för organisationer att simulera och validera system före driftsättning.
Dessutom kan NVIDIA NIM-mikrotjänster driftsättas på Vertex AI och Google Kubernetes Engine för att stödja arbetsbelastningar inom visuell AI och robotik. Dessa tjänster möjliggör funktioner som videoanalys i realtid, robotplanering och automatiserad databehandling.
Plattformsfokus: Från experiment till produktion
Uppdateringarna positionerar Google Cloud AI Hypercomputer som en fullstackplattform för att flytta AI-arbetsbelastningar från forskning till produktion. Med tätt integrerade beräknings-, nätverks-, mjukvaru- och säkerhetsfunktioner är plattformen utformad för att stödja storskaliga agentsystem, industriell automation och AI-applikationer i realtid.


 Amazon