

Deskside AI-system byggda på NVIDIAs GB10 har ett jobb, och de gör det bra: placera 128 GB enhetligt minne och en petaflop beräkningskapacitet på ett skrivbord tillräckligt nära personen som använder det för att iterationen ska vara omedelbar. Vad de saknar är en anslutning till den lagring som en organisation redan använder. Varje DGX Spark- och OEM-variant levereras med en enda kort M.2-kortplats, vilket begränsar den lokala kapaciteten till cirka 4 TB och placerar varje dataset, modell och kontrollpunkt på den maskinen utanför styrningen, åtkomstkontrollerna, säkerhetskopieringen och revisionsloggen som finns i datacentret. Multiplicera det med ett labb, en avdelning eller ett campus, och resultatet är dussintals isolerade 4 TB-öar, som var och en innehåller sin egen kopia av samma modeller och dataset, var och en bara så säker som skrivbordet den står på.
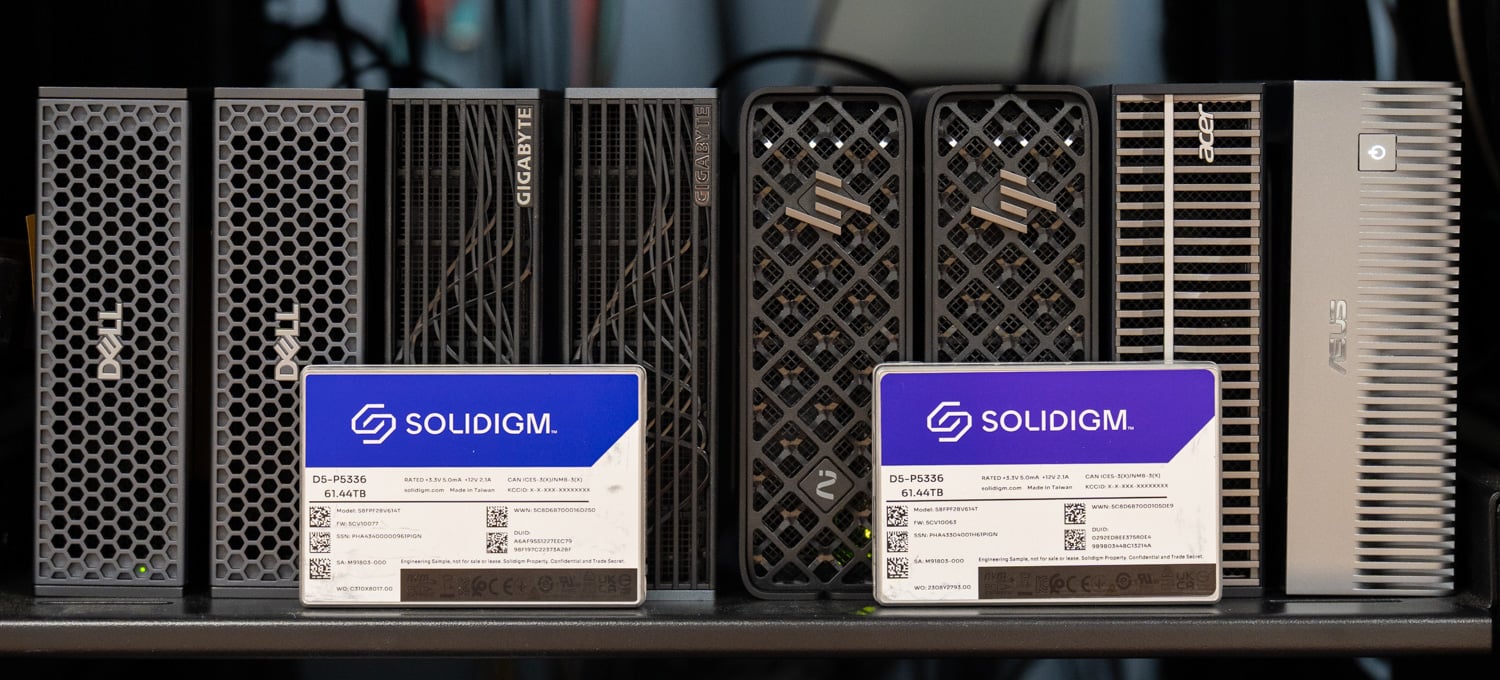
Det här projektet tar lagringsproblemet tillbaka till datacentret. Vi byggde en DGX Spark delad lagringsvärd från en Dell PowerEdge R770AP, åtta Solidigm D5-P5336 QLC SSD-diskar i Graid SupremeRAID RAID 5, Broadcom 400GbE-nätverk och Tuxera Fusion som hanterar NFS över RDMA, och anslöt sedan åtta Sparks till sina 100GbE-portar. Varje Spark på infrastrukturen monterar samma styrda, paritetsskyddade lagringspool med en linje; en enda kopia av varje modell och dataset hanterar dem alla, ingen arbetsstation behöver mer lagringsutrymme än den levereras med, och Sparks själva kan placeras i racket bredvid arrayen där de är enklare att säkra, kyla och dela. Poängen med den här versionen är där data finns, och vilken NVMe-server som helst med snabba nätverkskort skulle kunna spela rollen. Oregon State University, som utforskar ett storskaligt Spark-labb för AI-inlärning och vill ge studenter tillgång till forskningsdatauppsättningar mätta i tiotals terabyte, delade sina tankar med oss när vi utformade bygget, och för data i den skalan var delad lagring den metod som passade denna utvärdering.
Key Takeaways
- En array, åtta Sparks, ingen klientprogramvara: Åtta DGX Sparks från fem OEM-tillverkare monterar NFS/RDMA-delningar från en enda Solidigm D5-P5336 QLC-array bakom Graid SupremeRAID och Tuxera Fusion, över de 100 GbE-portar de redan har, med en enradsmontering på standard Ubuntu.
- Hostade modeller laddas som lokala modeller: En 78 GB Qwen3.5-122B-A10B-NVFP4-modell laddades från den delade arrayen på 269.6 sekunder på en Spark, inom 13 % av de 239.6 sekunder som samma Spark behövde från sin interna NVMe, och åtta Sparks som laddade samma enda kopia samtidigt slutförde mellan 232.8 och 326.5 sekunder.
- Ett exemplar ersätter en silo på varje skrivbord: Modeller och datamängder på styrd, paritetsskyddad datacenterlagring ersätter kopior per arbetsstation på 4 TB M.2-diskar, så utnyttjandet ökar, kopieringsdata minskar och inget Spark behöver en lagringsuppgradering eller en plats på ett skrivbord. För ett storskaligt AI-inlärningslabb som det Oregon State utforskar, där forskningsdatamängder uppgår till tiotals terabyte, är detta den metod som passar användningsfallet i vår utvärdering.
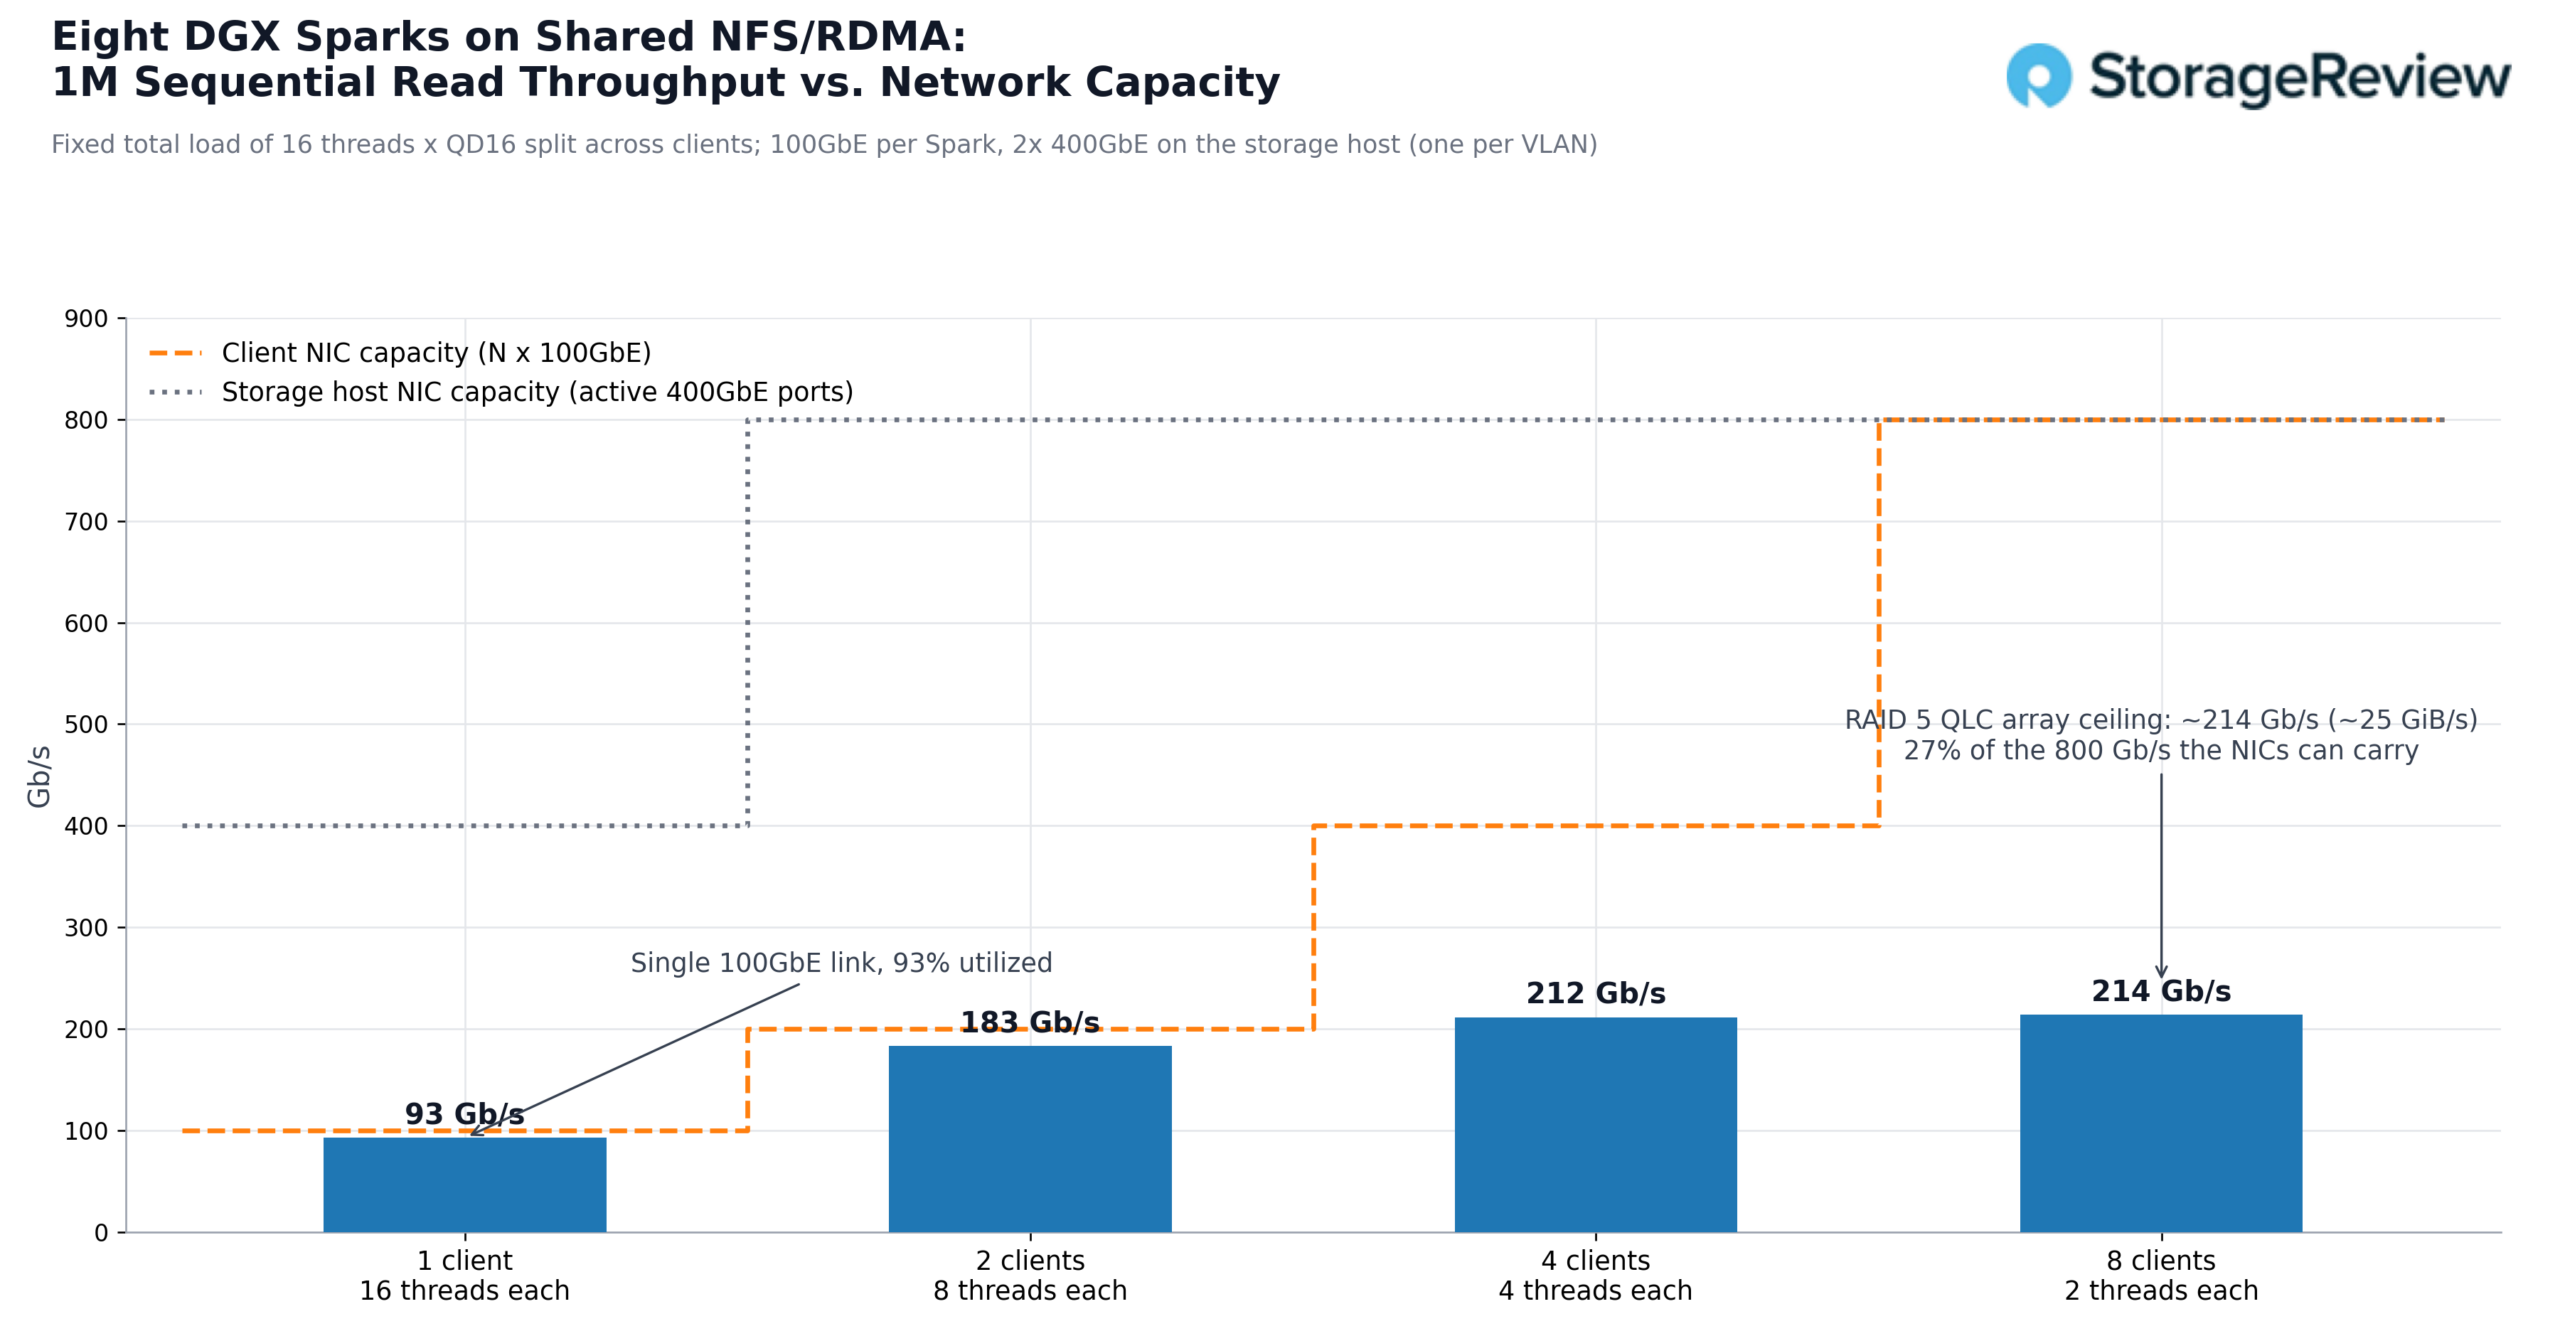
- Enheterna sätter taket, och nätverket har utrymme: Med alla åtta Sparks-avläsningar samtidigt nådde RAID 5-matrisen med åtta enheter en topphastighet på nära 25 GiB/s, cirka 214 Gb/s, vilket använde 27 % av de 800 Gb/s som de två Broadcom BCM57608-nätverkskorten i värden kan bära. En Spark-avläsning från matrisen på 10.8 GiB/s matchar den snabbaste interna M.2-hastigheten vi har uppmätt i ett GB10-system.
- Styrning kommer med protokollet: NFS med RDMA placerar mappar per användare, delade datauppsättningar och värdbaserade modeller i ett namnutrymme med Active Directory-, Kerberos- och LDAP-hooks, vilket gör att data förblir under datacenterkontroll medan Sparks flyttas in i racket.
Problemet med en AI-ö på varje skrivbord
DGX Spark och dess OEM-varianter från Dell, GIGABYTE, HP, Acer och ASUS delar alla GB10-plattformen och samma lagringstak. I vår ursprungliga DGX Spark-recension var lagring plattformens tydligaste begränsning. Den interna kortplatsen tar korta M.2-diskar, så de 8TB-klient-SSD-diskar som levereras i 2280-formfaktorn får inte plats fysiskt. Luisuantech GP Spark som vi recenserade i augusti svarar på det med ett M.2-kabinett med fyra fack som hänger på en 100GbE-port, vilket är en ren lösning för en Spark på ett skrivbord och, i labbskala, en större silo på varje skrivbord.
Kapacitet är halva problemet; den andra halvan är vad som händer med data när de väl landar på en stationär dator. En 78 GB-modell som dras ner till en Spark är en kopia som ingen inom IT kan se. En forskningsdatauppsättning som lagras på lokal flashminne är en kopia utanför säkerhetskopieringsschemat, utanför åtkomstpolicyn och utanför institutionella revisioner. Tio Sparks i ett labb betyder tio kopior av samma vikt som förbrukar 780 GB flashminne som skulle kunna användas till något annat, och tio platser där en datauppsättning kan komma ut genom dörren med maskinen. Problemet förvärras allt eftersom siffrorna växer, vare sig det gäller GB10-system eller någon annan stationär AI-infrastruktur. Varje organisation som har hanterat en flotta av bärbara datorer känner till detta mönster, och svaret var detsamma då: behåll data på delad lagring i datacentret och låt slutpunkten vara en slutpunkt.
Tack och lov designade NVIDIA Spark med portar för att få det att fungera. Varje enhet har två QSFP56-burar på en integrerad ConnectX-7, med ett plattformstak på 200 GB användbar bandbredd bakom ett par PCIe Gen5 x4-länkar. I vår DGX Spark-klustergranskning beskrev vi split-role-konfigurationen där en bur går till en peer Spark och den andra till lagring. Det här projektet använder en bur per Spark för lagring vid 100 GbE, vilket lämnar den andra fri för kluster eller ytterligare bandbredd. Vid 100 GbE har varje Spark cirka 12.5 GB/s teoretisk bandbredd till lagringsvärden, vilket överstiger bandbredden som tillhandahålls av den interna M.2-kortplatsen på de flesta av dessa system.
När datan finns i andra änden av den länken ändras Sparks roll. Den blir en beräkningsslutpunkt med en startenhet och en lokal cacheenhet, och kapaciteten är inte längre ett köp per arbetsstation. En modell eller dataset skrivs en gång och läses av varje klient, så lagringsutnyttjandet ökar och antalet kopior minskar. Dataskydd flyttas till en paritetsskyddad array i ett serverchassi, och åtkomstkontroll, kryptering i vila, säkerhetskopiering och granskning sker där de redan gör det för allt annat. Och eftersom Spark nu inte behöver något annat än ström och en 100 GbE-länk finns det ingen anledning att den måste stå på ett skrivbord alls. Rackad bredvid lagringsvärden är den svalare, tystare, fysiskt säker och tillgänglig för den som behöver den härnäst.
Lagringsvärden
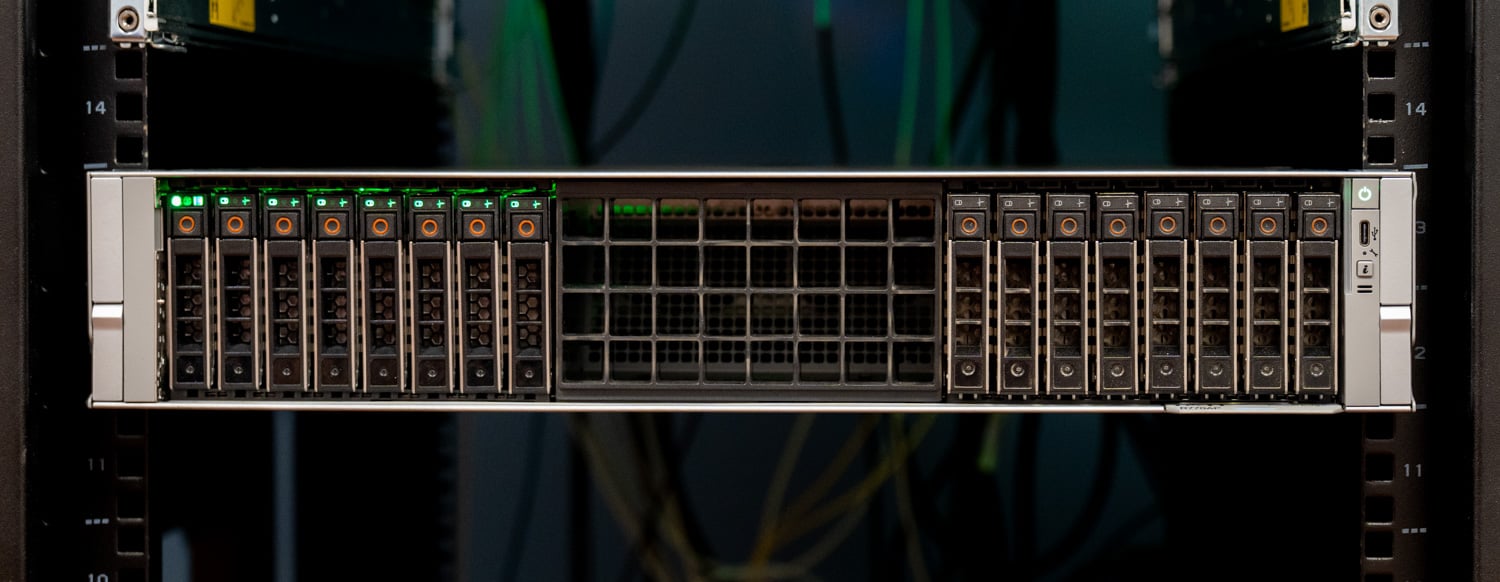
Lagringsvärden är en Dell PowerEdge R770AP , samma 2U Xeon 6-plattform som vi granskade tidigare i år, och vi använde den eftersom den var ledig i labbet när projektet startade. Vilken NVMe-server som helst med plats för snabba nätverkskort och en liten GPU skulle kunna fylla rollen, och R770AP är ett sätt att bygga den, även om den är lite överbyggd. Vår kör två Xeon 6 6978P-processorer med 1.5 TB DDR5 över 24 DIMM-moduler, använder en av sina två banker med åtta Gen5 NVMe-fack och hänger hårddiskarna och Graid GPU:n på CPU 0, med de två 400GbE-adaptrarna på CPU 1. Servern kör Ubuntu 24.04.
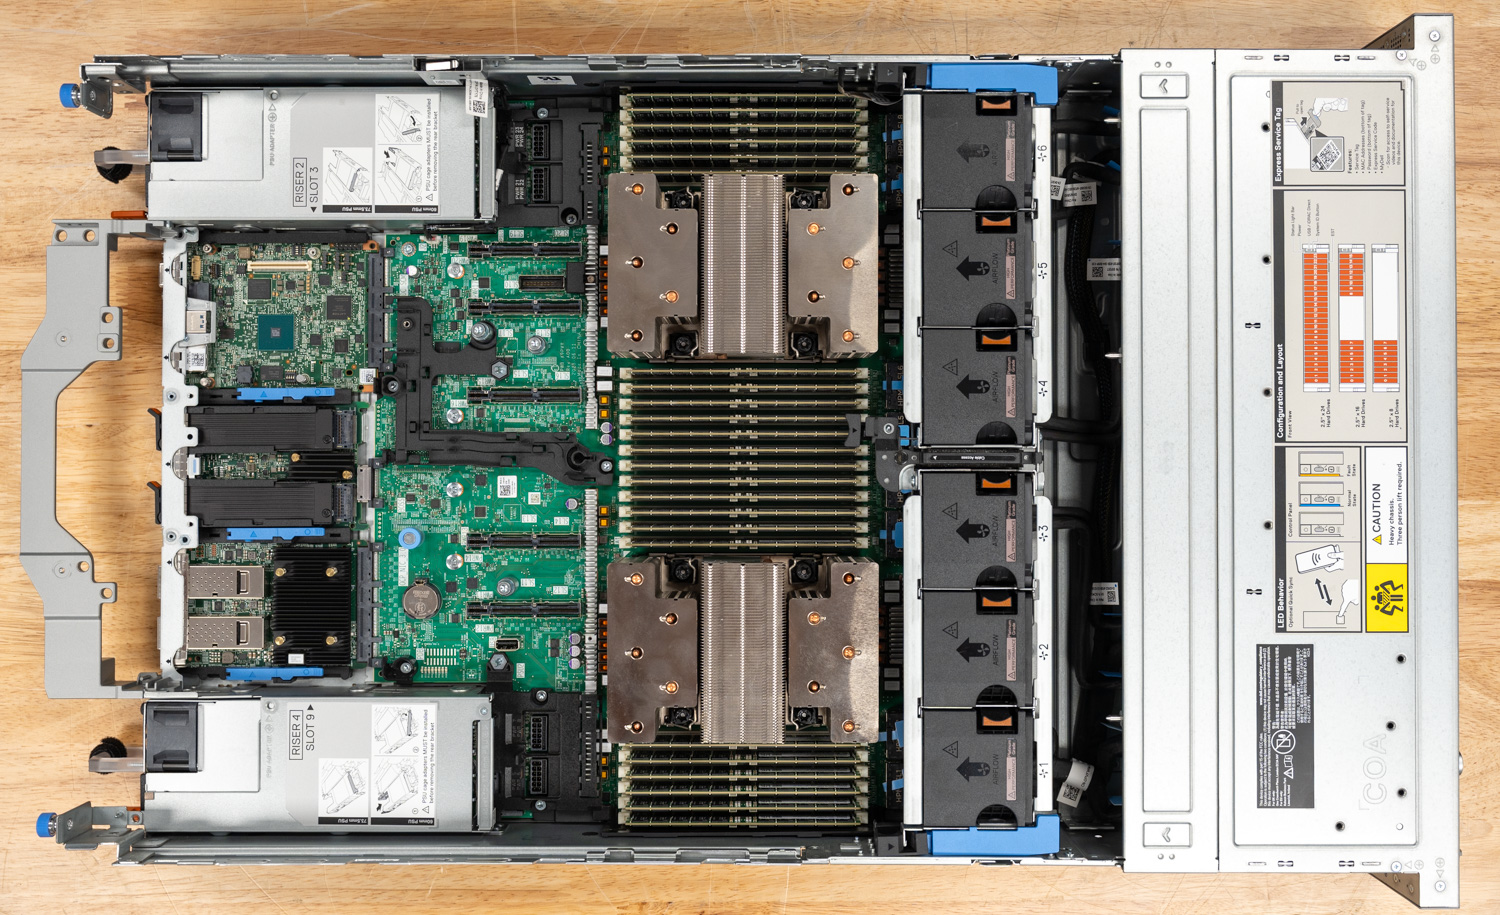
| Komponent | Konfiguration av lagringsvärd |
|---|---|
| server | Dell PowerEdge R770AP, 2U, 16x 2.5-tums Gen5 NVMe-fack |
| CPU | 2x Intel Xeon 6 6978P |
| Minne | 1.5 TB DDR5 (24x 64 GB) |
| lagring | 8x Solidigm D5-P5336 61.44TB U.2 PCIe 4.0 QLC (491.52TB rå) |
| RAID | Graid SupremeRAID, RAID 5 över alla åtta hårddiskar, NVIDIA RTX A2000 GPU på CPU 0 |
| FILSYSTEM | XFS på den virtuella SupremeRAID-enheten |
| Fil server | Tuxera Fusion (Fusion NFS, privat förhandsvisningsversion), NFS 4.1 över RDMA (RPC-RDMA på port 20049), användarläge |
| nätverk | 2x Broadcom BCM57608 (Thor 2) enkelports 400GbE, PCIe Gen5 x16 på CPU 1, RoCEv2 |
| Switch | Dell PowerSwitch Z9864F-ON, 64x 800 GbE OSFP112, Enterprise SONiC |
| Klientlänkar | 800G optik uppbruten till 8x100GbE, en länk per Spark, fyra Sparks per lagrings-NIC på separata VLAN |
| Klienter | 2x Dell Pro Max med GB10, 2x GIGABYTE AI TOP ATOM, 2x HP ZGX Nano G1n, Acer Veriton GN100, ASUS Ascent GX10 |
| OS | Ubuntu LTS 24.04 |
Varför QLC, och varför D5-P5336
I våra samtal med Oregon State om Spark-labbkonceptet var kapacitet det första kravet, eftersom de inblandade forskningsdataseten är stora. Serverns uppgift är att lagra allt som ett rum fullt av Sparks kan tänkas vilja ha, och att servera det i en form som kan läsas av många klienter samtidigt. Det är en läsintensiv profil med stora block och hög kapacitet, och det är den profilen som QLC byggdes för. D5-P5336- familjen sträcker sig från 7.68 TB till 122.88 TB; de 61.44 TB U.2-diskarna som används här är klassade av Solidigm för upp till 7 000 MB/s sekventiell läsning, 3 000 MB/s sekventiell skrivning, 1.005 miljoner slumpmässiga 4K-läs-IOPS och 65.2 PBW uthållighet, eller 0.58 diskskrivningar per dag under fem år, på 192-lagers QLC NAND med en 16KB indirektionsenhet.
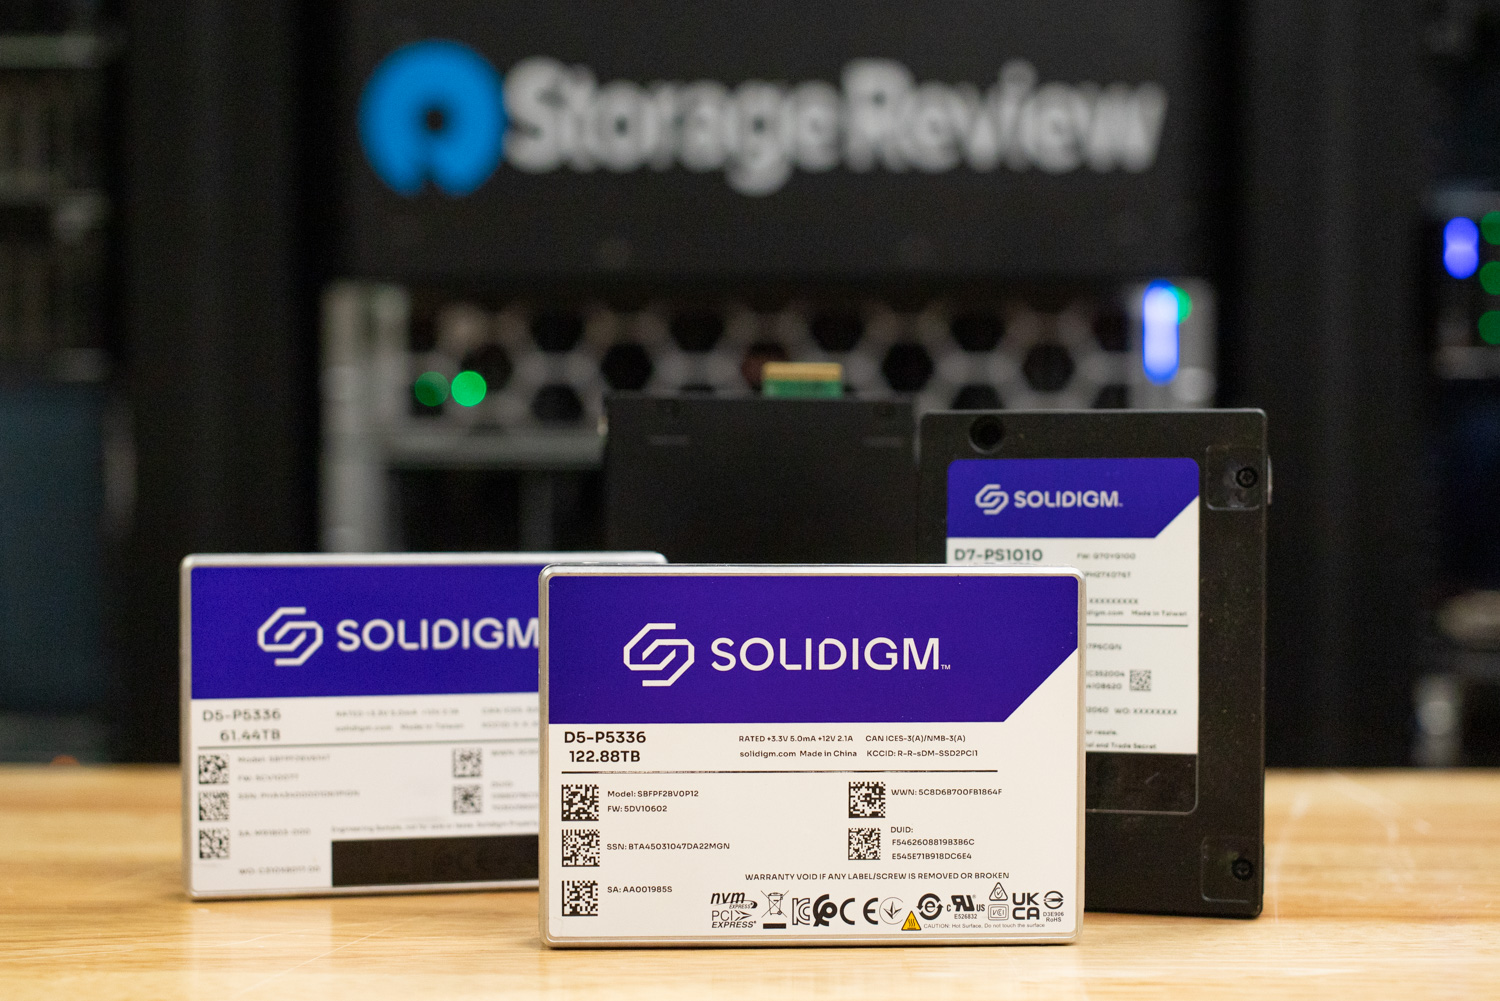
De åtta 61.44 TB-hårddiskarna fyller hälften av R770AP:s främre facks, och en produktionsversion skulle kunna utnyttja vilken kapacitetspunkt som helst i familjen och valfritt antal fack. Trots detta ger åtta hårddiskar i RAID 5 cirka 430 TB användbart utrymme med feltolerans för en enda hårddisk. Det är mer än 100 gånger vad en Sparks M.2-kortplats rymmer och tillräckligt för en avdelnings modellbibliotek, de delade datamängderna som studenterna arbetar från och hemkataloger per användare. Att fylla de övriga åtta facken fördubblar det utan att det påverkar nätverksdesignen, och storlekssiffrorna senare i den här recensionen visar varför hårddiskarna är den del som växer.
Den indirekta enheten på 16 kB är viktig för denna arbetsbelastning eftersom Solidigms större IU byter låg effektivitet för slumpmässig skrivning mot densitet och kostnad, och för en delning som hanterar modeller och datamängder är små slumpmässiga skrivningar en minoritet. Modellinläsning är stora sekventiella läsningar. Strömmande datamängder är stora sekventiella läsningar. Kontrollpunkter och studentfiler skrivs en gång och läses ofta. Arbetsfördelningen som följer av detta är den rätta för ett Spark-labb: den delade QLC-matrisen innehåller allt som läses av många, och Sparks egen M.2 hanterar scratch- och swap-trafiken som skrivs av en.
RAID på en GPU: Graid SupremeRAID
NVMe RAID på åtta Gen4-diskar, som var och en kan läsa med en hastighet av 7 000 MB/s, är den punkt där ett konventionellt RAID-kort för hårdvara blir flaskhalsen eftersom varje byte måste passera genom kortets PCIe-kortplats. Programvaru-RAID står inför en annan uppsättning resursutmaningar. Graid SupremeRAID avlastar paritetsberäkningar till en GPU och håller datasökvägen på värdens PCIe-banor, vilket är anledningen till att vi har sett det skala till mer än 180 GB/s i våra SupremeRAID AE-tester med 16 diskar. För den här värden körde vi SupremeRAID på en NVIDIA RTX A2000, en liten arbetsstations-GPU.
De åtta D5-P5336-diskarna raderades säkert och fylldes sekventiellt innan de överlämnades till Graid, och konfigurerades sedan som en enda RAID 5-array. Den resulterande virtuella disken formaterades med XFS och hanterades av Tuxera. RAID 5 är rätt nivå för en delning som denna: ett diskfel håller arrayen online, ombyggnader sker utan att användardata tas offline, och kapacitetsförlusten är en disk av åtta. RAID 6 eller RAID 10 skulle vara rimliga val för en produktionsdistribution som värdesätter skydd i ombyggnadsfönstret framför kapacitet, och SupremeRAID stöder båda.
Nätverket: Broadcom 400GbE och en 800G-kärna
Lagringssidan av strukturen består av två Broadcom BCM57608 Thor 2-adaptrar i R770AP, var och en ett 400GbE-nätverkskort med en port på ett PCIe Gen5 x16-gränssnitt. Broadcom positionerar BCM57608 som branschens 400G-nätverkskort med lägst strömförbrukning, och dess funktioner gör det till en bra lösning: RoCEv2 med förbättrad DCQCN-överbelastningskontroll, adaptiv routing, säker start med en kiselrot förtroende och inline kTLS-krypteringsavlastning. RoCEv2 överför NFS över RDMA i denna design, och överbelastningskontroll förhindrar att flera klienter trampar på varandra när de alla börjar dra samtidigt. Under bygget rapporterade bnxt_en-drivrutinen att de optiska modulerna på 400G-portarna nådde sin varningströskel på 70C under ihållande belastning. Vi åtgärdade detta med en liten fläktprofilförskjutning på R770AP, och nätverkskorten kördes utan problem därefter.
Båda nätverkskorten landar på en Dell PowerSwitch Z9864F-ON , vårt labbs 800G-kärnswitch, som kör Enterprise SONiC. Z9864F-ON har 64 OSFP112-portar vid 800GbE och bryter ut vilken som helst av dem till 2x400G, 4x200G eller 8x100G. En 800G-optik utbruten till 8x100G ansluter de åtta Sparks, en länk vardera, till samma switch som avslutar de två 400G-lagringslänkarna. Varje 400G-nätverkskort sitter på sitt eget VLAN och betjänar fyra Sparks, så lagringsvärden presenterar två RDMA-mål, och belastningen fördelas jämnt mellan dem enligt designen. I praktiken är detta en fullhastighetstopologi: 8x100G klientbandbredd på ena sidan, 2x400G lagringsbandbredd på den andra, och en switch med 102.4 Tbps kapacitet i mitten.
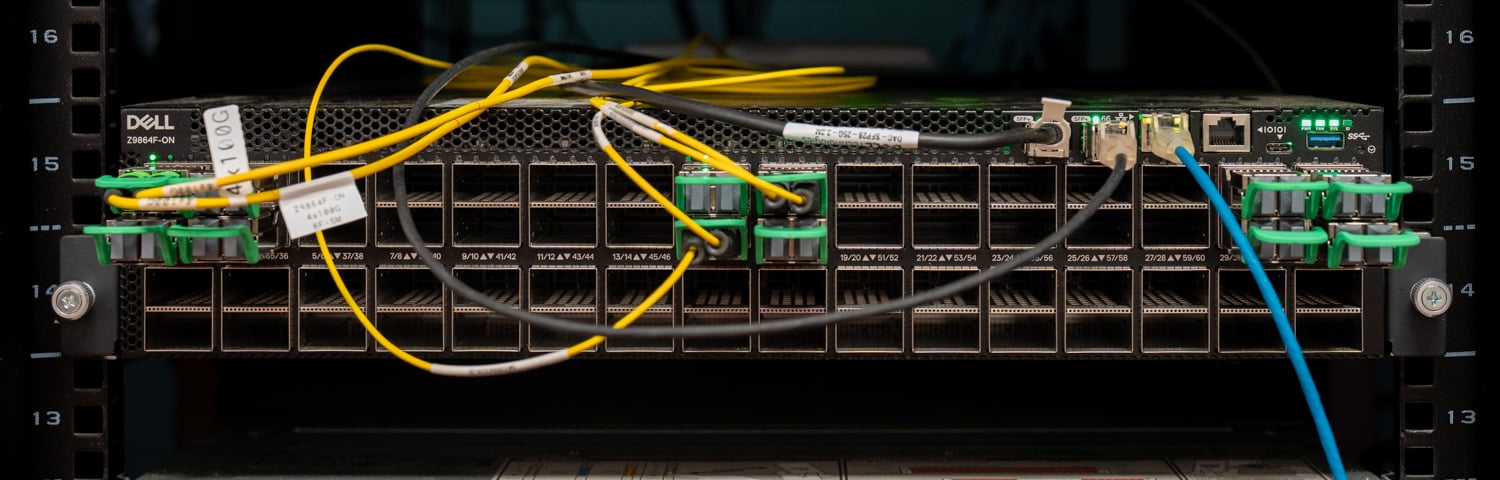
Vi validerade strukturen innan någon lagringsprogramvara rörde den. Server-till-server-tester mellan R770AP och en andra värd över 400G-länkarna kördes med linjehastighet i båda riktningarna, och RDMA-trafik från Sparks bekräftade att 100G-breakoutportarna fungerade med full hastighet. När Tuxeras ingenjörer hade NFS-delarna uppe visade iperf3 från Sparks till deras respektive nätverkskort en rena 99 Gbps bibehållen med fyra parallella strömmar och noll återsändningar.
Varför NFS och varför Tuxera
Med Graid som presenterar en snabb blockenhet skulle lagringsvärden kunna fungera som antingen NVMe-oF-blockmål eller fildelningar för Sparks. Vi testade blocksökvägen i GP Spark-recensionen, och den fungerar bra för en klient. För ett labb med många Sparks ville vi ha något annat. Blockvolymerna är en-till-en; varje användare skulle behöva en LUN, och i det ögonblick två användare vill ha samma dataset kopierar man den, vilket är problemet som hela denna design finns för att eliminera. NFS är mitten av Venn-diagrammet: ett enda namnutrymme innehåller delade dataset, värdbaserade modeller och mappar per användare. Varje Spark-montering använder NFS-klienten som redan finns i Ubuntu, och Kubernetes- och Slurm-verktygen som ett universitet skulle lägga ovanpå ett Spark-labb talar alla NFS.
Fusion NFS är NFS-halvan av Tuxera Fusion, multiprotokollfilservern som täcker SMB och NFS på en användarlägesbaserad, flertrådad kärna. Vi tittade först på Fusion SMB i ett Solidigm- och Tuxera-mediaarbetsflödesprojekt 2024. Tuxera hävdar upp till 22.7 GB/s över en enda 200 GbE-anslutning med RDMA, över kärnans NFSD och Ganesha i företagets egna tester, och produkten stöder NFS 4.1, aktiv-aktiv skalbar klustering, transparent redundans och Active Directory-, Kerberos- och LDAP-integration. Den sista uppsättningen är styrningskroken: samma katalog som styr vem som kan logga in på Spark styr också vad de kan se på delningen. En varning gäller för varje Tuxera-nummer i den här artikeln: versionen vi körde är en privat förhandsvisning av Fusion NFS som Tuxera säger inte har optimerats helt för prestanda, och programvaran är ännu inte tillgänglig för kommersiell försäljning. Allmän tillgänglighet är planerad till november, efter SC'26.
Tuxera installerade Fusion på R770AP, formaterade Graid-volymen med XFS och konfigurerade servern med NFS på standardporten och RPC-RDMA på port 20049, vilket utelämnade SMB-lyssnare eftersom det här projektet endast är NFS-baserat. Den initiala trådkonfigurationen var fyra protokolltrådar, var och en med åtta trådar för transport, sändning och mottagning, VFS-data och VFS-metadata, vilket Tuxera beskriver som en utgångspunkt för finjustering. Katalogtjänster utelämnades medvetet från labbet; en universitetsdistribution skulle lägga sina egna identitetstjänster ovanpå. På Spark-sidan är montering av delningen ett kommando:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
Den raden är hela klientintegrationen, utan drivrutin, initiatorkonfiguration och leverantörsprogramvara på Spark. En användare som loggar in på en annan Spark imorgon kör samma rad och ser samma filer.
Bevis på konfiguration: Åtta gnistor på en datauppsättning
Innan något modellarbete utfördes körde vi en sanity check på varje Spark individuellt: en 1M sekventiell fio-läsning med 16 jobb och ett ködjup på 16 mot dess egen mapp på arrayen. De åtta enheterna returnerade mellan 10.0 och 11.2 GiB/s, vilket mättade 100GbE-länken på var och en. Vi körde sedan en scanning för att bevisa att alla åtta kunde hålla sin del av belastningen. Varje körning håller 16 fasta trådar med ett ködjup på 16 totalt och sprider dem över en, två, fyra och åtta Sparks, över 1M sekventiella, 64K slumpmässiga, 16K sekventiella och 4K slumpmässiga arbetsbelastningar, med läsning och skrivning, direkt I/O, 60 sekunder per test. Varje Spark skriver till sin egen mapp på arrayen, fyra per lagrings-NIC, och det finns ingen QoS någonstans i stacken. Med alla åtta laddade samtidigt varierade 1 miljon sekventiella läsningar per enhet från 3.09 till 3.13 GiB/s, 64 000 slumpmässiga läsningar från 6 648 till 6 779 IOPS och 4 000 slumpmässiga skrivningar från 2 136 till 2 155 IOPS, över fem OEM-tillverkare på två VLAN utan rättvisekrav. Varje Spark nådde arrayen, varje Spark fick en jämn fördelning och konfigurationen var redo för den arbetsbelastning som räknas.
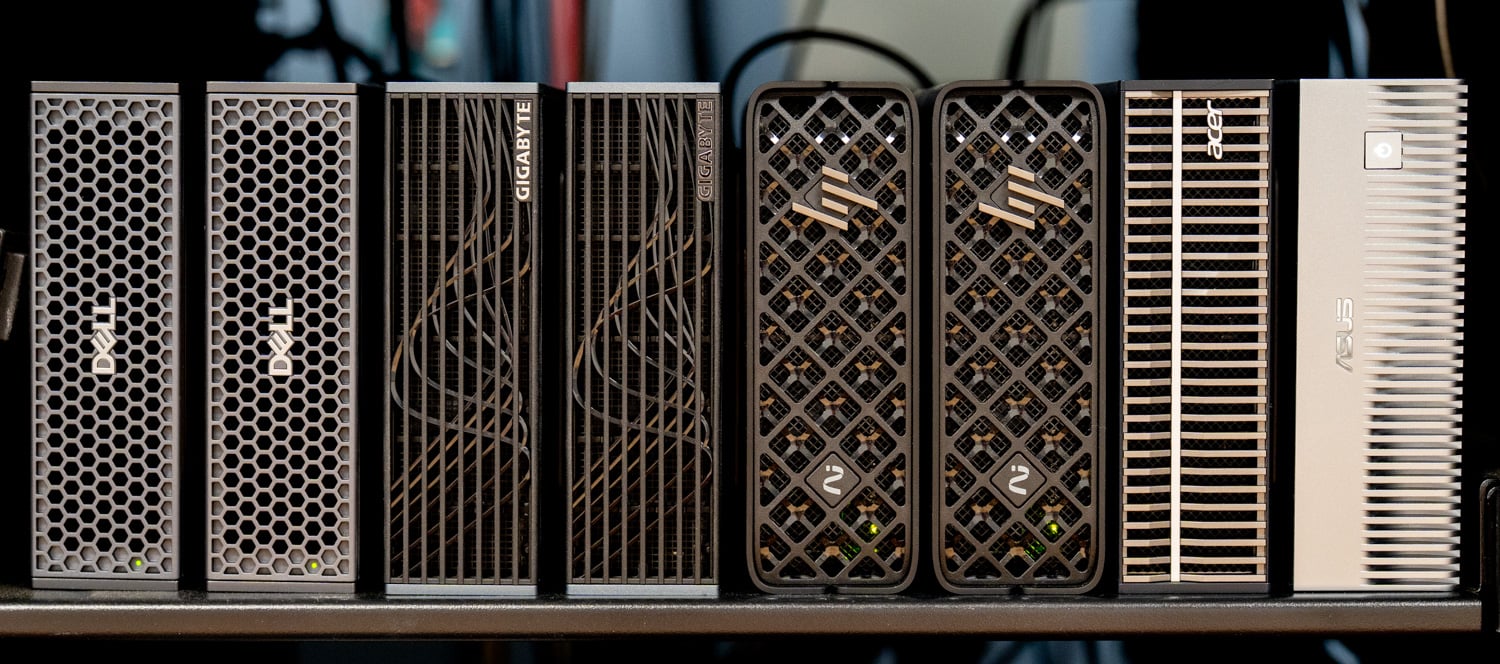
| Spark (åtta klienter, 2 trådar x QD16 vardera) | Lagrings-NIC | 1M sekventiell läsning | 64K Random Read IOPS | 4K Random Read IOPS | 4K Random Write IOPS |
|---|---|---|---|---|---|
| Dell Pro Max med GB10 (1) | 1 | 3,176 MB/s | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI TOP ATOM (1) | 1 | 3,195 MB/s | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201 MB/s | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | 3,194 MB/s | 6,670 | 10,100 | 2,149 |
| Dell Pro Max med GB10 (2) | 2 | 3,184 MB/s | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI TOP ATOM (2) | 2 | 3,187 MB/s | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189 MB/s | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | 3,163 MB/s | 6,734 | 10,300 | 2,145 |
Storleksanpassa värden: Två nätverkskort och gott om utrymme
Samma svep besvarar frågan som ett labb eller ett företag måste ställa sig innan de köper: var ligger taket, och vilken del av värden sätter det? De fyra panelerna nedan visar läsdataflödet över alla fyra arbetsbelastningarna när den fasta belastningen skalas från en Spark till åtta; skrivsidan täcks av texten och tabellen längre ner.
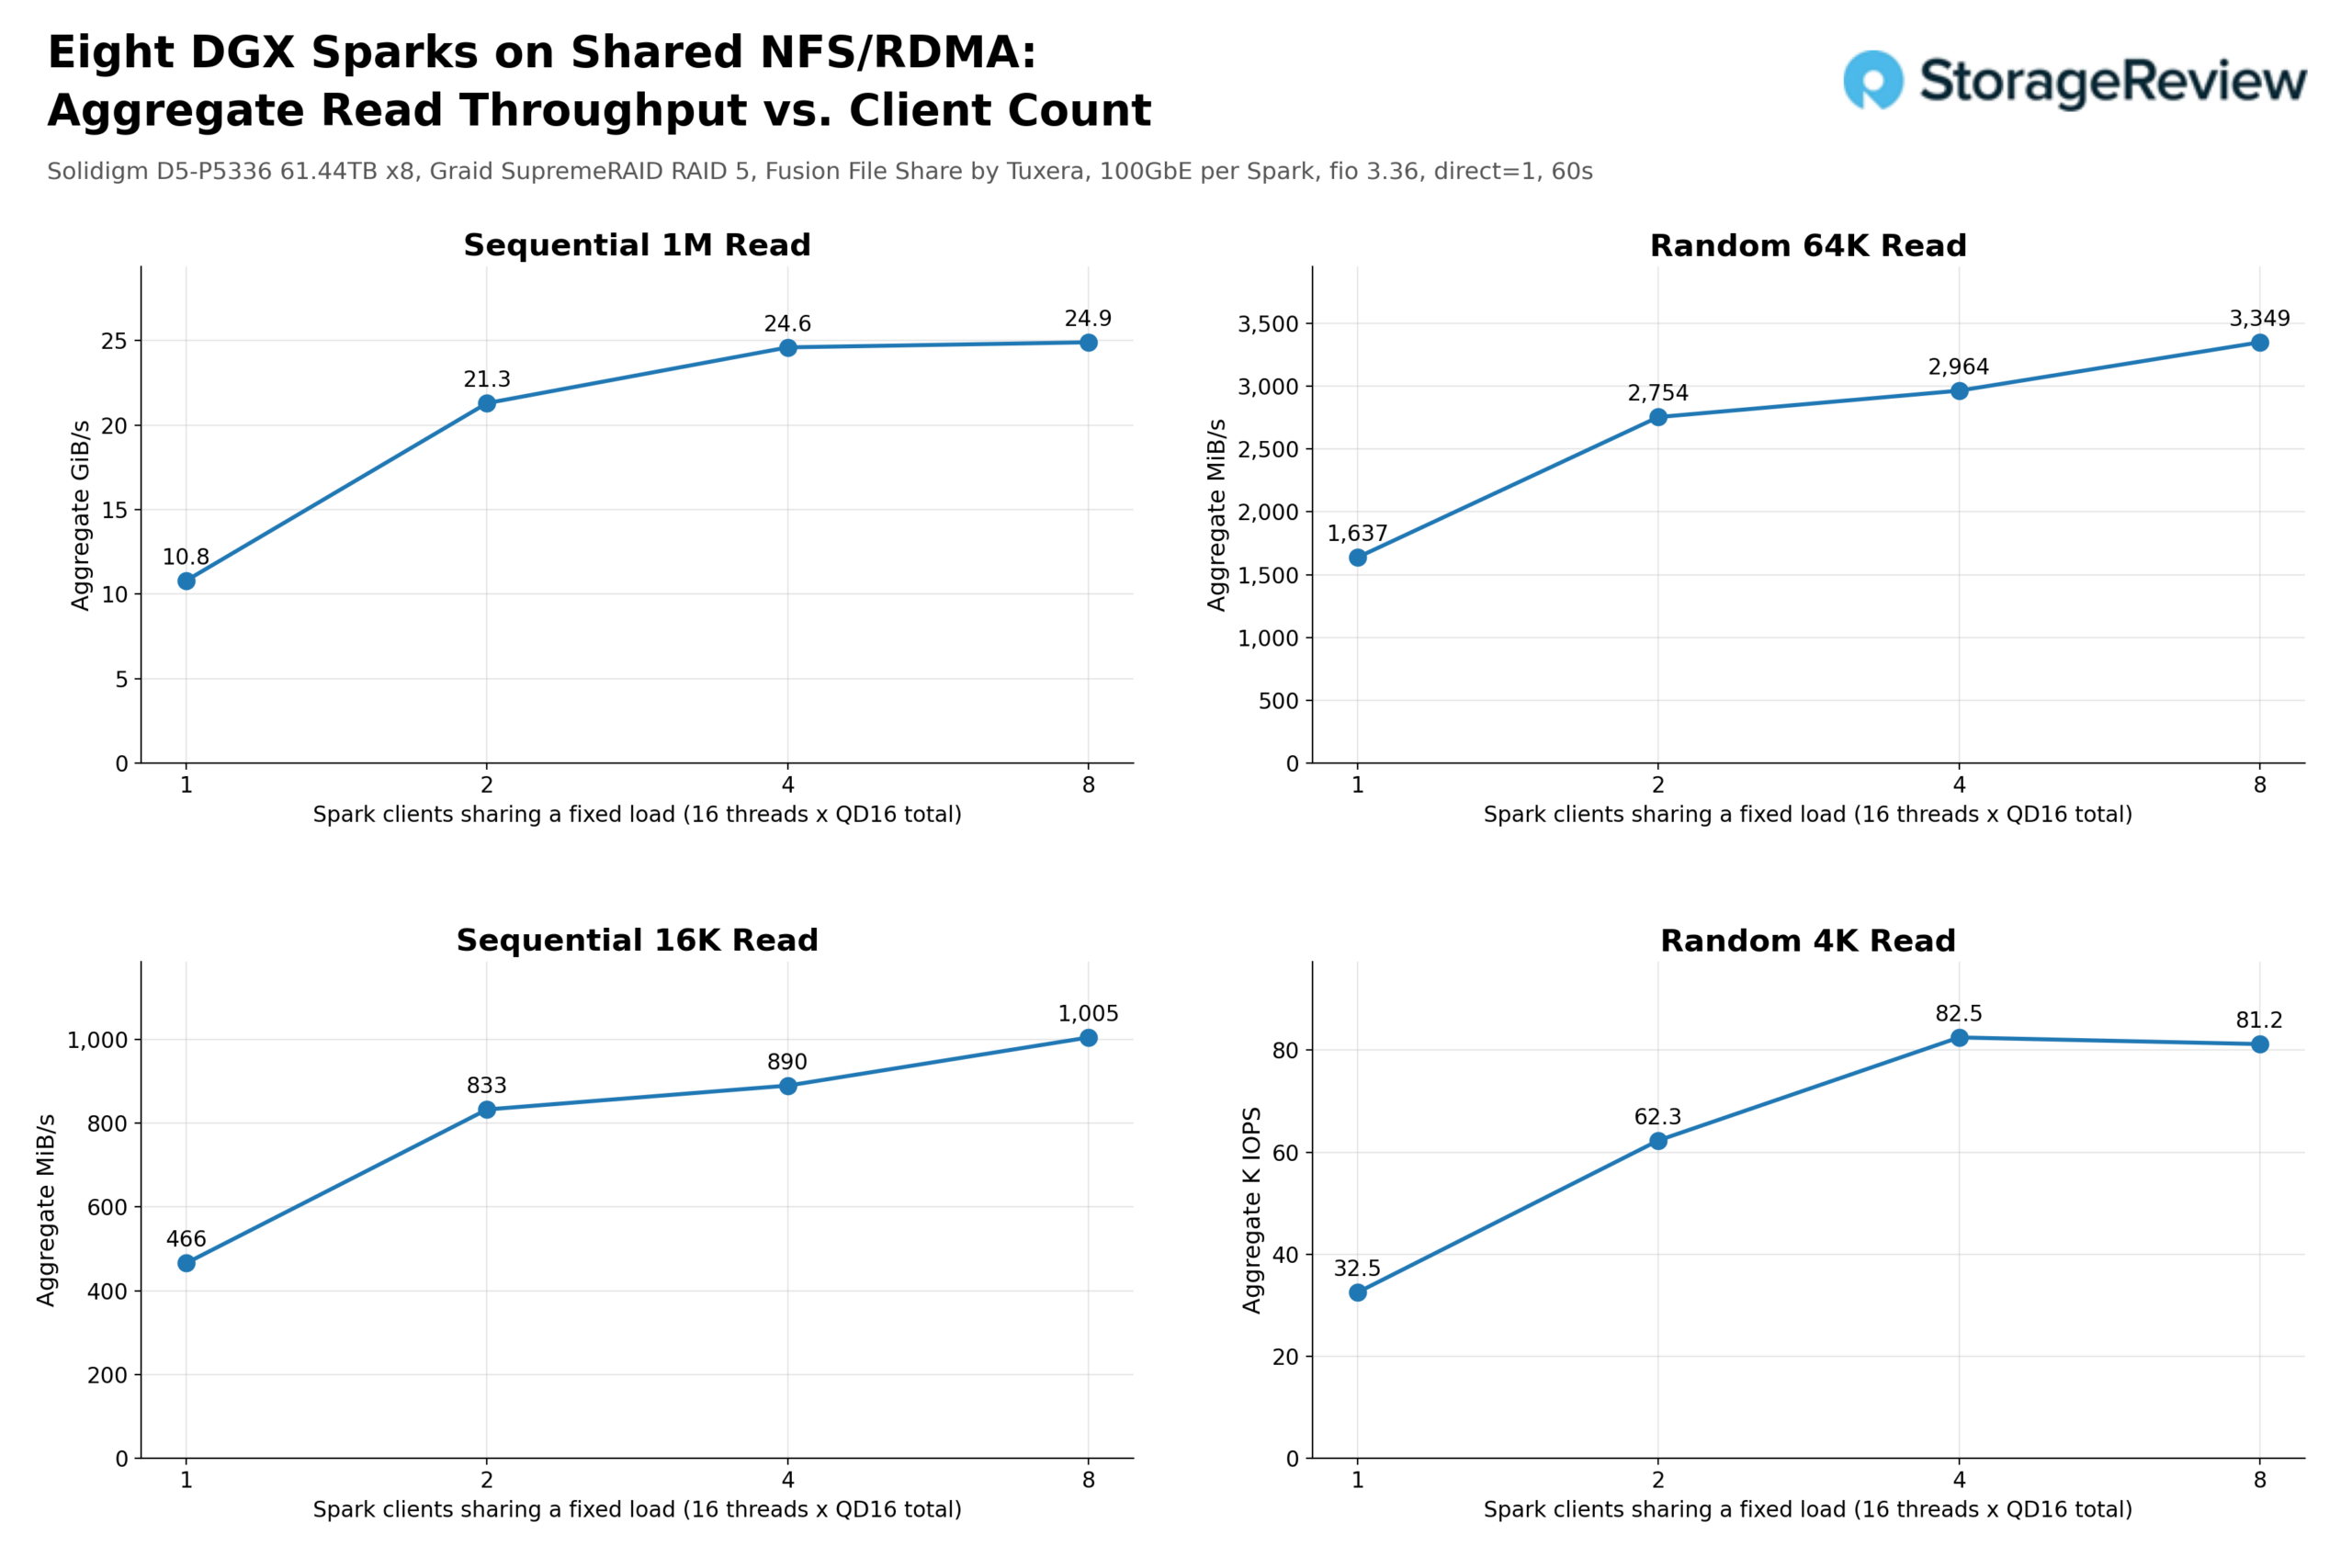
Den sammanlagda sekventiella läshastigheten på 1 Mb ökade från 10.8 GiB/s på en Spark till 21.3 GiB/s på två, 24.6 GiB/s på fyra och 24.9 GiB/s på åtta. Nätverksmässigt är det 93 Gb/s, 183 Gb/s, 212 Gb/s och 214 Gb/s jämfört med de 800 Gb/s som de två Broadcom 400 GbE-nätverkskorten kan bära, så vid full belastning på åtta klienter använde matrisen 27 % av värdens nätverkskapacitet. Platån nära 25 GiB/s tillhör RAID 5 QLC-matrisen med åtta enheter; nätverkskorten, switchen och Sparks egna 100 GbE-länkar blev aldrig gränsen.
Två serversidesnätverkskort täcker redan åtta Sparks med linjehastighet, och de skulle även täcka de andra åtta facken i R770AP: att fördubla antalet hårddiskar, oavsett om det är en andra array eller en bredare RAID-uppsättning, ger mer läsbandbredd bakom samma två portar, med utrymme att spara. Detsamma gäller för I/O. 4K slumpmässiga läsningar skalades från 32.5K IOPS på en klient till en platå på cirka 81K IOPS på fyra klienter och mer, med latens per I/O som sjönk från 7.9ms till 3.1ms allt eftersom varje klients kö blev grundare, och 64K slumpmässiga läsningar gick från 1 637 till 3 349 MiB/s, med nätverket långt under sin gräns i båda fallen.
Den andra jämförelsen som är viktig är mot den lagring som en Spark redan har. I våra individuella GB10-recensioner läser GDSIO 1M från den interna M.2-enheten nära 11.2 GiB/s på Acer Veriton GN100 och GIGABYTE AI TOP ATOM. Dell Pro Max med GB10 och HP ZGX Nano G1n nådde runt 5.5 GiB/s, medan ASUS Ascent GX10 närmade sig 5 GiB/s. Som jämförelse levererade Luisuantech GP Sparks externa NVMe-oF-enhet 9.5 GB/s över samma 100 GbE-port. En enda Spark-läsning från den delade QLC-arrayen på 10.8 GiB/s matchar de snabbaste interna hårddiskarna i den gruppen och fördubblar ungefär den långsammaste, över en kabel, från data som alla andra Spark-enheter också kan läsa. Verktygen skiljer sig åt: GDSIO på de interna hårddiskarna och fio över NFS här, så detta är en jämförelse av intervall.
Den fullständiga översikten visas nedan, med aggregerade siffror för alla fyra arbetsbelastningar vid varje klientantal. Varje läsrad ökar med klientantalet tills arrayen får slut på utrymme, och varje skrivrad förblir platt från en Spark till åtta, eftersom RAID 5-paritetsvägen håller arrayen vid ett fast skrivtak oavsett hur många klienter som delar den. För en resurs som är byggd för att läsas av många och skrivas en gång vid inmatning, är det den profilen som designen är byggd för.
| Aggregerat (totalt 16 trådar) | 1 Spark | 2 gnistor | 4 gnistor | 8 gnistor |
|---|---|---|---|---|
| 1M sekventiell läsning | 10.8 GiB/s | 21.3 GiB/s | 24.6 GiB/s | 24.9 GiB/s |
| 1M sekventiell skrivning | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s |
| 64K slumpmässig läsning | 1,637 MB/s | 2,754 MB/s | 2,964 MB/s | 3,349 MB/s |
| 64K slumpmässig skrivning | 722 MB/s | 719 MB/s | 723 MB/s | 703 MB/s |
| 16K sekventiell läsning | 466 MB/s | 833 MB/s | 890 MB/s | 1,005 MB/s |
| 16K sekventiell skrivning | 57 MB/s | 60 MB/s | 62 MB/s | 28 MB/s |
| 4K slumpmässig läsning | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| 4K slumpmässig skrivning | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
Hostingmodeller på delad lagring
Fio-svepet bevisar att arrayen och nätverket är mer än kapabla. Nästa test som är viktigt för användningsfallet är om en modell som lever på den delade arrayen laddas lika bra som en modell som lever på Sparks egen NVMe, eftersom det är arbetsflödet som hela designen är beroende av: en kopia, centralt värd, laddad av vem som helst. Vi valde Qwen3.5-122B-A10B i NVFP4, en modell med 122 miljarder parametrar och en blandning av experter som tar 78 GB på disk och får plats i ett enda Sparks 128 GB enhetligt minne. Vi mätte tiden från att starta inferensservern till att servern rapporterade fel, tillsammans med den genomsnittliga lagringsbandbredden över det fönstret, i tre scenarier: en Spark-laddning från sin interna NVMe, samma Spark-laddning över NFS/RDMA från den delade arrayen, och alla åtta Sparks-laddningar av samma enda kopia från arrayen samtidigt.
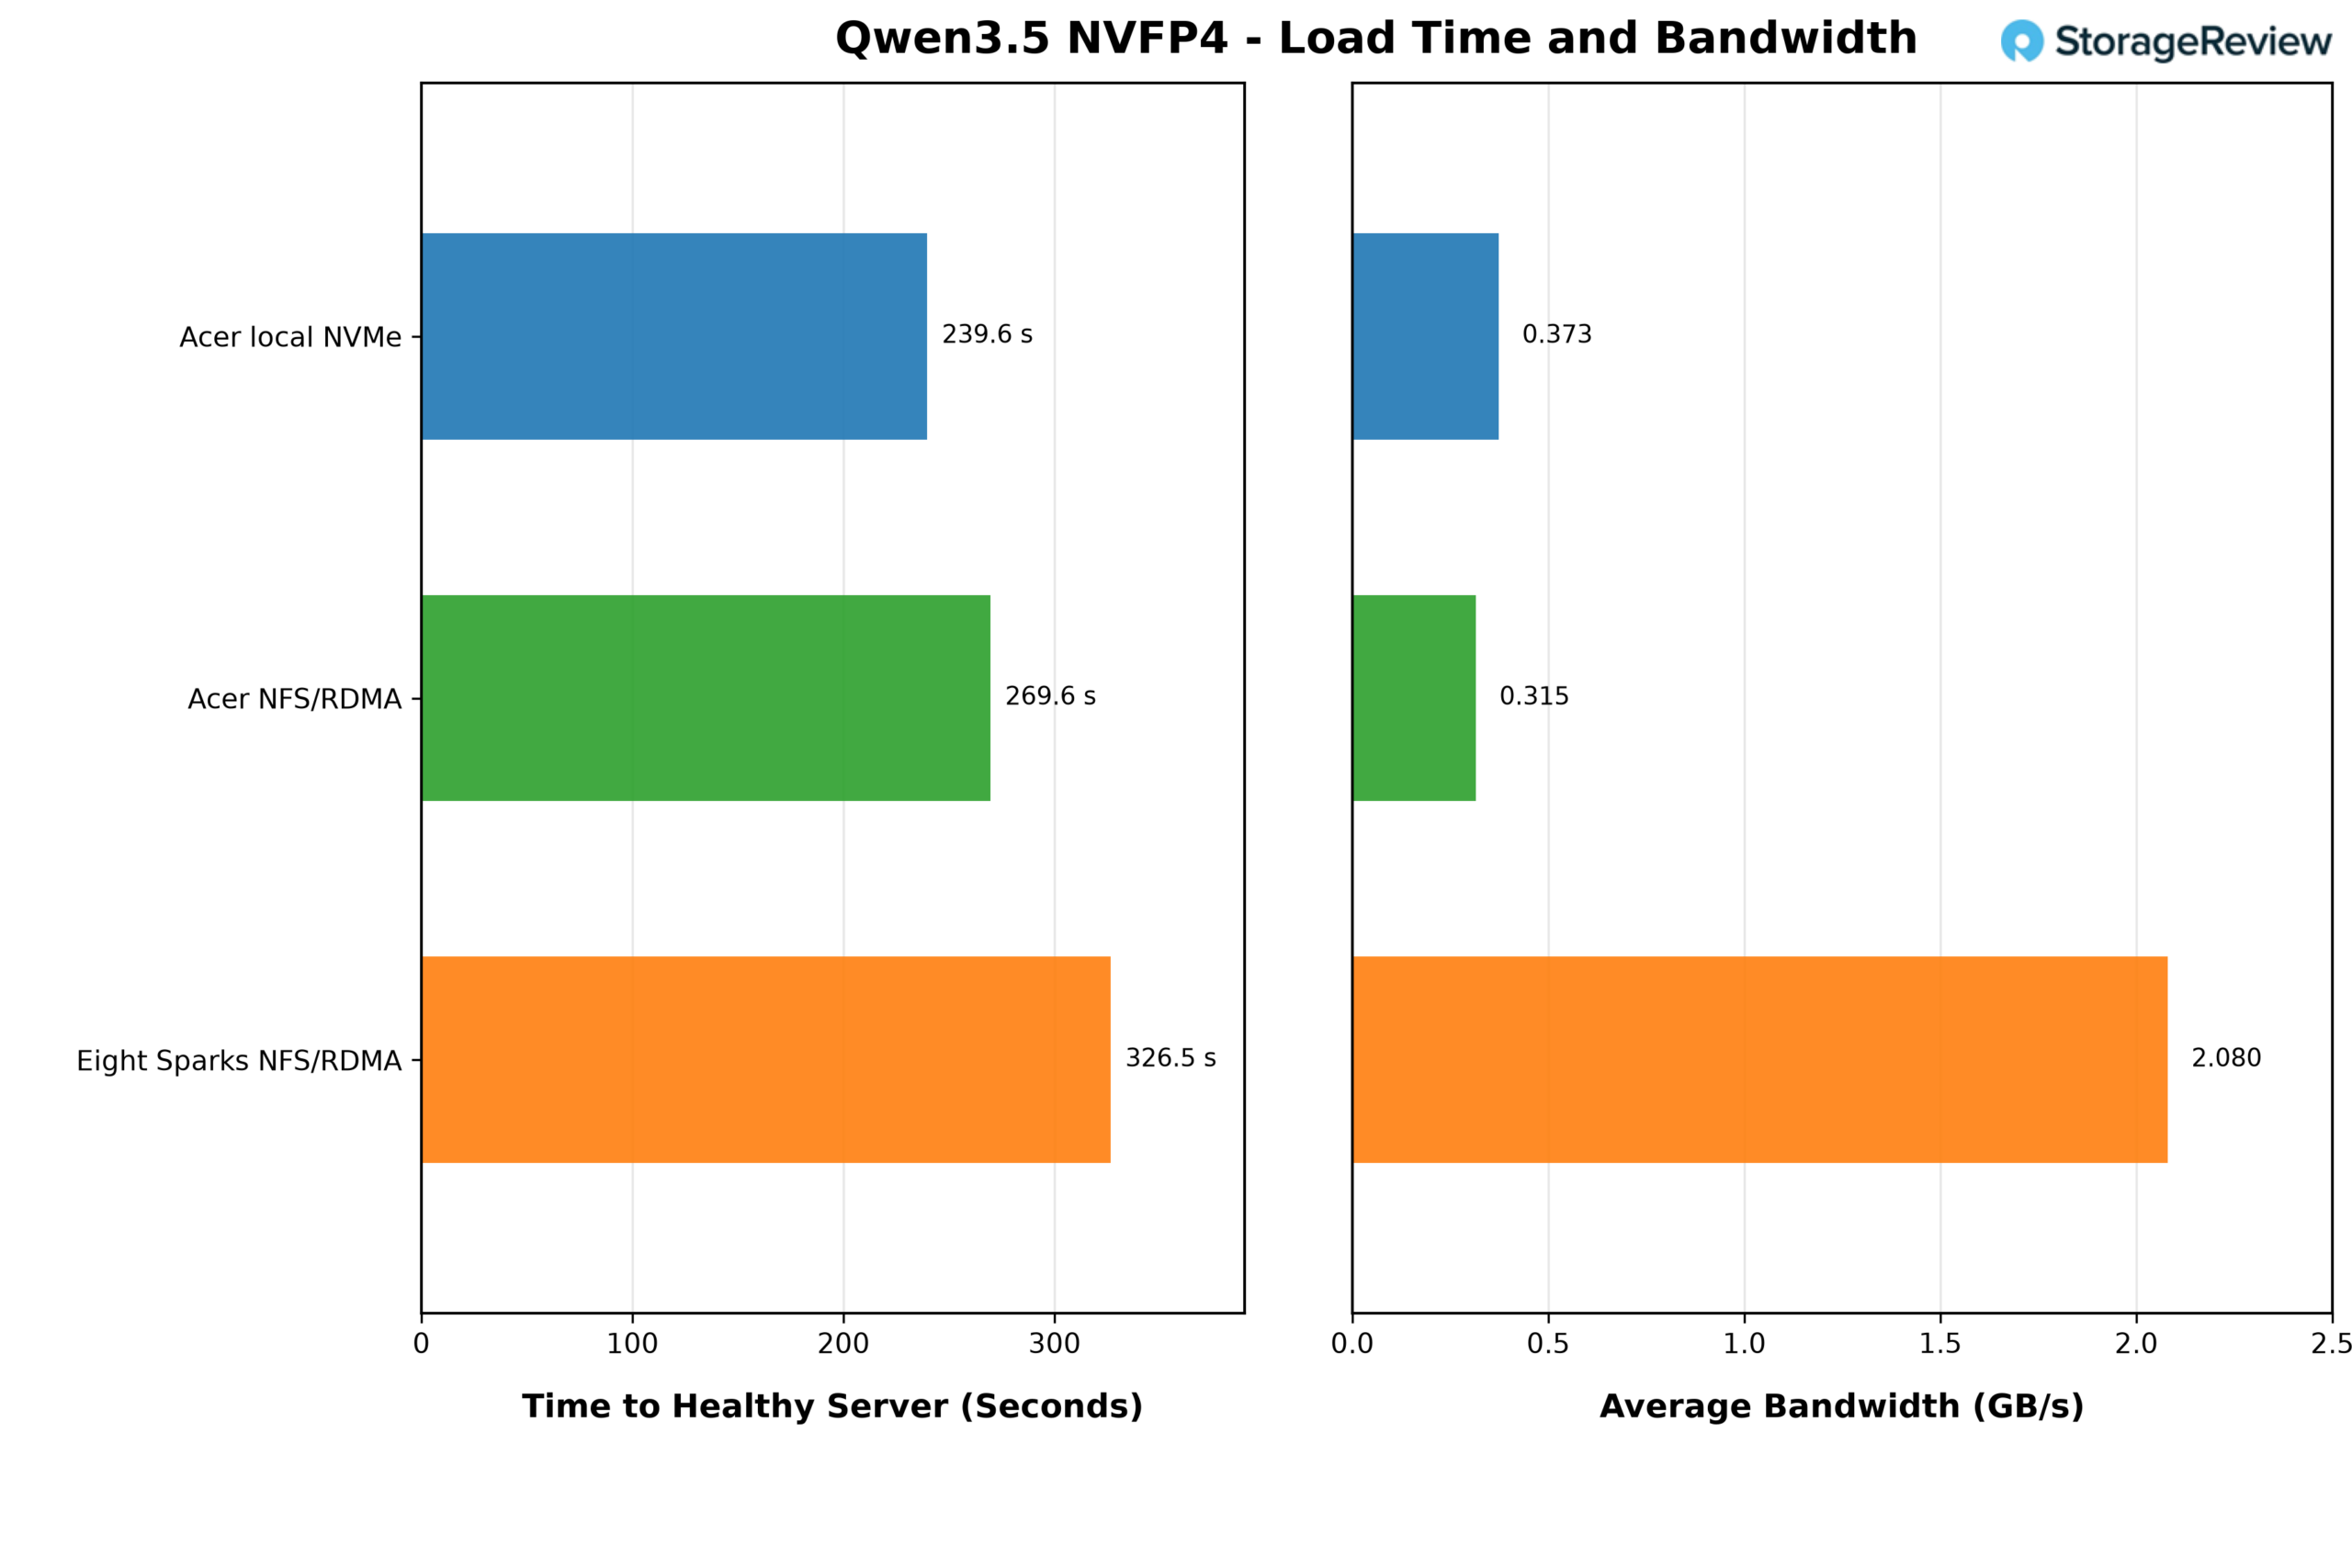
Från intern NVMe nådde Acer Veriton GN100 en fungerande server på 239.6 sekunder med ett genomsnitt på 0.373 GB/s. Från den delade arrayen via NFS/RDMA tog samma Spark 269.6 sekunder med 0.315 GB/s, cirka 30 sekunder, eller 13 %, längre tid. Genomsnitten visar att vid 78 GB under fyra minuter är modellinläsningen på en Spark inte lagringsbunden i något av fallen. GB10:s egen bearbetning av vikterna sätter takten, och lagringen tillbringar större delen av fönstret med att vänta.
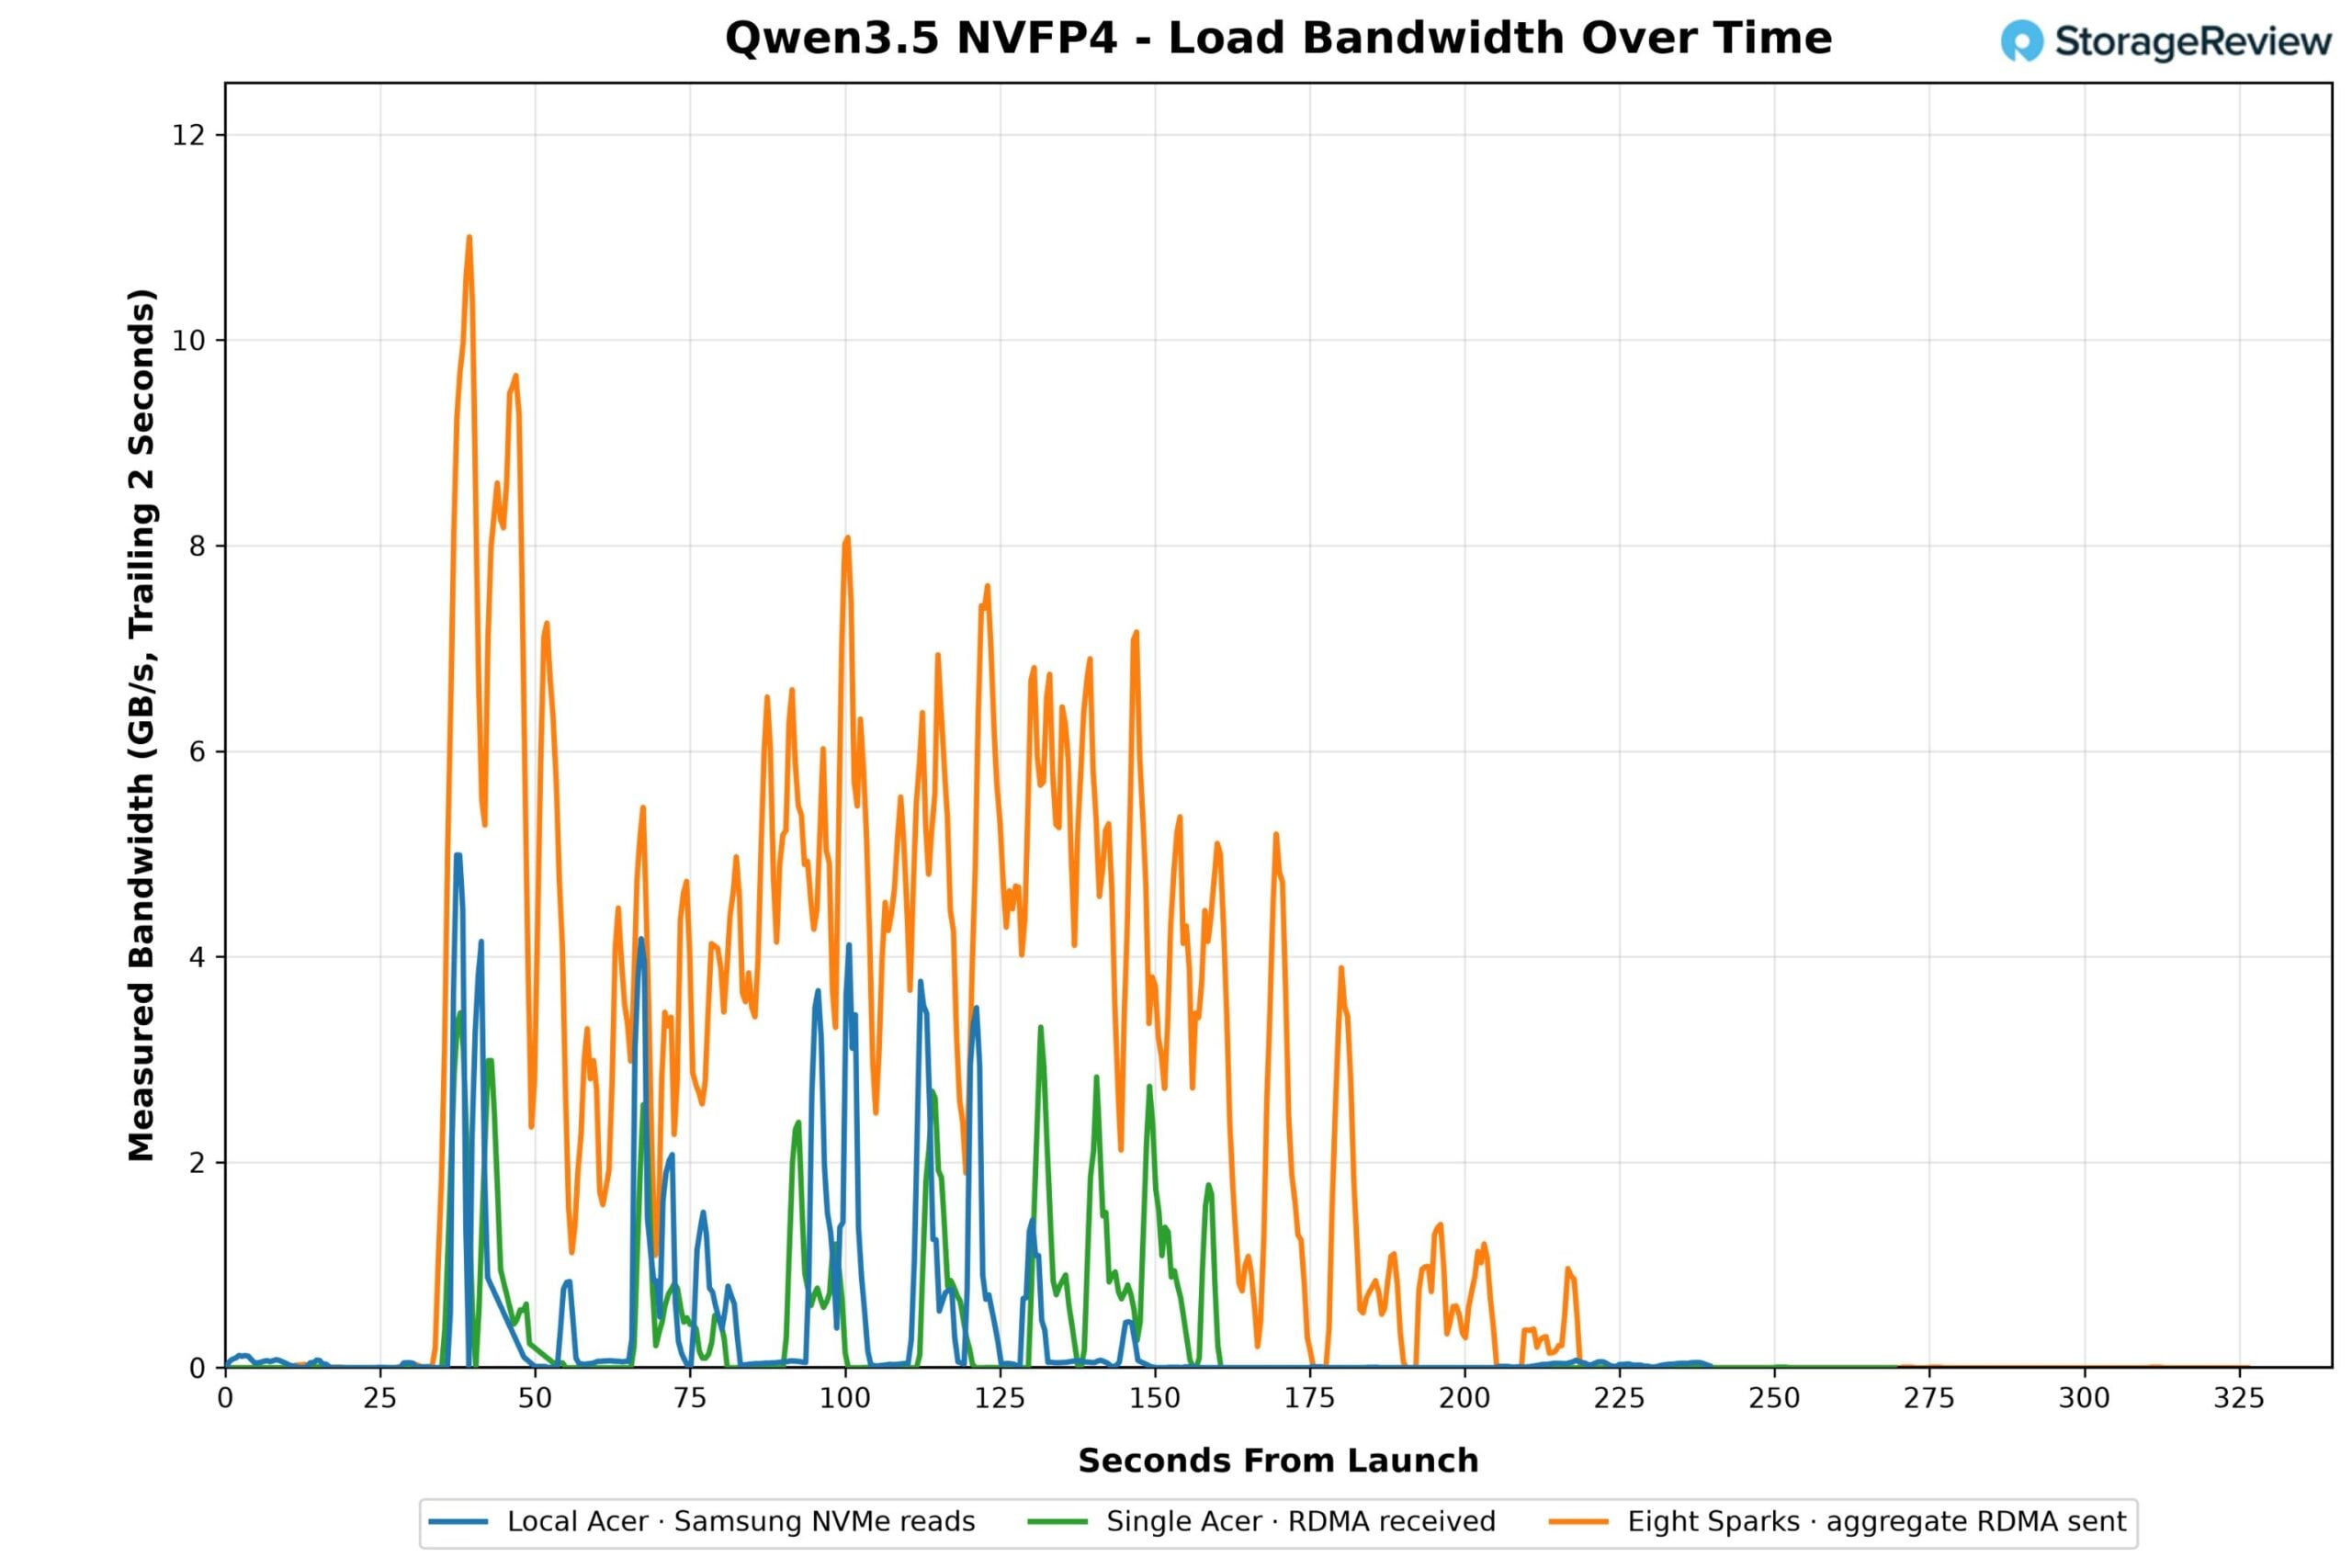
Bandbreddsspåret visar det mönstret: lokala NVMe-läsningar anländer i bursts som toppar nära 5 GB/s med långa mellanrum mellan dem; den enskilda NFS-klienten visar samma burstform vid något lägre toppar. Den aggregerade linjen med åtta Spark visar att arrayen är under samtidig efterfrågan. Med alla åtta som drar samma 78 GB samtidigt levererade arrayen en aggregerad topp på 11 GB/s under den första minuten, och stabiliserade sig sedan mellan ungefär 4 och 8 GB/s under de kommande två minuterna medan Sparks arbetade sig igenom sina vikter, med ett genomsnitt på 2.08 GB/s över hela fönstret. Jämfört med 25 GiB/s visade fio-svepet att arrayen kan leverera, där åtta Sparks som laddade en modell samtidigt använde en bråkdel av vad som är tillgängligt.
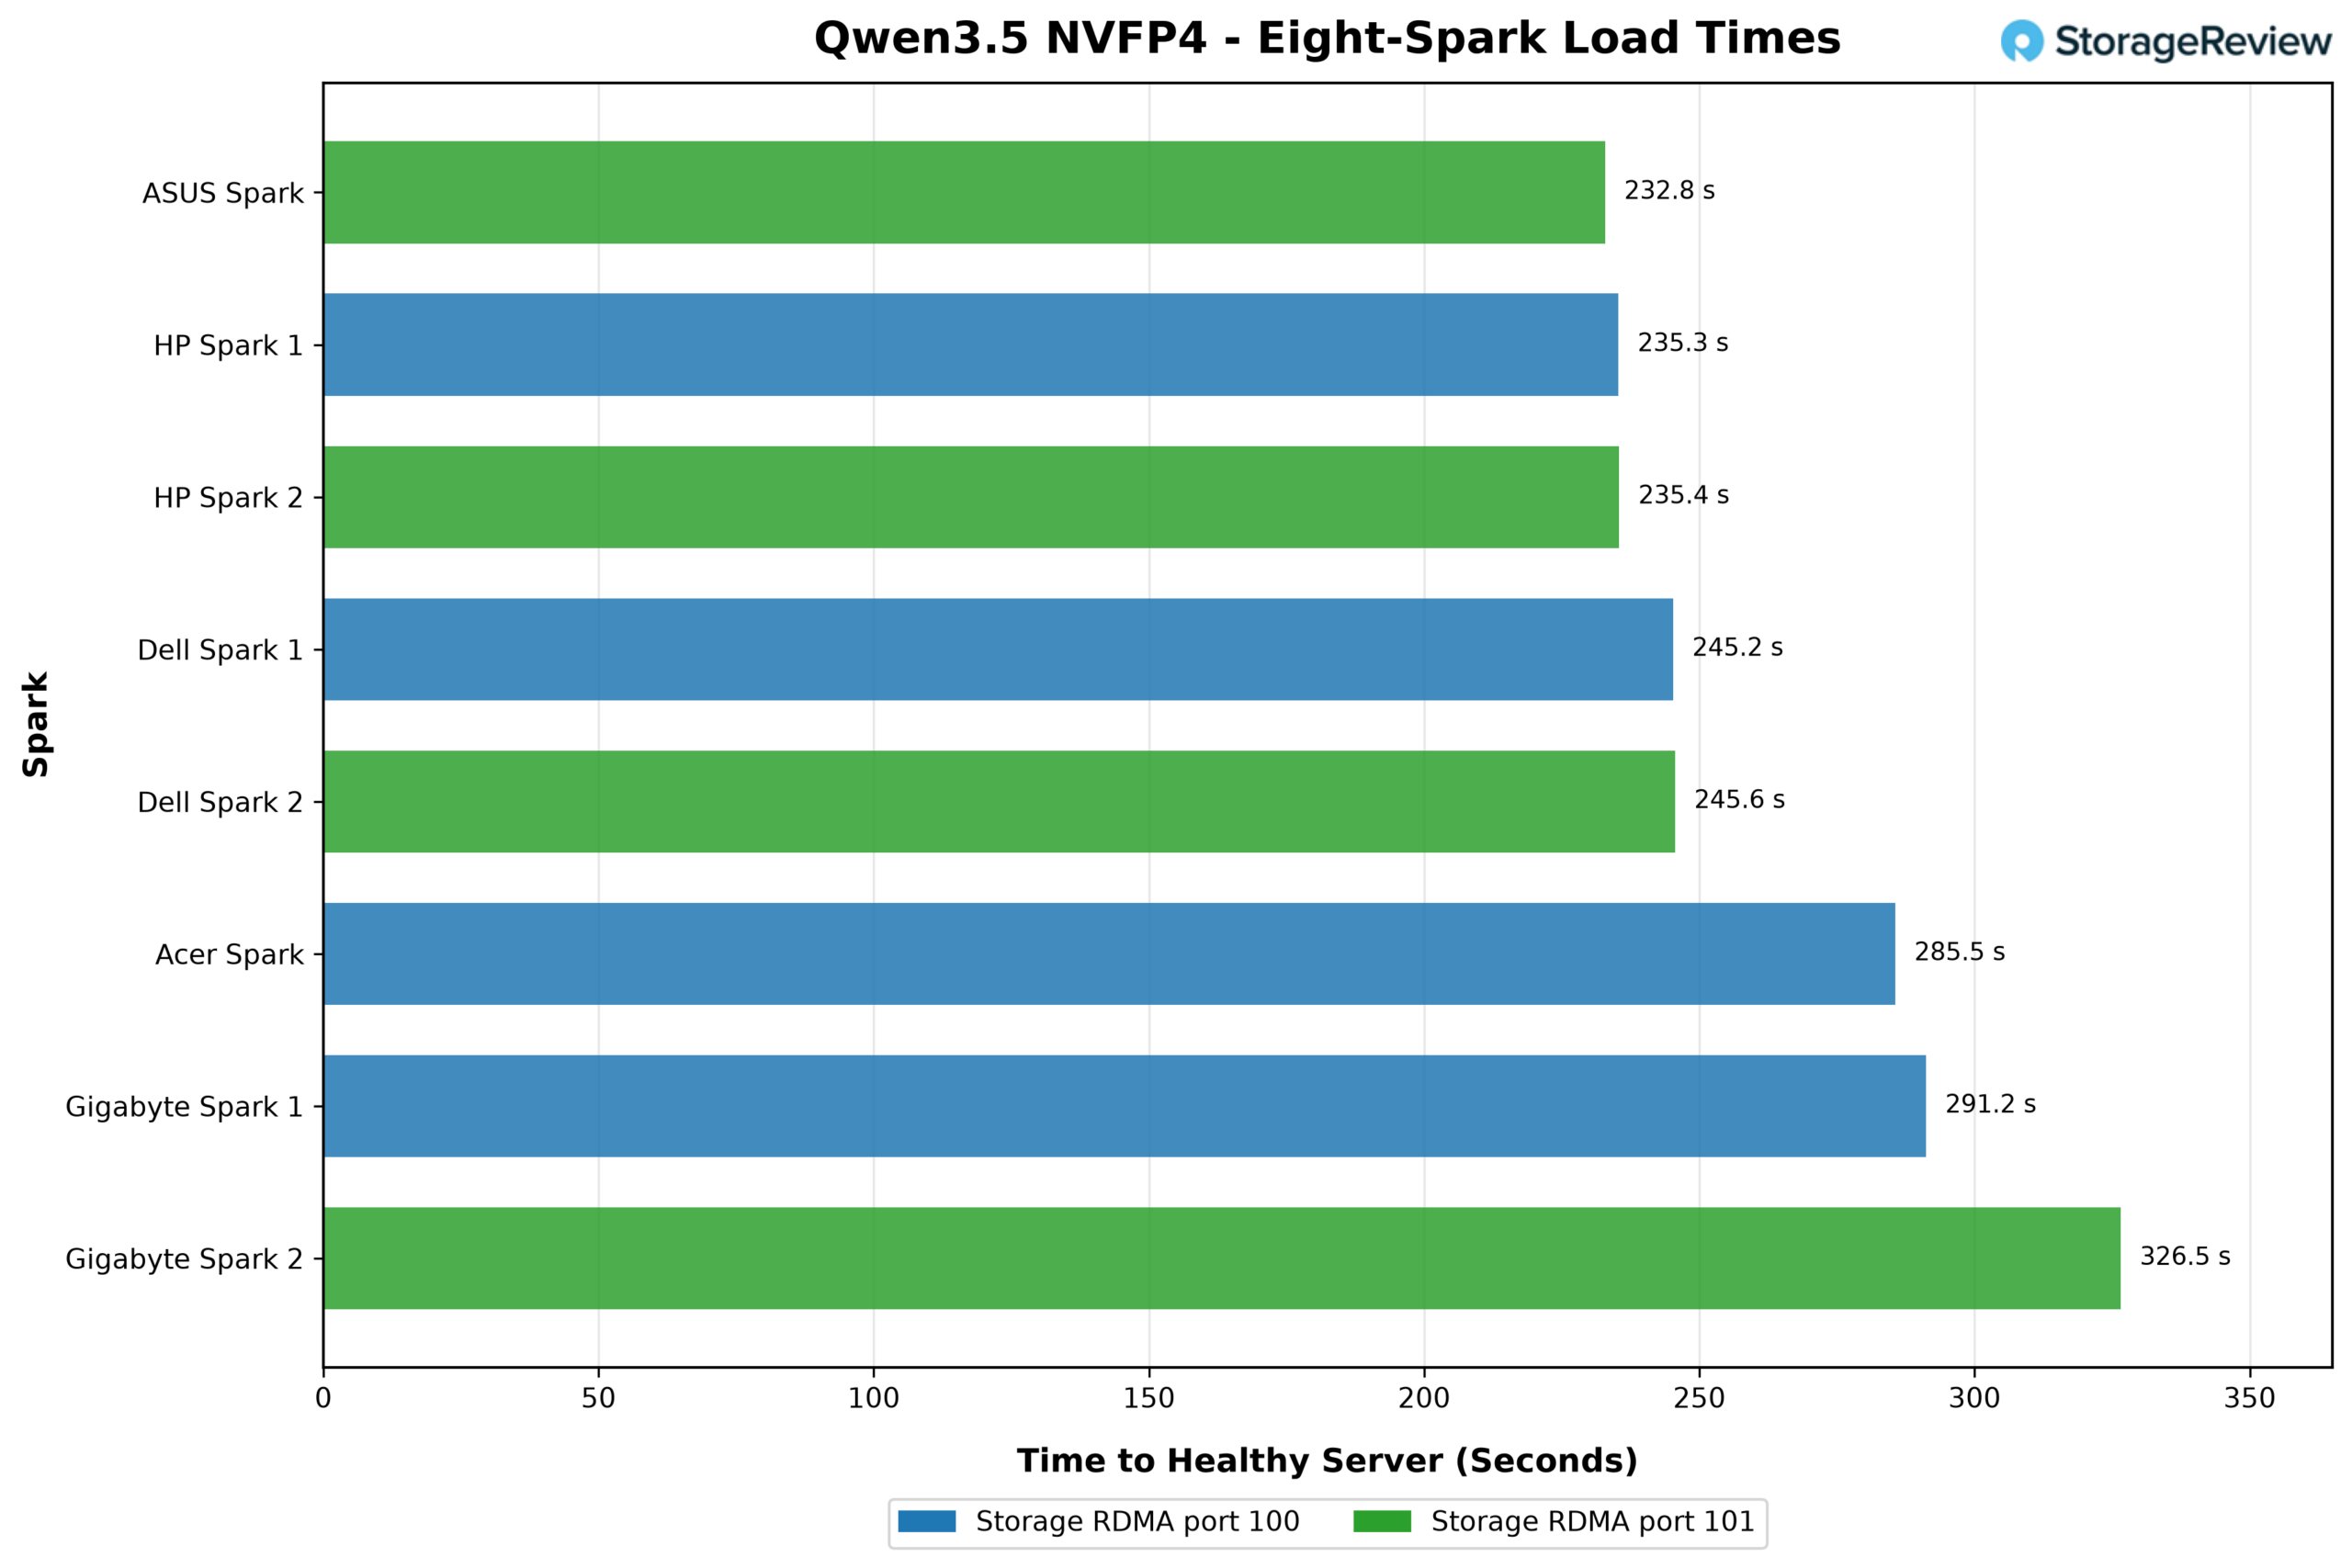
Laddningstiderna per enhet i åttavägstestet varierade från 232.8 sekunder på ASUS Ascent GX10 till 326.5 sekunder på en av GIGABYTE AI TOP ATOM-enheterna, med de två HP ZGX Nano G1n-systemen på 235.3 och 235.4 sekunder och de två Dell Pro Max med GB10-enheterna på 245.2 och 245.6 sekunder. Fem av de åtta Sparks som laddades samtidigt från den delade arrayen överträffade den enskilda Spark-laddningen ensam över NFS/RDMA, och tre av dem överträffade den lokala NVMe-körningen. Spridningen är inte en leverantörshistoria; utan QoS i stacken skiftar vilken enhet som väntar på arrayen när som helst från körning till körning, och de två enheterna på varje lagrings-NIC fördelas jämnt över de snabba och långsamma ändarna av diagrammet.
För ett labb blir resultatet att det kan behålla en kopia av varje modell i arrayen, och vilken Spark som helst, eller varje Spark, laddar den ungefär på samma tid som det skulle ta att ladda en lokal kopia, utan nedladdningssteg, ingen lokal kapacitet som förbrukas och ingen kopia av vikterna som ligger på ett skrivbord.
Användningsfallet för delstaten Oregon
Oregon States College of Earth, Ocean, and Atmospheric Sciences har varit en återkommande samarbetspartner i vårt arbete med AI-infrastruktur, från havsforskning i realtid ombord på ett forskningsfartyg till AI-assisterad akademisk bedömning med Metrum AI . Chris Sullivan, OSU:s chef för forskning och akademisk databehandling, och hans arkitekt, Thomas Olson, utforskar ett storskaligt Spark-labb för AI-inlärning som skulle kunna skalas till så många som 100 enheter, och deras tankar kring lagring informerade vår design på två specifika sätt.
För det första måste lagringen vara oberoende av Sparks. OSU betraktade ett filsystem som sträcker sig över själva Sparks och förkastade det för ett klassrum eftersom att lägga till eller ta bort en enda nod skulle störa lagringstjänsten för alla. En central array som alla Spark monterar innebär att en Spark kan läggas till, tas bort, ombildas eller överlämnas till en annan elev utan att påverka någon annans data. För det andra måste lagringen följa användaren. Vi beskriver OSU-kravet som en förstärkt version av fildelningar för AI-ändamål, där elever lagrar beständig information när de flyttar mellan system. Med NFS är det en mapp per elev; logga in på valfri Spark, montera delningen och ditt arbete finns där.
Dataseten är anledningen till att detta är mer viktigt för OSU än för en hemkatalogserver. College of Earth, Ocean, and Atmospheric Sciences vill göra sina forskningsdata, oceanografiska och atmosfäriska samlingar mätta i tiotals terabyte, tillgängliga för studenter för deras egen forskning. Det finns ingen version av det för skrivbordslagring: en 4TB M.2-plats kan inte hålla en enda av dessa samlingar, och även ett labb fullt av externa kabinett skulle innebära att man köper och fyller en kopia för varje skrivbord och sedan håller varje kopia aktuell, vilket ingen institution har råd med. Att vara värd för data en gång på arrayen och montera den över 100 GbE är den metod som uppfyllde det kravet i vår utvärdering. Samma array är värd för modellbiblioteket, så studenterna spenderar sin session med att köra Qwen, Llama eller någon annan modell, utan nedladdningssteg. Samma princip gäller för ett företag som driftsätter stationära AI-system som utvecklararbetsstationer: montera produktionsdatasetet över ett snabbt nätverk och låt systemet arbeta med det på plats, vilket eliminerar behovet av att ställa upp en andra datasjö så att stationära maskiner har något att läsa. Datan stannar i datacentret, under de åtkomstkontroller, krypteringar och säkerhetskopieringsrutiner som redan finns där, och Spark innehåller ingenting som spelar någon roll när den går ut genom dörren.
Slutsats
Deskside AI-hårdvara är bra på mycket, men den är inte fantastisk som en del av en organisations datatillgång, och den enda M.2-platsen i varje GB10-system säkerställer det: vad en användare än behöver kopieras till lokal flashminne, osynligt för IT, oskyddat och dupliceras på alla andra skrivbord som behöver samma sak. För en enda Spark är en extern lokal lagringsbox en rimlig lösning. För ett labb, en avdelning eller ett företag som driftsätter dessa i dussintals, är varje skrivbord med sina egna data en silo, och svaret är det som datacentret kom fram till för flera år sedan: placera kapaciteten bakom ett snabbt nätverk, styr det en gång och dela det. Sparks har redan höghastighetsnätverk; det här projektet visar vad som händer när du ger det någonstans att ta vägen, och det argumenterar för att Sparks själva hör hemma i racket bredvid det.
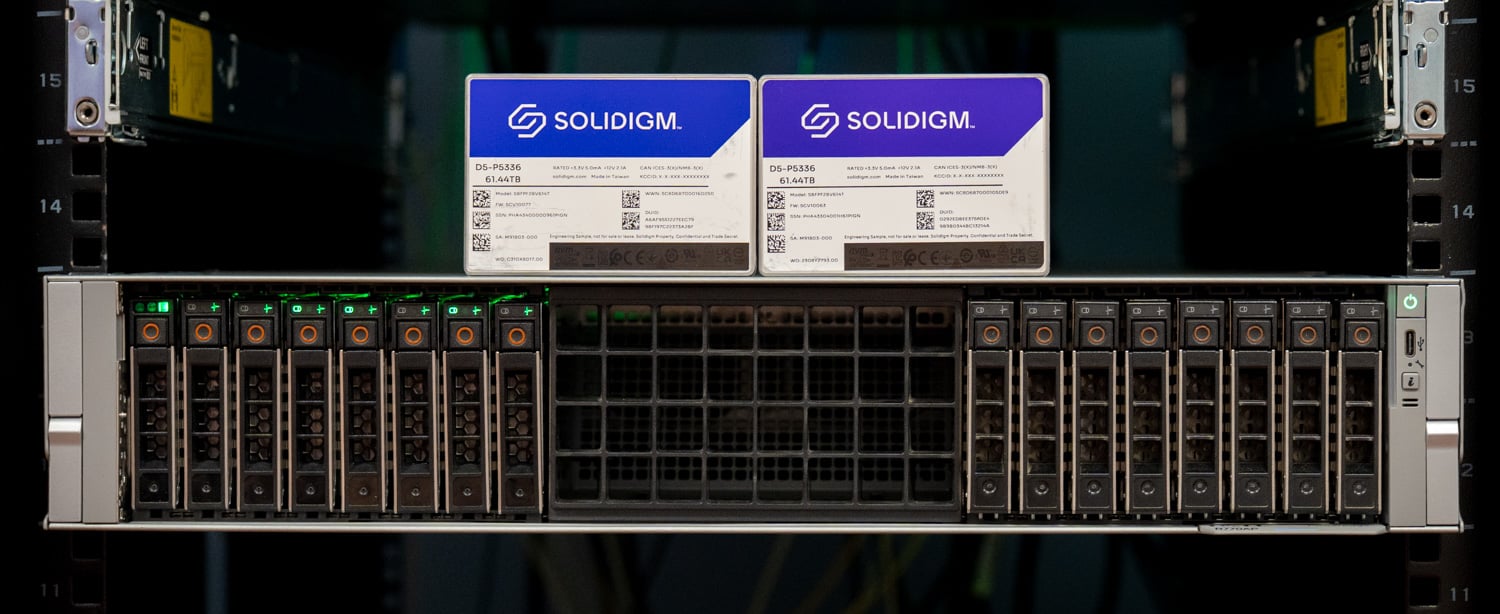
Åtta Solidigm D5-P5336 QLC-diskar i Graid RAID 5 i en Dell-server gav åtta Sparks en enda paritetsskyddad datauppsättning. Två Broadcom 400GbE-nätverkskort och ett Dell Z9864F-ON med en 800G-breakout gav åtta Sparks 100GbE vardera. Tuxeras Fusion NFS över RDMA gjorde den kapaciteten till en enda rads montering på standard Ubuntu med katalogtjänstkrokar för åtkomstkontroll. Under en fast belastning fördelad över alla åtta levererade arrayen 24.9 GiB/s aggregerad sekventiell läsning, jämnt fördelad utan QoS, och en enda Spark mättade sin länk till 10.8 GiB/s, lika snabbt som den bästa interna disken i något GB10-system vi har testat; det taket använde 27 % av vad de två serversidesnätverkskorten kan bära, så nätverket är dimensionerat för en mer komplett server än den här. Modelltestet bekräftade arbetsflödet: en 78 GB-modell som en gång värdas på den delade arrayen laddas på en Spark inom 13 % av lokal NVMe, och på åtta Sparks samtidigt, där fem av de åtta slutförs snabbare än solo-NFS-körningen.
QLC-flash gör att dessa ekonomiska lösningar fungerar eftersom arbetsbelastningen är både kapacitets- och läskrävande, D5-P5336:s starka sida, och en enda server kan lagra det som hundra Sparks aldrig skulle kunna bära lokalt, med en kopia av allt och varje kopia under datacentrets kontroll. Oregon State har produktionsforskningslagring för det arbete som inte kan vänta. Konceptet som Chris Sullivan och Thomas Olson utforskar är en utbildningsnivå som högskolan inte har idag: en styrd, delad pool dimensionerad för ett rack eller fler Sparks, byggd från en server och en handfull högkapacitetsenheter, som skulle kunna placera tiotals terabyte av verklig oceanografisk och atmosfärisk data framför ett storskaligt AI-inlärningslabb på samma infrastruktur som Sparks använder.
Denna rapport är sponsrad av Solidigm. Alla åsikter och åsikter som uttrycks i denna rapport är baserade på vår opartiska syn på produkten/de produkter som övervägs.
Hänvisningar till kommersiella produkter i den här artikeln är i informationssyfte och utgör inte ett godkännande av Oregon State University.



 Amazon