

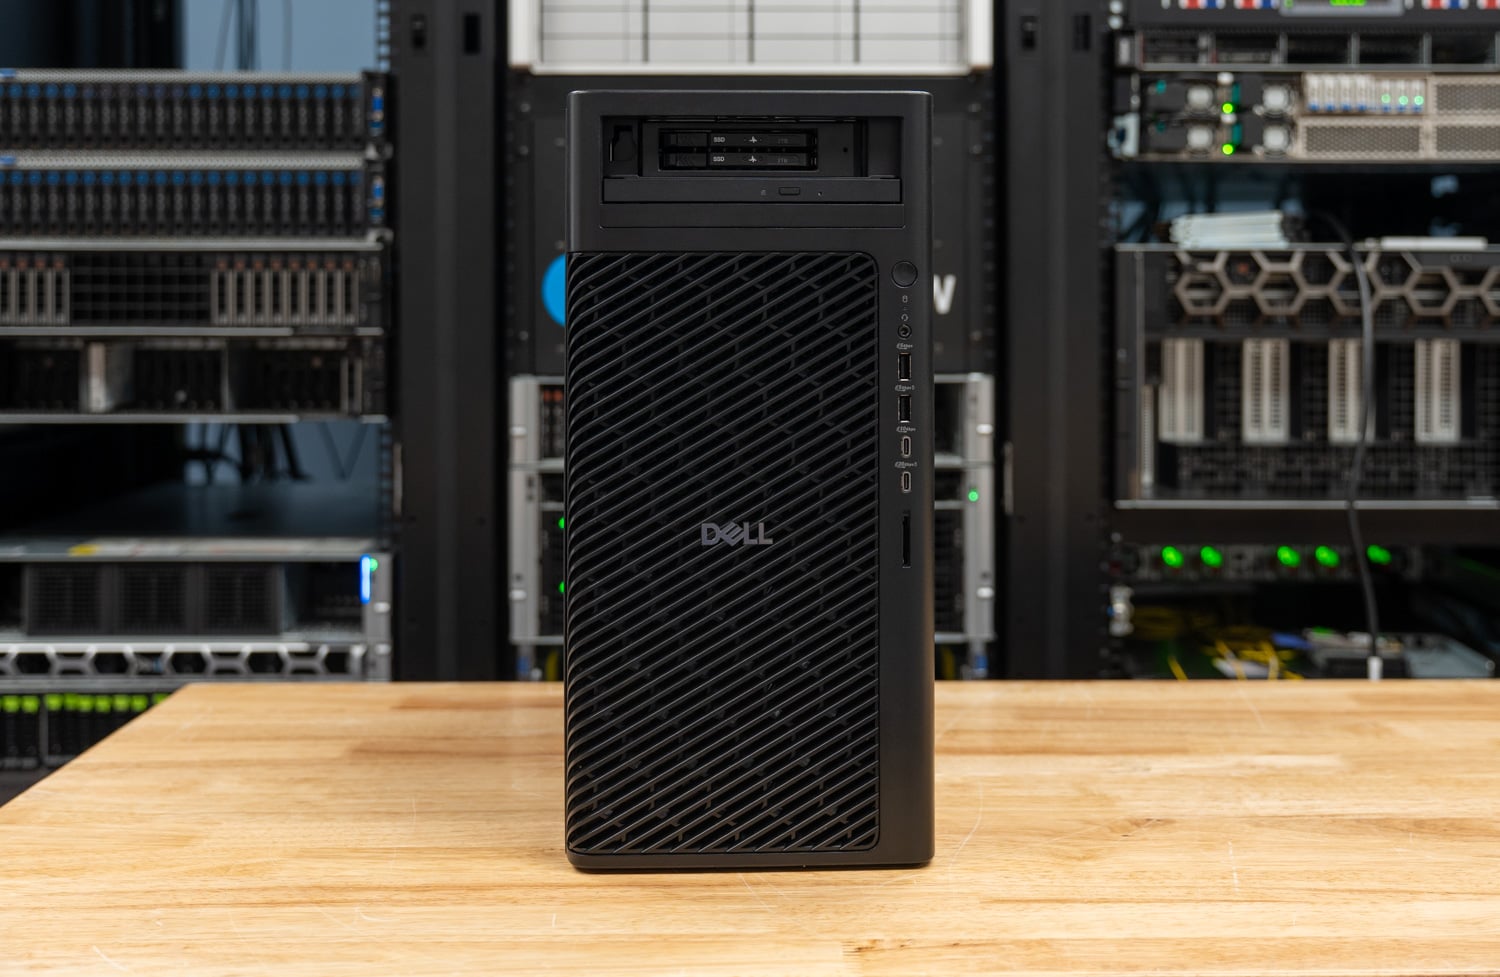
Dell Pro Precision 9 T2 är Xeon-versionen av den tornmodell med ett enda grafikkort som vi recenserade för ett år sedan som Dell Pro Max Tower T2 , och den kommer med två förändringar samtidigt: ett nytt namn, då Dell flyttar tillbaka sina arbetsstationer under varumärket Precision, och en ny plattform, där Intels Xeon 6 ersätter Core Ultra 9 285K inuti samma 32-liters chassi. Vår enhet levererades med 24-kärnig Xeon 658X, 128 GB DDR5-6400 RDIMM ECC, 300W RTX PRO 6000 Blackwell Max-Q och två 2TB E3.S Gen5-hårddiskar placerade i den främre FlexBay-enheten. Konfigurerad på samma sätt på Dell.com listas den för cirka 28 300 dollar.
Vi testade det som en matris: Pro Precision 9 T2 körde hela vår svit med Max-Q-kortet som den levererades med och igen med 600W RTX PRO 6000 Blackwell från vår Pro Max Tower T2, och den Core-baserade T2 körde båda korten också, så alla resultat nedan har fyra kolumner, och varje par isolerar en variabel: CPU-plattformen, eller GPU:ns effektgräns. Sviten är densamma som kördes på förra veckans RTX Spark-bärbara datorer , med några tillägg som debuterar här.
Xeon köper dataflöde och ger tillbaka latens. Pro Precision 9 T2 fick 12 322 i Cinebench 2026 multi-core mot 8 856 på Core T2, byggde LLVM på 140.2 sekunder mot 182.5 och läste 122 233 MB/s i STREAM Triad mot 33 003, medan dess single-core Cinebench-poäng på 454.1 ligger efter 285K:s 564.4 och dess Speedometer-poäng på 36.8 ligger efter 46.3. 600W-kortet lägger till cirka 7 till 20 procent på LLM-avkodning och 20 till 39 procent på snabb bearbetning och diffusion i båda tornen, och i Xeon-tornet kostar det processorn 4 till 5 procent på all-core-arbete.
Key Takeaways
- Xeon 6 är en dataöverföringsplattform i ett torn med en enda sockel: 12 322 i Cinebench 2026 multi-core, 39 procent före Core Ultra 9 285K i samma chassi, 289.6 GIPS i 7-Zip mot 174.8, DGEMM vid 1 638 GFLOPS mot 768, och 3.7 gånger minnesbandbredden från fyra kanaler DDR5-6400.
- 285K har fortfarande hastighet per tråd: Xeon ligger 20 procent efter i Cinebench single-core, 21 procent i Speedometer och 20 till 31 procent i single-threaded Python, med en kärna-till-kärna-latens på 56.2 ns mot 38.1.
- GPU:n bestämmer AI-resultaten, och 600W-kortet får sin ström på uppmaningar: MLPerf Llama 3.1 8B genererar 230.9 tokens per sekund med Max-Q och 252.8 med 600W-kortet, medan tiden till första token sjunker från 0.082 till 0.059 sekunder och Qwen-Image 20B renderar en 1024×1024-bild på 19.7 sekunder jämfört med 26.1.
- 600W-kortet belastar Xeons processorarbete med 4 till 5 procent: Cinebench-multikärnfrekvensen sjönk från 12 322 till 11 705 och den 30 minuter långa sustained loopen från 12 328 till 11 764, med steady-state-klockfrekvenser nere från 4 274 till 4 178 MHz; samma byte förändrade ingenting i Core T2.
- E3.S i FlexBay, stripad av VROC av Graid: Frontfacket rymmer två E3.S Gen5-hårddiskar, vilket är första gången vi har en tornarbetsstation i vårt labb, och Dells RAID0-startalternativ bygger in dem i en volym på 4 097 GB med VROC från Graid Technology. Stripe läser 9 332 MB/s sekventiellt och når en topp på 840.1 000 IOPS vid slumpmässig läsning i 4K, jämfört med 1.78 miljoner IOPS från den enda Gen5 M.2 i Core T2.
Från Pro Max till Pro Precision
Dell pensionerade namnet Precision i början av 2025, då varje arbetsstation blev Dell Pro Max, och de har nu återinfört det. Den 7 oktober döpte Dell om sina stationära datorer GB10 och GB300 från Dell Pro Max till Dell Pro Precision, och Dell.com listar Pro Precision 9 T2 tillsammans med de nya T4- och T6-tornen under samma varumärke. Pro Max finns kvar för de Core-baserade maskinerna, så Core Ultra-tornet som vi recenserade förra året säljs fortfarande som Dell Pro Max Tower T2, och Xeon-tornet som recenseras här är Dell Pro Precision 9 T2, modell PW9T2260.
T4 och T6 gjorde samma steg till Xeon 6 med namnbytet, och Dell positionerar de tre tornprocessorerna genom expansion. Pro Precision 9 T4 (PW9T4260) kör samma processorlista upp till 86-kärniga Xeon 698X, lägger till 16 DIMM-platser för upp till 4 TB DDR5-6400 på alla åtta minneskanaler och tar ett enda 600W RTX PRO 6000 eller två Max-Q-kort på en 1500W-källa, med ett 2400W-chassi som tillval.
Pro Precision 9 T6 (PW9T6260) är toppen av serien, med sex platser, en 2400W-matning och plats för två 600W RTX PRO 6000-kort, tre Max-Q-kort eller upp till fem RTX PRO 5000. T2 är instegsmodellen i familjen med en enda grafikprocessor och fyra kanaler.
Namngivningsnoggrannheten är viktig eftersom de två tornen är identiska på utsidan, med samma 32-liters chassi på 387 x 187.7 x 438 mm, samma ram och främre FlexBay, och samma RTX PRO 6000 Blackwell-alternativ i Dells konfigurator, så skillnaden ligger i moderkortet. Medan Pro Max Tower T2 parar ihop 24-kärniga Core Ultra 9 285K med fyra DIMM-platser med obuffrad DDR5, flyttar Pro Precision 9 T2 till Intels Xeon 6 för arbetsstationer, Granite Rapids-WS- plattformen som vi recenserade på ett rent moderkort i juni, med registrerat ECC-minne, fler PCIe-banor och en 250W-processor i toppkonfigurationen.

Dell erbjuder sex Xeon 6-processorer i Pro Precision 9 T2, från 12-kärnig Xeon 634 på 150W till 24-kärnig 658X på 250W i vår enhet, och steget från 634 till 658X är ett alternativ för 1 560 dollar. 658X kör 24 kärnor och 48 trådar vid 3.0 GHz bas och 4.9 GHz turbo med 144 MB L3, tre gånger 285K:s 36 MB, och den stöder AVX-512 och AMX, som 285K inte har. Chipet har åtta DDR5-6400-kanaler och 128 Gen5-banor; T2 har fyra DIMM-platser och fem expansionsplatser, och de större T4 och T6 exponerar resten.
| plattform | Dell Pro Precision 9 T2 (testad) | Dell Pro Max Tower T2 (testad) |
|---|---|---|
| Processorn | Intel Xeon 658X, 24 kärnor / 48 trådar, 3.0 till 4.9 GHz, 144 MB L3, 250 W | Intel Core Ultra 9 285K, 24 kärnor / 24 trådar (8P + 16E), upp till 5.7 GHz, 36 MB L3, 125 W |
| Instruktionsuppsättningar | AVX-512, AMX | AVX2 (ingen AVX-512), Intel AI Boost NPU |
| Minne | 4 x 32 GB DDR5-6400 RDIMM ECC (fyra kanaler; maximalt 1 TB) | 4 x 32 GB DDR5-4400 ECC UDIMM |
| Expansion | Gen5 x16, Gen5 x4, Gen4 x16, två Gen4 x8 (en x4 elektrisk) | Gen5 x16, en Gen4 x4 och två Gen3 x4 |
| Startlagring som testat | 2 x 2 TB E3.S Gen5 NVMe i den främre FlexBay-enheten, RAID0 (VROC från Graid Technology), 4 097 GB | 2TB SK hynix PCB01 M.2 Gen5 (enkel hårddisk) |
| Intern M.2 | 3 x M.2 2280 Gen5 | 1 x Gen5 och 2 x Gen4 M.2 |
| Strömförsörjning | 750 W standard; 500 W eller 1500 W valfritt (1500 W enligt tester) | 360W, 500W eller 1500W (80 Plus Platinum) |
| Grafik som testad | RTX PRO 6000 Blackwell Max-Q (300W) som levererat; 600W-kort även testat | RTX PRO 6000 Blackwell (600W som levererat; Max-Q-kort också testat |
| Chassi | 387 x 187.7 x 438 mm, 11.6 till 21.8 kg | 387 x 187.7 x 438 mm, 8.17 till 23 kg |
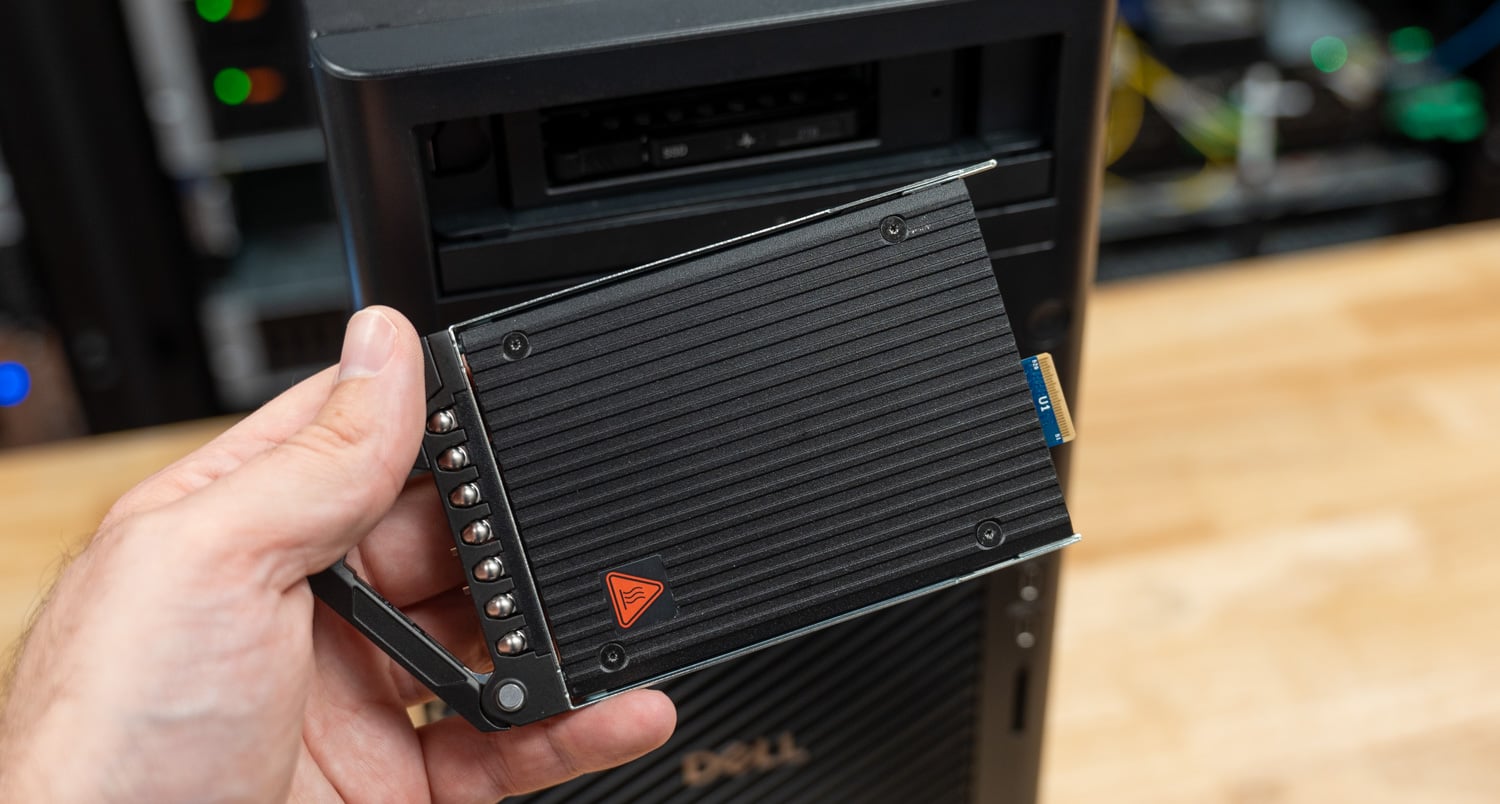
Core T2 startade från en enda M.2-hårddisk, medan vår Pro Precision 9 T2 levererades med Dells FlexBay NVMe-startkonfiguration: två E3.S Gen5-hårddiskar som kan bytas ut under drift bakom frontpanelen, sammanfogade till en volym på 4 097 GB med hjälp av RAID0-startalternativet. E3.S är den företagsformfaktor vi har bett tornleverantörer om, eftersom den flyttar kapacitetstaket långt förbi M.2 och hårddiskarna kommer ut på framsidan utan att chassit öppnas. RAID-lagret är VROC från Graid Technology , Intels VROC-kod som Graid tog över förra året och omlanserades på Computex, och detta är den första arbetsstationen i vårt labb som levereras med den.

600W-kortet behöver lite extra utrymme; Max-Q gör inte det. Vår enhet levererades med en Intel E810-XXV 25GbE-adapter med dubbla portar i kortplatsen bredvid grafikkortet, och för att installera 600W RTX PRO 6000 var vi tvungna att ta bort den; kortets kylare upptar den intilliggande kortplatsens utrymme såväl som kortplatsens strömförsörjning. Köpare som vill ha kortet med full effekt och ett höghastighetsnätverkskort bör planera kortplatslayouten innan de beställer, och en 1500W-strömförsörjning är den enda rimliga kombinationen för den; vår enhet hade 1500W-alternativet, en uppgradering på 40 dollar från standardströmförsörjningen på 750W.
Bygg och design
Pro Precision 9 T2 använder samma verktygslösa torn som Pro Max-versionen, med ett fullhöjdsnätgaller för intaget, ett sidospärr och en tumskruv för sidopanelen, samt FlexBay och en valfri smal optisk enhet bakom den nedre ramen. Dell listar chassit till 11.6 kg tomt och upp till 21.8 kg konfigurerat, och vårt, med 1500W-nätverket, 658X:s kylare och ett GPU med två kortplatser, ligger i toppen av det intervallet.

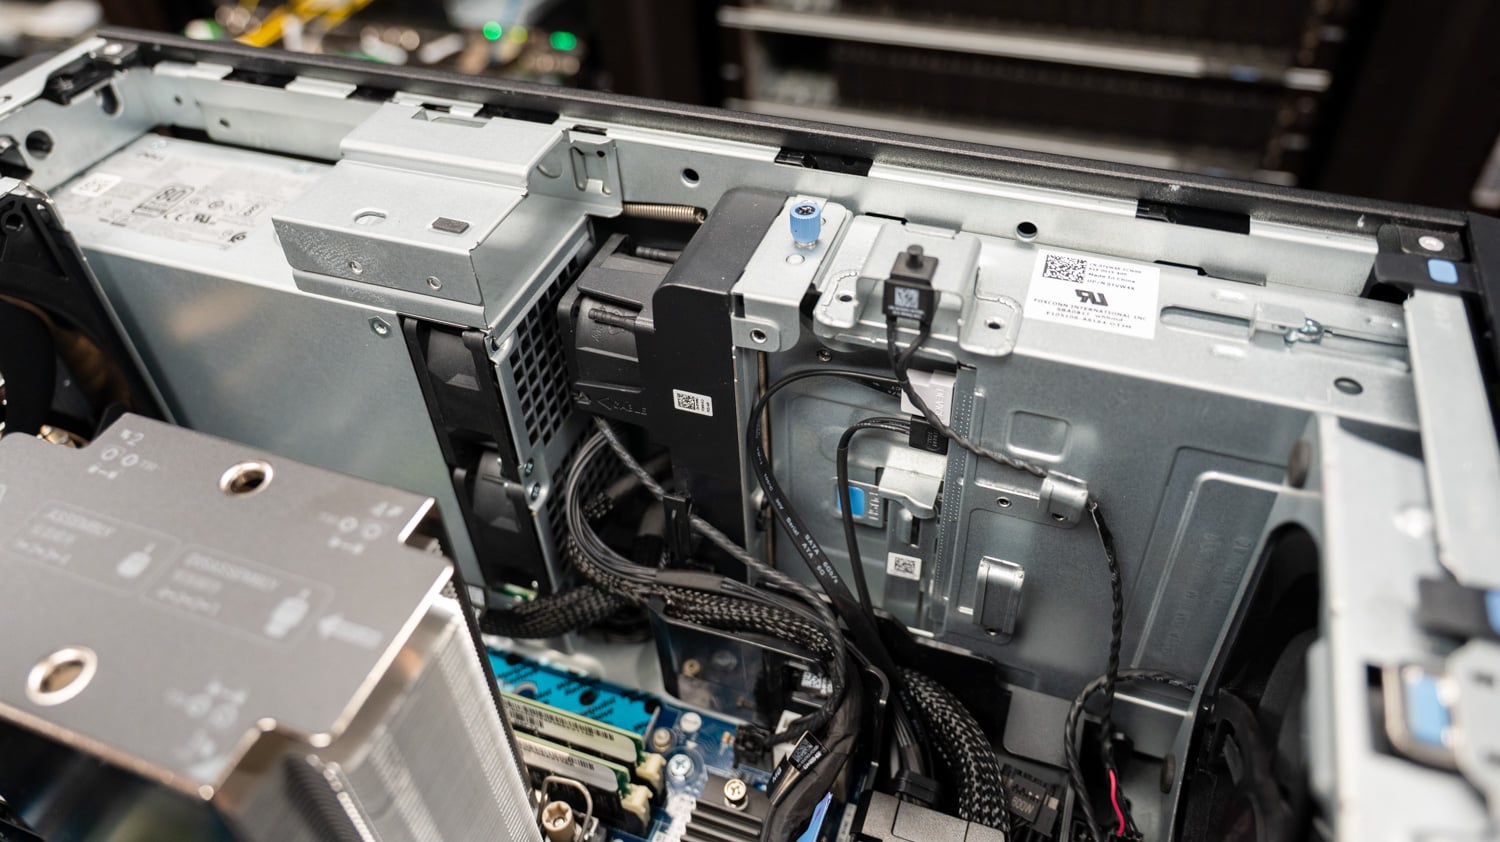
Insidan av chassit är byggd kring luftflöde, och Dell riktar luften exakt dit den behöver. Det stora kylhöljet, som håller DIMM-modulerna svala och flyttar varm luft från processorn rakt ut ur chassit, har en fläkt integrerad i själva höljet. Med chassit öppet kan du se hur höljet fungerar i chassits strukturella layout, där dess nedre kant vilar på GPU-stödfästet och sitter tätt mot sidokåpan.
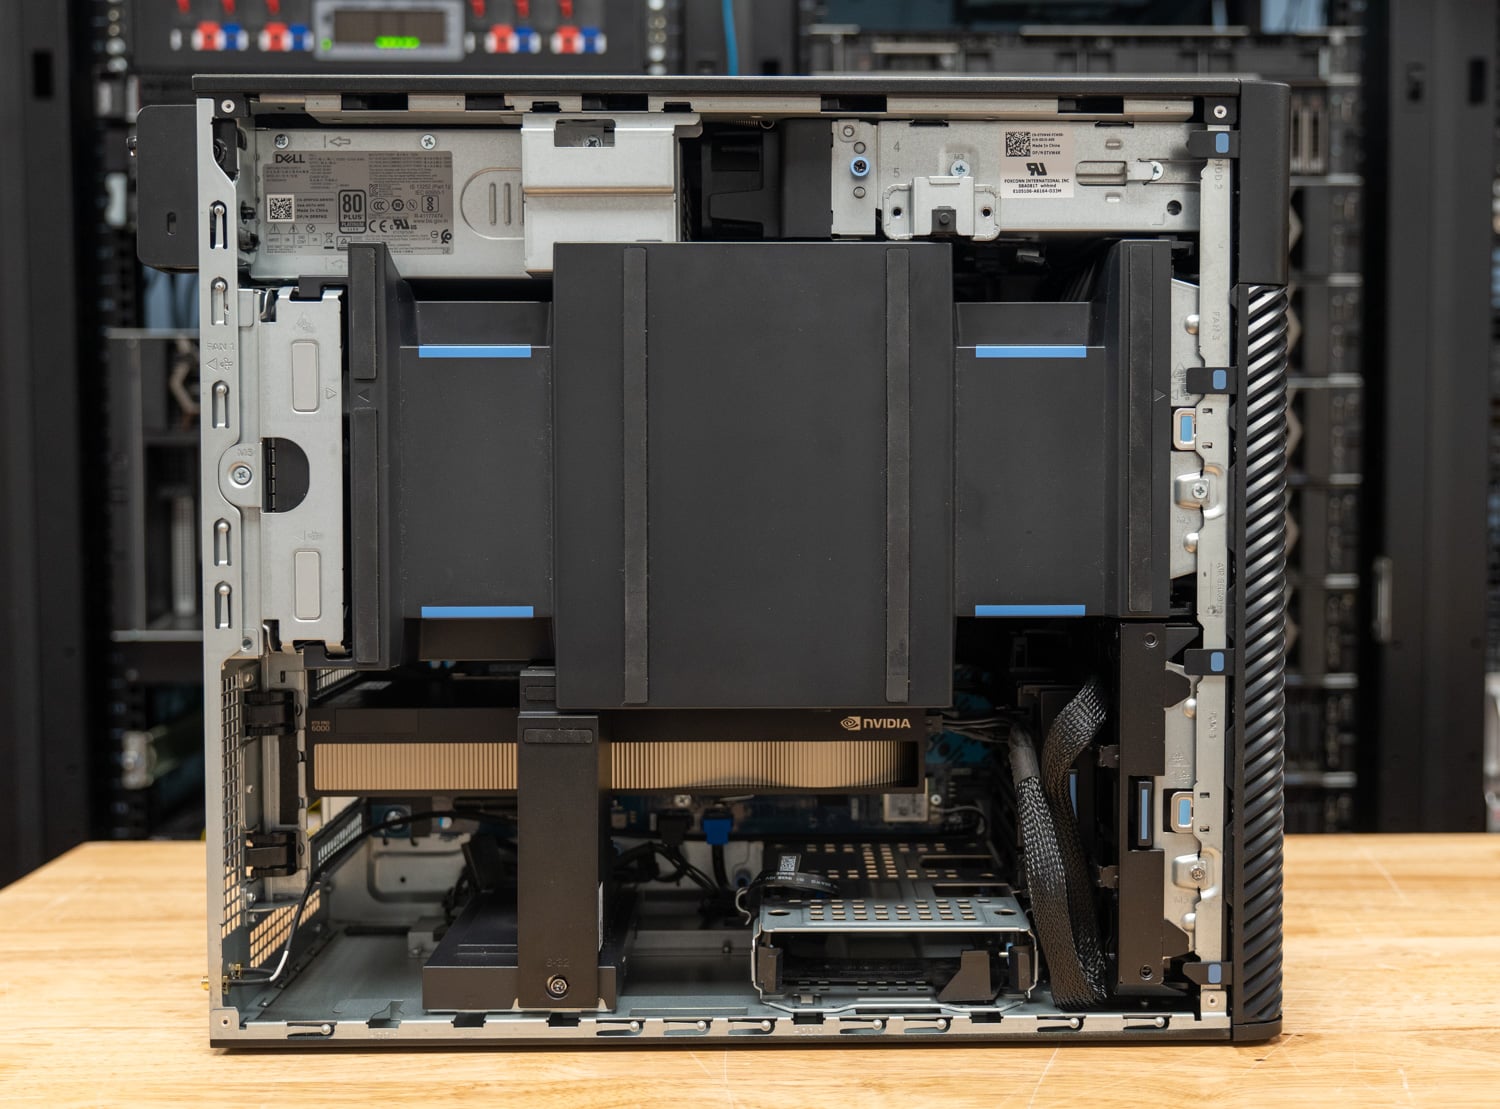
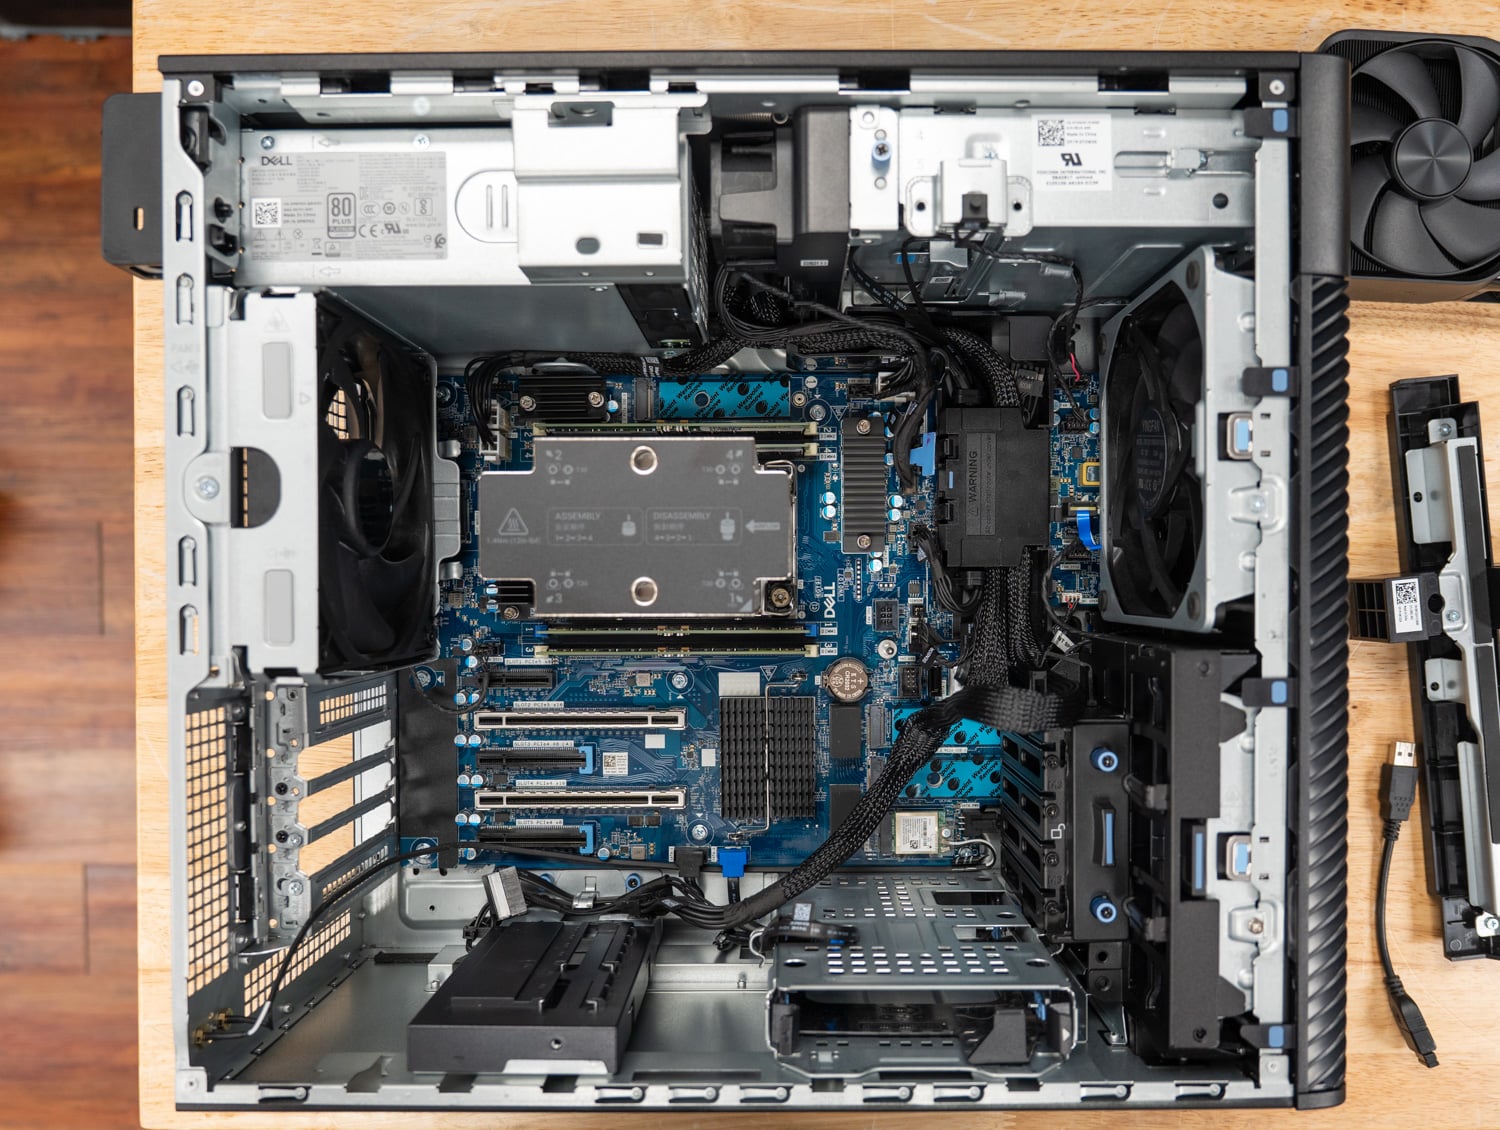
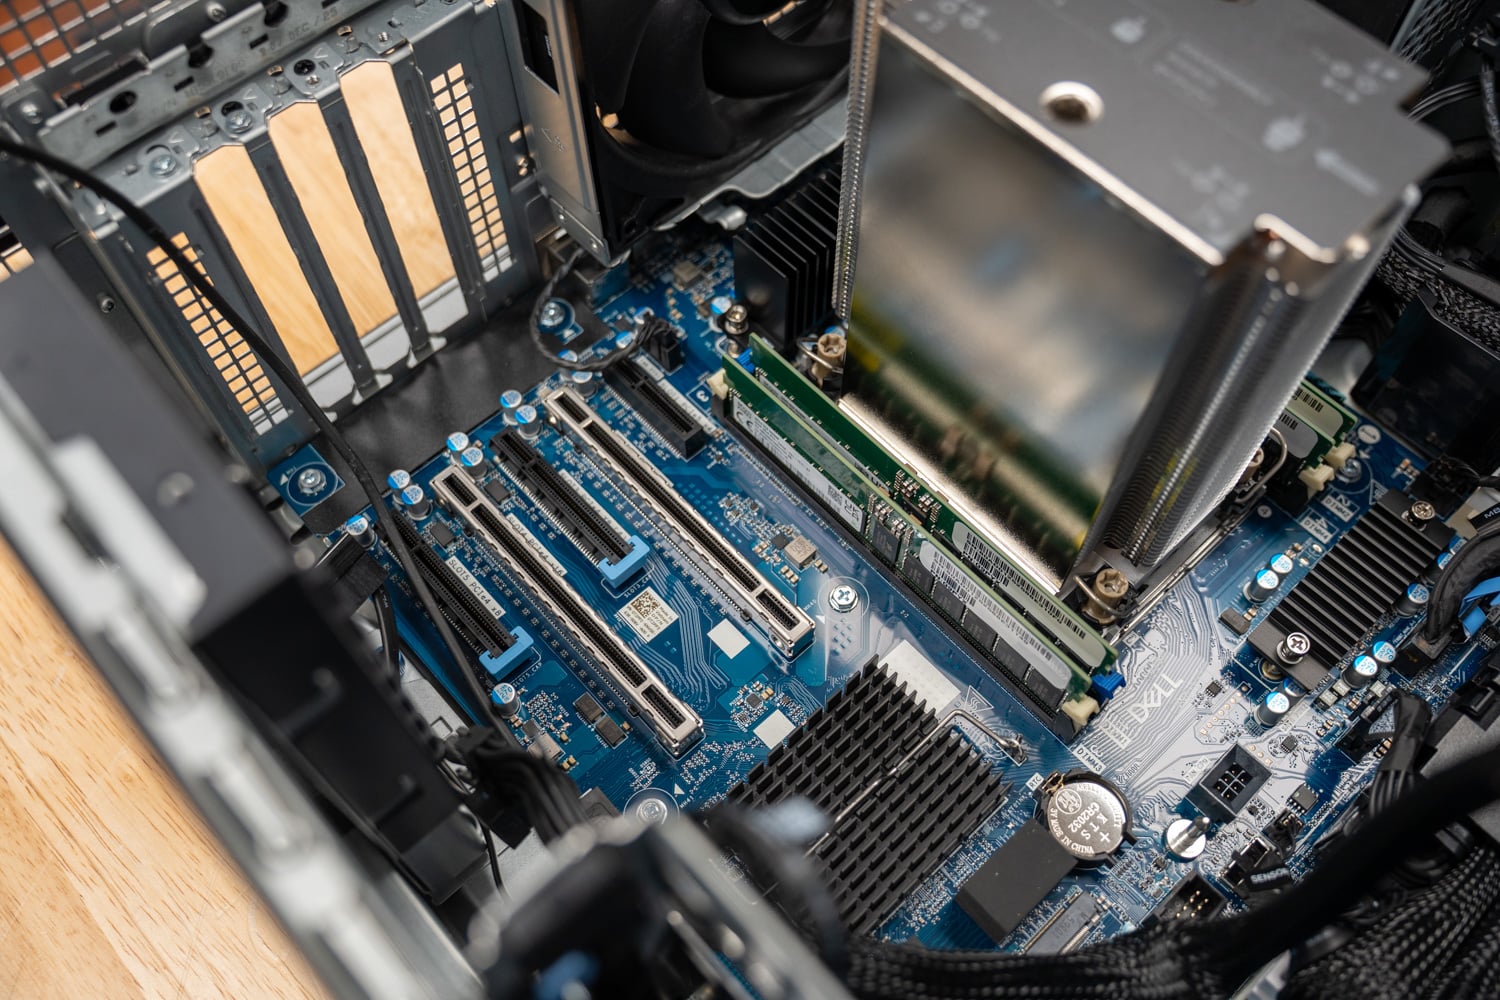
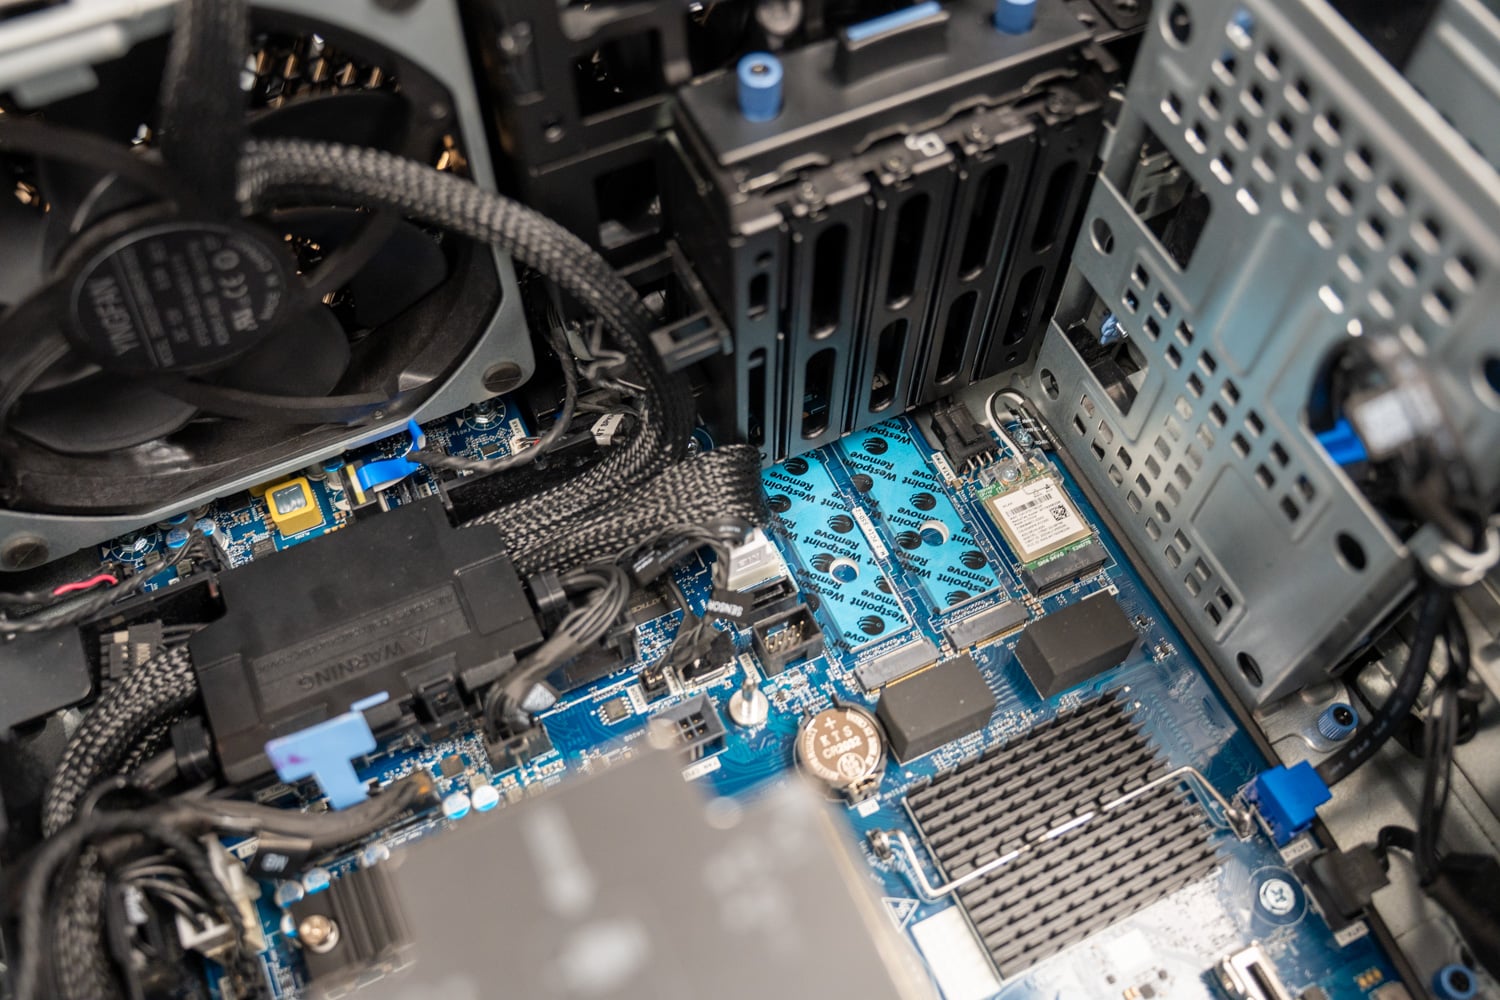
Invändigt följer layouten Pro Max-tornets: processorn och fyra DIMM-kortplatser sitter ovanför expansionsområdet, grafikkortet i Gen5 x16-kortplatsen stöds i sin bortre ände av en fäste, och nätaggregatet monteras på baksidan med ett handtag för verktygslös borttagning. Alla fem kortplatserna är i full höjd: kortplats 2 är Gen5 x16 för grafikkortet, kortplats 1 är Gen5 x4, och de andra tre är Gen4, en x16 och två öppna x8, för ett nätverkskort, ett minneskort eller en andra grafikkort. Tre interna M.2 2280 Gen5-kortplatser och två 3.5-tums SATA-kortplatser sitter bakom det främre E3.S-facket.
Främre I/O har ett headsetuttag, en 20 Gbps USB-C-port med PowerShare, en 10 Gbps USB-C-port, två USB-A-portar och en valfri SD-kortplats. Baksidan har ljudutgång, 20 Gbps och 10 Gbps USB-C-portar, två USB 2.0-portar med SmartPower, två USB-A 5 Gbps-portar, 1 GbE, en valfri modulplats som tar ett 5 GbE-nätverkskort eller två fler USB-A-portar, och en valfri äldre seriell port. Vår enhet har lagt till MediaTek MT7925 Wi-Fi 7-kortet i den interna M.2 2230-platsen och Intel E810-XXV 25 GbE-kortet, det som kom ut för 600W GPU.

Dell Pro Precision 9 T2 Specifikationer
| Specifikation | Dell Pro Precision 9 T2 (PW9T2260) |
|---|---|
| Plattformöversikt | |
| Processoralternativ | Intel Xeon 634 (12C, 150W), 636 (12C, 170W), 638 (16C, 180W), 654 (18C, 200W), 656 (20C, 210W), 658X (24C/48T, 144MB L3, 250W) Xeon 658X testad |
| Minne | DDR5 RDIMM ECC, 5600 eller 6400 MT/s, fyra platser, upp till 1 TB (4 x 256 GB) 128 GB (4 x 32 GB) DDR5-6400 enligt test |
| Grafikalternativ | NVIDIA RTX A400, A1000, RTX PRO 2000/4000/4500/5000/6000 Blackwell (600W)/6000 Blackwell Max-Q (300W), A800 Active; AMD Radeon Pro W7400; dubbla och trippelkonfigurationer på utvalda kort RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7, testad |
| lagring | Främre FlexBay: upp till två E3.S/NVMe-enheter plus valfri smal ODD eller ett 3.5-tums SATA-fack Internt: 3 x M.2 2280 Gen5 NVMe, 2 x 3.5-tums SATA RAID: Intel VMD med VROC från Graid Technology (RAID0-start, intern RAID0) 2 x 2 TB E3.S Gen5 NVMe i RAID0 (4 097 GB) enligt test |
| Expansion | Plats 1: Gen5 x4; Plats 2: Gen5 x16; Plats 3: Gen4 x8 (x4 elektrisk, öppen); Plats 4: Gen4 x16; Plats 5: Gen4 x8 (öppen); M.2 2230 för Wi-Fi |
| I / O | |
| Frontportar | 1 x USB-C 20 Gbps med PowerShare, 1 x USB-C 10 Gbps, 1 x USB-A 5 Gbps med PowerShare, 1 x USB-A 5 Gbps, headsetuttag, SD-kortplats som tillval |
| Bakre portar | 1 x USB-C 20 Gbps, 1 x USB-C 10 Gbps, 2 x USB 2.0 (SmartPower), 2 x USB-A 5 Gbps, ljudutgång, 1 x RJ45 1 GbE, valfri 5 GbE- eller dubbel USB-A-modul, valfri seriell port |
| Nätverk enligt test | Intel E810-XXV DA2 25GbE SFP28 med dubbla portar (borttagen för 600W GPU-körningar); MediaTek MT7925 Wi-Fi 7, Bluetooth 5.4 |
| Kraft och fysisk | |
| Strömförsörjning | 750 W standard; 500 W eller 1500 W valfritt; 1500 W enligt tester |
| Mått | 387 x 187.7 x 438 mm (15.23 x 7.38 x 17.24 tum) |
| Vikt | Minst 11.6 kg (25.57 lb) till högst 21.8 kg (48.06 lb) |
| Operativsystem | Windows 11 Pro för arbetsstationer (testad) eller Ubuntu Linux 24.04 LTS |
| Ledning och säkerhet | Intel vPro, TPM 2.0, chassiintrångsbrytare, låsbara ramalternativ, Kensington-kortplats |
| Pris | Dell.com Baskonfiguration 3 978 USD (Xeon 634, 16 GB, RTX A400, 256 GB, 750 W); cirka 28 300 USD testad (Xeon 658X, 128 GB DDR5-6400, RTX PRO 6000 Max-Q, 2 x 2 TB Gen5 FlexBay-diskar i RAID0, 1500 W, 25 GbE, Wi-Fi 7), Dell.com-priser från och med 19 oktober 2026 |
Det priset kommer med två förbehåll. Dell.coms konfigurator listar FlexBay-hårddiskar som 2TB M.2 2280 Gen5-moduler för 1 700 dollar styck, medan hårddiskarna i vår enhet är E3.S, och vi har frågat Dell när E3.S-alternativet dyker upp online. Och Dell är uppriktigt sagt att få företagsarbetsstationer köps till webbpris, så betrakta 28 300 dollar som ett tak som volym- och kontraktspriserna hamnar under. Minnet och GPU:n står för 19 090 dollar av det, och GPU-alternativet kostar detsamma oavsett om du väljer 300W- eller 600W-kortet.
Dell sätter exakt denna testenhet till 31 700 dollar i testad form, en siffra som lägger till E810-XXV 25GbE-adaptern, Wi-Fi 7, den optiska enheten och tre års ProSupport till den version vi prissatte.
Testuppsättning och metodik
Varje resultat i den här recensionen kommer från sr-client 1.2, vår skriptbaserade benchmark-svit för Windows-klienter, på dess fullständiga körprofil, med Dells fabriksinstallerade Windows-avbildning med Dells drivrutiner och NVIDIA-drivrutin 596.71 på alla fyra konfigurationer. Sviten tillämpar samma inställningar överallt: Windows energiläge med bästa prestanda, alla viloläge- och skärmavstängningstimers inaktiverade, Windows-brandväggen och UAC-prompter avaktiverade, VBS och minnesintegritet lämnas påslagna som levererade. Varje resultat är medianen av upprepade körningar, och sviten kör ett test vars spridning överstiger 2 procent innan den accepterar det.
De fyra konfigurationerna nedan är två tornkort och två grafikkort. Pro Precision 9 T2 körde hela sviten med sitt Max-Q-kort och återigen med 600W RTX PRO 6000 Blackwell från vår Pro Max Tower T2, och Pro Max Tower T2 körde båda korten i tur och ordning, så GPU-kolumnerna i ett tornkort skiljer sig bara åt i kortet och tornkolumnerna i ett GPU skiljer sig bara åt i plattformen. Core T2:s hårddisk är den enda 2TB Gen5 M.2 som den levererades med, och Xeon T2:s är dess två-disk E3.S-stripe, så lagrings- och modellladdningsraderna jämför dem som konfigurerats.
| konfiguration | CPU | Minne | GPU | Startdisk | OS och strömläge |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T2 (PW9T2260), Max-Q | Intel Xeon 658X, 24C / 48T, 250W | 128 GB DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300W, 96 GB | 2 x 2 TB E3.S Gen5 NVMe, VROC RAID0 (4 097 GB startvolym) | Windows 11 Pro för arbetsstationer 25H2, bästa prestanda |
| Dell Pro Precision 9 T2 (PW9T2260), 600 W | Intel Xeon 658X, 24C / 48T, 250W | 128 GB DDR5-6400 RDIMM ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600W, 96 GB | 2 x 2 TB E3.S Gen5 NVMe, VROC RAID0 (4 097 GB startvolym) | Windows 11 Pro för arbetsstationer 25H2, bästa prestanda |
| Dell Pro Max Tower T2 (FCT2250), Max-Q | Intel Core Ultra 9 285K, 24C/24T, 125W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 300W, 96 GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, Bästa prestanda |
| Dell Pro Max Tower T2 (FCT2250), 600 W | Intel Core Ultra 9 285K, 24C/24T, 125W | 128 GB DDR5-4400 ECC (4 x 32 GB) | NVIDIA RTX PRO 6000 Blackwell Workstation Edition, 600W, 96 GB | SK hynix PCB01 2TB, Gen5 x4 | Windows 11 Pro 26H2, Bästa prestanda |
Flera tester debuterar här, med början med LLM-serving, som kör llama-server med fyra modeller och sveper samtidighet från en begäran upp till det mesta som får plats i GPU-minnet, rapporterar total och per användare-genomströmning, tid till första token och tid per utdatatoken. Bildgenereringstestet renderar 1024×1024 bilder med FLUX.2 klein 4B, Z-Image Turbo 6B och Qwen-Image 20B vid Q4_0, Q8_0 och BF16-vikter, och poängsätter de kvantiserade utdata mot BF16 med PSNR och SSIM, så hastighet och återgivning ligger sida vid sida. Kodningsagenttestet körs nu på Crush, och agent-bredvid-användar-testet använder en reviderad metod som håller webbläsarens benchmark till tre fullständiga genomgångar.
Tre etiketter återkommer i tabellerna, som börjar med N/A, vilket betyder att ett test inte gäller för hårdvaran: SMT single-core på 285K, som inte har någon SMT, och OpenBLAS top-core-klassen på Xeon, vars 24 kärnor är en klass. Delvis markerar ett resultat som sviten accepterade med en anmärkning, oftast en kodningsagentnivå där en av tre körningar misslyckades med sina tester. Varken stationära datorer exponerade CPU- eller GPU-temperaturer för svitens sensorväg, så denna recensionsrapport avser CPU-klockor per test istället för en termisk tabell.
Lokal AI-prestanda
Med 96 GB GDDR7 i varje konfiguration är modellkapaciteten en given sak, och varje nivå i vår lokala AI-svit körs på alla fyra. Resultaten delas därför upp längs GPU-effektgränsen: där ett test är begränsat av minnesbandbredd körs Max-Q- och 600W-korten tätt ihop, och där det är begränsat av beräkningsförmåga ligger 600W-kortet före. CPU-plattformen spelar sällan någon roll, och där den gör det är riktningen värd att notera.
MLPerf-klient v2.0
MLPerf Client kör Llama 3.1 8B och Phi-4-mini genom fem promptkategorier och rapporterar tid till första token och tokenhastigheten efter den, som ett geometriskt medelvärde över kategorierna, med llama.cpp på CUDA som motor i varje konfiguration. Agentscenarierna kör Llama 3.1 8B som en dataanalysagent och en programvaruutvecklingsagent som anropar verktyg under flera omgångar.

| MLPerf-klient v2.0 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Llama 3.1 8B, tid till första token, geomean (s, lägre desto bättre) | 0.082 | 0.059 | 0.082 | 0.060 |
| Llama 3.1 8B, tokenhastighet, geomean (tok/s) | 230.9 | 252.8 | 230.0 | 246.7 |
| Phi-4-mini, tid till första token, geomean (s, lägre desto bättre) | 0.045 | 0.034 | 0.044 | 0.034 |
| Phi-4-mini, tokenhastighet, geomean (tok/s) | 345.9 | 379.0 | 351.0 | 374.3 |
| Dataanalytiker, heltäckande (s, lägre desto bättre) | 17.5 | 15.7 | 16.2 | 14.4 |
| Dataanalytikeragent, tokenhastighet (tok/s) | 202.9 | 223.9 | 202.3 | 218.4 |
| SWE-agent, heltäckande (s, lägre desto bättre) | 16.2 | 14.9 | 14.6 | 13.5 |
| SWE-agent, tokenhastighet (tok/s) | 197.5 | 214.6 | 195.5 | 210.2 |
Max-Q-kortet genererade Llama 3.1 8B med 230.9 tokens per sekund i Xeon-tornet och 230.0 i Core-tornet, och Phi-4-mini med 345.9 och 351.0, vilket är samma GPU som gör samma arbete. 600W-kortet höjde dessa till 252.8 och 379.0 tokens per sekund i Xeon-tornet, en vinst på cirka 9 procent, och minskade tiden till första token på Llama från 0.082 till 0.059 sekunder, en minskning med 28 procent. Snabb bearbetning är beräkningsbunden och avkodning är bandbreddsbunden, och de två korten delar samma minne, så effektbegränsningen syns mycket mer i den första token än i de efterföljande.
Agentscenarierna är där CPU-plattformen dyker upp. Dataanalysagenten slutförde på 16.2 sekunder på Core T2 med Max-Q-kortet och 17.5 på Xeon T2, och SWE-agenten på 14.6 mot 16.2, där Xeons verktygsanropsfaser tar cirka 1.5 sekunder längre i varje. Tokenhastigheterna matchar inom 1 procent, så skillnaden är verktygen som körs på processorn mellan modellanrop, där 285K:s snabbare kärnor slutförs tidigare.
Modellladdning
Detta test beräknar tiden för en lokal modell i Ollama från hårddisk till dess första genererade token, kall (filcachen rensad) och varm (filen finns redan i minnet), och rapporterar hur snabbt hårddisken lästes under kall laddning, när vikterna anlände till GPU-minnet, och en laddningseffektivitetssiffra som jämför läshastigheten under laddningen med hårddiskens sekventiella tak på 1 MB. Med 96 GB VRAM körs alla tre nivåerna: gpt-oss:20b vid 12.8 GB, Qwen3.6-35B-A3B vid 21.1 GB och gpt-oss:120b vid 60.9 GB.

| Modellinläsning (minnesmappning på) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| gpt-oss:20b, kall laddning till första token (s, lägre desto bättre) | 9.68 | 9.02 | 7.41 | 7.23 |
| gpt-oss:20b, varm laddning till första token (s, lägre desto bättre) | 7.52 | 7.18 | 6.60 | 6.61 |
| gpt-oss:20b, ankomst till GPU-minne, kallt (s, lägre desto bättre) | 4.44 | 4.33 | 3.00 | 2.95 |
| Qwen3.6-35B-A3B, kalllastning till första token (s, lägre desto bättre) | 13.31 | 12.32 | 11.62 | 11.01 |
| Qwen3.6-35B-A3B, varm laddning till första token (s, lägre desto bättre) | 11.63 | 10.75 | 10.35 | 9.99 |
| gpt-oss:120b, kall laddning till första token (s, lägre desto bättre) | 32.06 | 32.44 | 28.54 | 28.11 |
| gpt-oss:120b, varm laddning till första token (s, lägre desto bättre) | 27.18 | 26.49 | 25.58 | 25.73 |
| gpt-oss:120b, läsdataflöde under kall laddning (MB/s) | 9,875 | 9,106 | 11,633 | 11,248 |
| gpt-oss:120b, ankomst till GPU-minne, kallt (s, lägre desto bättre) | 11.33 | 11.57 | 7.74 | 7.63 |
| gpt-oss:120b laddas efter byte från gpt-oss:20b (s, lägre desto bättre) | 14.30 | 13.97 | 11.89 | 11.93 |
| Enhetsgräns, DiskSpd 1 MB sekventiell läsning (MB/s) | 11,306 | 11,296 | 11,563 | 11,646 |
Core T2 laddar alla modeller snabbare, och det är hårddisken som är anledningen. gpt-oss:120b nådde sin första token på 28.54 sekunder kallt på Core T2 jämfört med 32.06 på Xeon T2, med 61 GB vikter som anlände till GPU-minnet på 7.74 sekunder jämfört med 11.33. Den enskilda PCB01 matade den med 11 633 MB/s, precis vid dess 11 563 MB/s DiskSpd-tak, medan E3.S-stripen matade den med 9 875 MB/s mot ett eget tak på 11 306 MB/s. RAID-volymen läser stora block nästan lika snabbt som den enskilda hårddisken men klarar inte den hastigheten genom Ollamas minnesmappade laddningsväg.
Varma belastningar minskar gapet till en sekund eller två, eftersom filen redan finns i systemminnet och det som återstår är överföringen till VRAM och llama.cpps inställningar: 27.18 sekunder på Xeon T2 mot 25.58 för gpt-oss:120b, och 7.52 mot 6.60 för gpt-oss:20b. GPU:ns effektgräns gör ingen konsekvent skillnad för belastningen, som förväntat.
Kodningsagent
Crush, en terminalkodningsagent, driver en lokal modell som hanteras av Ollama genom en fast kodningsuppgift i ett fäst repository, med upp till tre rundor för att få repositoryets 11 tester att klaras. Vi rapporterar medianväggtiden för tre körningar, hur många som lyckades och genereringshastigheten. Väggtiden beror på hur många verktygsanrop och tokens modellen väljer att spendera, vilket varierar från körning till körning, så genereringshastigheten är den renare hårdvarujämförelsen. Agent-bredvid-användar-testet kör agenten och hastighetsmätaren tillsammans och rapporterar hur mycket var och en saktar ner den andra.

| Crush-kodningsmedel | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Nivå S, gpt-oss:20b, 64K kontext | ||||
| Väggtid, median (s, lägre desto bättre) | 55.1 | 99.8 | 57.2 | 43.2 |
| Framgångar (av 3) | 3 | 2 | 3 | 2 |
| Genereringshastighet (tok/s) | 214.1 | 237.9 | 218.0 | 237.7 |
| Nivå M, Qwen3.6-35B-A3B, 64K kontext | ||||
| Väggtid, median (s, lägre desto bättre) | 35.2 | 27.0 | 86.7 | 32.1 |
| Framgångar (av 3) | 3 | 3 | 3 | 3 |
| Genereringshastighet (tok/s) | 234.5 | 242.9 | 223.3 | 245.8 |
| Nivå L, Qwen3.6-35B-A3B, 128K kontext | ||||
| Väggtid, median (s, lägre desto bättre) | 38.1 | 30.6 | 74.1 | 58.8 |
| Framgångar (av 3) | 3 | 3 | 3 | 3 |
| Genereringshastighet (tok/s) | 222.9 | 237.0 | 231.1 | 252.8 |
| Nivå W, gpt-oss:120b, 128K kontext | ||||
| Väggtid, median (s, lägre desto bättre) | 49.1 | 37.9 | 56.6 | 30.8 |
| Framgångar (av 3) | 3 | 3 | 3 | 3 |
| Genereringshastighet (tok/s) | 160.9 | 177.1 | 158.5 | 174.4 |
| Agent bredvid användaren (gpt-oss:20b och hastighetsmätare tillsammans) | ||||
| Hastighetsmätare bredvid agenten (poäng) | 36.6 | 36.7 | 43.2 | 45.2 |
| Hastighetsmätarens nedbromsning (x, lägre desto bättre) | 1.005 | 1.011 | 1.053 | 1.044 |
| Agentgenereringshastighet bredvid hastighetsmätare (tok/s) | 218.2 | 231.6 | 212.4 | 229.2 |
| Agentens nedgång (x, lägre desto bättre) | 1.006 | 1.009 | 1.023 | 0.998 |
Varje konfiguration slutförde alla tre körningar av nivå W-uppgiften med gpt-oss:120b, den största modellen i sviten, och genererade 160.9 till 177.1 tokens per sekund i Xeon-tornet och 158.5 till 174.4 i Core-tornet, med 600W-kortet värt cirka 10 procent i varje. Qwen3.6-uppgifterna klarade också tre av tre överallt, med 223 till 253 tokens per sekund. gpt-oss:20b är modellen som snubblade: nivå S-uppgiften förlorade en av tre körningar på två av de fyra konfigurationerna, och dess 128K-kontextnivå M-uppgift (visas ej) förlorade minst en körning överallt, ett modellbeteende som hårdvaran inte ändrar.
Att köra agenten och ett webbläsartest samtidigt kostar nästan ingenting på en tornprocessor med en separat GPU och 24 kärnor till övers. Hastighetsmätaren saktade ner med 1.005x på Xeon T2 och 1.053x på Core T2 med agenten igång, och agentens genereringshastighet ökade med 2 procent eller mindre i samtliga fall. Xeon T2:s hastighetsmätare på 36.6 bredvid agenten är lägre än Core T2:s 43.2 av samma anledning som den är lägre ensam: 285K:s hastighet per kärna.
Retrieval-Augmented Generation
Vårt RAG-test bäddar in 20 963 SQuAD v1.1-avsnitt med nomic-embed-text, hämtar de fem bästa avsnitten för var och en av 2 000 frågor och besvarar 400 av dem med Phi-4-mini, med exakt matchning och F1 mot referenssvaren. Modellerna är små, så testet mäter hela pipelinen, inklusive CPU-sidans vektorsökning mellan GPU-faserna.

| RAG | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Ingestionsväggstid, 20 963 passager (s, lägre desto bättre) | 128.5 | 125.5 | 108.1 | 103.0 |
| Inbäddningshastighet (tok/s) | 29,875 | 30,592 | 35,165 | 37,508 |
| Hämtningstid för frågesökning, p50 (ms, lägre desto bättre) | 30.6 | 27.2 | 23.4 | 18.7 |
| Svar, Phi-4-mini tid till första token, p50 (s, lägre desto bättre) | 0.099 | 0.087 | 0.089 | 0.083 |
| Svar, snabb bearbetning (tok/s) | 20,318 | 26,549 | 21,356 | 26,619 |
| Svar, genereringshastighet (tok/s) | 296.4 | 337.8 | 324.3 | 344.1 |
| Fråga att besvara, p50 (s, lägre desto bättre) | 0.152 | 0.133 | 0.130 | 0.120 |
| Återkallelse@5 (%) | 82.7 | 82.7 | 82.7 | 82.7 |
| Svar F1 (%) | 74.65 | 74.65 | 74.65 | 74.65 |
Core T2 är snabbare genom denna pipeline. Den intog corpus på 108.1 sekunder mot 128.5 på Xeon T2 med samma Max-Q-kort, hämtade på 23.4 ms mot 30.6 som median, och besvarade en fråga på 0.130 sekunder mot 0.152. Båda stegen för inbäddning och hämtning har CPU-bundna steg, och de gynnar 285K. 600W-kortet ökade den snabba bearbetningen med 25 till 30 procent på båda plattformarna, från 20 318 till 26 549 tokens per sekund på Xeon T2, och noggrannheten var identisk i alla fyra konfigurationer, vilket den borde vara med samma modeller vid temperatur 0.
LLM Servering
Serveringstestet kör llama-server med Ministral 3 3B och 8B (4 096-token-prompter, 1 024-token-utdata), Qwen3.8 27B och gpt-oss 120B (8 192-token-prompter), allokerar så många platser som får plats i GPU-minnet efter vikterna och sveper sedan samtidighet från en begäran upp till den gränsen. Vi rapporterar total dataflöde (prompt- och utdatatokens tillsammans), utdatadataflöde, tid till första token och tid per utdatatoken vid medianvärdet. På ett 96 GB-kort får gpt-oss 120B plats på 64 platser med 22.5 GiB KV-cache, Qwen3.8 27B får plats med åtta och de två Ministral-modellerna får plats med fyra i sin kontext.

| llama-server, gpt-oss 120B, 8 192-token-prompter, 1 024-token-utdata | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| 1 samtidig: utdataflöde (tok/s) | 160.6 | 182.7 | 158.4 | 179.0 |
| 1 samtidiga: tid till första token, median (ms, lägre desto bättre) | 1,241 | 918 | 1,238 | 923 |
| 1 samtidiga: tid per utdatatoken, median (ms, lägre desto bättre) | 5.03 | 4.58 | 5.11 | 4.70 |
| 8 samtidiga: total genomströmning (tok/s) | 2,088 | 2,460 | 2,154 | 2,534 |
| 8 samtidiga: utdata per användare (tok/s) | 29.0 | 34.2 | 29.9 | 35.2 |
| 8 samtidiga: tid till första token, median (ms, lägre desto bättre) | 2,847 | 2,152 | 2,856 | 2,121 |
| 64 samtidiga: total genomströmning (tok/s) | 3,296 | 3,805 | 3,531 | 4,220 |
| 64 samtidiga: utdata per användare (tok/s) | 5.7 | 6.6 | 6.1 | 7.3 |
| 64 samtidiga: tid till första token, median (ms, lägre desto bättre) | 4,315 | 3,491 | 4,607 | 3,622 |
| 64 samtidiga: tid per utdatatoken, median (ms, lägre desto bättre) | 163.0 | 141.3 | 152.7 | 126.3 |
En enskild användare får gpt-oss 120B med 160.6 tokens per sekund på Max-Q-kortet och 182.7 på 600W-kortet, där den första token anländer efter 1 241 och 918 ms efter en prompt på 8 192 tokens. Att ladda kortet med 64 samtidiga förfrågningar ökade den totala dataflödet till 3 296 tokens per sekund på Max-Q och 3 805 på 600W-kortet, till en kostnad av 5.7 och 6.6 tokens per sekund per användare och första tokens på 4.3 och 3.5 sekunder. Kurvan planar ut mellan 4 och 32 samtidiga förfrågningar och hoppar igen vid 64, där batchen slutligen amorterar de långa prompterna.

| llama-server, utdataflöde vid den högsta samtidigheten som passar (tok/s) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Minister 3 3B Resonemang, 4 samtidiga | 562.5 | 600.4 | 576.8 | 625.3 |
| Minister 3 8B Resonemang, 4 samtidiga | 375.8 | 445.1 | 377.9 | 446.3 |
| Qwen3.8 27B, 8 samtidiga | 153.1 | 189.6 | 152.2 | 187.3 |
| gpt-oss 120B, 64 samtidiga | 366.3 | 422.8 | 392.3 | 468.9 |
| Dataflöde för enskild begäran (tok/s) | ||||
| Ministral 3 3B Resonemang | 232.1 | 241.8 | 232.1 | 246.0 |
| Ministral 3 8B Resonemang | 165.0 | 183.3 | 164.1 | 180.4 |
| Qwen3.8 27B | 54.0 | 63.7 | 54.1 | 63.0 |
| gpt-oss 120B | 160.6 | 182.7 | 158.4 | 179.0 |
Den kompakta Qwen3.8 27B är den långsammaste modellen här för en enskild användare med 54.0 tokens per sekund på Max-Q, eftersom varje token berör alla 27 miljarder parametrar, medan expertmixen gpt-oss 120B kör 3.0 gånger snabbare trots att den är fyra gånger större på disken. 600W-kortets fördel är störst på den kompakta modellen, 24 procent vid åtta samtidiga förfrågningar, och smalast på Ministral 3B på cirka 7 procent. De två tornen ligger inom cirka 3 procent överallt utom i gpt-oss-fallet med 64 förfrågningar, där Core T2 ledde med 7 till 11 procent med båda korten, så serverns CPU-sidas arbete vid den batchstorleken gynnar de snabbare kärnorna.
Bildgenerering
Bildgenereringstestet renderar 1024×1024 bilder med tre diffusionsmodeller vid tre viktningsprecisioner och rapporterar tiden per bild, brusreduceringshastigheten och GPU-minnet som vikterna upptar. Det renderar också samma frö vid BF16 och poängsätter Q4_0- och Q8_0-utdata mot det med PSNR och SSIM, vilket sätter en siffra på vad kvantisering kostar i bilden.

| Bildgenerering, 1024×1024 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| FLUX.2 klein 4B, 4 steg | ||||
| Q8_0: sekunder per bild (lägre desto bättre) | 1.66 | 1.37 | 1.59 | 1.30 |
| Q8_0: bilder per minut | 36.2 | 43.7 | 37.6 | 46.0 |
| BF16: sekunder per bild (lägre desto bättre) | 1.60 | 1.34 | 1.55 | 1.27 |
| Z-Image Turbo 6B, 8 steg | ||||
| Q8_0: sekunder per bild (lägre desto bättre) | 3.82 | 2.89 | 3.78 | 2.82 |
| Q8_0: bilder per minut | 15.7 | 20.7 | 15.9 | 21.3 |
| BF16: sekunder per bild (lägre desto bättre) | 3.61 | 2.76 | 3.56 | 2.68 |
| Qwen-Image 20B, 20 steg | ||||
| Q4_0: sekunder per bild (lägre desto bättre) | 25.60 | 19.11 | 25.57 | 18.97 |
| Q8_0: sekunder per bild (lägre desto bättre) | 26.08 | 19.66 | 26.02 | 19.42 |
| BF16: sekunder per bild (lägre desto bättre) | 26.17 | 20.45 | 26.05 | 20.28 |
| Q8_0: bilder per minut | 2.30 | 3.05 | 2.31 | 3.09 |
| BF16: GPU-minne för vikter (GiB) | 45.3 | 45.3 | 45.3 | 45.3 |
Diffusion är beräkningsbunden, och 600W-kortet visar det: Qwen-Image 20B vid Q8_0 tog 26.1 sekunder per bild på Max-Q och 19.7 på 600W-kortet i Xeon-tornet, en ökning på 33 procent i bilder per minut, med Z-Image Turbo som ökade med 32 procent och FLUX.2 klein 21 procent. CPU-plattformen är irrelevant här, med de två tornen inom 1 procent på varje rad förutom serverstart, där Xeon T2:s RAID-volym tar några sekunder längre tid att ladda vikterna.
| Kvantiseringskvalitet mot BF16 (samma frö) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| PSNR (dB, högre desto bättre) / SSIM (högre desto bättre) | ||||
| FLUX.2 liten 4B, Q4_0 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 | 17.5 / 0.788 |
| FLUX.2 liten 4B, Q8_0 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 | 32.9 / 0.987 |
| Z-Image Turbo 6B, Q4_0 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 | 19.6 / 0.752 |
| Z-Image Turbo 6B, Q8_0 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 | 28.5 / 0.938 |
| Qwen-Bild 20B, Q4_0 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 | 22.3 / 0.792 |
| Qwen-Bild 20B, Q8_0 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 | 35.8 / 0.985 |
Fidelity-raderna är identiska för de fyra konfigurationerna, eftersom utdata beror på vikterna och inte hårdvaran. Q8_0 reproducerar BF16-bilden vid en SSIM på 0.938 till 0.987 och 28 till 36 dB PSNR, medan Q4_0 faller till 0.75 till 0.79 SSIM och 18 till 22 dB, vilket är en annan bild. På ett 96 GB-kort finns det ingen minnesskäl att köra dessa modeller under Q8_0; Qwen-Images BF16-vikter passar på 45.3 GiB, och BF16 renderas lika snabbt som Q8_0 eller något snabbare på alla tre modellerna, eftersom Q8_0-vägen spenderar tid på att avkvantisera.
CPU-prestanda
De två processorerna delar upp vår CPU-svit längs en ren linje. Där ett test använder alla kärnor vinner Xeon 658X med 27 till 150 procent i de flesta av dem, och ju bredare vektorerna är och ju tyngre minnestrafiken är, desto större är dess marginal. Där ett test körs på en tråd eller några få vinner Core Ultra 9 285K med 13 till 31 procent tack vare en 5.7 GHz P-kärna mot en 4.9 GHz Xeon-kärna med högre cache och minneslatens. 600W GPU:ns effekt på Xeons resultat från alla kärnor täcks av varje tabell och sammanfattas i klockavsnittet.
Cinebench 2026 och ihållande belastning
Cinebench 2026 renderar en scen med Maxons Redshift-motor på processorn och mäter genomströmning för enkärnig, SMT-enkärnig (två trådar på en fysisk kärna) och flerkärnig. Vi följer upp det med en kontinuerlig loop som upprepar flerkärnig körning i cirka 30 minuter och jämför stationärt tillstånd med det första passet.

| Cinebench 2026 (poäng, högre desto bättre) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Enstaka kärna | 454.1 | 455.6 | 564.4 | 564.5 |
| SMT enkelkärnig | 599.1 | 601.0 | Ej tillämpligt (ingen SMT) | Ej tillämpligt (ingen SMT) |
| Flerkärnig | 12,322 | 11,705 | 8,856 | 8,838 |
| Ihållande loop, första pass | 12,201 | 11,731 | 8,717 | 8,788 |
| Ihållande loop, stationärt tillstånd | 12,328 | 11,764 | 8,825 | 8,844 |
| Steady state / första genomgång | 1.010 | 1.003 | 1.012 | 1.006 |
| Ihållande loop, stationär CPU-klocka (MHz) | 4,274 | 4,178 | 4,669 | 4,690 |
658X fick 12 322 flerkärniga processorer med Max-Q-kortet installerat, 39 procent före 285K:s 8 856, och höll 12 328 under den 30 minuter långa loopen, ett stabilt tillstånd på 1 procent över sin första omgång. På en kärna är ordningen omvänd: 285K fick 564.4 mot Xeons 454.1, och det krävs två trådar på en Xeon-kärna, vid 599.1, för att passera 285K:s entrådiga siffra.
Genom att byta till 600W-kortet ökade Xeons flerkärniga poäng till 11 705 och dess steady state till 11 764, 5 procent lägre, med en steady state-klockfrekvens nere från 4 274 till 4 178 MHz. Core T2 visade ingen sådan förändring, vid 8 856 och 8 838. Sviten registrerade inte CPU- eller GPU-temperaturer på något av tornen, så vi kan inte säga om 250W-processorn förlorar på grund av 600W-kortets värme eller på grund av en delad strömförbrukning, bara att den förlorar 4 till 5 procent på varje all-core-test med det större kortet i chassit.
7-Zip
7-Zips inbyggda benchmark rapporterar LZMA-komprimerings- och dekomprimeringsgenomströmning i giga-instruktioner per sekund, en gång på varje tråd och en gång fäst på en enda kärna. LZMA bygger på heltalsgenomströmning, grenprediktion samt cache- och minneslatens, så det belönar kärnantal och en snabb minnesväg mer än vektorbredd.

| 7-Zip (GIPS, högre desto bättre) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Alla trådar | ||||
| Totalt | 289.6 | 288.9 | 174.8 | 175.7 |
| Komprimera | 276.4 | 273.5 | 151.5 | 151.9 |
| packa | 303.0 | 304.4 | 198.1 | 199.4 |
| En tråd | ||||
| Totalt | 8.74 | 8.05 | 10.82 | 10.83 |
| Komprimera | 8.66 | 7.80 | 9.31 | 9.31 |
| packa | 8.83 | 8.30 | 12.33 | 12.34 |
På 48 trådar hade Xeon ett snitt på 289.6 GIPS mot 285K:s 174.8 den 24:e tråden, en ledning på 66 procent, med en ledning på 82 procent för kompression och 53 procent för dekompression. På en tråd hade 285K ledningen på 10.82 GIPS mot 8.74, och gapet ökade med 600W-kortet i Xeon-tornet till 8.05, i linje med de lägre klockfrekvenserna som konfigurationen körde på.
Blender, HandBrake och LLVM
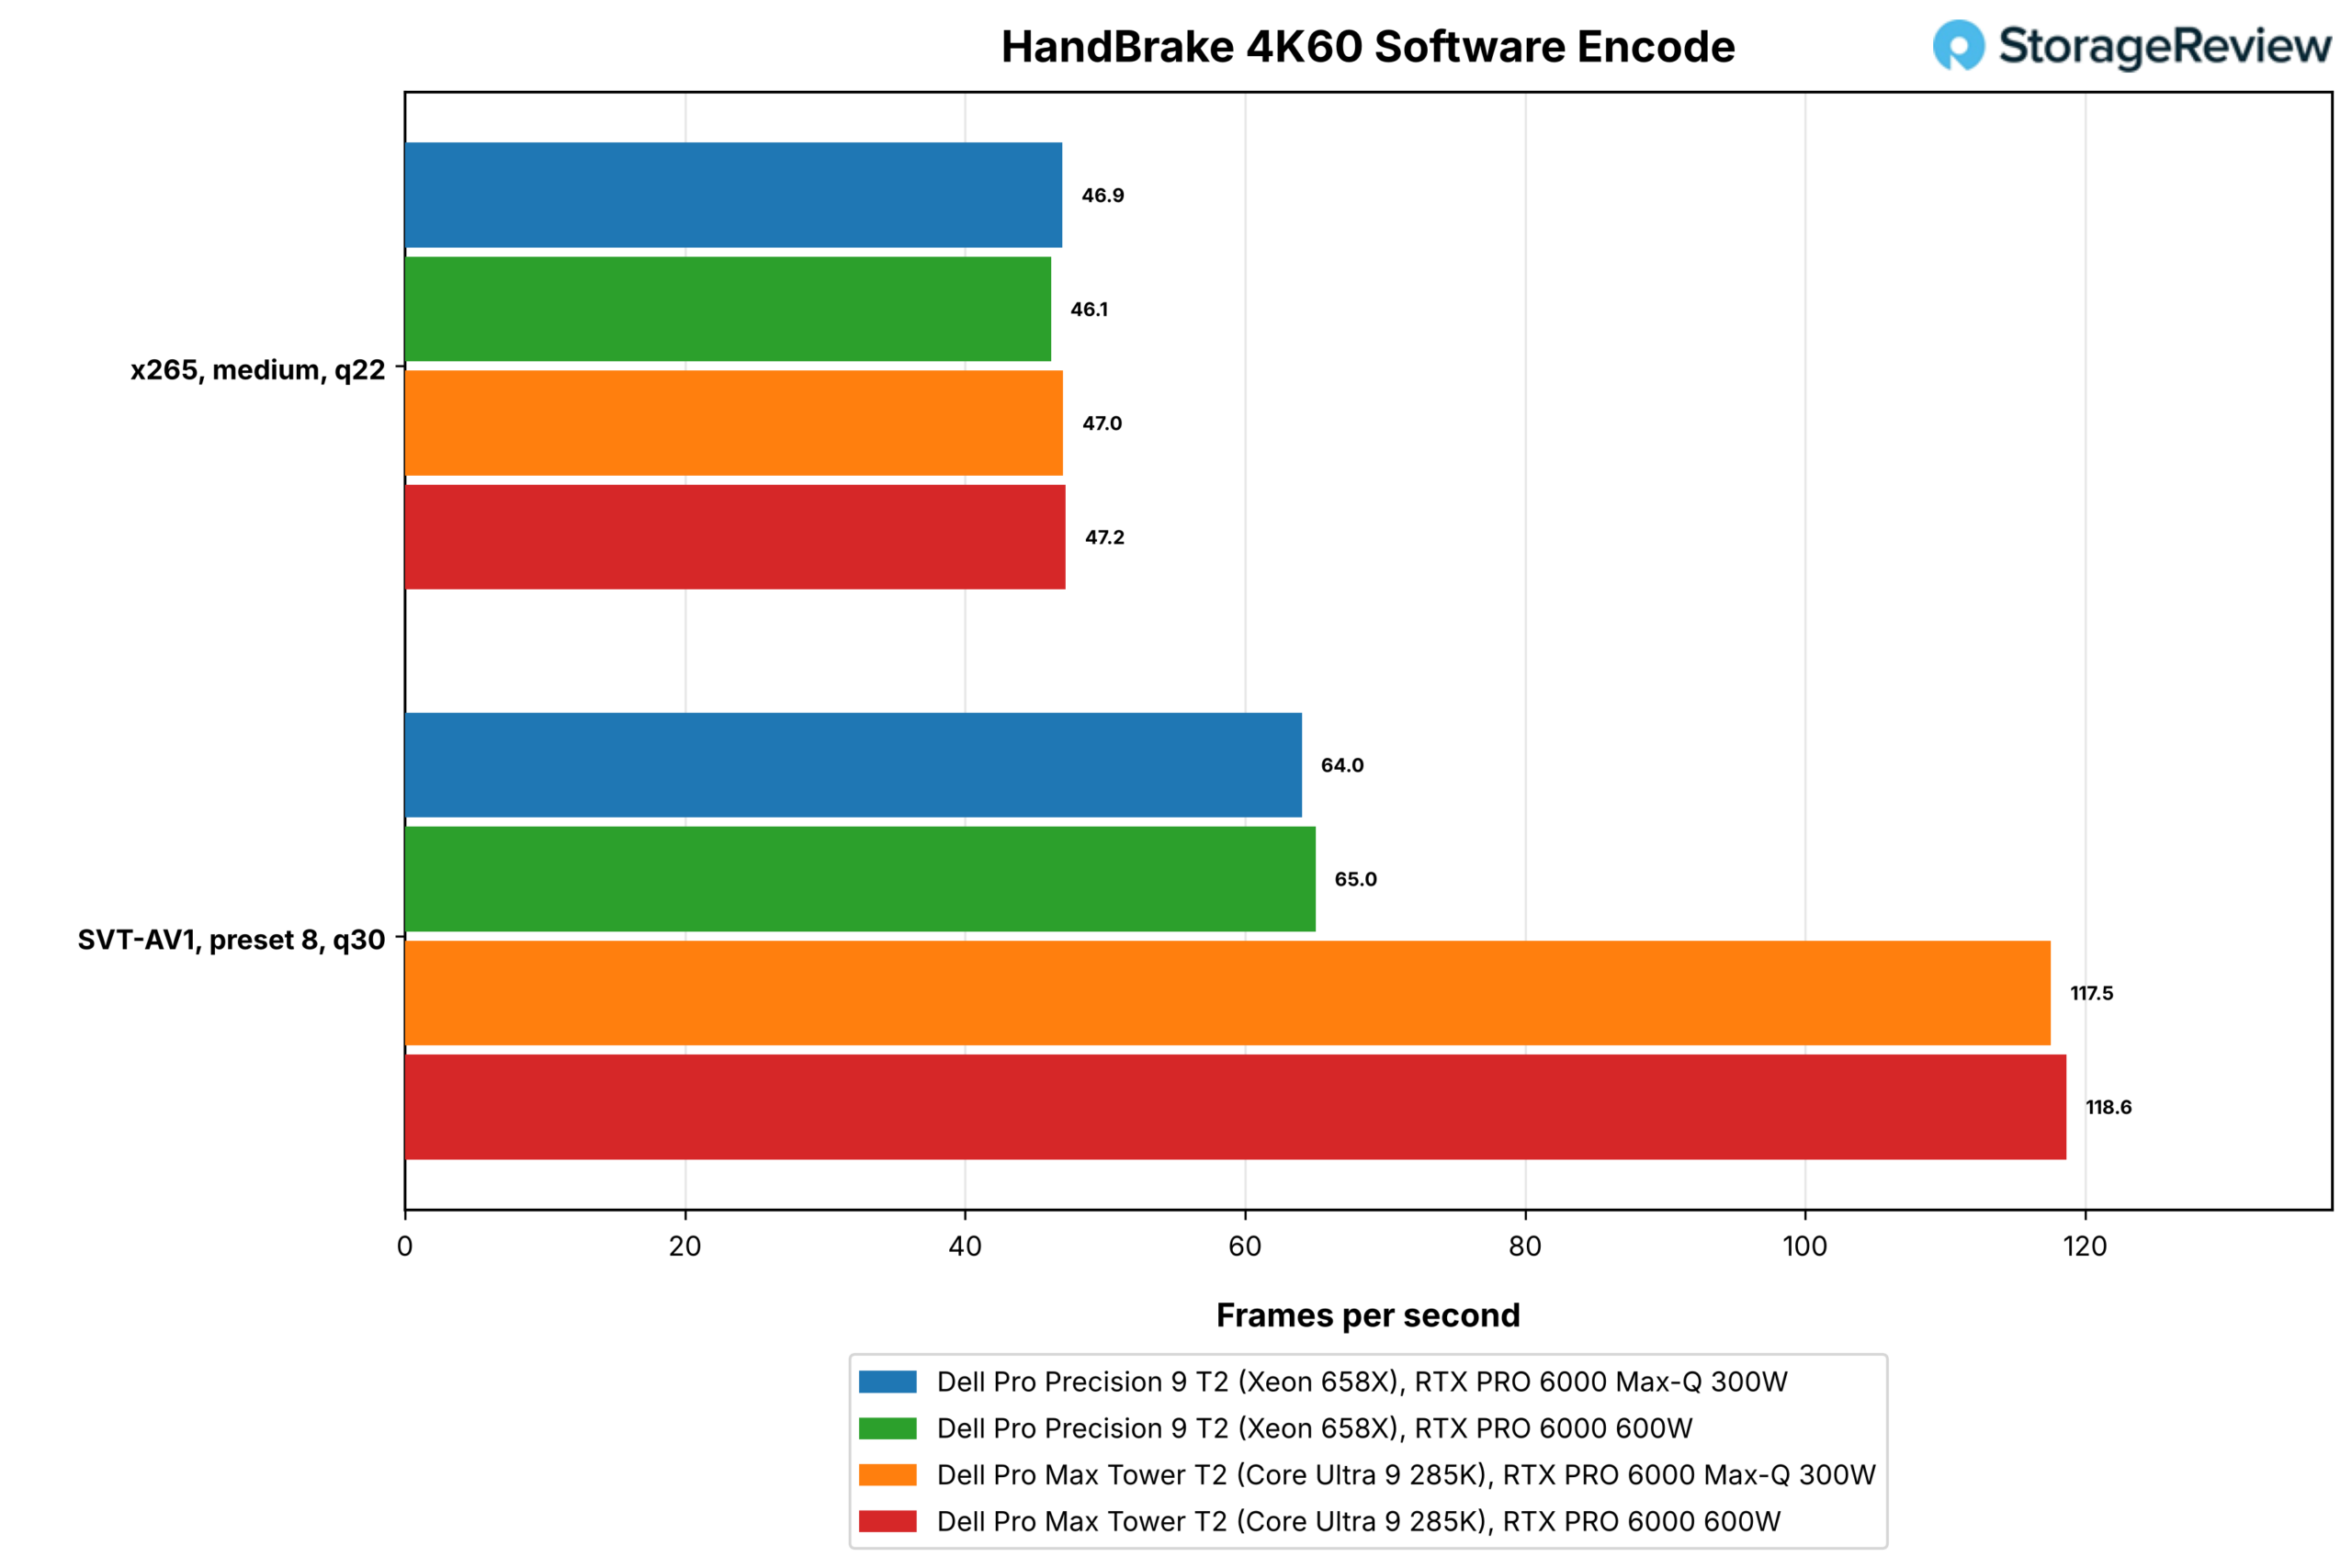
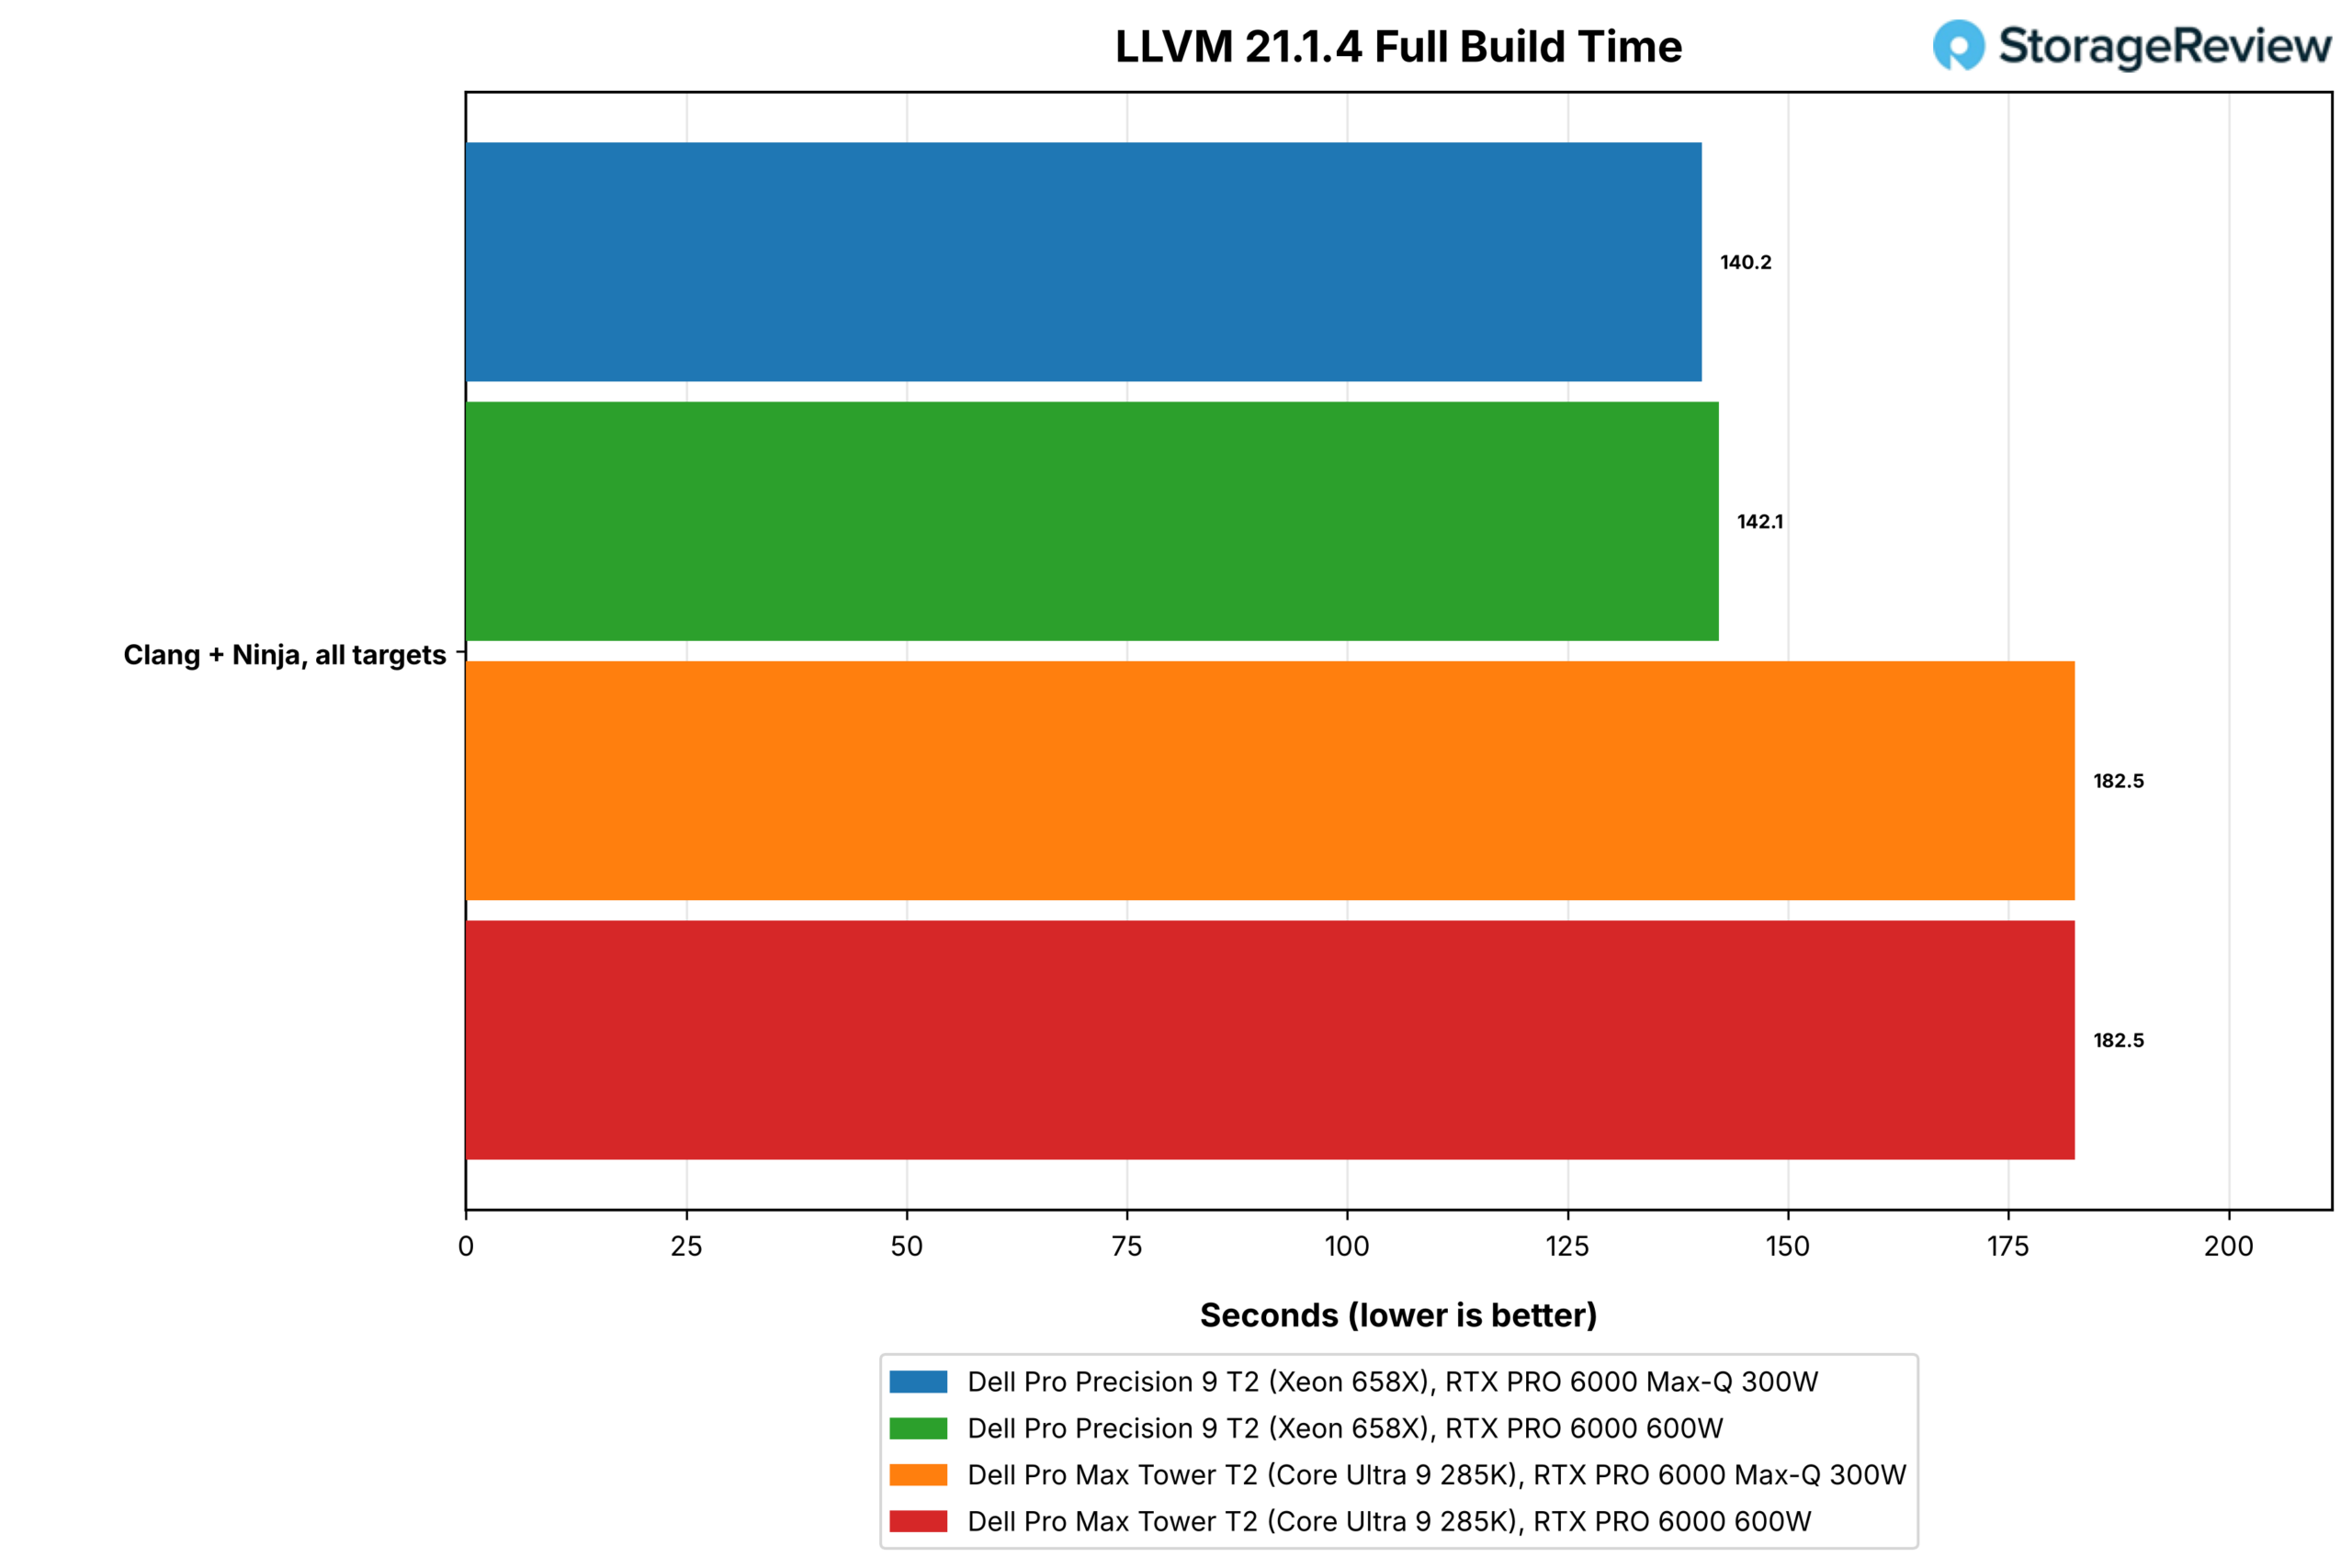
Blender 4.5 renderar scenerna Monster, Junkshop och Classroom med Cycles på processorn. HandBrake kodar 60 sekunder av ett 4K60-klipp i programvara med x265 (HEVC, medium förinställning, kvalitet 22) och SVT-AV1 (förinställning 8, kvalitet 30). LLVM-testet kompilerar hela LLVM 21.1.4-trädet med Clang och Ninja, den längsta all-core-arbetsbelastningen i sviten.

| Testa | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Blender 4.5 Monster (prover/min, högre desto bättre) | 366.2 | 339.0 | 259.6 | 257.7 |
| Blender 4.5 Junkshop (prover/min) | 238.1 | 228.0 | 166.2 | 166.8 |
| Blender 4.5 Klassrum (prover/min) | 187.2 | 169.2 | 132.5 | 132.3 |
| HandBrake x265, medium, q22 (fps, högre desto bättre) | 46.9 | 46.1 | 47.0 | 47.2 |
| HandBrake SVT-AV1, förinställning 8, q30 (fps) | 64.0 | 65.0 | 117.5 | 118.6 |
| LLVM 21.1.4 build (s, lägre desto bättre) | 140.2 | 142.1 | 182.5 | 182.5 |
Xeon renderade Monster med 366.2 samplingar per minut mot 259.6 på 285K, en ledning på 41 procent som ligger inom två poäng över alla tre scener, och den byggde LLVM på 140.2 sekunder mot 182.5, 23 procent kortare tid. Med 600W-kortet installerat sjönk Xeons Blender-poäng med 7 till 10 procent, den högsta kostnaden för kortet någonstans i CPU-sviten.
HandBrake delade sig längs kodarlinjerna: x265 vid medelinställningen körde på 46.9 fps på Xeon och 47.0 på 285K, oavgjort, medan SVT-AV1 vid förinställning 8 körde på 64.0 fps på Xeon mot 117.5 på 285K.
Vi tillbringade en eftermiddag med att analysera det gapet, och det är ett resultat per tråd. Kodaren når sin topp på parallellitetsnivå 6 vid denna förinställning och håller ungefär nio logiska processorers arbete sysselsatt på Xeon; att tvinga sina AVX2-kärnor istället för AVX-512 förändrade ingenting (63.8 mot 63.9 fps), och att fästa den till en tråd per fysisk kärna gick 2 procent långsammare (62.6 fps), så varken vektorvägen eller SMT-schemaläggning är orsaken. Det som återstår är själva Xeon-kärnan och nätet mellan kärnorna, vilket en pipeline-kodare som väntar på handoffs mellan steg känner av i varje bildruta.
Stockfish, primesieve, Python och webbläsaren
Stockfishs inbyggda bänk rapporterar schacksökningshastighet i miljoner noder per sekund. primesieve räknar primtalen under 10^12 på alla trådar och under 10^11 på en tråd. PyPerformance kör tre CPython-benchmarks (go, nbody och regex_compile) fästa på en snabb kärna, och Speedometer 3.1 mäter webbapplikationers responsivitet i Microsoft Edge.
| Testa | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Stockfish-bänk, alla trådar (Mnps, högre desto bättre) | 40.87 | 39.17 | 30.10 | 30.63 |
| Stockfiskbänk, en tråd (Mnps, högre desto bättre) | 1.65 | 1.60 | 1.99 | 1.99 |
| primesieve 1e12, alla trådar (s, lägre desto bättre) | 7.69 | 7.51 | 6.77 | 6.84 |
| primesieve 1e11, en tråd (s, lägre desto bättre) | 10.09 | 10.76 | 8.72 | 8.72 |
| PyPerformance go (ms, lägre desto bättre) | 91.4 | 91.0 | 64.8 | 64.9 |
| PyPerformance nbody (ms, lägre desto bättre) | 68.3 | 68.8 | 54.3 | 53.8 |
| PyPerformance regex_compile (ms, lägre desto bättre) | 88.6 | 90.5 | 61.1 | 61.2 |
| Hastighetsmätare 3.1, Edge (poäng, högre desto bättre) | 36.8 | 37.3 | 46.3 | 46.5 |
Stockfish nådde 40.87 Mnps på Xeon mot 30.10 på 285K på 48 trådar, och på en tråd ledde 285K med 1.99 mot 1.65. primesieve är det enda all-thread-testet som 285K vinner, med 6.77 sekunder mot 7.69, eftersom dess sieve får plats i cachen och skalar med klockan lika mycket som med kärnorna. De enkeltrådade raderna går alla till 285K med 13 till 31 procent: PyPerformance går på 64.8 ms mot 91.4, regex_compile på 61.1 mot 88.6, och Speedometer på 46.3 mot 36.8.
Det siffran i webbläsaren är den en köpare upplever vid skrivbordet. Ett Speedometer-resultat på 36.8 är fortfarande snabbt i absoluta termer, men det är en femtedel under Core-torndatorn i samma chassi, och alla som väljer Xeon för dess dataflöde bör förvänta sig att maskinens interaktiva sida är ett steg långsammare än en Core Ultra-stationär dator.
GROMACS, OpenBLAS och minne
GROMACS kör benchMEM-fallet för molekylär dynamik på 16 kärnor i fyra rank-and-thread-layouter och rapporterar nanosekunder simulerad tid per dag för bästa layout. Vårt OpenBLAS-test kör en HPL-liknande dubbelprecisions-LU-lösning vid tre problemstorlekar och en DGEMM-matrismultiplikation på alla kärnor, och på 285K igen på dess åtta P-kärnor enbart; Xeons 24 kärnor är en klass, så de raderna gäller inte. STREAM mäter ihållande minnesbandbredd, och latensraderna mäter en enda åtkomst till minne och mellan kärnor.

| Testa (högre desto bättre) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| GROMACS benchMEM, bästa layout (ns/dag) | 47.39 | 47.91 | 37.30 | 37.07 |
| OpenBLAS LU N=10000, alla kärnor (GFLOPS) | 570.3 | 517.3 | 519.7 | 523.1 |
| OpenBLAS LU N=20000, alla kärnor (GFLOPS) | 1,208.6 | 1,100.6 | 633.2 | 631.8 |
| OpenBLAS LU N=40000, alla kärnor (GFLOPS) | 1,659.2 | 1,613.7 | 667.9 | 669.5 |
| OpenBLAS LU N=20000, endast P-kärnor (GFLOPS) | Ej tillämpligt (en kärnkurs) | Ej tillämpligt (en kärnkurs) | 515.2 | 517.7 |
| OpenBLAS DGEMM M=8000, alla kärnor (GFLOPS) | 1,637.8 | 1,750.9 | 768.2 | 767.6 |
| OpenBLAS DGEMM M=8000, endast P-kärnor (GFLOPS) | Ej tillämpligt (en kärnkurs) | Ej tillämpligt (en kärnkurs) | 565.3 | 566.5 |
Det är här AVX-512, 144 MB L3 och fyra kanaler DDR5-6400 kombineras. DGEMM nådde 1 638 GFLOPS på Xeon mot 768 på 285K, och N=40000 LU-lösningen, som strömmar 11.9 GB genom minnet, kördes på 1 659 mot 668 GFLOPS, 2.5 gånger Core-tornets. 285K:s resultat rör sig knappt från N=20000 till N=40000 eftersom det är bandbreddsbundet då, medan Xeon fortsätter att skala. GROMACS på 16 kärnor gynnade Xeon med 27 procent vid 47.39 ns/dag.

| Testa | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| STREAM-kopiering (MB/s, högre desto bättre) | 106,698 | 106,512 | 39,477 | 39,426 |
| STREAM-skala (MB/s) | 105,368 | 105,180 | 39,788 | 39,801 |
| STREAM Lägg till (MB/s) | 119,520 | 119,332 | 36,324 | 36,306 |
| STREAM-triaden (MB/s) | 122,233 | 122,135 | 33,003 | 33,014 |
| Minnesfördröjning, 1 GiB buffert, 4 KiB sidor (ns, lägre desto bättre) | 148.3 | 147.8 | 135.2 | 135.4 |
| Kärna-till-kärna-latens, medelvärde av alla par (ns, lägre desto bättre) | 56.2 | 56.0 | 38.1 | 38.2 |
| Kärna-till-kärna-latens, minsta par (ns) | 4.6 | 4.6 | 18.6 | 18.6 |
| Kärna-till-kärna-latens, maximalt par (ns) | 65.7 | 66.8 | 44.7 | 44.5 |
STREAM Triad körde med 122 233 MB/s på Xeon T2 och 33 003 på Core T2, 3.7 gånger bandbredden, från fyra kanaler DDR5-6400 RDIMM mot fyra DDR5-4400 UDIMM på en plattform som inte kan hålla jämna steg med sina DIMM-moduler. Kostnaden är latens: 148.3 ns till minne på Xeon mot 135.2 på 285K, och 56.2 ns mellan kärnor i genomsnitt mot 38.1. Xeons minimum på 4.6 ns är ett par SMT-syskon på en kärna, och dess maximum på 65.7 ns är en resa över mesh-kretsen.
Gaming
SuperTuxKart 1.5 kör sitt inbyggda riktmärke i 1080p helskärm på den högsta förinställningen med vsync av, och vi rapporterar den genomsnittliga och den stabila bildfrekvensen. Vid denna upplösning har GPU:n mer utrymme att spara, så resultatet följer processorn, och testet ersätter de många professionella visningsportarna som är begränsade på samma sätt. NVENC-godkännandet i vårt kodningstest slutfördes inte på dessa system och utelämnas.

| SuperTuxKart 1.5, 1080p Ultra, vsync av (fps, högre desto bättre) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Genomsnitt | 304.6 | 323.2 | 359.1 | 383.5 |
| Vanligtvis | 304 | 322 | 354 | 376 |
| Steady | 161 | 174 | 122 | 135 |
Core T2 snittade 359.1 fps med Max-Q-kortet jämfört med 304.6 på Xeon T2, återigen samma gap som single-thread, medan Xeon-tornet höll en högre stabil bildfrekvens på 161 fps jämfört med 122, med färre dippar. 600W-kortet bidrog med cirka 6 procent till genomsnittet i båda tornen.
Klockor under belastning
Varken tornet rapporterade CPU- eller GPU-temperaturer genom svitens sensorväg, så den termiska tabell vi vanligtvis publicerar ersätts här med den genomsnittliga CPU-klockan under varje test, vilket är det tal som förklarar 600W-kortets effekt på Xeon. Med Max-Q installerat höll 658X 4 269 MHz genom den 30 minuter långa ihållande loopen och 4 040 till 4 480 MHz i de kortare all-core-testerna. Med 600W-kortet i chassit kördes de flesta av dessa tester lägre, med upp till 300 MHz, och alla fick lägre poäng.
| Genomsnittlig CPU-klocka under testet (MHz) | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Cinebench 2026 | 4,477 | 4,470 | 4,789 | 4,786 |
| Ihållande loop | 4,269 | 4,182 | 4,663 | 4,682 |
| 7-Zip | 4,414 | 4,307 | 4,854 | 4,837 |
| Lutfisk | 4,291 | 3,995 | 4,749 | 4,741 |
| Blandare | 4,258 | 4,253 | 4,582 | 4,552 |
| Handbrake | 4,188 | 4,180 | 4,601 | 4,622 |
| LLVM-bygge | 4,202 | 4,258 | 4,582 | 4,585 |
| gromacs | 4,288 | 4,290 | 4,664 | 4,694 |
| OpenBLAS | 4,039 | 3,979 | 4,766 | 4,761 |
| STRÖMMA | 4,321 | 4,326 | 4,687 | 4,676 |
| primsikt | 4,441 | 4,268 | 4,814 | 4,810 |
| MLPerf-klient | 4,191 | 4,138 | 3,814 | 3,686 |
| Kodningsagent | 4,134 | 4,100 | 4,239 | 4,213 |
| LLM-tjänstgöring | 4,261 | 4,169 | 4,229 | 4,209 |
| Bildgenerering | 4,044 | 4,008 | 3,702 | 3,837 |
| RAG | 4,178 | 4,197 | 4,172 | 4,108 |
| Super Tux Kart | 4,239 | 4,211 | 4,637 | 4,649 |
Stockfish föll från 4 291 till 3 995 MHz, primesieve från 4 441 till 4 268, 7-Zip från 4 414 till 4 307 och den sustained loop-frekvensen från 4 269 till 4 182, medan 285K körde inom 20 MHz från sig själv i varje all-core-test oavsett kort.
Medelklockan är inte hela förklaringen. Cinebench och Blender låg i genomsnitt inom 10 MHz från sina Max-Q-värden och tappade ändå 5 till 10 procent, vilket tyder på att medelvärdet per test jämnas ut vid korta avvikelser. 658X drar upp till 250 W, 600 W-kortet ytterligare 600 W, och båda släpper ut samma 32-litersvolym bakom ett främre intag; huruvida begränsaren är processorns termiska utrymme eller ett plattformseffekttak är en fråga som vårt nästa steg med extern strömförsörjning och temperaturloggning kommer att besvara. För närvarande bör köpare som kör all-core CPU-arbete veta att Max-Q-konfigurationen är den snabbare på CPU-sidan.
Lagringsprestanda
Vårt lagringstest kör filsystemets fyra hörn mot startenheten vid 5 GB och 25 GB utrymme, genom filsystemet och igen mot den råa enheten, och rapporterar 25 GB-resultaten här. På Core T2 är startenheten en enda 2 TB SK hynix PCB01 på Gen5 x4; på Pro Precision 9 T2 är det de två E3.S Gen5-enheterna i FlexBay, strippade till en 4 097 GB RAID0-volym av VROC från Graid Technology. BitLocker var avstängd på alla fyra konfigurationer, så filsystemraderna mäter NTFS och RAID-lagret, inte kryptering.


| fio, 25 GB utrymme, QD32 | Pro Precision 9 T2, Max-Q 300W | Pro Precision 9 T2, 600W | Pro Max Tower T2, Max-Q 300W | Pro Max Tower T2, 600W |
|---|---|---|---|---|
| Sekventiell läsning 128K, filsystem (MB/s) | 9,332 | 9,255 | 11,377 | 11,406 |
| Sekventiell läsning 128K, rå enhet (MB/s) | 10,782 | 10,675 | 11,186 | 11,444 |
| Sekventiell skrivning 128K (MB/s) | 6,507 | 6,496 | 7,401 | 7,371 |
| 1 MB förfylld läsning, QD32 (MB/s) | 4,617 | 4,679 | 6,440 | 6,346 |
| Slumpmässig läsning 4K, filsystem, topp (IOPS) | 840,075 | 853,615 | 1,778,576 | 1,756,968 |
| Slumpmässig läsning 4K, rå enhet, topp (IOPS) | 1,107,862 | 1,120,737 | 2,297,681 | 2,294,800 |
| Slumpmässig skrivning 4K, topp (IOPS) | 557,512 | 550,505 | 957,461 | 921,774 |
| Raw / slumpmässig läsning av filsystemet | 1.32x | 1.31x | 1.29x | 1.31x |
| Slumpmässig läsning 4K, 4 jobb, p99 latens (USA, lägre desto bättre) | 506 | 485 | 183 | 185 |
| Slumpmässig läsning 4K, 16 jobb, p99.99 latens (USA, lägre desto bättre) | 15,270 | 23,462 | 676 | 676 |
| Slumpmässig skrivning 4K, 4 jobb, p99-latens (USA, lägre desto bättre) | 610 | 594 | 228 | 228 |
| Drivtemperatur, maximum (C) | Ej tillämpligt (bakom RAID) | Ej tillämpligt (bakom RAID) | 50 | 57 |
Stripe är inte snabbare än den enskilda hårddisken, och på små block ligger den långt efter den. De två E3.S-hårddiskarna läser 9 332 MB/s sekventiellt genom NTFS och 10 782 från råvolymen, mot 11 377 och 11 186 för PCB01, och skriver 6 507 MB/s mot 7 401. Vid 4K slumpmässiga läsningar nådde volymen en topp på 840.1K IOPS genom filsystemet och 1.11M rå, mot 1.78M och 2.30M för den enskilda hårddisken, och slumpmässiga skrivningar på 557.5K IOPS mot 957.5K. Förhållandet mellan rå och filsystem är ungefär 1.3x på båda, så NTFS kostar lika mycket på var och en; skillnaden är VROC-lagret som ligger under båda vägarna.
Svansfördröjningen följer: vid 16 jobb tog de långsammaste 0.01 procenten av slumpmässiga läsningar 15.3 ms på volymen jämfört med 0.68 ms på den enskilda hårddisken, och läsfördröjningen för p99 med 4 jobb var 506 ms mot 183. Programvaru-RAID över två NVMe-enheter lägger till ett CPU-hopp till varje I/O, och fio CPU-avläsningarna visar det, vid 80 procent på de sekventiella passen jämfört med 40 procent på Core T2. Volymen döljer också hårddiskarnas SMART-data, så sviten kunde inte logga deras temperatur.
Inget av detta gör FlexBay till fel val. Den ger T2-diskar som kan serviceras direkt under drift och kopplas in under drift i en formfaktor som skalas till kapaciteter som M.2 inte kan uppnå, och en startvolym på 4 TB från två diskar är praktiskt. Det betyder att en köpare vars arbetsbelastning består av småblocks-slumpmässig I/O, en lokal databas eller en kraftigt cachad modellkatalog, bör titta på en enda E3.S-disk utan stripe, eller på de interna M.2-kortplatserna, där Core T2:s resultat visar vad en Gen5-disk gör i detta chassit.
Slutsats
Dell Pro Precision 9 T2 är Pro Max Tower T2 med en arbetsstationsprocessor i sig, och recensionsdata visar att det är precis vad köpare kan förvänta sig. I samma 32-liters chassi levererar Xeon 658X 39 procent mer Cinebench-flerkärnig dataöverföring, 3.7 gånger minnesbandbredden, dubbelt så hög DGEMM-hastighet och en 24-kärnig, 48-trådig processor med AVX-512, AMX, registrerat ECC-minne och en väg till 1 TB. Den ger tillbaka 13 till 31 procent på enkeltrådat arbete, från primesieve till Python, och köpare som tillbringar sin dag i en viewport eller en terminal kommer att märka det.
GPU-valet är det som den här recensionen utformades för att hjälpa köpare att förstå. Max-Q- och 600W RTX PRO 6000-korten delar 96 GB minne och avkodar inom 7 till 20 procent av varandra, och 600W-kortet får sin kraft genom snabb bearbetning, där tiden till första token minskar med en tredjedel eller mer, och genom diffusion, där bilderna anländer 20 till 34 procent snabbare.
I Xeon-tornet kostar 600W-kortet också processorn 4 till 5 procent på all-core-arbete och kräver platsen bredvid, vilket i vår enhet innebar att 25GbE-adaptern togs bort. För ett torn vars ägare kör CPU-renderingar och simuleringar såväl som lokala modeller är Max-Q-kortet som Dell levererar det balanserade valet; för ett som levererar modeller till ett team eller renderar bilder hela dagen är 600W-kortet värt platsen och 1500W-strömförsörjningen.
E3.S i FlexBay är den formfaktor vi har velat ha i ett tornkort i åratal; VROC från Graid Technology är en trovärdig kombination för RAID-stacken. Den är långsammare på små slumpmässiga I/O än den enskilda M.2-enheten i Core T2, ungefär hälften så långsammare på 4K-läsningar och -skrivningar, och en köpare som inte behöver en RAID-kompatibel startvolym kan överväga en E3.S-enhet eller de interna M.2-kortplatserna istället.
Å andra sidan, med E3.S SSD-diskar som nu överstiger 60 TB, får användare med extrema dataanvändningsfall tillgång till en helt ny värld som tidigare skulle ha inneburit externa kabinett eller montering av en delad lagringsvolym, med flashprissättning som den praktiska gränsen.
För cirka 28 300 dollar konfigurerat på Dell.com, före volympriserna som de flesta företagsköpare ser, listas Pro Precision 9 T2 cirka 4 500 dollar högre än en Pro Max Tower T2 konfigurerad på samma sätt idag: ett 285K-minne, 128 GB DDR5-4400 ECC, RTX PRO 6000, en 2 TB Gen5-hårddisk och 1 500 W-aggregatet kostar cirka 23 800 dollar, med GPU- och minnesalternativen på de två tornen inom 900 dollar från varandra. Den andra FlexBay-hårddisken kostar 1 700 dollar av den skillnaden, och resten är Xeon-plattformen.
Vad den köper är ett torn med en sockel som beter sig som en liten server under belastning på alla kärnor, med samma yta som en stationär dator, och det är fallet för namnet Precision som kommer tillbaka.
Topplista: Dell Pro Precision 9 T2 har utnämningen till bästa stationära arbetsstation totalt på vår topplista över bästa stationära arbetsstationer , och dess RTX PRO 6000-resultat visas även på vår topplista över bästa företags-GPU:er .



 Amazon