

英特爾今天在OCP全球峰會上正式公佈了Crescent Island的產品名稱。這款英特爾D系列GPU基於Xe3P架構,最高可配備480GB LPDDR5X內存,擁有1.5TB/s的內存頻寬和1.3 petaflops的FP8計算能力,所有這些都集成在一張350W風冷PCIe卡中。 480GB的容量指的是合作夥伴代工的顯示卡;英特爾自家品牌的顯示卡容量為160GB。英特爾表示,目前正在向伺服器OEM廠商、ODM廠商、雲端服務商和獨立軟體供應商提供樣品。英特爾發布的渲染圖被標記為GPU D270,這是我們目前看到的該系列顯示卡的首個產品編號。
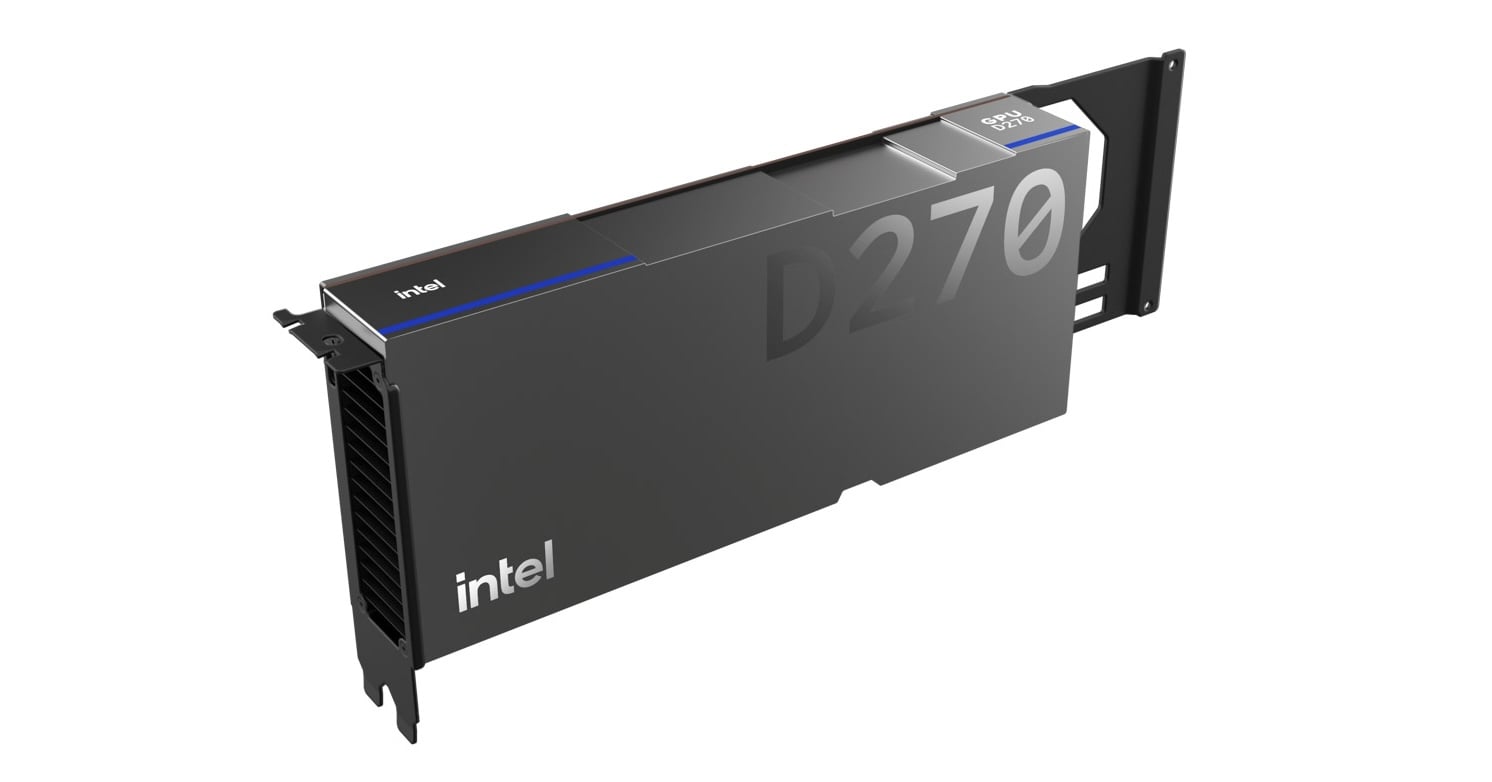
Xe3P架構面向記憶體密集型推理
英特爾在OCP 2025 大會上首次展示了 Crescent Island 架構,並在 8 月份的 Hot Chips 大會上詳細介紹了其晶片:採用 Xe3P 架構,配備 32 個 Xe 核心和 256 個 XMX 引擎,並使用 LPDDR5X 內存取代 HBM 內存,因此該電池可以直接安裝到現有風機架中。今天新增的資訊包括產品名稱、頻寬和計算參數,以及確認客戶已收到樣機。
作為參考,英特爾目前發表的 PCIe 推理加速器是 Gaudi 3,配備 128GB HBM2e 顯存,讀寫速度為 3.7TB/s。我們曾在二月對戴爾 PowerEdge XE7740伺服器中的這款顯示卡進行過詳細評測。當英特爾在 OCP 2025 大會上首次展示這款 GPU 時,將 Crescent Island 架構與 Gaudi 3 機架式設計結合。而 D 系列顯示卡則反其道而行之,單卡顯存容量接近 Gaudi 3 的四倍,頻寬卻遠低於 Gaudi 3 的一半。
英特爾表示,單張D系列顯示卡可承載高達約3000億個參數的模型,而配備8個GPU的主機可擴充至超過1兆個參數。該公司將該顯示卡定位為持續的多租戶推理和長上下文代理工作負載,在這些工作負載中,鍵值快取的成長速度遠遠超出運算能力的成長速度。這張顯示卡的頻寬為1.5TB/s,遠低於HBM級加速器,英特爾認為,對於解碼密集型服務而言,每瓦和每美元的容量比峰值頻寬更為重要。
英特爾資料中心事業部人工智慧產品及市場推廣副總裁 Anil Nanduri 表示:「推理正成為人工智慧的核心工作負載,企業需要能夠以合適的成本提供合適性能的基礎設施。英特爾 GPU D 系列致力於讓高容量推理的部署切實可行,並實現經濟高效的擴展。」軟體方面基於通用產品的 Xe 平台,英特爾表示 GPU,因此在平台上可確保其在 Arc Pro 可移植性的二元性,英特爾表示顯示卡上開發的程式碼無需重寫核心即可移植到 D 系列顯示卡上。
英特爾的堆疊整合了上游運行時和服務框架,涵蓋至強主機和D系列加速器,並從一開始就支援Meta的Muse Glimmer——Meta為本地代理工作構建的擁有300億參數的開放權重模型。目前運行在至強處理器上的英特爾企業級人工智慧代理工具包採用基於提供者的架構,並將隨著D系列硬體的上市而逐步擴展到D系列,從而在加速器大規模應用之前就已部署好編排層。
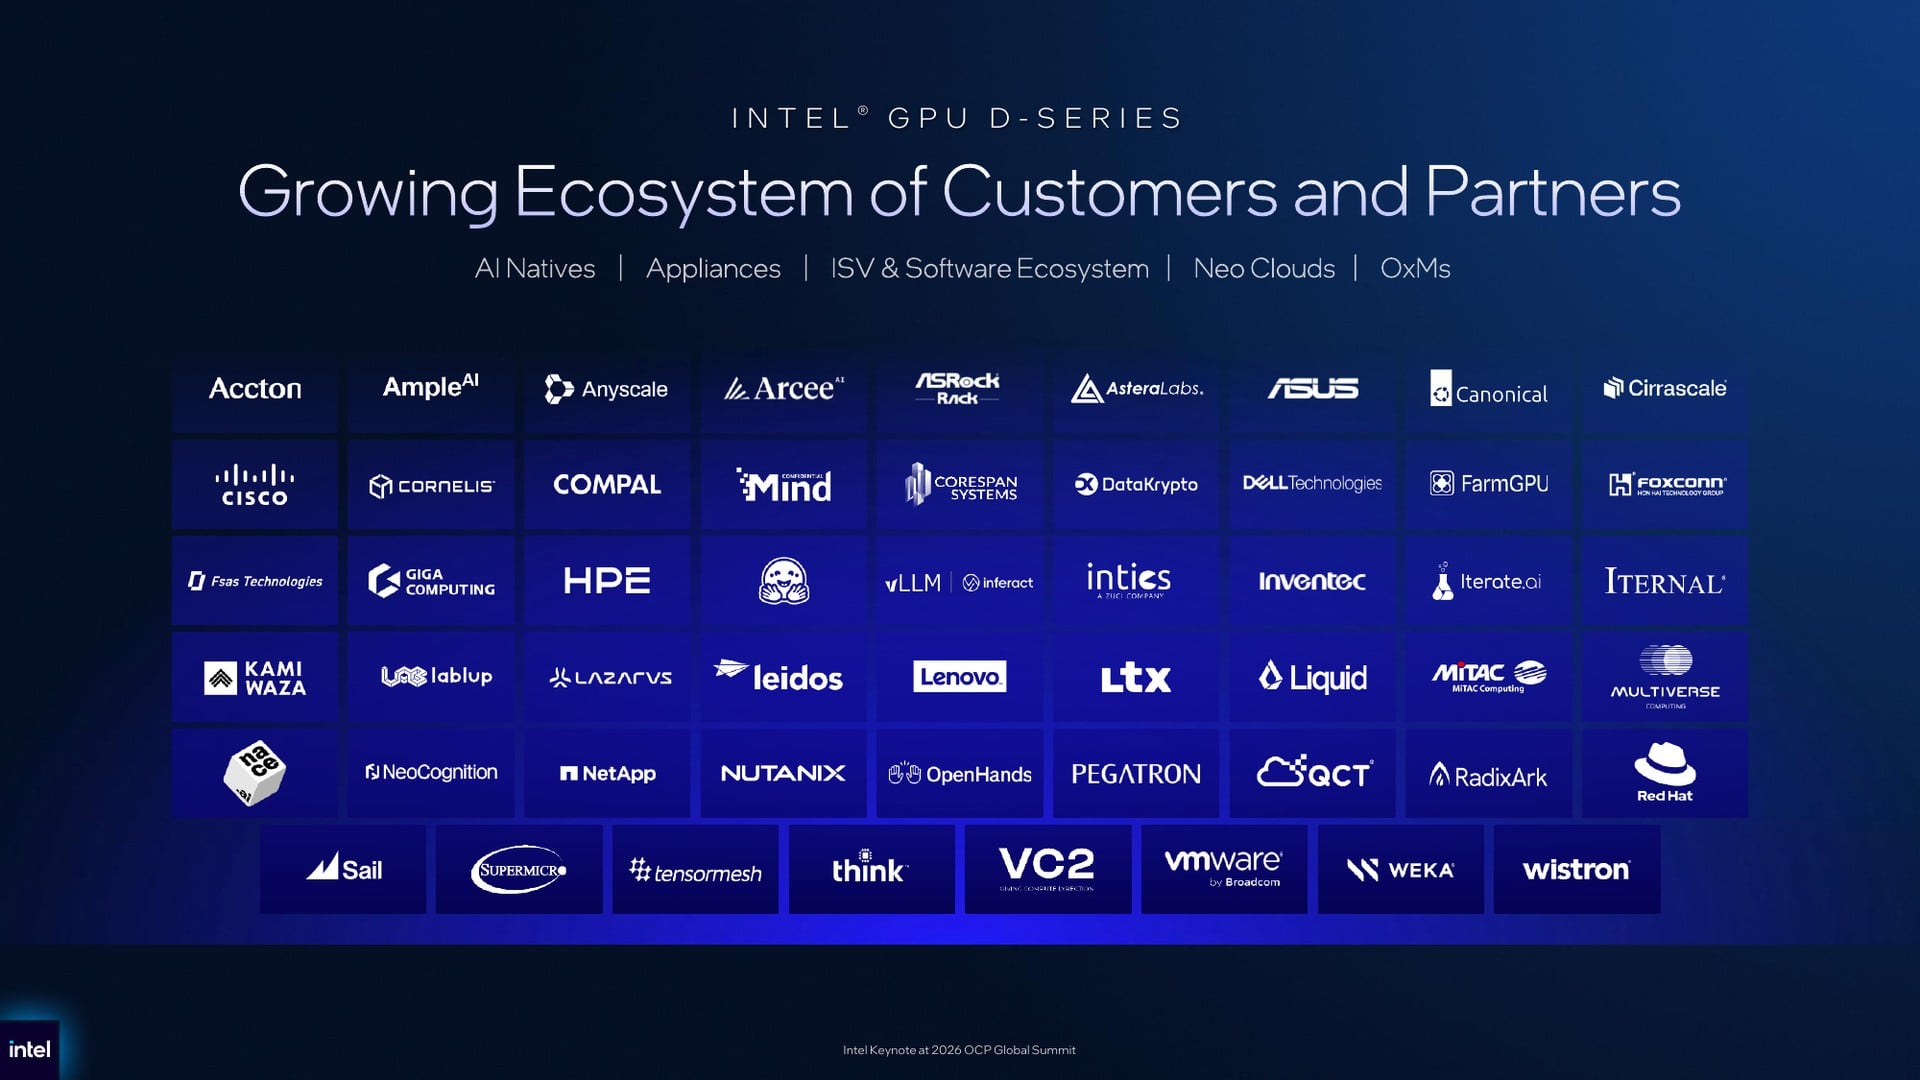
英特爾在主題演講中展示的合作夥伴幻燈片上列出了多達 53 家公司的標誌,涵蓋人工智慧原生企業、設備供應商、軟體、新型雲端平台以及 OEM 和 ODM 廠商。伺服器廠商的名稱都在意料之中:戴爾、HPE、聯想、超微、思科、華碩、華擎機架、科技、美泰科技、和碩、高通科技、緯創資通、英業達、仁寶科技和富士康。對於一款主打便攜性的顯示卡而言,軟體廠商的名單更為重要,因為該顯示卡上整合了 Red Hat、Canonical、博通旗下 VMware、Nutanix、NetApp、WEKA、vLLM、Hugging Face、Anyscale 和 OpenHands 等廠商的產品,互連方面則有 Astera Labs 和 Cornelis 的產品。
ORv3 Xeon 機架可擴充至超過 46,000 個核心
除了這張顯示卡,英特爾還展示了基於Xeon 6+ 處理器,並依照 OCP Open Rack v3 規格建構的機架級系統。英特爾表示,最高密度的配置每個機架可容納超過 46,000 個核心,總功耗為 133.45kW。 288 核心的 Xeon 6+ 處理器需要 160 個插槽才能達到如此高的效能,即在一個機架中部署 80 個雙路節點,每個插槽的功耗約為 834W,這還不包括機架的其他部分。英特爾將這些機架定位在代理管線的 CPU 端,用於處理令牌路由、檢索、資料庫查找、程式碼執行以及為加速器提供 I/O 資料。
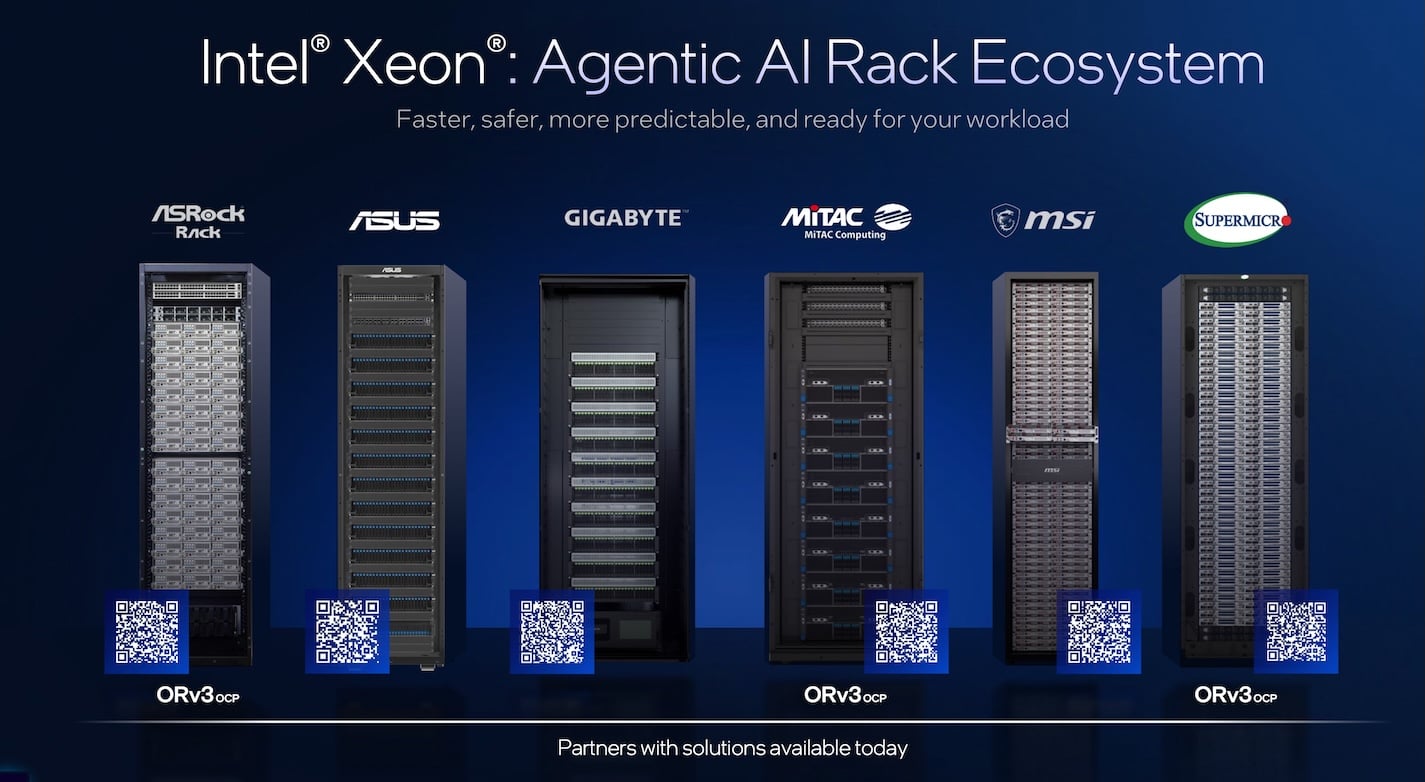
合作夥伴幻燈片列出了華擎機架 (ASRock Rack)、華碩 (ASUS)、技嘉 (GIGABYTE)、MiTAC Computing、微星 (MSI) 和超微 (Supermicro) 等廠商,目前都提供相關係統。展示的六款機架中,三款採用 ORv3 架構,其餘三款則採用 19 吋機殼。英特爾表示,衡量 AI 機架的標準正在轉向其在目標延遲下能夠支援的並發代理數量。 「智慧代理 AI 正在改變客戶對資料中心的需求。僅僅更快地產生代幣已經不夠了。基礎設施必須能夠協調複雜的工作流程、執行任務,並高效地大規模交付有用的工作成果。」英特爾資料中心事業部執行副總裁兼總經理 Kevork Kechichian 表示。
OCP的開放式適配器卡工作仍在繼續
英特爾還提到了其在OCP開放適配器卡工作組的工作,該工作組由英特爾與AMD、戴爾、英偉達和高通於今年早些時候共同組建。該工作小組正在定義一種介於標準PCIe卡和完整機架級系統之間的子機架加速器外形尺寸,並採用標準化的機械、電源和帶外管理接口,以便不同廠商的加速器可以安裝到同一個開放式機箱中。
工作小組的目標是為 19 吋和 21 吋機架式推理和中端訓練平台開發高功率適配器,英特爾和 AMD 將在本週的峰會上展示該規範的最新進展。自 2011 年以來,英特爾已為 OCP 貢獻了 116 項內容,Nic Dubé 的主題演講“Put Every Prompt in Its Place”(每個提示都各就各位)定於太平洋時間 10 月 13 日上午 10:30 舉行。


 Amazon