

微軟今天在 OCP 全球高峰會上發表了 Azure Maia 300,這是其自主研發的第三代推理加速器,也是首款採用多晶片架構的產品。每個加速器都配備一個台積電 N2P 計算晶片和八個 HBM4 顯存堆疊,在 950W TDP 的功耗下,可提供 288GB 的內存,吞吐量高達 18TB/s。一個 Maia 300 機架可容納 96 個這樣的加速器,總功耗為 167kW。微軟聲稱,與領先的基於 GPU 的系統相比,Maia 300 的每兆瓦令牌吞吐量提高了 40%,機架級代幣吞吐量更是 Maia 200 的 7 倍。作為微軟所稱的千兆瓦級 Maia 部署計畫的一部分,該產品將於 2027 年開始投入生產部署。
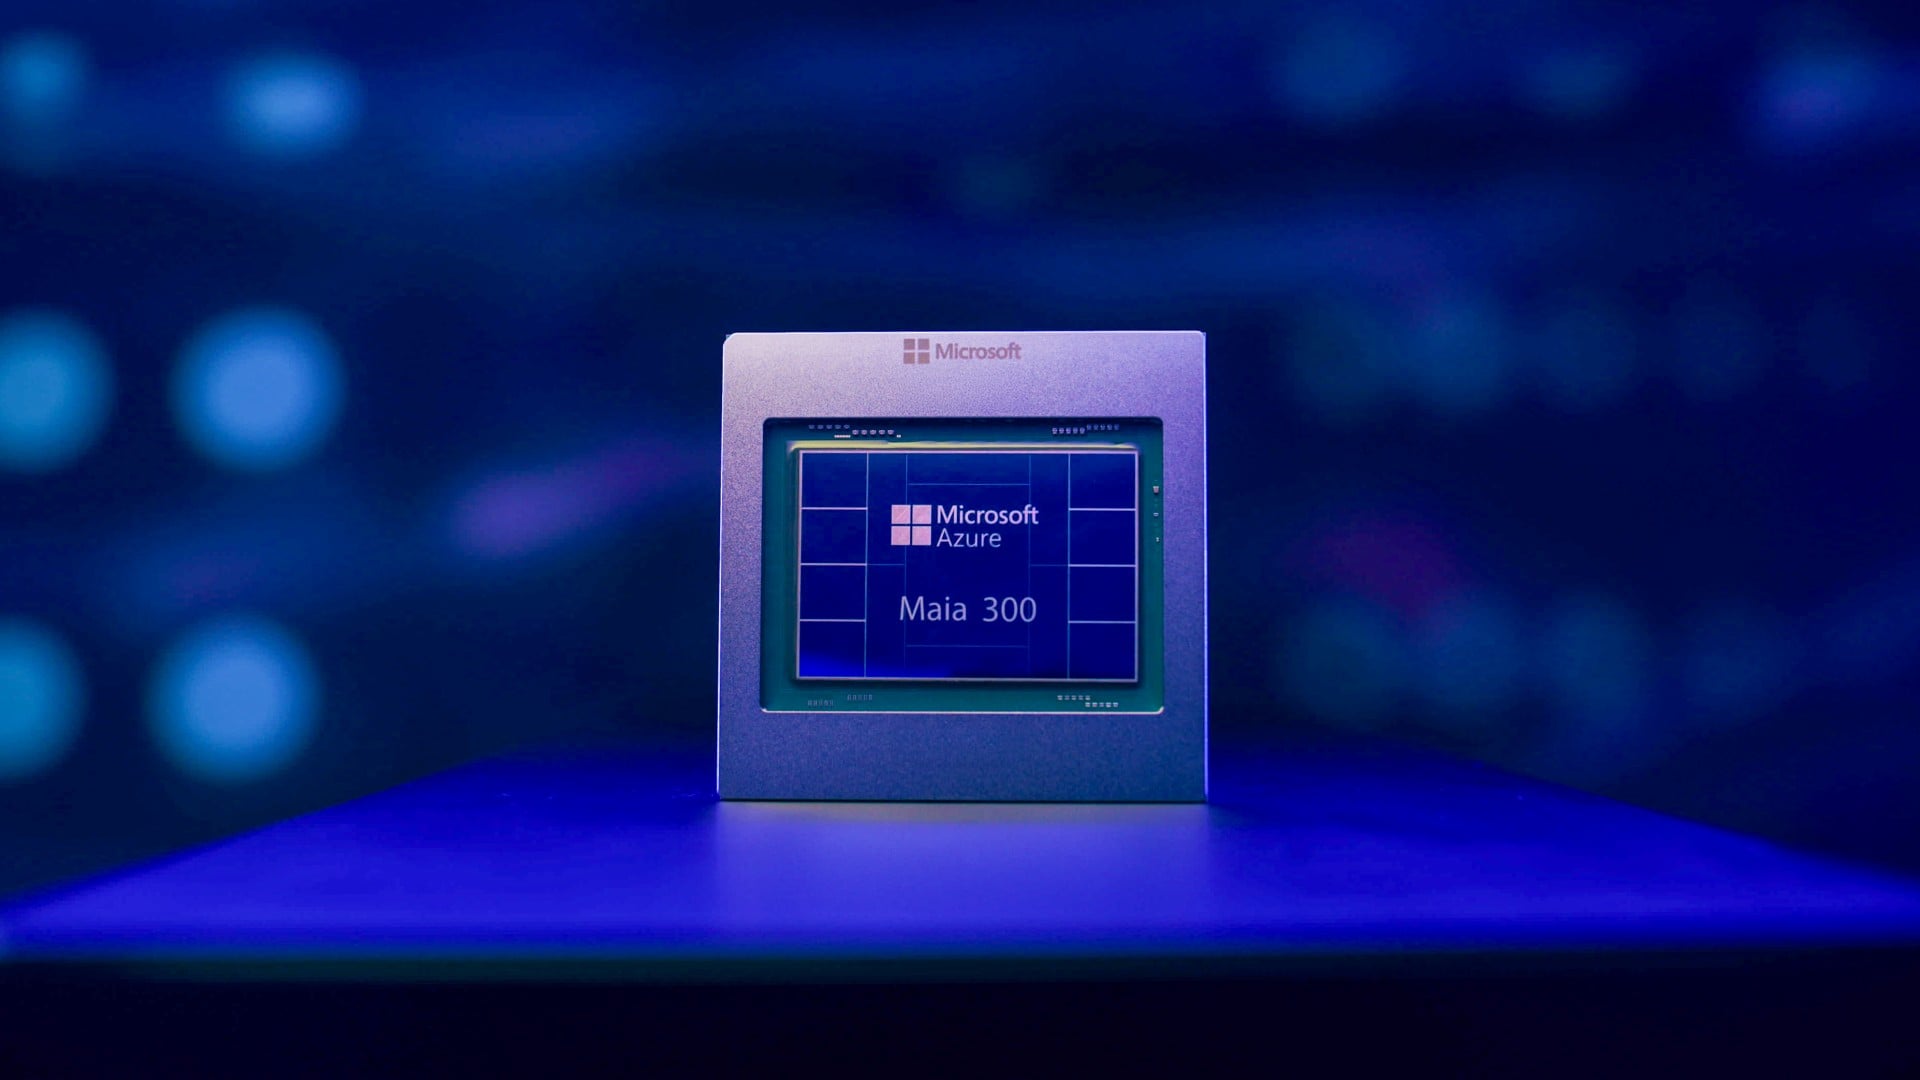
Maia 300 晶片:N2P 計算晶片,八個 HBM4 記憶體堆疊,32 個 400G 端口
Maia 200 採用單晶片 N3P 設計,配備六個 HBM3E 記憶體堆疊。 Maia 300 則將設計拆分為一個基於 N2P 的主運算晶片、兩個 I/O 晶片和四個記憶體晶片,其中八個 HBM4 記憶體堆疊將容量從 216GB 提升至 288GB,頻寬從 7.1TB/s 提升至 18TB/s。峰值運算效能下降:FP4 模式下為 13.8 POPS,FP8 模式下為 6.9 POPS,分別比 Maia 200 的 10.1 POPS 和 5.1 POPS 有所提升,因此,與記憶體頻寬提升 2.5 倍相比,FP4 運算效能提升了 37%。微軟對此晶片的總結是:頻寬提升了 2.5 倍,容量提升了 33%,每瓦 HBM 頻寬約為 Maia 2 的兩倍。
運算部分由四個叢集組成,每個叢集包含 12 個 tile,每個 tile 包含一個張量單元、一個向量處理器、一個重塑器、一個 DMA 引擎和一個本地 SRAM,叢集共用 SRAM 和位於其上方的晶片網路 (SoC)。微軟將這種方法稱為軟體定義資料流架構:軟體將資料放置在這些本地記憶體、DMA 引擎和網路中。 SoC 透過片上 AI 網路控制器(即擴充架構)向主機提供 PCIe Gen6 x16 介面和 32 個 400Gb/s 乙太網路連接埠。
在 Maia 300 上,記憶體組織方式從統一存取 (UAL) 改為跨晶片的 NUMA 佈局,以便將資料放置在靠近使用它的計算單元的位置。此外,透過增強 MXFP4 和硬體資料類型轉換,精確度進一步降低,旨在減少計算和鍵值快取儲存中每個令牌移動的位元組數。核心還可以使用片上 SRAM 作為軟體管理的暫存區,從而避免對 HBM 造成流量壓力。微軟將每瓦效能的提升歸功於這些改進,儘管 TDP 從 750W 增加到 950W,但該公司聲稱每瓦效能提升了 2.5 倍以上。
每個機架96個加速器,超級艙共12,288個。
Maia 300 機架將加速器數量翻倍至 96 個,並將機架功率從 64kW 提升至 167kW,這意味著每個加速器插槽的功耗約為 1.74kW(包含網路、冷卻和電源轉換)。根據微軟的數據,整個機架可提供 27.6TB 的 HBM 記憶體、1,728TB/s 的總 HBM 頻寬以及 1,324 POPS 的 FP4 運算能力,而 Maia 200 機架的相應數據分別為 10.4TB、341TB/sOPS 和 485 POPS。每個加速器的雙向擴展頻寬從 2.8TB/s 提升至 3.2TB/s,採用微軟定制 AI 傳輸協議的雙層以太網擴展網絡,其超級集群 (superpod) 可容納 12,288 個加速器,是上一代產品(約 6,000 個)的兩倍。
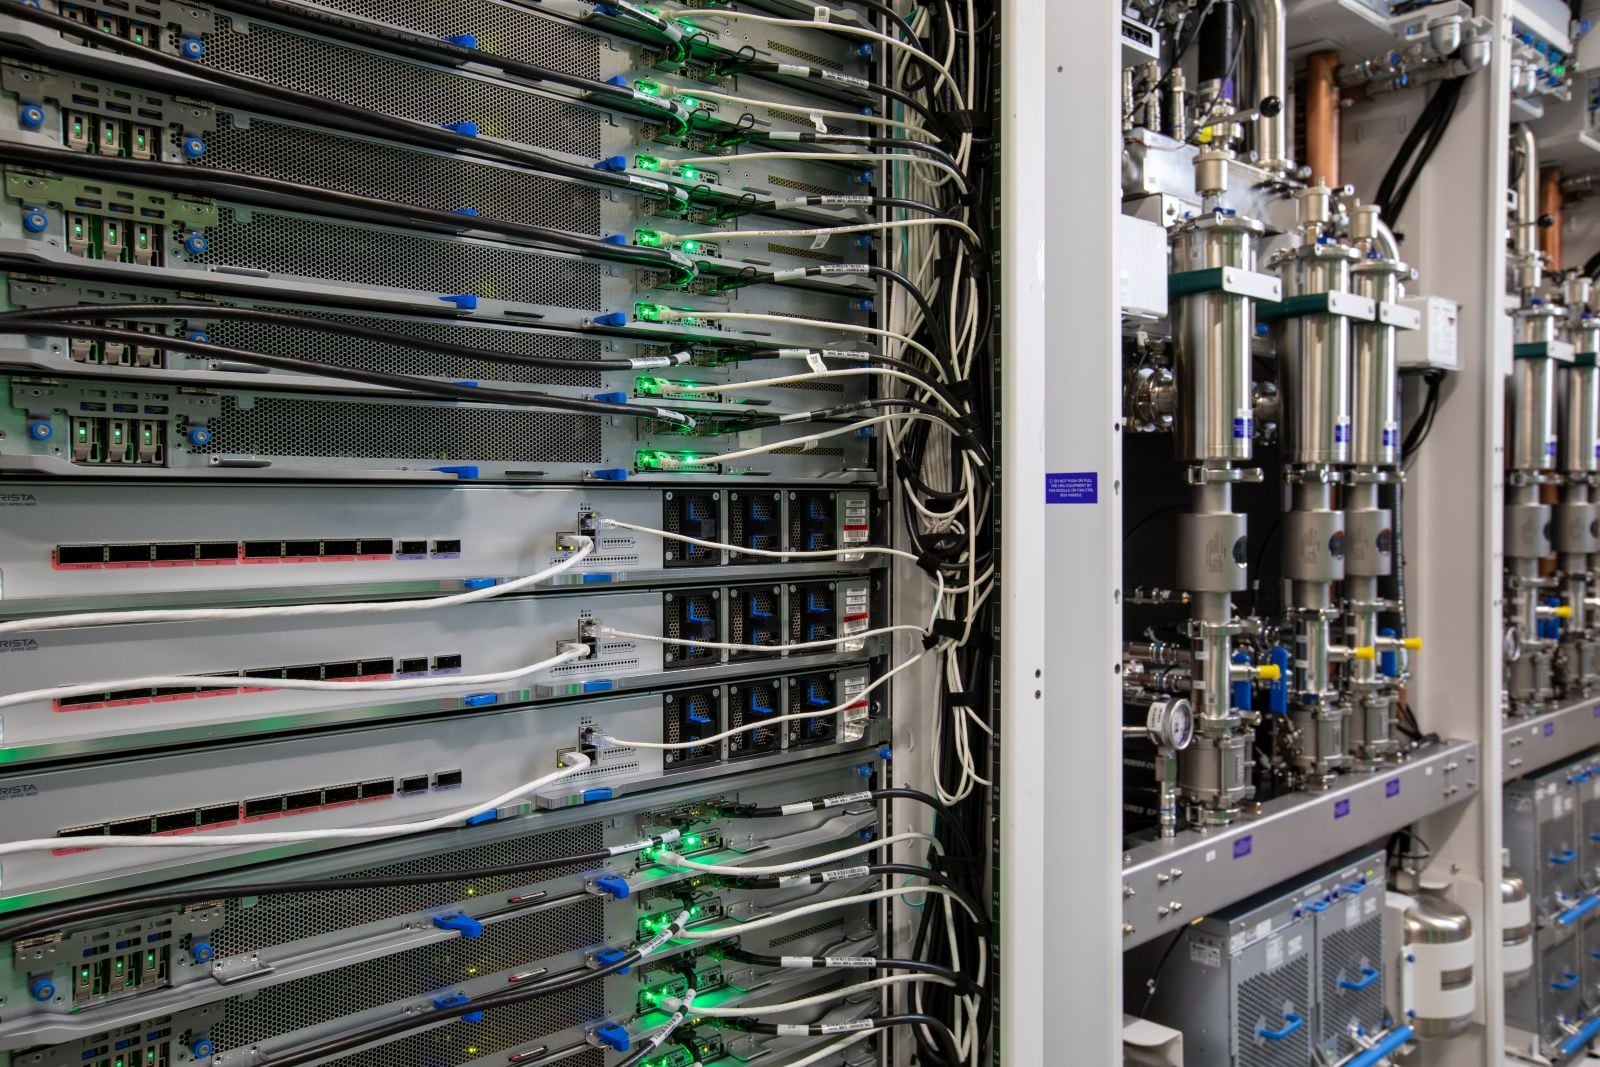
微軟的機架圖顯示,作業透過橫向擴展架構分片到各個機架,分片之間進行專家並行通信,這種流量模式正是大型混合專家模型在服務運行時所產生的。該公司表示,相同的通訊模型適用於超級集群中的任何加速器,因此,一個跨越 16 個加速器的作業和一個跨越四個機架的作業使用相同的語義。
Maia 300 規格
| 規格 | 瑪雅300 | 瑪雅200 |
|---|---|---|
| 加速器 | ||
| 過程 | 多小晶片、N2P 運算晶片 | 單體式 N3P |
| FP4峰 | 13.8 流行音樂 | 10.1 流行音樂 |
| FP8峰 | 6.9 流行音樂 | 5.1 流行音樂 |
| SoC TDP | 950W | 750W |
| HBM | 8 x HBM4,288GB,18TB/s | 6 x HBM3E,216GB,7.1TB/s |
| 主機界面 | PCIe Gen6 x16 | 沒有說明 |
| 擴展頻寬(雙向) | 3.2TB/秒 | 2.8TB/秒 |
| 後端網路 | 採用 AI 傳輸的雙層乙太網路擴展,32 x 400Gb/s | 採用人工智慧傳輸的雙層乙太網路擴展 |
| 機架和縱向擴充領域 | ||
| 每架加速器數量 | 96 | 48 |
| 機架功率 | 167kW | 64kW |
| 機架式高密度脂蛋白(HBM)容量 | 27.6TB | 10.4TB |
| 機架式 HBM 頻寬 | 1,728TB/秒 | 341TB/秒 |
| 機架 FP4 峰值 | 1,324 流行音樂 | 485 流行音樂 |
| 規模化領域 | 約12,288個加速器 | 約6,000個加速器 |
Maia 300 的市場定位以及其宣稱的依據
Maia 200 目前已在 Microsoft Copilot 和 MAI 模型團隊的生產環境中投入使用,GitHub Copilot 和 Microsoft Foundry 也將在年底前遷移到該平台。微軟表示,Maia 200 正在美國、歐洲和澳洲進行部署,其每瓦的令牌數比其 GPU 基礎設施高出 1.7 倍,用於 Teams、Copilot 和 Cowork 中的內建 AI 功能。
「我們將從 2027 年開始將 Azure Maia 系列擴展到千兆瓦級部署,使 Maia 成為微軟產品和服務的主要推理系統,」微軟雲端與人工智慧執行副總裁 Scott Guthrie 在宣布 Maia 300 時寫道。 NVIDIA 和 AMD 仍然是微軟訓練叢集中的一員,微軟尚未將 Maia 作為 Azure 客戶可以租用的執行個體類型提供。其宣稱的效率優勢——每兆瓦的令牌數比領先的基於 GPU 的系統高出 40%——並未指明具體的 GPU、型號或服務配置,而且由於 Maia 只能在微軟內部運行,因此公司外部人員無法對其進行測試。
已公佈的規格確實支援這項設計:每個加速器的記憶體頻寬提升了 2.5 倍,FP4 運算能力提升了 37%,機架式伺服器在功耗僅為 Maia 200 機架式伺服器 2.6 倍的情況下,實現了 5.1 倍的 HBM 頻寬。這是一款專為長上下文和智慧推理的解碼階段而設計的晶片,該階段的瓶頸在於為算術單元提供數據。它也展示了超大規模資料中心在擁有端到端工作負載的情況下如何調整推理部分的規模。我們曾在 1 月報道Maia 200 的發布,微軟表示將在 11 月的 Ignite 大會上公佈更多細節。




 Amazon