

MLCommons今天發布了MLPerf Storage v3.0的測試結果,這一輪測試不僅改變了基準測試的內容,也改變了領先者的格局。這是唯一經過審計的AI儲存基準測試首次涵蓋了完整的流程:訓練吞吐量、檢查點機制,以及兩個新的推理工作負載——向量資料庫測試和鍵值快取測試。共有19家機構提交了143個測試結果,其中11家是首次提交,包括微軟Azure、NVIDIA、Everpure以及一群大多數讀者可能不太熟悉的AI儲存新創公司。同樣值得注意的是,在v2.0版本中佔據領先地位的DDN、華為、Hammerspace和Lightbits等公司,此次並未提交測試結果。
首先說明一點,v3.0 版本將其模擬加速器從 H100 升級到 B200,提高了單一加速器的頻寬要求,因此 v3.0 的資料不能與 v2.0 的結果直接比較。這些資料由 MLCommons 審核的廠商提交;StorageReview 並未進行或獨立驗證此測試。
檢查點是重頭戲
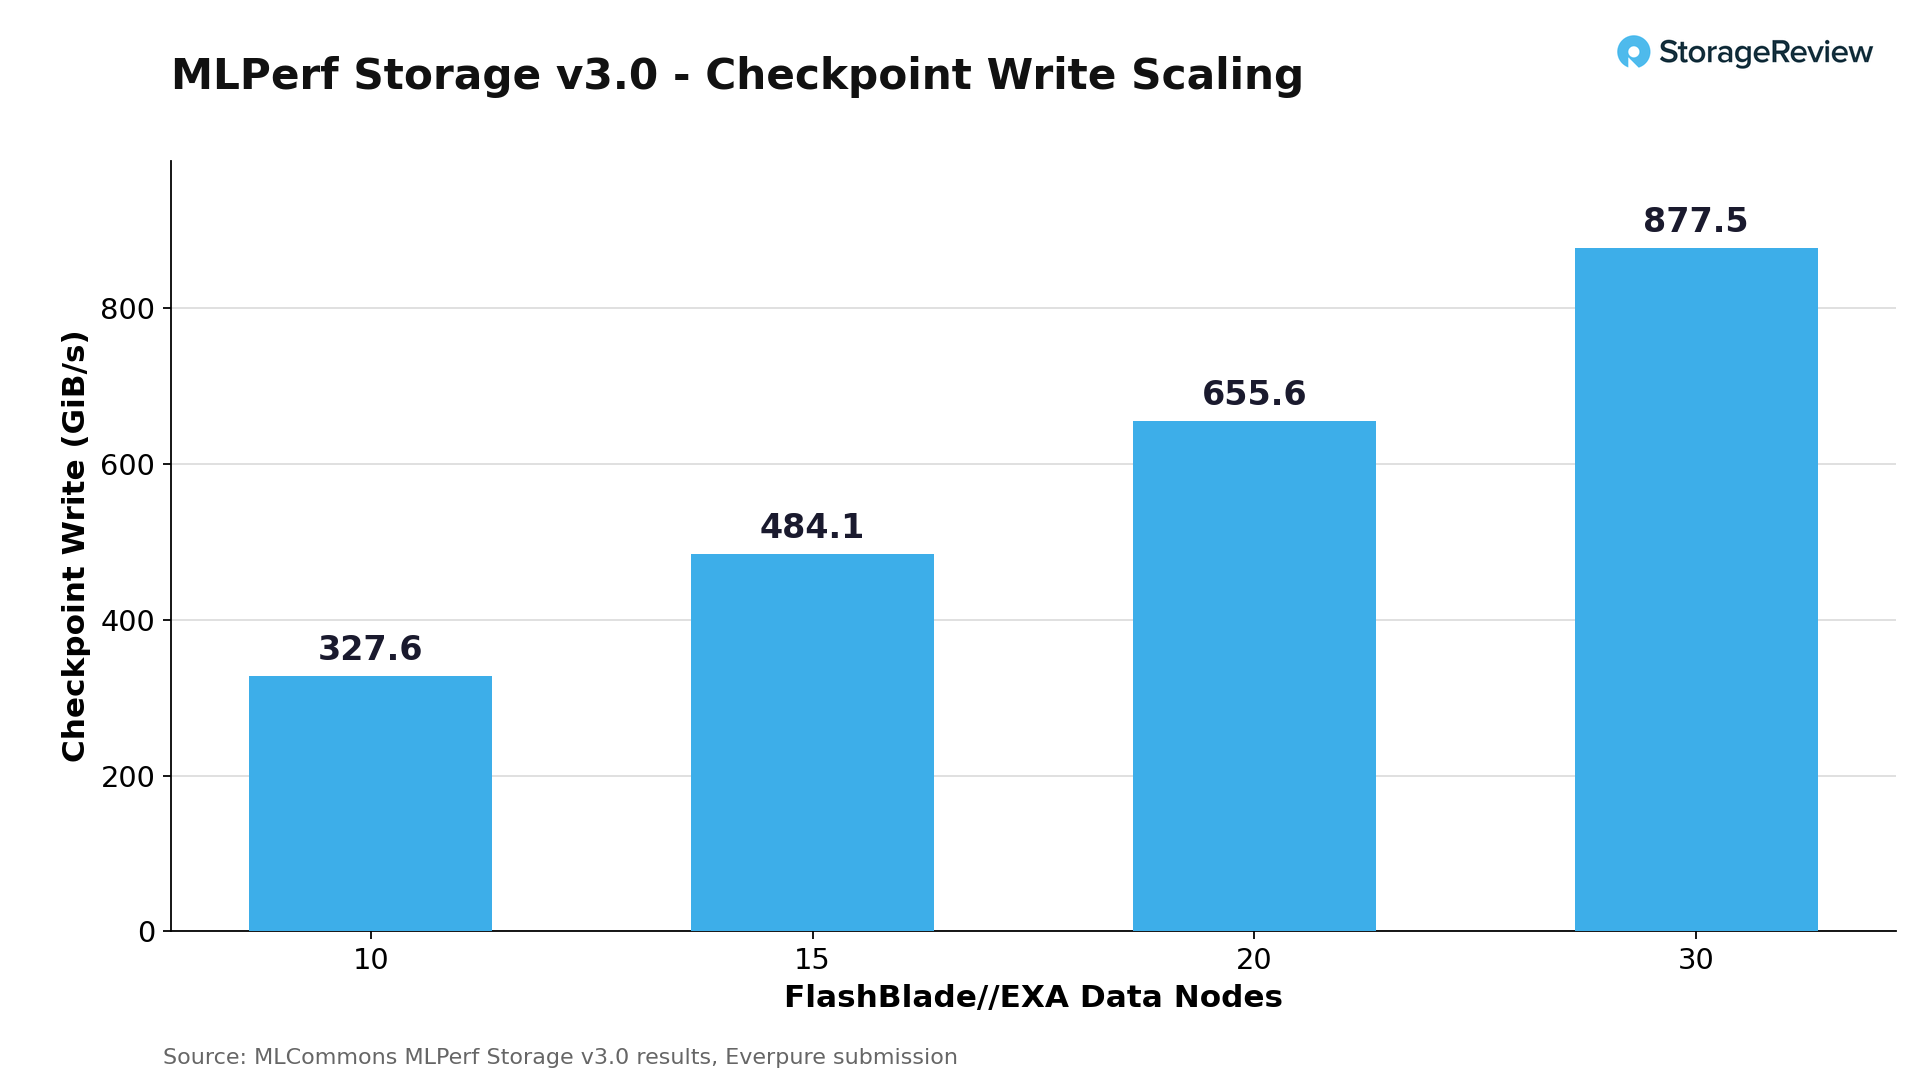
MLCommons 將檢查點機制列為一級工作負載,因為它已成為公認的效能瓶頸:大規模訓練作業會定期寫入大量狀態,而刷新檢查點的每一秒都意味著加速器空閒一秒鐘。本輪測試中最大的數據也屬於此範疇。 Everpure(前身為 Pure Storage)首次亮相 MLPerf Storage 大會,提交了 FlashBlade//EXA 的測試結果,其效能幾乎與資料節點數量呈線性增長:10 個資料節點時檢查點寫入速度為 327.6 GiB/s,15 個為 484.1 GiB/s,20 個時為 6557075 個節點時為 557075 075772070720700777720707:457 節點。 GiB/s,讀取速度為 833.0 GiB/s。過去一年,Everpure 一直宣稱 //EXA 具有很高的吞吐量;而這次測試結果首次經過審計證實了這些說法。
第二高的檢查點寫入速度或許更能說明問題。 Azure Managed Lustre 是第一個參與基準測試的超大規模雲端儲存服務,在 4,096 TiB 的部署規模下,擁有 128 個客戶端,檢查點寫入速度達到了 642.2 GiB/s。在兩輪測試之前,人們很難想像託管雲端檔案服務能夠與專用 AI 儲存陣列相提並論。
| 檢查點(熱門提交) | 系統 | 寫入黑白資料(GiB/s) |
|---|---|---|
| 永純 | FlashBlade//EXA,30 個資料節點 | 877.5 |
| 天藍 | 託管 Lustre,4,096TiB,128 位客戶 | 642.2 |
| 炎榮科技 | F9000X,8 個客戶 | 313.7 |
| 蘇州紫山隆林 | 多種配置 | 313.7 |
| 圖靈數據 | F9200,8 個客戶 | 307.1 |
| UBIX | UbiPower18000,3 個儲存節點 | 293.8 |
訓練:你可能不知道的名字
3D U-Net 訓練排行榜被新秀們佔據。燕榮科技的 F9000X 持續提供 543.9 GiB/s 的讀取頻寬,為 99 個模擬 B200 加速器供電,成為本輪訓練吞吐量最高的公司。新加坡人工智慧基礎設施公司 TuringData 首次提交測試結果,以 541.5 GiB/s 的讀取頻寬位居第二,落後 4 GiB/s。此叢集僅由三個儲存節點組成,為 96 個模擬 B200 加速器供電。同樣的三節點 F9200 叢集也提交了 Checkpoint-70B 測試結果,讀取頻寬為 539.9 GiB/s,寫入頻寬為 307.1 GiB/s。 UBIX 的 UbiPower18000 叢集由三個儲存節點組成,配備 16 塊 15.36TB NVMe 硬碟和四路 NDR400 網絡,最終達到 454.1 GiB/s 的吞吐量。 HPE 是唯一提交訓練結果的成熟企業陣列供應商,其 K3000 的訓練速度為 345.8 GiB/s。
| 3D U-Net 訓練(最佳提交) | 讀取黑白資料(GiB/s) | 模擬B200加速器 |
|---|---|---|
| 炎榮科技 F9000X | 543.9 | 99 |
| 圖靈數據 F9200 | 541.5 | 96 |
| UBIX UbiPower18000 | 454.1 | 80 |
| 蘇州紫山隆林 | 433.4 | 80 |
| FarmGPU | 406.7 | 75 |
| Azure 託管 Lustre | 379.1 | 70 |
推理加入基準測試
這兩個新增工作負載反映了儲存需求的實際成長方向。 KV快取測試衡量儲存系統在長上下文LLM服務中對注意力狀態進行分頁的速度,我們在先前針對戴爾和Solidigm的KV快取卸載工作中對此模式進行了深入研究。 Everpure再次刷新了本輪測試的最高紀錄,在51台主機組成的FlashBlade//EXA配置上實現了1,623.4 GiB/s的KV快取讀取速度,而UBIX(443.7 GiB/s)和FarmGPU(443.6 GiB/s)則在標準規模的測試中名列前茅。在向量資料庫方面,TTA的Seahorse系統以每秒57,620次查詢的成績位居查詢吞吐量榜首。
另一項結構性變化是協議。 v3.0 版本新增了對 S3 物件儲存的支持,大約六分之一的提交版本使用了該儲存。 NVIDIA 佔據了其中的大部分份額,提交了 20 個 AIStore 測試案例,涵蓋了 OCI、AWS 和 GCP 上的裸機配置,最高檢查點寫入速度達到了 133.3 GiB/s。雖然絕對數值低於平行檔案系統,但物件儲存能夠運行訓練和檢查點工作負載,這標誌著 POSIX 檔案系統在先前的領域佔據了主導地位。
MLCommons 在本輪評測中也開始將電源和機架空間效率作為首要指標進行追蹤。
Everpure FlashBlade//EXA
Everpure FlashBlade//EXA 系統在 405B 和 1.25T 參數模型檢查點類別以及鍵值 (KV) 快取檢索基準測試中均處於領先地位,突顯了該平台在資料密集型人工智慧訓練和推理工作負載期間保持高吞吐量的能力。
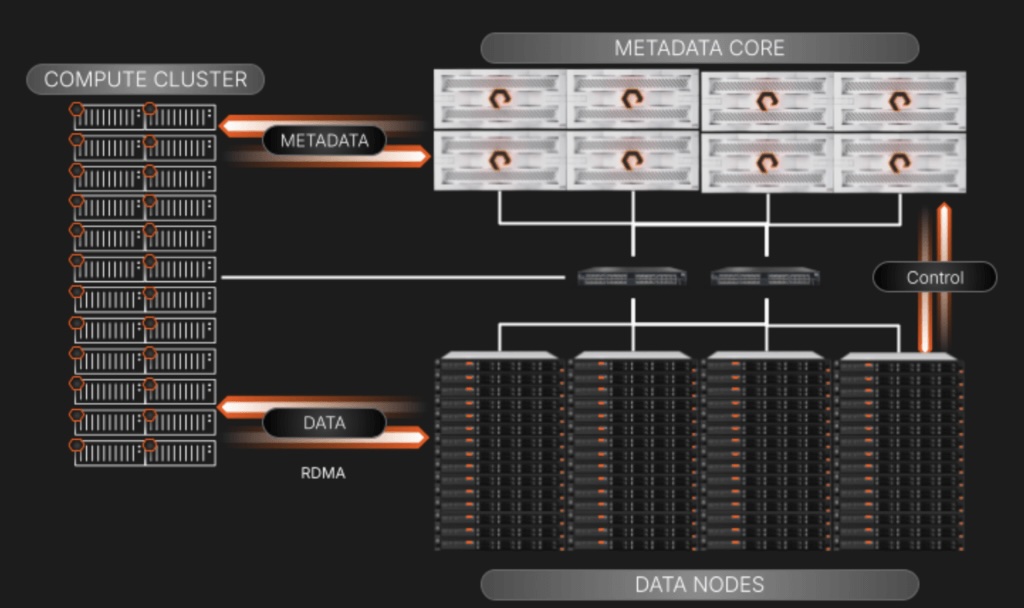
Everpure提交的設定方案將30個FlashBlade//EXA刀鋒伺服器(120個DirectFlash模組用於處理元資料)與30個Linux/NVMe資料節點配對,在單一檔案系統中提供了約866TB的可用容量。此方案將元資料透過pNFS/TCP傳輸,而資料則透過NFSv3的RDMA傳輸。在1.25T參數的檢查點模擬中,使用1,024個客戶端加速器,該30節點配置在17.74秒的時間內實現了877.52 GiB/s的寫入頻寬,並在28.99秒內實現了588.28 GiB/s的讀取頻寬。在 KV 快取推斷測試中,僅使用儲存的 Llama 3.1 8B 運行報告每秒 85,736 個令牌,結合儲存和系統記憶體的 8B 運行報告每秒 67,642 個令牌,僅使用儲存的 70B 運行報告每秒 33,403 個令牌。
缺席意味著什麼
基準測試輪次可以證明兩件事:提交者的能力以及缺席者選擇不展示的能力。贏得最大規模新雲端和人工智慧工廠部署的廠商 VAST Data、WEKA 和 DDN 都缺席了 v3.0 輪次,v2.0 輪次的提交者華為、Hammerspace 和 Lightbits 也同樣缺席。廠商缺席測試輪次的原因有很多,例如工程週期、發佈時間以及基準測試的策略;缺席測試輪次並不代表系統速度慢。但這確實意味著,經過審計的記錄和部署記錄指向了不同的廠商名單,買家必須權衡兩者。我們的「最佳儲存陣列」頁面精確地記錄了這種差異,標明了哪些是經過審計的記錄,哪些是部署記錄,並且已經更新了完整的 v3.0 測試結果。



 Amazon