

NVIDIA 和聯發科宣布大幅擴展雙方的策略合作,涵蓋企業級 AI 基礎設施、邊緣運算、用戶端 PC 和汽車平台。為支持這項合作,NVIDIA 已投資 3.5 億美元購買聯發科發行的可轉換債券。此次技術合作的核心在於,聯發科將 NVIDIA NVLink Fusion 平台整合到 NVIDIA 的機架式 AI 環境中,為超大規模資料中心、雲端服務供應商和前沿模型開發者提供一個預先驗證的框架,用於設計可直接部署到 NVIDIA 機架式 AI 環境中的客製化加速器 (XPU)。
兩家公司的領導階層將擴展聯盟的重點放在跨運算領域的整合上。 NVIDIA創辦人兼執行長黃仁勳指出,從大型資料中心到個人系統和軟體定義汽車,都需要加速運算,並特別提到了聯發科在系統晶片設計、連接性和每瓦性能方面的專長。聯發科副董事長兼執行長蔡崇信表示,將聯發科的客製化晶片設計能力與NVIDIA的加速運算堆疊和軟體生態系統相結合,將加速客戶在雲端AI基礎設施、本地AI運算和汽車領域的創新。
基於NVLink Fusion平台的客製化晶片設計
為機架級部署開發半客製化 AI 加速器,在高速 SerDes、互連拓撲結構、高頻寬記憶體 (HBM) 整合、多晶片先進封裝以及系統級熱力學和機械性能認證等方面,都面臨著巨大的工程挑戰。聯發科並沒有要求客戶從零開始設計這些底層互連和封裝層,而是採用NVLink Fusion作為模組化設計藍圖。
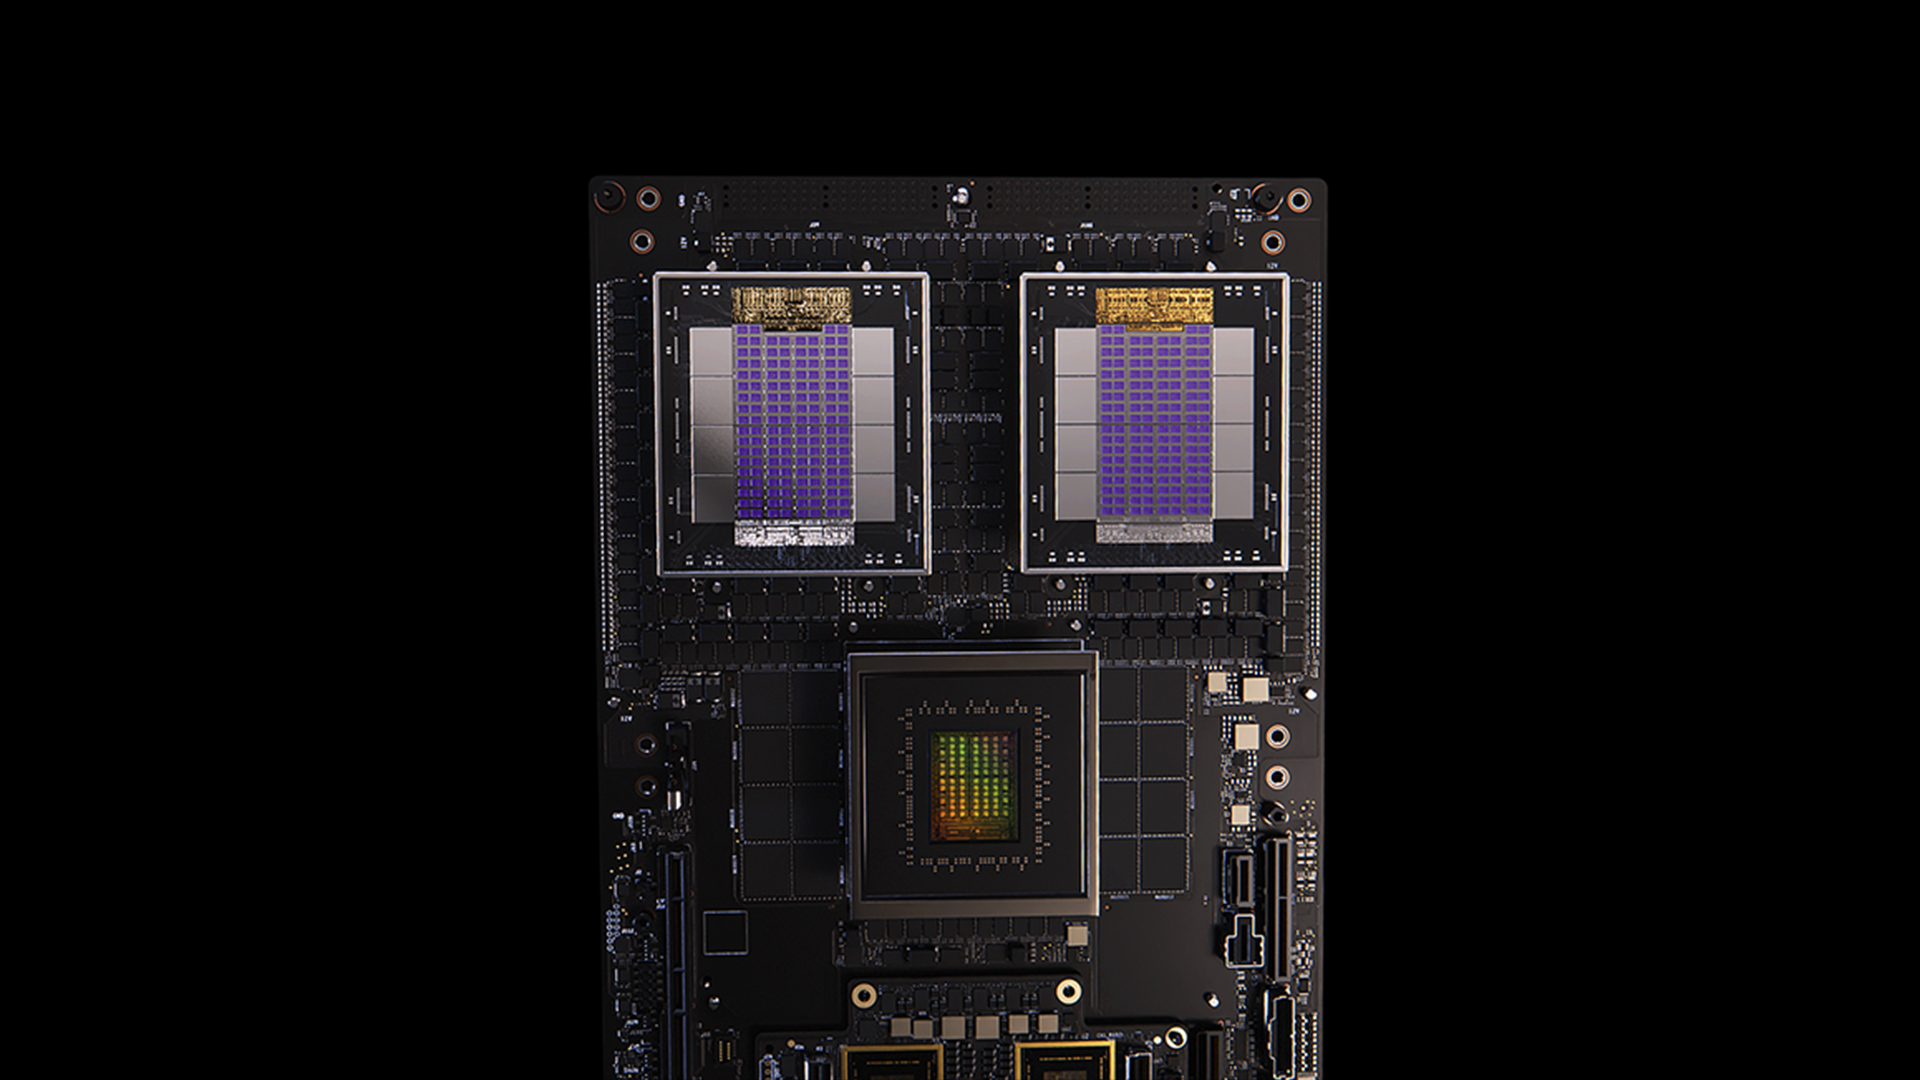
NVLink Fusion 架構提供了一個標準化的、預先認證的多晶片基礎架構,其中包含多種主要子系統技術。 NVIDIA NVLink Fusion 晶片組利用 NVIDIA 光子或電互連技術,在客製化 XPU 和更廣泛的 NVLink 擴展架構之間建立直接連接。為了支援一致、低延遲的晶片間通信,NVIDIA NVLink-C2C可在客戶 XPU、NVIDIA Rosa CPU 和其他相容的處理單元之間提供高頻寬、高能效的晶片間連接。在記憶體方面,NVIDIA NVHBM整合了客製化的記憶體接口,以擴展可用頻寬並提高能效,同時為活躍的運算引擎預留更多晶片面積。
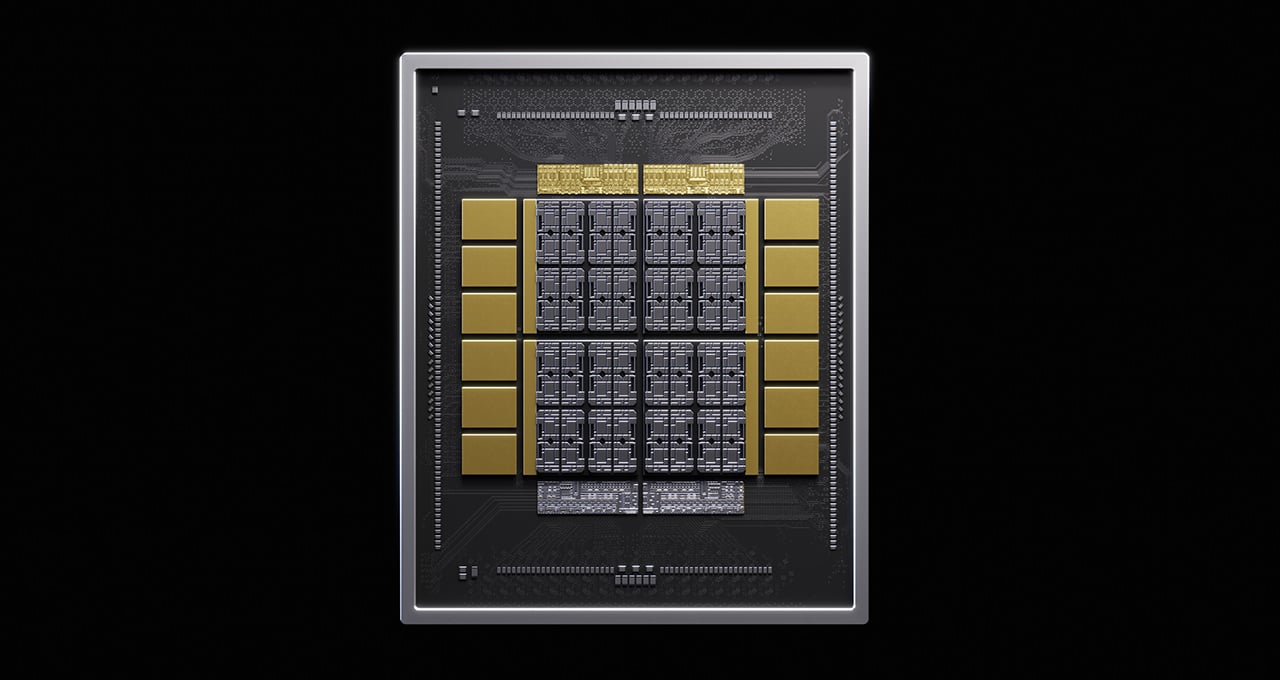
透過此框架,企業客戶可將專有的處理架構提供給聯發科,從而根據其目標工作負載自訂特定的效能配置、記憶體密度和功耗目標。聯發科則負責管理製造多晶片封裝所需的複雜封裝、實體實作和供應鏈物流。這些客製化的 XPU 可與 NVIDIA MGX 模組化機架級架構和橫向擴展網路架構對接,從而顯著降低開發風險,並縮短專用 AI 工廠的產品上市時間。
擴展客戶端運算和汽車平台
除了資料中心基礎設施之外,此次合作還著眼於生成式和智慧體人工智慧工作負載的本地客戶端運算。兩家公司先前曾合作開發 GB10 Grace Blackwell 超級晶片,該晶片透過 NVLink-C2C 將 NVIDIA Blackwell GPU 與基於 ARM 的 Grace CPU 連接起來,為開發者和邊緣環境的NVIDIA DGX Spark平台提供動力。如今,這項合作正透過 NVIDIA RTX Spark 擴展到客戶端系統。兩家公司表示,RTX Spark 將與基於 GB10 的 DGX Spark(同樣透過 NVLink-C2C 將 Blackwell GPU 和 Grace CPU 連接起來)一起,為面向人工智慧時代的下一代消費級 PC 提供動力。
在汽車領域,此次合作涵蓋了多代人工智慧驅動的軟體定義汽車產品。聯發科的天璣自動平台整合了NVIDIA的AI和RTX圖形技術,用於打造智慧汽車座艙,並可與NVIDIA DRIVE AGX協同工作。兩家公司正以此為基礎,建構可擴展的架構,以支援日益智慧化的AI定義汽車。


 Amazon