

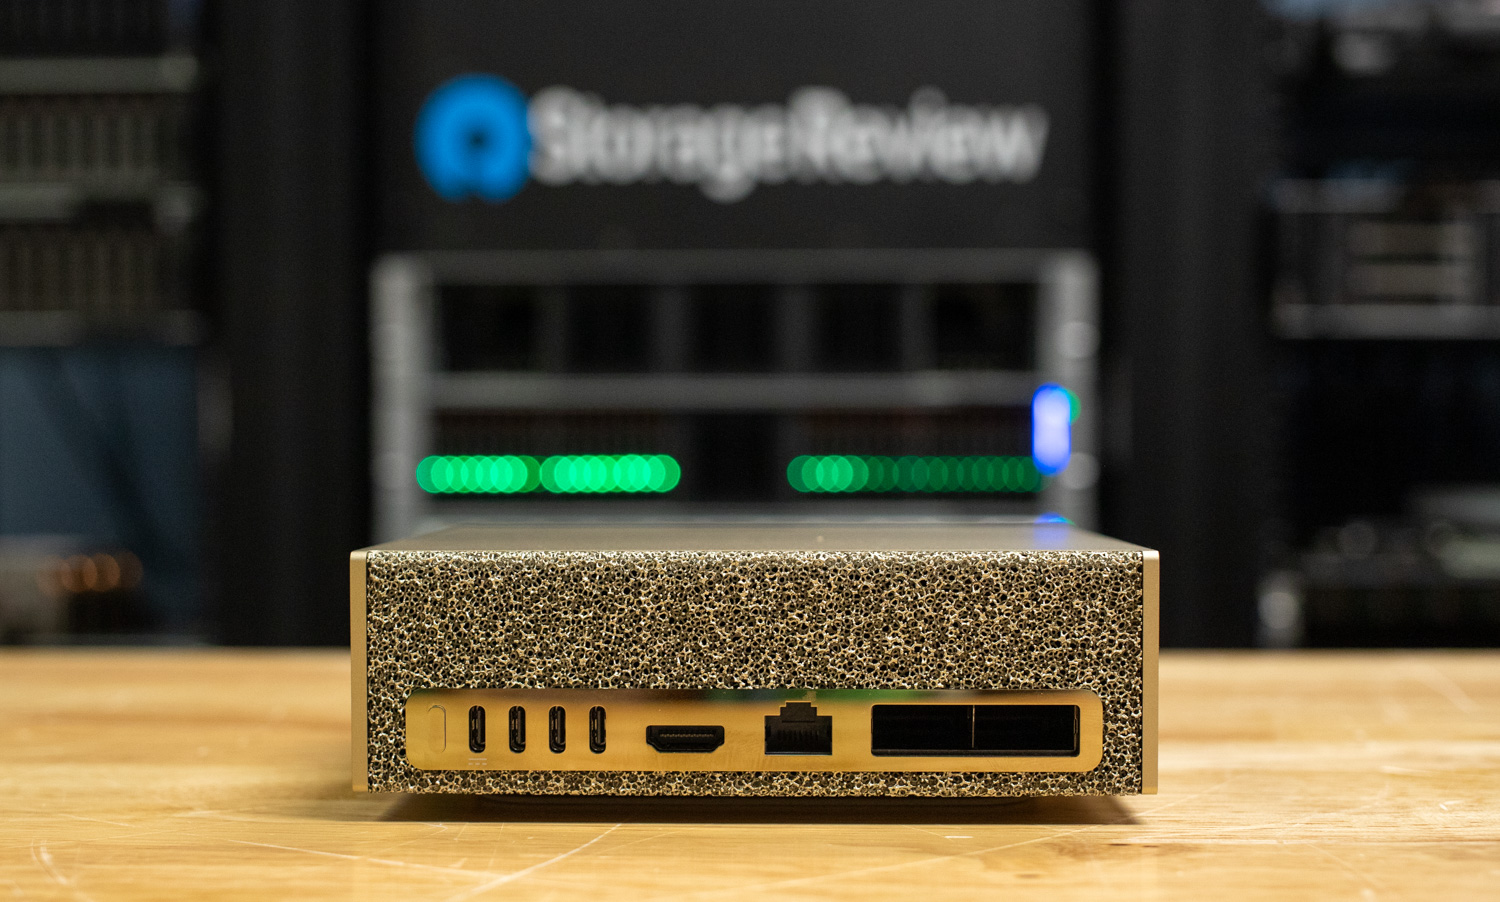
在 2026 年國際消費電子展 (CES) 上,NVIDIA 發布了DGX Spark的軟體更新,進一步拓展了其作為緊湊型本地部署 AI 系統的功能。此次更新主要針對新的運行時環境、量化格式和部署方案,使用戶能夠更輕鬆地在本地運行開源模型、自動化工作流程以及創建和 3D 管線。此更新面向已在實驗室、邊緣部署或工程環境中使用 DGX Spark 的團隊,不涉及任何新的硬體。
企業環境中的開源人工智慧
NVIDIA 強調了開源 AI 的快速崛起。開源 AI 框架和模型的月下載量從 2023 年 6 月的約 700 萬次增加到 2025 年 12 月的約 3.9 億次。 Spark 已進行調整以支援這一趨勢:PyTorch、vLLM、SGLang、llama.cpp、LlamaIndex 以及來自 Qwen、Meta、Stability 和 Wan 等社區的眾多模型現已完全整合到系統中。
對於採用開源工具的企業而言,這意味著更少的自訂整合工作,以及他們已使用的技術堆疊更可靠的運作。
自發布以來速度提升高達 2.5 倍
NVIDIA 聲稱,與 DGX Spark 發佈時相比,關鍵工作負載的效能提升高達 2.5 倍。這項提升源自於 TensorRT-LLM 的增強、更先進的量化技術以及解碼優化,而非硬體方面的改變。
一個具體的例子是使用 TensorRT-LLM 的 Qwen-235B。從 FP8 量化過渡到 NVFP4 量化,並採用 Eagle3 的推測性解碼,吞吐量提升了一倍以上。在 CUDA 和 llama.cpp 下的 Stable Diffusion 3.5 Large 演算法中,Qwen3-30B 的效能提升約為 1.4 倍。由於 PyTorch 管線針對 Spark 的 GPU 進行了最佳化,因此,無論是完全最佳化還是參數最佳化,微調過程都能帶來顯著但較小的效能提升。
劇本:從「桌面上的盒子」到可用的工作流程
為了彌合原始運算能力與可用解決方案之間的差距,NVIDIA 推出了新的 DGX Spark playbook,將工具、模型和指南結合起來,用於常見的企業任務。
新增內容包括:
- 推理:vLLM、SGLang、TensorRT-LLM、推測性解碼、多模態推理、Spark 上的 NIM、NVFP4 量化和本地 Nemotron-3 Nano。
- 微調:多 Spark PyTorch 微調、FLUX.1 DreamBooth LoRA、LLAMA Factory、NeMo 和基於 Unsloth 的高效訓練。
- 數據科學:CUDA-X 數據科學、優化的 JAX、文本到知識圖譜,以及特定領域的工作流程,例如單細胞 RNA 定序和定量投資組合優化。
- 工具與連線:ComfyUI、VS Code、DGX Dashboard、AI Workbench 中的 RAG、Tailscale 和基於 NCCL 的「Connect Two Sparks」。
重點不在於花俏的演示,而在於可復現性。這些操作手冊作為預先驗證的參考框架,無需重構整個技術堆疊即可部署到本機。
混合型 MacBook 和 Spark 讓 AI 影片串流速度提升 8 倍
在內容創作方面,NVIDIA 測試了 AI 視訊生成工作流程,將 MacBook Pro M4 Max 與 DGX Spark 透過 ComfyUI 和 FLUX.1-dev、WAN 2.2 以及 GPU 加速的擴大機結合。
參考流程以一段未來都市中紅色跑車的 4K 影片為特色,充分展現了改進之處。僅在 MacBook 上運行整個工作流程大約需要 8 分鐘。將繁重的處理任務轉移到 DGX Spark 後,時間縮短至約 1 分鐘,速度提升了 8 倍。
這項進展源自於在 Spark 上運行 FLUX.1-dev 和 WAN 2.2 的量化 NVFP4/NVFP8 版本,並隨後應用 RTX 視訊超解析度技術。對於媒體、設計和行銷團隊而言,這使得生成式影片的渲染方式從批次式轉變為更接近互動式迭代的過程,同時也能在資料中心或邊緣機架內保持控制權。
3D 和 RTX 重混:Spark 作為後台 AI 協處理器
DGX Spark 也被當作一款協處理器,用於基於 RTX Remix 的 3D 工作流程。例如,在 RTX 5090 系統上執行互動式「Mod」環境時,Spark 會大量產生 AI 紋理(例如,100 種材質),並將結果傳回場景中,而不會中斷藝術家的工作。
使用 SWAT 4 進行的前後對比展示了 AI 增強型材料如何使傳統資產煥發新生。然而,關鍵的商業優勢在於工作流程設計:Spark 作為一個持續的後台引擎,用於產生任務,而主工作站則保持運作。
Nsight Copilot:本地 CUDA AI 助手
值得一提的是,新增功能是 Nsight Copilot,它在 DGX Spark 上本地運行。
開發者可以要求諸如「使用 CUDA 以 FP4 格式編寫矩陣乘法」之類的任務,Nsight Copilot 提供了一個完整的 cuBLAS-Lt 範例,該範例在裝置上將 FP32 輸入量化為 FP4,設定每個張量的縮放比例,以 FP32 格式執行 FPGEMM,並傳回 FP32 格式。重要的是,此過程無需將程式碼或資料傳送到雲端服務:
- 無需支付雲端推理費用。
- 原始碼、資料和 IP 位址均保留在本機。
- 本地GPU負責管理延遲和吞吐量。
對於擁有嚴格資料治理規則的組織而言,這既可以實現人工智慧輔助開發,又能確保網路內部的一切安全。
智能體、機器人與邊緣運算:從實驗室到生產環境
NVIDIA正透過與Hugging Face和開源機器人Reachy Mini的合作,將Spark擴展到智慧體和機器人應用領域。 DGX Spark負責運作智能體、LLM、VLM和規劃器,而Reachy Mini則提供了一種適用於人機互動研究、教育和原型設計的實體形態。
DGX Spark 將於 1 月底前納入 NVIDIA AI Enterprise。這將為企業提供受支援的軟體堆疊、生命週期管理和安全更新,以便在邊緣和本地場景(例如智慧製造和檢測、智慧零售和防損以及即時醫療保健應用)中運行 Spark。
生態系和OEM支持
NVIDIA 在更新的最後重點介紹了其廣泛的生態系統:模型提供者(OpenAI、Mistral、Stability、Qwen、Meta、ElevenLabs、Black Forest Labs 等)、工具(vLLM、Comfy、LlamaIndex、Docker、Jupyter、Weights & Biases、Anyscale,以及 VASP 和 GROM GROM等科學代碼)以及包括戴爾、聯想、惠普、華碩、微星、超微等在內的眾多 OEM 廠商。
對於企業買家而言,DGX Spark 的訊息是,它不再只是面向開發人員的工具。它是一個小型節點,可以無縫整合到現有工具、供應商關係和生產 AI 策略中。


 Amazon