

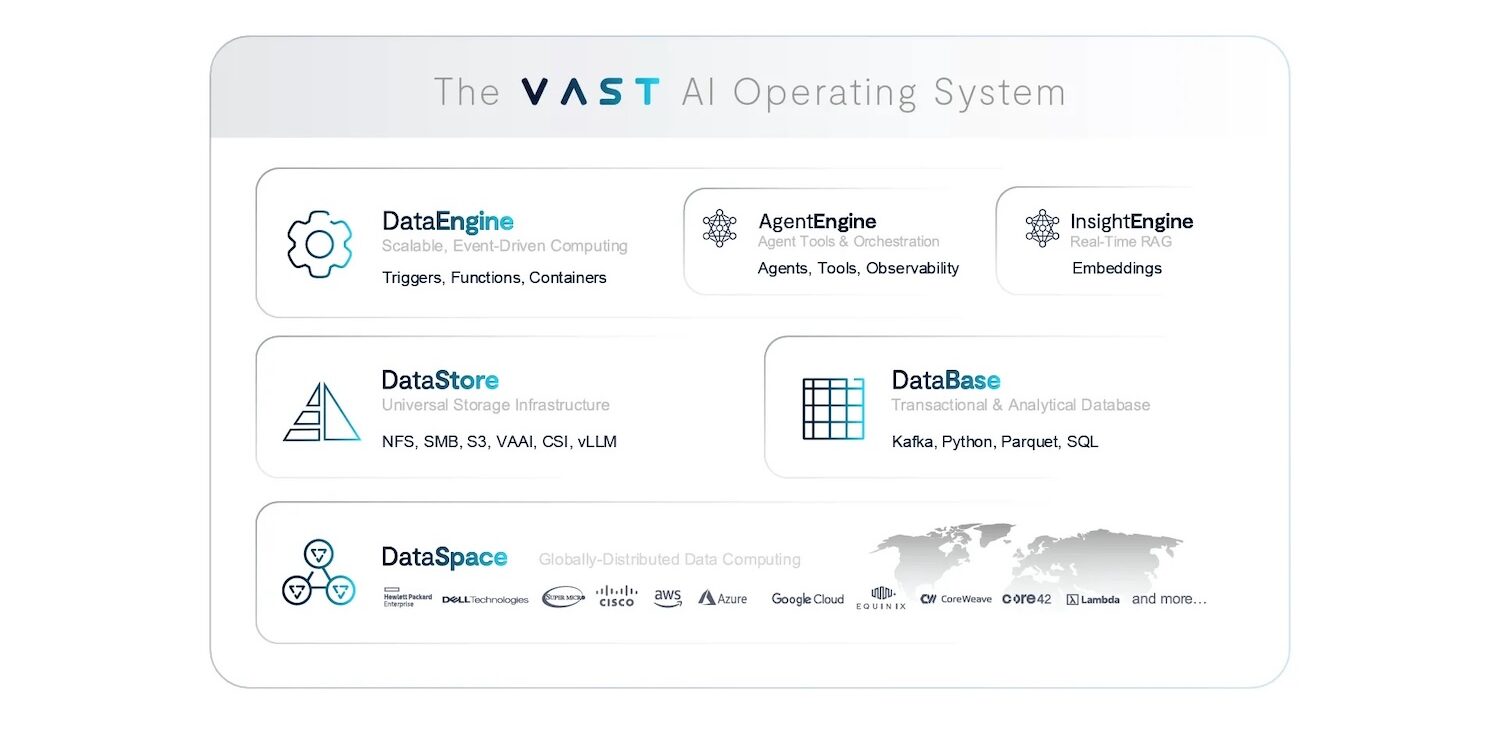
VAST Data 推出了一種全新的推理架構,支援 NVIDIA 推理上下文記憶體儲存平台。該系統專注於涉及持續、多輪代理驅動會話的 AI 應用。 VAST 將此平台定位為專為 AI 設計的儲存類別,可增強對鍵值 (KV) 快取的訪問,實現節點間推理上下文的快速共享,並提高能源效率。該設計採用 NVIDIA BlueField-4 DPU 和 Spectrum-X 以太網,而 VAST AI 作業系統 (AI OS) 則提供有效管理此共享基礎架構資源所需的軟體。
有關 KV 快取的重要性的更多信息,請查看我們與 Pliops 合作完成的這篇深度分析。
該公告標誌著限制實際應用中推理表現的因素發生了變化。隨著推理從簡單的提示轉向跨多個代理和用戶的持續推理,上下文資訊僅保留在單一GPU伺服器上的理念已不再適用。在這種情況下,整體效能越來越依賴推理歷史記錄在持續操作期間的儲存、復原、重複使用、擴展和共享效率。鍵值快取(KV快取)從內部最佳化機制演變為主要資料路徑,進而影響首次令牌獲取時間(TTFT)、GPU使用率和叢集效率。
重建圍繞DPU的推理資料路徑
VAST 的策略是將 VAST AI OS 軟體直接運行在 NVIDIA BlueField-4 DPU 上。與傳統的客戶端-伺服器模式不同,VAST 架構將儲存和上下文服務作為外部元件進行訪問,而是將這些資料服務直接整合到 GPU 伺服器(推理發生的地方),同時也支援專用資料節點配置。這種方法旨在最大限度地減少瓶頸,並消除不必要的複製和延遲,從而避免並發量增加時效能下降的問題。
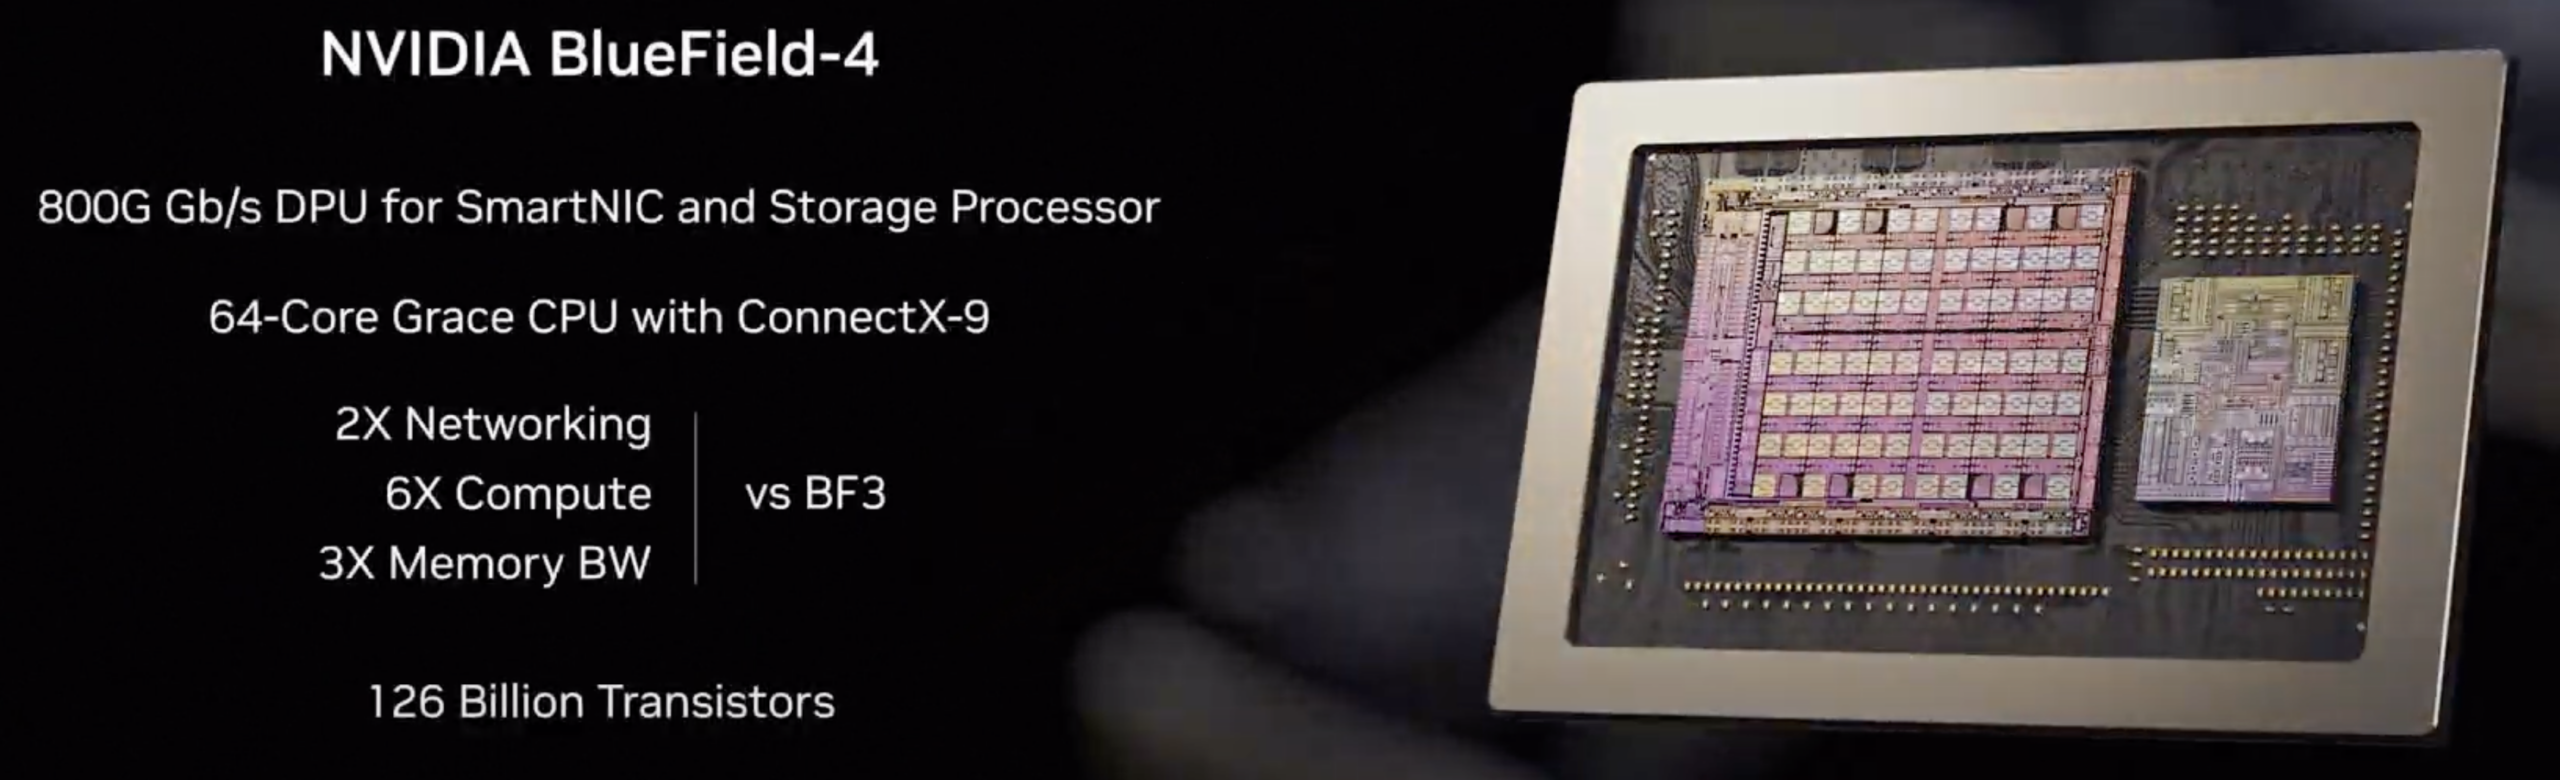
這種 DPU 原生設計明確針對大型推理系統的實際需求。當數百個會話同時運作時,管理鍵值快取就變成了持續的輸入/輸出 (I/O) 工作。系統必須快速讀取上下文以保持會話運行,將其儲存以供長期使用,並在工作節點之間共享上下文,以防止在基礎架構將操作引導至較慢的路徑或需要大量協調時出現重複處理。 TTFT 增加,導致 GPU 等待而非處理。 VAST 斷言,透過 BlueField-4 將資料平面移至伺服器可以實現更有效率的上下文流量、更高的吞吐量和更可靠的延遲,使其更接近 GPU 處理循環。
VAST 也強調使用 RDMA 架構實現從 GPU 記憶體到持久性 NVMe 儲存的高效路徑。這有效地實現了 GPU 伺服器和儲存之間的上下文平滑傳輸,減少了傳統系統中常見的重複資料處理。其目標是確保上下文傳輸與高效能網路保持「帶內」連接,同時最大限度地減少 CPU 參與和客戶端開銷。
大規模共享、連貫的背景
新架構與 VAST 的並行解耦共享一切 (DASE) 設計協同工作。 VAST 解釋說,這使得每個主機都能存取共享的、全域一致的上下文命名空間,而無需承擔通常在大規模場景下產生的協調成本。在長時間運行的、由代理人驅動的推理中,這項細節至關重要。上下文不僅規模龐大,共享程度也越來越高。
智能體系統通常需要同時使用多個工具,在多個智能體之間切換,並在互動過程中表現出類似記憶的行為。這就要求系統重複使用上下文而不是重新建立上下文,並在推理工作節點之間共享上下文而不是將其綁定到單一節點。如果系統因調度、驅逐或故障恢復等原因無法維持情境局部性,則必須快速恢復並繼續會話,而無需重新處理冗長的提示歷史記錄。這樣一來,鍵值快取就成為叢集中至關重要的資源,挑戰在於如何使其廣泛可用,同時避免成為同步瓶頸。
VAST 的觀點是,將基於 DPU 的資料服務與共享儲存架構結合,可以創建一個全域可存取的上下文層,即使並發會話數量增加,也能保持高效運作。該平台並非透過添加獨立的上下文單元來擴展,而是允許叢集在擴展的同時,繼續受益於資源的重複使用和共享。
語境即新的表現範圍
VAST 執行長 John Mao 指出,大型推理系統的競爭優勢正從單純的運算能力轉向記憶體和情境系統。他總結道,最有效的集群並非僅僅是那些峰值浮點運算能力最高的集群,而是那些能夠即時共享和管理上下文的集群。他還強調了即時按需存取上下文的重要性,並將其視為關鍵效能指標。他警告說,如果無法快速檢索和重複使用上下文,GPU 將處於閒置狀態,效率也會受到影響。
隨著模型規模擴大和會話時長增加,許多維運人員的經驗也印證了這一點。推理群集通常配置為最大程度地產生令牌,但實際體驗會受到壓力下的尾延遲和 TTFT 的影響。隨著提示符的延長和會話的持續,上下文管理所花費的時間也會增加。如果上下文無法快速恢復或重複使用,GPU 週期就會浪費在重新建立狀態或等待資料傳輸。 VAST 的架構方法將鍵值快取視為共享基礎設施,從而減少了這些問題並提高了叢集的整體效率。
從實驗到受控的生產推斷
VAST 也將平台定位為從實驗性部署過渡到生產就緒型推理服務(包括在受監管環境下)的平台。隨著推理成為一項具有特定安全性和合規性要求的獲利服務,管理鍵值快取需要的不僅僅是速度,還需要監管。
在長時間會話中,上下文可能包含敏感提示、推理步驟、工具輸出以及使用者提供的資訊。企業越來越需要針對此類情境進行策略控制、隔離措施、稽核追蹤和生命週期管理。 VAST 聲稱,這些 AI 原生資料服務已內建於 AI 作業系統中,使組織能夠將鍵值快取視為可管理的資源,而非臨時狀態。
從營運角度來看,VAST 旨在解決大型推理環境中常見的挑戰:快取遺失或無法共享時發生的上下文重建風暴,以及上下文成為瓶頸而非計算瓶頸時造成的 GPU 時間浪費。該公司認為,增強上下文的持久性和重複使用性將減少重複計算並提高資源利用率,從而隨著上下文規模和會話並發性的增加,提高每瓦吞吐量和每美元吞吐量。
英偉達:情境管理驅動規模經濟
NVIDIA網路資深副總裁Kevin Deierling強調了情境在人工智慧中的重要性,並將其比作人類記憶。他指出,有效管理上下文對於擴展多輪和多用戶推理至關重要,這反過來又改變了大規模上下文記憶體的處理方式。他提到,VAST Data AI OS與NVIDIA BlueField-4結合,能夠隨著工作負載的增加提供高吞吐量、穩定的資料路徑,從而支援這一目標。這種合作意義重大,因為它將DPU和乙太網路架構整合到核心推理上下文中,而不僅用於主儲存存取或網路連接。關鍵在於,上下文現在不僅對GPU構成挑戰,也對網路和儲存構成挑戰,現代推理架構需要集中加速和可靠的資料傳輸,以確保GPU高效運作。
如果 VAST 的架構能夠實現預期優勢,那麼其真正的影響將不在於峰值基準測試分數,而在於服務的穩定性能:在多個會話處於活動狀態時降低 TTFT,隨著上下文增加效能下降的幅度更小,透過減少上下文重建來提高資源利用率,以及更直接地實現多節點推理(此時上下文共享不再是劣勢,而是優勢)。此外,它還將推理基礎設施推向更「原生於 AI」的模型,將鍵值快取視為一個託管記憶體層,由持久性 NVMe 提供支持,並在節點間共享,同時嚴格限制延遲。
VAST前瞻會議
VAST Data 將在首屆 VAST Forward 用戶大會上公佈其策略,該大會定於 2026 年 2 月 24 日至 26 日在猶他州鹽湖城舉行。該公司計劃在大會上舉辦詳細的技術講座、實踐操作研討會和認證項目,屆時VAST 的領導層、客戶和合作夥伴將出席。


 Amazon