

歷史上,GPU 讀取的每個儲存資料都必須經過主機 CPU,CPU 負責管理檔案系統、提交指令並回傳資料。對於大型順序傳輸而言,這種開銷可以忽略不計,但當每秒處理數百萬次 512 位元組的操作時,就會成為瓶頸。在聖克拉拉舉行的 2026 年 FMS 大會上,NVIDIA 發布了新的軟體和一項行業倡議,旨在消除這一瓶頸。
這次發布的核心內容是 cuFile,這是一個允許 GPU 直接讀寫儲存裝置的 API。 NVIDIA 將 cuFile 及其完整的支援軟體堆疊開源,程式碼託管在 GitHub 上新成立的 XIO-SIG 組織中。創始維護者包括 Google、Intel、Meta 和 NVIDIA。此外,NVIDIA 也正式啟動了 Storage-Next 項目,該項目至少從 GTC 2025 大會起就已公開討論。 Storage-Next 目前已匯集了 40 多家儲存和快閃廠商,例如 DDN、KIOXIA 和 Micron,以及控制器製造商、散熱專家和標準組織。這些參與者正在共同定義當客戶端是 GPU 而非 CPU 時,儲存設備應該如何運作。
問題:主機介導的 I/O
傳統上,GPU 系統採用以主機為中心的 I/O 模型。 CPU 負責調度 GPU 任務、準備數據,並發起 GPU 與網路或儲存之間的所有資料傳輸。每個操作都遵循一定的順序:GPU 核心完成,控制權返回給 CPU,CPU 設定傳輸,然後啟動下一個核心。每次操作的成本主要包括核心啟動和 CPU-GPU 同步開銷,以微秒為單位。對於大量傳輸而言,這種開銷可以忽略不計,但對於細粒度操作而言,這種開銷就變得相當顯著了。
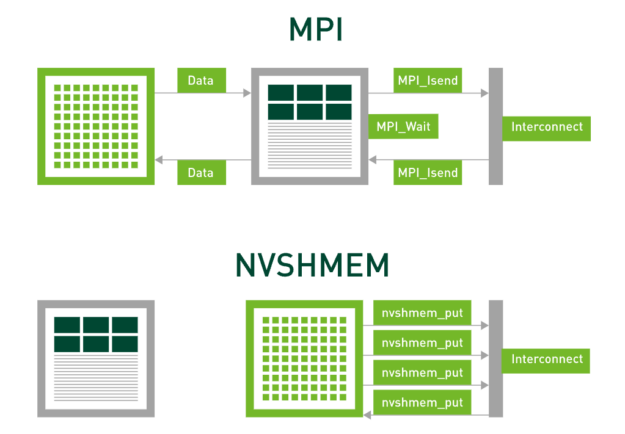
對於 GPU 間的通信,NVIDIA 透過 NVSHMEM 消除了主機參與,使設備程式碼能夠直接發起傳輸並將其與計算重疊。其影響顯著:當 GROMACS 將其光環交換通訊從 MPI 遷移到 NVSHMEM 時,通訊會從關鍵路徑中移除,並與計算完全重疊。
預存程序保留了主機中介模型。從 NVMe 磁碟機讀取資料仍會將控制權交還給 CPU,運行檔案系統並等待完成。訓練過程可以容忍這種情況,因為它的讀取操作量大且頻率低。但推理過程則不然。提供鍵值快取條目、嵌入向量和向量搜尋結果每秒會產生數百萬次小的隨機讀取操作,而每次讀取操作都需要 CPU 參與。
GPU 啟動的 I/O 和 SCADA
SCADA(可擴展、加速的資料存取)將 NVSHMEM 模型應用於存儲,使 GPU 能夠啟動和管理自己的儲存 I/O。
這項基礎研究成果是 BaM(Big Accelerator Memory,大型加速記憶體),由 NVIDIA、IBM、伊利諾大學和布法羅大學共同發表於 ASPLOS 2023 會議。 BaM 展示了 GPU 直接管理 NVMe 驅動器,將各個線程生成的小請求合併並緩存,從而在無需主機幹預的情況下維持接近驅動器飽和的隊列深度。在相同的硬體配置下,BaM 處理資料分析工作負載的速度比 CPU 發起的存取快 5.3 倍,並且從閃存執行圖工作負載的硬體成本比將相同資料儲存在主機記憶體中最多可降低 21.7 倍。
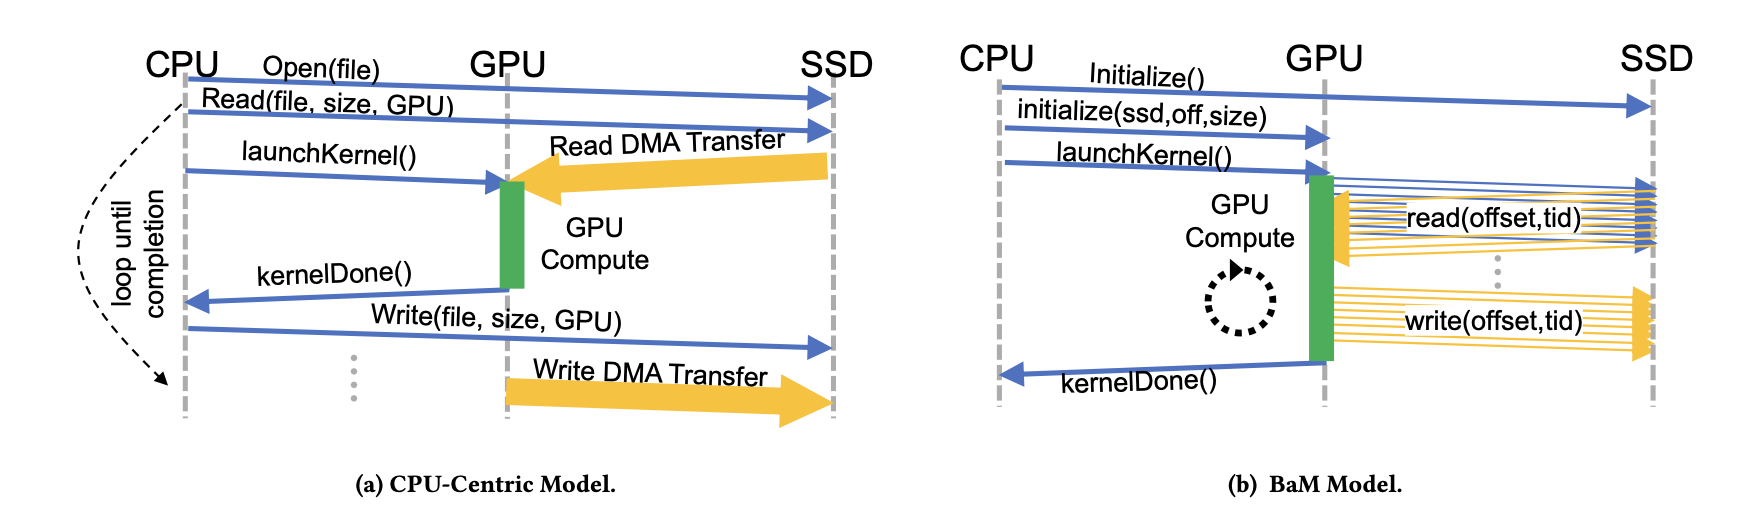
SCADA是其產品化形式。 GPU上的執行時期環境位於核心執行緒與儲存裝置之間。它將分散的小請求合併成讀取操作,這些操作要么從GPU快取中獲取數據,要么發送到驅動器,驅動器可以是本地NVMe固態硬碟,也可以是遠端儲存伺服器。
必須限制對設備的直接訪問,因為對共享驅動器的原始訪問可能導致一個應用程式讀取或損壞另一個應用程式的資料。 NVIDIA 的設計將權限等級分開。應用程式中對效能至關重要的部分以非特權模式運行,位於可信任計算基之外。特權元件在設定時使用標準的 Linux 安全機制,為每個應用程式與其授權儲存裝置之間配置受保護的存取。 NVIDIA 指出,正是這種權限分離和基於 Linux 的互通性,使得該技術堆疊以開源形式發布,而不是作為封閉的 CUDA 元件發布。
SCADA 與 GPUDirect 儲存有何不同
每次儲存操作都包含資料路徑(移動的位元組)和控制路徑(請求的建置、提交和完成處理)。 GPUDirect Storage (GDS) 於 2019 年推出,並於 2021 年開始供貨,它將 CPU 從資料路徑中移除:透過 cuFile,資料透過 DMA 在磁碟機和 GPU 記憶體之間傳輸,無需在主機 RAM 中使用緩衝區。 NVIDIA 的發布資料顯示,DGX-2 的 CPU 路徑速度上限為 50GB/s,而 GDS 能夠合併路徑,使速度上限接近 200GB/s。 DDN、VAST、WEKA、Pure Storage 和其他主要 AI 儲存廠商均已通過 GDS 認證。控制路徑仍然保留在 CPU 上:主機軟體仍然決定要取得哪些資料並發出每個請求,而 GPU 是 DMA 的目標,而不是發起者。
在大傳輸量的情況下,這種分配方式效果很好。 1MB 的讀取操作可以將控制路徑的成本分攤到幾乎為零。但當讀取量達到 512 位元組時,情況就相反了。每次請求的固定成本佔據主導地位,CPU 的負載會遠高於硬碟的負載。 SCADA 將控制路徑轉移到 GPU 上,GPU 透過保持數十萬次操作的運行,以與吸收記憶體延遲相同的方式吸收每次操作的延遲。
兩者並存:cuFile 用於批次傳輸,SCADA 用於大量小隨機讀取。
Storage-Next 和 512 位元組問題
SCADA 負責 GPU 端。 Storage-Next 則負責硬碟端,目前針對不同的工作負載進行了最佳化。
企業級固態硬碟 (SSD) 十年來一直針對 4KB 隨機讀取進行最佳化,以匹配資料庫和虛擬化的存取模式。大多數控制器處理 512 位元組讀取和 4KB 讀取所需的工作量大致相同,因此小於 4KB 的請求會以 4KB 的成本運作。推理存取模式則更小:嵌入資料佔用數百字節,鍵值快取區塊遠小於 1KB。如果從針對 4KB 最佳化的驅動器來處理這些數據,則會導致 8 倍的讀取放大,浪費頻寬和控制器快取。當儲存數十 TB 的小物件時,這種放大效應決定了快閃記憶體作為儲存層的可行性。
Storage-Next 旨在圍繞更小的儲存單元重新設計驅動器、控制器和系統。該專案在 GTC 2025 大會上正式亮相,目前已在進行中,其目標是在功耗和尾延遲限制下,最大限度地提高每個 GPU 的 512 位元組 IOPS。在 FMS 大會上,NVIDIA 公佈了成員名單,涵蓋了 40 多家儲存和快閃廠商,並指定 SCADA 作為建置框架。
參考結果是美光在SC25大會上演示的單一伺服器在SCADA程式設計模型下實現了2.3億512位元組隨機讀取IOPS:該伺服器由44塊美光9650 PCIe Gen6 SSD組成,這些SSD位於三台博通PEX90000 Gen650 PCIe Gen6 SSD組成,這些SSD位於三台博通PEX90000 Gen620Fcon 760機之後,由三台安裝台連接機組內。該數值約為44塊SSD總額定IOPS(550萬)的95%。
這個數字的組成至關重要。 230億次512位元組的讀取操作相當於約118GB/s的有效載荷,這相當於四到五個硬碟可以順序傳輸的資料量。真正的突破在於操作次數。如果僅透過主機軟體來維持如此龐大的運算量,光是提交和完成的處理就需要佔用數十個CPU核心,而演示中使用的單一CPU幾乎處於空閒狀態。如果將這些操作分配到GPU的十萬多個執行緒上,每個執行緒每秒只需執行數千次操作。
SSD 的效能如今已成為關鍵因素。美光 9650 是首款 PCIe Gen6 SSD,順序讀寫速度高達 28GB/s,隨機讀取 IOPS 更是達到了創紀錄的 5.5 萬。美光在演示中表示,其性能可從 1 個硬碟線性擴展到 44 個硬碟。鎧俠 (Kioxia) 的 GP 系列是一款專為 512 位元組訪問而設計的 XL-Flash SSD,目前正在 Storage-Next 計劃下進行開發。 NVIDIA 的 Storage-Next 路線圖要求 PCIe Gen7 SSD 的單塊 IOPS 達到 100 億,包括 Marvell 在內的控制器廠商目前正朝著這個目標進行設計。要達到這樣的效能,需要重新設計控制器,改進針對小負載的糾錯機制,並制定定義 GPU 原生驅動器行為的標準。
映射到訓練和推理
這兩條路徑對應兩種訪問模式。訓練過程受限於頻寬。它會傳輸大型順序分片,並定期寫入數TB的檢查點,在此期間GPU處於空閒狀態。在這種傳輸規模下,CPU開銷可以忽略不計,因此GDS和新開源的cuFile協定堆疊仍然是正確的接口,其效能以每GPU的GB/s和檢查點持續時間來衡量。
推理性能受限於 IOPS。 KV快取(會話中已處理的每個標記的注意力狀態)會隨著上下文長度的增加而增長。智能體部署會同時執行數千個同時會話。這很快就會超出 GPU 記憶體的限制,而重新計算已驅逐的條目比重新讀取它們消耗更多的 GPU 時間。標準設計採用分層緩存,快取從 GPU 記憶體溢出到系統記憶體再到閃存,並透過大量的隨機小讀取操作進行填充。向量搜尋和嵌入查找也遵循相同的模式。這正是 SCADA 系統所追求的存取模式,也是 NVIDIA 以 512 位元組 IOPS 而非頻寬來衡量效能的原因。從快閃記憶體而非記憶體提供 KV 快取會增加每個 GPU 支援的上下文數量和並髮使用者數量,從而決定每個使用者的服務成本。
硬體:Vera BlueField-4 STX 和 CMX
平台層採用的是NVIDIA Vera BlueField-4 STX,這是在 GTC 2026 上推出的機架級儲存架構,並於本週進行了擴展。 STX 將 Vera Rubin 平台與 BlueField-4 儲存處理器結合,每個處理器都整合了 Vera Arm 核心、800Gb/s 的整合網路以及大約 6 倍於 BlueField-3 的運算能力。
在FMS大會上,NVIDIA發布了這些核心的基準測試結果。一個代表適用於所有流量的內聯資料服務儲存系統的兩階段壓縮和加密管線,在Vera晶片上的吞吐量最高可達x86 CPU的3.21倍。這意味著目前在儲存控制器中佔用x86核心的加密、壓縮和驗證功能,可以遷移到Vera晶片上,從而降低功耗。 NVIDIA的BlueField軟體框架DOCA負責在資料路徑中強制執行安全性策略。基於STX的CMX上下文記憶體儲存將BlueField-4背後的快閃記憶體池化為共享的KV快取層,用於長上下文推理。來自DDN、戴爾、HPE、IBM、VAST Data、WEKA等合作夥伴的系統預計將於2026年下半年上市。
關閉的思考
策略架構清晰:NVIDIA 正在發布 GPU 用於存取儲存的接口,開源其實現,並組織 40 多家供應商來規範底層硬體的行為。開放 cuFile 打破了 NVIDIA 將該層保留在 CUDA 內部的慣例。但只有當驅動器、控制器和陣列供應商都基於此介面進行開發時,GPU 發起的儲存介面才能真正發揮作用。英特爾加入維護行列是值得關注的訊號。作為目前儲存系統中 x86 晶片的主要供應商,英特爾正在支援旨在將該晶片從 I/O 路徑中移除的軟體。
美光的示範證明了這種方案的可行性。三塊GPU驅動44塊第六代固態硬碟,使其讀寫速度達到額定讀寫速度的約95%,而這種小塊大小的固態硬碟一直以來都被業界忽略。現在的問題在於執行:程式碼需要上線GitHub,SCADA系統需要從框架發展成為受支援的CUDA組件,以及廠商需要大量出貨針對小塊讀取最佳化的固態硬碟。以上數據來自NVIDIA及其合作夥伴,並非獨立測量結果。我們將在今年下半年STX系統到實驗室後進行測試。


 Amazon