

NVIDIA、Rebellions 和 SK Telecom 宣布了一項計劃,將在韓國建立基於 Rebellions 下一代 R200 神經處理單元的自主人工智慧推理基礎設施。此基礎架構將採用 NVIDIA NVLink Fusion 技術在機架內部連接,並基於 NVIDIA MGX 機架架構建置。 SK Telecom 將在其人工智慧資料中心部署該系統,並與其模型和服務一同運作。三家公司預計 R200 系統將於 2028 年準備就緒並投入使用。
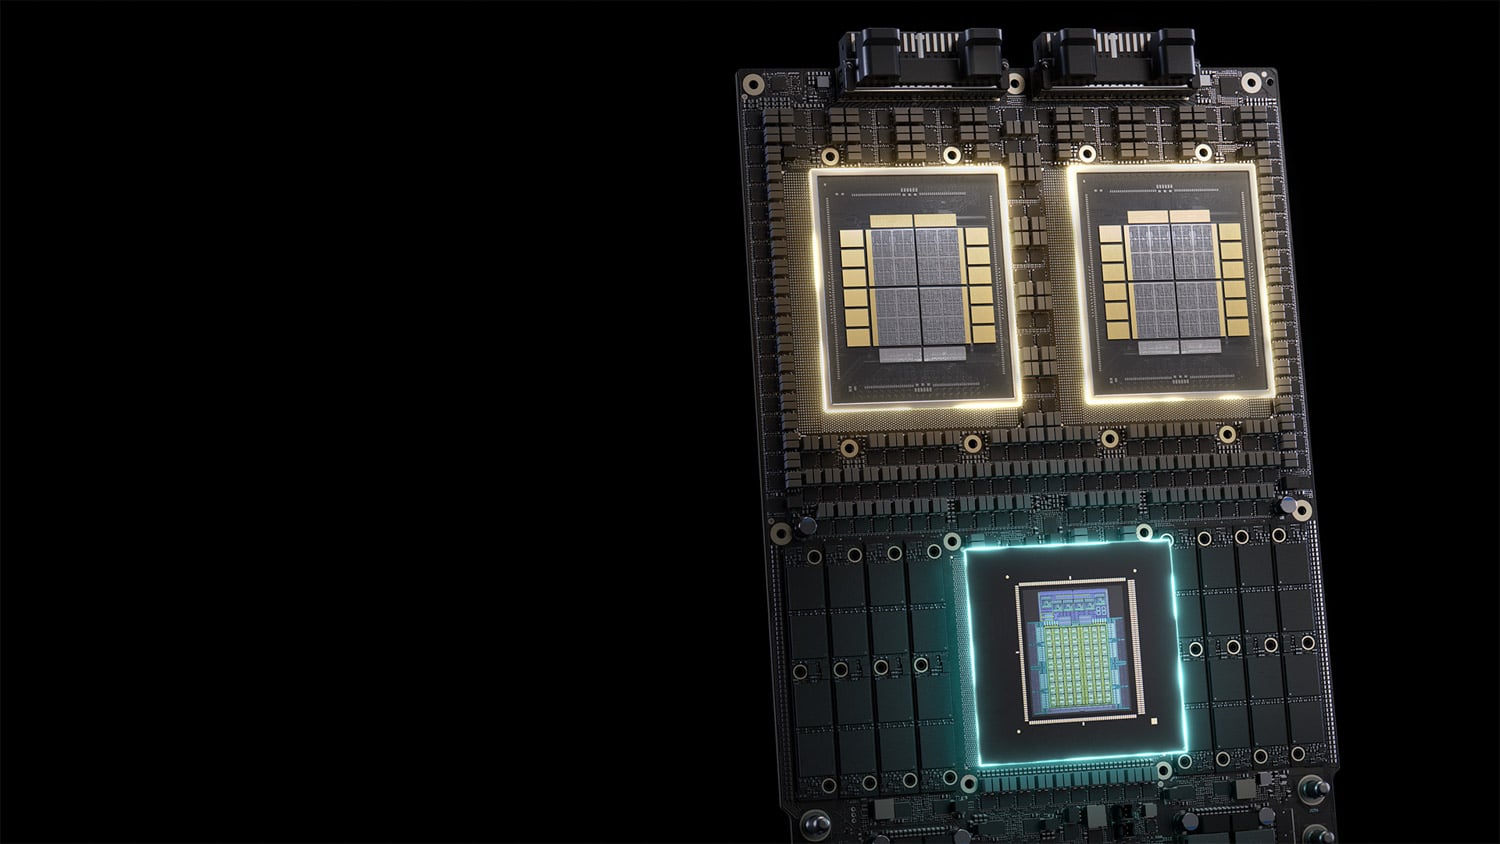
NVLink Fusion 連接 R200 NPU
Rebellions 正在設計 R200,用於對前沿模型(包括數萬億參數的混合專家模型)進行低延遲、高能效的推理。 NVLink Fusion是 NVIDIA 的一項計劃,旨在將客製化晶片整合到其可擴展架構中:晶片製造商將 NVLink 整合到其處理器中,即可使用 NVIDIA 的 NVLink 交換、高頻寬、低延遲網路以及相關的基礎設施生態系統。 Rebellions 計劃利用 NVLink Fusion 將機架內的 R200 NPU 透過 NVLink 可擴充網路連接起來,並將這些處理器整合到 NVIDIA 平台中,作為機架級系統的一部分。
兩家公司尚未公佈R200的具體規格、每個NPU的NVLink頻寬,以及計劃配置的任何性能測試結果。 Rebellions目前使用的是Rebel100晶片,而R200的發佈公告中並未提及內存、製程節點或功耗等信息,因此兩代產品之間的具體差異尚不清楚。
MGX機架架構支援系統開發
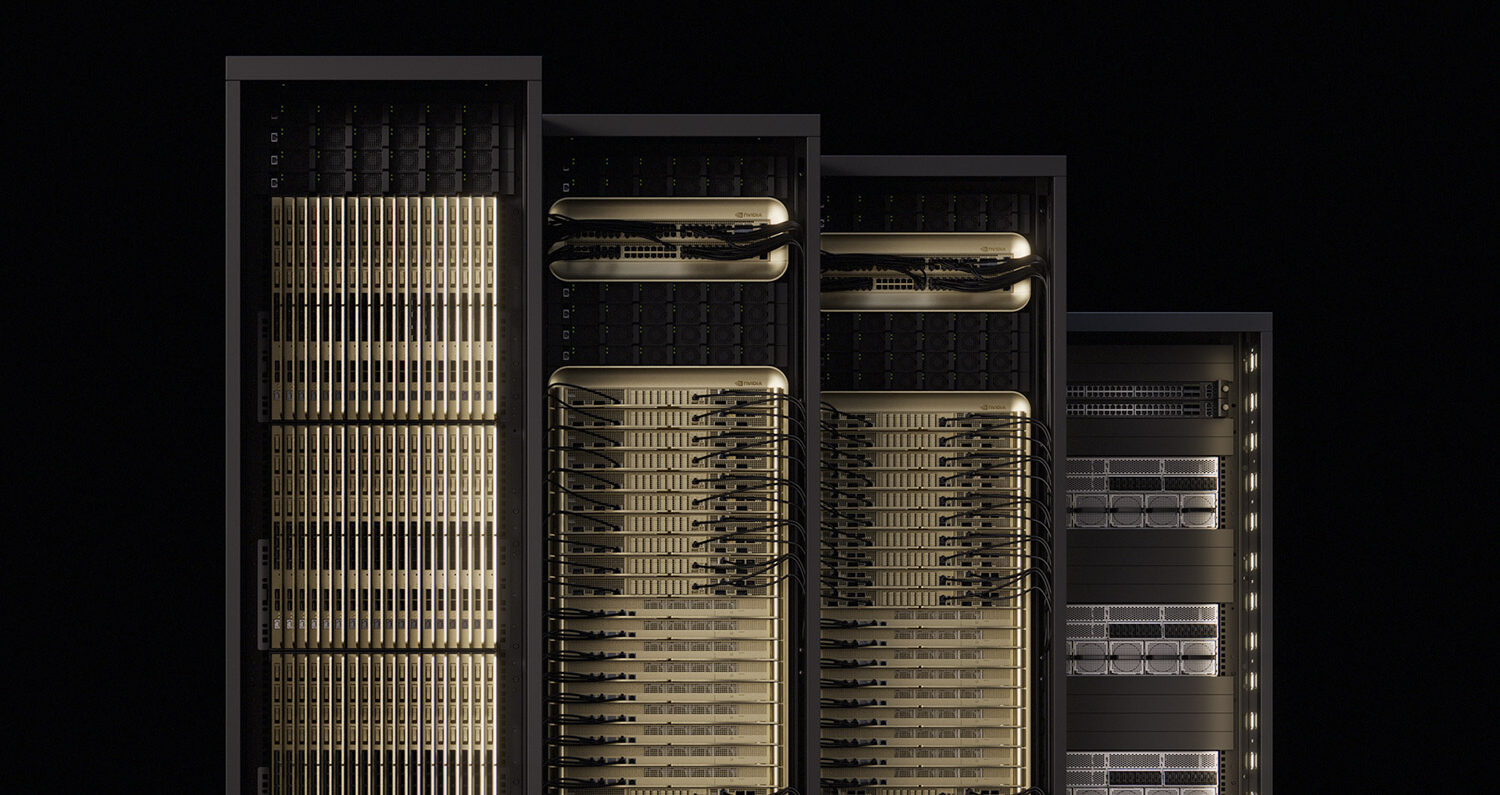
NVIDIA 的MGX 機架架構和參考設計為 Rebellions 的系統開發提供了起點,同時也能接觸到已生產 MGX 硬體的原始設計製造商和組件供應商。 MGX 定義了機架的共享元件,包括佔地面積、供電和散熱,因此 GPU 系統和 NPU 系統可以採用相同的資料中心設計。 SK Telecom 計劃在其 AI 資料中心部署基於標準化 MGX 機架的 R200 系統,這使得他們能夠在處理器最終確定之前規劃電源和散熱方案。
GPU用於預填充,NPU用於解碼
最有趣的技術細節是這三家公司計劃開發的推理分離方案。推理分為兩個階段,對硬體的要求不同:預填充階段處理提示訊息,通常受計算資源限制;解碼階段一次生成一個令牌,通常受記憶體頻寬和延遲限制。建議的配置方案在 NVIDIA GPU 上運行預填充,在 Rebellion NPU 上運行解碼,兩者透過 NVLink 架構連接。
既定目標是更高的推理吞吐量和更佳的能效。將解碼任務交給NPU的優勢目前仍停留在設計意圖階段,尚未在實際系統中實現,但從理論上講,這種邏輯是合理的。預填充和解碼分離在GPU池中已是常見做法,包括NVIDIA的Dynamo Serving框架;而透過NVLink將這兩個階段分割到不同的處理器架構上則是新的突破。
Rebellions 聯合創始人兼首席執行官 Sunghyun Park 表示,此次合作將該公司的 AI 晶片和系統設計與 NVIDIA 的互連和機架級能力以及 SK Telecom 的模型和數據中心運營相結合,旨在為大規模前沿模型實現低延遲、節能的推理。
SK Telecom 連接模型和服務
SK Telecom 帶來了模式和客戶。該公司計劃在該基礎設施上運行其專有的基礎模型,包括 AX K2,以及透過韓國政府「全民人工智慧」專案開發的面向公眾的服務。 SK Telecom 的資料中心營運、模型和服務完善了雙方所稱的全端式自主人工智慧策略,這項工作建立在SK 和 NVIDIA在 7 月韓國人工智慧高峰會上提出的更廣泛的合作關係之上。
韓國科學技術資訊通信部支持英偉達與韓國NPU公司(首先是Rebellions和SK Telecom)的合作,並闡述了涵蓋物理AI和GPU供應的更廣泛合作計劃。其目標是打造符合韓國語言、產業及公營及私營部門優先事項的AI服務。
庫存情況
Rebellions R200 系統預計將於 2028 年準備就緒並投入使用。目前尚無樣品發放計畫、提前體驗計畫、正式上市日期或定價資訊。


 Amazon