

在幾代硬體發展歷程中,記憶體和網路設備供應商都曾關注過高效能運算叢集中不同的瓶頸。記憶體製造商專注於提升封裝記憶體頻寬,而網路架構供應商則致力於提昇機箱間和機架間的吞吐量。如今,這兩種視角都聚焦於同一個瓶頸:限制分散式運算節點和記憶體池之間資料傳輸的頻寬壁壘。
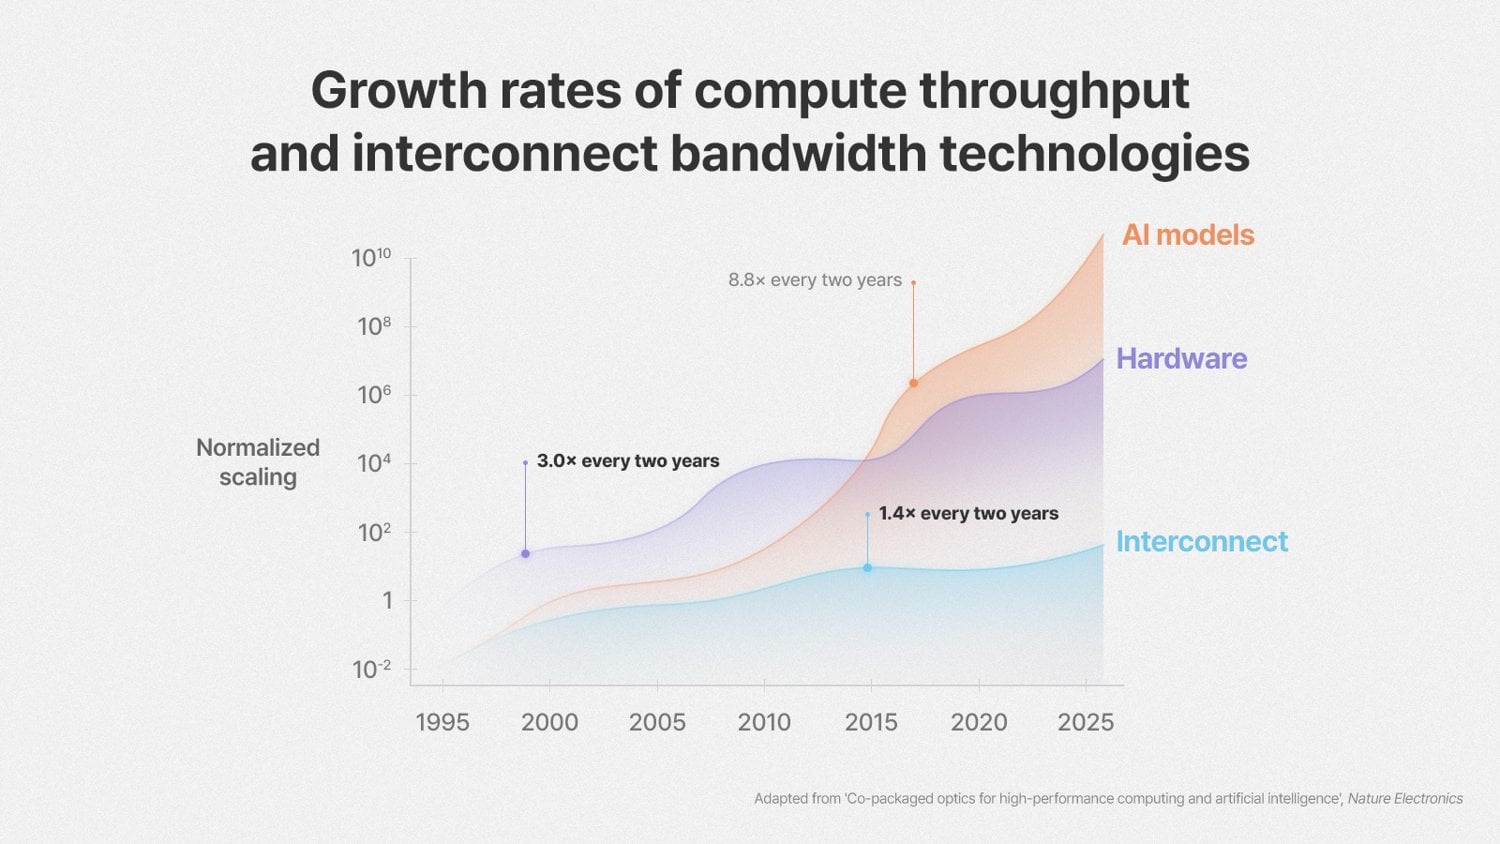
雖然高頻寬記憶體(HBM) 有效地解決了單一 AI 加速器封裝級頻寬的限制,但現代超大規模訓練和推理工作負載如今已擴展到分佈在機架和節點上的數萬個處理器。在這些分散式拓樸結構中,運算吞吐量歷來每兩年成長約 3 倍,而互連頻寬同期僅成長約 1.4 倍。由此產生的不平衡使得主要的擴展瓶頸集中在實體互連層。
該評估源自於8月20日發表於《自然·電子學》的一篇題為《用於高效能運算和人工智慧的共封裝光學元件》的觀點論文,該論文由SK海力士與維吉尼亞大學、伊利諾大學厄巴納-香檳分校、麻省理工學院、南洋理工大學和延世大學的研究人員共同撰寫。 SK海力士人工智慧基礎設施團隊負責人洪承勳、維吉尼亞大學教授李奎相為通訊作者。
| 階段 | 結果 |
|---|---|
| AI叢集擴展瓶頸轉移 | |
| HBM 封裝內 | 解決了晶片/封裝記憶體瓶頸問題 |
| 銅走線 | 晶片外物理衰減/功率牆 |
| CPO整合 | 將光學織物直接匯聚到基板上 |
為了解決這個限制,SK海力士與維吉尼亞大學、伊利諾大學香檳分校、南洋理工大學、麻省理工學院和延世大學的研究人員合作,在《自然·電子學》雜誌上發表了一篇題為「用於高效能運算和人工智慧的共封裝光學元件」的研究論文。該論文詳細闡述了共封裝光學元件(CPO)和光運算互連(OCI)如何與記憶體和封裝架構協同發展,以支援未來叢集的擴展。
銅互連的物理極限
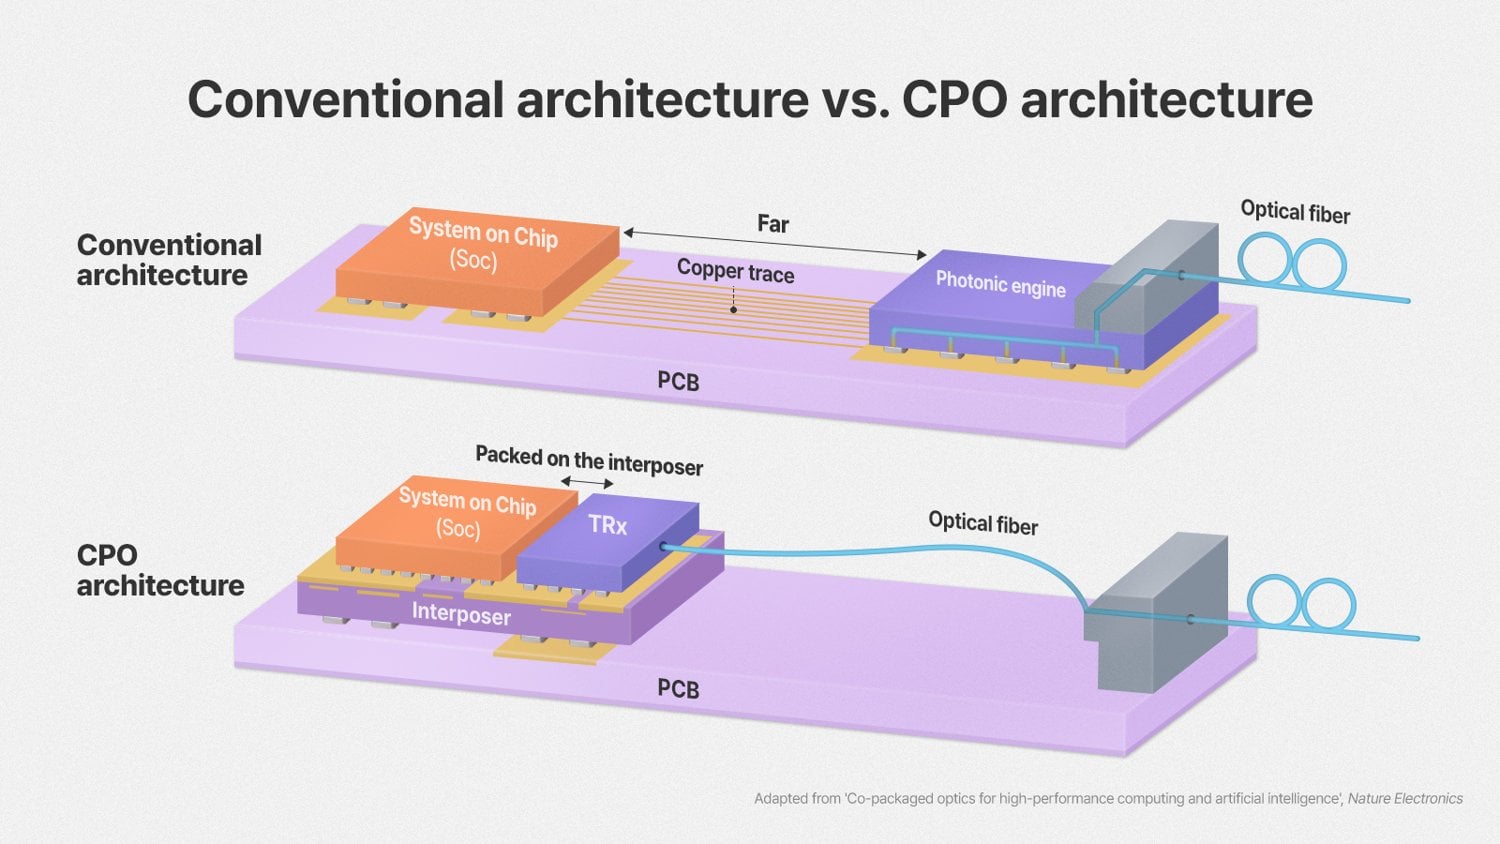
在短距離傳輸中,依賴銅線和直連銅纜的標準電氣互連仍然實用。然而,隨著資料速率的提高,電訊號傳輸會面臨嚴重的訊號衰減、插入損耗和功耗增加的問題。在較長的電路板走線和背板上管理高速訊號需要複雜的均衡和重定時電路,這會增加延遲並消耗大量功率。
共封裝光學元件如何改變路徑
CPO 透過將光收發器直接安裝在與主機處理器或加速器相同的封裝基板上,克服了這些物理限制。將高速電訊號直接轉換為計算矽附近的光子通道,最大限度地縮短了電氣走線長度,從而降低了寄生電容和訊號衰減。這種架構能夠在電路板、機架和擴展艙之間實現低損耗、高頻寬的光傳輸,同時保持更高的頻寬密度和更強的抗電磁幹擾能力。
| 公制 | 目標規格 |
|---|---|
| CPO節點的目標規格 | |
| 節點頻寬密度 | 每個節點 > 100 Tb/s |
| 能源效率 | < 1 pJ/比特 |
| 晶片間互連延遲 | <10 ns |
| 整合路徑 | 2.5D 中介層到 3D 異質 |
路線圖描繪了架構演進的藍圖,從標準的二維多晶片模組和2.5D矽中介層集成,逐步邁向三維異構堆疊。最終的架構里程碑是將光鏈路直接延伸到記憶體子系統本身。
透過使用光子中介層將記憶體堆疊與計算引擎直接連接,系統可以繞過傳統的板級佈線限制。這種方法能夠實現解耦式、低延遲的共享記憶體池,多個計算引擎可以透過光背板存取共享容量,而無需像傳統網路結構那樣承受串行化和解串行化帶來的效能損耗。
商業部署面臨的工程挑戰
將CPO從先進封裝演示過渡到生產資料中心硬體面臨許多尚未解決的工程難題。將低功耗矽光子元件與高功率主機邏輯集成,需要精密的隔熱措施以及先進的微流控或直接封裝冷卻設計。
此外,業界必須開發標準化的低延遲相干協議,以便在無需專有軟體開銷的情況下協調光耦合記憶體事務。可靠的商業化需要端到端的硬體協同設計,涵蓋DRAM晶片拓撲結構、客製化記憶體控制器、光子引擎和異質基板封裝。對於SK海力士而言,光耦合技術路線圖與其傳統路線圖並行推進;該公司在2026年FMS大會上詳細介紹了16層HBM4和晶圓鍵合的375層NAND快閃記憶體。


 Amazon