

WEKA宣布將其NeuralMesh平台與NVIDIA STX參考架構集成,使其增強型記憶體網格成為下一代AI基礎設施的核心組件。此組合方案旨在解決大規模推理環境中的主要限制因素之一:記憶體限制會影響效能、成本和可擴展性。
基於 NeuralMesh 架構,WEKA 的增強記憶體網格透過外部化和持久化鍵值快取來擴展 GPU 記憶體。在 NVIDIA STX 部署中,該架構支援用於智慧體 AI 工作負載的高吞吐量上下文記憶體存儲,從而實現跨會話、工具和工作流程的長上下文推理。該公司表示,採用NVIDIA Vera Rubin NVL72系統、BlueField-4 DPU 和 Spectrum-X 乙太網路的配置可以將上下文記憶體令牌吞吐量提高 4 到 10 倍。該平台預計還將提供至少 320 GB/s 的讀取吞吐量和 150 GB/s 的寫入吞吐量,比傳統 AI 儲存系統的效能高出一倍以上。

記憶體基礎設施成為推理瓶頸
WEKA 的整合方案圍繞著人工智慧部署中日益嚴峻的瓶頸——記憶體牆——展開。在現代推理管線中,GPU 上有限的高頻寬記憶體會導致頻繁的鍵值快取驅逐,從而造成重複計算並降低效率。隨著併發量的增加,這些效率損失會不斷累積,推高基礎設施成本並降低系統可預測性。
該公司提倡採用共享鍵值快取基礎設施作為解決方案。透過跨用戶和會話維護持久上下文,共享快取消除了冗餘計算並穩定了令牌吞吐量。 NVIDIA STX提供了一個用於實作此模型的參考架構,而 WEKA 則提供了儲存和記憶體擴充層。
神經網格和增強記憶網格架構
NeuralMesh 是 WEKA 的分散式儲存平台,旨在跨整個 NVIDIA STX 堆疊運作。該系統提供專為 AI 工作負載量身定制的高效能資料服務,而增強記憶體網格 (Augmented Memory Grid) 則作為一個專用的記憶體擴充層,將鍵值快取 (KV cache) 匯集到 GPU 記憶體之外。
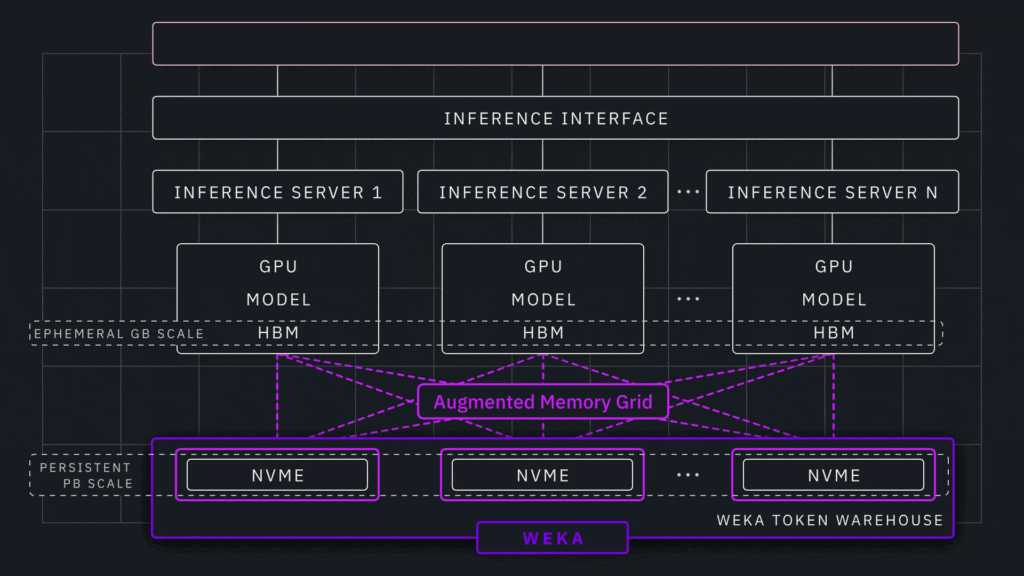
這種方法允許推理環境在不耗盡 GPU 資源的情況下維持長時間的上下文會話。透過保留快取狀態並支援跨工作負載的重複使用,該平台旨在隨著部署規模的擴大,保持高利用率和穩定的效能。
WEKA 報告稱,最初在 GTC 2025 上推出的增強型記憶體網格 (Augmented Memory Grid) 已在搭載 BlueField DPU 的 NVIDIA Grace CPU 平台上完成驗證,並已正式發布。此架構顯著提升了推理效率,包括大幅縮短首次令牌獲取時間、提高每個 GPU 的令牌吞吐量,以及在並發量增加時保持效能穩定。將儲存資料路徑卸載到 BlueField-4 進一步降低了 CPU 開銷,並最大限度地減少了 I/O 瓶頸。
效能和效率提升
在生產環境中,該平台旨在提升反應速度和基礎設施效率。 WEKA 指出,增強型記憶體網格 (Augmented Memory Grid) 可以將首次令牌回應時間 (Time-to-first-token) 縮短 4 倍至 20 倍,同時將每個 GPU 的令牌輸出量提高 6.5 倍。這些效能提升得益於更高的鍵值快取命中率和更少的重複計算,從而使系統能夠在上下文視窗和使用者數量增長的情況下保持效能。
AI基礎設施供應商Firmus是率先將NeuralMesh技術應用於NVIDIA基礎設施的公司之一。該公司報告稱,大規模部署後,令牌吞吐量顯著提升,延遲顯著降低,並將這些優勢歸功於對現有GPU資源的更高效利用,而非硬體規模的擴展。
對人工智慧基礎設施設計的影響
此次整合凸顯了人工智慧系統架構的轉變,記憶體和儲存設計越來越決定整體效能和成本效益。隨著智慧型體人工智慧工作負載的擴展和上下文視窗的增大,僅使用DRAM的方法由於不斷增加的重複計算開銷和GPU利用率不足而變得越來越不可行。
WEKA 將持久共享的鍵值快取定位為 AI 工廠的基礎功能。採用此模型的組織可以維持更高的 GPU 利用率,降低每次推理任務的能耗,並獲得更可預測的擴展特性。相反,繼續僅依賴本地 GPU 記憶體的環境,隨著工作負載的擴展,可能會面臨不斷增加的營運成本和收益遞減的問題。
庫存情況
WEKA 的增強記憶網格通常作為 NeuralMesh 平台的一部分提供。


 Amazon