

AMD的晶片或許是先驅:早在NVIDIA進入市場之前,Strix Halo迷你PC和筆記型電腦就已經配備了128GB的統一記憶體。但本地AI桌面這一概念實際上是NVIDIA開創的,當時他們將一顆Grace Blackwell超級晶片裝進一個一公升大小的盒子裡,並命名為DGX Spark。其理念很簡單:一檯面向開發者的機器,擁有足夠的統一記憶體來運行強大的模型,可以放在桌面上,而不是像DGX Spark那樣按流量計費。 AMD Ryzen AI Halo正是AMD對標DGX Spark的回應。 AMD於2026年5月與Ryzen AI Max PRO 400系列一同發表了這款產品;6月起,Micro Center獨家開啟預售,7月10日正式發售。 Ryzen AI Halo擁有類似的尺寸、128GB的統一記憶體、3,999美元的售價,以及一些使其與Spark截然不同的設計。
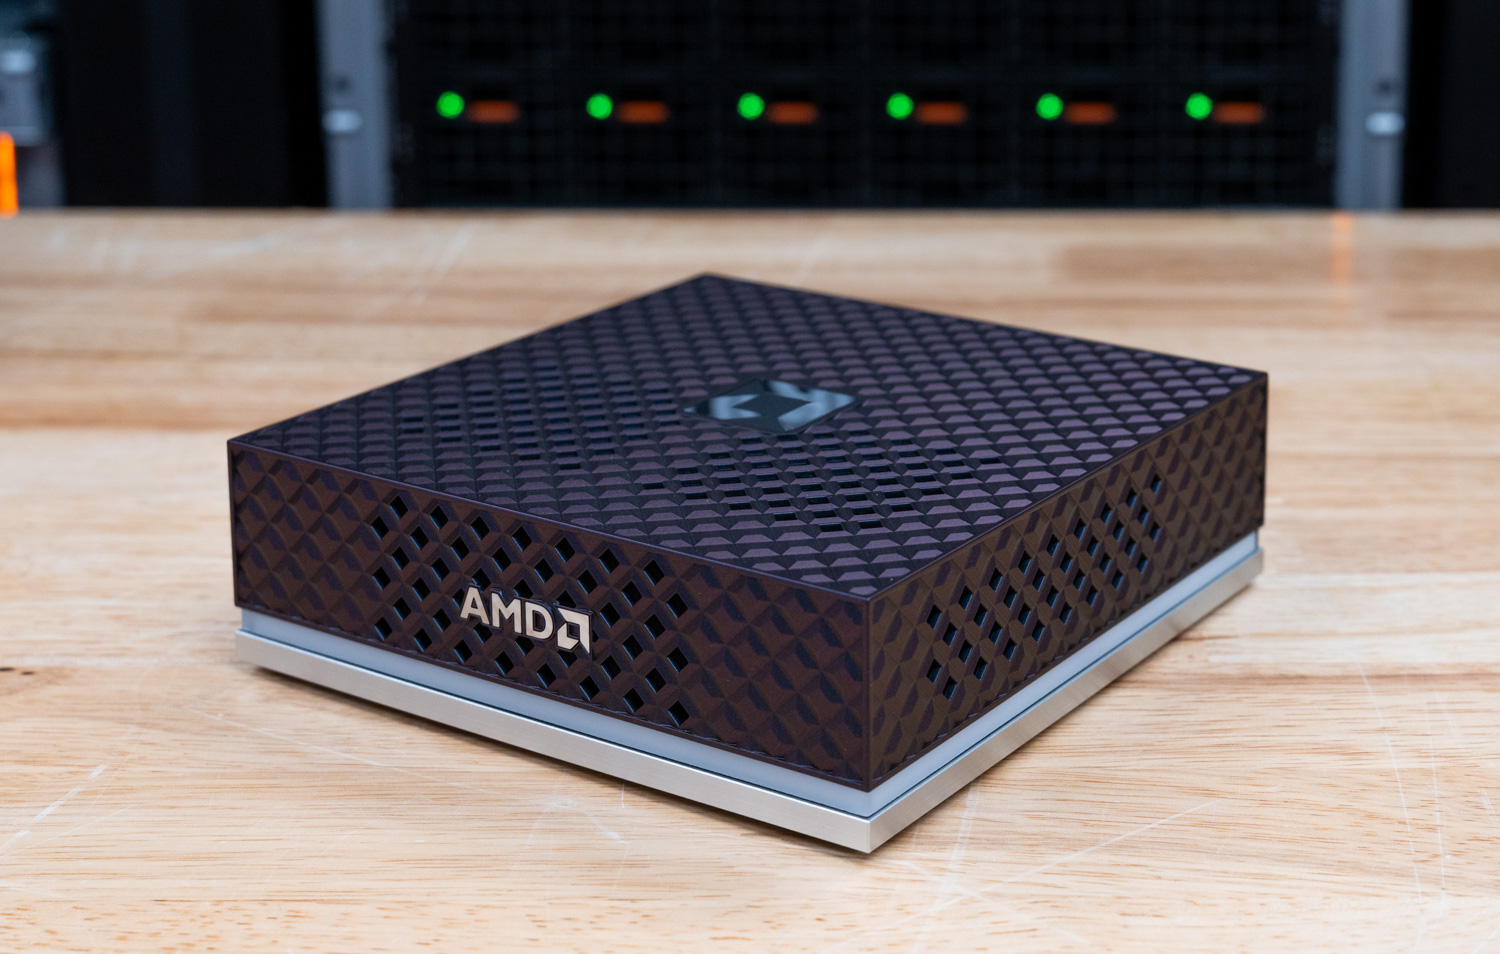
AMD 將 Halo 定位為其首款 AI 開發平台,旨在為開發者提供快速且便利的本地 AI 建置和運作途徑。其核心搭載 Ryzen AI Max+ 395 處理器,這是一款 16 核心 32 線程的「Zen 5」架構處理器,集成 Radeon 8060S 顯示卡(40 個 RDNA 3.5 計算單元)和一顆 50 TOPS 的 XDNA 2 NPU,AMD 宣稱該平台提供高達 OPS 的綜合吞吐量。 128GB 的 LPDDR5x 記憶體運作頻率為 8000 MT/s,提供 256 GB/s 的頻寬,整個平台透過一個 120W 的 USB-C 介面供電。 AMD 表示,該記憶體池足以容納高達 2,000 億個參數的模型。它是一個完整的 x86 迷你工作站,而這正是其最關鍵的差異。
差別就在於Windows系統。 Spark運作的是NVIDIA基於Linux的DGX作業系統,除此之外別無其他;而Halo在相同的硬體上可以啟動Windows 11或AMD的Linux開發者鏡像。原生Windows支援是我們從關注Spark的使用者那裡聽到的最普遍的需求,這也重新定義了這款產品的目標使用者群體。 AMD本身的定位也印證了這一點:Windows和Linux雙系統,而Spark目前只支援Linux(至少目前是如此)。
Halo 與 Spark 的差異還在於三個決策,每一項都針對我們先前收到的關於 Spark 的投訴。 Halo 採用的是標準的 M.2 2280 SSD,而非 Spark 使用的較不常見的 2242 固態硬碟,這為想要更換硬碟的使用者提供了更豐富的第三方選擇,包括 8TB 容量。 Halo 出廠時,可變顯存 (VGA) 已預設為在兩種作業系統下的最大分配量,因此無需手動調整即可載入大型模型。此外,Halo 的機殼周圍還環繞著一個帶有指示燈的狀態環,這彌補了部分用戶收到的 Spark 機型(具體情況取決於 OEM 廠商)的暗淡無光設計。 AMD 這種設計的成本體現在機箱背面,那裡沒有高速互連,只有 10GbE 接口,這限制了多節點叢集的功能。這些都是權衡取捨,也決定了這台機器在任何基準測試運行之前所針對的工作負載。
價格方面,細節至關重要。配備 2TB SSD 的 Halo 售價為 3,999 美元,與入門級 Spark 系統的市價基本持平。但具體價格取決於你指的是哪一款 Spark。 NVIDIA 自家的 DGX Spark 配備更大容量的硬碟,售價接近 4,700 美元,這與 LPDDR5X 和 NAND 快閃記憶體的供應緊張有關。華碩和其他廠商的入門級 Grace Blackwell 系統售價仍在 4,000 美元左右,目前在亞馬遜上仍有售(關聯連結)。與同類產品相比,Halo 的價格處於同級水平,其優勢在於上述因素,而非價格上的競爭優勢。
我們在 Windows 和 Linux 系統上使用 StorageReview 的本機 AI 套件對 Halo 進行了測試,並將測試結果與設計和軟體分析一起呈現在本評測中。
關鍵要點
- 雙作業系統的x86方案: Ryzen AI Halo 是 Spark 類別中唯一一款可以在完整的 x86 平台上啟動 Windows 11 或 Linux 的盒子,售價 3,999 美元,配備 2TB SSD,而 DGX Spark Founders Edition 的售價為 4,699 美元。
- 用於儲存大型模型的記憶體: 128GB LPDDR5x-8000 統一內存,速度為 256GB/s,支援本地高達 200 億個參數的模型,可變圖形內存經過預調校,因此大型模型無需手動配置即可加載。
- 我們測試過最強的 Ryzen AI Max+ 395: Halo 在幾乎所有 Windows 工作負載中都勝過了 HP Z2 Mini G1a 和 ZBook Ultra G1a,包括 Cinebench R23 多核心 37,316 分、7-Zip 184.2 GIPS,以及領先的 Procyon AI 文字產生 (Phi 1,192) 和影像產生 (SD 1.5 FP16 93 7)。
- CPU優勢,推理劣勢(相對於Spark): 在 Linux 系統上,Halo 在 CPU 性能方面完全勝過 DGX Spark,在 7-Zip 中壓縮速度快 11%,解壓縮速度快 38%,LLVM 編譯速度也快了 14%,但在大多數 vLLM 服務場景中,在高並發情況下,Halo 的性能落後於 DGX 20 到 20 117171717797137 70797179717971379713 年的預週期。工作中,效能差距甚至達到了 8.8 倍。
- 儲存功能尚可,網路效能一般: 標準的 M.2 2280 插槽允許後續升級到 8TB,但該平台的設計會將內建的 Gen5 Micron 4600 協商到 Gen4,而且由於沒有高速交換矩陣,單一 10GbE 連接埠無法實現 Spark 的 200G ConnectX-7 所支援的多節點叢集。
論文規範
| 規格 | AMD Ryzen AI Halo 系統 |
|---|---|
| 處理器 | |
| 中央處理器 | AMD Ryzen™ AI Max+ 395 處理器 16 核心/32 執行緒(Zen 5 架構) |
| GPU | AMD Radeon™ 8060S 整合式顯示卡 40 個計算單元(RDNA™ 3.5 架構) |
| NPU | AMD XDNA™ 2 NPU |
| 記憶體應用 | |
| 內存類型 | LPDDR5x |
| 內存容量 | 128GB |
| 記憶體速度 | 8000MT /秒 |
| 內存帶寬 | 256GB /秒 |
| 儲存 | |
| 儲存 | 2TB M.2 NVMe SSD (SED) |
| 網路與連接 | |
| 乙太網路 - ENET | 1 × 10GbE |
| Wi-Fi | Wi-Fi 7 |
| 藍牙 | 藍牙5.4 |
| 的I / O | |
| USB | 3 個 USB-C 接口,1 個 USB-C 接口(電源輸入) |
| 顯示輸出 | 1×HDMI 2.1b |
| 系統 | |
| TDP | 120W |
| 操作系統 | Linux 或 Windows 11 |
| 尺寸 | 150×150×45.4毫米(5.9×5.9×1.79英寸) |
| 重量 | 小於 1.2 公斤(2.65 磅) |
AMD Ryzen AI Halo 的建造與設計
AMD Ryzen AI Halo 系統採用類似 NVIDIA Spark 的緊湊型設計,尺寸僅 150 × 150 × 45.4 毫米,重量不到 1.2 公斤(2.65 磅)。鋁製機殼頂部和正面採用醒目的幾何通風圖案,不僅賦予系統獨特的外觀,還能最大限度地提高散熱系統的氣流效率。儘管體積小巧,但該平台被設計成功能齊全的桌面 AI 工作站,能夠處理工作站應用程式、本地 LLM 推理和 AI 開發工作負載。
前
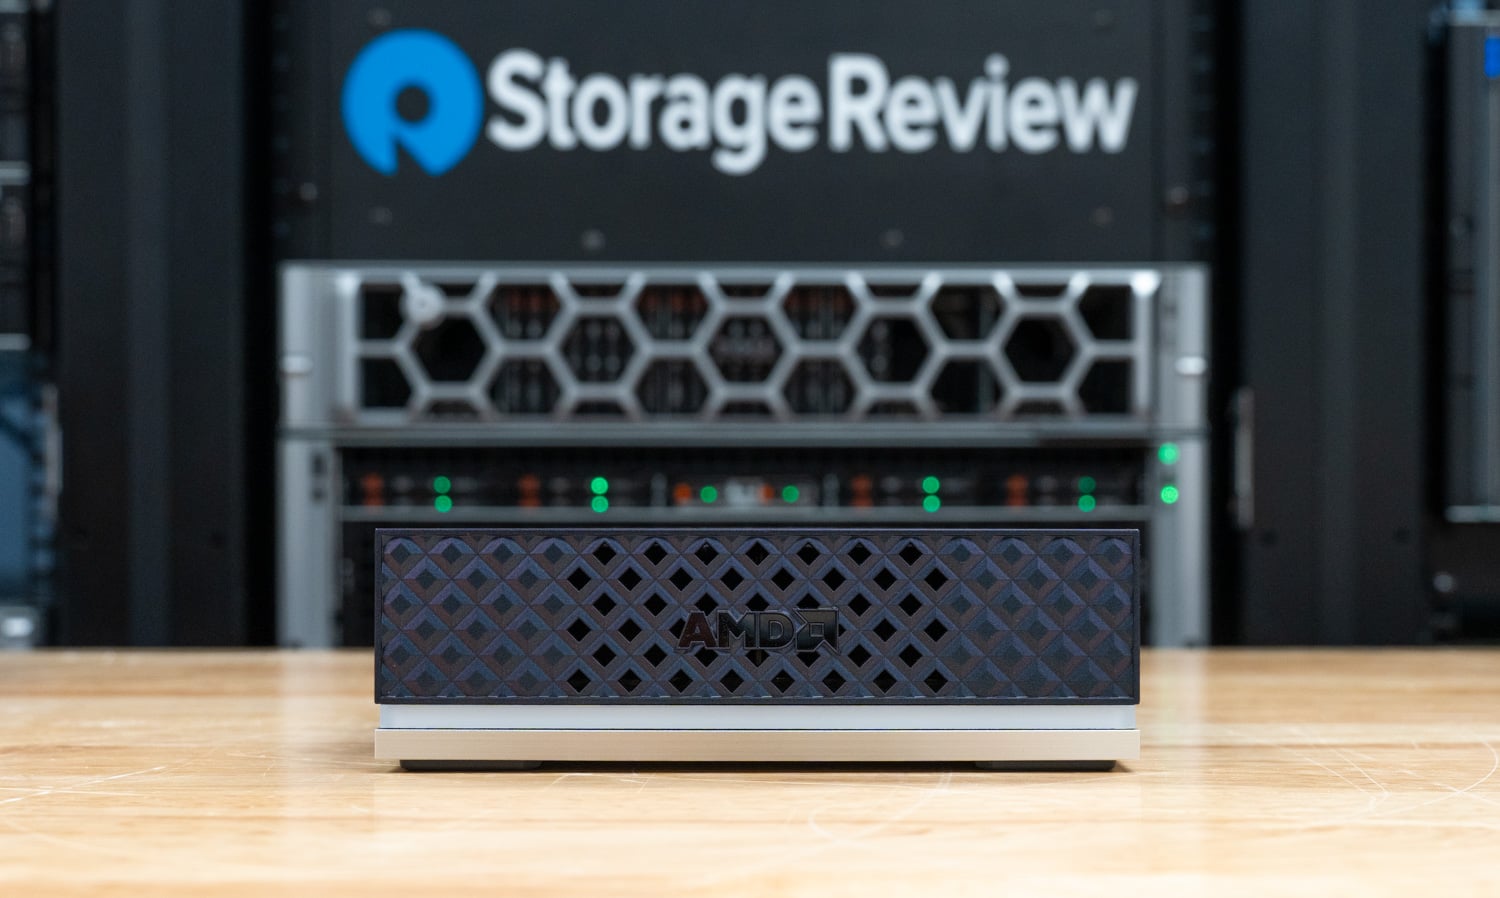
系統正面設計簡潔,幾乎完全由一塊橫跨機殼寬度的網狀通風格柵構成。 AMD並沒有在正面設置接口,而是將這部分空間用於氣流流通,讓冷空氣通過大面積的網狀進氣口進入系統,同時保持正面的整潔。機殼底部的銀色裝飾條與霧面黑色的外殼形成微妙的視覺對比。
後端I / O
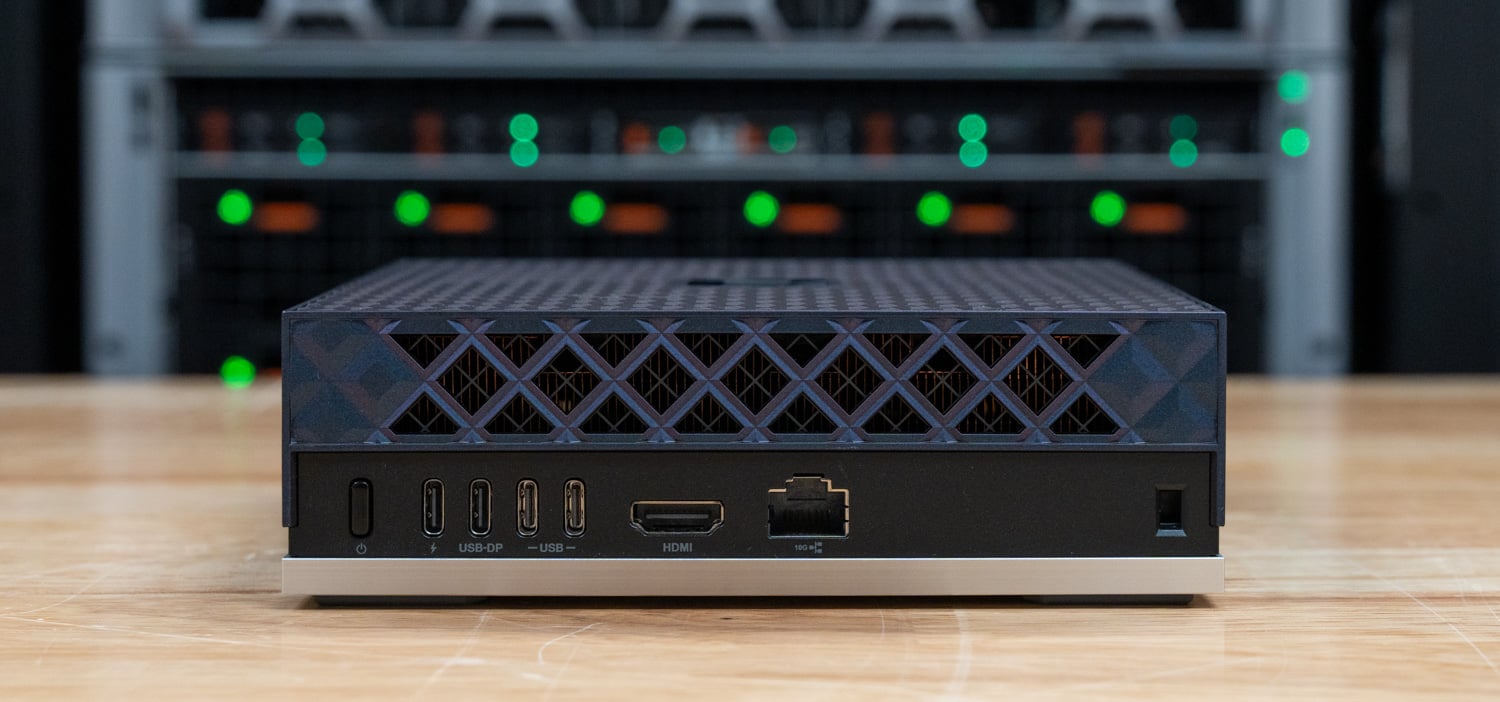
所有外部介面均位於系統後方。從左到右,後面板包括以下部件:
- USB-C電源輸入
- 支援 DisplayPort Alt Mode 的 USB-C 連接埠
- 兩個額外的 USB-C 端口
- HDMI 2.1b 輸出
- 10GbE RJ45 以太網
- Kensington 安全鎖槽
該系統提供三個 USB-C 資料連接埠和一個專用的 USB-C 電源接口,可同時連接多個高速週邊和顯示器。 HDMI 2.1b 提供原生顯示輸出,而整合的 10GbE 乙太網路介面使該平台非常適合高速 NAS 連接、AI 資料集傳輸和本地開發環境。
內部設計
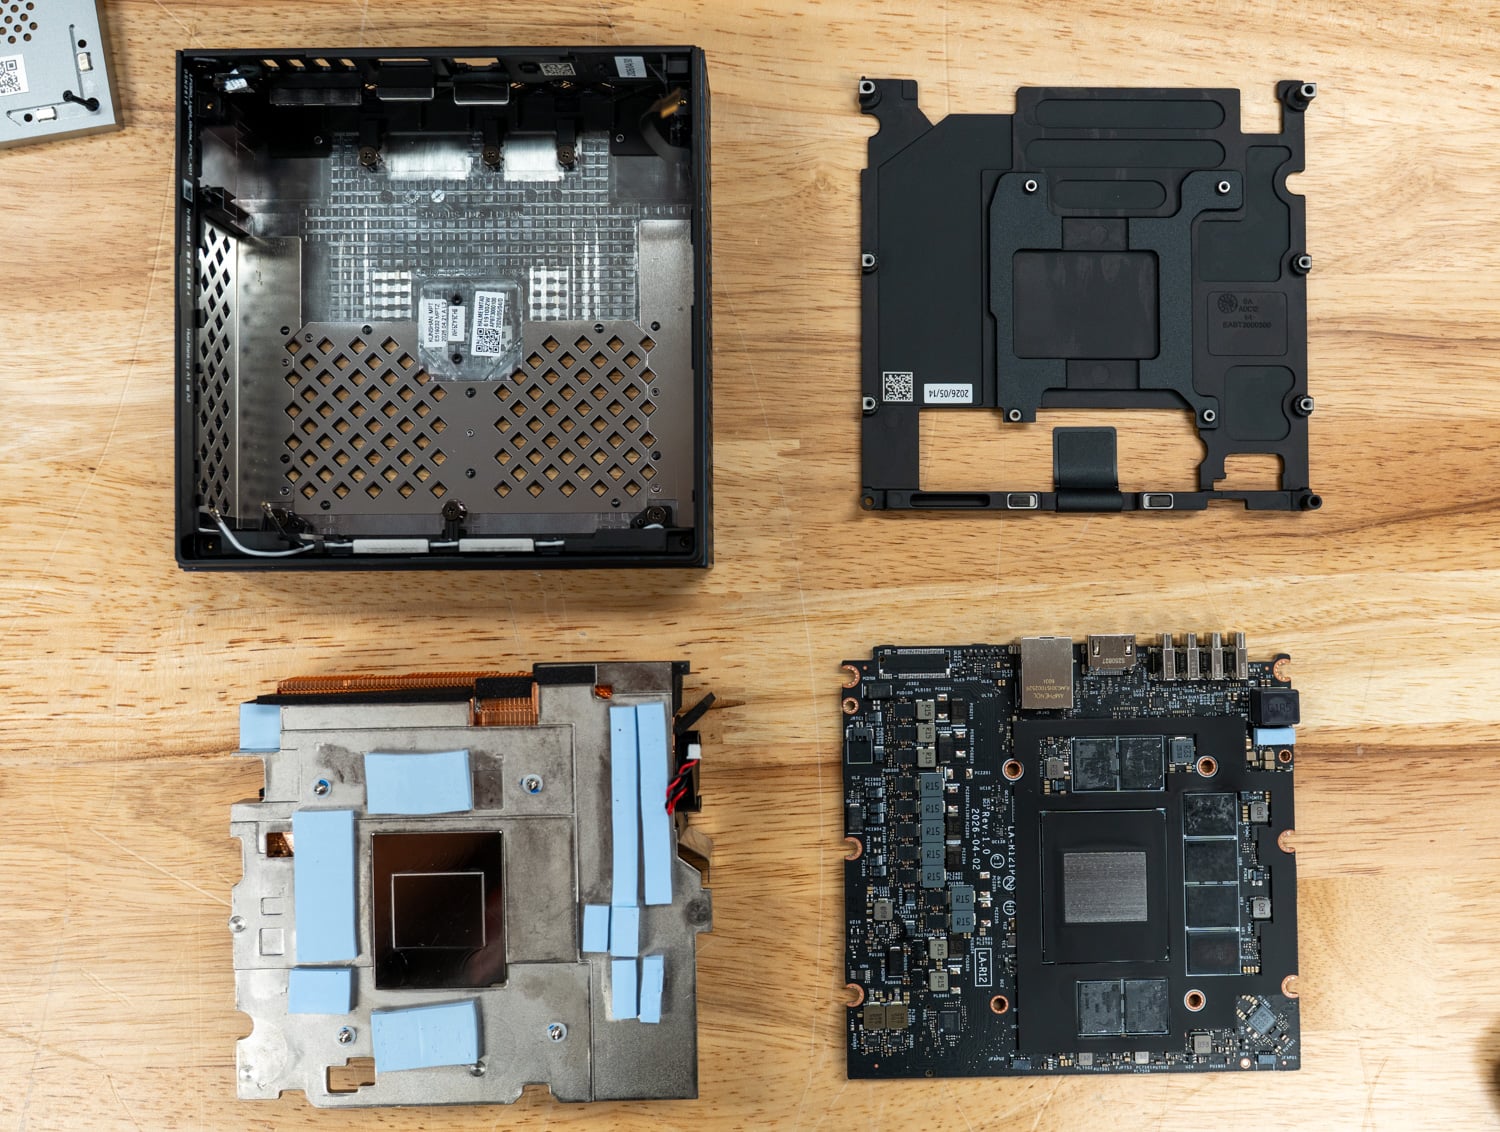
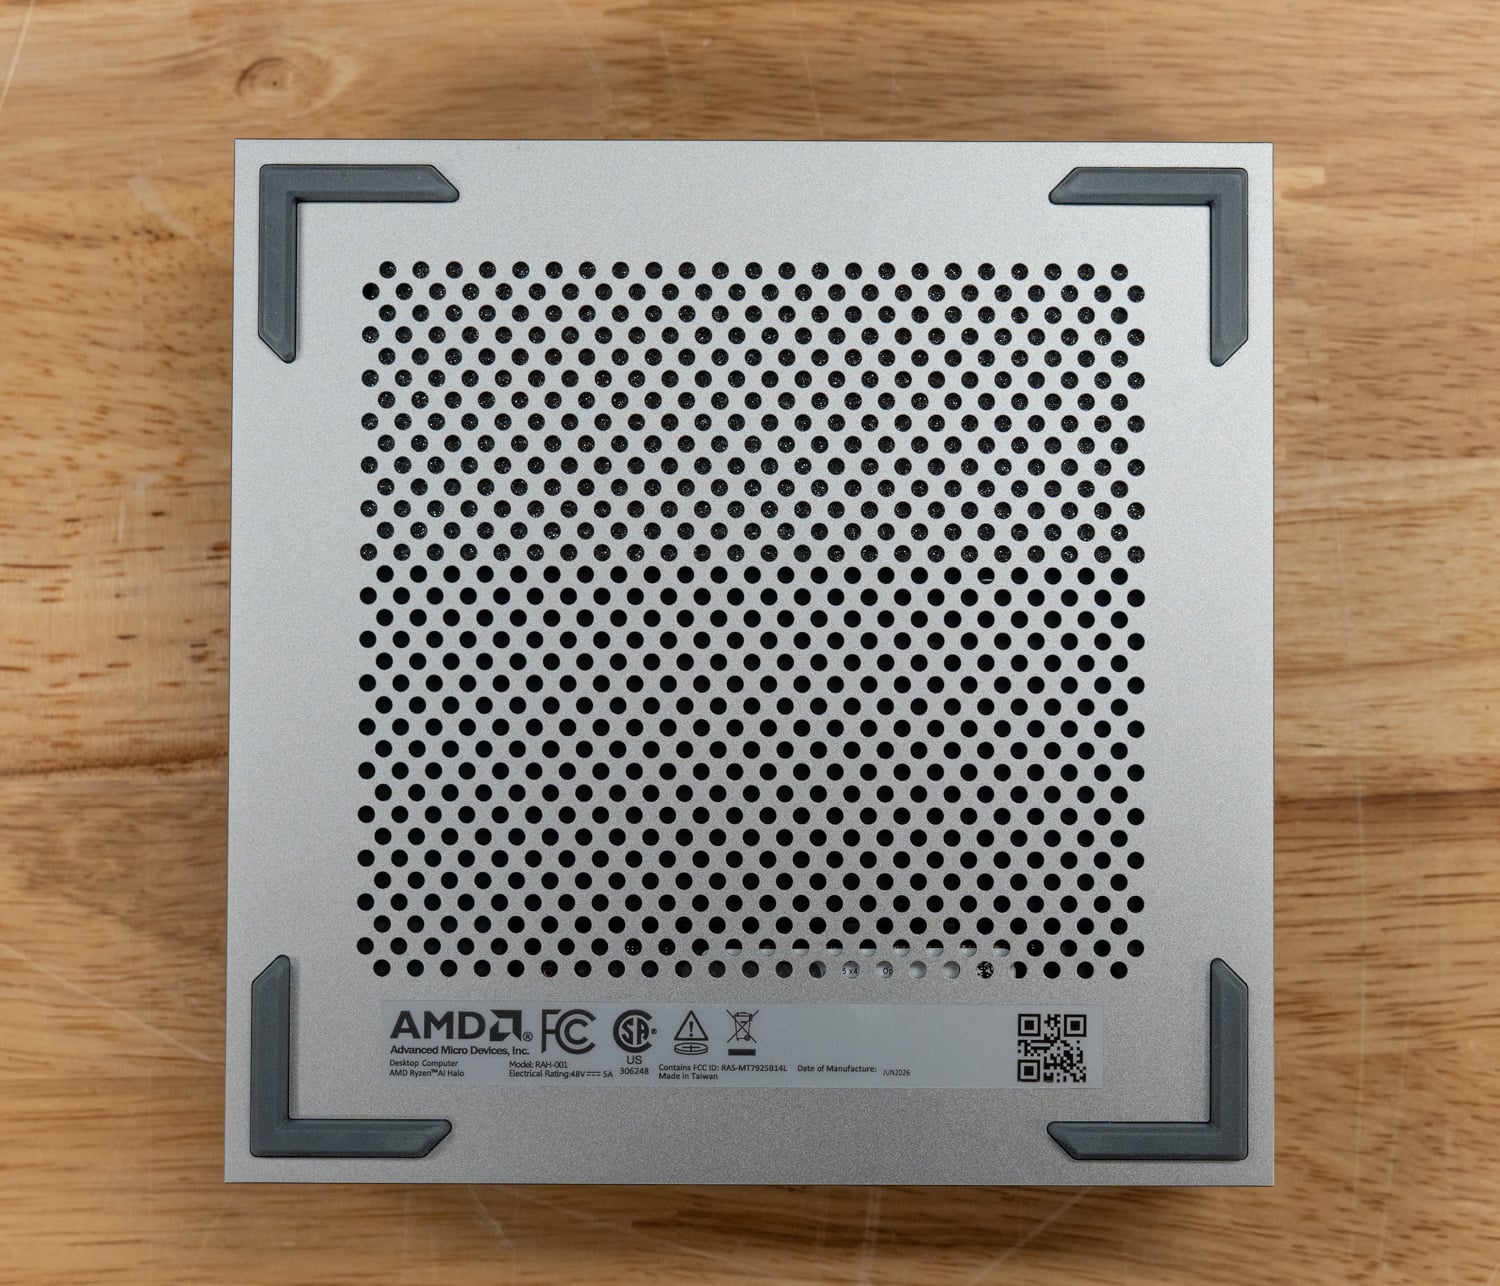
Ryzen AI Halo 的底部有一個大的穿孔通風口,可以吸入空氣來冷卻安裝在主機板底部的組件,四個角落上的橡膠腳墊使設備在桌子或架子上保持穩定。
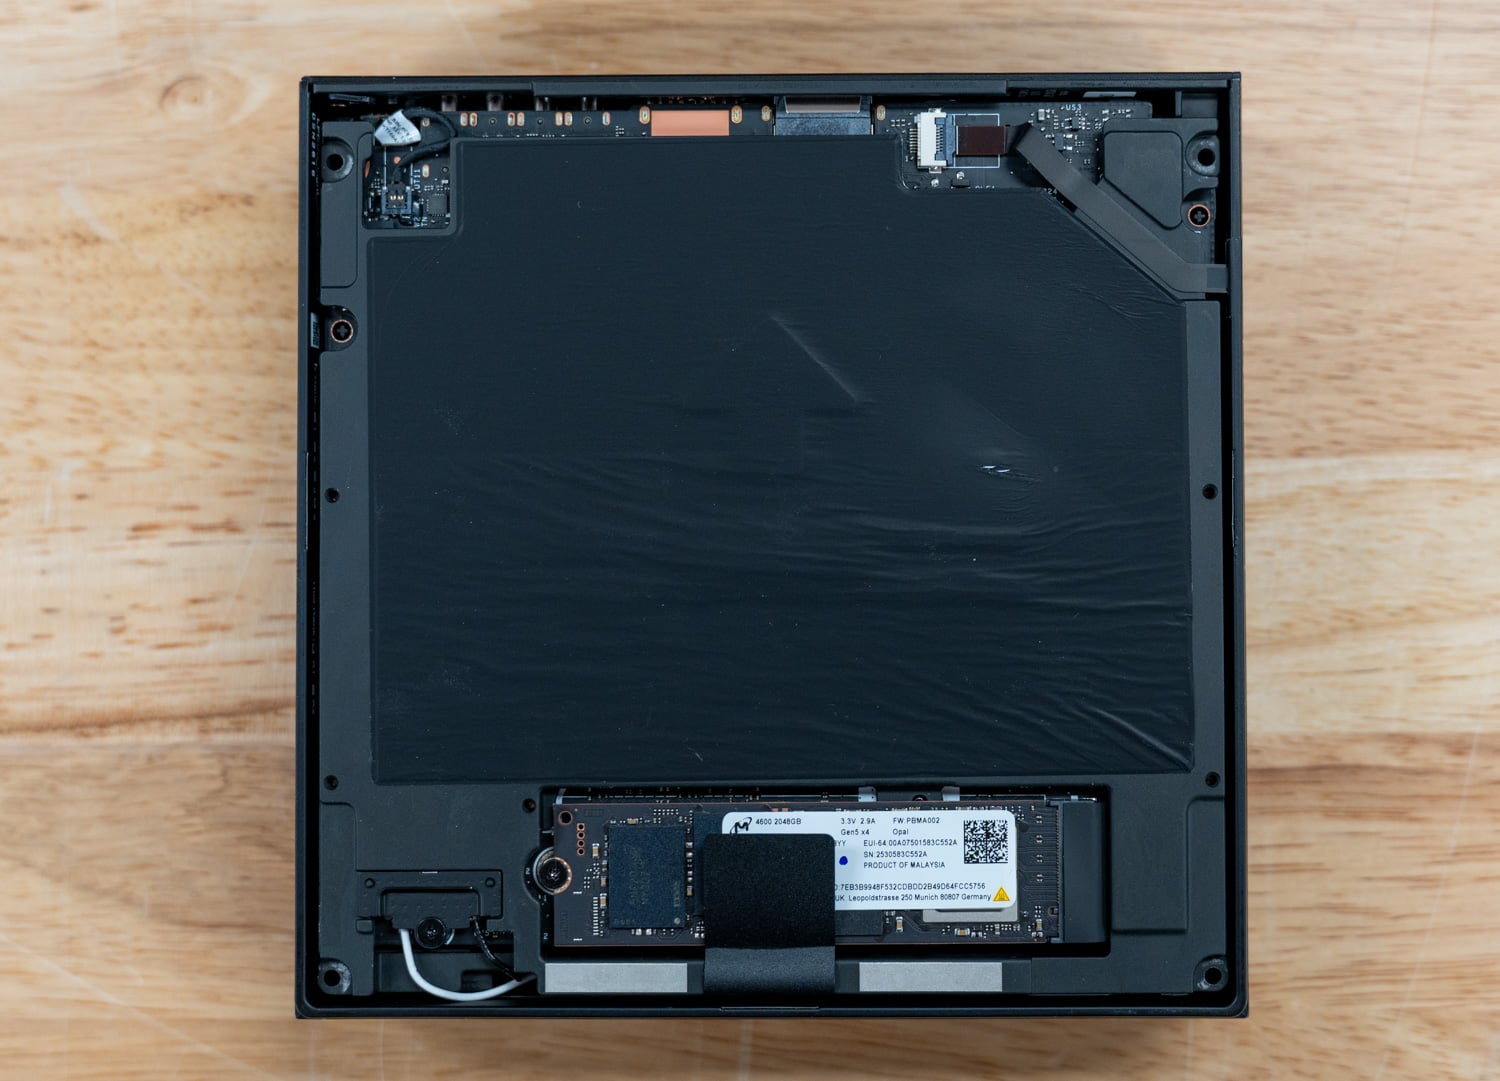
旋下固定底蓋的四顆螺絲,即可看到 M.2 SSD 插槽和一些系統下部主機板組件,包括 Wi-Fi 網卡介面。在我們評測的這台機器中,該插槽安裝了一塊 Micron 4600 2TB Gen5 x4 SSD,而黑色膠貼則將主機板的其他部分與裸露的底面隔開。
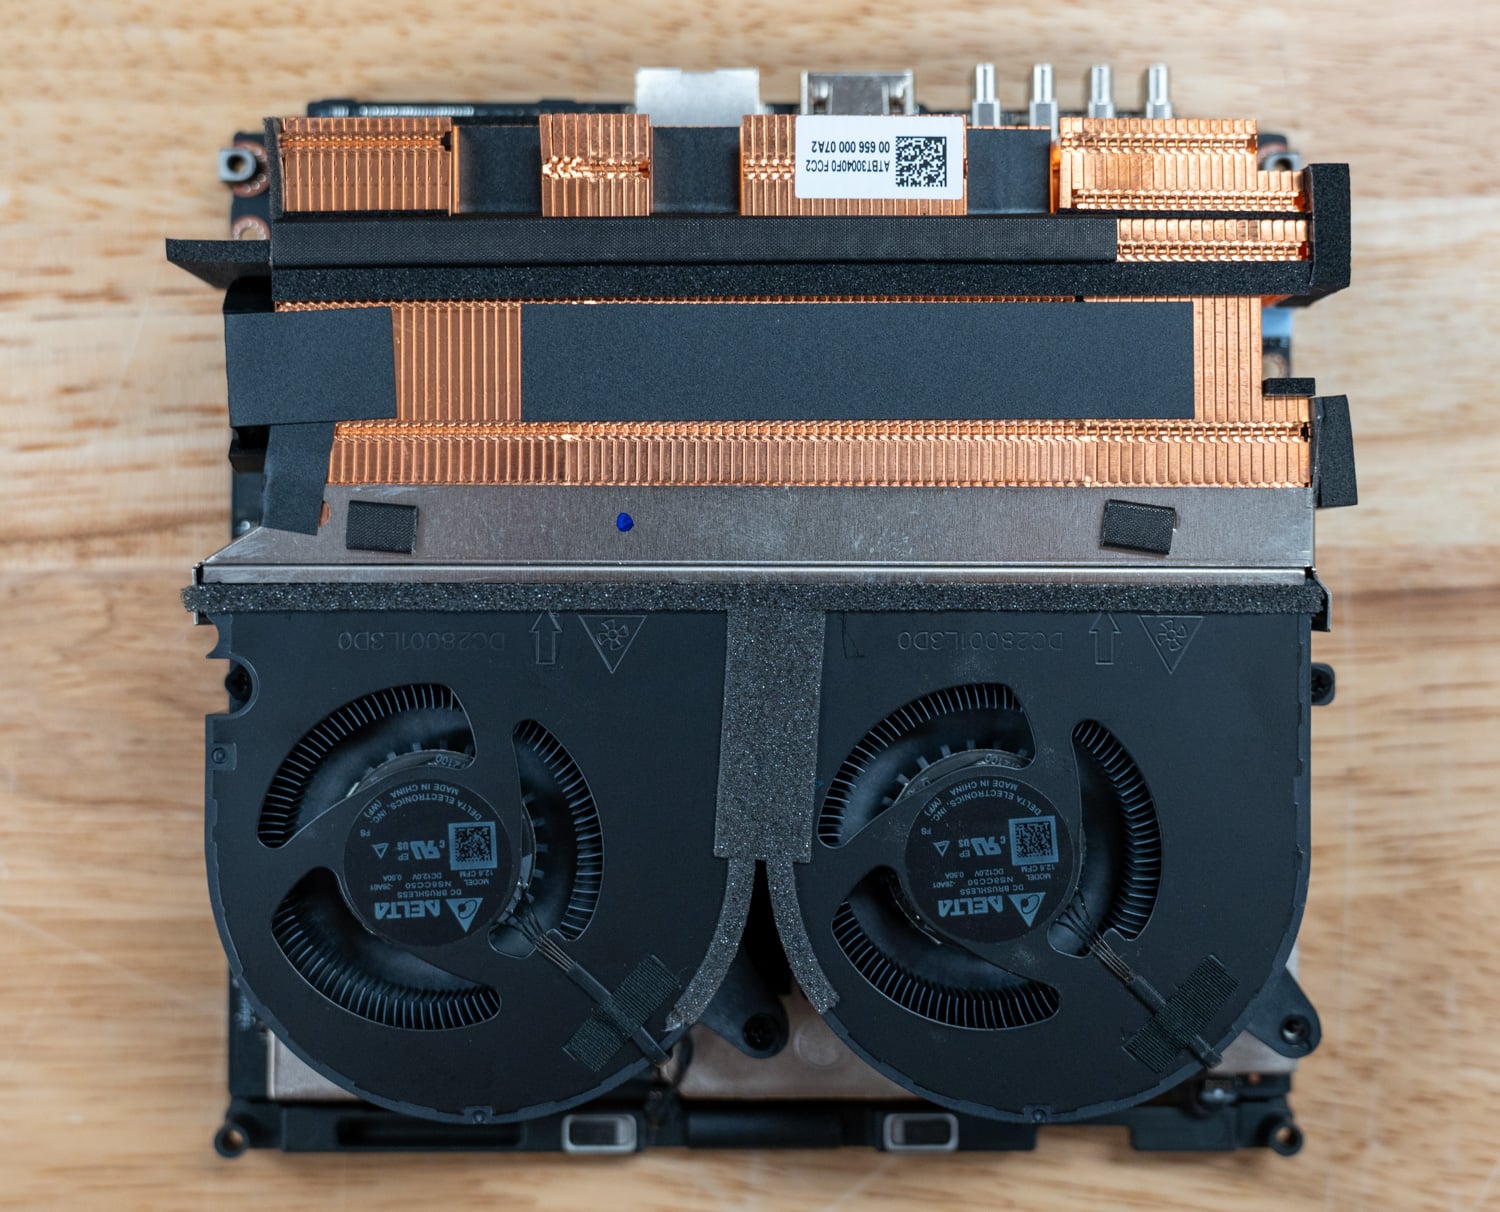
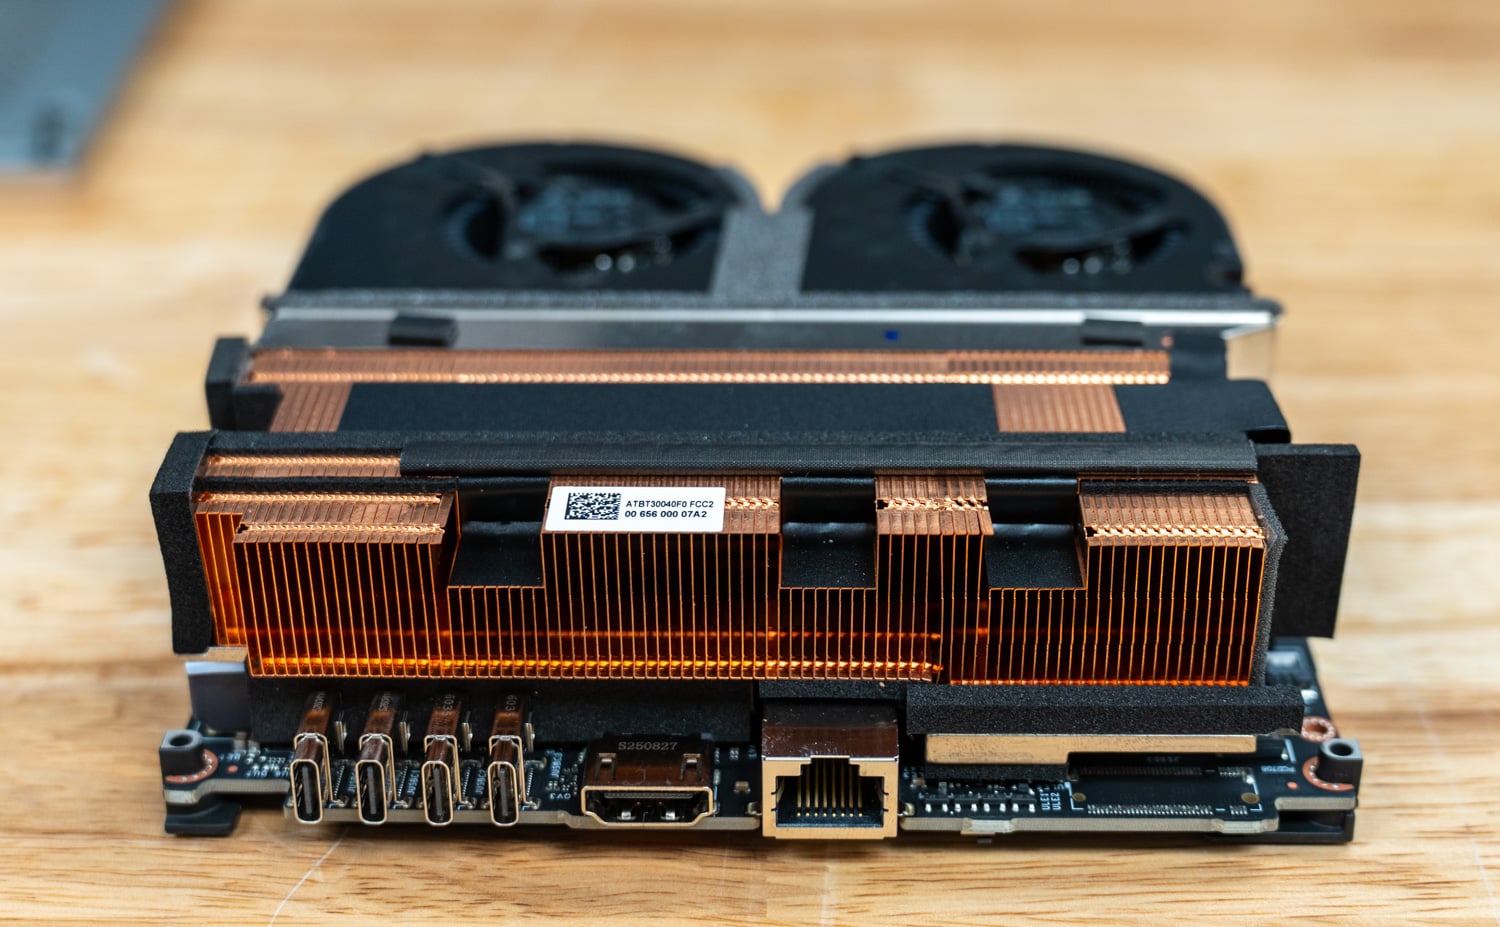
在散熱方面,AMD 採用了與 NVIDIA DGX Spark 類似的方法,使用雙風扇將空氣吸入散熱片,然後從機殼後部排出。
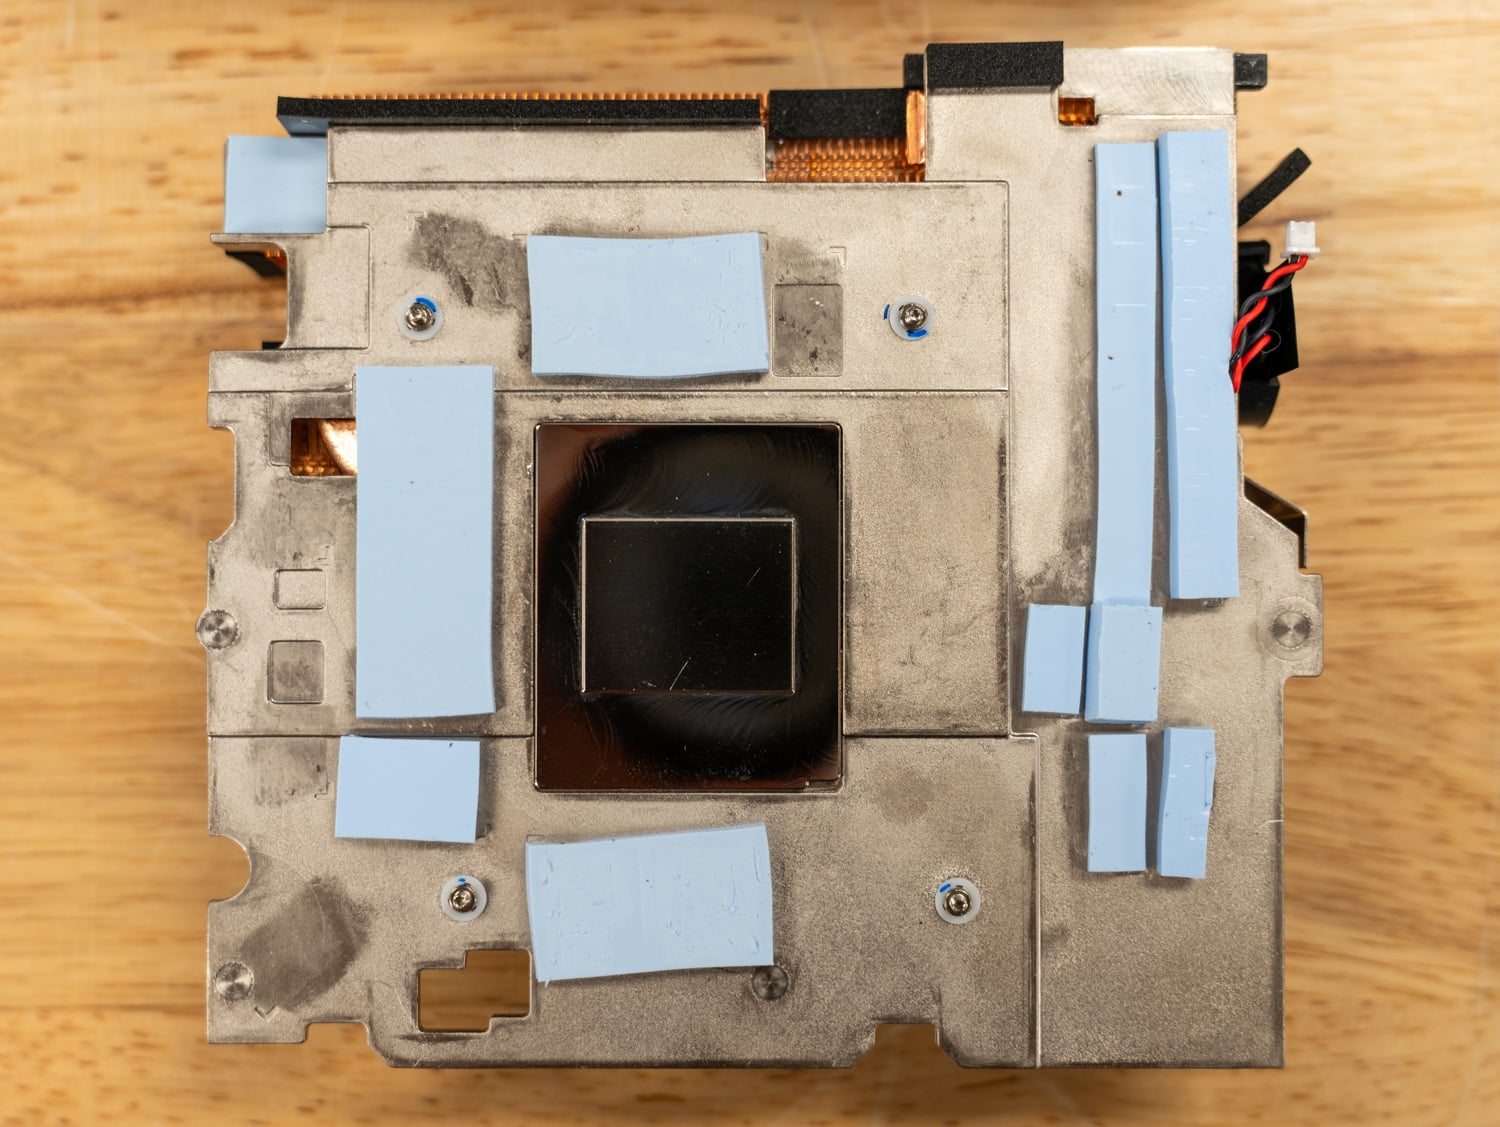
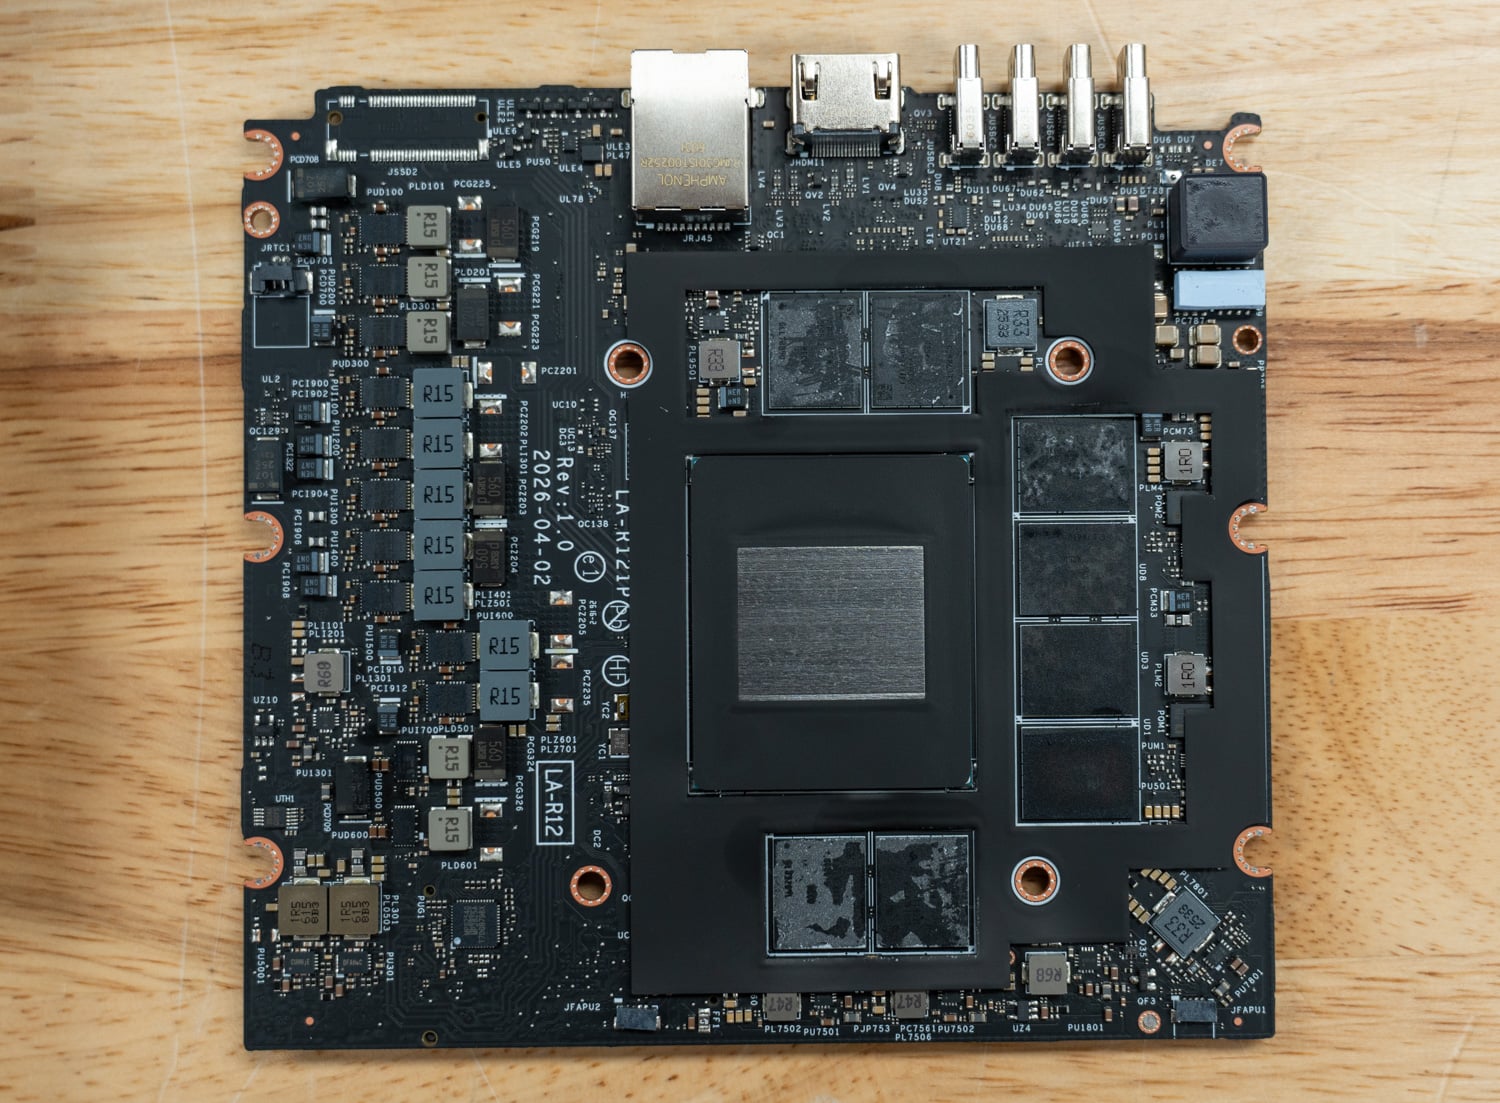
拆下散熱組件後,主機板便映入眼簾,中央為APU核心,兩側為記憶體封裝,左側邊緣則是VRM電路。核心上可見的銀色方塊並非液態金屬或膏狀導熱材料,而是AMD在核心與散熱器之間塗覆的固體導熱墊或塗層的殘留物。這解釋了它為何呈現均勻乾燥的外觀,而非膏狀或液態金屬通常留下的濕漉漉的痕跡。
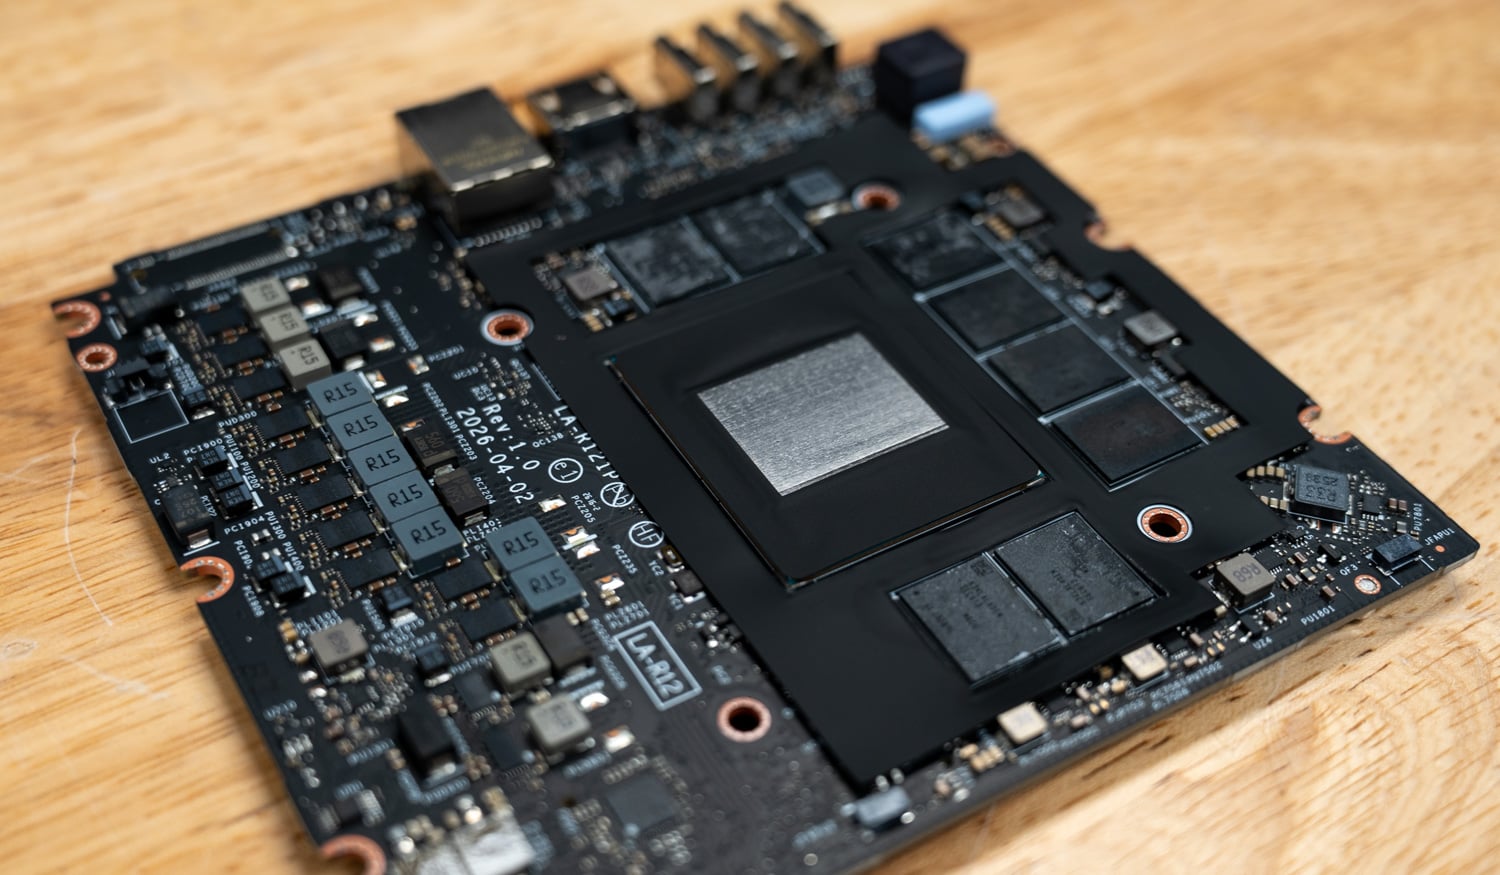
翻轉散熱器即可看到其冷板的底部,那裡有一塊鏡面拋光區域與晶片直接接觸。同時,周圍的記憶體和供電區域都預先貼有厚度不一的導熱墊。
AMD Ryzen AI Halo 效能測試
我們對 AMD Ryzen AI Halo 平台在 Windows 和 Linux 系統上的效能進行了評估,以檢視其在工作站應用程式和 AI 相關工作負載中的效能。在 Windows 測試中,我們將 AMD Ryzen AI Halo 系統與兩款搭載 Ryzen AI Max+ PRO 395 處理器的商用系統進行了比較:一款是緊湊型桌上型工作站 HP Z2 Mini G1a,另一款是行動工作站 HP ZBook Ultra G1a 14 吋。由於這三款系統採用相同的底層處理器架構和 Radeon 8060S 整合式顯示卡,因此這些比較突顯了 Halo 平台在不同散熱環境和系統設計下的效能表現。
在 Linux 測試中,我們轉向了 AI 開發和儲存工作負載,將 Ryzen AI Halo 系統與 NVIDIA DGX Spark 進行了比較。這些測試著重於 FIO 儲存基準測試和 vLLM 推理性能,比較了 AMD 基於 Ryzen AI Halo 的開發者平台與 NVIDIA 專為本地大型語言模型推理而構建的 AI 開發系統。
測試單元
UL Procyon:人工智慧電腦視覺
Procyon AI 電腦視覺基準測試能夠深入剖析 AI 推理引擎在專業級的表現表現。它整合了多家廠商的引擎,所提供的性能評分能夠準確反映設備的實際能力。此基準測試透過比較不同硬體類型(包括 CPU、GPU 和 NPU)的 AI 加速效能,評估最先進的神經網路模型,使用戶能夠評估其在各種工作負載和條件下的相對效率。
為了反映真實世界的AI工作負載,該基準測試使用了六種不同的神經網路模型,每種模型都因其與現代電腦視覺任務的相關性而被選中。 MobileNet V3 是一款緊湊的、專注於行動裝置的模型,專為影像中的主體識別而設計;而 Inception V4 則以更深、更複雜的架構執行相同的任務。
YOLO V3(You Only Look Once)專注於透過估計目標機率進行即時目標偵測。基於 MobileNet V2 建構的 DeepLab V3 則著重於語意影像分割和像素聚類。 Real-ESRGAN 是計算量最大的測試模型,它將影像從 250×250 解析度放大到 1,000×1,000 解析度。最後,ResNet 50 是一種穩健的分類模型,能夠更有效地訓練深度神經網路。
Ryzen AI Halo平台在CPU和GPU工作負載下均展現出強勁的AI推理效能。在CPU測試中,其總分為216分,略低於HP Z2 Mini的227分,並輕鬆超越HP ZBook Ultra的186分。 GPU推理表現更為出色,Halo系統以553分的總分位居榜首,領先ZBook Ultra(528分)和Z2 Mini(528分)。此外,它還創下了最快MobileNet V3推理速度,僅需0.38毫秒,並在185.08毫秒內完成了高要求的REAL-ESRGAN工作負載測試,而Z2 Mini和ZBook Ultra的測試時間分別為211.76毫秒和200.40毫秒。
| UL Procyon:AI 電腦視覺推理(越低越好) | AMD Ryzen AI Halo(Ryzen AI Max+ 395 | Radeon 8060S) | HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU 時間 | |||
| AI計算機視覺整體評分(越高越好) | 216 | 227 | 186 |
| 移動網V3 | 0.73毫秒 | 0.75毫秒 | 1.09毫秒 |
| 殘差網絡 50 | 6.02毫秒 | 5.99毫秒 | 6.84毫秒 |
| 盜夢空間V4 | 17.18毫秒 | 17.12毫秒 | 19.80毫秒 |
| 深實驗室V3 | 29.21毫秒 | 21.20毫秒 | 28.27毫秒 |
| 優洛V3 | 35.60毫秒 | 36.58毫秒 | 41.64毫秒 |
| 真愛斯甘 | 1,931.13毫秒 | 1,892.10毫秒 | 2,138.97毫秒 |
| GPU時代 | |||
| AI計算機視覺整體評分(越高越好) | 553 | 528 | 583 |
| 移動網V3 | 0.38毫秒 | 0.42毫秒 | 0.46毫秒 |
| 殘差網絡 50 | 4.04毫秒 | 3.85毫秒 | 3.27毫秒 |
| 盜夢空間V4 | 13.26毫秒 | 15.15毫秒 | 11.62毫秒 |
| 深實驗室V3 | 12.72毫秒 | 10.98毫秒 | 10.72毫秒 |
| 優洛V3 | 11.17毫秒 | 12.64毫秒 | 10.57毫秒 |
| 真愛斯甘 | 185.08毫秒 | 211.76毫秒 | 200.40毫秒 |
UL Procyon:人工智慧文字生成
Procyon AI 文字產生基準測試透過提供簡潔一致的評估方法,簡化了 AI LLM 效能測試。它支援對多個 LLM 模型進行重複測試,同時最大限度地降低了大型模型規模和可變因素帶來的複雜性。此基準測試由 Procyon 與 AI 硬體領域的領導企業合作開發,優化了本地 AI 加速器的使用,從而實現更可靠、更有效率的效能評估。以下結果使用 TensorRT 進行測量。
在Procyon AI文本生成測試中,Ryzen AI Halo參考平台在所有測試的語言模型中表現最佳。其Phi總分高達1,192分,遠超HP Z2 Mini的965分和HP ZBook Ultra的922分。 Mistral也表現出色,得分998分,領先850分和829分。 Llama3的得分為847分,也優於其他兩款得分分別為766分和756分的競爭系統。 Halo平台也縮短了所有型號的首令牌產生時間,只需0.996秒即可產生第一個Phi令牌,延遲幾乎是HP系統的一半。雖然Z2 Mini在令牌生成吞吐量方面略勝一籌,但Halo平台顯著更低的啟動延遲使其獲得了最佳的整體基準測試成績。
| UL Procyon:人工智慧文字生成 | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Phi 總分 | 1,192 | 965 | 922 |
| Phi 輸出到第一個代幣的時間 | 0.996秒 | 1.898秒 | 1.956秒 |
| Phi 每秒輸出令牌 | 55.271 令牌/秒 | 68.967 令牌/秒 | 64.986 令牌/秒 |
| Phi 總持續時間 | 56.237秒 | 52.666秒 | 55.501秒 |
| 米斯特拉爾總分 | 998 | 850 | 829 |
| 米斯特拉爾輸出第一個令牌的時間 | 1.603秒 | 2.734秒 | 2.783秒 |
| 米斯特拉爾每秒輸出令牌 | 35.027 令牌/秒 | 43.358 令牌/秒 | 41.992 令牌/秒 |
| 米斯特拉爾總持續時間 | 88.582秒 | 81.716秒 | 84.065秒 |
| Llama3 總分 | 847 | 766 | 756 |
| Llama3 輸出第一個令牌的時間 | 1.963秒 | 2.545秒 | 2.578秒 |
| Llama3 每秒輸出令牌 | 34.630 令牌/秒 | 36.752 令牌/秒 | 36.243 令牌/秒 |
| Llama3 整體持續時間 | 92.026秒 | 91.987秒 | 93.200秒 |
| Llama2 總分 | 不適用 | 936 | 929 |
| Llama2 輸出第一個令牌的時間 | 不適用秒 | 3.813秒 | 3.860秒 |
| Llama2 每秒輸出令牌 | N/A 代幣/秒 | 24.685 令牌/秒 | 24.619 令牌/秒 |
| Llama2 整體持續時間 | 不適用秒 | 136.077秒 | 136.720秒 |
UL Procyon: 人工智能圖像生成
Procyon AI 影像產生基準測試提供了一種一致且準確的方法,用於衡量從低功耗 NPU 到高階 GPU 等各種硬體的 AI 推理效能。它包含三個測試:針對高階 GPU 的 Stable Diffusion XL (FP16)、針對中等效能 GPU 的 Stable Diffusion 1.5 (FP16) 以及針對低功耗裝置的 Stable Diffusion 1.5 (INT8)。此基準測試會針對每個系統使用最佳推理引擎,確保結果的公平性和可比較性。
影像生成被證明是 Ryzen AI Halo 最強的工作負載之一。在 Stable Diffusion 1.5 FP16 測試中,Halo 平台獲得了 937 分的總分,而 Z2 Mini 和 ZBook Ultra 的得分分別為 725 分和 648 分;同時,Halo 的圖像生成時間也縮短至 106.7 秒,而 Z2 Mini 和 ZBook 18 秒的圖像生成時間也縮短為 106.7 秒,而 Z2 Mini 和 ZBook。 Stable Diffusion XL 測試同樣展現了強大的優勢,Halo 系統僅用時 878.5 秒就完成了測試,比 Z2 Mini 快了約 174 秒,比 ZBook Ultra 快了超過 450 秒。此外,該平台還以 9,158 分的總分完成了 Stable Diffusion 1.5 INT8 基準測試,而 HP 的兩款對比系統均未提供此測試。
| UL Procyon:人工智慧影像生成 | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 穩定擴散 1.5 (FP16) – 總分 | 937 | 725 | 648 |
| 穩定擴散 1.5 (FP16) – 總時間 | 106.7秒 | 137.815秒 | 154.203秒 |
| 穩定擴散 1.5 (FP16) – 影像產生速度 | 6.670 秒/影像 | 8.613 秒/影像 | 9.638 秒/影像 |
| 穩定擴散 1.5 (INT8) – 總分 | 9,158 | 不適用 | 不適用 |
| 穩定擴散 1.5 (INT8) – 總時間 | 27.298秒 | 不適用 | 不適用 |
| 穩定擴散 1.5 (INT8) – 影像生成速度 | 3.412 秒/影像 | 不適用 | 不適用 |
| 穩定擴散 XL (FP16) – 總分 | 682 | 570 | 451 |
| 穩定擴散 XL (FP16) – 總時間 | 878.493秒 | 1,052.468秒 | 1,329.592秒 |
| 穩定擴散 XL (FP16) – 影像產生速度 | 54.906 秒/影像 | 65.779 秒/影像 | 83.100 秒/影像 |
規格工作站 4
SPECworkstation 4.0 基準測試是一款綜合性工具,用於評估工作站效能的所有關鍵方面。它提供 CPU、圖形、加速器和磁碟效能的實際測量數據,為專業人士提供所需的數據,以便他們做出明智的硬體投資決策。此基準測試包含一套專門針對 AI 和 ML 工作負載的測試,例如資料科學任務和基於 ONNX 執行時間的推理測試,這反映了 AI/ML 在工作站環境中日益增長的重要性。它涵蓋七個行業垂直領域和四個硬體子系統,能夠提供對當今工作站性能的詳細且相關的衡量標準。
SPECworkstation 4 測試凸顯了 Ryzen AI Halo 平台平衡的工作站效能。它在金融服務 (2.92)、媒體與娛樂 (2.97)、產品設計 (2.22) 以及生產力與開發 (1.27) 四個類別中均取得了最高分,超越了 HP Z2 Mini 和 HP ZBook Ultra。 Z2 Mini 在能源 (2.50 對 2.35) 和生命科學 (2.60 對 2.33) 兩個類別中略佔優勢。總體而言,Halo 參考平台在基準測試的專業工作負載中表現出色,並在所有測試類別中都保持了競爭力。
| SPECworkstation 4.0.0(越高越好) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S)
|
HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 能源 | 2.35 | 2.50 | 2.20 |
| 金融服務 | 2.92 | 2.35 | 1.60 |
| 生命科學 | 2.33 | 2.60 | 2.20 |
| 媒體與娛樂 | 2.97 | 2.22 | 1.90 |
| 產品設計 | 2.22 | 2.00 | 1.74 |
| 生產力與發展 | 1.27 | 1.00 | 1.03 |
樂士馬克
Luxmark 是一款 GPU 基準測試軟體,它使用開源光線追蹤渲染器 LuxRender 來評估系統在處理高精度 3D 場景時的效能。此基準測試軟體可用於評估伺服器和工作站的圖形渲染能力,尤其適用於視覺特效和建築視覺化應用,因為在這些應用中,精確的光照模擬至關重要。
Luxmark 的測試結果顯示,三款搭載 Ryzen AI Max+ 395 處理器的平台之間的效能差異微乎其微。 Halo 參考系統在 Food 測試中取得了最高的 4,158 分,略高於 Z2 Mini (3,943) 和 ZBook Ultra (3,915)。在 Hallbench 工作負載測試中,其得分為 8,014,略低於 Z2 Mini 的 8,477 分,但高於 ZBook Ultra 的 7,833 分。總體而言,測試結果表明,無論採用何種外形尺寸,搭載 Radeon 8060S 顯示卡的系統都能提供非常相似的光線追蹤效能。
| Luxmark(越高越好) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 大廳長凳 | 8,014 | 8,477 | 7,833 |
| 食品 | 4,158 | 3,943 | 3,915 |
7-Zip 壓縮
7-Zip 壓縮基準測試評估 CPU 在壓縮和解壓縮過程中的效能,以 GIPS(每秒千兆指令數)和 CPU 使用率來衡量效能。更高的 GIPS 和更有效率的 CPU 使用率顯示效能更優。
在 7-Zip 基準測試中,Ryzen AI Halo 平台在所有主要類別中均名列前茅。其壓縮率高達 176.7 GIPS,遠超 HP Z2 Mini 的 139.3 GIPS 和 ZBook Ultra 的 139.6 GIPS。解壓縮性能同樣強勁,達到 191.6 GIPS,超過了 Z2 Mini 的 164.0 GIPS 和 ZBook Ultra 的 174.0 GIPS。綜合來看,Halo 平台取得了 184.2 GIPS 的最高綜合評分,比競爭對手高出約 20%,在歸檔創建和提取工作負載方面展現了卓越的整數吞吐量。
| 7-Zip 壓縮基準(越高越好) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) | |||
|---|---|---|---|---|---|---|
| 壓縮 | ||||||
| 當前 CPU 使用率 | ||||||
| 電流額定值/使用 | 6.370 吉普斯 | 5.136 吉普斯 | 4.883 吉普斯 | |||
| 額定電流 | 174.589 吉普斯 | 140.405 吉普斯 | 140.061 吉普斯 | |||
| 產生的 CPU 使用率 | ||||||
| 結果評級/使用 | 6.424 吉普斯 | 5.126 吉普斯 | 4.890 吉普斯 | |||
| 結果評級 | 176.742 吉普斯 | 139.298 吉普斯 | 139.617 吉普斯 | |||
| 解壓縮 | ||||||
| 當前 CPU 使用率 | ||||||
| 電流額定值/使用 | 7.670 吉普斯 | 6.805 吉普斯 | 6.029 吉普斯 | |||
| 額定電流 | 196.986 吉普斯 | 159.451 吉普斯 | 175.104 吉普斯 | |||
| 產生的 CPU 使用率 | ||||||
| 結果評級/使用 | 7.766 吉普斯 | 6.793 吉普斯 | 6.028 吉普斯 | |||
| 結果評級 | 191.645 吉普斯 | 163.969 吉普斯 | 174.046 吉普斯 | |||
| 總評分 | ||||||
| 總 CPU 使用率 | ||||||
| 總評分/使用情況 | 7.095 吉普斯 | 5.959 吉普斯 | 5.459 吉普斯 | |||
| 總評分 | 184.194 吉普斯 | 151.634 吉普斯 | 156.832 吉普斯 | |||
攪拌機基準
Blender 是一款開源的 3D 建模應用程式。此基準測試使用 Blender Benchmark 工具運行。得分以每分鐘採樣數衡量,數值越高表示表現越好。
CPU渲染是Ryzen AI Halo的另一個主要優勢。在Monster場景中,其每分鐘取樣數達到244.7,領先HP Z2 Mini(224.3)和HP ZBook Ultra(189.3)。 Junkshop場景緊接著,每分鐘取樣數為159.4,高於149.5和129.4。 Classroom場景的每分鐘採樣數為131.6,比Z2 Mini(116.3)高出約13%,比ZBook Ultra(94.1)高出近40%。這些結果表明,Ryzen AI Max+ 395儘管體積小巧,卻能提供出色的多執行緒渲染效能。
| Blender 基準 CPU(每分鐘樣本數,越高越好) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monster | 244.7 個樣本/米 | 224.3 個樣本/米 | 189.29 個樣本/米 |
| 舊貨店 | 159.4 個樣本/米 | 149.5 個樣本/米 | 129.42 個樣本/米 |
| 課堂 | 131.6 個樣本/米 | 116.3 個樣本/米 | 94.14 個樣本/米 |
各系統間的GPU渲染結果非常接近。 Halo參考平台在Monster場景下的渲染速度為每分鐘704.2個取樣點,略低於Z2 Mini(745.6),但高於ZBook Ultra(661.5)。 Junkshop場景的渲染速度在Halo平台(366.6)和Z2 Mini(366.5)之間基本上持平。同時,Halo系統在Classroom場景的渲染速度最高,達到每分鐘361.5個採樣點,略高於Z2 Mini(359.0)和ZBook Ultra(333.3)。結果表明,Radeon 8060S在不同實現方式下都能提供極其穩定的GPU渲染效能。
| Blender 基準 GPU(每分鐘樣本數,越高越好) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monster | 704.2 個樣本/米 | 745.55 個樣本/米 | 661.50 個樣本/米 |
| 舊貨店 | 366.6 個樣本/米 | 366.54 個樣本/米 | 341.92 個樣本/米 |
| 課堂 | 361.51 個樣本/米 | 359.01 個樣本/米 | 333.26 個樣本/米 |
y 粉碎機
y-cruncher 是一款多執行緒、可擴展的程序,能夠計算圓周率和其他數學常數,精度可達萬億位小數。自 2009 年發布以來,它已成為超頻玩家和硬體愛好者常用的基準測試和壓力測試工具。
y-cruncher 的測試結果會隨計算規模而變化。在 10 億位和 2.5 億位的計算中,三款系統的完成時間相差無幾秒,其中 HP 系統略勝一籌。隨著工作負載的增加,Halo 逐漸拉開差距,以 71.948 秒完成 1 億位的計算,而 Z2 Mini 和 ZBook Ultra 的完成時間分別為 75.021 秒和 78.19 秒。在 5 億位的計算中,Halo 的完成時間為 151.409 秒,比 Z2 Mini 快約 6%,比 ZBook Ultra 快約 12%,這表明隨著運行時間的延長,桌上型電腦機箱能夠更好地承受繁重的多線程負載。
| Y-Cruncher(總計算時間) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 1億 | 13.193秒 | 12.965秒 | 12.93秒 |
| 2.5億 | 34.578秒 | 34.533秒 | 34.91秒 |
| 5億 | 71.948秒 | 75.021秒 | 78.19秒 |
| 10億 | 151.409秒 | 160.252秒 | 171.72秒 |
Geekbench 6
Geekbench 6 是一款跨平台基準測試軟體,用於衡量系統整體效能。
Geekbench 6 測試結果進一步印證了 Halo 平台平衡的效能表現。其單核得分高達 2,986 分,領先 HP Z2 Mini (2,862) 和 ZBook Ultra (2,825)。多核心性能同樣以 18,068 分領先。 Radeon 8060S 顯示卡在 OpenCL GPU 測試中取得了 92,883 分的最高分,略微超過 Z2 Mini (91,591),並輕鬆超越 ZBook Ultra (85,337)。 CPU 和 GPU 測試的持續領先優勢,充分展現了 Ryzen AI Max+ 395 平台的全面效能。
| Geekbench 6(越高越好) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU單核 | 2,986 | 2,862 | 2,825 |
| CPU 多核 | 18,068 | 17,210 | 17,562 |
| GPU OpenCL | 92,883 | 91,591 | 85,337 |
Cinebench R23
Cinebench R23 是一款廣受認可的基準測試軟體,用於評估 CPU 在 3D 渲染工作負載中的效能。它基於 Cinema 4D 引擎,能夠衡量處理器處理單執行緒和多執行緒任務的能力,從而深入了解其整體響應速度和並行處理能力。
Cinebench R23 測試顯示,兩款搭載 Ryzen AI Max+ 395 處理器的桌面級產品之間的競爭非常激烈。 Halo 參考平台的多核心得分為 37,316,略微領先 HP Z2 Mini 的 37,156,而兩款產品均輕鬆超越了 HP ZBook Ultra 的 29,112。單核心效能也呈現相同的趨勢,Halo 平台得分為 2,047,而 Z2 Mini 和 ZBook Ultra 的得分分別為 2,020 和 1,984。儘管與 Z2 Mini 的差距不大,但 Halo 系統始終在基準測試中名列前茅。
| Cinebench R23(越高越好) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 多核 | 37,316 | 37,156 | 29,112 |
| 單核 | 2,047 | 2,020 | 1,984 |
Cinebench 2024
Cinebench 2024 在 R23 的基礎上引入了基於 GPU 的渲染測試,同時仍專注於 CPU 效能。在本部分,我們僅考察 CPU 得分,以便更深入了解各個系統處理現代 3D 渲染任務的能力。
最新的 Cinebench 2024 基準測試結果與 R23 的結果相符。 Ryzen AI Halo 的多核心得分最高,達到 1,916 分,略微領先 HP Z2 Mini(1,906 分),並大幅領先 HP ZBook Ultra(1,579 分)。單核心效能方面,Halo 平台同樣表現出色,得分為 116 分,而 Z2 Mini 和 ZBook Ultra 分別為 112 分和 111 分。雖然各桌上型電腦系統之間的差距仍然很小,但測試結果再次證明了 Ryzen AI Max+ 395 能夠持續提供頂級的 CPU 渲染效能。
| Cinebench 2024(越高越好) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a(銳龍 AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a 14 吋(銳龍 AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 多核 | 1,916 | 1,906 | 1,579 |
| 單核 | 116 | 112 | 111 |
Phoronix 基準測試
Phoronix 測試套件是一個開源的自動化基準測試平台,支援超過 450 種測試設定檔和 100 多個測試套件(透過 OpenBenchmarking.org)。它能夠處理從安裝依賴項到運行測試和收集結果的所有步驟,因此非常適合性能比較、硬體驗證和持續整合。我們將重點放在 Stream、7-Zip 和 LLVM 測試中的效能表現。
透過 Phoronix 基準測試套件,我們發現 AMD Ryzen AI Halo 平台和 NVIDIA DGX Spark 的效能表現相當接近。 Ryzen AI Halo 系統在以 CPU 為中心的工作負載中始終領先,在 7-Zip 壓縮測試中比 DGX Spark 快 11%,在 7-Zip 解壓縮測試中快 38%,並且在 LLVM 編譯測試中也快了 14%。另一方面,DGX Spark 展現了更強的持續記憶體頻寬,在 STREAM Scale、Triad 和 Add 測試中分別領先 17%、13% 和 15%。 Halo 在 STREAM Copy 基準測試中保持了 18% 的優勢,這表明雖然兩款系統都性能強勁,但 Ryzen AI Halo 平台更擅長通用計算性能,而 DGX Spark 在以內存頻寬為中心的工作負載中展現了更高的吞吐量。
| 測試 | AMD Ryzen AI Halo | NVIDIA DGX Spark | 優勝者 |
|---|---|---|---|
| 7-Zip 壓縮(MIPS) | 186,921 | 169,052 | 光環(+11%) |
| 7-Zip 解壓縮(MIPS) | 146,109 | 106,084 | 光環(+38%) |
| 串流複製(MB/s) | 145,363 | 123,730 | 光環(+18%) |
| 流規模(MB/s) | 110,611 | 128,970 | 火花(+17%) |
| STREAM Triad (MB/s) | 107,105 | 121,433 | 火花(+13%) |
| 流添加(MB/s) | 107,022 | 122,815 | 火花(+15%) |
| LLVM 編譯(Make,秒) | 431.8 | 504.3 | Halo(速度提升 14%) |
FIO性能基準
為了衡量儲存效能在產業通用指標上的表現,我們使用 fio。我們傳統的 SSD 測試會預先將每個硬碟裝滿兩碟資料作為輔助硬碟進行預處理;而在這裡,我們直接在檔案系統層面測試每個硬碟。我們之前使用 GDSIO 測試過 NVIDIA 系統,但 AMD 沒有提供類似的 GPU 直接儲存測試,因此在兩個平台上運行檔案系統層級的 fio 測試可以使它們處於公平的競爭環境中,這比單獨測試硬碟的效能更為重要。
NVIDIA DGX Spark(創始版)和 AMD Ryzen AI Halo 都配備了 PCIe Gen5 固態硬碟,因此理論上這兩個平台的原始硬碟頻寬上限相同。然而,實際上,在這個系統中,Halo 的固態硬碟以 PCIe Gen4 鏈路速度運行,這使得可用頻寬遠低於硬碟本身的頻寬能力。在本節中,請務必牢記此連結速度限制,因為它是造成兩個平台頻寬差距的重要原因之一。
在本節中,我們將重點放在以下 FIO 基準:
- 128K 連續
- 64K隨機
- 16K 連續
- 16K隨機
- 4K隨機
128K 順序讀取
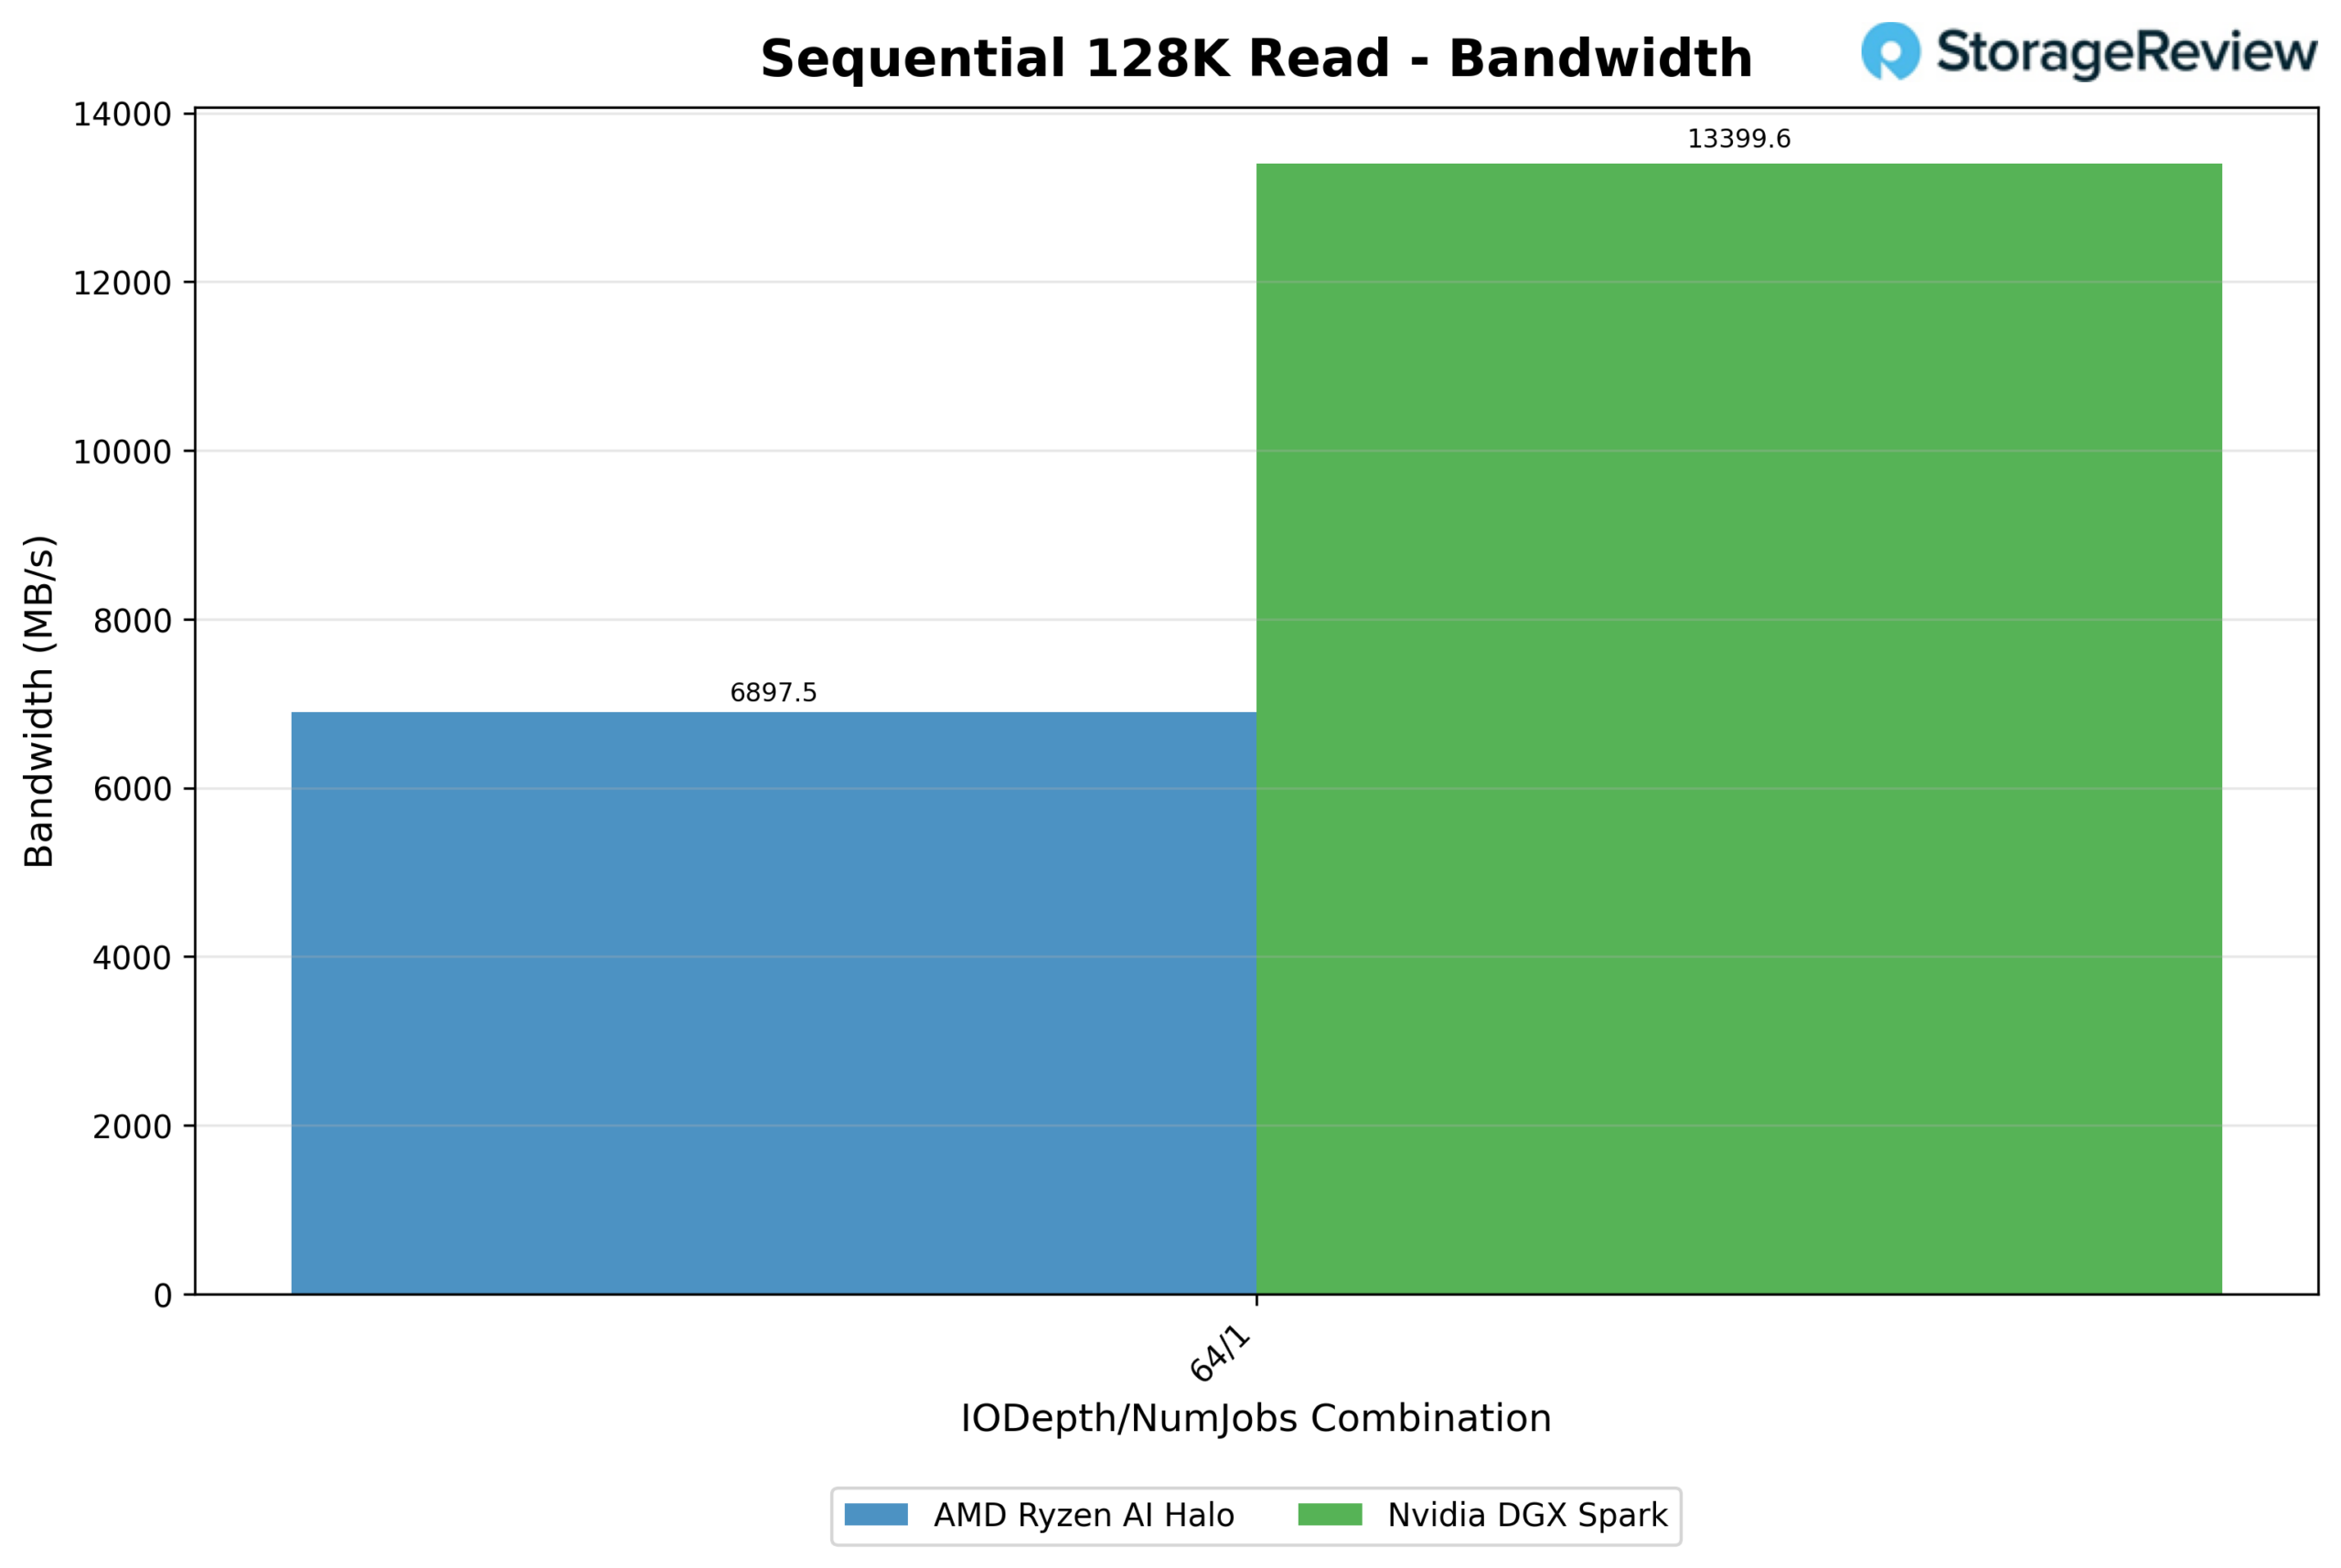
在單執行緒、深度隊列的 128K 順序讀取(64/1)測試中,NVIDIA DGX Spark 的讀寫速度達到了 13,399.6 MB/s,幾乎是 AMD Ryzen AI Halo 的 6,897.5 MB/s 的兩倍。延遲也呈現相同的趨勢:Spark 在此深度下的平均延遲為 0.597 毫秒,而 Halo 則為 1.159 毫秒,儘管資料傳輸量只有 Spark 的一半,但每次請求的速度幾乎是 Spark 的兩倍。這是整個測試過程中差距最明顯的一次,表明 Spark 的儲存堆疊專為在此資料區塊大小下更高的持續順序吞吐量而設計。
128K 順序寫入
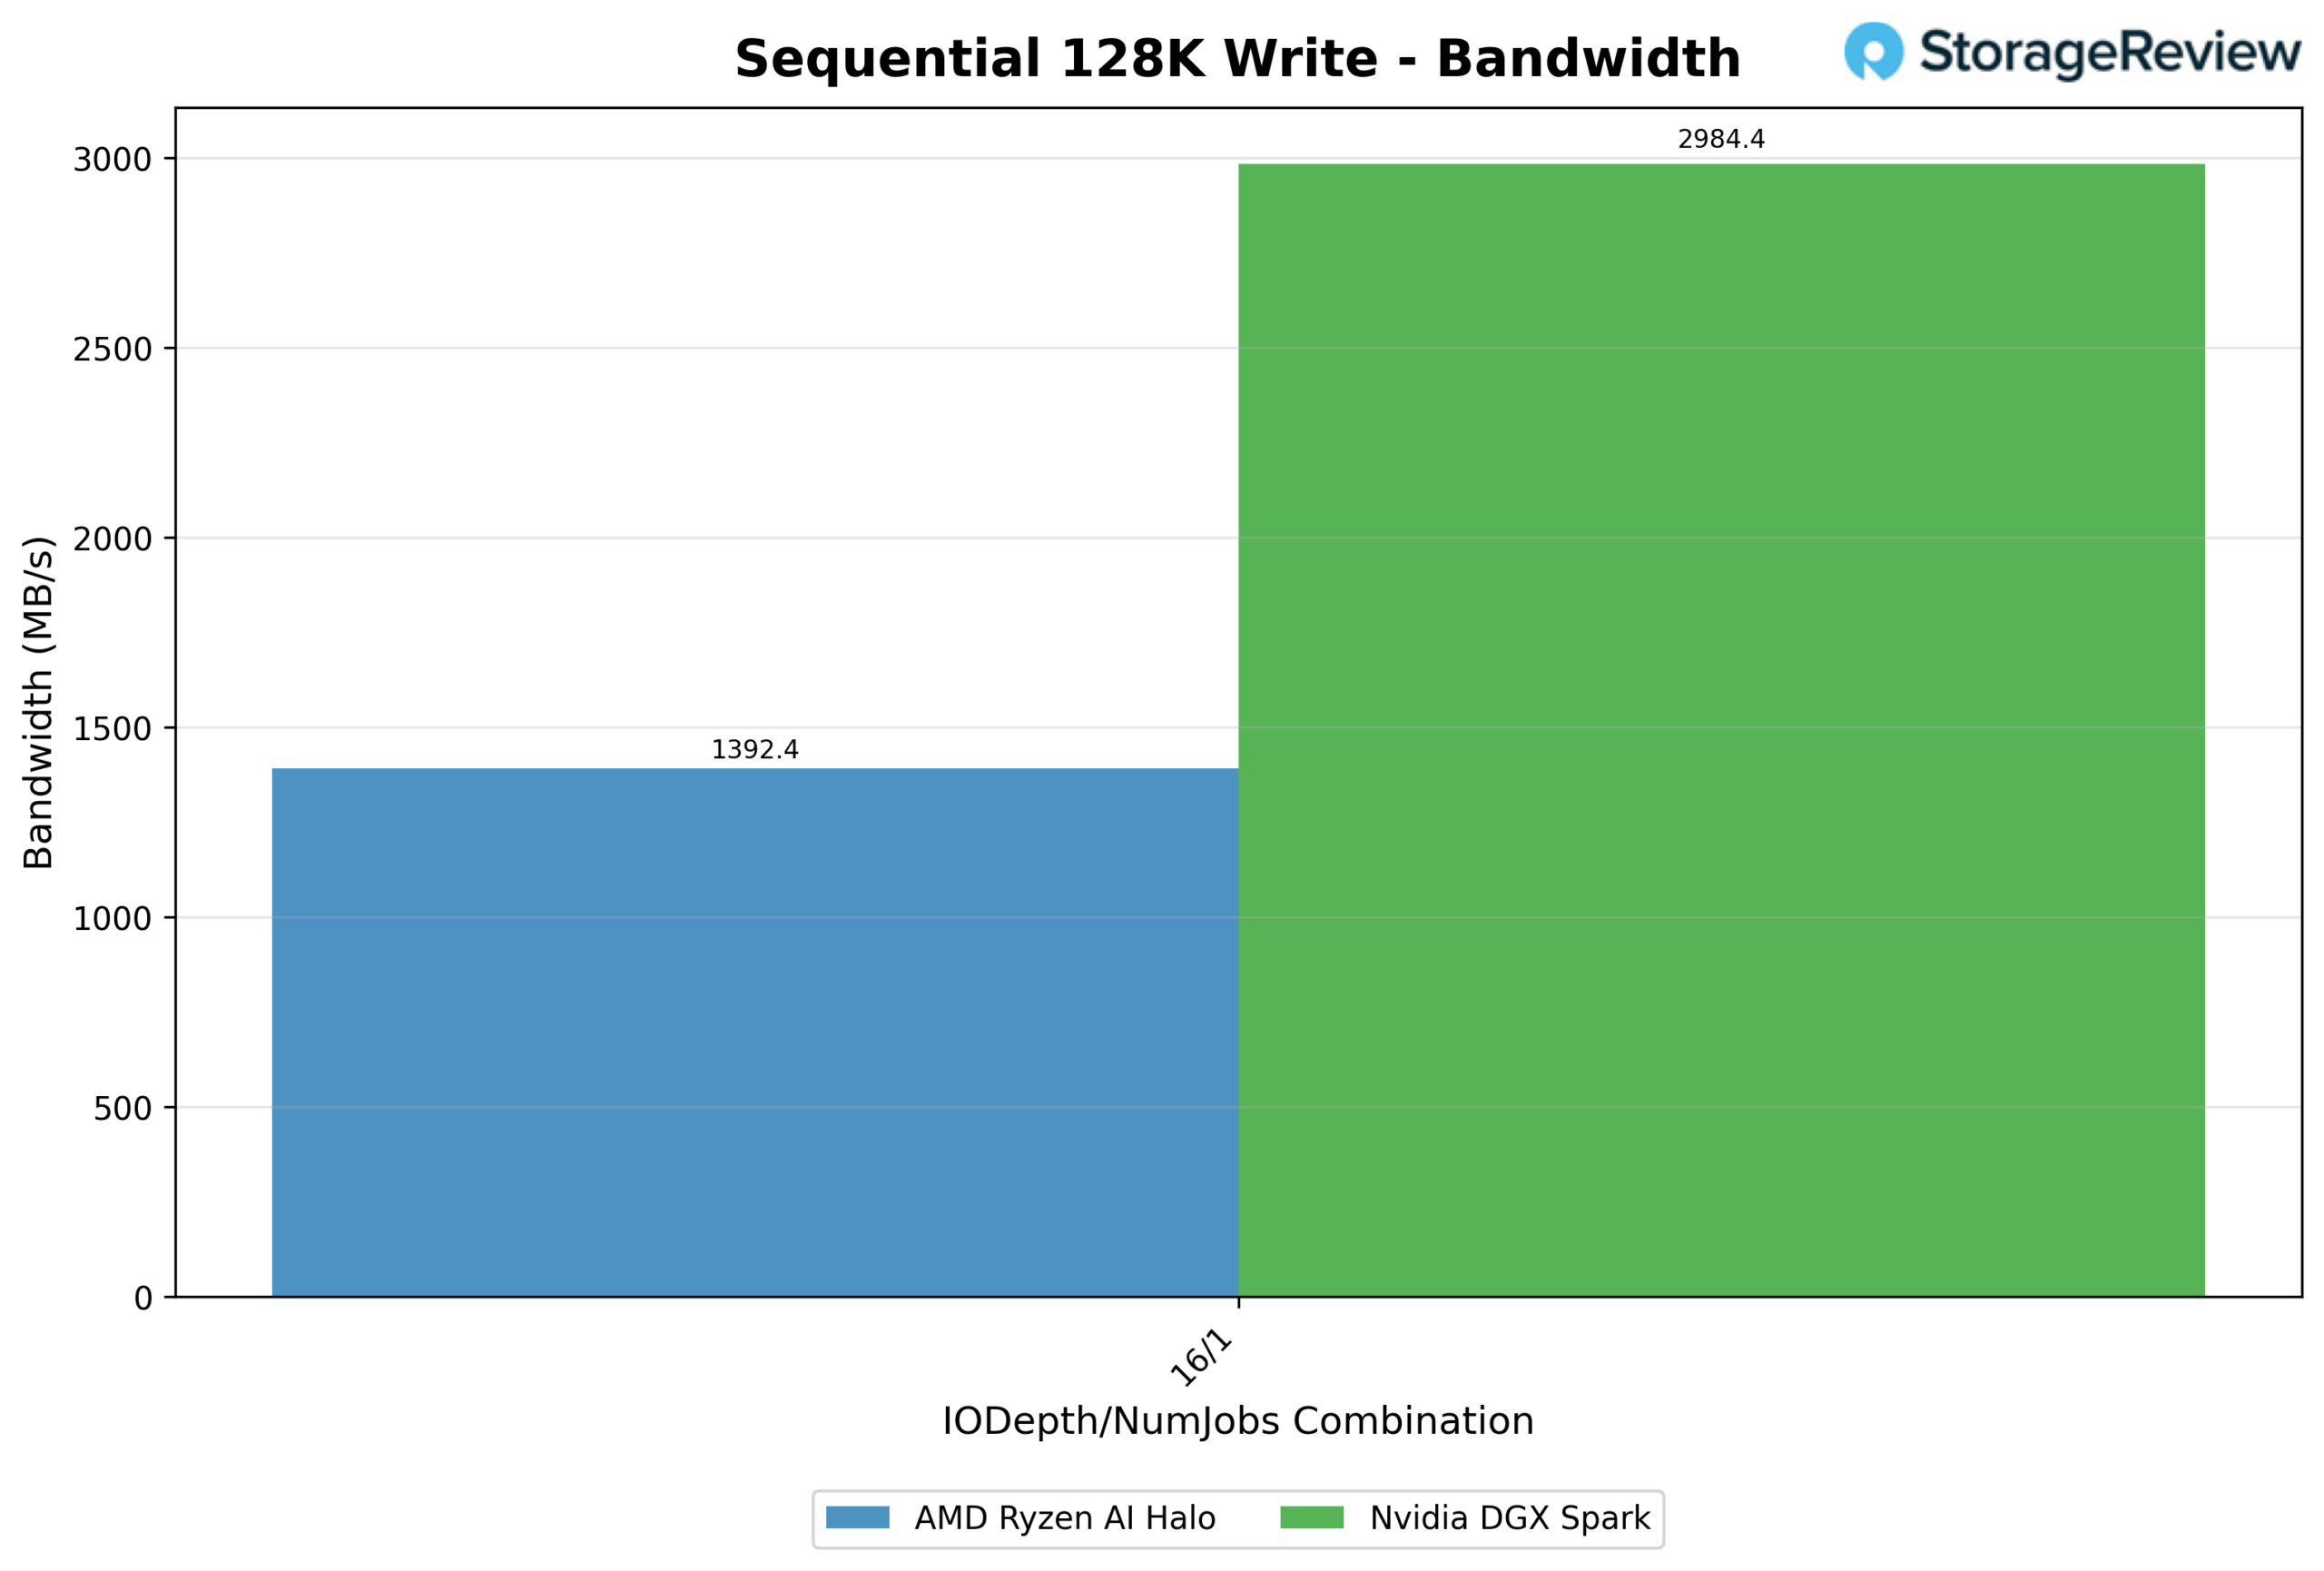
寫入效能方面也呈現類似的趨勢。在 IODepth 16/1 下,Spark 的寫入速度達到了 2,984.4 MB/s,而 Halo 僅為 1,392.4 MB/s,NVIDIA 的優勢高達 114%。延遲方面,Spark 也更勝一籌,僅 0.67 毫秒,而 Halo 則為 1.436 毫秒。結合讀取測試結果,128K 順序寫入是 Spark 相對於 Halo 最強的表現。
64K 隨機讀取
Halo 在低隊列深度下的延遲優勢在此得以充分展現。在 1/1 佇列深度下,Halo 的回應時間僅為 0.051 毫秒,而 Spark 則為 0.275 毫秒,單一未完成請求的回應速度快了 5 倍以上。這種差距在低到中等隊列深度下仍然存在,Halo 的延遲遠低於 0.2 毫秒,而 Spark 在大部分測試範圍內則徘徊在 0.2 到 0.45 毫秒之間。
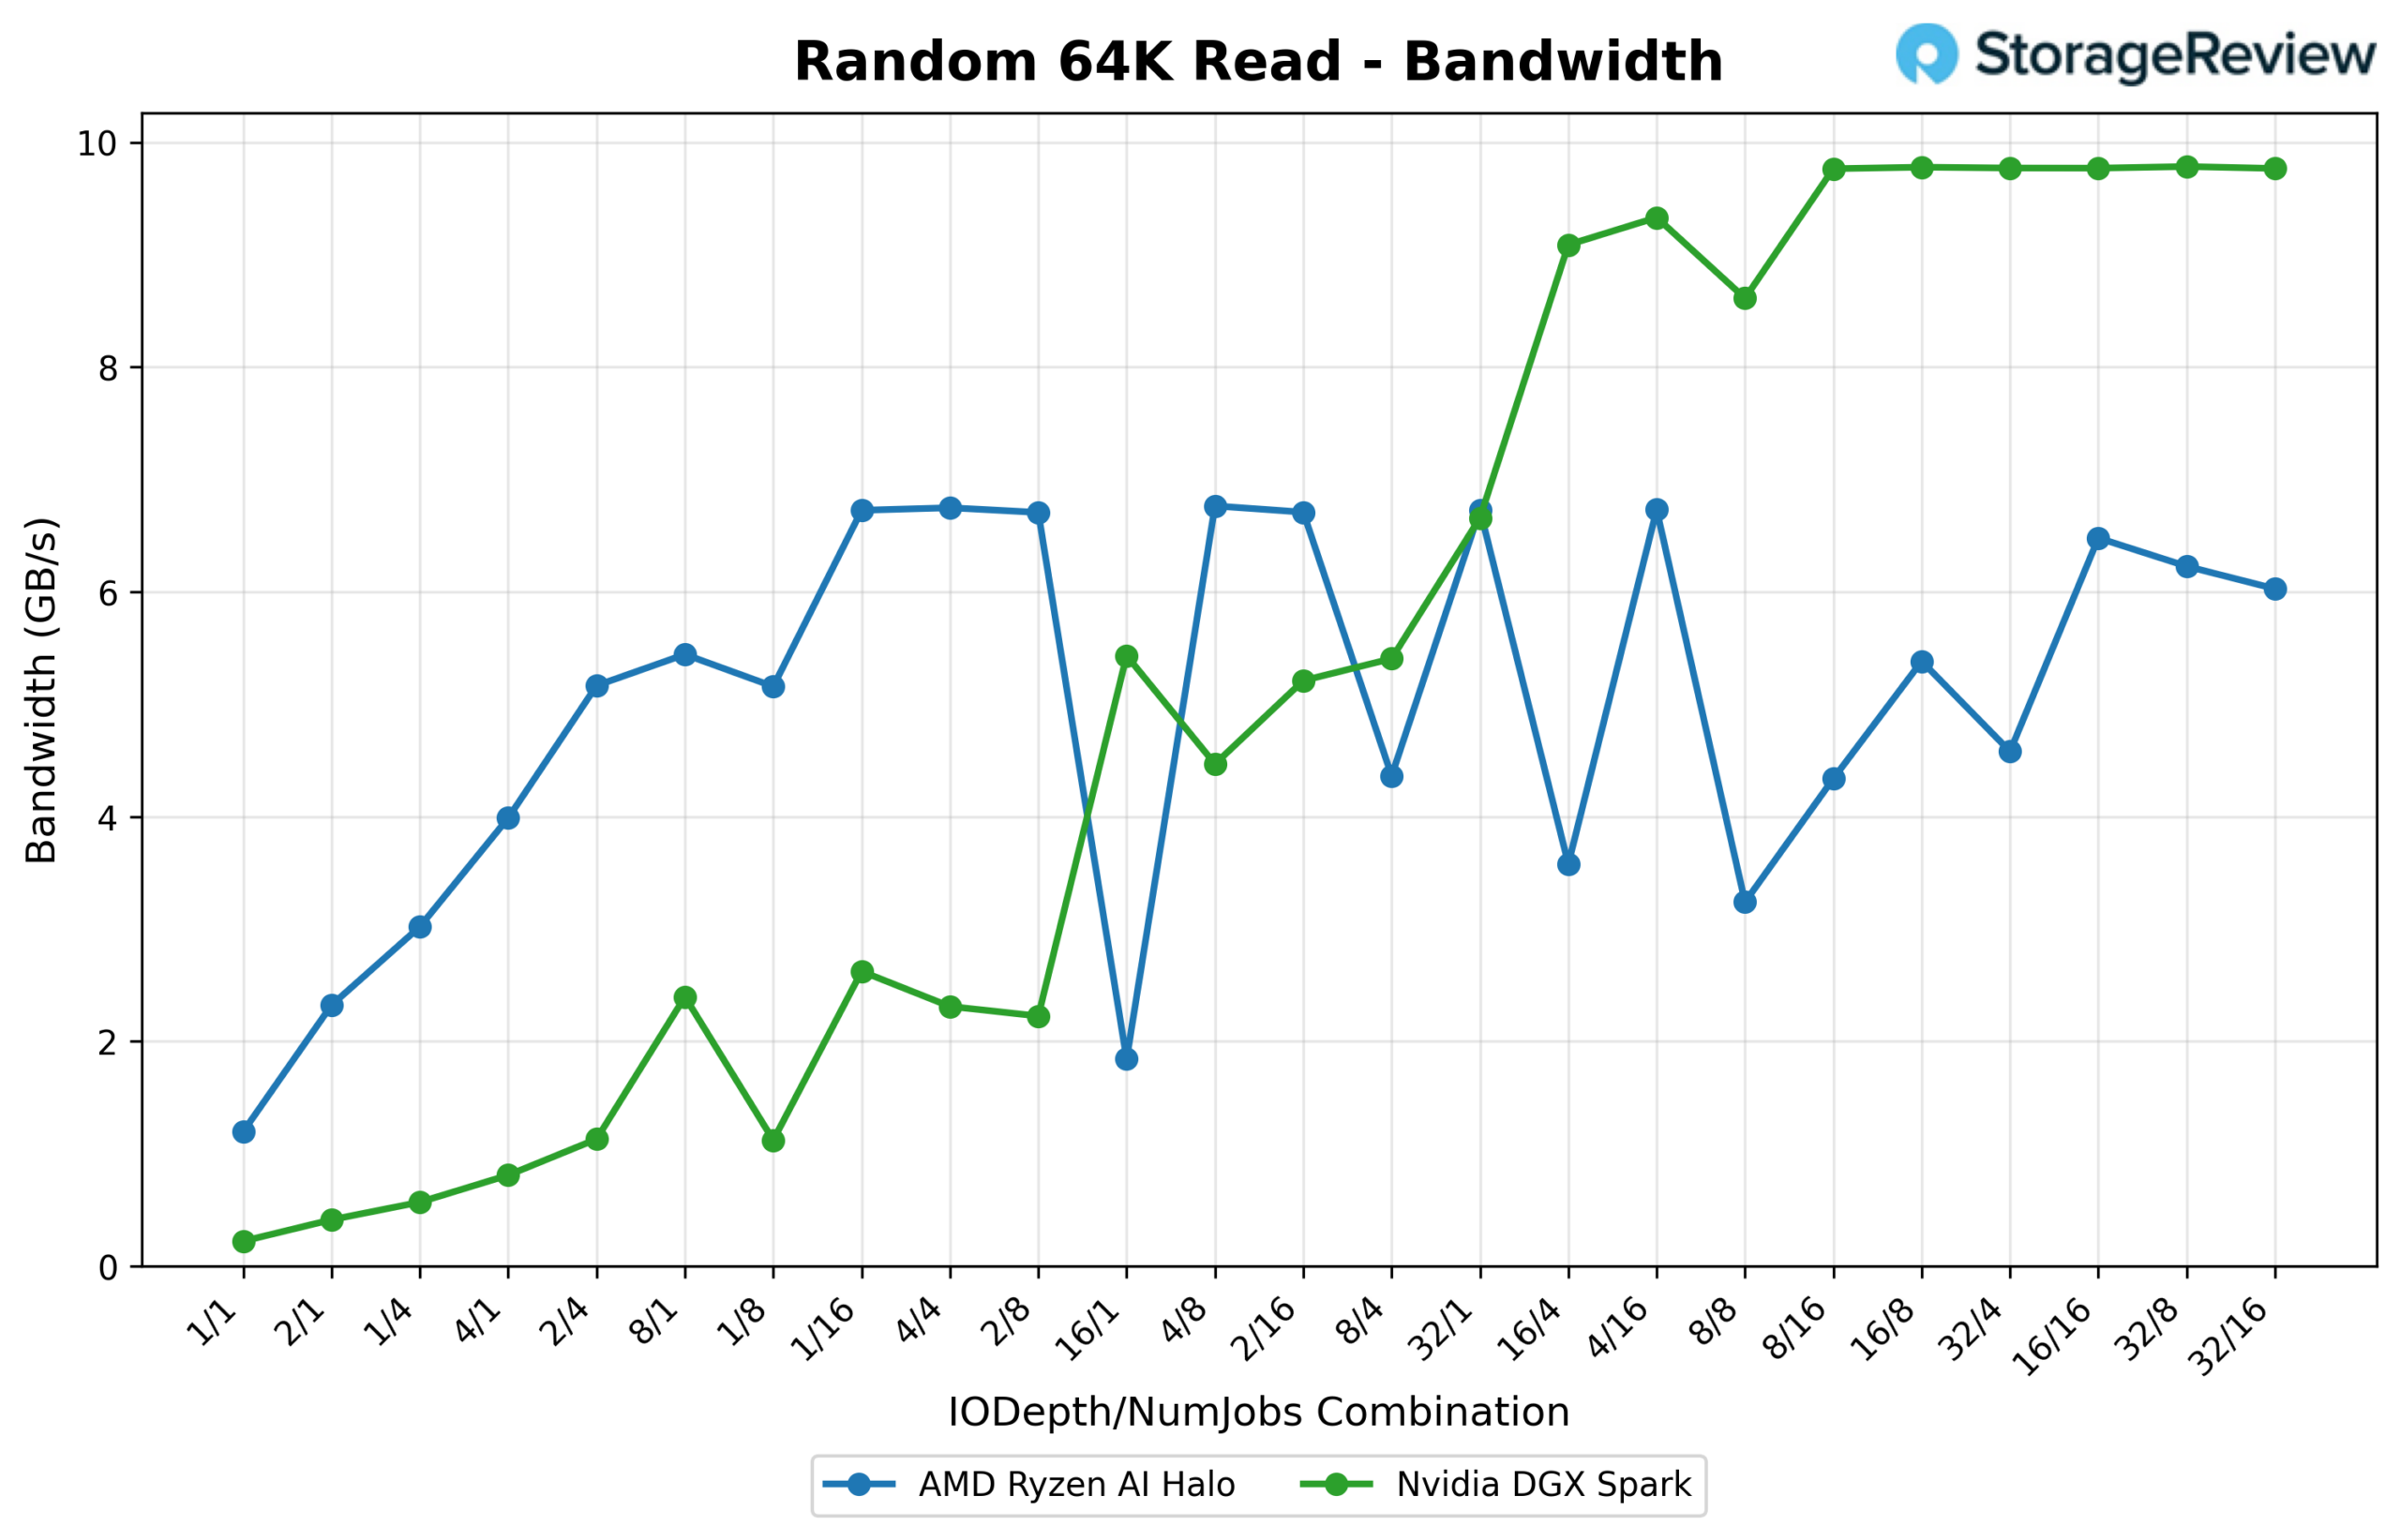
然而,規模擴大後情況就截然不同了。當佇列深度和執行緒數超過大約 16/4 時,Spark 的頻寬開始下降,從 8/16 開始穩定在 9.8 GB/s 左右,在 32/8 時達到峰值 10,019.1 MB/s(160.3K IOPS)。 Halo 則從未達到這個上限:它的頻寬飽和在 6.0–6.9 GB/s 之間,在 4/8 時達到峰值 6,926.5 MB/s(110.8K IOPS)。它的頻寬曲線明顯更加不穩定,根據隊列深度和線程數的組合,頻寬會在大約 2 到 6.8 GB/s 之間波動,而不是平滑上升。
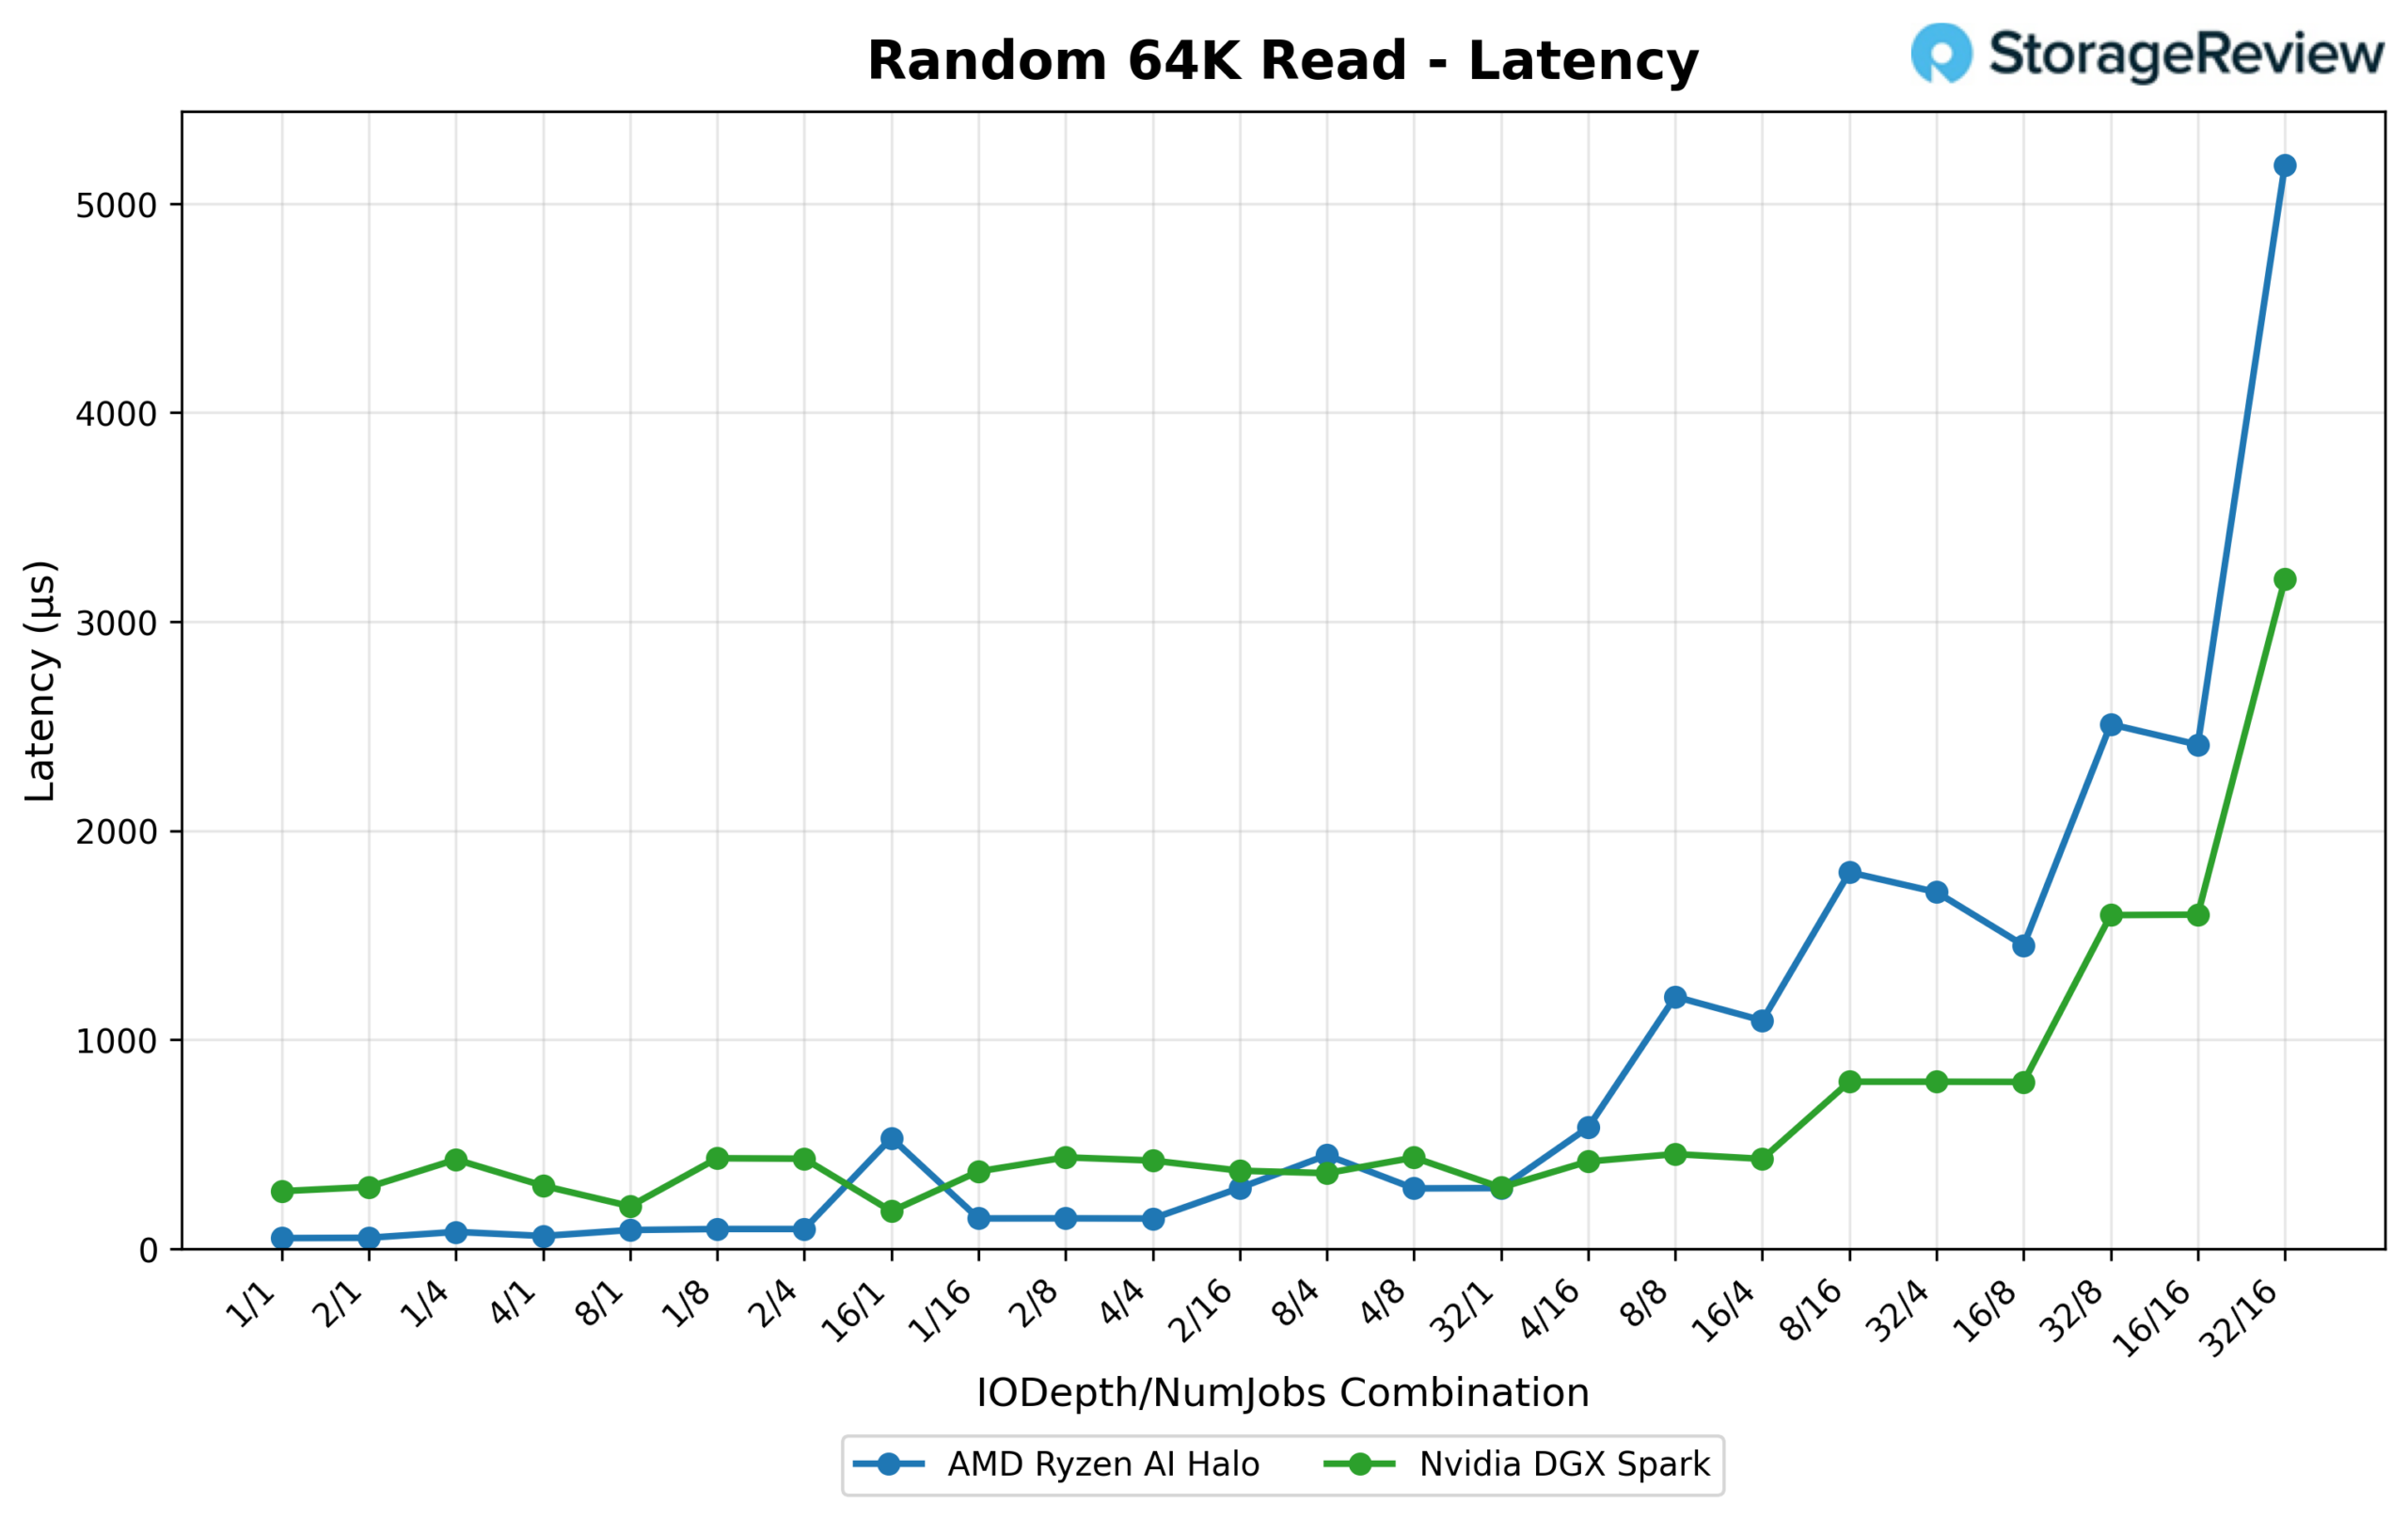
在完全飽和狀態下,延遲也對 Spark 更有利:在 32/16 時,Halo 的平均延遲膨脹到 5.185 毫秒,而 Spark 為 3.204 毫秒,這意味著 Halo 為其低隊列深度響應速度付出的代價是,一旦隊列完全加載,其尾部行為就會變差。
64K 隨機寫入
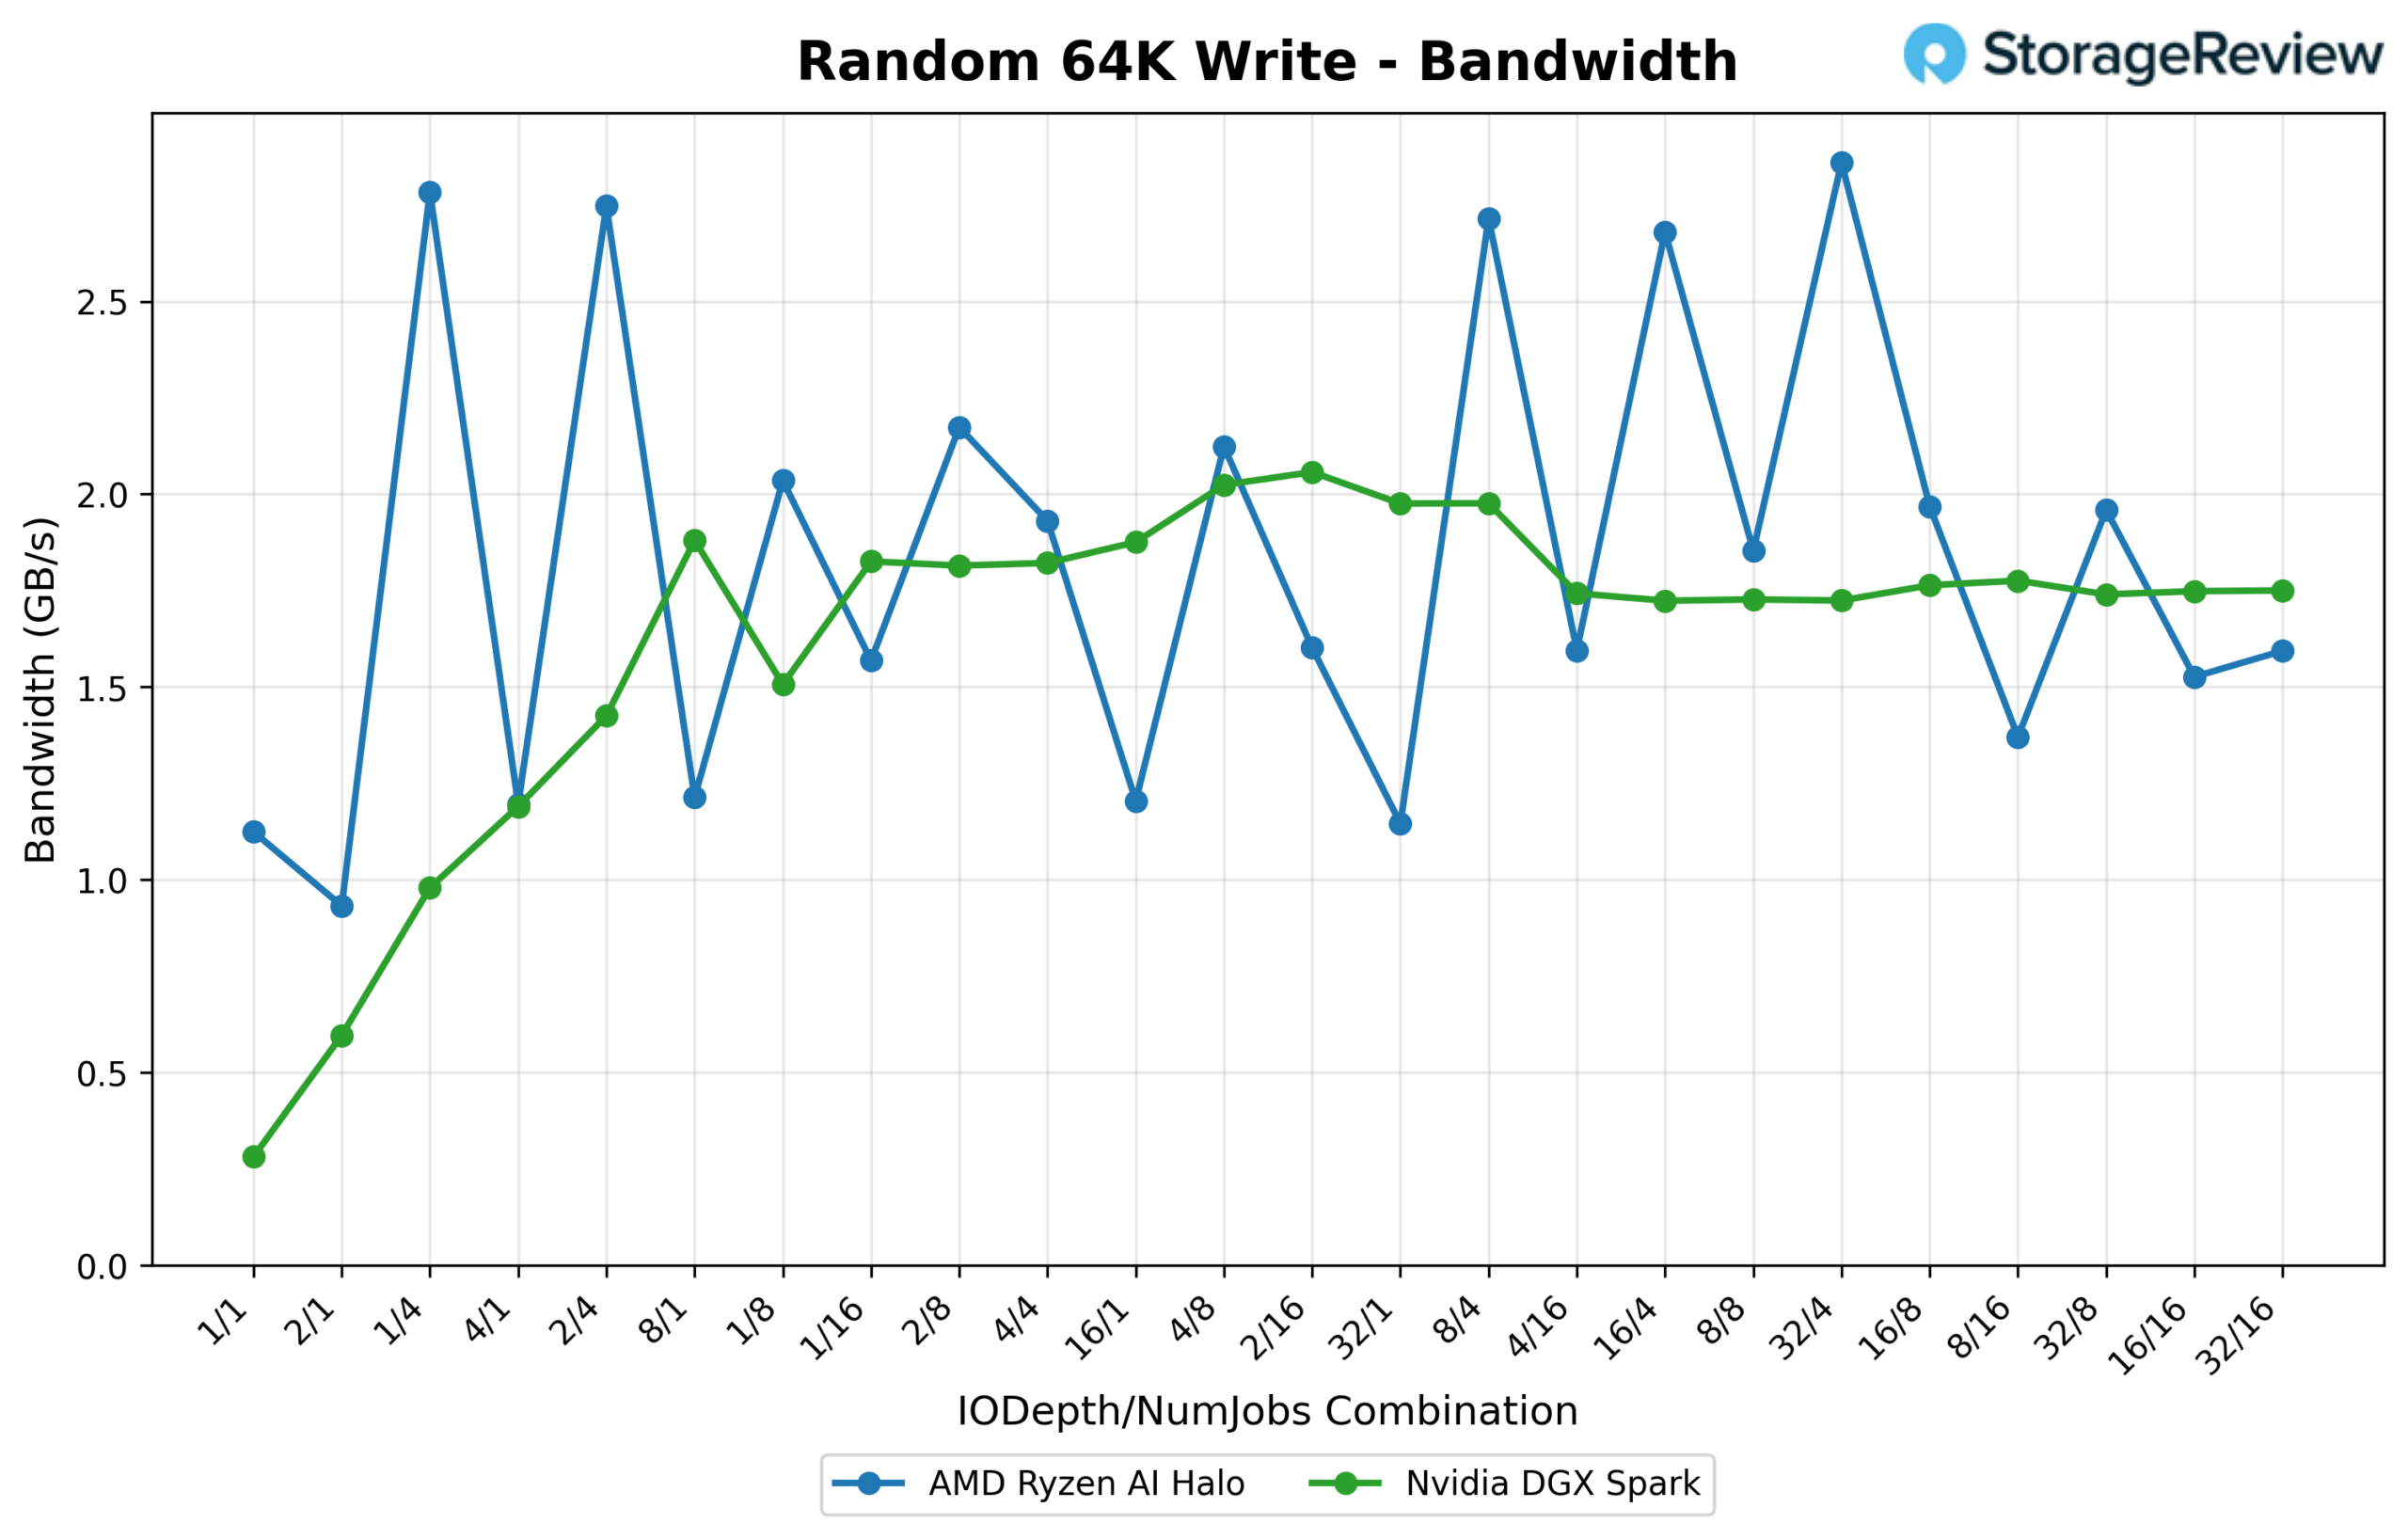
隨機 64K 寫入頻寬在兩個平台上的差距比讀取頻寬要小,儘管曲線形狀截然不同。 Halo 的頻寬波動更大:它會反覆躍升至 2.5 GB/s 以上(在 32/4 時峰值達到 2,929.1 MB/s / 46.9K IOPS),然後在相鄰的組合下回落至 1.1–1.5 GB/s 的範圍內。 Spark 則相對穩定,在大部分測試中都保持在 1.7–2.0 GB/s 的範圍內,並在 2/16 時達到峰值 2,106.6 MB/s(33.7K IOPS)。
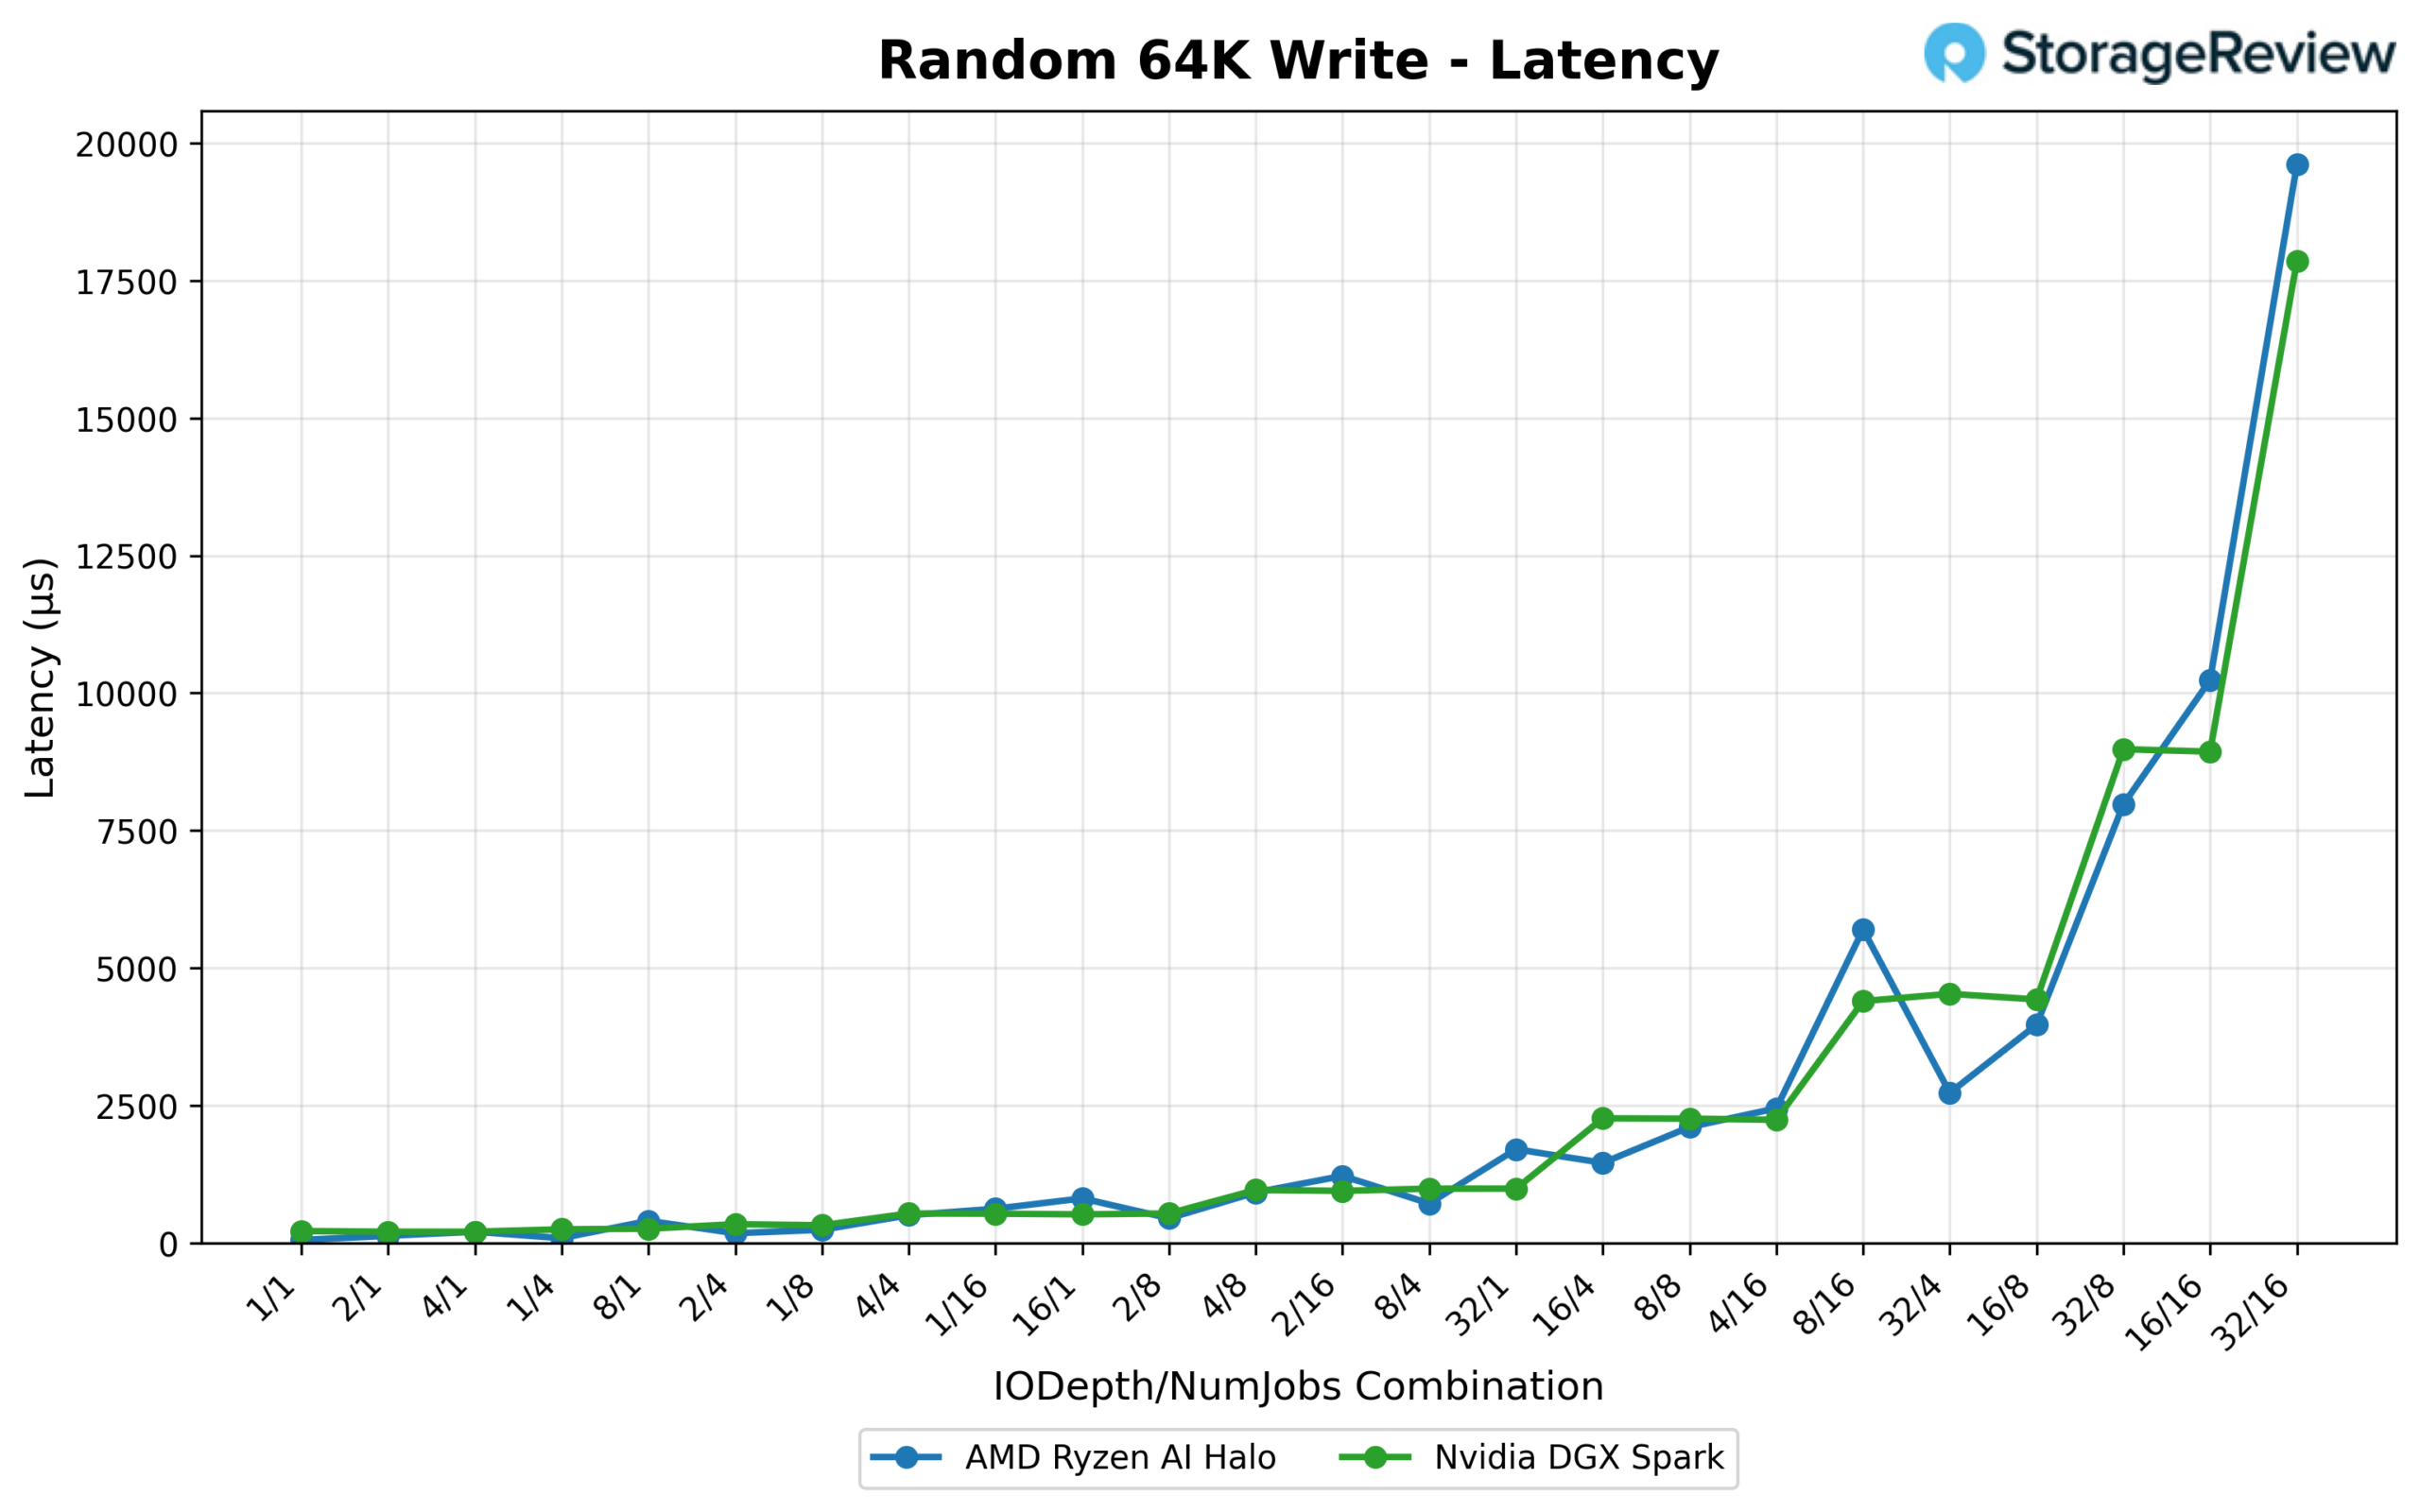
延遲與 64K 讀取模式相符:在低佇列深度下,Halo 的速度明顯更快(1/1 時為 0.054 毫秒,而 Spark 為 0.217 毫秒),但隨著佇列深度和執行緒數達到兩位數,兩款硬碟的效能都急劇下降。在完全飽和(32/16)時,Halo 的延遲達到 19.611 毫秒,而 Spark 為 17.857 毫秒。此時兩款硬碟都明顯承受較大的寫入放大壓力,Halo 在曲線頂端的表現再次略遜一籌。
16K 順序讀取
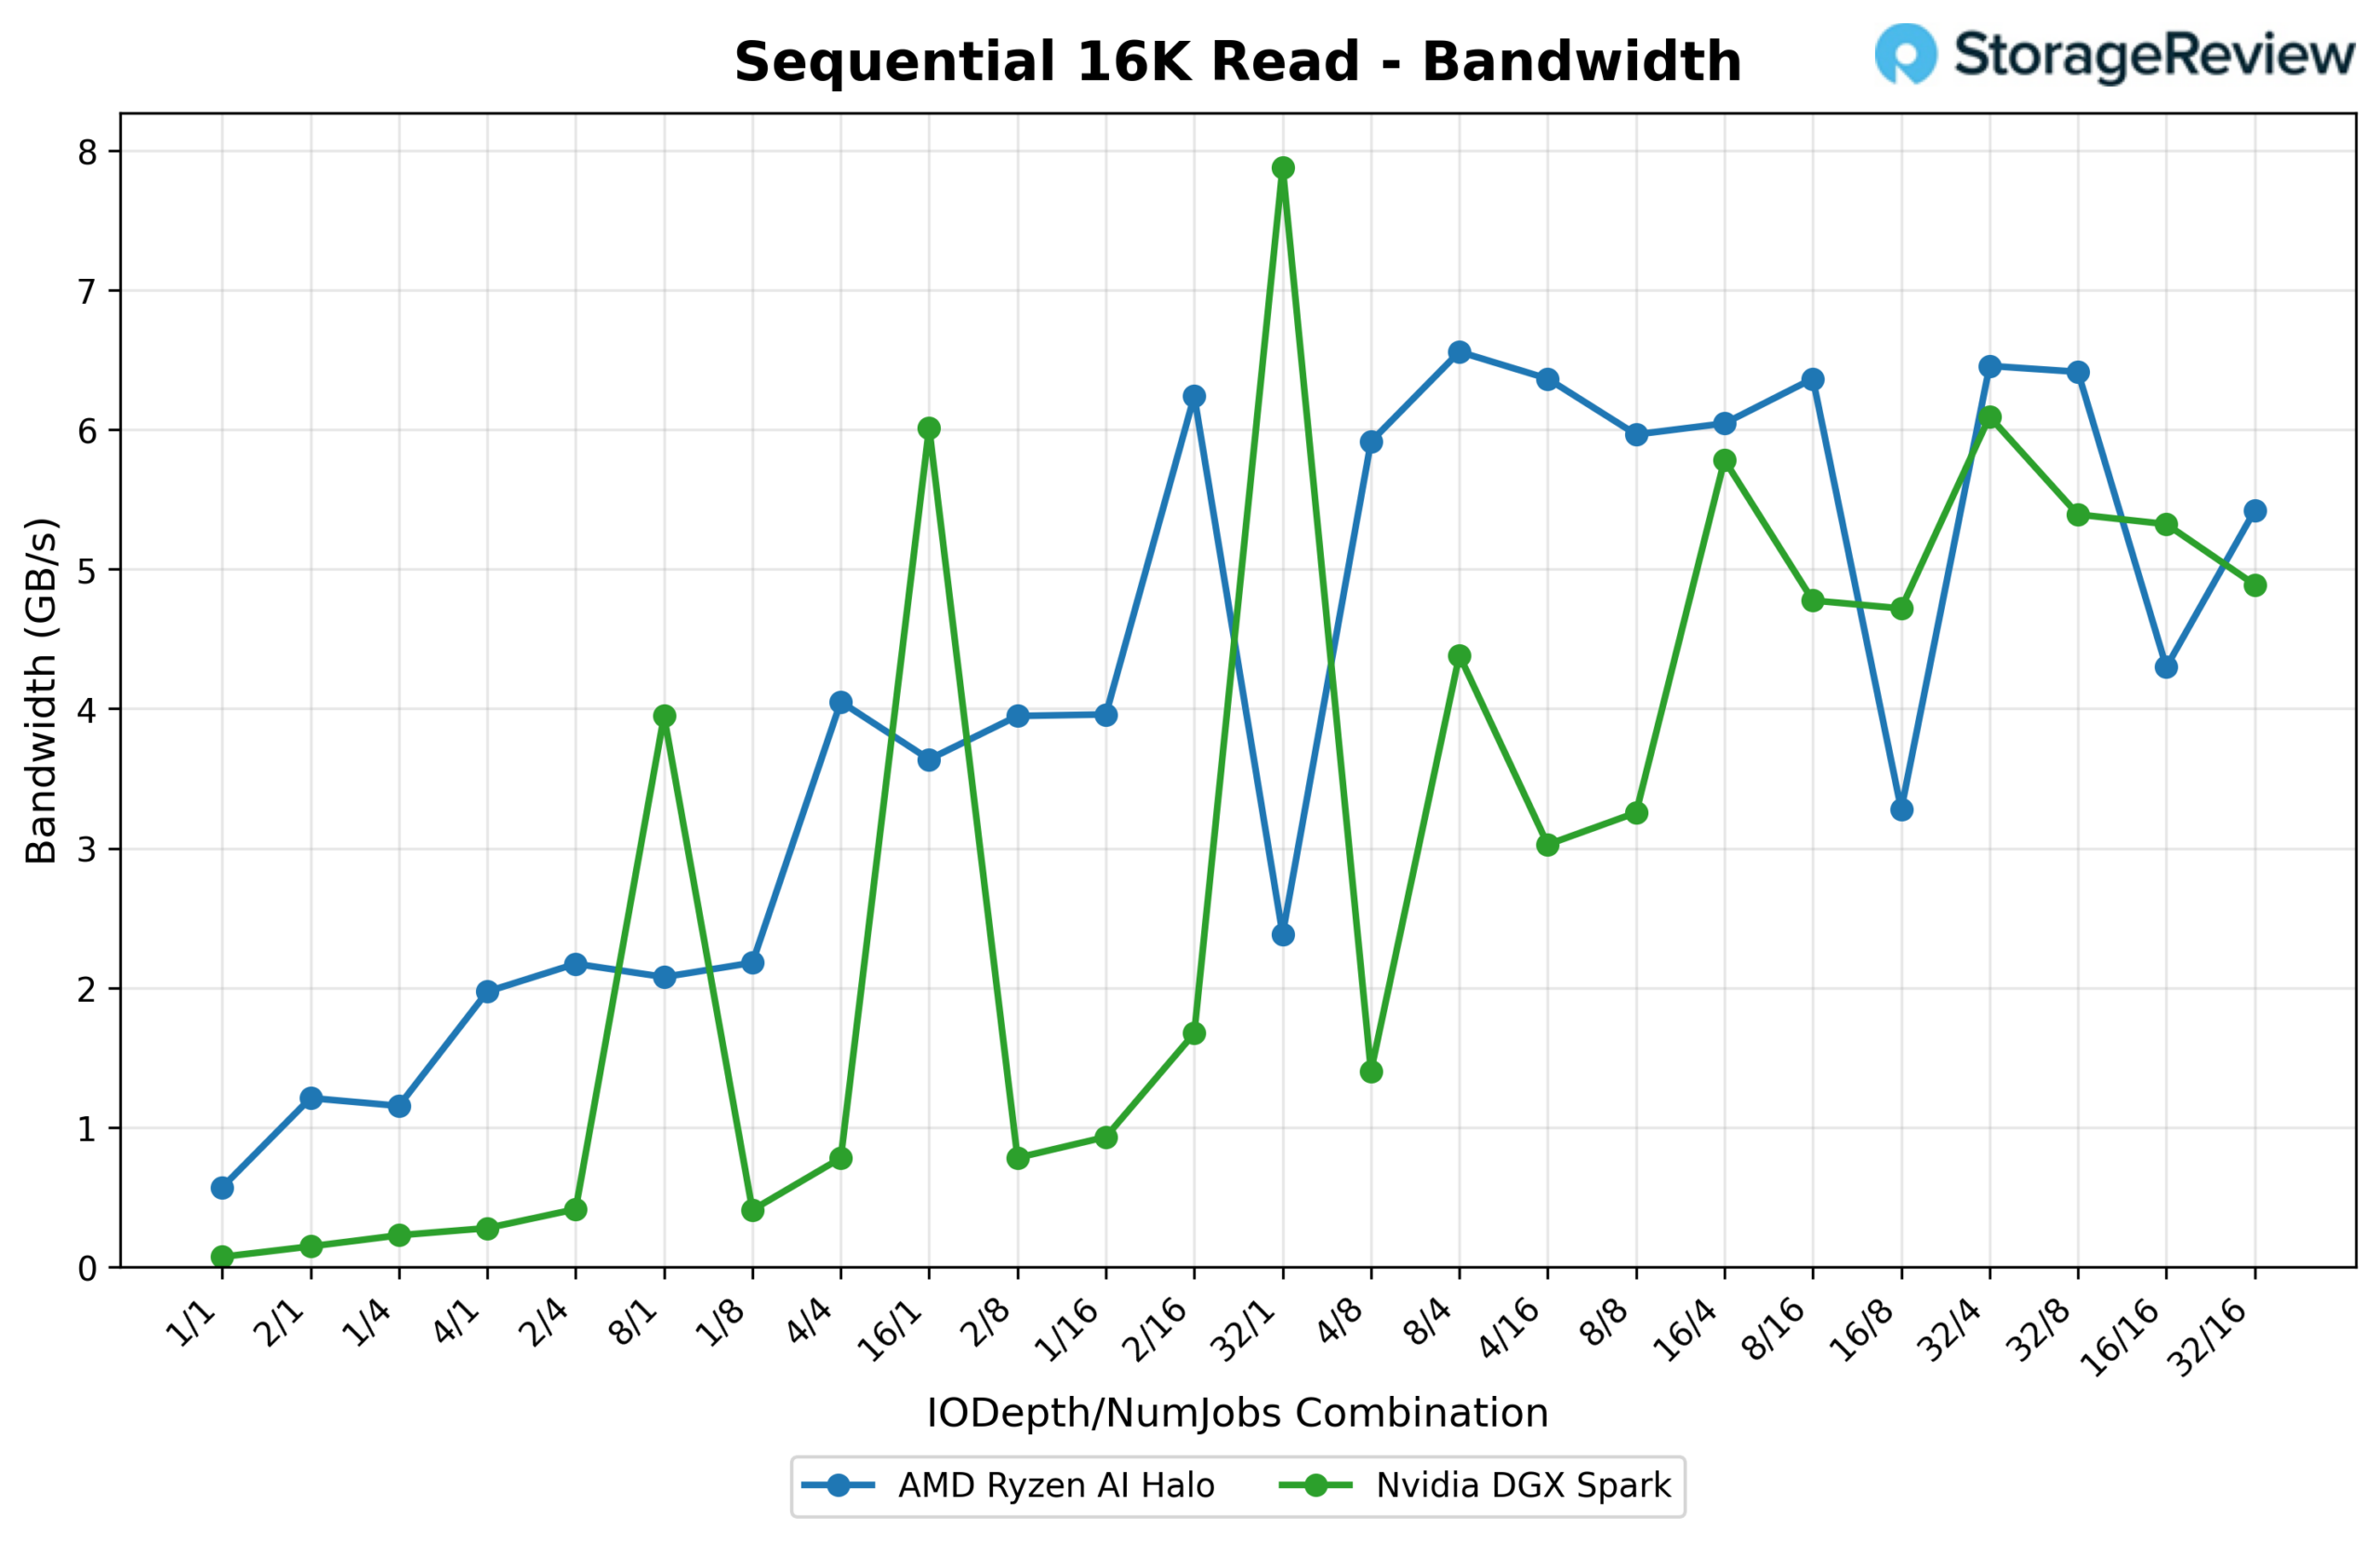
在大部分測試過程中,頻寬都保持在較高水平,兩款硬碟的讀寫速度均在 1-8 GB/s 之間波動,具體數值取決於讀寫深度和執行緒數的組合。 Spark 的峰值略高,在 32/1 的讀寫深度下達到 8,069.3 MB/s(516.4K IOPS),而 Halo 在 8/4 的讀寫深度下最高達到 6,715.8 MB/s(429.8K IOPS)。
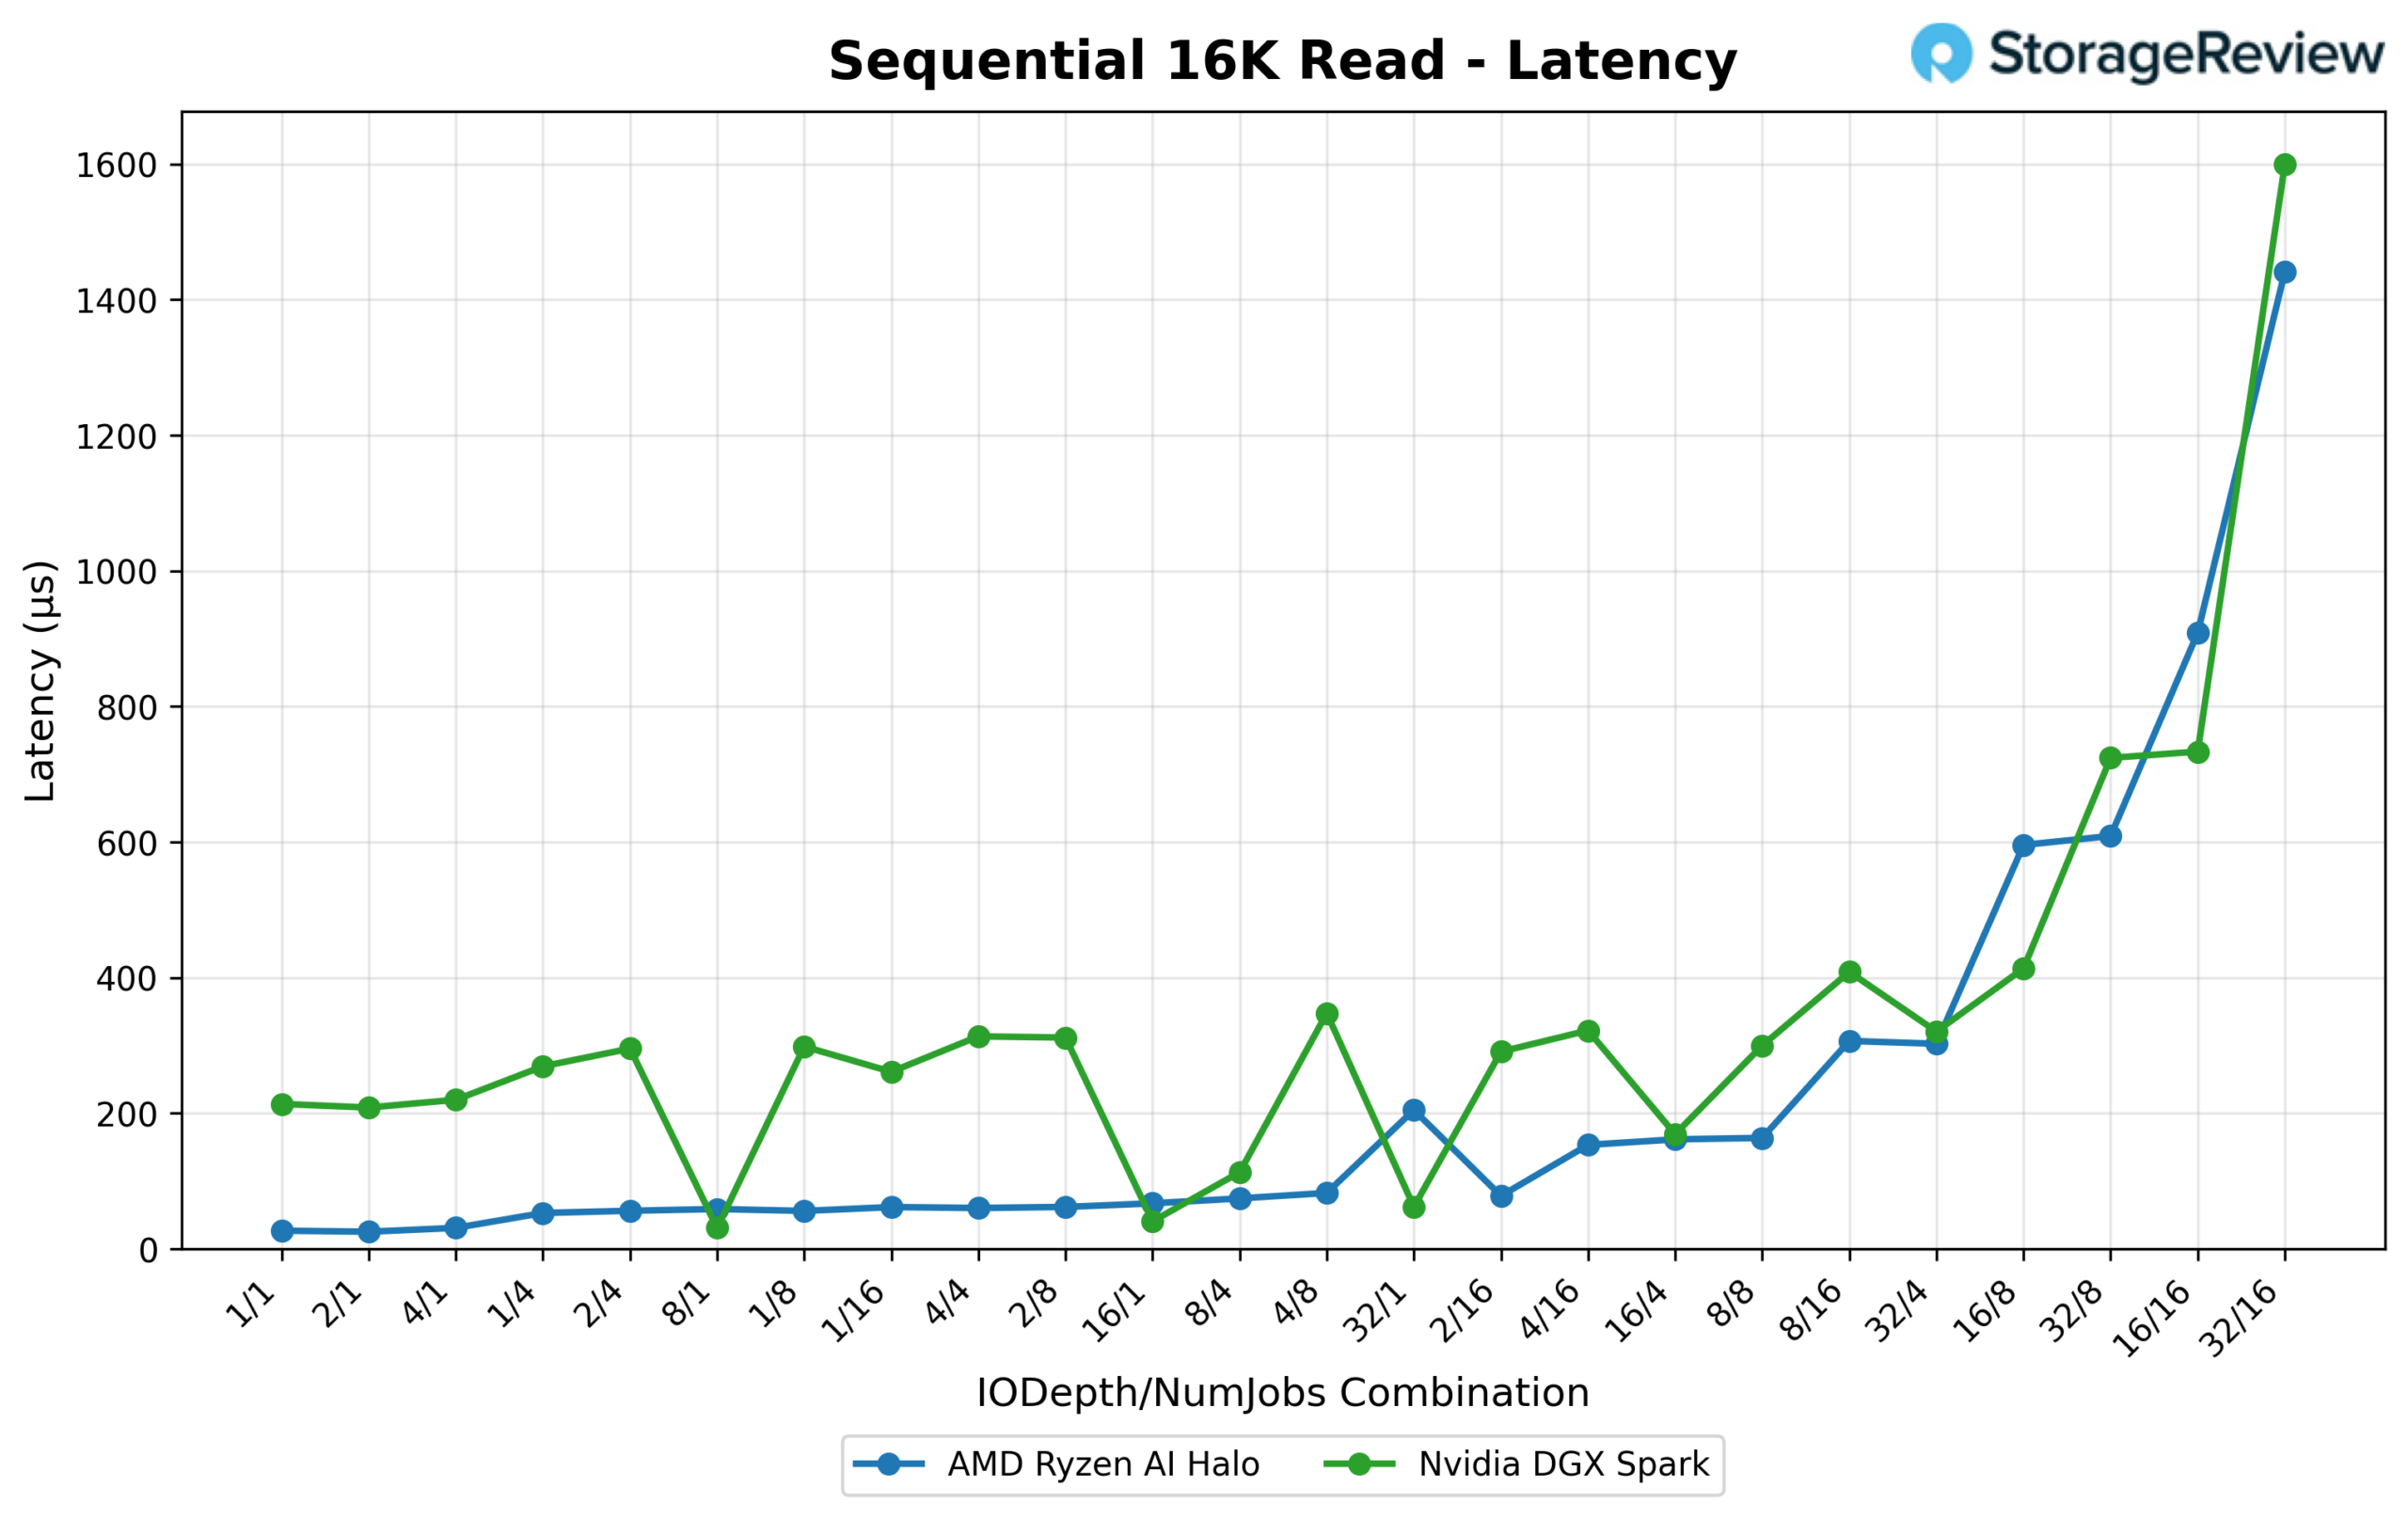
除了佇列最頂端之外,Halo 在所有情況下都保持著更低的延遲。在 1/1 佇列中,Halo 的反應時間為 0.027 毫秒,而 Spark 為 0.214 毫秒,並且在大部分佇列掃描過程中,Halo 的延遲都保持較低。只有在隊列深度最深時,兩者的差距才會縮小。在 32/16 隊列中,Halo 的平均延遲為 1.441 毫秒,略低於 Spark 的 1.599 毫秒,這使得 Halo 的延遲曲線在飽和狀態下沒有超過 Spark 的少數幾個點之一。
16K 順序寫入
頻寬方面也相差無幾:Spark 在 16/1 時達到峰值 2,141.6 MB/s (137.1K IOPS),Halo 在 1/8 時也緊隨其後,達到 1,970.9 MB/s (126.1K IOPS)。
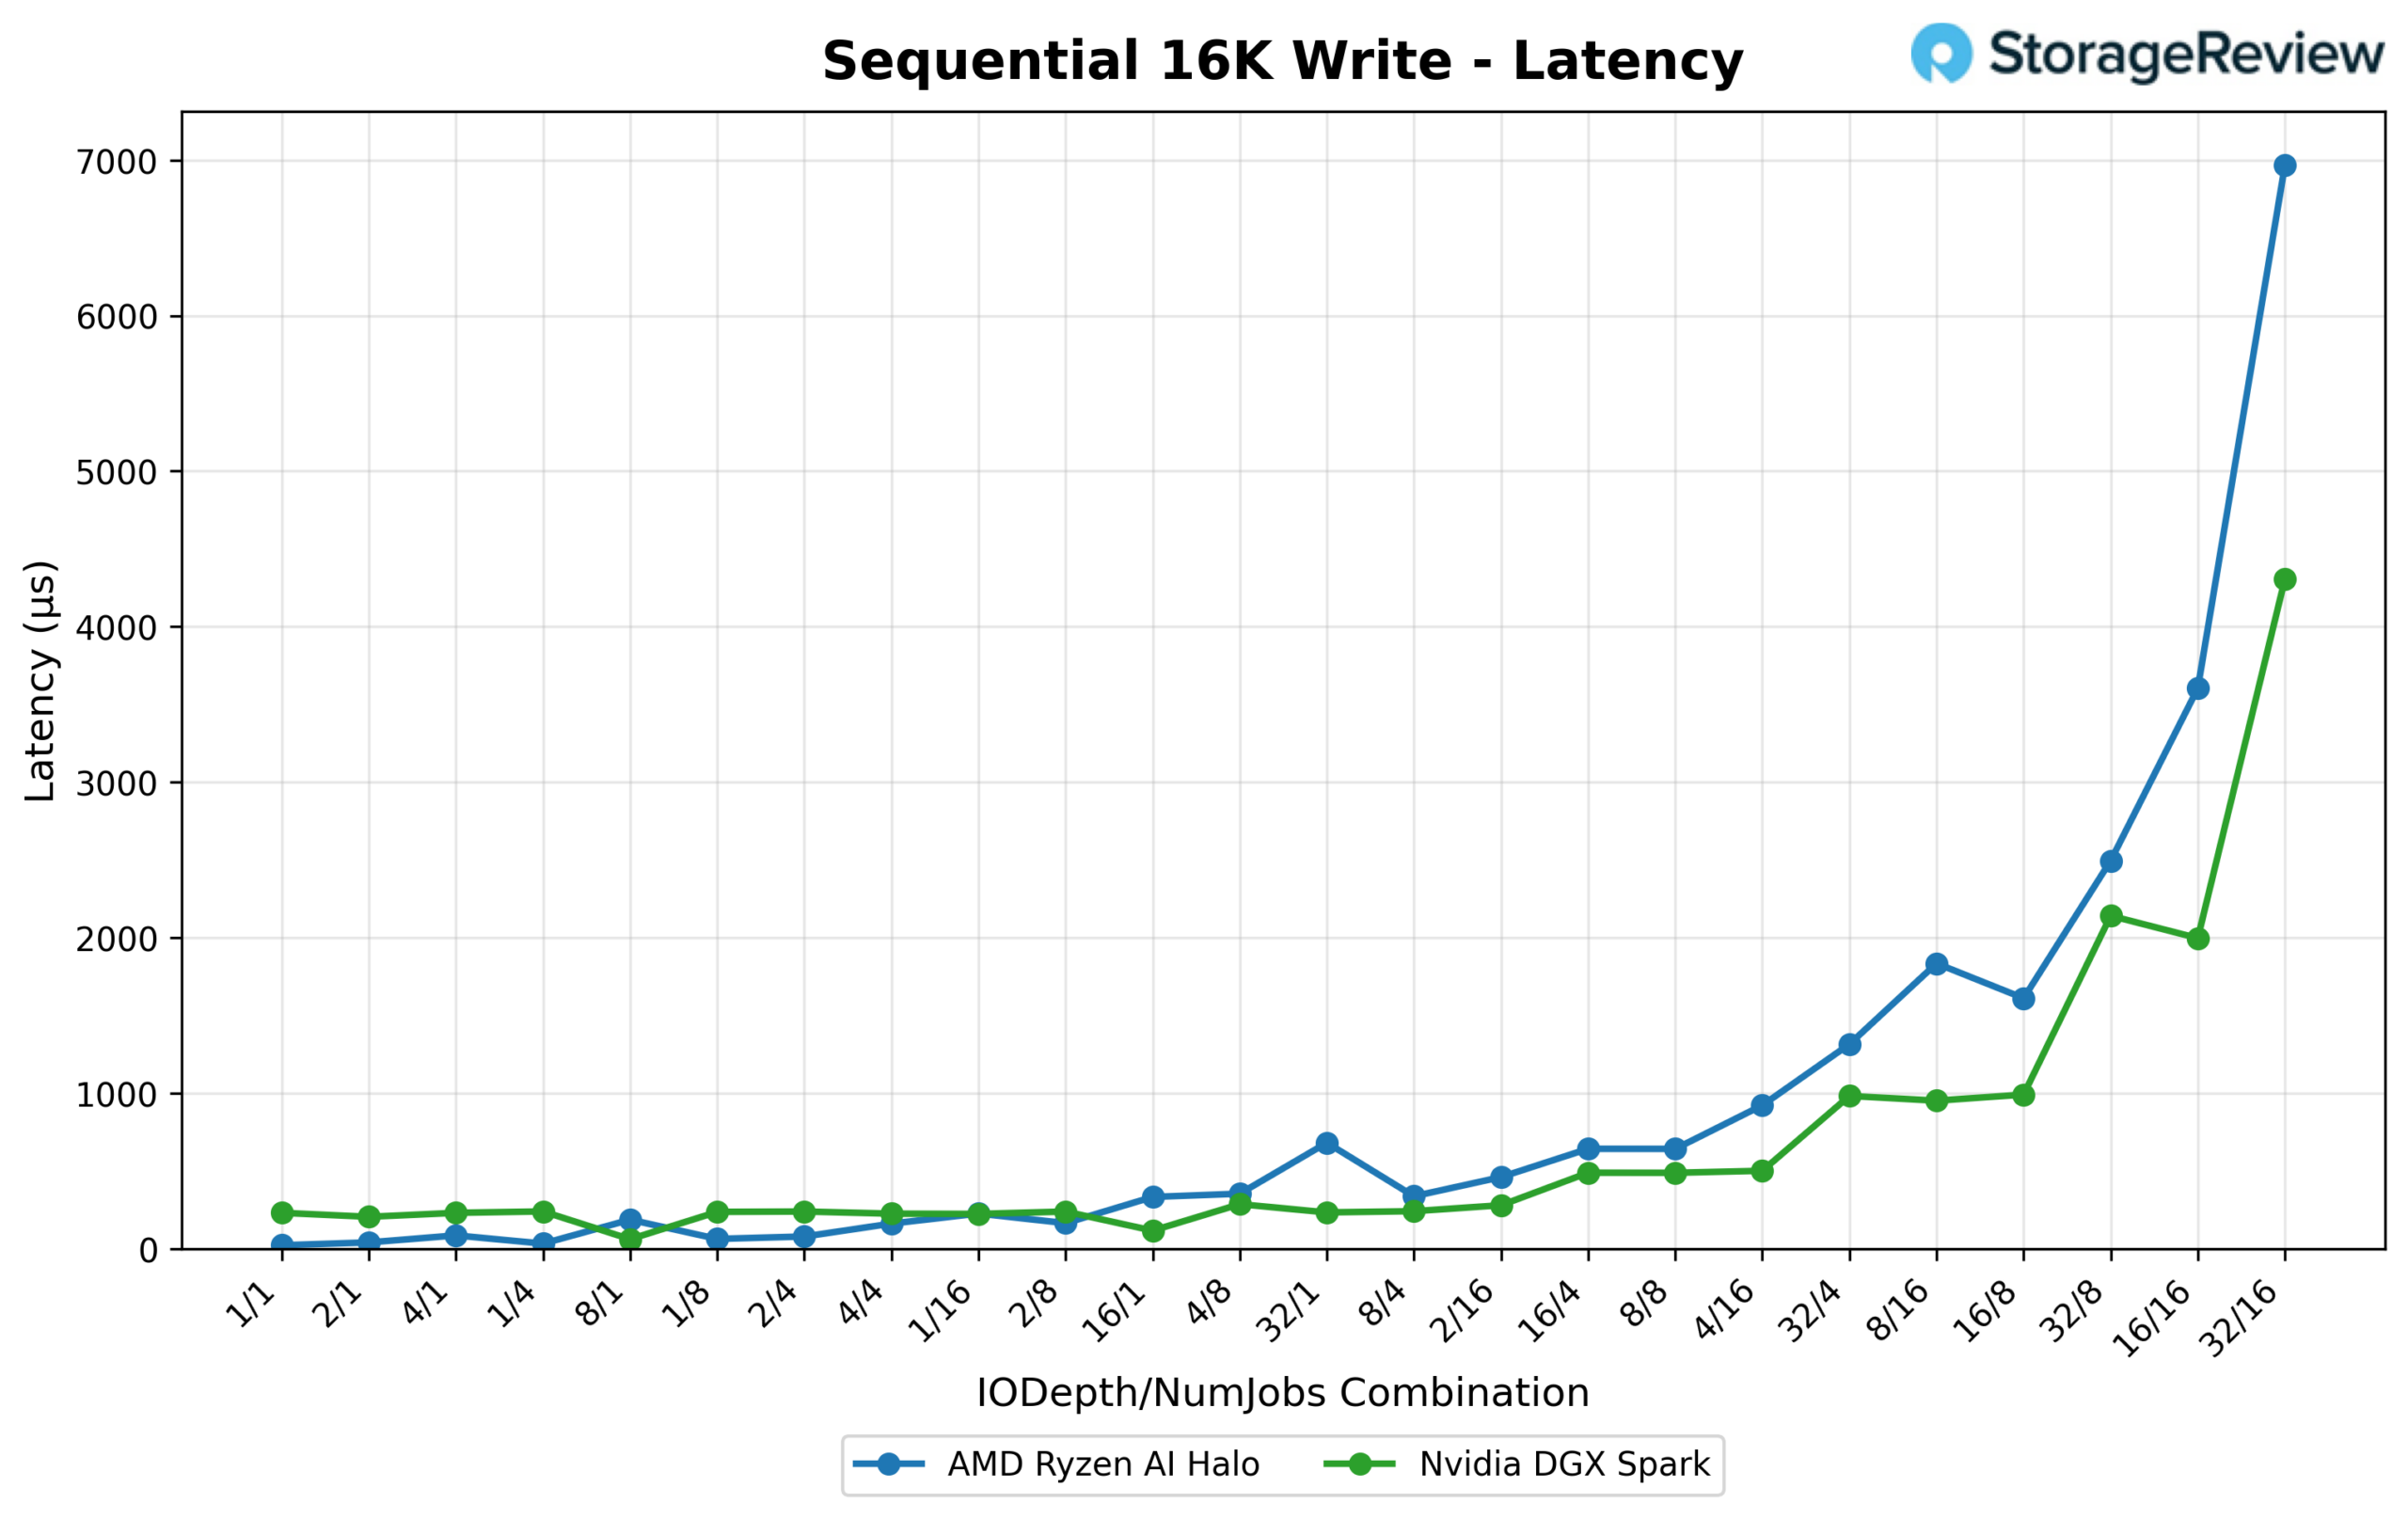
延遲是兩者性能差異最為顯著的地方。在佇列深度較低時,Halo 的延遲表現遠超 Spark(1/1 時為 0.022 毫秒,而 Spark 為 0.231 毫秒),但隨著佇列深度的增加,Halo 的延遲曲線會急遽上升。到 32/16 時,Halo 的平均延遲已攀升至 6.967 毫秒,遠高於 Spark 在同一位置的 4.306 毫秒。此外,Halo 的延遲曲線也更難以預測,在一些中等隊列深度組合下會出現明顯的峰值,而 Spark 的延遲曲線則相對平穩。
16K 隨機讀取
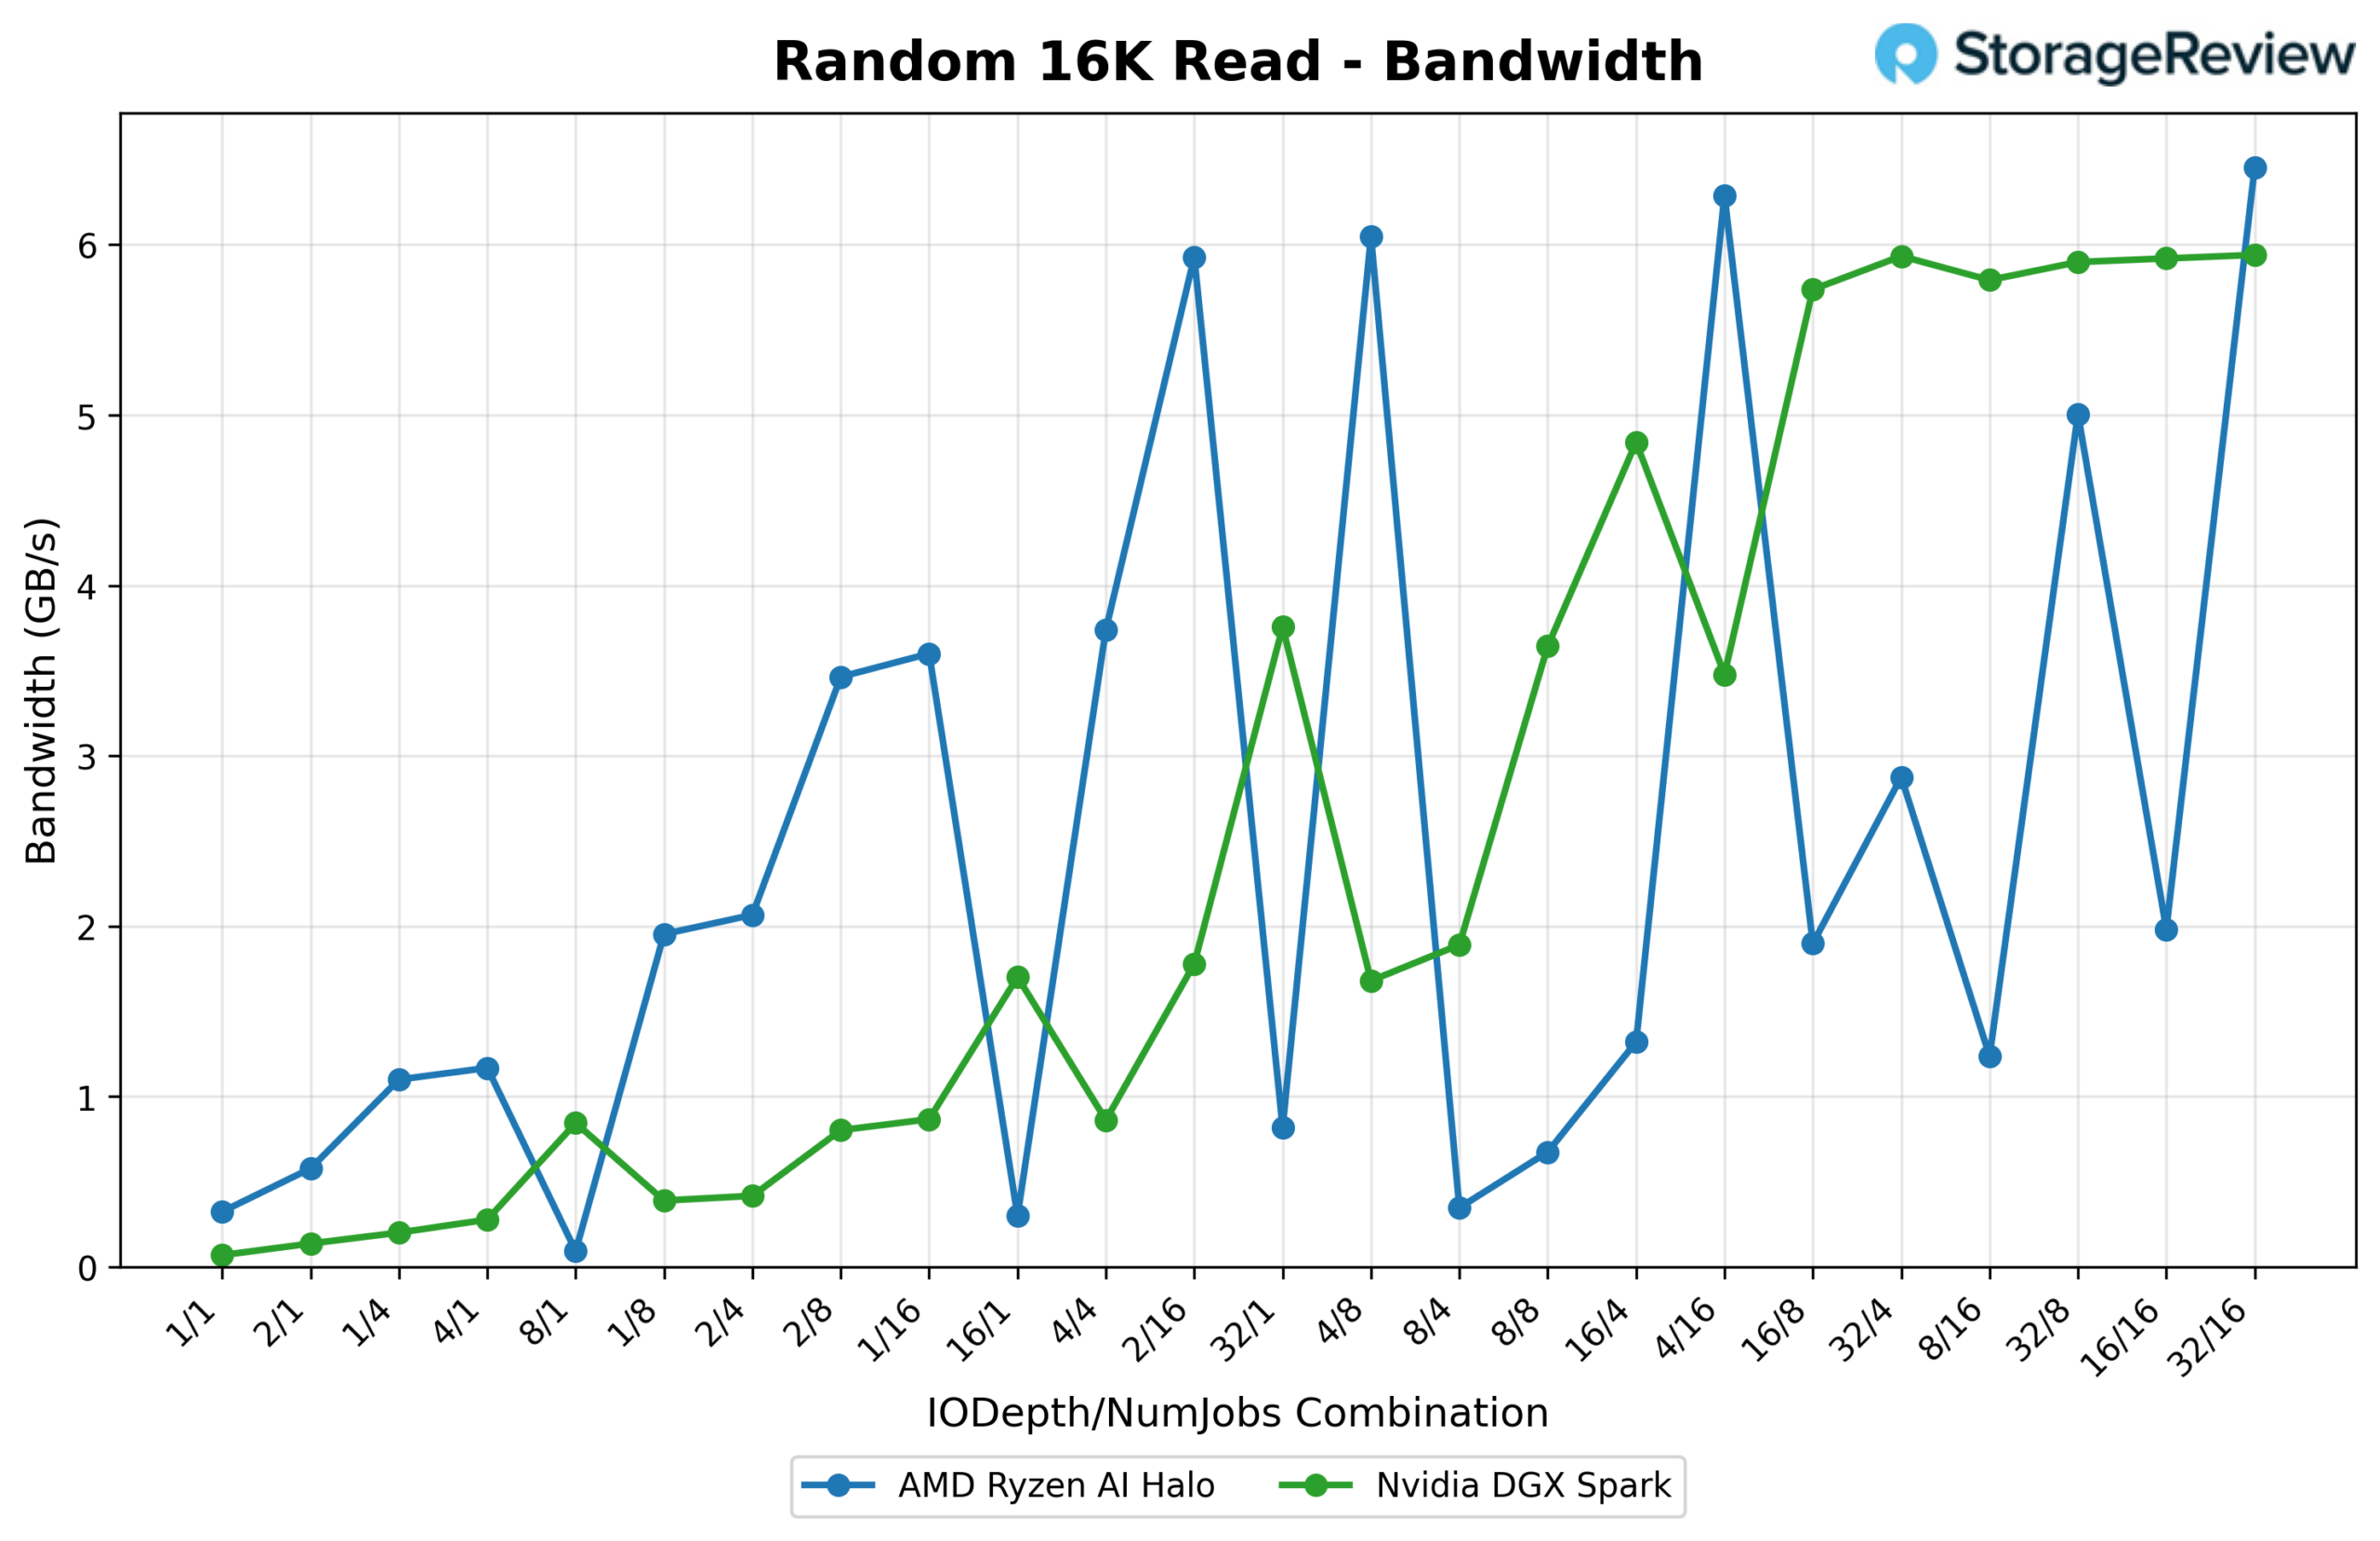
這是 Halo 表現較好的一次。在 32/16 配置下,它的峰值頻寬達到了 6,609.4 MB/s(423.0K IOPS),高於 Spark 在相同配置下的 6,082.6 MB/s(389.3K IOPS)。
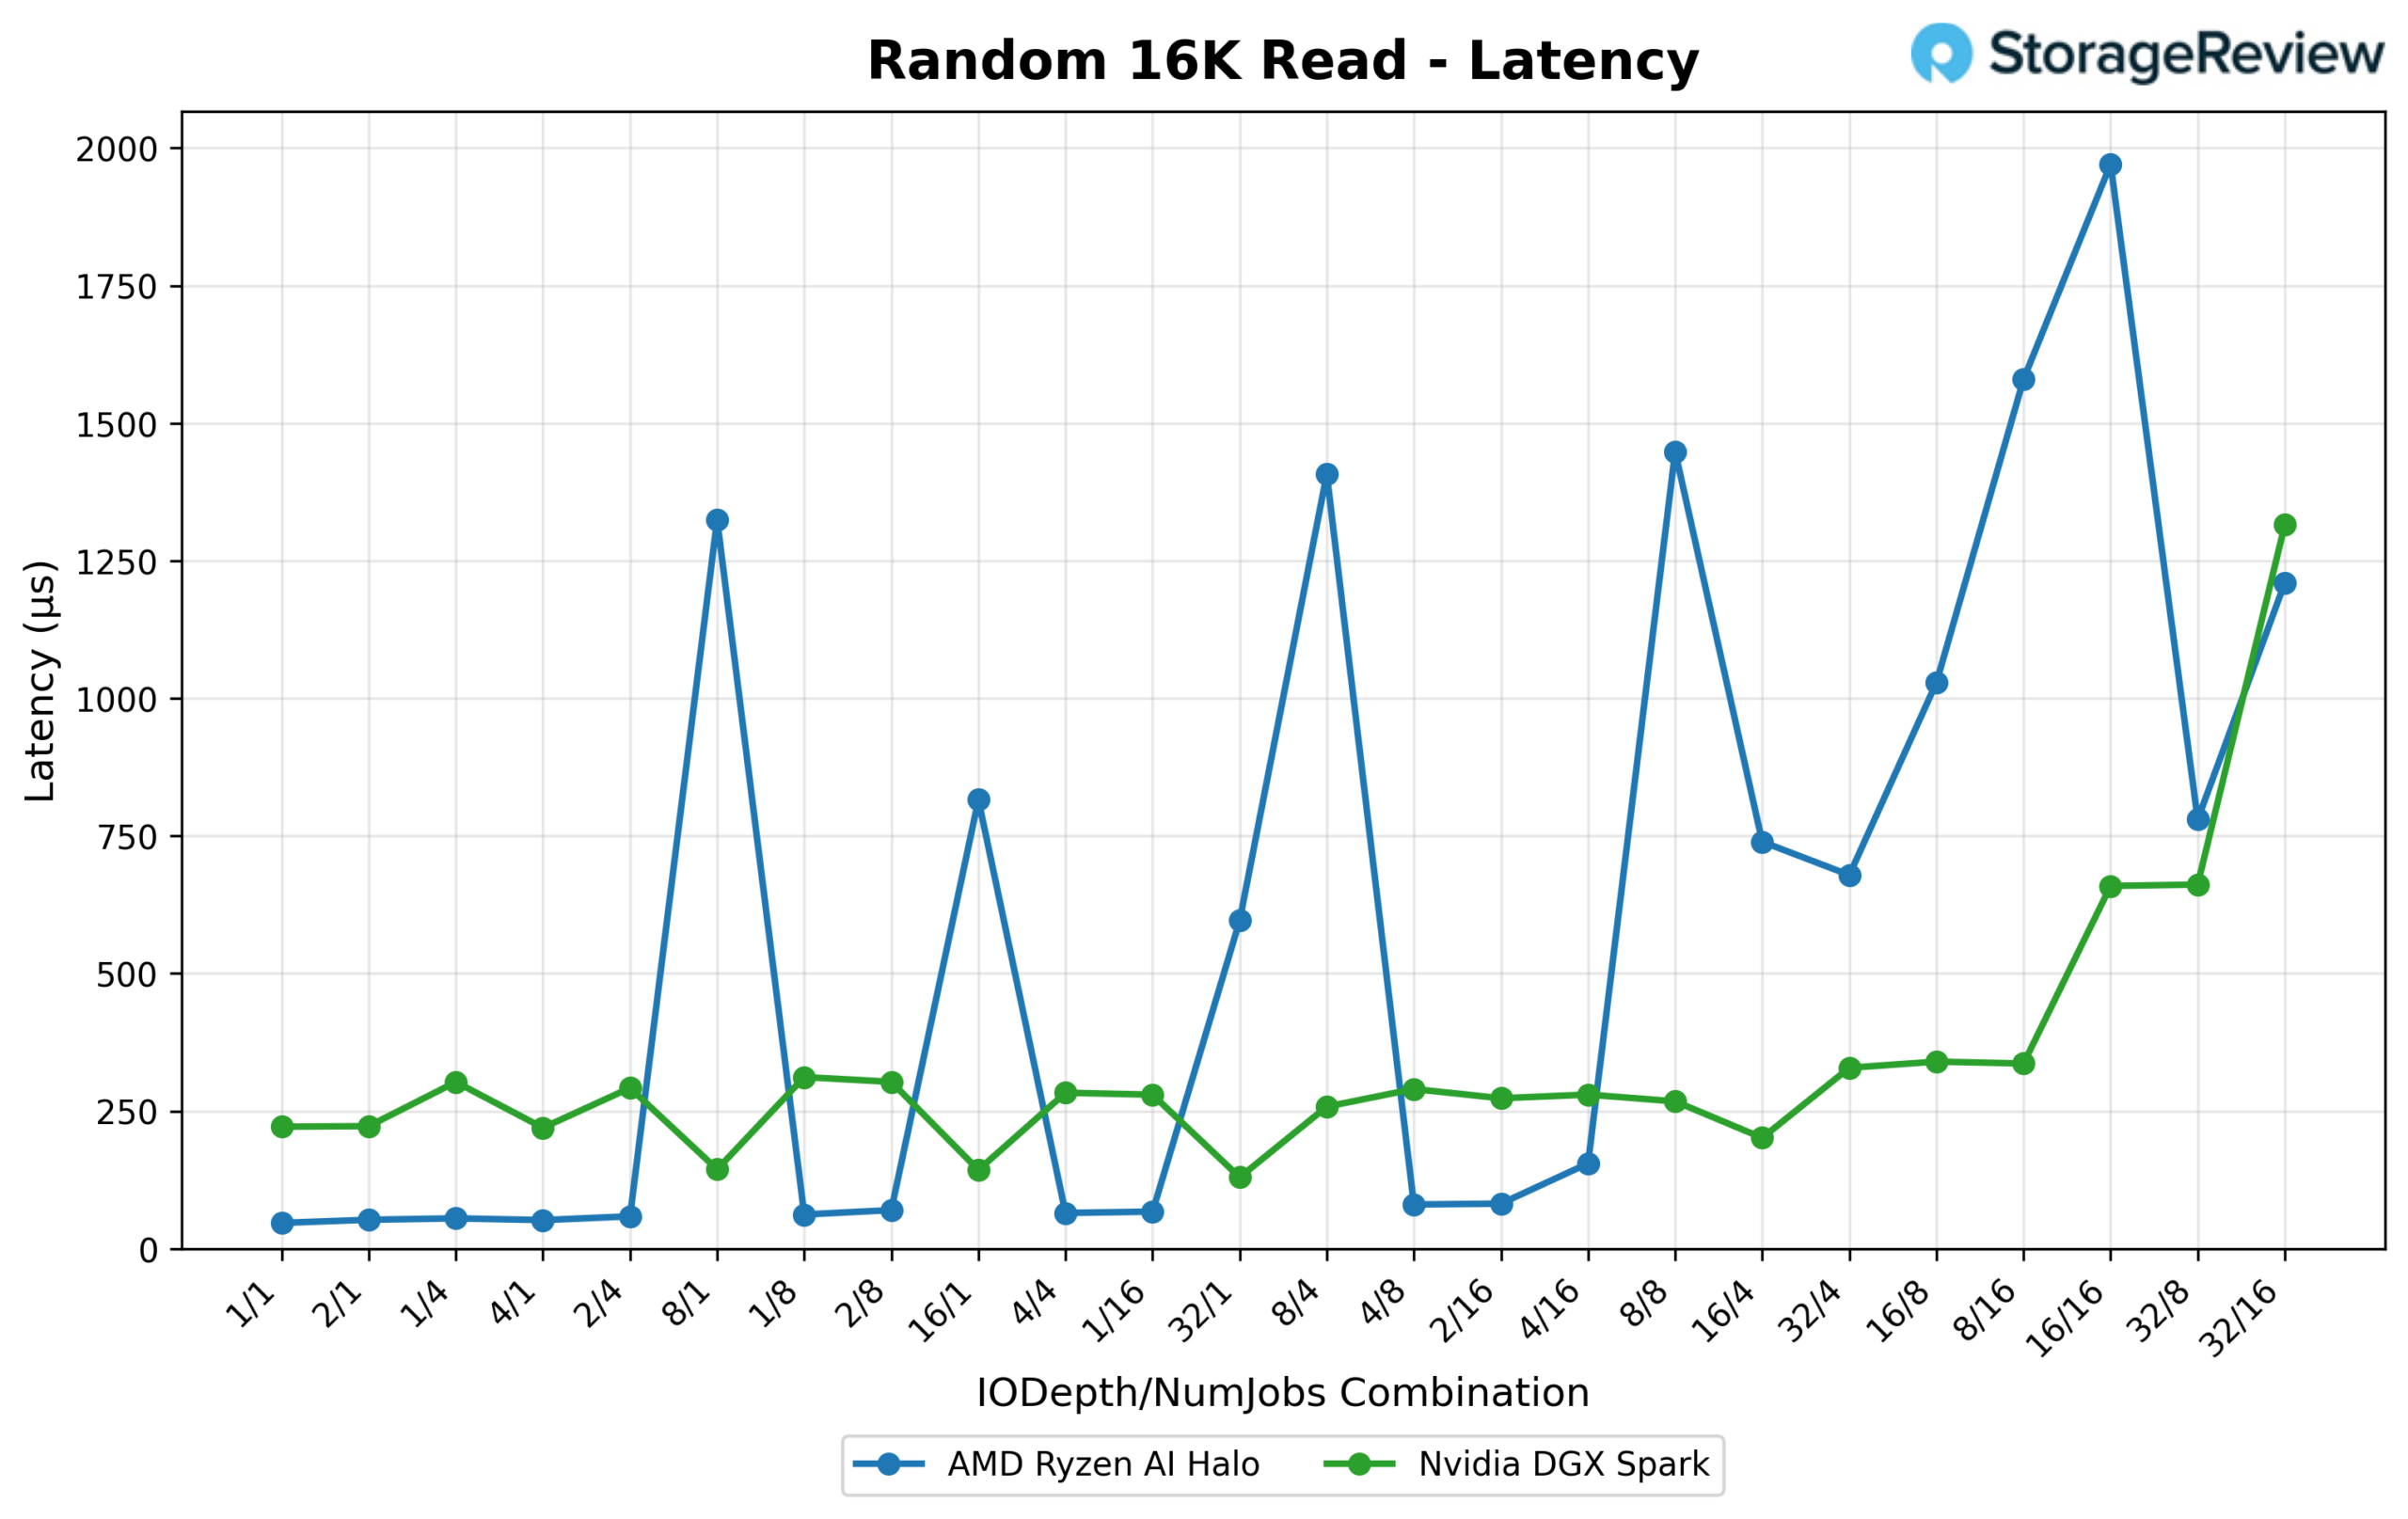
延遲方面,Halo 的初始延遲優勢非常明顯(1/1 佇列時為 0.047 毫秒,而 Spark 為 0.222 毫秒)。然而,Halo 的延遲曲線在整個測試過程中波動更大,在 8/1、16/1、8/4 和 8/8 隊列深度處出現明顯的峰值,遠高於 Spark 相對平滑(儘管基線更高)的曲線。在隊列深度最高時,Halo 的峰值延遲為 1.971 毫秒(16/16 隊列深度),超過了 Spark 的峰值延遲 1.315 毫秒(32/16 隊列深度),因此 Halo 犧牲了穩定性,換取了低隊列深度下的極快速度。
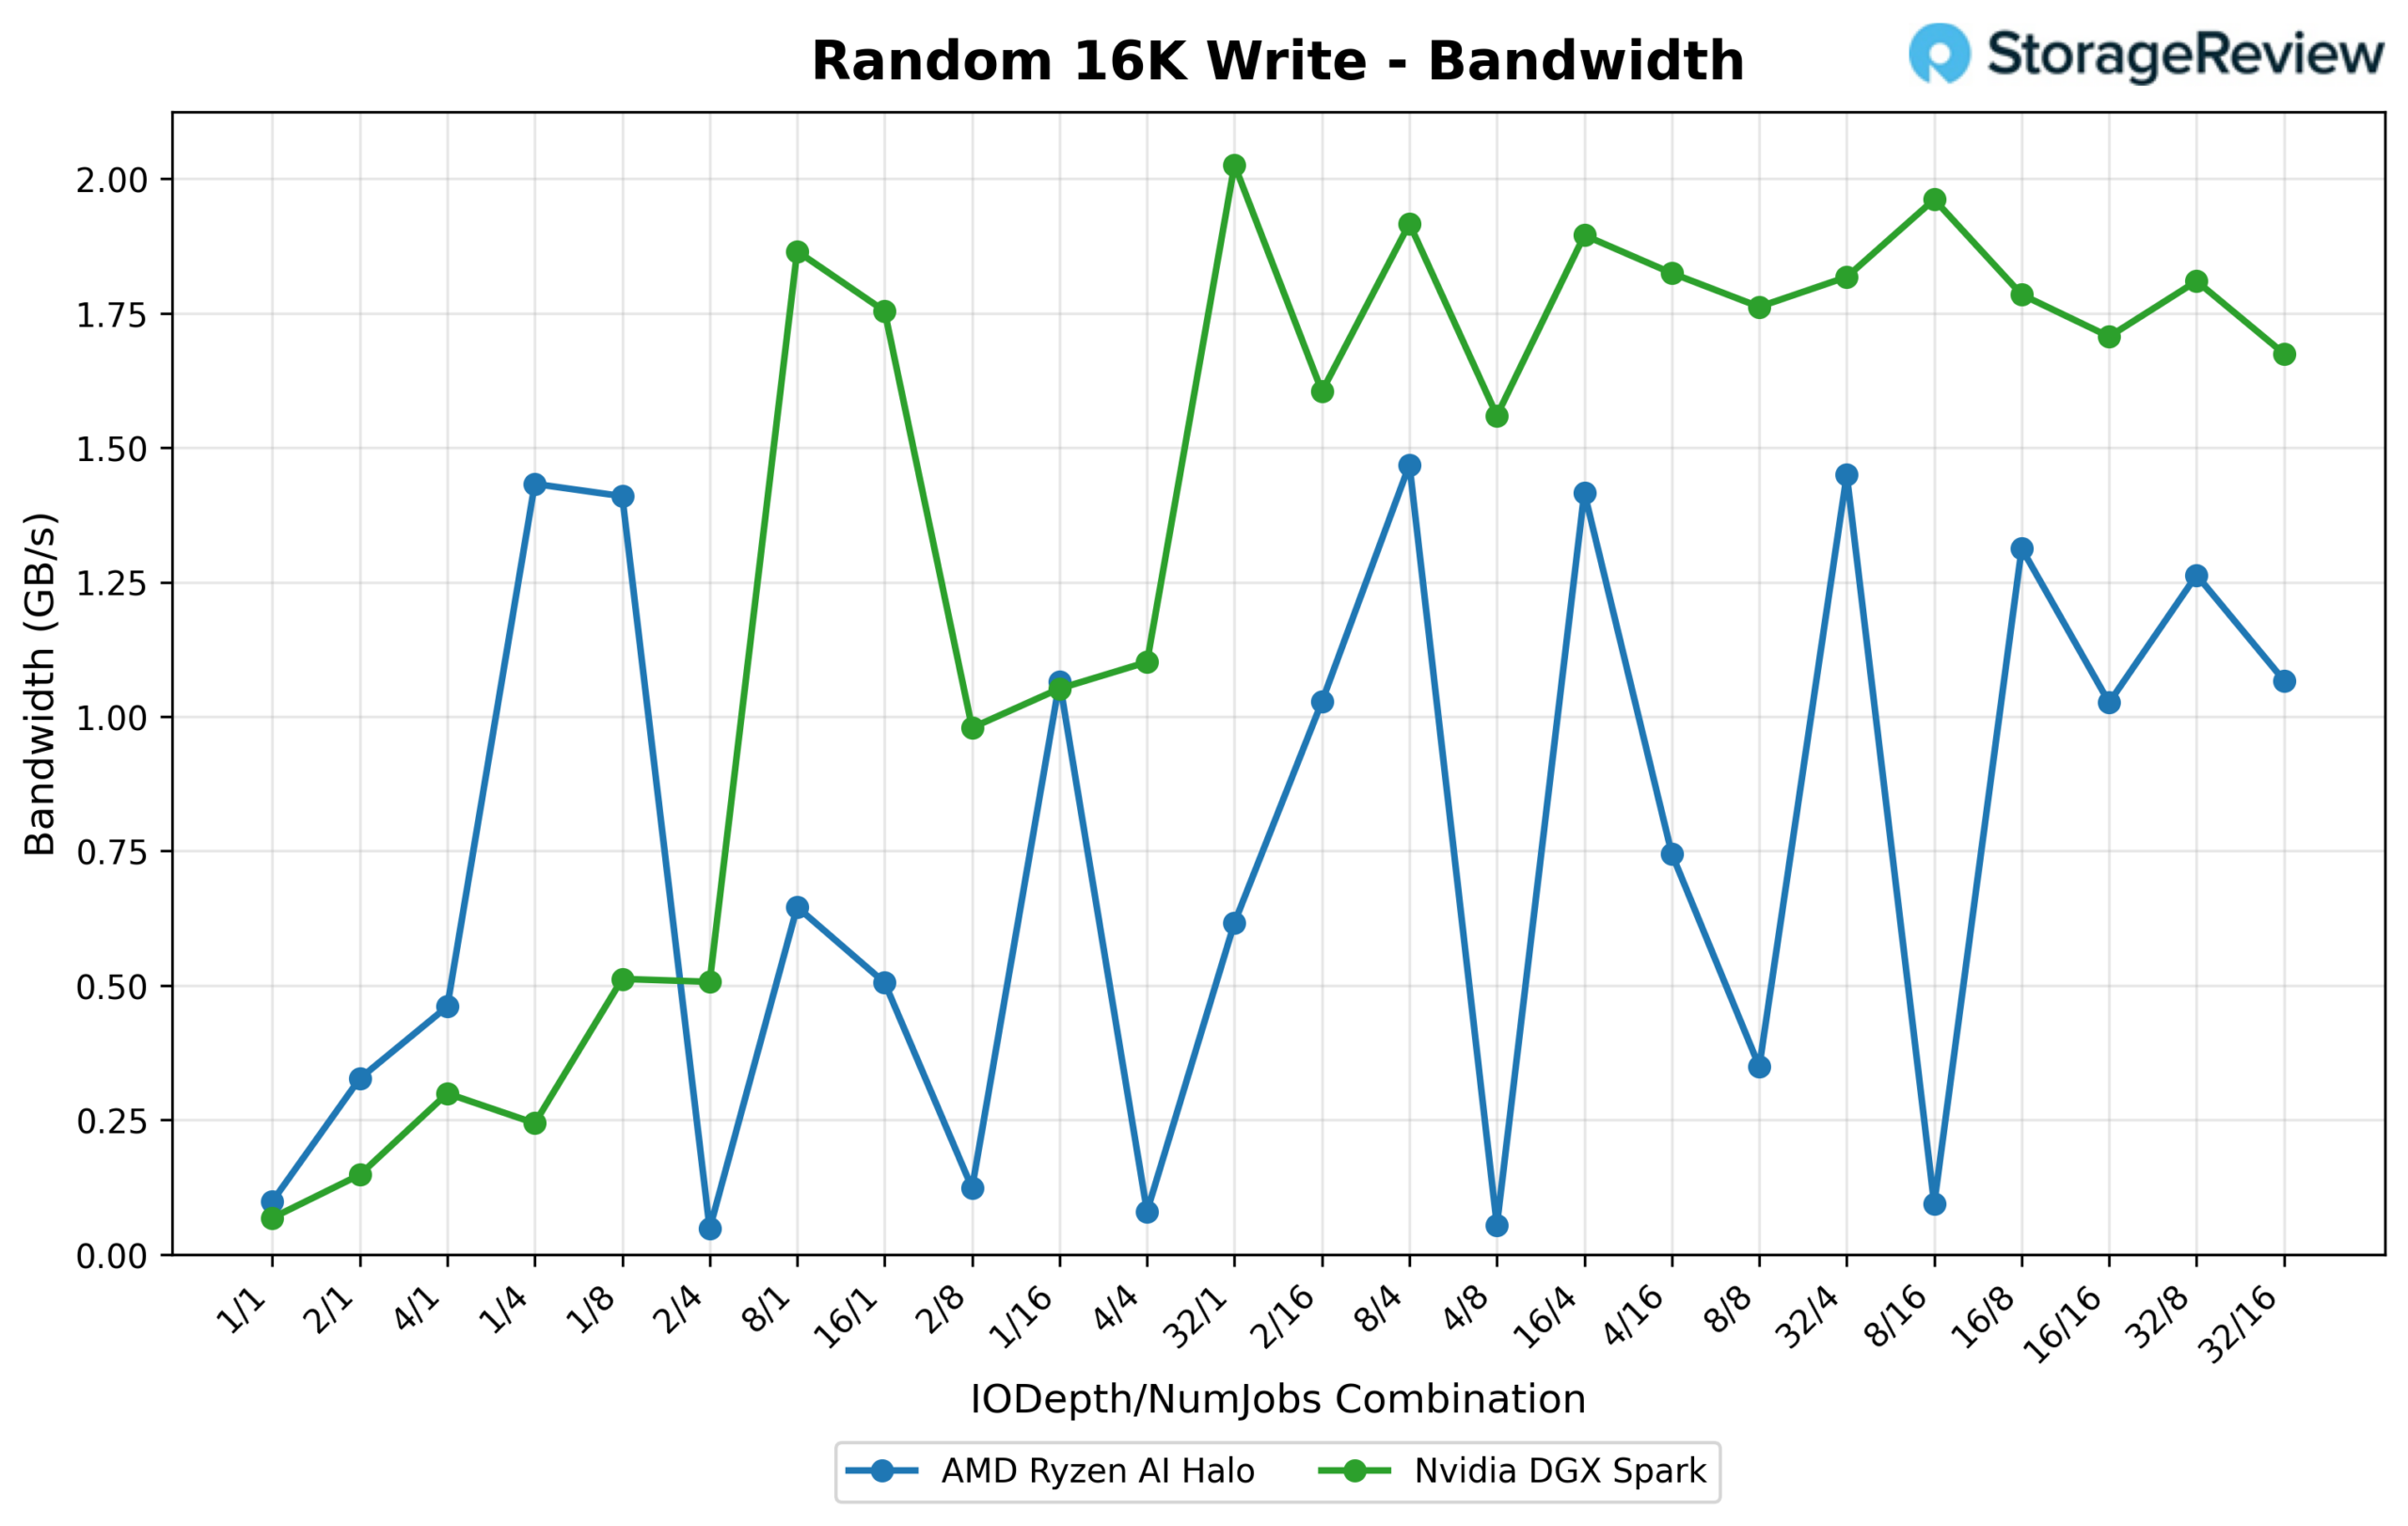
16K 隨機寫入
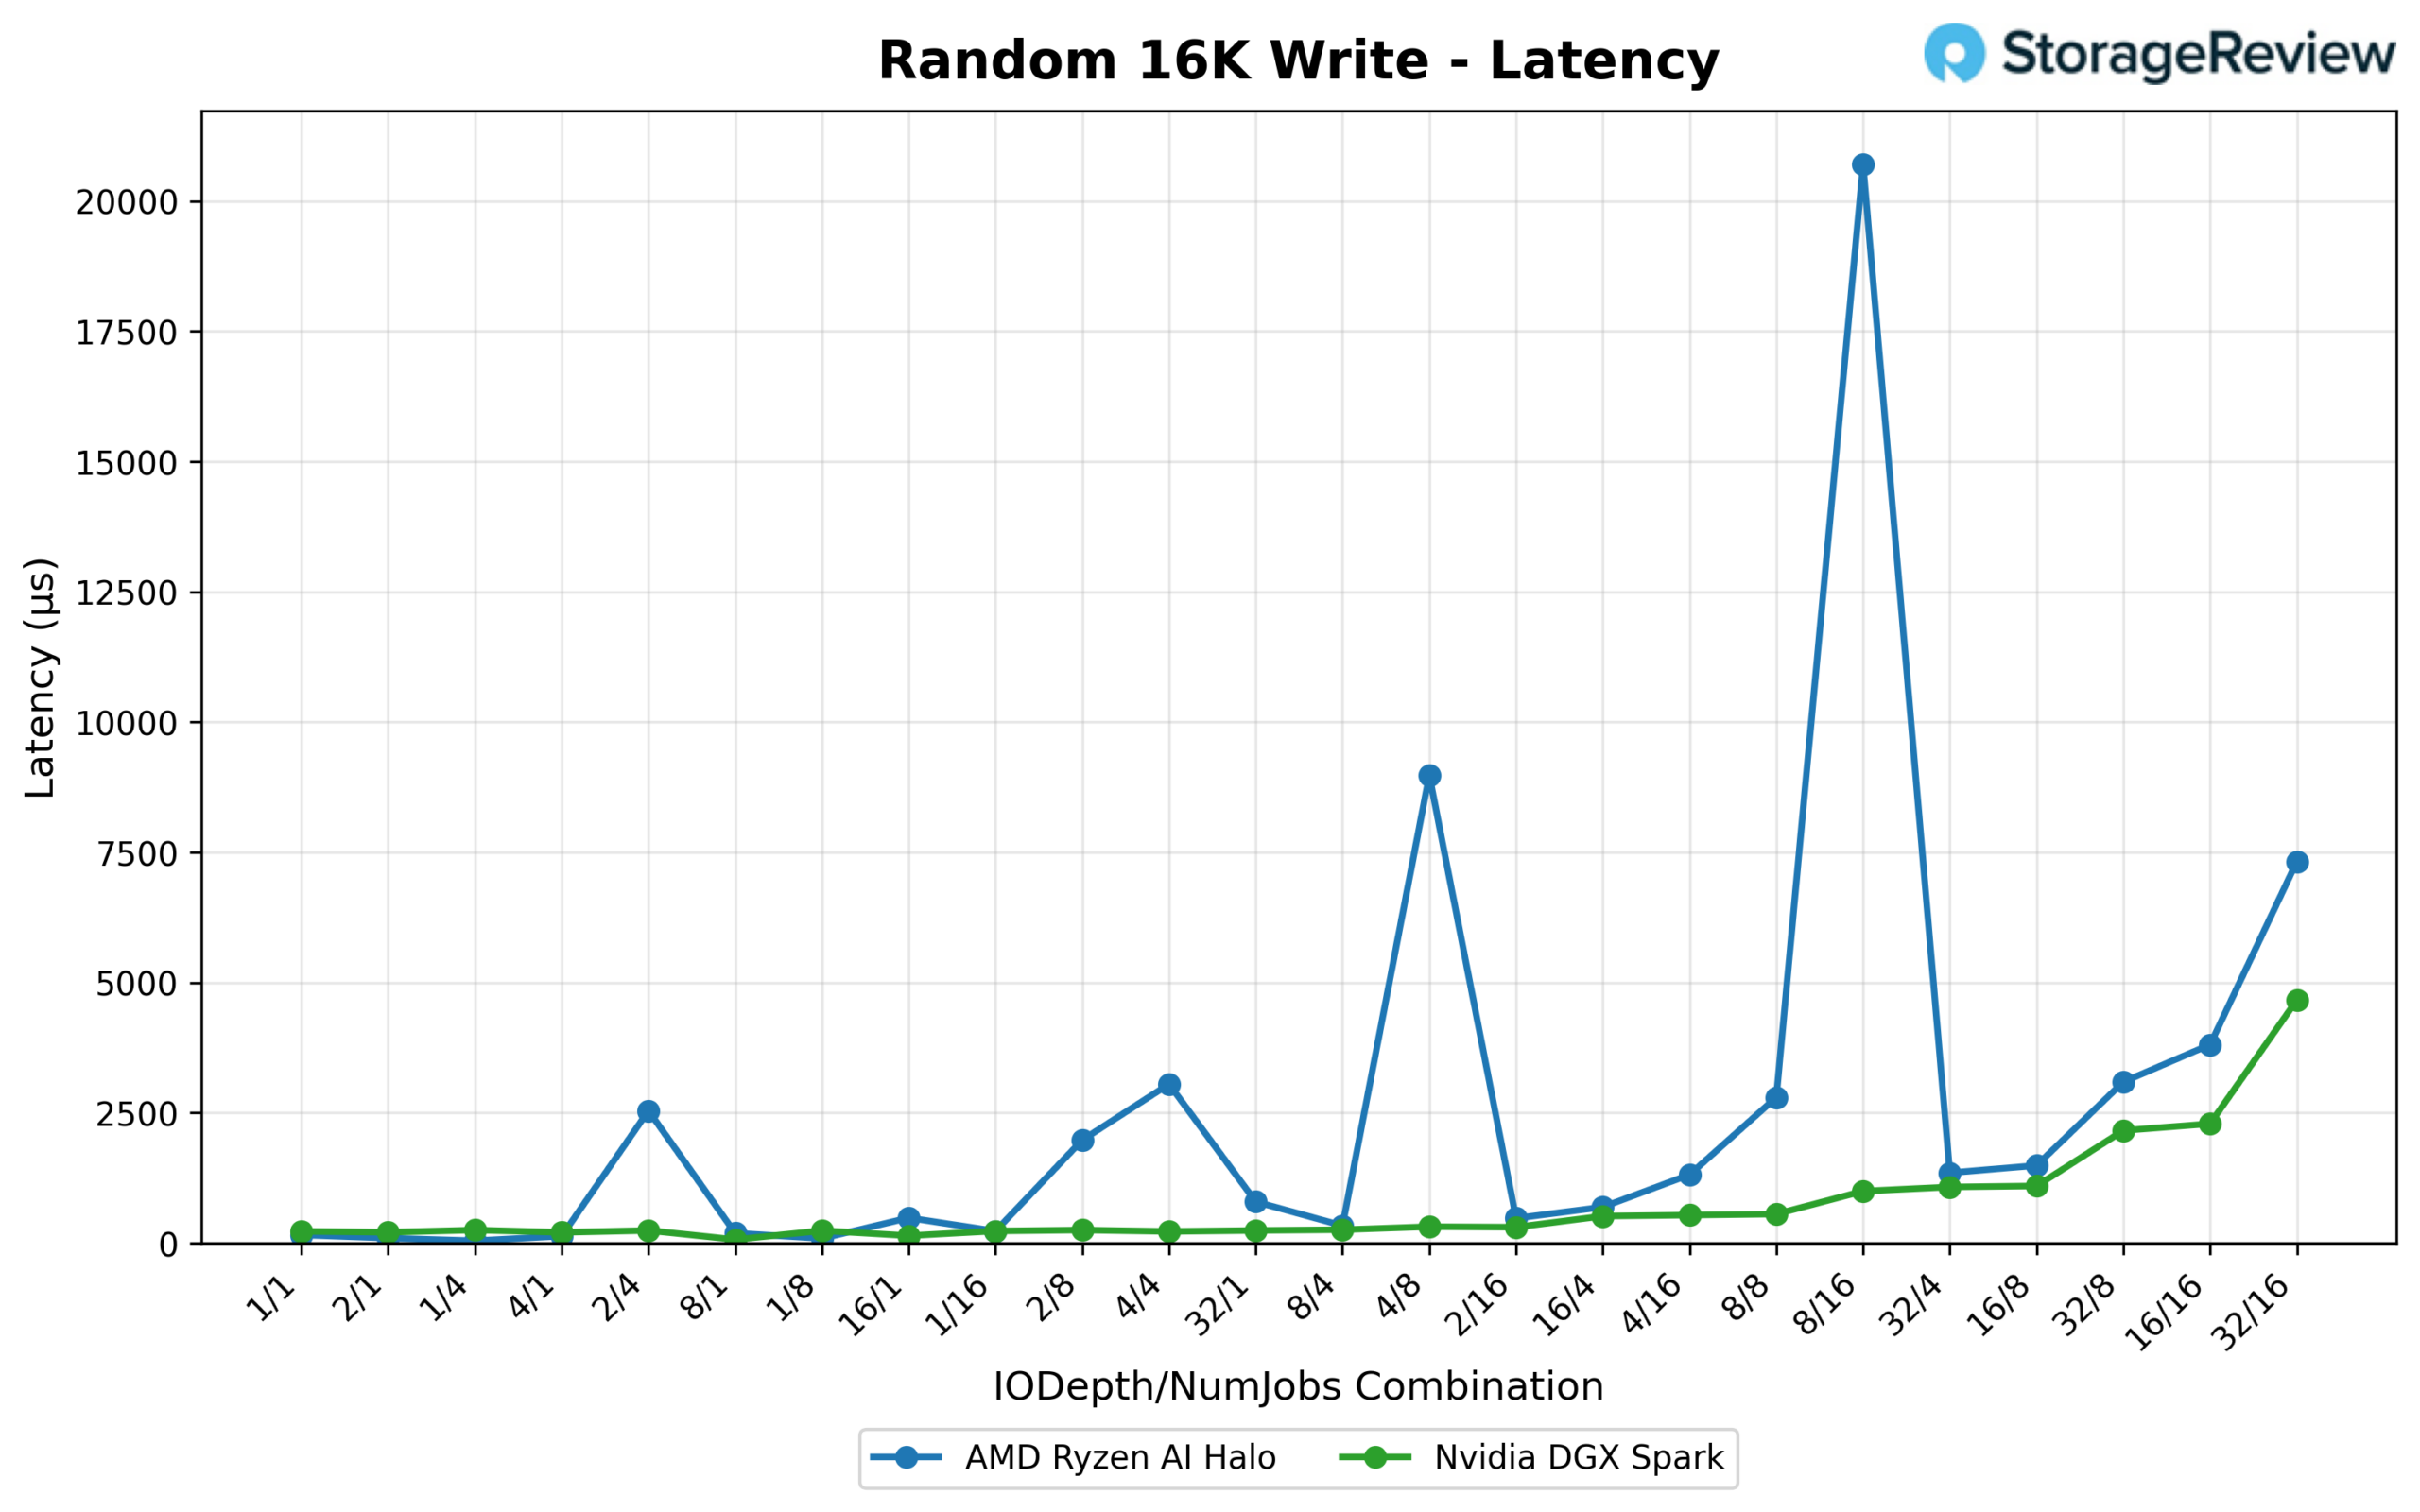
頻寬方面,Spark 更勝一籌,在 32/1 的記憶體配置下,其頻寬可達 2,074.1 MB/s(132.7K IOPS),而 Halo 在 8/4 的記憶體配置下僅為 1,503.5 MB/s(96.2K IOPS)。 Spark 的頻寬曲線也更穩定,在初始上升期之後的大部分測試時間內,頻寬都保持在 1.6–2.0 GB/s 的範圍內。相較之下,Halo 的頻寬在不同記憶體配置下波動較大,大約在 0.1 到 1.5 GB/s 之間。
延遲是本次測試的亮點:Halo 在 1/1 執行緒時延遲較低(0.154 毫秒 vs. 0.224 毫秒),但在 8/16 執行緒時,其平均延遲飆升至驚人的 20.698 毫秒,幾乎是 Spark 在整個測試過程中最差延遲(4.664 毫秒)的 4.5 倍。除了這個峰值之外,Halo 的延遲表現尚可,但對於任何可能在該特定線程深度/線程組合下運行的工作負載而言,這都是一個值得注意的顯著異常值。
4K 隨機讀取
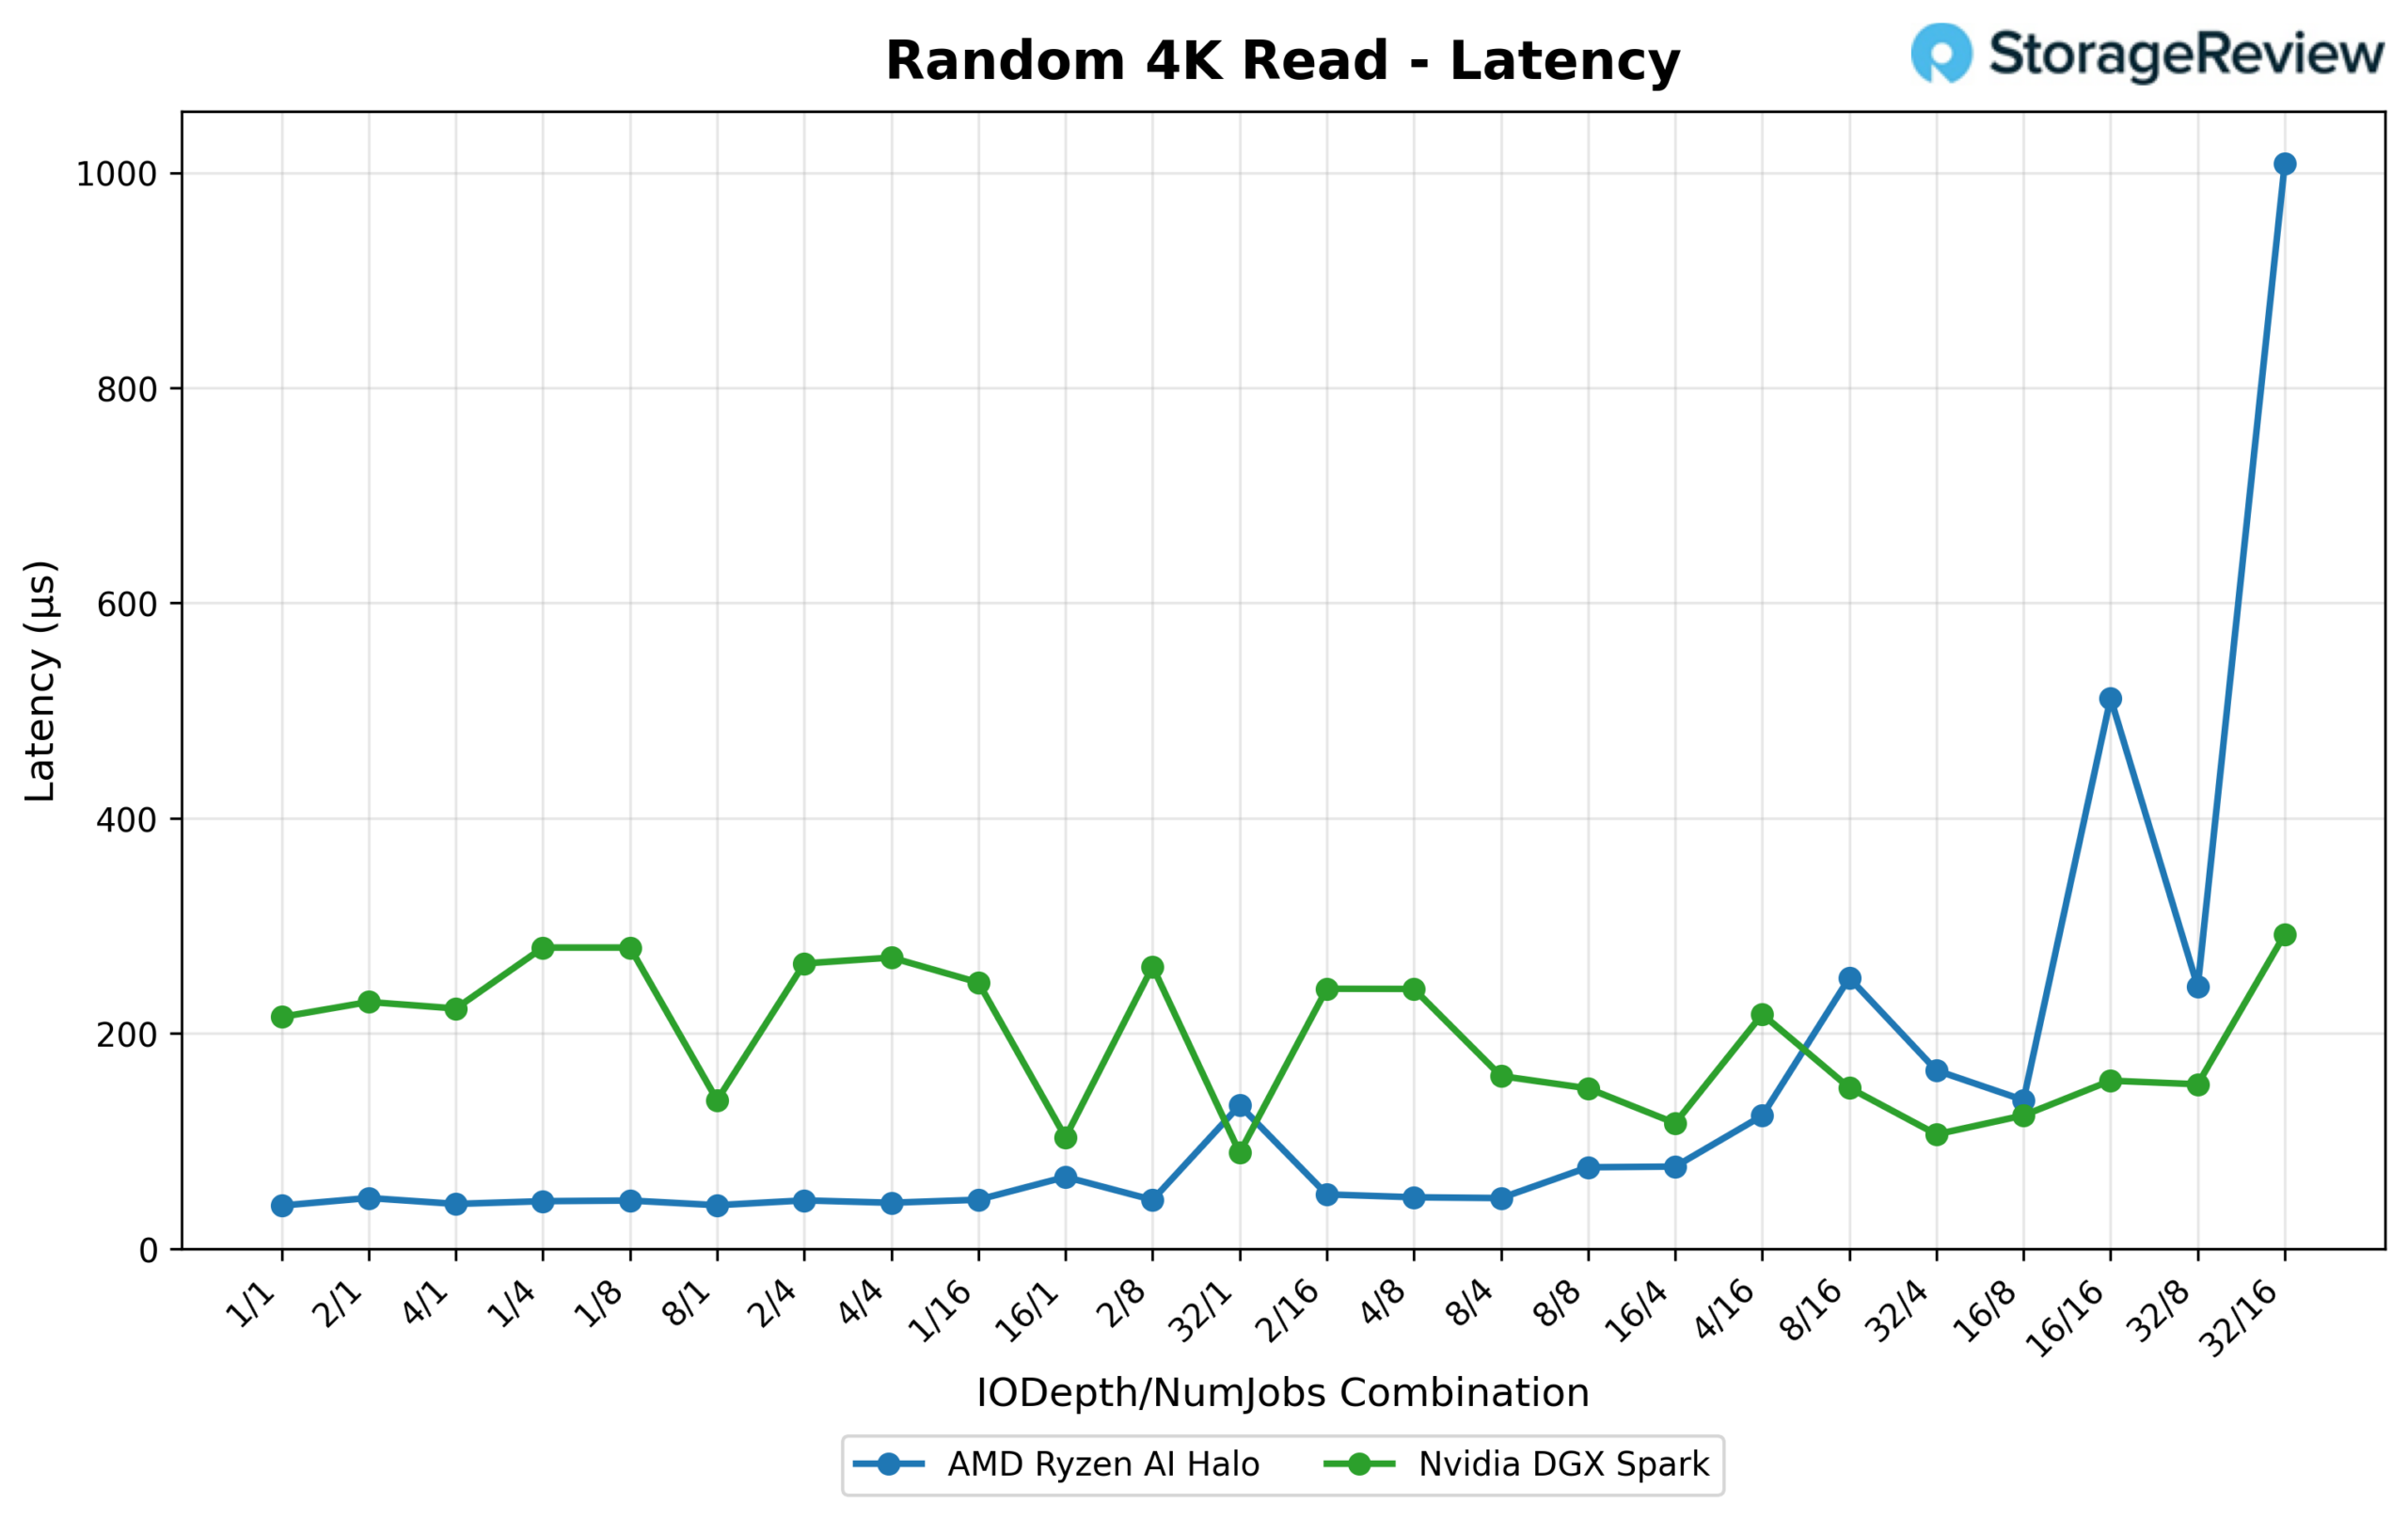
在低佇列深度下,Halo 的反應速度明顯更快(1/1 時為 0.04 毫秒,而 Spark 為 0.215 毫秒),並且在測試的大部分中低延遲範圍內都保持著延遲優勢。但 Spark 在大規模吞吐量方面則遙遙領先:其在 32/16 佇列深度下的峰值 IOPS 達到 1,750.7K(6,838.8 MB/s),遠超 Halo 在 32/8 佇列深度下的峰值 1,050.4K IOPS(4,103.2 MB/s)。
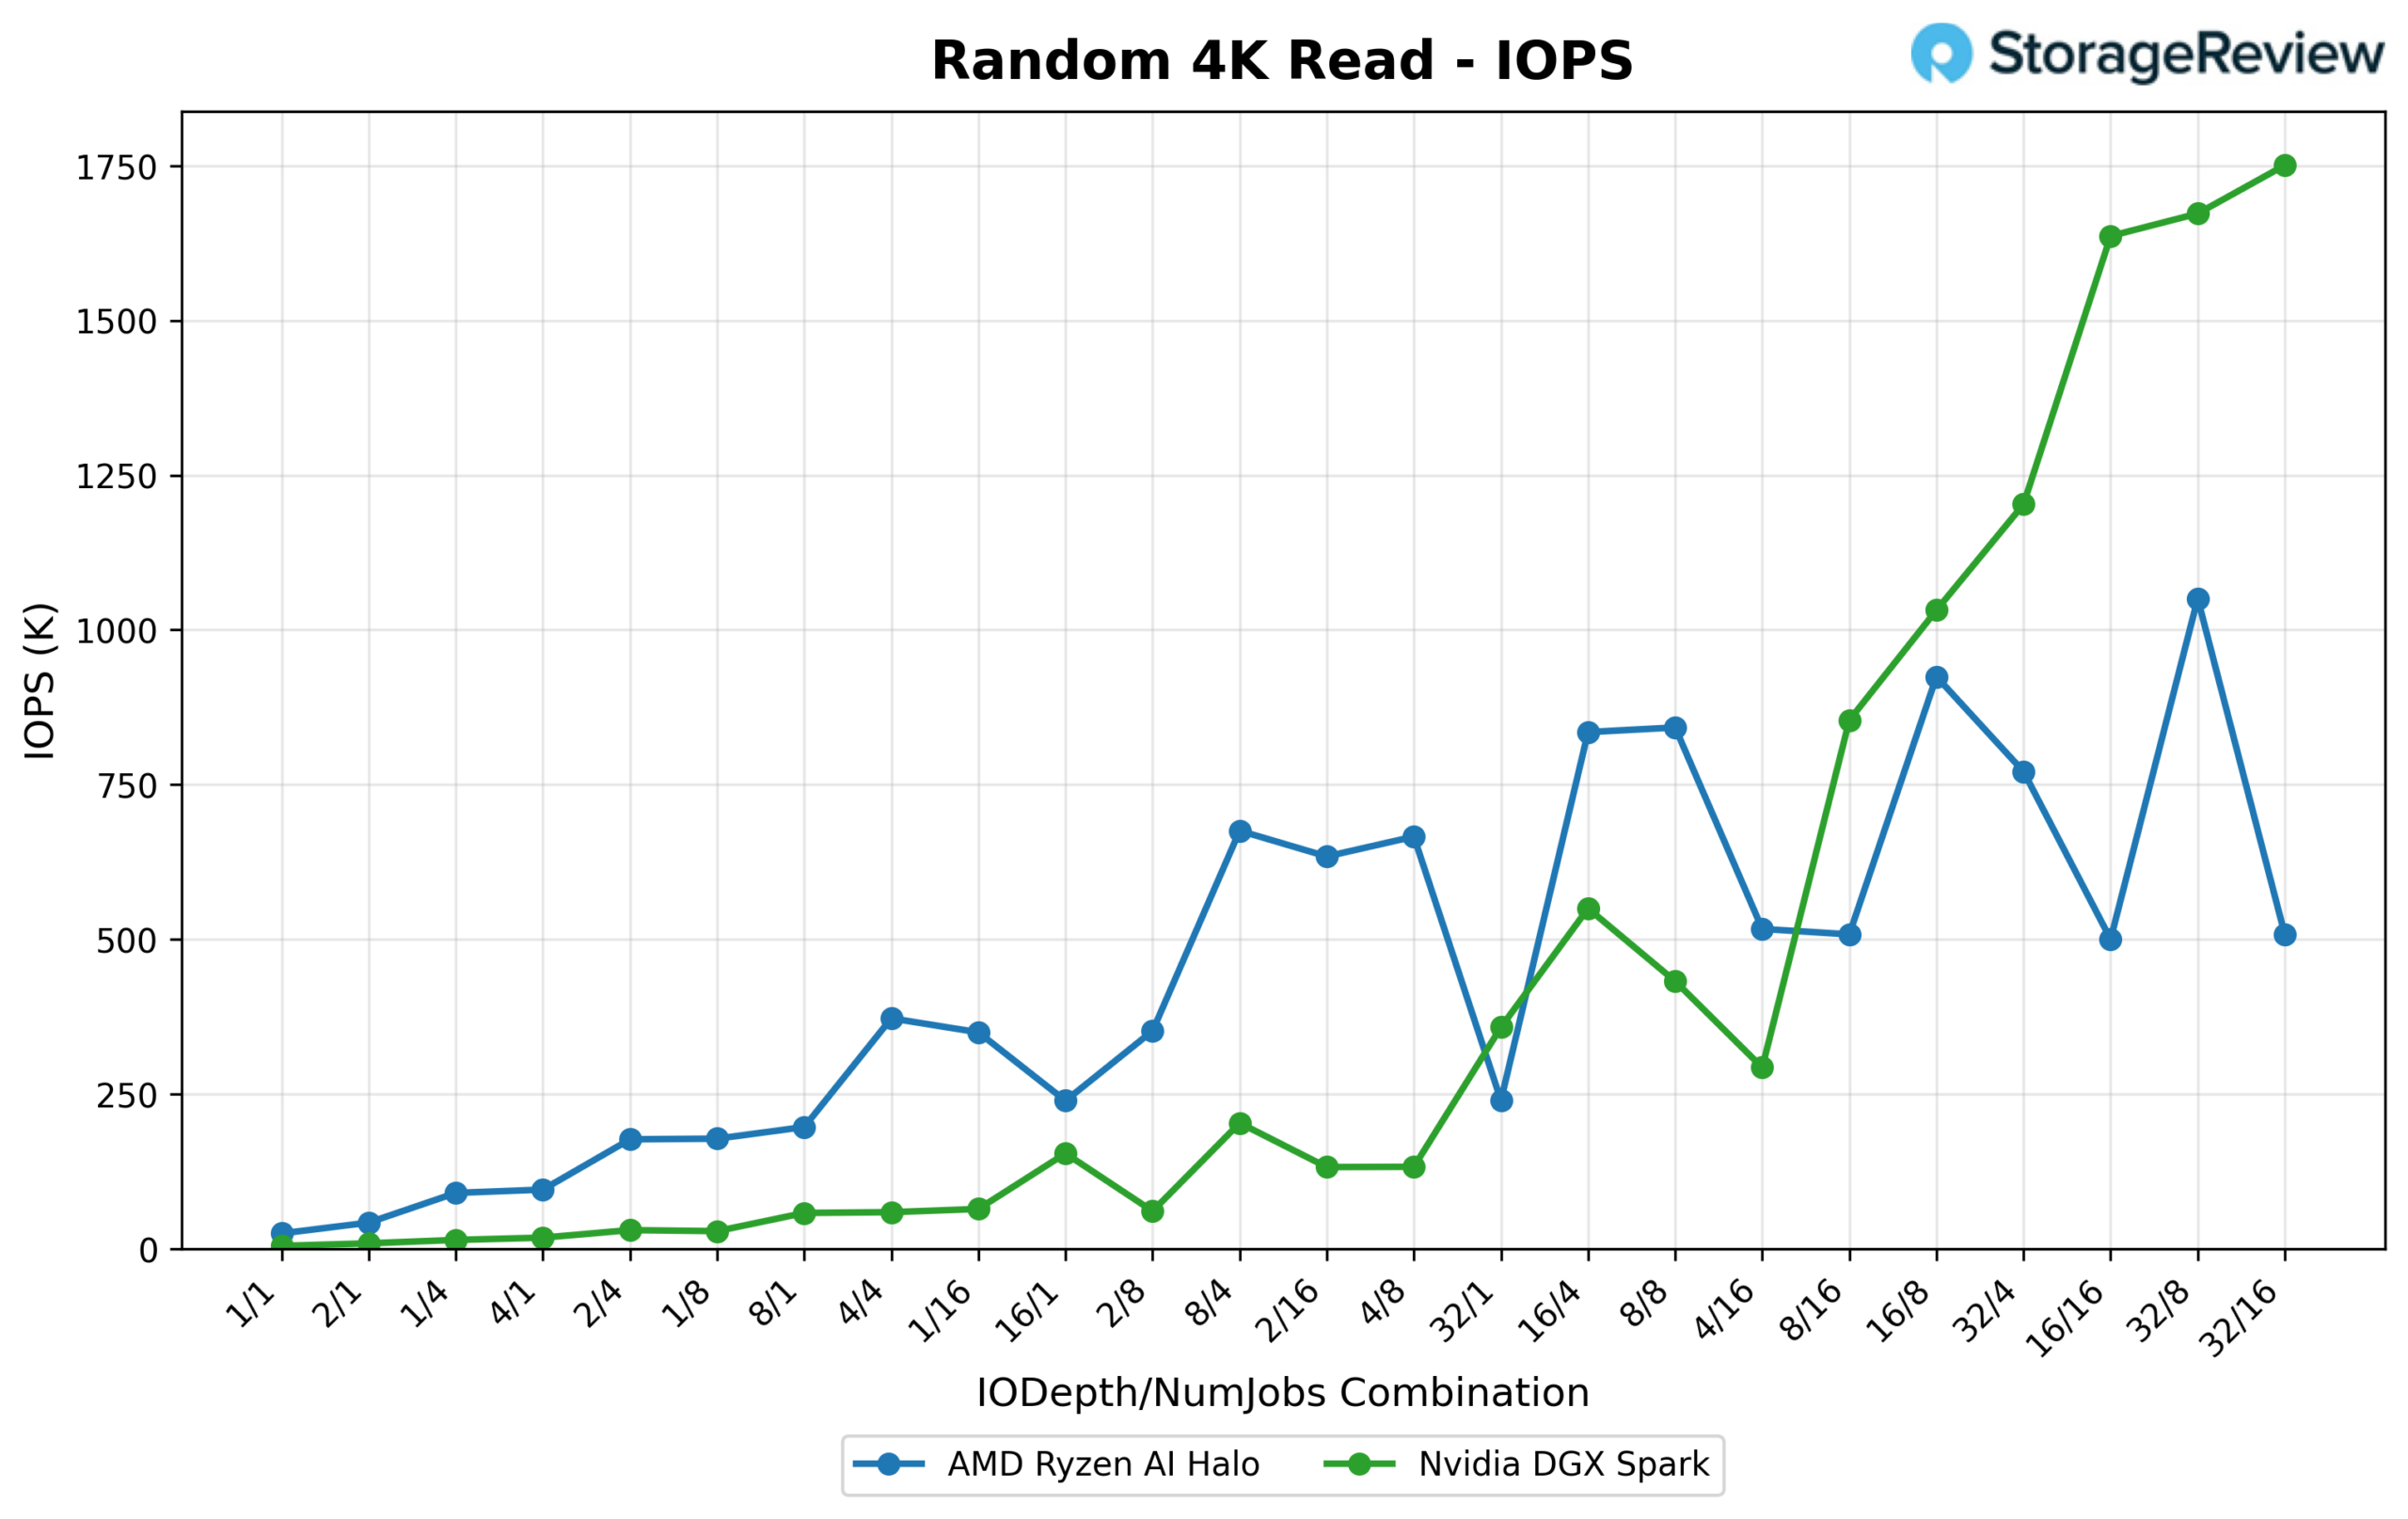
有趣的是,在高隊列深度下,延遲情況發生了逆轉。即使佇列深度和執行緒數增加,Spark 的延遲曲線仍然相對穩定,峰值僅為 0.292 毫秒。相較之下,Halo 在隊列深度為 16/16 時(0.513 毫秒)和 32/16 時(1.009 毫秒)出現急劇上升,超過其穩態基線值的 3 倍以上,這意味著其在低隊列深度下出色的響應能力並不能延續到隊列深度達到飽和狀態。
4K 隨機寫入
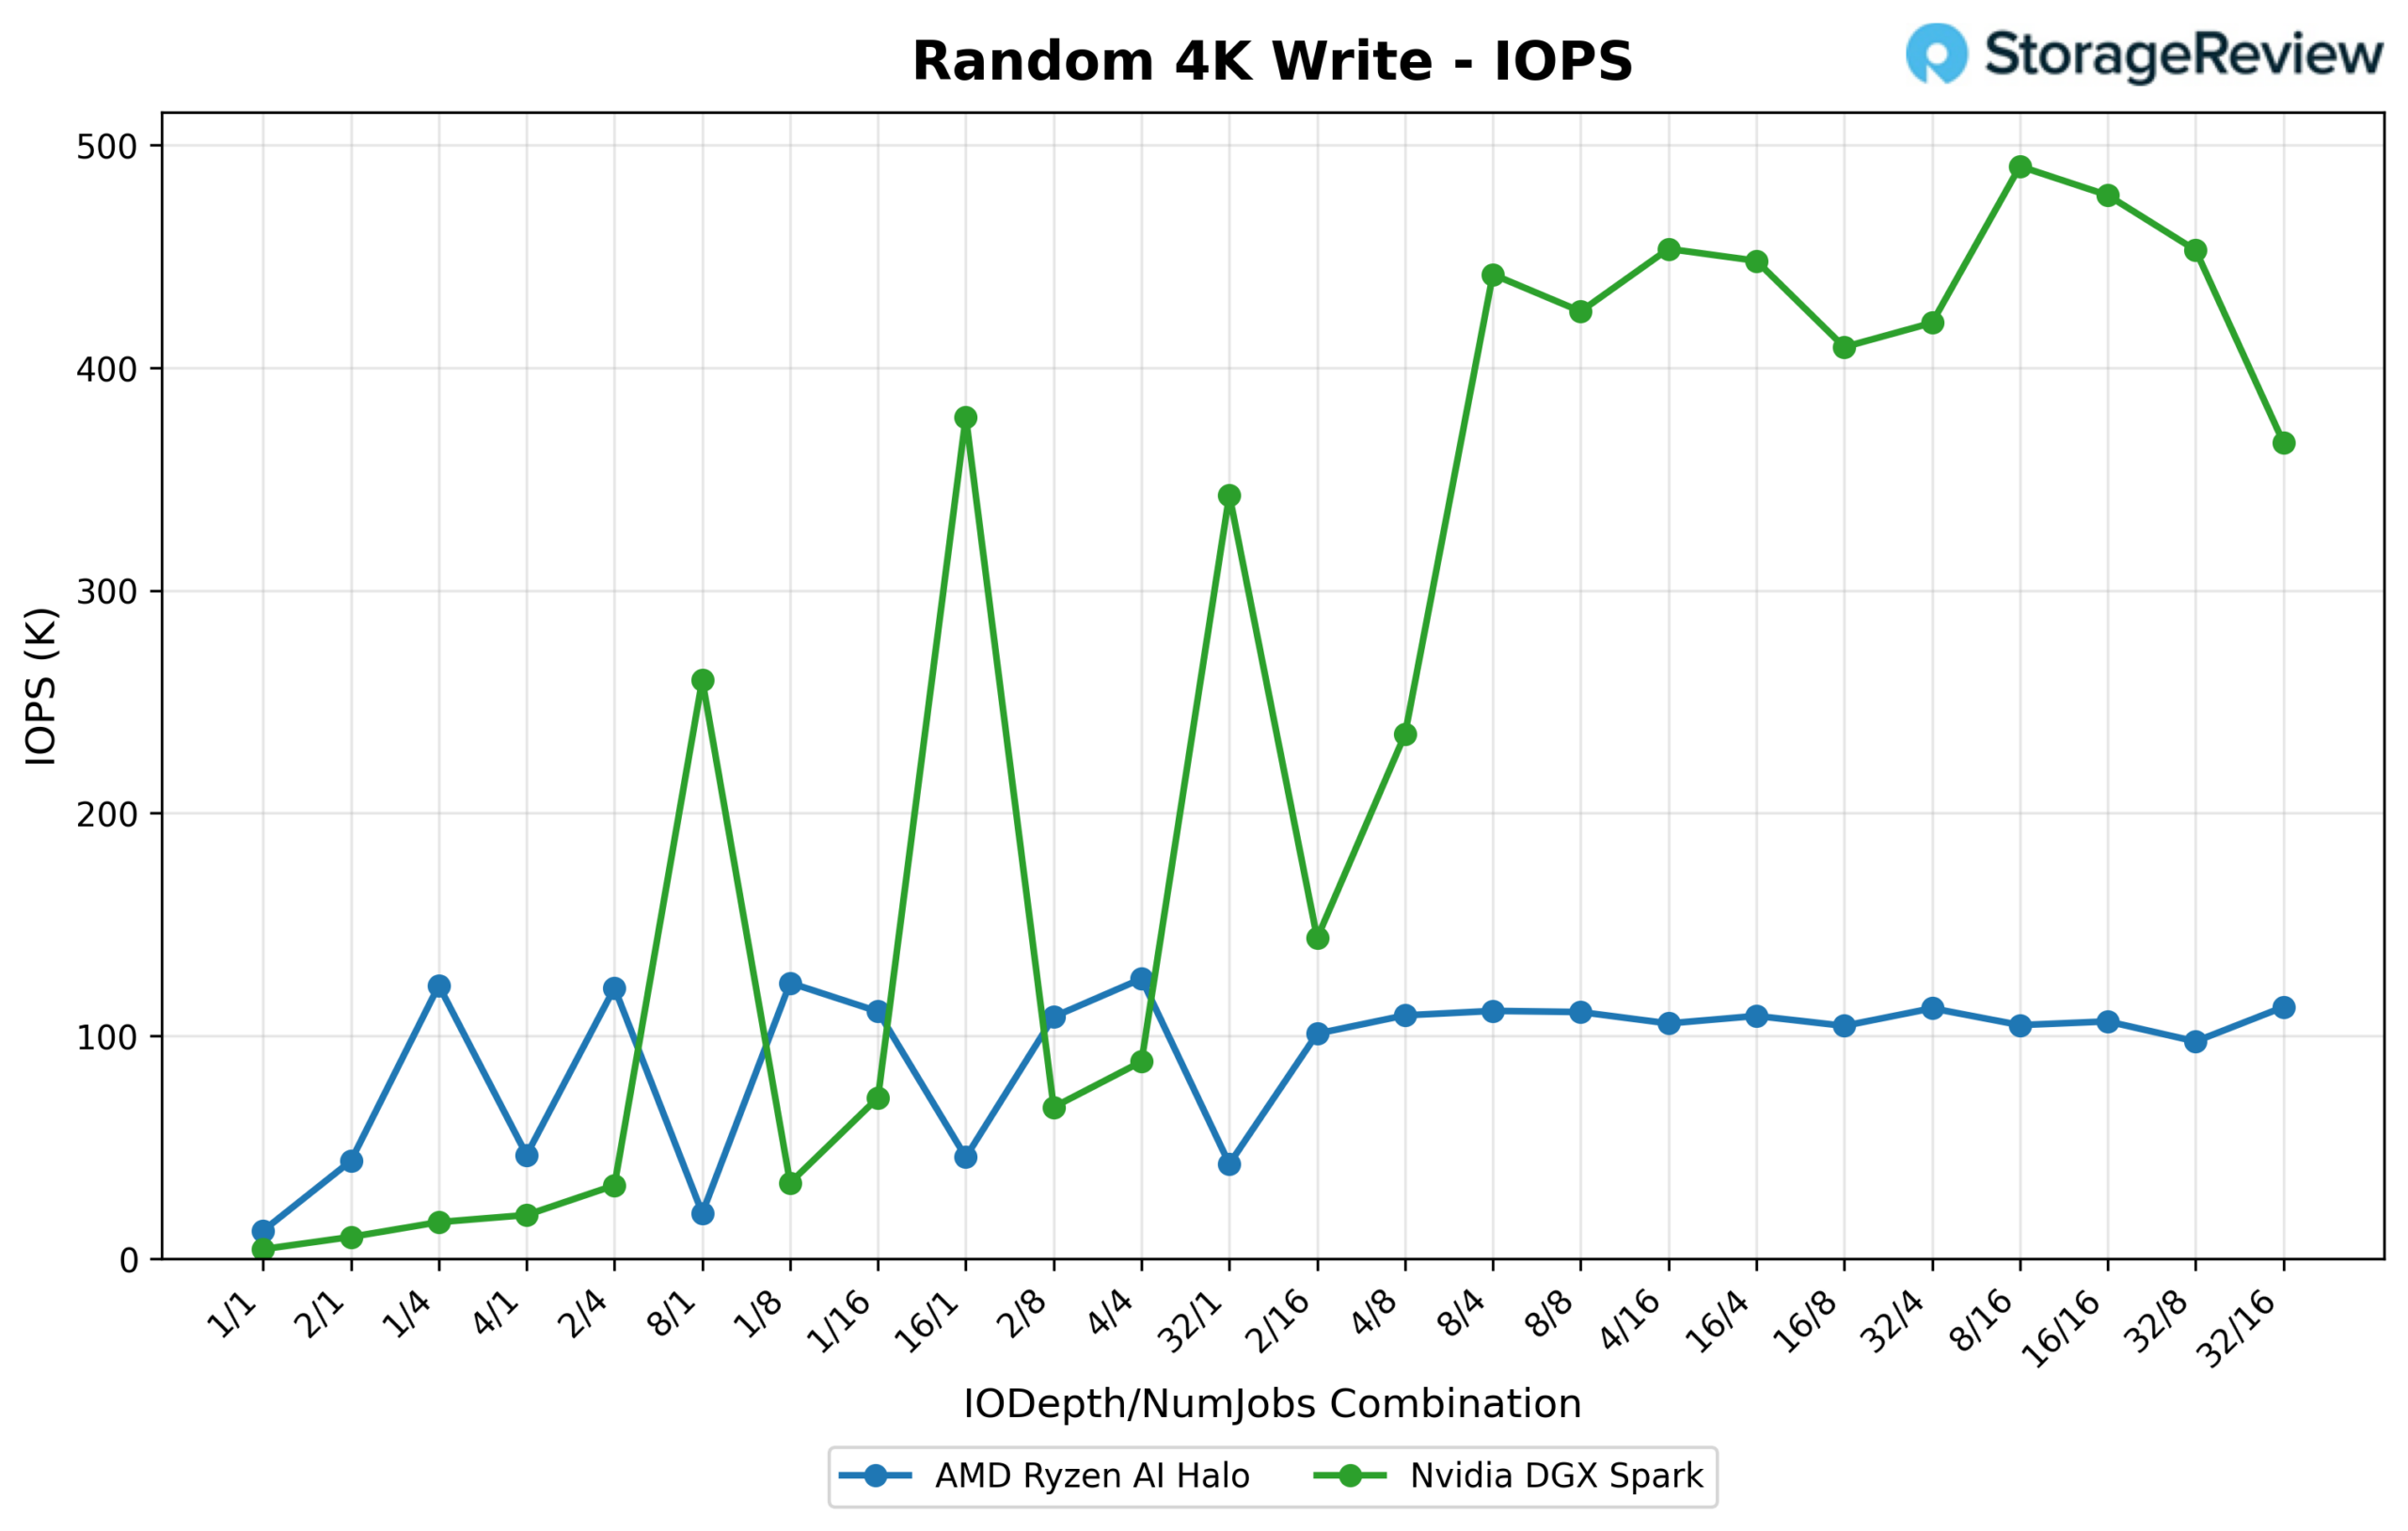
這是本次測試中 IOPS 差距最大的一次。 Spark 的隨機 4K 寫入效能隨著佇列深度和執行緒數的增加而迅速提升,在 8/16 時達到 490.4K IOPS (1,915.6 MB/s)。而 Halo 的性能則更早達到瓶頸,且峰值也低得多,在 4/4 時僅為 125.6K IOPS (490.7 MB/s),之後在剩餘的測試中從未超過 110-115K IOPS。 Spark 的效能幾乎是 Halo 的四倍。
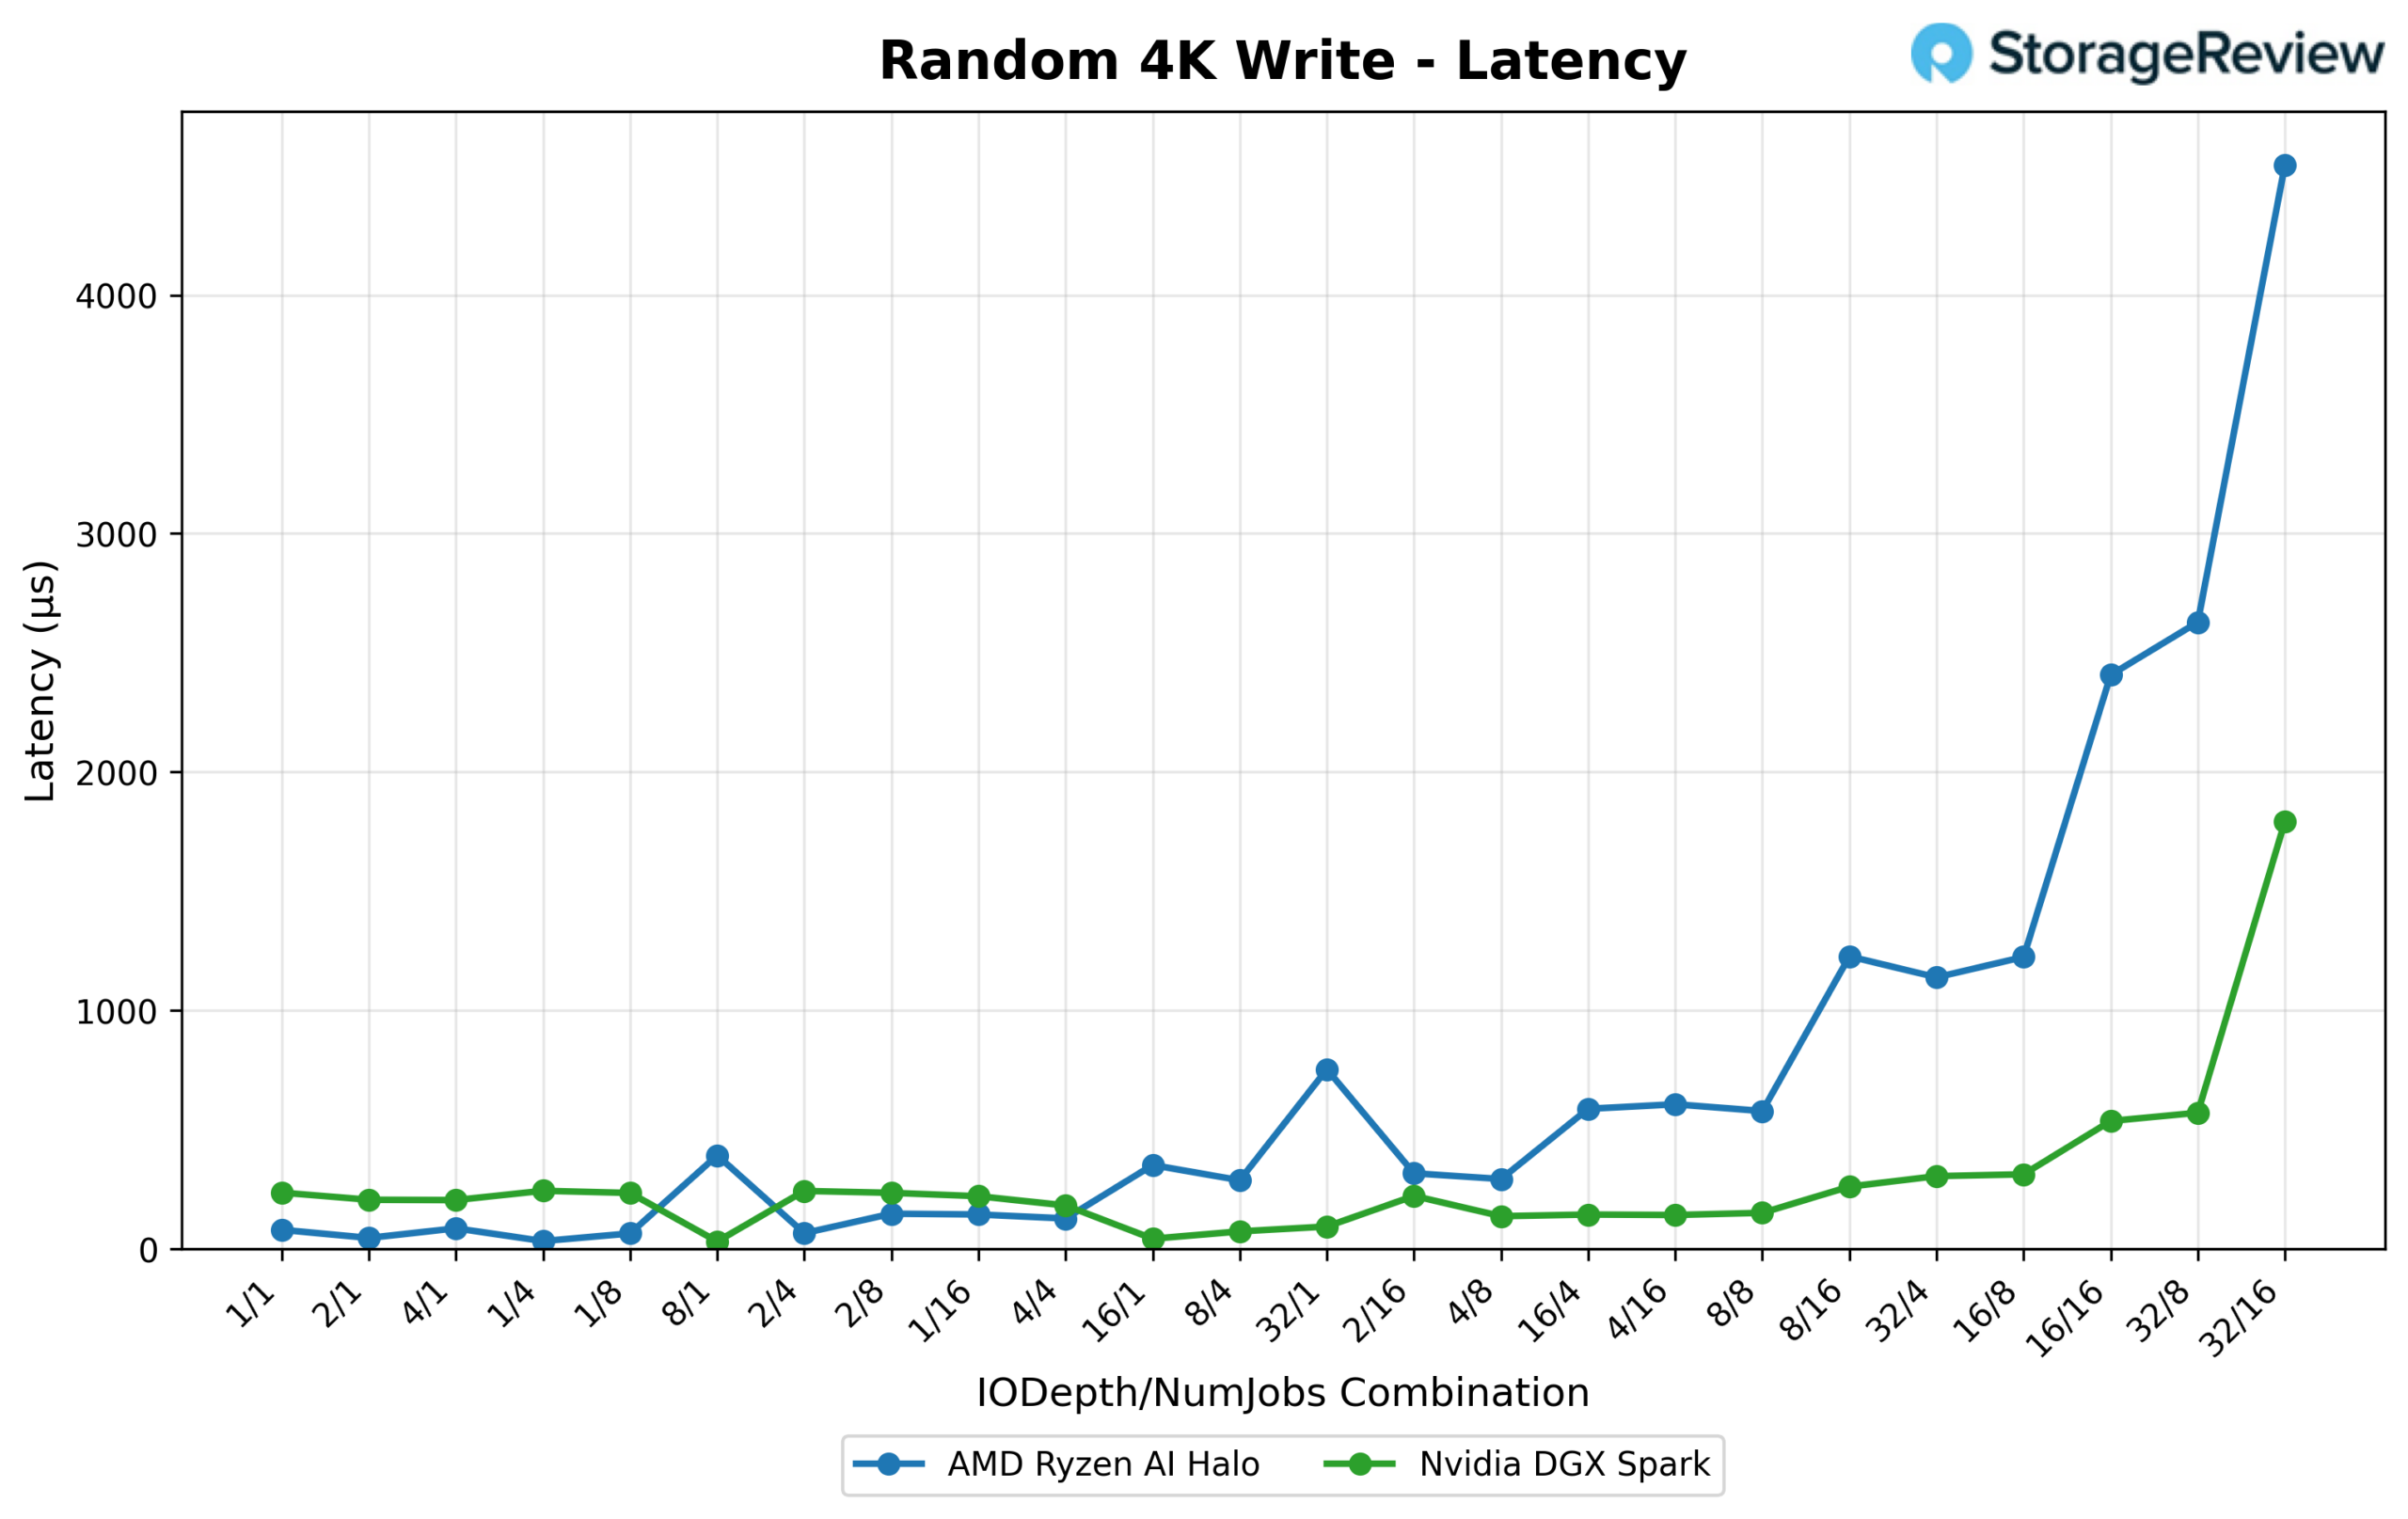
在低隊列深度下,Halo 的延遲優勢再次顯現(1/1 時為 0.079 毫秒,而 Spark 為 0.235 毫秒)。到了 32/16 佇列深度,Halo 的平均延遲攀升至 4.546 毫秒,而 Spark 的延遲則相對穩定在 1.792 毫秒。結合 IOPS 的差距,本次測試中 Spark 的優勢最為顯著,且在整個佇列深度/執行緒範圍內都保持穩定。
vLLM 線上服務 – LLM 推理效能
vLLM 是 LLM 領域最受歡迎的高吞吐量推理和服務引擎之一。 vLLM 線上服務基準測試評估了該推理引擎在並發請求下的實際服務效能。它透過向運行中的 vLLM 伺服器發送請求來模擬生產環境的工作負載,並可配置請求速率、輸入輸出長度和並發客戶端數量等參數。此基準測試可測量關鍵指標,包括吞吐量(每秒令牌數)、首令牌時間 (TTF) 和單次輸出令牌時間 (TPOT),可協助使用者了解 vLLM 在不同負載條件下的效能。
我們測試了涵蓋各種架構、參數規模和量化策略的一系列模型的推理效能,以評估不同並發配置下的吞吐量。
GPT OSS 120B
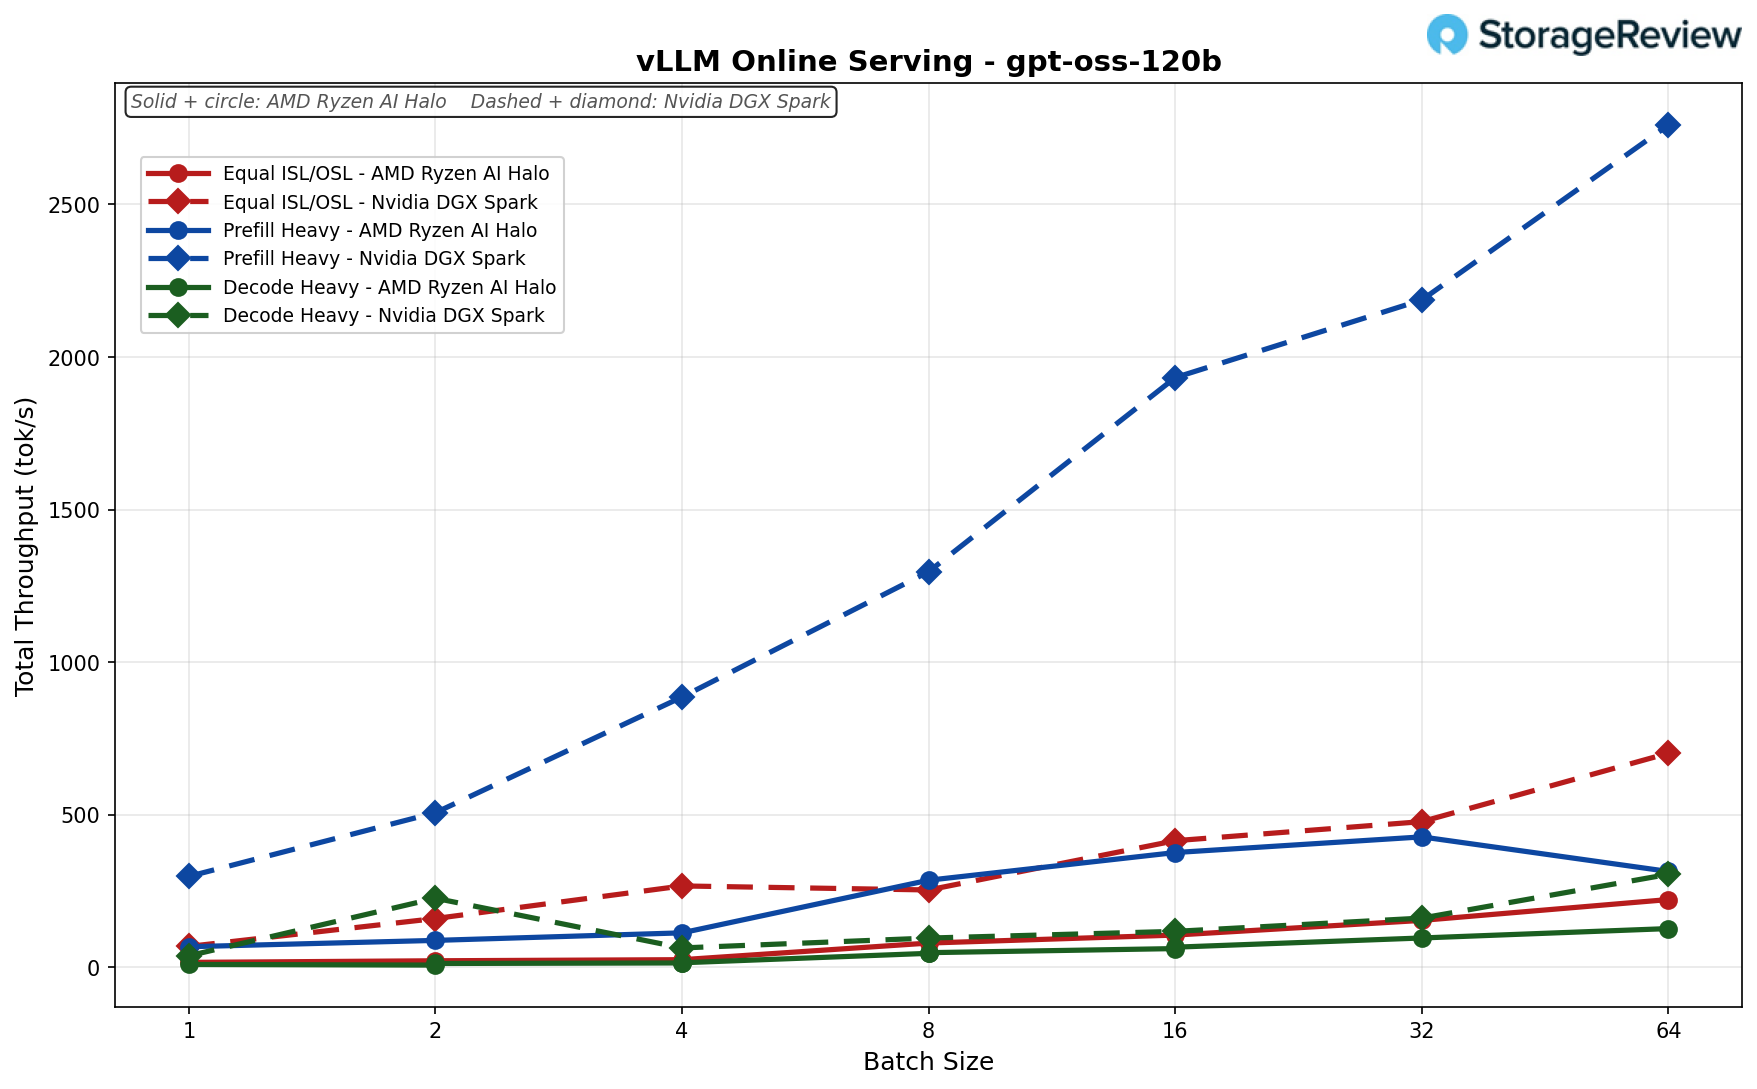
相等的 ISL/OSL (256/256):Halo 在批次大小為 64 時可擴展至 222 tok/s,而 Spark 則達到 701(大約落後 3.2 倍)。
預填充重型(8k/1k):Halo 的吞吐量在第 32 批次達到峰值(427 tok/s),然後在第 64 批次下降到 314,而 Spark 則飆升至 2,760(約 8.8 倍)——這是該組中差距最大的。
解碼重型資料(1k/8k):Halo 的解碼速度達到了 127 tok/s,而 Spark 在批量大小為 64 時達到了 305 tok/s(大約是 2.4 倍)。
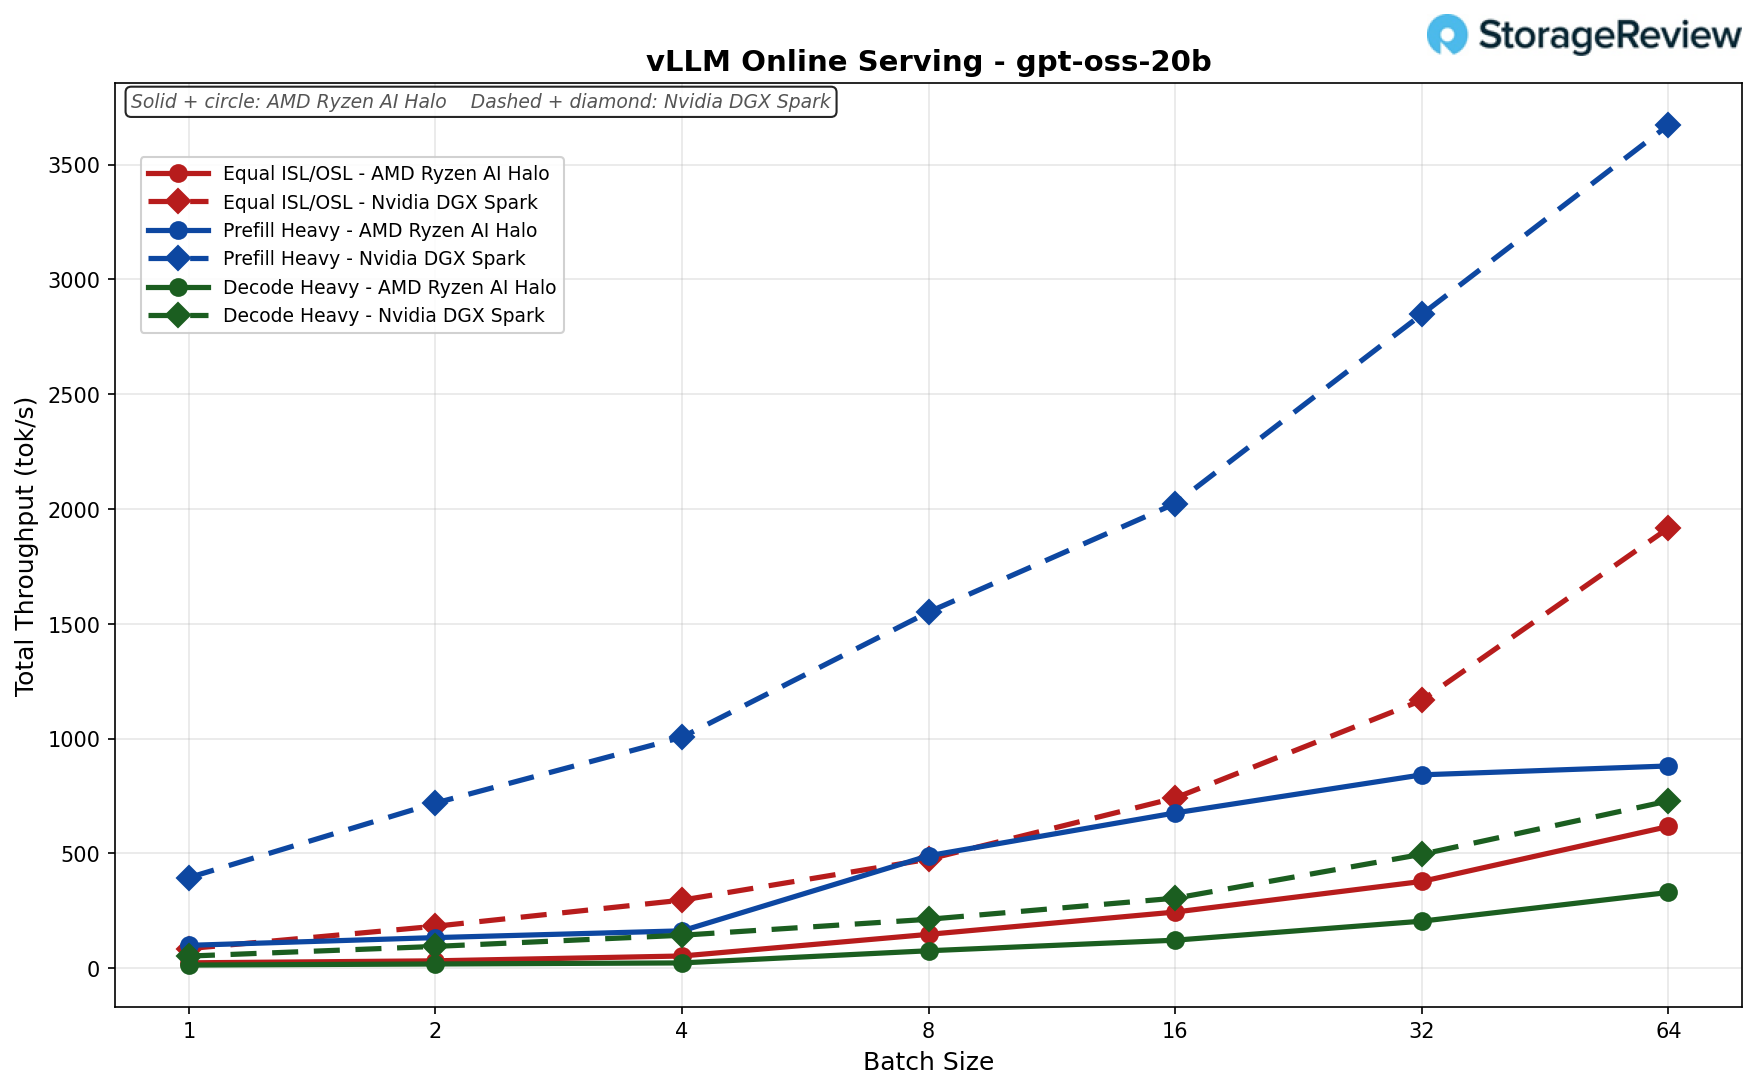
GPT OSS 20B
ISL/OSL 相等 (256/256):Spark 在每個批次中都領先,在第 64 批次時擴展到 1,917 tok/s 對比 617 tok/s(Spark 領先約 3.1 倍)。
預填充重型 (8k/1k):Spark 的領先優勢最大,在批次大小為 64 時達到 3,672 tok/s,而 881 tok/s(Spark 領先約 4.2 倍)。
解碼重型數據(1k/8k):Spark 始終領先,在第 64 批次達到 728 tok/s,而其他數據為 330 tok/s(Spark 領先約 2.2 倍)。
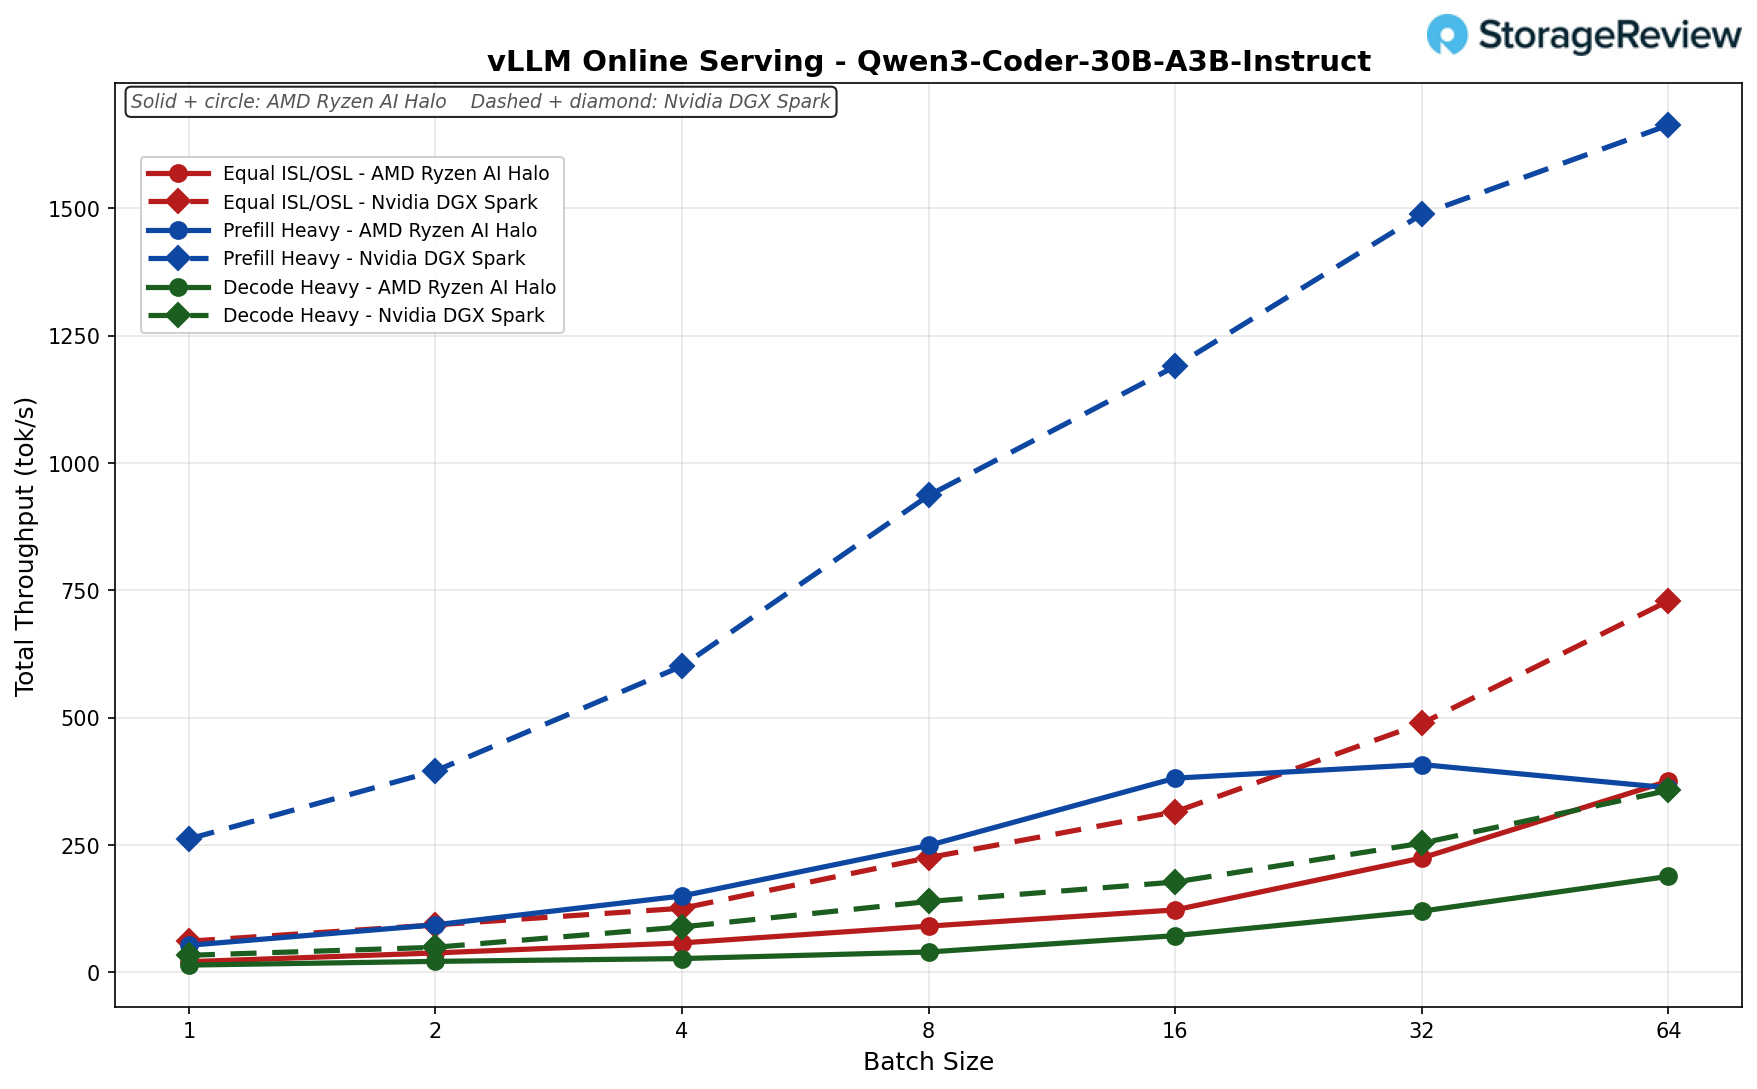
Qwen3 編碼器 30B A3B 指令
相等 ISL/OSL (256/256):Halo 在批次大小為 64 時擴展到 376 tok/s,大約是 Spark 的 729 的一半(約 1.9 倍)——這是比較緊湊的相等 ISL/OSL 結果之一。
預填充重型(8k/1k):Halo 在第 32 批次達到高峰(408 tok/s),然後在第 64 批次下降到 362,落後於 Spark 的 1,663(約 4.6 倍)。
解碼重型資料(1k/8k):Halo 的解碼速度達到了 188 tok/s,而 Spark 在批量大小為 64 時達到了 357 tok/s(大約是 1.9 倍)。
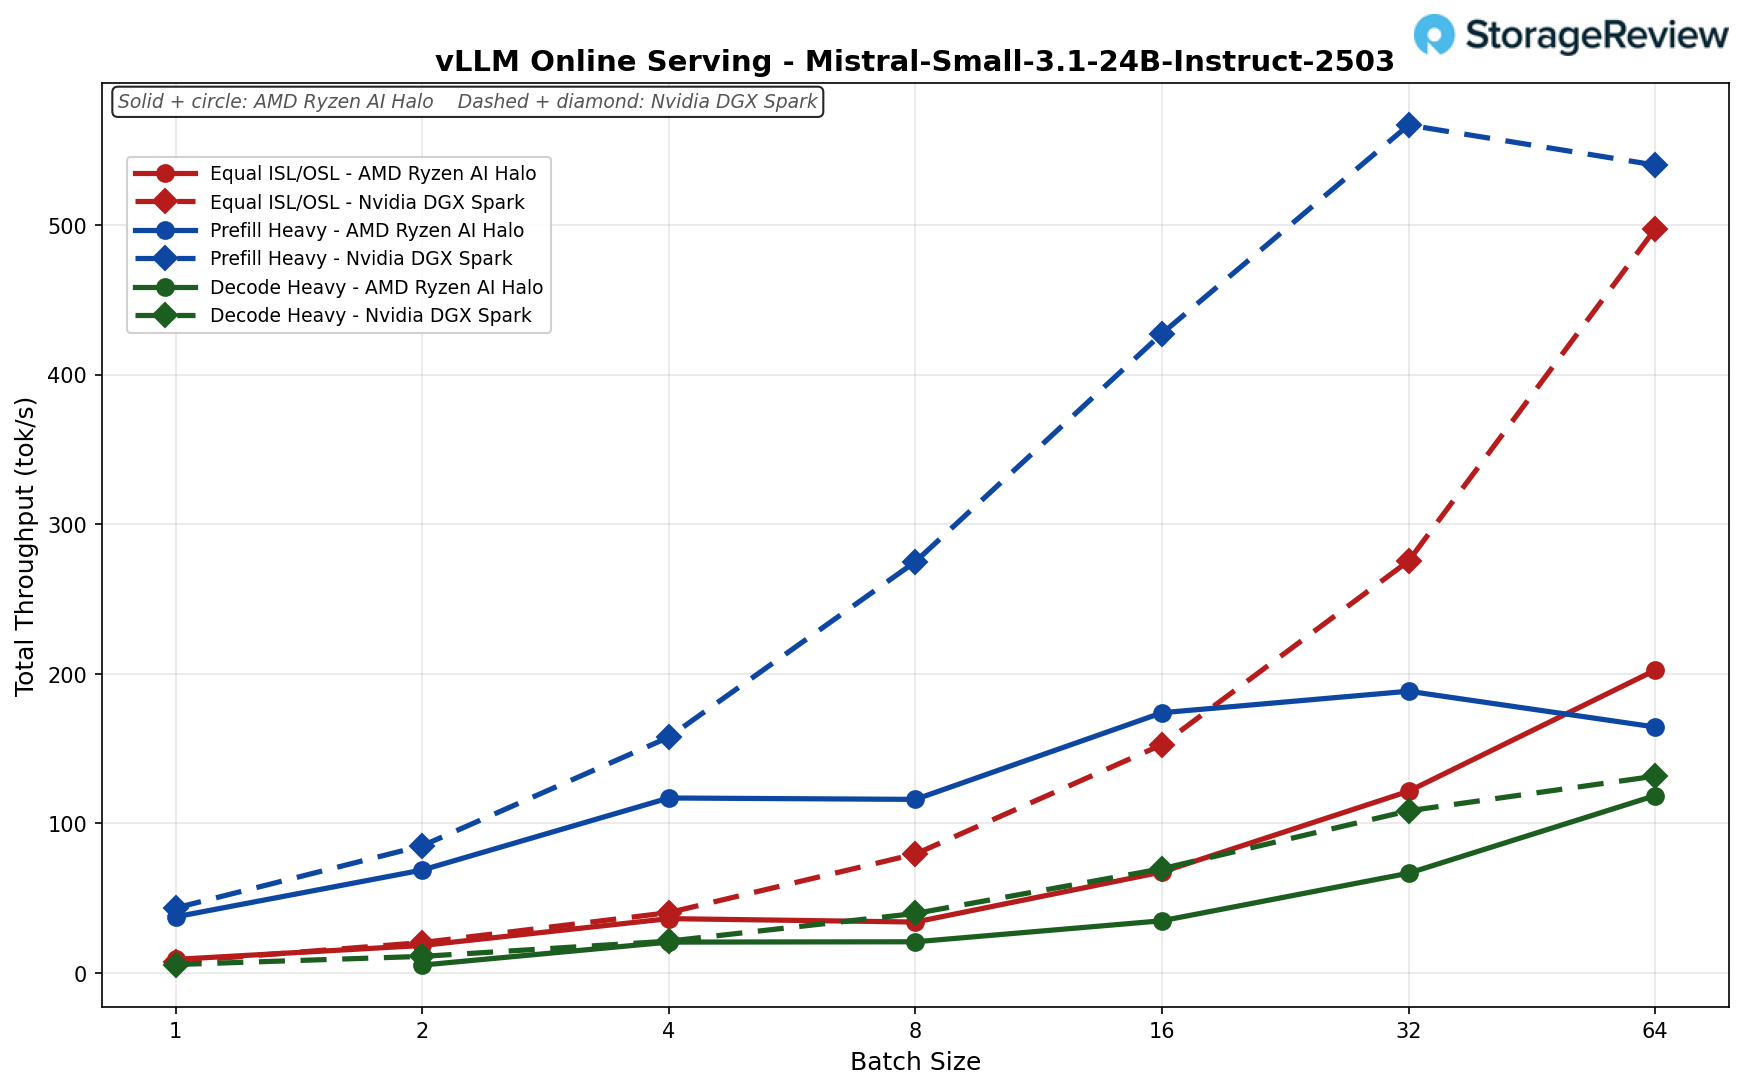
Mistral Small 3.1 24B 指令
ISL/OSL 相等 (256/256):Halo 在第 1 批次中實際上領先 (9 對 8 tok/s),然後在第 64 批次穩定在 202 tok/s,而 Spark 為 498(大約落後 2.5 倍)。
預填充重型(8k/1k):Halo 在第 32 批次達到高峰(188 tok/s),在第 64 批次略微下降到 164,落後於 Spark 的 540(約 3.3 倍)。
解碼重型 (1k/8k):幾乎全程持平,Halo 在第 64 批達到了 119 tok/s,而 Spark 達到了 132 tok/s(相差約 11%)。
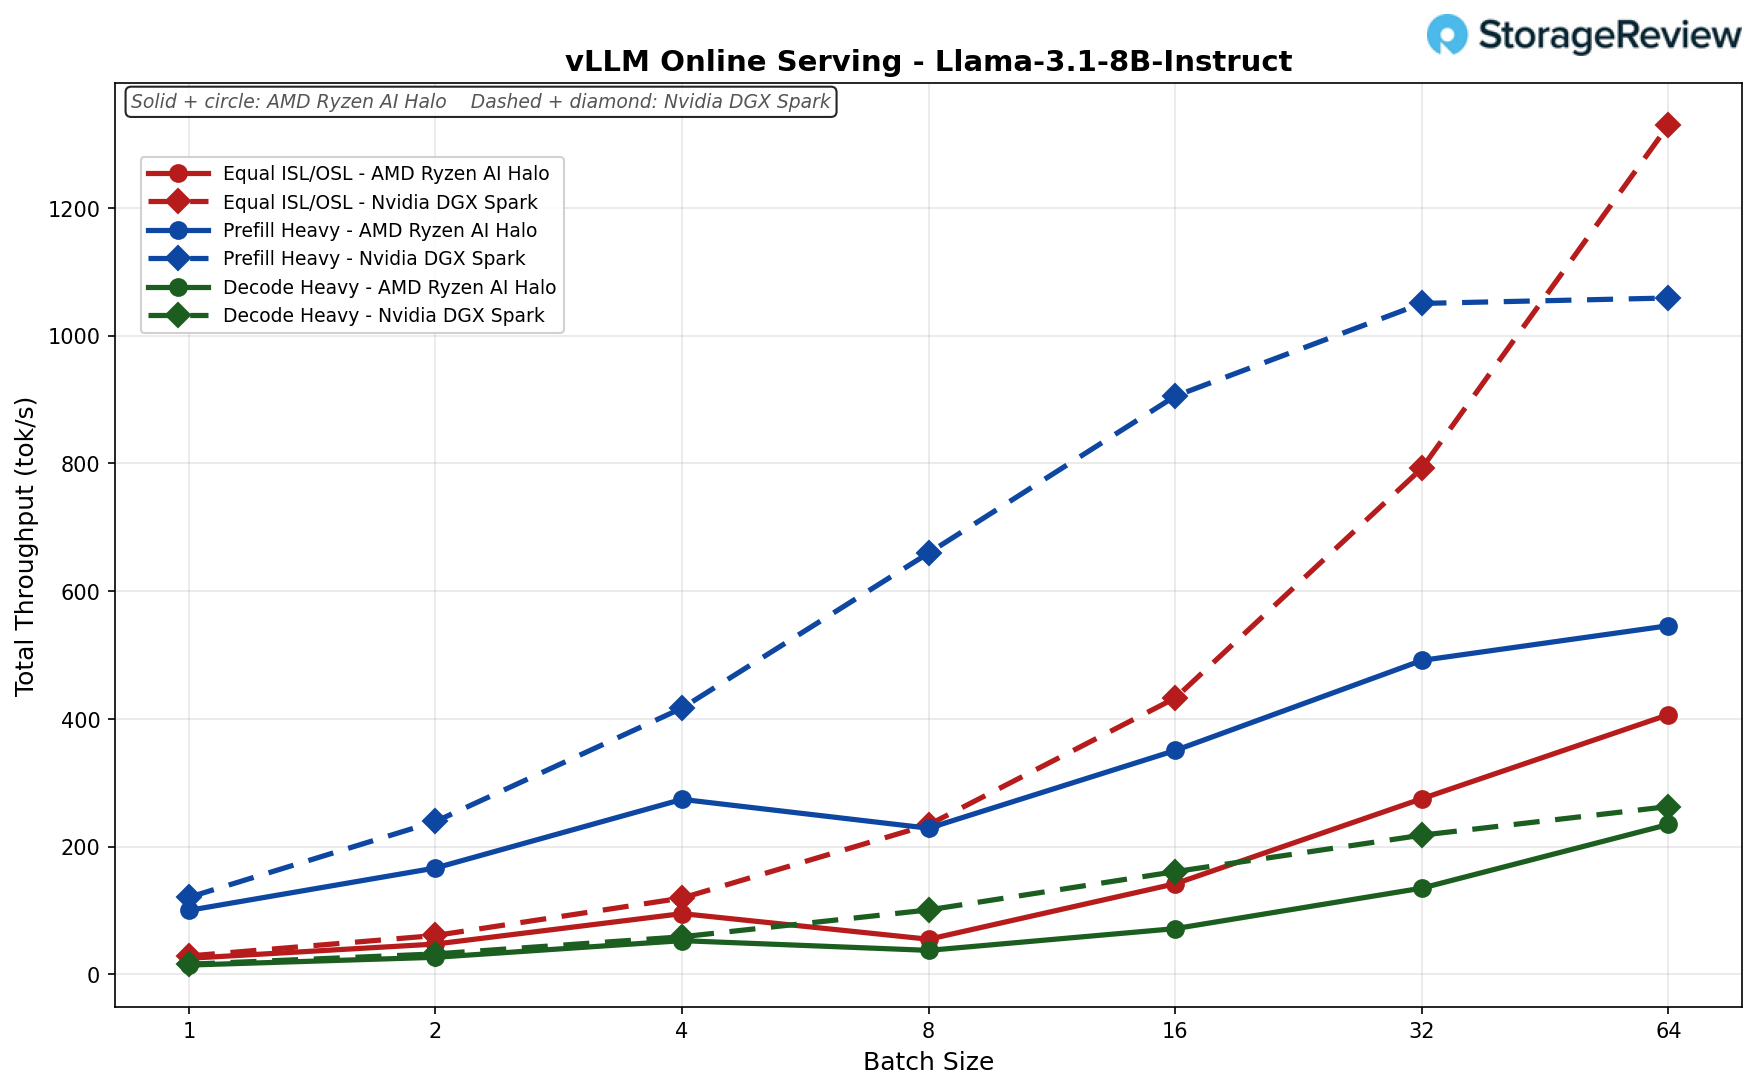
駱駝 3.1 8B 指導
ISL/OSL 相等 (256/256):Halo 的性能從第 1 批次的 25 tok/s 穩步提升到第 64 批次的 407 tok/s,在第 4 批次之前與 Spark 的性能非常接近,之後 Spark 的性能超過了 Halo,達到了 1,330 倍(Halo3.3 倍)。
預填充重型(8k/1k):Halo 在批次大小為 64 時達到了 546 tok/s,大約是 Spark 的 1,059 的一半。
解碼重型(1k/8k):Halo 最具競爭力的場景,在 64 的批次大小下,速度達到 235 tok/s,而 Spark 的速度為 263 tok/s(相差約 12%)。
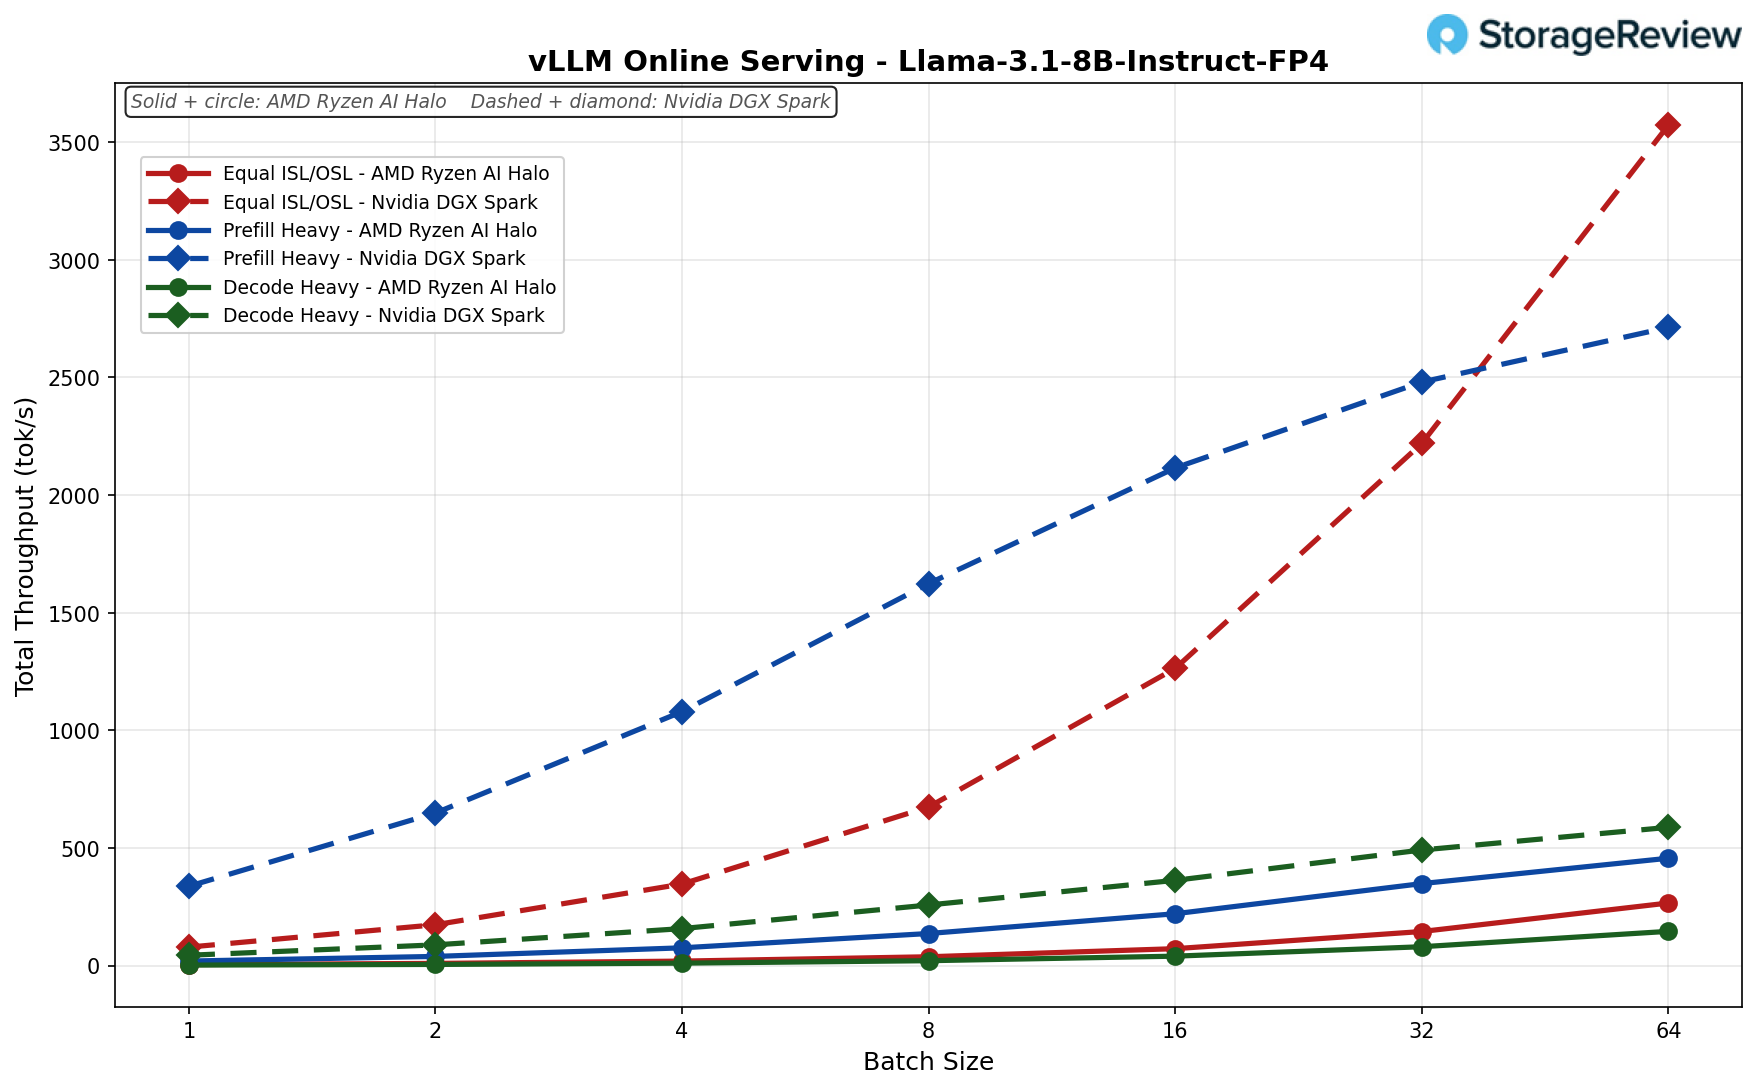
Llama 3.1 8B 指令 FP4
ISL/OSL 相等 (256/256):Halo 在批次大小為 64 時峰值達到 267 tok/s,遠遠落後於 Spark 的 3,573——FP4 顯示差距最大(約 13.4 倍)。
預填充重型(8k/1k):Halo 在批量大小為 64 時達到了 457 tok/s,而 Spark 則達到了 2,713(約 5.9 倍)。
解碼重型資料(1k/8k):Halo 的解碼速度為 146 tok/s,而 Spark 在批次大小為 64 時解碼速度為 588 tok/s(大約是 4 倍)。
結語
AMD Ryzen AI Halo 進入了 NVIDIA 憑藉 DGX Spark 開創的領域,但它並沒有試圖在 Spark 的主場與其競爭。在我們的 vLLM 測試中,Spark 在大多數高並發場景下都擁有 2 到 4 倍的吞吐量優勢,在預填充密集型 GPT OSS 120B 工作中,優勢甚至高達 8.8 倍,僅在兩次解碼密集型測試中差距縮小到約 10%。此外,Spark 的儲存子系統在飽和狀態下幾乎贏得了所有 fio 測試。 Halo 的優勢在於,它以相近的體積提供了相同的 128GB 統一內存和 200 億參數上限,售價為 3,999 美元,而 Spark Founders Edition 的售價為 4,699 美元(儘管一些 OEM 廠商將其售價低於 4,000 美元)。 Halo 是一款完整的 x86 架構機器,可啟動 Windows 11 或 Linux 系統,而不僅僅是 DGX OS。
撇開 Spark 不談,Halo 是我們測試過的最強 Ryzen AI Max+ 395 實作。在幾乎所有我們測試的 Windows 工作負載中,它都超越了 HP Z2 Mini G1a 和 ZBook Ultra G1a:Cinebench R23 多核心測試得分 37,316,7-Zip 壓縮速度達到 184.2 GIPS(HP 分別為 151.6 和 156.8),Procy 10 億位元,50 億位元和 156.8),Proc-000 億位元和 50 億位元組的 50 億位元數運算速度也最快。在 Linux 系統下,Halo 在 CPU 密集的 Phoronix 測試中完勝 Spark,7-Zip 壓縮速度提升 11%,LLVM 編譯速度提升 14%。 Halo 首先是一款緊湊型工作站,AI 開發功能是在此基礎上疊加的,而非取代。
對於需要最大每秒本地令牌數或計劃通過高速網路叢集節點的開發者來說,Spark 仍然是最佳選擇;Halo 的 10GbE 頻寬和 vLLM 上限與 Spark 相比仍有差距。對於使用 ROCm 建置應用程式的開發者、需要 Windows 系統整合的團隊,或任何希望一台裝置即可滿足專業工作負載和本機模型工作需求的使用者來說,Halo 更為合適。其標配的 M.2 2280 插槽和預調校的可變顯存解決了 Spark 用戶最常抱怨的兩大問題。 AMD 也表示,該平台將在第三季推出搭載 Ryzen AI Max PRO 400 系列處理器的版本,最高支援 192GB 統一顯存,因此追求更大顯存容量的用戶無需更換平台即可輕鬆升級。
產品頁面 – AMD Ryzen AI Halo
排行榜: AMD Ryzen AI Halo 在我們的「最佳本地 AI 桌上型電腦」排行榜中佔據「最佳 x86 替代方案」的位置。



 Amazon