

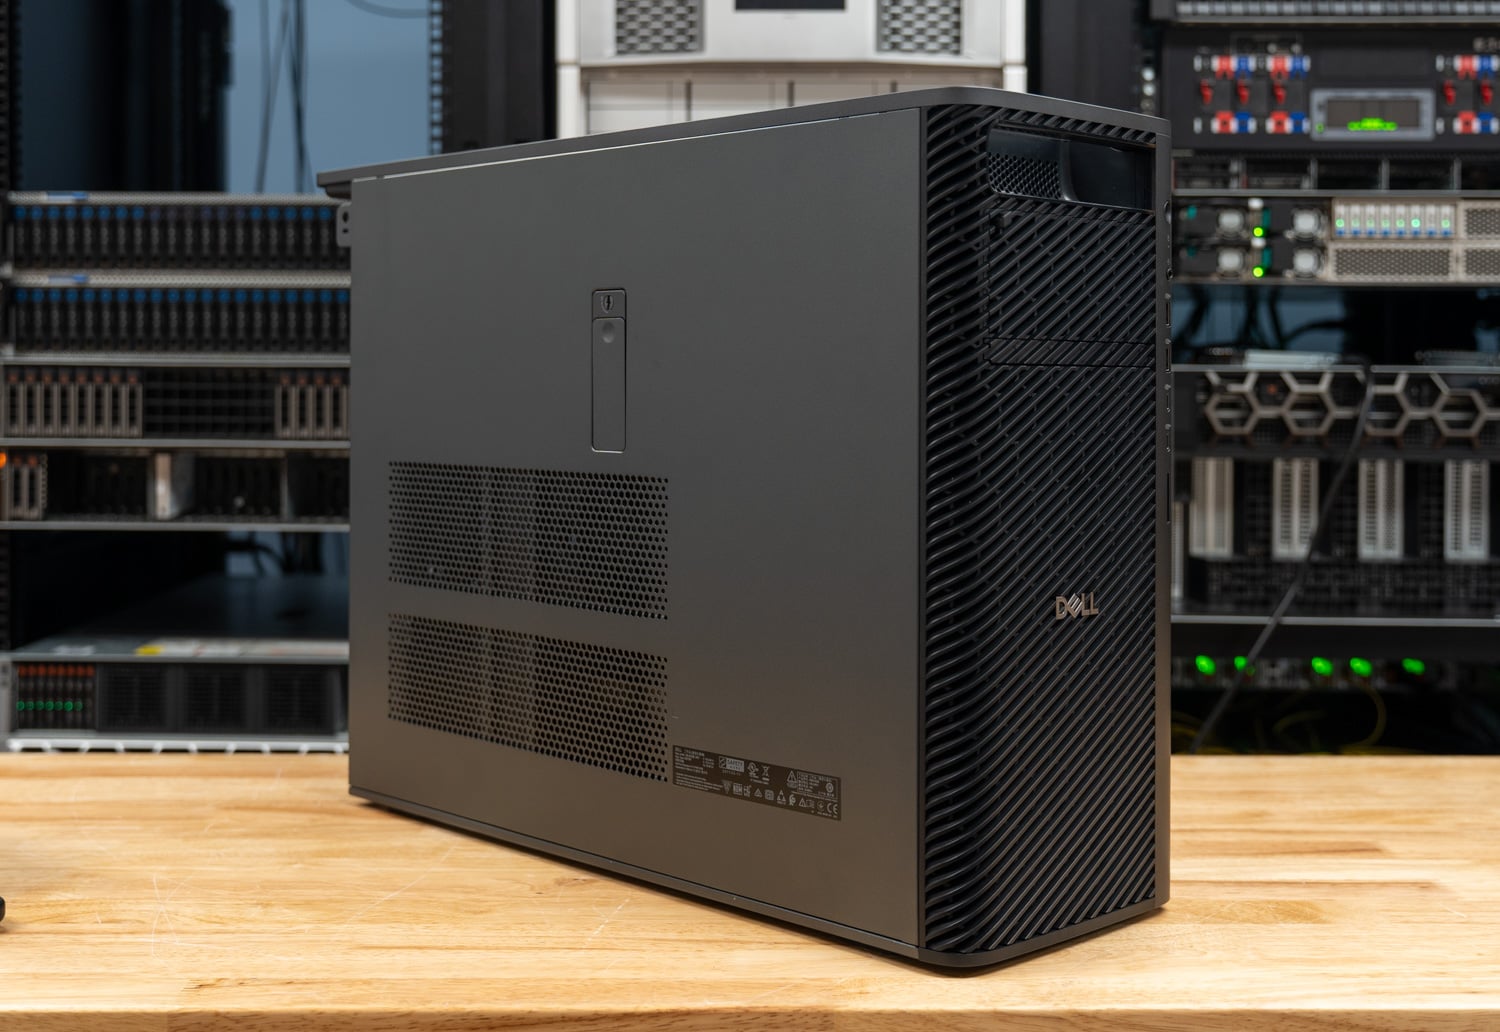
戴爾Pro Precision 9 T4是戴爾Pro Precision系列中的頂級單路塔式工作站,我們評測的這台機器配置了本地AI應用,其規模之大,大多數工作站都無法企及。它搭載了英特爾86核心至強698X處理器、256GB DDR5-6400 ECC記憶體、兩塊300W NVIDIA RTX PRO 6000 Blackwell Max-Q顯示卡(每塊顯示卡配備96GB GDDR7顯存)、兩塊2TB Gen55硬碟以及一個雙固態硬碟以及一個雙固態連接埠。在戴爾官網上,同樣的配置售價約為66,600美元。
關鍵要點
- 雙GPU可以將一張顯示卡無法容納的模型變成一張可用的模型。 容量為 129.3GB 的 MiniMax M2.7 在兩張 RTX PRO 6000 顯示卡上分配使用時,每秒可為一位用戶生成 83.7 個令牌,是使用一張顯示卡並將剩餘部分內存放在系統內存中時每秒生成 30.3 個令牌的 2.8 倍。
- 第二個 GPU 將服務效能提升了 1.85 到 2.02 倍,將嵌入效能提升了 1.92 倍。 在 Ministral 3 3B 上,llama.cpp 的峰值輸出從每秒 582.5 個標記增加到每秒 1,176.1 個標記;在 gpt-oss 120B 上,每個 GPU 配備一台伺服器,峰值輸出從每秒 424.8 個標記增加到 787.9 個嵌入時間 40 秒
- 第二塊 GPU 將 LoRa 週期的耗時縮短了 37%。 在 Ministral 3 8B 上,LoRA 的一個 epoch 在一個 GPU 上耗時 31.5 分鐘,在兩個 GPU 上耗時 19.7 分鐘,最終的保留損失分別為 1.169 和 1.167。
- T4 的至強處理器在記憶體頻寬方面表現出色。 STREAM Triad 的速度達到了 328GB/s,比 Precision 7875 中的 Threadripper PRO 9995WX 高出 53%;T4 完成 OpenFOAM drivAer 求解用時 293 秒,而 Threadripper PRO 556WX 軸用時 10 秒; Threadripper PRO 53.9WX 用時 83.7 秒。
- Precision 7875 在核心密集型 CPU 工作方面領先。 96 核心 Threadripper 在 7-Zip 測試中領先 37%,在 Blender Monster 測試中領先 30%,並且在 LLVM 構建中僅用時 43.7 秒,而其他處理器則需要 58.4 秒。
Pro Precision 9 T4 的位置
戴爾將T4定位為旗艦級單路塔式工作站,專為需要最高運算密度和擴展性的企業用戶而設計,其主要工作負載包括人工智慧開發、工程模擬和科學計算。 T4的定位高於戴爾Pro Precision 9 T2,後者採用相同的Granite Rapids-WS Xeon 6工作站平台,但機殼較小,僅配備一塊GPU。 T4則在此基礎上增加了該系列頂級的八通道處理器,最高可達86個核心,並且根據型號不同,最多可安裝四塊顯示卡。
戴爾官網提供的處理器選項從12核心的至強634起步,最高可選64核心的至強696X,我們評測的這款機型則搭載了86核心的至強698X,配備336MB緩存,基礎頻率2.0GHz,最高頻率可達4.8GHz,功耗350W。內存方面,最高可選配4TB DDR5 RDIMM內存,共有16個內存插槽,我們評測的這款機型在其中8個插槽中安裝了32GB、6400MT/s的內存條。顯示卡方面,起步配置為單張RTX A400,具體顯示卡數量取決於機型:戴爾的配置器列出了四張RTX A1000顯示卡、三張RTX PRO 4000 Blackwell顯示卡、兩張300W RTX PRO 6000 Max-Q顯示卡,或一張600W RTX PRO 6000。
戴爾官網路上的基本配置售價為 5,925 美元。我們的配置在此基礎上增加了 Xeon 698X 處理器(8,300 美元)、256GB 內存(15,000 美元)和兩塊 RTX PRO 6000 Max-Q 顯示卡(30,820 美元),這還不包括存儲、網絡以及戴爾為該級別配置自動添加的 36 個月。
構建和設計
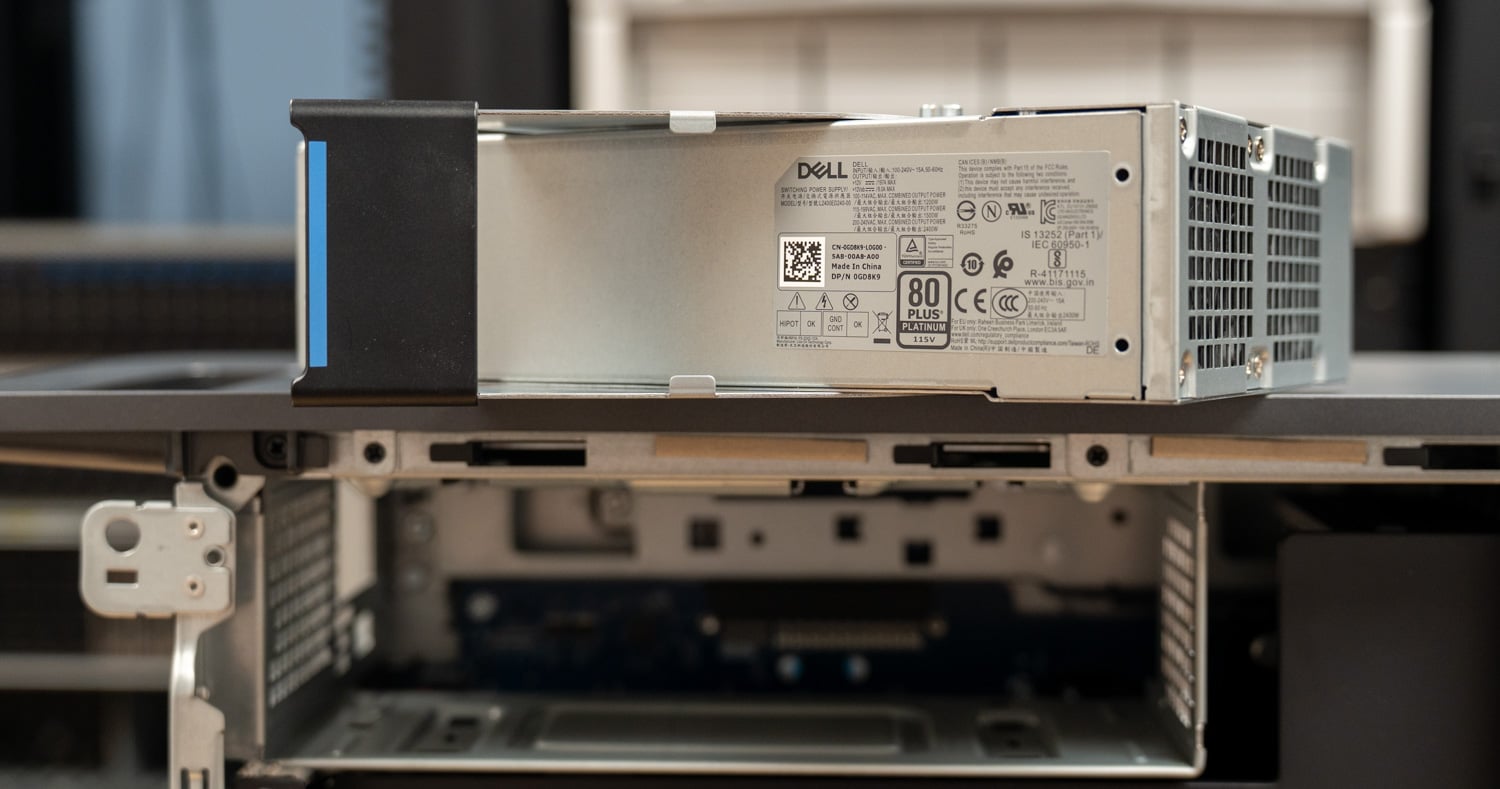
T4 是一款全塔式機箱,高 449.8 毫米,寬 203.7 毫米,深 617.5 毫米。戴爾官方數據顯示,其重量依配置不同,最小為 24.1 公斤,最大為 33.6 公斤。我們評測的這台機器配備了 2400W 白金電源,這是戴爾配置器為雙 RTX PRO 6000 配置自動選擇的電源;而對於配置較低的機型,則預設配備 1500W 電源。
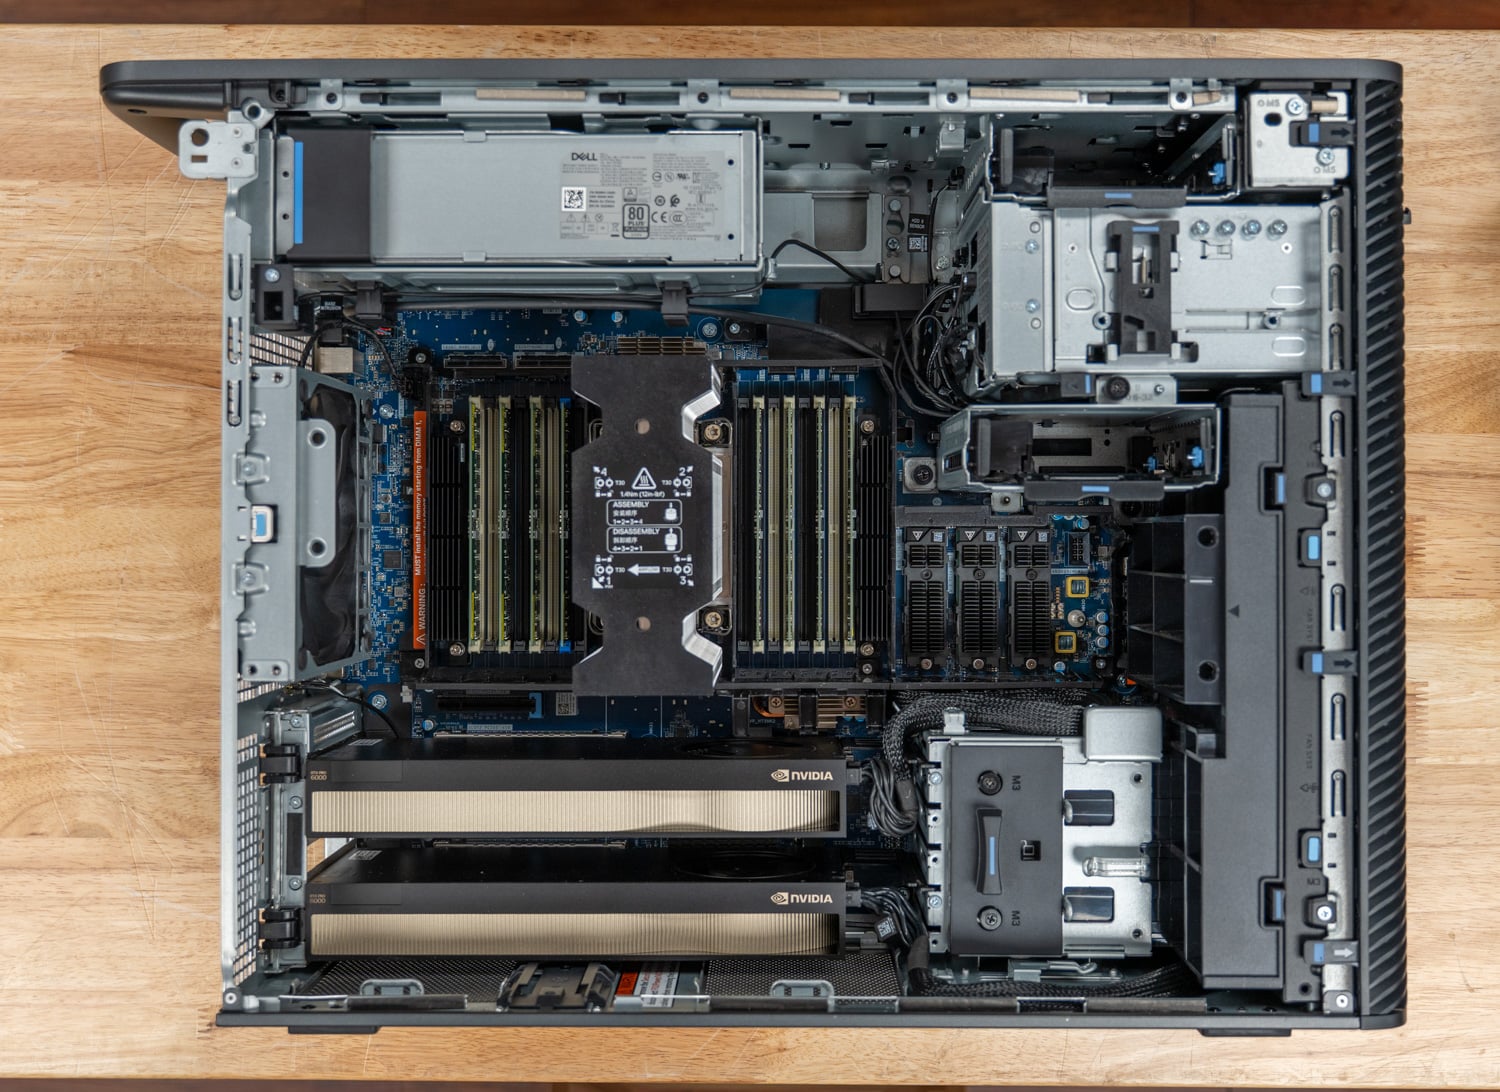
T4 的可維護性是一大亮點,首先是無需工具即可透過側邊板上的卡扣打開機箱,其次是 2400W 電源,只需手動從機箱頂部後方滑出即可。其他所有部件,包括顯示卡和固態硬碟,都可以用十字螺絲起子拆卸,戴爾標誌性的藍色觸點標記了哪些部件需要手動拆卸。實驗室發現,對於這個價位的工作站來說,使用者在現場維修這款平台非常方便。
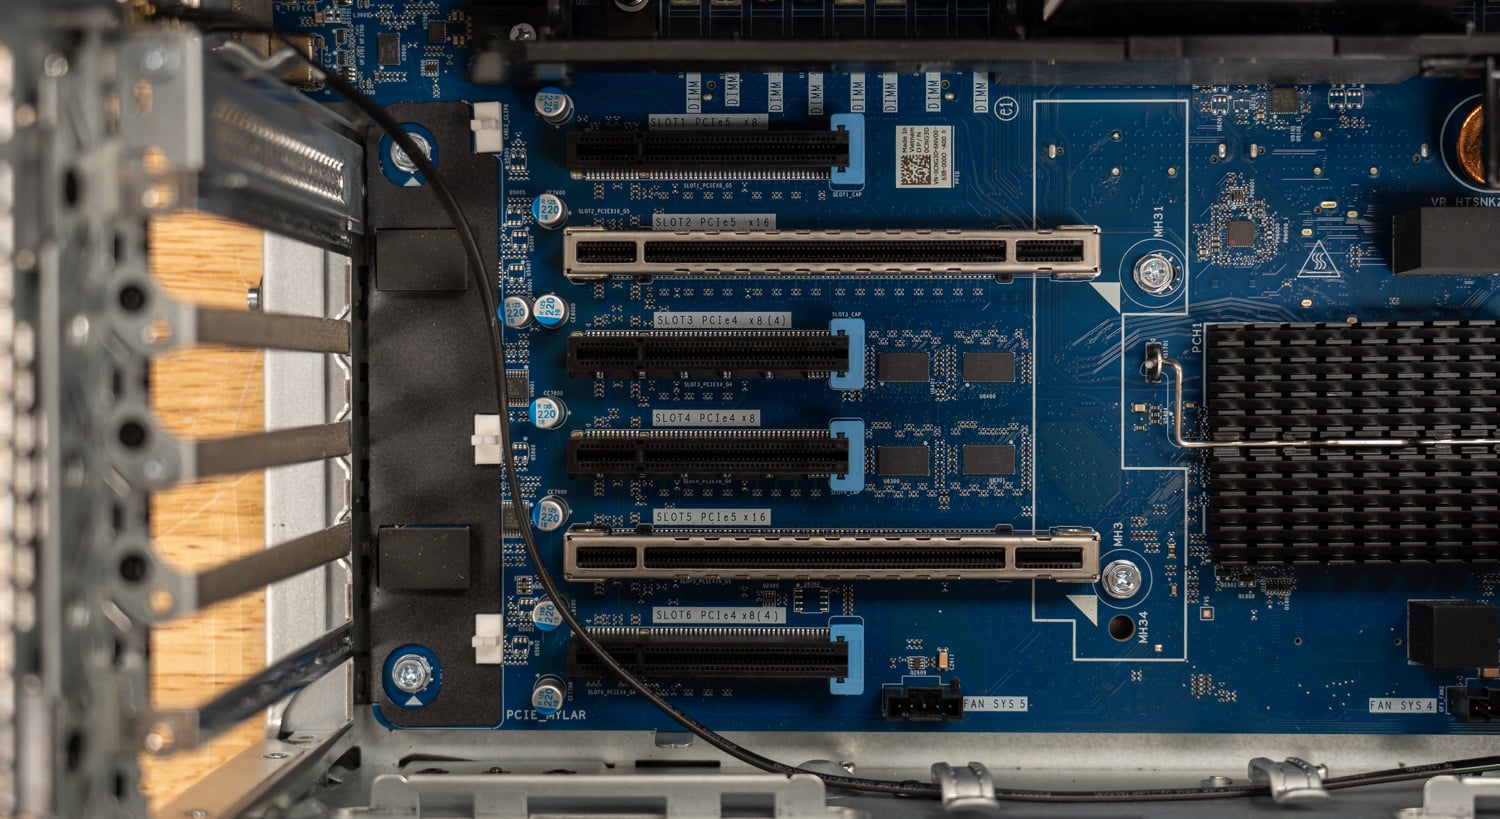
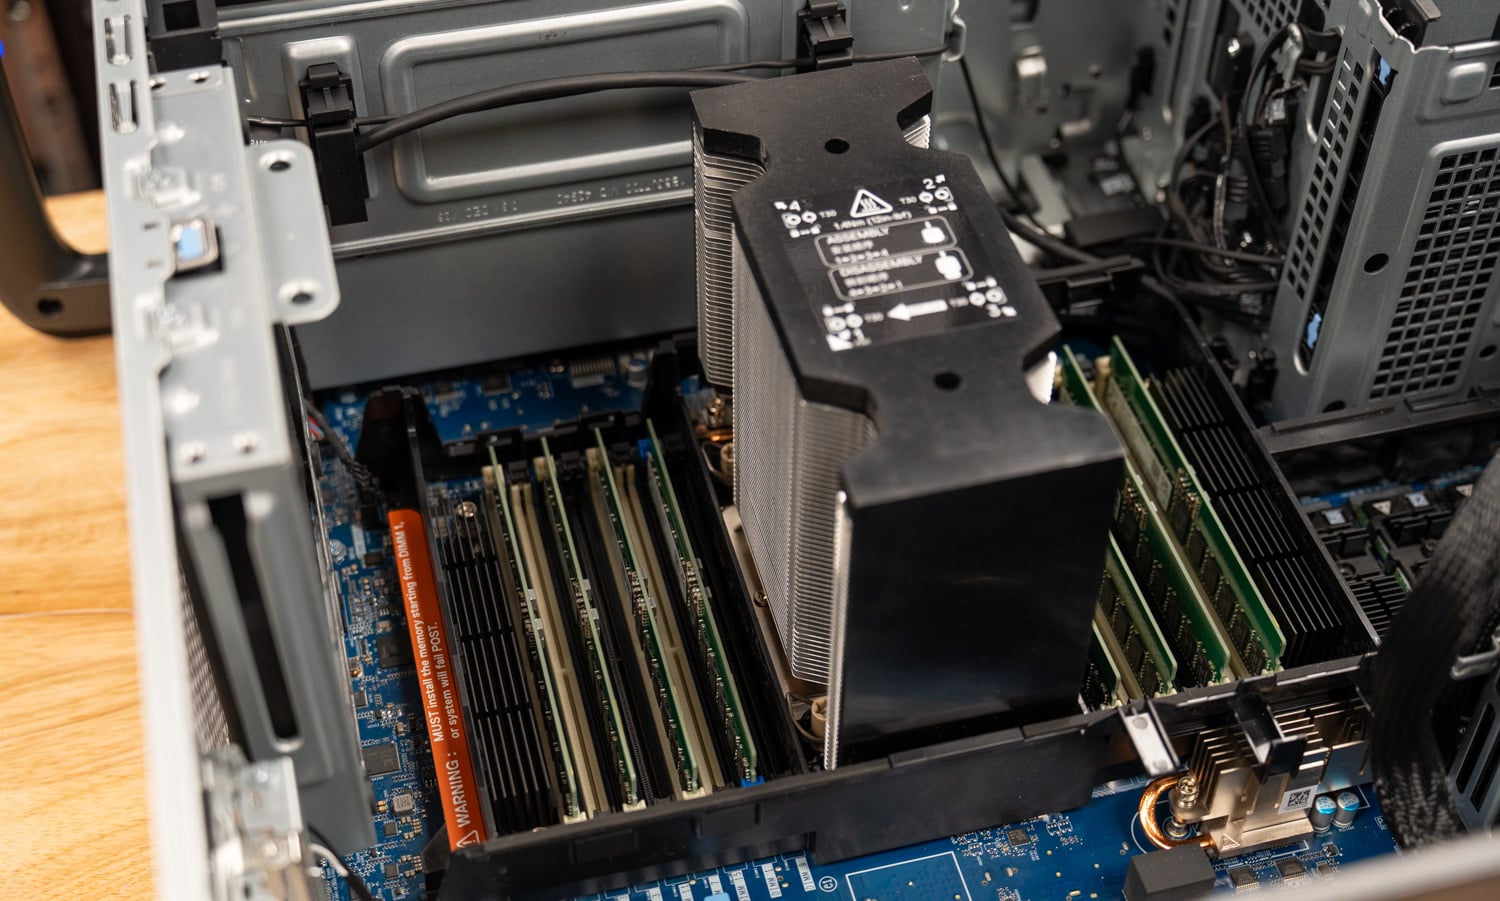
就同級塔式機殼而言,戴爾的散熱設計堪稱最佳。空氣從前向後流動,大型貼合式導風罩引導氣流向下流過處理器和內存,同時將此通道與 PCIe 插槽區域隔離。這種佈局為兩塊 300W 顯示卡提供了獨立的氣流,避免它們吸入 350W 至強處理器產生的熱空氣。處理器區域和顯示卡插槽之間設有兩顆風扇。風扇組件採用相同的藍色接點,並且可以拆卸,方便使用者檢修記憶體。
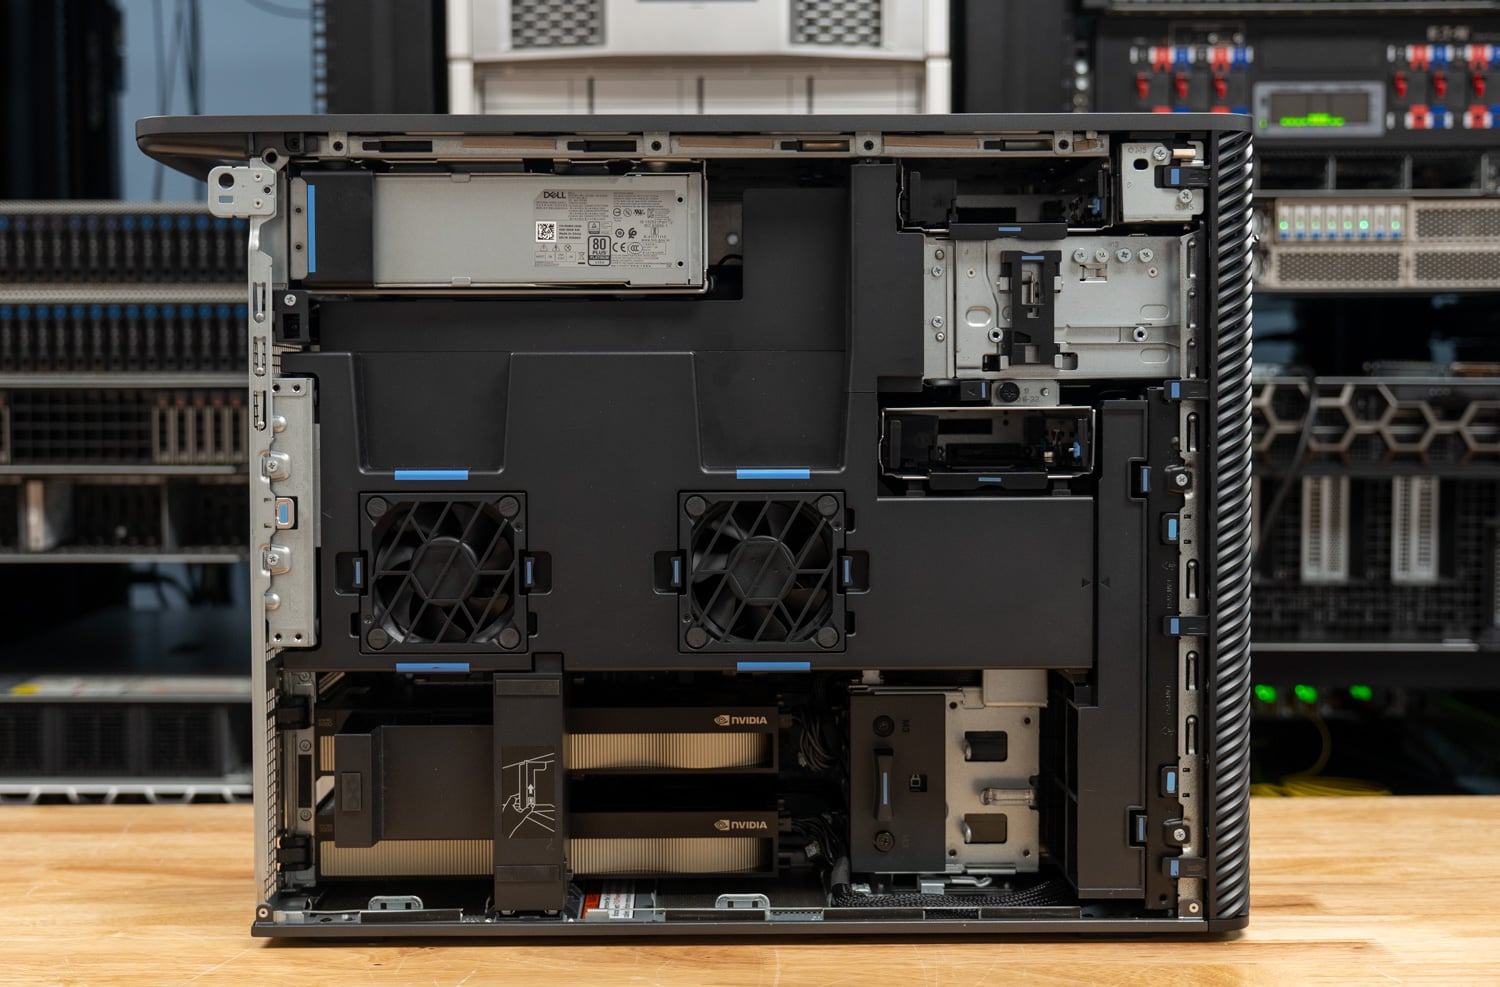
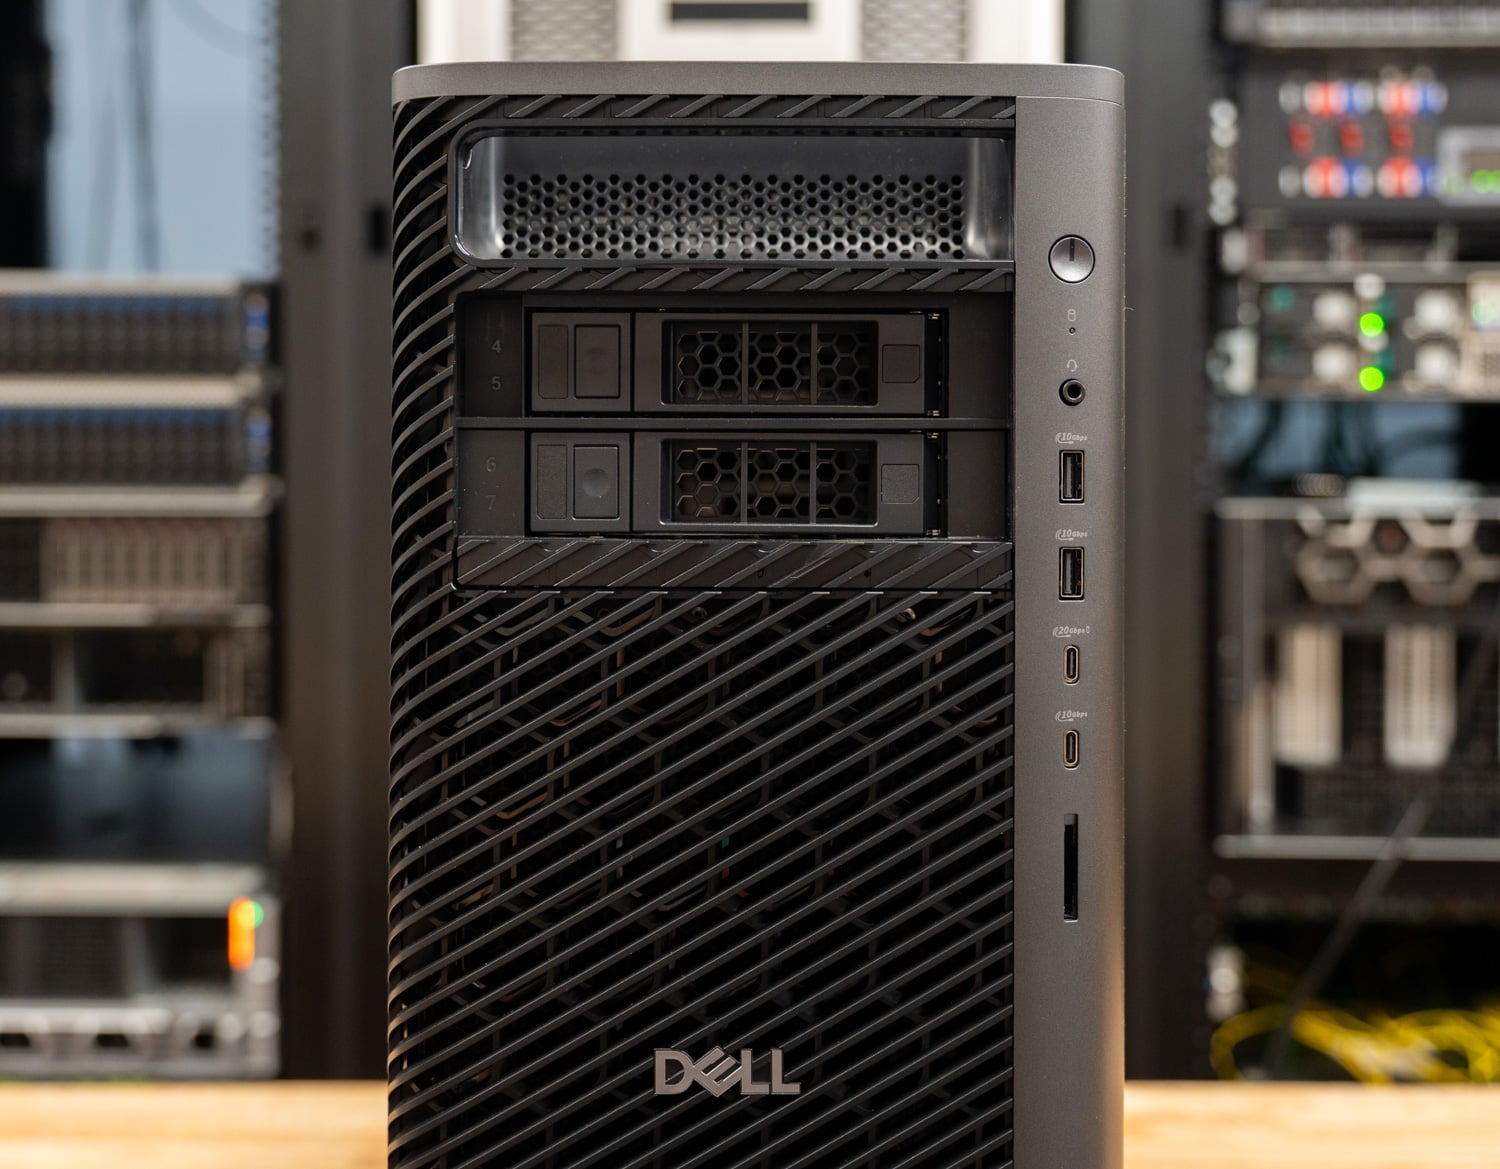
擴充功能方面,該機配備了六個全高 PCIe 插槽:兩個用於安裝顯示卡的 Gen5 x16 插槽、一個 Gen5 x8 插槽、一個 Gen4 x8 插槽,以及兩個帶有 x8 連接器和 x4 線纜的 Gen4 插槽。儲存方面,該機提供三個內部 M.2 Gen5 插槽和一個 Gen4 插槽、兩個內部 3.5 吋 SATA 硬碟位,以及一個前置 FlexBay 擴充槽,最多可容納四個 NVMe 固態硬碟或兩個 3.5 吋固態硬碟,並可選配超薄光碟機。我們評測的這台機器使用一塊 2TB 的 Gen5 固態硬碟啟動,並在一個內部 M.2 插槽中安裝了另一塊 2TB 的 Gen5 固態硬碟。
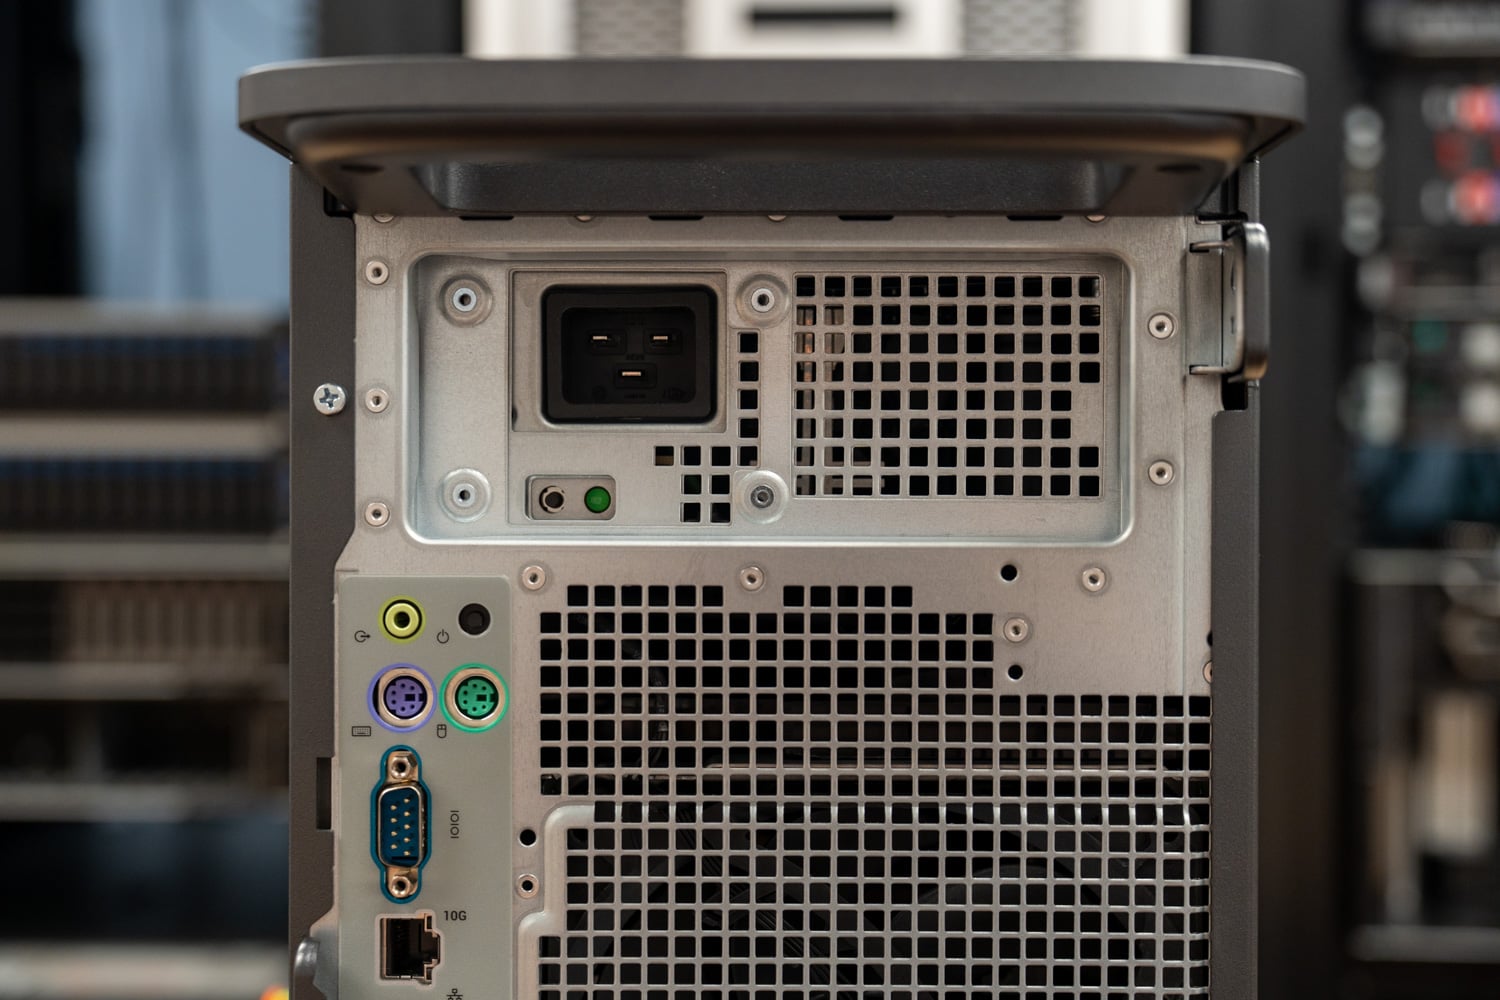
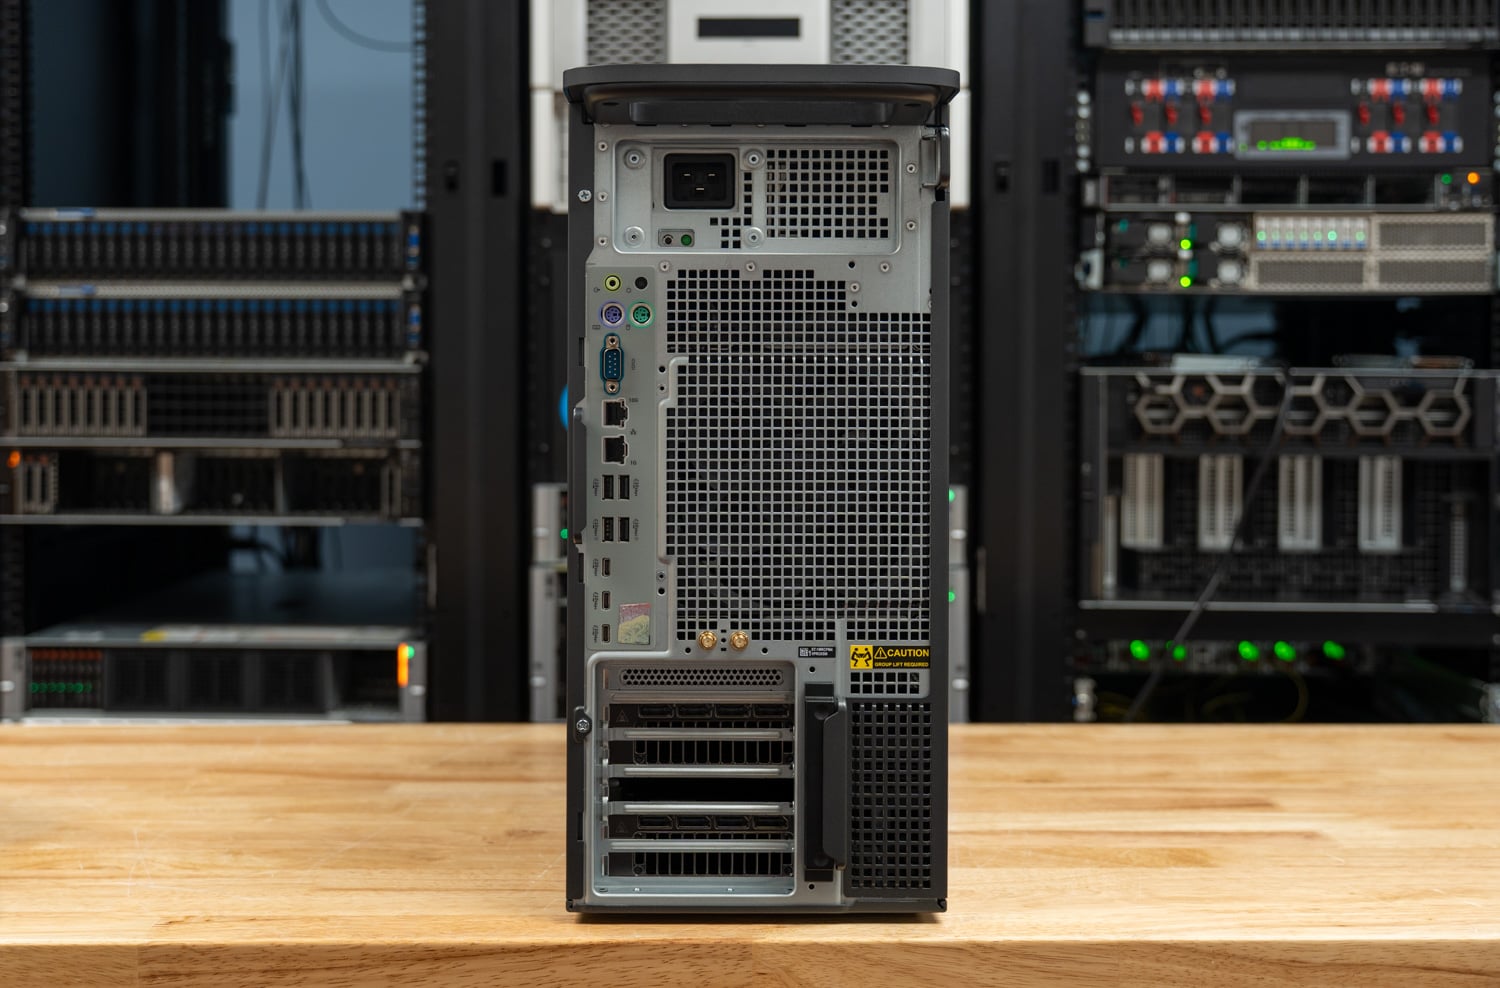
前面板配備耳機插孔、兩個 10Gbps USB-A 連接埠、一個支援 PowerShare 的 20Gbps USB-C 連接埠、一個 10Gbps USB-C 連接埠以及一個可選的 SD 卡插槽。後面板則增加了 10GbE 和 1GbE RJ-45 連接埠、四個 10Gbps USB-A 連接埠、兩個 10Gbps USB-C 連接埠、一個 20Gbps USB-C 連接埠、串列埠、兩個 PS/2 連接埠以及線路輸出連接埠。我們評測的這款產品還配備了 Intel E810-XXV 雙埠 25GbE SFP28 網路卡、支援藍牙 5.4 的 MediaTek Wi-Fi 7 MT7925 無線網路卡、讀卡機以及戴爾的雙 USB-C 擴充卡。
安全性和管理功能包括 TPM 2.0、Dell SafeBIOS、機箱入侵偵測、自加密硬碟支援、BIOS 安全擦除以及 Intel vPro 企業版技術。戴爾表示,T4 的關鍵組件中高達 85% 的部件採用再生塑料,把手中採用 90% 的再生鋁,機箱中採用 11% 的再生鋼,並且該配置符合能源之星 (ENERGY STAR) 標準。
戴爾 Pro Precision 9 T4 規格
| 規格 | 戴爾專業版 Precision 9 T4(測試機型) |
|---|---|
| 系統平台 | |
| 型號 | 戴爾 Pro Precision 9 T4 (PW9T4260) |
| 處理器 | 英特爾至強 698X 處理器,86 核心 172 線程,336MB 緩存,基礎頻率 2.0GHz,最高可達 4.8GHz,功耗 350W |
| 處理器選項 | Xeon 634(12 核)至 Xeon 698X(86 核) |
| 記憶體應用 | 256GB (8x 32GB) DDR5-6400 RDIMM ECC 16 個插槽,最大支援 4TB |
| 圖像 | 2塊NVIDIA RTX PRO 6000 Blackwell Max-Q工作站版顯示卡,每塊配備96GB GDDR7記憶體,每塊耗電量300W。 |
| 操作系統 | Windows 11 專業工作站版(已在 Ubuntu 26.04.1 LTS 上測試) |
| 儲存 | |
| 按配置 | 2x 2TB M.2 2280 Gen5 x4 TLC SED(皆安裝在內部 M.2 插槽) |
| 內部插槽 | 3 個 M.2 2230/2280 Gen5 NVMe 接口 1 個 M.2 2230/2280 Gen4 NVMe 接口 2 個 3.5 英寸 SATA |
| FlexBay | 最多可安裝 4 個 NVMe 硬碟,外加一個可選的超薄光碟機,或 2 個 3.5 吋 SATA 硬碟。 |
| 擴充和連接 | |
| PCIe插槽 | 2x Gen5 x16 1x Gen5 x8 1x Gen4 x8 2x Gen4 x8(x4 電氣) |
| 網路相關 | 英特爾 E810-XXV 雙埠 25GbE SFP28(擴充卡) 板載 10GbE 和 1GbE RJ-45 聯發科 Wi-Fi 7 MT7925,藍牙 5.4 |
| 前端口 | 1 個支援 PowerShare 的 USB-C 20Gbps 接口 1 個 USB-C 10Gbps 接口 2個USB-A 10Gbps 耳機插孔 可選的 SD 卡插槽 |
| 後端口 | 1 個 USB-C 20Gbps 接口 2 個 USB-C 10Gbps 接口 4個USB-A 10Gbps 串列介面、2 個 PS/2 介面、線路輸出接口 |
| 力量和體能 | |
| 電源供應 | 2400瓦白金版(可選1500瓦) |
| 尺寸 | 449.8 x 203.7 x 617.5毫米(17.70 x 8.01 x 24.31吋) |
| 重量 | 根據配置不同,重量為 24.1 公斤至 33.6 公斤(53.1 磅至 74.1 磅)。 |
| 保固 | ProSupport 提供遠端診斷後的現場服務,有效期 36 個月。 |
| 價格 | 基本款 5,925 美元 配置價格約為 66,600 美元(Dell.com) |
測試設定和方法
我們在 Linux 系統上測試高階工作站,本次評測的四台系統均運行 Ubuntu 26.04.1 LTS,核心版本為 7.0.0-43,NVIDIA 驅動程式版本為 595.99.02,CUDA 版本為 13,llama.cpp 版本為 b11716,Ollama 版本為測試模式,並採用 0.40.3,Ollama 版本。測試結果來自三個工具:sr-client 用於本機 AI 和用戶端工作負載,sr-harness 用於編譯、壓縮、加密、Web 服務和 y-cruncher,sr-suite r5.28 用於 GROMACS、OpenFOAM、ClickHouse、Valkey 和記憶體頻寬。每個結果均為多次測試的中位數。
所有四個系統均在 BIOS 散熱模式設定為「超高性能」的情況下運行,T4 運行的是 BIOS 1.2.0。 T4 測試平台使用了 sr-harness 3.3,Precision 7875 使用了 3.5,兩台 T2 都使用了 3.6,這些版本都使用了相同的測試陣容。
所有對比系統均為戴爾塔式機,配備 RTX PRO 6000 Blackwell 顯示卡。戴爾 Precision 7875採用 96 核心 Threadripper PRO 9995WX 處理器,搭配兩張 RTX PRO 6000 Max-Q 顯示卡和 512GB DDR5-5600 內存,是配置最接近的對比機型。戴爾 Pro Precision 9 T2搭載 24 核心 Xeon 658X 處理器和一張 Max-Q 顯示卡,而戴爾 Pro Max Tower T2 則搭載 24 核心 Core Ultra 9 285K 處理器和 600W RTX PRO 6000 核心 Core Ultra 9 285K 處理器和 600W RTX PRO 6000 核心 Core卡,這體現了更高的 GPU 限制所帶來的效能提升。
| 型號 | 中央處理器 | 記憶體應用 | GPU | 試駕 | BIOS 熱模式 |
|---|---|---|---|---|---|
| 戴爾專業版 Precision 9 T4 | Xeon 698X,86 核 | 256GB DDR5-6400(8通道) | 2塊 RTX PRO 6000 Max-Q (300W) | 2TB SK海力士PCB01 Gen5 | 超性能 |
| 戴爾Precision 7875 | Threadripper PRO 9995WX,96 核心 | 512GB DDR5-5600(8通道) | 2塊 RTX PRO 6000 Max-Q (300W) | 2TB 三星 Gen4 | 超性能 |
| 戴爾專業版 Precision 9 T2 | Xeon 658X,24 核 | 128GB DDR5-6400(4通道) | 1塊 RTX PRO 6000 Max-Q (300W) | 三星 PM9E1 Gen5,2TB 硬碟,組成條狀陣列 | 超性能 |
| 戴爾 Pro Max 塔式 T2 | Core Ultra 9 285K,24 核 | 128GB DDR5-4400(2通道) | 1塊RTX PRO 6000(600W) | 2TB 三星 PM9F1 Gen4 | 超性能 |
本地人工智慧效能
這裡的每個系統都至少配備一塊 96GB GDDR7 顯存的 RTX PRO 6000 Blackwell 顯示卡,因此單 GPU 測試結果主要衡量顯示卡本身的效能、功耗極限以及平台為其供電的速度。 T4 的雙顯示卡配置使其脫穎而出,我們的雙 GPU 測試針對每種型號都採用了三種不同的方式:第一種是使用兩台獨立的伺服器(每台伺服器配備一塊顯示卡)進行吞吐量測試;第二種是將一個模型按層級分配到兩塊顯示卡上進行測試;第三種是針對 MiniMax M2.7 處理器,將加載到其中一塊系統記憶體卡中的資料。
LLM 在單一 GPU 上運行
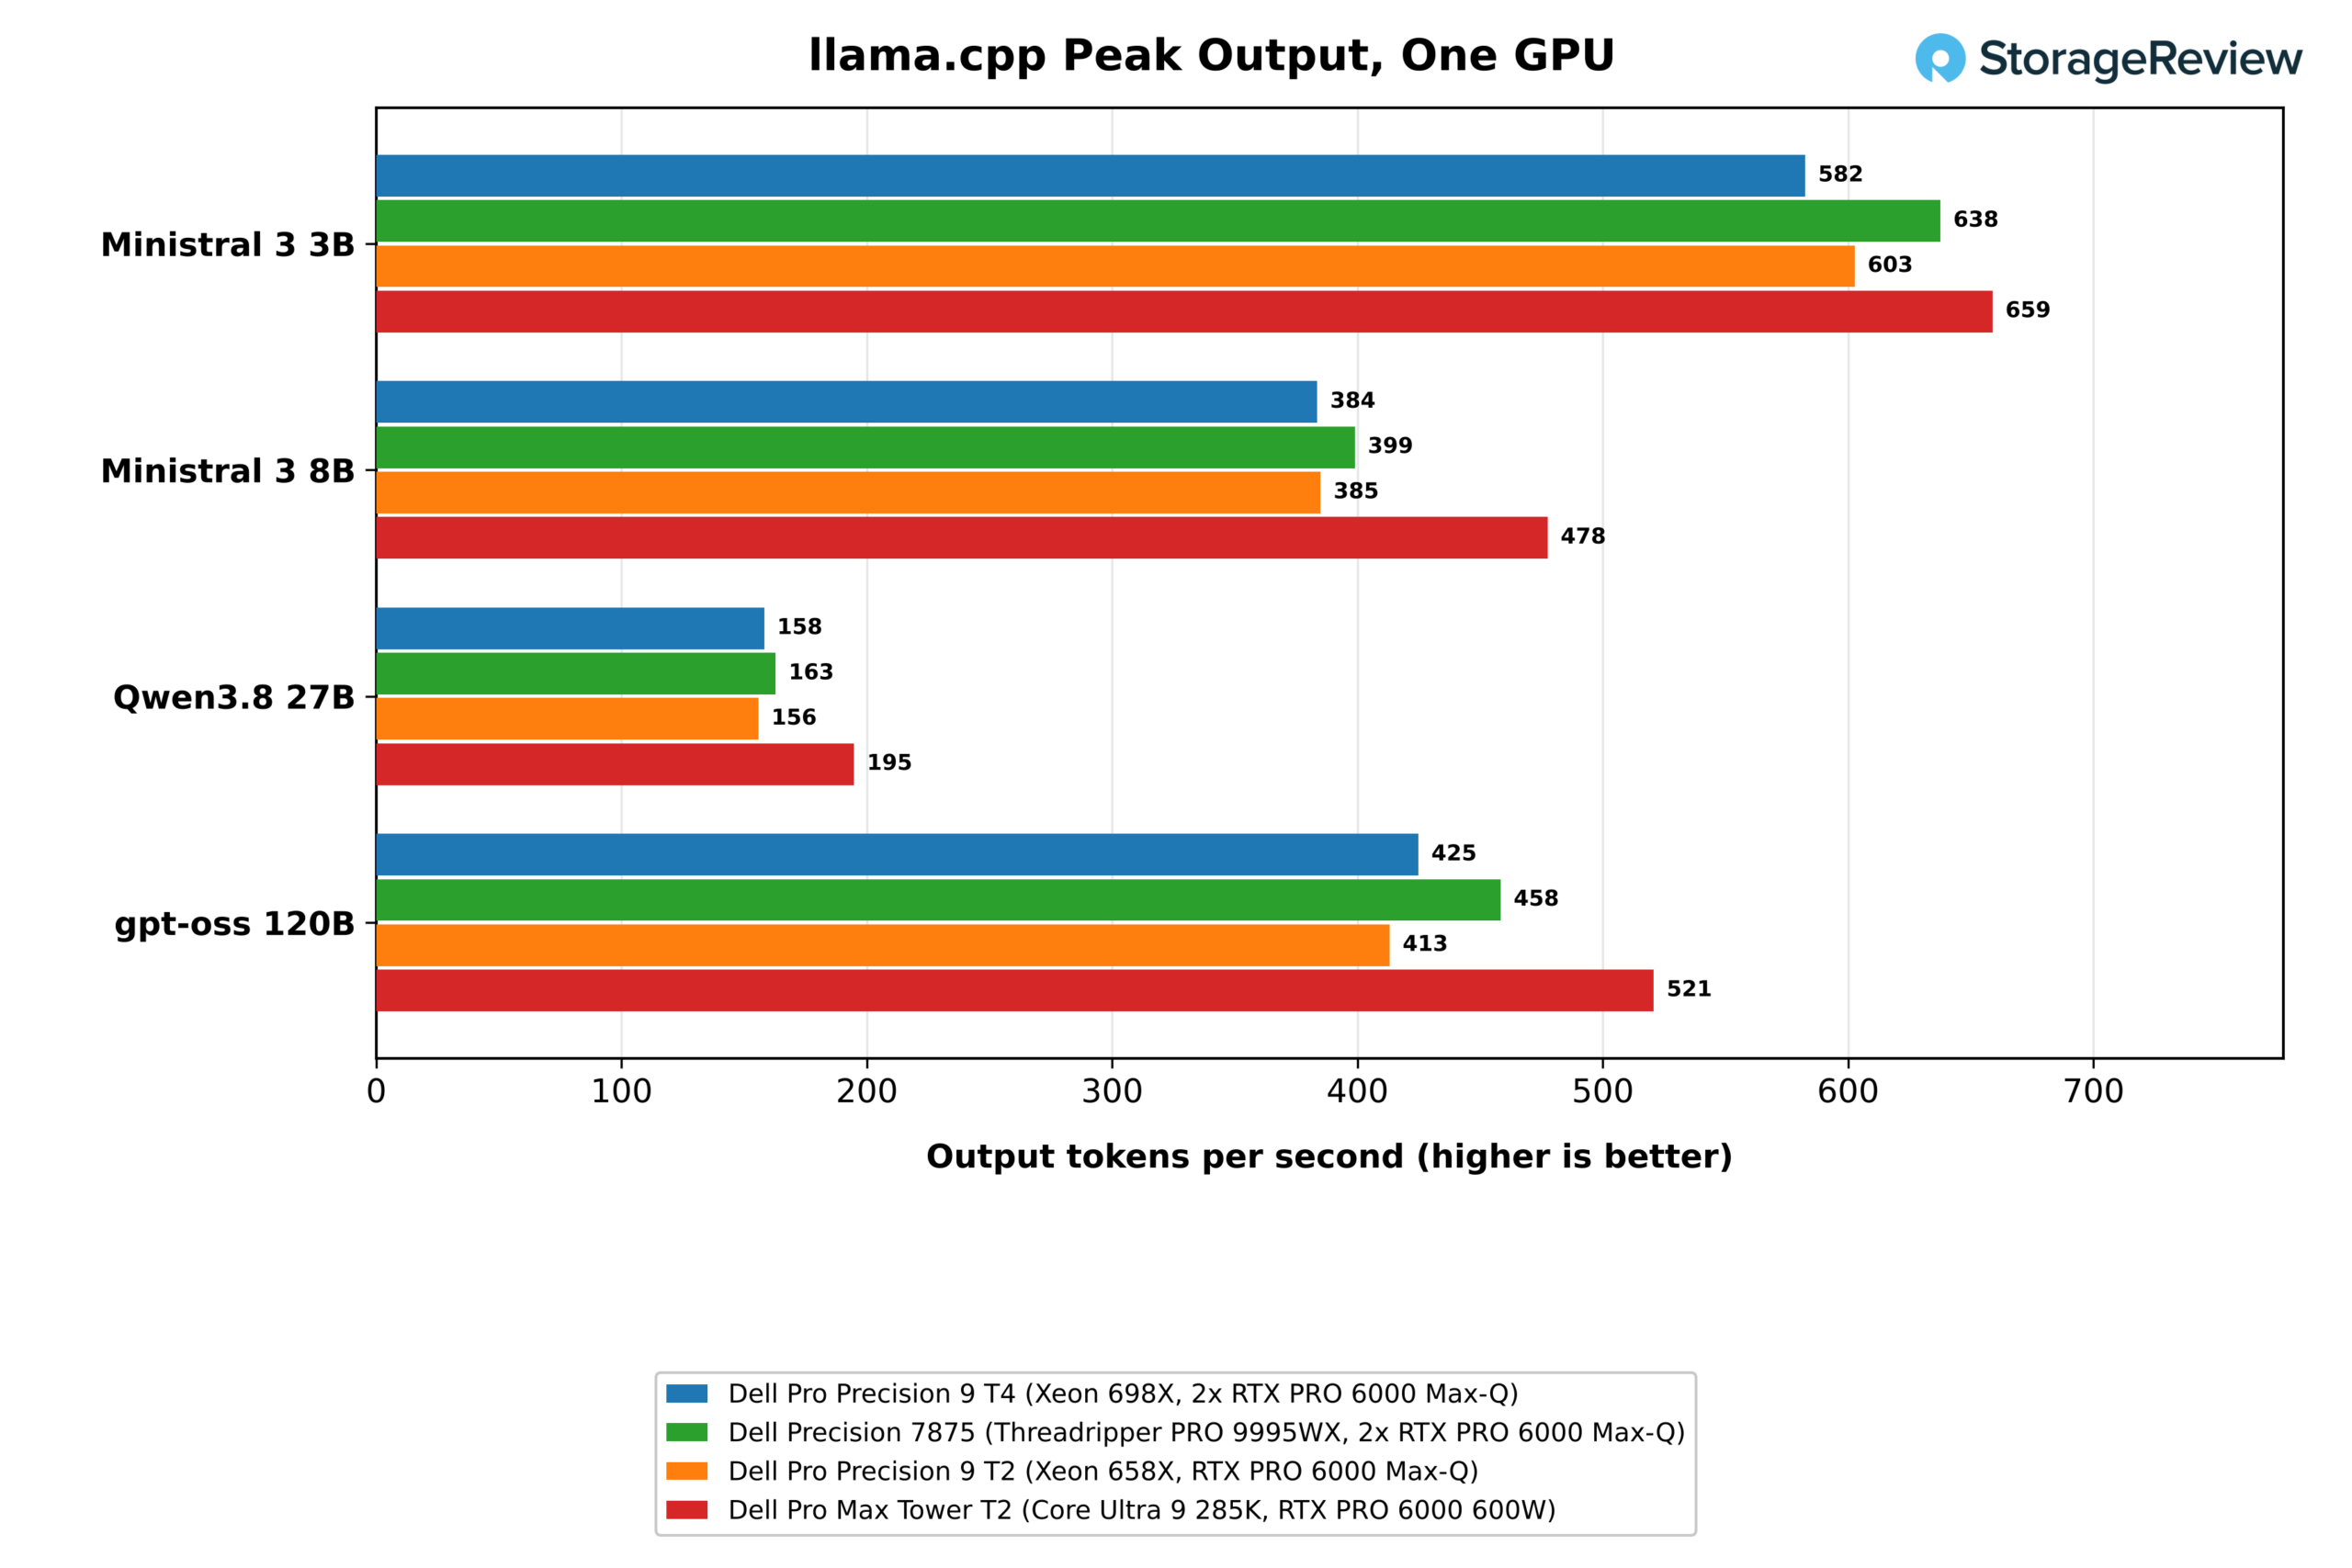
| llama.cpp 伺服器,單一 GPU(每秒輸出 token 數,越高越好) | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| 部長3號3B,一項請求 | 240.5 | 252.6 | 243.8 | 261.6 |
| 部長3號3B,峰 | 582.5 | 637.6 | 602.6 | 658.8 |
| 部長3號8B,一項請求 | 166.8 | 171.1 | 167.3 | 194.5 |
| 部長3號8B,峰 | 383.6 | 398.9 | 384.9 | 477.5 |
| Qwen3.8 27B,一個請求 | 54.9 | 55.4 | 53.8 | 64.5 |
| Qwen3.8 27B,峰值 | 158.1 | 162.8 | 155.8 | 194.7 |
| gpt-oss 120B,一個請求 | 166.9 | 171.2 | 164.5 | 193.0 |
| gpt-oss 120B,峰值 | 424.8 | 458.4 | 413.1 | 520.7 |
| gpt-oss 120B,單次請求,首次取得代幣所需時間(毫秒,越低越好) | 1,189 | 1,181 | 1,213 | 844 |
在單GPU配置下,T4的效能達到了此顯示卡300W功耗限制的上限。在gpt-oss 120B鏡像上,它能為單一用戶產生每秒166.9個令牌,在64個並發請求的情況下,峰值達到每秒424.8個令牌,在所有四款機型中,其性能與配備Max-Q處理器的Precision 7875顯示卡相差不到1%到9%,與配備Max-Q處理器的Precision 7875顯示卡相差不到1%到9%,與 Precision 的性能相當1%。 Pro Max Tower T2中的600W顯示卡在所有機型上的峰值速度都提升了13%到25%,在gpt-oss 120B鏡像上達到了每秒520.7個代幣。
兩款GPU:副本模型與分割模型
| llama.cpp 伺服器,雙 GPU(每秒輸出 token 數,越高越好) | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 |
|---|---|---|
| Ministral 3 3B,峰值,每台伺服器對應一個GPU | 1,176.1 | 1,260.2 |
| Ministral 3 8B,峰值,每台伺服器對應一個GPU | 765.7 | 796.4 |
| Qwen3.8 27B,峰值,每台伺服器對應一個GPU | 310.8 | 323.2 |
| gpt-oss 120B,峰值,每台伺服器對應一個GPU | 787.9 | 905.8 |
| gpt-oss 120B,一個請求,按層拆分 | 170.6 | 182.4 |
| gpt-oss 120B,峰值,依層分割 | 539.2 | 619.4 |
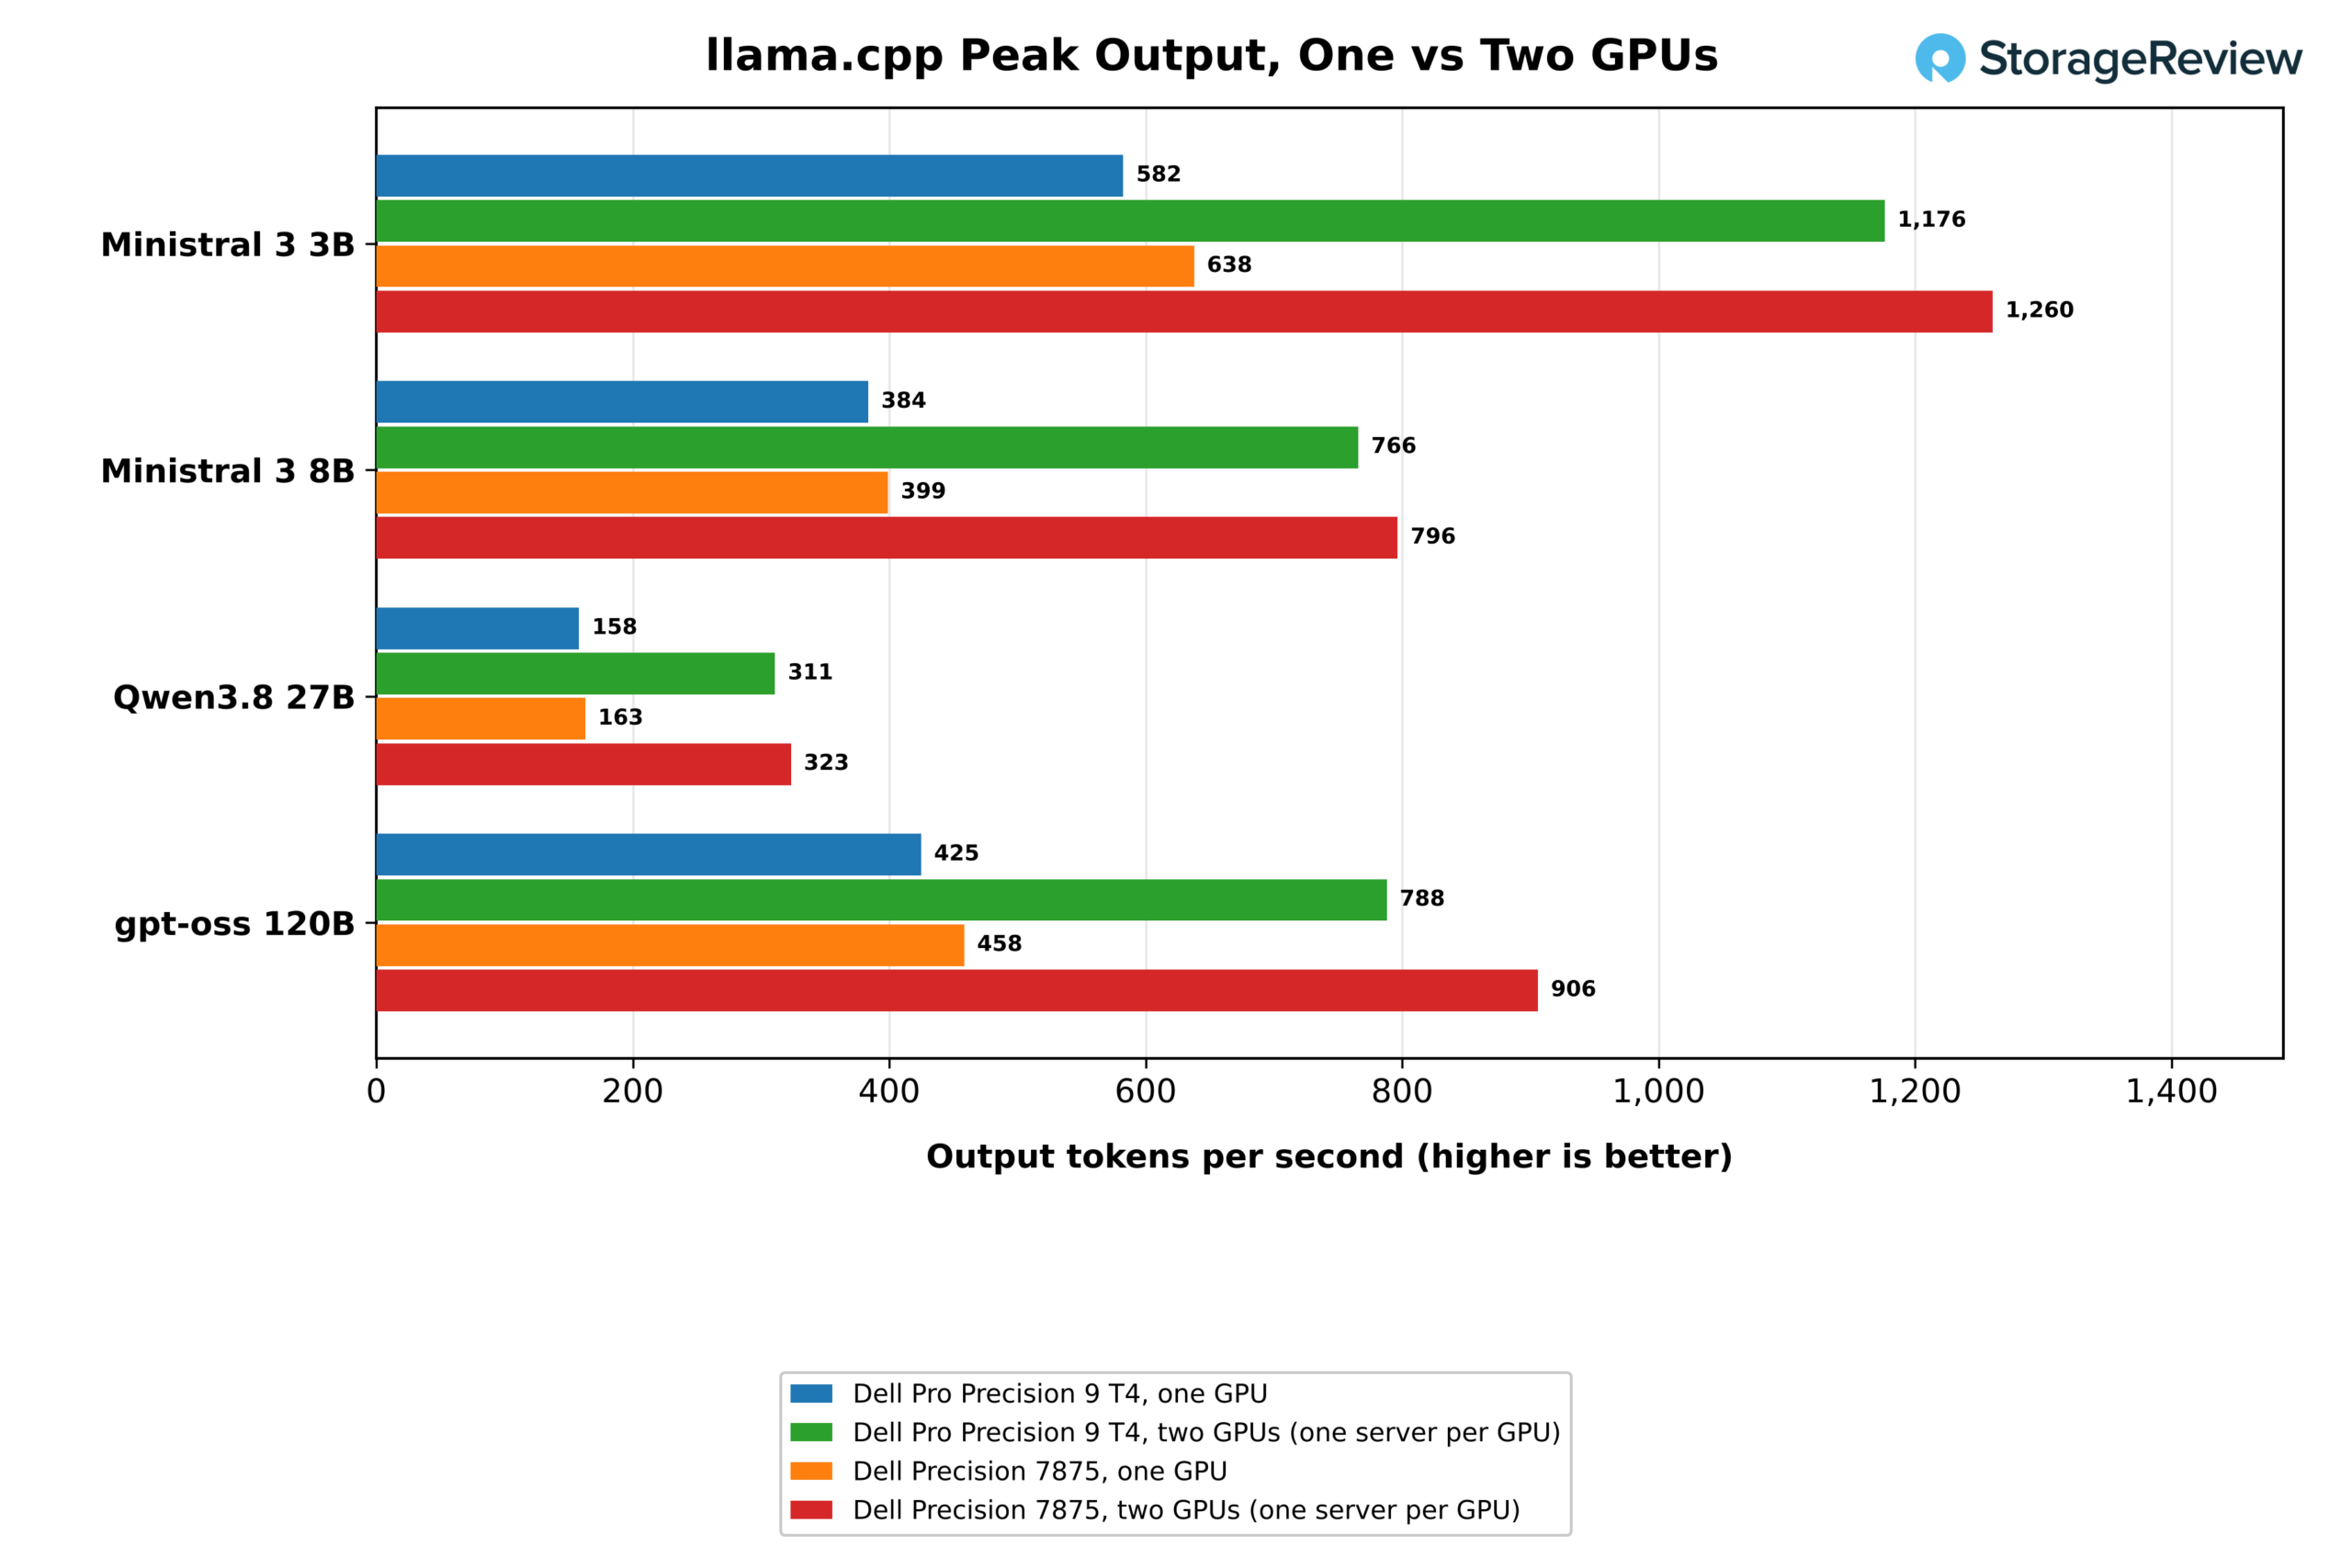
每個 GPU 運行一台伺服器,使 T4 的峰值輸出在四種型號上都提升了 1.85 到 2.02 倍。 。 gpt-oss 120B 在 T4 上的峰值輸出提升了 1.85 倍,達到每秒 787.9 個令牌;在 Precision 7875 上提升了 1.98 倍,達到每秒 905.8 個令牌,峰值並發請求數達到 128 個,而 T4 的峰值並發請求數為 64 個請求數達到 128 個,而 T4 的峰值並發請求數為 64 個。
將 gpt-oss 120B 資料按層分配到兩張顯示卡上,對於已經能夠載入到一張顯示卡上的模型來說,是使用第二張顯示卡速度較慢的方式。這種方式處理單一使用者的速度為每秒 170.6 個令牌,與單張顯示卡的速度相差不到 3%,峰值速度為每秒 539.2 個令牌,比單張顯示卡高出 27%,但遠低於兩張顯示卡達到的 787.9 個令牌。這種分層分配的方式適用於無法載入到單張顯示卡上的模型,例如 MiniMax M2.7。
| llama.cpp 伺服器,gpt-oss 120B,8,192 個令牌提示符,1,024 個令牌輸出 | T4,單GPU | T4,雙GPU,每塊GPU一台伺服器 | T4,兩個GPU,依層劃分 | Precision 7875,雙GPU,每塊GPU一台伺服器 |
|---|---|---|---|---|
| 1 個並發節點:總吞吐量(令牌/秒) | 1,502 | 1,504 | 1,536 | 1,530 |
| 1 個同時使用者:首次到達令牌的時間,中位數(毫秒,數值越低越好) | 1,189 | 1,180 | 719 | 1,189 |
| 8 個並發節點:總吞吐量(令牌/秒) | 2,760 | 4,820 | 3,300 | 4,949 |
| 8 個同時使用者:每個使用者的輸出(令牌/秒) | 38.3 | 66.9 | 45.8 | 68.7 |
| 8 個同時使用者:首次到達令牌的時間,中位數(毫秒,數值越低越好) | 2,654 | 2,523 | 1,622 | 2,472 |
| 64 個並發節點:總吞吐量(令牌/秒) | 3,823 | 7,091 | 4,853 | 7,557 |
| 64 個同時使用者:每個使用者的輸出(令牌/秒) | 6.6 | 12.3 | 8.4 | 13.1 |
| 64 個同時使用者:首次到達令牌的時間,中位數(毫秒,數值越低越好) | 3,874 | 3,226 | 2,852 | 2,867 |
在 gpt-oss 120B 上的完整測試表明,第二張顯示卡如何改變了效能曲線,總吞吐量包括提示符號和輸出令牌的數量。單 GPU 的吞吐量從單一請求的每秒 1,502 個令牌提升到 8 個並發請求時的每秒 2,760 個令牌,以及 64 個並發請求時的每秒 3,823 個令牌,此時每個使用者每秒可獲得 6.6 個輸出令牌。每張 GPU 連接一個伺服器時,總吞吐量在 8 個並發請求時達到每秒 4,820 個令牌,在 64 個並發請求時達到每秒 7,091 個令牌。在 64 個並發請求時,吞吐量是單卡吞吐量的 1.85 倍,每個用戶每秒可獲得 12.3 個輸出令牌。將模型分配到兩張顯示卡上,雖然峰值吞吐量有所下降,總令牌數為每秒 4,853 個令牌,但單一使用者獲得第一個令牌的時間從 1,189 毫秒縮短至 719 毫秒。

MiniMax M2.7:一款尺寸過大的顯示卡
| MiniMax M2.7 Q4_K_M,129.3GB(除非另有說明,容量越大越好) | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| 一個GPU加上系統內存,一個請求(令牌/秒) | 30.3 | 32.8 | 22.6 | 15.8 |
| 單一 GPU 加上系統內存,峰值(令牌/秒) | 35.5 | 39.1 | 27.7 | 18.0 |
| 單GPU加系統內存,首次令牌到達時間(毫秒,越低越好) | 16,224 | 16,143 | 16,216 | 18,522 |
| 兩塊GPU按層劃分,一個請求(令牌/秒) | 83.7 | 85.0 | 單 GPU | 單 GPU |
| 兩塊GPU依層劃分,峰值(令牌/秒) | 127.3 | 129.5 | 單 GPU | 單 GPU |
| 兩塊GPU依層分配,首次到達令牌的時間(毫秒,越低越好) | 3,138 | 3,162 | 單 GPU | 單 GPU |
| 冷啟動,單GPU加記憶體(數值越低越好) | 40.5 | 65.8 | 37.6 | 81.1 |
| 冷啟動,雙GPU分擔負載(s值越低越好) | 27.6 | 50.7 | 單 GPU | 單 GPU |
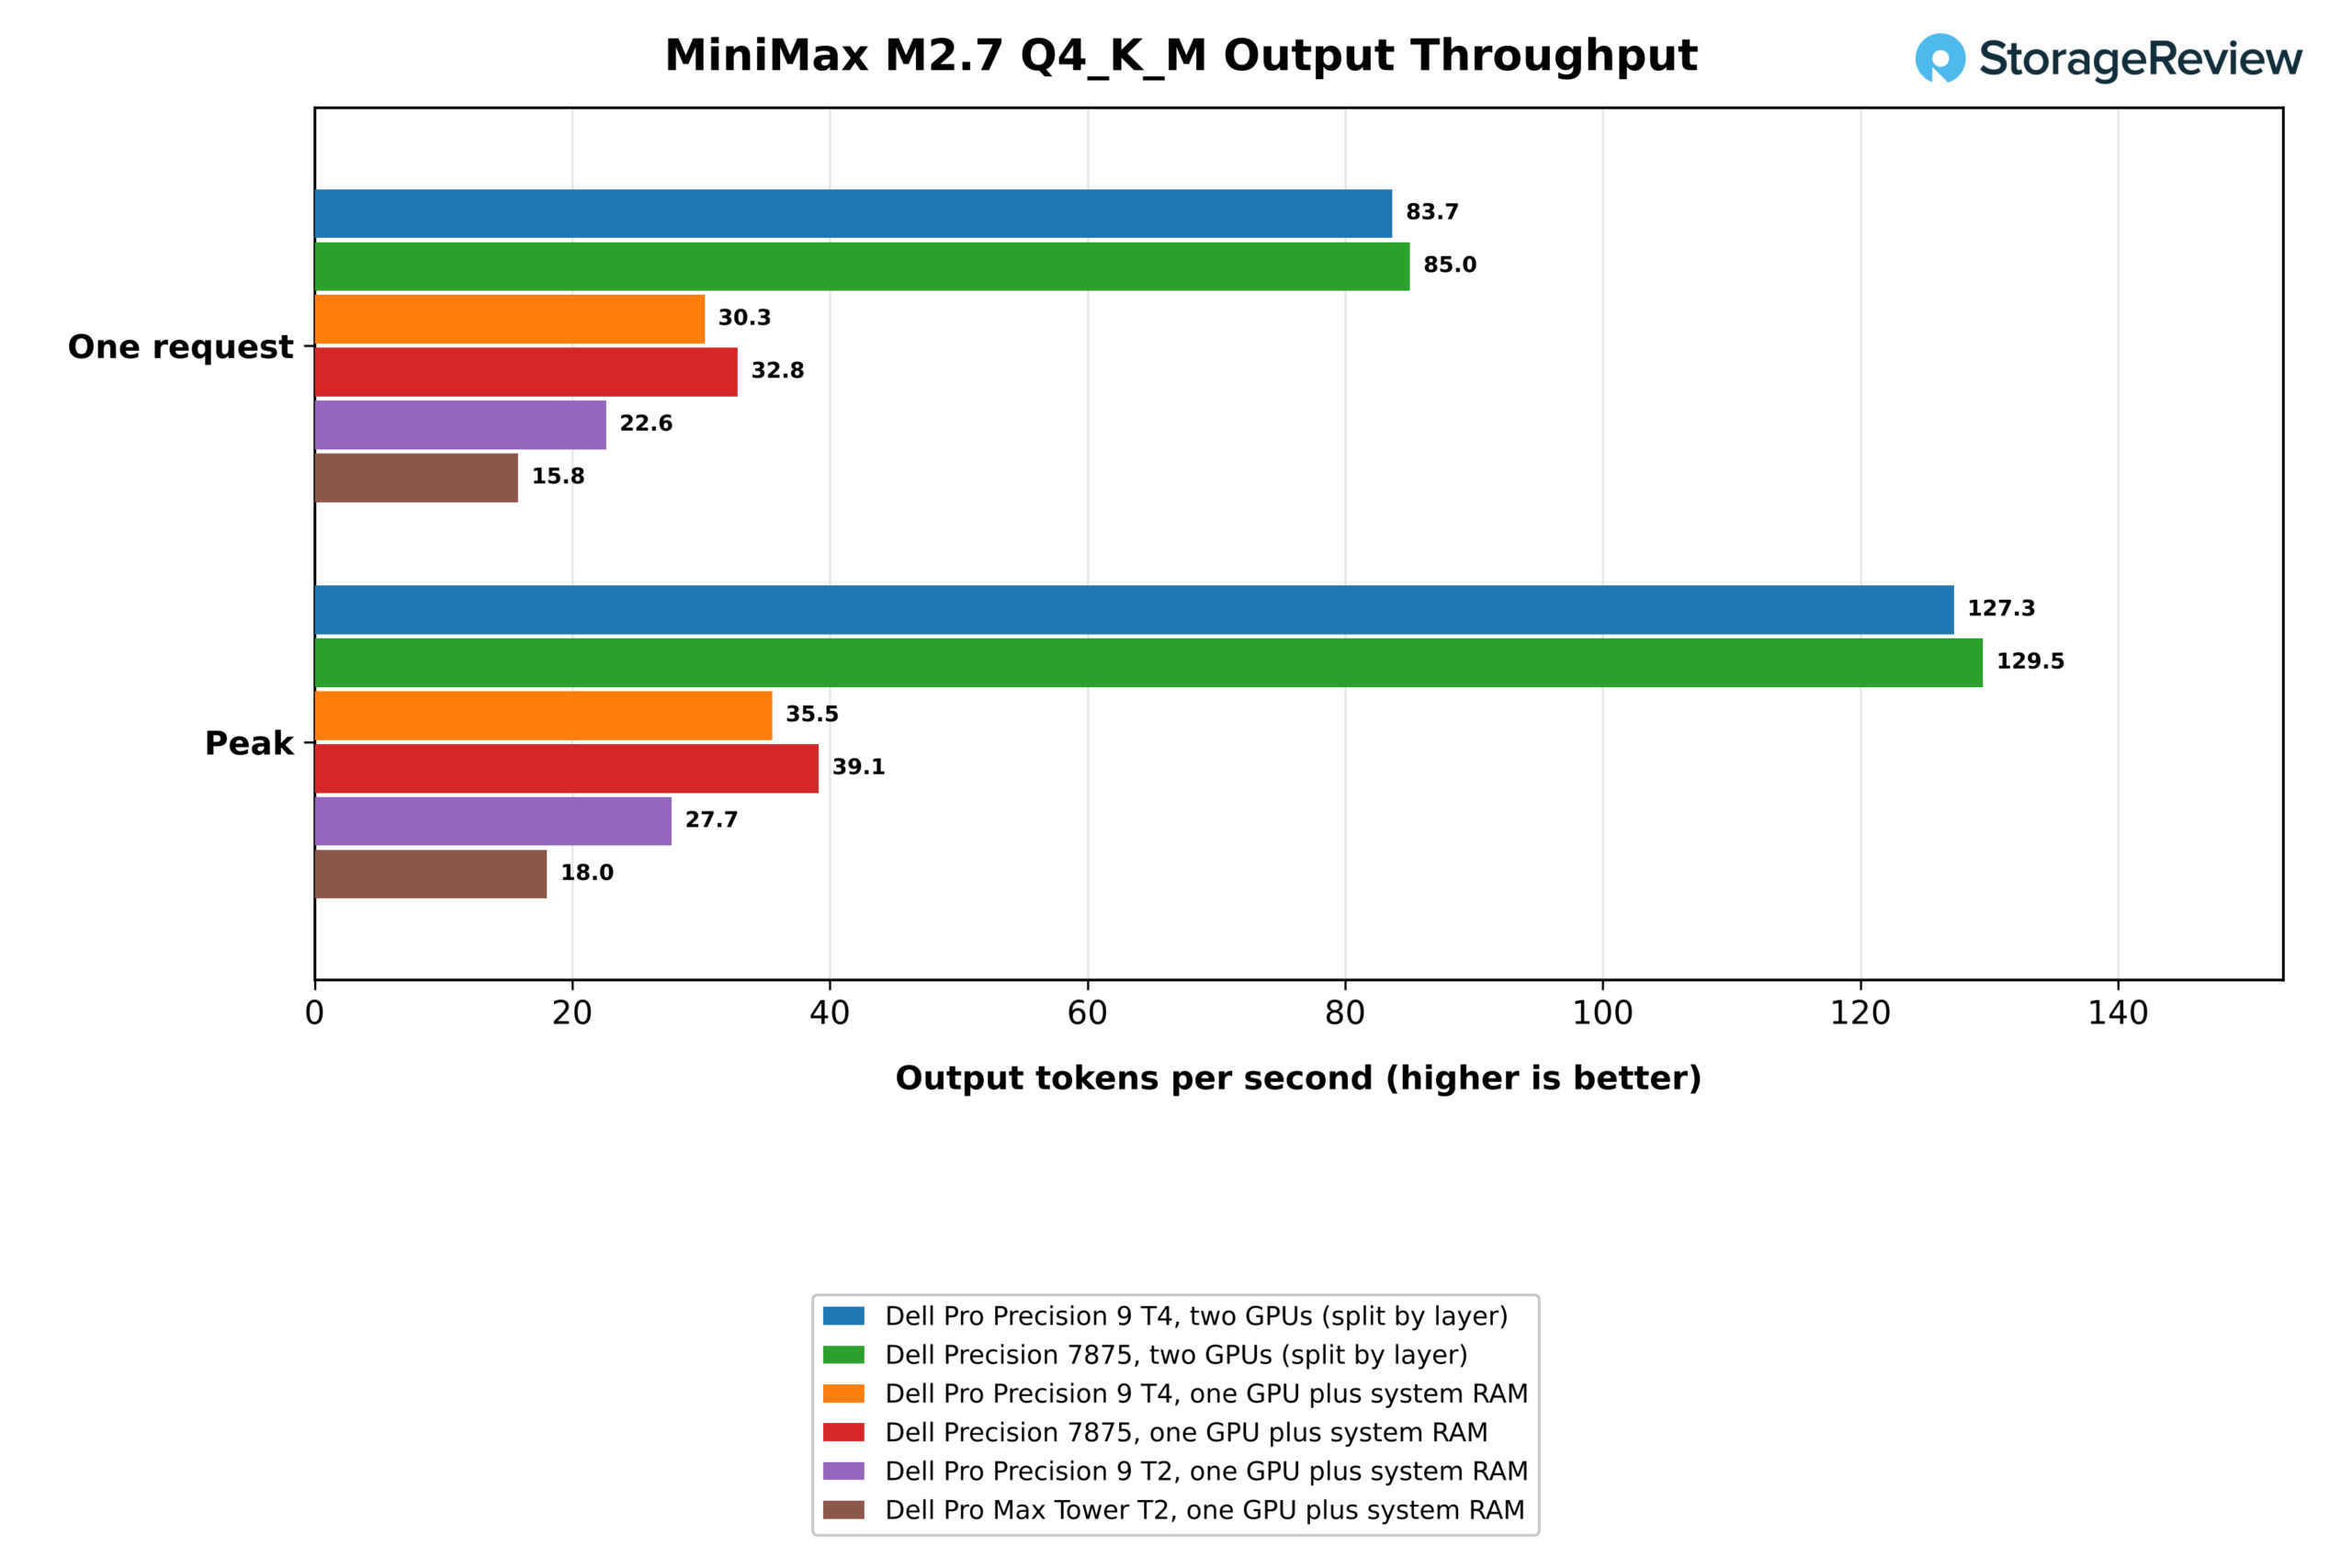
MiniMax M2.7 是一個擁有 230 億參數的混合專家模型,其 4 位元量化佔用 129.3GB 內存,超過了單張 RTX PRO 6000 的 96GB 內存。在單卡運行(其餘記憶體位於系統記憶體)的情況下,T4 為單一使用者每秒產生 30.3 個令牌,傳回第一個令牌耗時 16.2 秒。將模型分配到兩張顯示卡上後,單一使用者輸出提升至每秒 83.7 個令牌,是單卡運行速度的 2.8 倍。返回第一個令牌的時間從 16.2 秒縮短至 3.1 秒,峰值吞吐量從每秒 35.5 個令牌提升至每秒 127.3 個令牌。
單GPU測試結果顯示,一旦模型效能超出系統記憶體限制,主機平台的重要性就顯而易見。 T4配備八通道DDR5-6400內存,其性能比四通道Pro Precision 9 T2高出34%,達到每秒22.6個令牌;比雙通道Pro Max Tower T2高出1.9倍,達到每秒15.8個令牌,儘管Pro Max Tower T2的600W顯卡在所有適配的模型上速度都更快。 Precision 7875的記憶體頻寬比T4低35%,但效能卻以每秒32.8個令牌略勝一籌,因此僅憑頻寬無法解釋此結果。我們報告的是7875的領先優勢,尚未確定其具體原因。
模型加載
| Ollama 0.40.3 和 llama.cpp 模型負載(s,越低越好) | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| gpt-oss:20b (12.8GB),冷啟動 | 5.79 | 7.61 | 5.57 | 7.95 |
| gpt-oss:20b,暖色調 | 3.45 | 2.50 | 3.47 | 3.05 |
| gpt-oss:120b (60.9GB),冷啟動 | 15.16 | 25.80 | 15.16 | 28.18 |
| gpt-oss:120b,暖色調 | 7.49 | 5.01 | 7.87 | 6.81 |
| gpt-oss:120b,冷寫入,每個 GPU 上各一份 | 26.47 | 35.55 | 單 GPU | 單 GPU |
| MiniMax M2.7 (129.3GB),冷啟動,單顯示卡加記憶體 | 40.5 | 65.8 | 37.6 | 81.1 |
| MiniMax M2.7,發熱,單顯示卡加內存 | 28.6 | 15.2 | 36.7 | 80.5 |
冷啟動載重測試中,第五代固態硬碟(Gen5 SSD)表現較佳。 T4 從其 SK 海力士第五代固態硬碟載入 gpt-oss:120b 檔案系統僅需 15.2 秒,與 Pro Precision 9 T2 的速度相當,遠超配備第四代固態硬碟的 Precision 7875(25.8 秒)和 Pro Max Tower T2(28.2 秒)。而從頁面快取進行熱啟動載入測試時,情況則相反,7875 僅需 5.0 秒,T4 則需要 7.5 秒。此外,同時將資料副本載入到每個 GPU 上,T4 耗時 26.5 秒。
大規模檢索增強生成
| RAG 超過 1,002,067 個維基百科段落 | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| 嵌入,單GPU(通道/秒) | 1,126 | 1,196 | 1,141 | 1,388 |
| 嵌入牆體時間,單一GPU(秒,數值越低越好) | 890 | 838 | 878 | 722 |
| 嵌入,兩個GPU(遍歷/秒) | 2,162 | 2,371 | 單 GPU | 單 GPU |
| 嵌入牆面時間,兩個 GPU(s,數值越低越好) | 464 | 423 | 單 GPU | 單 GPU |
| HNSW 指數建構(s,越低越好) | 27.3 | 34.8 | 46.3 | 118.6 |
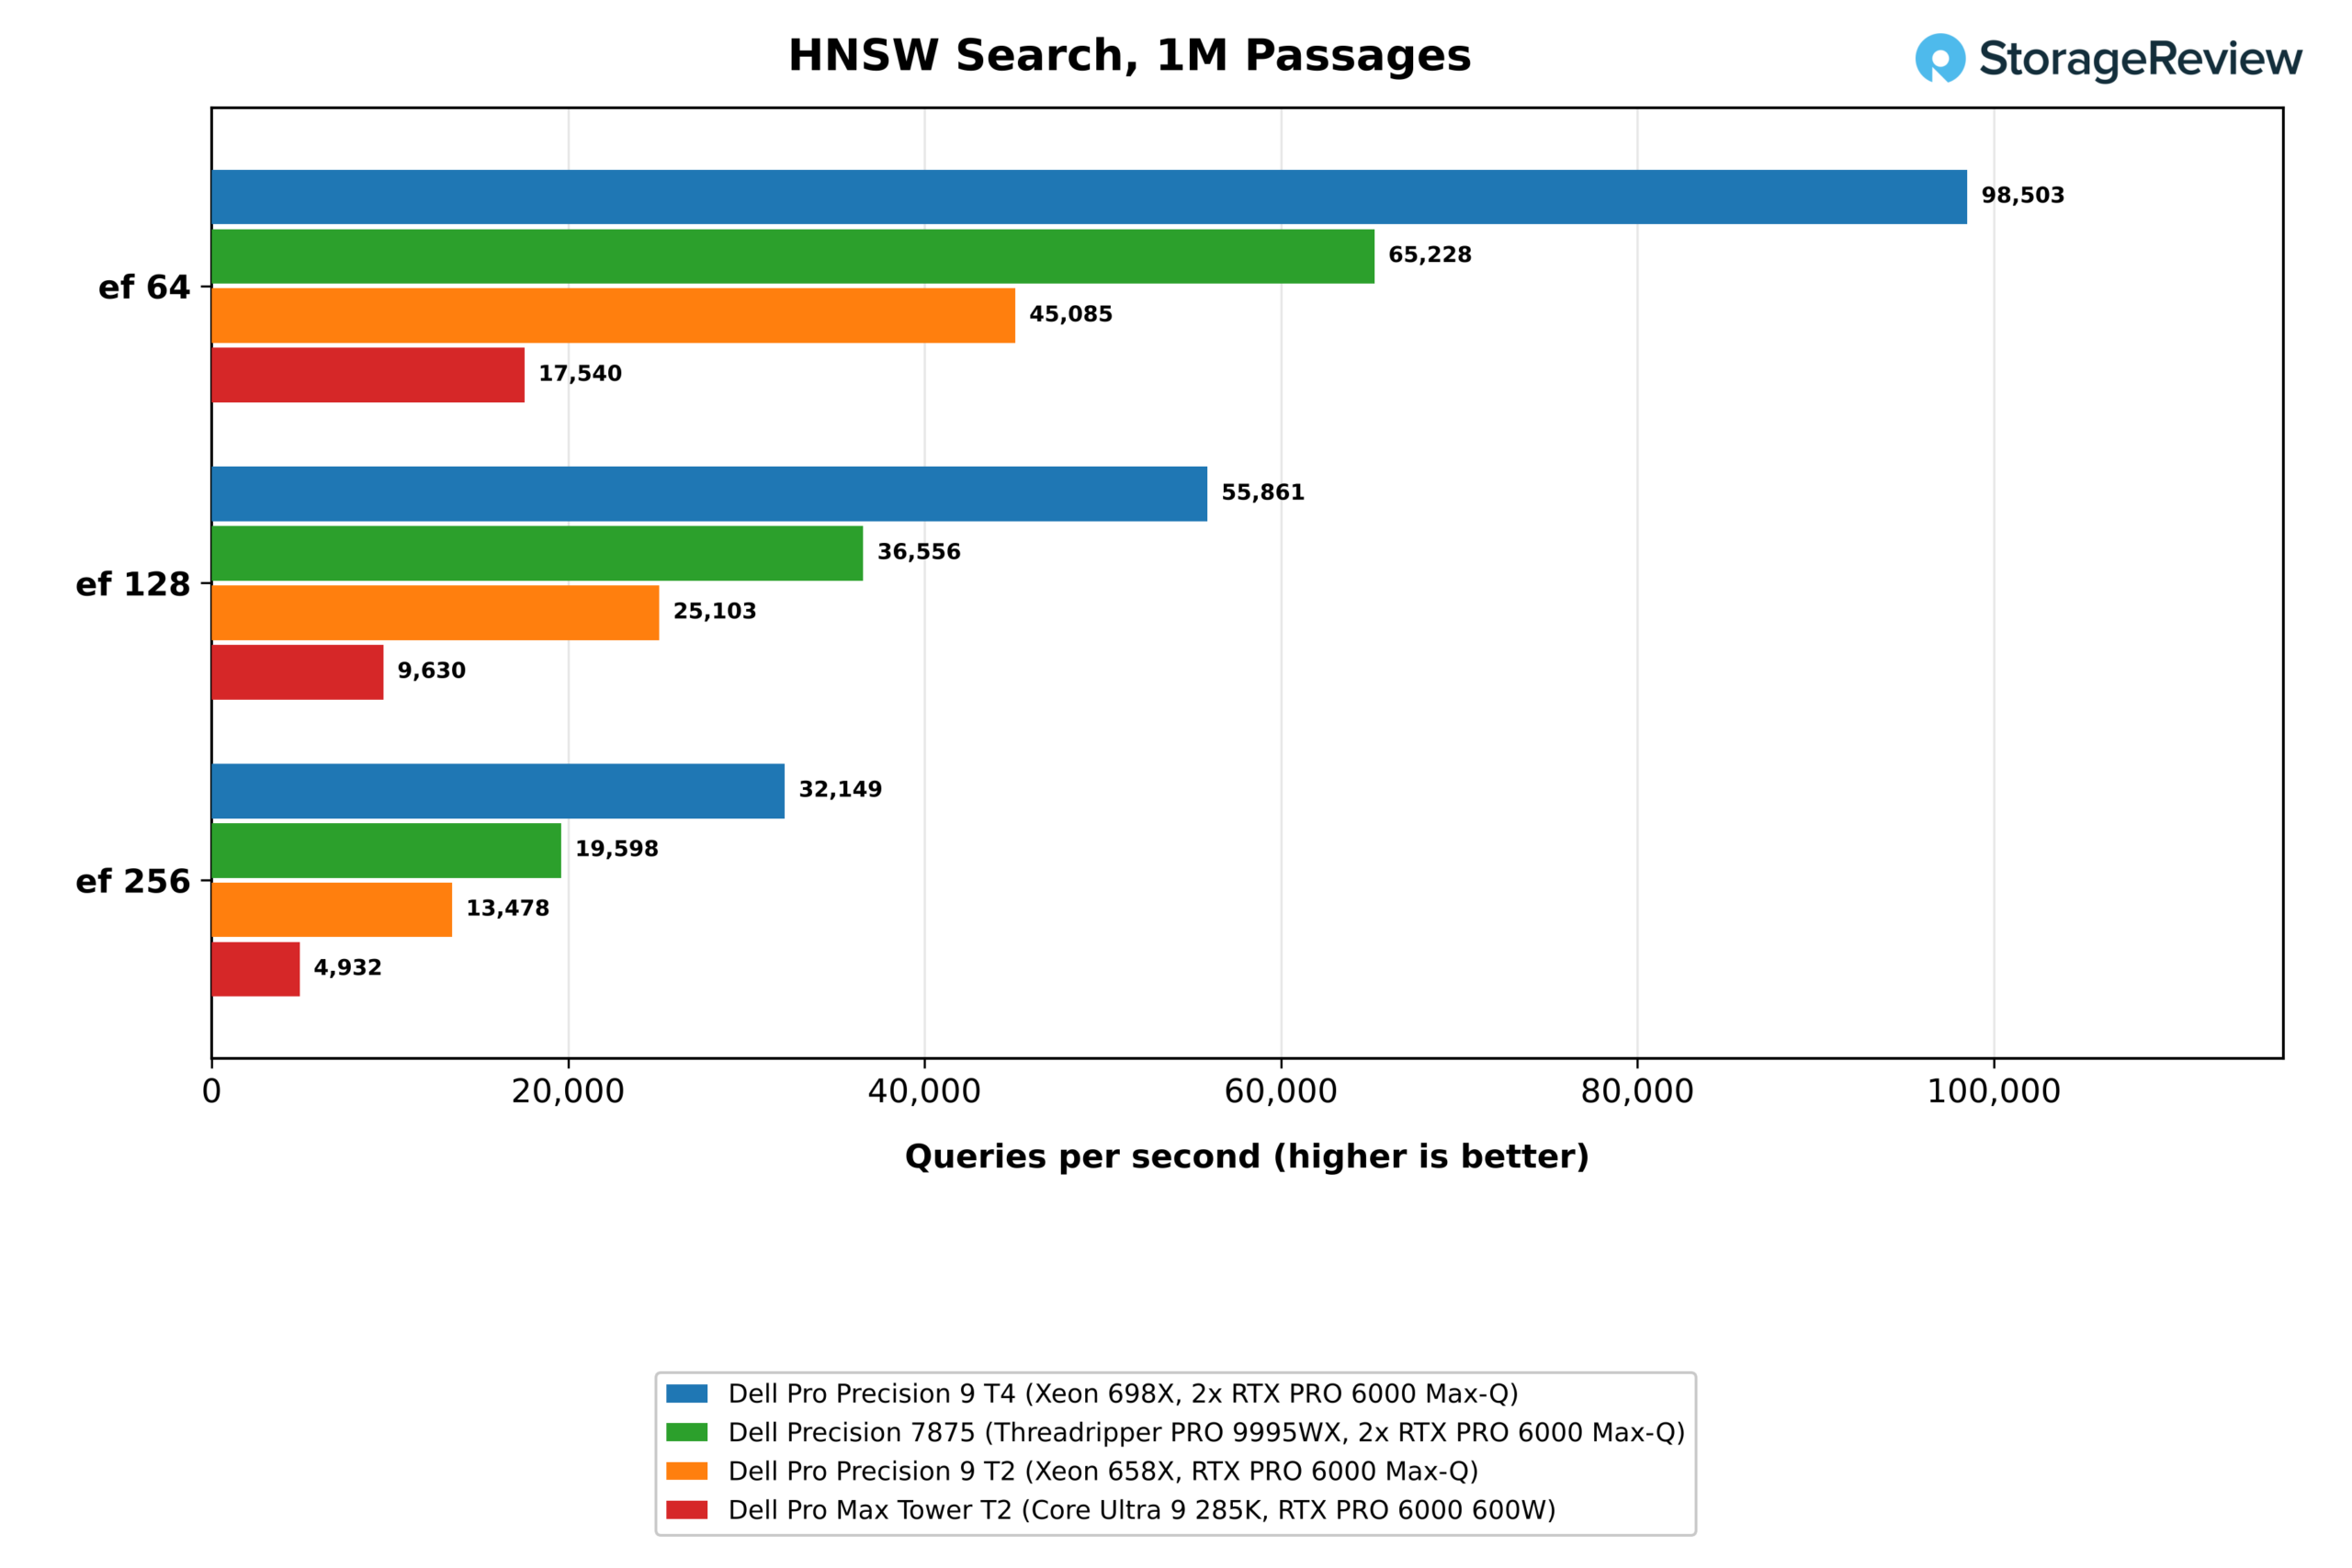
| HNSW 搜索,ef 64(查詢/秒) | 98,503 | 65,228 | 45,085 | 17,540 |
| HNSW 搜索,ef 256(查詢/秒) | 32,149 | 19,598 | 13,478 | 4,932 |
| 召回率@5 與精確搜尋相比,有效值為 256 (%) | 97.59 | 97.67 | 97.26 | 97.70 |
| 第50頁需回答的問題(s,數值越低越好) | 0.123 | 0.082 | 0.117 | 0.095 |
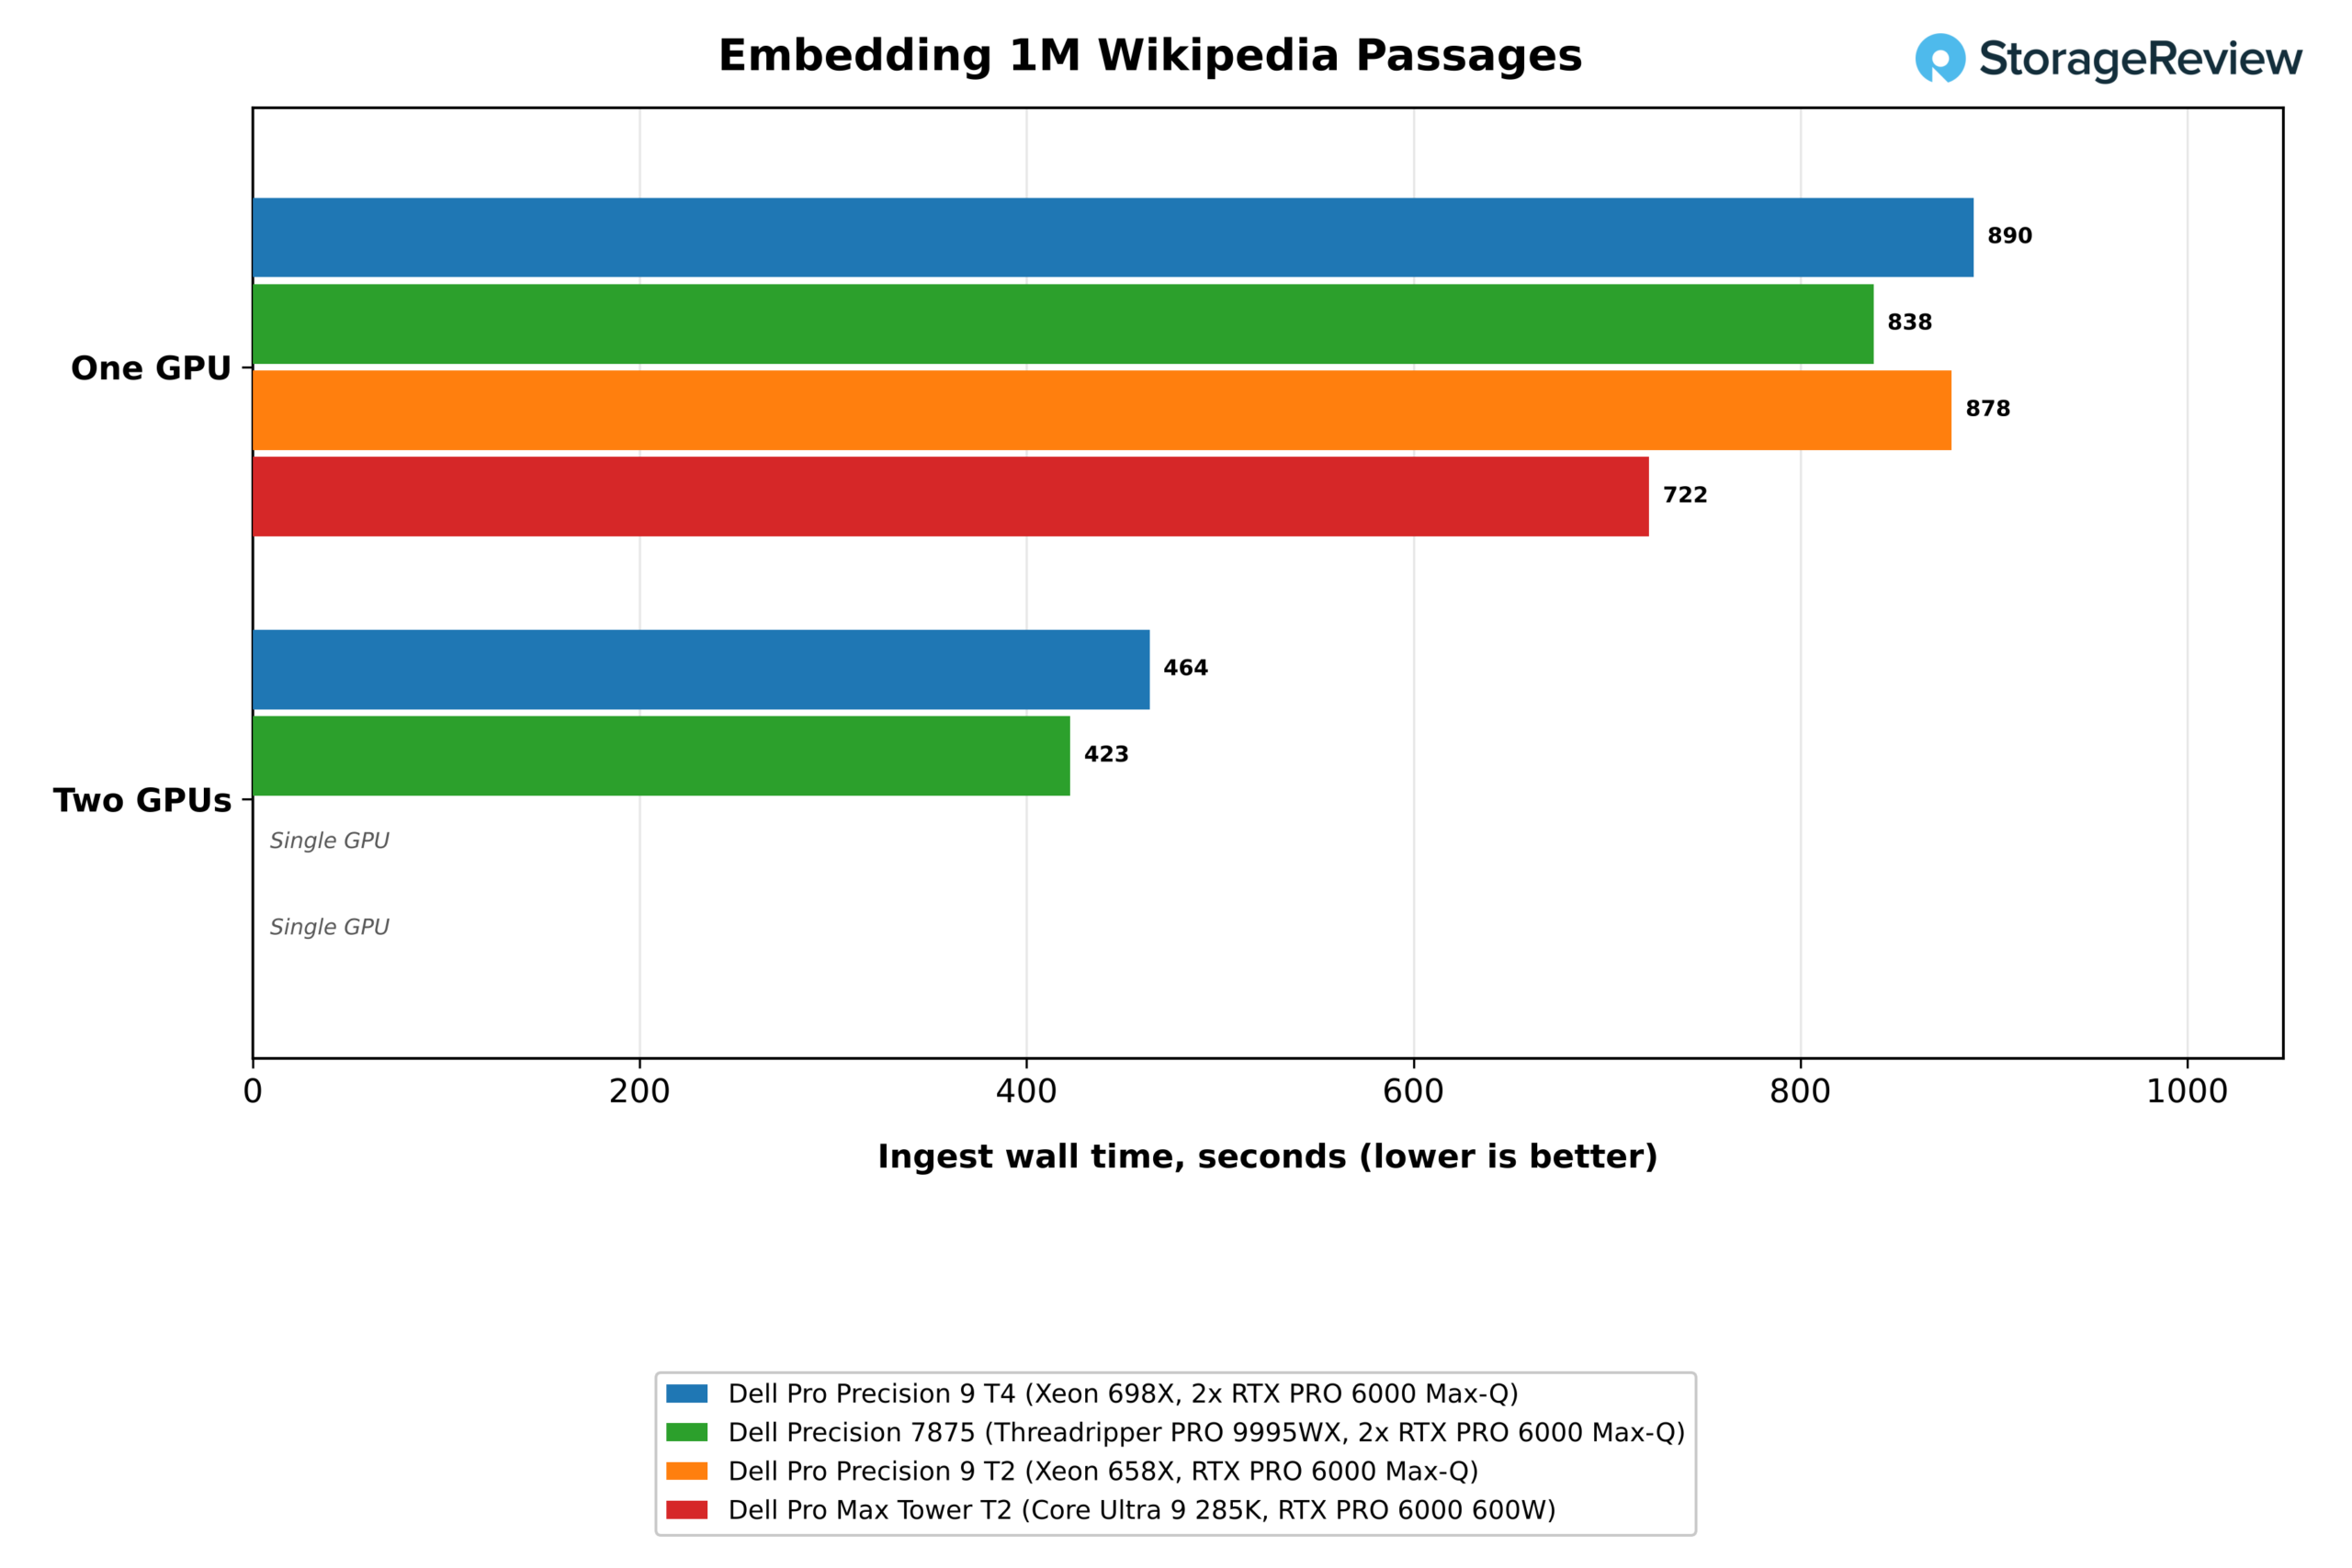
RAG-at-scale 測試將 SQuAD 問題隱藏在一百萬個維基百科段落中,使用 nomic-embed-text 嵌入文本,建立 HNSW 索引,並使用 Phi-4-mini 產生答案。使用兩塊 GPU 將 T4 的嵌入時間從 890 秒縮短到 464 秒,速度提升了 1.92 倍。 Precision 7875 使用兩塊 GPU 完成相同任務耗時 423 秒。 Pro Max Tower T2 中的 600W 顯示卡是本次測試中單 GPU 速度最快的,耗時 722 秒。
索引建置和向量搜尋均在 CPU 上運行,而這正是 T4 的優勢。它建立 HNSW 索引僅需 27.3 秒,而 Precision 7875 和 Pro Max Tower T2 分別需要 34.8 秒和 118.6 秒。在有效搜尋效率 (ef) 為 64 時,其搜尋速度高達每秒 98,503 次查詢,是 7875 的 1.51 倍,Core Ultra 系統的 5.6 倍。在有效搜尋效率 (ef) 為 256 時,其搜尋速度達到每秒 32,149 次查詢,精確搜尋召回率高達 97.6%,回應時間中位數為 0.12 秒。
微調
| Ministral 3 8B LoRA、BF16、Dolly 15k 的一個紀元 | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| 單GPU訓練週期時間(分鐘,越短越好) | 31.5 | 27.2 | 30.6 | 22.3 |
| 吞吐量,單一 GPU(令牌/秒) | 1,584 | 1,834 | 1,631 | 2,236 |
| 訓練前後保留損失,單GPU | 1.534年到1.169年 | 1.534年到1.172年 | 1.534年到1.167年 | 1.534年到1.167年 |
| 使用兩塊 GPU 進行 Epoch 訓練所需的時間(分鐘,越短越好) | 19.7 | 18.1 | 單 GPU | 單 GPU |
| 吞吐量,雙GPU(令牌/秒) | 2,528 | 2,754 | 單 GPU | 單 GPU |
| 第二塊GPU帶來的加速 | 1.60x | 1.50x | 單 GPU | 單 GPU |
| 訓練後保留的損失,雙GPU | 1.167 | 1.168 | 單 GPU | 單 GPU |
單週期 LoRA 測試在 Dolly 15k 上對 BF16 中的 Ministral 3 8B 演算法進行微調,共運行 1,849 步,每 100 步對 200 個預留樣本進行評分。所有系統的初始預留樣本損失均為 1.534,最終損失介於 1.167 和 1.172 之間,因此差異主要體現在每個週期的運行時間上。一台 T4 GPU 以每秒 1,584 個 token 的速度運行了 31.5 分鐘,與搭載相同 Max-Q 顯示卡的 Pro Precision 9 T2 的成績相差不到 3%。 Precision 7875 耗時 27.2 分鐘,而 Pro Max Tower T2 中的 600W 顯示卡則耗時 22.3 分鐘。
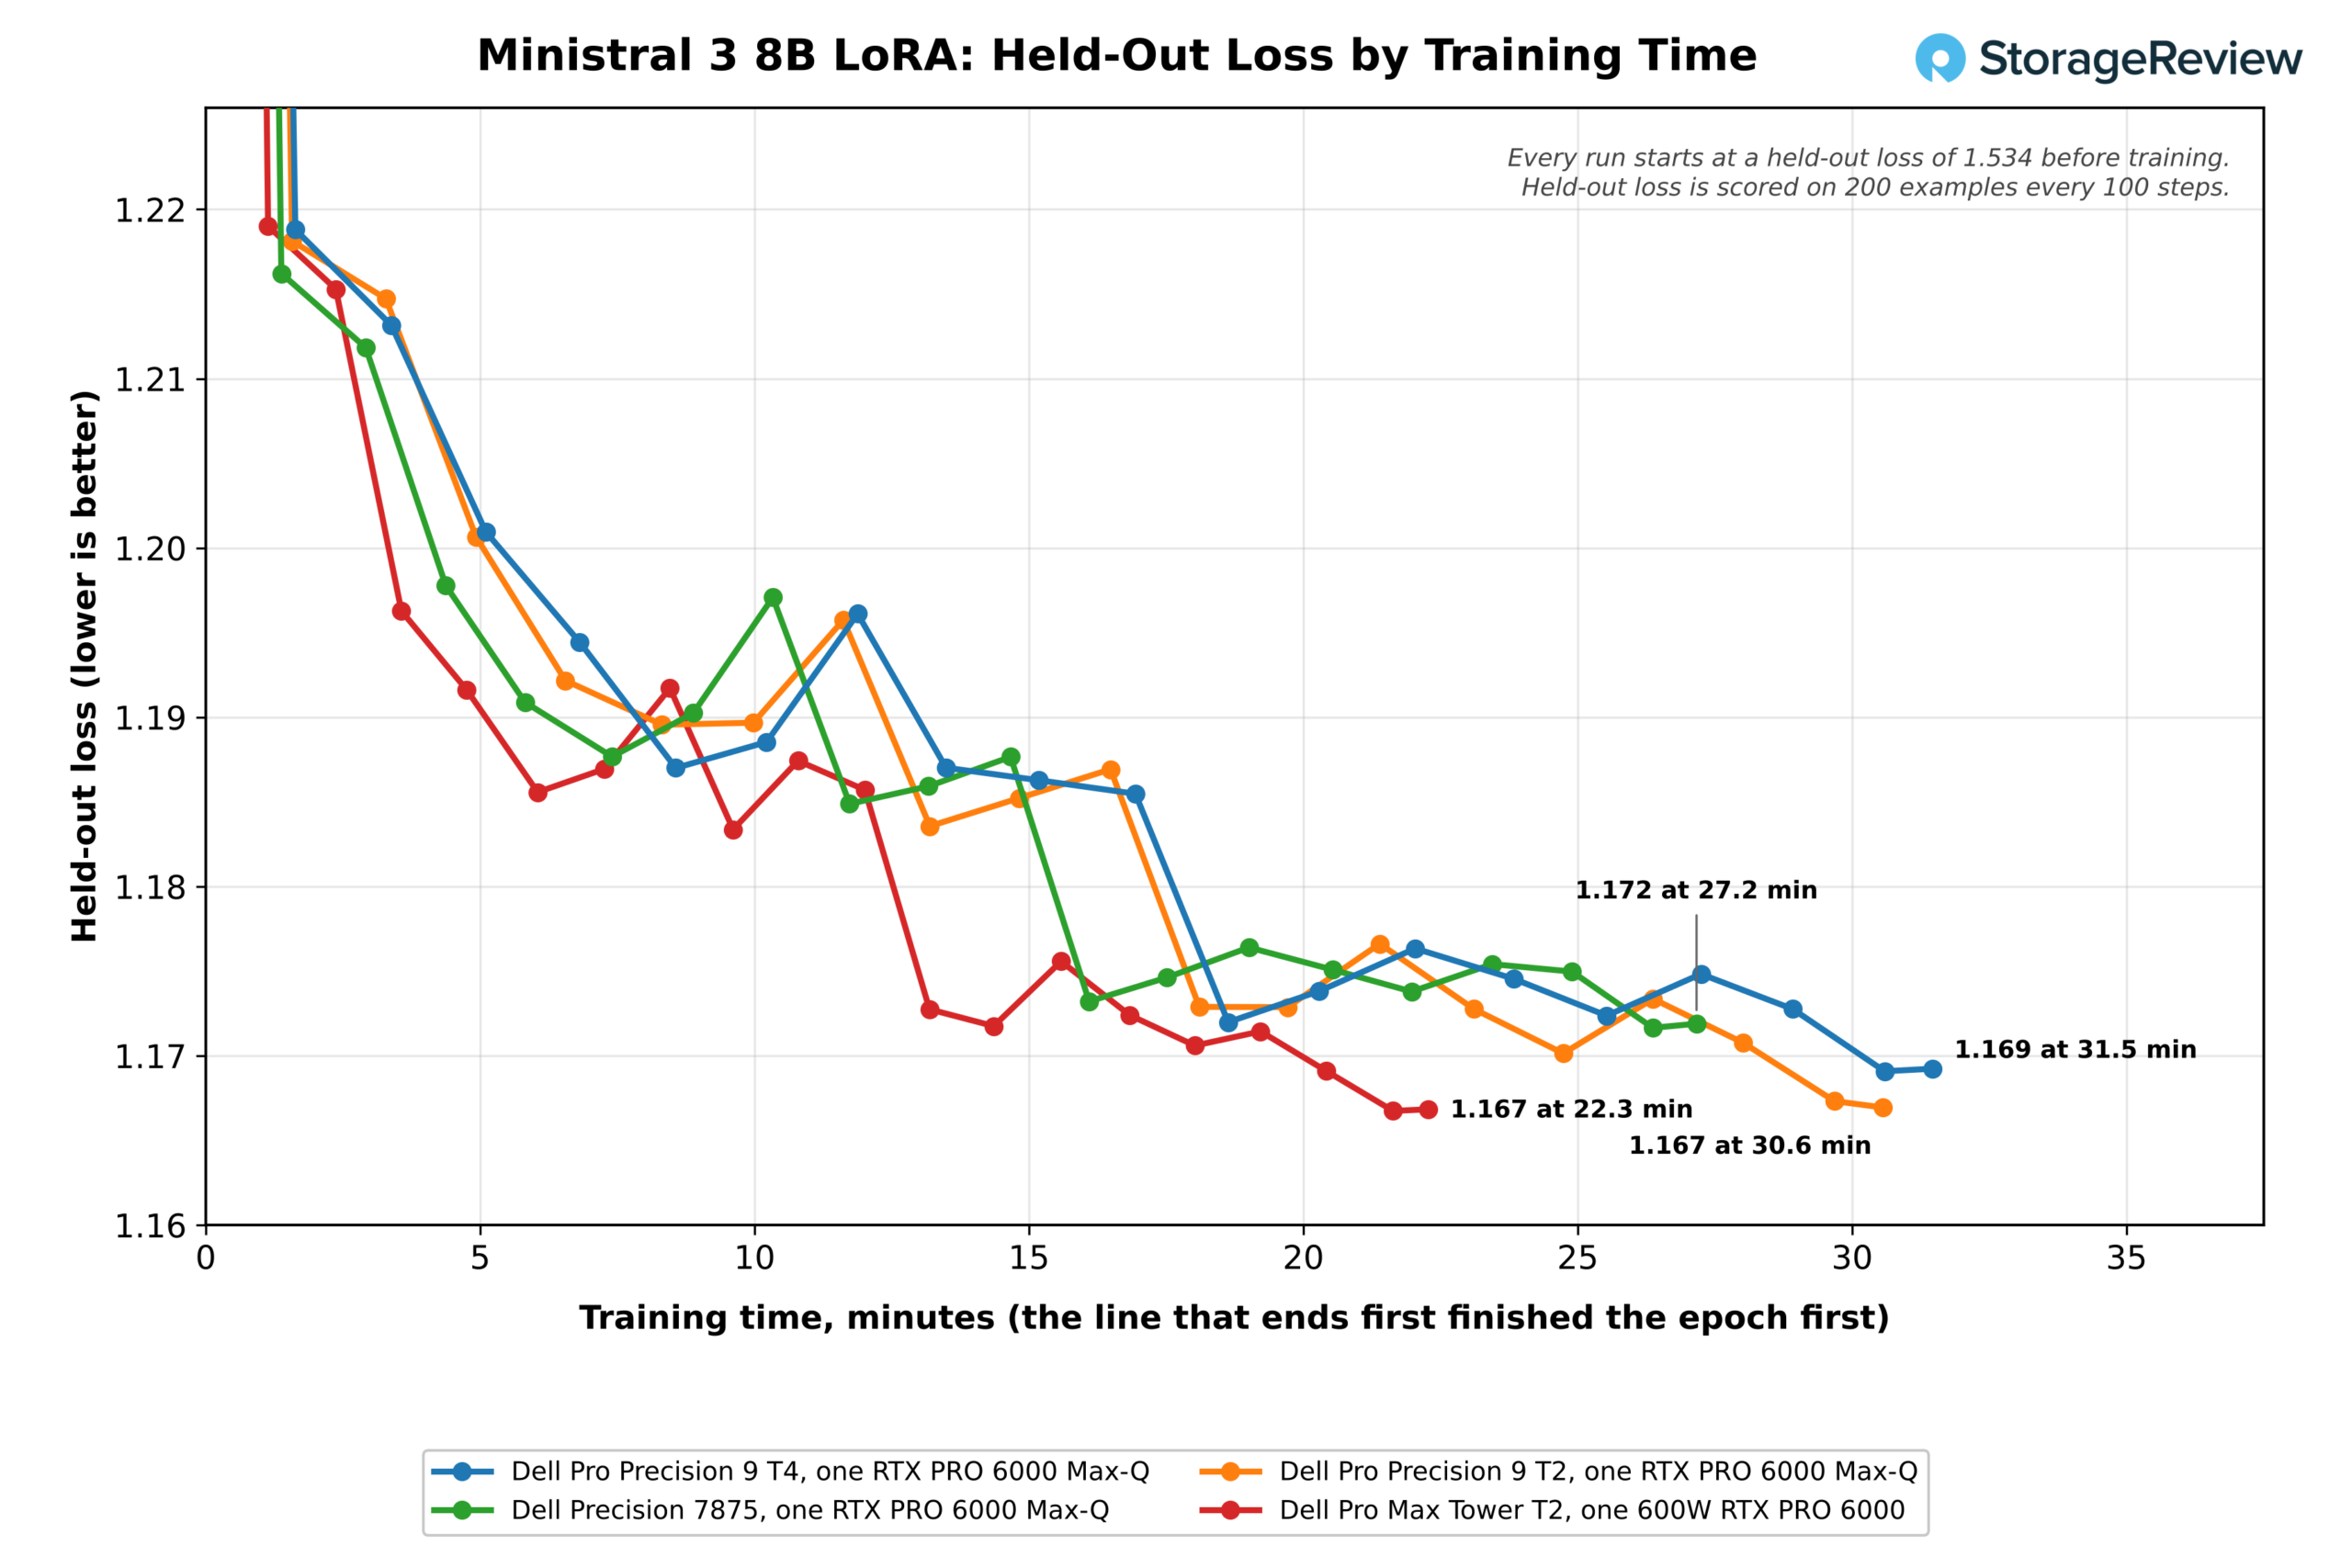
在T4上,訓練開始後的前100步(1.6分鐘)內,保留損失從1.534降至1.219,隨後在接下來的訓練週期中穩定在1.169。在增加第二個GPU後,T4的訓練週期縮短至19.7分鐘,速度達到每秒2,528個標記,速度提升了1.60倍,優於單張600W顯示卡的22.3分鐘。 Precision 7875在雙GPU配置下完成訓練週期僅需18.1分鐘,速度提升了1.50倍,雙GPU運轉結束時的保留損失分別為1.167和1.168。
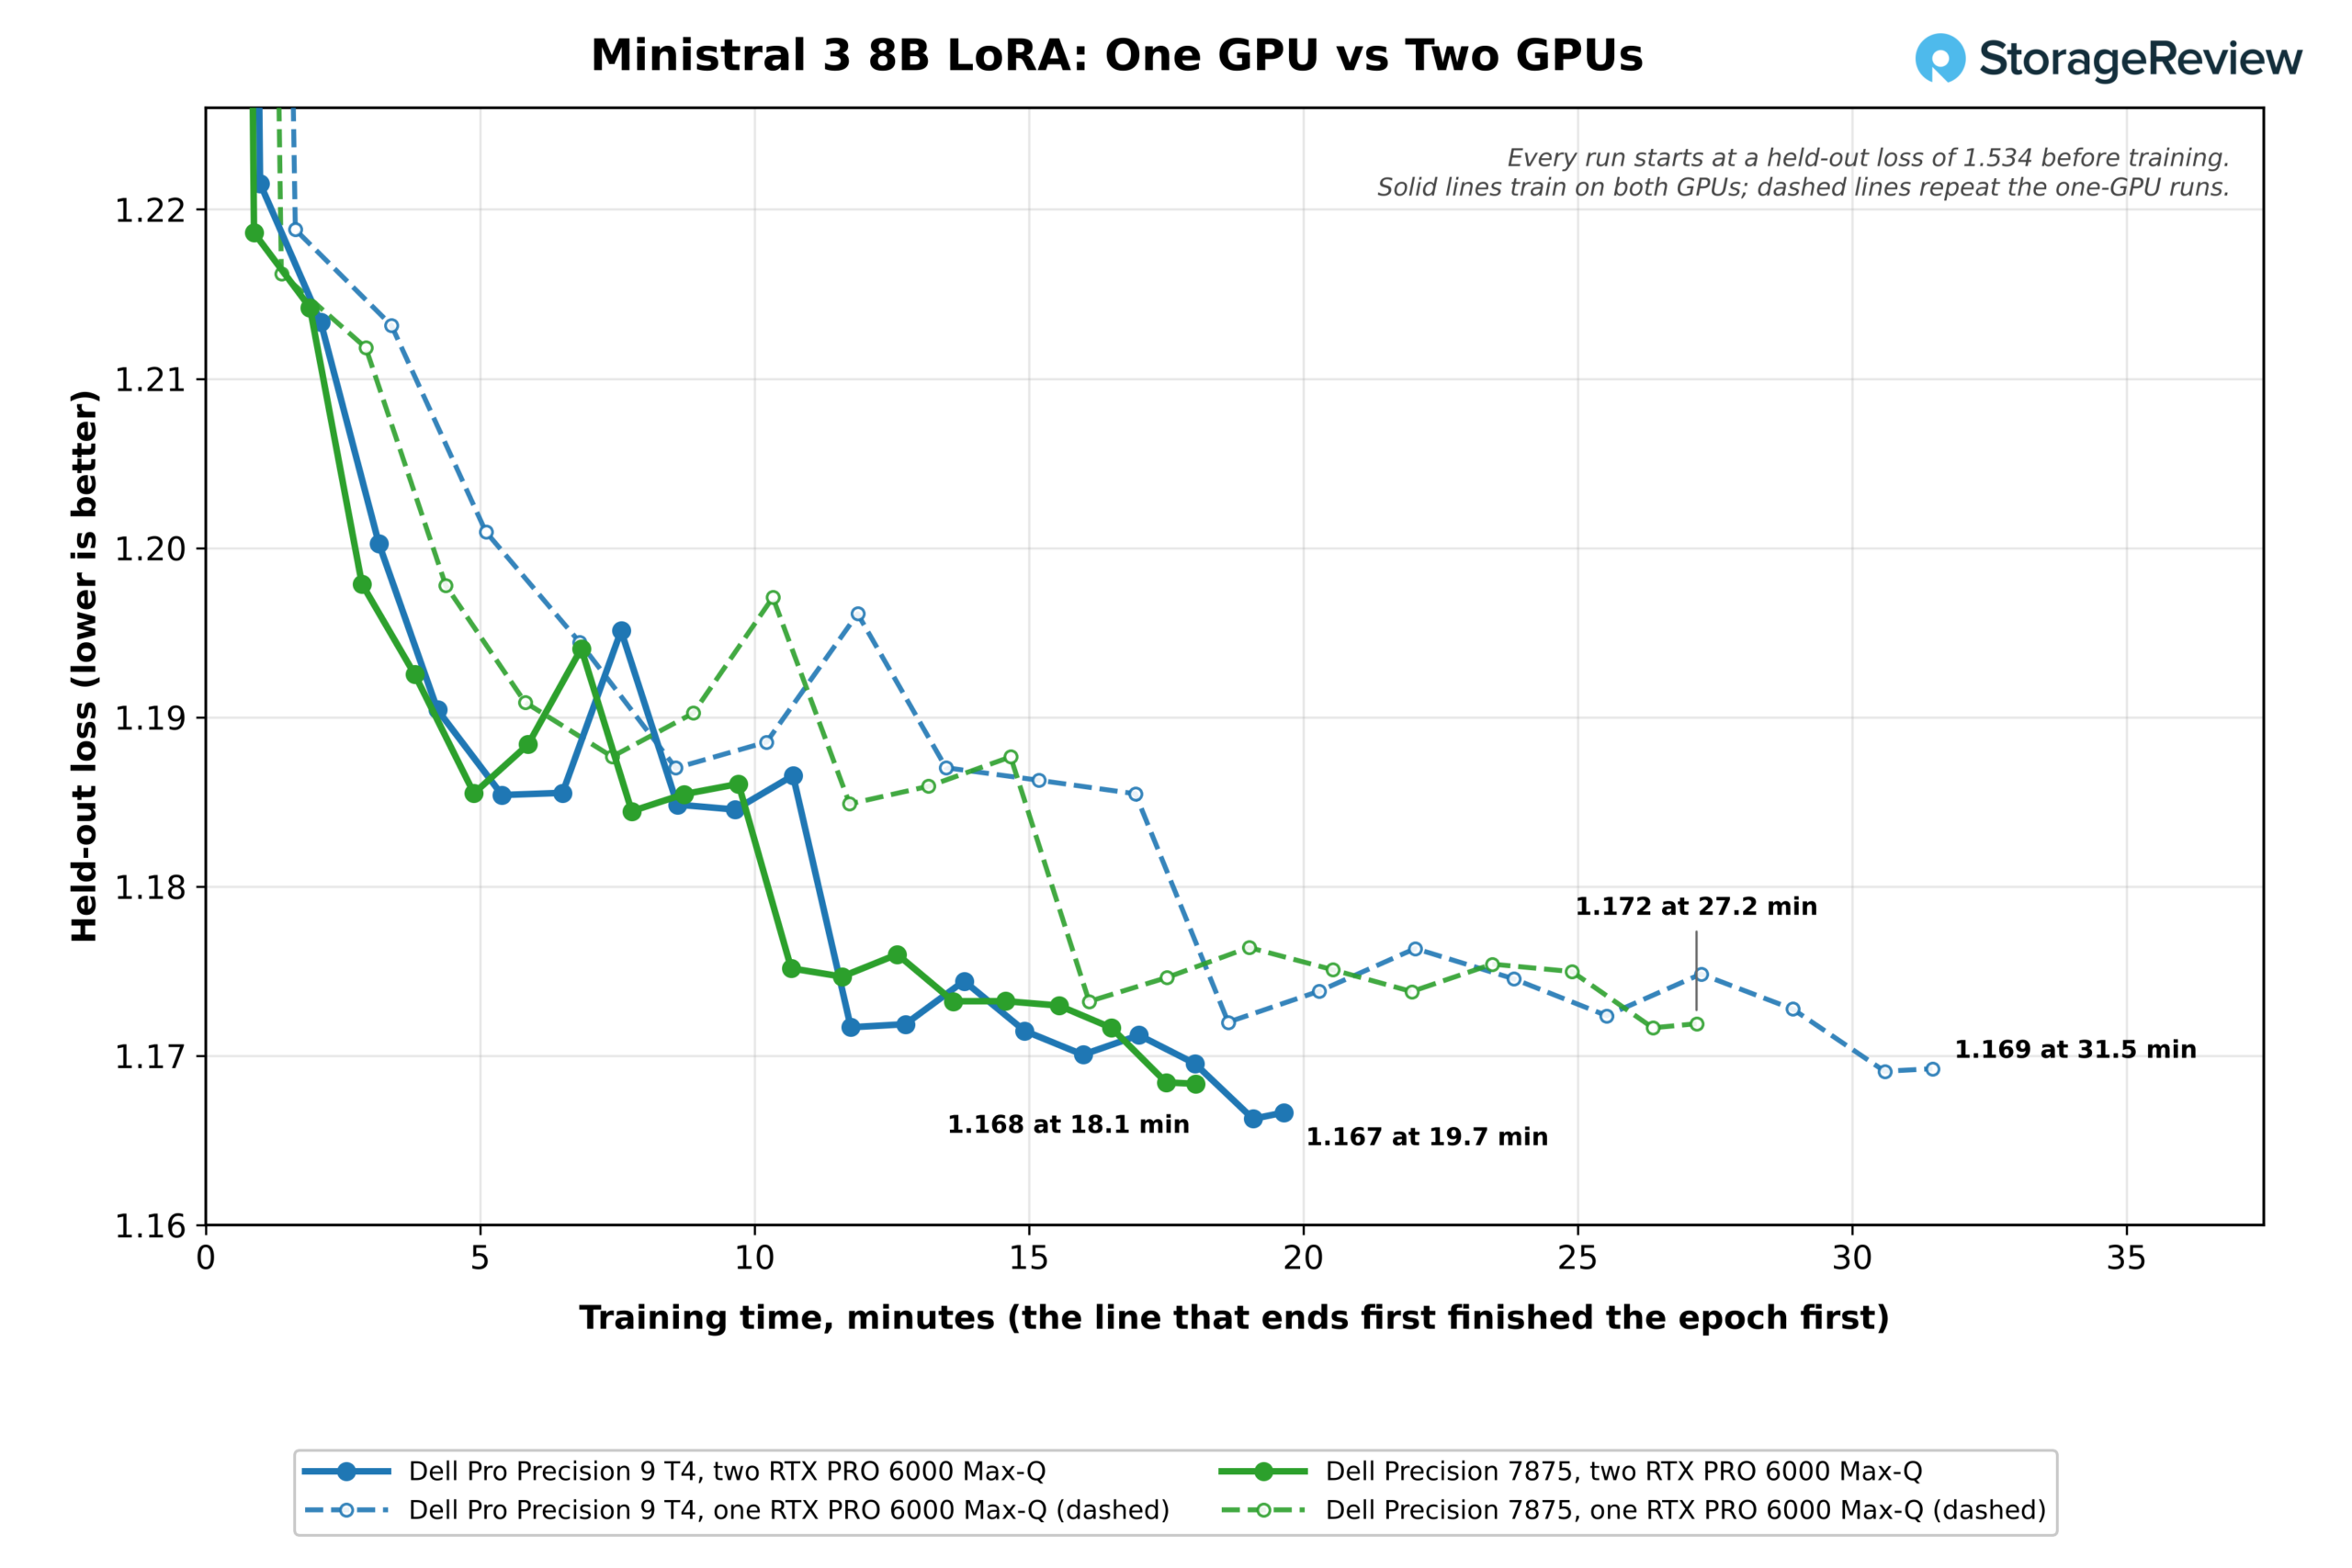
兩張顯示卡皆以資料並行運行,每個GPU處理兩個樣本,梯度累積到同一個全域批次(8個樣本),單GPU運行四遍,雙GPU運行兩遍。因此,雙GPU運行在每個步驟中都使用相同的樣本,最終得到相同的損失值。由於每個GPU在每次運行中都處理兩個短樣本,第二張顯示卡的工作量很小,因此梯度交換在每個步驟中佔據了更大的比例。單張顯示卡的GPU顯存峰值達到19.5GiB,雙顯示卡的峰值達到19.7GiB,僅佔每張RTX PRO 6000顯示卡96GB顯存的一小部分。
編碼代理、小規模 RAG 和影像生成
| 編碼代理、RAG 和圖像生成(除非另有說明,數值越高越好) | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| 編碼代理 gpt-oss:20b 64K,成功運行(共 3 次) | 3 | 2* | 2* | 2* |
| 編碼代理 gpt-oss:120b 128K,成功運行(共 3 次) | 3 | 3 | 3 | 3 |
| 編碼代理,gpt-oss:120b,生成速率(token/s) | 161.5 | 167.9 | 166.7 | 183.2 |
| RAG,20,963 段,攝取量(段/秒) | 304.6 | 433.8 | 392.1 | 371.6 |
| RAG 答案生成,Phi-4-mini(令牌/秒) | 372.5 | 410.0 | 402.8 | 415.8 |
| FLUX.2 klein 4B BF16, 1024×1024(影像/分鐘) | 40.96 | 43.03 | 41.32 | 54.25 |
| Z-Image Turbo 6B BF16(影像/分鐘) | 17.29 | 17.67 | 17.27 | 23.83 |
| Qwen-Image 20B BF16(圖像/分鐘) | 2.43 | 2.45 | 2.39 | 3.20 |
*測試套件標記:此系統上的三個代理程式運行中,有一個未通過全部 11 項測試。
T4 在所有模型層級的所有編碼代理測試中均通過,包括在 64K 上下文中全部三次 gpt-oss:20b 測試(其他三台系統僅通過了其中兩次),並且在 gpt-oss:120b 測試中每秒生成 161.5 個 token。影像生成運行在單一 GPU 上,因此 T4 在 BF16 中使用 FLUX.2 klein 演算法產生影像的速度為每分鐘 40.96 張,與其他 Max-Q 系統相當,落後於 600W 顯示卡的每分鐘 54.25 張。
CPU性能
CPU 測試結果顯示,T4 的 86 個 Xeon 核心與 Precision 7875 的 96 個 Threadripper 核心相比毫不遜色,兩款 24 核心的 T2 作為參考基準。 Threadripper 的核心數比 Xeon 多 10 個,執行緒數也從 Xeon 的 172 個增加到 192 個。在記憶體頻寬決定效能的方面,T4 更勝一籌;而在核心數和時脈頻率決定效能的方面,7875 則更勝一籌。
壓縮、渲染和編譯
| 測試 | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| 7-Zip,所有執行緒(GIPS) | 619.8 | 850.0 | 285.1 | 172.7 |
| 7-Zip,單線程(GIPS) | 8.85 | 10.58 | 9.27 | 11.04 |
| Blender 4.5 Monster(採樣/分鐘) | 961.8 | 1,253.8 | 400.7 | 303.0 |
| Blender 4.5 Junkshop(樣本/分鐘) | 641.9 | 849.7 | 266.9 | 191.9 |
| Blender 4.5 課堂(樣本/分鐘) | 442.8 | 612.2 | 187.2 | 147.1 |
| HandBrake x265 (fps) | 31.4 | 41.7 | 41.5 | 40.0 |
| HandBrake SVT-AV1 (fps) | 159.4 | 255.8 | 198.5 | 122.6 |
| LLVM 21 版本(版本編號越低越好) | 58.4 | 43.7 | 106.4 | 155.9 |
| Linux 核心 allmodconfig(s,數值越小越好) | 312 | 264 | 537 | 843 |
| OpenSSL AES-256-GCM,所有執行緒(GB/s) | 882.6 | 1,139.1 | 371.2 | 137.0 |
| nginx,1,000 個連線(請求/秒) | 414,468 | 467,128 | 323,567 | 153,732 |
T4 在 7-Zip 測試中取得了 619.8 GIPS 的成績,在 Blender Monster 測試中取得了 961.8 個採樣/分鐘的成績,分別是 2.4 核 Pro Precision 9 T2 的 2.2 倍和 24 倍。 Precision 7875 在 7-Zip 測試中領先 37%,在 Blender Monster 測試中領先 30%,其 LLVM 構建耗時 43.7 秒,而 T4 耗時 58.4 秒;Linux 內核 allmodconfig 構建耗時 264 秒,而 T4 時 312 秒。單核心速度是 T4 的弱點,其單執行緒 7-Zip 測試成績為 8.85 GIPS,是該組產品中最低的。
HandBrake 的 x265 編碼是此表中的異常值,原因更多在於編碼器而非處理器。其他三台系統在 24 核心或 96 核心的情況下,幀率均在 40.0 到 41.7 fps 之間,因此在此預設下,x265 的效能提升並不依賴核心數量。 T4 的 31.4 fps 與其在 x265 使用的執行緒上較低的單核心頻率相符。編碼過程中,T4 的 172 個線程平均頻率約為 1GHz,溫度在 51°C 到 64°C 之間,顯示晶片大部分處於空閒狀態。 SVT-AV1 的效能提升更為顯著,T4 的幀率為 159.4 fps,而 7875 的幀率為 255.8 fps。


記憶體頻寬、仿真和數學
| 測試 | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| STREAM Triad (MB/s) | 328,329 | 215,177 | 141,832 | 45,102 |
| OpenFOAM 13 驅動程序,3 萬個單元格,求解(s,數值越低越好) | 293 | 556 | 826 | 未完成 |
| GROMACS benchPEP,所有核心(ns/天) | 1.243 | 1.034 | 未運行 | 未運行 |
| GROMACS benchMEM,16 個核心(ns/天) | 68.09 | 84.94 | 78.03 | 54.26 |
| OpenBLAS DGEMM,所有核心(GFLOPS) | 3,664 | 4,745 | 2,319 | 1,063 |
| OpenBLAS LU 求解 N=20000 (GFLOPS) | 1,660 | 1,172 | 1,616 | 858 |
| y-cruncher Pi,1 億位(s,越小越好) | 4.01 | 7.45 | 8.51 | 24.61 |
| y-cruncher Pi,10 億位(s,越小越好) | 53.9 | 83.7 | 119.2 | 347.9 |
| y-cruncher Pi,25 億位(s,越小越好) | 155.6 | 259.6 | 未運行 | 未運行 |
T4 配備八通道 DDR5-6400 內存,在 STREAM Triad 測試中頻寬達到 328GB/s,比 Precision 7875 的 DDR5-5600 快 53%,是四通道 Pro Precision 9 T2 的 2.3 倍。接下來是頻寬密集任務:T4 僅用 293 秒就完成了 3 萬單元的 OpenFOAM drivAer 測試,而 7875 和 Pro Precision 9 T2 分別耗時 556 秒和 826 秒,Pro Max Tower T2 甚至未能在 150 分鐘的測試時限內完成。此外,T4 還用 6,851 秒完成了 22.6 萬單元的測試。

GROMACS benchPEP(大型全核分子動力學算例)在 T4 上的運行速度為 1.243 ns/天,而 7875 為 1.034 ns/天;LU 分解的計算性能達到 1,660 GFLOPS,而 7875 為 1,172 GFL。 y-cruncher 計算圓周率 100 億位小數僅需 53.9 秒,而 7875 則需要 83.7 秒;計算 250 億位小數僅需 155.6 秒,而 7875 則需要 259.6 秒。對於快取密集運算,Threadripper 更勝一籌,其在 OpenBLAS DGEMM 算例中以 4,745 GFLOPS 的成績領先 3,664 GFLOPS。


資料庫和服務
| 測試 | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| ClickBench 熱測試,43 次查詢(秒,數值越低越好) | 3.21 | 2.88 | 4.80 | 10.44 |
| ClickBench 冷運行,43 個查詢(秒,數值越低越好) | 6.45 | 7.09 | 6.92 | 14.22 |
| Valkey 緩存,SET(請求/秒) | 666,714 | 1,138,696 | 914,832 | 1,719,108 |
| Valkey 緩存,GET(請求/秒) | 865,353 | 1,279,429 | 991,576 | 1,648,278 |
| Stockfish,所有線程(Mnps) | 68.21 | 168.27 | 45.44 | 37.42 |
| PyPerformance 的值為(毫秒,數值越低越好) | 74.3 | 66.0 | 72.1 | 56.7 |
ClickHouse 在 T4 上執行 43 個 ClickBench 查詢,熱機測試耗時 3.21 秒,冷機測試耗時 6.45 秒,熱機測試比 7875 慢 0.33 秒,冷機測試快 0.64 秒。 Valkey 更偏愛單核心效能強勁的處理器,而非多核心處理器。 T4 每秒 666,714 次 SET 請求的處理能力落後於其他三個對比系統,其中 Pro Max Tower T2 搭載的 Core Ultra 9 285K 以每秒 1.72 萬次的請求處理能力領先。此結果與 T4 的單執行緒測試結果相符,值得對延遲敏感型服務進行評估。
在所有 172 個執行緒都滿載運作且處理器平均溫度為 87°C 的情況下,T4 在 Stockfish 演算法中每秒搜尋 68.21 萬個節點,是 48 執行緒 Pro Precision 9 T2 的 1.5 倍,但遠低於 192 執行緒 7875 的 168.27 萬次搜尋速度的一半。 T4 在首次完整運行測試時超時,之後透過獨立複測才得到上述結果。我們在此報告實際測量結果,尚未找出效能擴展性不足的原因。
存儲性能
| fio,佔用空間 25GiB(越大越好) | 戴爾專業版 Precision 9 T4 | 戴爾Precision 7875 | 戴爾專業版 Precision 9 T2 | 戴爾 Pro Max 塔式 T2 |
|---|---|---|---|---|
| 順序讀取 128K (MB/s) | 14,152 | 7,089 | 20,914 * | 7,234 |
| 順序寫入 128K (MB/s) | 10,078 | 5,265 | 12,564 | 6,772 |
| 隨機讀取 4K,峰值(IOPS) | 2,306,346 | 993,569 | 3,214,066 | 1,538,387 |
| 隨機寫入 4K,峰值(IOPS) | 1,830,776 | 787,388 | 2,353,766 | 1,326,030 |
*重新運行後,該套件已標記為運行間存在差異。
T4 的 2TB SK 海力士 Gen5 啟動碟順序讀取速度為 14,152MB/s,順序寫入速度為 10,078MB/s。其順序讀取速度約為 Precision 7875 和 Pro Max Tower T2 中 Gen4 硬碟的兩倍。隨機效能峰值達到 2.31 萬讀取 IOPS 和 1.83 萬寫入 IOPS。 Pro Precision 9 T2 的順序讀取速度為 20,914MB/s,超過了單一 Gen5 x4 連結的容量,而該系統的測試磁碟區是由三星 PM9E1 Gen5 硬碟組成的條帶化陣列。我們僅測試了 T4 的啟動盤,第二個 2TB 硬碟未參與此測試。

負載下的散熱和時脈頻率
| 戴爾專業版 Precision 9 T4 | CPU 最大值 (C) | CPU 平均值 (C) | 平均CPU時脈頻率(MHz) |
|---|---|---|---|
| 7-ZIP | 93 | 80.6 | 1,967 |
| 混合器 | 91 | 85.7 | 2,587 |
| GROMACS | 96 | 81.3 | 1,313 |
| LLVM 建構 | 83 | 74.5 | 2,127 |
| OpenBLAS | 80 | 62.9 | 1,325 |
| 法學碩士服務 | 84 | 65.0 | 924 |
| 微調 | 71 | 61.2 | 854 |
| 大規模 RAG | 74 | 64.4 | 987 |
| 儲存 | 64 | 55.4 | 942 |
在BIOS設定為超高性能模式後,Xeon 698X在7-Zip測試中最高溫度為93℃,在GROMACS測試中最高溫度為96℃。表格中的時脈頻率資料是所有172個邏輯CPU的平均值。 Blender和Stockfish會佔用所有線程,並將頻率保持在2.5GHz至2.6GHz之間,高於晶片2.0GHz的基礎頻率。 GROMACS和OpenBLAS分別佔用64個和86個實體核心,其餘執行緒的空閒頻率接近0.8GHz,因此它們的平均頻率約為1.3GHz。 GPU驅動的任務使處理器溫度保持較低,在LLM服務、微調和RAG測試中,平均溫度為61℃至65℃,因為這些測試主要依賴顯示卡。

結語
戴爾 Pro Precision 9 T4 專為本地 AI 工作而打造,而第二張 RTX PRO 6000 顯示卡正是其優勢所在。兩塊 Max-Q 顯示卡使四個模型的峰值服務吞吐量提升了 1.85 倍至 2.02 倍,嵌入吞吐量提升了 1.92 倍,在 Ministral 3 8B 數據集上,LoRa epoch 的運行時間從 31.5 分鐘縮短至 19.7 分鐘,並且將 MiniMax Mken.2.7(單幅用戶處理 30.3 的單數)個提升至 83.7 個。在 gpt-oss 120B 資料集上,每塊 GPU 運行一個伺服器,在 64 個請求的情況下,總 token 數達到了每秒 7,091 個;而將模型分配到兩塊顯示卡上運行,則單用戶第一個 token 的返回時間從 1,189 毫秒縮短至 719 毫秒。

八通道 DDR5-6400 記憶體使 Xeon 698X 的記憶體頻寬比 Threadripper PRO 9995WX 高出 53%。這項頻寬優勢使得 T4 在 OpenFOAM、GROMACS benchPEP、y-cruncher 和 HNSW 的搜尋結果方面均優於 Precision 7875,而 T4 的第五代儲存也能更快地載入大型模型。機殼同樣值得稱讚,它擁有我們見過的戴爾同級產品中最佳的散熱設計,並且電源無需工具即可輕鬆拆裝。
在核心密集型渲染、壓縮和編譯任務中,7875 的效能仍領先 18% 到 38%,在 SVT-AV1 測試中更領先 60%。 Xeon 的單核速度落後於該組所有其他系統,這在 Valkey 和其他輕線程服務中表現尤為明顯。在 T4 上對單一 GPU 進行微調的速度也較慢,LoRA epoch 耗時 31.5 分鐘,而 7875 僅需 27.2 分鐘,Pro Max Tower T2 中的 600W 顯示卡也只需 22.3 分鐘,所有系統的最終成績差距均在 0.005 分鐘內。
根據戴爾官網的配置,T4 的售價約為 66,600 美元,它適合那些希望在本地部署、嵌入和微調模型(包括需要超過 96GB GPU 顯存的模型)的團隊,同時還能在同一台機器上進行內存密集型仿真和分析。對於主要從事渲染和編譯工作的使用者來說,Threadripper 平台速度更快;而只需要一塊 GPU 的使用者可以選擇配置相同的顯示卡,例如尺寸較小的 Pro Precision 9 T2。

排行榜:戴爾 Pro Precision 9 T4 在我們的「最佳本地 AI 桌上型電腦」排行榜上榮獲「最佳本地 AI 至強塔式機」稱號。


 Amazon