

Společnost NVIDIA přidala 23. října konfiguraci DGX Spark s 64GB unifikovanou pamětí , která začíná na 4 999 dolarech a prodává se exkluzivně u společností Acer, ASUS, Dell, Gigabyte, HP a MSI. Nová SKU obsahuje stejný procesor GB10 Grace Blackwell Superchip, síťové rozhraní ConnectX-7, operační systém DGX a softwarový balík NVIDIA AI jako 128GB model. NVIDIA uvádí, že 64GB jednotka sama o sobě zvládá modely až 100 miliard parametrů pro lokální inferenci, jemné ladění a pracovní postupy agentů bez odesílání dat do cloudu.
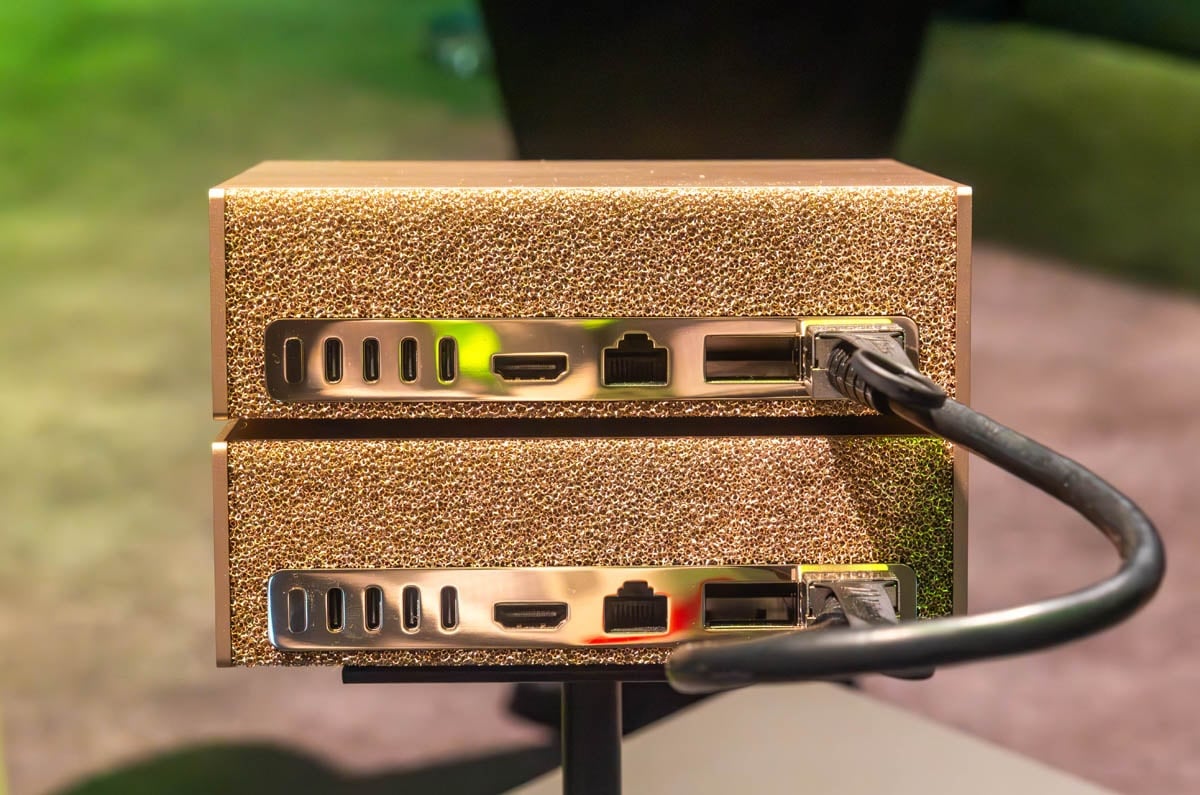
Dva 64GB Sparky pro jeden 128GB cluster
Téma levnějšího zařízení (ve srovnání s tržními cenami většího modelu) spočívá v tom, že dva jednotky v clusteru si vedou docela dobře. Každý DGX Spark má integrovanou síťovou kartu ConnectX-7, takže dvojice se připojuje přímo přes kabel QSFP na 200GbE spojení bez přepínače. NVIDIA Sync Cluster Assistant zajišťuje vyhledávání, ověřuje konfiguraci zařízení a nastavuje síť ConnectX-7. Dvě 64GB jednotky sdružují 128 GB unifikované paměti, což podle NVIDIA stačí k provozování modelů s až 200 miliardami parametrů.
Interní čísla společnosti NVIDIA pro párování používají Qwen3.8 27B: dva clusterované 64GB systémy poskytovaly až 1.7násobný výkon oproti jednomu 128GB systému. Protože každý uzel provozuje stejné knihovny CUDA, inferenční enginy a obraz operačního systému DGX, pracovní zátěž zahrnuje obě jednotky bez nutnosti přestavby softwarového prostředí. Mezi podporované inferenční frameworky patří llama.cpp, Ollama, vLLM a LM Studio. NVIDIA má krátké video o propojení dvou Sparků pomocí NVIDIA Sync.
Spustili jsme distribuovaný inferenční cluster napříč jednotkami Dell, Gigabyte a HP DGX Spark a nedávno jsme umístili sdílené úložiště za cluster Spark přes 100GbE . SKU s 64 GB snižuje vstupní cenu pro tento typ nastavení, s tou nevýhodou, že jedna jednotka nyní obsahuje polovinu paměti oproti původní jednotce.
Spouštěč modelů NVIDIA Sync dorazí koncem října
Druhá polovina oznámení se týká softwaru. NVIDIA Sync Model Launcher, který má být uveden na trh koncem října, stahuje a spouští model napříč jedním Sparkem nebo clusterovanou dvojicí, například Qwen3.8 27B, a zpřístupňuje výsledný koncový bod vývojářským počítačům v síti. Dokáže také nastavit OpenCode pro daný model, takže vývojáři mohou kódovat z prohlížeče a cluster Spark provádí inferenci.
Systémy s 64GB pamětí jsou dodávány se stejným softwarem jako model s 128GB pamětí: DGX OS, knihovny CUDA-X pro umělou inteligenci, sadu nástrojů NVIDIA Agent Toolkit, otevřené modely Nemotron a běhová prostředí včetně Ollama, vLLM a PyTorch s CUDA. NVIDIA toto zařízení prezentuje jako lokální platformu pro agenty, inferenci, jemné ladění, datovou vědu a vývoj na okraji sítě a port ConnectX-7 umožňuje později přidat druhou jednotku. Pro tvůrce agentů NVIDIA poukazuje jako výchozí body na své playbooky pro NemoClaw, OpenClaw, Hermes Agent a OpenShell na webu build.nvidia.com.


 Amazon