

ASUS ExpertCenter Pro ET900N G3 je druhá stanice GB300 DGX, kterou jsme testovali, a první, kterou jsme si mohli osobně vyzkoušet v laboratoři; naše testování MSI XpertStation WS300 probíhalo na dálku. Používá stejný křemík NVIDIA, jaký jsme testovali v MSI XpertStation WS300: superčip Grace Blackwell Ultra Desktop se 72 jádry Grace, grafický procesor B300, 252 GB paměti HBM3e, 496 GB paměti LPDDR5X a síťovou kartu ConnectX-8 SuperNIC se dvěma 400GbE porty. ASUS zabalil základní platformu do úhledného pouzdra určeného pro umělou inteligenci u stolu a přidal několik vylepšení, která u WS300 nenajdete: dvě rukojeti nahoře, samostatný ventilátor zaměřený na optické moduly ConnectX-8 a 1,600W napájecí zdroj s certifikací 80 PLUS Titanium.
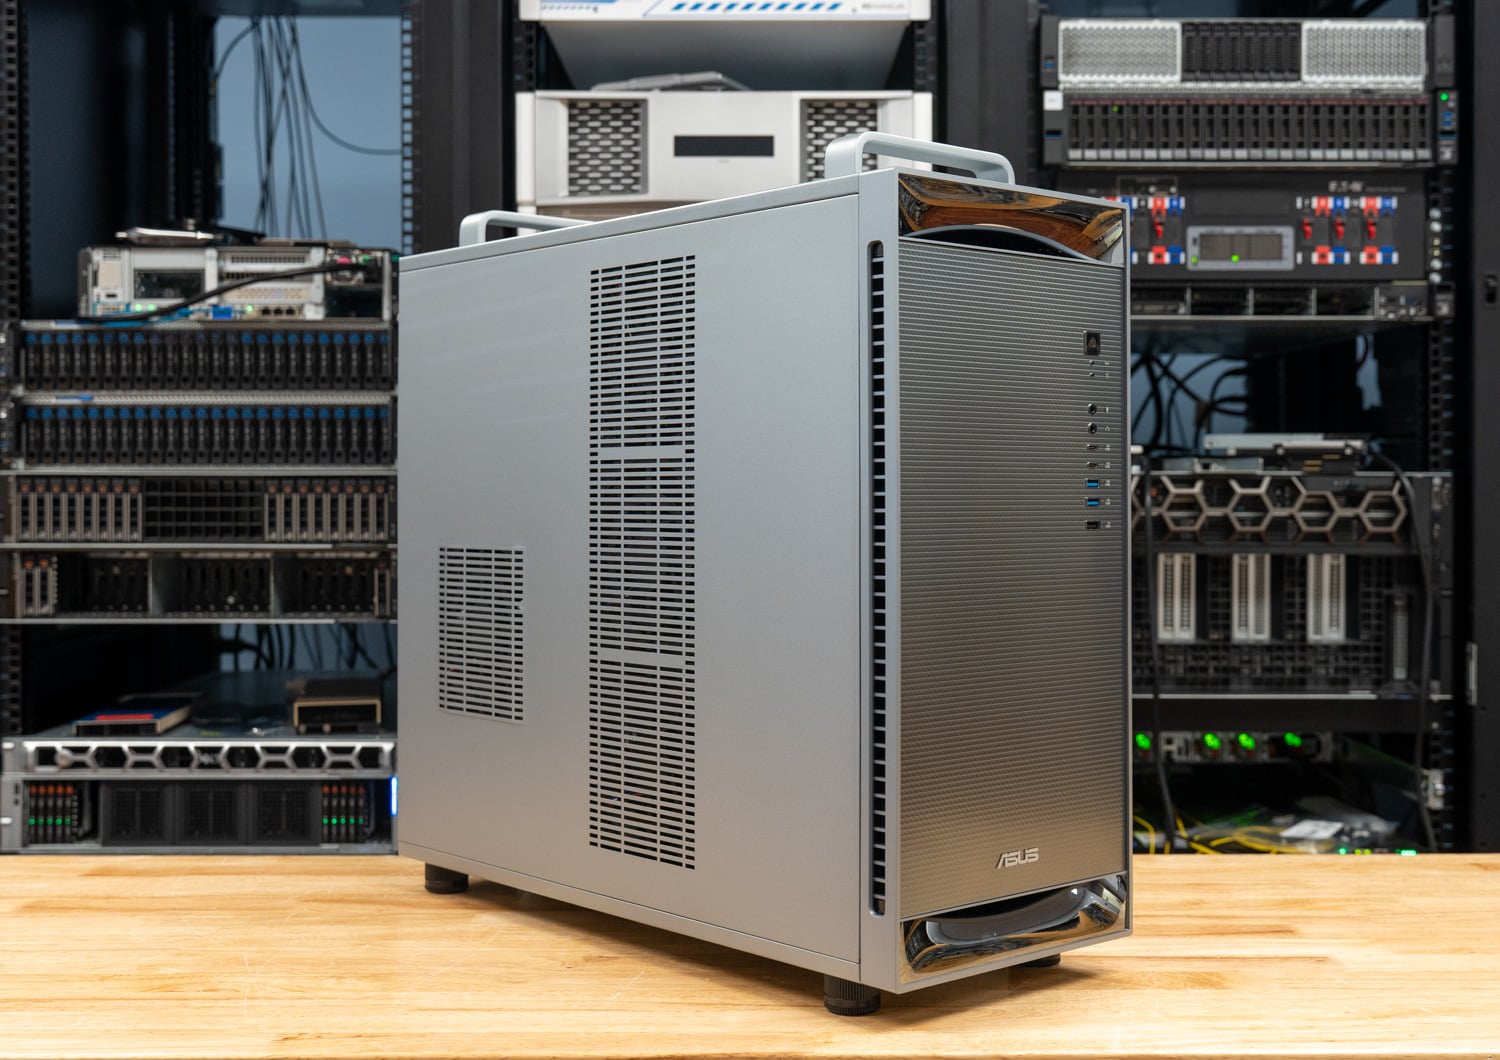
Společnost ASUS poslala ET900N G3 do laboratoře na zhruba týdenní benchmarking, fotografování a fyzické kontroly s nainstalovanou grafickou kartou RTX PRO 2000. Recenze WS300 se zabývá samotnou platformou, čipy B300, Grace, NVLink-C2C, MIG a tím, k čemu slouží stanice DGX. Tato recenze se zabývá tím, co ASUS kolem superčipu postavil a zda se čísla vyrovnají prvnímu testovanému věžovému počítači GB300.
Specifikace ASUS ExpertCenter Pro ET900N G3
| Specifikace | ASUS ExpertCenter Pro ET900N G3 |
|---|---|
| Přehled platformy | |
| Superčip | Superčip NVIDIA GB300 Grace Blackwell Ultra pro stolní počítače |
| Procesor (CPU) | NVIDIA Grace, 72 Arm Neoverse V2 jádra |
| GPU | NVIDIA Blackwell Ultra (B300), až 20 PFLOPS NVFP4 s řídkostí |
| Propojení CPU a GPU | NVLink-C2C, 900 GB/s obousměrný |
| Memory | |
| Koherentní paměť | 748GB |
| Paměť GPU | 252GB HBM3e, 7.1 TB/s |
| Paměť CPU | 496GB LPDDR5X, 396GB/s, 4x SOCAMM |
| Skladování | |
| Spouštěcí jednotky | 2x M.2 2280 PCIe 5.0 x4 (Key M), osazený 2x 2TB NVMe disky v RAID 1 |
| Rozšiřující disky | 2x M.2 2280 (Key M), PCIe 6.0 x4 pro ASUS, otevřené z výroby |
| networking | |
| SuperNIC | NVIDIA ConnectX-8, 2x QSFP112 400GbE |
| Ethernet | 1x Marvell 10GbE 1x Realtek 1GbE (BMC) |
| Rozšíření | |
| PCIe sloty | 1x PCIe 5.0 x16 2x PCIe 5.0 x16 (x8 signály) |
| Doplňková grafická karta | Až jedna grafická karta NVIDIA RTX PRO Blackwell; recenzovaný kus je dodáván s grafickou kartou RTX PRO 2000 Blackwell |
| Vstup / výstup | |
| Přední | 2x USB 10 Gb/s typu C 2x USB 10 Gb/s typu A 1x USB 2.0 Konektory pro sluchátka a mikrofon |
| Zadní | 4x USB 10 Gb/s typu A 1x Micro-USB COM (sériová konzole BMC) 1x Mini DisplayPort (BMC) 3x audio jacky |
| Management a bezpečnost | |
| BMC | ASPEED AST2600 s firmwarem AMI MegaRAC, IPMI a Redfish |
| Bezpečnost | Integrovaný TPM 2.0 |
| Napájení a chlazení | |
| napájení | 1x 1 600 W ATX, 80 PLUS Titanium |
| Chlazení | Kapalinové chlazení AIO s uzavřenou smyčkou (podle ASUSu) s chladicími deskami na GB300, SOCAMM a ConnectX-8; přední a horní chladiče, zadní ventilátor šasi, samostatný ventilátor nad klecemi QSFP112 |
| Provozní teplota | 10C na 35C |
| Software a provedení | |
| Operační systém | Ubuntu s vývojářskými nástroji NVIDIA AI; ASUS plánuje podporu vývoje AI pro Windows |
| Rozměry | 584 x 232 x 565 mm (23.0 x 9.1 x 22.3 palce), dle údajů společnosti ASUS |
| Hmotnost | 27 kg netto, 32 kg brutto |
Design a budování
Společnost ASUS ET900N G3 obléká do podoby firemní pracovní stanice s kartáčovaným stříbrným šasi, tmavou síťovanou přední částí, chromovaným krytem a nohou a nízko umístěným logem ASUS na přední straně. Proporce odpovídají platformě: 584 x 232 x 565 mm dle uváděných rozměrů společnosti ASUS, což je s výškou 529 mm, hloubkou 570 mm a šířkou 246 mm o něco vyšší a užší než WS300. S hmotností 27 kg se nejedná o systém, s nímž by se někdo pohyboval jen tak ledabyle, a právě zde přichází do hry první rozhodnutí specifické pro ASUS. Dvě kovová madla na horní hraně, jedno vpředu a jedno vzadu, umožňují dvěma lidem zvednout věžový počítač na stůl nebo do vozíku, aniž by museli uchopit panely. Na kancelářském počítači vypadají trochu nepatřičně, dokud byste nemuseli věžový počítač GB300 přenášet přes laboratoř.
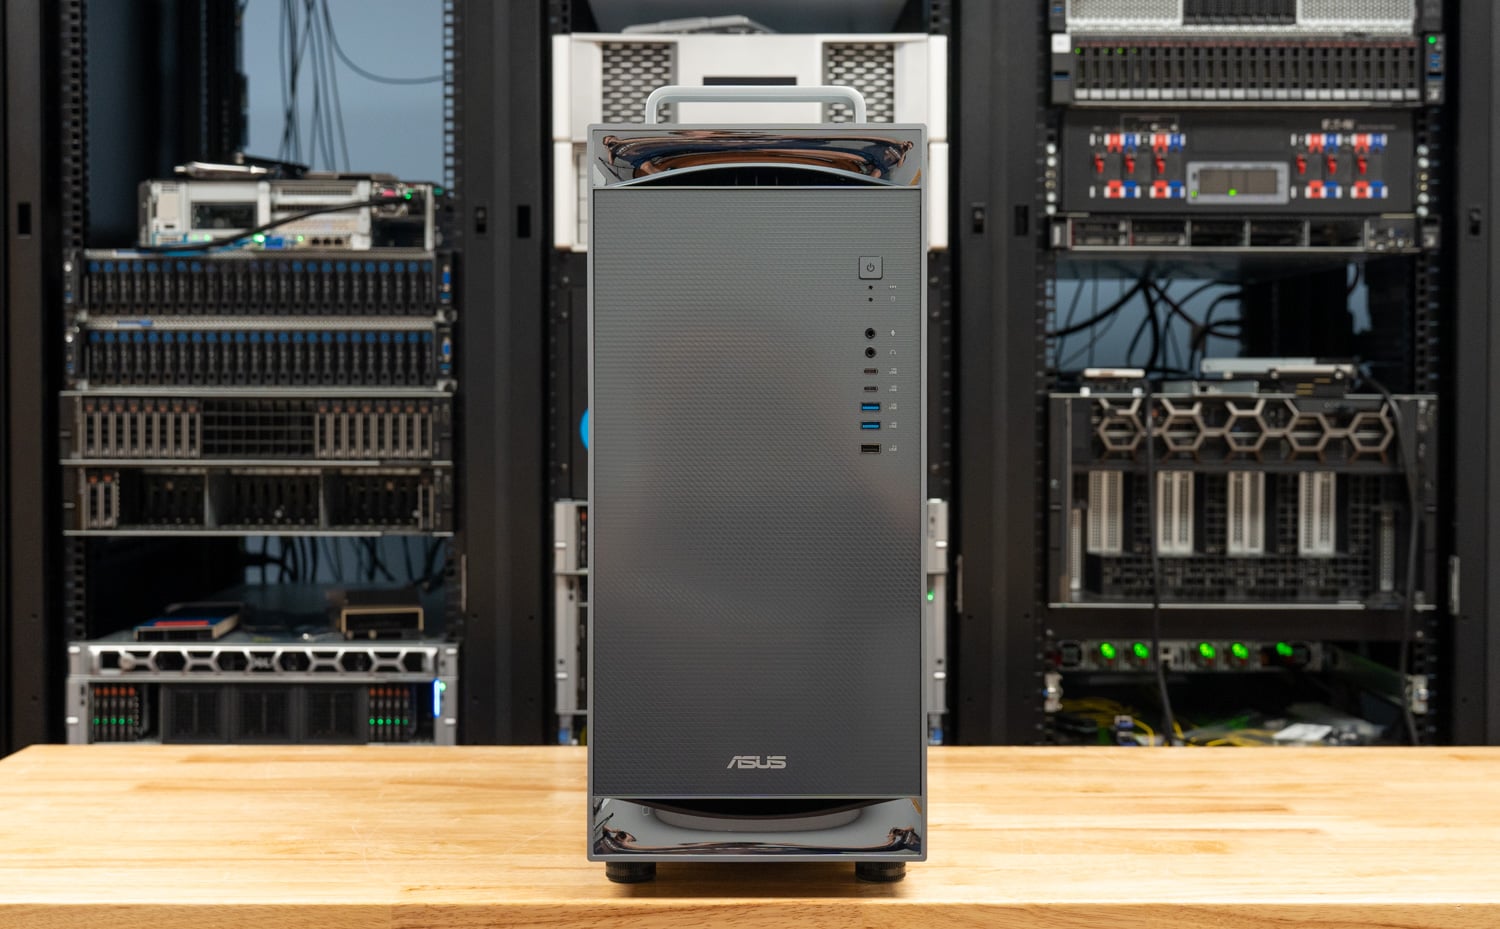
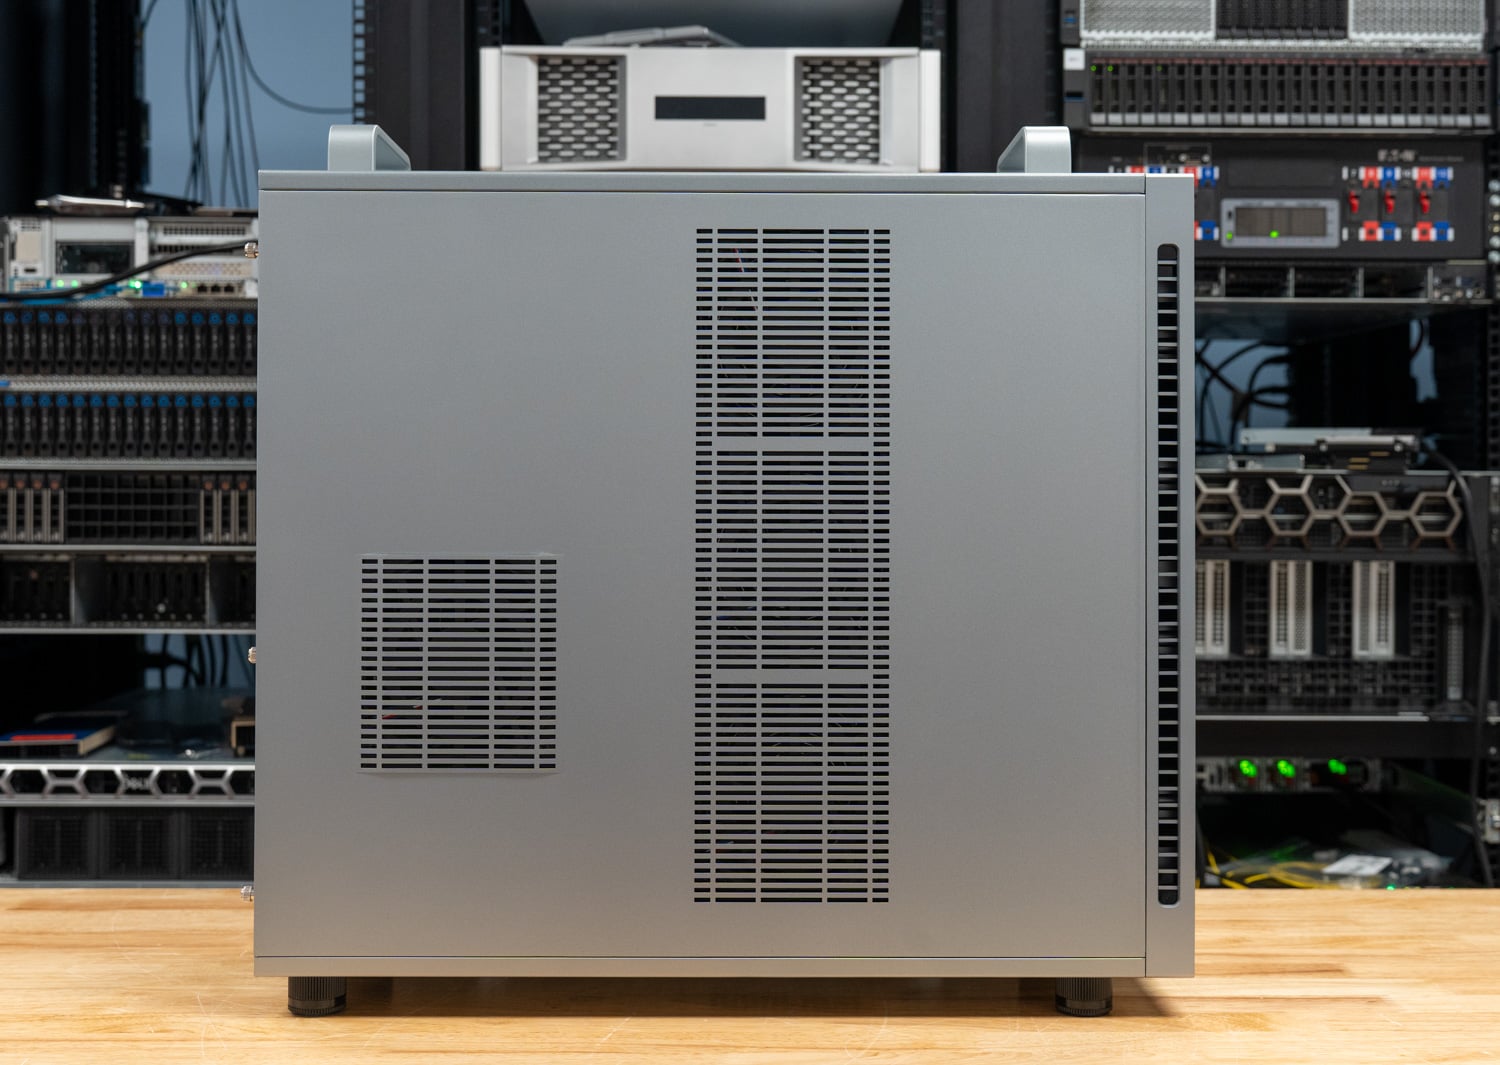
Přední panel obsahuje tlačítko napájení, dva 10Gbps porty USB typu A, dva 10Gbps porty USB typu C, port USB 2.0 a samostatné konektory pro sluchátka a mikrofon, vše uspořádané ve svislém pruhu v pravém horním rohu mřížky. Boční panel je velká ventilovaná deska s dlouhým perforovaným sloupkem vpředu pro sání chladiče a menší čtvercovou mřížkou vzadu, která je v linii se systémovými ventilátory. Není zde žádné okno ani osvětlení, což vyhovuje cílové skupině kupujících.
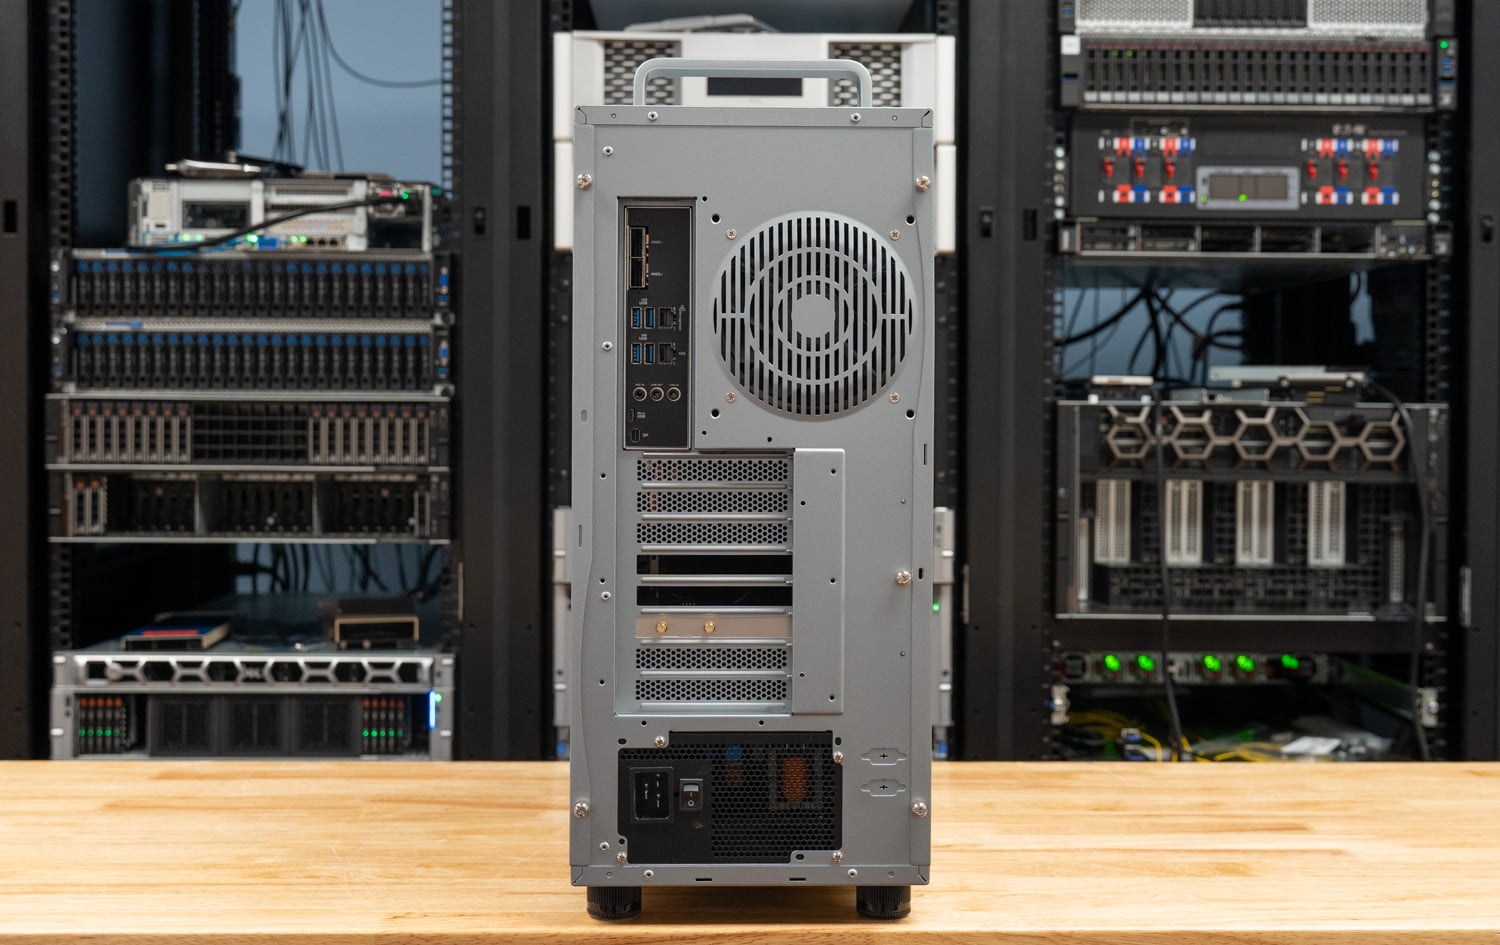
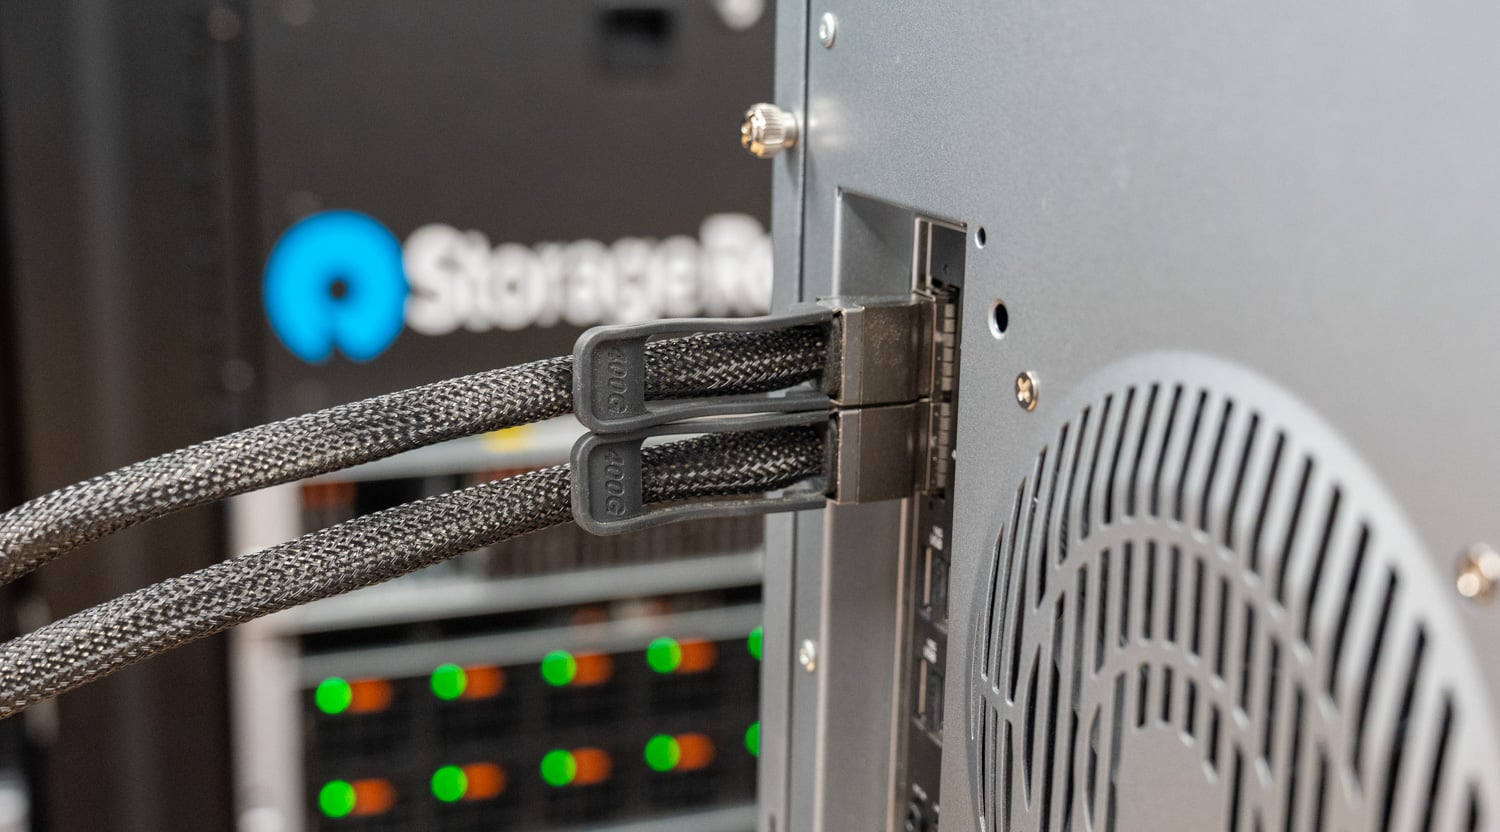
Vzadu rozvržení odděluje I/O pracovní stanice od hardwaru serveru pod ním. Horní cluster obsahuje čtyři 10Gbps porty USB typu A, 10GbE a 1GbE RJ45 konektory, tři audio konektory, konzolový port Micro-USB pro BMC a Mini DisplayPort, který BMC ovládá pro nastavení. Dvě šasi QSFP112 pro ConnectX-8 se nacházejí v horní části I/O štítu; vedle nich je odsávací ventilátor; tři kryty rozšiřujících slotů probíhají uprostřed; a napájecí zdroj se vstupem C19 je ve spodní části. Stejně jako u WS300 je Mini DisplayPort výstupem BMC pro počáteční nastavení a řešení problémů; každý, kdo chce na tomto počítači stolní počítač, potřebuje kartu RTX PRO.
Uvnitř ET900N G3
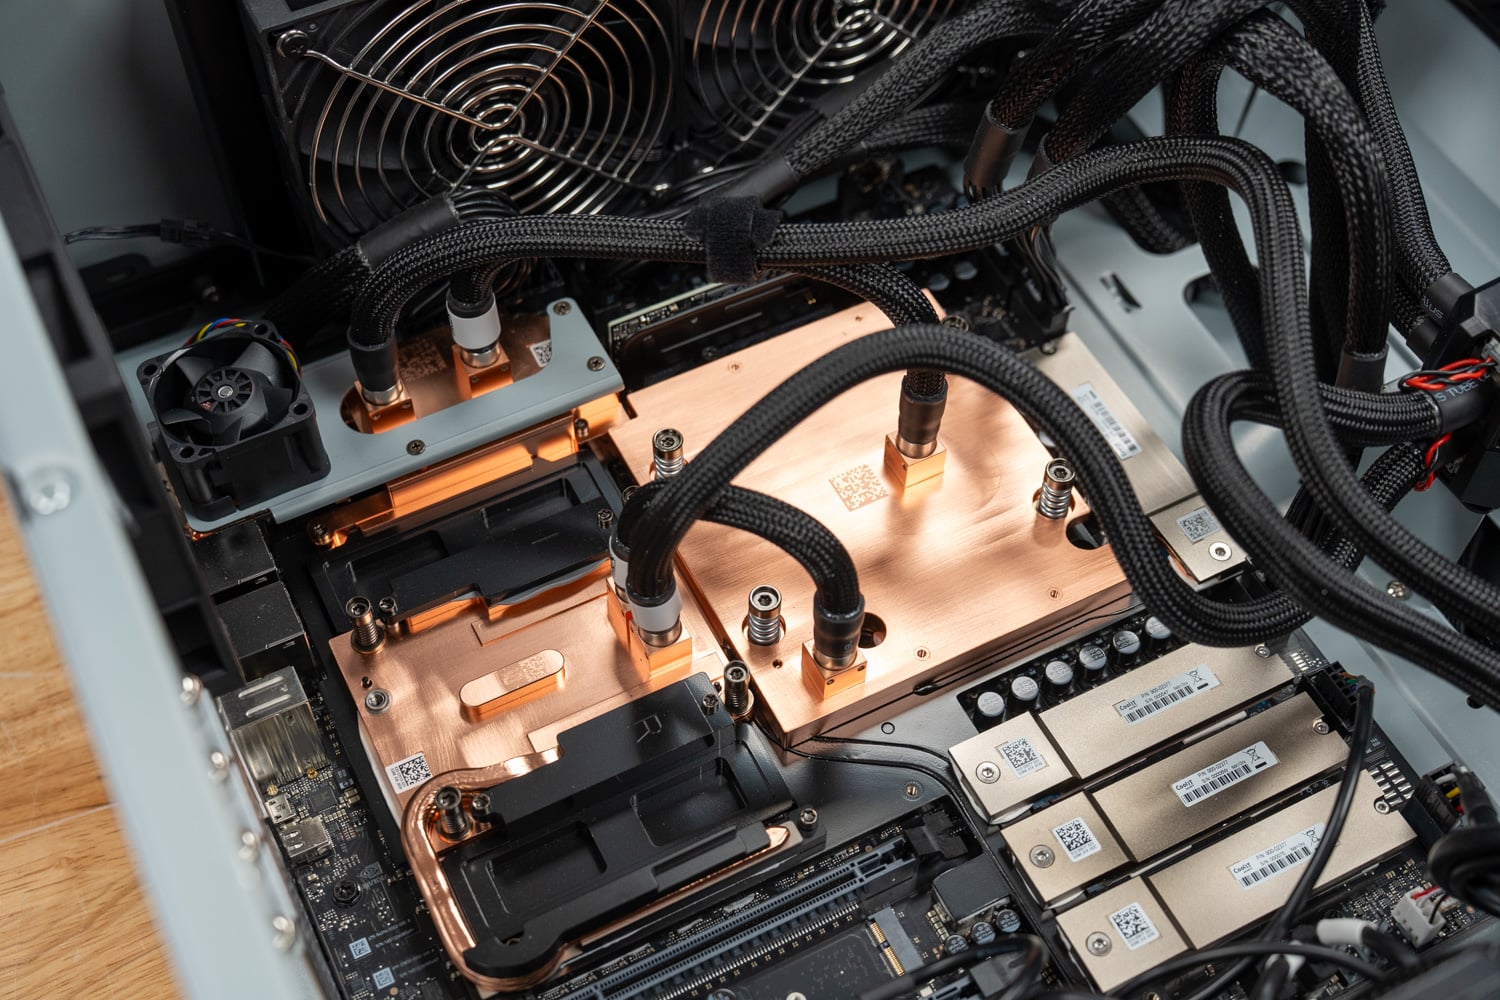
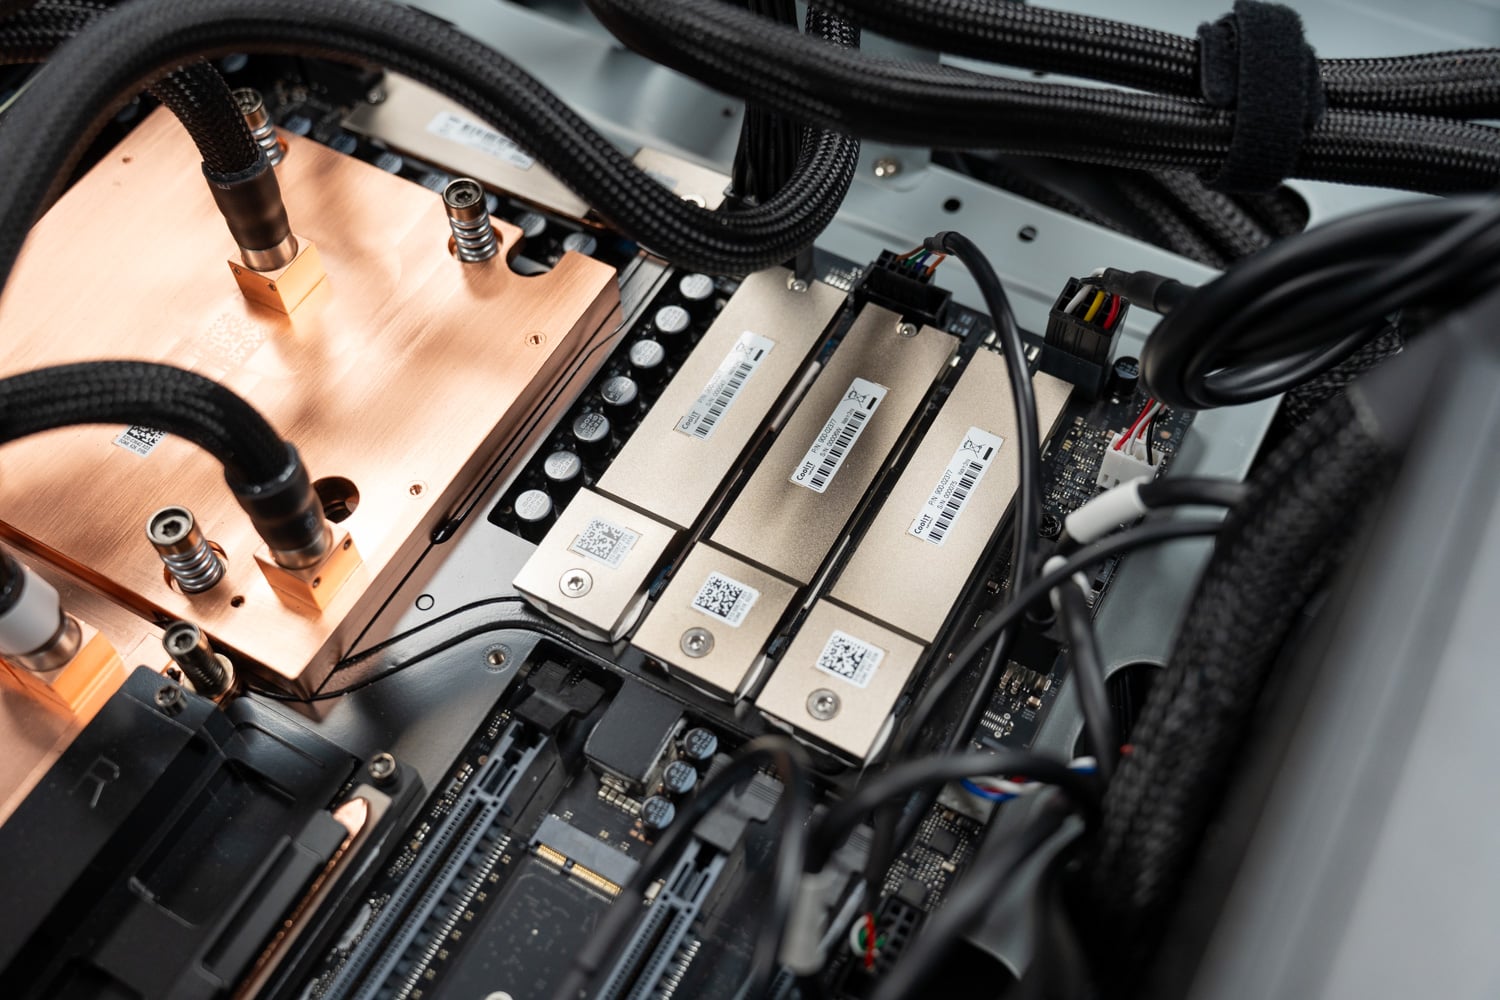
Po sejmutí bočního panelu se ET900N G3 jeví jako blízký příbuzný WS300, což se dalo očekávat, vzhledem k tomu, že oba sdílejí stejnou základní desku NVIDIA. Superčip GB300 je umístěn pod měděnou chladicí deskou na levé straně šasi, moduly SOCAMM jsou pod vlastními měděnými deskami vedle ní a ConnectX-8 pod třetím blokem poblíž zadních I/O panelů. Z bloků vede opletená trubice k rozdělovači namontovanému na příčném nosníku šasi a odtud k radiátorům. Tři sloty PCIe plné délky jsou umístěny pod superčipem, napájecí zdroj zabírá spodní přední roh a kovový kryt zakrývá kabelovou cestu podél spodní části.
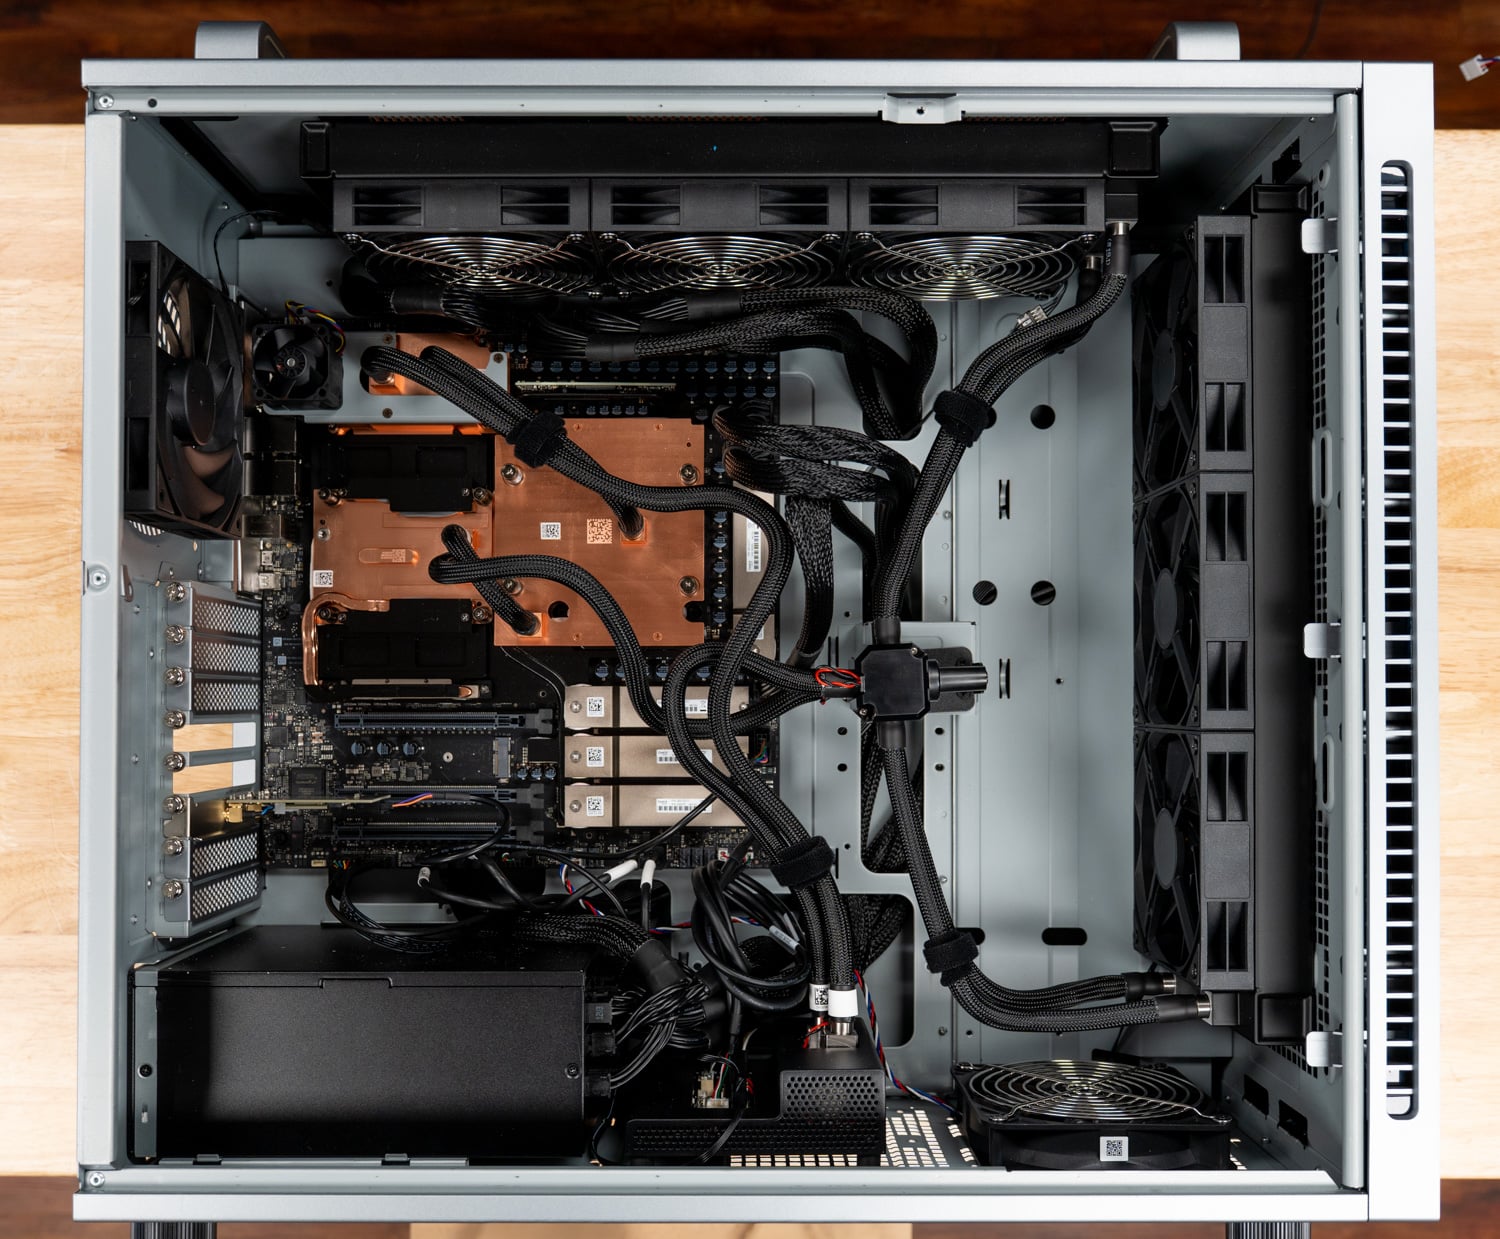
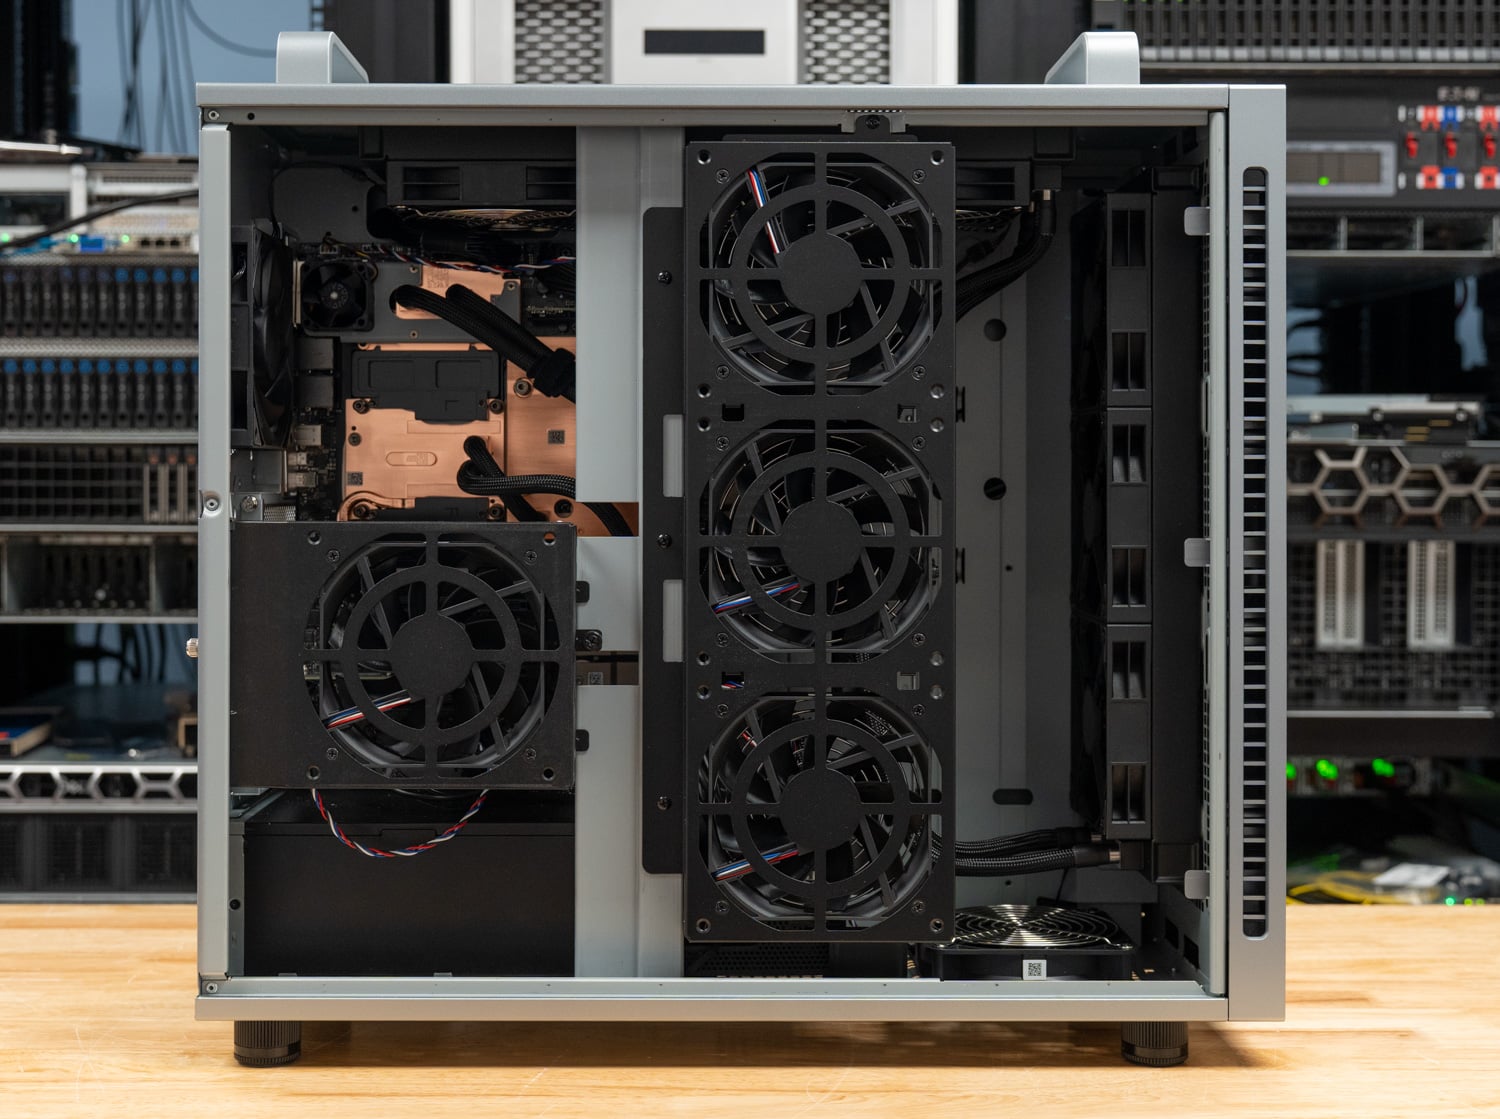
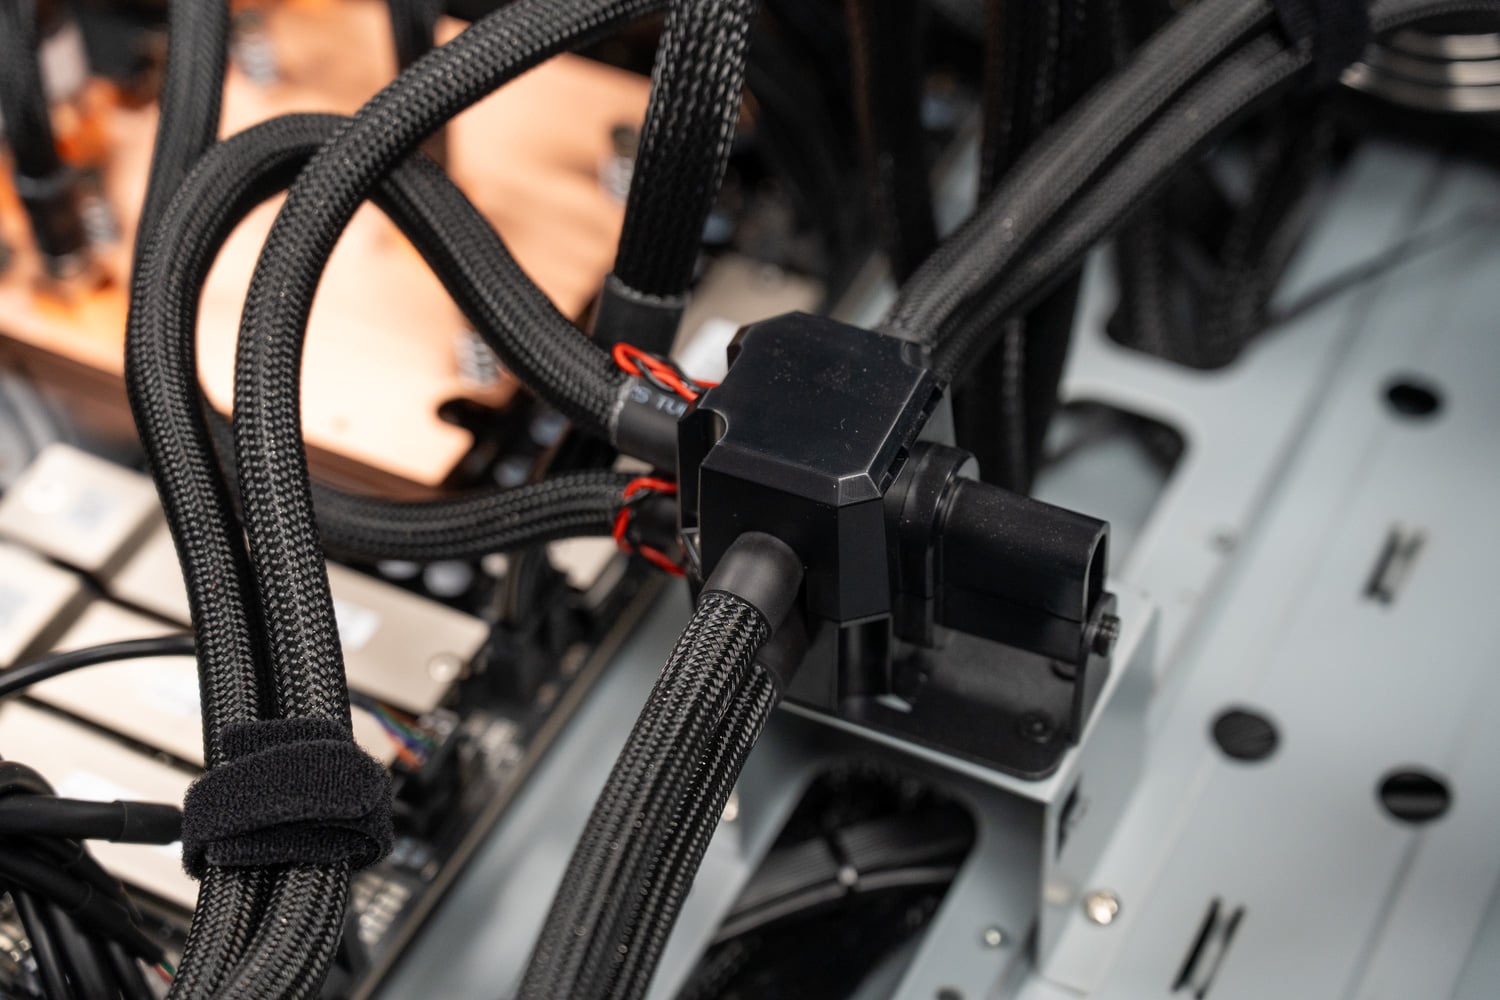
Uspořádání uvnitř se řídí stejným vzorem jako u WS300: jeden chladič namontovaný svisle za přední mřížkou a druhý podél horní části, každý s řadou ventilátorů, plus ventilátor šasi vzadu. Chladicí potrubí je opatřeno návleky a připevněno k příčnému nosníku pomocí suchých zipů a sběrné potrubí sjednocuje průchody ze čtyř chladicích desek tak, aby ke každému chladiči dosáhly pouze dvě potrubí.
Ventilátor optiky
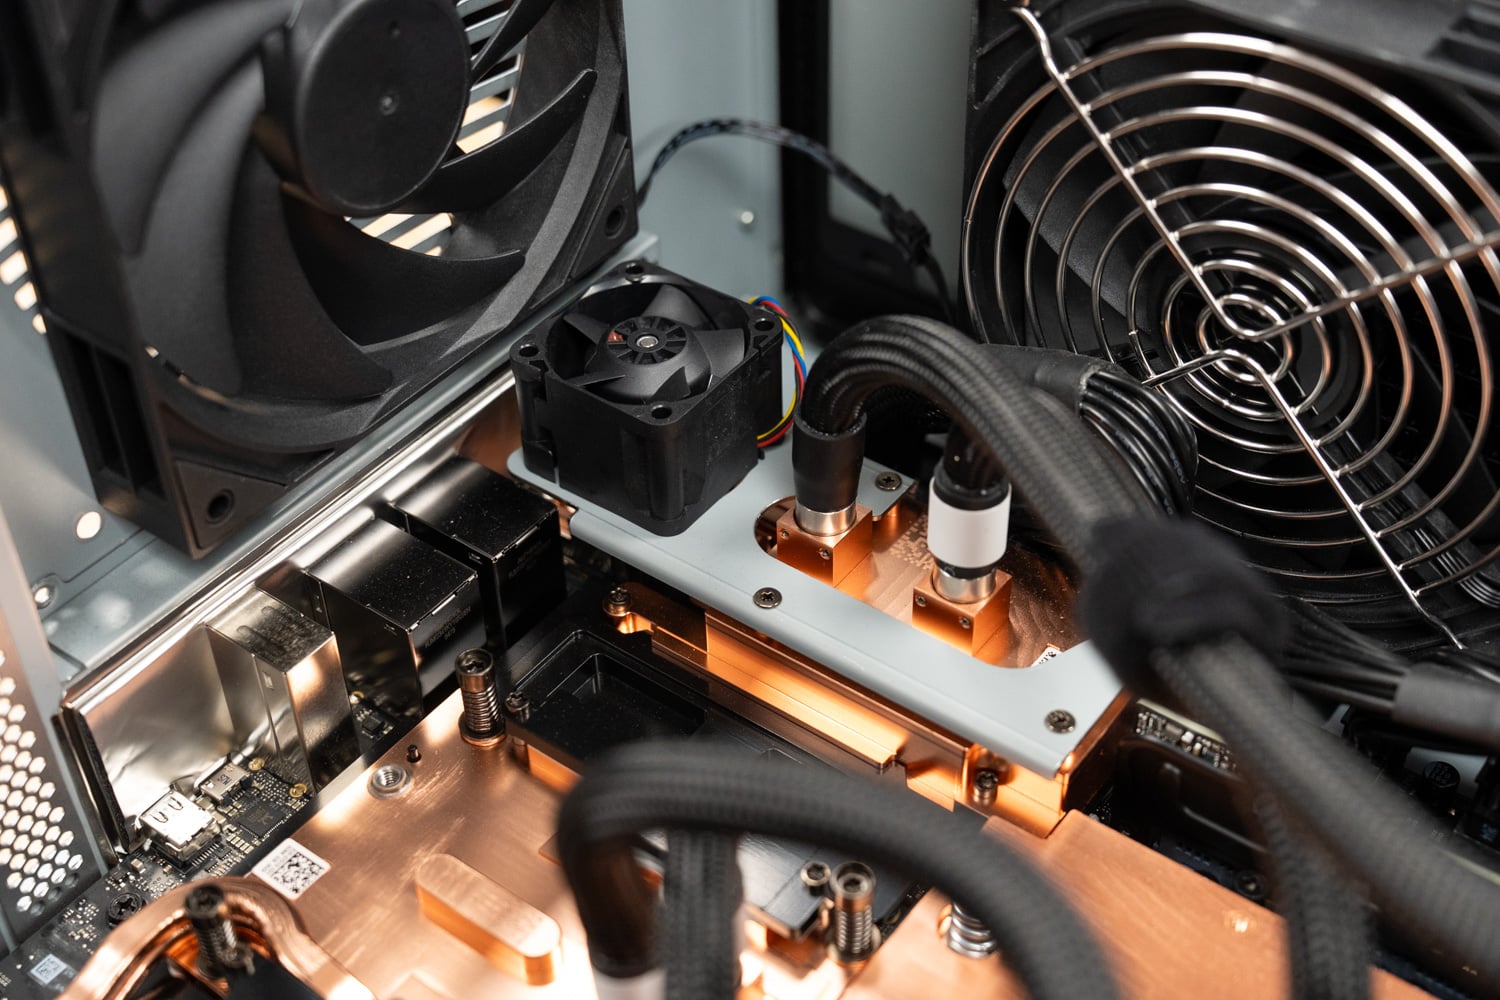
Jediným chladicím prvkem, který v modelu WS300 nemá obdobu, je malý ventilátor namontovaný na držáku nad chladicí deskou ConnectX-8, namířený na klece QSFP112. Kapalinová smyčka obsluhuje samotný křemík SuperNIC, ale optické transceivery 400G generují vlastní teplo a jsou umístěny v kovových klecích, ke kterým se chladicí deska dostane pouze vedením. V jiných testech jsme si všimli, že se ConnectX-8 při trvalém zatížení zahřívá a že se může přehřát i samotná optika, takže vyhřívaná cesta proudění vzduchu napříč klecemi je příjemným designovým prvkem pro každého, kdo plánuje provozovat ET900N G3 na optickém kabelu celé hodiny. S DAC převodníky, kterými jsme jej propojili s druhou stanicí GB300 pro hluboký ponor do clusterované inference, který stále probíhá, má ventilátor méně práce.
Úložiště, rozšíření a napájení
Společnost ASUS dodala model ET900N G3 s jedním 2TB NVMe diskem pro operační systém a softwarový stack NVIDIA, a to v dvojici slotů M.2 2280 připojených k rozhraní Grace přes PCIe 5.0 x4. Druhá dvojice slotů je připojena k integrovanému přepínači PCIe adaptéru ConnectX-8 a je dodávána prázdná.
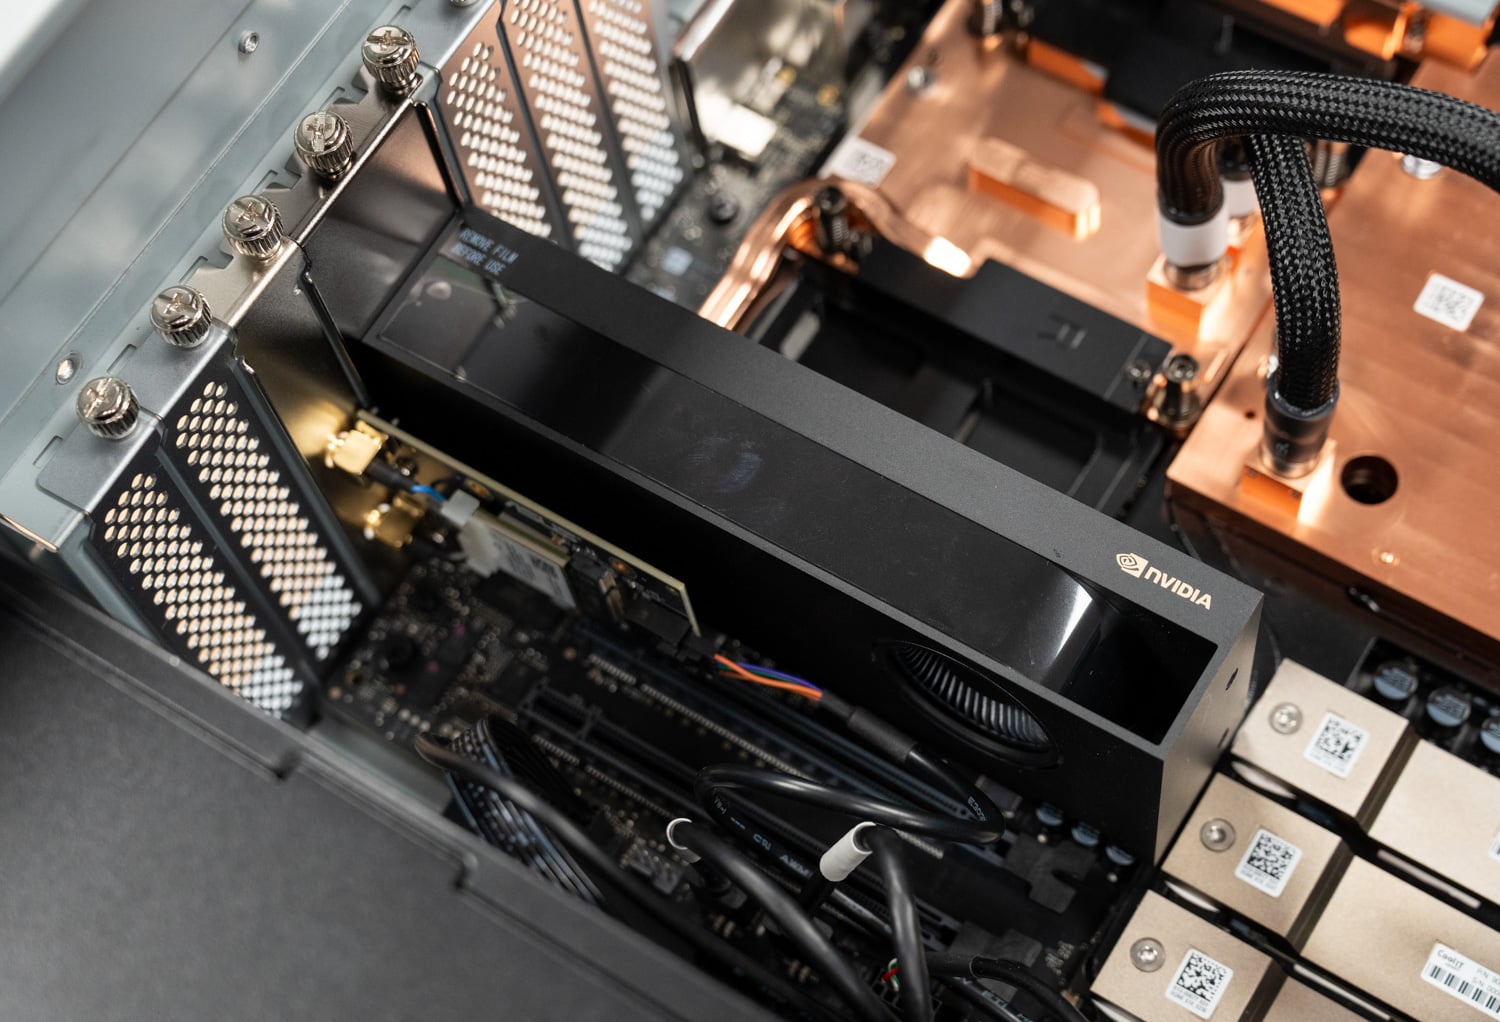
Náš recenzovaný kus dorazil s grafickou kartou NVIDIA RTX PRO 2000 Blackwell ve slotu PCIe 5.0 x16, což je jedna z konfigurací, které ASUS uvádí. Karta poskytuje obrazový výstup, aniž by výrazně snižovala spotřebu energie GB300, a ASUS uvádí, že šasi pojme až jednu kartu RTX PRO Blackwell. Před benchmarkem jsme RTX PRO 2000 vyřadili, takže Superchip měl plný akcelerační rozpočet, což je stejná podmínka jako u WS300, a v tomto šasi jsme netestovali žádnou vysoce výkonnou kartu RTX PRO; tuto cestu a to, co dělá se sdílenou spotřebou energie, probereme v nadcházející recenzi GB300 Station.
Napájecí zdroj je ATX jednotka s výkonem 1 600 W, kterou ASUS hodnotí jako 80 PLUS Titanium, což je o krok nad Platinum jednotkou v modelu WS300. Titanium vyžaduje 94% účinnost při 50% zátěži a vstupním napětí 115 V ve srovnání s 92 % u Platinum a je to jediná úroveň, která stanovuje spodní hranici zátěže na 10 %, takže ET900N G3 by měl při plném zatížení GB300 spotřebovávat o několik desítek wattů méně. Rozpočet je stále sdílený: Grace, B300, čerpadla, ventilátory, úložiště a případná grafická karta RTX PRO spotřebovávají stejných 1 600 W a služba vsloshd od NVIDIA přesouvá prostor mezi Superchipem a přídavnou GPU podle toho, jak se jejich spotřeba mění, bez pevného limitu u obou. Recenze WS300 tuto politiku prochází a zde zůstává nezměněna. Pro instalace v Severní Americe zůstává požadavkem vyhrazený 20A obvod.
Připojení
Dva porty QSFP112 zařízení ConnectX-8 propojují ET900N G3 se vším ostatním: úložištěm, druhou stanicí DGX nebo clusterovou strukturou. Tyto porty se v laboratoři již používají, přičemž ET900N G3 je kabelově připojen k druhé stanici GB300 přes 400G DAC pro podrobný rozbor clusterované inference, který zveřejníme samostatně. 10GbE port Marvell zpracovává běžný hostitelský provoz a port Realtek 1GbE je vyhrazen pro BMC.
Poznámky k testování
Všechny výsledky v této recenzi pocházejí z jednotky, kterou společnost ASUS dodala do naší laboratoře, v konfiguraci paměti s 252 GB HBM3e a 496 GB LPDDR5X. Systém běžel bez nainstalované grafické karty RTX PRO, takže čip GB300 Superchip měl plný energetický rozpočet akcelerátoru, což odpovídalo podmínkám našeho testování WS300. Softwarový stack, konfigurace vLLM, profily pracovní zátěže a souběžné měření jsou stejné jako u WS300, takže lze oba věžové počítače přímo porovnávat. Tato recenze se týká pouze výkonu; u této jednotky jsme neměřili spotřebu energie ani teplotu.
Zátěžové úlohy představují dva stejné profily živé inference vLLM, které spouštíme na každém lokálním systému AI: stejná pracovní úloha s 512 vstupními a 512 výstupními tokeny a pracovní úloha s vysokým počtem předfillů s 8 192 vstupními a 1 024 výstupními tokeny, rozšířená od jednoho do 128 souběžných streamů. U modelů na hranici možností porovnáváme server Dell PowerEdge XE7740 s GPU vybaveným dvěma nebo čtyřmi kartami RTX PRO 6000 , což je nejbližší alternativa v jednom boxu pro tyto kontrolní body. U menších modelů porovnáváme jednu grafickou kartu RTX PRO 6000 ve stejném XE7740, jednu síťovou kartu H200 v Dell PowerEdge R770 a GB10 DGX Spark, reprezentovanou Acer Veriton GN100 , což je stejný Spark, který jsme použili v recenzi WS300. Níže uvedené hodnoty pro ET900N G3 jsou přesné hodnoty z protokolů běhu; hodnoty pro porovnávací systém jsou odečteny z našich grafů výsledků.
Výkon inference
Hraniční modely na koherentním paměťovém fondu
Důvodem existence GB300 je obsluha modelů na obou stranách hranice 252GB HBM3e u B300, takže začneme se čtyřmi kontrolními body, které ji pokrývají: DeepSeek V4 Flash a MiniMax M2.7 se do HBM vejdou s dostatkem prostoru, MiniMax M3 se sotva vejde a část svých expertních pamětí přesouvá do paměti Grace a GLM-5.2 odlehčuje zhruba polovinu své hmotnosti. Na druhé straně každého grafu je nejbližší alternativa v jednom boxu: karty RTX PRO 6000 pohromadě v PowerEdge XE7740 s expertním odlehčením pro hostování paměti tam, kde je to potřeba.
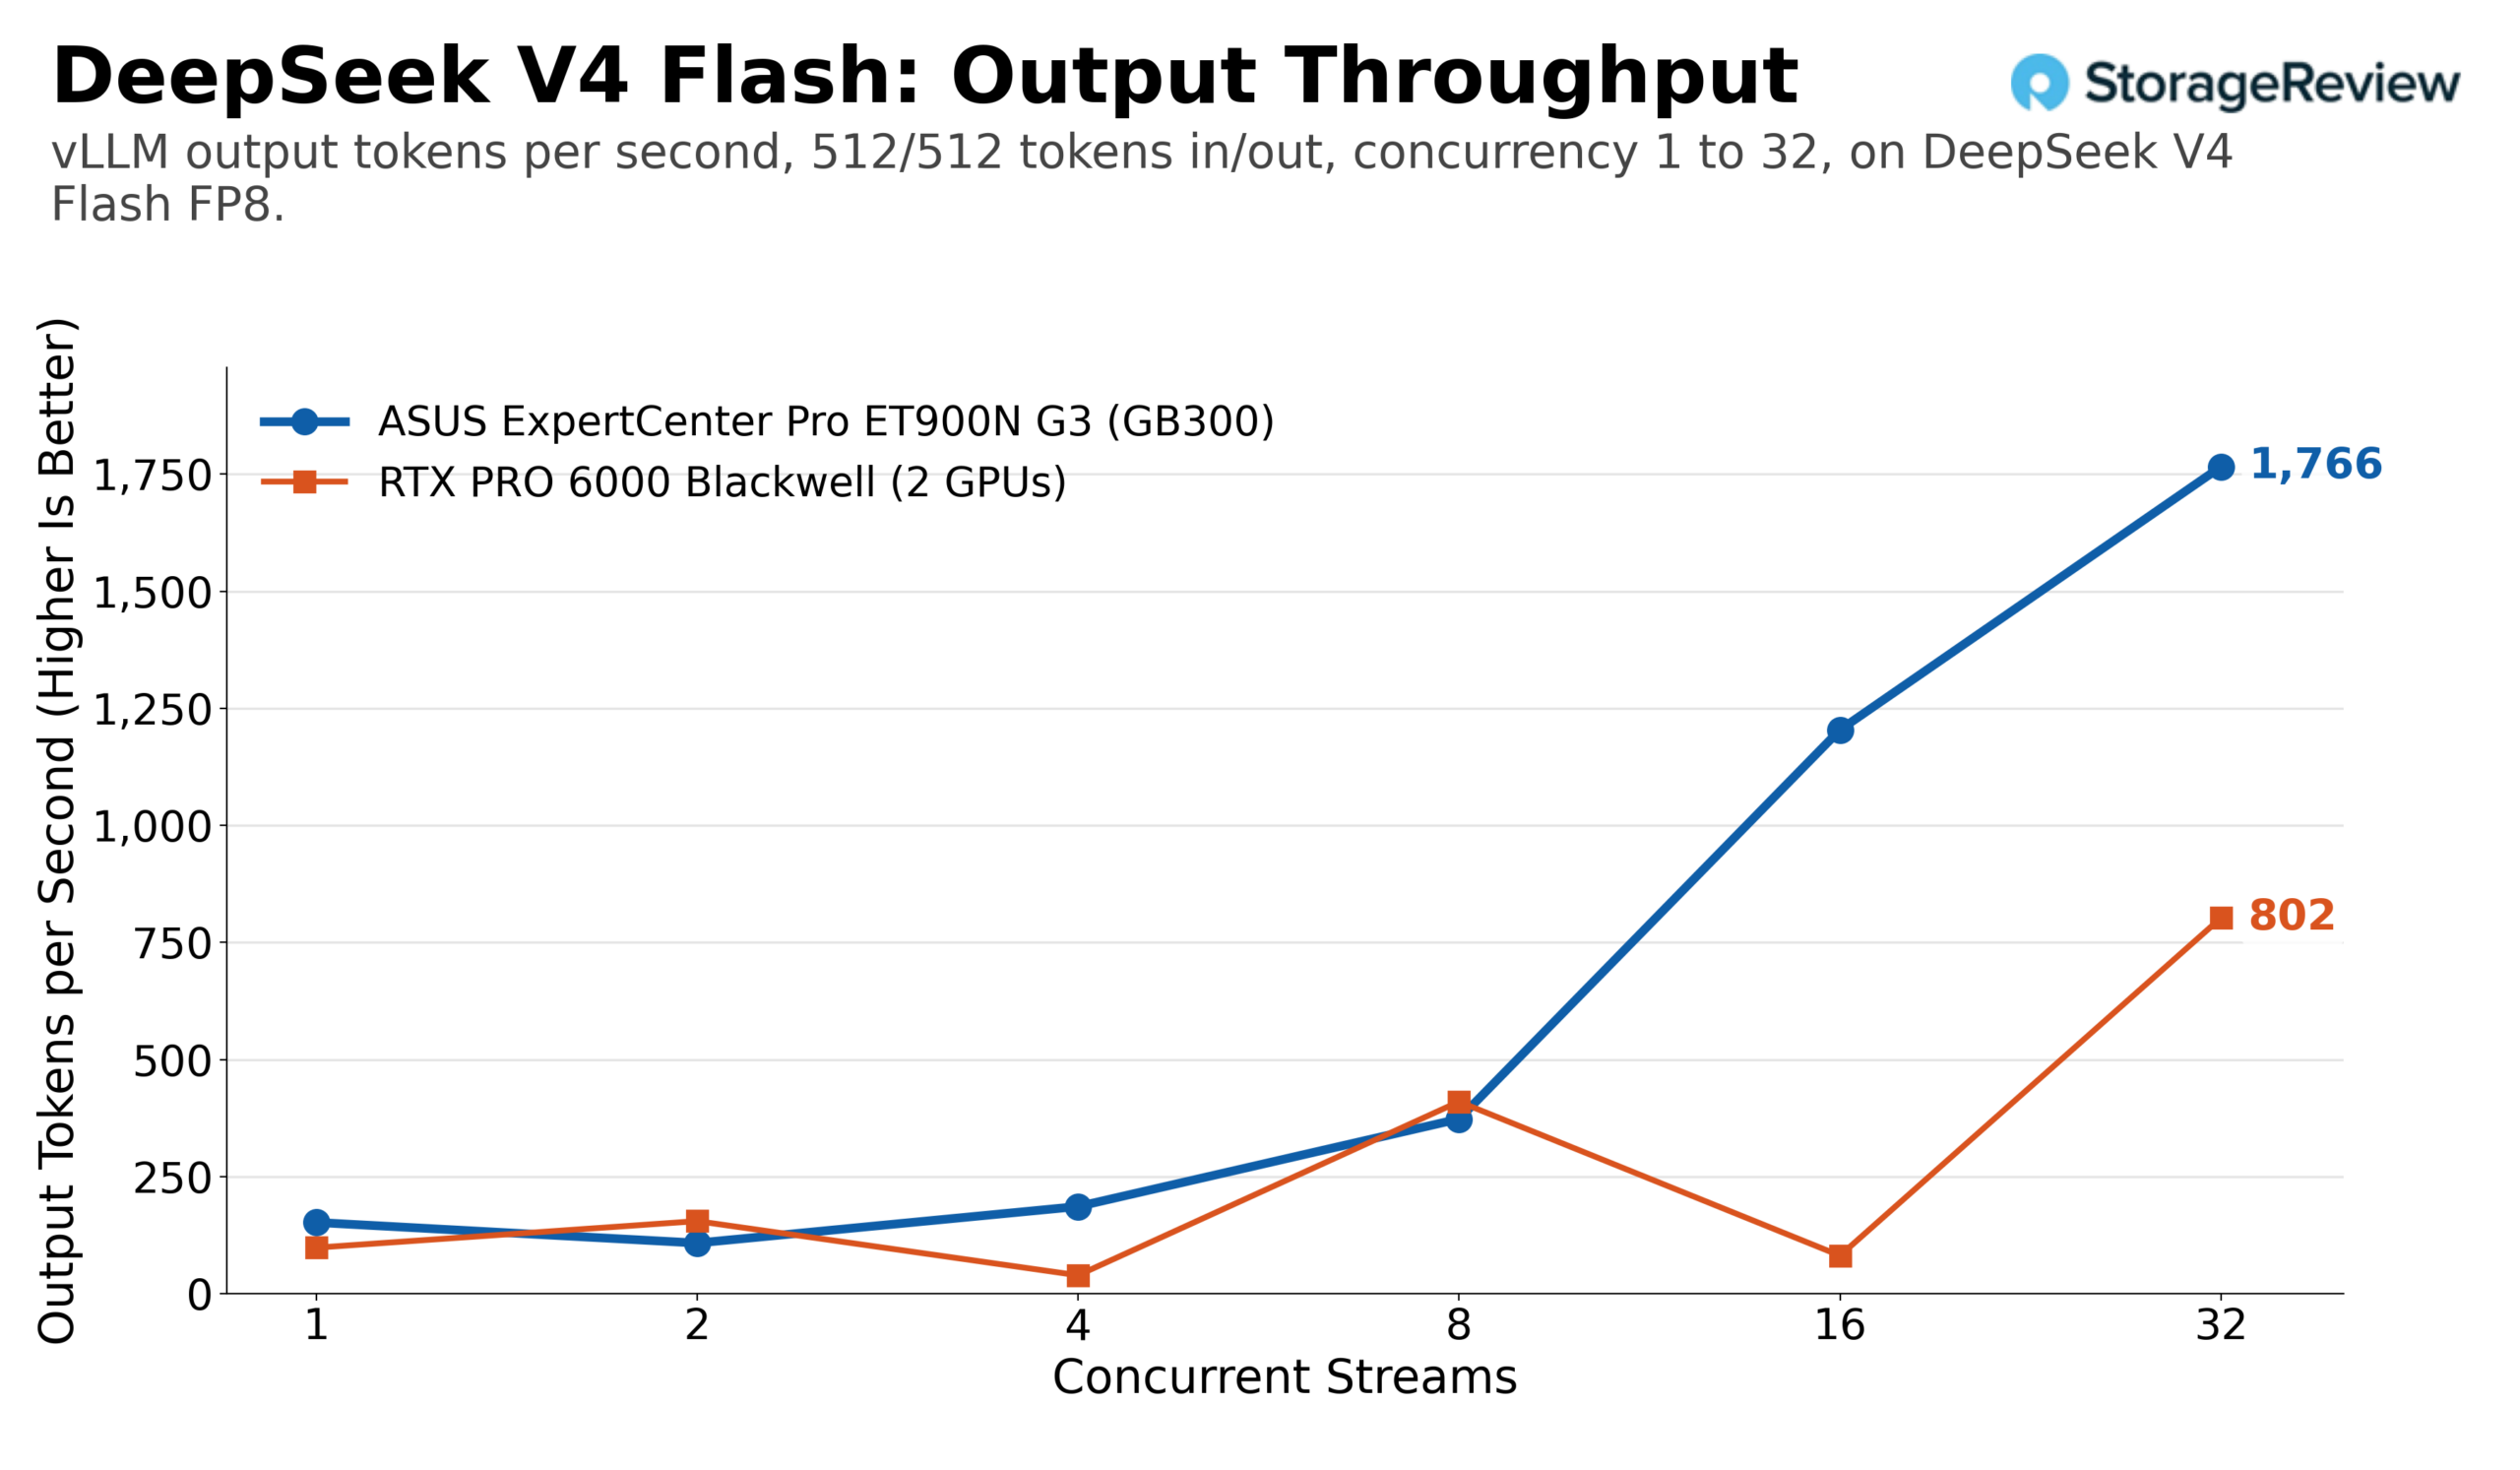
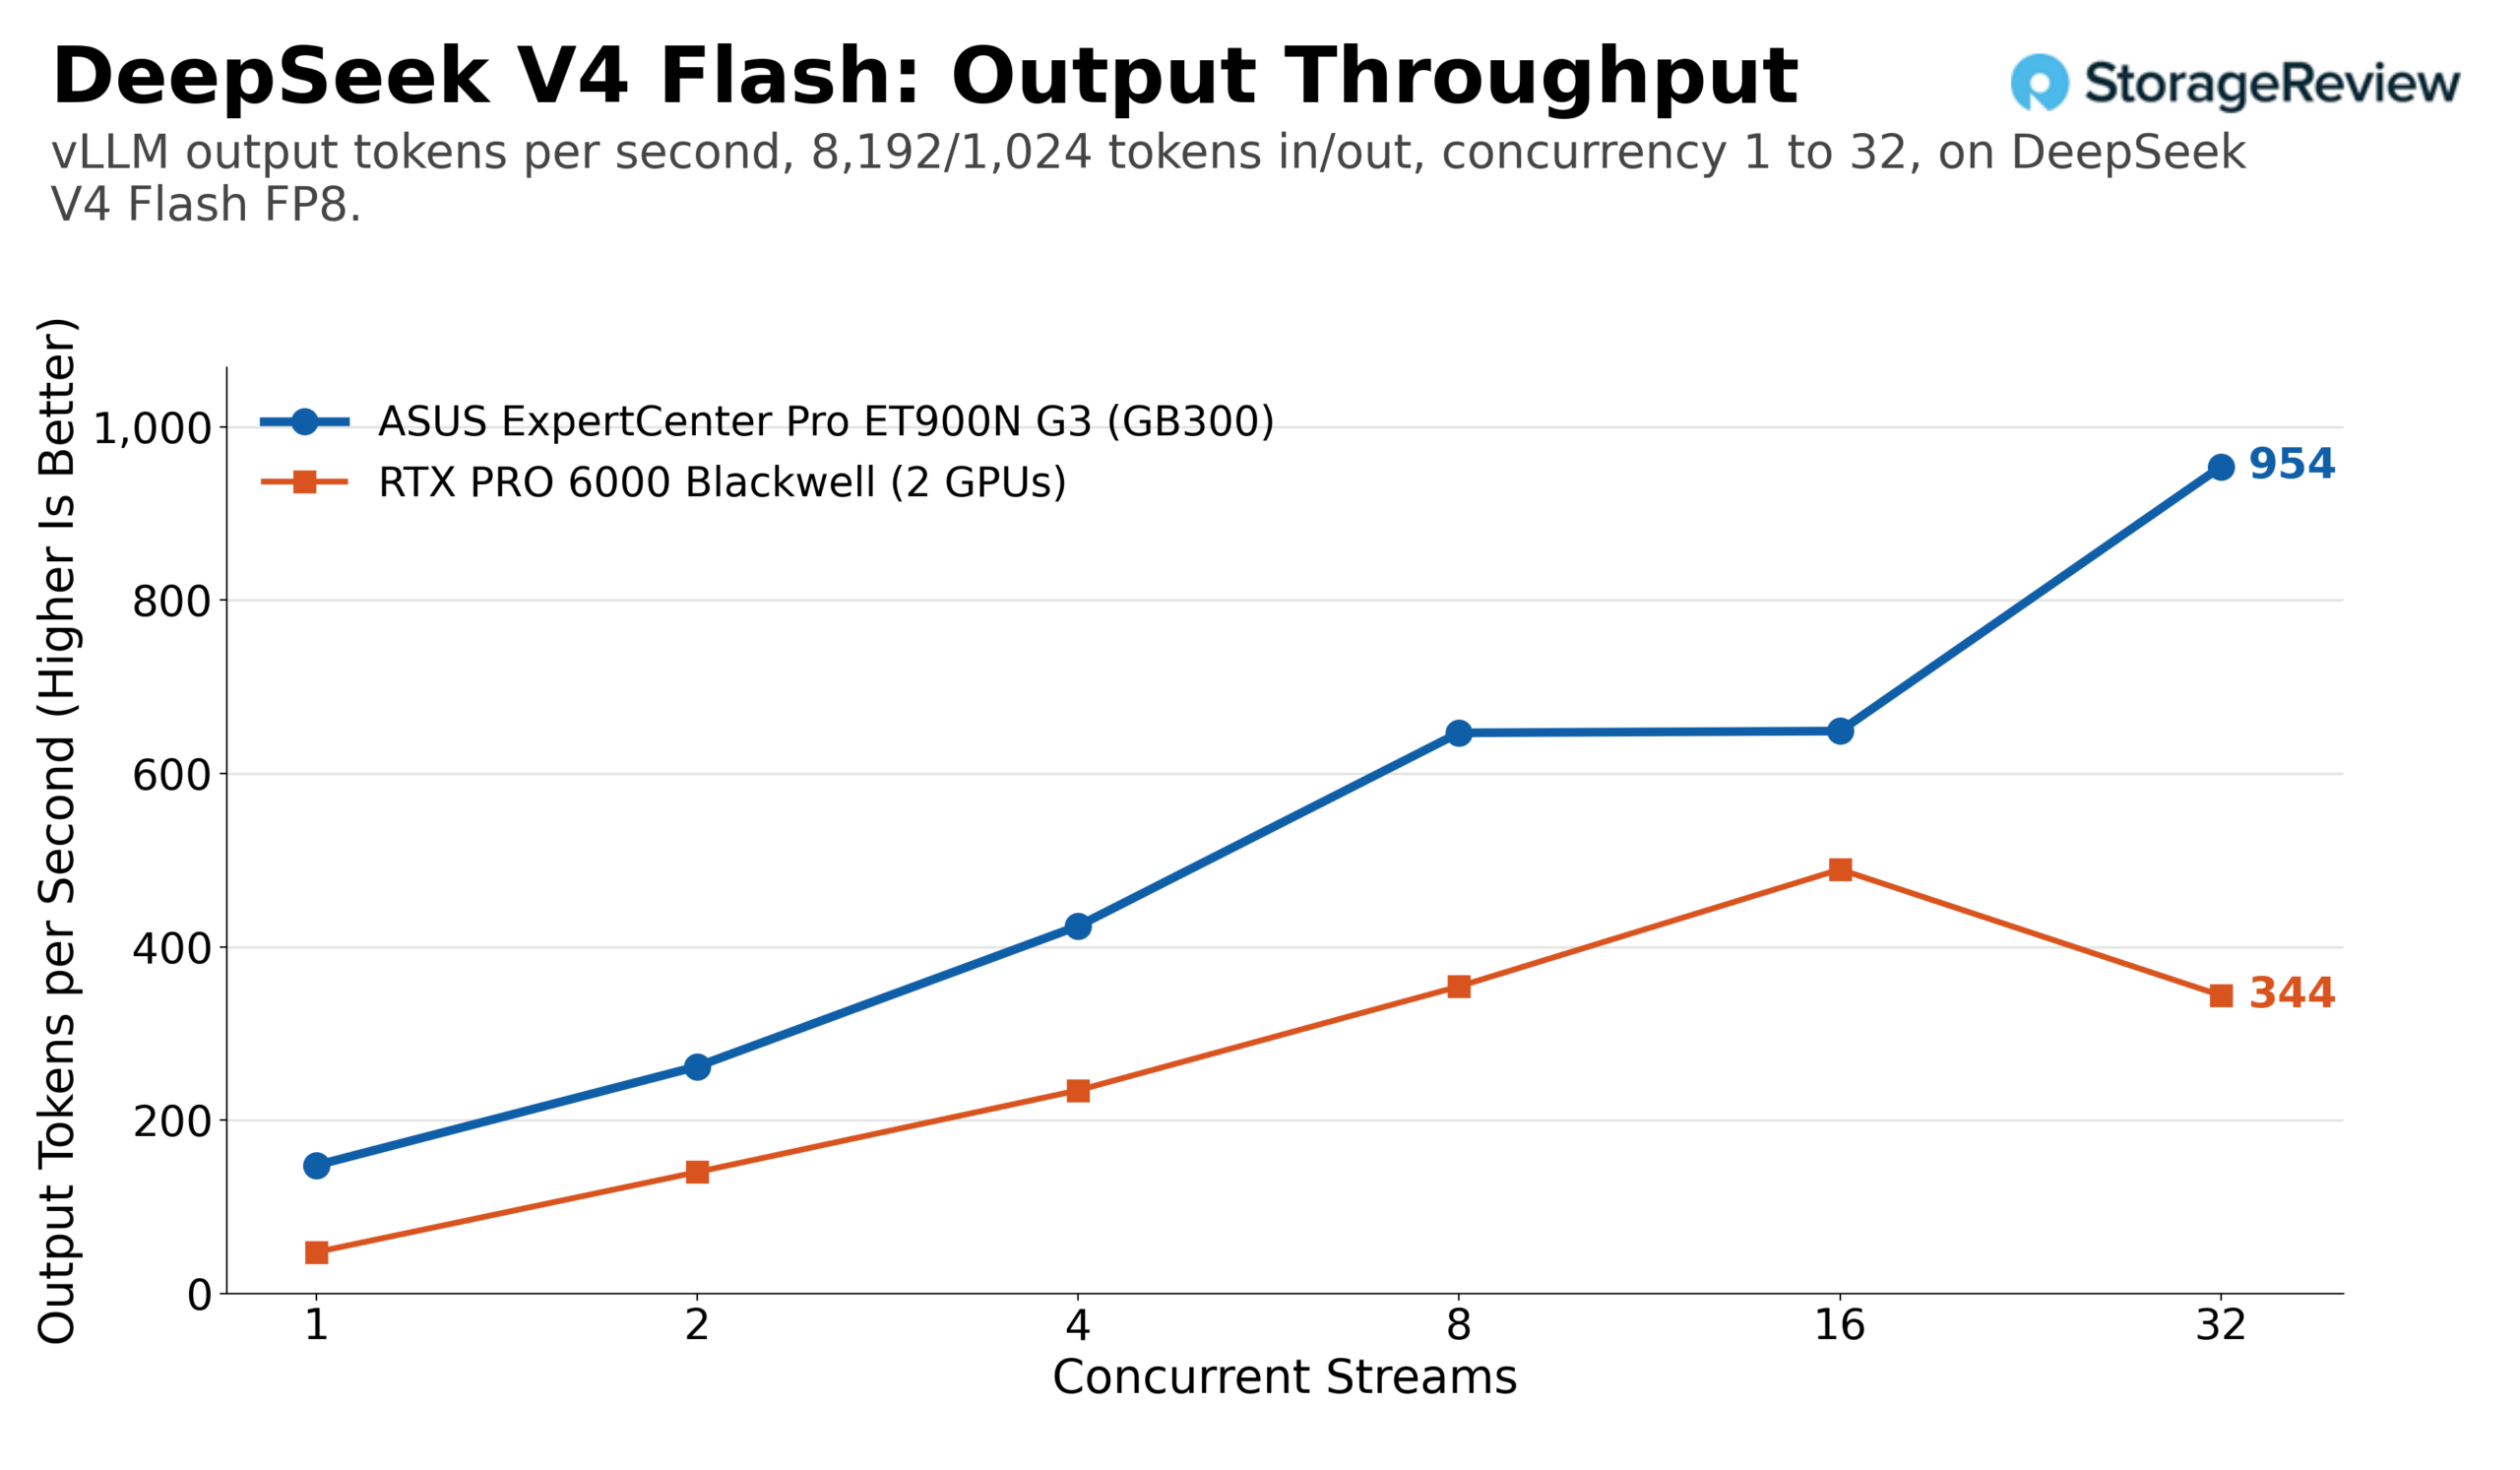
DeepSeek V4 Flash je snadný případ: nativní kontrolní bod FP8 o velikosti přibližně 20 GB, který B300 bez námahy obsluhuje. Výstupní propustnost při stejném zatížení vzrostla ze 152 tokenů za sekundu s 1 streamem na 1 766 s 32 streamy, čímž se celková propustnost tokenů zvýšila na 3 532. V profilu s vysokým počtem předfillů se výstupní propustnost ET900N G3 zvýšila ze 148 na 954 tokenů za sekundu, s celkovým počtem 8 587 tokenů. Dvojice karet RTX PRO 6000 dosáhla vrcholu poblíž 800 výstupních tokenů za sekundu při stejném zatížení a přibližně 490 u dlouhých promptů, s nerovnoměrnou křivkou při nízké souběžnosti.
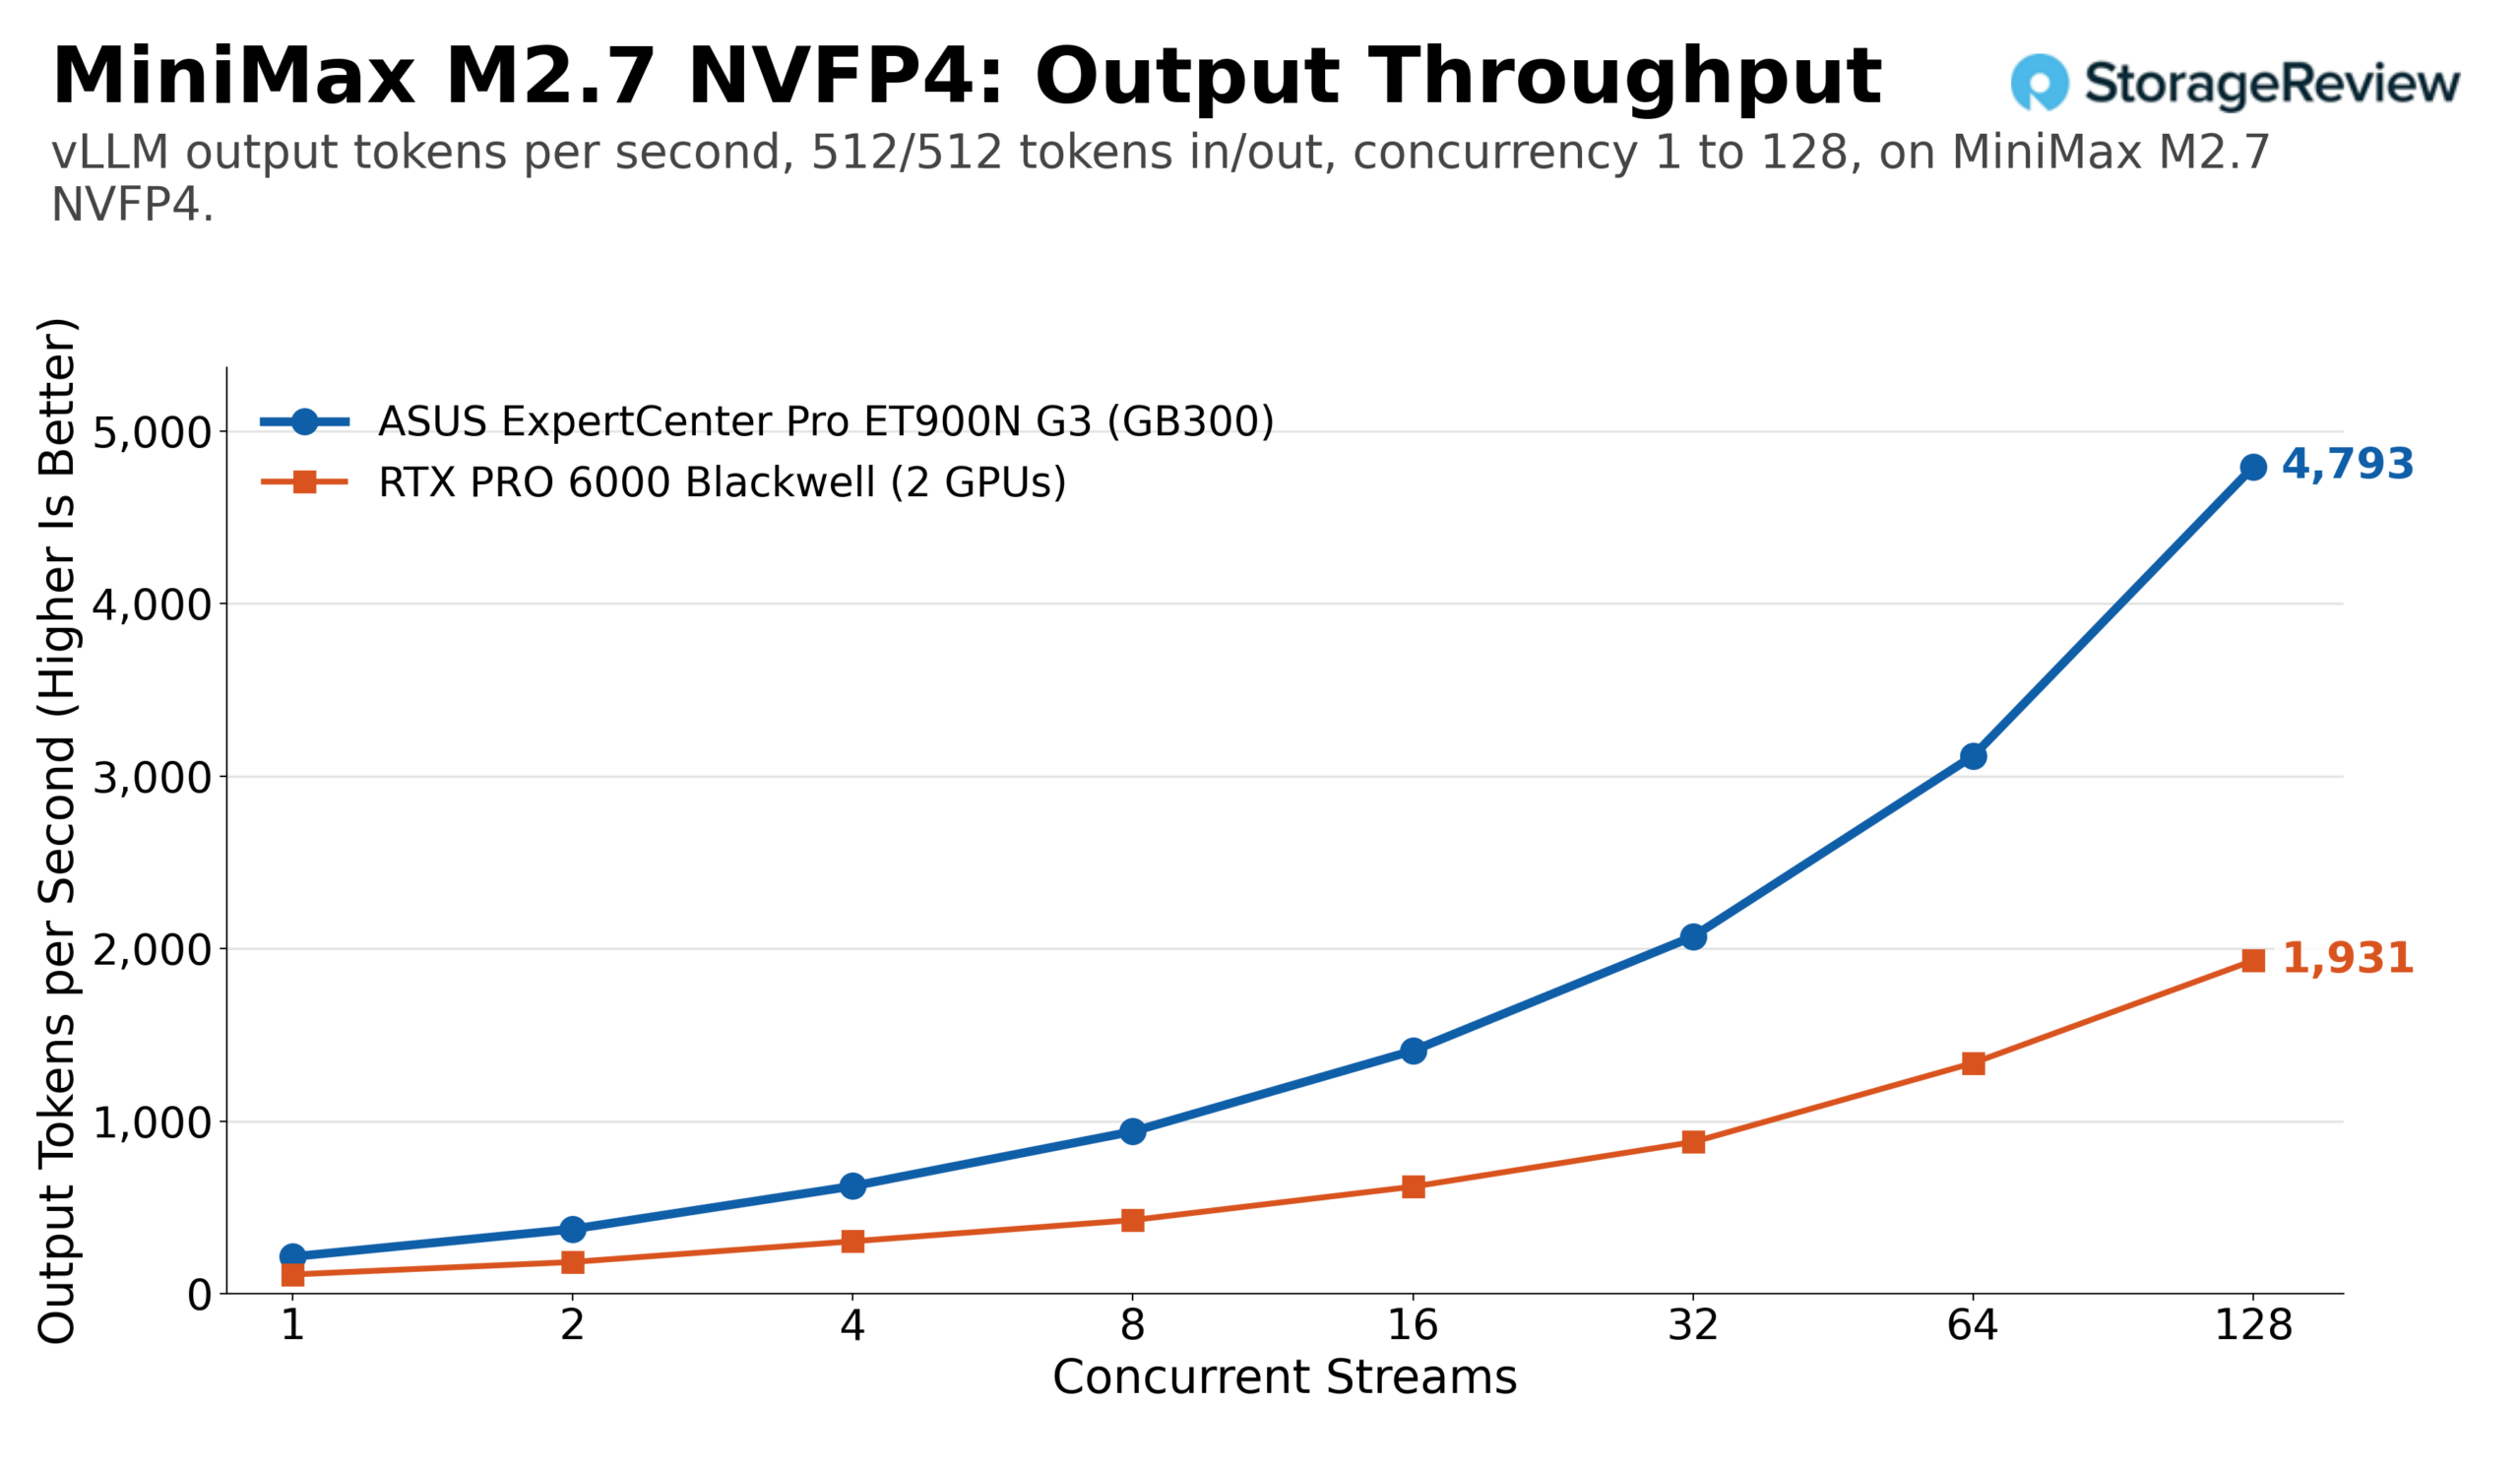
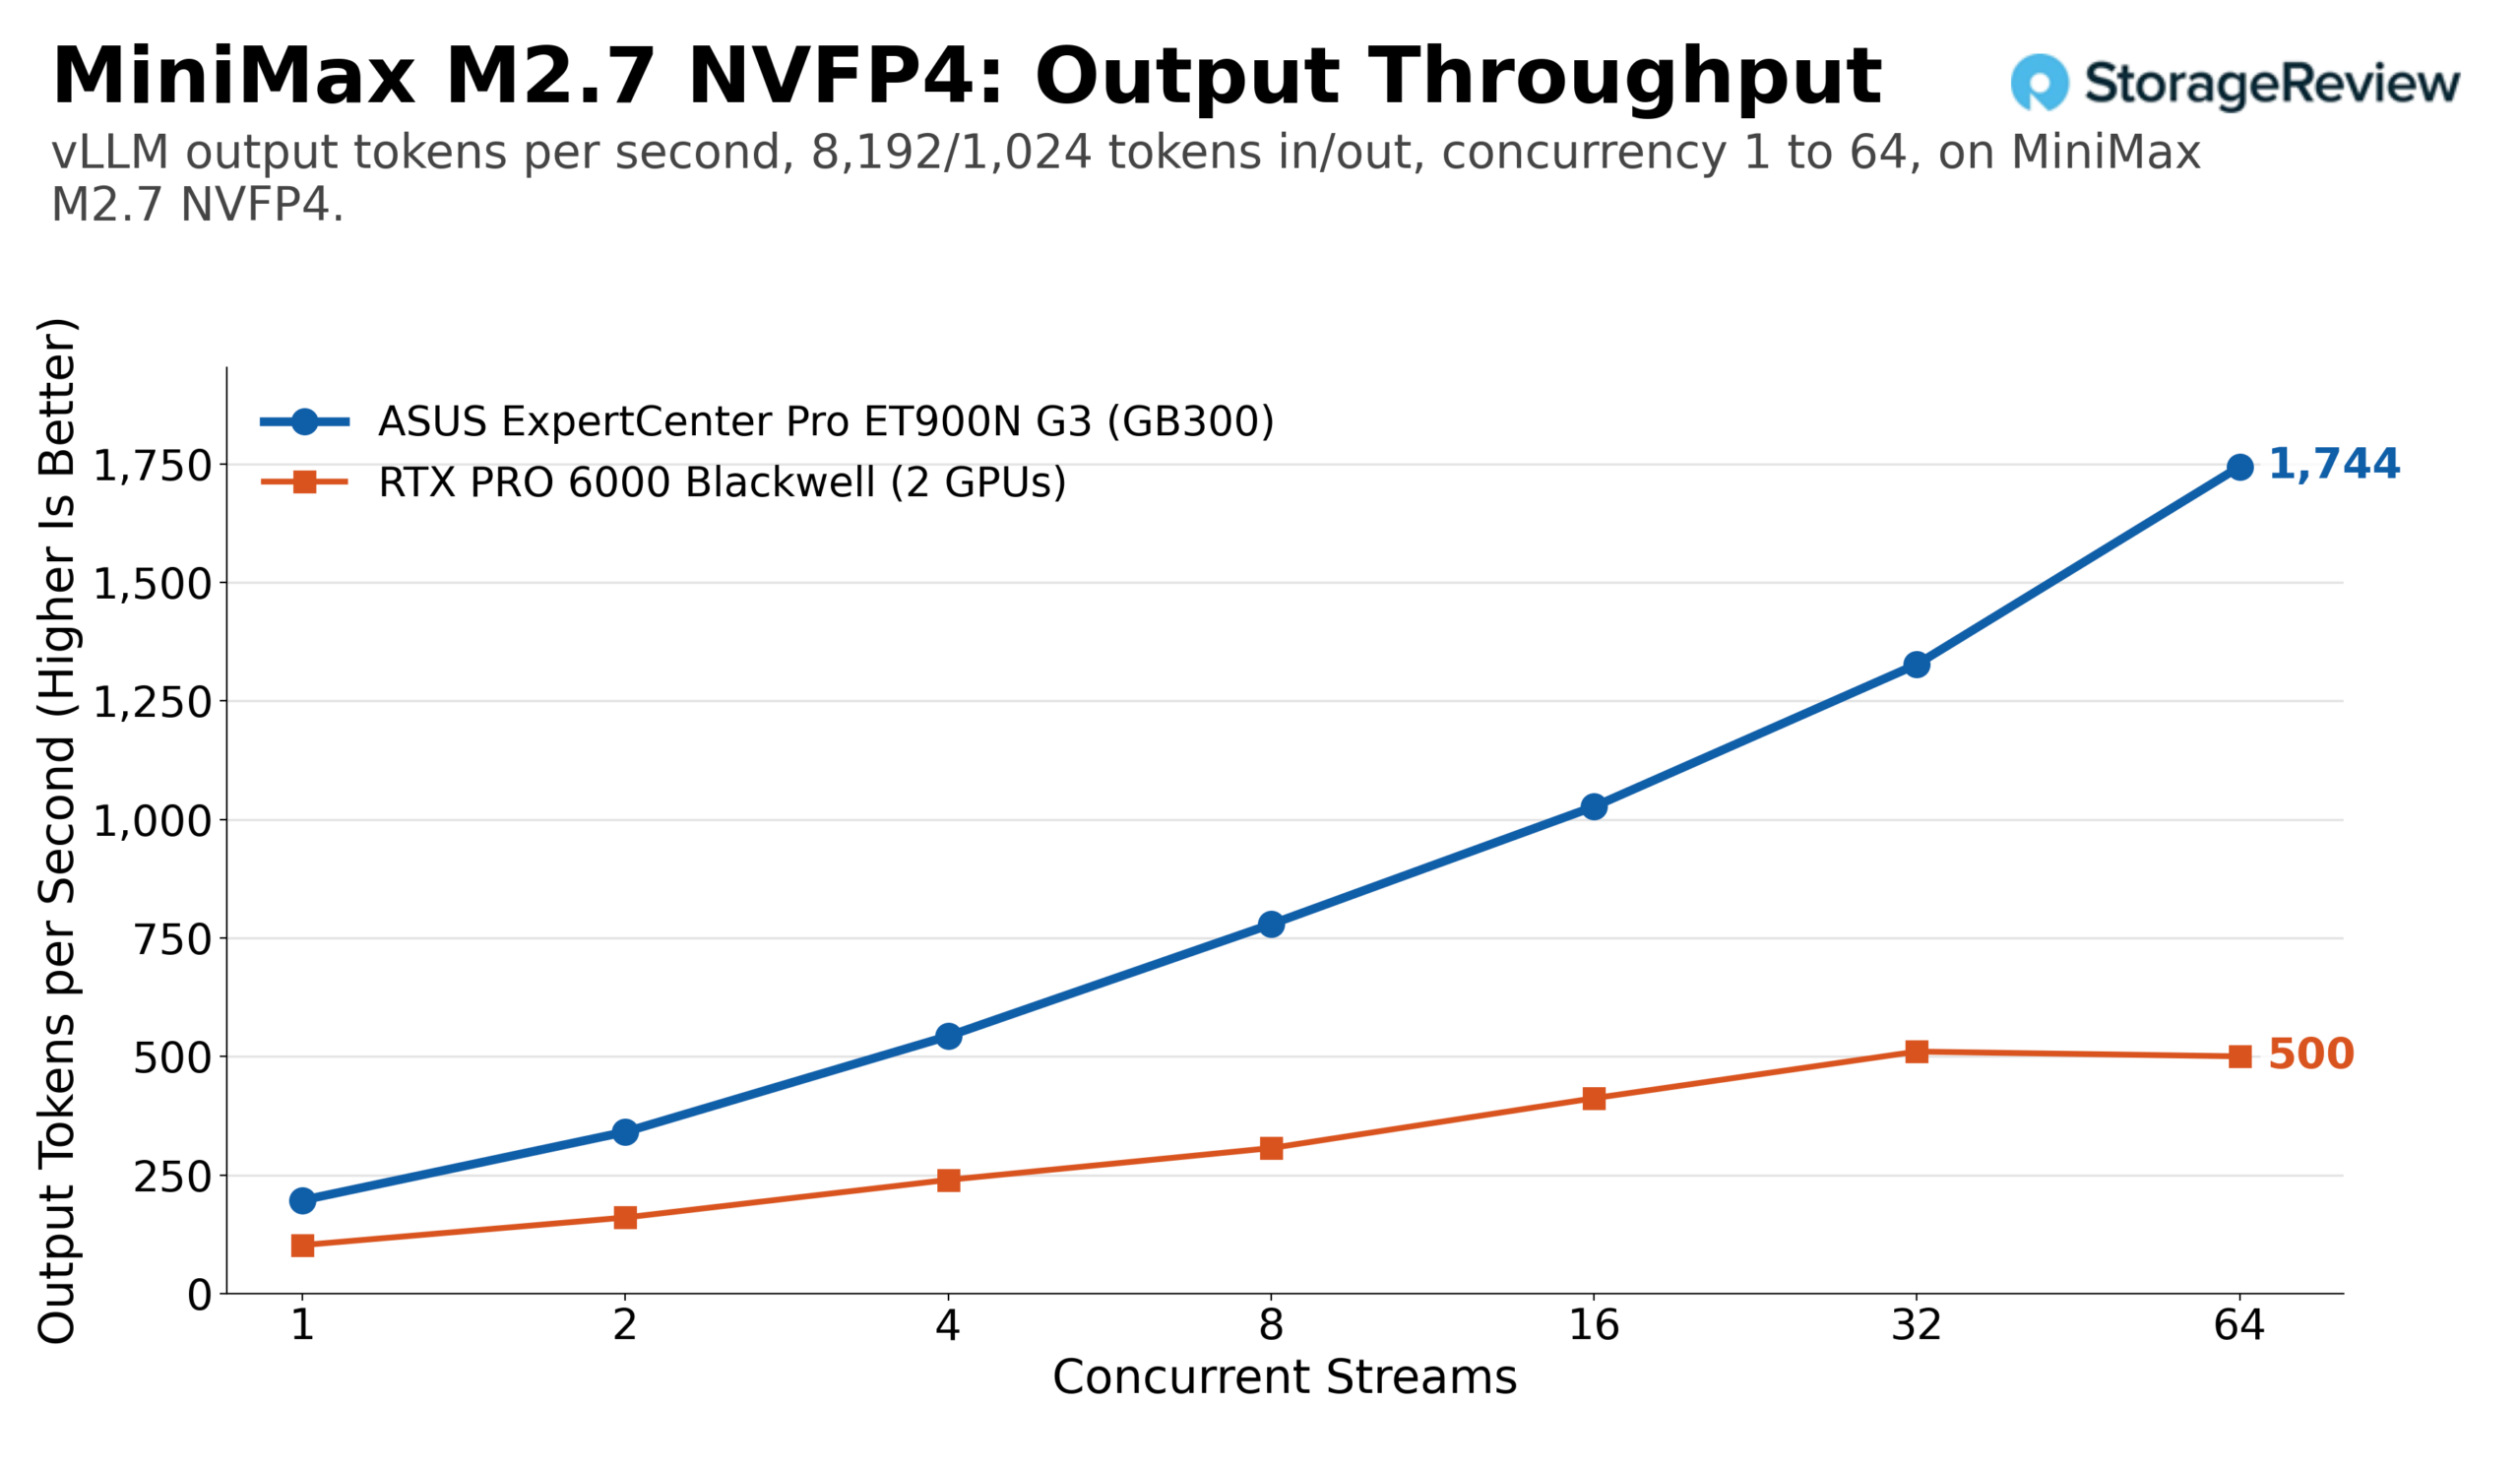
MiniMax M2.7 v kvantizaci NVIDIA NVFP4 zabírá přibližně 125 GB HBM a škáloval se nejdále ze čtyř. Stejná pracovní zátěž se zvýšila z 214 výstupních tokenů za sekundu na jednom streamu na 4 793 na 128 streamech a celková propustnost dosáhla 9 586. Běh s velkým počtem předfillů se škáloval na 1 744 výstupních tokenů za sekundu a celkem 15 700 tokenů za sekundu při 64 streamech. Dvě karty RTX PRO 6000 sledovaly stejný tvar na méně než polovině výšky, s maximem kolem 1 930 výstupních tokenů za sekundu při stejné pracovní zátěži a přibližně 510 na dlouhých promptách.
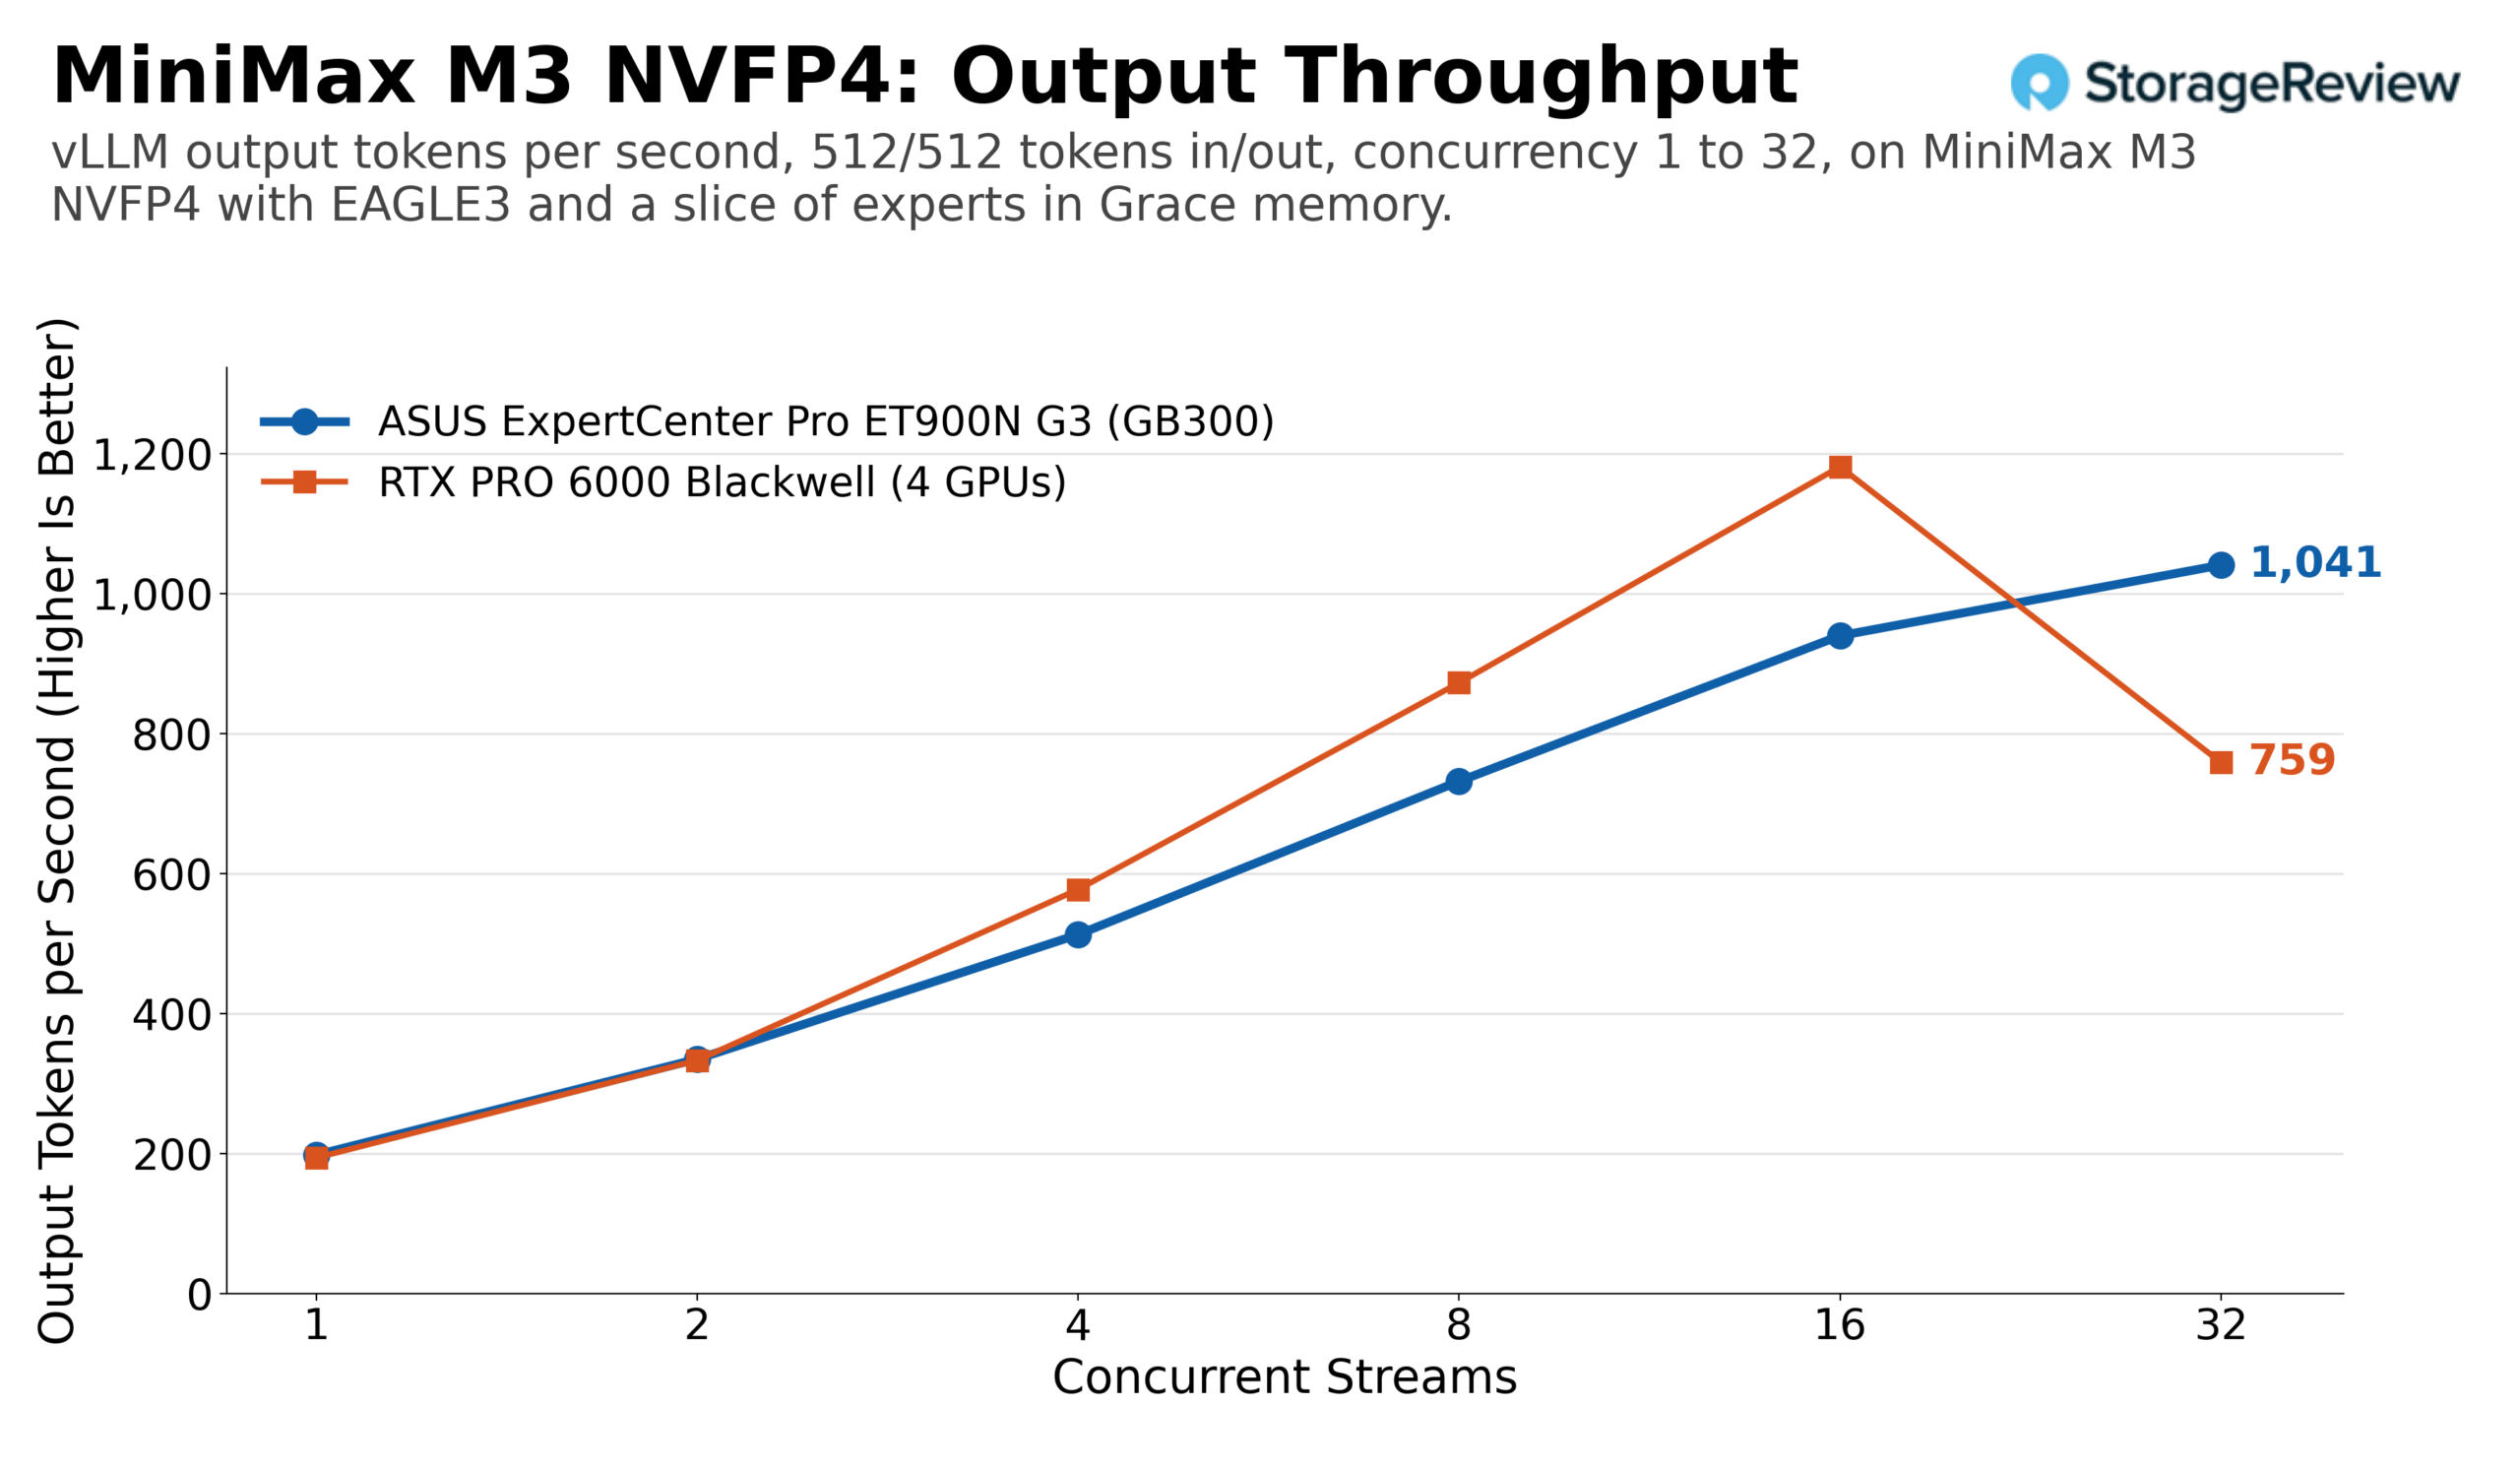
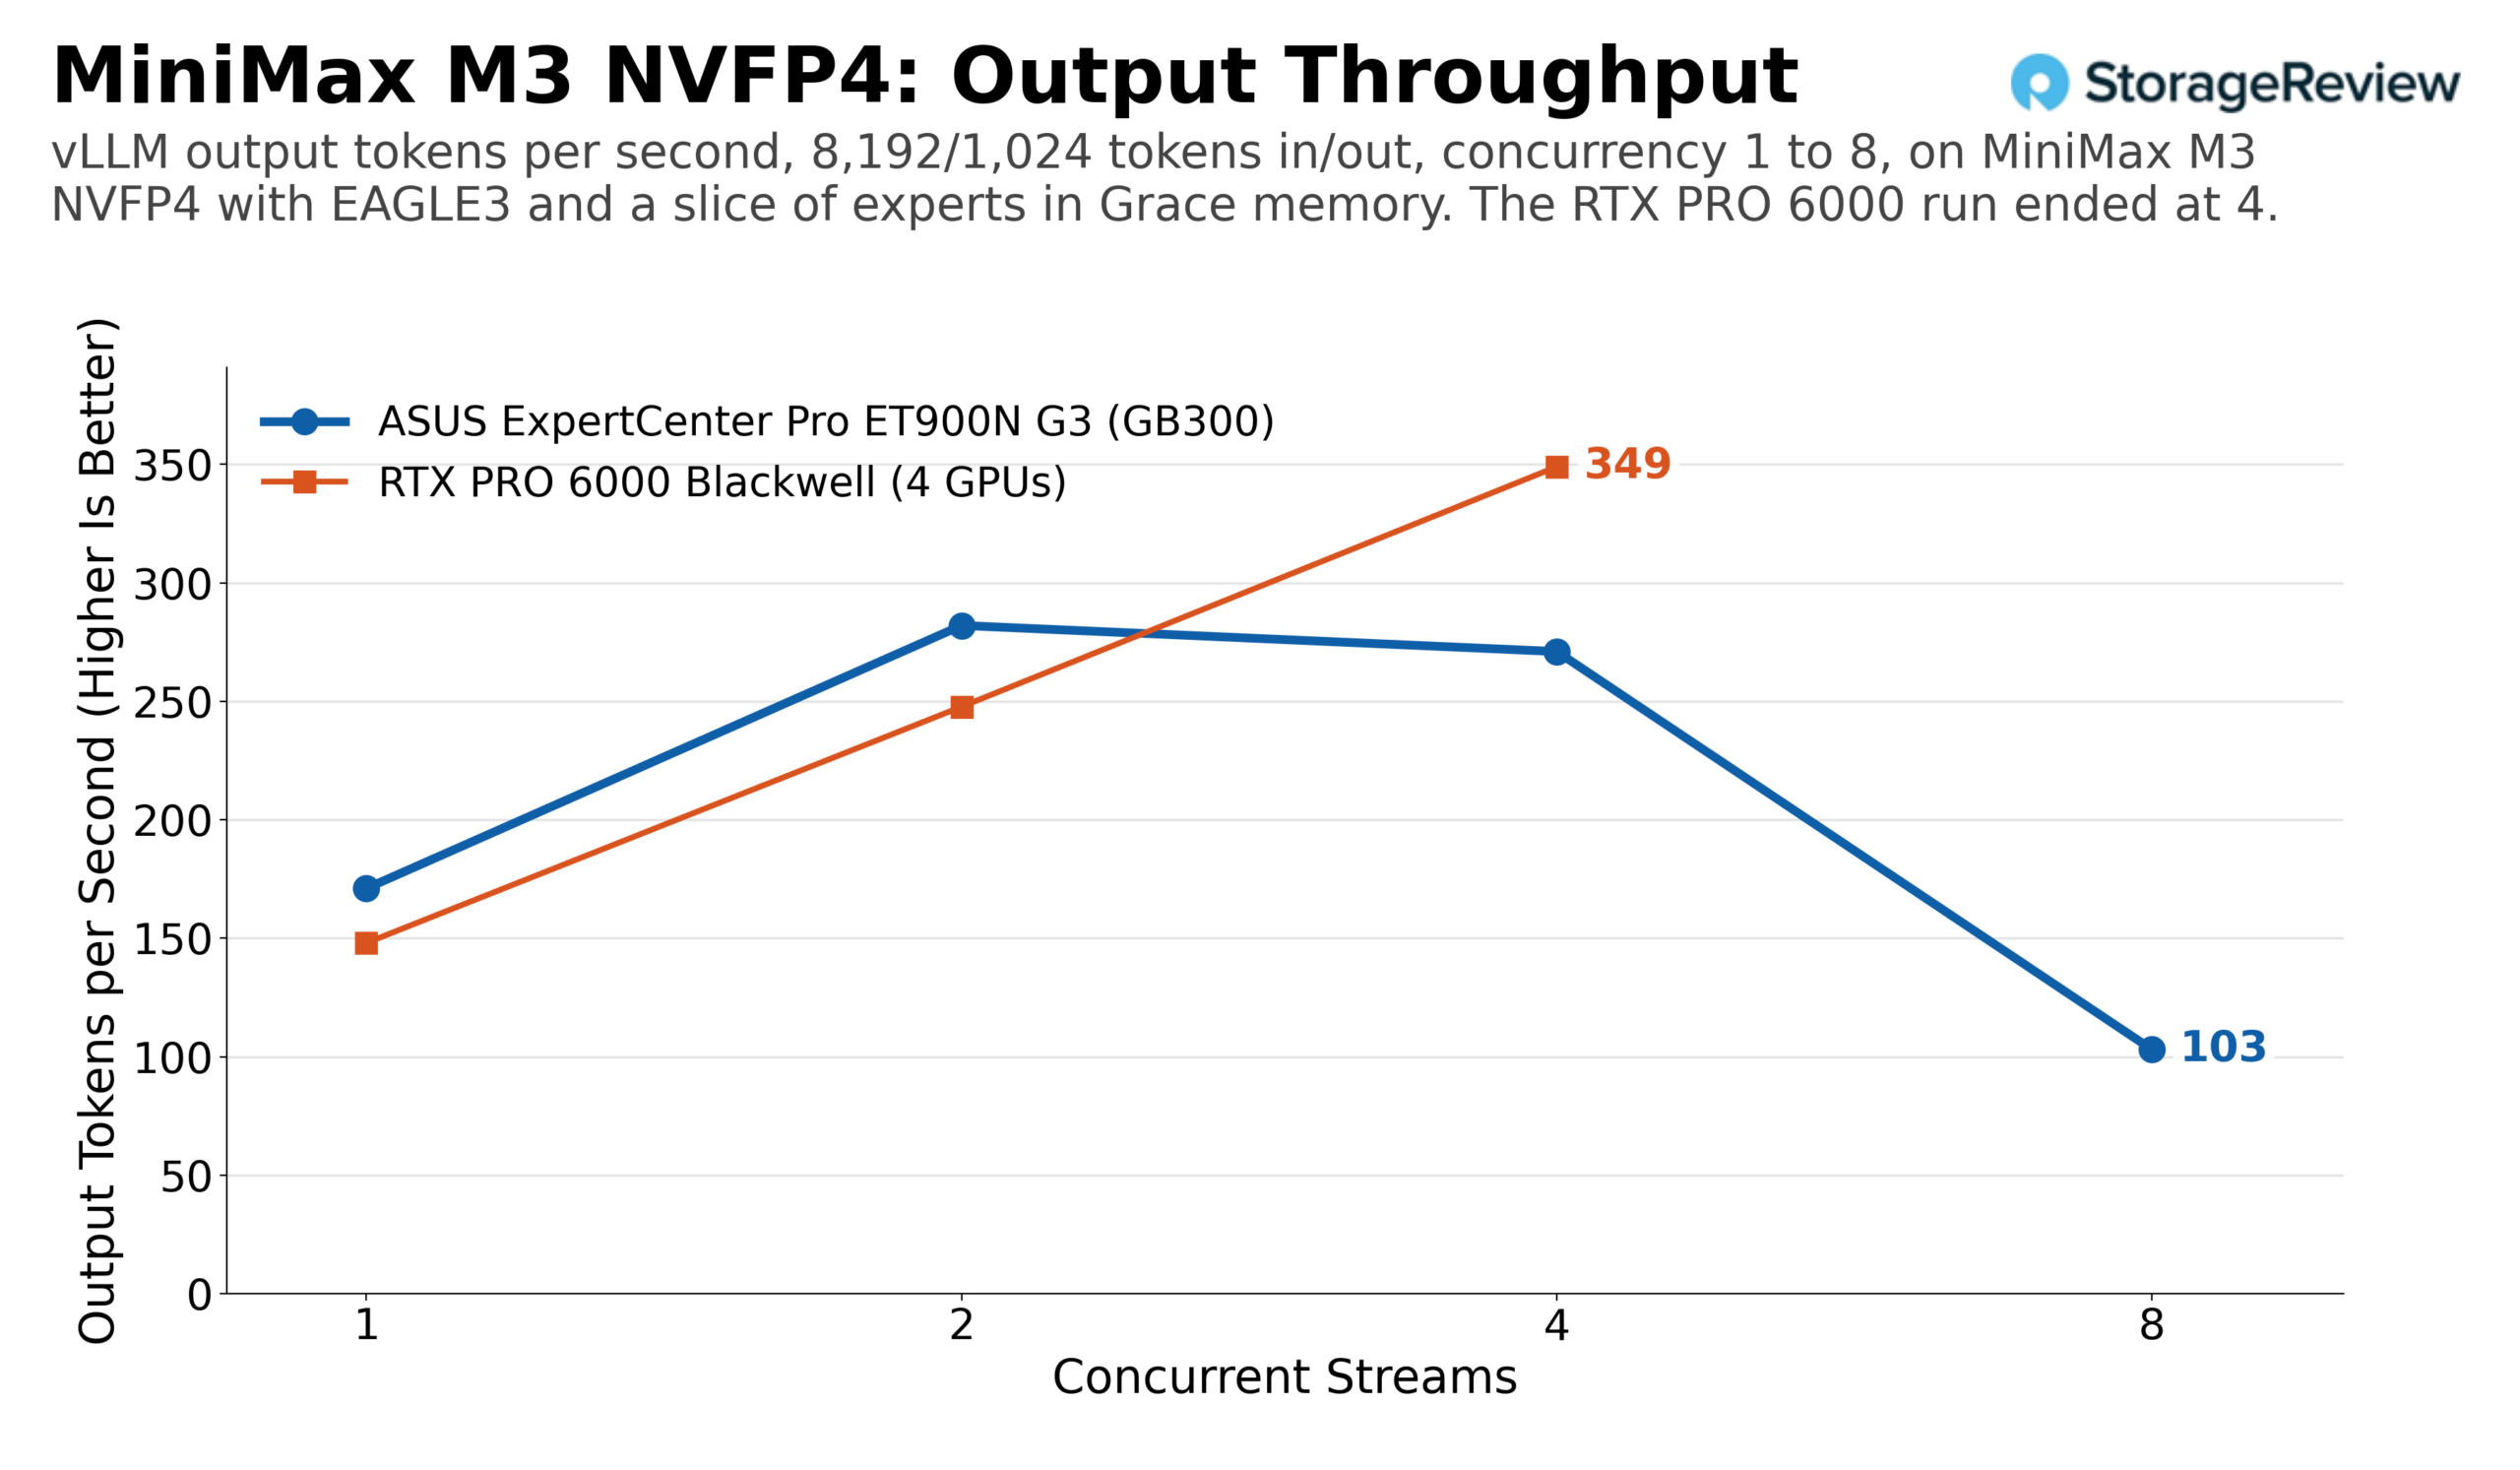
MiniMax M3 ukazuje, jaké to je sotva se vejít do paměti. Kontrolní bod NVFP4 je menší než 252 GB, ale běhová a KV mezipaměť také potřebují místo, takže část expertů se nachází v paměti Grace a každý krok dekódování, který se jich dotkne, prochází NVLink-C2C. Se spekulativním dekódováním EAGLE3 dosáhl ET900N G3 1 041 výstupních tokenů za sekundu při 32 streamech při stejném zatížení a profil s vysokým počtem předfillů dosáhl vrcholu 282 při dvou streamech, udržel se na 271 při čtyřech a klesl na 103 při osmi, protože dlouhé prompty spotřebovaly zbývající mezipaměť. Čtyři karty RTX PRO 6000 se stejným spekulativním dekodérem držely krok s osmi streamy a u 16 streamů se dostaly dopředu s přibližně 1 180 výstupními tokeny za sekundu, poté klesly zpět na zhruba 760 při 32 streamech. V profilu s vysokým počtem předfillů pojala čtyřkartová krabice přibližně 349 výstupních tokenů za sekundu ve čtyřech streamech oproti 271 u stanice. Model, který se nachází přímo na hranici HBM, je jediným místem v této sadě, kde 384 GB VRAM na čtyřech kartách konkuruje 252 GB HBM plus offload.
GLM-5.2 je případ použití, který umožňuje pouze koherentní fond. Kontrolní bod NVFP4 uchovává v paměti Grace přibližně 215 GB expertních vah se spekulativním dekódováním MTP a ET900N G3 jej obsluhoval rychlostí 35 výstupních tokenů za sekundu pro jeden stream a 139 pro 32 streamů při stejném zatížení, s celkovou propustností 277. V profilu s vysokým počtem předfillů se sweep protáhl na 32 streamů, dosáhl 120 výstupních tokenů za sekundu a celkem 1 079 tokenů. Čtyři karty RTX PRO 6000, z nichž každá uvolňovala přibližně 30 GB do hostitelské paměti, zvládly přibližně 40 výstupních tokenů za sekundu při 32 streamech, přičemž u dlouhých výzev od čtyř streamů dále se toto číslo zploštilo na zhruba 9 až 10. Ani jeden ze systémů nedává pocit, že by 433GB model působil rychle, ale GB300 s 396GB/s LPDDR5X a 900GB/s NVLink-C2C pro experty s nízkým zatížením se stále škáluje tam, kde končí hostitelská paměť připojená k PCIe napříč čtyřmi kartami.
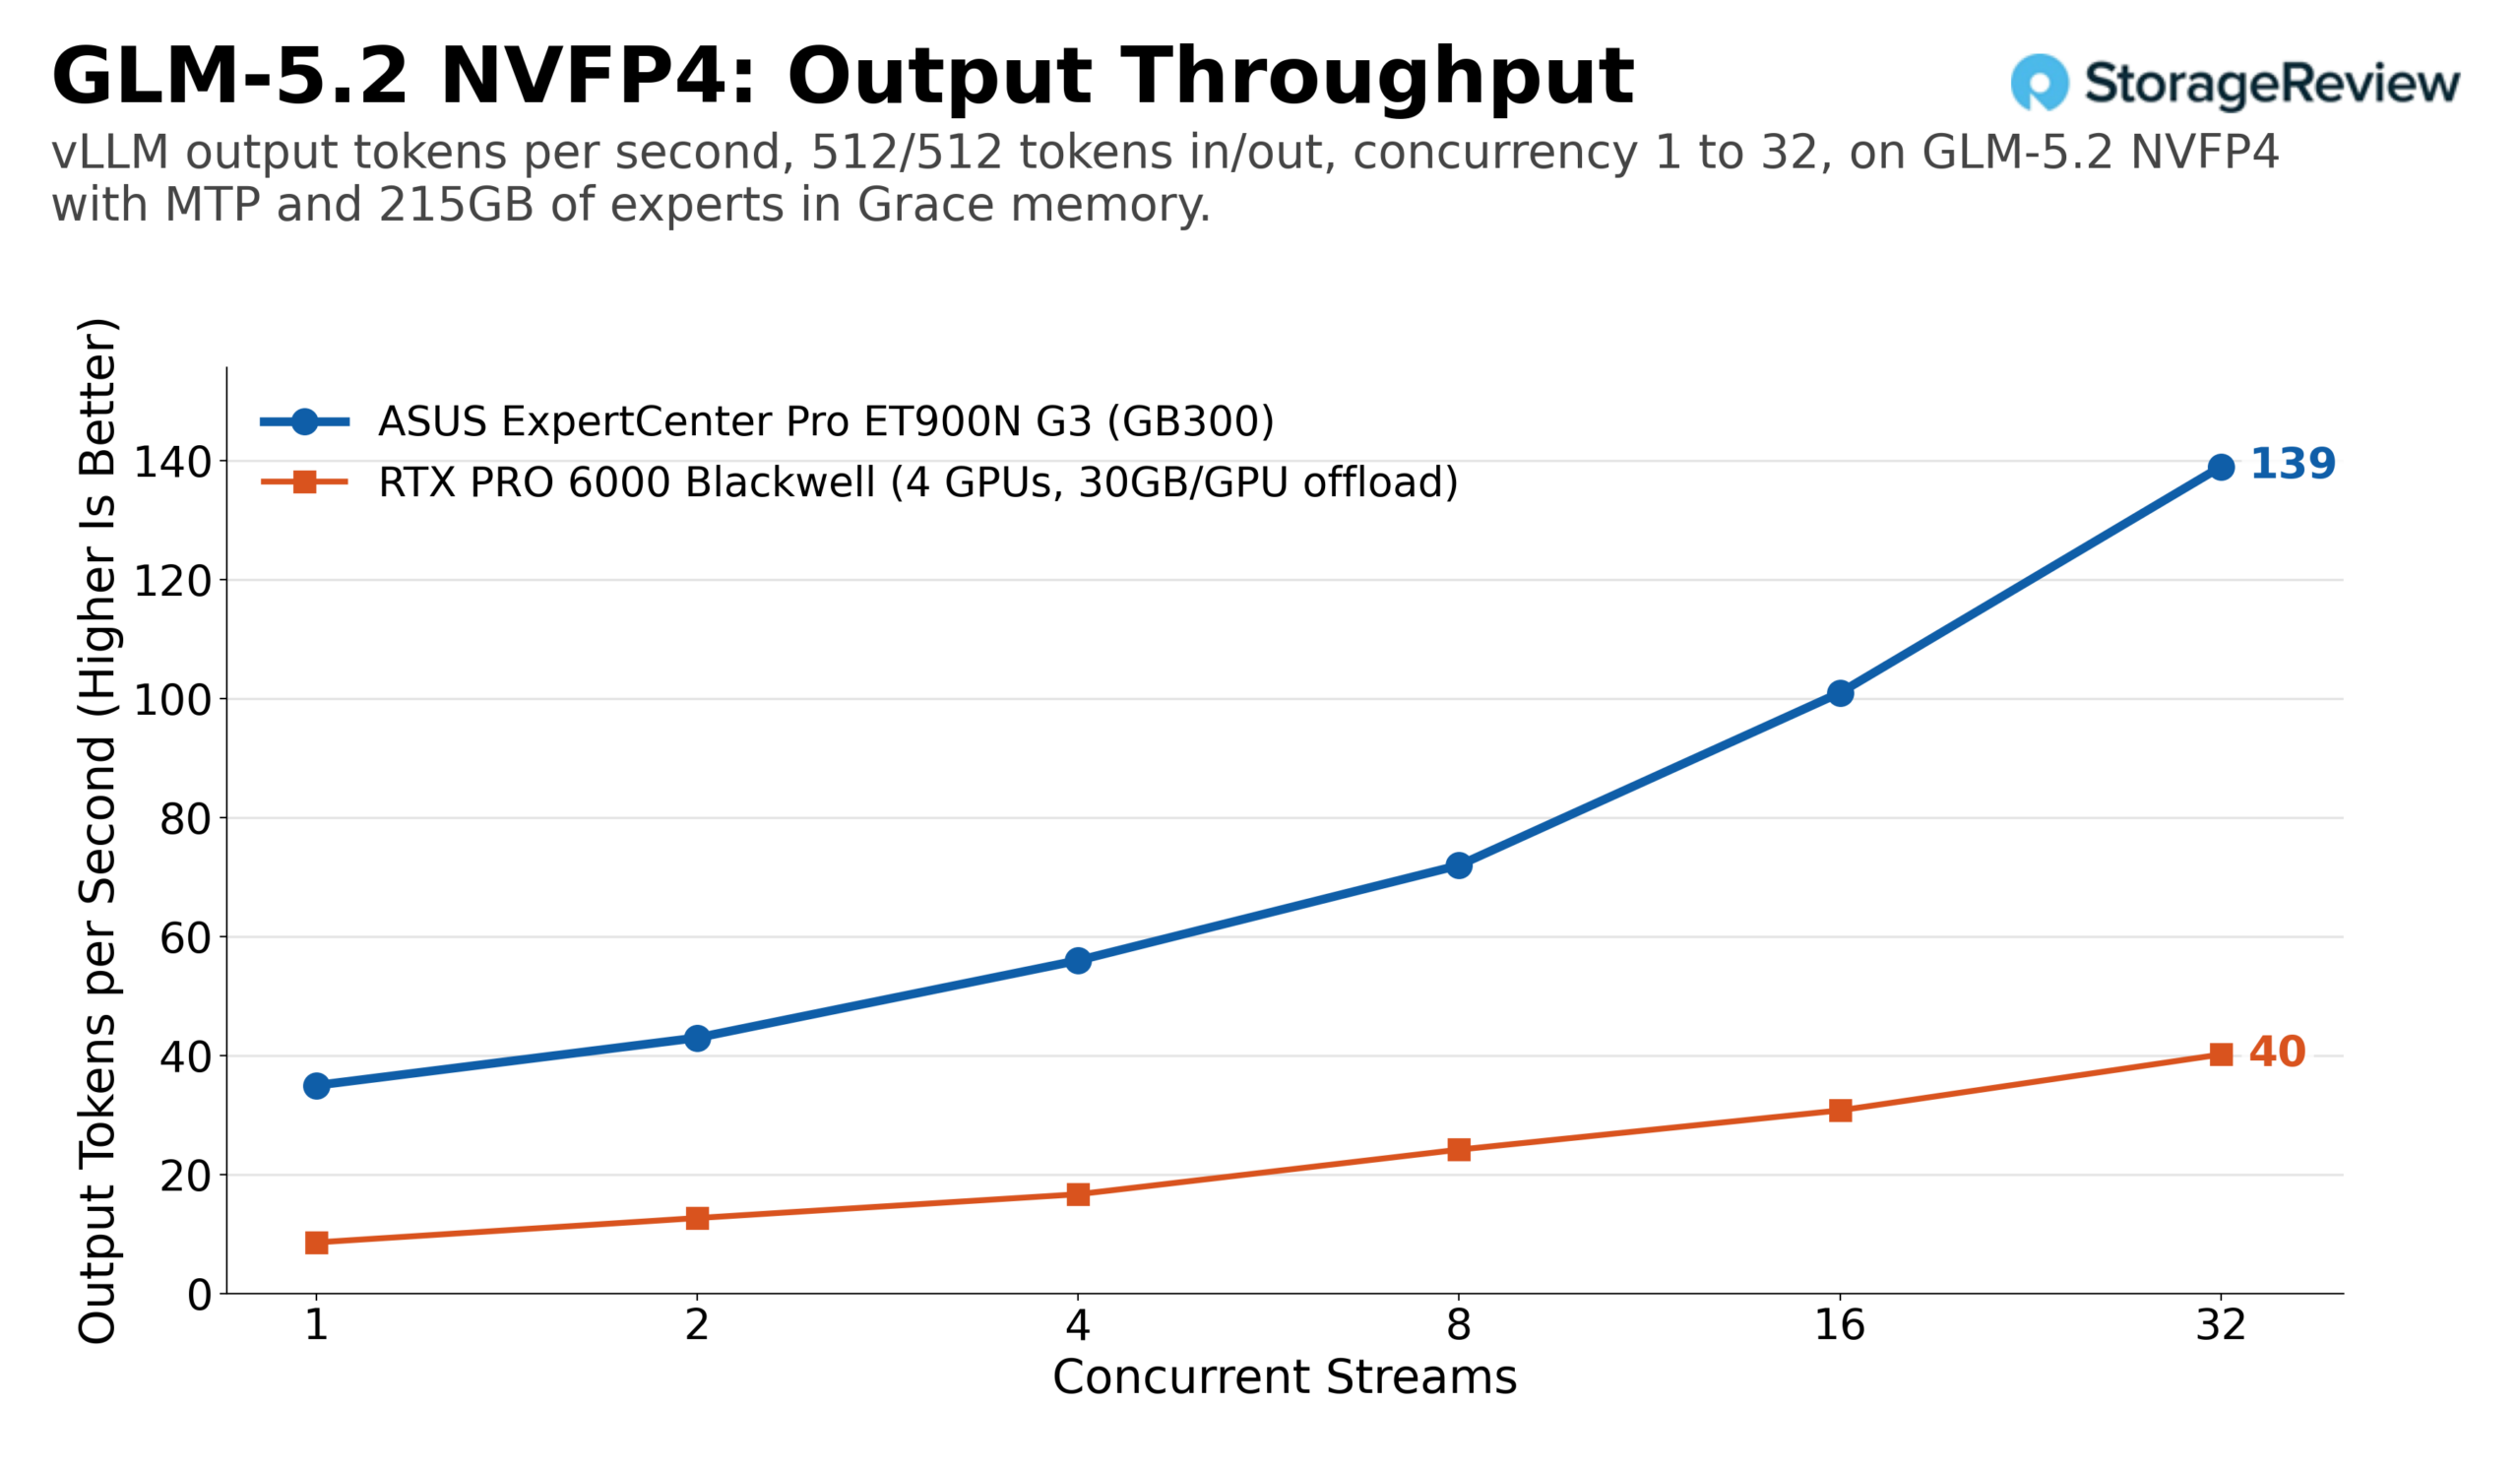
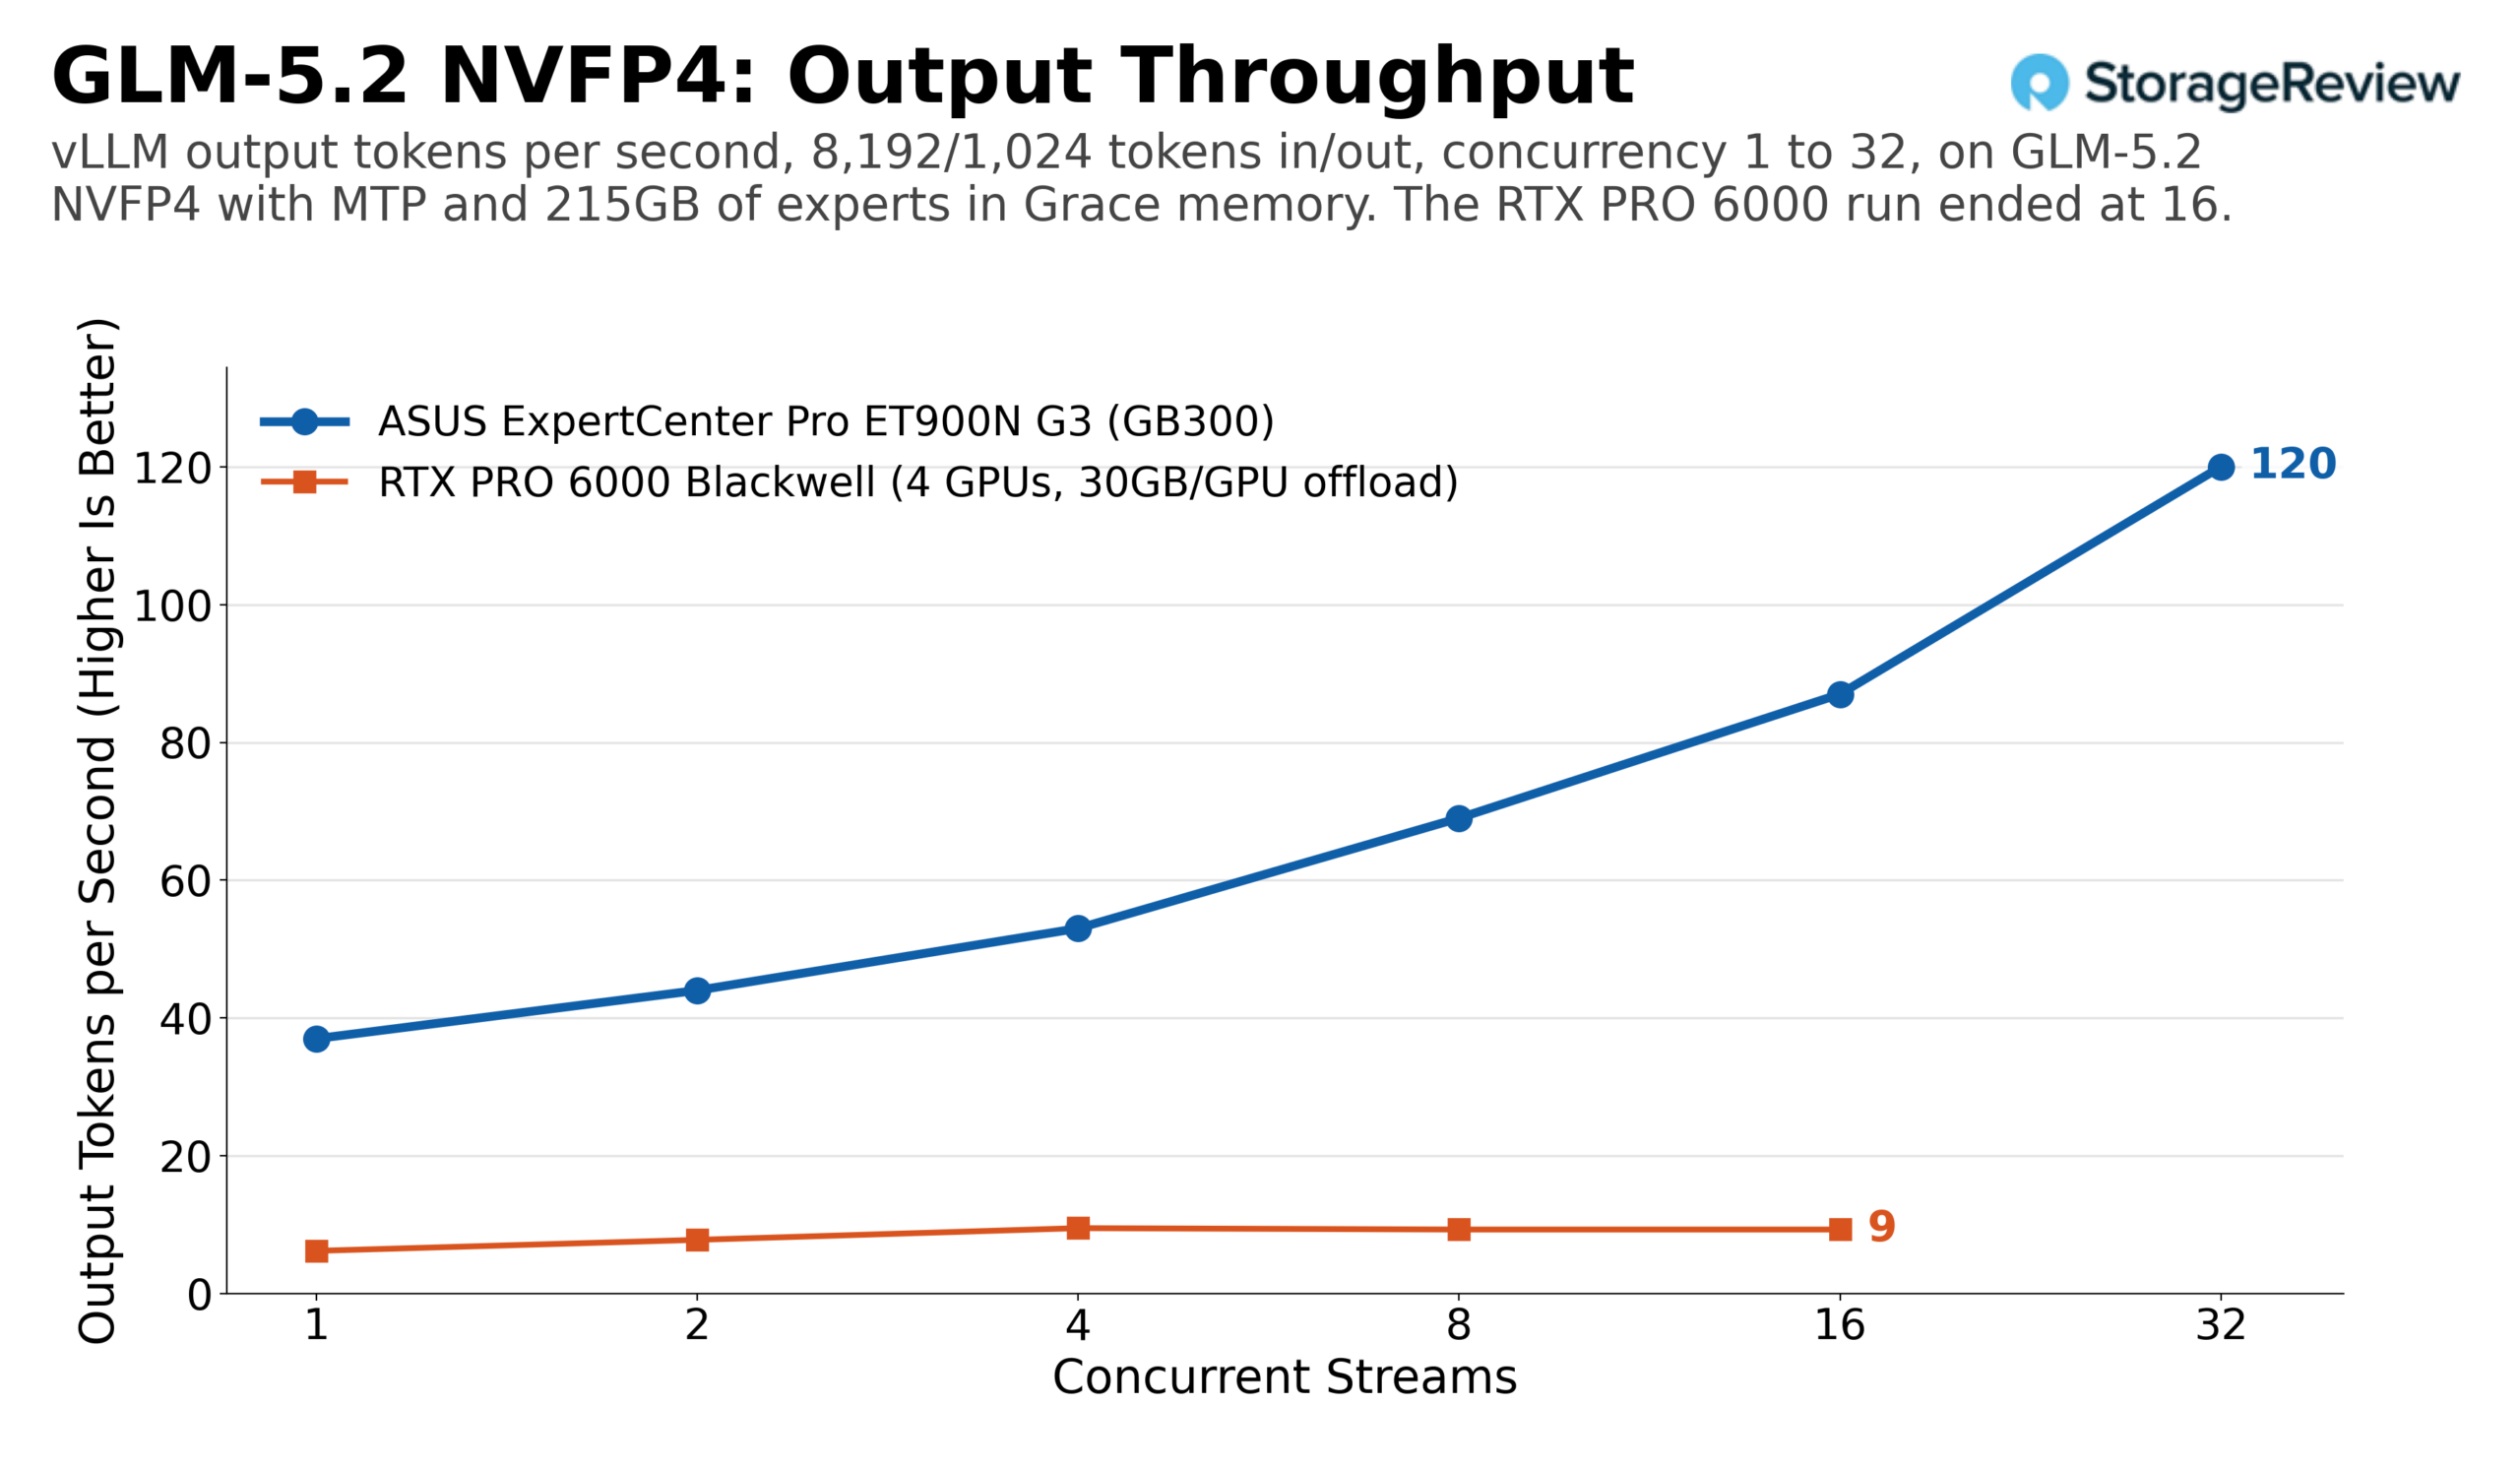
V porovnání s MSI WS300 se výsledky hraničního modelu ET900N G3 v každém bodě, který můžeme porovnat, pohybují v rozmezí přibližně 1 %: 1 766 výstupních tokenů za sekundu na DeepSeek V4 Flash při 32 streamech na obou věžích, 4 793 oproti 4 801 na MiniMax M2.7 při 128, 1 041 na MiniMax M3 při 32 streamech na obou a 139 na GLM-5.2 při 32 streamech na obou.
Sdílené modely proti RTX PRO 6000, H200 NVL a DGX Spark
Druhá polovina benchmarkingu využívá modely dostatečně malé pro každý systém: GPT-OSS-20B a 120B v nativním MXFP4; Llama 3.1 8B v BF16 a FP8; Mistral Small 24B v BF16 a FP8; a Qwen3 Coder 30B v BF16 a FP8. Novinkou od recenze WS300 je jediná NVL karta H200, karta NVIDIA se 141GB Hopper, která srovnání poskytuje akcelerátor datových center o generaci zpět.
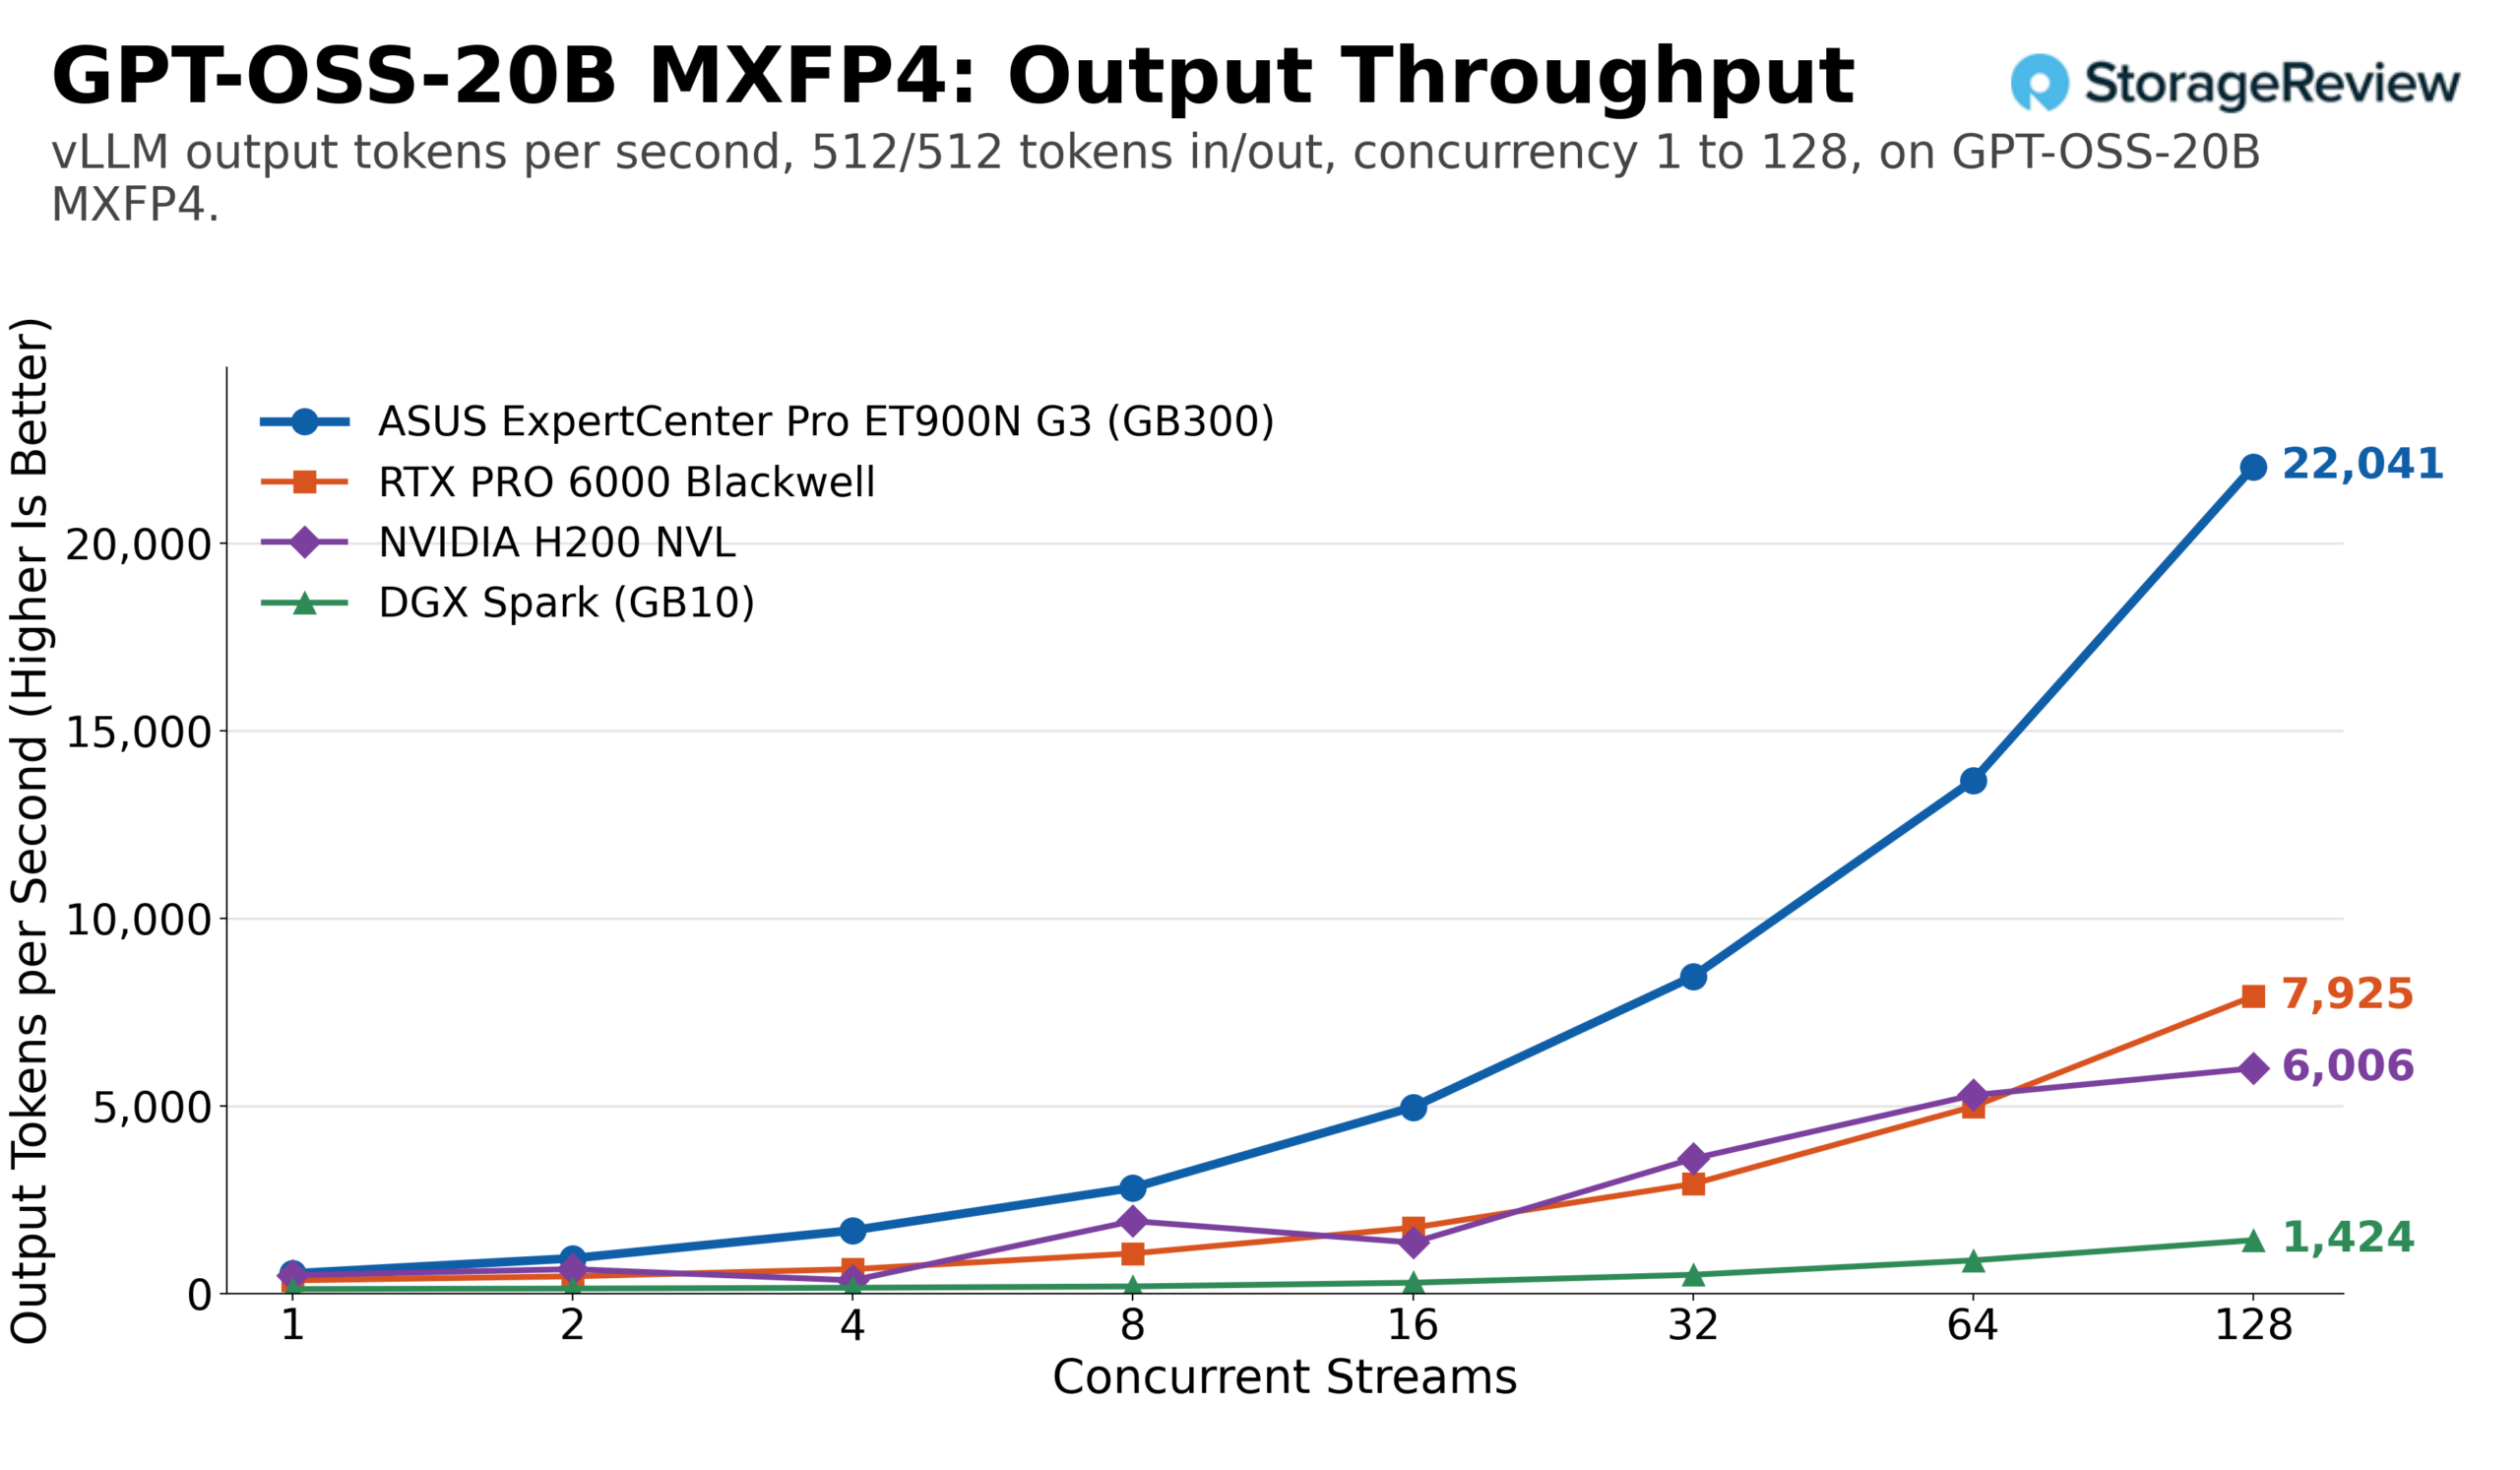
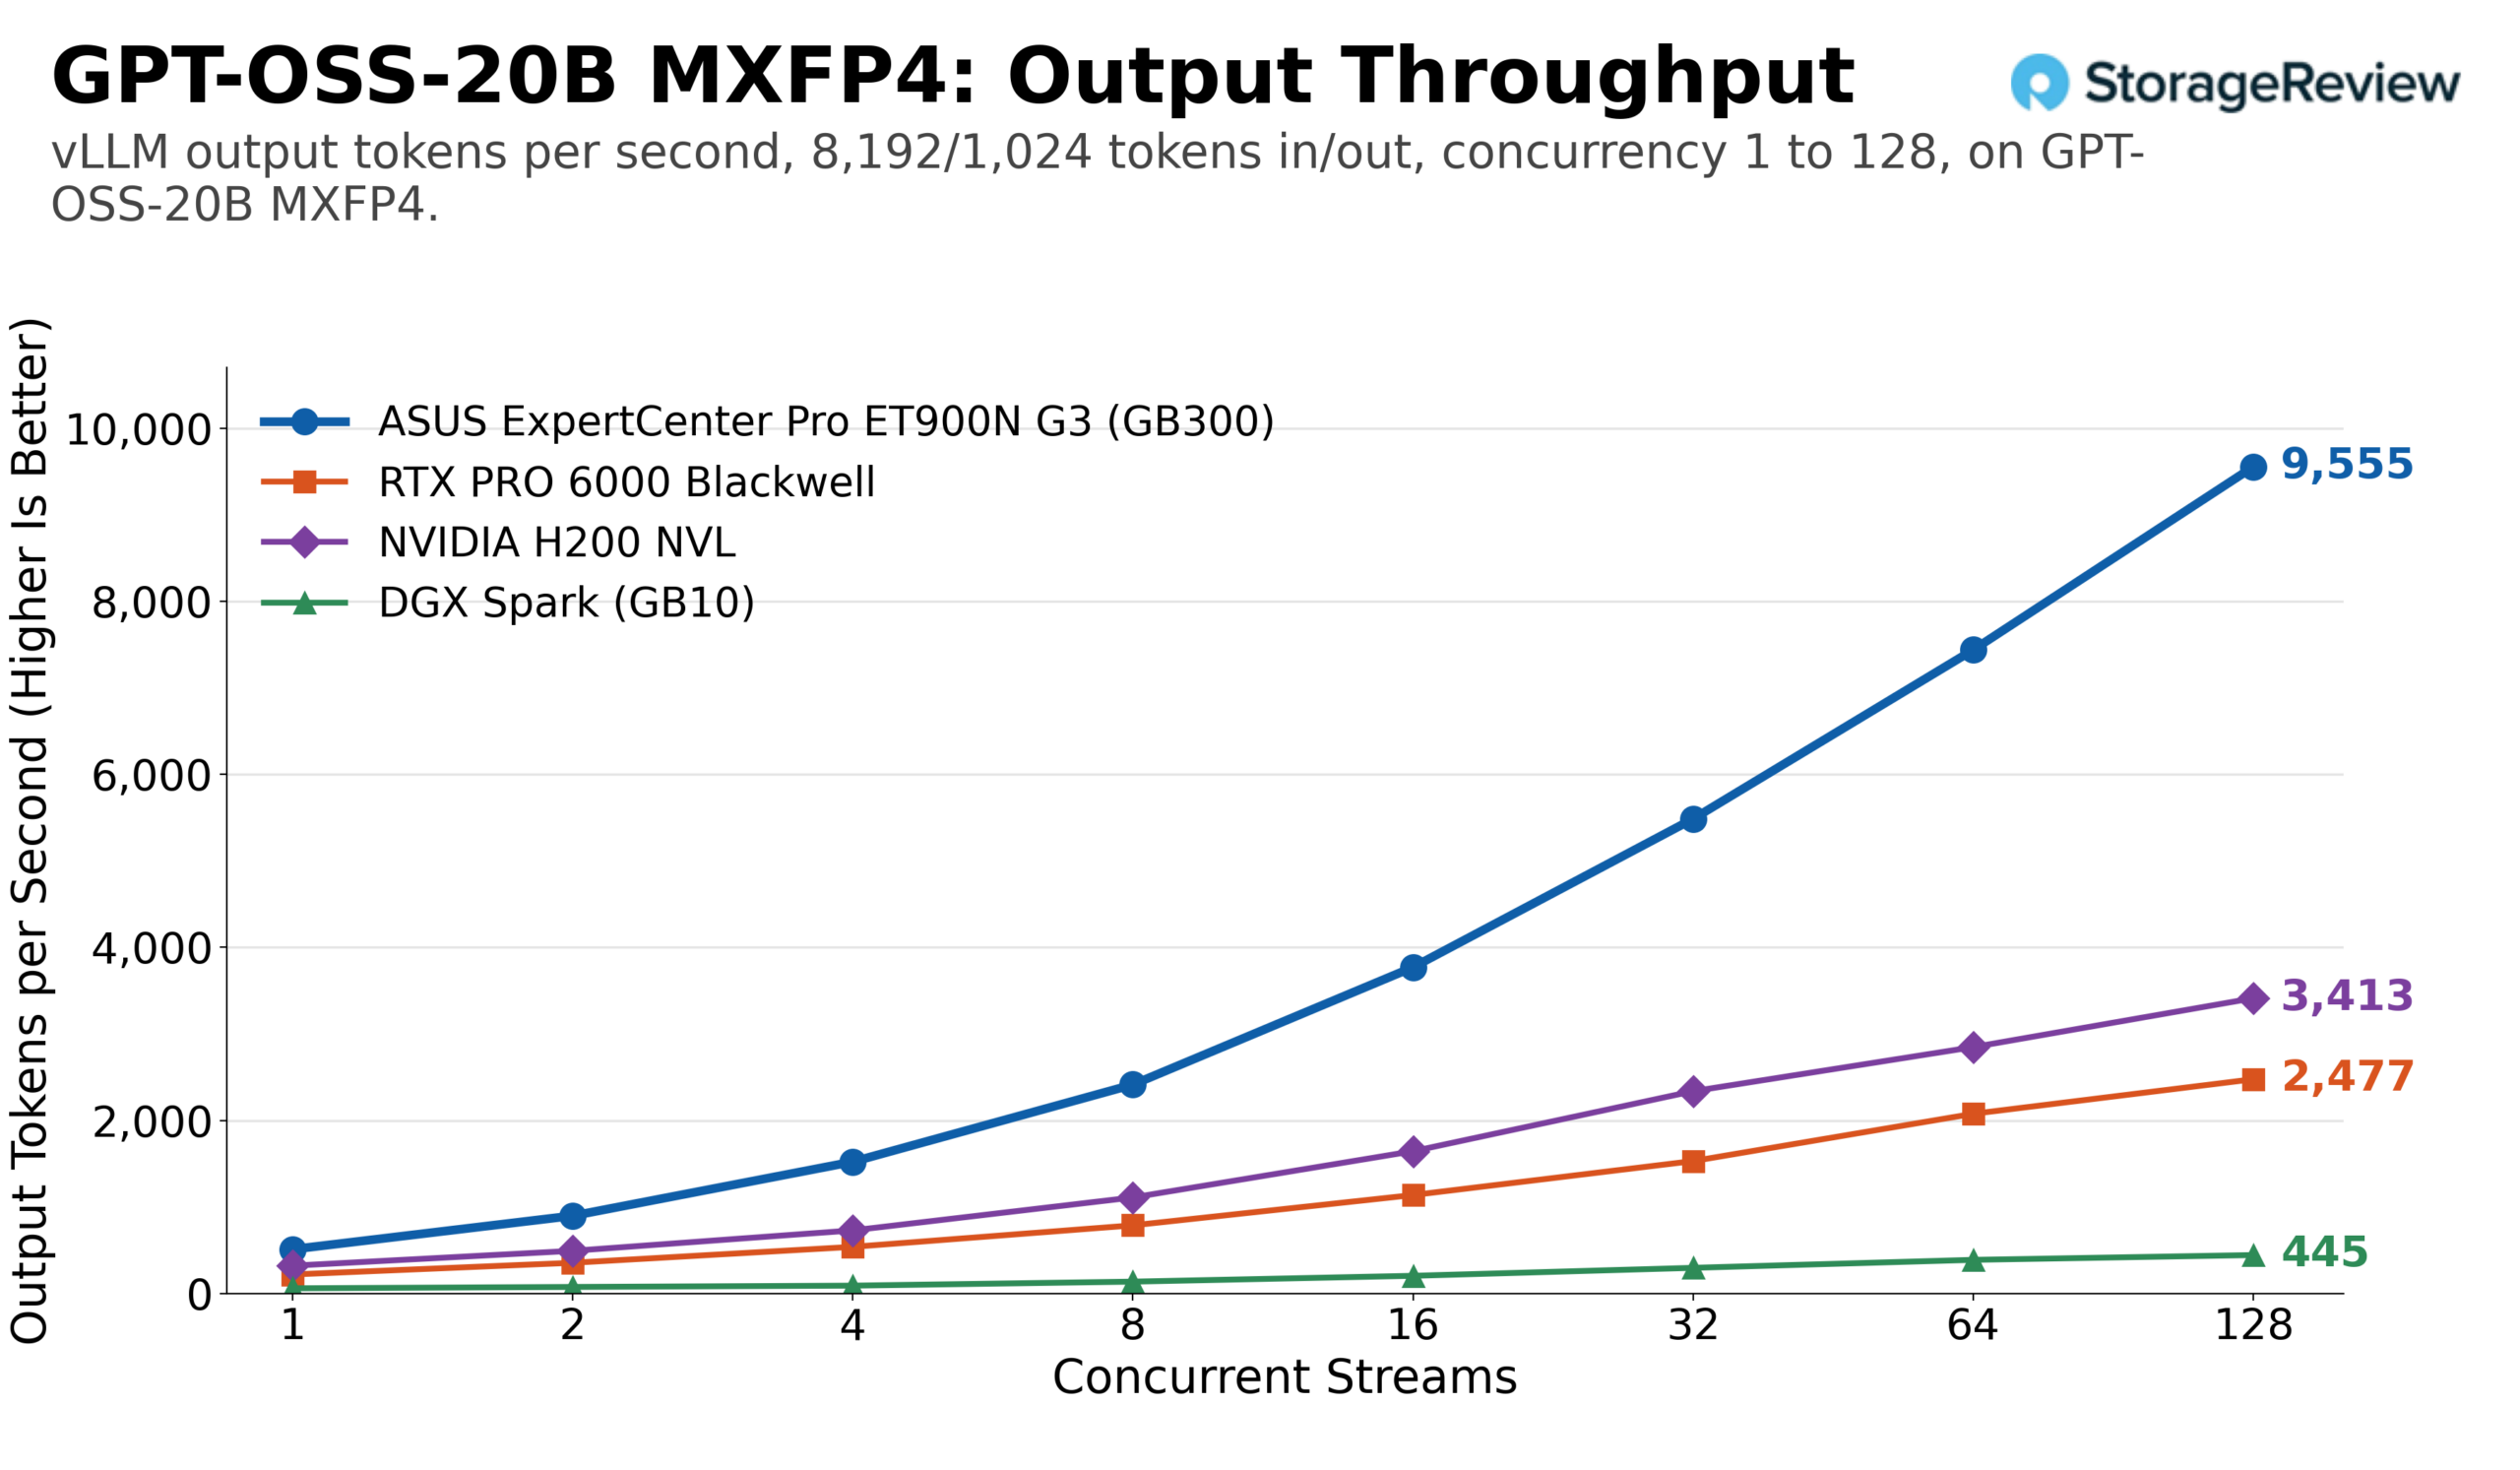
GPT-OSS-20B je nejpřátelštější test ze sady, kontrolní bod, který každý systém pohodlně zvládne, a při stejném zatížení se ET900N G3 škáloval na 22 041 výstupních tokenů za sekundu při 128 streamech, celkem tedy 44 082, oproti přibližně 7 920 u RTX PRO 6000, 6 010 u H200 NVL a 1 420 u DGX Spark. V režimu jednoho streamu stanice vyprodukovala 536 výstupních tokenů za sekundu, ve srovnání s 354 u karty, 489 u H200 a 120 u Sparku. Profil s vysokým počtem předfillů rozdíl dále prohloubil: 9 555 výstupních tokenů za sekundu a celkem 85 994 při 128 streamech pro stanici, přičemž RTX PRO 6000 dosáhla přibližně 2 480, H200 NVL 3 410 a Spark 445.
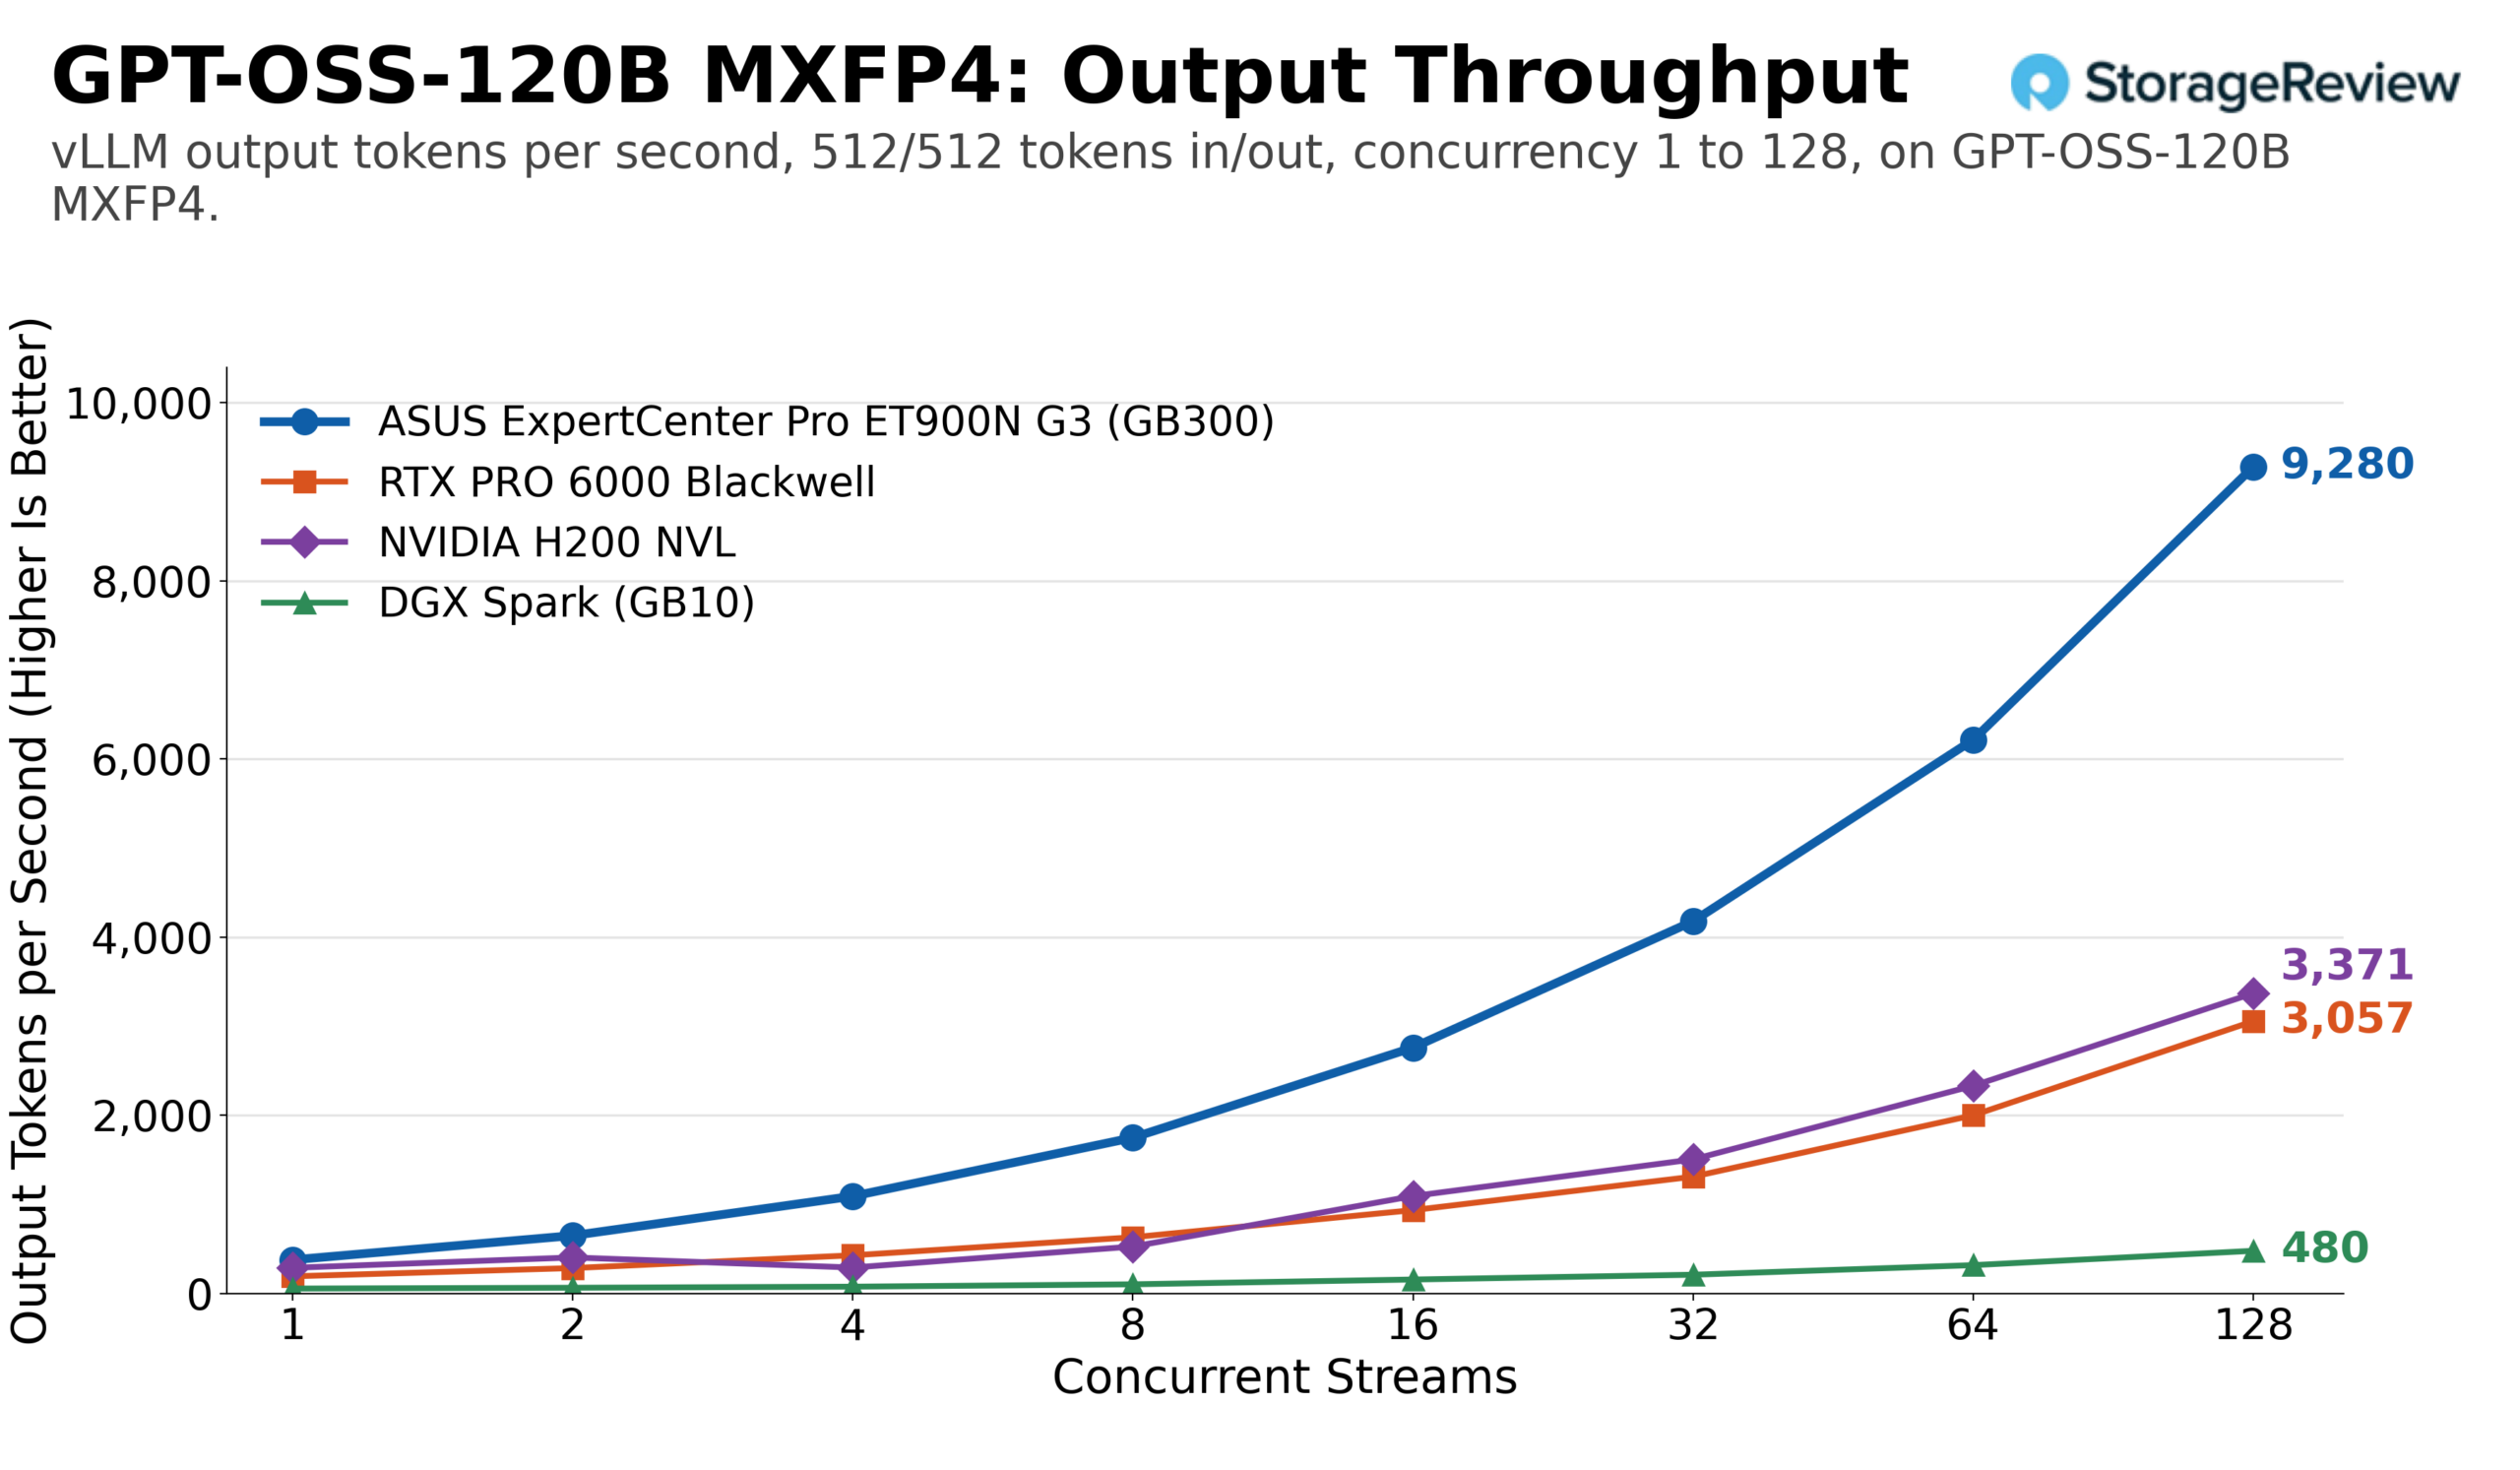
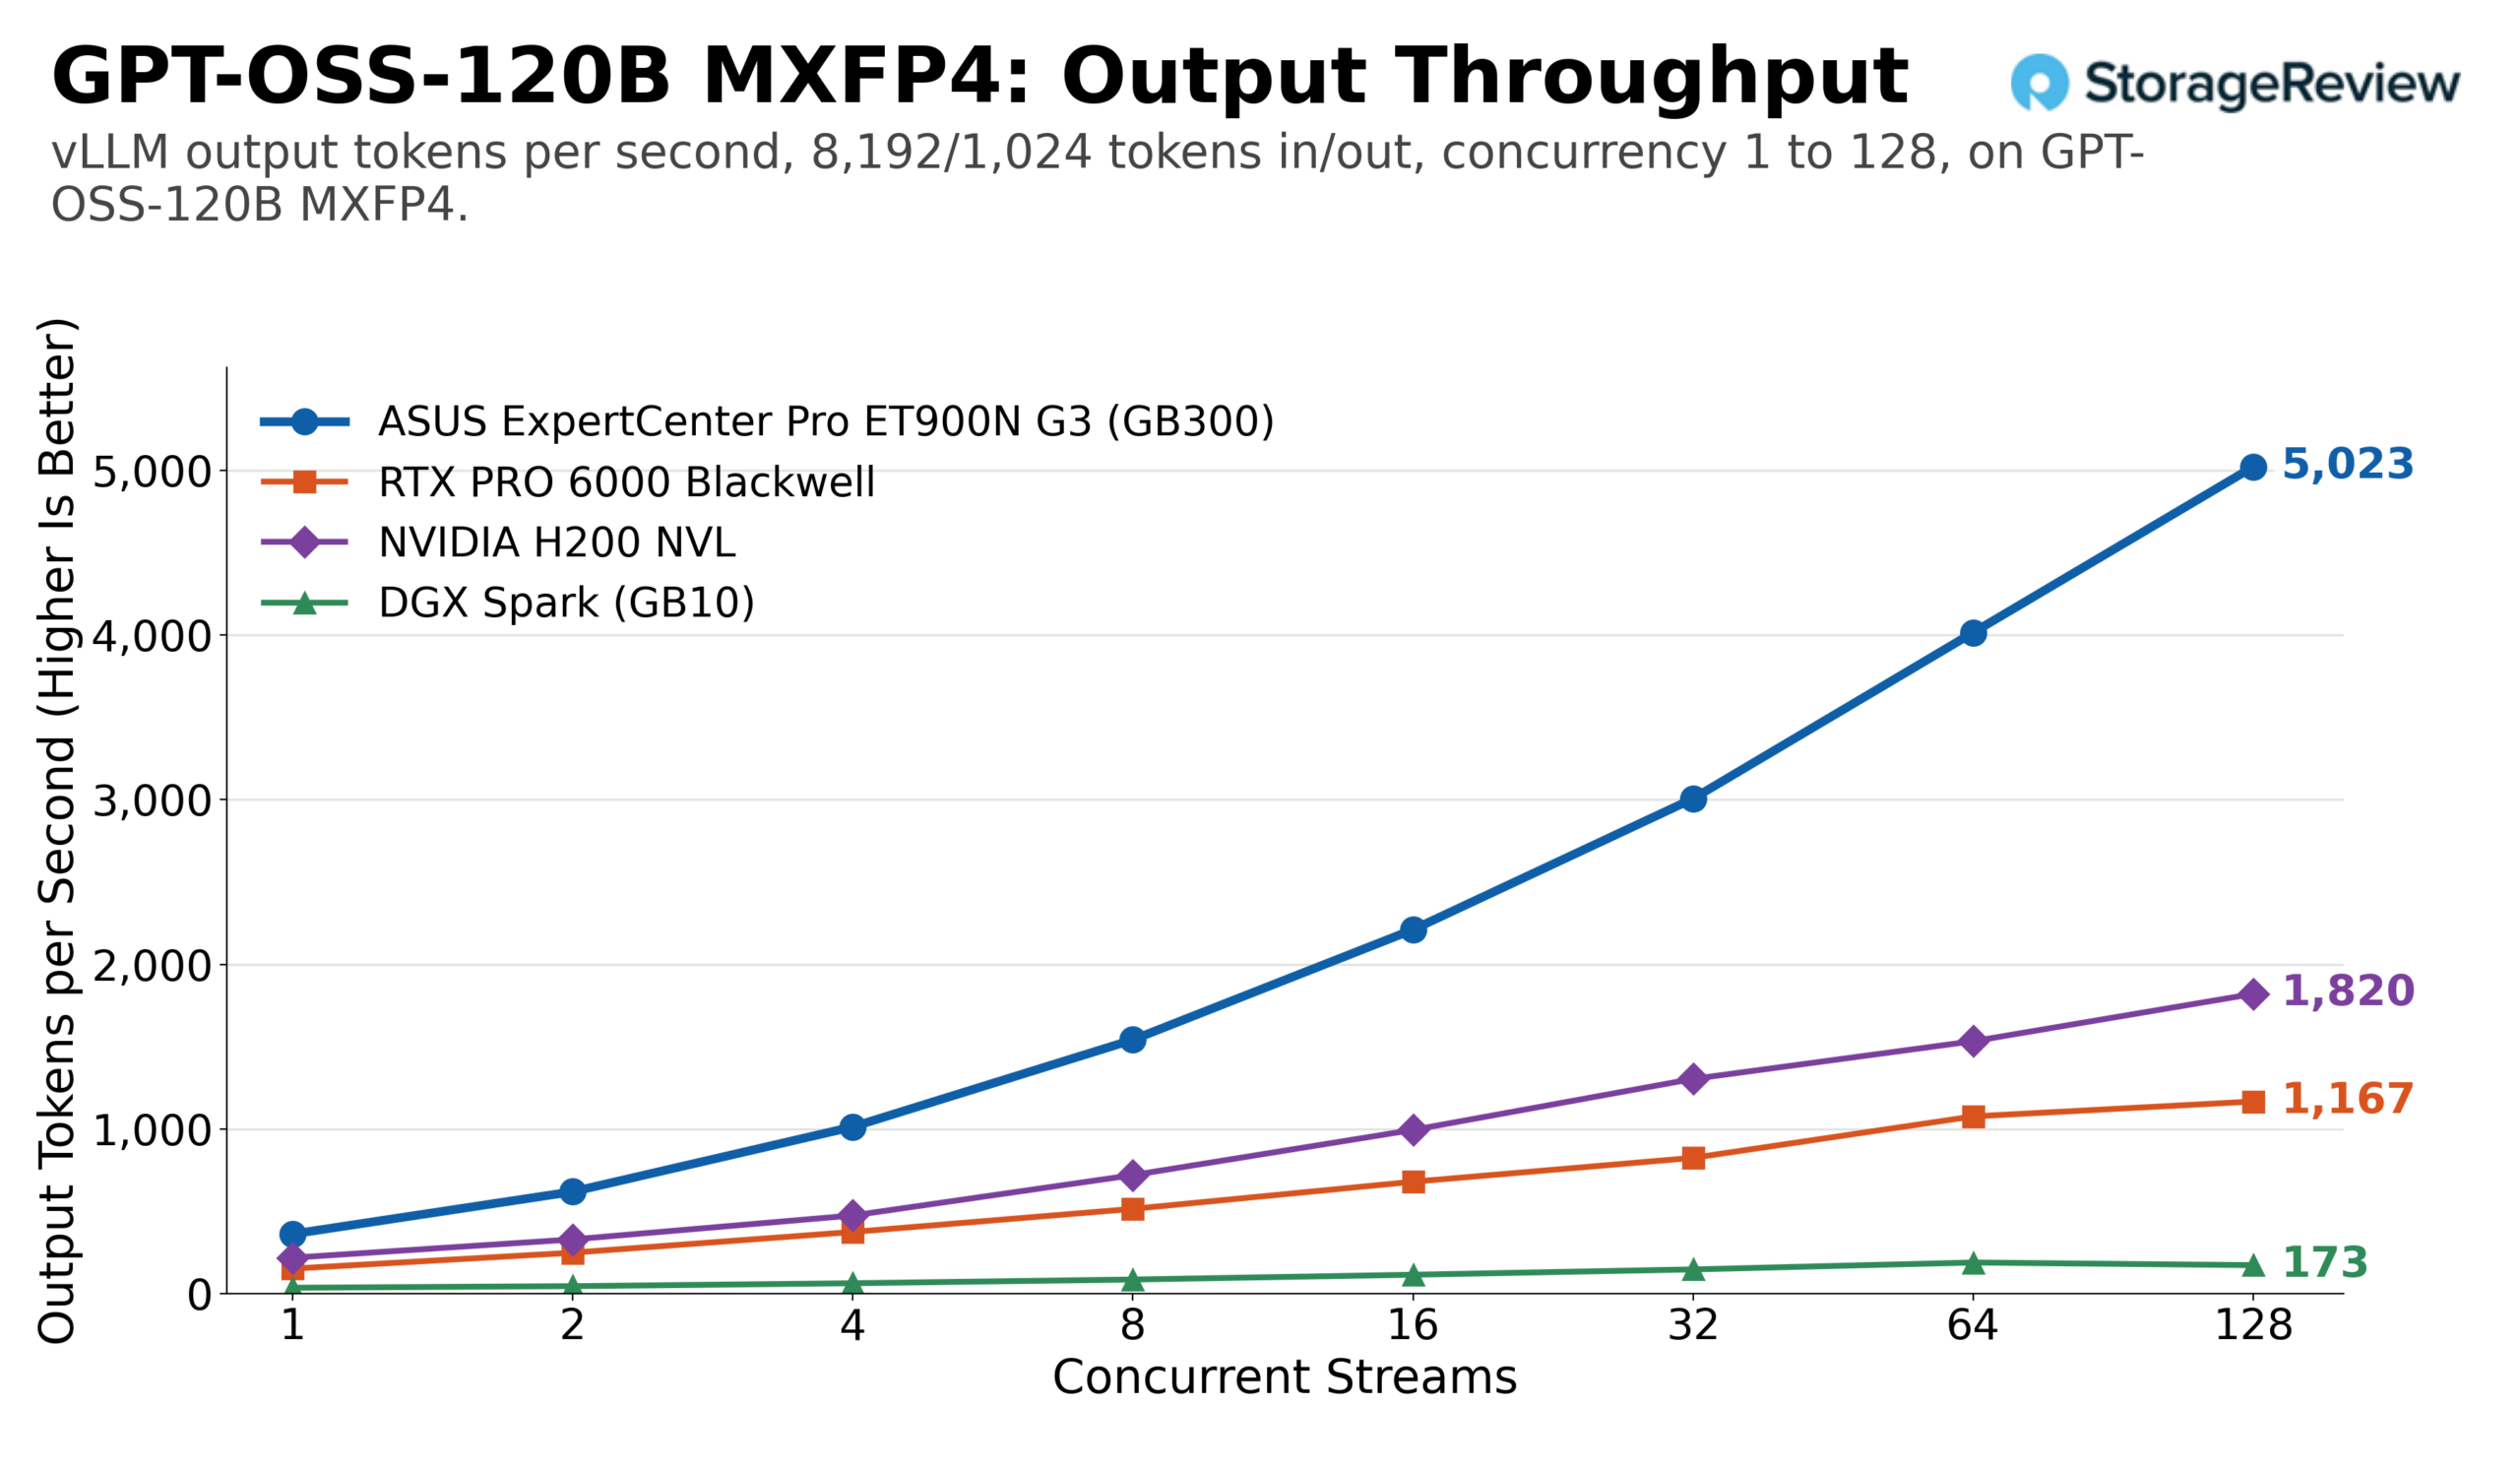
GPT-OSS-120B je místo, kde paměť začíná třídit pole. ET900N G3 dosáhl 9 280 výstupních tokenů za sekundu při stejném zatížení a 128 streamy, což je zhruba třikrát více než RTX PRO 6000 s 3 060, 2.8krát více než H200 NVL s 3 370 a více než 19krát více než Spark s 480. Při dlouhých výzvách menším systémům brzy došel prostor v mezipaměti KV: RTX PRO 6000 dosáhl vrcholu kolem 1 170 výstupních tokenů za sekundu a H200 NVL téměř 1 820, zatímco Station stále stoupal se 128 streamy a skončil na 5 023, s celkovou propustností 45 205 tokenů za sekundu.
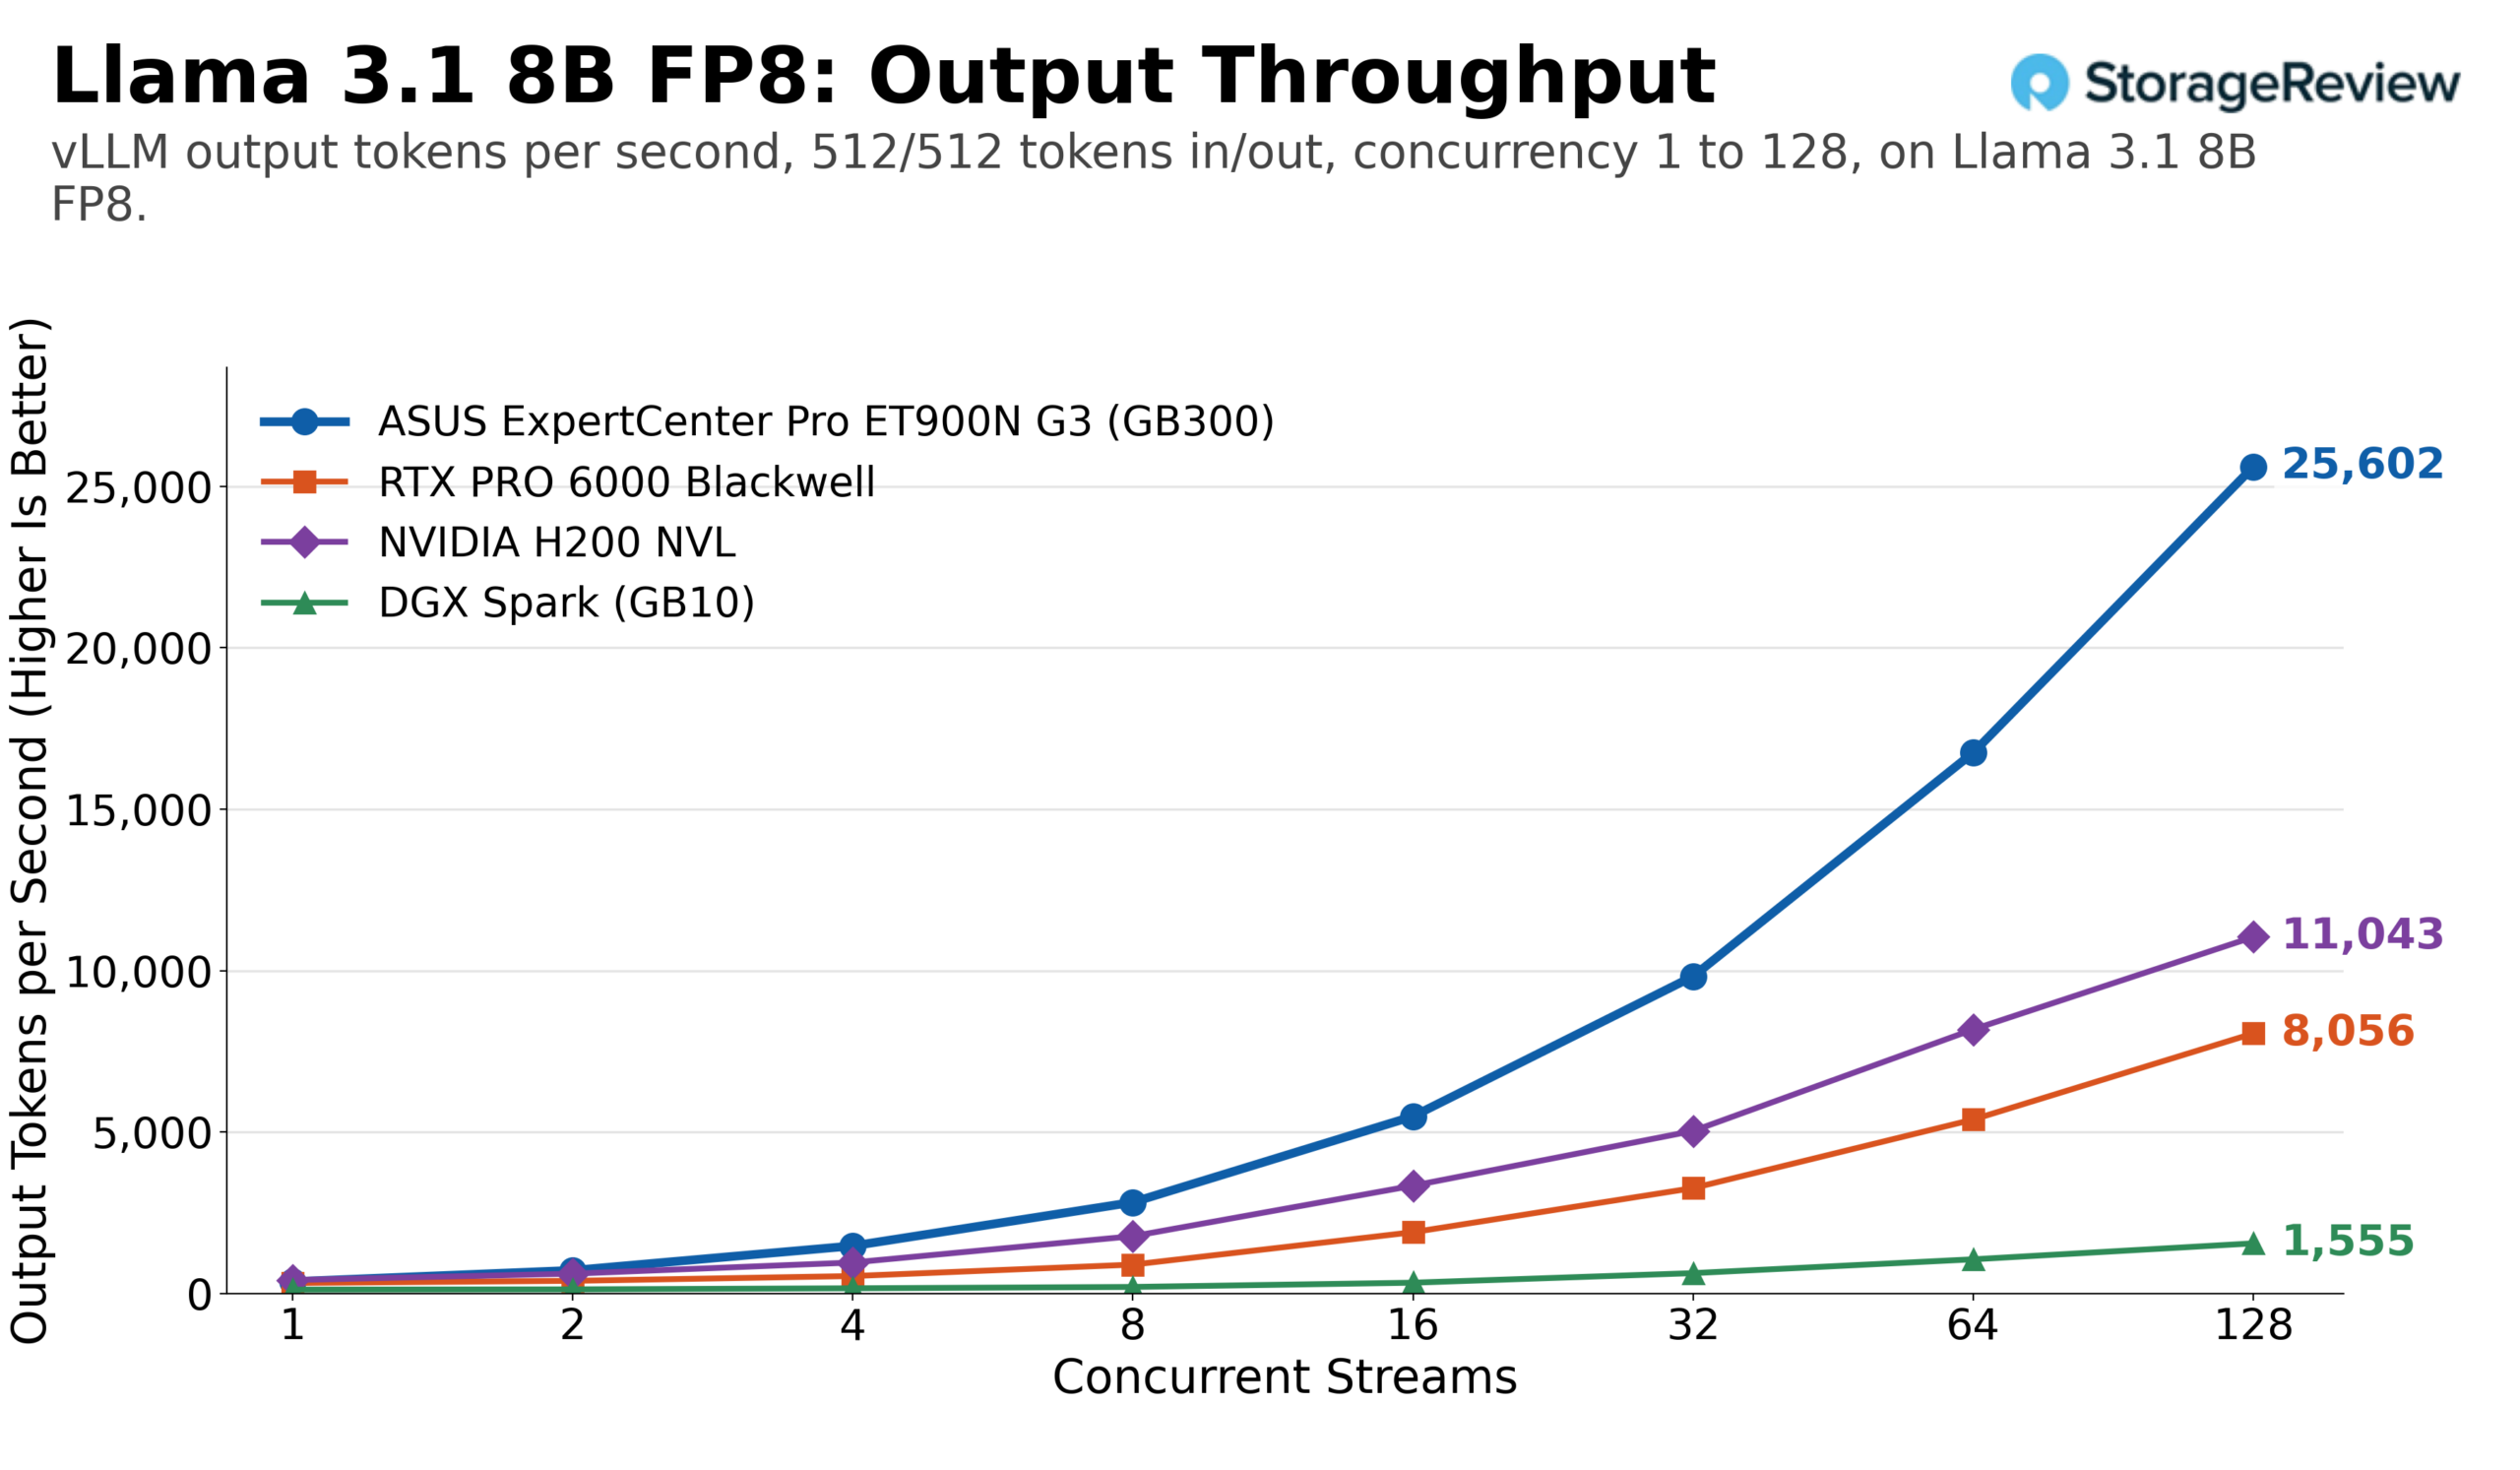
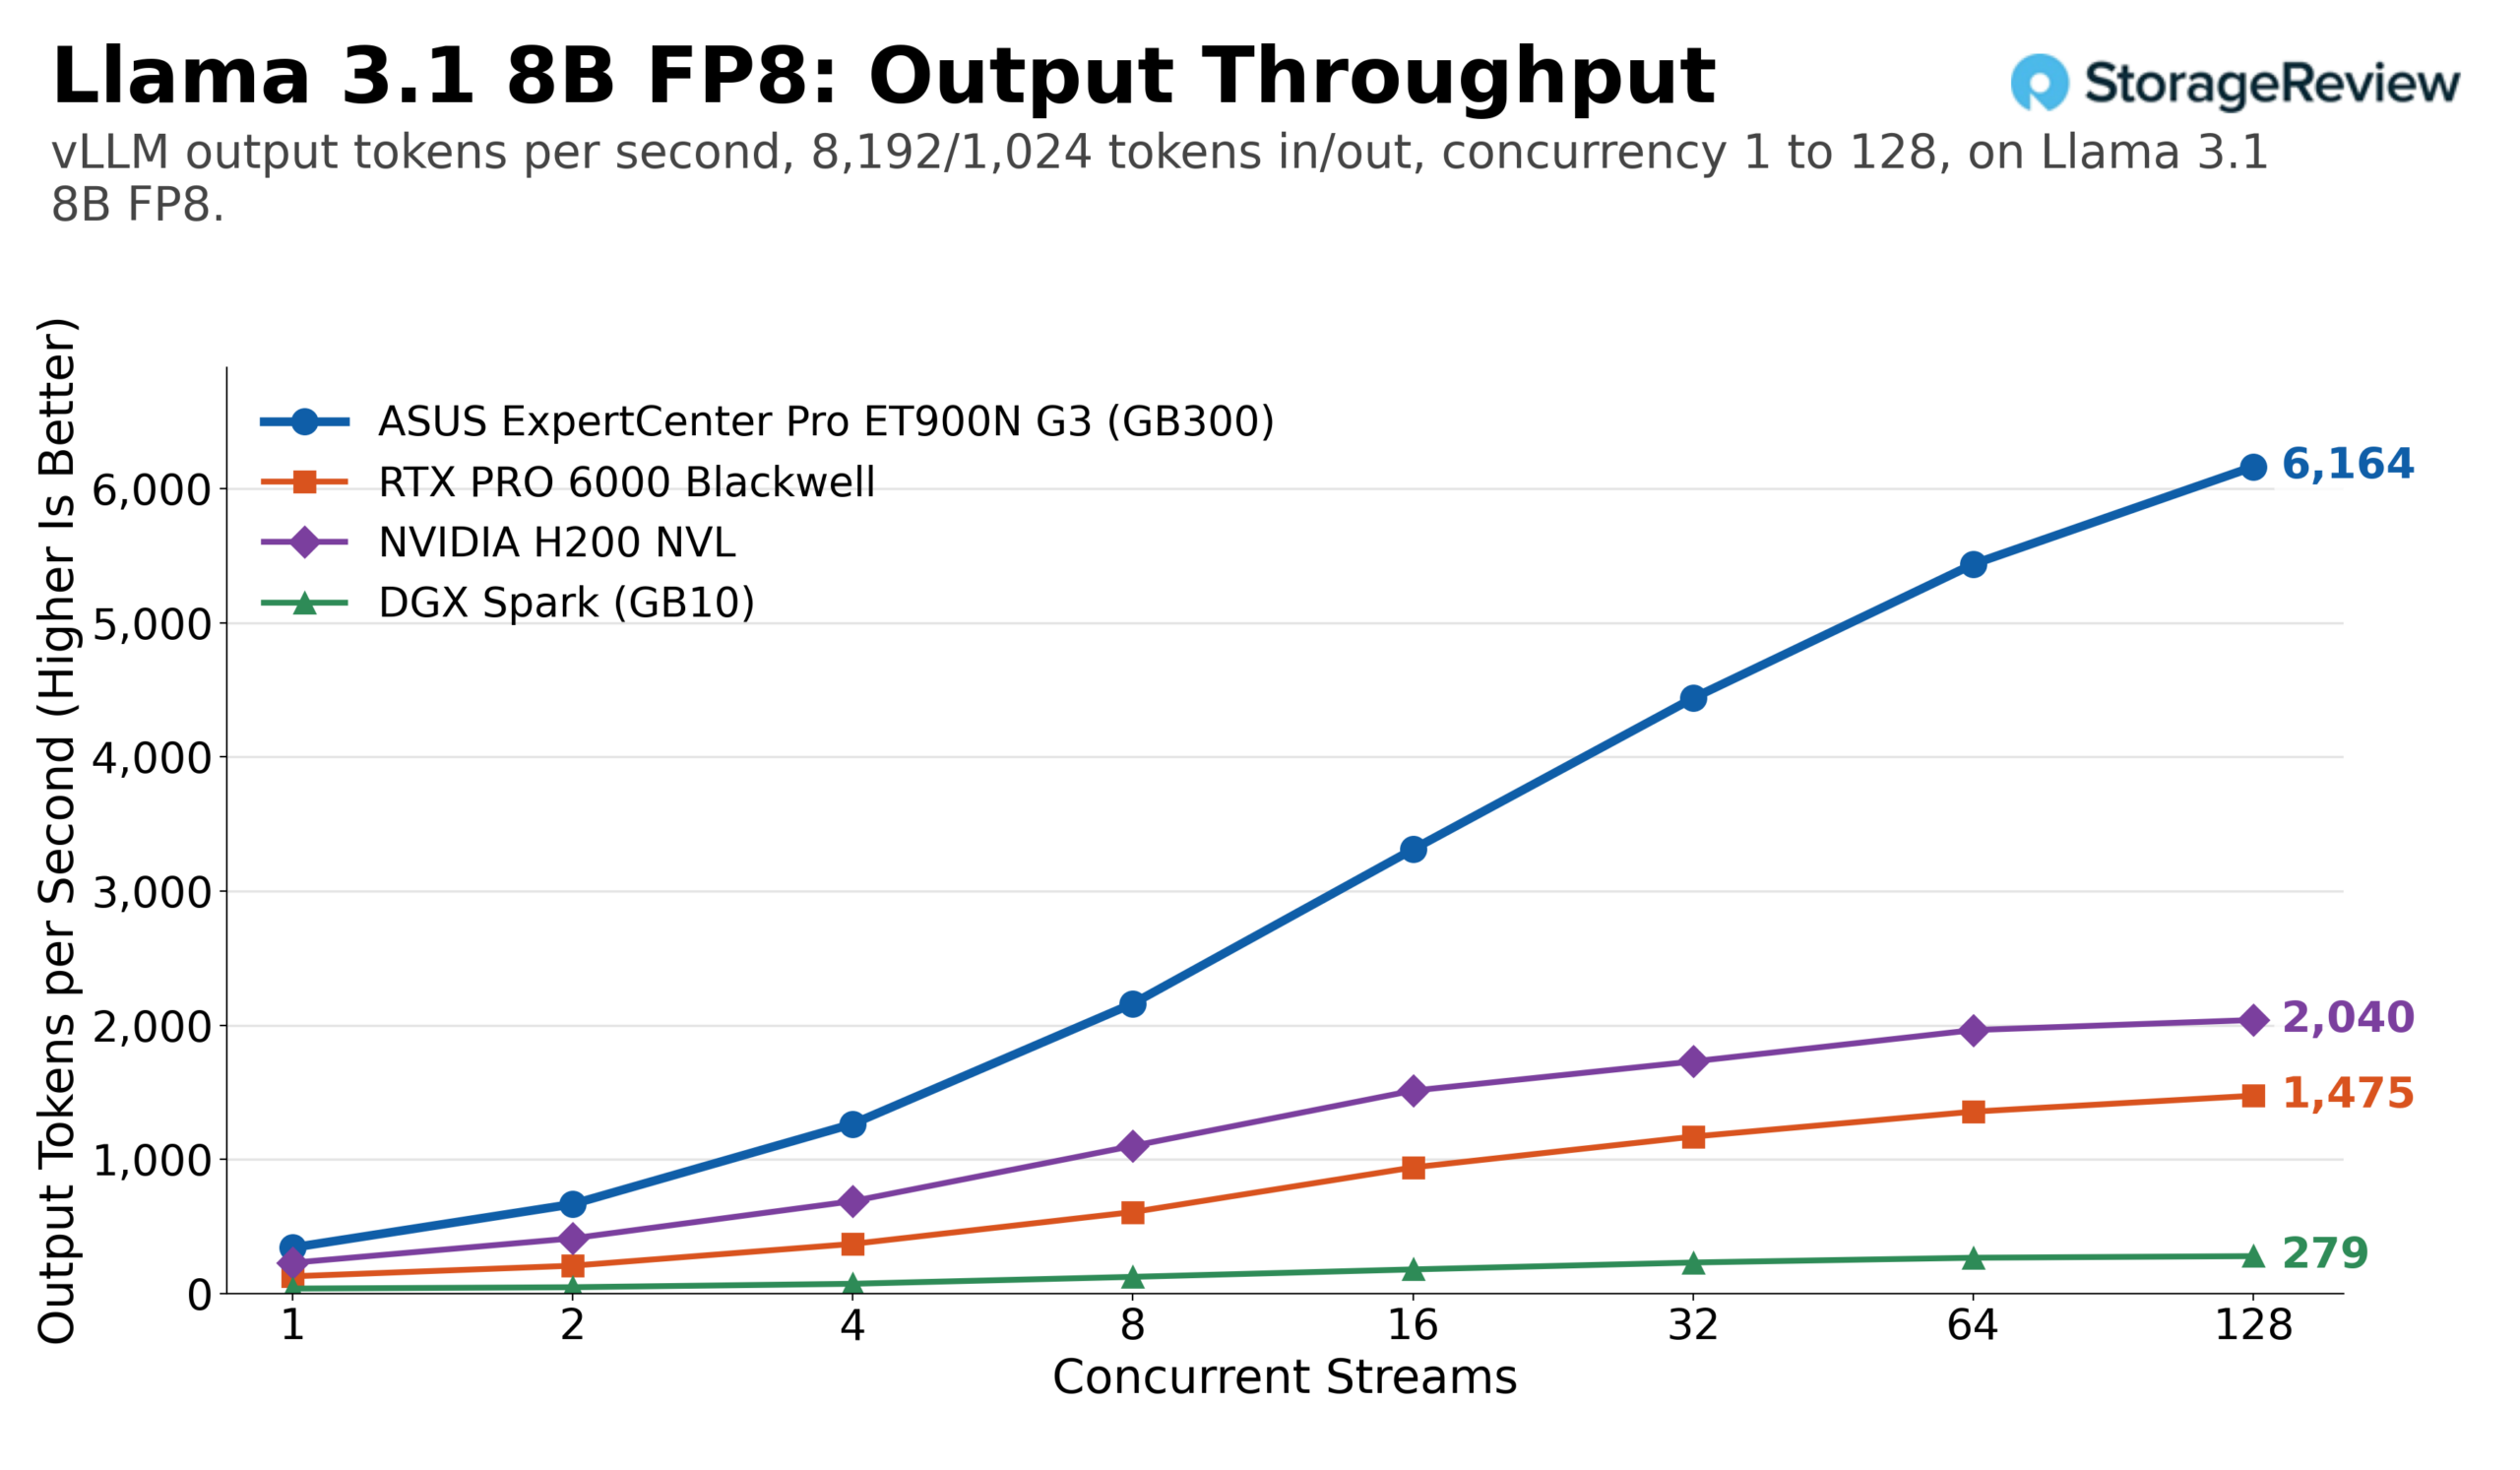
Llama 3.1 8B v FP8 je nejvyšším jednotlivým číslem v sadě. ET900N G3 při stejném zatížení zvládl 25 602 výstupních tokenů za sekundu napříč 128 streamy, celkem 51 205, ve srovnání s přibližně 8 060 u RTX PRO 6000 a 11 040 u H200 NVL. Pokles z BF16 na FP8 zvýšil Station o přibližně 50 % (ze 17 074 na 25 602), zatímco RTX PRO 6000 získala přibližně 70 % a H200 NVL asi 37 % ze stejné změny. Profil s vysokým počtem prefillů vše komprimoval, přičemž Station dosáhla 6 164 výstupních tokenů za sekundu, karta 1 480 a H200 2 040.
Mistral Small 24B v 8. FP dosáhl nejširších poměrů. ET900N G3 dosáhl vrcholu 11 075 výstupních tokenů za sekundu při stejném zatížení, což je 3.4krát více než RTX PRO 6000 s 3 240, 2.4krát více než H200 NVL s 4 610 a téměř 20krát více než Spark s 559. Při dlouhých výzvách dosáhl RTX PRO 6000 vrcholu 32 streamů a přibližně 480 výstupních tokenů za sekundu, než poklesl; H200 NVL dosáhl vrcholu přibližně 854 a Station dosáhla 2 302 se 128 streamy.


Qwen3 Coder 30B, model kombinující experty s malým počtem aktivních parametrů, je místem, kde se rozdíl v počtu jednotlivých streamů zmenšuje. V jednom streamu a se stejnou zátěží dodala RTX PRO 6000 přibližně 232 výstupních tokenů za sekundu pro 319 tokenů stanice a 308 tokenů NVL H200. Dávkování obnovuje pořadí: při 128 streamech dosáhl ET900N G3 12 439 výstupních tokenů za sekundu v FP8, což je 3.1násobek výkonu karty s 3 990 tokeny a 1.7násobek výkonu H200 s 7 450 tokeny NVL. V profilu s vysokým počtem předfillů dosáhla stanice 3 837 výstupních tokenů za sekundu, zatímco RTX PRO 6000 dosáhl vrcholu přibližně 880 tokenů při 64 streamech a H200 NVL přibližně 1 820 tokenů.


Napříč sdílenými modely dosáhl ET900N G3 2.8 až 3.4krát lepšího výkonu než jedna RTX PRO 6000 a 1.7 až 3.7krát lepšího výkonu než H200 NVL při plné souběžnosti, přičemž rozdíl mezi oběma se při dlouhých výzvách rozšiřoval, jakmile jim došla kapacita KV cache. Oproti WS300 se tyto čtyři opět nacházejí v rozmezí 1 %: 22 041 oproti 22 161 na GPT-OSS-20B, 9 280 oproti 9 294 na GPT-OSS-120B, 11 075 oproti 11 157 na Mistral Small FP8 a 12 439 oproti 12 425 na Qwen3 Coder FP8. Úplné srovnání 14 modelů, včetně tří modelů s většími rozdíly, je uvedeno v další části.
Dvě věže, jedna základní deska: ASUS ET900N G3 vs. MSI WS300
ET900N G3 a MSI XpertStation WS300 jsou stejné základní desky NVIDIA GB300 DGX Station ve dvou OEM šasi a obě prošly stejnými 14 modely, stejnými dvěma pracovními zátěžemi a stejným souběžným testováním na stejné sestavě vLLM. Níže uvedený graf porovnává maximální výstupní propustnost ET900N G3 napříč všemi modely s modely WS300.
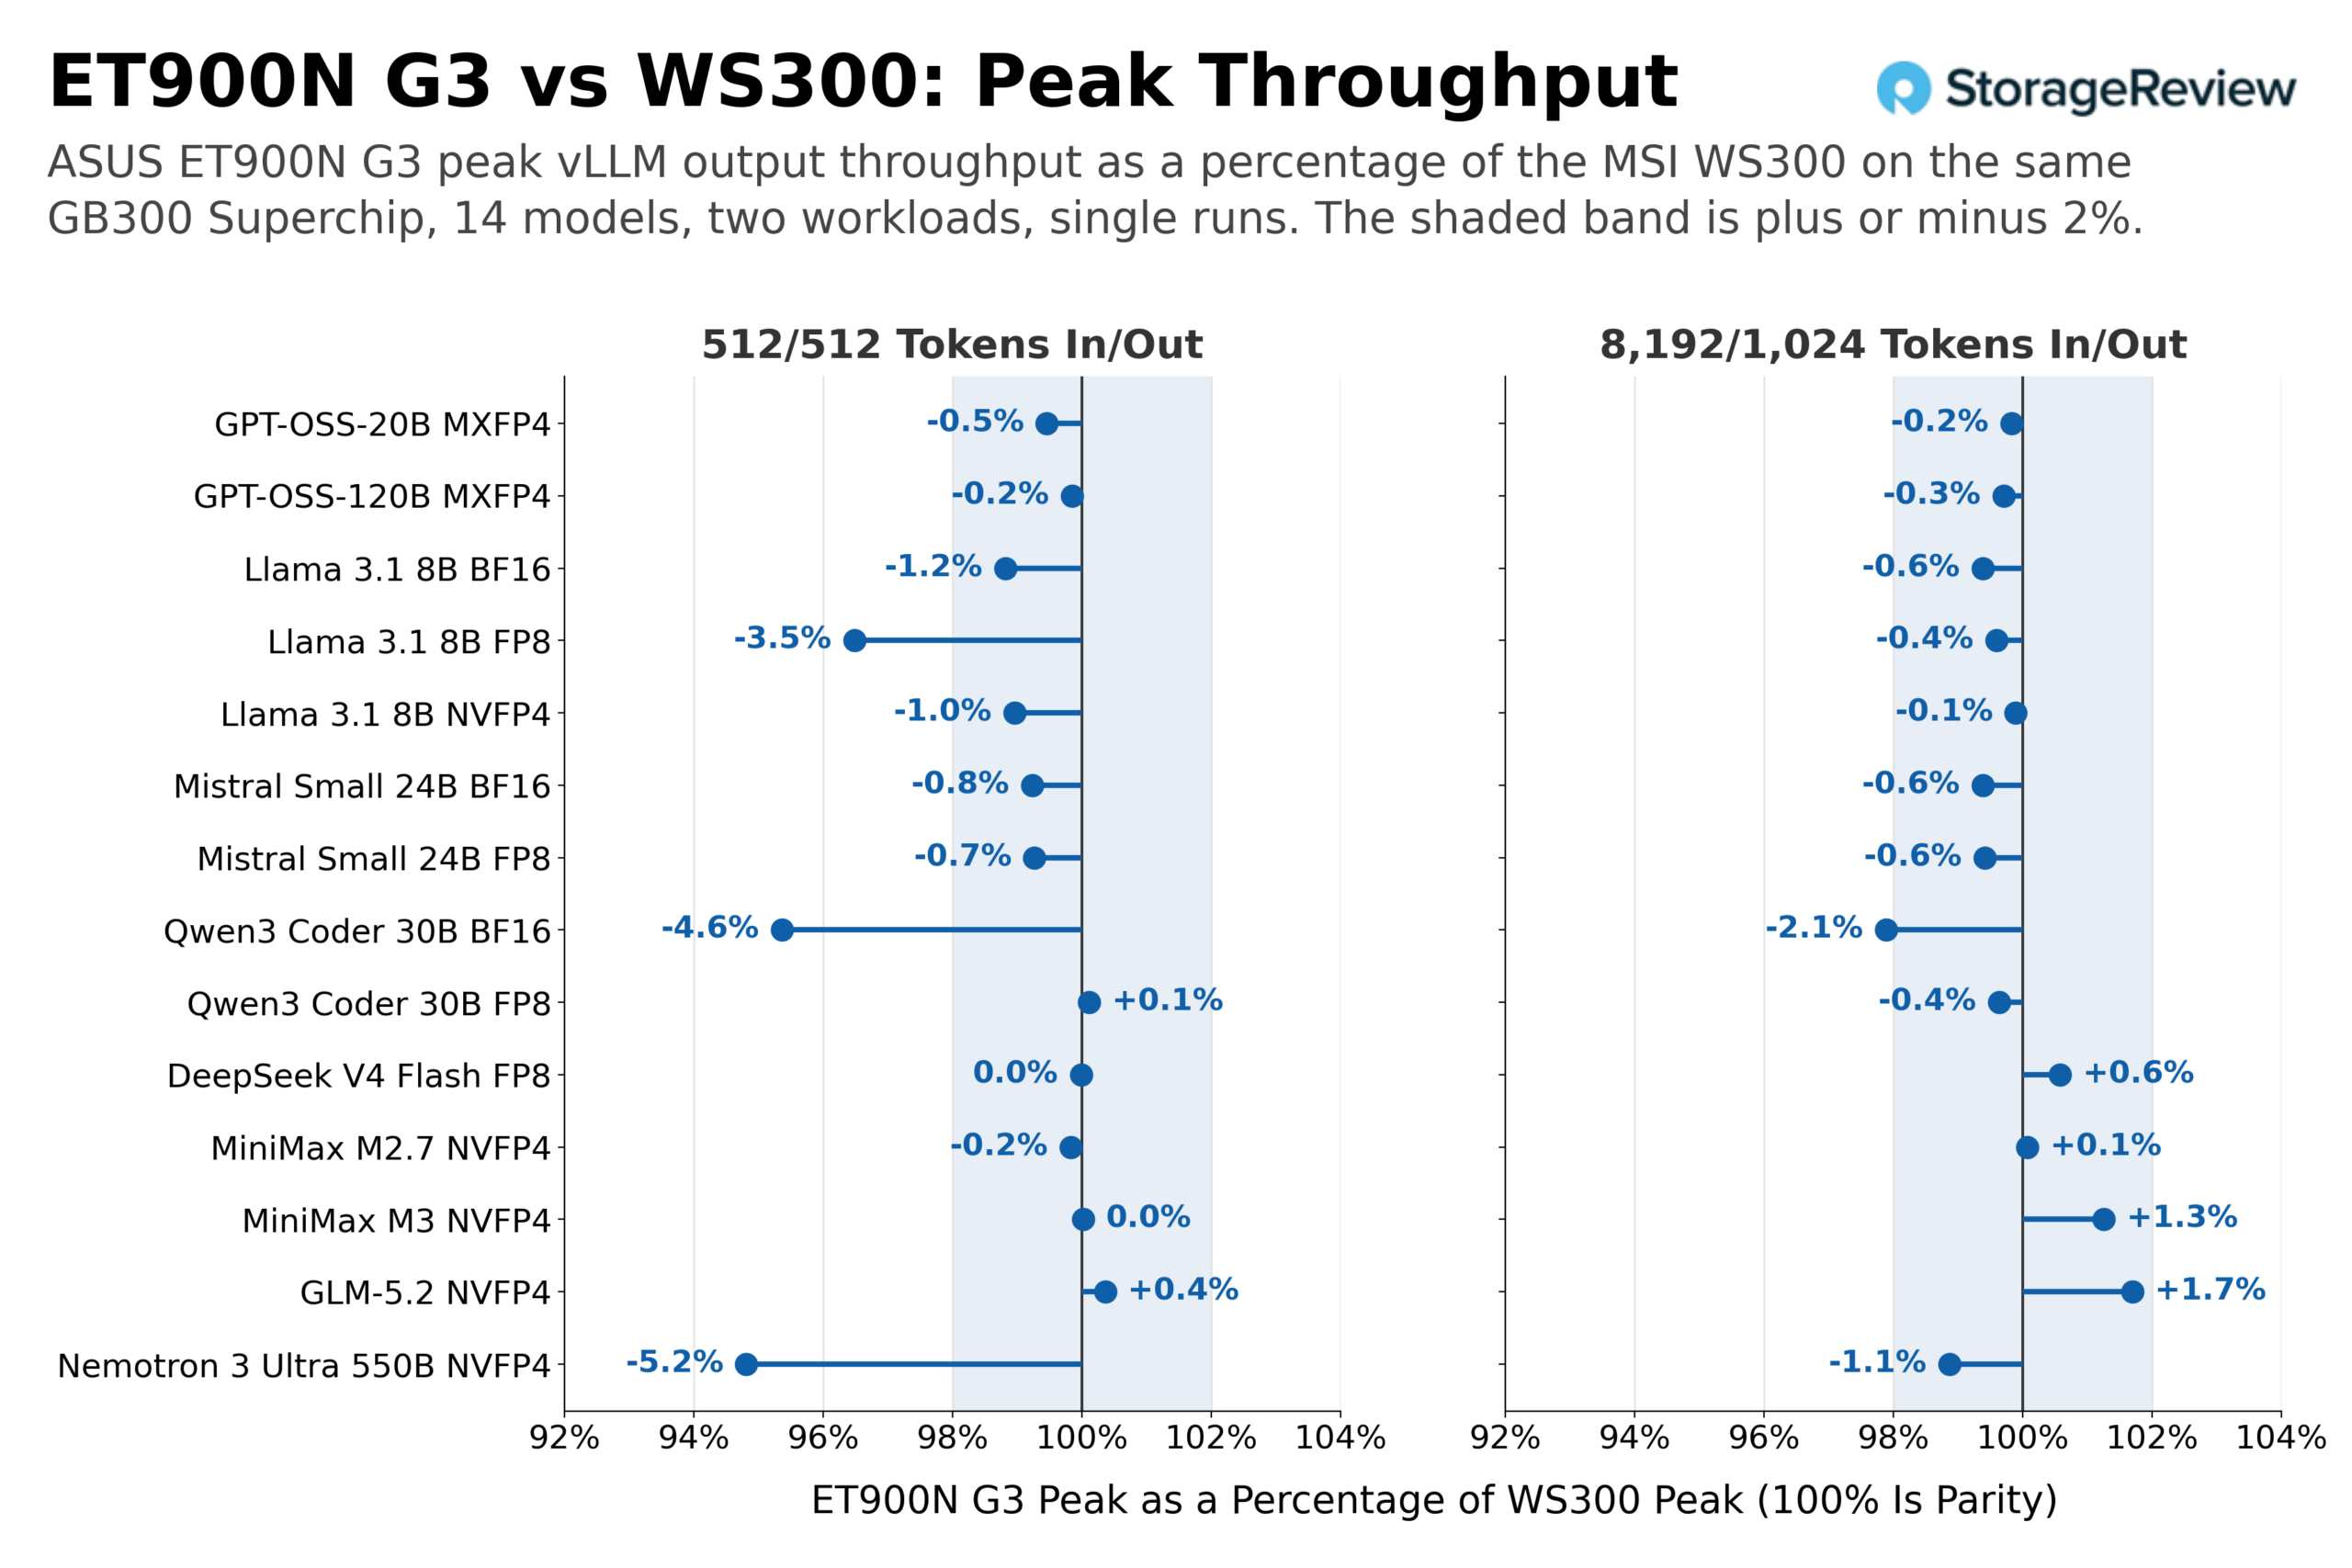
Z 28 párů model-zátěž se 24 od sebe liší o více než 2 % a většina z nich je jen zlomek procenta ve prospěch WS300. Čtyři se nacházejí mimo toto pásmo, tři z nich mají stejnou zátěž: Llama 3.1 8B FP8 s výkonem o 3.5 % nižším než WS300 (25 602 oproti 26 536 výstupním tokenům za sekundu), Qwen3 Coder 30B BF16 s výkonem o 4.6 % nižším než WS300 (10 000 oproti 10 486) a Nemotron 3 Ultra 550B s výkonem o 5.2 % nižším než WS300 (159 oproti 168), plus Qwen3 Coder 30B BF16 opět s výkonem o 2.1 % nižším než WS300 v dlouhých výzvách. Každý zde uvedený údaj je z jednoho běhu na každé věži, takže rozdíl 2 až 5 % mezi třemi modely ze 14 není něco, co bychom připisovali šasi; Pouze zaznamenáváme data a rozdíl mezi nimi. Modely, které se spoléhají na koherentní paměťový fond, MiniMax M3 a GLM-5.2, dosahují u obou úloh parity nebo vyšší; to je výsledek, který je podle nás pro platformu nejdůležitější: cesta Grace offload funguje v šasi ASUS stejně jako v šasi MSI.
| Model | WS300 8 192/1 024 | ET900N G3 8 192/1 024 | Delta | WS300 8 192/1 024 | ET900N G3 8 192/1 024 | Delta |
|---|---|---|---|---|---|---|
| GPT-OSS-20B MXFP4 | 22,161 | 22,041 | -0.5% | 9,572 | 9,555 | -0.2% |
| GPT-OSS-120B MXFP4 | 9,294 | 9,280 | -0.2% | 5,038 | 5,023 | -0.3% |
| Lama 3.1 8B BF16 | 17,278 | 17,074 | -1.2% | 3,520 | 3,498 | -0.6% |
| Lama 3.1 8B FP8 | 26,536 | 25,602 | -3.5% | 6,189 | 6,164 | -0.4% |
| Lama 3.1 8B NVFP4 | 28,698 | 28,400 | -1.0% | 6,744 | 6,737 | -0.1% |
| Mistral Small 24B BF16 | 7,922 | 7,861 | -0.8% | 1,643 | 1,633 | -0.6% |
| Mistral Small 24B FP8 | 11,157 | 11,075 | -0.7% | 2,316 | 2,302 | -0.6% |
| Kodér Qwen3 30B BF16 | 10,486 | 10,000 | -4.6% | 3,830 | 3,749 | -2.1% |
| Kodér Qwen3 30B FP8 | 12,425 | 12,439 | + 0.1% | 3,851 | 3,837 | -0.4% |
| DeepSeek V4 Flash FP8 | 1,766 | 1,766 | 0.0% | 948 | 954 | + 0.6% |
| MiniMax M2.7 NVFP4 | 4,801 | 4,793 | -0.2% | 1,743 | 1,744 | + 0.1% |
| MiniMax M3 NVFP4 | 1,041 | 1,041 | 0.0% | 278 | 282 | + 1.3% |
| GLM-5.2 NVFP4 | 138 | 139 | + 0.4% | 118 | 120 | + 1.7% |
| Nemotron 3 Ultra 550B NVFP4 | 168 | 159 | -5.2% | 142 | 140 | -1.1% |
GPT-OSS-20B, případ s nejvyšší hustotou v sadě, a GLM-5.2, případ s odlehčením zátěže, ukazují překrytí bez poměru: v obou případech běh WS300 bod za bodem sleduje ET900N G3.
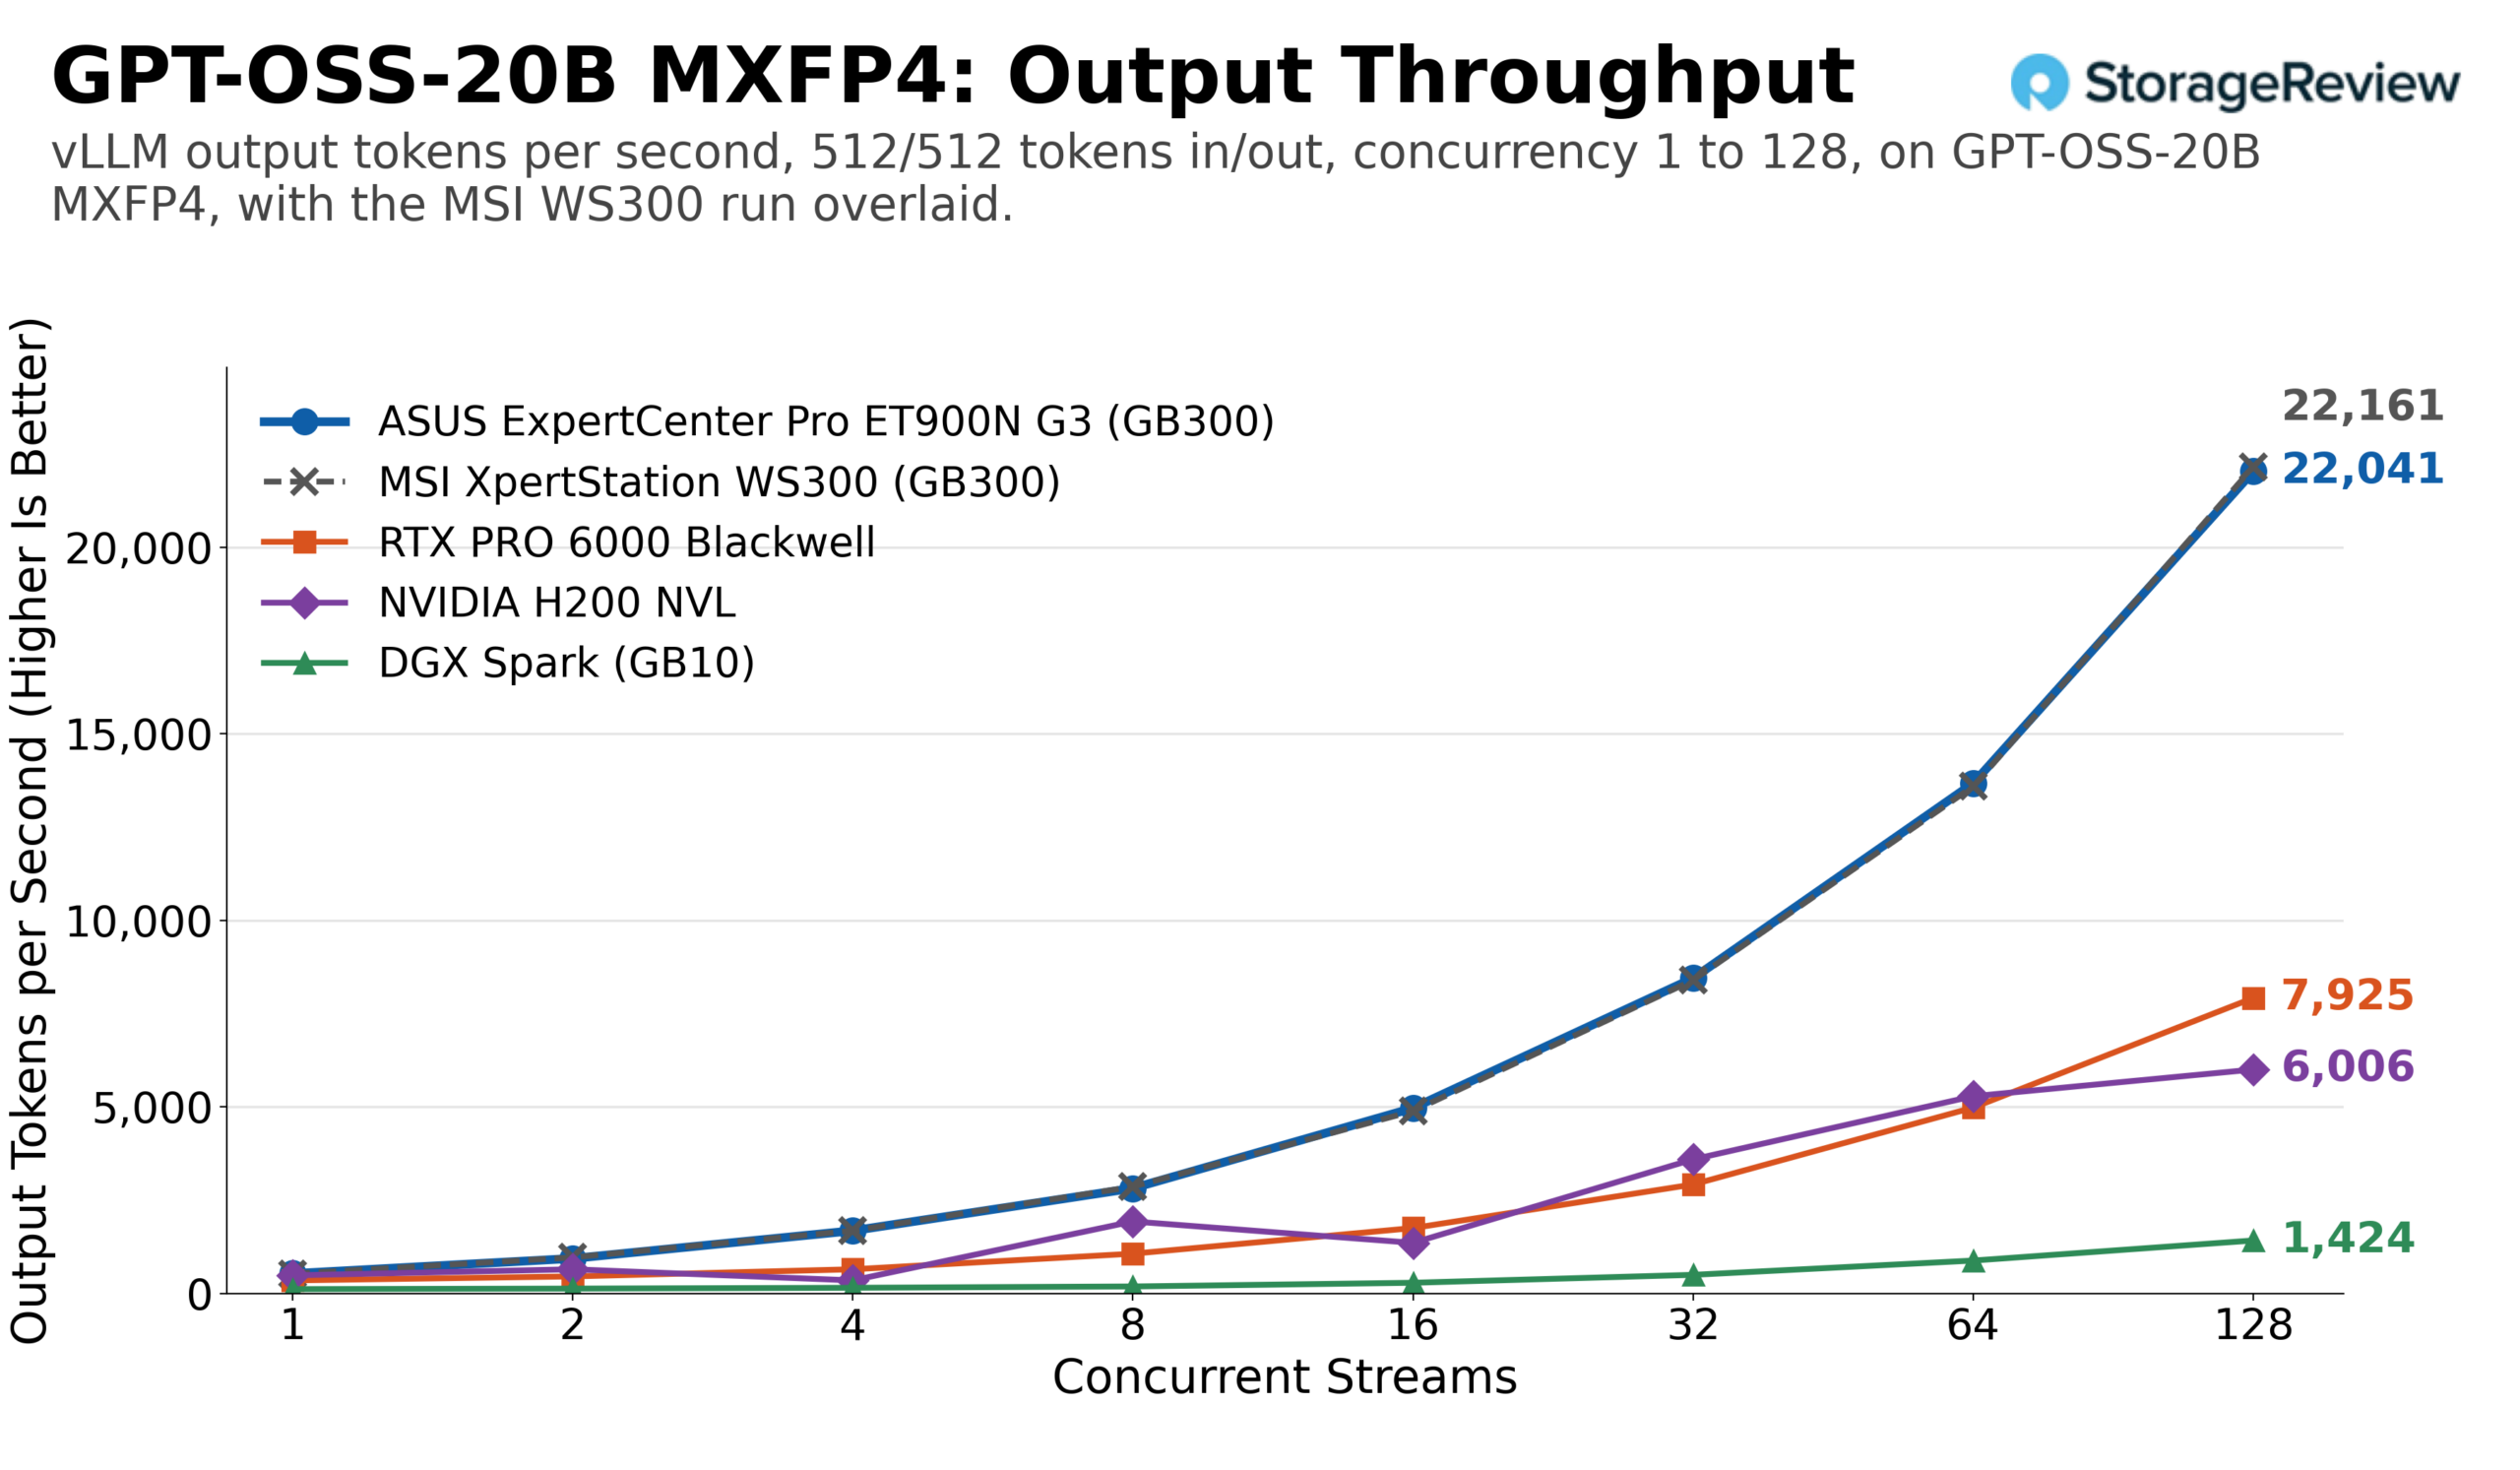
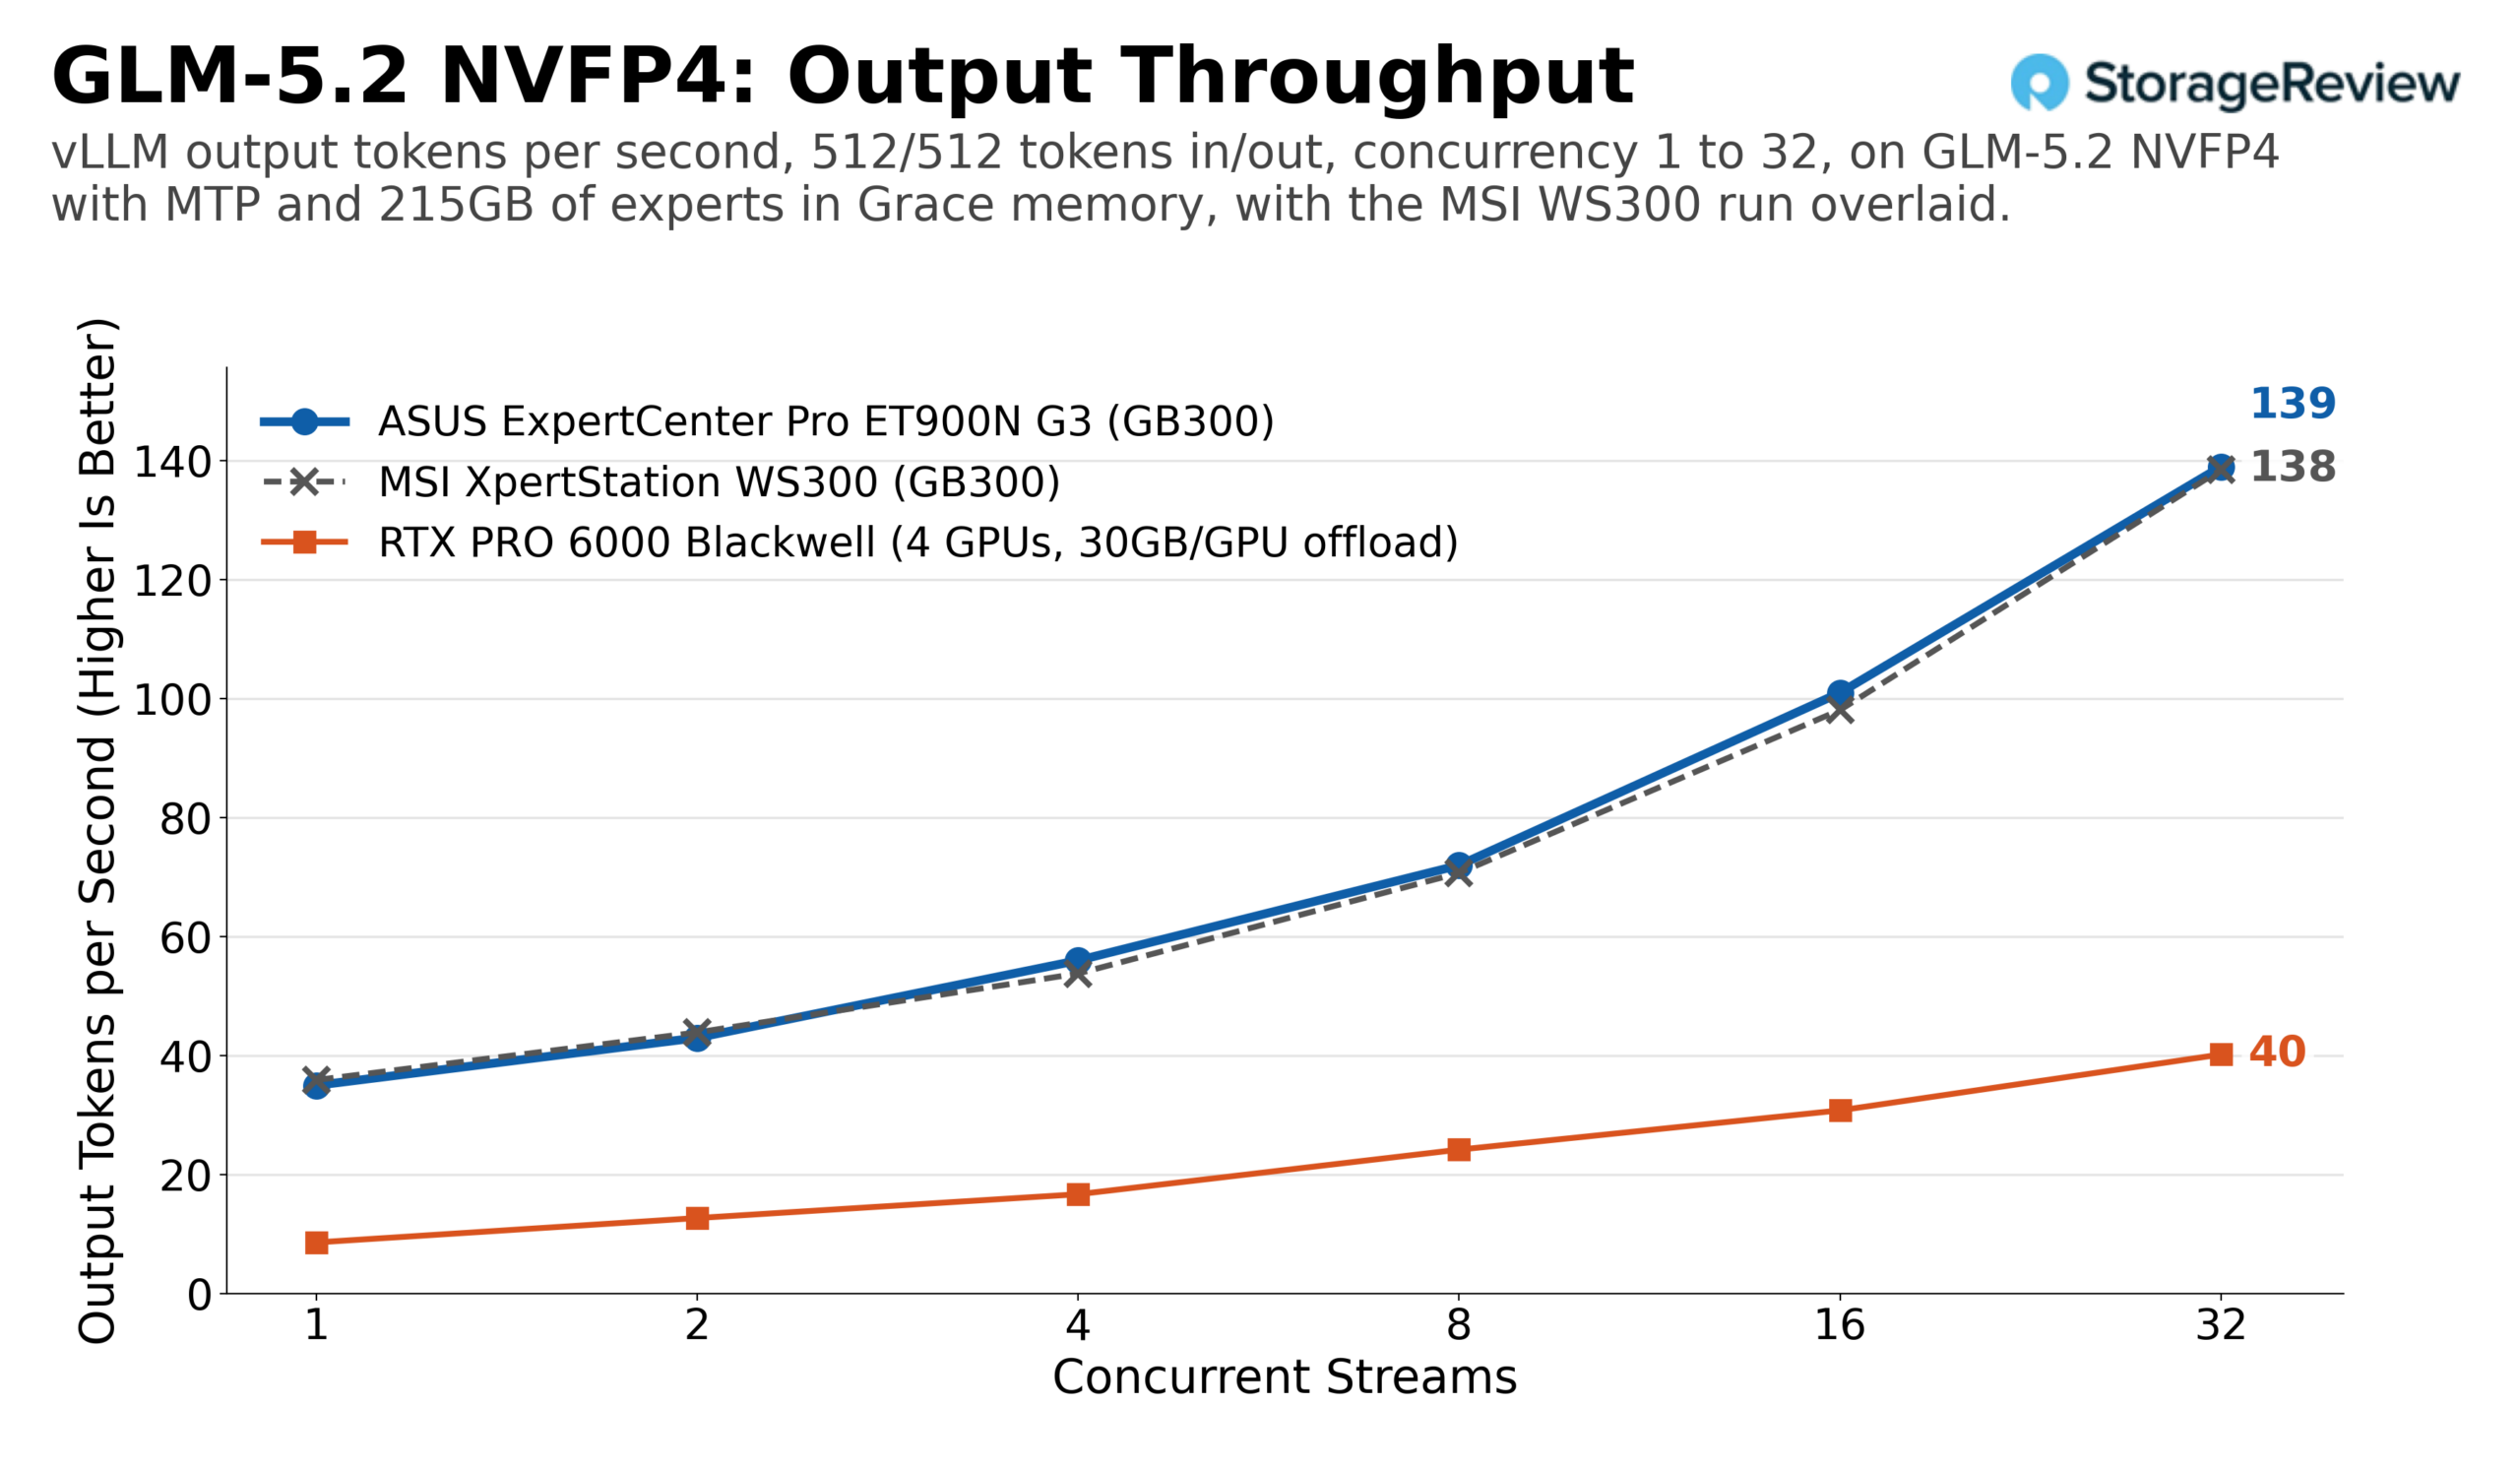
Toto je srovnání, na kterém budeme stavět, jakmile laboratoří projde další věže GB300. Další je HP ZGX, další budou následovat a každá z nich provádí stejný test, takže veškeré rozdíly mezi implementacemi OEM se zde zobrazí v jednom grafu pro každou věž, přičemž modelové grafy obsahují nezpracované křivky.
Závěr
ASUS ExpertCenter Pro ET900N G3 splňuje požadavky druhé implementace referenční platformy: potvrzuje tu první. Napříč 14 modely a dvěma pracovními zátěžemi se jeho maximální propustnost vLLM pohybovala v rozmezí 2 % oproti MSI XpertStation WS300 ve 24 z 28 srovnání, od 1 766 výstupních tokenů za sekundu na DeepSeek V4 Flash po 22 041 na GPT-OSS-20B, se čtyřmi odlehlými hodnotami v jednotlivých běhech mezi 2 a 5 %. A obsluhoval GLM-5.2 s 215 GB expertní paměti Grace rychlostí, které čtyři karty RTX PRO 6000 nedokázaly dosáhnout. Superčip GB300 nastavuje strop a ASUS odvedl dobrou práci.
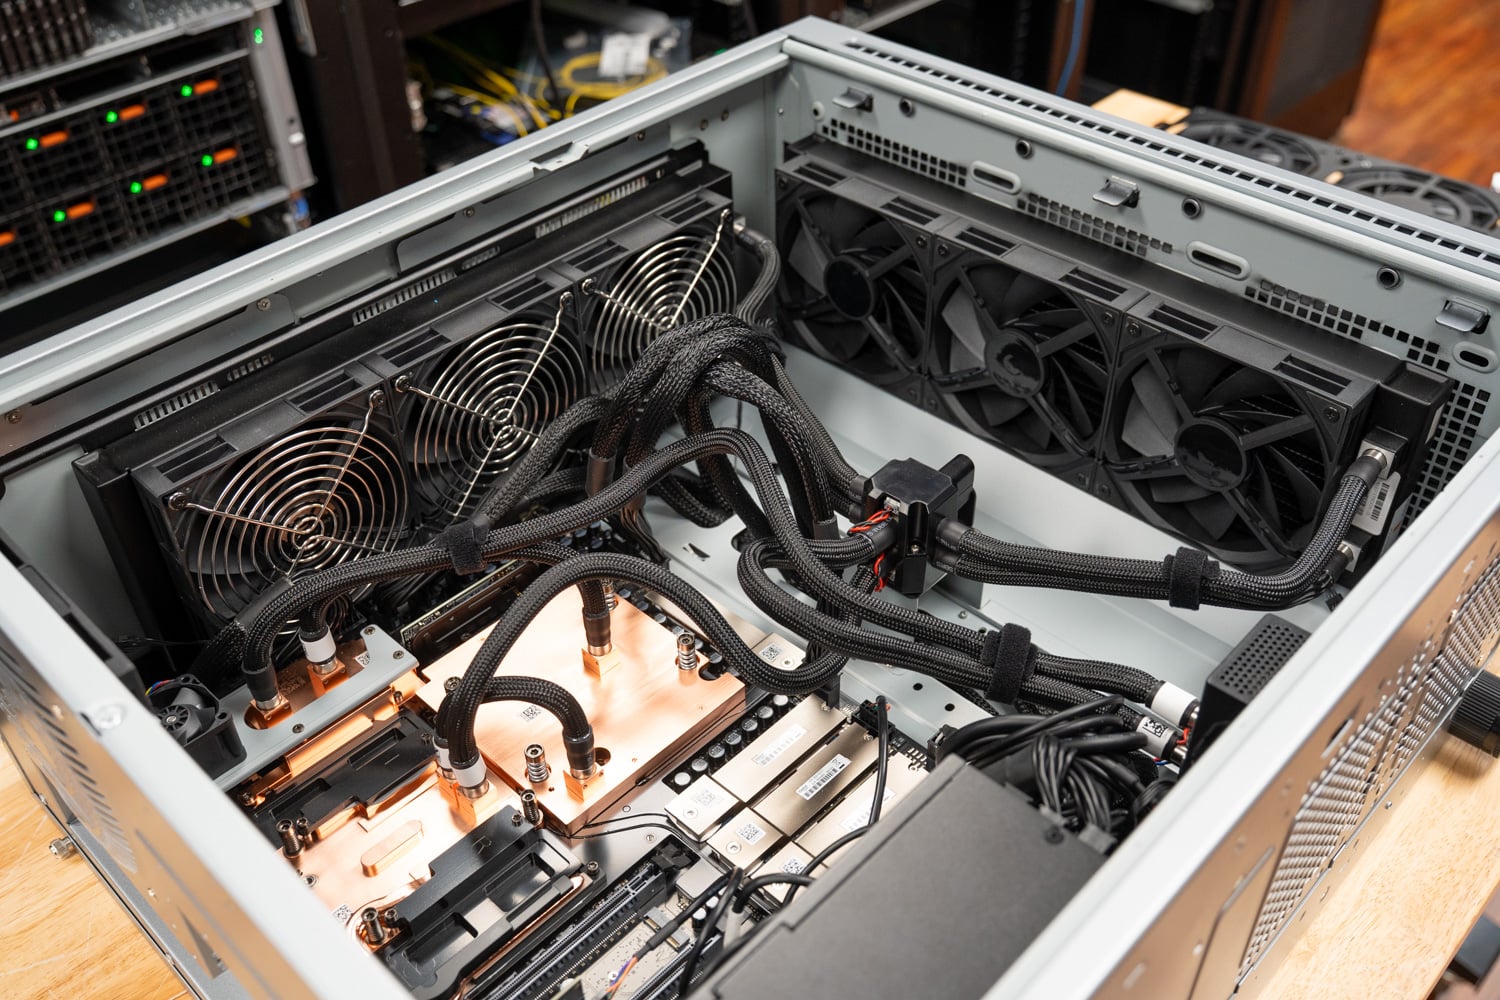
ASUS přidává praktické vlastnosti: rukojeti promění 27kg věž v něco, co mohou dva lidé přenášet, aniž by se museli držet panelů, ventilátor nad moduly QSFP112 řeší potenciální problém pro každého, kdo hodiny provozuje 400G optiku, a zdroj Titanium snižuje spotřebu energie u zásuvky. Hostitelský modul Arm, 20A obvod, výstup pro displej pouze BMC a sdílený rozpočet 1 600 W při instalaci velké grafické karty jsou realitou platformy, která platí stejnou měrou pro obě věže.
Stanice GB300 DGX zůstává nejvýkonnější věcí, jakou jsme kdy na stůl postavili, a ASUS ze své verze udělal dobrý způsob, jak si ji koupit.
Na naší Nejlepší stolní počítače pro lokální umělou inteligenci leaderboard, the ET900N G3 now stands alongside the WS300 as a tested alternative in the Best GB300 System slot.



 Amazon