

Prohlédli jsme si několik stanic GB300 DGX a nedávno jsme měli dvě z nich fyzicky nainstalované v naší laboratoři současně: ASUS ExpertCenter Pro ET900N G3 a stanici HP ZGX Fury AI . Vzhledem k tomu, že obě věže stály vedle sebe, chtěli jsme je propojit a zjistit, jak by druhý GB300 mohl zvýšit výkon jednoho stroje pro koordinovanější úlohy umělé inteligence u stolu.
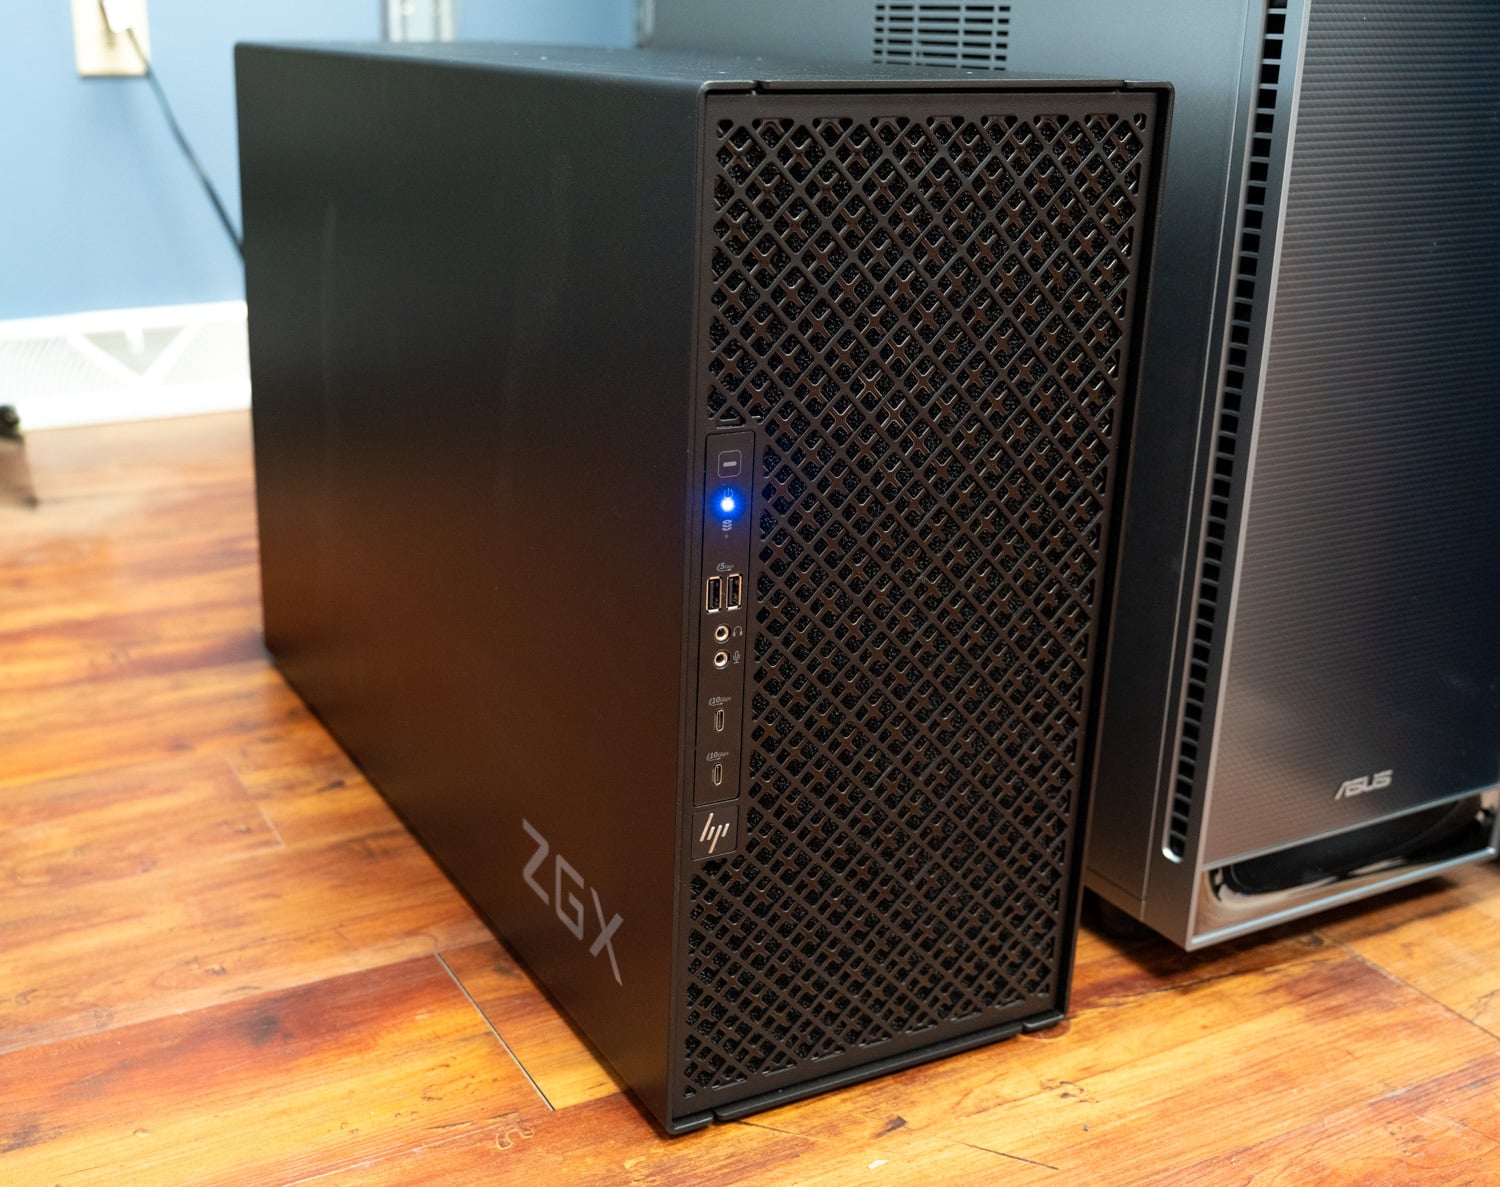
Rozšiřování stolního počítače o jeden systém najednou není nový nápad; NVIDIA to explicitně zdůraznila platformou GB10. Jednou z věcí, které dělaly DGX Spark tak výjimečným, byla možnost začít s jedním systémem a připojovat další s rostoucím zatížením. GB300 začíná s podstatně vyšším výkonem, ale provozování větších modelů nebo obsluha většího počtu uživatelů může zatěžovat i jeden z nejrychlejších stolních počítačů, které jsme testovali. To je přesně to, o co jsme v naší původní recenzi MSI šli : pokud vaše zatížení ospravedlňuje jednu z těchto stanic, je snadné si představit, jak by nakonec mohla ospravedlnit i několik.
Pro mnoho kupujících bude cena určujícím faktorem, kdy se rozšíření stane praktickým. Pochopení toho, jak dobře dvě stanice nyní fungují společně, dává někomu, kdo začíná s jednou, jasnější představu o tom, co by mohl z rozšíření později získat.
Key Takeaways
- Dva kabely, 98 % rychlosti linky: Dva 400G DAC převodníky mezi porty ConnectX-8 na desce ASUS ET900N G3 a HP ZGX Fury poskytly NCCL rychlost 98 GB/s při vysílání, redukci a odesílání/příjmu oproti 100 GB/s, které dvojice zvládne, GPUDirect RDMA dosáhla na každé liště rychlosti 392 Gb/s a zápis 8bajtového RDMA dosahoval průměrné doby 1.46 µs. Nastavení zvládl software NVIDIA.
- GLM-5.2 získává 11x při shodné souběžnosti: Kontrolní bod NVFP4 s kapacitou 433 GB přenáší do paměti Grace přibližně 215 GB expertních vah na jedné stanici, která obsluhovala 139 výstupních tokenů za sekundu ve 32 streamech; rozděleno mezi dva B300 v tenzorovém paralelním režimu dosáhlo 1 525 ve 32 streamech a 3 141 ve 256 streamech.
- GLM-5.3 se zvyšuje ze 188 na 5 018 tokenů za sekundu: Největšího nárůstu v sadě, 27x, dosáhl druhý model, který přeplňuje 252 GB HBM3e, přičemž dvojice stále dosahuje 256 streamů při stejném zatížení a udržuje téměř 600 výstupních tokenů za sekundu při výzvách s 8 192 tokeny, což je zhruba pětinásobek oproti jednomu věžovému serveru.
- Dlouhé výzvy MiniMax-M3 se zastaví na osmi streamech na jedné stanici: Výstupní výkon jedné věže klesl na 103 tokenů za sekundu při osmi streamech, jakmile došla KV mezipaměť; dvojice ve stejném bodě obsloužila 736 tokenů, což je 7.1x, a pokračovala na 1 801 při 256 streamech.
- Modely, které se hodí, získají druhou kopii a rozdělení před vyplněním/dekódováním: S jednou stanicí v režimu předplnění a druhou v režimu dekódování se propustnost GLM-5.3 Flash ztrojnásobila u 32 streamů v režimu krátkých prompts (z 828 na 2 721) a zdvojnásobila u 32 streamů v režimu dlouhých prompts (z 1 219 na 2 448). DeepSeek V4.1 Flash dosáhla nejvyšší výstupní propustnosti ze všech testovaných modelů, 5 248 tokenů za sekundu při 256 streamech.
Síťování na stanici DGX
Než se pustíme do samotného clusteru, shrňme si síťové funkce, kterými jsme se zabývali v naší recenzi MSI. Síťová karta ConnectX-8 SuperNIC nabízí více než jen síťové připojení. Její integrovaný přepínač PCIe se stará také o část interních I/O operací stanice, a to připojením k Grace a také ke dvěma slotem pro úložiště PCIe Gen 6 x4.
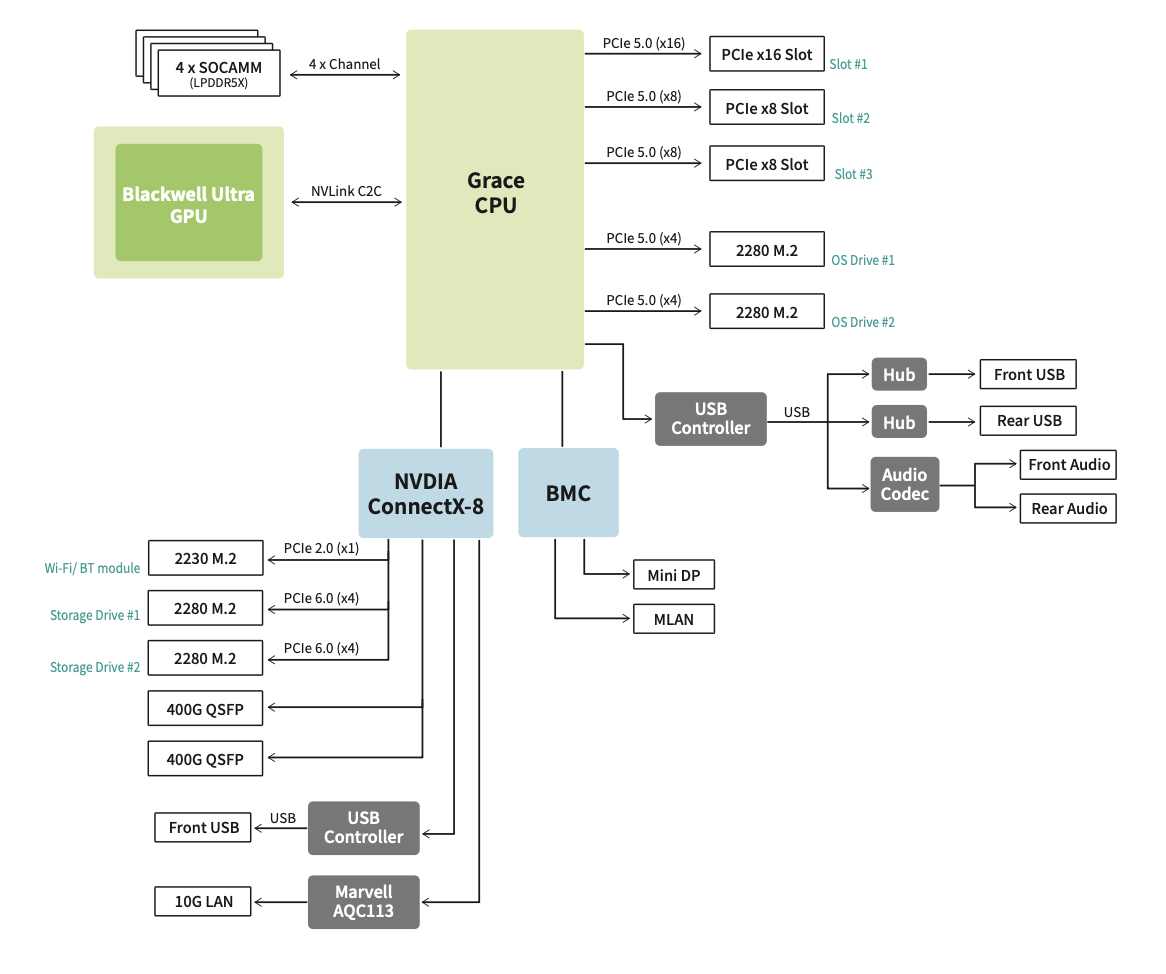
Pro samotné síťování systém nabízí dva porty QSFP112 s rychlostí 400 Gb/s každý, což poskytuje celkovou šířku pásma 800 Gb/s pro propojení stanic nebo jejich připojení k větší síti.
Ve srovnání s implementací v DGX Spark, kterou jsme probírali v naší původní recenzi DGX Spark , byl Sparkův ConnectX-7 třídy 400 Gb/s výkonnější, než dokázala plně využít PCIe konektivita GB10. Řadič se nacházel za dvěma samostatnými linkami PCIe 5.0 x4, což omezovalo užitečnou celkovou propustnost sítě na přibližně 200 Gb/s. Jeho dva fyzické porty se v Linuxu také zobrazovaly jako čtyři logická ethernetová rozhraní. Získání plné šířky pásma vyžadovalo namapování těchto rozhraní zpět na připojenou kleci, konfiguraci obou logických rozhraní za ní a zajištění toho, aby provoz RDMA mohl používat obě cesty PCIe.
Stanice nám nabízí jednodušší uspořádání se dvěma porty 400 Gb/s, které mohou sloužit jako nezávislá síťová kolejnice.
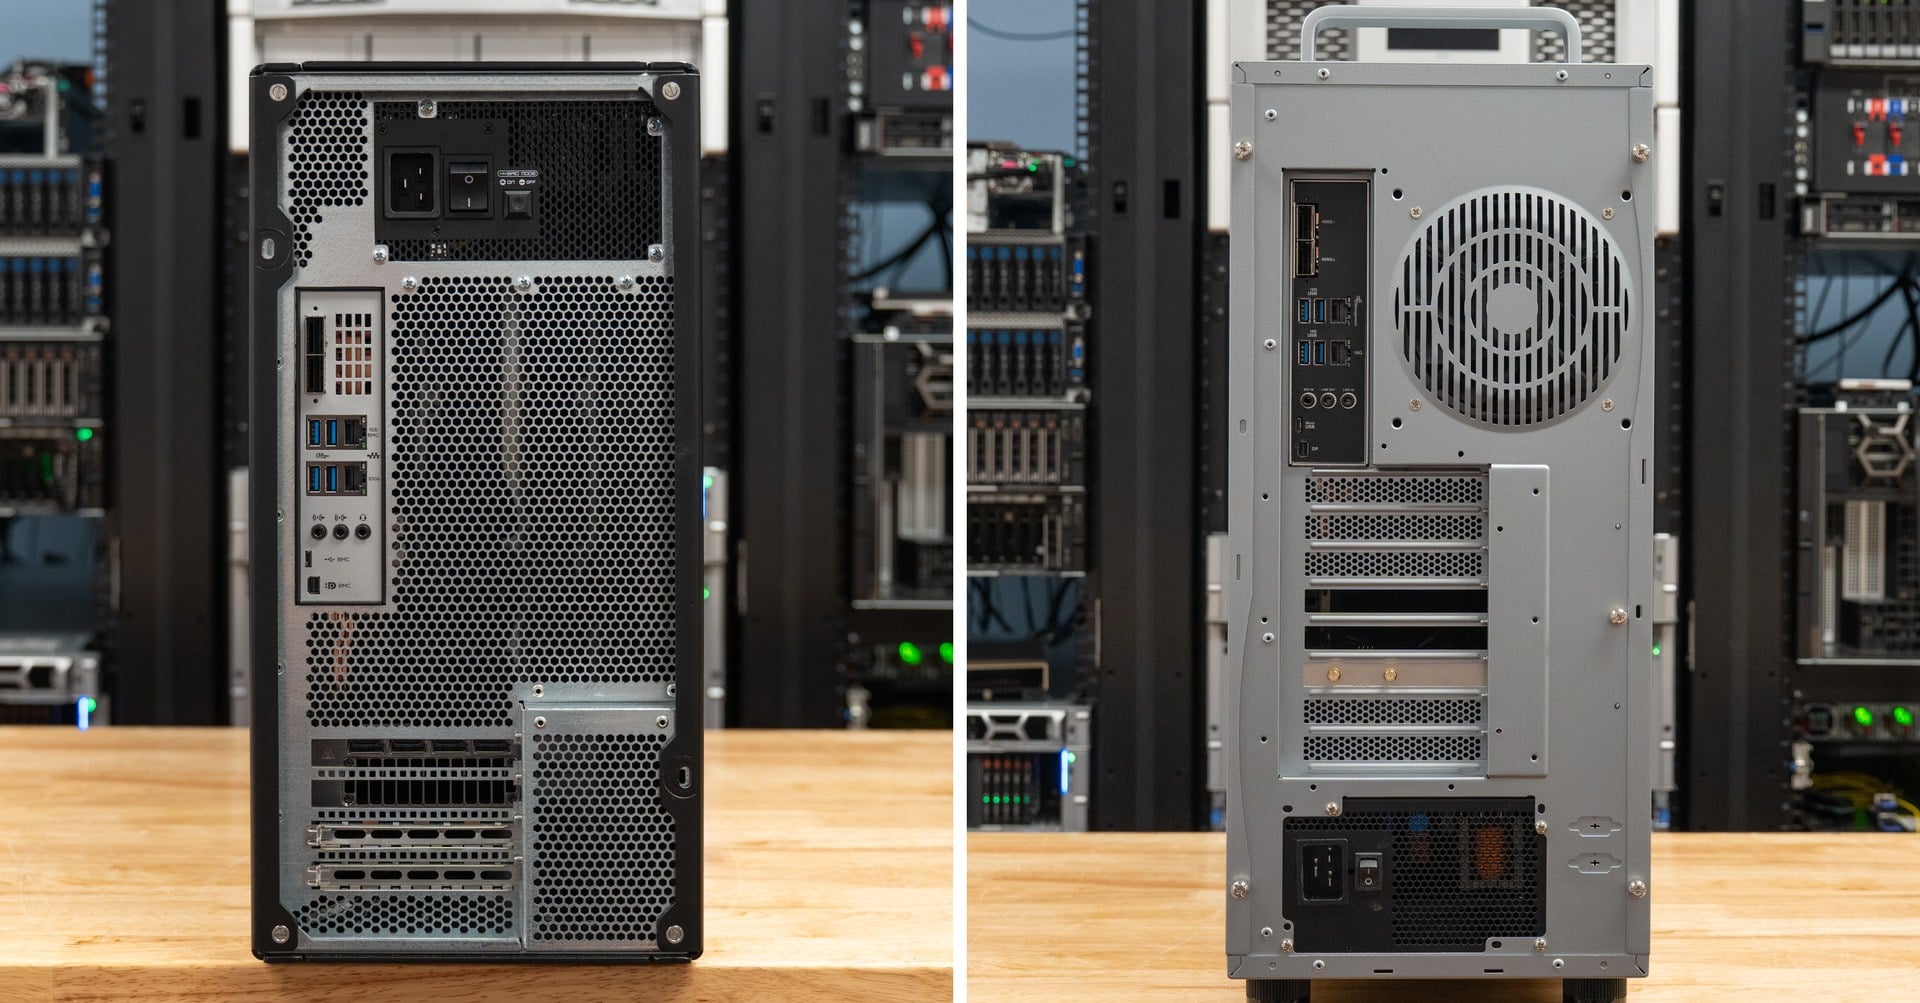
Protažení čtyřnásobku použitelné šířky pásma Sparku přes dvojici klecí QSFP také zvyšuje zátěž chlazení a během našeho testování si s ní poradily všechny jednotky. Samotný ConnectX-8 je chlazen kapalinou a někteří dodavatelé, jako například MSI, toto chlazení rozšiřují i na klece QSFP, zatímco jiné systémy používají chladiče a samostatné ventilátory nad klecemi, jak jsme viděli v naší recenzi od ASUSu. Toto chlazení je obzvláště užitečné pro optické moduly, které generují více tepla než pasivní DAC. Oba přístupy se v našem testování osvědčily a v síti jsme se nesetkali s problémy s chlazením.
Propojení dvou stanic
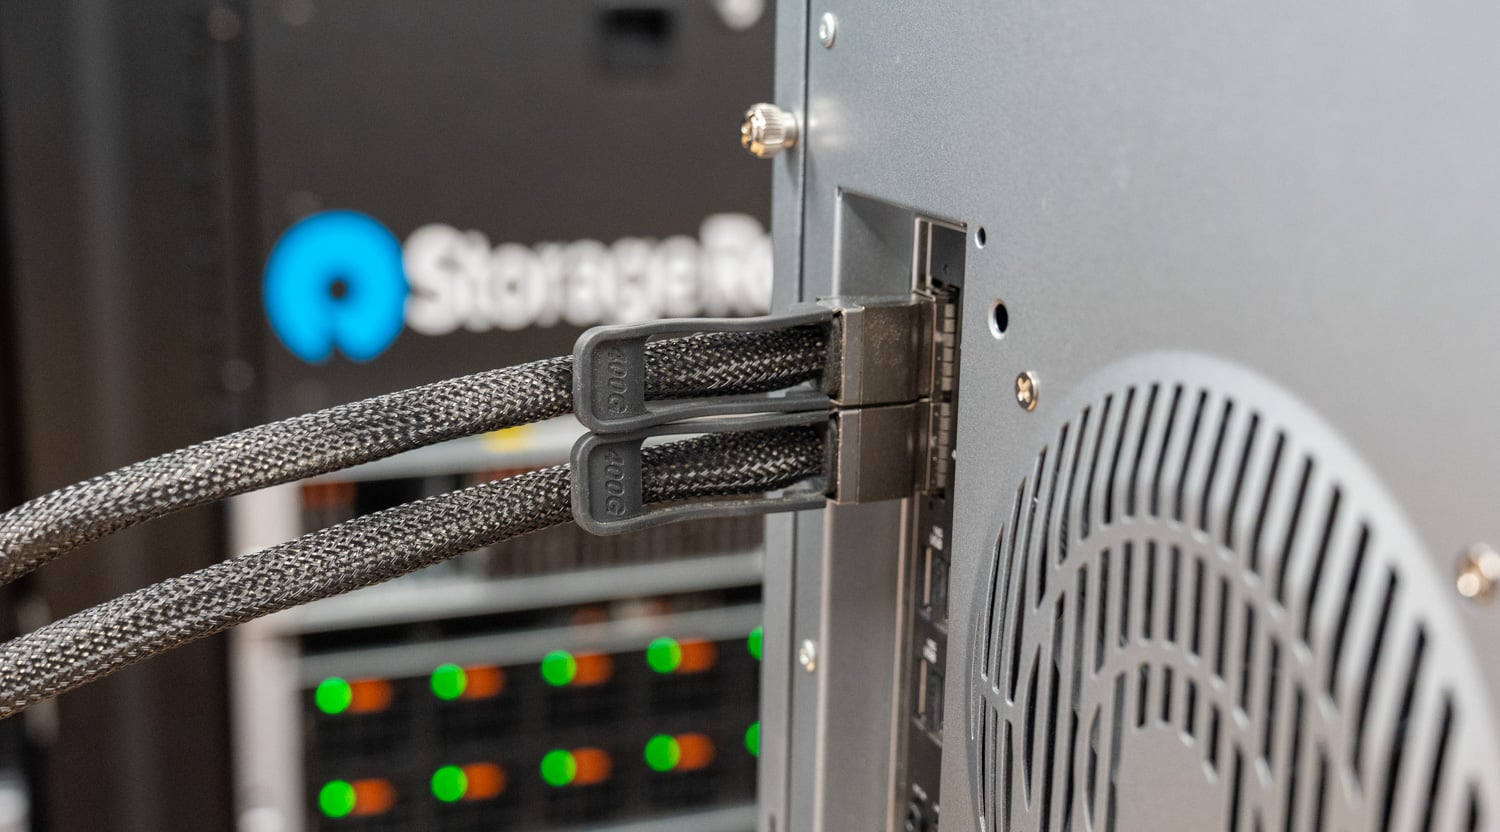
Seskupení dvou stanic DGX bylo jednoduché: propojili jsme ASUS a HP přímo pomocí dvou měděných kabelů 400G Direct Attach (DAC) mezi jejich odpovídajícími porty QSFP112, čímž jsme získali dvě nezávislá připojení s rychlostí 400 Gb/s.
Co se týče softwaru, NVIDIA poskytuje podrobný návod pro clusterování systémů a instrukce byly dostatečně jasné, takže jsme jednoduše poskytli odkaz na Claude Code a nechali ho, aby se postaral o nastavení. Nakonfiguroval síť mezi oběma stanicemi, spustil testy šířky pásma NCCL a poskytl nám zprávu o výsledcích.
Průvodce je očíslovaný playbook spouštěný z třetího počítače, který se k oběma stanicím připojuje přes SSH. Porty jsou propojeny jako odpovídající kolejnice, QSFP0 na QSFP0 a QSFP1 na QSFP1, a každá kolejnice se stává vlastním bodovým propojením RoCEv2: skripty přivedou dvě rozhraní ConnectX-8 na 9 000bajtovou MTU, každé kolejnici přidělí vlastní privátní /24 a použijí běhová nastavení RoCE a GPUDirect.
Ověřovací průchod poté potvrdí, že oba linky trénované na 400G, že jumbo pingy procházejí každou kolejnicí a že obě RDMA zařízení, mlx5_0 a mlx5_1, hlásí aktivitu. Běh ib_write_bw na každé kolejnici dokazuje, že fabric přesouvá RDMA provoz, nikoli pouze pingy. Poté je NCCL namířen na obě kolejnice s NCCL_IB_HCA=mlx5_0,mlx5_1 a úloha se spustí jako jakýkoli jiný běh na dvou uzlech. Níže uvedené výsledky vzešly z této sekvence.
První tabulka pochází z nccl-tests, kolektivů distribuované inference nebo trénovacích úloh, probíhajících napříč dvěma stanicemi B300 s oběma používanými kolejemi. S jednou GPU na stanici se každý kolektiv omezuje na výměnu dat mezi dvěma GPU přes dvojici 400G linek, takže sloupec šířky pásma sběrnice se odečítá přímo oproti 100 GB/s (800 Gb/s), které oba kabely poskytují. Vrchol představuje nejlepší výsledek napříč velikostmi zpráv; sloupec 16 GiB představuje největší testovanou zprávu, kde se šířka pásma ustálila.
| Operace | Velikost vrcholu | Špičková šířka pásma sběrnice | Šířka pásma sběrnice 16 GiB |
|---|---|---|---|
| Vše redukováno | 1 GiB | 92.242 GB / s | 91.346 GB / s |
| Všichni se shromáždí | 16 GiB | 87.893 GB / s | 87.893 GB / s |
| Snížení rozptylu | 2 GiB | 93.930 GB / s | 92.905 GB / s |
| Broadcast | 16 GiB | 97.975 GB / s | 97.975 GB / s |
| Snížit | 16 GiB | 97.978 GB / s | 97.978 GB / s |
| Všechni ke všem | 8 GiB | 80.522 GB / s | 80.512 GB / s |
| Odesílání/příjem, jednosměrné | 16 GiB | 97.953 GB / s | 97.953 GB / s |
| Odesílání/příjem, obousměrné | 16 GiB | 83.748 GB/s na směr | Celkem 167.496 GB/s |
Vysílání, redukce a jednosměrné odesílání/příjem dosáhly rychlosti 98 GB/s, což je 98 % kapacity obou kabelů. Vzorce s daty pohybujícími se oběma směry najednou dosáhly nižších hodnot, 92 GB/s pro redukci všech dat a 80 GB/s pro přenos všech dat ke všem. Referenčním bodem pro tyto účely je výsledek obousměrného odesílání/příjmu: s oběma grafickými procesory vysílajícími současně se rychlost v každém směru ustálila na 84 GB/s, celkem 167 GB/s napříč linkou.
Druhá tabulka klesá pod NCCL k nezpracované cestě RDMA, přičemž ib_write_bw používá jednu lištu najednou. Řádky GPUDirect zapisují 1 MiB přenosů z HBM jednoho B300 do HBM druhého, přičemž síťová karta čte a zapisuje přímo do paměti GPU; obě linie dosáhly rychlosti 392 Gb/s, což je 98 % rychlosti linky. Řádky host-memory jsou základním kouřovým testem průvodce, jedním párem fronty získaným z paměti Grace, kterou playbook NVIDIA na lince 400G udává na 220 až 230 Gb/s; my jsme zaznamenali 228 Gb/s. Řádek latence je 8bajtový zápis: v průměru 1.46 µs.
| test | Šířka pásma | Využití odkazů |
|---|---|---|
| GPUDirect RDMA, paměť GPU, ib_write_bw, přenosy 1 MiB | ||
| Železnice 0 | 392.15 Gb / s | 98.04% |
| Železnice 1 | 392.15 Gb / s | 98.04% |
| RDMA hostitelské paměti, obě kolejnice | ||
| Zápis RDMA, jednosměrný | 228.15 Gb / s | |
| RDMA čtení, jednosměrné | 228.23 Gb / s | |
| Odesílání RDMA, jednosměrné | 228.16 Gb / s | |
| RDMA zápis, obousměrný | Celkem 447.10 Gb/s | |
| Latence zápisu RDMA, 8 bajtů | Průměr 1.46 µs; 1.63 a 1.66 µs 99. percentil u železnice | |
Jak jsme testovali cluster
Čas s touto dvojicí byl omezený, proto jsme se zaměřili na inferenci, což je v současnosti nejoblíbenější úloha v oblasti umělé inteligence. Tuto práci plánujeme rozšířit i na větší klastry. V tomto článku jsme se zaměřili na větší modely a porovnali jednu stanici se dvěma stanicemi pomocí tenzorového paralelismu (TP) a disagregace prefill/decode (PD).
Tenzorový paralelismus rozděluje váhové tenzory a výpočty v rámci modelu mezi více GPU. V naší konfiguraci se dvěma stanicemi, neboli TP2, každá B300 drží část modelu a obě pracují na každém požadavku. To nám dává více paměti s vysokou šířkou pásma (HBM), do které můžeme umístit váhy, spolu s více výpočetními prostředky pro jejich spuštění. Vyžaduje to také, aby si GPU vyměňovaly mezivýsledky a synchronizovaly se prostřednictvím NCCL v průběhu inference, takže komunikační režie se stává součástí nákladů na spuštění modelu.
Disagregovaná inference přiřazuje fáze předvyplňování a dekódování požadavku odděleným workerům. Předvyplňování zpracovává vstupní prompt a vytváří mezipaměť klíč/hodnota (KV), což je stav pozornosti, který model znovu používá během generování. Dekódování poté tento stav použije ke generování výstupních tokenů jeden po druhém. Tyto dvě fáze mají odlišné požadavky na zpracování: předvyplňování je náročné na výpočetní výkon, zatímco dekódování je náročné na šířku pásma paměti. Ve větších nastaveních umožňuje disagregovaná inference, jako je tato, operátorovi nezávisle škálovat tyto workery podle poptávky, jak ukázal náš článek o odlehčení mezipaměti KV.
V konfiguraci s jedním uzlem, kdy obě fáze sdílejí jednoho pracovníka, může vLLM prokládat práci s předvyplňováním příchozích výzev s prací s dekódováním požadavků, které již probíhají. Toto zpracování výzev může prodloužit dobu mezi výstupními tokeny. V našem nastavení PD jedna stanice zpracovává předvyplňování a přenáší mezipaměť KV požadavků na druhou stanici, která se stará o dekódování. Každý pracovník má přístup ke své vlastní kopii modelu, včetně všech dat umístěných v paměti Grace. Dekódovací pracovník již nemusí plánovat zpracování nových výzev současně s generováním tokenů, což zrychluje propustnost inference.
Pro naše testování určovaly paměťové nároky modelu, který přístup jsme použili. U největších kontrolních bodů, kde jedna stanice musela přesunout značné množství vah modelu do paměti Grace, nám TP poskytl nejlepší výkon. Rozložení vah mezi dvě GPU umožnilo, aby větší část modelu zůstala v HBM, a snížilo se tak riziko ztráty zátěže. U modelů, které se poměrně dobře hodily na jednu stanici, ať už kompletně v HBM, nebo s omezeným přesunem do Grace, jsme použili disagregaci PD. Ta zahrnovala DeepSeek V4.1 Flash s jeho vyhledávacími tabulkami Engram umístěnými v paměti Grace DRAM.
Abychom zachovali srovnatelnost s naším starším pokrytím, zachovali jsme naši starší metodologii s pevnými délkami vstupních sekvencí (ISL) a výstupních sekvencí (OSL). Stejná pracovní zátěž používá 512 vstupních tokenů a 512 výstupních tokenů, zatímco pracovní zátěž s vysokým počtem předfillů používá 8 192 vstupních tokenů a 1 024 výstupních tokenů. Počet souběžných požadavků měníme, přičemž délky těchto sekvencí zůstává pevná.
Výchozí hodnotou pro jednu stanici v každém grafu je ASUS ET900N G3 z naší recenze, s rozbalením 32 streamů; pro dvě stanice je to 256. Každý bod je jednoprůchodový, takže pokles na jedné úrovni souběžnosti je hlášen jako shromážděný.
Konfigurace inference
| Model | Režim clusteru | Software a licence | Spekulativní dekódování | Vzpomínka na milost |
|---|---|---|---|---|
| DeepSeek V4.1 Flash (FP8) | Předvyplňování/dekódování, úplná kopie pro každou stanici | vllm/vllm-openai:deepseekv41-flash-0909 | Vlastní tvůrce modelu, pevných 5 žetonů | Dvě engramové tabulky FP8 (188.84 GiB) uložené v paměti Grace plus 131.97 GB expertních vah nahraných na každé stanici. |
| GLM-5.3 NVFP4 | Tenzorová rovnoběžka (TP2) | Kontejner NVIDIA vLLM 26.08 NGC (vLLM 0.27.1) | MTP, fixní draft se 5 tokeny | Žádné na clusteru; 215 GB expertních vah je odloženo na jedné stanici |
| GLM-5.3 Flash NVFP4 | Předvyplňování/dekódování – disagregace, předvyplňování ASUS, dekódování HP | vLLM 0.28.1 RC1 | MTP, fixní draft se 5 tokeny | Nevyplněno |
| GLM-5.2 NVFP4 | Tenzorová rovnoběžka (TP2) | Kontejner NVIDIA vLLM 26.08 NGC (vLLM 0.27.1) | MTP, fixní draft se 3 tokeny | Žádné na clusteru; přibližně 215 GB expertních vah je odloženo na jedné stanici |
| MiniMax-M3 NVFP4 | Tenzorová rovnoběžka (TP2) | Kontejner NVIDIA vLLM 26.08 NGC (vLLM 0.27.1) | EAGLE3, pevný draft se 3 žetony | Žádný v klastru; jen malá část expertů vysazených na jedné stanici |
Výkon inference
DeepSeek V4.1 Flash
DeepSeek V4.1 Flash běžel disagregovaně, jedna stanice zpracovávala předfill a druhá dekódování, přičemž každá stanice obsahovala plnou kopii modelu: dvě tabulky engramů FP8 o celkové velikosti 188.84 GiB, uložené v paměti Grace a dalších 131.97 GB expertních vah nahrávaných do paměti Grace. Díky tomu je to jediná konfigurace v sadě s pamětí Grace ve hře na obou strojích. Je to také jediný model bez linky pro jednu stanici, protože recenze od ASUSu používala starší kontrolní bod V4 Flash a tyto dva nelze přímo srovnávat.
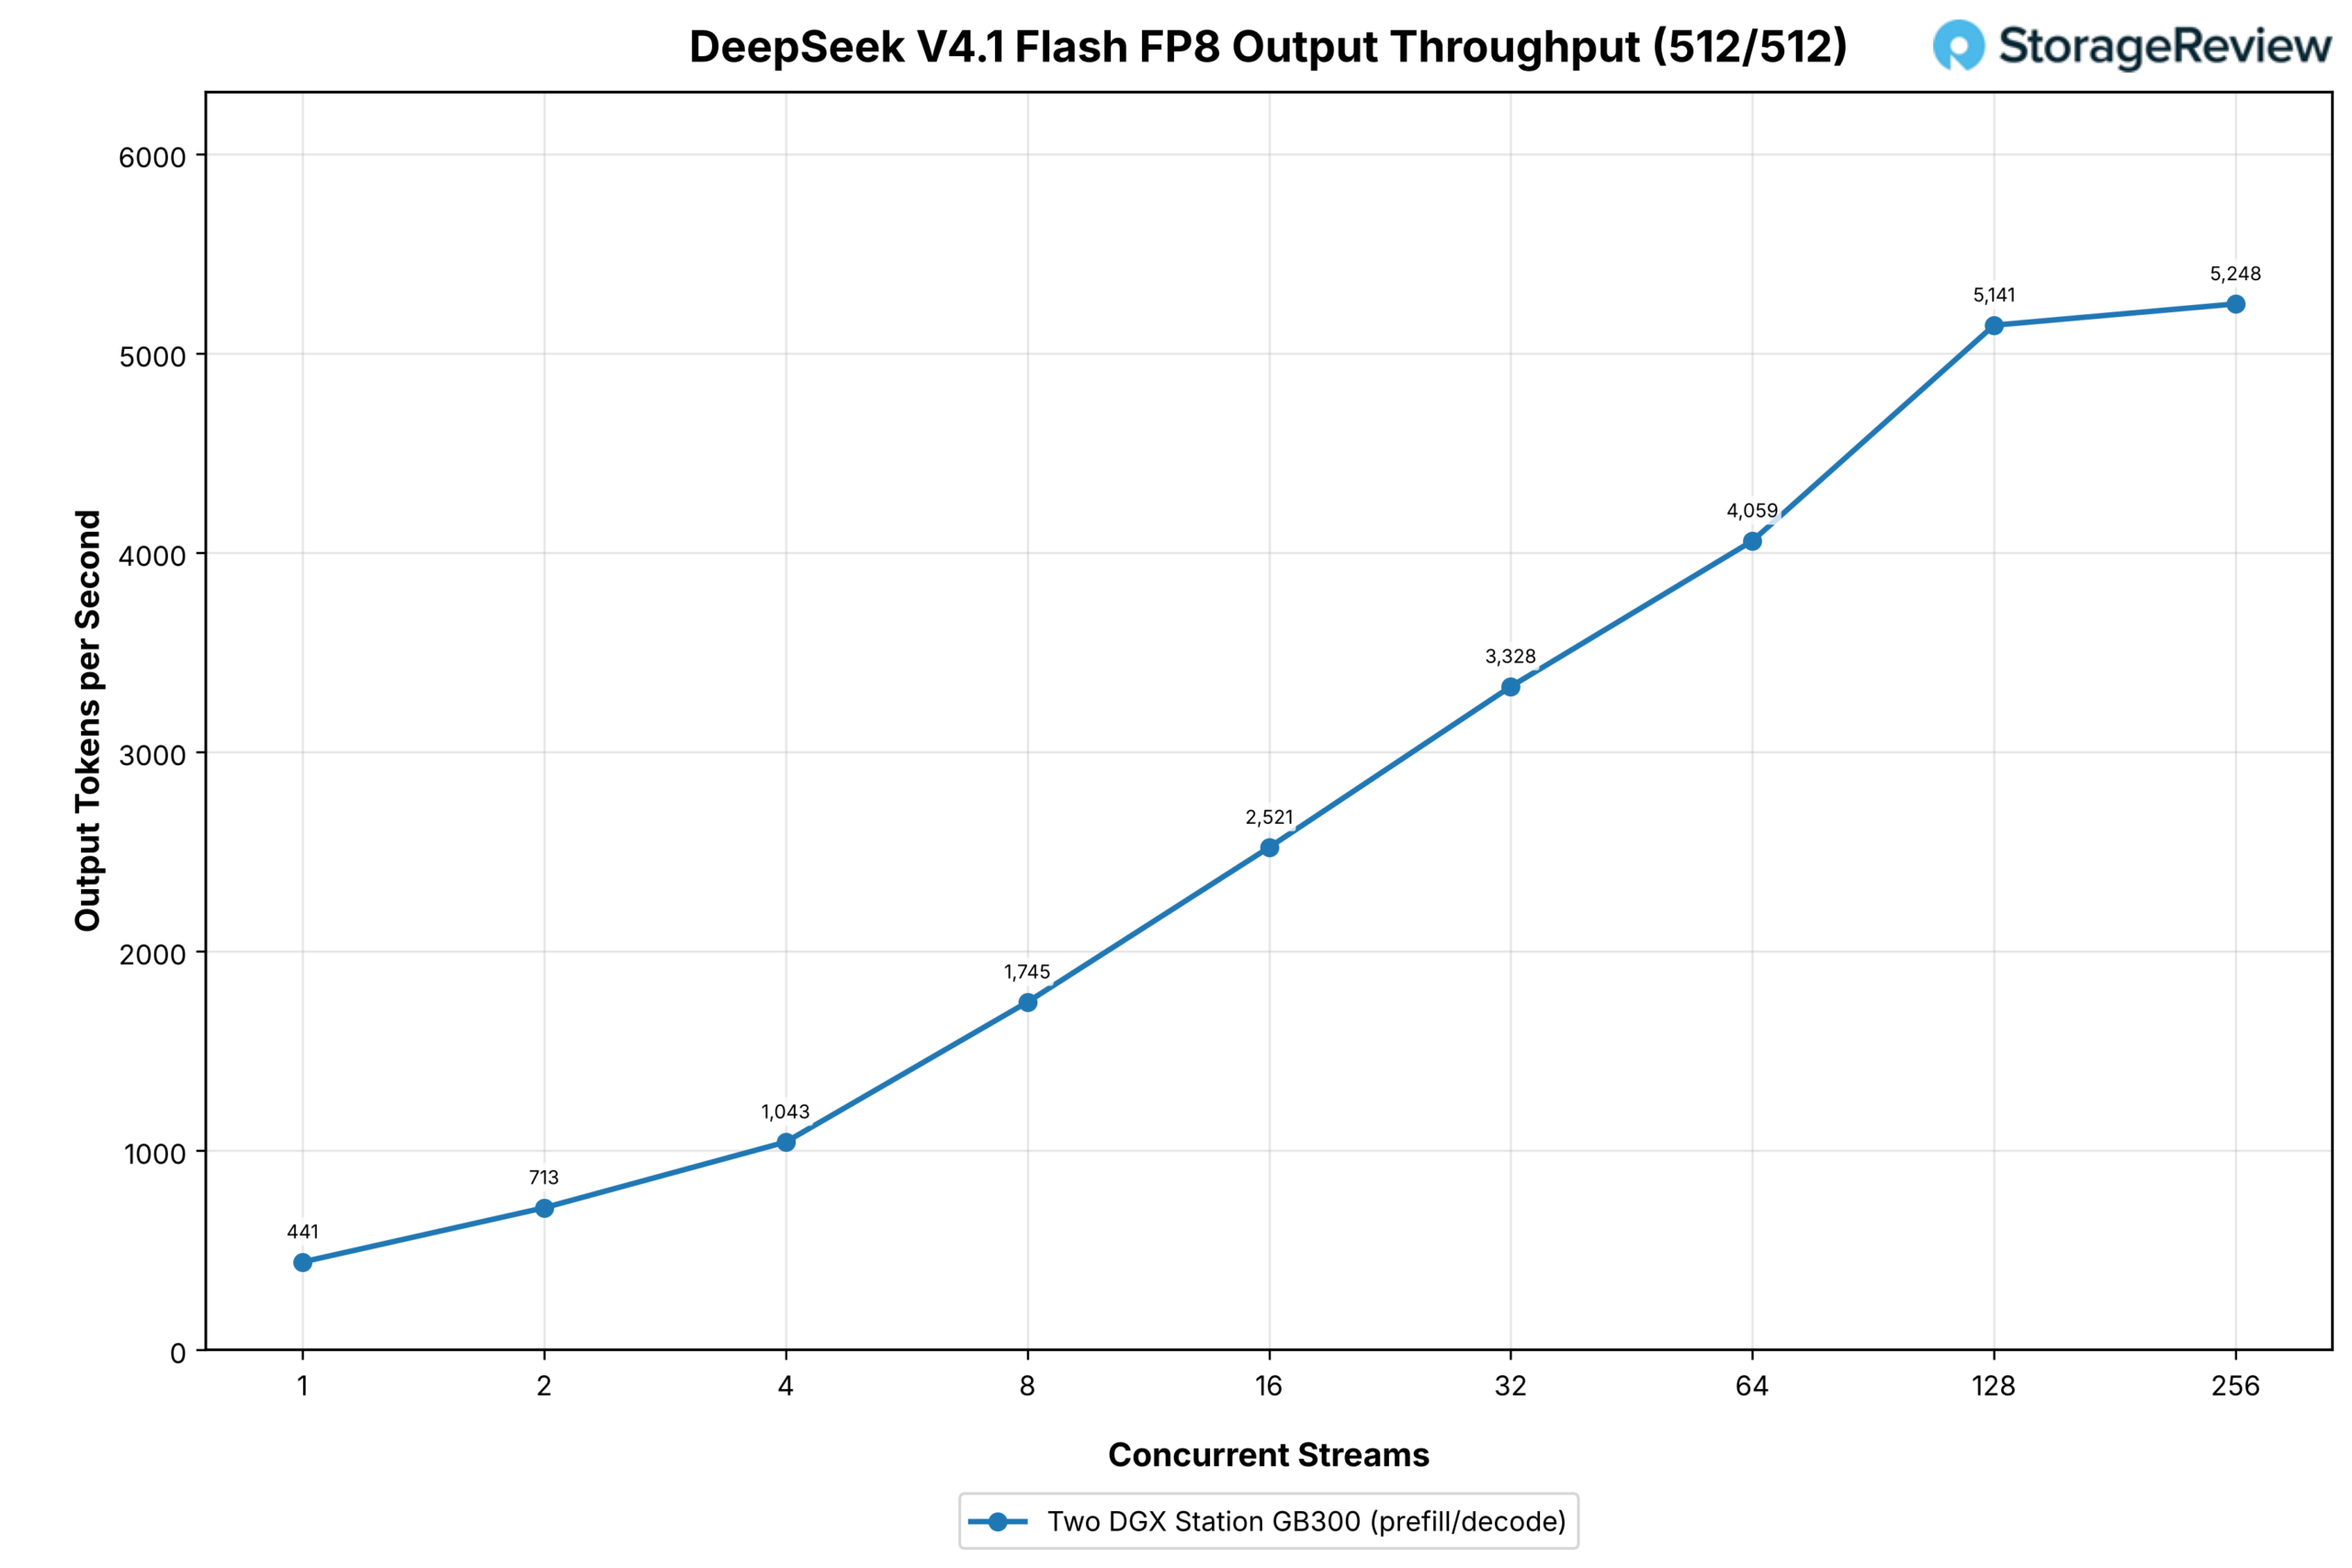
Na clusteru se dvěma stanicemi běžel nativní model FP8 od 441 výstupních tokenů za sekundu v jednom streamu přes 3 328 při 32 streamech, 5 141 při 128 streamech a 5 248 při 256 streamech, což je nejvyšší výstupní propustnost ze všech modelů v této sadě, přičemž křivka se zplošťuje pouze v horní části rozsahu. Pro srovnání, jediná stanice ASUS v naší recenzi obsluhovala V4 Flash s rychlostí 1 766 výstupních tokenů za sekundu ve 32 streamech.
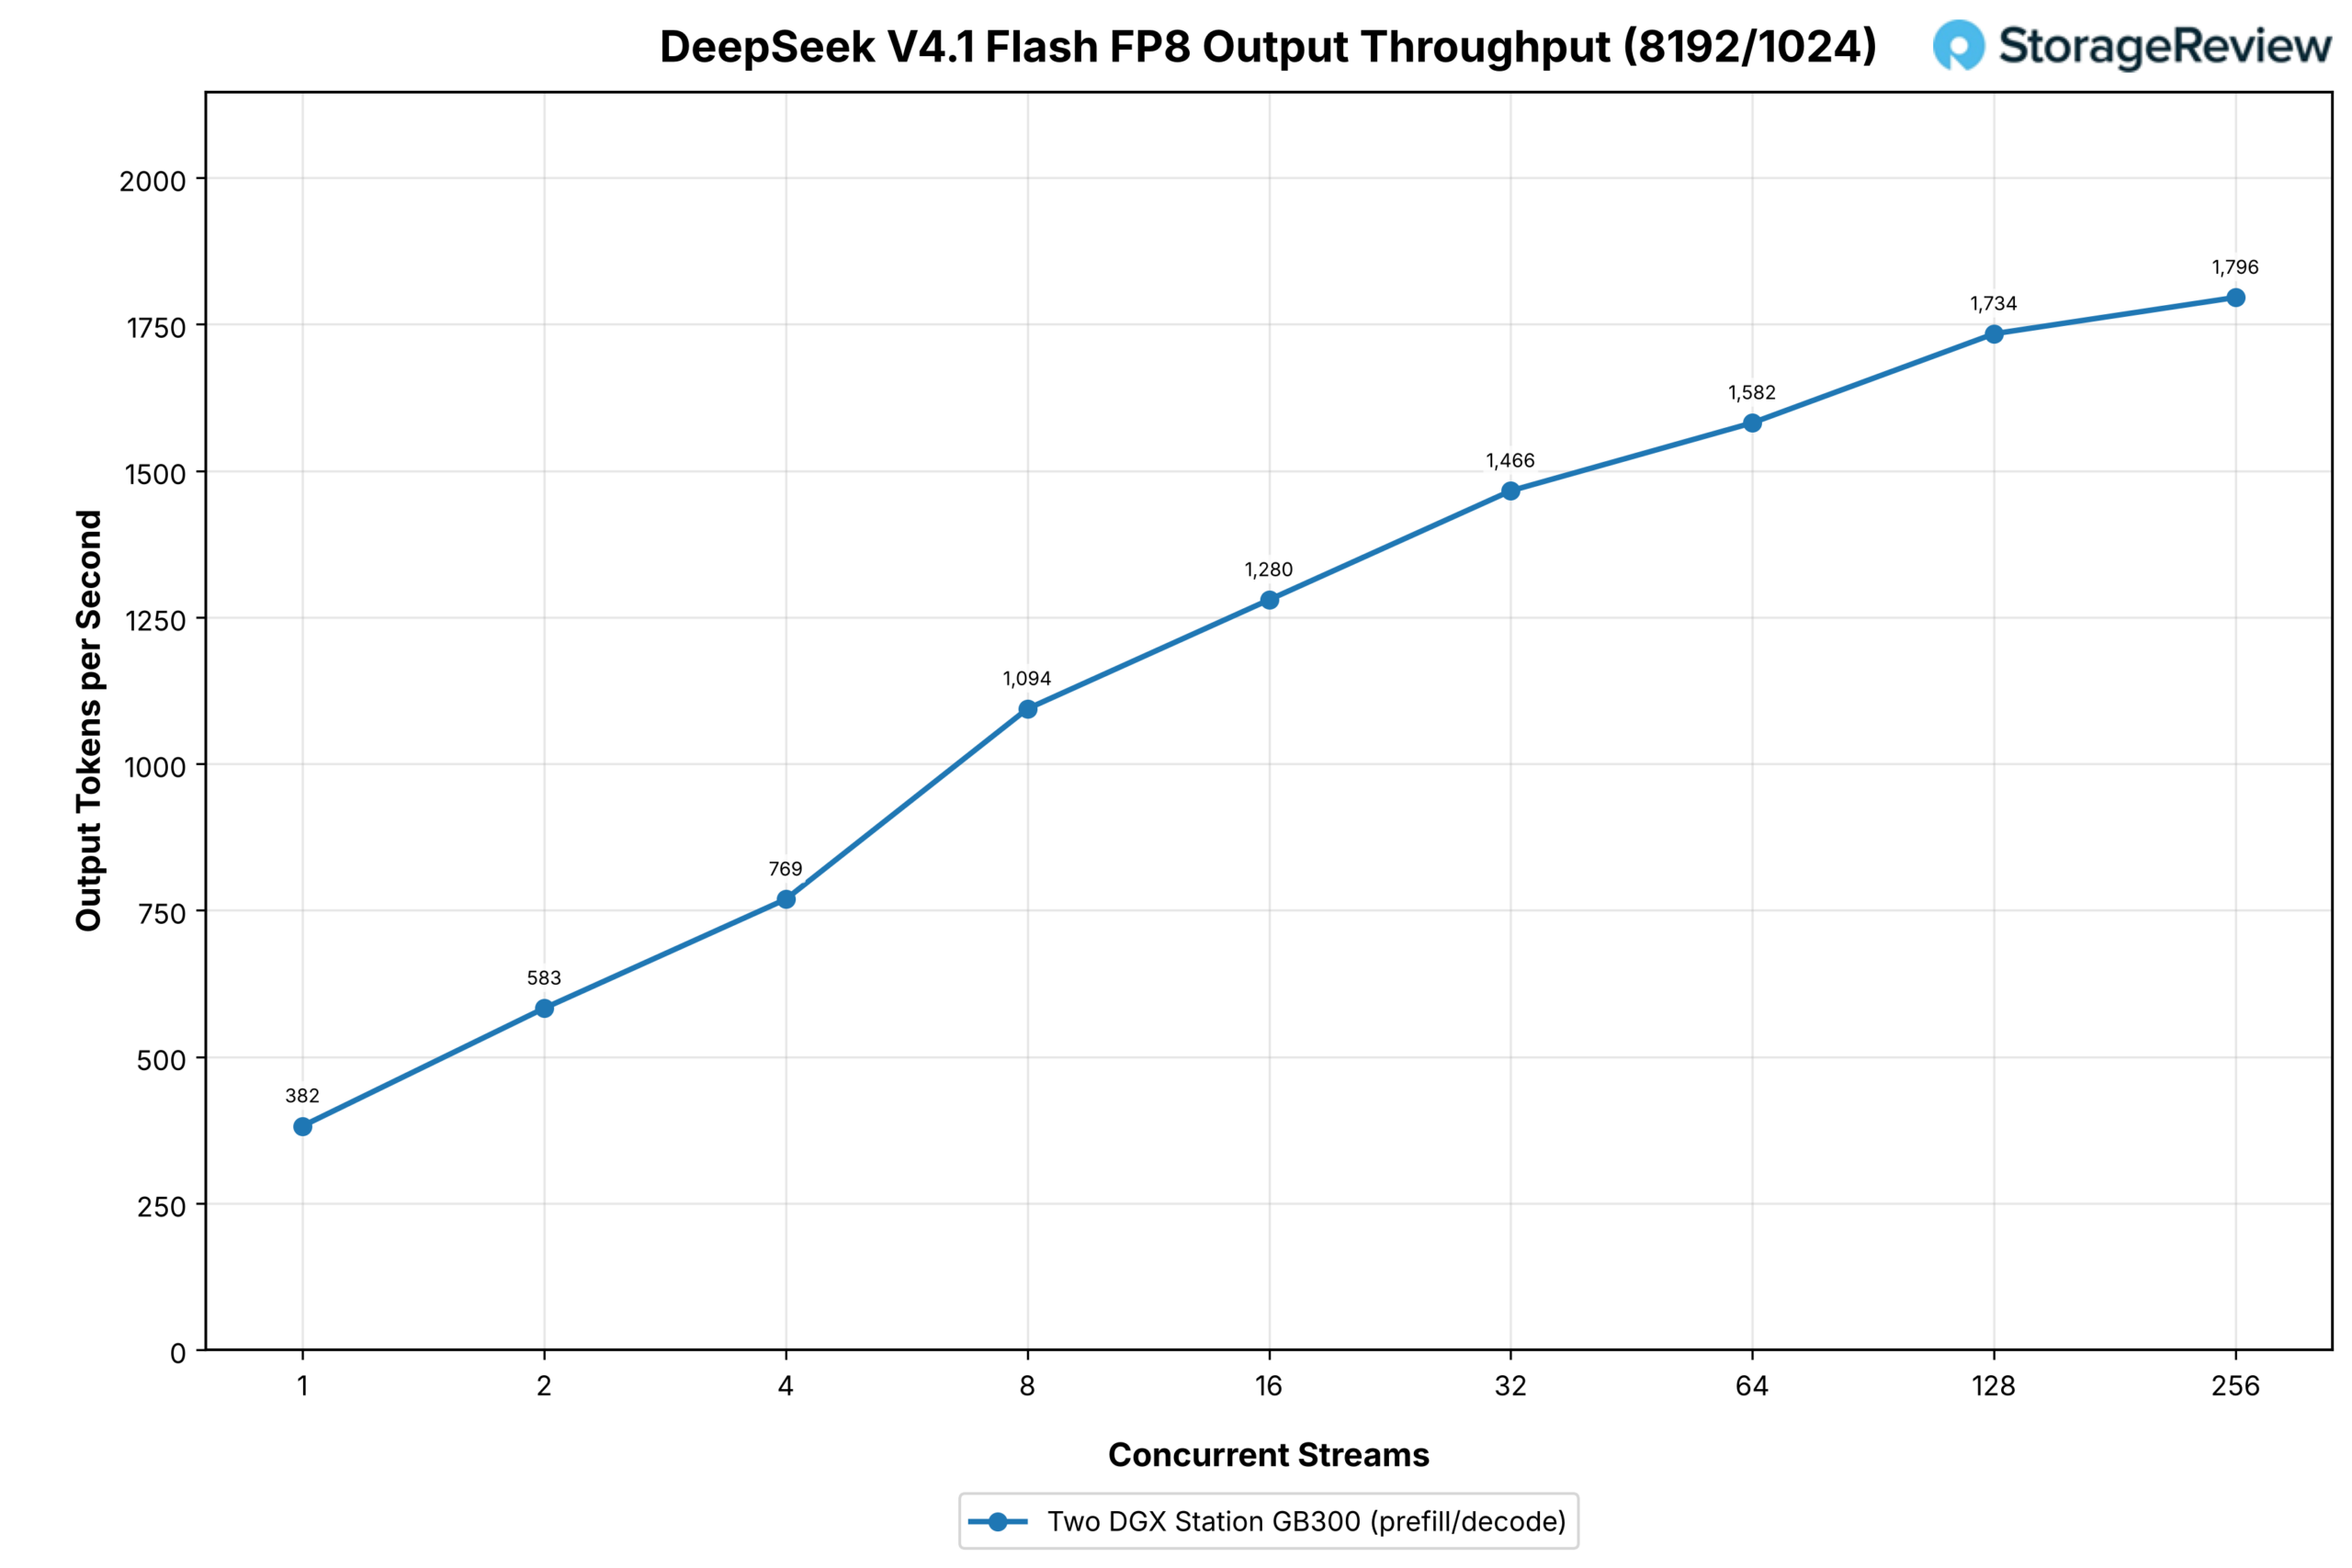
V profilu s vysokým počtem předfillů se cluster pohyboval od 382 výstupních tokenů za sekundu v jednom streamu přes 1 466 při 32 streamech až po 1 796 při 256 streamech. Protože každý požadavek nese 8 192 vstupních tokenů, dosáhla celková propustnost na vrcholu cyklu 16 163 tokenů za sekundu. Díky tabulkám Engram a 131.97 GB expertních vah uložených v paměti Grace na každé stanici zůstávají křivky v celém cyklu plynulé bez ohledu na situaci.
GLM-5.3
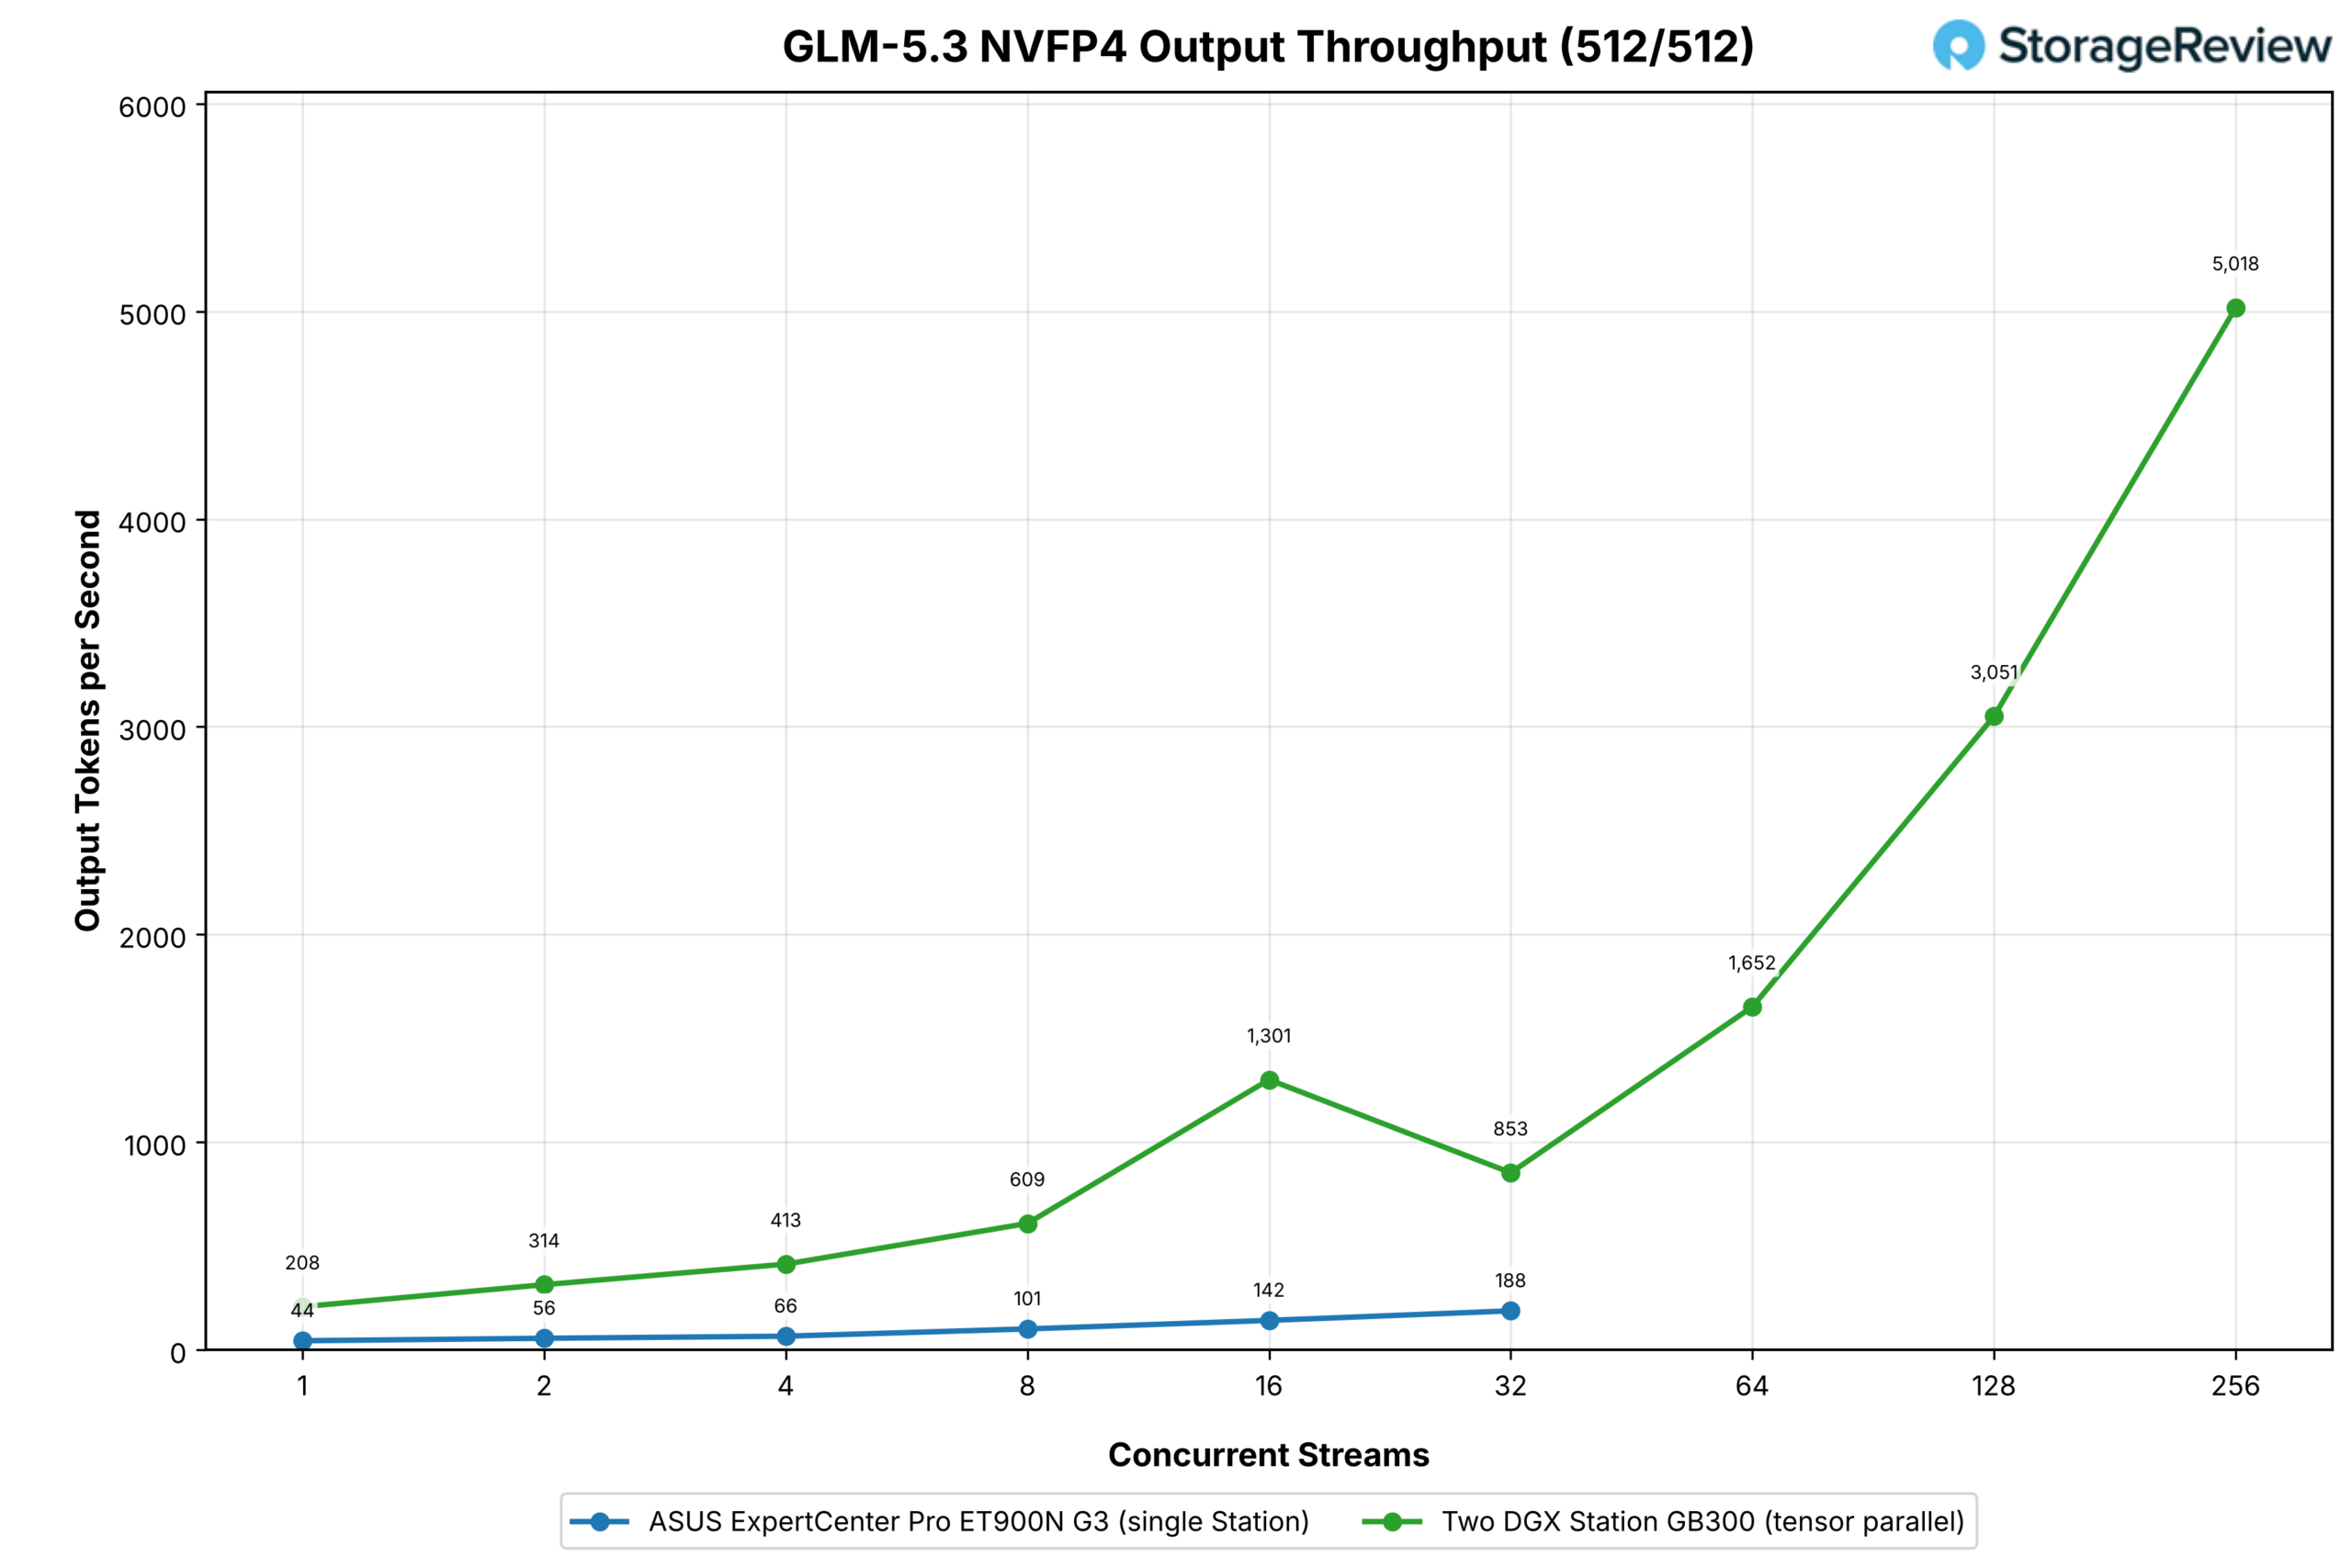
GLM-5.3 běžel v TP2 bez Grace offloadu. Na jedné stanici se do Grace paměti přesune 215 GB expertních vah a výsledek clusteru sleduje GLM-5.2 po většinu doby snímání, než se stane nerovnoměrným. Jedna stanice běžela ze 44 výstupních tokenů za sekundu v jednom streamu na 188 při 32 tokenech při stejném zatížení.
Dvoustaniční cluster se zvýšil z 208 u jednoho proudu na 1 301 u 16, což je mezi 4.7násobkem a 9.2násobkem počtu u jedné věže, klesl na 853 u 32 a poté pokračoval v nárůstu na 1 652 u 64, 3 051 u 128 a 5 018 u 256. Bod 32 proudů je v datech tak, jak jsou shromážděna; rozhodnutí o dávkování a výběr jádra se mění s rostoucí souběžností a tenzorově paralelní nasazení přidává kolektiv na každou vrstvu, která musí být dokončena před dalším krokem, takže křivka není přímka, ale strop při 256 proudech je 27násobkem toho, čeho jedna stanice dosáhla u 32 proudů.
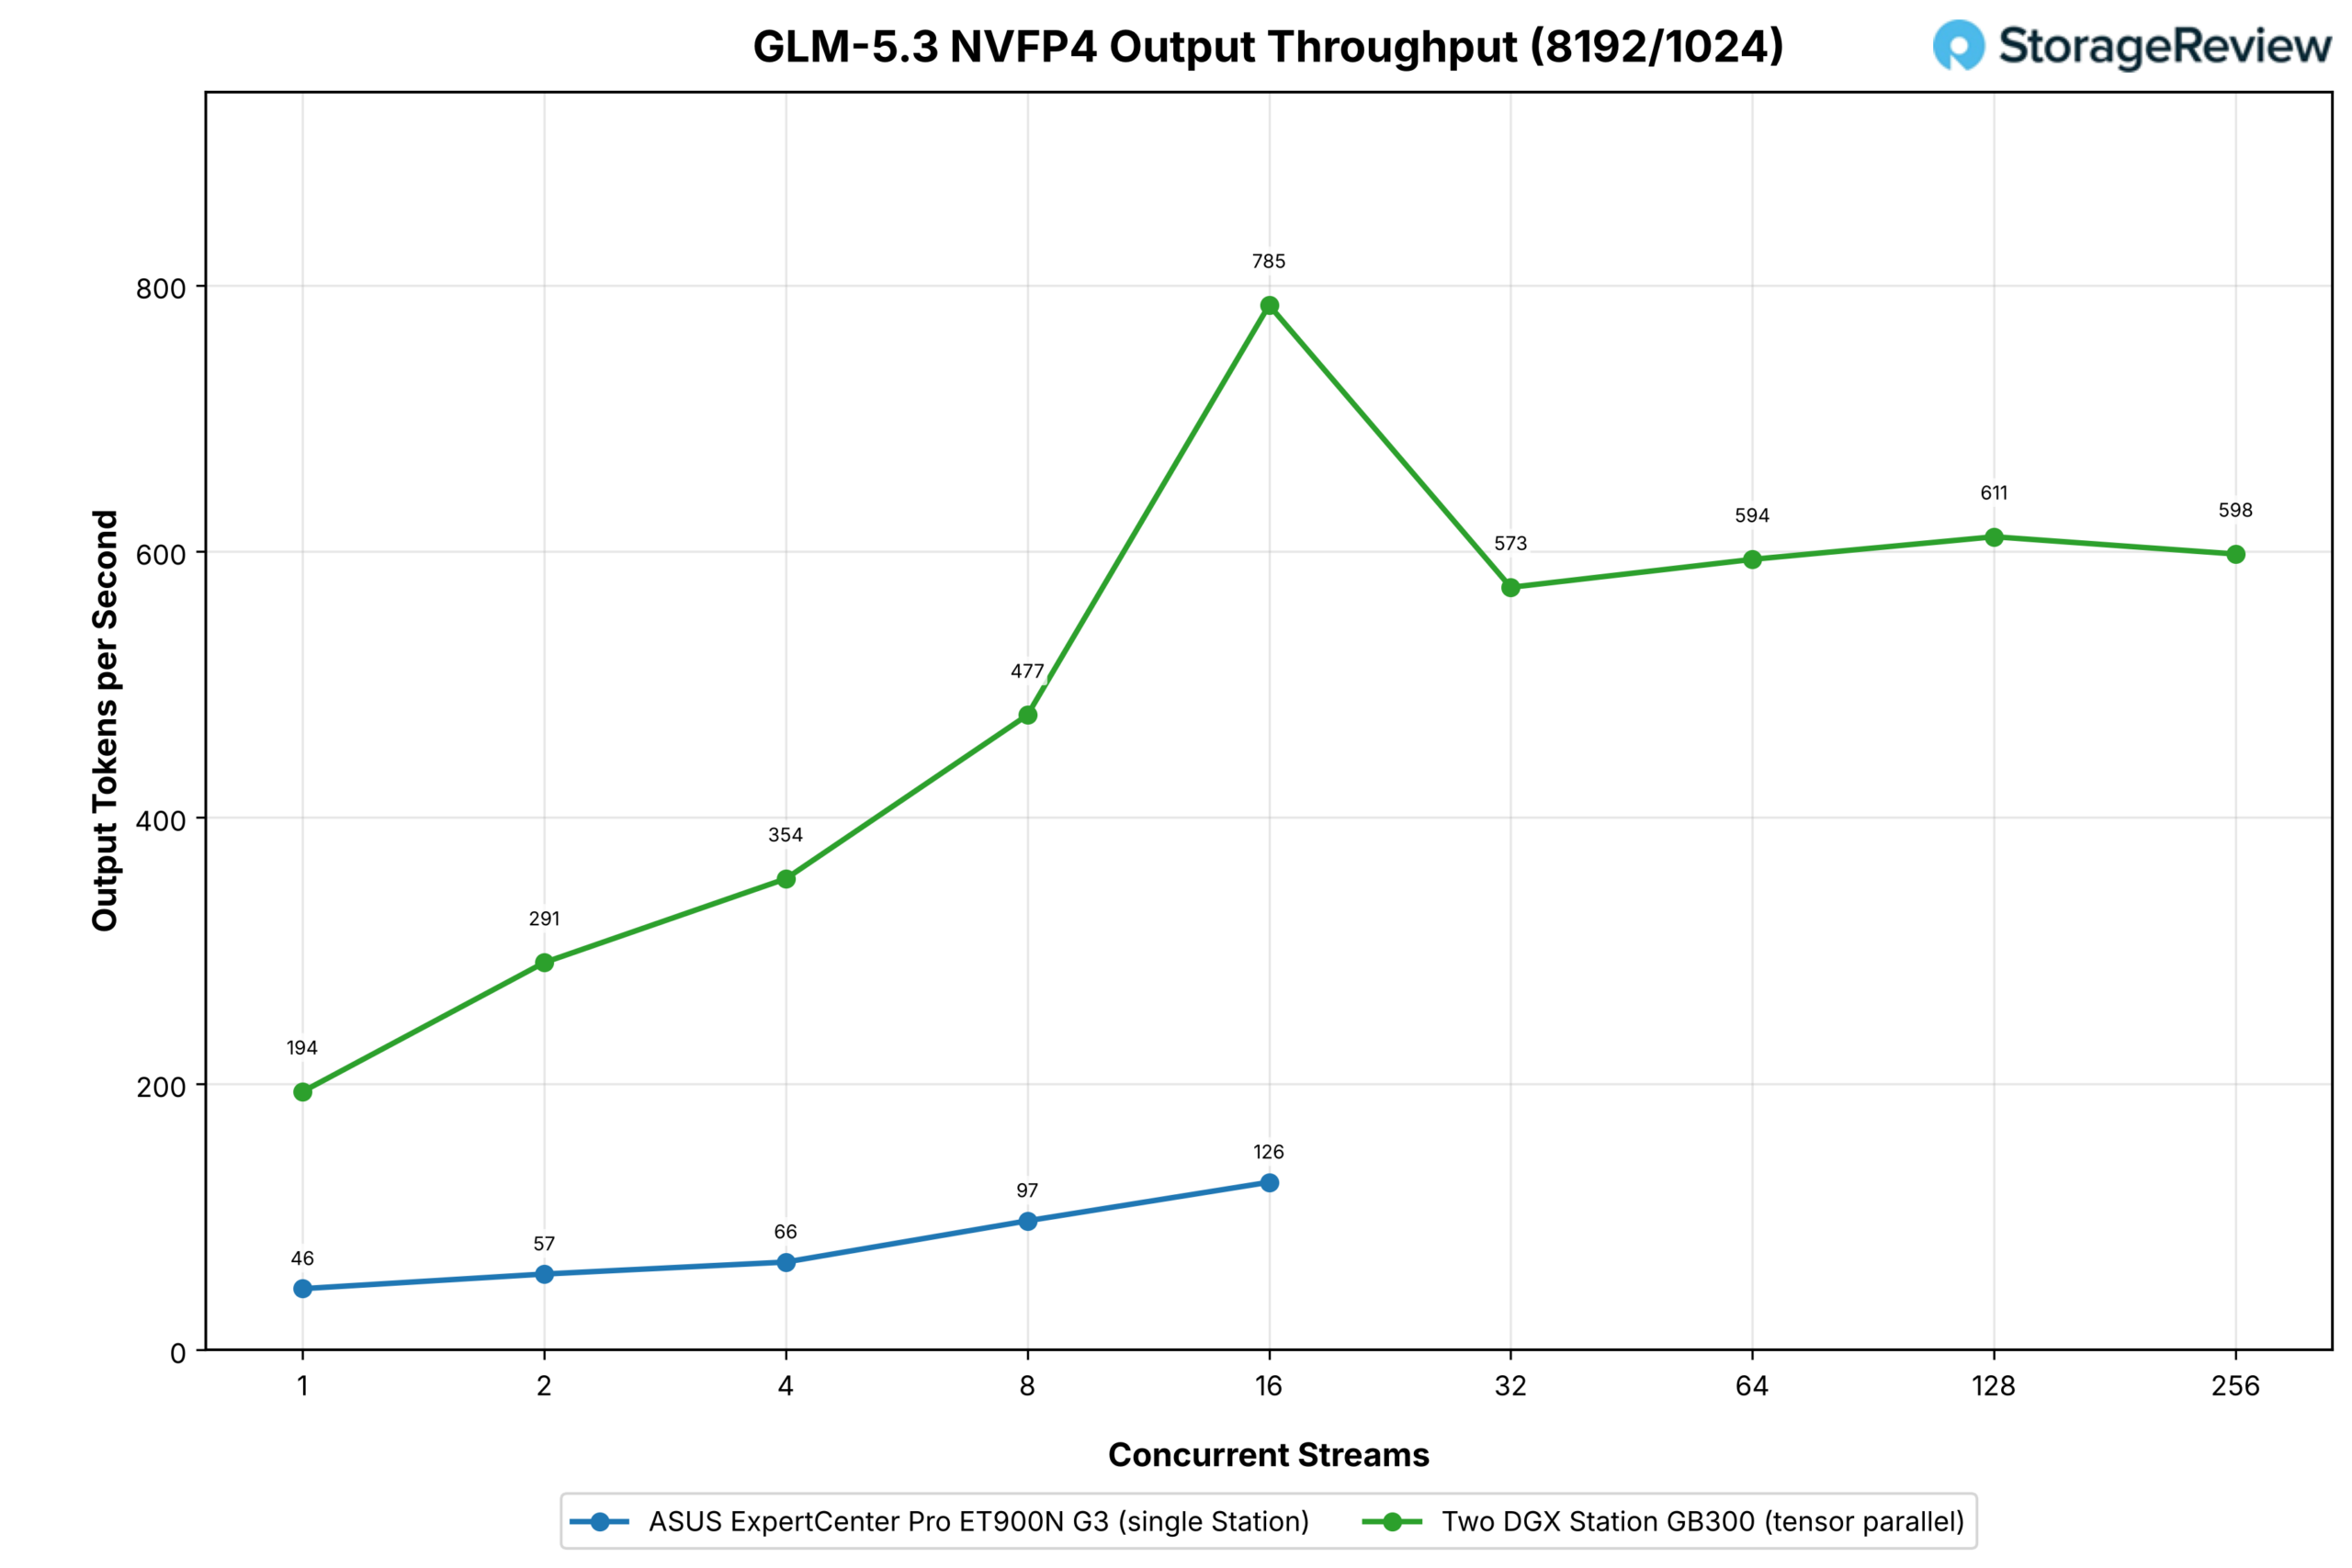
V profilu s vysokým počtem předfillů se jediná stanice záměrně zastavila na 16 streamech: model s odlehčenou zátěží se brzy zploští a z dalšího posunu souběžnosti se nelze moc poučit. Z 46 výstupních tokenů za sekundu u jednoho streamu se posunula na 126 u 16. Cluster se ve stejném rozsahu posunul ze 194 na 785, nahoře 6.2x, a poté se ustálil mezi 573 a 611 z 32 streamů na 256, což je dlouhodobý strop poblíž 600 výstupních tokenů za sekundu, což je stále asi pětinásobek nejlepší hodnoty jediné stanice.
Blesk GLM-5.3
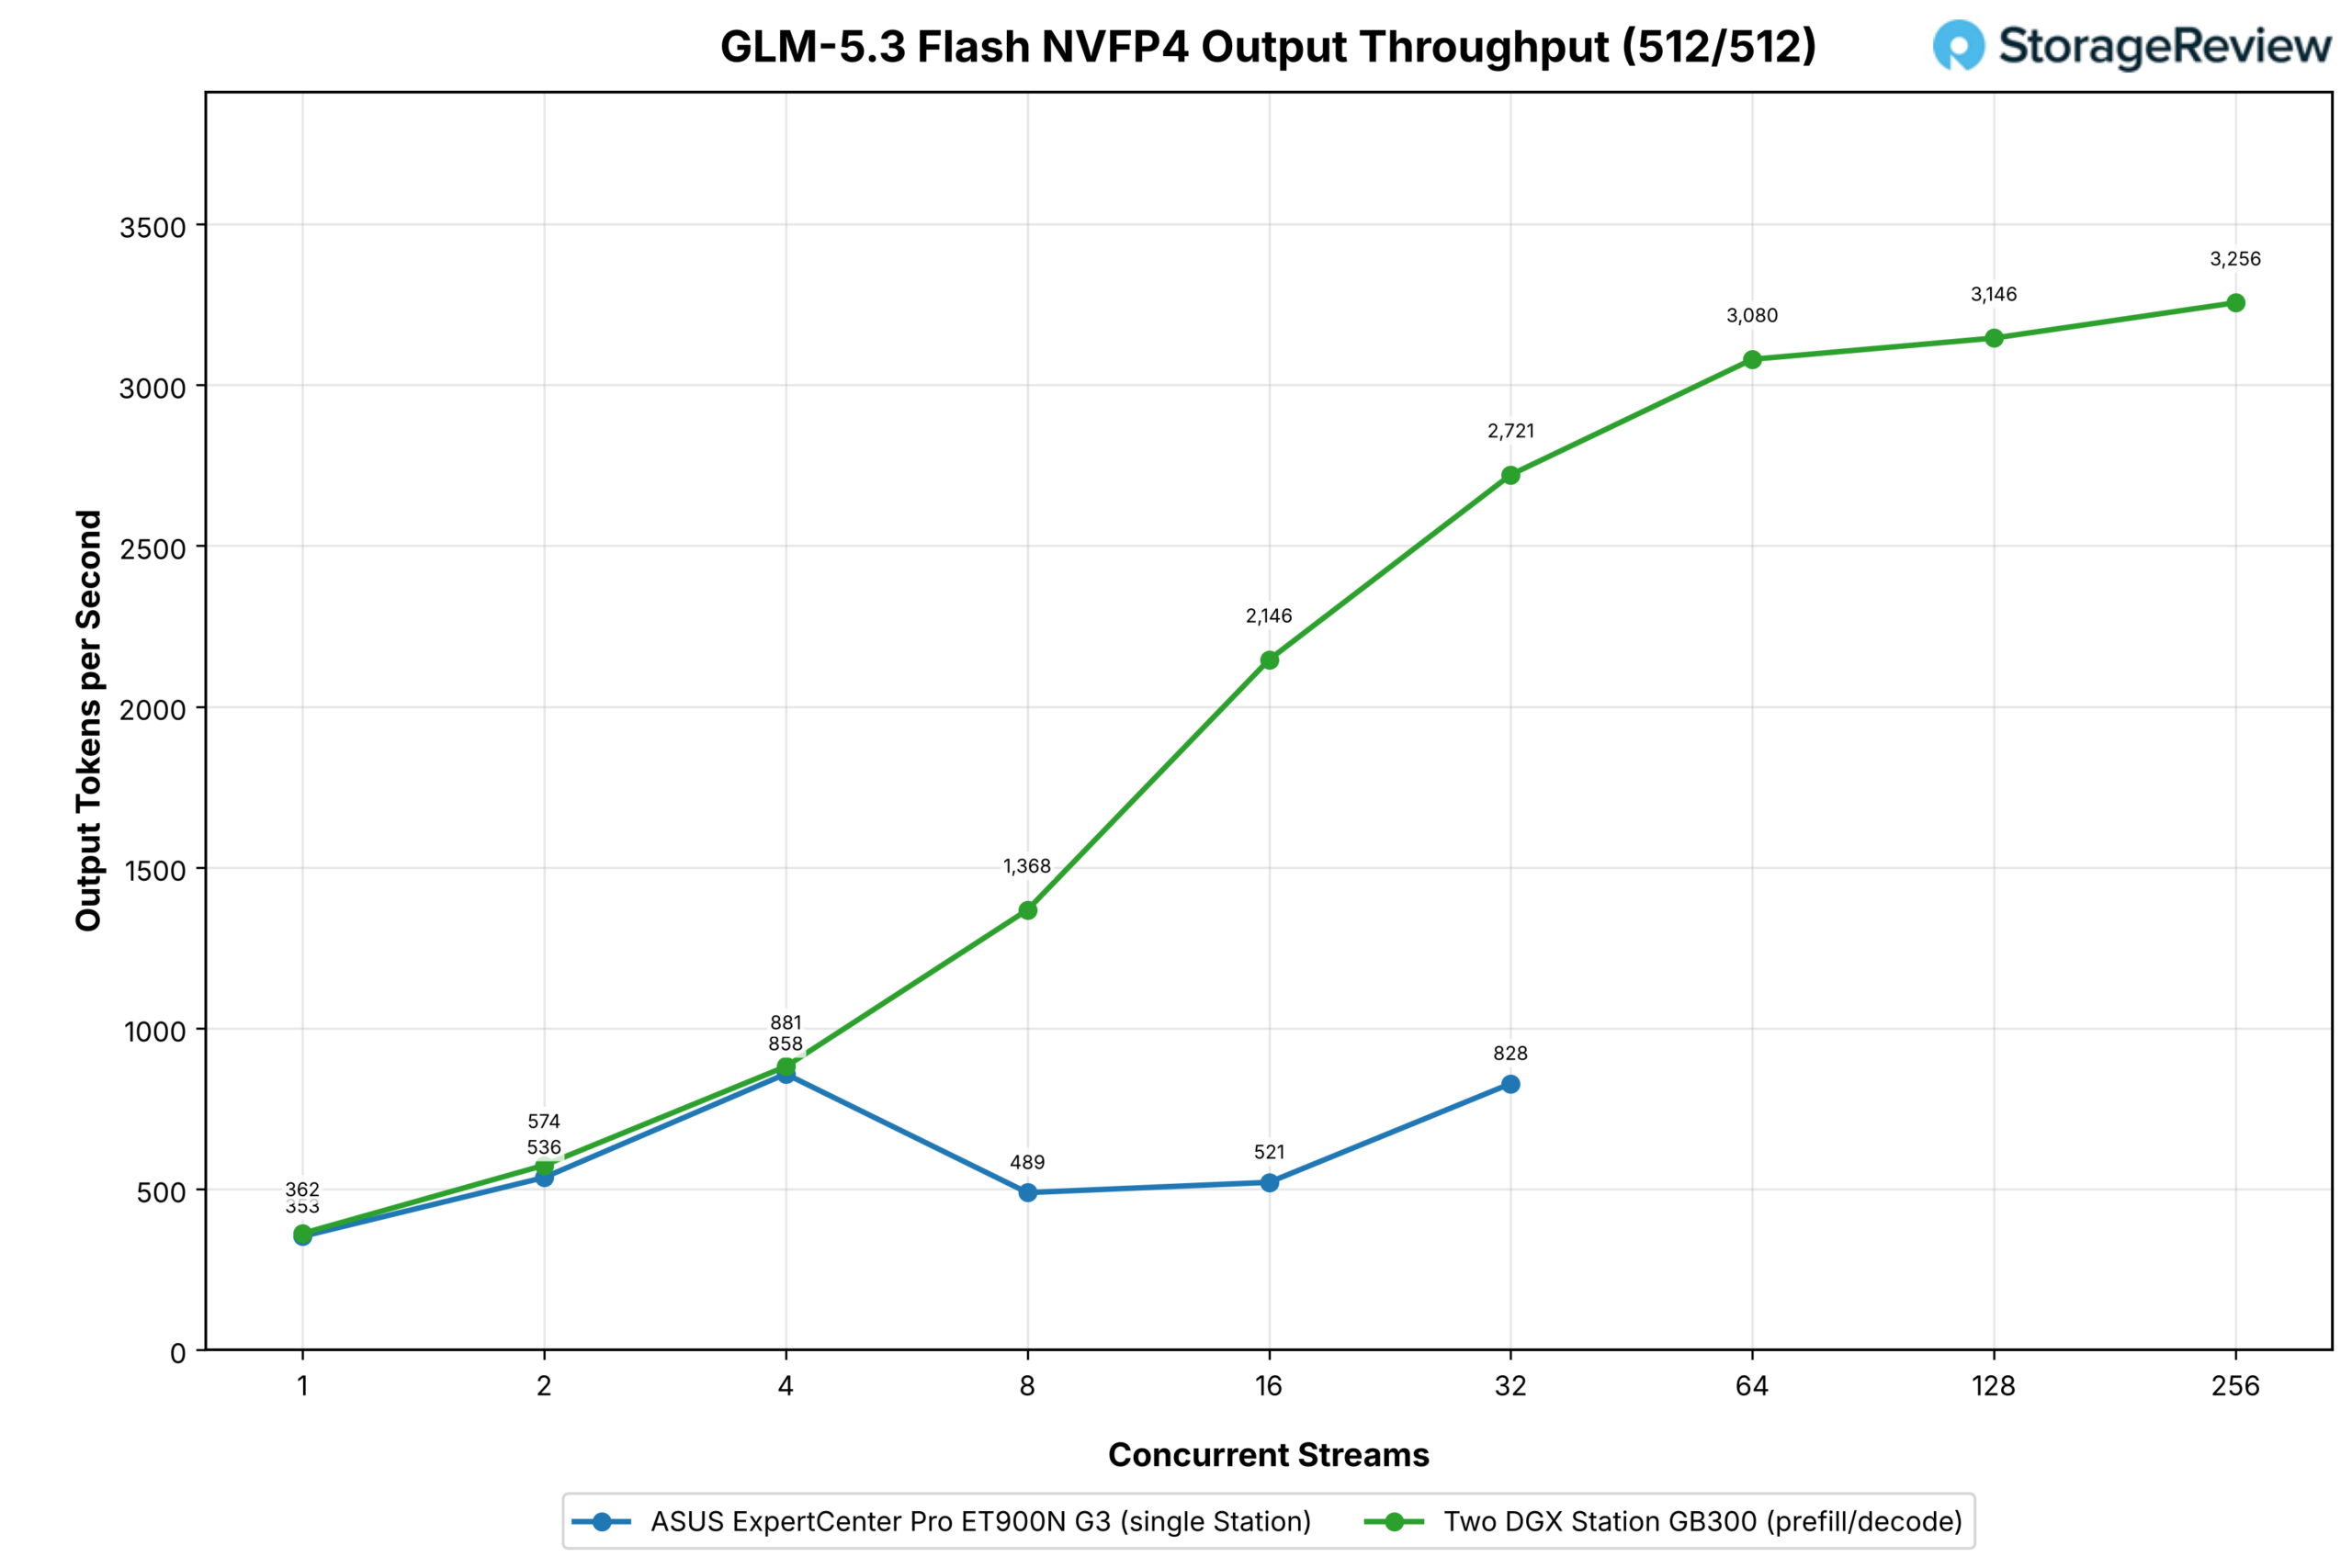
GLM-5.3 Flash je dostatečně malý na to, aby každá stanice pojala celou kopii, takže běžel disagregovaně, s předfillem ASUS a dekódováním HP. Flash má malý počet aktivních parametrů, takže na jedné stanici již běží rychle: 353 výstupních tokenů za sekundu v jednom streamu a 828 při 32 tokenech při stejném zatížení, s nerovnoměrným středem (858 u čtyř streamů, 489 u osmi), který hlásíme jako shromážděný.
U desagregované dvojice se stejné zatížení pohybovalo od 362 výstupních tokenů za sekundu u jednoho streamu přes 2 721 u 32 tokenů za sekundu, což je 3.3krát více než u jedné věže, a dále až na 3 256 u 256 streamů.
U jednoho a dvou streamů dvojice téměř přesně odpovídá jedné stanici, což je přesně to, co byste očekávali, když dekódovací stanice vykonává stejnou práci sama; zisk se dostaví, jakmile je v provozu dostatek požadavků, aby stanice s předběžným naplněním zůstala zaneprázdněna a aby dekódovací stanice mohla těžit z toho, že se nikdy nepozastavuje kvůli předběžnému naplnění.
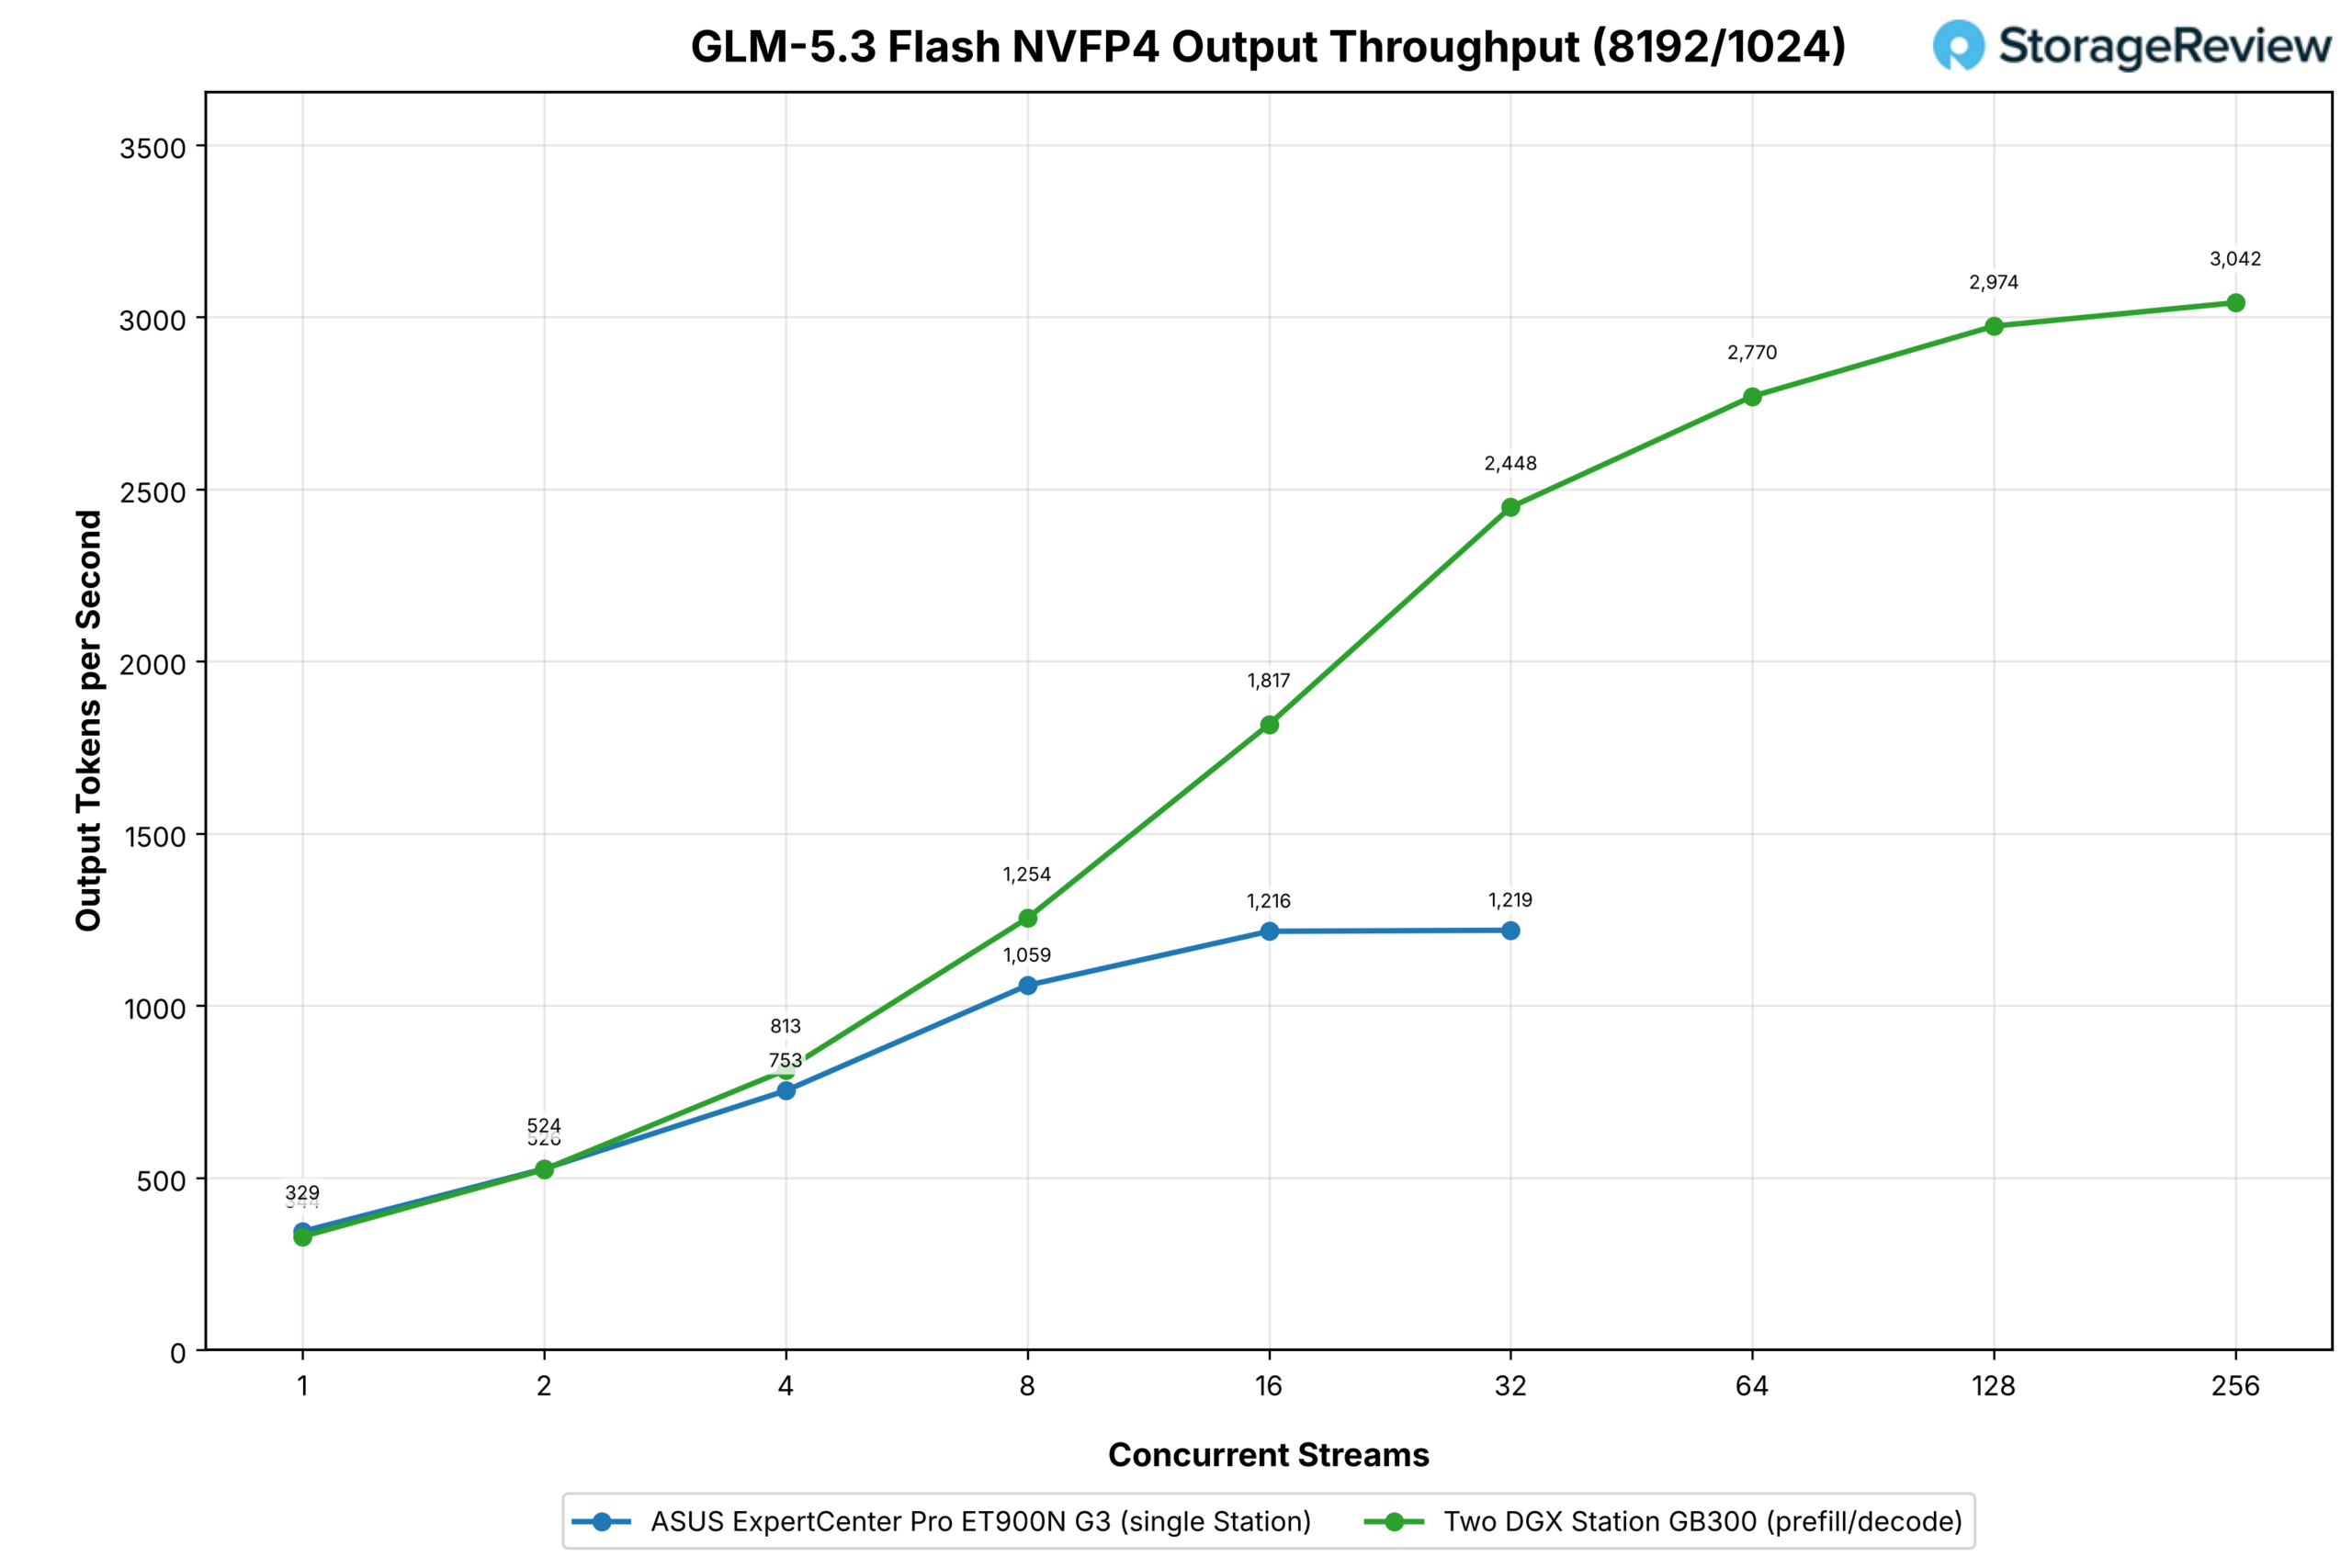
Na profilu s vysokým podílem předfillu se počet výstupních tokenů za sekundu u jedné stanice zvýšil z 344 u jednoho streamu na 1 216 u 16 streamů a udržel se na 1 219 u 32 streamů, což je od 16 streamů stagnace. Dvojice předfill/dekódování se neustále zvyšovala, z 329 u jednoho streamu na 2 448 u 32 streamů, což je dvojnásobek oproti jedné stanici, kde se ustálila, a dále na 3 042 u 256 streamů. Toto rozdělení je určeno pro dlouhé výzvy, protože stanice s předfillem absorbuje výzvy s 8 192 tokeny, zatímco mezipaměť KV a výpočetní programy dekódovací stanice zůstávají v procesu generování.
GLM-5.2
GLM-5.2 běžel v TP2 bez Grace offloadu na clusteru a je to model, který nejlépe svědčí pro druhou stanici. Kontrolní bod NVFP4 má přibližně 433 GB, takže na jednom GB300 je v paměti Grace uloženo zhruba 215 GB expertních vah a každý dekódovací krok, který se jich dotkne, prochází přes NVLink-C2C do LPDDR5X rychlostí 396 GB/s. Rozděleno na dvě stanice, každá B300 obsahuje v HBM3e přibližně polovinu modelu.
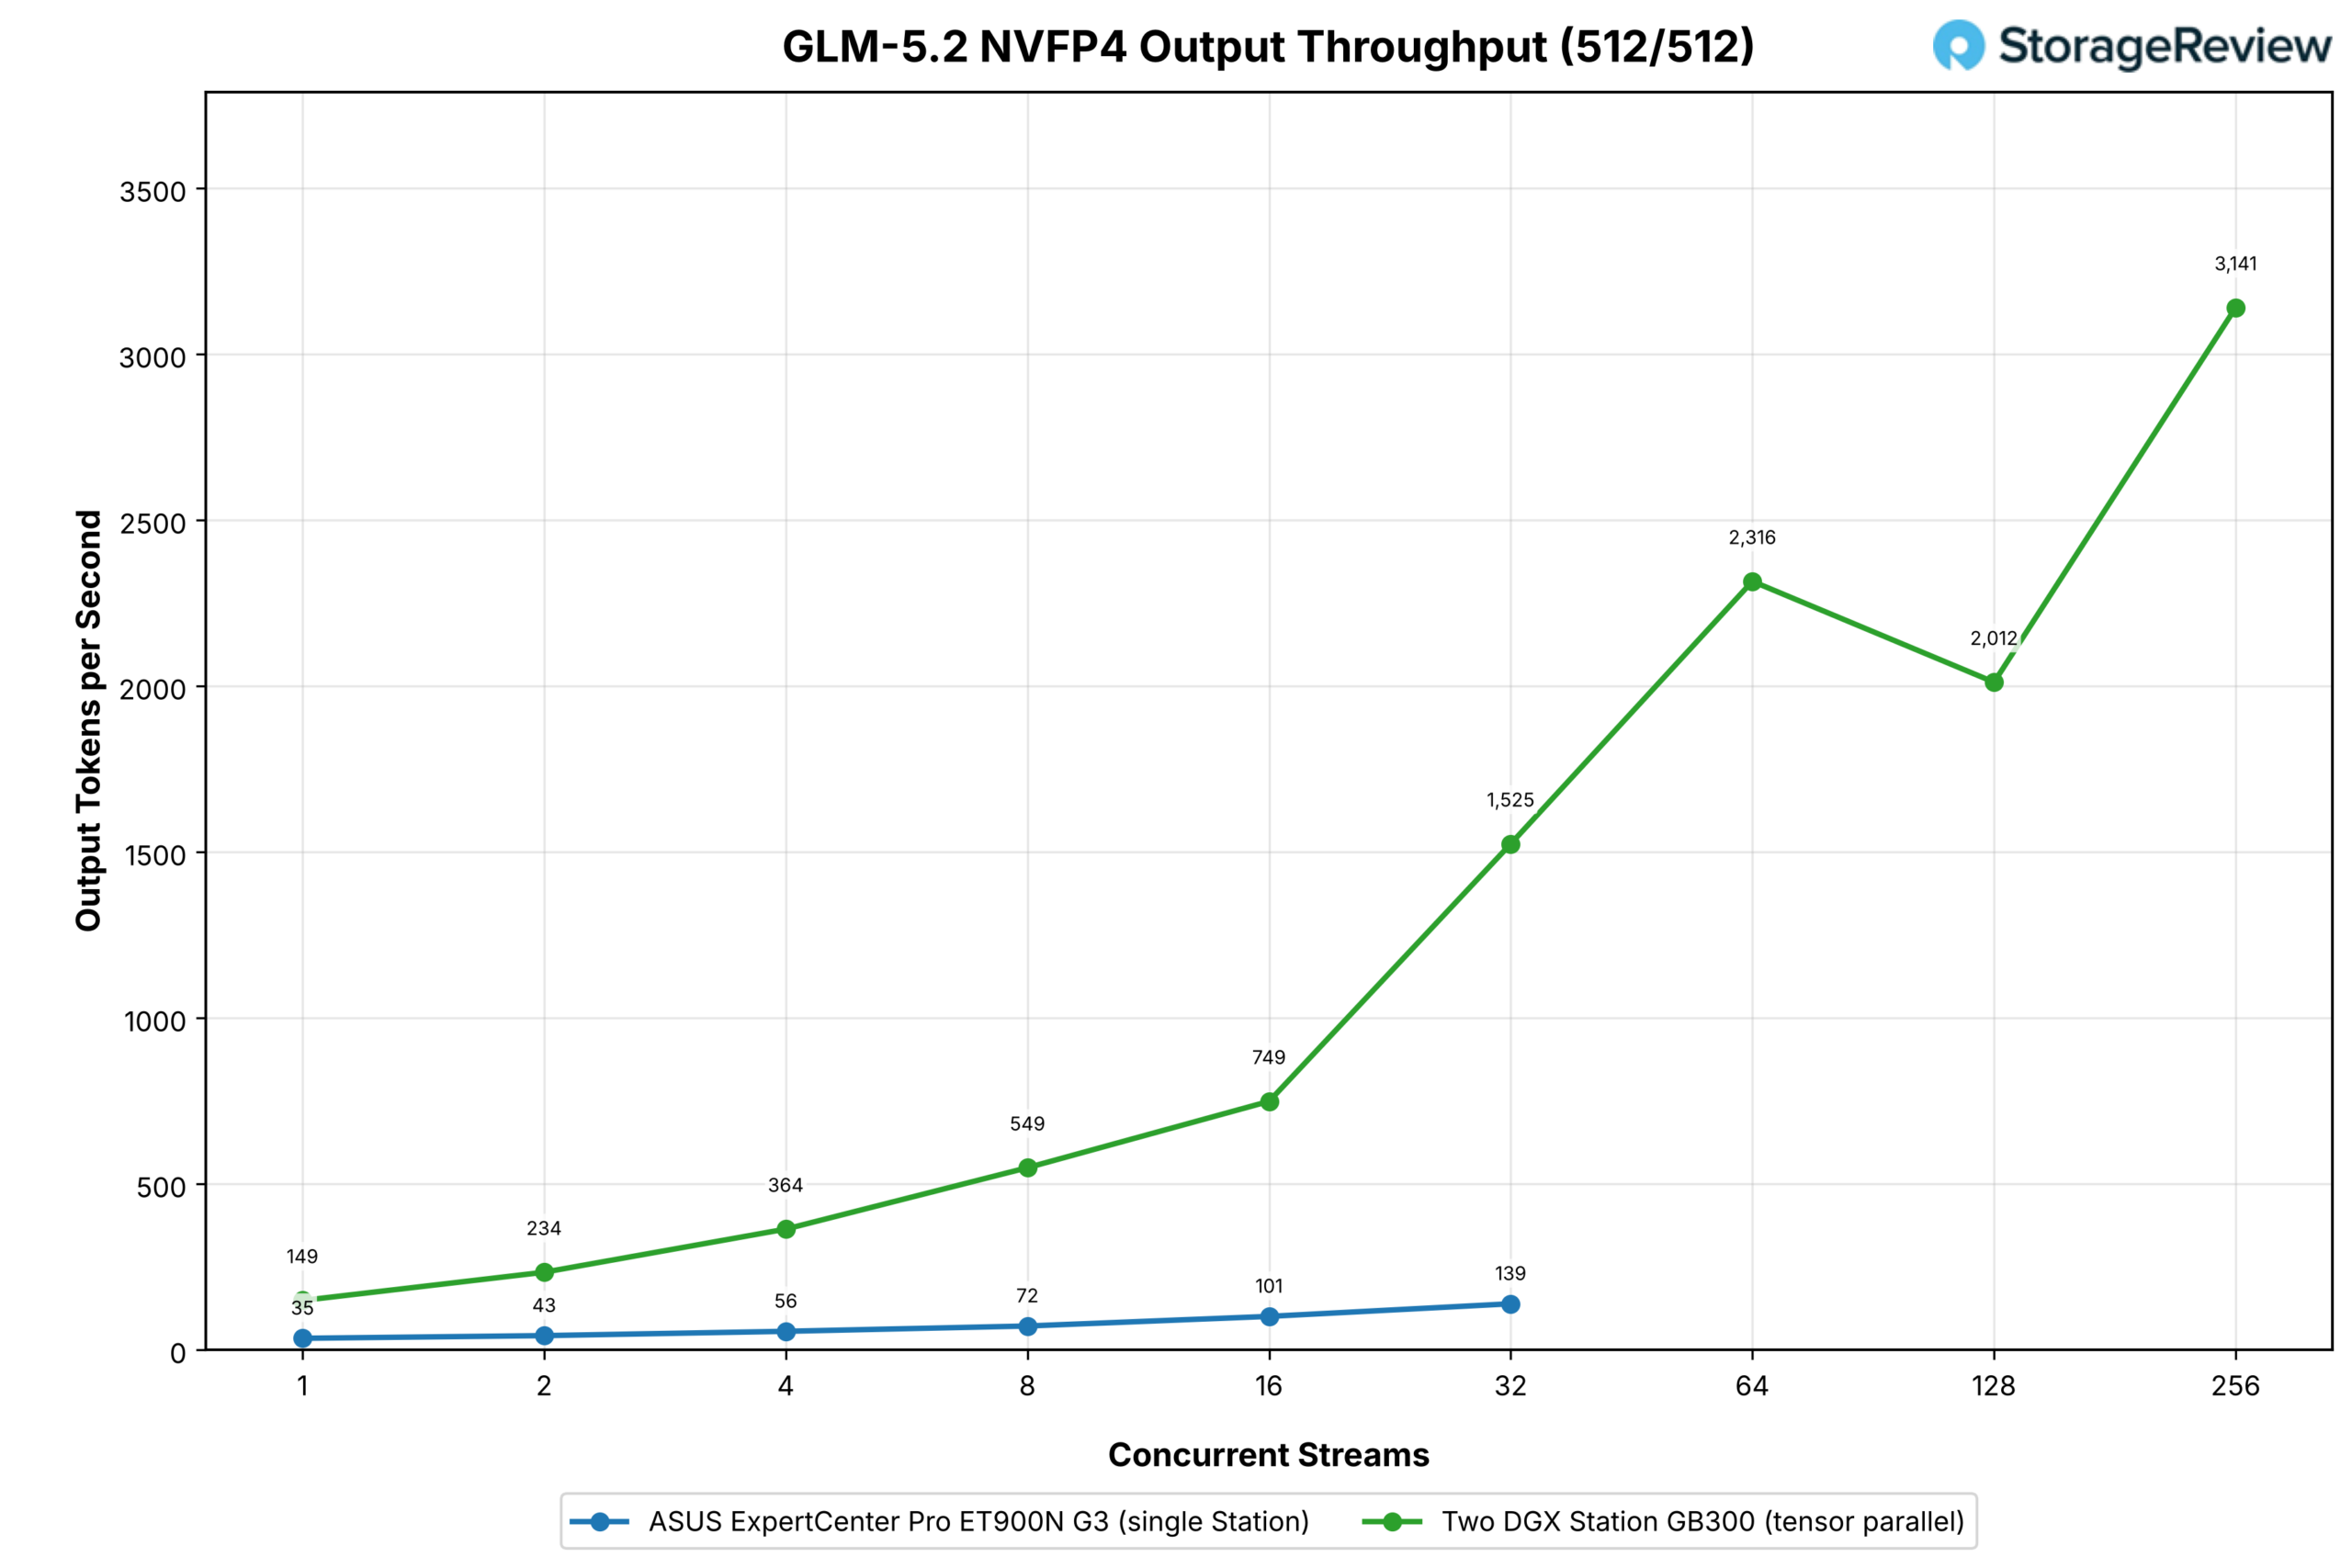
Při stejném zatížení dodával jeden ET900N G3 35 výstupních tokenů za sekundu v jednom streamu a 139 při 32 streamech. Dvoustaniční cluster začal na 149 tokenech za sekundu v jednom streamu, což je 4.3x více než jeden věžový server, dosáhl 1 525 při 32 streamech, což je 11x více, a neustále stoupal nad rámec záběru jedné stanice na 2 316 při 64 streamech a 3 141 při 256 streamech, s poklesem na 2 012 při 128 streamech. Model, který jedna stanice obsluhuje konverzační rychlostí pro hrstku uživatelů, se stává modelem, který mohou dvě stanice obsluhovat oddělení.
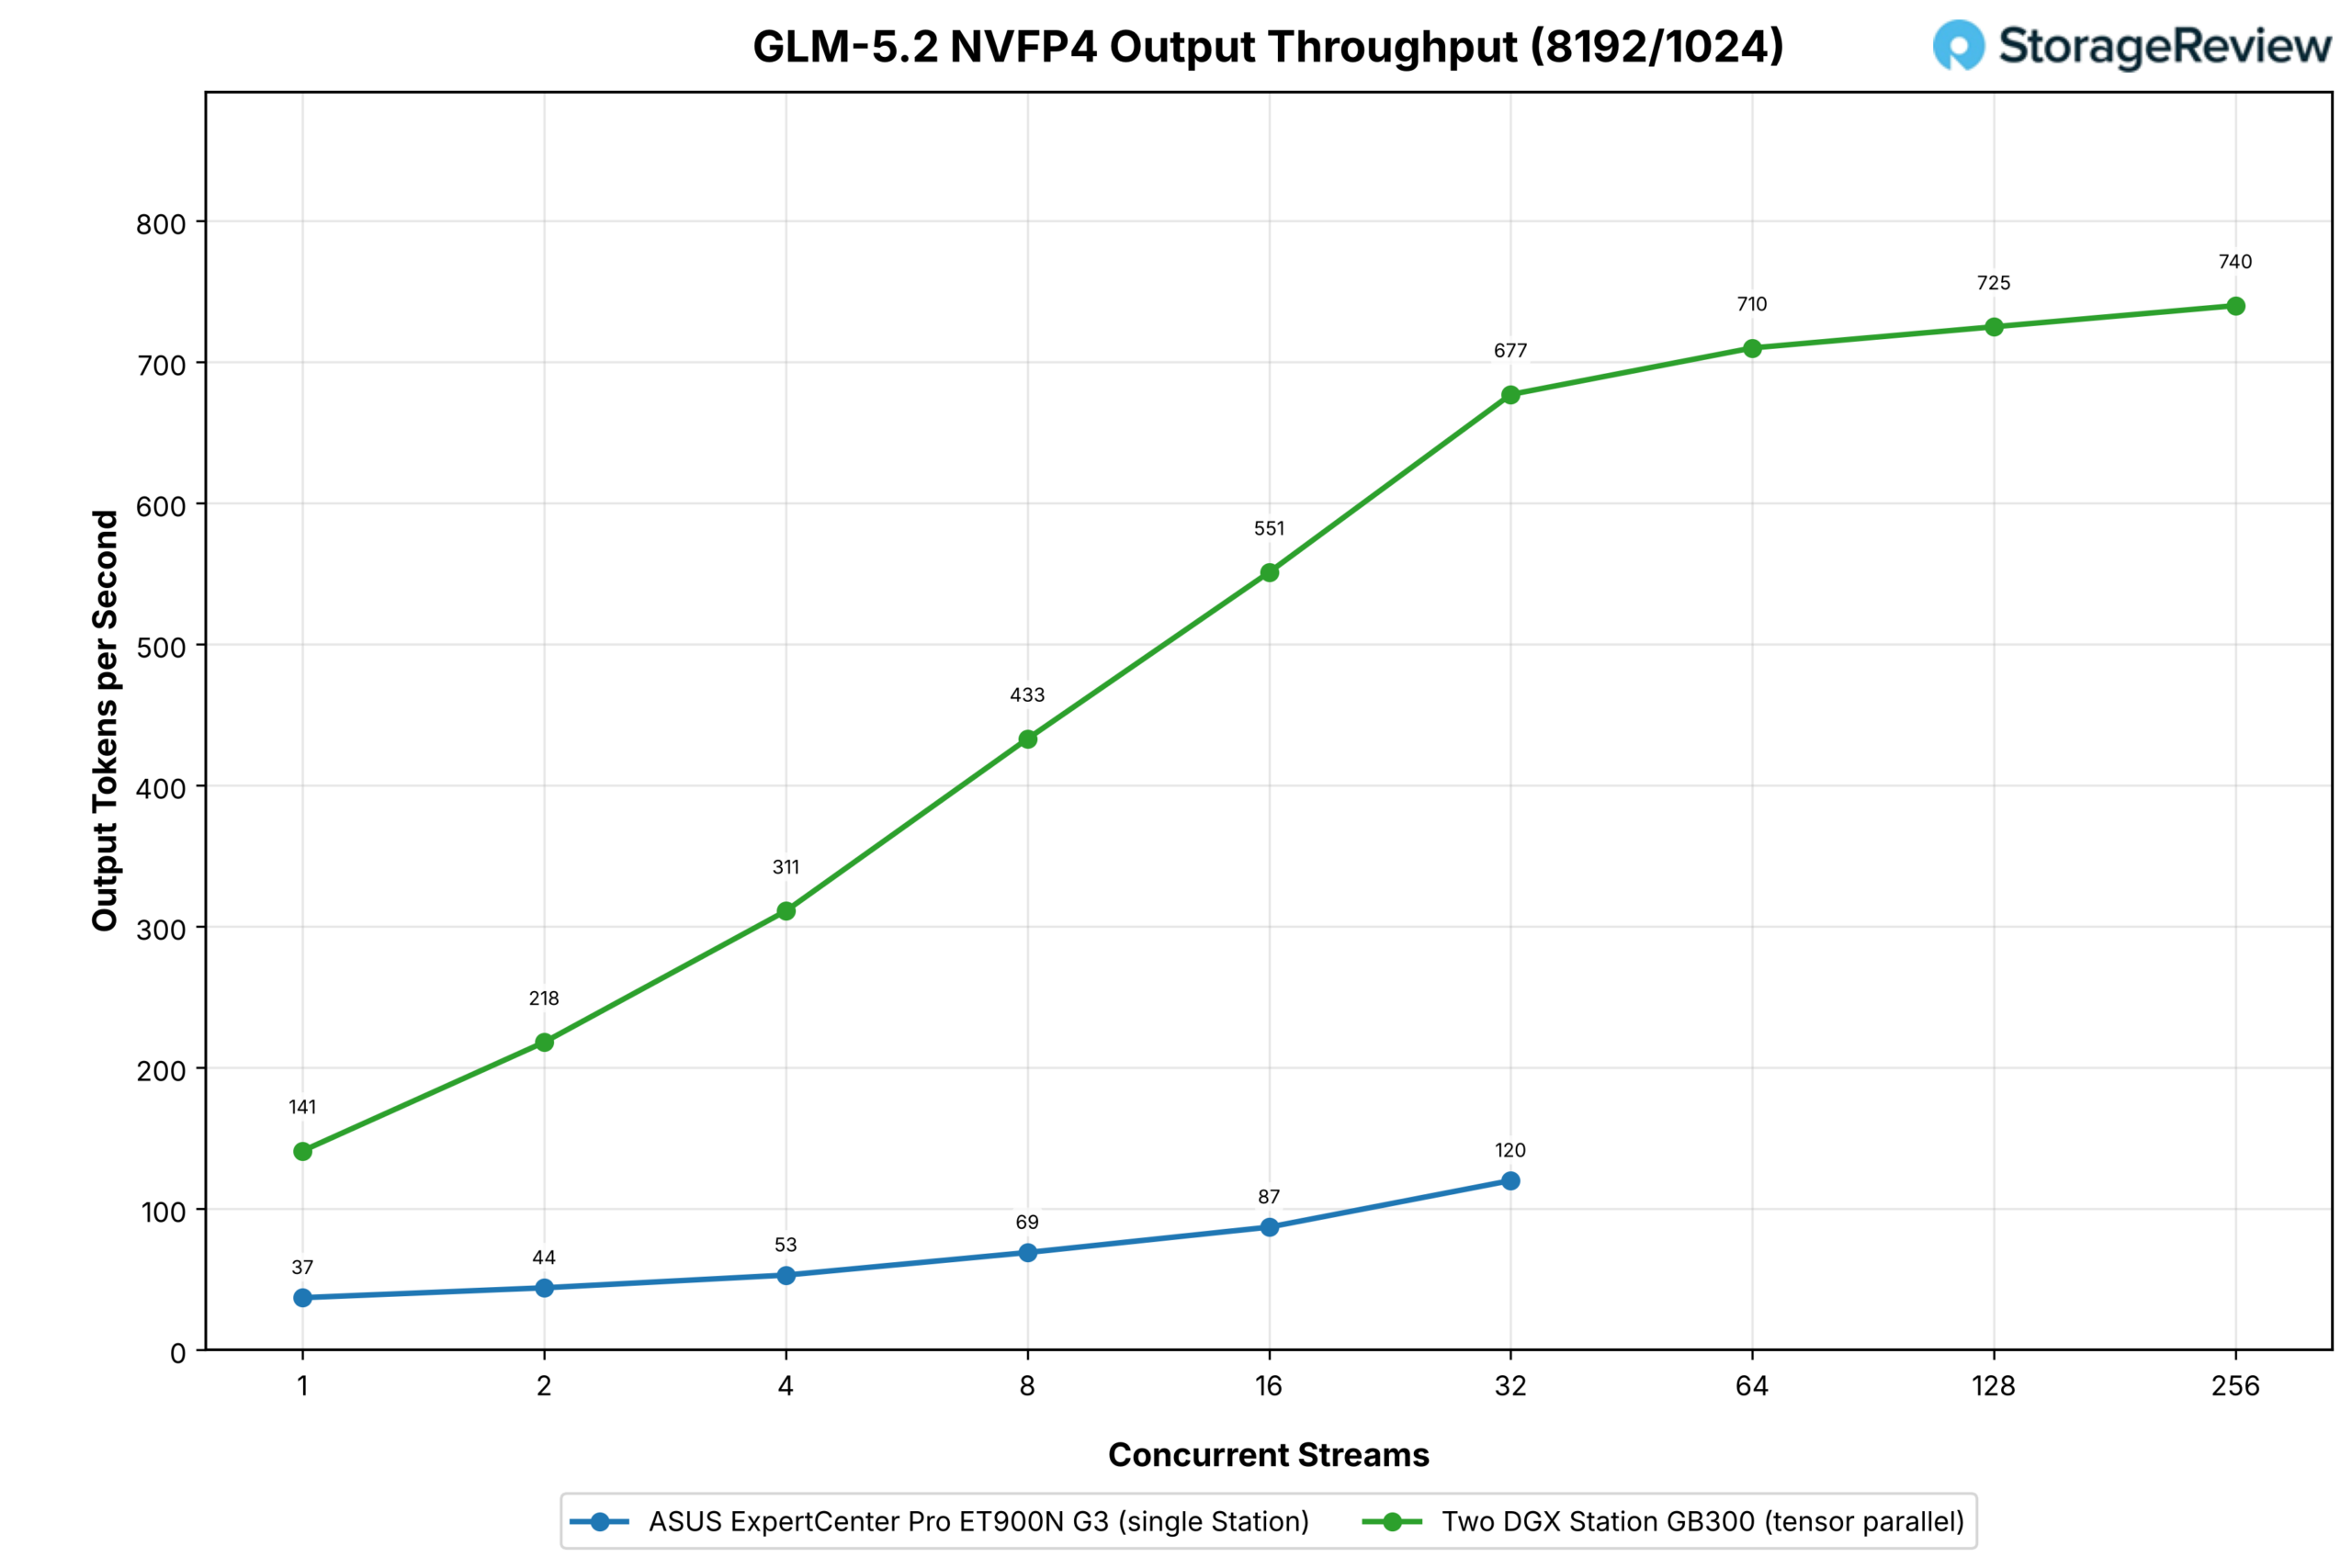
Profil s vysokým obsahem předfillů vypráví stejný příběh v nižší výšce, kdy se jedna stanice pohybuje z 37 výstupních tokenů za sekundu u jednoho streamu na 120 u 32 streamů a cluster se pohybuje ze 141 na 677 ve stejném rozsahu, 3.8x ve spodní části rozptylu a 5.6x v horní části, a poté se zplošťuje u 710, 725 a 740 až do 256 streamů.
U dlouhých výzev je více práce v předběžném vyplňování, kde jsou obě konfigurace vázány na výpočetní výkon, takže penalizace za odlehčení, kterou druhá stanice odstraní, je menším podílem z celkového počtu než u krátkých výzev. Zisk u obou profilů výrazně přesahuje dvojnásobek, protože druhá stanice bere 433GB model z LPDDR5X a vkládá ho celý do HBM, a to je zde důležitější než výpočetní výkon druhého B300.
MiniMax-M3
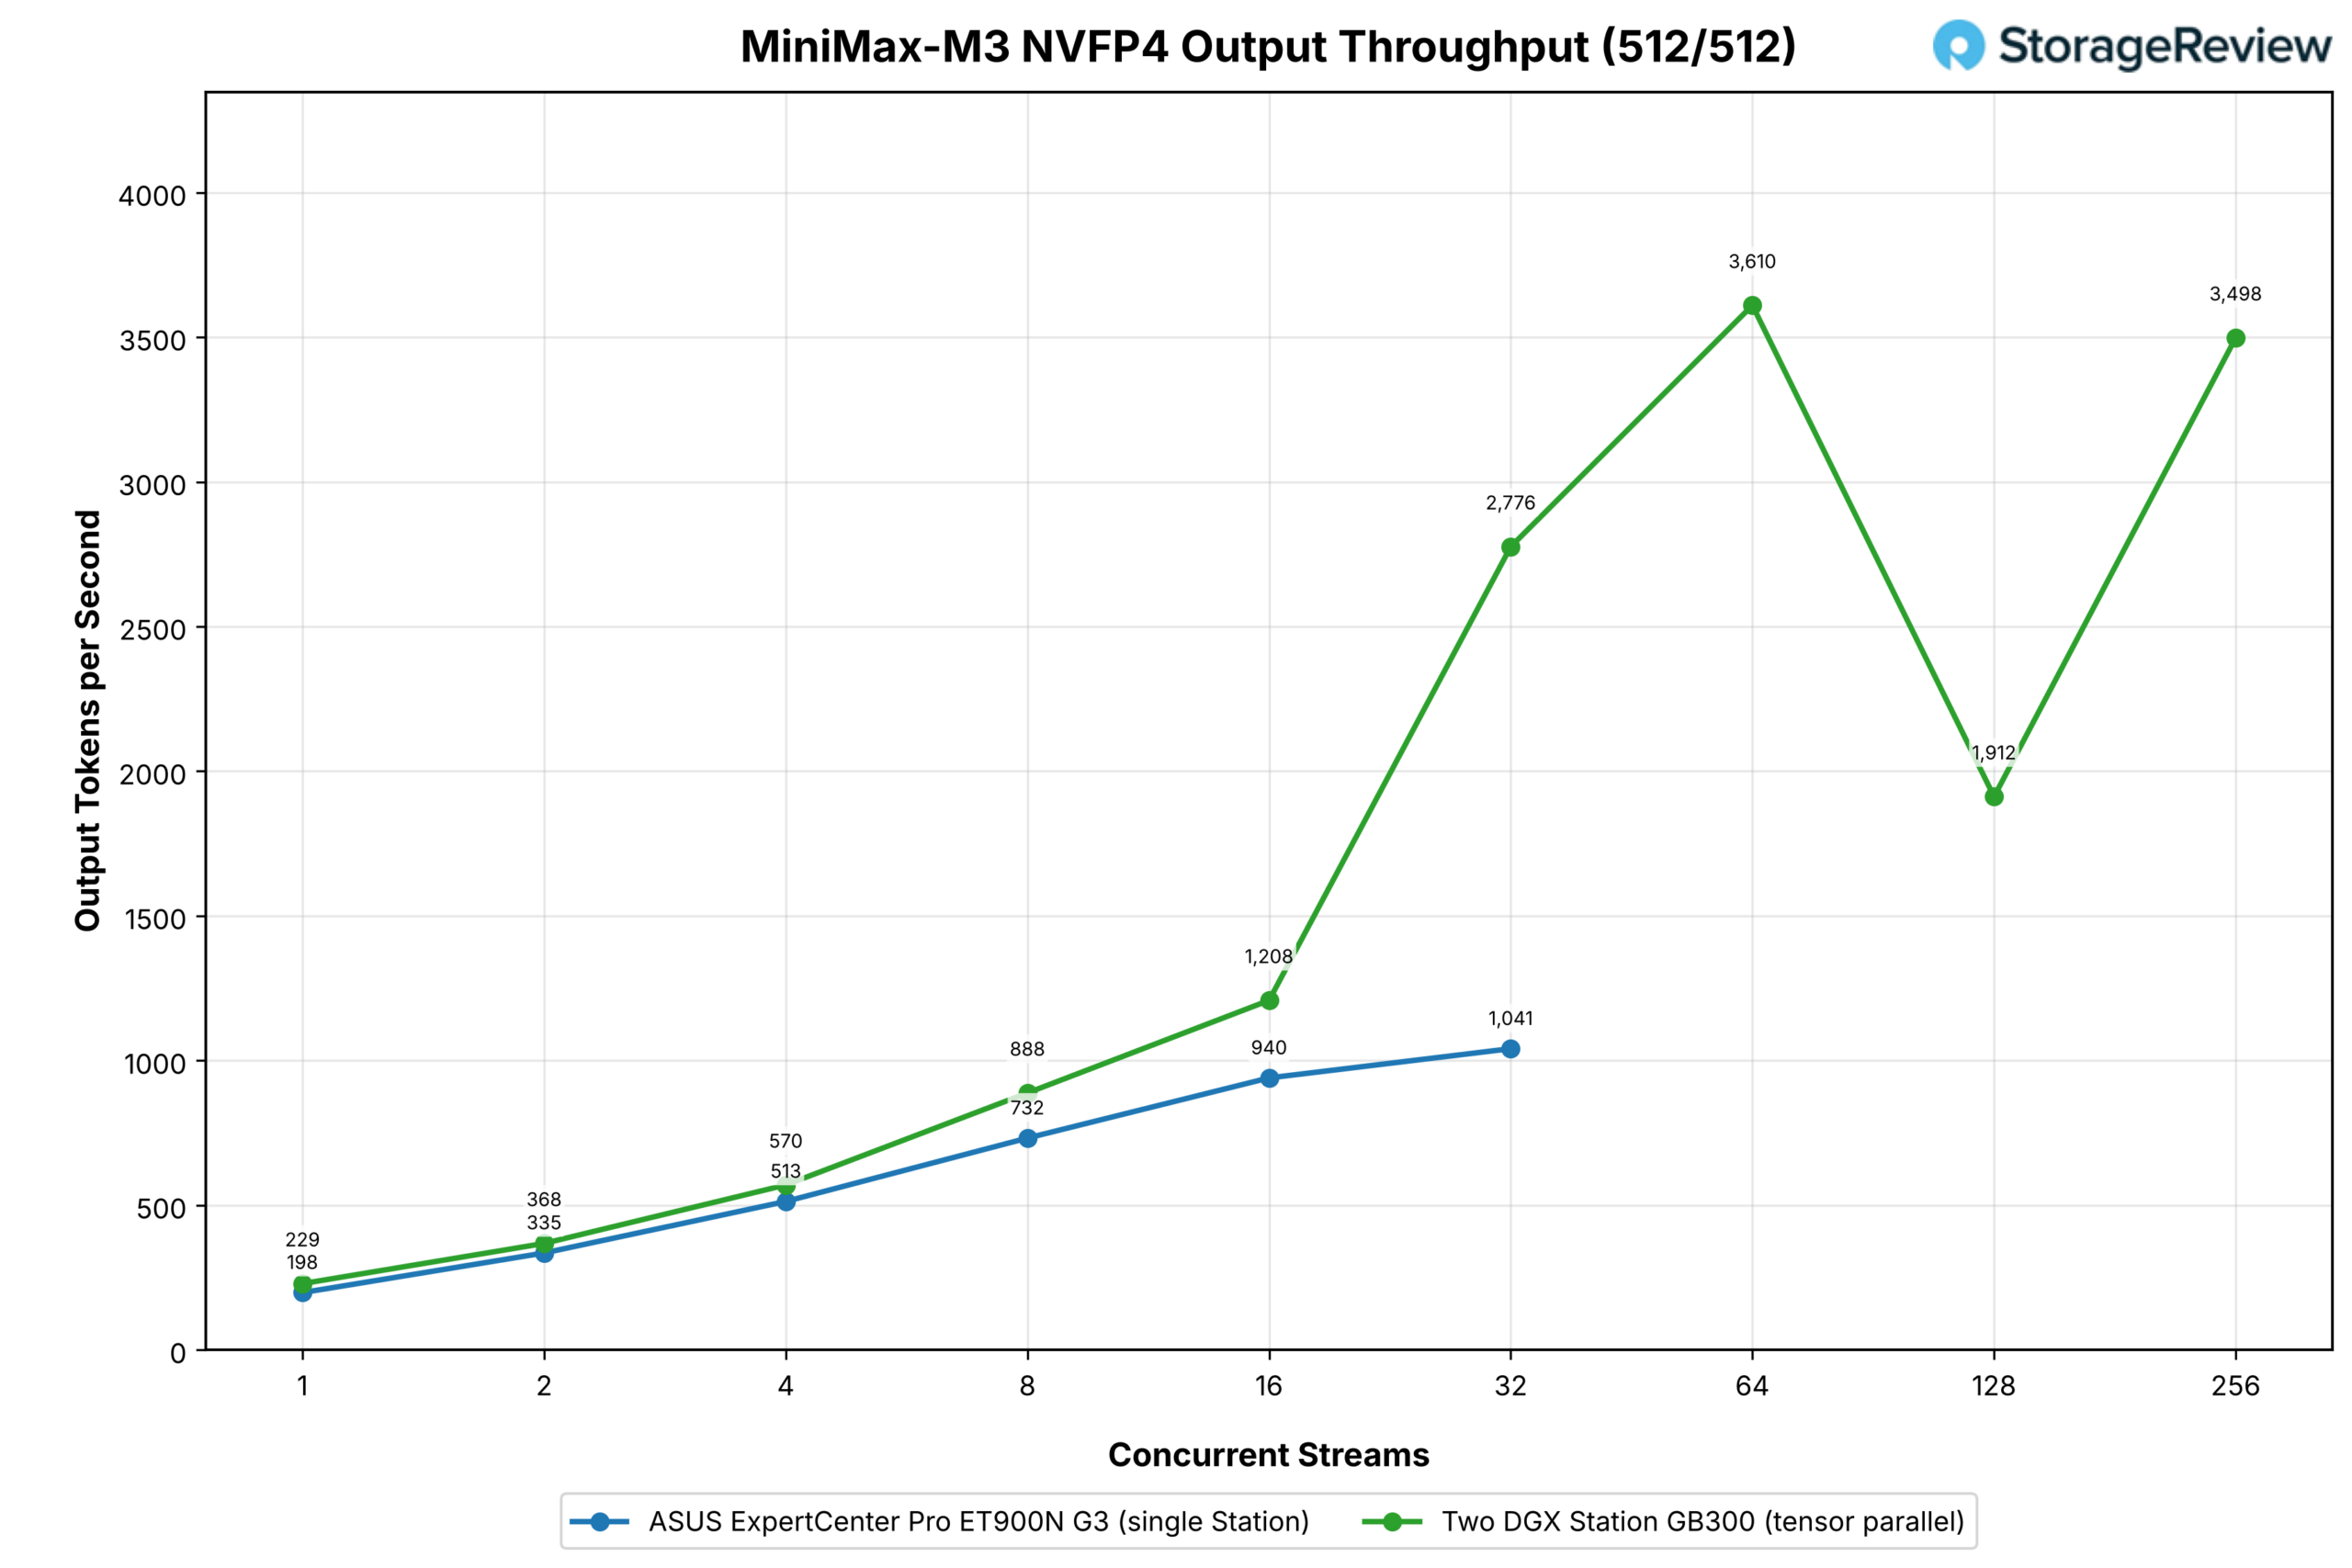
MiniMax-M3 běžel v TP2 bez Grace offloadu. Na jedné stanici se nachází přímo na hranici HBM, s částí svých expertů na Grace paměti, a v recenzi ASUSu dosáhl 1 041 výstupních tokenů za sekundu ve 32 streamech při stejném zatížení jako EAGLE3.
Cluster úzce sleduje jednu stanici prostřednictvím 16 streamů (1 208 oproti 940) a poté se odpojuje: 2 776 na 32, což je 2.7násobek oproti jedné věži, 3 610 na 64, což je pokles na 1 912 na 128 a 3 498 na 256. Dvě stanice zde přidávají méně než na GLM-5.2, protože jedna stanice již většinu tohoto modelu uchovává v HBM, takže příspěvek druhé GPU se blíží škálování prostých výpočtů s prostorem pro mezipaměť KV nahoře.
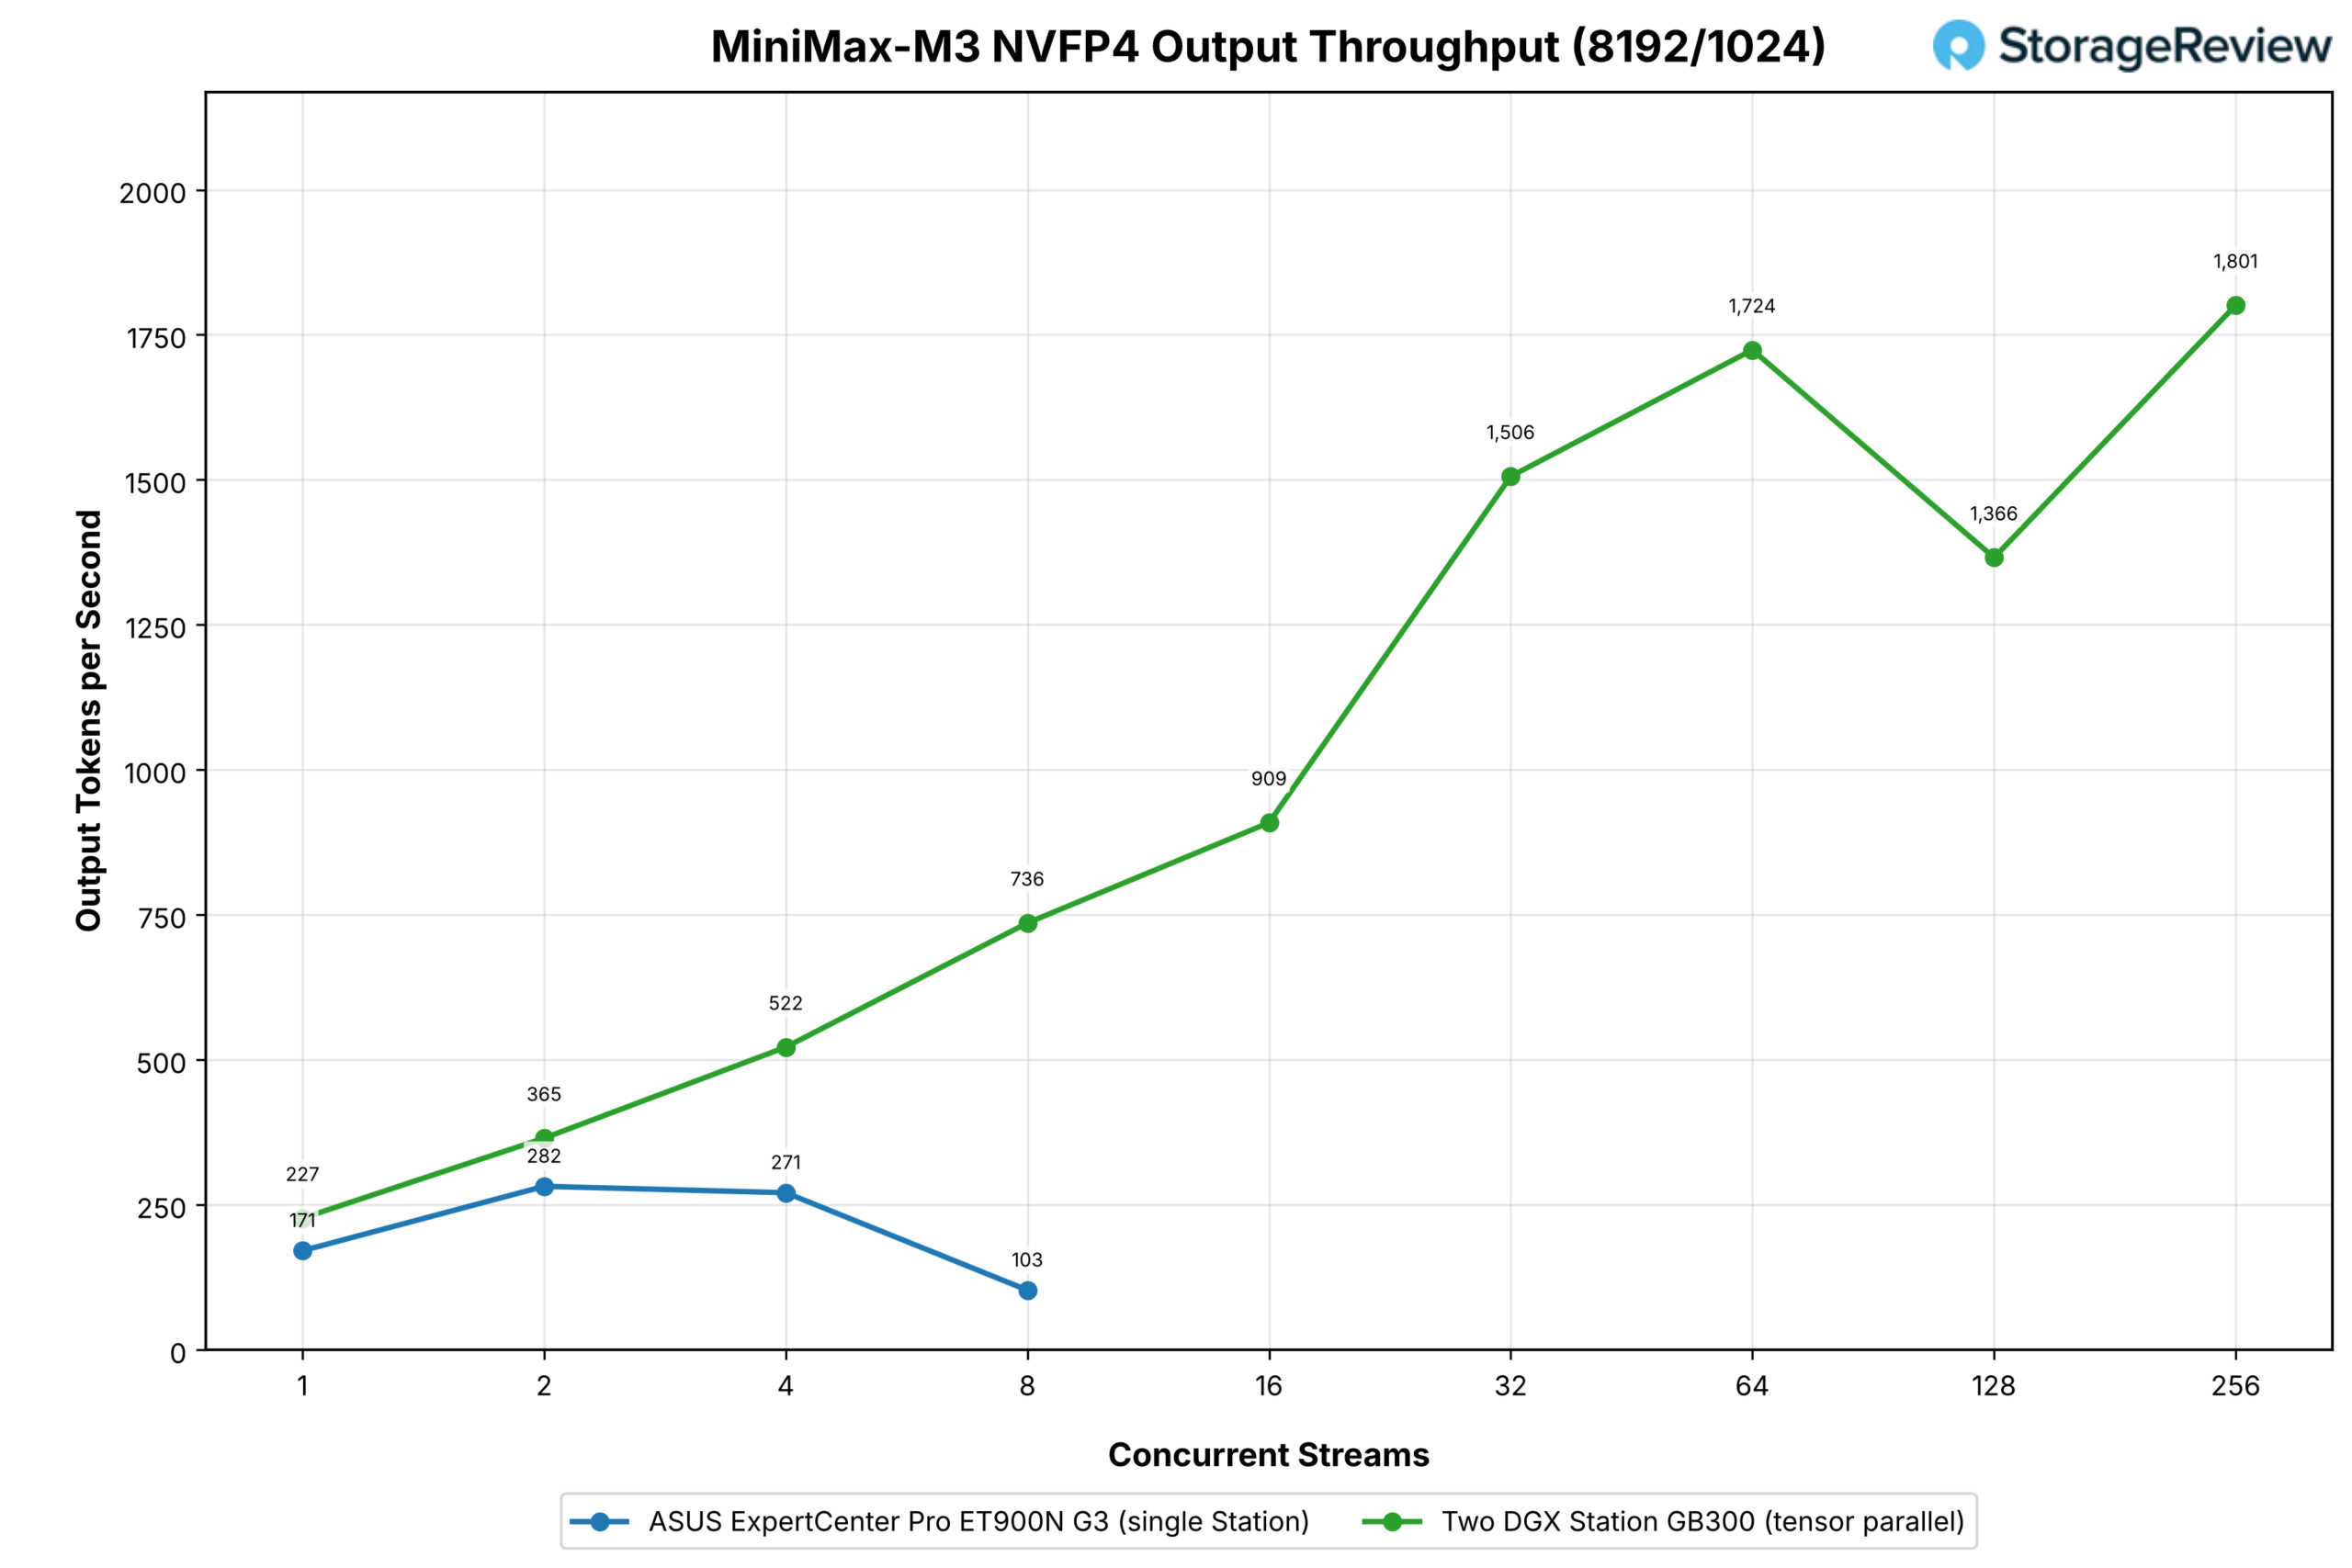
Profil s vysokým obsahem předfillů představuje místo, kde MiniMax-M3 na jedné stanici došel prostor: výzvy s 8 192 tokeny rychle spotřebovaly zbývající mezipaměť KV, takže jedna věž dosáhla vrcholu 282 výstupních tokenů za sekundu ve dvou streamech, u čtyřech se udržela na 271 a v osmi klesl na 103, kde sweep skončil, protože už nebylo co měřit.
S modelem rozděleným mezi dvě stanice se stejné body pohybovaly na hodnotách 365, 522 a 736, což představuje 30% nárůst u dvou streamů, kde obě konfigurace mají volnou mezipaměť, a 7.1x u osmi streamů, kde jedna došla. Klastr poté pokračoval na 909 u 16, 1 506 u 32, 1 724 u 64, 1 366 u 128 a 1 801 u 256, což je rozsah, kterého jedna stanice na tomto profilu vůbec nedosáhne.
Závěr
Dvě stanice GB300 DGX propojené kabely přes vlastní porty ConnectX-8 dělají přesně to, co dokumentace NVIDIA uvádí; nastavení proběhlo bez problémů a toto jsou první data o propustnosti, která jsme viděli pro konfiguraci s dvěma systémy.
Druhá stanice si vydělává na modelech, které překračují 252 GB HBM3e: GLM-5.2 se zvýší ze 139 výstupních tokenů za sekundu při 32 streamech na jedné stanici na 1 525 na dvou a dále na 3 141 při 256 streamech, protože rozdělení vyjímá 433GB model z LPDDR5X; GLM-5.3 dosahuje 5 018 při 256 streamech ze stropu 188 pro jednu stanici; MiniMax-M3 se při dlouhých výzvách zpomaluje z věže, která zpomaluje na osmi streamech, na dvojici, která stále stoupá na 256.
U dvou modelů, které se vejdou do jedné stanice, GLM-5.3 Flash a DeepSeek V4.1 Flash, je lepším způsobem využití druhého pole dát každé stanici celou kopii, oddělit předběžné vyplňování od dekódování a nechat dekódovací proces generovat bez pauzování; na GLM-5.3 Flash se zdvojnásobila propustnost dlouhých výzev při 32 streamech a ztrojnásobila propustnost krátkých výzev a DeepSeek V4.1 Flash dosáhl nejvyšší výstupní propustnosti v sadě s 5 248 tokeny za sekundu.
Náš pohled na produkt se od recenze MSI XpertStation WS300 nezměnil : jedná se o zajímavý stroj pro specifický trh a pokud ho budete potřebovat, můžete si pořídit i další.
Nejlepší způsob, jak je provozovat, je jako zaměnitelnou infrastrukturu: fond, na kterém tým plánuje práci a který se přetváří podle změn projektu, a NVIDIA vlastní součásti, které to umožňují. Koupila Run:ai pro plánování, Brev pro vývojářská prostředí a Lepton pro výpočetní tržiště a kterýkoli z těchto tří v kombinaci s rackem stanic by produkt učinil atraktivnějším, pokud k němu máte přístup.
Dvouprocesorová konfigurace se dobře škálovala; nejlepší naměřený zisk byl u GLM-5.3, ze 188 výstupních tokenů za sekundu na jedné stanici na 5 018 napříč dvojicí (27násobný zisk), a při shodné souběžnosti dosáhl GLM-5.2 11násobného nárůstu u 32 streamů, v obou případech na modelech, které jedna stanice může obsluhovat pouze přenesením vah do paměti Grace. To je výsledek GB300 oproti 2x 400G a nás to nabádá k zvědavosti, jak bude stanice Vera Rubin vypadat, až ji NVIDIA uvede na trh s novou generací HBM a NVLink-C2C.
To, kde se to hodí, se nezměnilo: dvě stanice na stole, bez racku nebo datového centra za nimi, nyní slouží modelům, které dříve ospravedlňovaly server s grafickou kartou a s ním spojené vybavení. Tým, který nemůže získat slot v datovém centru nebo na něj nechce čekat, má cestu k inferenci na hranici možností hned vedle sebe. NVIDIA nastavila laťku pro tuto kategorii, bez ohledu na cenu. Třída GB300 se umístila v našem žebříčku Nejlepší stolní počítače pro lokální umělou inteligenci , kde tato data z clusteru nyní podporují tuto volbu.



 Amazon