

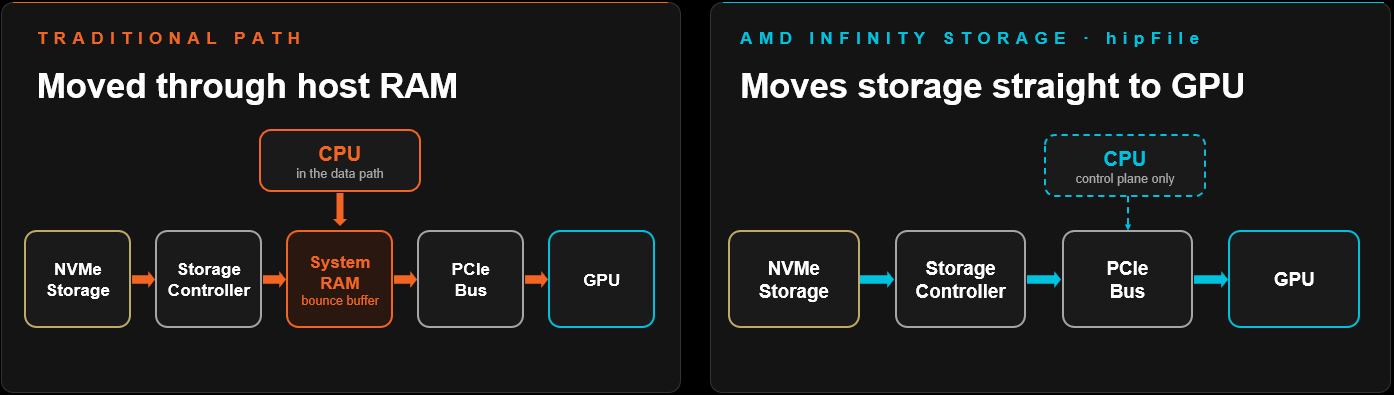
AMD ROCm 10.1, veröffentlicht am 5. Oktober, legt den Fokus auf den Datenpfad zwischen Speicher und GPU. Checkpoint-Dateien, Key-Value-Caches und Modellgewichte überschreiten mittlerweile regelmäßig den Speicher des Beschleunigers. In diesem Fall bestimmt die Zeit für den Datentransfer die Iterationszeit stärker als die eigentlichen Berechnungen. Mit dieser Version wird AMD Infinity Storage, der in ROCm 7.14 eingeführte Direct-Storage-Stack, erweitert. Der Speicherzugriff wird in die HIP-Laufzeitumgebung integriert und NUMA-fähiger Hostspeicher hinzugefügt, sodass die Daten die GPU direkt erreichen, ohne den Umweg über den CPU-Speicher.
Direkte GPU-Speicherpipelines und NUMA-fähiger Speicher
Die hipFILE-Bibliothek in AMD Infinity Storage verfügt nun über ein asynchrones Fast-Path-Backend. Lese- und Schreibanfragen werden direkt über einen HIP-Stream ausgeführt, wodurch der im herkömmlichen Verfahren erforderliche Zwischenspeicherungsschritt im Host-Speicher entfällt. Laut AMD führt dies zu geringeren Latenzen für Checkpoint-Engines und KV-Cache-Offload bei gleichbleibender Bandbreite. Die Versionshinweise nennen die entsprechenden Aufrufe: hipFileReadAsync() und hipFileWriteAsync() unterstützen nun den Fast Path.
Eine Batch-I/O-API übermittelt mehrere Dateianfragen gleichzeitig und verteilt sie auf einen internen Pool von Worker-Threads. Dadurch bleiben die Speicherwarteschlangen gefüllt, wenn ein Trainingsjob einen großen Datensatz abruft. Die Telemetriedaten werden entsprechend erweitert: hipFileGetStatsL1, L2 und L3 liefern zunehmend detailliertere I/O-Statistiken. Diese Zähler werden an die ROCm-Profiler übermittelt, sodass ein Operator erkennen kann, ob eine Pipeline durch Rechenleistung, Speicher oder Datenübermittlung eingeschränkt ist.
Auf Hosts mit zwei Sockets führt ein auf dem falschen Socket allokierter Puffer bei jeder Übertragung zu einer zusätzlichen Belastung zwischen den Sockets. ROCm 10.1 erweitert die HIP-APIs für die virtuelle Speicherverwaltung um hipMemLocationTypeHostNuma und hipMemLocationTypeHostNumaCurrent. Dadurch kann der Hostspeicher während des gesamten Lebenszyklus (Erstellen, Reservieren, Zuordnen und Abbauen) auf einem bestimmten NUMA-Knoten platziert werden. Bibliotheken wie RCCL können darauf aufbauend NUMA-lokale, kopierfreie Kommunikationspuffer erstellen und den Host-zu-Gerät-Datenverkehr von der Socket-Verbindung fernhalten.
ROCm CLI v1.0.0 und AI Agent Workflows
ROCm CLI ist ab Version 1.0.0 als einzelne Binärdatei für Linux, Windows und WSL2 verfügbar. Sie installiert, konfiguriert und führt lokale KI-Workloads auf AMD-GPUs aus. Die CLI erkennt die von vLLM benötigten Pakete flash-attn und amd-aiter, unterstützt das aktualisierte ROCm-10 -Paketlayout und bietet eine Option für vollständig nicht-interaktive Installationen in skriptbasierten Umgebungen oder CI-Umgebungen. Ein Vollbild-Dashboard mit intuitiver Benutzeroberfläche zeigt Live-GPU-Telemetriedaten neben der Modellbereitstellung und ein lokales Chatfenster zur Überprüfung der Antwort eines Endpunkts an.
AMD Skills, die Paketintegrationen für Codierungsagenten wie Claude Code und Codex, werden um zwei weitere Pakete erweitert. quark-install installiert AMD Quark mit einem passenden PyTorch-Build, und quark-torch-llm-ptq führt die Quantisierung nach dem Training auf PyTorch- und Hugging-Face-LLMs mit Schemata wie FP8 und INT4 durch.
Profilerstellung und Modernisierung der Telemetrie
Das ROCprofiler-SDK bietet jetzt auch Kernel-Replay (Beta). Da die GPU-Hardware nur eine begrenzte Anzahl von Leistungsindikatoren pro Dispatch bereitstellt, musste die gesamte Anwendung bisher für jede Indikatorgruppe einmal neu ausgeführt werden, um alle Indikatoren zu erfassen. Kernel-Replay führt nun jeden Dispatch erneut aus, setzt den GPU-Speicher zwischen den Durchläufen zurück und erfasst alle Indikatoren in einem einzigen Durchlauf. Das SDK ermöglicht außerdem das Starten und Stoppen des Profilings an jedem beliebigen Punkt während eines Laufs für PyTorch Kineto und Triton Proton und enthält einen PC-Sampling-Agenten, der einen Programmierassistenten durch das rocprofv3-PC-Sampling führt, um Rechenengpässe zu finden.
Der Roofline-Bericht des ROCm Compute Profilers ist jetzt eine interaktive HTML-Seite. So kann ein Entwickler einen einzelnen Kernel isolieren und die Achse der arithmetischen Intensität zwischen verschiedenen Cache-Ebenen umschalten. Es gibt PC-Sampling-Berichte pro Kernel, bis hin zu Abtast- und Stall-Zählern für einzelne Befehle. Ein neuer Leitfaden behandelt das Profiling von vLLM. Der ROCm Systems Profiler bietet jetzt Linux-Tracing für Gorgon Point 1, 2 und 3 APUs (gfx1150, gfx1152 und gfx1153). ROCm Optiq visualisiert nun rocprofv3-Profile zusammen mit den Traces des Systems Profilers und der Analyse des Compute Profilers.
AMD SMI (amd-smi) löst ROCm SMI ab, das in dieser Version aus dem Standard-Build entfernt wurde. Es unterstützt AMD-GPUs, -CPUs und -APUs unter Linux und Windows, sowohl auf Bare-Metal-Systemen als auch in virtualisierten Umgebungen, mit einer Befehlszeilenschnittstelle (CLI), einer C-Bibliothek (amd_smi_lib) sowie Schnittstellen für Python, Go und Rust. Die Container-Unterstützung erstreckt sich auf containerd, CRI-O, Podman, LXC und LXD, einschließlich Kubernetes-Pods, sodass Cluster-Administratoren GPU-Prozesse und deren Auslastung dem jeweiligen Container zuordnen können.
Kern-Compiler-Updates, Bibliotheken und Laufzeitunterstützung
Die Toolchain wird von LLVM 23 auf LLVM 24 aktualisiert, und das Makro `clang_major` meldet nun Version 24. Dies sollten alle überprüfen, die Compilerversionen fixieren oder gegen libLLVM linken. Inkrementelle Builds werden durch das Caching der Partitionen, die die Linkzeitoptimierung für Gerätecode erzeugt, beschleunigt, sodass unveränderte Partitionen beim nächsten Build wiederverwendet werden.
Der Composable Kernel beschleunigt die Aufmerksamkeitssteuerung auf Radeon-GPUs und erweitert seinen Dispatcher um weitere quantisierte Matrixmultiplikationstypen. MIGraphX verwendet anstelle des Backend-Compilers rocMLIR nun rocMLIRTriton. Laut AMD verbessert dies die Inferenzleistung und verkürzt häufig die Modellkompilierungszeiten, während der Compiler weiterhin mit dem Upstream-Triton kompatibel bleibt. rocSPARSE löst Dreiecksfunktionen direkt auf Matrizen im ELLPACK-Format (ELL), ohne vorherige Konvertierung.
hipThreads, eine neue Funktion der ROCm Core SDK-Threading-Bibliotheken, bringt Standard-C++-Threading-Konzepte auf AMD-GPUs unter Linux und Windows. Ziel ist es, bestehenden CPU-Thread-Code auf der GPU zu beschleunigen, ohne ihn vollständig in HIP-Kernel und Synchronisierungsprimitive umschreiben zu müssen.
Das Windows-Subsystem für Linux 2 (WSL2) ist als technische Vorschau verfügbar. Standard-Linux-Pakete werden im Gastsystem installiert, und die GPU-Paravirtualisierung delegiert die Arbeit an den Windows-Hosttreiber. Die Vorschau umfasst .deb-Pakete und Python-Wheels, jedoch keine RPMs. Profiling, Debugging und KFD-abhängige Tools funktionieren in WSL2 noch nicht. Im Bereich der Virtualisierung wird KVM SR-IOV nun sowohl als Host- als auch als Gastsystem unter Ubuntu 26.04 LTS unterstützt, in Kombination mit Version 9.3.0.K des AMD GIM-Virtualisierungstreibers.
Die Liste der unterstützten Hardware umfasst neben der Radeon AI PRO R9600 auch die Instinct MI355X, MI350X und MI350P, die MI300- und MI200-Serie, den Rest der Radeon AI PRO R9700-Familie sowie Ryzen AI-Prozessoren.


 Amazon