

Lightbits Labs, das Unternehmen hinter NVMe over TCP, steigt mit Inferra, einer KV-Cache-Orchestrierungs-Engine, in den Markt für Inferenzsoftware ein. Die Software feiert morgen, am 15. September, auf dem AI Infra Summit in Santa Clara ihre öffentliche Premiere. Inferra virtualisiert GPU-Speicher über DRAM- und NVMe-Speicherebenen hinweg und wandelt den KV-Cache in eine persistente Datenschicht um. Dadurch müssen Aufmerksamkeitszustände für Workloads mit langem Kontext und mehreren Sitzungen nicht mehr in HBM gespeichert oder bei Speicherverlust neu berechnet werden. Lightbits verspricht bis zu 16-mal mehr gleichzeitige Inferenzsitzungen auf bestehenden GPUs, eine mehr als 100-fache Latenzverbesserung durch das Vorladen von Aufmerksamkeitszuständen anstelle deren Neuberechnung sowie Kontextfenster mit bis zu 10 Millionen Token. Die Engine wurde bereits in Kunden-Betaprogrammen getestet, unter anderem mit OVH.
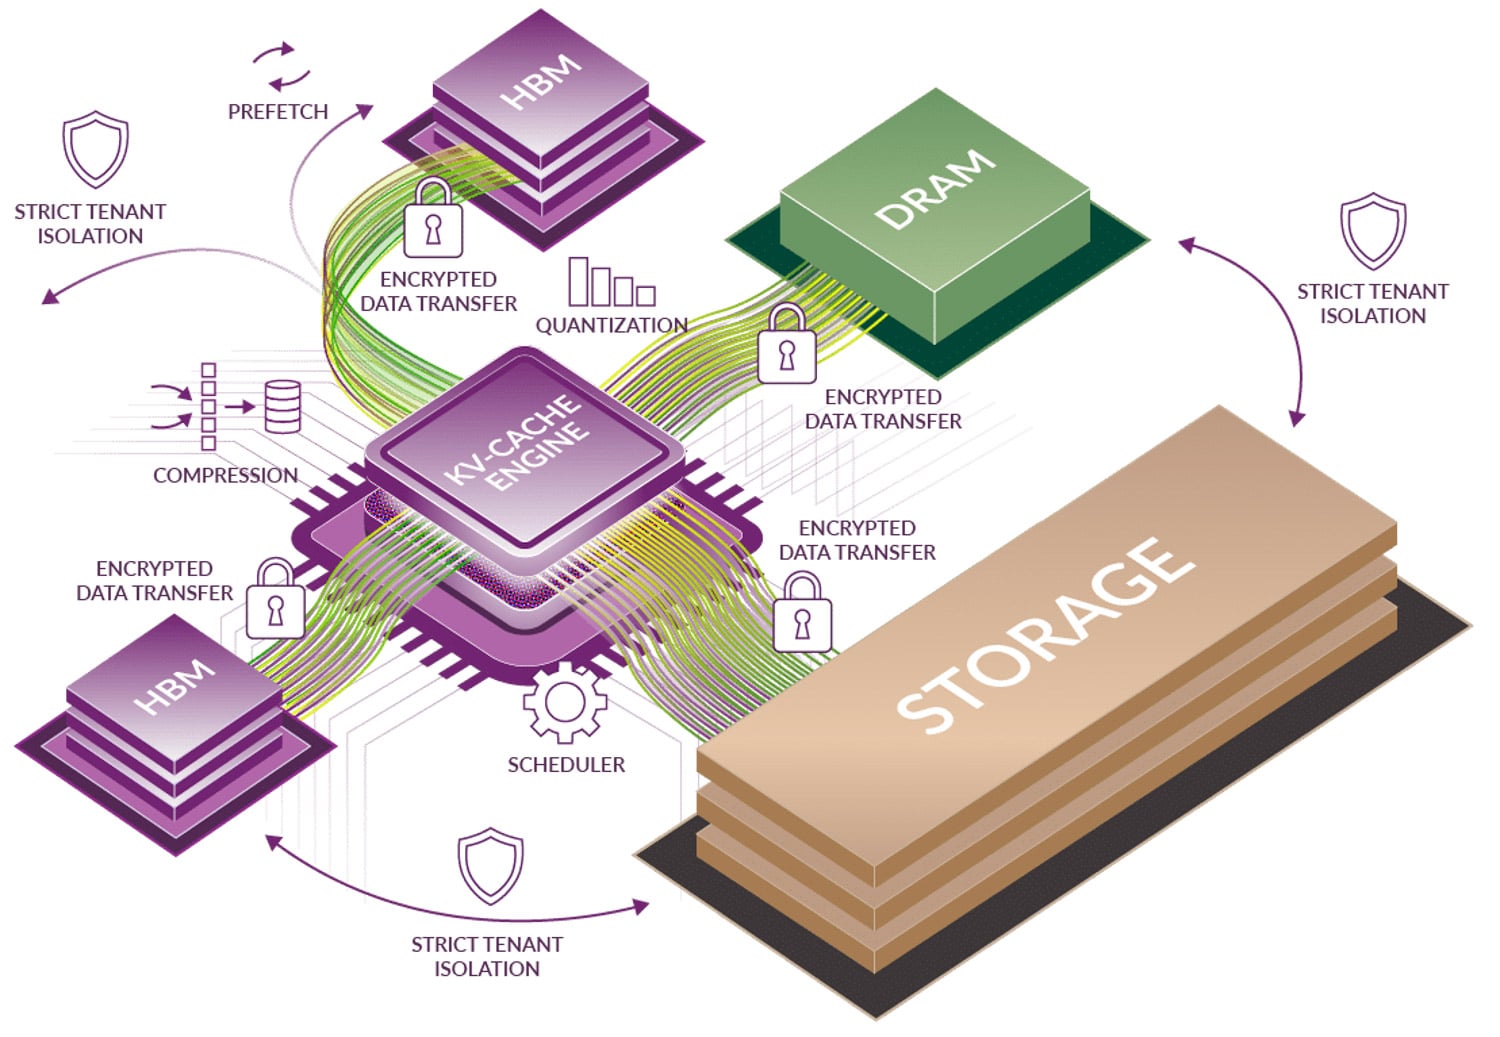
Vorabruf statt Neuberechnung
Der von Inferra anvisierte Flaschenhals ist derselbe, den wir in unserem Abschnitt zur KV-Cache-Auslagerung in den Flash- Speicher beschrieben haben: Mit zunehmender Kontextlänge und steigender Anzahl an Sitzungen übersteigt der KV-Cache den GPU-Speicher. Der Server-Stack entfernt ihn dann entweder und berechnet die Vorbefüllung später neu oder begrenzt die Anzahl der Sitzungen, die eine GPU verwalten kann. Beide Vorgehensweisen verbrauchen GPU-Zyklen für bereits erledigte Arbeit. Inferra hält den Cache über Speicher- und Speicherebenen hinweg aktiv, und ein prädiktiver Prefetcher lädt Aufmerksamkeitszustände rechtzeitig zur GPU zurück, bevor das Modell sie benötigt. Laut Lightbits reduziert dieser Ansatz sowohl die Time-to-First-Token (TTFT) als auch die Time Per Output Token (TPOT). Die angegebene 100-fache Verbesserung bezieht sich auf die Latenzverbesserung gegenüber der Neuberechnung dieser Zustände.
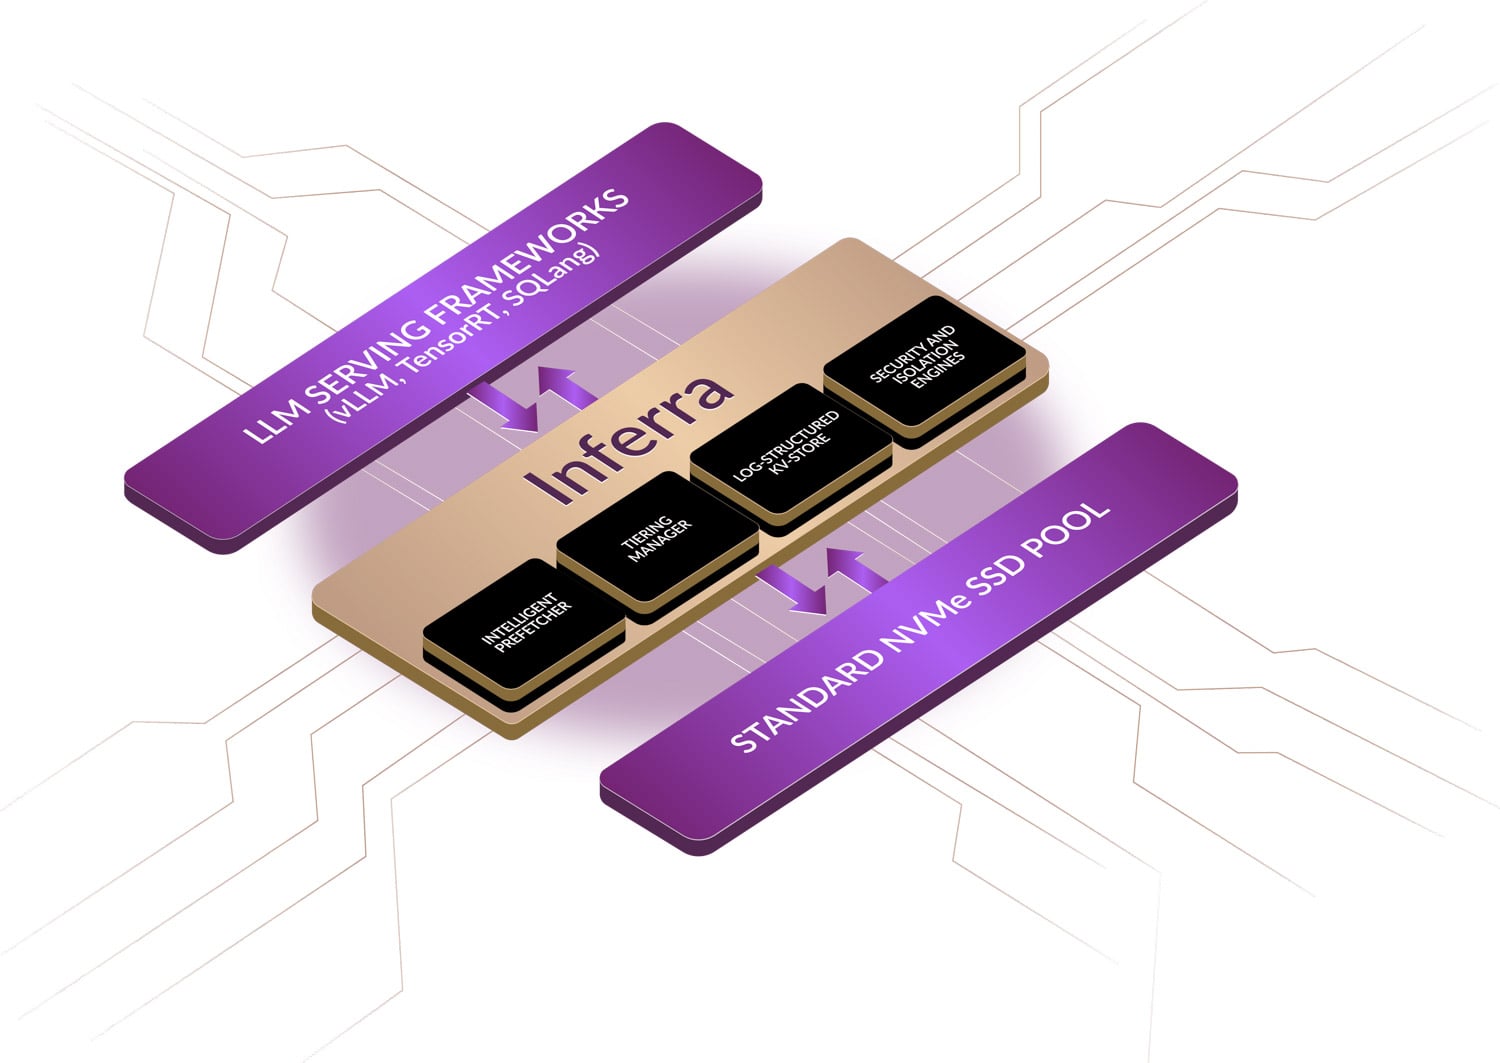
Das Blockdiagramm von Lightbits veranschaulicht die vier Komponenten: einen intelligenten Prefetcher, einen Tiering-Manager, einen logstrukturierten Key-Value-Speicher sowie Sicherheits- und Isolationsmodule, die zwischen dem darüberliegenden Serving-Framework und einem darunterliegenden Standard-NVMe-SSD-Pool positioniert sind. Das Unternehmen nennt vLLM, TensorRT und SGLang als unterstützte Serving-Frameworks und gibt an, dass das Modul GPU- und SSD-unabhängig ist. Der logstrukturierte Speicher ermöglicht die praktische Anwendung einer Flash-Schicht für einen sich ständig ändernden Cache, da er Aktualisierungen sequenziell anhängt und kleine, zufällige Schreibvorgänge von den Laufwerken fernhält. In unserem Test der Solidigm D7-PS1030 haben wir untersucht, wie sich ein Laufwerk mit 3 DWPD in dieser Rolle bewährt . Im Bereich Multi-Tenant beschreibt Lightbits eine sichere Mandantenisolation und ein intelligentes Cache-Management für eine gemeinsam genutzte Inferenzinfrastruktur mit verschlüsselter Übertragung zwischen den Schichten. Dies ermöglicht es einer Neocloud, einen einzigen Key-Value-Pool mit konsistenten SLAs an viele Kunden zu verteilen.
Avigdor Willenz, Mitgründer und Vorsitzender von Lightbits Labs, bezeichnete die Markteinführung als Bruch mit Speicherlösungen, die bisher für Trainingspipelines entwickelt wurden. Inferenz sei „ein völlig anderes Paradigma“, sagte er, und „die Nachrüstung bestehender Trainings- und Speichersysteme zur Behebung des KV-Cache-Engpasses funktioniert einfach nicht. Sie wurden für eine andere Ära entwickelt. Wir haben Inferra von Grund auf speziell für die Lösung des GPU-Effizienzproblems entwickelt, und es hat sich bereits in Kunden-Betaprogrammen bewährt.“
OVH, Solidigm und die Demos am Stand 219
OVH ist der offizielle Beta-Kunde. „Mit Inferras intelligentem KV-Cache-Tiering konnten wir deutliche Verbesserungen der GPU-Auslastung erzielen und unseren Kunden damit eine skalierbarere und kostengünstigere Grundlage für ihre KI-Agenten- und RAG-Workloads bieten“, so Yaniv Fdida, Chief Product and Technology Officer bei OVH. Solidigm testete die Engine in seinem AI Central Lab auf D7-PS1010 -Laufwerken. Avi Shetty, VP Ecosystem, Solutions and Market Enablement des Unternehmens, erklärte, die Ergebnisse zeigten, wie netzwerkgebundener Speicher mit intelligenter Software-Virtualisierung die Speichergrenzen für komplexe, agentenbasierte KI überwinden kann. Diese Kombination aus einem netzwerkgebundenen NVMe-Pool und einer Software-Ebene ist das Kerngeschäft von Lightbits; der LightOS-Blockspeicher basiert seit 2019 auf NVMe/TCP.
Ramesh Chettuvetty, Senior Vice President für KI-Produkte und -Geschäft bei Lightbits, bezeichnete Inferra als „die weltweit erste KV-Cache-Beschleunigungs-Engine, die ungenutzte GPUs eliminiert und Kontextfenster von bis zu 10 Millionen Token auf Standardhardware ermöglicht“. Er sagte, sie liefere „sofortige Amortisation und generiert vom ersten Tag an positive Einsparungen“. Dies sind Herstellerangaben vor unabhängigen Tests. Die Pressemitteilung enthält weder Informationen zu Preisen noch zu Paketen oder einem allgemeinen Verfügbarkeitsdatum; die Engine befindet sich aktuell in der Kunden-Beta-Phase. Lightbits präsentiert während des Gipfels Live-Demos der Ergebnisse zu Sitzungsdichte und Latenz am Stand 219 und hat einen Pod Efficiency Analyzer für Teams bereitgestellt, die die GPU-Einsparungen für ihren eigenen Cluster modellieren möchten, bevor sie einen buchen.


 Amazon