

NVIDIA und Cisco haben heute Pläne für Ultra-Dense Small Form Factor Pluggable (USFP) vorgestellt, ein optisches Modulformat für 400-Gbit/s-Ethernet pro Lane in KI-basierten Netzwerken. Die ersten geplanten Transceiver bieten 16 Vollduplex-Lanes auf einer Fläche, die etwa der eines OSFP-Moduls entspricht. Dies entspricht einer Übertragungsrate von 6.4 Tbit/s pro Modul. Der Anschluss ist für eine Erweiterung auf 32 Lanes und 12.8 Tbit/s ausgelegt. Laut NVIDIA und Cisco bietet USFP die vierfache Bandbreite und Frontplattendichte von 200-Gbit/s-pro-Lane-Modulen bei etwa 1.3-facher Energieeffizienz.
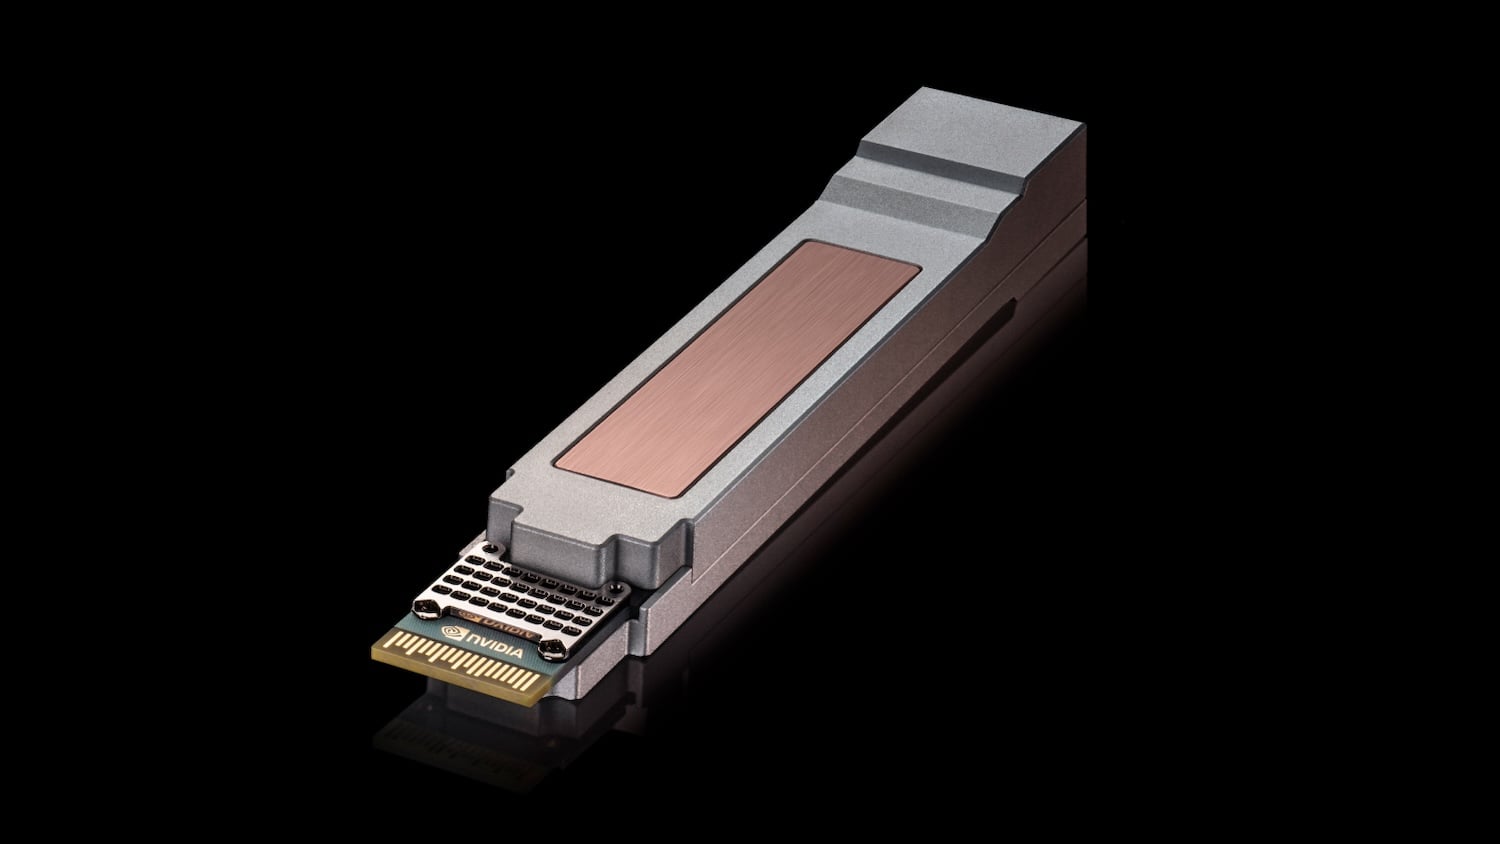
USFP ist ein Plan ohne Zeitplan für die Mustererstellung oder Verfügbarkeit. NVIDIA und Cisco beabsichtigen, das Design durch eine gemeinschaftlich getragene Multi-Source-Vereinbarung in eine offene Industriespezifikation umzuwandeln. Es ist Teil eines größeren Beitragspakets von NVIDIA zum OCP Global Summit, das auch Vera-Rubin-Rack-Designs, DSX-AI-Fabriksoftware, Anlagen- und Netzspezifikationen, 800-VDC-Stromversorgung sowie Ethernet-Projekte mit Meta und Google umfasst.
USFP erhöht die Anzahl der Fahrspuren und die Bandbreitendichte des Frontpanels
USFP verdoppelt sowohl die Anzahl der Lanes als auch die Datenrate pro Lane im Vergleich zu heutigen Modulen. Laut NVIDIA und Cisco ermöglicht dies einem Switch, mehr 1.6-Tb/s-Endpunkte anzuschließen, ohne eine zusätzliche Netzwerkebene zu benötigen. Die Module sind sowohl für Switches als auch für SuperNICs geeignet. Die Unternehmen sehen die Portdichte an der Vorderseite als limitierenden Faktor für das Wachstum von KI-Netzwerken: Sobald ein Switch keine Ports mehr bietet, ist der nächste Schritt eine weitere Switch-Ebene mit mehr optischen Schnittstellen, was Latenz, Stromverbrauch und Kosten erhöht. USFP behält das steckbare Modell bei, sodass die Module weiterhin vor Ort austauschbar und wartungsfreundlich bleiben.
„Der Aufbau der weltweit größten KI-Fabriken beginnt mit der Überarbeitung selbst kleinster Verbindungen“, sagte Gilad Shainer, Senior Vice President bei NVIDIA. Bill Gartner, Senior Vice President und General Manager für optische Systeme und Optik bei Cisco, erklärte, dass die Steigerung der Übertragungsrate von 400 Gbit/s pro Lane bei steckbaren Optiken mehr als eine inkrementelle Erweiterung der aktuellen Moduldesigns erfordere.
Ein neuer Anschluss unterstützt 400-Gbit/s-Signalisierung
Der Stecker ist eine zweidimensionale Kontaktanordnung mit einem zweistufigen Einsteckverfahren, bei dem die Hochgeschwindigkeitskontakte erst nach dem Einsetzen des Moduls aktiv werden. Laut NVIDIA und Cisco reduziert dies den Kontaktverschleiß, verbessert die Signalintegrität und macht die Einsteckkraft besser vorhersagbar. Der Stecker ist für 400 Gbit/s pro Lane ausgelegt und verbessert laut den Herstellern auch die Leistung bei 200 Gbit/s pro Lane.
Ein USFP-Modul kann bis zu 100 W ohne dedizierten Kühlkreislauf im Transceiver abführen. Laut den Herstellern vereinfacht dies das Switch-Design und verbessert die Zuverlässigkeit. Jede USFP-Konfiguration unterstützt optische Designs, die die Signalverarbeitung vereinfachen und so Latenz und Stromverbrauch reduzieren. Das Format ist mit einer Vielzahl optischer Technologien und Reichweitenklassen kompatibel. NVIDIA und Cisco arbeiten mit TE Connectivity und Amphenol an Gehäusen, Steckverbindern und Modulen. Weitere Partner werden erwartet. Die Zusammenarbeit baut auf den bestehenden Interoperabilitätsarbeiten zwischen NVIDIA Spectrum-X und Cisco Silicon One-basierten Ethernet-Netzwerken auf.
MGX 1.2 erweitert die Vera Rubin Rack-Infrastruktur
NVIDIA steuerte seine Vera-Rubin -Rack- und Compute-Tray-Designs über seine offene MGX-Architektur zum OCP bei. Diese Designs sind Teil des MGX-Referenzdesigns der dritten Generation in der Open DC Initiative des OCP, zusammen mit den offenen Flüssigkeitskühlungsdesigns MQD und MQDB. Die MGX-1.2-Spezifikation erweitert die Spezifikationen um eine stufenlose Flüssigkeitskühlung, eine interoperable Verbindungsinfrastruktur für Racks und eine flüssigkeitsgekühlte 5,000-A-Stromschiene. Sie bietet native Unterstützung für 19-Zoll-Geräte und Rack-Installationen bis zu 250 kW.
Konfigurierbare I/O-Einschübe, lüfterlose, flüssigkeitsgekühlte Recheneinschübe und standardisierte Strom- und Kühlschnittstellen runden die Spezifikation ab. Laut NVIDIA verkürzen die gemeinsamen Schnittstellen die Montage-, Test- und Servicezeiten für Partner. Eine separate Spezifikation für das Vera-CPU- Rack erweitert MGX über beschleunigtes Rechnen hinaus. NVIDIA positioniert Vera Rubin NVL72 als Plattform für umfangreiches Training und Inferenz und das Vera-CPU-Rack für den Toolaufruf, die Orchestrierung und die Sandbox-Ausführung, die agentenbasierte Workloads mit sich bringen.
DSX OS fügt Netzwerk-, Rack- und Clusterverwaltungskomponenten hinzu.
NVIDIA hat DSX OS, die offene Betriebsschicht seiner DSX AI Factory-Plattform, um vier Open-Source-Komponenten erweitert. Der NVIDIA Config Manager automatisiert die Konfiguration, Validierung und Wartung von Switches in KI-Systemen. Die NVIDIA Cluster Readiness Engine führt vor dem Trainingsstart Stresstests für GPU-Cluster mit Workload-Simulationen durch. Laut NVIDIA werden dadurch Hardwareprobleme erkannt, die andernfalls zum Abbruch von Trainingsaufträgen führen würden.

Der NVIDIA Rack Management Service behandelt das Rack als Betriebseinheit und bietet Hardwareabstraktion und Firmware-Management auf dieser Ebene. Der Cluster API Provider für den NVIDIA Infrastructure Controller übernimmt die Bare-Metal-Bereitstellung und das Onboarding von Mandanten. NVIDIA gibt an, dass sich Rohhardware innerhalb weniger Stunden in produktionsreife Cluster verwandeln lässt. Die Komponenten basieren auf NVIDIAs Erfahrung mit DGX Cloud und ermöglichen Cloud-Anbietern und Softwarepartnern die Integration von KI-Fertigungsprozessen in Multi-Tenant-Plattformen.
Offene Spezifikationen umfassen Anlagendesign und Netzrückgewinnung
NVIDIA, AMD, Google und Meta haben die Open Data Center Specification v0.7 veröffentlicht, einen gemeinsamen Entwurf für Rechenzentren, der Stromversorgungsarchitektur, Kühlung und physische Anordnung umfasst und von Geräteherstellern, Colocation-Anbietern und Betreibern als Grundlage für ihre Planung genutzt werden kann. Google, Meta, Microsoft und NVIDIA haben außerdem die OCP Grid Resilience Specification veröffentlicht. Diese definiert, wie große KI-Rechenzentren Stromausfälle überstehen sollen: die Verbindung aufrechterhalten, automatisch reagieren und innerhalb von zwei Sekunden nahezu Volllast erreichen. Laut NVIDIA entsprechen beide Spezifikationen dem DSX-Referenzdesign.
Visionbay hat Pläne für K-1 vorgestellt, eine KI-Fabrikplattform, die NVIDIAs 800-VDC -Referenzarchitektur mit Vertiv-Stromversorgungs- und Kühlkomponenten für zukünftige Vera-Rubin-Implementierungen kombiniert. K-1 verlagert die AC/DC-Wandlung in Cluster-basierte Stromversorgungszentren und verteilt 800 VDC näher an die Rechenzentren. Die Einführung von 800 VDC, Flüssigkeitskühlung und modularer Erweiterung erfolgt schrittweise. Visionbay hat noch keinen Einführungstermin genannt.
Meta setzt auf Spectrum-6 und Multiplane-Netzwerke
Meta setzt in seinen Vera Rubin KI-Fabriken auf NVIDIA Spectrum-6 102.4-Tbit/s-Ethernet. Laut NVIDIA verdoppelt Spectrum-6 die Schaltkapazität und die Bandbreite pro Lane im Vergleich zu Spectrum-4 und erreicht 200 Gbit/s pro Lane mit Leistungsisolation zwischen den Jobs. Metas Spectrum-6-basierter N-IceCube-Switch wird in das flüssigkeitsgekühlte IcePack 100T-Rack integriert und nutzt FBOSS, Metas offene Switch-Software, die die OCP Switch Abstraction Interface für die herstellerunabhängige Hardwaresteuerung verwendet.
Spectrum-X Multiplane kombiniert Spectrum-6-Switches mit ConnectX-9 SuperNICs und verteilt den GPU-Datenverkehr hardwareseitig auf bis zu acht unabhängige Netzwerkebenen. Laut NVIDIA skaliert das Design mit weniger Switch-Ebenen auf über 100,000 GPUs. Fällt eine Komponente aus, wird der Datenverkehr auf die verbleibenden Ebenen umgeleitet, sodass die Prozesse mit reduzierter Bandbreite fortgesetzt werden. Meta und NVIDIA bestätigen die erhöhte Ausfallsicherheit sowohl lokal als auch in der Cloud, ohne jedoch konkrete Zahlen zu veröffentlichen.
Google Falcon Transport zielt auf zukünftige NVIDIA-Netzwerkhardware ab
NVIDIA und Google haben die Unterstützung von Falcon Transport für zukünftige NVIDIA ConnectX-10 SuperNICs und BlueField DPUs angekündigt. Falcon ermöglicht zuverlässige Datenübertragung über Ethernet durch Multipath-Load-Balancing, programmierbare Staukontrolle, hardwarebasierte Wiederherstellung bei Paketverlusten und Sicherheit pro Verbindung. NVIDIA implementiert dies mit Hardwarebeschleunigung und DOCA-Software, sodass NVIDIA- und Google-NICs ein gemeinsames Transportprotokoll verwenden, während Anwendungen weiterhin die standardmäßigen RDMA-Schnittstellen nutzen. Laut den Unternehmen verbessert dies die Bandbreitennutzung und die Vorhersagbarkeit der Leistung für KI- und Speicherdatenverkehr bei wachsendem Ethernet-Netzwerk.
Cisco liefert Silicon One G300-Systeme aus und fügt ein 51.2T Top-of-Rack-Teil hinzu
Cisco nutzte die gleiche OCP-Ankündigung, um sein Silizium-Portfolio zu aktualisieren. Der Silicon One G300 mit 102.4 Tbit/s ist jetzt als Muster verfügbar, und die ersten G300-basierten Systeme werden bereits an Kunden ausgeliefert. Zudem hat Cisco den G302 vorgestellt, einen 51.2 Tbit/s Switch-ASIC mit 200G SerDes für Top-of-Rack-Systeme mit 1.6T-Optik und direkter Chip-Flüssigkeitskühlung. Die Auslieferung ist für Ende 2026 geplant. Cisco gab außerdem bekannt, dass sein 51.2 Tbit/s P200 Deep-Buffer-Routing-Silizium nun bei Hyperscalern im Einsatz ist: Microsoft hat P200-Systeme in die Produktion überführt, und Alibaba Cloud hat seinen hauseigenen Quantum Cat Router auf P200-Basis in seinem eCORE-Backbone mit SONiC implementiert.
Die übrigen Cisco-Produkte sind betriebsbereit. Der Cisco 8001 ist ein Management-Switch auf Basis des Silicon One A100 in 10G- und 1G-Versionen, der SONiC in das Out-of-Band-Netzwerk integriert. Dadurch können Betreiber einheitliche APIs und Automatisierungen vom Fabric bis zum Rack nutzen. Cisco-validiertes SONiC ist in der Nexus-One-Architektur enthalten. Die Option „Live Protect“, die bekannt gewordene Sicherheitslücken zur Laufzeit behebt, bevor ein permanenter Fix bereitgestellt wird, ist für Mitte 2027 geplant. Cisco ist Mitglied von ESUN und arbeitet nach eigenen Angaben an der Spezifikation 1.0 für Scale-up-Netzwerke.


 Amazon