

NVIDIA hat eine neue DGX Spark -Konfiguration mit 64 GB Unified Memory auf den Markt gebracht . Die neue Version ist ab 4,999 US-Dollar erhältlich und wird seit dem 23. Oktober exklusiv über Acer, ASUS, Dell, Gigabyte, HP und MSI vertrieben. Sie verfügt über denselben GB10 Grace Blackwell Superchip, ConnectX-7-Netzwerkfunktionen, DGX OS und denselben NVIDIA AI-Software-Stack wie das 128-GB-Modell. Laut NVIDIA kann die 64-GB-Variante Modelle mit bis zu 100 Milliarden Parametern für lokale Inferenz, Feinabstimmung und Agenten-Workflows ausführen, ohne Daten in die Cloud zu senden.
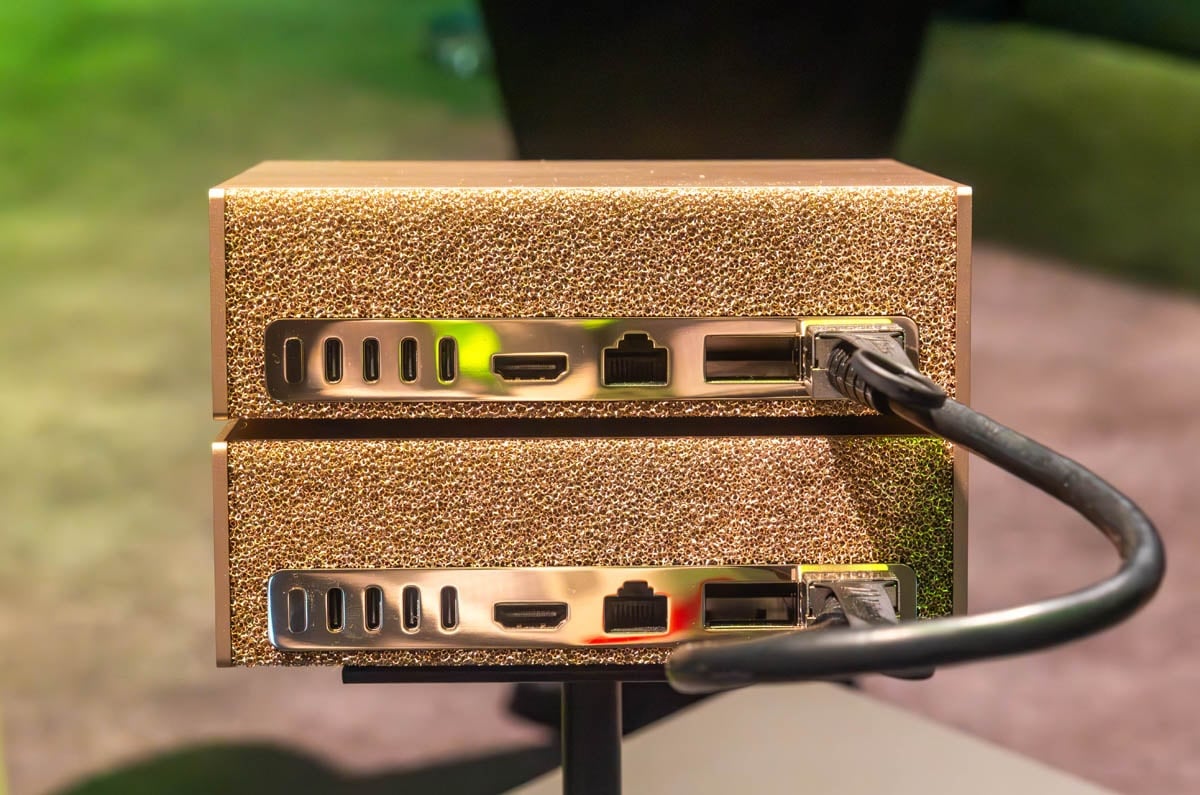
Zwei 64-GB-Sparks für einen 128-GB-Cluster
Das günstigere Modell (im Vergleich zu den Marktpreisen des größeren Modells) zeichnet sich dadurch aus, dass zwei Geräte im Cluster sehr gute Ergebnisse liefern. Jedes DGX Spark verfügt über eine integrierte ConnectX-7-Netzwerkkarte, sodass zwei Geräte direkt über ein QSFP-Kabel an eine 200-GbE-Verbindung angeschlossen werden können – ohne zwischengeschalteten Switch. Der NVIDIA Sync Cluster Assistant übernimmt die Geräteerkennung, validiert die Gerätekonfiguration und richtet das ConnectX-7-Netzwerk ein. Zwei 64-GB-Einheiten bilden zusammen einen gemeinsamen Speicher von 128 GB, was laut NVIDIA für Modelle mit bis zu 200 Milliarden Parametern ausreicht.
Die internen Zahlen von NVIDIA für das Kopplungssystem basieren auf Qwen3.8 27B: Zwei geclusterte 64-GB-Systeme erreichten eine bis zu 1.7-fache Leistung im Vergleich zu einem einzelnen 128-GB-System. Da auf jedem Knoten dieselben CUDA-Bibliotheken, Inferenz-Engines und dasselbe DGX-OS-Image verwendet werden, erstreckt sich eine Arbeitslast über beide Einheiten, ohne dass die Softwareumgebung neu erstellt werden muss. Unterstützte Inferenz-Frameworks sind unter anderem llama.cpp, Ollama, vLLM und LM Studio. NVIDIA bietet ein kurzes Video zur Verbindung zweier Spark-Systeme mit NVIDIA Sync an.
Wir betrieben einen verteilten Inferenzcluster auf Dell-, Gigabyte- und HP-DGX-Spark-Einheiten und haben kürzlich einen gemeinsam genutzten Speicher hinter einem Spark-Cluster über 100GbE implementiert . Die 64-GB-Variante senkt den Einstiegspreis für ein solches Setup, allerdings verfügt eine einzelne Einheit nun nur noch über die Hälfte des Speichers des ursprünglichen Modells.
Der NVIDIA Sync Model Launcher erscheint Ende Oktober.
Der zweite Teil der Ankündigung betrifft Software. Der NVIDIA Sync Model Launcher, der Ende Oktober erscheinen soll, lädt ein Modell herunter und startet es auf einem einzelnen Spark-Knoten oder einem Clusterpaar (beispielsweise Qwen3.8 27B). Anschließend stellt er den resultierenden Endpunkt den Entwicklerrechnern im Netzwerk zur Verfügung. Zudem kann er OpenCode für dieses Modell einrichten, sodass Entwickler im Browser programmieren können, während der Spark-Cluster die Inferenz durchführt.
Die 64-GB-Systeme werden mit derselben Software wie das 128-GB-Modell ausgeliefert: DGX OS, CUDA-X KI-Bibliotheken, das NVIDIA Agent Toolkit, Nemotron Open-Source-Modelle und Laufzeitumgebungen wie Ollama, vLLM und PyTorch mit CUDA. NVIDIA positioniert das System als lokale Plattform für Agenten, Inferenz, Feinabstimmung, Data Science und Edge-Entwicklung. Dank des ConnectX-7-Anschlusses kann später eine zweite Einheit hinzugefügt werden. Für die Entwicklung von Agenten verweist NVIDIA auf seine Playbooks für NemoClaw, OpenClaw, Hermes Agent und OpenShell auf build.nvidia.com als Ausgangspunkt.


 Amazon