

Deskside-KI-Systeme auf Basis von NVIDIAs GB10 haben eine Aufgabe, die sie hervorragend erfüllen: 128 GB einheitlichen Speicher und eine Petaflop-Rechenleistung so nah am Benutzer bereitzustellen, dass Iterationen sofort erfolgen. Was ihnen fehlt, ist die Anbindung an den bereits vorhandenen Speicher des Unternehmens. Jede DGX Spark- und OEM-Variante verfügt über einen einzelnen kurzen M.2-Steckplatz, der die lokale Kapazität auf etwa 4 TB begrenzt und alle Datensätze, Modelle und Prüfpunkte auf diesem Rechner außerhalb der Governance-, Zugriffskontroll-, Backup- und Audit-Trail-Systeme des Rechenzentrums platziert. Multipliziert man dies mit einem Labor, einer Abteilung oder einem Campus, ergeben sich Dutzende isolierter 4-TB-Inseln, von denen jede ihre eigene Kopie derselben Modelle und Datensätze enthält – jede nur so sicher wie der Schreibtisch, auf dem sie steht.
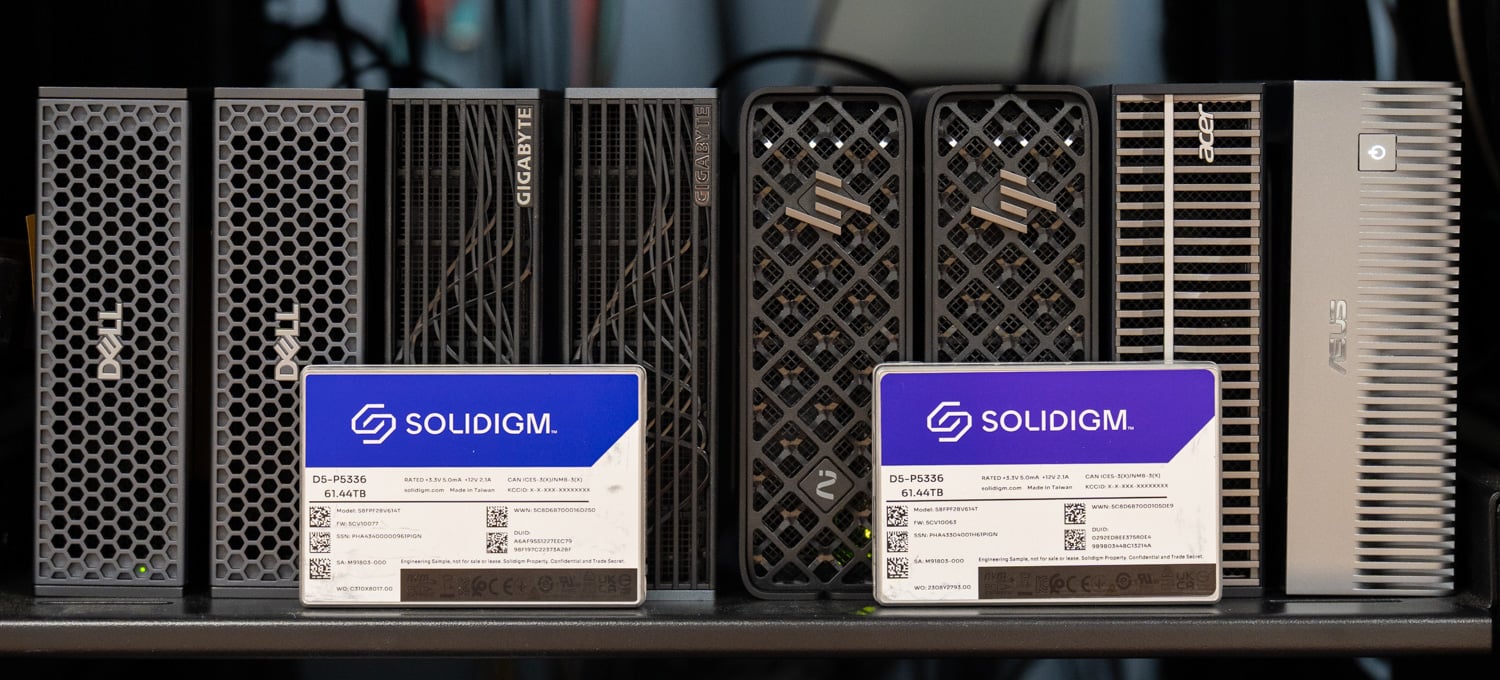
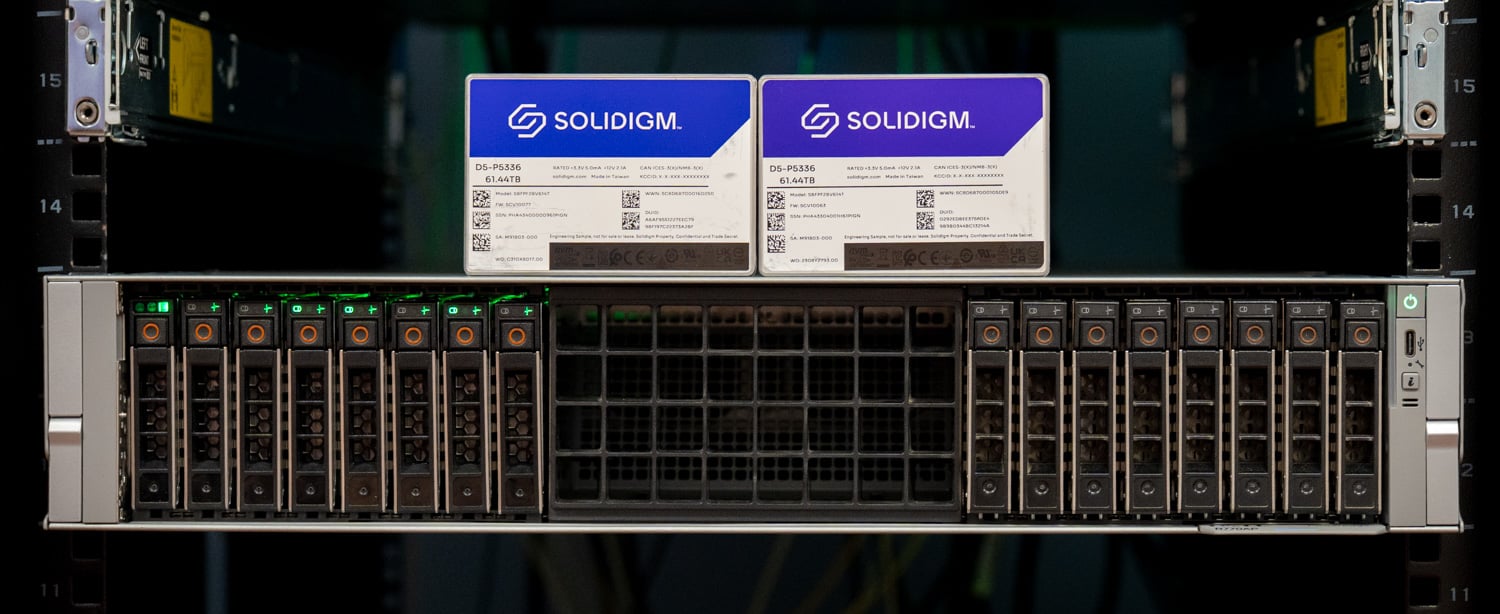
Dieses Projekt verlagert das Speicherproblem zurück ins Rechenzentrum. Wir haben einen DGX Spark Shared Storage Host auf Basis eines Dell PowerEdge R770AP, acht Solidigm D5-P5336 QLC SSDs im Graid SupremeRAID RAID 5-Verbund, Broadcom 400GbE-Netzwerk und Tuxera Fusion für NFS über RDMA aufgebaut und anschließend acht Sparks an die 100GbE-Ports angeschlossen. Jeder Spark im Netzwerk greift über eine einzige Leitung auf denselben verwalteten, paritätsgeschützten Speicherpool zu. Eine einzige Kopie jedes Modells und Datensatzes dient allen Geräten. Keine Workstation benötigt mehr Speicherplatz als standardmäßig vorhanden. Die Sparks selbst können im Rack neben dem Array platziert werden, wo sie einfacher zu sichern, zu kühlen und gemeinsam zu nutzen sind. Im Mittelpunkt dieses Aufbaus steht der Speicherort der Daten, und jeder NVMe-Server mit schnellen Netzwerkkarten eignet sich dafür. Die Oregon State University, die ein groß angelegtes Spark-Labor für KI-Lernen plant und ihren Studenten Zugang zu Forschungsdatensätzen im Terabyte-Bereich ermöglichen möchte, teilte uns ihre Überlegungen mit, als wir den Aufbau konzipierten. Für Daten dieser Größenordnung war gemeinsamer Speicher der Ansatz, der für diese Evaluierung am besten geeignet war.
Wichtige Erkenntnisse
- Ein Array, acht Sparks, keine Client-Software: Acht DGX Sparks von fünf OEMs mounten NFS/RDMA-Freigaben von einem einzigen Solidigm D5-P5336 QLC-Array hinter Graid SupremeRAID und Tuxera Fusion über die bereits vorhandenen 100GbE-Ports mit einer einzeiligen Mount-Anweisung auf dem Standard-Ubuntu.
- Gehostete Modelle werden wie lokale Modelle geladen: Ein 78 GB großes Qwen3.5-122B-A10B-NVFP4-Modell wurde auf einem Spark in 269.6 Sekunden vom gemeinsamen Array geladen, was innerhalb von 13 % der 239.6 Sekunden liegt, die der gleiche Spark von seiner internen NVMe benötigte. Acht Sparks, die gleichzeitig dieselbe einzelne Kopie luden, benötigten zwischen 232.8 und 326.5 Sekunden.
- Auf jedem Schreibtisch ersetzt ein Exemplar ein Datensilo: Modelle und Datensätze auf verwaltetem, paritätsgeschütztem Rechenzentrumsspeicher ersetzen die Kopien pro Arbeitsplatz auf 4-TB-M.2-Laufwerken. Dadurch steigt die Auslastung, der Kopieraufwand sinkt und Spark benötigt weder ein Speicher-Upgrade noch zusätzlichen Platz auf dem Schreibtisch. Für ein groß angelegtes KI-Lernlabor wie das von der Oregon State University, in dem Forschungsdatensätze mehrere zehn Terabyte umfassen, ist dies der Ansatz, der sich für unseren Evaluierungsfall als geeignet erwiesen hat.
- Die Laufwerke setzen die Obergrenze, das Netzwerk hat aber noch Spielraum: Mit allen acht Spark-Laufwerken gleichzeitig erreichte das RAID-5-Array mit acht Laufwerken eine maximale Übertragungsrate von knapp 25 GiB/s (ca. 214 Gbit/s). Dies entsprach 27 % der maximalen Übertragungsrate von 800 Gbit/s, die die beiden Broadcom BCM57608-Netzwerkkarten im Host-System übertragen können. Eine einzelne Spark-SSD erreichte im Array eine Übertragungsrate von 10.8 GiB/s, was der schnellsten internen M.2-SSD entspricht, die wir jemals in einem GB10-System gemessen haben.
- Die Governance ist Teil des Protokolls: NFS mit RDMA ordnet benutzerbezogene Ordner, gemeinsam genutzte Datensätze und gehostete Modelle in einem Namensraum mit Active Directory-, Kerberos- und LDAP-Anbindungen zusammen. Dadurch bleiben die Daten unter der Kontrolle des Rechenzentrums, während die Sparks in das Rack umziehen.
Das Problem mit einer KI-Insel auf jedem Schreibtisch
Der DGX Spark und seine OEM-Varianten von Dell, GIGABYTE, HP, Acer und ASUS basieren alle auf der GB10-Plattform und bieten die gleiche Speicherkapazität. In unserem ursprünglichen Test des DGX Spark war der Speicherplatz die größte Einschränkung der Plattform. Der interne Steckplatz ist für kurze M.2-Laufwerke ausgelegt, sodass die 8-TB-Client-SSDs im 2280-Formfaktor nicht passen. Der von uns im August getestete Luisuantech GP Spark löst dieses Problem mit einem M.2-Gehäuse mit vier Einschüben, das an einen 100GbE-Port angeschlossen wird. Dies ist eine elegante Lösung für einen Spark auf einem Schreibtisch und ermöglicht im Labormaßstab die Nutzung eines größeren Speichers auf jedem Schreibtisch.
Die Speicherkapazität ist die eine Hälfte des Problems; die andere Hälfte betrifft den Verbleib der Daten auf den Rechnern. Ein 78-GB-Modell, das auf einen Spark heruntergefahren wird, ist eine Kopie, die in der IT-Abteilung niemand einsehen kann. Ein Forschungsdatensatz, der auf lokalem Flash-Speicher abgelegt wird, ist eine Kopie, die außerhalb des Backup-Plans, der Zugriffsrichtlinien und institutioneller Audits liegt. Zehn Sparks in einem Labor bedeuten zehn Kopien mit demselben Speicherbedarf, die 780 GB Flash-Speicher belegen, der anderweitig genutzt werden könnte. Zehnmal kann ein Datensatz mit dem Rechner das Labor verlassen. Das Problem verschärft sich mit steigender Datenmenge, sei es bei GB10-Systemen oder einer beliebigen Desktop-KI-Infrastruktur. Jedes Unternehmen, das eine Laptop-Flotte verwaltet, kennt dieses Muster, und die Lösung war damals dieselbe: Die Daten auf gemeinsam genutztem Speicher im Rechenzentrum speichern und die Endgeräte als Endgeräte nutzen.
Glücklicherweise hat NVIDIA die Spark mit entsprechenden Anschlüssen ausgestattet. Jede Einheit verfügt über zwei QSFP56-Steckplätze auf einem integrierten ConnectX-7-Chip und bietet eine maximale nutzbare Bandbreite von 200 Gbit/s über zwei PCIe Gen5 x4-Verbindungen. In unserem Test des DGX Spark-Clusters haben wir die Split-Role-Konfiguration beschrieben, bei der ein Steckplatz an einen anderen Spark und der andere an den Speicher angeschlossen wird. In diesem Projekt wird pro Spark ein Steckplatz für den Speicher mit 100 Gbit/s genutzt, der zweite bleibt für Clustering oder zusätzliche Bandbreite frei. Mit 100 Gbit/s stehen jedem Spark theoretisch etwa 12.5 GB/s Bandbreite zum Speicherhost zur Verfügung, was die Bandbreite des internen M.2-Steckplatzes der meisten dieser Systeme übersteigt.
Sobald die Daten am anderen Ende der Verbindung liegen, ändert sich die Rolle des Spark. Er wird zu einem Rechenendpunkt mit Boot- und lokalem Cache-Laufwerk, und die Speicherkapazität muss nicht mehr pro Workstation erworben werden. Ein Modell oder Datensatz wird nur einmal geschrieben und von jedem Client gelesen, wodurch die Speicherauslastung steigt und die Anzahl der Kopien sinkt. Der Datenschutz wird auf ein paritätsgeschütztes Array in einem Servergehäuse verlagert, und Zugriffskontrolle, Verschlüsselung ruhender Daten, Datensicherung und Auditierung erfolgen dort, wo sie bereits für alle anderen Funktionen üblich sind. Da der Spark nun lediglich Strom und eine 100-GbE-Verbindung benötigt, muss er nicht mehr auf einem Schreibtisch stehen. Im Rack neben dem Speicherhost platziert, ist er kühler, leiser, physisch gesichert und steht jedem zur Verfügung, der ihn benötigt.
Der Speicherhost
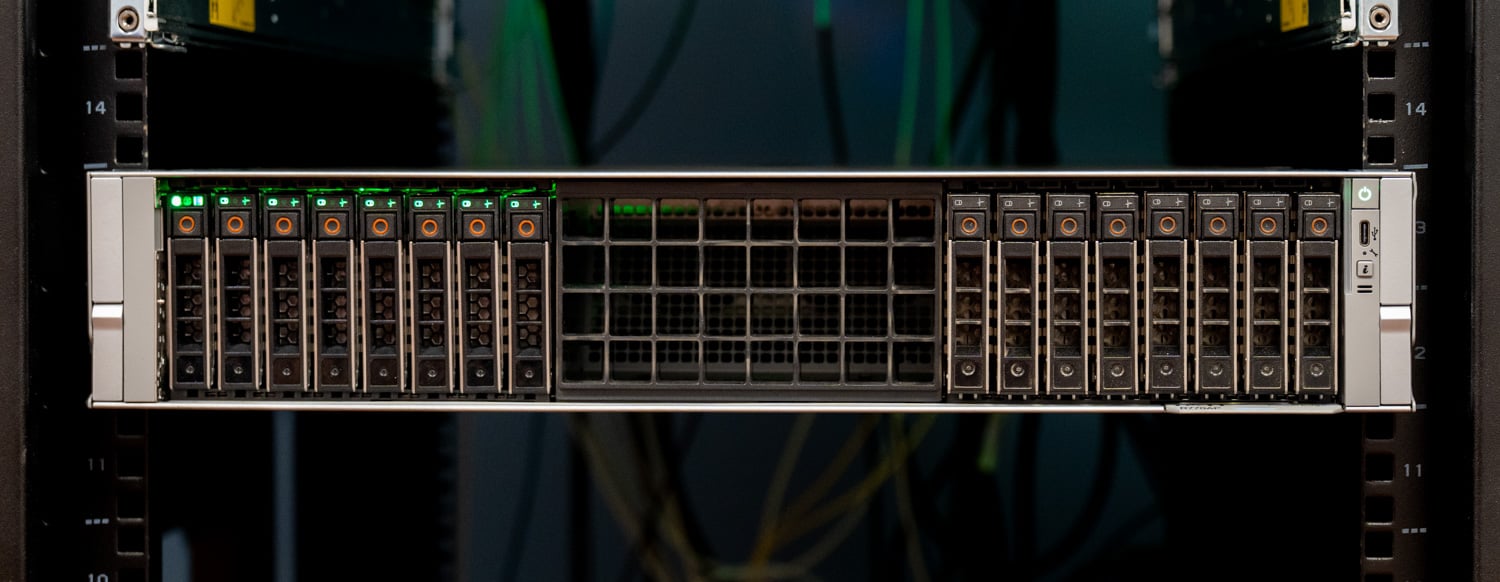
Als Speicherserver dient ein Dell PowerEdge R770AP , dieselbe 2U-Xeon-6-Plattform, die wir bereits Anfang des Jahres getestet haben. Wir nutzten ihn, da er zu Projektbeginn im Labor kostenlos zur Verfügung stand. Jeder NVMe-Server mit Platz für schnelle Netzwerkkarten und eine kleine GPU eignet sich dafür, und der R770AP ist eine Möglichkeit, ihn zu konfigurieren, auch wenn er etwas überdimensioniert ist. Unser Server ist mit zwei Xeon-6-6978P-Prozessoren und 1.5 TB DDR5-RAM auf 24 DIMM-Steckplätzen ausgestattet, nutzt einen seiner beiden Blöcke mit je acht Gen5-NVMe-Einschüben und hängt die Laufwerke sowie die Graid-GPU an CPU 0 an, während die beiden 400-GbE-Adapter an CPU 1 angeschlossen sind. Auf dem Server läuft Ubuntu 24.04.
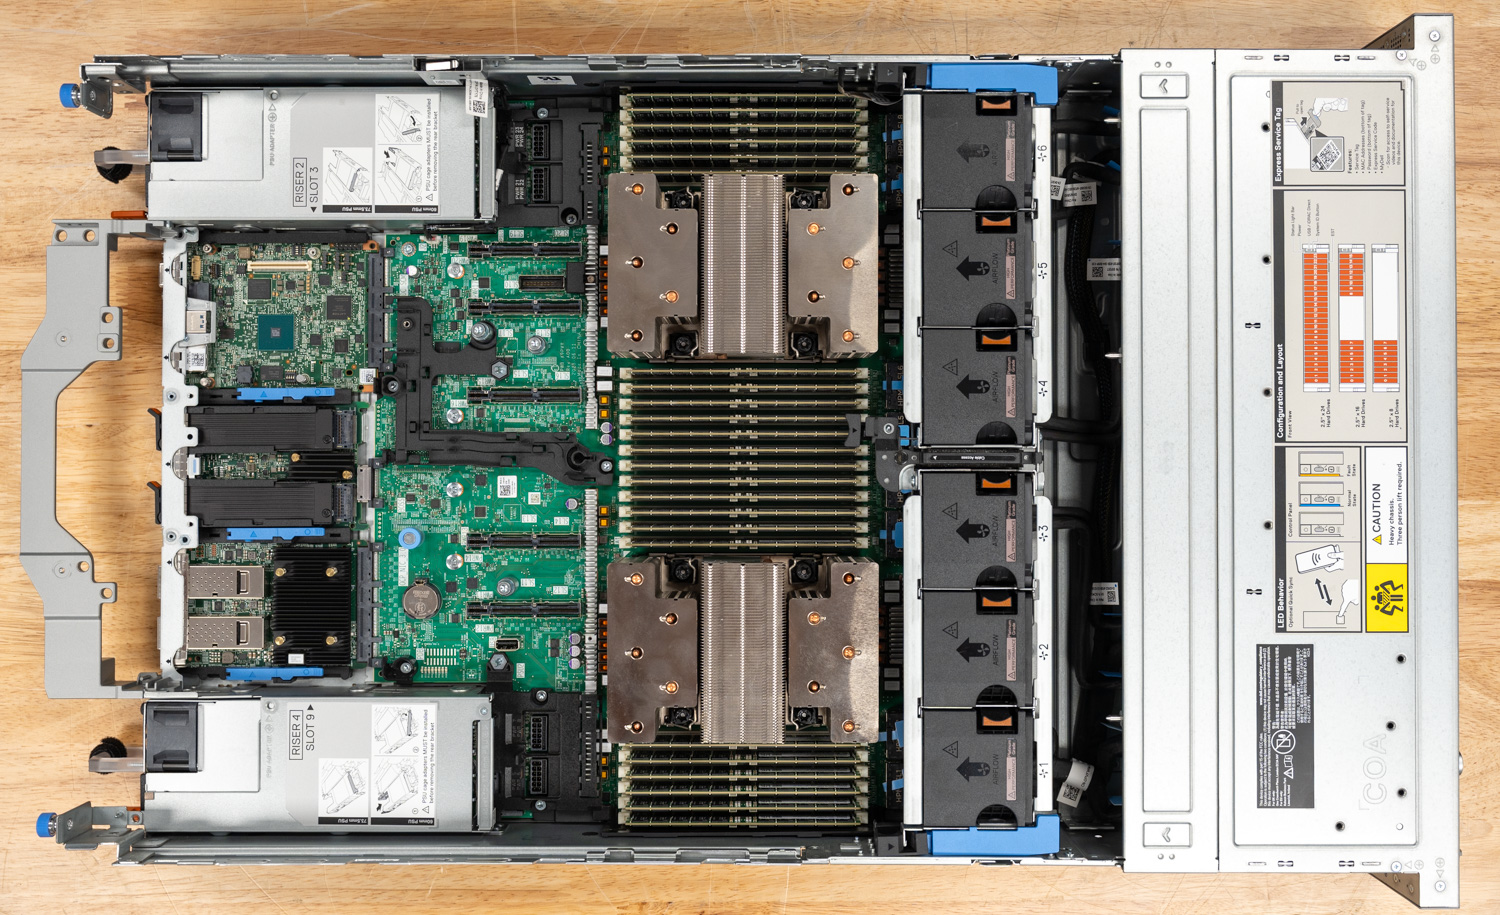
| Komponente | Speicherhostkonfiguration |
|---|---|
| Server | Dell PowerEdge R770AP, 2U, 16x 2.5-Zoll Gen5 NVMe-Einschübe |
| CPU | 2x Intel Xeon 6 6978P |
| Memory | 1.5 TB DDR5 (24 x 64 GB) |
| Lagerung | 8x Solidigm D5-P5336 61.44 TB U.2 PCIe 4.0 QLC (491.52 TB roh) |
| RAID | Graid SupremeRAID, RAID 5 über alle acht Laufwerke, NVIDIA RTX A2000 GPU auf CPU 0 |
| Dateisystem | XFS auf dem virtuellen SupremeRAID-Laufwerk |
| Dateiserver | Tuxera Fusion (Fusion NFS, private Vorabversion), NFS 4.1 über RDMA (RPC-RDMA auf Port 20049), Benutzermodus |
| Netzwerken | 2x Broadcom BCM57608 (Thor 2) Single-Port 400GbE, PCIe Gen5 x16 auf CPU 1, RoCEv2 |
| Schalter | Dell PowerSwitch Z9864F-ON, 64x 800GbE OSFP112, Enterprise SONiC |
| Kundenlinks | 800G-Glasfaserkabel aufgeteilt in 8x100GbE, eine Verbindung pro Spark, vier Sparks pro Speicher-NIC in separaten VLANs. |
| Kunden | 2x Dell Pro Max mit GB10, 2x GIGABYTE AI TOP ATOM, 2x HP ZGX Nano G1n, Acer Veriton GN100, ASUS Ascent GX10 |
| OS | Ubuntu LTS 24.04 |
Warum QLC und warum der D5-P5336?
In unseren Gesprächen mit der Oregon State University über das Spark-Laborkonzept war die Speicherkapazität die wichtigste Anforderung, da die verwendeten Forschungsdatensätze sehr umfangreich sind. Der Server soll alle Daten speichern können, die ein ganzes Spark-Labor benötigt, und sie so bereitstellen, dass sie von vielen Clients gleichzeitig gelesen werden können. Das entspricht einem leseintensiven Profil mit großen Blöcken und hoher Kapazität – genau das Profil, für das QLC entwickelt wurde. Die D5-P5336- Familie bietet Speicherkapazitäten von 7.68 TB bis 122.88 TB. Die hier verwendeten 61.44 TB großen U.2-Laufwerke erreichen laut Solidigm sequentielle Lesegeschwindigkeiten von bis zu 7,000 MB/s, sequentielle Schreibgeschwindigkeiten von 3,000 MB/s, 1.005 Millionen zufällige 4K-Lese-IOPS und eine Ausdauer von 65.2 PBW, was 0.58 Schreibvorgängen pro Tag über fünf Jahre entspricht. Die Daten basieren auf 192-lagigem QLC-NAND mit einer 16-KB-Indirektionseinheit.
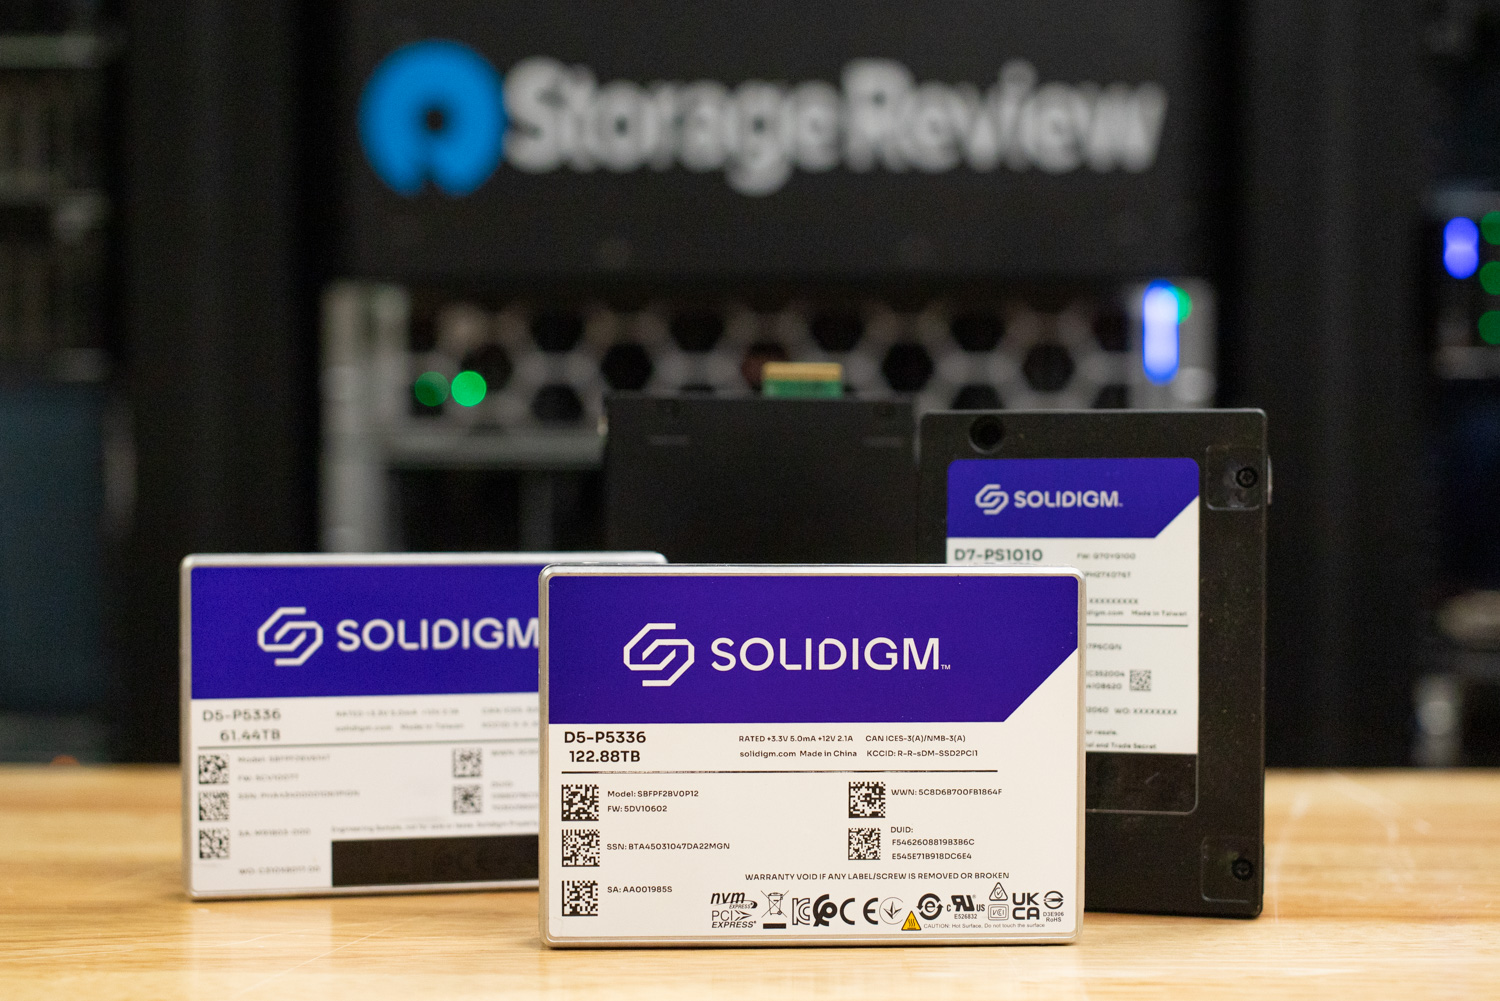
Die acht 61.44-TB-Festplatten belegen die Hälfte der vorderen Einschübe des R770AP. Bei der Serienkonfiguration kann jede beliebige Kapazität innerhalb der Produktfamilie und jede Anzahl an Einschüben gewählt werden. Selbst dann bieten acht Festplatten im RAID-5-Verbund rund 430 TB nutzbaren Speicherplatz mit Ausfallsicherheit für einzelne Festplatten. Das ist mehr als das Hundertfache der Kapazität des M.2-Steckplatzes eines Spark und ausreichend für die Modellbibliothek einer Fakultät, die gemeinsam genutzten Datensätze der Studierenden und die Benutzerverzeichnisse. Durch die Belegung der anderen acht Einschübe verdoppelt sich die Kapazität, ohne dass das Netzwerkdesign verändert werden muss. Die später in diesem Testbericht aufgeführten Dimensionierungszahlen verdeutlichen, warum die Festplatten der Schlüssel zum Wachstum sind.
Die 16-KB-Indirektionseinheit ist für diese Arbeitslast relevant, da die größere IU von Solidigm die Effizienz kleiner, zufälliger Schreibvorgänge zugunsten von Dichte und Kosten reduziert. Bei einem Share, der Modelle und Datensätze bereitstellt, sind kleine, zufällige Schreibvorgänge jedoch die Ausnahme. Das Laden von Modellen erfolgt durch große, sequenzielle Lesevorgänge. Das Streaming von Datensätzen erfolgt ebenfalls durch große, sequenzielle Lesevorgänge. Checkpoints und Studentendateien werden einmal geschrieben und häufig gelesen. Die daraus resultierende Arbeitsteilung ist optimal für ein Spark-Labor: Das gemeinsam genutzte QLC-Array speichert alle Daten, die von vielen gelesen werden, während die eigene M.2-SSD von Spark den Scratch- und Swap-Datenverkehr verarbeitet, der von einem einzelnen Benutzer geschrieben wird.
RAID auf einer GPU: Graid SupremeRAID
NVMe-RAID auf acht Gen4-Laufwerken mit jeweils 7,000 MB/s Lesegeschwindigkeit ist der Punkt, an dem eine herkömmliche Hardware-RAID-Karte zum Flaschenhals wird, da jedes Byte den PCIe-Steckplatz der Karte passieren muss. Software-RAID steht vor anderen Herausforderungen. Graid SupremeRAID lagert die Paritätsberechnungen auf eine GPU aus und hält den Datenpfad auf den PCIe-Lanes des Hosts. Daher konnten wir in unseren SupremeRAID-AE-Tests mit 16 Laufwerken Skalierungsraten von über 180 GB/s beobachten. Für diesen Host verwendeten wir SupremeRAID auf einer NVIDIA RTX A2000, einer kompakten Workstation-GPU.
Die acht D5-P5336-Festplatten wurden sicher gelöscht und sequenziell beschrieben, bevor sie an Graid übergeben und anschließend als einzelnes RAID-5-Array konfiguriert wurden. Das resultierende virtuelle Laufwerk wurde mit XFS formatiert und von Tuxera bereitgestellt. RAID 5 ist für eine solche Freigabe optimal: Ein Festplattenausfall hält das Array online, Wiederherstellungen erfolgen ohne Datenverlust, und der Kapazitätsverlust beträgt nur eine Festplatte pro acht. RAID 6 oder RAID 10 wären sinnvolle Alternativen für einen Produktiveinsatz, bei dem der Schutz vor Wiederherstellungsfenstern wichtiger ist als die Speicherkapazität. SupremeRAID unterstützt beide RAID-Level.
Das Netzwerk: Broadcom 400GbE und ein 800G-Kern
Die Speicherschnittstelle des Fabric besteht aus zwei Broadcom BCM57608 Thor 2-Adaptern im R770AP, jeweils eine 400GbE-Netzwerkkarte mit einem Port auf einer PCIe Gen5 x16-Schnittstelle. Broadcom positioniert die BCM57608 als die branchenweit energieeffizienteste 400G-Netzwerkkarte, und ihre Ausstattung macht sie ideal: RoCEv2 mit verbesserter DCQCN-Staukontrolle, adaptives Routing, Secure Boot mit einem Silizium-Root of Trust und Inline-kTLS-Verschlüsselungsauslagerung. RoCEv2 unterstützt in diesem Design NFS über RDMA, und die Staukontrolle verhindert, dass sich mehrere Clients gegenseitig behindern, wenn sie gleichzeitig Daten abrufen. Während der Entwicklung meldete der bnxt_en-Treiber, dass die optischen Module an den 400G-Ports unter Dauerlast die Warnschwelle von 70 °C erreichten. Wir behoben dieses Problem durch eine geringfügige Anpassung des Lüfterprofils am R770AP, und die Netzwerkkarten funktionierten anschließend einwandfrei.
Beide Netzwerkkarten sind an einen Dell PowerSwitch Z9864F-ON angeschlossen , unserem 800G-Core-Switch im Labor, auf dem Enterprise SONiC läuft. Der Z9864F-ON verfügt über 64 OSFP112-Ports mit 800GbE, die jeweils auf 2x400G, 4x200G oder 8x100G aufgeteilt werden können. Eine 800G-Glasfaser, die auf 8x100G aufgeteilt ist, verbindet die acht Sparks (jeweils eine Verbindung) mit demselben Switch, an dem auch die beiden 400G-Speicherverbindungen terminiert sind. Jede 400G-Netzwerkkarte befindet sich in einem eigenen VLAN und bedient vier Sparks. Der Speicherhost stellt somit zwei RDMA-Ziele bereit, und die Last wird systembedingt gleichmäßig auf diese verteilt. In der Praxis handelt es sich um eine Topologie mit voller Bandbreite: 8x100G Client-Bandbreite auf der einen Seite, 2x400G Speicher-Bandbreite auf der anderen Seite und ein Switch mit einer Kapazität von 102.4Tbps in der Mitte.
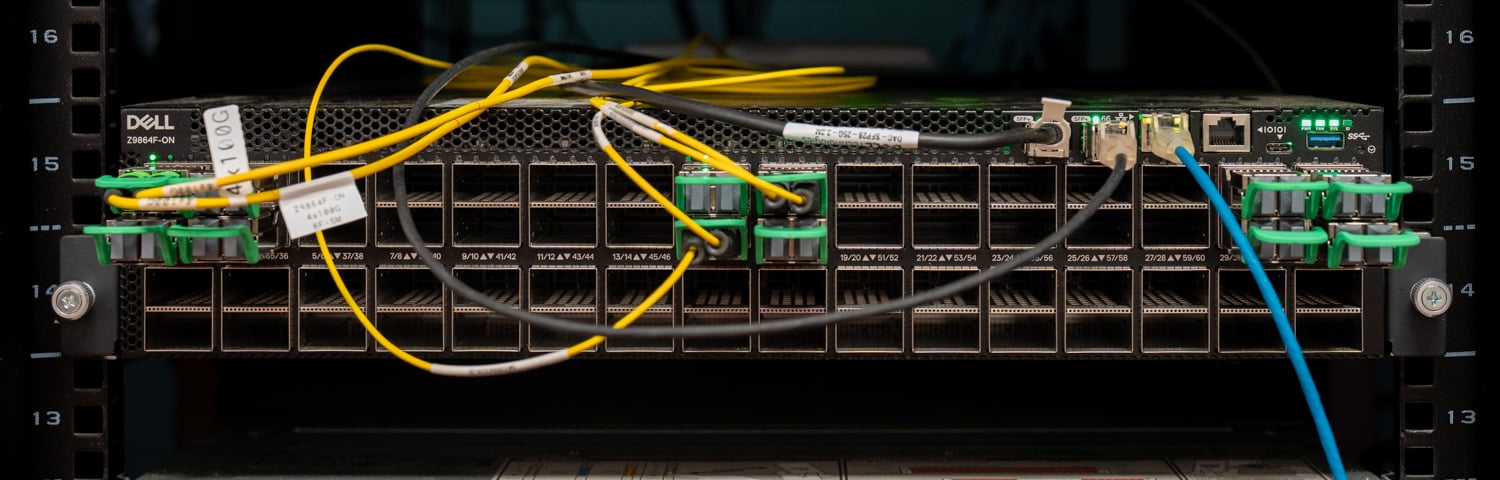
Wir validierten die Infrastruktur, bevor Speichersoftware darauf installiert wurde. Server-zu-Server-Tests zwischen dem R770AP und einem zweiten Host über die 400G-Verbindungen liefen in beide Richtungen mit Leitungsgeschwindigkeit, und der RDMA-Verkehr von den Sparks bestätigte, dass die 100G-Breakout-Ports mit voller Geschwindigkeit arbeiteten. Nachdem die Ingenieure von Tuxera die NFS-Freigaben eingerichtet hatten, zeigte iperf3 von den Sparks zu ihren jeweiligen Netzwerkkarten eine stabile Übertragungsrate von 99 Gbit/s mit vier parallelen Datenströmen und ohne Neuübertragungen.
Warum NFS und warum Tuxera?
Da Graid ein schnelles Blockgerät bereitstellt, kann der Speicherhost die Sparks entweder als NVMe-oF-Blockziele oder als Dateifreigaben bedienen. Wir haben den Blockpfad im GP Spark-Test geprüft, und er funktioniert gut für einen einzelnen Client. Für ein Labor mit vielen Sparks benötigten wir jedoch eine andere Lösung. Blockvolumes sind 1:1-zu-1-zugehörig; jeder Benutzer bräuchte eine LUN, und sobald zwei Benutzer auf denselben Datensatz zugreifen, muss dieser kopiert werden – genau dieses Problem soll unser Design lösen. NFS bildet die Schnittstelle: Ein einziger Namespace enthält gemeinsam genutzte Datensätze, gehostete Modelle und benutzerspezifische Ordner. Jede Spark-Einbindung nutzt den in Ubuntu bereits integrierten NFS-Client, und die Kubernetes- und Slurm-Tools, die eine Universität in einem Spark-Labor einsetzen würde, unterstützen alle NFS.
Fusion NFS ist die NFS-Komponente von Tuxera Fusion, dem Multiprotokoll-Dateiserver, der SMB und NFS auf einem einzigen, im Benutzermodus arbeitenden, multithreadfähigen Kern unterstützt. Wir haben Fusion SMB erstmals 2024 in einem Media-Workflow-Projekt von Solidigm und Tuxera getestet . Tuxera gibt Geschwindigkeiten von bis zu 22.7 GB/s über eine einzelne 200-GbE-Verbindung mit RDMA an, was laut eigenen Tests die Leistung von Kernel NFSD und Ganesha übertrifft. Das Produkt unterstützt NFS 4.1, Active-Active-Scale-Out-Clustering, transparentes Failover sowie die Integration von Active Directory, Kerberos und LDAP. Letzteres dient als Governance-Schnittstelle: Dasselbe Verzeichnis, das die Anmeldung bei Spark steuert, regelt auch, welche Daten auf der Freigabe sichtbar sind. Wichtig: Die von uns verwendete Version ist eine private Vorabversion von Fusion NFS, die laut Tuxera noch nicht vollständig für optimale Leistung optimiert ist und noch nicht kommerziell erhältlich ist. Die allgemeine Verfügbarkeit ist für November nach der SC'26 geplant.
Tuxera installierte Fusion auf dem R770AP, formatierte das Graid-Volume mit XFS und konfigurierte den Server mit NFS auf dem Standardport und RPC-RDMA auf Port 20049. SMB-Listener wurden weggelassen, da dieses Projekt ausschließlich NFS verwendet. Die anfängliche Thread-Konfiguration umfasste vier Protokoll-Threads mit jeweils acht Threads für Transport (Senden und Empfangen), VFS-Daten und VFS-Metadaten. Tuxera beschreibt dies als Ausgangspunkt für die Optimierung. Verzeichnisdienste wurden in der Laborumgebung bewusst weggelassen; eine universitäre Implementierung würde eigene Identitätsdienste integrieren. Auf der Spark-Seite erfolgt das Mounten der Freigabe mit einem einzigen Befehl:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
Diese eine Zeile stellt die gesamte Clientintegration dar – ohne Treiber, ohne Initiatorkonfiguration und ohne Herstellersoftware auf dem Spark. Ein Benutzer, der sich morgen an einem anderen Spark anmeldet, führt dieselbe Zeile aus und sieht dieselben Dateien.
Konfigurationsnachweis: Acht Sparks auf einem Datensatz
Vor Beginn der Modellierung führten wir einen Funktionstest für jeden einzelnen Spark durch: einen sequenziellen Lesevorgang von 1 Million fio-Daten mit 16 Jobs und einer Warteschlangenlänge von 16 gegen den jeweiligen Ordner im Array. Die acht Einheiten erreichten dabei Datenraten zwischen 10.0 und 11.2 GiB/s und nutzten die 100-GbE-Verbindung voll aus. Anschließend führten wir einen Lastsweep durch, um zu beweisen, dass alle acht Einheiten ihren Anteil an der Last bewältigen konnten. Jeder Testlauf umfasste 16 Threads mit einer Warteschlangenlänge von insgesamt 16 und verteilte diese auf ein, zwei, vier und acht Sparks. Die Workloads betrugen 1 Million sequenziell, 16 zufällig, 64 sequenziell und 4 zufällig. Es wurden Lese- und Schreibvorgänge mit direkter E/A durchgeführt, die Testdauer betrug 60 Sekunden. Jeder Spark schrieb in seinen eigenen Ordner im Array, vier pro Storage-NIC. Im gesamten Stack war keine QoS-Funktion implementiert. Bei gleichzeitiger Auslastung aller acht Spark-Geräte lagen die sequenziellen Lesegeschwindigkeiten pro Einheit bei 1 Million zwischen 3.09 und 3.13 GiB/s, die zufälligen Lesegeschwindigkeiten bei 64 KB zwischen 6,648 und 6,779 IOPS und die zufälligen Schreibgeschwindigkeiten bei 4 KB zwischen 2,136 und 2,155 IOPS. Diese Tests wurden über fünf OEMs in zwei VLANs ohne Fairness-Regelung durchgeführt. Jedes Spark-Gerät erreichte das Array, erhielt einen gleichmäßigen Anteil, und die Konfiguration war für die relevante Arbeitslast bereit.
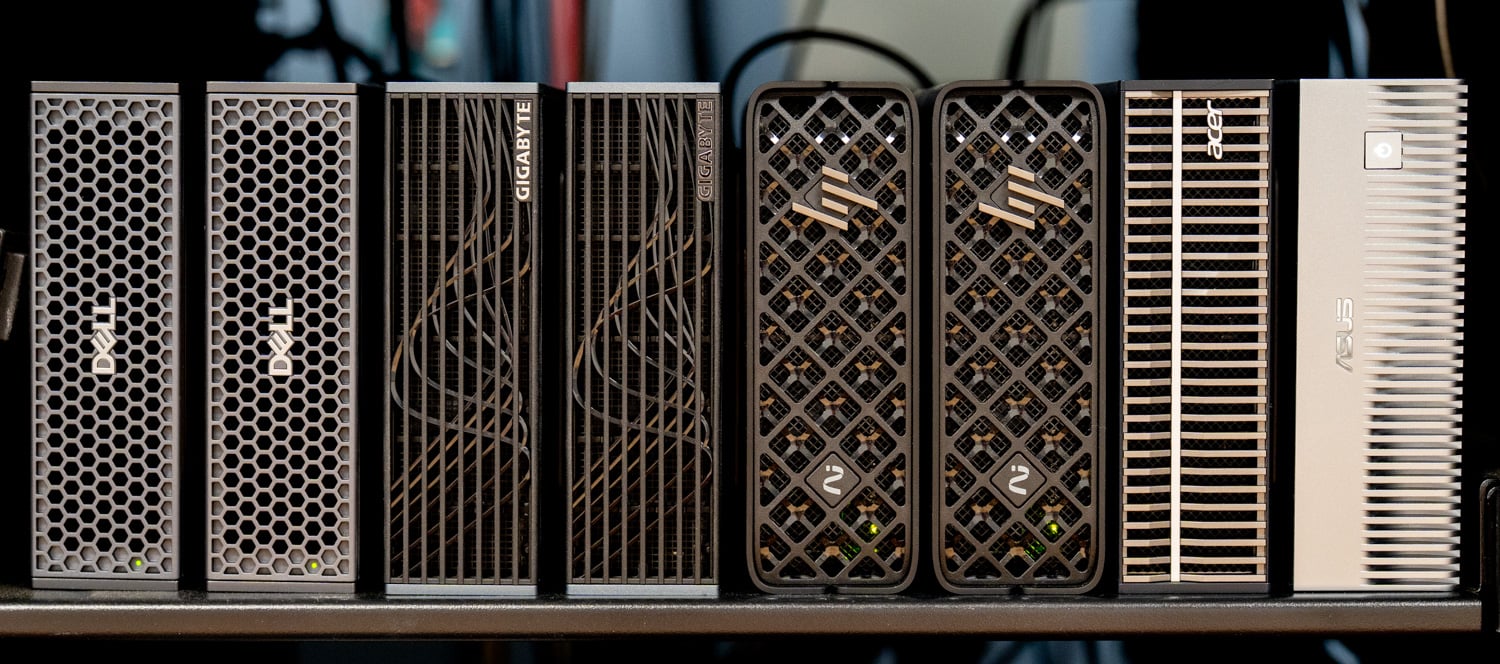
| Spark (acht Clients, je 2 Threads x QD16) | Speicher-Netzwerkkarte | 1 Mio. sequentielles Lesen | 64K Random Read IOPS | 4K Random Read IOPS | 4K Random Write IOPS |
|---|---|---|---|---|---|
| Dell Pro Max mit GB10 (1) | 1 | 3,176 MB/s | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI TOP ATOM (1) | 1 | 3,195 MB/s | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201 MB/s | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | 3,194 MB/s | 6,670 | 10,100 | 2,149 |
| Dell Pro Max mit GB10 (2) | 2 | 3,184 MB/s | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI TOP ATOM (2) | 2 | 3,187 MB/s | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189 MB/s | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | 3,163 MB/s | 6,734 | 10,300 | 2,145 |
Dimensionierung des Hosts: Zwei Netzwerkkarten und ausreichend Spielraum
Dieselbe Analyse beantwortet die Frage, die sich Labore oder Unternehmen vor dem Kauf stellen müssen: Wo liegt die Leistungsgrenze und welcher Teil des Hosts bestimmt sie? Die vier folgenden Diagramme zeigen den Lesedurchsatz für alle vier Workloads bei einer festen Last von einem bis acht Spark-Instanzen; die Schreibseite wird im Text und in der Tabelle weiter unten behandelt.
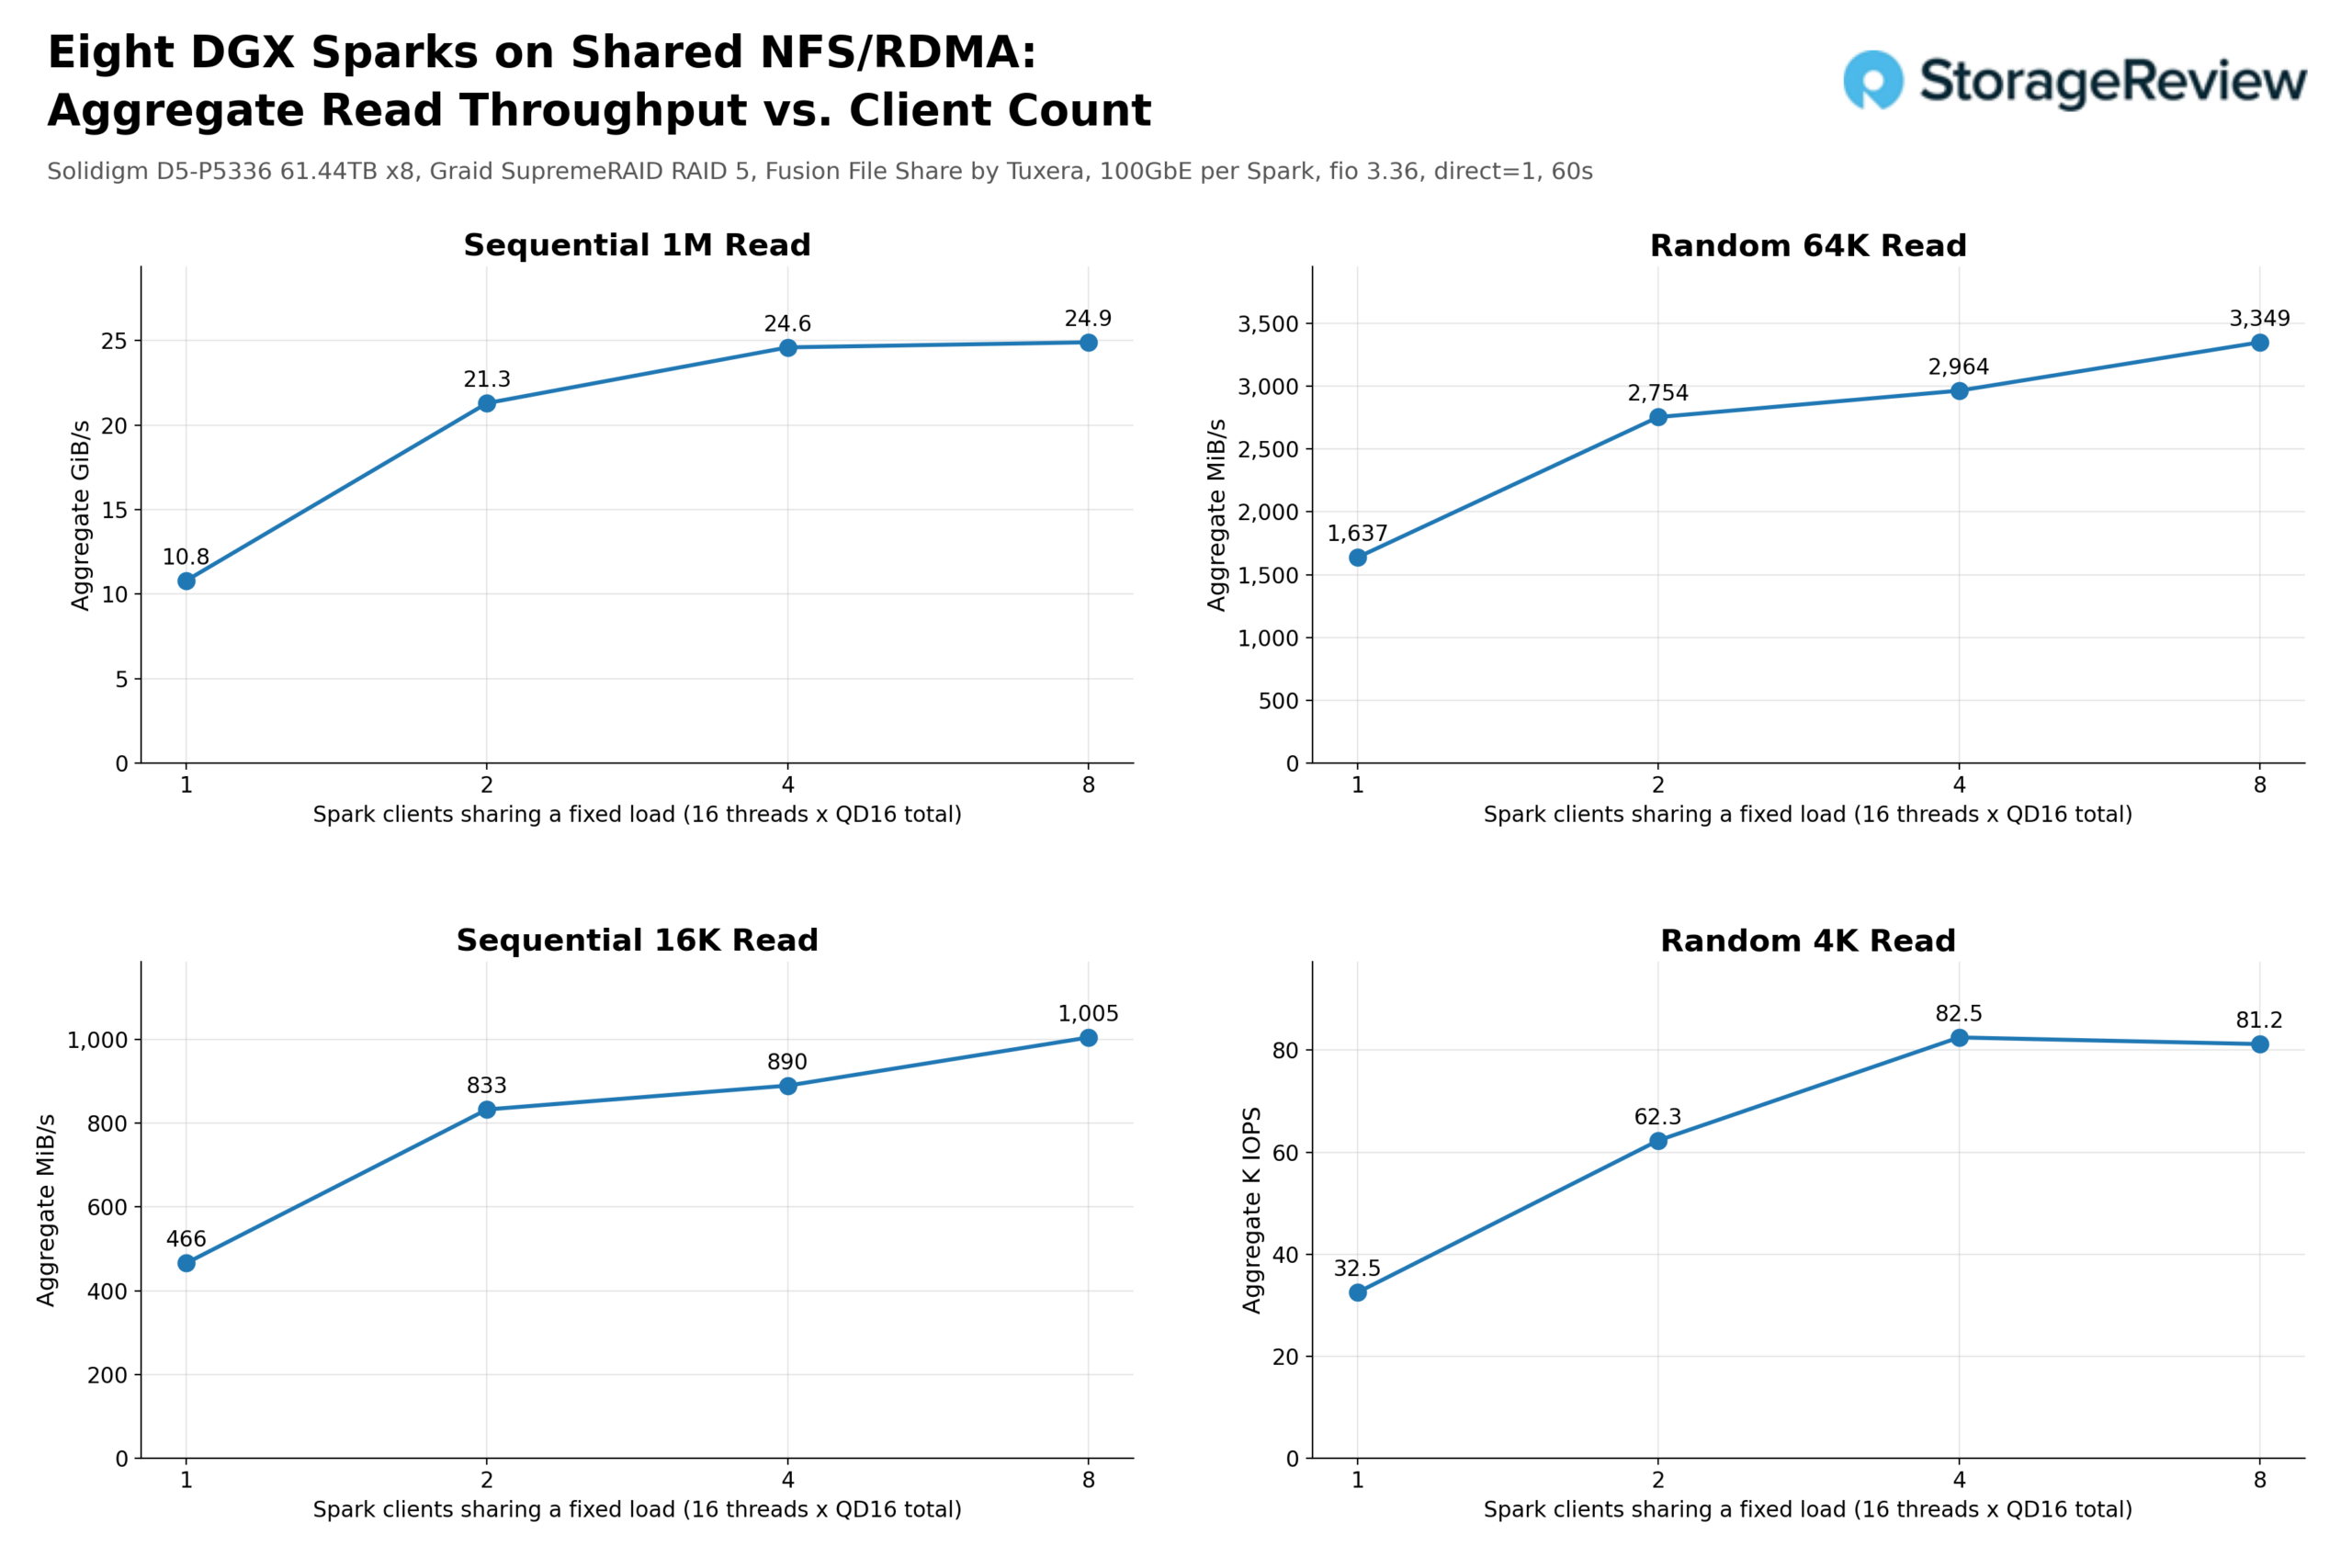
Die aggregierte sequentielle Lesegeschwindigkeit (1M) stieg von 10.8 GiB/s auf einem Spark-Gerät auf 21.3 GiB/s auf zwei, 24.6 GiB/s auf vier und 24.9 GiB/s auf acht Geräten. Netzwerktechnisch entspricht dies 93 Gbit/s, 183 Gbit/s, 212 Gbit/s bzw. 214 Gbit/s gegenüber den 800 Gbit/s, die die beiden Broadcom 400GbE-Netzwerkkarten übertragen können. Unter Volllast mit acht Clients nutzte das Array somit 27 % der Netzwerkkapazität des Hosts. Das Plateau bei etwa 25 GiB/s ist auf das RAID-5-QLC-Array mit acht Festplatten zurückzuführen; die Netzwerkkarten, der Switch und die 100GbE-Verbindungen der Spark-Geräte stellten nie den Limitfaktor dar.
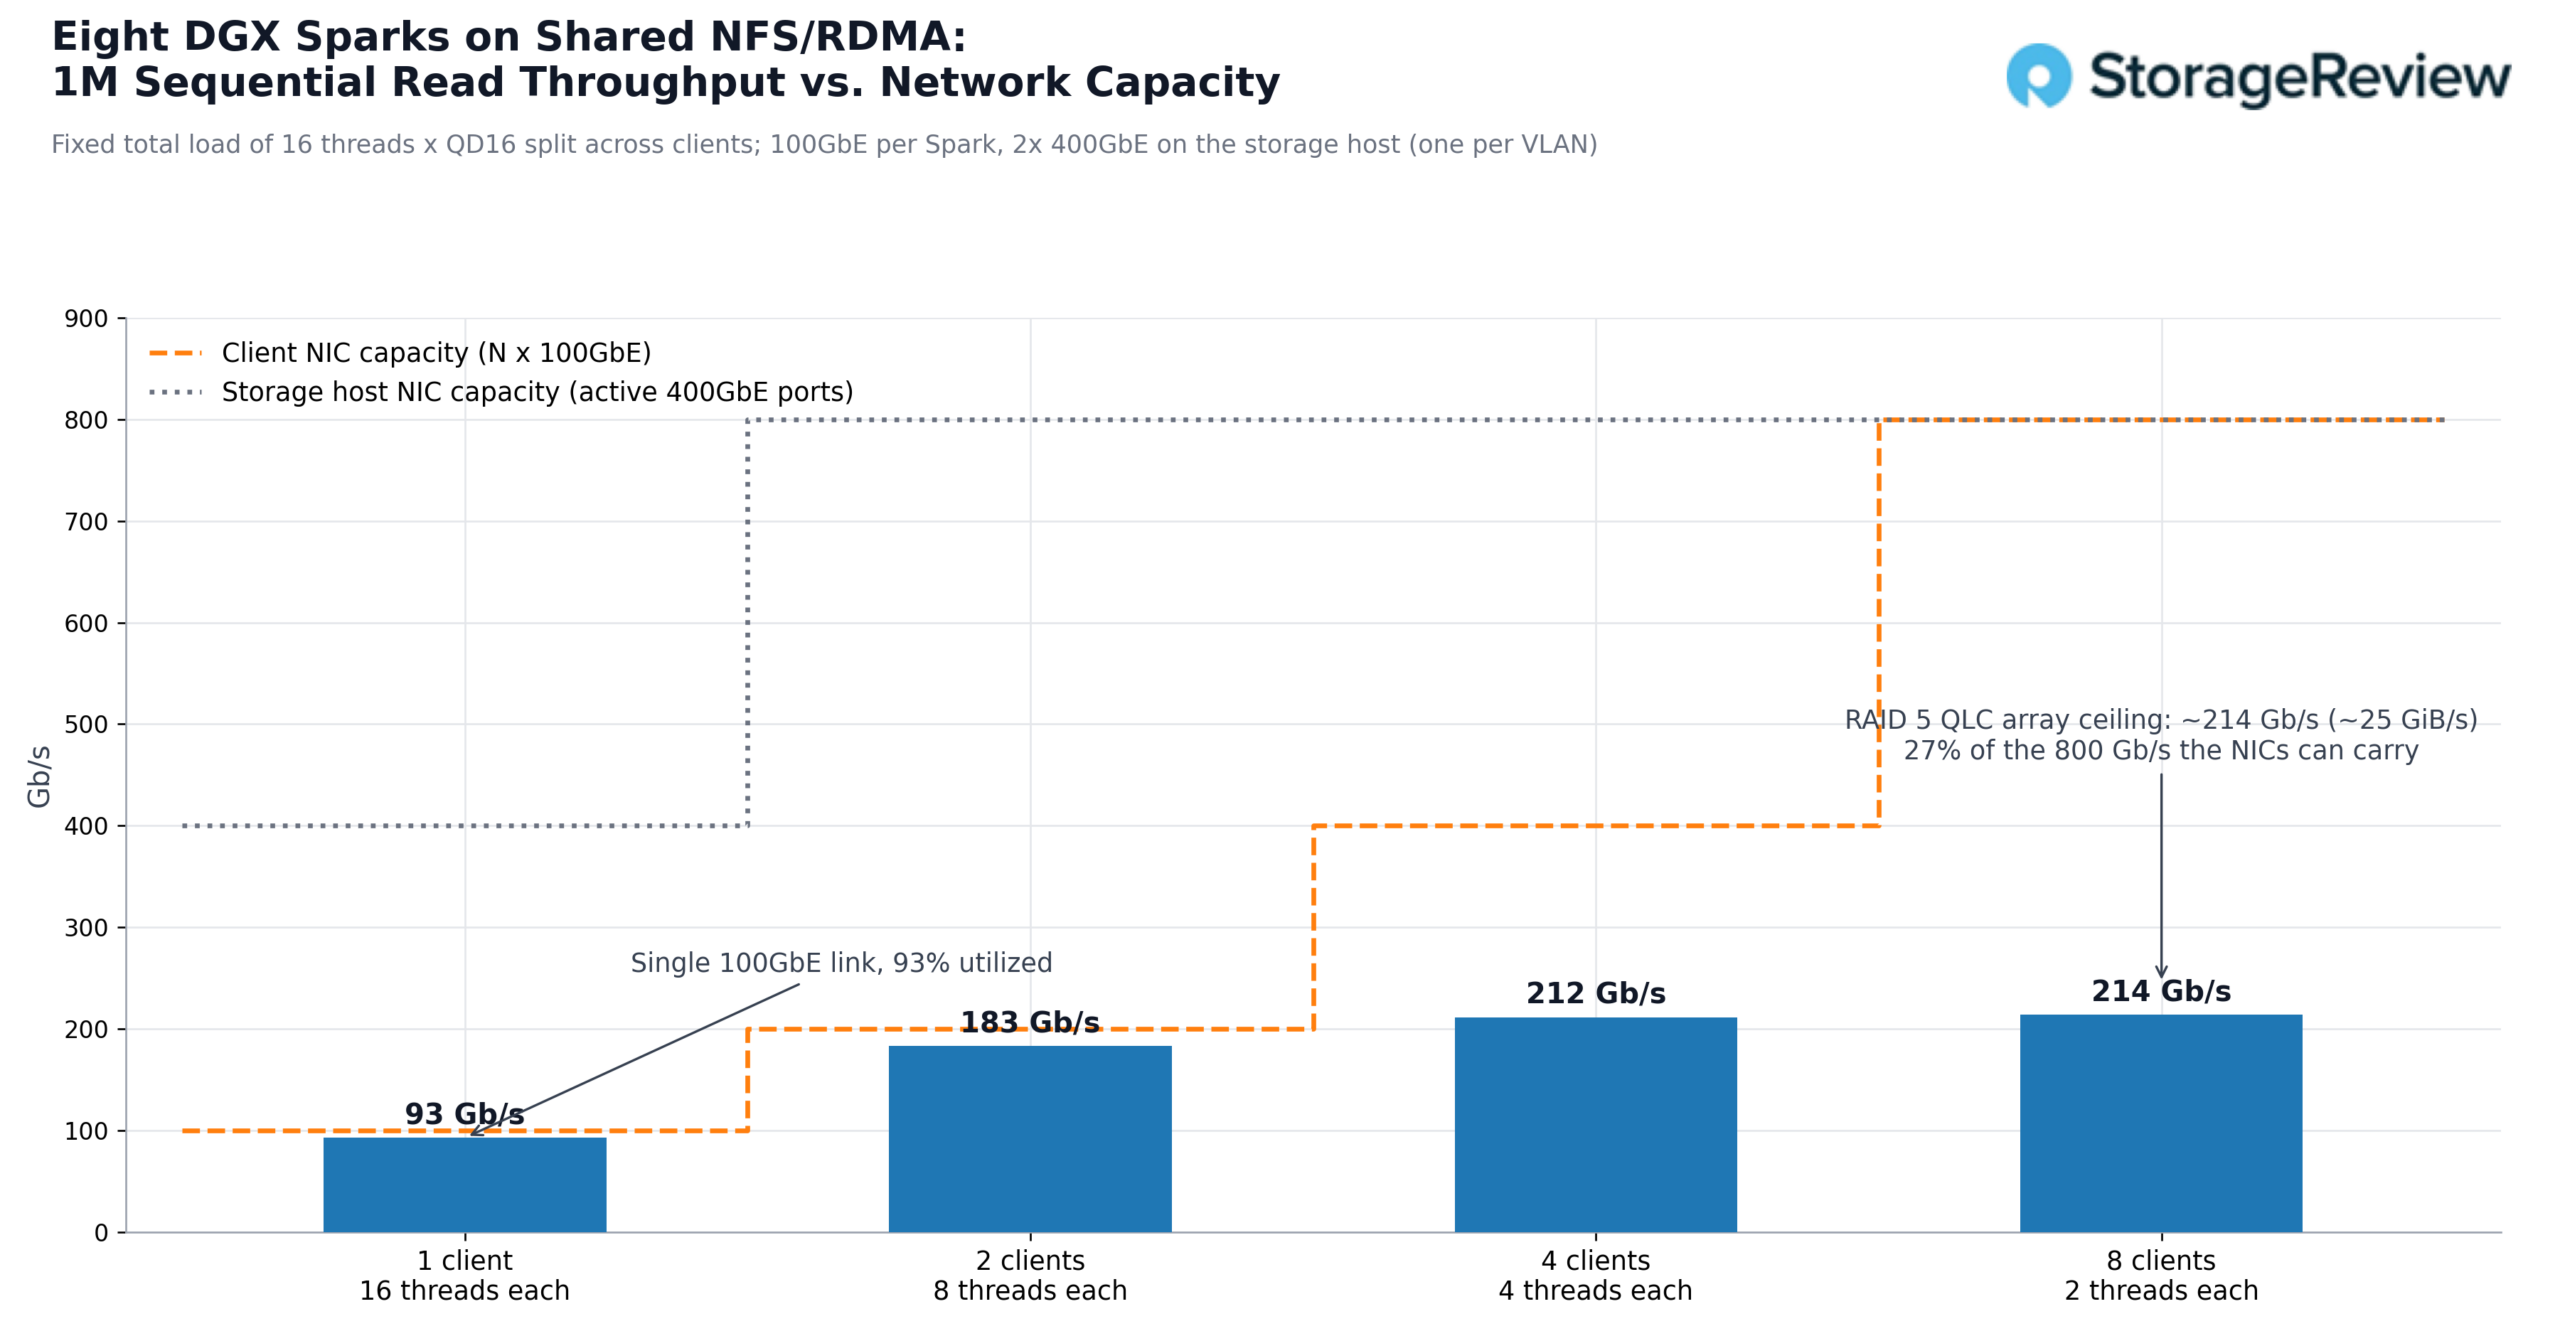
Zwei serverseitige Netzwerkkarten (NICs) versorgen bereits acht Spark-Laufwerke mit Leitungsgeschwindigkeit und würden auch die anderen acht Einschübe des R770AP abdecken: Durch die Verdopplung der Laufwerksanzahl, sei es als zweites Array oder als größeres RAID-System, steht über dieselben zwei Ports mehr Lesebandbreite zur Verfügung – und es ist noch Reserve vorhanden. Dasselbe gilt für die E/A. Zufällige 4K-Lesezugriffe skalierten von 32.5 IOPS bei einem Client auf ein Plateau von etwa 81 IOPS bei vier und mehr Clients. Die Latenz pro E/A sank von 7.9 ms auf 3.1 ms, da die Warteschlange jedes Clients kürzer wurde. Zufällige 64K-Lesezugriffe stiegen von 1,637 auf 3,349 MiB/s, wobei das Netzwerk in beiden Fällen weit unter seiner Leistungsgrenze lag.
Der andere wichtige Vergleich bezieht sich auf den bereits vorhandenen Speicher eines Spark. In unseren Einzeltests mit GB10 erreichten GDSIO-1M-Lesegeschwindigkeiten von der internen M.2-SSD beim Acer Veriton GN100 und GIGABYTE AI TOP ATOM Spitzenwerte von knapp 11.2 GiB/s. Der Dell Pro Max mit GB10 und der HP ZGX Nano G1n erreichten etwa 5.5 GiB/s, während der ASUS Ascent GX10 sich 5 GiB/s annäherte. Zum Vergleich: Die externe NVMe-oF-Box des Luisuantech GP Spark lieferte über denselben 100GbE-Anschluss 9.5 GB/s. Ein einzelner Spark, der vom gemeinsam genutzten QLC-Array mit 10.8 GiB/s liest, erreicht die Geschwindigkeit der schnellsten internen Laufwerke dieser Gruppe und verdoppelt die Geschwindigkeit des langsamsten Laufwerks – über ein einziges Kabel – im Vergleich zu Daten, die jeder andere Spark ebenfalls lesen kann. Die verwendeten Tools unterscheiden sich: GDSIO auf den internen Laufwerken und fio über NFS. Daher handelt es sich um einen Vergleich der Bandbreite.
Die vollständige Übersicht mit aggregierten Werten für alle vier Workloads bei jeder Clientanzahl finden Sie unten. Die Anzahl der Lesevorgänge steigt mit der Clientanzahl, bis die Kapazität des Arrays erschöpft ist. Die Anzahl der Schreibvorgänge bleibt hingegen von einem bis acht Spark-Prozessoren konstant, da der RAID-5-Paritätspfad die Schreibkapazität des Arrays unabhängig von der Anzahl der Clients, die es gemeinsam nutzen, auf einem festen Limit hält. Für eine Freigabe, die für den gleichzeitigen Zugriff durch viele Clients und einmaliges Schreiben beim Dateneingang ausgelegt ist, entspricht dieses Design genau diesem Profil.
| Gesamt (insgesamt 16 Threads) | 1 Funken | 2 Funken | 4 Funken | 8 Funken |
|---|---|---|---|---|
| 1 Mio. sequentielles Lesen | 10.8 GiB/s | 21.3 GiB/s | 24.6 GiB/s | 24.9 GiB/s |
| 1 Mio. sequentielles Schreiben | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s |
| 64K Zufälliges Lesen | 1,637 MB/s | 2,754 MB/s | 2,964 MB/s | 3,349 MB/s |
| 64K Zufälliges Schreiben | 722 MB/s | 719 MB/s | 723 MB/s | 703 MB/s |
| 16K sequentielles Lesen | 466 MB/s | 833 MB/s | 890 MB/s | 1,005 MB/s |
| 16K sequentielles Schreiben | 57 MB/s | 60 MB/s | 62 MB/s | 28 MB/s |
| 4K Zufälliges Lesen | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| 4K Zufälliges Schreiben | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
Hosting-Modelle auf gemeinsam genutztem Speicher
Der fio-Sweep beweist, dass Array und Netzwerk mehr als leistungsfähig sind. Der nächste wichtige Test für diesen Anwendungsfall ist, ob ein Modell auf dem gemeinsam genutzten Array genauso schnell geladen wird wie ein Modell auf dem internen NVMe-Speicher des Spark. Denn genau darauf basiert das gesamte Design: eine zentral gehostete Kopie, die von jedem geladen werden kann. Wir wählten Qwen3.5-122B-A10B in NVFP4, ein Mixture-of-Experts-Modell mit 122 Milliarden Parametern, das 78 GB Speicherplatz benötigt und in den 128 GB großen Arbeitsspeicher eines einzelnen Spark passt. Wir maßen die Zeit vom Start des Inferenzservers bis zur Meldung „Fehlerfrei“ sowie die durchschnittliche Speicherbandbreite in diesem Zeitraum in drei Szenarien: ein Spark lädt von seinem internen NVMe-Speicher, derselbe Spark lädt über NFS/RDMA vom gemeinsam genutzten Array und alle acht Sparks laden gleichzeitig dieselbe Kopie vom Array.
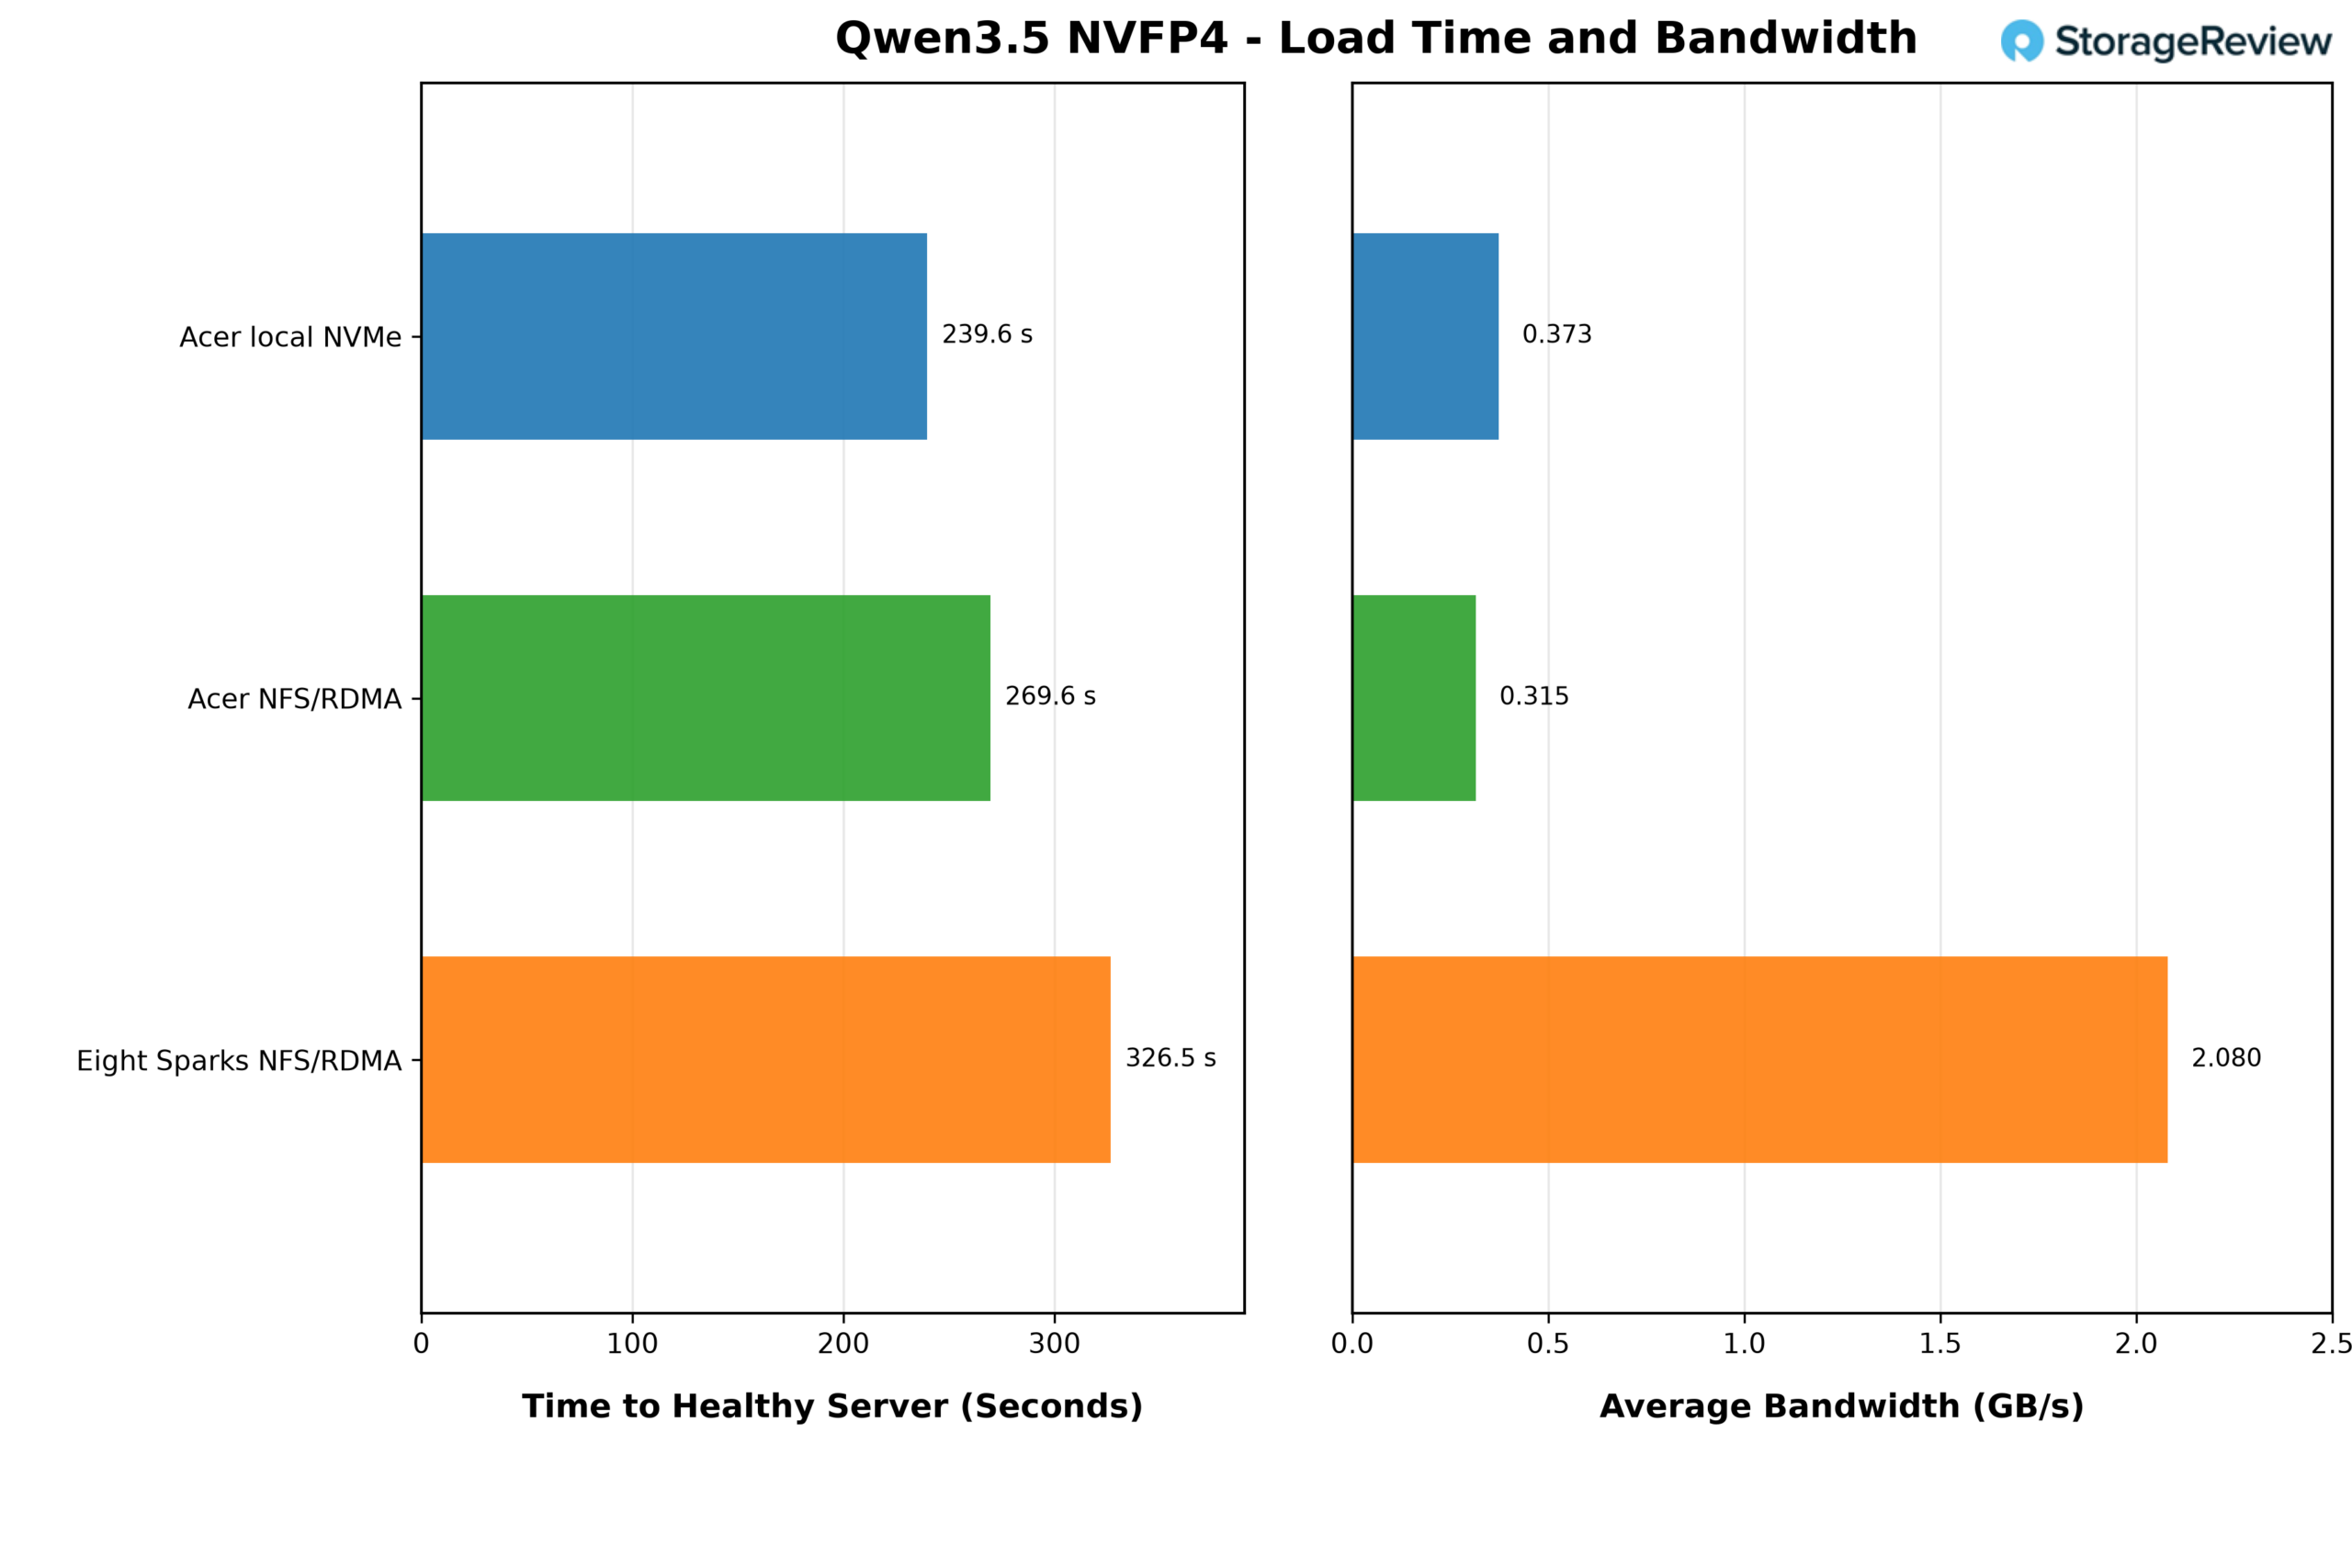
Mit der internen NVMe-SSD erreichte der Acer Veriton GN100 nach 239.6 Sekunden einen betriebsbereiten Serverzustand mit einer durchschnittlichen Übertragungsrate von 0.373 GB/s. Über das gemeinsam genutzte Array via NFS/RDMA benötigte derselbe Spark 269.6 Sekunden bei 0.315 GB/s, also etwa 30 Sekunden bzw. 13 % länger. Die Durchschnittswerte zeigen, dass das Laden von Modellen auf einem Spark bei 78 GB über vier Minuten in beiden Fällen nicht speicherlimitiert ist. Die Verarbeitung der Gewichtungen durch den GB10 gibt das Tempo vor, während der Speicher den größten Teil der Zeit im Leerlauf verbringt.
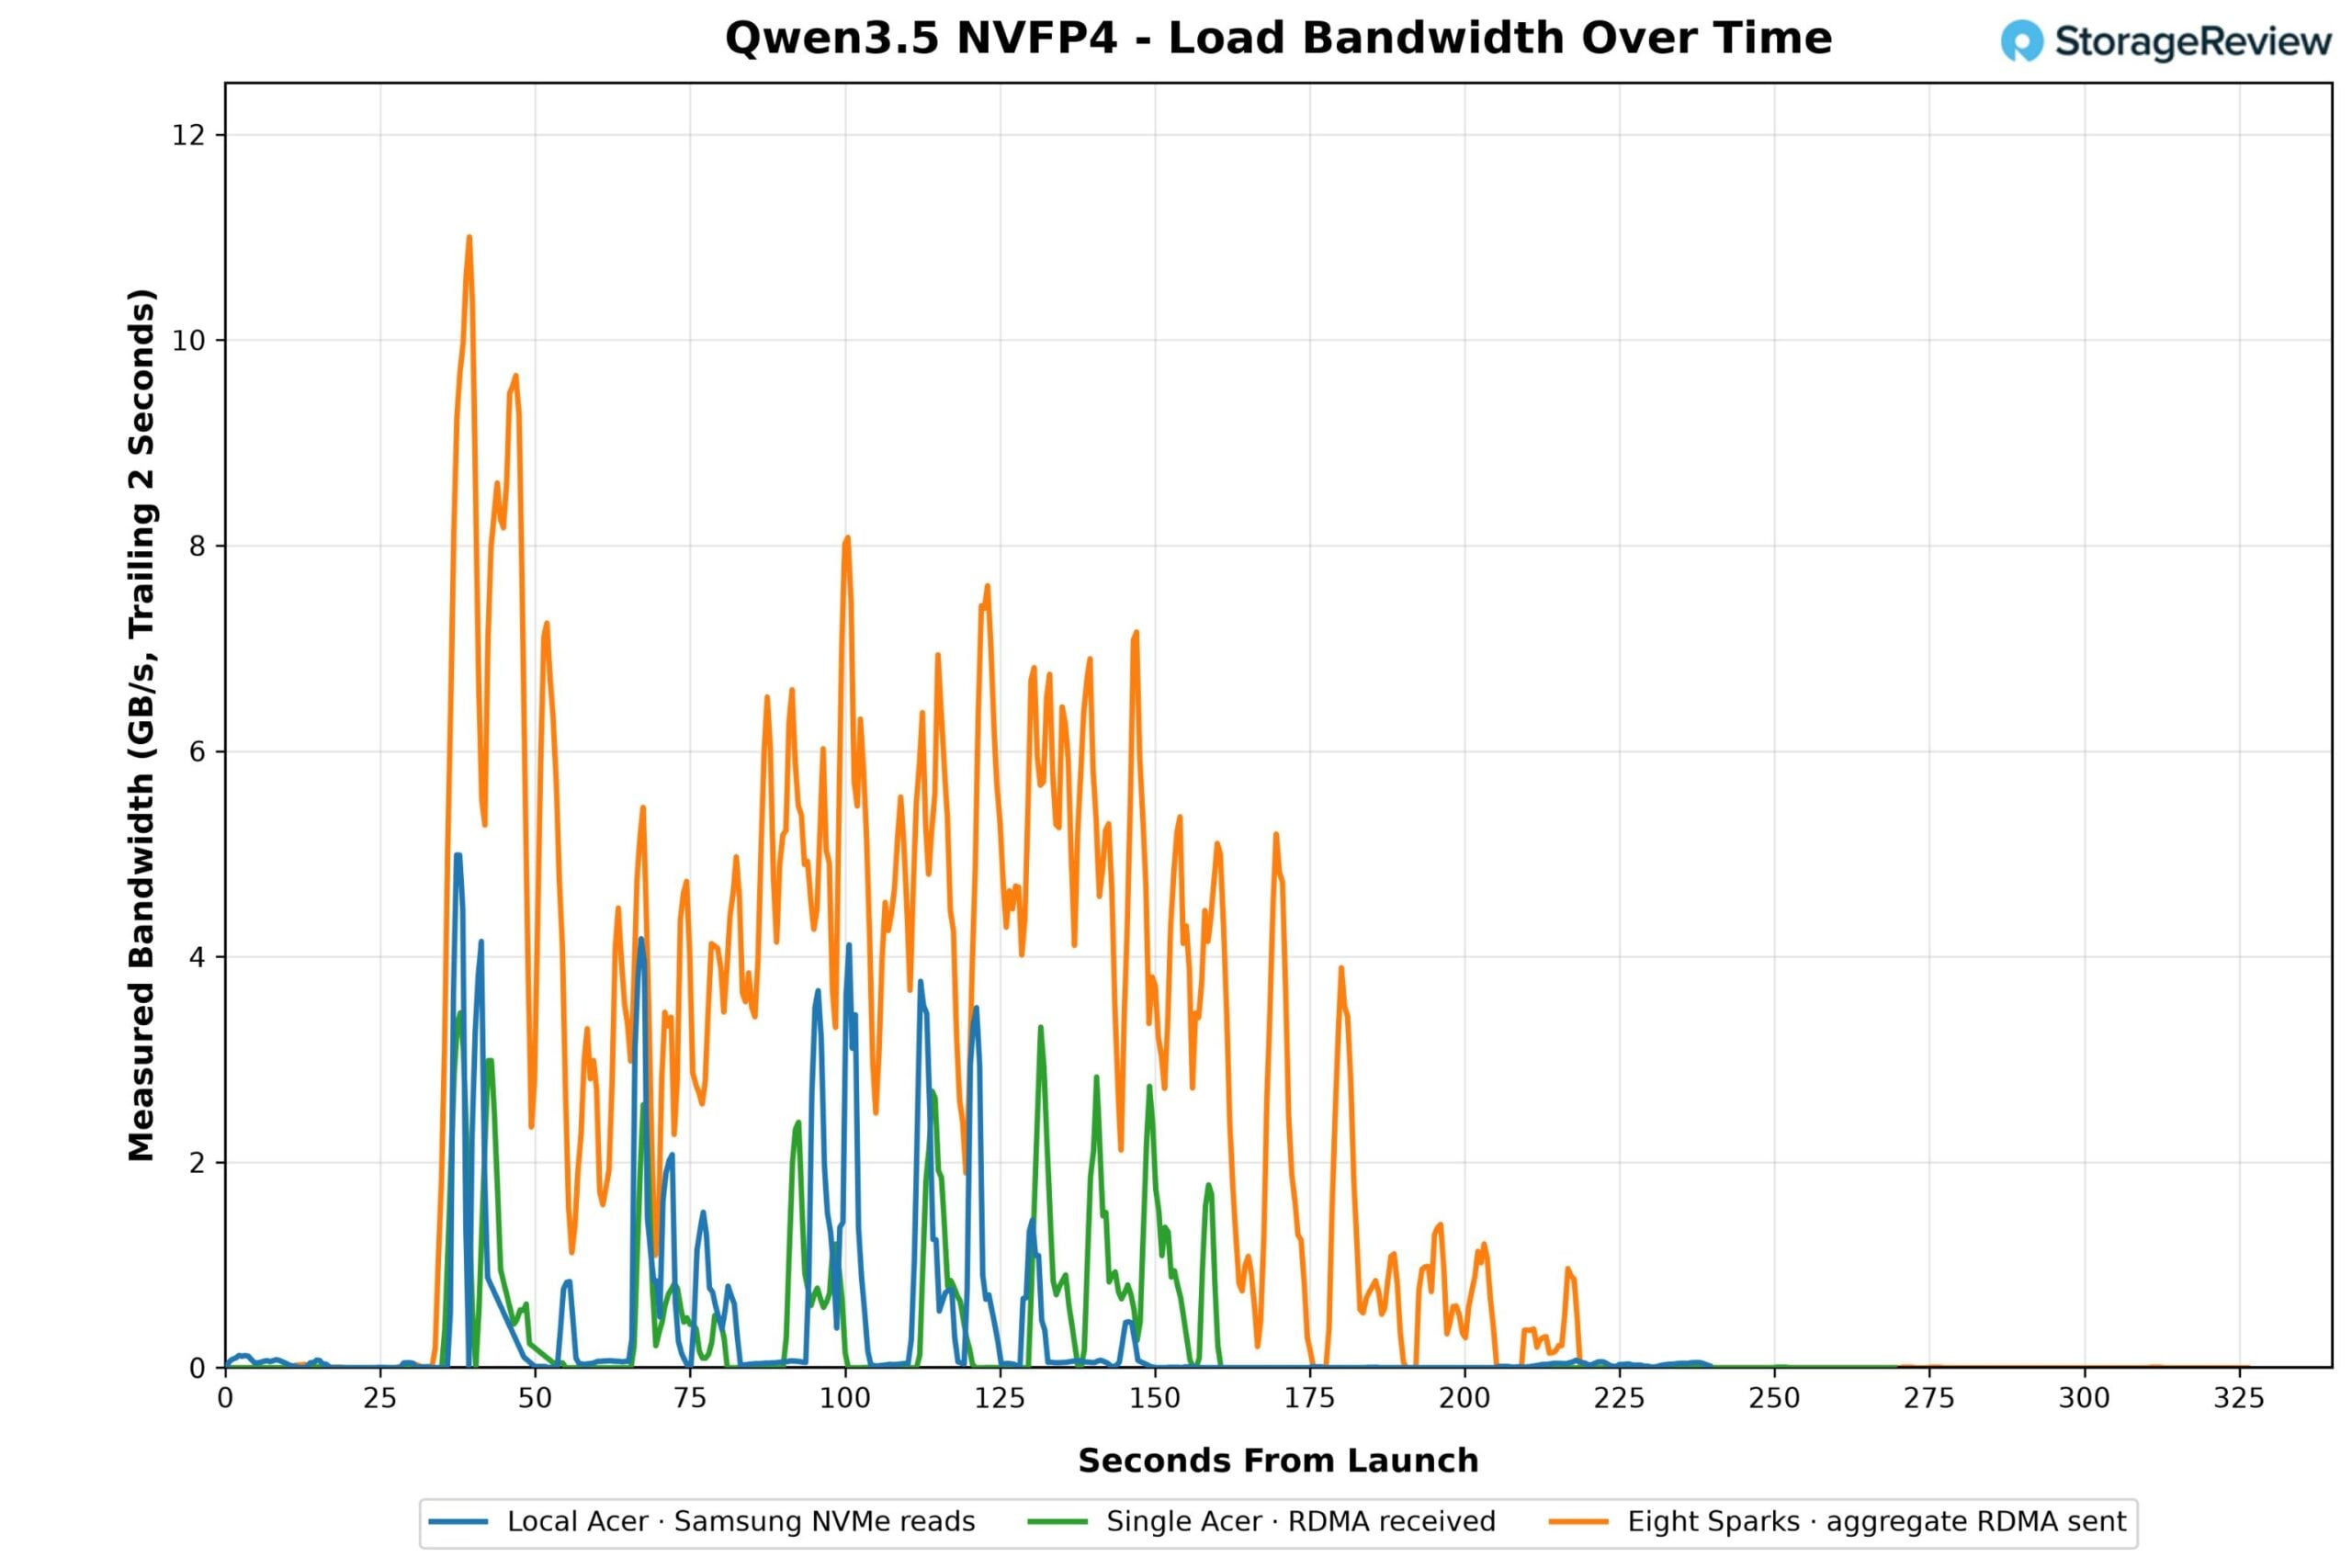
Die Bandbreitenanalyse zeigt dieses Muster: Lokale NVMe-Lesezugriffe erfolgen in Spitzenwerten um 5 GB/s mit langen Pausen dazwischen; der einzelne NFS-Client zeigt das gleiche Spitzenmuster mit etwas niedrigeren Spitzenwerten. Die Kurve für die acht Sparks zeigt die Leistung des Arrays unter gleichzeitiger Last. Da alle acht Sparks gleichzeitig auf dieselben 78 GB zugreifen, erreichte das Array in der ersten Minute einen Spitzenwert von 11 GB/s und pendelte sich dann in den folgenden zwei Minuten zwischen etwa 4 und 8 GB/s ein, während die Sparks ihre Datenmengen abarbeiteten. Der Durchschnitt über das gesamte Zeitfenster lag bei 2.08 GB/s. Im Vergleich zu den 25 GiB/s, die das Array laut fio-Sweep liefern kann, nutzten acht Sparks, die gleichzeitig ein Modell luden, nur einen Bruchteil der verfügbaren Kapazität.
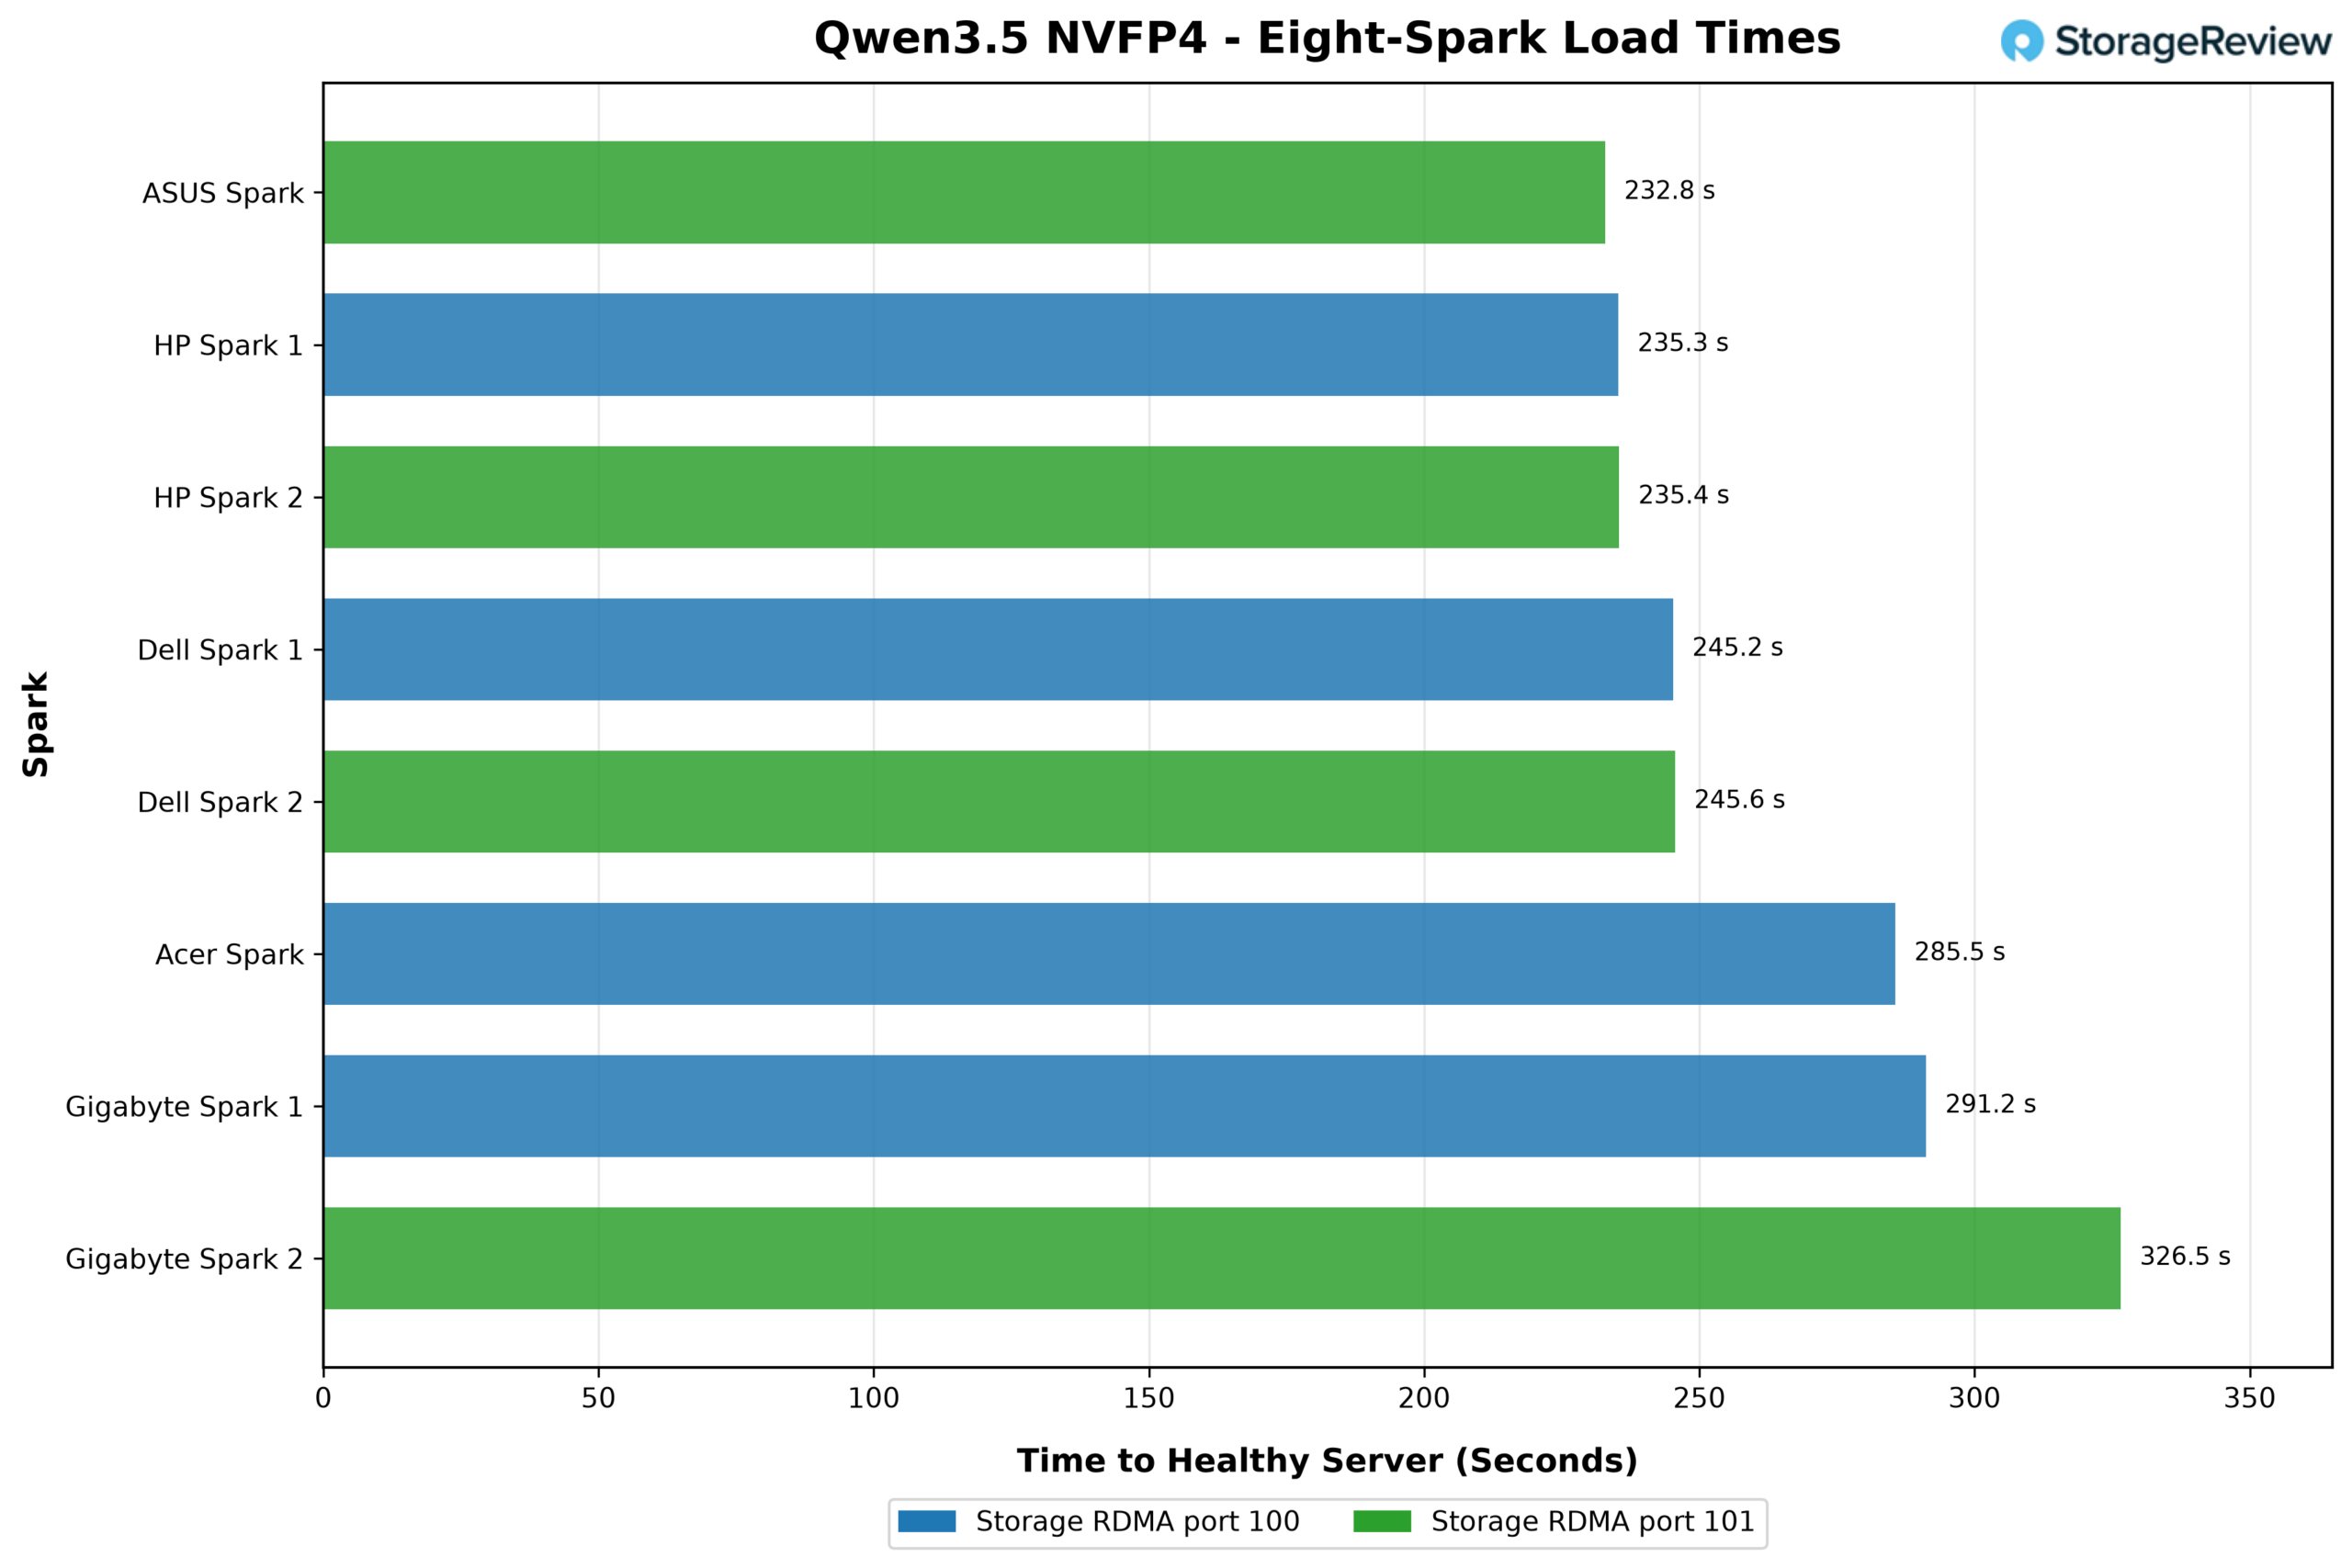
Die Ladezeiten pro Einheit im Acht-Wege-Test reichten von 232.8 Sekunden auf dem ASUS Ascent GX10 bis 326.5 Sekunden auf einer der GIGABYTE AI TOP ATOM-Einheiten. Die beiden HP ZGX Nano G1n-Systeme erreichten 235.3 bzw. 235.4 Sekunden, die beiden Dell Pro Max mit GB10 245.2 bzw. 245.6 Sekunden. Fünf der acht gleichzeitig vom gemeinsamen Array geladenen Spark-Systeme waren schneller als das Laden eines einzelnen Spark-Systems über NFS/RDMA, und drei von ihnen waren schneller als der lokale NVMe-Test. Diese Streuung ist nicht herstellerbedingt; da keine QoS-Funktion im System implementiert ist, wechselt die jeweils wartende Einheit von Testlauf zu Testlauf, und die beiden Einheiten pro Storage-NIC verteilen sich gleichmäßig auf die schnellen und langsamen Werte im Diagramm.
Für ein Labor bedeutet dies, dass es eine Kopie jedes Modells auf dem Array speichern kann und jeder Spark-Prozess diese in etwa der Zeit lädt, die zum Laden einer lokalen Kopie benötigt würde – ohne Download-Schritt, ohne Verbrauch von lokalem Speicherplatz und ohne dass eine Kopie der Gewichte auf einem Schreibtisch herumliegt.
Der Anwendungsfall im Bundesstaat Oregon
Das College für Erd-, Ozean- und Atmosphärenwissenschaften der Oregon State University (OSU) arbeitet seit Langem mit uns im Bereich der KI-Infrastruktur zusammen – von Echtzeit-Meeresforschung an Bord eines Forschungsschiffs bis hin zu KI-gestützten akademischen Prüfungen mit Metrum AI . Chris Sullivan, Forschungsdirektor und Leiter des Bereichs Akademisches Rechnen an der OSU, und sein Architekt Thomas Olson entwickeln ein groß angelegtes Spark-Labor für KI-Lernen, das auf bis zu 100 Einheiten skalierbar ist. Ihre Überlegungen zum Thema Speicherung flossen in zweierlei Hinsicht in unser Design ein.
Erstens muss der Speicher unabhängig von den Sparks sein. Die OSU erwog ein Dateisystem, das sich über die Sparks selbst erstreckt, verwarf es jedoch für den Einsatz in einem Hörsaal, da das Hinzufügen oder Entfernen eines einzelnen Knotens den Speicherdienst für alle beeinträchtigen würde. Ein zentrales Array, das von jedem Spark eingebunden wird, ermöglicht es, einen Spark hinzuzufügen, zu entfernen, neu aufzusetzen oder an einen anderen Studenten zu übergeben, ohne die Daten anderer zu beeinträchtigen. Zweitens muss der Speicher dem Benutzer folgen. Wir beschreiben die OSU-Anforderung als eine erweiterte Version von Dateifreigaben für KI-Zwecke, bei der Studenten persistente Informationen speichern, während sie zwischen Systemen wechseln. Mit NFS ist das ein Ordner pro Student; man meldet sich bei einem beliebigen Spark an, bindet die Freigabe ein, und die Arbeit ist dort verfügbar.
Die Datensätze sind der Grund, warum dies für die OSU wichtiger ist als für einen Server im Home-Verzeichnis. Das College für Erd-, Ozean- und Atmosphärenwissenschaften möchte seine Forschungsdaten – ozeanografische und atmosphärische Sammlungen im Umfang von mehreren zehn Terabyte – Studierenden für deren eigene Forschung zur Verfügung stellen. Auf herkömmlichen Desktop-Speichern ist dies nicht möglich: Ein 4-TB-M.2-Steckplatz reicht nicht einmal für eine dieser Sammlungen aus, und selbst ein Labor voller externer Gehäuse würde bedeuten, für jeden Arbeitsplatz eine Kopie anzuschaffen, zu bestücken und diese dann stets aktuell zu halten – ein Aufwand, den sich kein Fachbereich leisten kann. Die Daten einmalig auf dem Array zu speichern und über 100-GbE einzubinden, ist der Ansatz, der diese Anforderung in unserer Evaluierung erfüllt. Auf demselben Array befindet sich auch die Modellbibliothek, sodass Studierende während ihrer Sitzungen Qwen, Llama oder ein anderes Modell ohne Download-Schritte ausführen können. Dasselbe Prinzip gilt für Unternehmen, die Desktop-KI-Systeme als Entwickler-Workstations einsetzen: Die Produktionsdaten werden über ein schnelles Netzwerk bereitgestellt, und das System kann direkt damit arbeiten. Dadurch entfällt die Notwendigkeit, einen zweiten Data Lake einzurichten, damit die Desktop-Rechner Daten zum Lesen haben. Die Daten verbleiben im Rechenzentrum unter den dort bereits bestehenden Zugriffskontrollen, Verschlüsselungs- und Backup-Vorgaben. Der Spark-Rechner enthält keine relevanten Daten, wenn er das Rechenzentrum verlässt.
Fazit
KI-Hardware für den Arbeitsplatz ist in vielen Bereichen gut, aber nicht optimal als Teil der Dateninfrastruktur eines Unternehmens. Der einzelne M.2-Steckplatz in jedem GB10-System sorgt dafür: Alle Benutzerdaten werden lokal auf Flash-Speicher kopiert, sind für die IT unsichtbar, ungeschützt und werden auf jedem anderen Arbeitsplatz, der dieselben Daten benötigt, dupliziert. Für einen einzelnen Spark ist ein externer lokaler Speicher eine sinnvolle Lösung. In Laboren, Abteilungen oder Unternehmen, die Dutzende dieser Geräte einsetzen, bildet jeder Arbeitsplatz mit seinen eigenen Daten ein Datensilo. Die Lösung ist dieselbe, die Rechenzentren schon vor Jahren gefunden haben: die Kapazität über ein schnelles Netzwerk bereitstellen, einheitlich verwalten und gemeinsam nutzen. Die Sparks verfügen bereits über Hochgeschwindigkeitsnetzwerke; dieses Projekt zeigt, was passiert, wenn man ihnen Zugriff darauf gewährt, und argumentiert, dass die Sparks selbst in das Rack daneben gehören.
Acht Solidigm D5-P5336 QLC-Festplatten im Graid RAID 5-Verbund in einem Dell-Server stellten acht Spark-Systeme mit einem einzigen, paritätsgeschützten Datensatz bereit. Zwei Broadcom 400GbE-Netzwerkkarten und ein Dell Z9864F-ON mit 800G-Breakout-Port ermöglichten jedem der acht Spark-Systeme eine 100GbE-Anbindung. Tuxeras Fusion NFS über RDMA machte diese Kapazität auf einem Standard-Ubuntu-System mit Directory-Service-Hooks zur Zugriffskontrolle über eine einzige Zeile Mount möglich. Unter konstanter Last, verteilt auf alle acht Systeme, erreichte das Array eine sequentielle Lesegeschwindigkeit von 24.9 GiB/s, gleichmäßig verteilt und ohne QoS. Ein einzelnes Spark-System erreichte sogar eine maximale Übertragungsrate von 10.8 GiB/s – so schnell wie die beste interne Festplatte in einem von uns getesteten GB10-System. Diese maximale Übertragungsrate entsprach 27 % der Kapazität der beiden serverseitigen Netzwerkkarten. Das Netzwerk ist also für einen leistungsstärkeren Server ausgelegt. Der Modelltest bestätigte den Arbeitsablauf: Ein 78 GB großes Modell, das einmal auf dem gemeinsam genutzten Array gehostet wird, wird auf einem Spark innerhalb von 13 % der lokalen NVMe-Last geladen, und auf acht Sparks gleichzeitig, wobei fünf der acht schneller fertig sind als der Solo-NFS-Lauf.
QLC-Flashspeicher ermöglicht diese Wirtschaftlichkeit, da die Arbeitslast speicher- und leseintensiv ist – die Stärke des D5-P5336. Ein einzelner Server kann Datenmengen speichern, die hundert Spark-Systeme lokal niemals bewältigen könnten. Dabei wird jede Kopie der Daten vom Rechenzentrum kontrolliert. Die Oregon State University verfügt über produktiven Forschungsspeicher für dringende Forschungsprojekte. Das von Chris Sullivan und Thomas Olson entwickelte Konzept stellt eine Bildungsplattform dar, die der Universität bisher fehlt: ein verwalteter, gemeinsam genutzter Pool, der für ein oder mehrere Racks mit Spark-Systemen ausgelegt ist. Dieser Pool, bestehend aus einem Server und einigen wenigen Festplatten mit hoher Kapazität, könnte Dutzende Terabytes an realen ozeanografischen und atmosphärischen Daten einem groß angelegten KI-Lernlabor auf derselben Infrastruktur zur Verfügung stellen, die auch die Spark-Systeme nutzen.
Dieser Bericht wird von Solidigm gesponsert. Alle in diesem Bericht geäußerten Ansichten und Meinungen basieren auf unserer unvoreingenommenen Sicht auf das/die betrachtete(n) Produkt(e).
Die in diesem Artikel enthaltenen Verweise auf kommerzielle Produkte dienen lediglich Informationszwecken und stellen keine Empfehlung seitens der Oregon State University dar.



 Amazon