

NVIDIA hat die Serienproduktion des NVIDIA Groq 3 LPX angekündigt , eines dedizierten interaktiven Inferenzbeschleunigers, der die Vera Rubin NVL72-Plattform ergänzt. Da sich KI-Workloads in Unternehmen von der reinen Modellvorverarbeitung hin zu Echtzeit-Schlussfolgerungen und der Orchestrierung autonomer Agenten verlagern, ändern sich die Infrastrukturanforderungen. Agentenbasierte Workflows erfordern iterative, mehrstufige Ausführung, wobei sich Latenzzeiten bei der Token-Generierung über automatisierte Schlussfolgerungspfade, Abfragen externer Tools und die Kommunikation zwischen mehreren Agenten hinweg verstärken können.
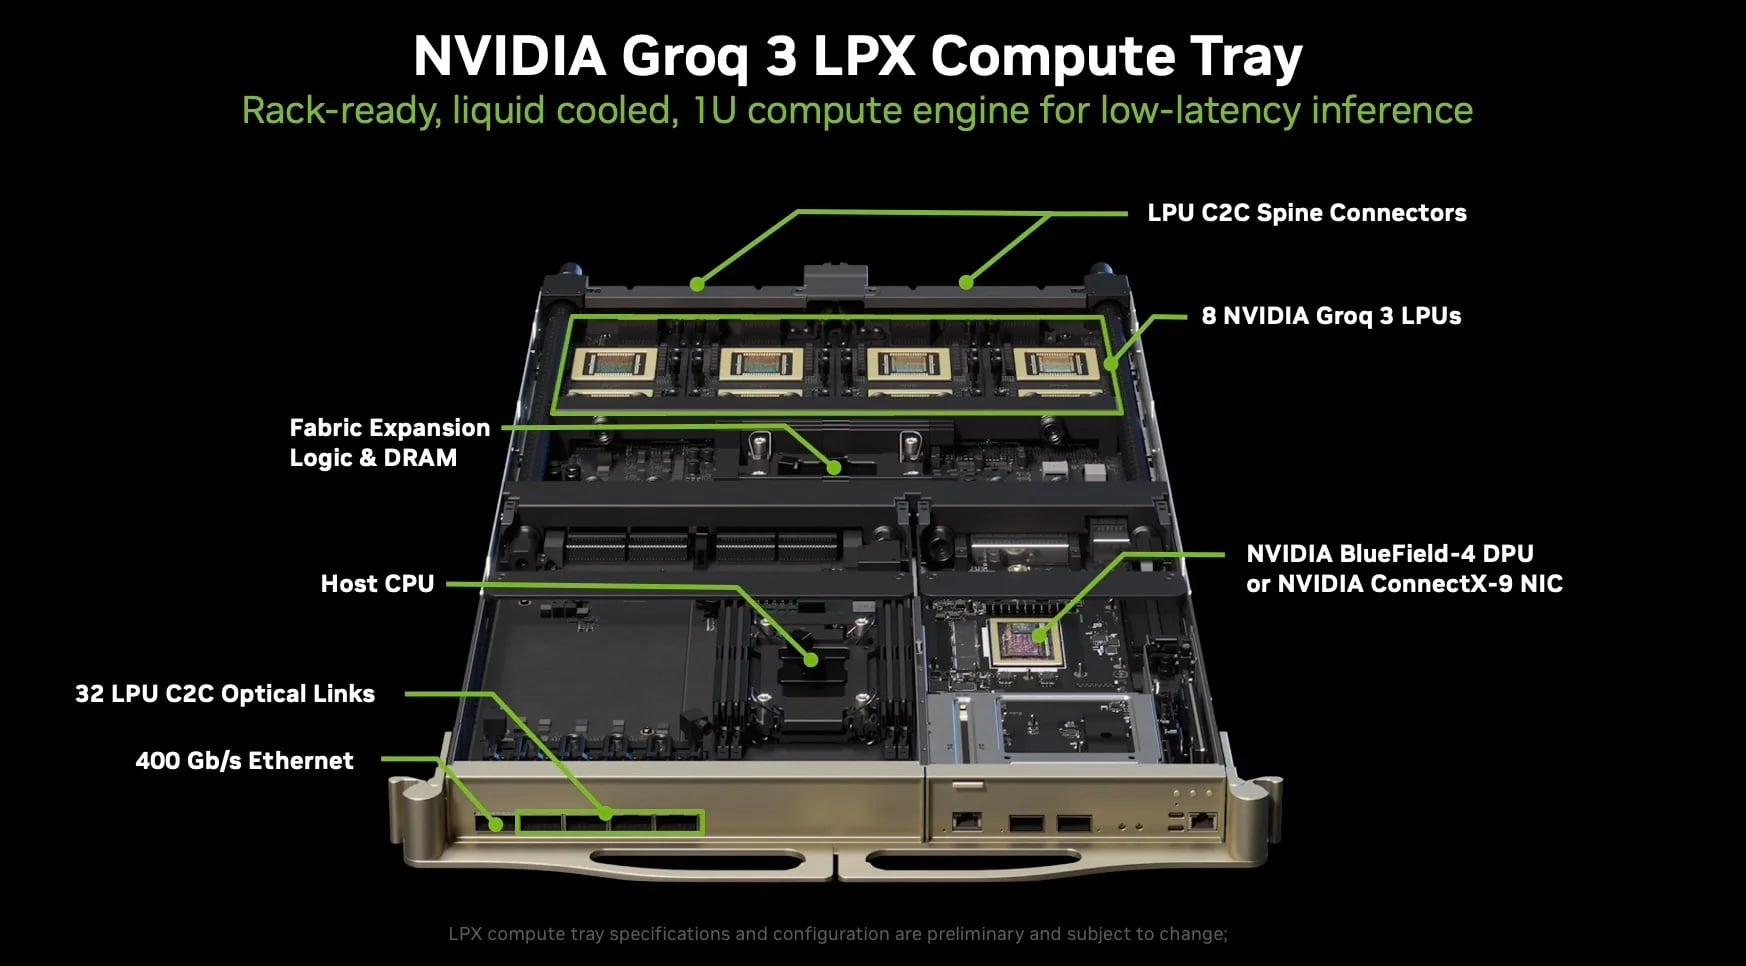
Die Groq 3 LPX-Architektur zeichnet sich insbesondere durch ihre Leistungsfähigkeit in dieser Dekodierungsphase aus. Jedes 2U-Rechengehäuse mit Flüssigkeitskühlung beherbergt sechzehn Groq 3 LPUs sowie eine Host-CPU, Logik zur Fabric-Erweiterung und DRAM. Zusätzlich verfügt es über entweder eine BlueField-4 DPU oder eine ConnectX-9 NIC, optische Chip-zu-Chip-Verbindungen für 32 LPUs und 400-Gbit/s-Ethernet an der Vorderseite. In einem heterogenen Einsatz mit Vera Rubin NVL72-Systemen übernehmen NVIDIA Rubin GPUs die Kontextaufnahme und Vorberechnungen für große Eingabedatensätze, während die Groq 3 LPX-Einheiten die latenzempfindliche Token-Ausgabe generieren.
Architektur und Benchmark-Leistung
Bei Standard-Leistungsbewertungen von Artificial Analysis mit dem Open-Source-Modell Gemma 4 31B und einem aktiven Kontextfenster von 100,000 Token erreichte der Groq 3 LPX eine Ausgaberate von 3,400 Token pro Sekunde. NVIDIA merkt an, dass dieser Durchsatz viermal höher ist als bei der nächstbesten alternativen Plattform mit identischen Langzeitkontextparametern. Artificial Analysis verzeichnet dies als das schnellste jemals für dieses Modell gemessene Ergebnis. Der Vergleich ist jedoch aufschlussreich: Die NVIDIA-Angabe stammt von einem privaten Vorabversions-Endpunkt, gemessen am 21. August, während die Vergleichswerte von produktiven, serverlosen Produktionsumgebungen stammen. Die Aufrechterhaltung einer extrem hohen Generierungsgeschwindigkeit über 100.000-Token-Fenster hinweg ist essenziell für Enterprise-Agent-Architekturen, die kontinuierlich umfangreiche Code-Repositories, komplexe API-Schemas und umfangreiche technische Dokumentationen analysieren.
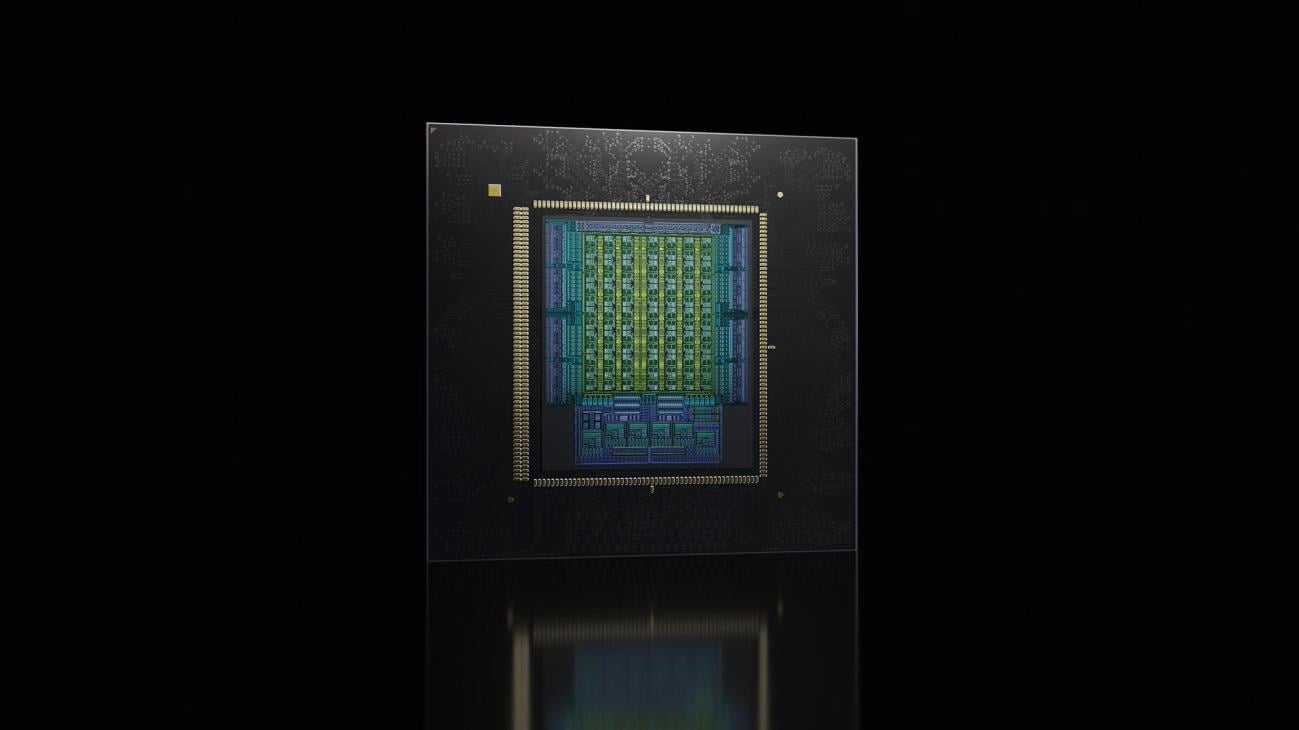

Aus Sicht der physikalischen Systemarchitektur umfasst eine Groq 3 LPX-Implementierung im Rack-Maßstab bis zu 256 LP30-Beschleuniger, die über Hochgeschwindigkeits-Direktverbindungen zwischen den Chips miteinander verbunden sind.
Cloud-Bereitstellungen und Systemökosystem
Die ersten kommerziellen Anwendungen sind bei spezialisierten Cloud-Service-Anbietern bereits im Gange. Nebius wurde als erster KI-Cloud-Partner für den Einsatz von Groq 3 LPX ausgewählt und plant, die Hardware in seinen Produktions-Inferenzdienst Nebius Token Factory zu integrieren. Diese Architektur ermöglicht Entwicklern den Zugriff auf Echtzeit-Inferenzbeschleunigung über bestehende API-Schnittstellen, ohne dass Codebasen auf neue Framework-Abstraktionen migriert werden müssen. Der Inferenzanbieter Groq erwartet, zu den ersten Anwendern der Plattform zu gehören.


NVIDIA präsentiert zum Launch aktualisierte Plattformberechnungen für das zugehörige Rack und verspricht einen bis zu 30-fach höheren Token-Durchsatz pro Megawatt für Vera Rubin NVL72 im Vergleich zu GB300 NVL72 bei einer agentenbasierten Codierungslast von 140,000 Token. Dieser Vorteil vergrößert sich mit steigenden Interaktivitätszielen pro Benutzer. Die Hardware-Implementierung ist in NVIDIAs umfassende Rubin AI-Fabrikinfrastruktur integriert, die sieben separate Chips in fünf speziell entwickelten Rack-Konfigurationen umfasst.
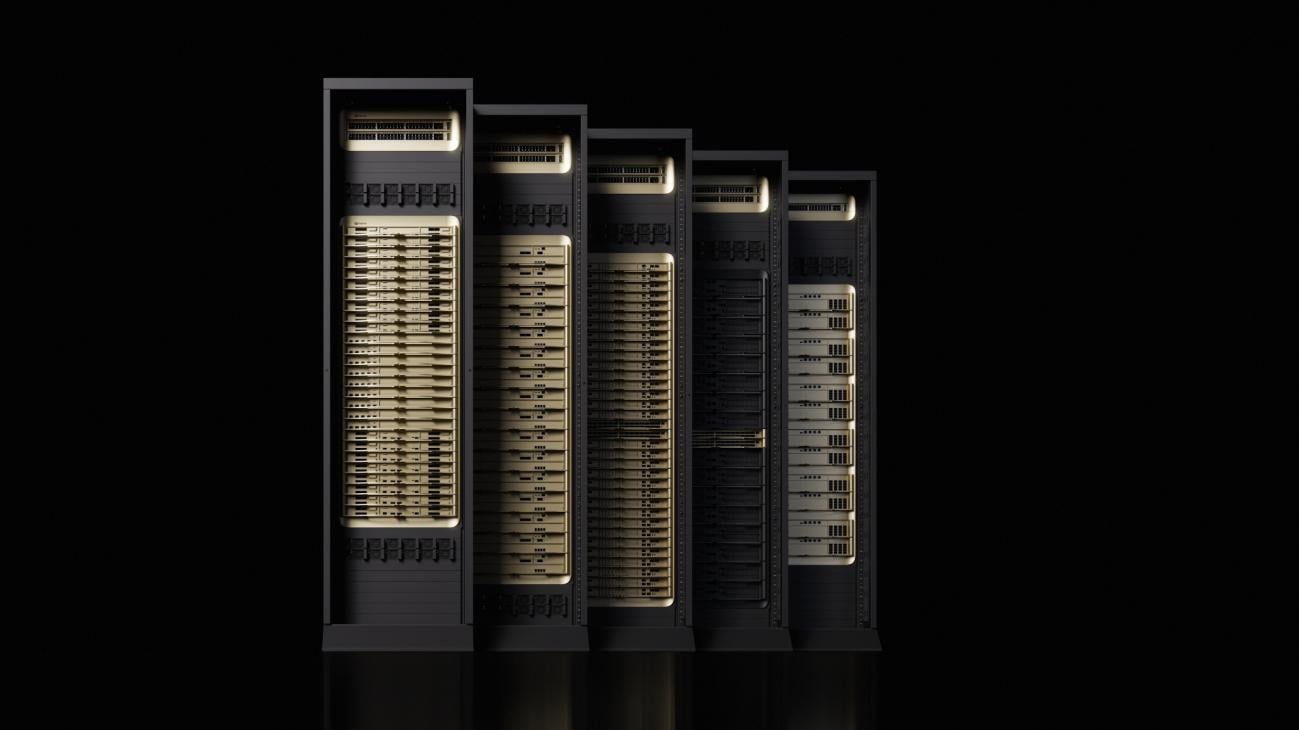
Zu den Systemkomponenten, die zusammen mit Rubin- und LPX-Rechenclustern arbeiten, gehören NVIDIA Vera CPU-Racks, Vera BlueField-4 STX-Speicherarrays und NVIDIA Spectrum-6 SPX-Netzwerk-Fabrics.
Was NVIDIA und Nebius sagen
„Inferenz ist der Wachstumsmotor der KI. NVIDIA Grace Blackwell und NVL72 haben die Inferenz großer Sprachmodelle mit einem beispiellosen Sprung in Leistung und Effizienz revolutioniert“, sagte Jensen Huang, Gründer und CEO von NVIDIA. „Vera Rubin erweitert diese Vision mit workload-optimierten KI-Fabrikkonfigurationen, die für das Zeitalter der agentenbasierten KI entwickelt wurden, und setzt mit LPX für ultraschnelle Token-Generierung neue Maßstäbe in puncto Leistung.“
Nebius verdeutlichte den Nutzen anhand der tatsächlichen Latenz für die Nutzer. „Die Generierungsphase ist diejenige Phase der Inferenz, die die Reaktionsfähigkeit eines KI-Systems bestimmt, und genau diese Phase beschleunigt NVIDIA Groq 3 LPX“, so Danila Shtan, CTO von Nebius. „Als erste KI-Cloud, die diese Technologie über die Nebius Token Factory produktiv einsetzt, stellen wir sicher, dass jeder Schritt im Ablauf eines Agenten unmittelbar spürbar ist – über dieselbe API, die Entwickler bereits nutzen, ohne Migration auf einen neuen Stack.“
Spectrum-X Multiplane- und Scale-In-Infrastruktur
Um den enormen Netzwerkbedarf dieser Rechenzentren zu decken, stellte NVIDIA seine Spectrum-X Multiplane Ethernet-Architektur in den Vordergrund. Herkömmliche Clustererweiterungen über die heutigen Dichtegrenzen hinaus erfordern oft eine dritte Switching-Ebene, was zu Latenzproblemen, Kosten für Glasfaserkabel und einem erhöhten Stromverbrauch führt. Spectrum-X Multiplane umgeht dieses Problem, indem es die Host-Netzwerkschnittstellen in mehrere unabhängige Ebenen aufteilt, die jeweils ein flaches, zweistufiges Netzwerk betreiben, das auf bis zu 512,000 GPUs skaliert.

Verkehrsmanagement und Fehlerkorrektur werden von der NVIDIA ConnectX-9 SuperNIC direkt im Chip realisiert. In Kombination mit Spectrum-6 Ethernet-ASICs mit 102.4 Tbit/s unterstützt sie Netzwerkgeschwindigkeiten von bis zu 1,600 Gbit/s pro GPU. Spectrum-XGS Ethernet erweitert dieses Codesign auf Standorte und beschleunigt laut NVIDIA die Leistung von NCCL-Kollektiven an mehreren Standorten um das 1.9-Fache. In einer Acht-Ebenen-Topologie leitet Hardware-Failover den Datenverkehr sofort um ausgefallene Pfade herum und erhält dabei rund 90 Prozent der gesamten Netzwerkbandbreite aufrecht. NVIDIA gibt die Hardware-Wiederherstellung mit 11-mal schneller als softwarebasiertes Multiplane-Load-Balancing an, was laut NVIDIA zu einer 1.6-fach höheren Produktivität in KI-Fabriken führt.

Parallel dazu stellte NVIDIA seine Scale-In-Netzwerkarchitektur vor, die BlueField-4-Datenverarbeitungseinheiten mit dem DOCA-Software-Stack kombiniert . Scale-In zielt auf die Nord-Süd-Infrastruktur ab und lagert Multi-Tenant-Isolation, In-Silicon-Verschlüsselung mit Leitungsgeschwindigkeit, Telemetrie und Hochleistungsspeicherdatenpfade von den Hostprozessoren aus.
NVLink Fusion für kundenspezifische Siliziumintegration
NVIDIA hat außerdem NVLink Fusion für Hyperscale-Betreiber mit Bedarf an Hybridarchitekturen vorgestellt. Das Framework ermöglicht die direkte Integration von kundenspezifischen XPUs und CPUs von Drittanbietern in die skalierbaren Netzwerkarchitekturen NVLink und NVLink-C2C der sechsten Generation von NVIDIA. Durch die Nutzung modularer NVIDIA MGX-Gehäuse und der zugehörigen Managementsoftware können Rechenzentrumsbetreiber die Designs für gemeinsam genutzte Stromversorgung, Kühlung und Netzwerk-Racks standardisieren und gleichzeitig das Verhältnis von GPUs, LPUs und kundenspezifischen Chips an die sich ändernden Workloads anpassen.
NVIDIA machte auf der Hot Chips eine zweite Ankündigung zu Vera Rubin: SpaceXAI setzt Vera-CPUs für die agentenbasierten Workloads hinter Grok ein und plant, einen optimierten Vera Rubin NVL72 an Bord seines Starmind-Satelliten der ersten Generation in die Umlaufbahn zu bringen.


 Amazon