

NVIDIA hat auf der GTC Berlin Minerva vorgestellt, eine AIOps-Plattform, die Telemetriedaten von GPUs, Netzwerken, Speichern, Schedulern und den darauf laufenden KI-Workloads erfasst und anschließend maschinelles Lernen einsetzt, um fehlerhafte Komponenten zu identifizieren, bevor diese den Trainingsvorgang verlangsamen. Dell Technologies, Lenovo und Supermicro werden Minerva in ihre Portfolios für KI-Fabrikbetrieb integrieren, IREN nutzt die Plattform bereits, und IBM, Jio, Lambda, Quake AI, Tesla, Aolani und Bitdeer AI planen die Implementierung. NVIDIA hat weder Preise noch einen allgemeinen Verfügbarkeitstermin bekannt gegeben.
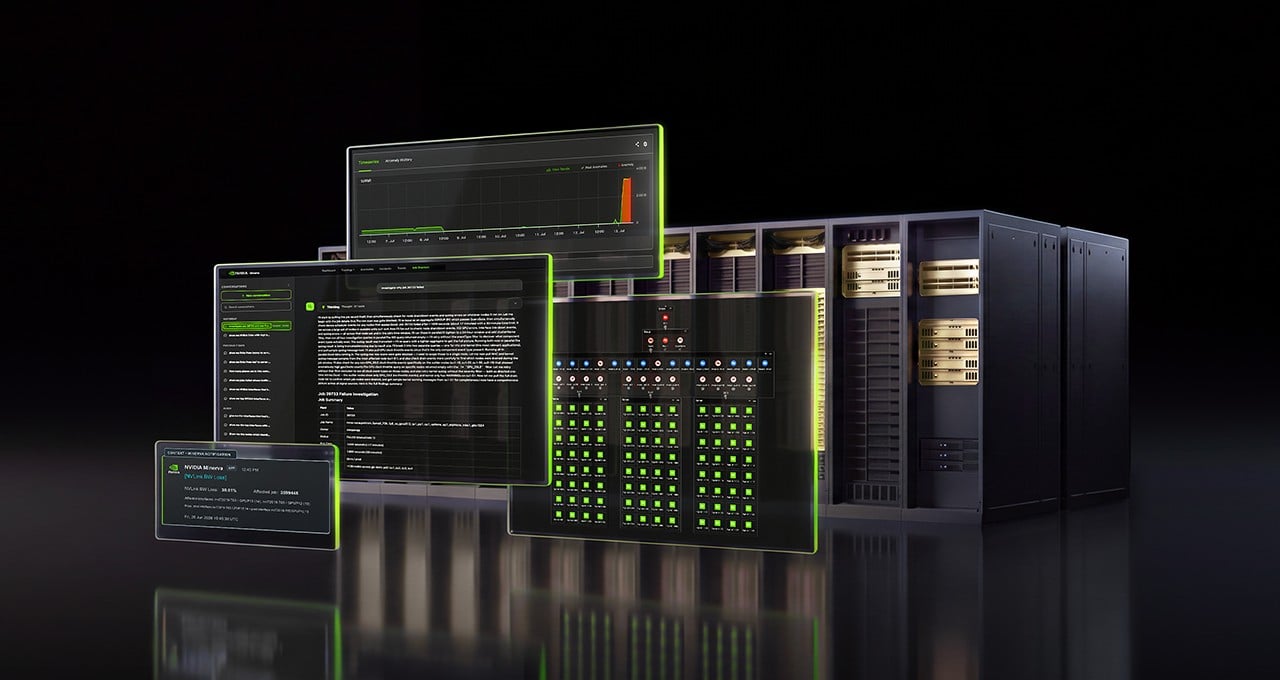
Das Problem, das Minerva angeht, ist jedem Betreiber großer Cluster bekannt: Tausende von GPUs in einem Hochgeschwindigkeitsnetzwerk verhalten sich wie eine einzige Maschine. Wenn also eine einzelne Komponente außerhalb der Spezifikationen arbeitet, zieht sie den gesamten Prozess nach hinten. NVIDIA nennt als Beispiele eine GPU, die heißer läuft als ihre Nachbarn, und eine NVMe-SSD, deren Leistung unter Last abnimmt. Solche Datensignale finden sich heute in Netzwerktools, Rechenwerkzeugen und den Dashboards von ML-Teams wieder – jedes mit einer separaten Ansicht desselben Clusters.
Was Minerva Uhren
Minerva erstellt einen dynamischen Wissensgraphen, der GPUs, SuperNICs, Switches, Kabel und die darauf geplanten Jobs abbildet. Anschließend analysiert das Unternehmen mithilfe von überwachtem und unüberwachtem maschinellem Lernen Milliarden von Datenpunkten pro Stunde (laut NVIDIA). Die Modelle lernen das normale Verhalten der Fabrik, erkennen bisher unbekannte Anomalien, prognostizieren sich anbahnende Ausfälle und korrelieren verwandte Ereignisse anhand der Topologie. So lässt sich ein langsamer Trainingsjob in Fabriken mit Hunderttausenden von GPUs auf die verantwortliche Komponente zurückführen.
Die Ausgabe erfolgt in Form von Vorfällen, wobei zusammengehörige Ereignisse zu einem einzigen Eintrag zusammengefasst und die wahrscheinliche Ursache zugeordnet wird. Laut NVIDIA ersetzt dies eine Flut von Warnmeldungen durch eine einzige, umsetzbare Maßnahme. Ein integrierter Assistent beantwortet Fragen in natürlicher Sprache anhand der Live-Telemetriedaten und empfiehlt eine Lösung. Die Plattform ist zudem mit externen Agenten-Tools kompatibel. Die Bediener entscheiden, ob die Behebung manuell durchgeführt oder von Minerva über Infrastruktur-APIs und externe Systeme automatisiert wird.
NVIDIA beschreibt den Nutzen als KI-Fabrikausbeute, gemessen in GPU-Stunden, Datendurchsatz, Clusterverfügbarkeit und Token-Produktion. Die versprochenen Ergebnisse sind längere Intervalle zwischen Unterbrechungen, schnellere Reparaturen und weniger zu priorisierende Warnmeldungen, wodurch das Betriebsteam von reaktiver zu proaktiver Wartung übergehen kann. Dies sind Herstellerangaben ohne konkrete Zahlen; NVIDIA hat weder die mittlere Reparaturzeit noch die Verfügbarkeitswerte für Minerva veröffentlicht.
Wo es sich im Stapel befindet
NVIDIA bietet bereits Betriebssoftware für seine Referenzdesigns an. Mission Control , eingeführt im März 2025, übernimmt die Clusterbereitstellung über den Base Command Manager, das Workload-Management über Run:ai, Telemetrie und die autonome Job-Wiederherstellung für DGX SuperPOD-Systeme. In derselben Woche wie Minerva veröffentlichte NVIDIA drei Open-Source-DSX-OS-Komponenten als Entwicklervorschau für das Lebenszyklusmanagement von KI-Fabriken: Config Manager für die Netzwerkkonfiguration, Rack Management Service für die Stromversorgung, Inventarisierung, Firmware- und Switch-Verwaltung auf Rack-Ebene sowie die Cluster Readiness Engine zur Validierung von GPU-Clustern mit verteilten Workloads.
Das Ausmaß des Problems, das Minerva angehen will, wurde letzte Woche in Metas Prometheus-Bericht deutlich . Meta betreibt jede NVL72-Domäne als 64-GPU-Slice, wobei die restlichen acht GPUs als Ersatz im Rack bereitgehalten werden. Etwa zwei Prozent der Racks werden als Reserve gehalten, und jedes reparierte System wird bis zur erfolgreichen Validierung unter Quarantäne gestellt. Ein Jahr Ursachenforschung mit NVIDIA-Ingenieuren vor Ort reduzierte die Ausfallzeiten um 99 Prozent und steigerte die mittlere Zeit zwischen Unterbrechungen auf über 54,000 GPU-Stunden, mit dem Zielwert von 100,000 Stunden.
Das ist ein Hyperscaler, der eine speziell entwickelte Telemetrie-Pipeline und ein gemeinsames Triage-Team mit NVIDIA betreibt. Minerva scheint eine vorkonfigurierte Version dieser Vorgehensweise zu sein – eine sofort einsatzbereite Lösung für Unternehmen oder Neocloud-Anbieter, die Transparenz auf Hyperscaler-Niveau hinsichtlich GPU-, Fabric- und Speicherzustand sowie den dazugehörigen Austausch- und Neustart-Workflow benötigen. Die Lösung wird von denselben OEMs bereitgestellt, die auch die Racks verkaufen.
NVIDIA hat noch nicht bekannt gegeben, in welchem Verhältnis Minerva zu Mission Control oder DSX OS steht, ob es als Software, Appliance oder gehosteter Dienst ausgeliefert wird oder wie die OEM-Verpackung von Dell, Lenovo und Supermicro aussehen wird. Auf der Dokumentationsseite des Produkts werden Kunden für die Bedienungsanleitung an ihr zuständiges NVIDIA-Kundenbetreuungsteam verwiesen. Als Kundenreferenz wird IREN genannt, das laut NVIDIA Minerva bereits zur Optimierung seiner KI-Fabriken einsetzt.
„NVIDIA Minerva bietet unserem Betriebsteam einen Überblick über das gesamte Netzwerk, die GPUs und die darauf laufenden Jobs“, sagte Denis Skrinnikoff, Chief Technology Officer von IREN, der die Software dafür lobte, dass sie dem Team mehr Zeit für die proaktive Wartung verschafft habe.
Im Bereich der Speicherlösungen ist die interessante Behauptung, dass das Verhalten der Laufwerke unter Last neben GPU- und Fabric-Telemetriedaten als Eingangsgröße dient. Denn ein NVMe-Gerät, dessen Leistung nachlässt, zeigt sich in der GPU-Auslastung erst dann, wenn ein Checkpoint oder ein Datenladevorgang ins Stocken gerät. Wie detailliert diese Speichertelemetrie ist und welche OEM- und Array-Plattformen sie liefern, wird mit Spannung erwartet, sobald diese Lösung auf den Markt kommt.



 Amazon