

Sandisk hat den ersten Flash-Speicherchip mit hoher Bandbreite (HBF) fertiggestellt. Das Unternehmen präsentierte ihn am 13. August 2026 auf einer Folie im Rahmen seines Investorentags unter der Überschrift „HBF-Roadmap“, neben einem Bild des Chips. Die zweite Hälfte der Folie befasst sich mit den ersten Mustern von HBF-Inferenzprodukten: Verfügbarkeit in Kürze, 2027.

Ein Tapeout ist ein wichtiger Meilenstein bei jedem neuen Siliziumchip. Er bedeutet, dass das Design fertiggestellt und auf ein Maskenset festgelegt ist. Ab diesem Zeitpunkt ist die Architektur nicht mehr nur eine Folie, sondern wird zu einem realen Siliziumchip. Bis zum fertigen Produkt sind es jedoch noch einige Schritte. Die Wafer müssen aus der Fertigung zurückkommen, der Chip muss die Zielvorgaben erfüllen, die Ausbeute muss ein wirtschaftliches Niveau erreichen, und der Chip muss anschließend das Stapeln in 8- und 16-fach gestapelten Konfigurationen mit einem darunterliegenden, funktionierenden Logikchip und Controller überstehen. Danach folgen die thermische und Ausdauerqualifizierung, die Entwicklung der Beschleunigersoftware zur Adressierung des Speichers sowie die vierteljährlichen Kundenqualifizierungszyklen. Sandisk teilt den Investoren mit, dass der erste dieser Schritte abgeschlossen ist.
Was Sandisk über die Leistung von HBF sagt
HBF verwendet NAND-Speicher anstelle von DRAM und platziert ihn in einem HBM-ähnlichen Gehäuse neben dem Beschleuniger. Laut Sandisks HBF-Datenblatt bietet die erste Generation 512 GB pro Stapel, bestehend aus sechzehn 256-GB-Chips, bei einer Lesegeschwindigkeit von 1.6 TB/s. Sandisk gibt an, dass dies die 8- bis 16-fache Kapazität von HBM bei ähnlichen Kosten in einem Gehäuse mit vergleichbarer Größe, Stapelhöhe und Leistungsaufnahme wie HBM4 bietet. Da es sich um NAND-Speicher handelt, ist er nichtflüchtig und benötigt beim Auffrischen keine Energie.
Die Roadmap im Datenblatt geht noch weiter. Eine zweite Generation zielt auf mehr als 2 TB/s und bis zu 1 TB pro Stack bei 0.8-fachem Stromverbrauch der ersten Generation ab, während eine dritte Generation über 3.2 TB/s und bis zu 1.5 TB pro Stack bei 0.64-fachem Stromverbrauch erreichen soll. Die Präsentation für den Investorentag beschreibt die Ziel-Workloads klar: LLMs mit Experten, lange Kontextlängen und große KV-Caches. Die Architektur wurde unter Einbeziehung des Feedbacks führender Cloud- und KI-Kunden entwickelt.
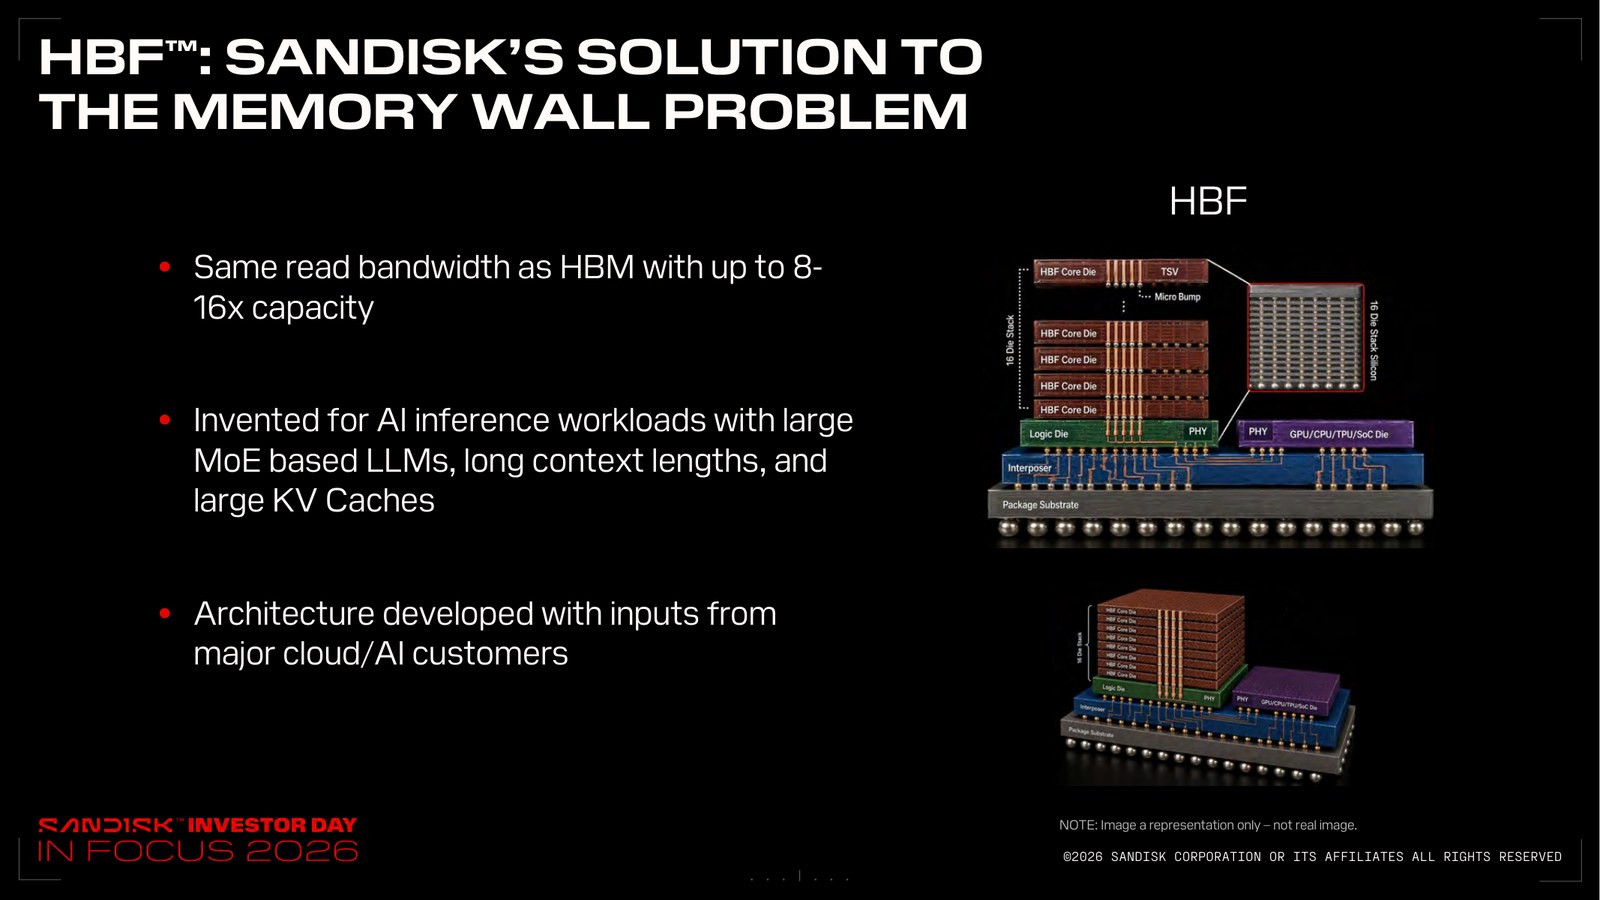
Das Dokument beschreibt außerdem drei Einsatzmöglichkeiten. HBF kann HBM ergänzen und einen Teil der Speicherplätze um eine xPU herum belegen, während HBM den Rest behält. Es kann HBM-Speicherplätze bei ähnlicher Speichergröße vollständig ersetzen. Alternativ kann es disaggregiert eingesetzt werden und Dekodierungsgewichte sowie den KV-Cache speichern, während eine kleinere HBM-Ebene als Cache dient. Diese Flexibilität ist wichtiger als es zunächst scheint, da sie den Einsatz von HBF in einem Socket ermöglicht, ohne dass ein Beschleunigerhersteller auf HBM verzichten muss.
Die internen Nummern, die Sandisk auf dem Bildschirm anzeigt
Sandisk präsentierte einen Vergleich der Token-Ausgabe bei Inferenz mit einer HBF-GPU, vier HBF-GPUs und acht HBM-GPUs. Daraus leitet das Unternehmen zwei Aussagen ab, die beide auf internen Tests basieren. Die erste Aussage bezieht sich auf eine achtfache Investitionskosteneffizienz, definiert als die minimale Konfiguration für die Ausführung des Modells: eine HBF-GPU im Vergleich zu acht HBM-GPUs. Die zweite Aussage bezieht sich auf eine doppelt so hohe GPU-Effizienz: Vier HBF-GPUs liefern die gleiche Token-Ausgabe wie acht HBM-GPUs. Das Datenblatt enthält außerdem ein zugehöriges Simulationsergebnis: HBF erreicht beim Lesen vortrainierter Gewichte für Llama 3.1 405B eine um 2.2 % geringere Leistung als HBM mit unbegrenzter Kapazität.
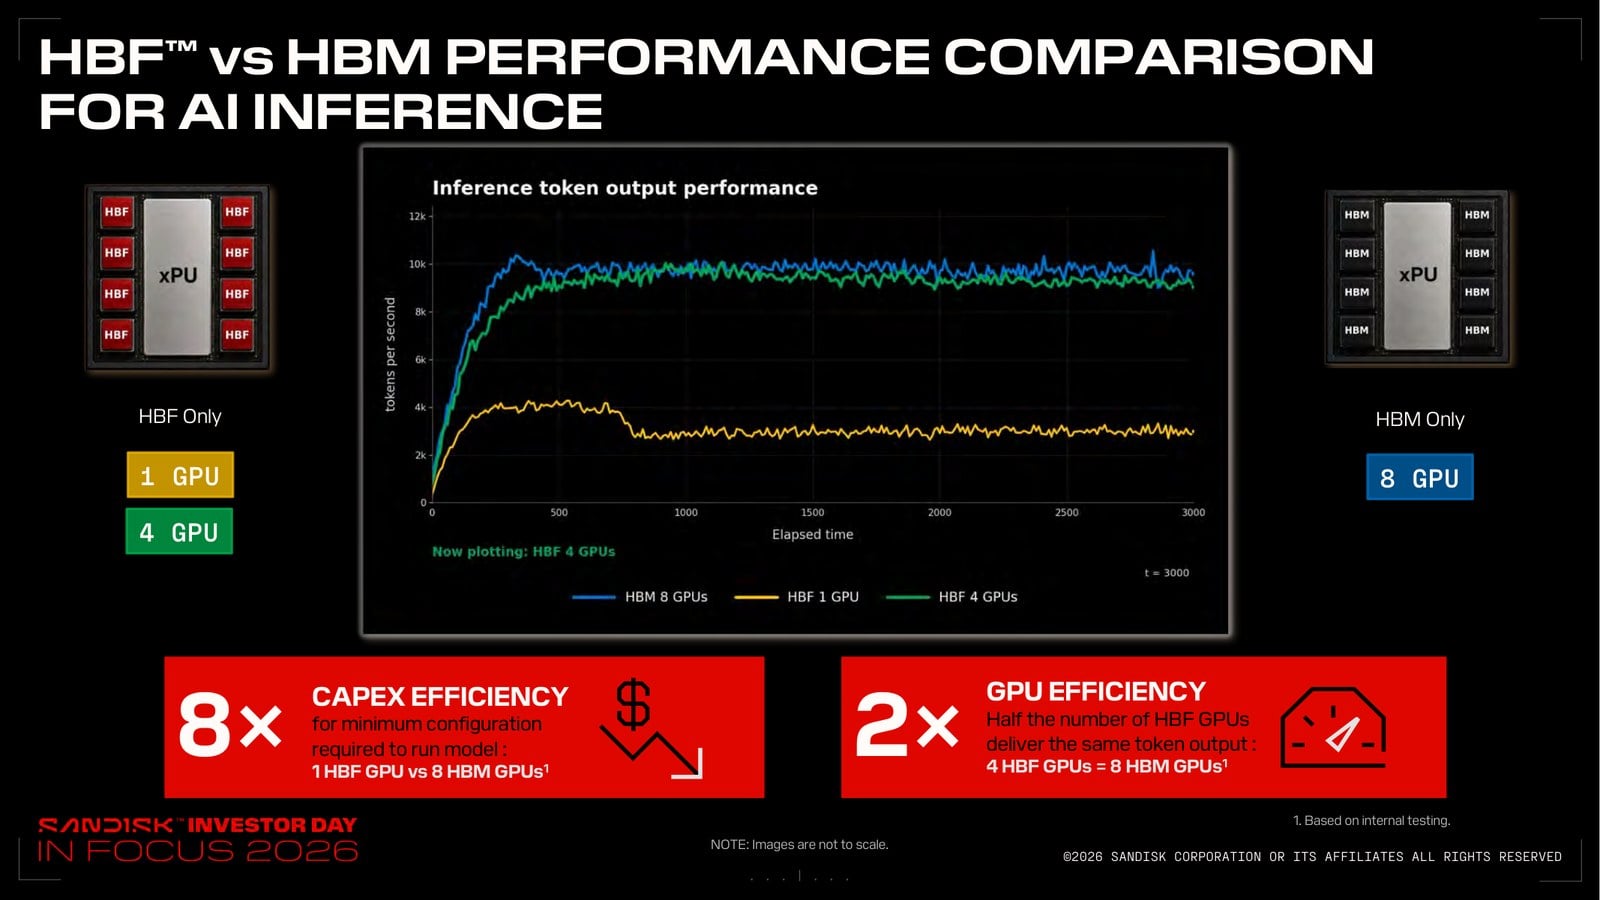
Hierbei handelt es sich um Herstellerangaben zu noch nicht veröffentlichten Chips, und die betreffende Grafik enthält keine Achsenwerte für Token pro Sekunde. Sie verdeutlicht jedoch das Konzept: Passt ein Modell in einen Speicher, der acht- bis sechzehnmal größer ist, bei gleicher Bandbreite und annähernd gleichem Stromverbrauch, benötigt man weniger Beschleuniger, um es zu speichern, und die vorhandenen Beschleuniger verbringen weniger Zeit im Leerlauf.
Wo steht der Zeitplan?
Zur Planung dienen zwei Sandisk-Mitteilungen als Rahmen für den Zeitplan. Im August 2025 gab das Unternehmen bekannt, dass die ersten HBF-Muster für die zweite Jahreshälfte 2026 geplant seien und KI-Inferenzgeräte mit HBF Anfang 2027 erwartet würden. Auf dem Investorentag im August 2026 wurden die ersten HBF-Inferenzproduktmuster für 2027 angekündigt. Die Zeitpläne für neue Speicherklassen konkretisieren sich mit der Umsetzung der Designs in Silizium, und die Plattformen der ersten Generation haben sich im Laufe dieses Zyklus aufgrund der Qualifizierungsanforderungen nach vorne verschoben. Der Tapeout belegt jedoch den Fortschritt von HBF.
Der Ökosystem-Aspekt ist weiter fortgeschritten als der Silizium-Aspekt.
Die Standardisierungsarbeit schreitet schneller voran als die Produktentwicklung. Am 3. August veröffentlichten Sandisk und SK hynix über das Open Compute Project die erste technische Spezifikation für HBF , sechs Monate nach der Gründung des Konsortiums, an dem auch Google und TensorEntr beteiligt waren. Wir berichteten über die Spezifikation und ihre Definitionen, als sie veröffentlicht wurde. Jim Keller von TensorEntr wurde bei der Veranstaltung zum Mitglied des technischen Beirats ernannt.
SK hynix, Mitautor der Spezifikation und Vorsteller seines eigenen gestaffelten Speicherkonzepts auf der FMS 2026 , ist maßgeblich daran beteiligt, ob sich daraus ein Standard oder ein Produkt eines einzelnen Herstellers entwickelt. Sandisk verfügt aktuell über einen fertig gefertigten Chip, eine veröffentlichte Spezifikation und plant die Auslieferung von Mustern für 2027. Der nächste entscheidende Meilenstein ist die Prüfung von Siliziumchips, die den Anforderungen genügen. Dies wird durch einen Fabrikbericht bestätigt, zu dem Sandisk hoffentlich bald weitere Informationen geben wird.



 Amazon