

Manche Server erweitern bestehende Systeme, andere setzen neue Maßstäbe. Der Dell PowerEdge R7725xd gehört zur zweiten Kategorie. In unseren jüngsten Tests, konfiguriert mit 24 Micron 9550 PRO PCIe Gen5 NVMe SSDs und vier 2x 200GbE NICs, erreichte dieser 2U-Server einen höheren Rohdaten-Durchsatz als jedes bisher von uns gemessene System. Intern erzielte die Plattform über 300 GB/s im NVMe-Speicherpool. Über das Netzwerk erreichte sie 160 GB/s mit Standard-RDMA – ohne zusätzliche Komplexität.
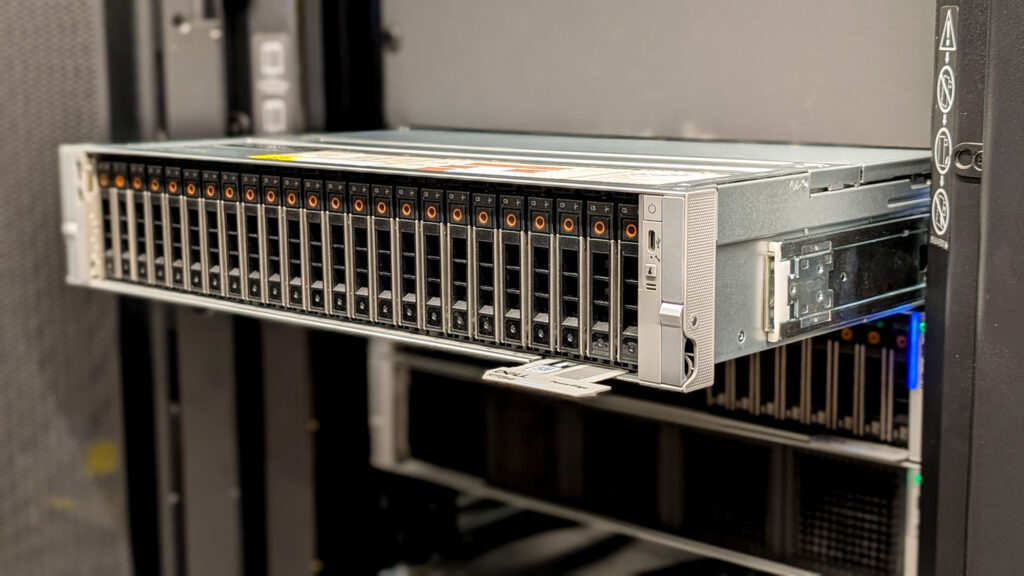
Dies ist nicht einfach nur ein schnellerer Speicherserver. Es ist ein System, das die Architektur datenintensiver Systeme grundlegend verändert. Moderne KI-Trainings- und Inferenzpipelines werden oft nicht durch die GPU-Leistung begrenzt, sondern dadurch, wie schnell Daten bereitgestellt, gestreamt, gemischt und zwischengespeichert werden können. Große GPU-Knoten bleiben ungenutzt, wenn der Speicher nicht mithalten kann. Teams begegnen diesen Einschränkungen durch den Einsatz von Caches, überdimensionierter Speicherkapazität und komplexem Tiering, um sicherzustellen, dass die Beschleuniger Daten schnell genug erhalten, um ihre Kosten zu rechtfertigen.
Der Dell PowerEdge R7725xd beseitigt den Flaschenhals direkt an der Quelle. Der Server basiert auf einer U.2-Backplane mit 24 Einschüben, wobei jedes Laufwerk über eine dedizierte PCIe Gen5 x4-Verbindung direkt mit dem AMD EPYC-Prozessorkomplex verbunden ist. Es gibt keine Bandbreitenaufteilung und keinen Midplane-Expander zur Reduzierung der Parallelität. Die Leistung skaliert reibungslos, da die Hardwarearchitektur auf die Aggregation des Durchsatzes ohne Konflikte ausgelegt ist. In einer herkömmlichen 2-Sockel-Konfiguration sind die CPUs über vier XGMI-Verbindungen für die Kommunikation zwischen den Sockeln verbunden. Im R7725xd wird eine dieser Verbindungen für zusätzliche 16 PCIe Gen5-Lanes pro CPU genutzt, wodurch der Server insgesamt 160 PCIe Gen5-Lanes erhält (96 für die vorderen SSDs und 64 für die vier hinteren PCIe-Steckplätze). In Kombination mit Microns 9550 PRO SSDs, die für dauerhafte Schreiblasten und hohe Lebensdauer ausgelegt sind, wird das System zu einer leistungsstarken Datenmaschine, die sowohl checkpointintensive als auch kontinuierliche Streaming-Workloads unterstützt.
Wir haben PEAK:AIO auf dieser Architektur aufgebaut, um parallele Übermittlungspfade zu nutzen und die Effizienz auch bei steigender Parallelität aufrechtzuerhalten. Das Ergebnis war nicht nur Spitzenleistung, sondern auch dauerhafte Leistung unter Last. Die Plattform kann als lokaler Ausführungsknoten für Vorverarbeitung, Training oder Transformation fungieren oder über das Netzwerk als Speicher mit hoher Bandbreite für mehrere GPU-Systeme dienen. Wer es etwas abenteuerlicher mag, kann auch beides gleichzeitig nutzen.
Wichtige Erkenntnisse
- Beispielloser Durchsatz in einem einzelnen Knoten: Der R7725xd erreichte eine interne Bandbreite von über 300 GB/s und 160 GB/s über NVMe-oF RDMA und konnte damit mit Multi-Node-Speicherclustern in einem 2U-Gehäuse mithalten.
- Echte Gen5-Architektur, keine Switches, kein Fan-Out: Alle 24 Micron 9550 PRO SSDs erhalten dedizierte x4 PCIe Gen5 Lanes direkt vom CPU-Komplex, was eine Skalierung der Leitungsgeschwindigkeit ohne Konflikte ermöglicht.
- Ausgestattet mit AMD EPYC 9005-Prozessoren: Zwei AMD EPYC 9575F Prozessoren bieten die für einen dauerhaften, hochgradig parallelen E/A-Verkehr notwendige Lane-Anzahl, Speicherbandbreite und NUMA-Topologie.
- Konzipiert für KI-, Analyse- und Checkpoint-intensive Workloads: Das System beseitigt die E/A-Engpässe, die moderne GPU-Pipelines zum Stillstand bringen, und ermöglicht so eine kontinuierliche Datenübertragung mit hoher Bandbreite.
- PEAK:AIO schaltet volle Parallelität frei: Der Software-Stack von PEAK:AIO sorgt dafür, dass die Warteschlangenstrukturen auch unter Last optimal ausgelastet bleiben und bietet so eine hohe Unternehmensleistung zu einem überzeugenden Preis-Leistungs-Verhältnis pro GB.
Speziell entwickelt für NVMe-Durchsatz
Bei den neuesten Servern verzichtete Dell in speicherintensiven Konfigurationen auf PCIe-Switches. Modelle wie der PowerEdge R770 oder R7725 bieten PCIe Gen5 x4-Einschübe für bis zu 16 SSDs und nutzen bei größeren Speicherkonfigurationen x2-Einschübe. Server der Vorgängergeneration, wie der PowerEdge R760, enthielten in Konfigurationen mit 24 NVMe-Einschüben noch einen PCIe-Switch. Um den Aufbau zu vereinfachen und die durch PCIe-Switches verursachte Komplexität zu reduzieren, verfolgte Dell bei neuen Servern die Strategie, die Anzahl der PCIe-Lanes in speicherintensiven Konfigurationen zu verringern. Dies änderte sich erst mit dem R7725xd.
Der Unterschied zwischen dem Standard-R7725 und dem R7725xd liegt in der Verteilung der PCIe-Root-Complex-Ressourcen. Der Basis-R7725 verteilt die PCIe-Lanes auf Speicher, GPU-Erweiterung und allgemeine E/A. Die „xd“-Variante hingegen verteilt dieses Budget neu, sodass das NVMe-Subsystem die PCIe-Bandbreite primär nutzt. Die 24 U.2-Einschübe sind direkt mit dem PCIe-Gen5-Root-Interface der CPU verbunden, wobei jede SSD einen eigenen x4-Endpunkt erhält – keine gemeinsame Verbindung über einen PCIe-Switch oder Retimer-Tree. Dadurch verfügt jedes Laufwerk über unabhängige Warteschlangenstrukturen und unabhängige DMA-Pfade zum Speichercontroller.
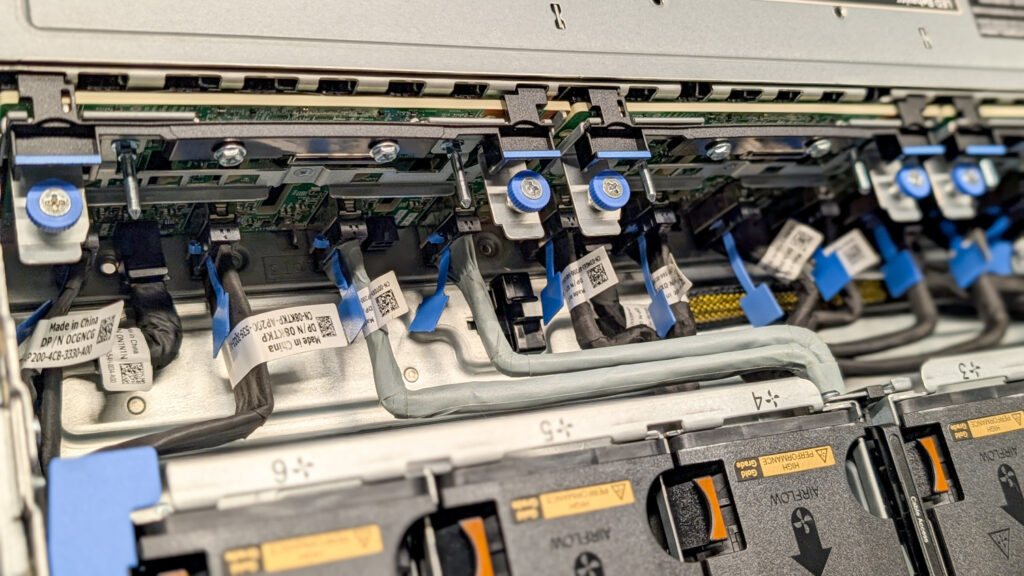
Die Topologie von Backplane und Riser spiegelt dieses Engagement wider. Dell gruppiert die NVMe-Anschlüsse und PCIe-Steckplätze auf beide AMD EPYC-Sockel, sodass jeder Prozessor direkt einen Teil des Laufwerkssatzes verwaltet. Dadurch entstehen zwei symmetrische NVMe-Domänen mit jeweils eigenen lokalen Latenzeigenschaften und vollständiger Lese-/Schreibkonkurrenz. Beim Einbau von vier Broadcom Dual-Port 200GbE-Netzwerkkarten als Erweiterungskarten ermöglichte die Steckplatzanordnung, dass jede Netzwerkkarte in einer PCIe-Domäne platziert wurde, die der entsprechenden NVMe-Gruppe zugeordnet war. Unter NVMe-over-RDMA blieb der Netzwerkverkehr somit lokal auf dem Sockel, der die zugehörige Laufwerks-E/A verarbeitete. Dadurch wurde der Inter-Socket-Infinity-Fabric-Hop vermieden, der üblicherweise Latenz und Bandbreitenverbrauch unter Last verursacht.
Das thermische Verhalten unterstützt einen dauerhaft hohen Durchsatz. U.2 bietet auch in dichten Gen5-Konfigurationen Vorteile, da es einen definierten Luftstromkanal und eine vorhersehbare Kühlkörperoberfläche für jedes Gerät bereitstellt. Die Lüftermodule mit hohem statischen Druck und die Gehäusekanäle des R7725xd gewährleisten einen gleichmäßigen Luftstrom über alle 24 Einschübe hinweg und ermöglichen so kontinuierliche Schreibvorgänge unter Volllast ohne Drosselung. Das mechanische Design ergänzt das elektrische: Jedes Laufwerk kann seine volle Leistung erbringen, da die Plattform für die Kühlung von 24 gleichzeitig betriebenen Gen5-Geräten unter Last ausgelegt ist.
Diese Kombination aus Wurzelkomplex-Ausrichtung, konsistentem NUMA-Layout, Socket-optimierter NIC-Platzierung und thermisch stabilem U.2-Gehäuse ermöglicht dem System I/O-Leistung in großem Umfang. Die Architektur vermeidet Engpässe und optimiert die Leistung.
Dell PowerEdge R7725xd iDRAC 10 Übersicht
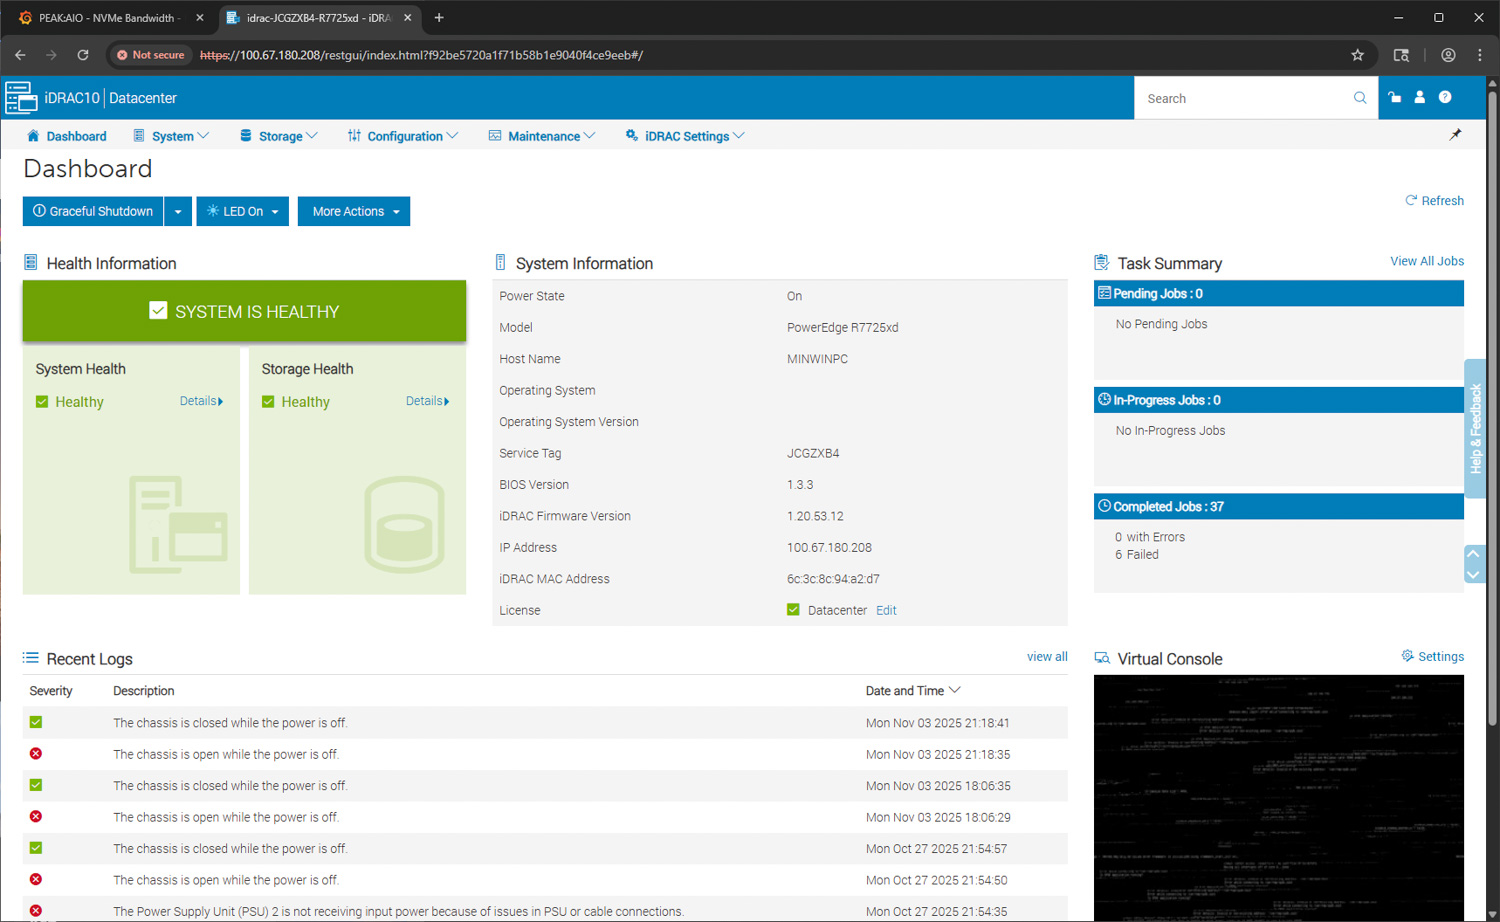
Diese Generation des R7725xd verfügt, wie viele andere von uns getestete Plattformen der 17. Generation, über Dells neue iDRAC 10-Plattform. Diese dient als zentrale Anlaufstelle für Fernverwaltung, Systemüberwachung und Out-of-Band-Steuerung. Das Dashboard bietet eine sofortige Übersicht über den allgemeinen Systemzustand, den Speicherstatus und die letzten Aktivitäten. Bei unserem Testgerät ist der System- und Speicherzustandsbericht grün, was den ordnungsgemäßen Betrieb des Servers bestätigt. Wichtige Systemdetails wie Modell, Hostname, BIOS-Version, iDRAC-Firmware-Version, IP-Adresse und Lizenzinformationen werden auf der rechten Seite der Benutzeroberfläche angezeigt.
Das Dashboard enthält außerdem eine Aufgabenübersicht, die abgeschlossene, ausstehende und laufende Vorgänge anzeigt. Darunter befindet sich eine Liste der letzten Protokolle, die Gehäuseeingriffe und Meldungen zur Stromversorgung erfasst und so einen schnellen Überblick über Hardware-Statusänderungen ermöglicht, ohne dass tiefergehende Menüs aufgerufen werden müssen. Die virtuelle Konsole für die vollständige Fernsteuerung des KVM-Systems ist unten rechts verfügbar.
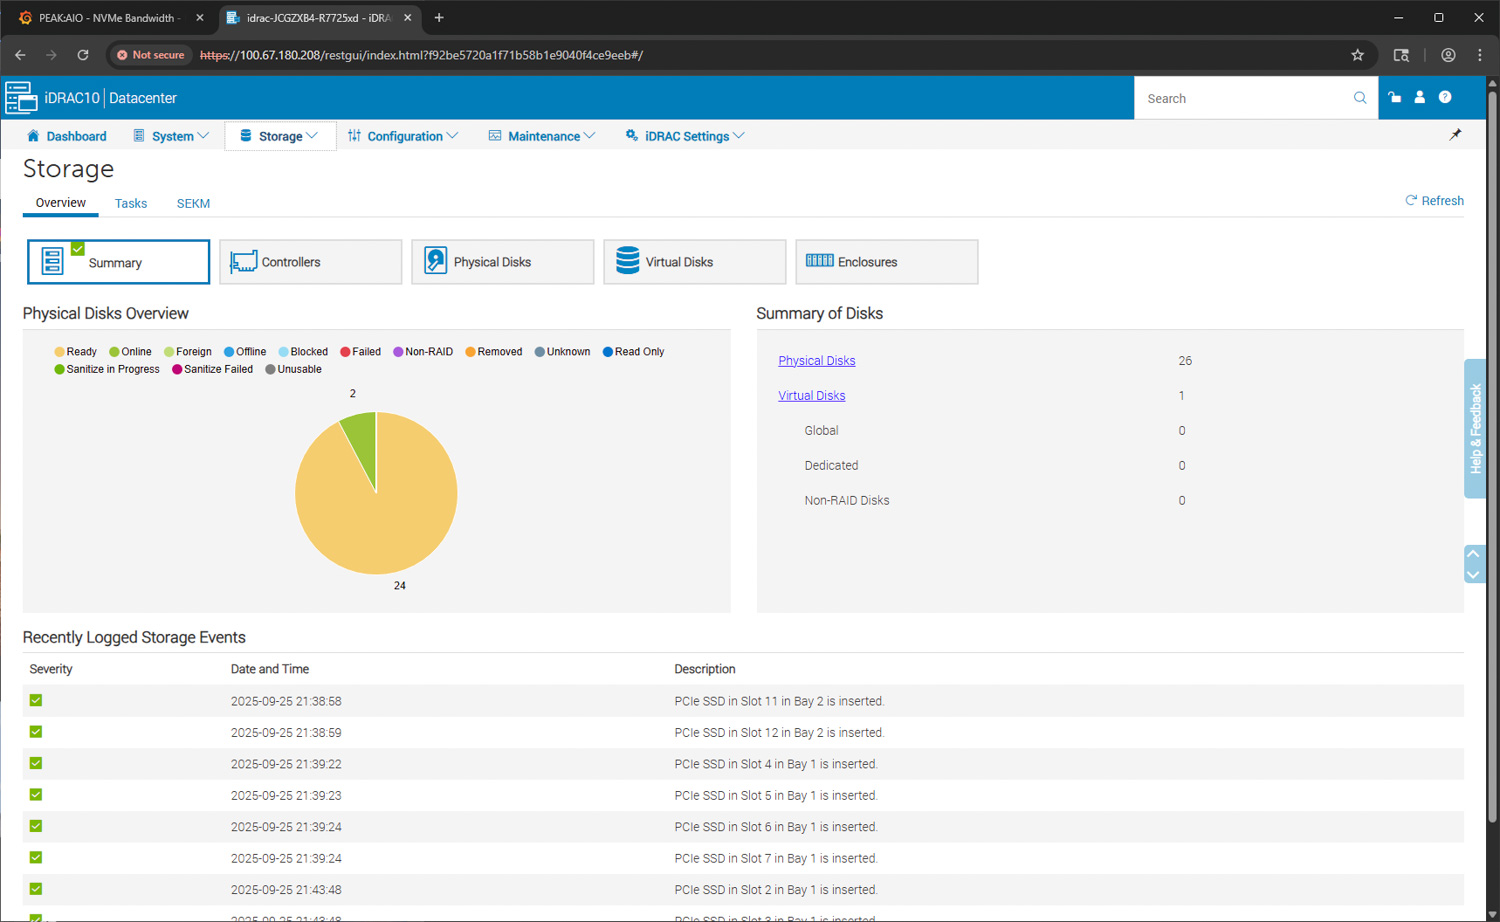
Der Speicherbereich von iDRAC 10 bietet eine vollständige Übersicht aller im R7725xd installierten physischen Festplatten. Das Übersichtsfenster zeigt die Anzahl aller angeschlossenen Laufwerke an, ergänzt durch ein Tortendiagramm, das deren Status visualisiert. In dieser Konfiguration sind 24 NVMe-SSDs aktiv und betriebsbereit. Zusätzlich sind zwei weitere Boot-Laufwerke im System vorhanden, die vom primären NVMe-SSD-Bank getrennt sind.
Rechts zeigt die Übersicht der Datenträger eine Aufschlüsselung in physische Datenträger und zugehörige virtuelle Datenträger. Da der R7725xd eine direkte NVMe-Architektur ohne herkömmliche RAID-Controller verwendet, werden alle Laufwerke als Nicht-RAID-Laufwerke angezeigt und sind einzeln adressierbar. Dies entspricht dem Systemdesign für große NVMe-Pools und SDS-Plattformen.
Unterhalb der Statusübersicht listet der Bereich „Kürzlich protokollierte Speicherereignisse“ die Einfügeprotokolle für jede PCIe-SSD auf, sortiert nach Einbauschacht und Steckplatz. Diese Protokolle bestätigen die korrekte Erkennung in allen Laufwerksschächten und helfen, Probleme mit dem Einbau, der Verkabelung oder dem Hot-Swap-Vorgang zu identifizieren. Bei großen Installationen sind diese Protokolle nützlich, um die Laufwerksbereitstellung zu verfolgen oder zu überprüfen, ob die Kapazität wie erwartet bestückt wurde.
Der letzte Screenshot zeigt die detaillierte Ansicht der NVMe-Geräte in iDRAC10. Jedes im System installierte NVMe-Laufwerk wird mit Status, Kapazität und Einbauort aufgelistet. Durch Auswahl eines Laufwerks wird eine vollständige Übersicht seiner Eigenschaften angezeigt.
In diesem Beispiel zeigt das Informationsfeld des Laufwerks die vollständige Modellbezeichnung, das Geräteprotokoll, den Formfaktor und die ausgehandelten PCIe-Einstellungen an. Die NVMe-Laufwerke arbeiten mit einer Verbindungsgeschwindigkeit von 32 GT/s und einer ausgehandelten x4-Verbindung. Dies bestätigt, dass die Laufwerke auf der PCIe-Gen5-Backplane des Systems mit voller Bandbreite arbeiten. Der Informationsbereich zeigt außerdem den prozentualen Ausdauerwert, den verfügbaren Ersatzspeicher und den Protokolltyp an und unterstützt Administratoren so bei der Überwachung des Laufwerkszustands und der zu erwartenden Lebensdauer.
Diese detaillierte Laufwerksberichterstattung ist besonders wertvoll in NVMe-Konfigurationen mit hoher Speicherdichte, wo die Verbindungsbreite, die ausgehandelte Geschwindigkeit und der Zustand der Speichermedien das Arbeitslastverhalten und die Speicherleistung direkt beeinflussen.
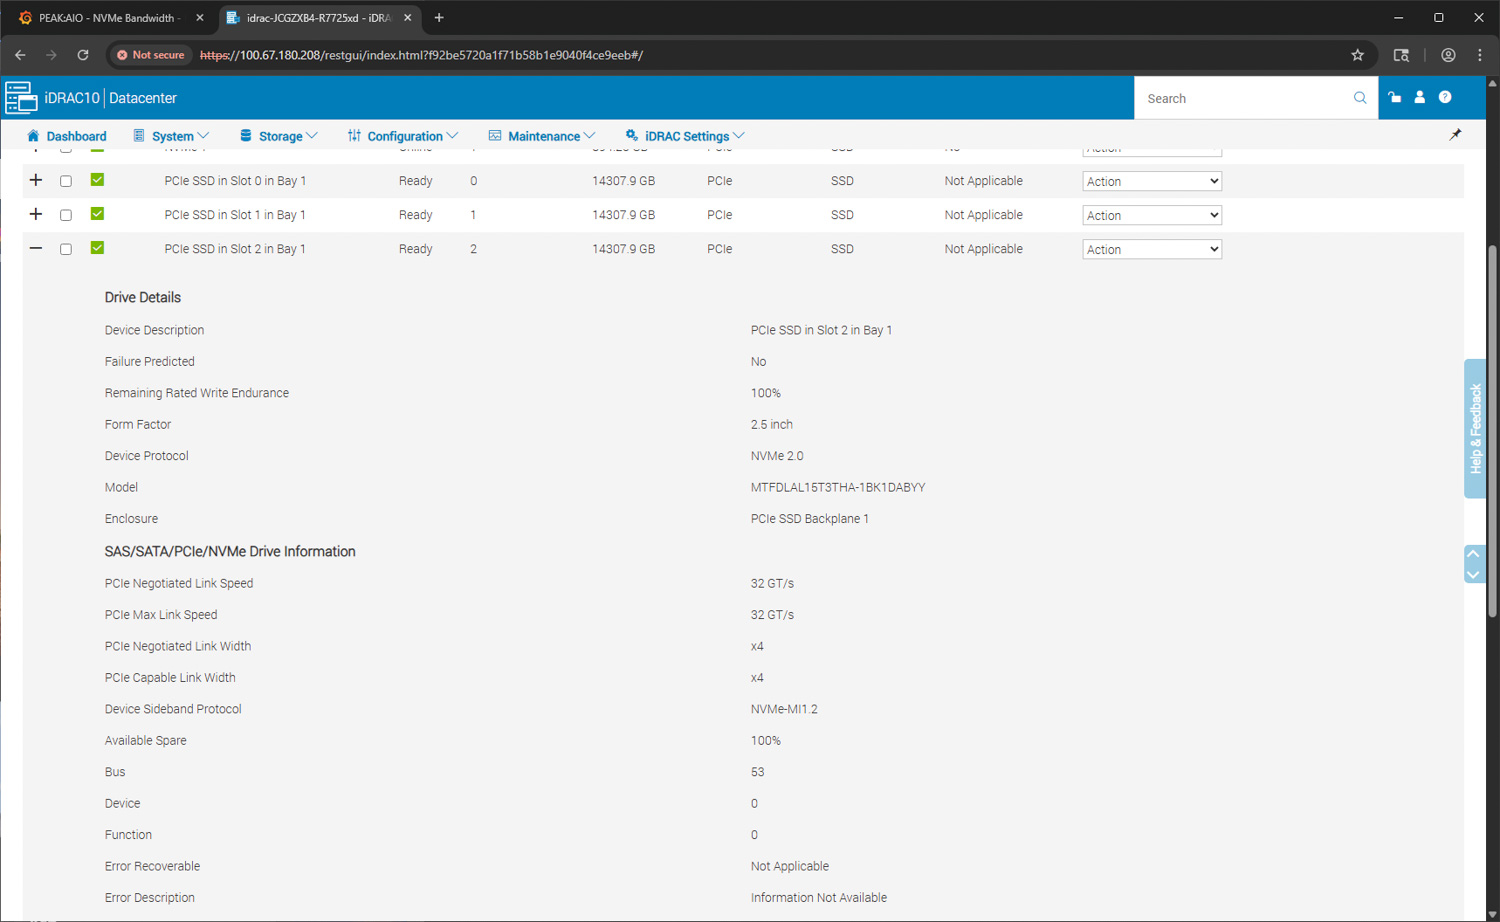
Insgesamt bietet die iDRAC 10-Schnittstelle eine klare, hardwareorientierte Sicht auf die NVMe-Speicherarchitektur des R7725xd und ermöglicht so eine einfache Überprüfung des Verbindungszustands, des Laufwerksstatus und der Systemintegrität auf einen Blick.
Dell PowerEdge R7725xd Leistung
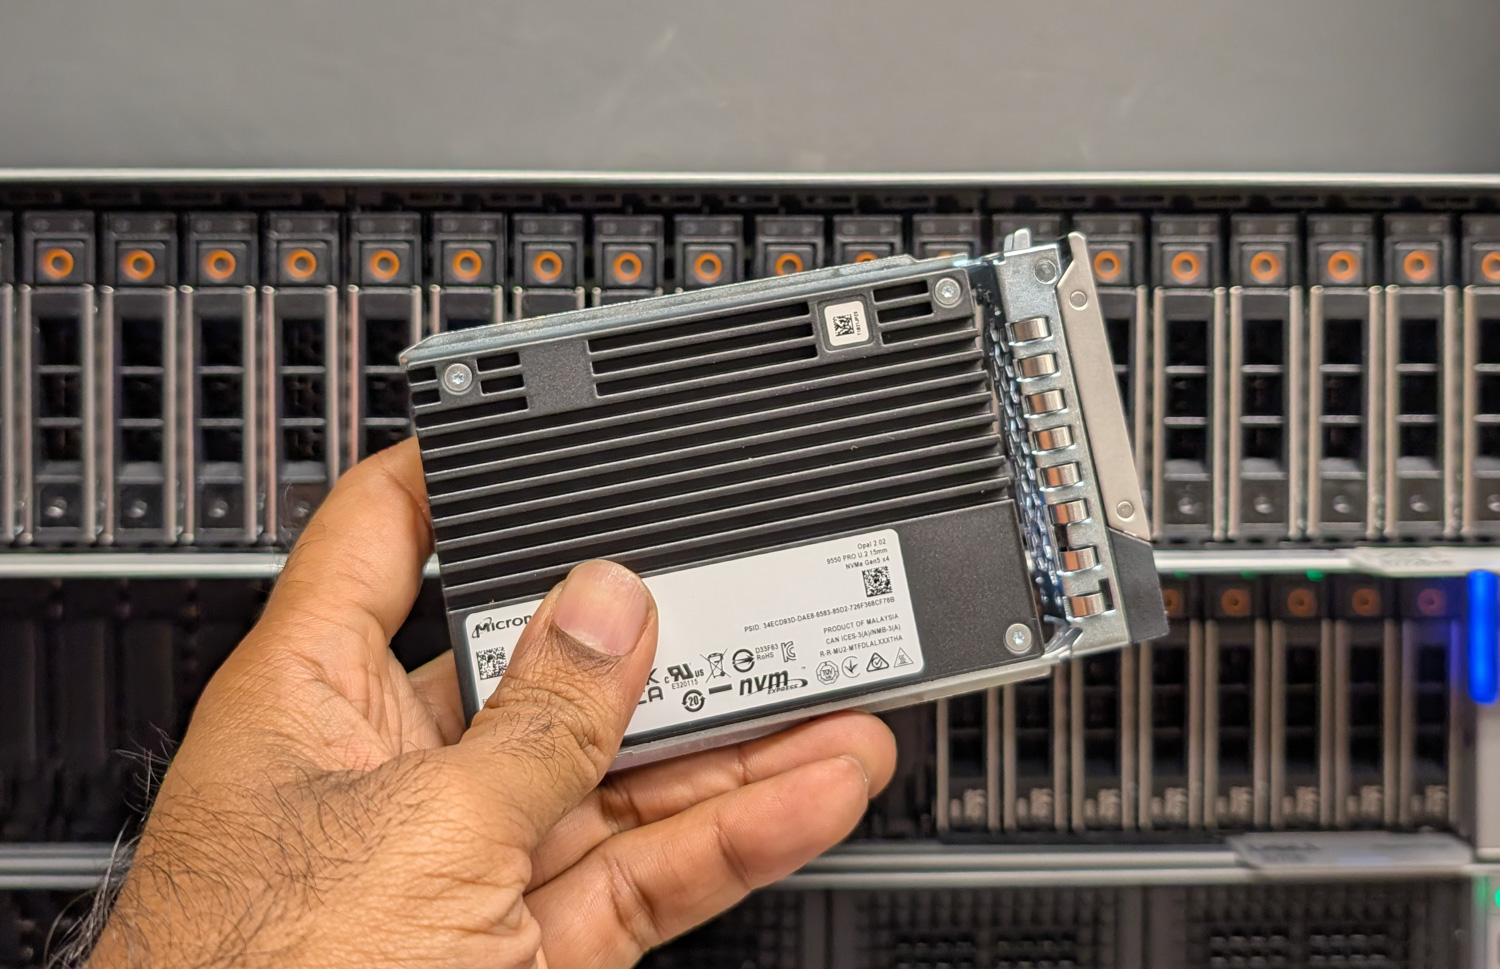
Vor den Tests wurde unser System mit einer ausgewogenen und dennoch leistungsstarken Konfiguration ausgestattet. Es verfügt über zwei AMD EPYC 9575F Prozessoren mit je 64 hochfrequenten Kernen und 24 DDR5-DIMMs mit je 32 GB und einer Übertragungsrate von 6400 MT/s. Für den Speicher sorgen 24 Micron 9550 PRO U.2 NVMe SSDs mit je 15.36 TB, die jeweils über eine dedizierte PCIe Gen5 x4-Verbindung angebunden sind. Dies ergibt eine Gesamtspeicherkapazität von 368.64 TB. Die Micron 9550 PRO SSDs erreichen sequentielle Lesegeschwindigkeiten von bis zu 14,000 MB/s und sequentielle Schreibgeschwindigkeiten von bis zu 10,000 MB/s. Die Netzwerkanbindung übernehmen vier Broadcom BCM57608 Adapter mit insgesamt acht 200-Gbit/s-Ports sowie eine BCM57412 OCP NIC mit zwei zusätzlichen 10-Gigabit-Ports.
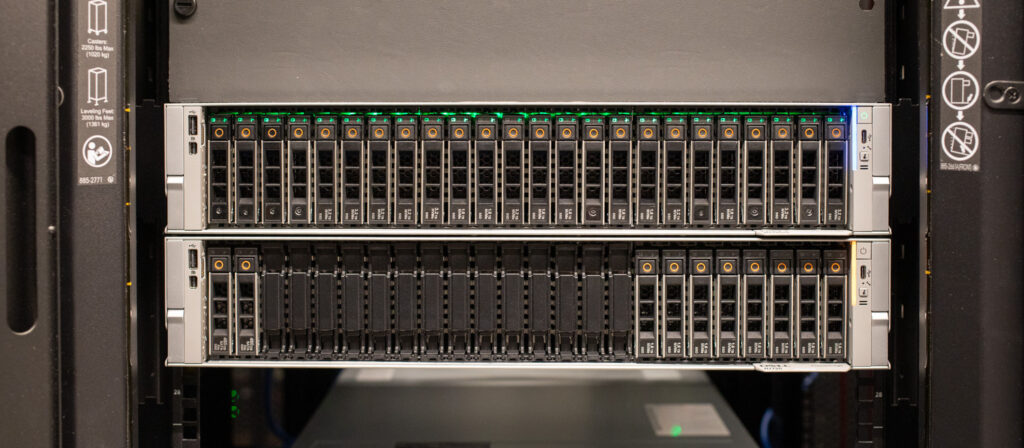
Spezifikationen des Testsystems
- ZENTRALPROZESSOR: 2x AMD EPYC 9575F 64-Kern-Hochfrequenzprozessoren
- Erinnerung: 24 x 32 GB DDR5 @ 6400 MT/s
- Lagerung: 24 Micron 9550 PRO U.2-Laufwerke mit je 15.36 TB (jeweils über 4 PCIe Gen5-Lanes angebunden); unterstützt aktuell Laufwerke mit bis zu 128 TB, höhere Kapazitäten sind in Planung.
- Netzwerk: 4x Broadcom BCM57608 2x200G NICs, 1x BCM57412 2x10Gb OCP NIC
- Schalter: Dell PowerSwitch Z9664
FIO-Leistungsbenchmark
Zur Messung der Speicherleistung des PowerEdge R7725xd verwendeten wir branchenübliche Metriken und das FIO-Tool. In diesem Abschnitt konzentrieren wir uns auf die folgenden FIO-Benchmarks:
- Zufällige 4K – 1M
- Sequenziell 4K – 1M
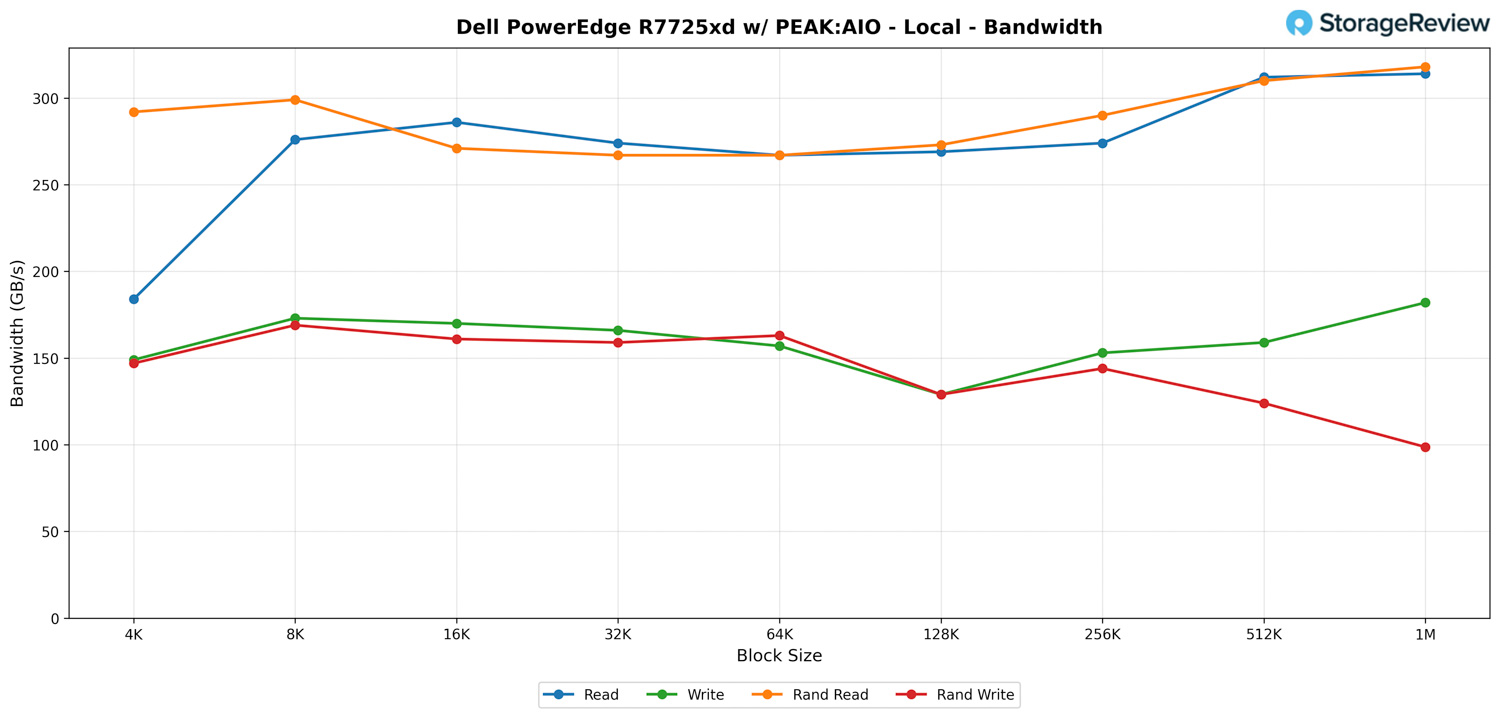
FIO – Lokal – Bandbreite
Beim Testen des lokalen Zugriffs auf die 24 PCIe Gen5 NVMe-Laufwerke im Dell PowerEdge R7725xd zeigt das System genau das, was man von einer Plattform erwarten würde, bei der jedes Laufwerk über eine vollständige x4-PCIe-Gen5-Verbindung mit den CPUs verbunden ist. Ohne Netzwerkverbindung wird hier der reine, interne Durchsatz des Dell Gen5-Speicherlayouts und die uneingeschränkte PCIe-Bandbreite der AMD EPYC-Plattform demonstriert.
Sequenzielle Lesevorgänge beginnen bei 184 GB/s mit 4-KB-Blöcken und skalieren mit zunehmender Blockgröße schnell. Von 512 KB bis 1 MB hält der Server konstant 312 bis 314 GB/s, was ein deutliches Indiz dafür ist, wie effizient das System alle 24 × 4 Gen5-Lanes zu einer dauerhaften Lesebandbreite bündeln kann, ohne dass es zu Engpässen auf Controller-Ebene kommt.
Sequenzielle Schreibvorgänge folgen einem anderen Verlauf, bleiben aber im erwarteten Bereich. Ausgehend von 149 GB/s steigen die Werte über 100 GB/s und erreichen bei 1 Million Schreibvorgängen 182 GB/s. Dies entspricht dem Schreibverhalten der Micron 9550 PRO SSDs und dem Overhead, der bei hochparallelen NVMe-Schreibvorgängen über so viele unabhängige Geräte entsteht.
Die Leistung beim zufälligen Lesen ist ein weiteres Highlight. Das System erreicht Geschwindigkeiten von fast 300 GB/s bei kleinsten Blockgrößen, sinkt im mittleren Bereich leicht ab und erreicht bei größeren Blockgrößen wieder Werte zwischen 200 und 300 GB/s. Bei 1 MB werden maximal 318 GB/s beim zufälligen Lesen erreicht, was die Fähigkeit der Plattform demonstriert, gemischte Operationen gleichmäßig auf alle 24 Laufwerke zu verteilen.
Zufällige Schreibvorgänge erfolgen mit einer geringeren Rate, was typisch für verteilte Metadaten- und Schreibzuweisungsaufgaben über ein breites NVMe-Netzwerk ist. Die Ergebnisse bleiben während des größten Teils des Tests im Bereich von 140 bis 160 GB/s und fallen bei 1 MB auf knapp unter 100 GB/s ab.
FIO – Lokal – IOPS
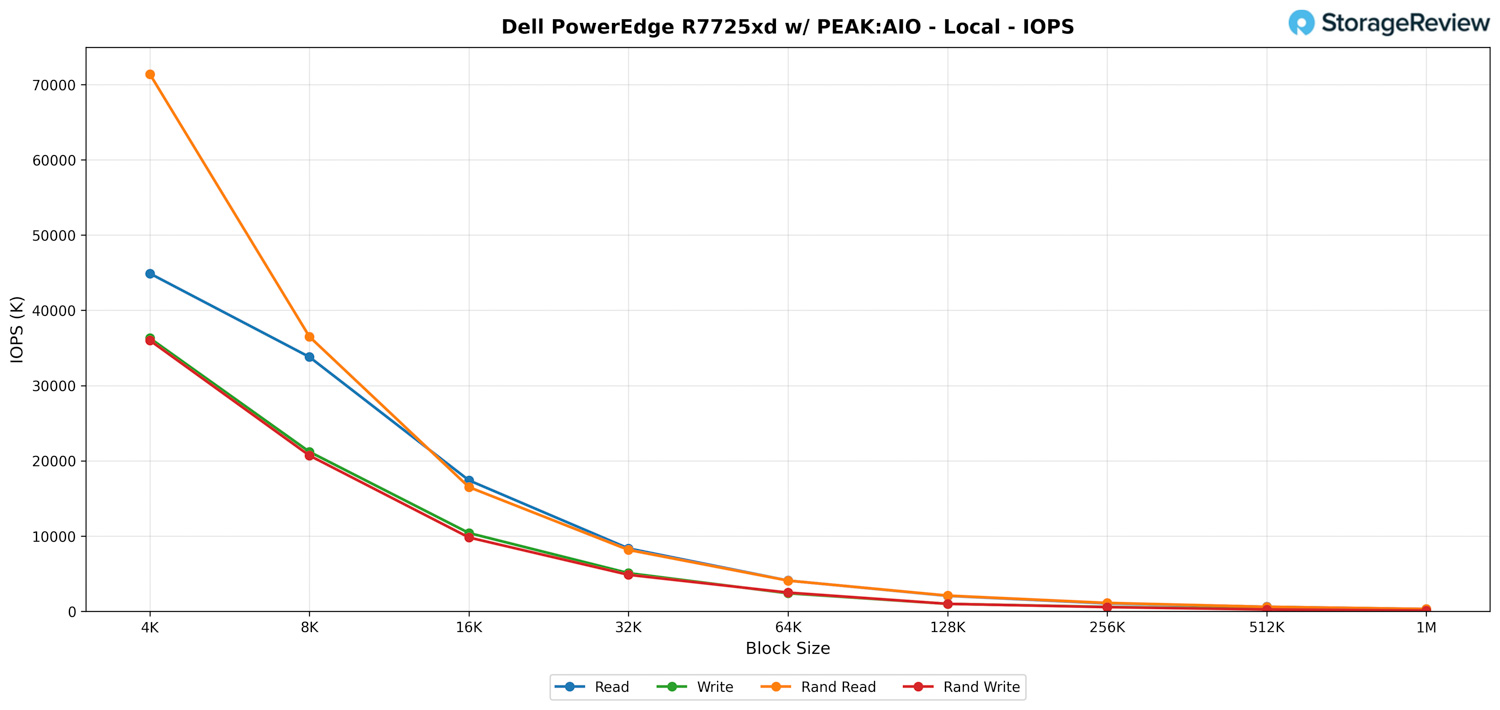
Bei Betrachtung der IOPS-Seite zeigt der R7725xd eine robuste Leistung bei kleinen Blöcken, wobei die Anforderungsraten weit in den zweistelligen Millionenbereich reichen, bevor größere Blockgrößen die Arbeitslast in Richtung eines bandbreitengetriebenen Profils verschieben.
Bei 4K erreichen die Lese-IOPS 44.9 Millionen und die Schreib-IOPS 36.3 Millionen. Zufällige Lesezugriffe erzielen sogar noch höhere Werte von 71.4 Millionen IOPS, was die Fähigkeit des Systems unterstreicht, rechenintensive Arbeitslasten effizient auf alle Laufwerke zu verteilen. Diese Werte sinken erwartungsgemäß mit zunehmender Blockgröße, der Verlauf bleibt jedoch über die Bereiche 8K, 16K und 32K hinweg konstant.
Bei 16K- und 32K-Blöcken pendeln sich die Lesezugriffe bei 17.4 Millionen bzw. 8.35 Millionen IOPS ein, während die zufälligen Lesezugriffe mit 16.5 Millionen bzw. 8.15 Millionen nahezu identische Werte erreichen. Die Schreibzugriffe folgen dem erwarteten Muster und bleiben sowohl bei sequenziellen als auch bei zufälligen Zugriffen stabil.
Bei Blockgrößen ab 64 KB verlagert sich der Test von reinen IOPS hin zu einem stärker bandbreitenbegrenzten Szenario. Die IOPS-Werte sinken in den niedrigen Millionenbereich und erreichen schließlich Hunderttausende. Bei einer Blockgröße von 1 MB liegen die Lese-IOPS bei etwa 300, die Schreib-IOPS bei etwa 174 und die IOPS für zufällige Operationen im selben Bereich.
Insgesamt zeigen die lokalen IOPS-Ergebnisse deutlich die Fähigkeit des Systems, sehr hohe Arbeitslasten mit hoher Warteschlangenlänge über kleine Blöcke hinweg zu bewältigen, wobei die Skalierung vorhersehbar ist, wenn die Übertragungen zunehmen und die Bandbreite zum dominierenden Faktor wird.
PEAK:AIO: Warum der Dell PowerEdge R7725xd für diese Arbeitslast geeignet ist
PEAK:AIO wurde für Umgebungen entwickelt, die extrem schnellen Zugriff mit geringer Latenz auf große Datensätze erfordern, typischerweise für KI-Training, Inferenzpipelines, Finanzmodellierung und Echtzeitanalysen. Die Plattform profitiert von dichtem NVMe-Speicher, ausgewogener PCIe-Bandbreite und vorhersehbarer Latenz auch bei hoher Skalierbarkeit. Um diese Anforderungen zu erfüllen, muss die zugrunde liegende Hardware einen dauerhaften Durchsatz gewährleisten und gleichzeitig unter hoher Last eine konsistente und reproduzierbare Leistung sicherstellen.
Hier harmoniert der Dell PowerEdge R7725xd perfekt mit PEAK:AIO. Die Systemarchitektur ist darauf ausgelegt, die PCIe-Gen5-Ressourcen optimal zu nutzen und die volle Bandbreite der 24 frontseitigen U.2-NVMe-Einschübe direkt den CPUs zur Verfügung zu stellen, ohne auf herkömmliche RAID-Controller angewiesen zu sein. Dieses Layout ermöglicht PEAK:AIO die Parallelität und das Latenzprofil, die es von modernen NVMe-basierten Datenpipelines erwartet. Die NVMe-SSDs wurden in zwei RAID-0-Gruppen aufgeteilt.
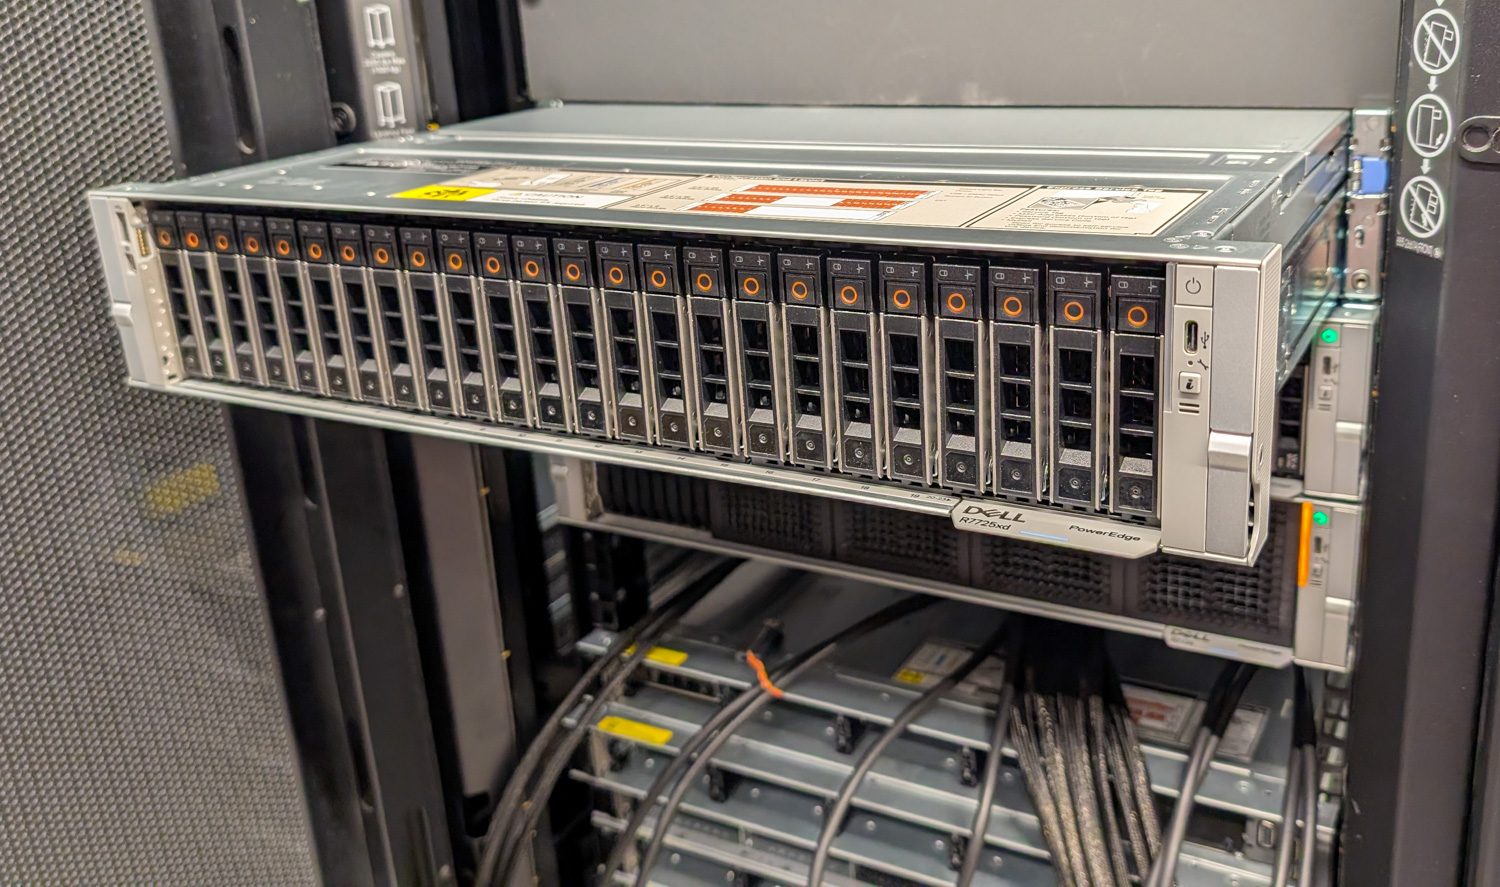
Im getesteten Szenario verwendeten wir zwei Client-Systeme, die jeweils mit zwei Broadcom BCM57608 2x 200G-Netzwerkkarten ausgestattet waren und an den R7725xd angeschlossen waren. Dadurch entstanden insgesamt vier 200G-Uplinks pro Client, wodurch der R7725xd in eine realistische Hochleistungskonfiguration versetzt wurde, die der in PEAK:AIO-Produktionsumgebungen üblichen Konfiguration entspricht. Diese hohe Netzwerkbandbreite bot uns ausreichend Spielraum, um das NVMe-Subsystem, die PCIe-Topologie und die CPU-Verbindungen voll auszulasten, ohne dass es auf der Netzwerkkartenebene zu Engpässen kam.
Das Ergebnis ist eine Plattform, die optimal auf die Workloads von PEAK:AIO abgestimmt ist. Die R7725xd bietet hohe NVMe-Speicherkapazität, PCIe-Gen5-Durchsatz, zwei AMD EPYC 9005-Prozessoren für Parallelverarbeitung und die Netzwerkfähigkeit, um die Datenaufnahme mehrerer Clients mit mehreren hundert Gigabit pro Client zu gewährleisten. All diese Eigenschaften sind grundlegend für die Erfüllung der Leistungsanforderungen von PEAK:AIO.
PEAK:AIO – NVMe-oF RDMA – Bandbreite
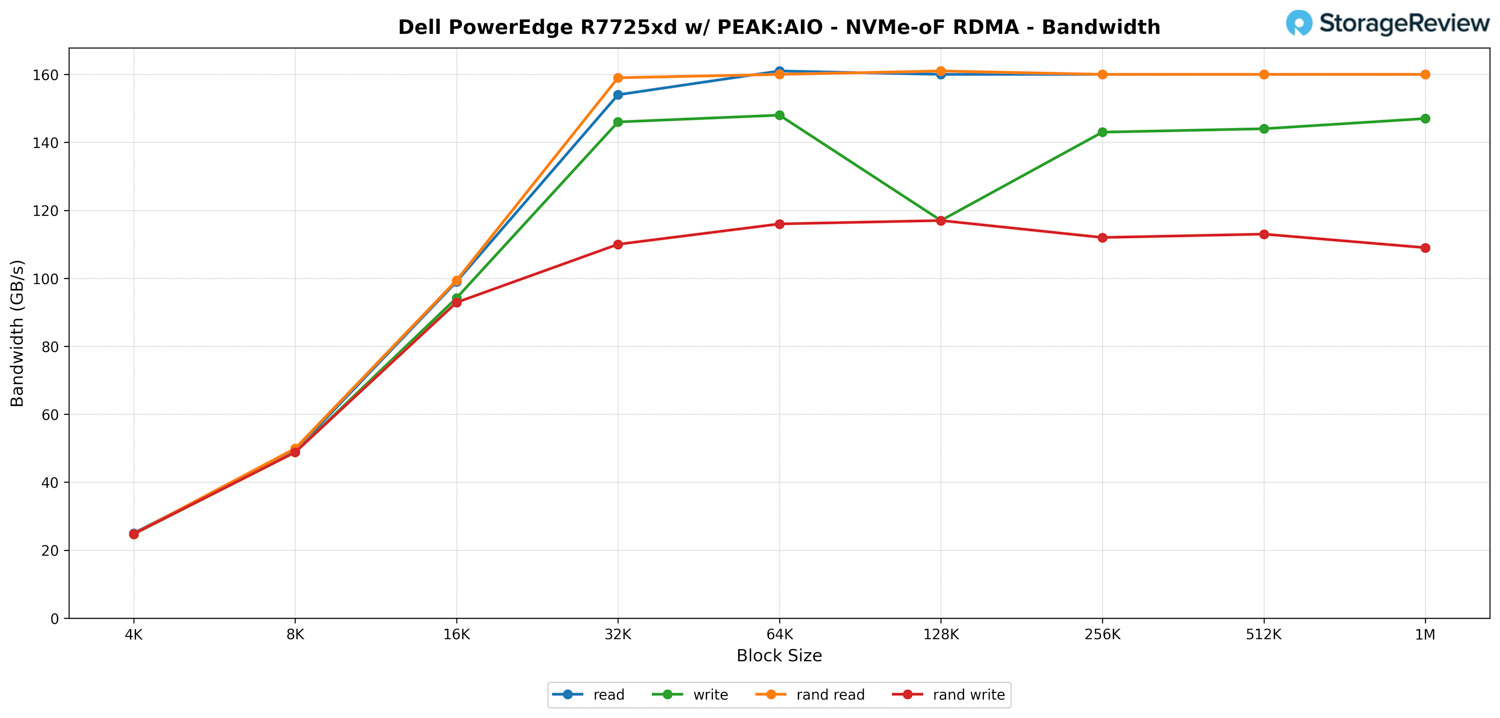
Die Untersuchung der NVMe-oF-RDMA-Bandbreite auf dem PowerEdge R7725xd mit PEAK:AIO zeigt genau den erwarteten Trend für ein System mit dieser PCIe- und Netzwerkbandbreite. Mit zunehmender Blockgröße steigt der Durchsatz rapide an, bis er sich nahe der praktischen Leistungsgrenze der Plattform einpendelt.
Bei kleinen Blockgrößen beginnt die Leistung sowohl beim Lesen als auch beim Schreiben im Bereich von etwa 20 GB/s. Dies ist normal, da 4K- und 8K-Übertragungen den IOPS-Pfad deutlich stärker belasten als den Durchsatzpfad. Sobald wir zu 16K- und 32K-Blöcken übergehen, steigt die Leistung deutlich an. Die Lesegeschwindigkeit erreicht bei 32K-Blöcken etwa 154 GB/s und klettert weiter auf etwa 160 GB/s. Dies entspricht genau dem erwarteten Wert für ein Dual-Client-Setup über vier 200-Gbit/s-Verbindungen.
Die Leistung beim zufälligen Lesen entspricht nahezu perfekt der sequenziellen Leseleistung. PEAK:AIO sorgt für eine effiziente Auslastung der Befehlswarteschlangen, sodass die Bandbreite beim zufälligen Lesen im Wesentlichen der Bandbreite beim sequenziellen Lesen über den gesamten Bereich folgt und sich bei etwa 159 bis 161 GB/s von 32 KB bis 1 MB einpendelt. Dies deutet darauf hin, dass der Speicherstapel bei gemischten Zugriffsmustern keinen Flaschenhals darstellt und die PCIe-Topologie des R7725xd die Last gleichmäßig auf die 24 NVMe-Gen5-Laufwerke verteilt.
Die Schreibleistung verläuft ähnlich, erreicht aber einen etwas niedrigeren Maximalwert als die Leseleistung. Sequenzielle Schreibvorgänge bleiben bei mittleren Blockgrößen im Bereich von 140 bis 148 GB/s, fallen bei 128 KB auf etwa 117 GB/s ab, erholen sich aber mit zunehmender Blockgröße wieder. Zufällige Schreibvorgänge verhalten sich anders und pendeln sich bei etwa 110–117 GB/s ein, was für Workloads mit gemischten Warteschlangen, die zusätzlichen Overhead verursachen, normal ist.
Die wichtigste Erkenntnis aus diesem Abschnitt ist, dass die R7725xd selbst bei mehreren Clients, die das System an seine Grenzen bringen, problemlos extrem hohe Bandbreiten über NVMe-oF bereitstellt. Sobald die Blockgröße 32 KB oder mehr erreicht, nutzt der Server seine verfügbare Netzwerk- und Speicherbandbreite konstant voll aus. Genau diese Art von Leistung soll PEAK:AIO erzielen, wodurch diese Ergebnisse die Skalierbarkeit der Plattform unter realen Bedingungen eindrucksvoll bestätigen.
PEAK AIO – NVMe-oF RDMA IOPS
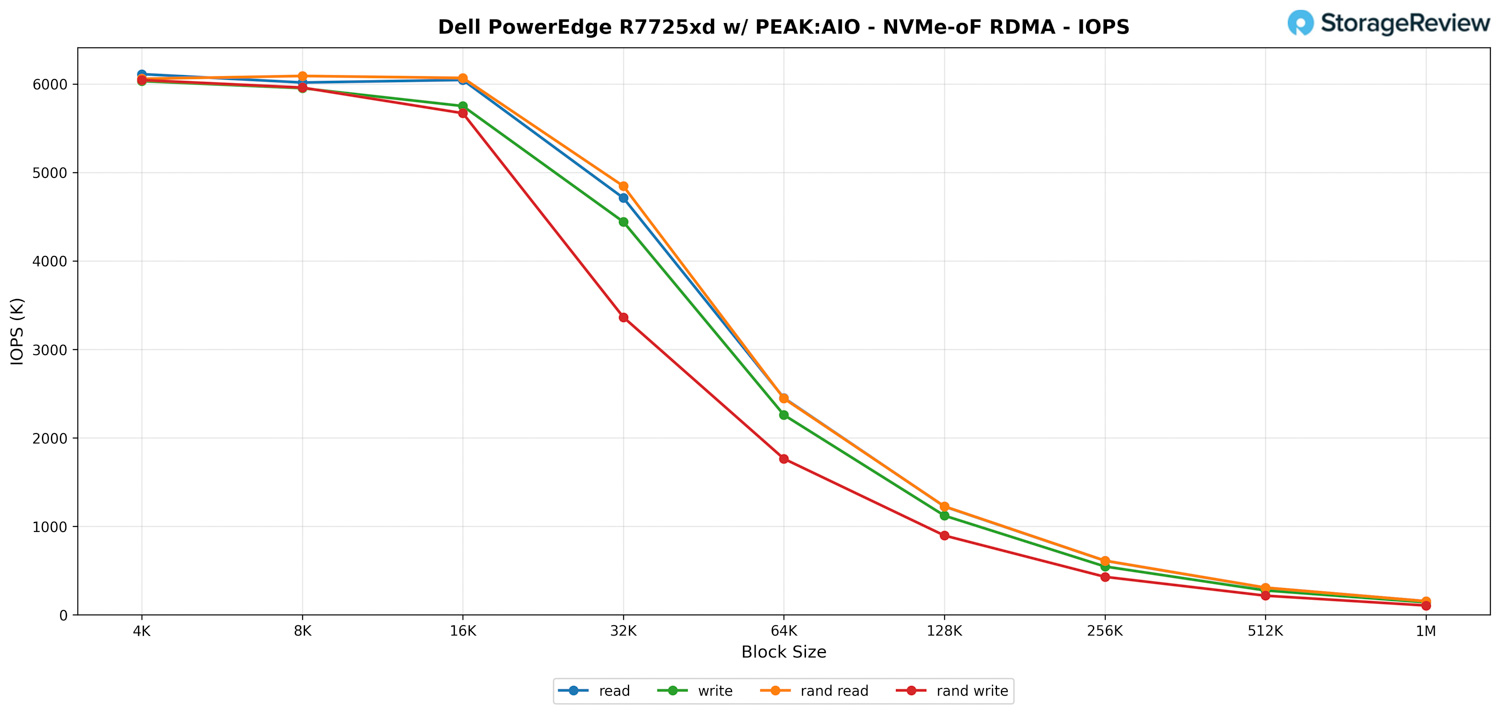
Hinsichtlich der IOPS zeigt der PowerEdge R7725xd eine starke Leistung bei kleinen Blöcken, obwohl wir anfänglich niedrigere Werte als erwartet beobachtet haben. Dieses Problem dürfte sich zukünftig durch verbesserte Netzwerktreiberunterstützung beheben lassen. Selbst unter Berücksichtigung dieser Tatsache verhält sich die Skalierung bei zunehmender Blockgröße genau wie bei NVMe-oF RDMA.
Bei der kleinsten Blockgröße erreicht das System über 6 Millionen IOPS sowohl bei sequenziellen als auch bei zufälligen Arbeitslasten. Lese-, Schreib-, zufällige Lese- und Schreibraten liegen bei 4K und 8K in etwa im gleichen Bereich, was darauf hindeutet, dass die Frontend-Clients, die PCIe-Infrastruktur und die NVMe-Laufwerke selbst die Anforderungsrate problemlos bewältigen können.
Mit zunehmender Blockgröße sinkt die IOPS-Rate erwartungsgemäß. Bei 32 KB liegt die Leserate bei etwa 4.7 Millionen IOPS, während die Schreibrate mit rund 4.4 Millionen etwas niedriger liegt. Am stärksten betroffen sind zufällige Schreibvorgänge, die auf etwa 3.3 Millionen IOPS fallen. Dies entspricht dem zusätzlichen Warteschlangen- und CPU-Overhead, der durch gemischte Zugriffsmuster entsteht.
Bei größeren Blöcken nimmt die IOPS-Rate erwartungsgemäß linear ab. Ab 256K- und 512K-Übertragungen wird der Durchsatz zum dominierenden Kriterium, und die IOPS-Rate sinkt erwartungsgemäß auf einige Hunderttausend. Bei einer Blockgröße von 1 MB konvergieren alle Workloads auf 140–153 IOPS, was mit den Bandbreitenwerten aus dem vorherigen Abschnitt übereinstimmt.
GPUDirect-Speicherleistung
Einer der Tests, die wir mit der R7725xd durchgeführt haben, war der Magnum IO GPUDirect Storage (GDS)-Test. GDS ist eine von NVIDIA entwickelte Funktion, die es GPUs ermöglicht, die CPU beim Zugriff auf Daten auf NVMe-Laufwerken oder anderen Hochgeschwindigkeitsspeichern zu umgehen. Anstatt Daten über die CPU und den Arbeitsspeicher zu leiten, ermöglicht GDS die direkte Kommunikation zwischen GPU und Speichermedium, wodurch die Latenz deutlich reduziert und der Datendurchsatz verbessert wird.
So funktioniert GPUDirect-Speicher
Traditionell müssen Daten, die auf einem NVMe-Laufwerk gespeichert sind, zunächst die CPU und den Arbeitsspeicher durchlaufen, bevor sie die GPU erreichen. Dieser Prozess führt zu Engpässen, da die CPU als Vermittler fungiert, was Latenzzeiten verursacht und wertvolle Systemressourcen verbraucht. GPUDirect Storage beseitigt diese Ineffizienz, indem es der GPU ermöglicht, über den PCIe-Bus direkt auf die Daten des Speichermediums zuzugreifen. Dieser direkte Pfad reduziert den Aufwand für die Datenübertragung und ermöglicht so schnellere und effizientere Datenübertragungen.
KI-Workloads, insbesondere solche mit Deep Learning, sind äußerst datenintensiv. Das Training großer neuronaler Netzwerke erfordert die Verarbeitung von Terabytes an Daten, und jede Verzögerung bei der Datenübertragung kann zu einer Unterauslastung der GPUs und längeren Trainingszeiten führen. GPUDirect Storage bewältigt diese Herausforderung, indem es sicherstellt, dass die Daten so schnell wie möglich an die GPU übermittelt werden, wodurch Leerlaufzeiten minimiert und die Recheneffizienz maximiert werden.
Darüber hinaus ist GDS besonders vorteilhaft für Workloads, die das Streamen großer Datensätze beinhalten, wie etwa Videoverarbeitung, Verarbeitung natürlicher Sprache oder Echtzeit-Inferenz. Durch die Reduzierung der Abhängigkeit von der CPU beschleunigt GDS die Datenbewegung und gibt CPU-Ressourcen für andere Aufgaben frei, was die Gesamtsystemleistung weiter verbessert.
Neben der reinen Bandbreite bietet GPUDirect mit NVMe-oF (TCP/RDMA) auch I/O mit extrem niedriger Latenz. Dadurch wird sichergestellt, dass den GPUs nie die Daten ausgehen, was das System ideal für KI-Inferenzen in Echtzeit, Analyse-Pipelines und Videowiedergabe macht.
GDSIO-Lesen (sequenziell)
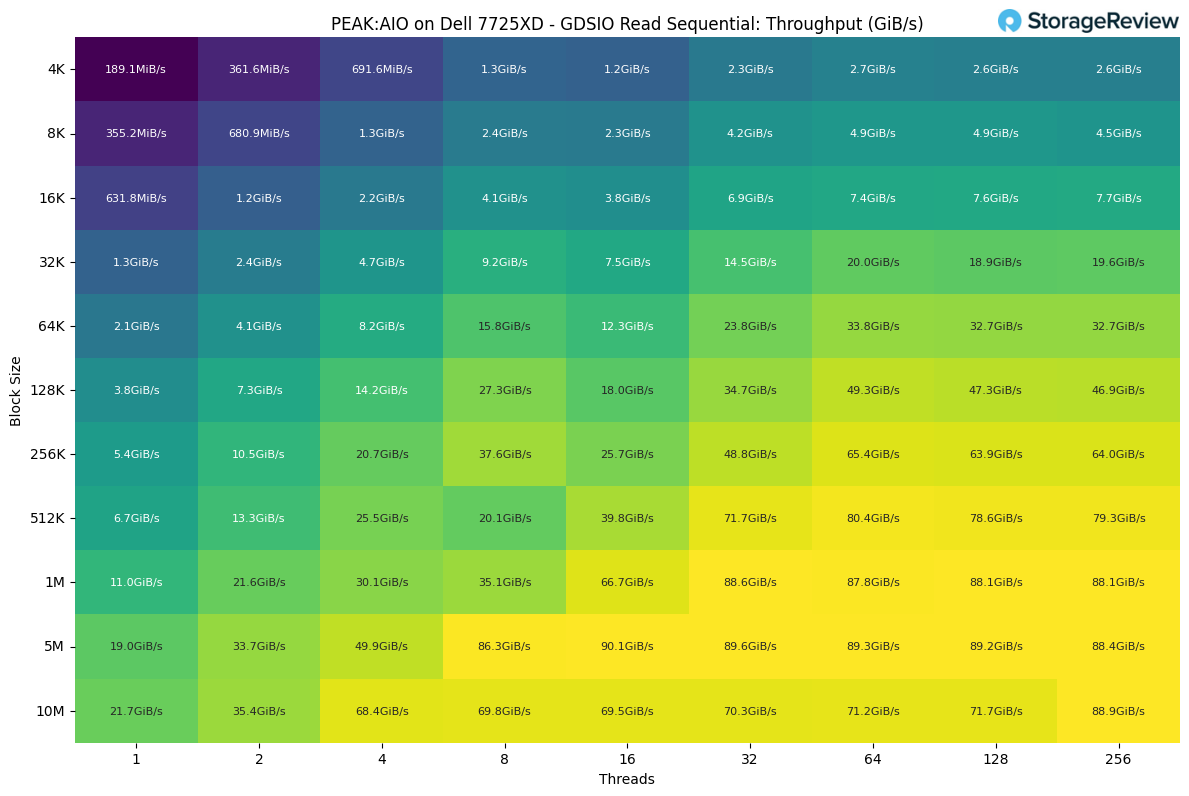
Bei der Untersuchung von PEAK:AIO mit einem Client, der GDSIO verwendet, zeigt der Lesedurchsatz ein deutliches Skalierungsmuster mit zunehmender Blockgröße und Threadanzahl. Dieser einzelne Client war über zwei 400G-Verbindungen angebunden, wodurch sein Gesamtpotenzial auf 90 GB/s begrenzt war.
Bei kleinsten Blockgrößen und geringer Threadanzahl ist die Leistung bescheiden: 4K-Lesezugriffe erreichen mit einem einzelnen Thread etwa 189 MiB/s. Sobald wir die Threadparallelität erhöhen, reagiert das System sofort und erzielt 691 MiB/s mit vier Threads. Bei größeren Blöcken knackt es sogar den Multi-GiB/s-Bereich.
Die mittleren Blockgrößen zeigen die stärkste Abhängigkeit von der Threadanzahl. Bei 32 KB steigt der Durchsatz von 1.3 GiB/s bei einem einzelnen Thread auf fast 20 GiB/s bei 64 Threads, mit nur geringfügigem Abfall darüber hinaus. Ein ähnliches Muster zeigt sich bei 64 KB und 128 KB, wo das System von niedrigen einstelligen GiB/s-Werten bei geringer Parallelität auf über 30 GiB/s mit zunehmender Arbeitslast ansteigt.
Bei größeren Blockgrößen flacht der Durchsatz ab, da das System seine Leistungsgrenze für einen einzelnen Client erreicht. Bei 1 MiB steigt die Leistung von 11 GiB/s mit einem Thread auf etwa 88 GiB/s bei hoher Threadanzahl. Die Übertragungen von 5 MiB und 10 MiB zeigen dasselbe Plateau und erreichen unabhängig von der Threadanzahl (64, 128 oder 256) maximal etwa 89–90 GiB/s.
GDSIO-Schreiben (sequenziell)
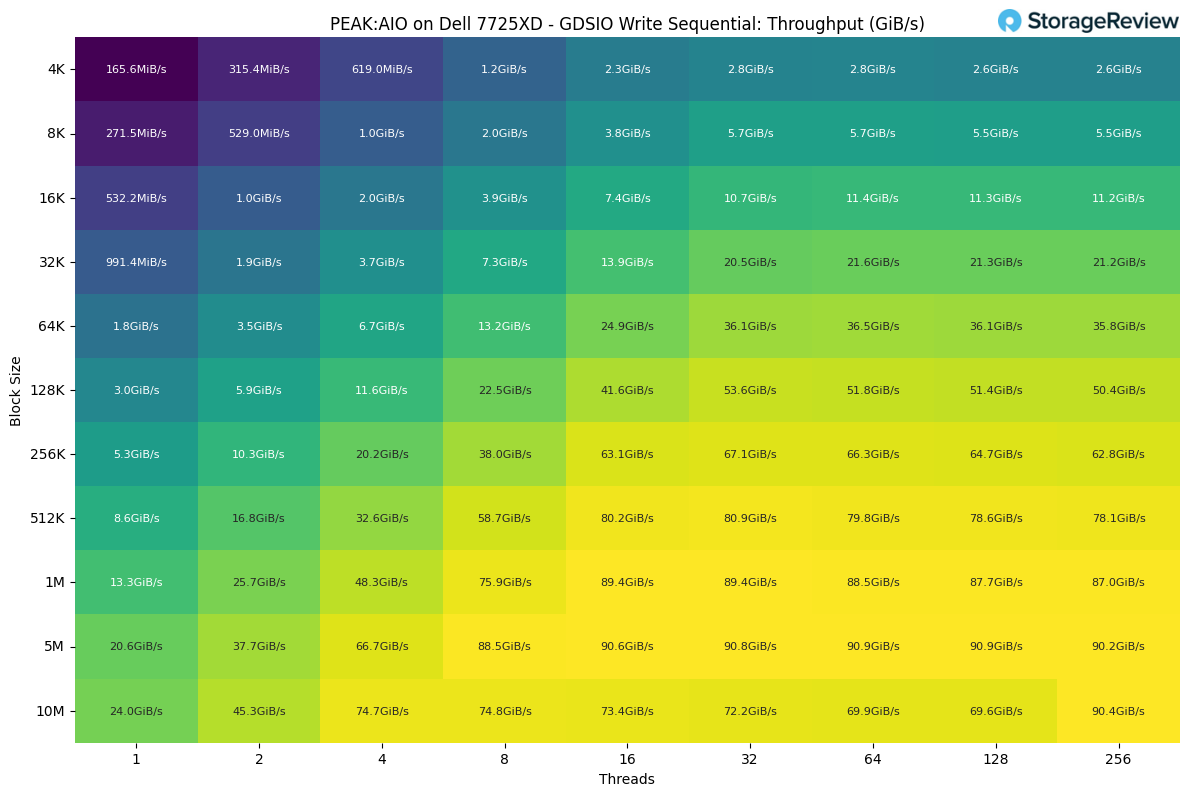
Beim Schreiben verläuft das Skalierungsverhalten ähnlich wie beim Lesen, allerdings mit etwas geringerer Leistung über die meisten Blockgrößen hinweg, was bei sequenziellen Schreibvorgängen zu erwarten ist. Bei den kleinsten Blockgrößen beginnt der Durchsatz bei 165 MiB/s für einen einzelnen Thread bei 4 KB und steigt mit zunehmender Parallelität stetig an. Bei vier Threads erreicht er etwas über 619 MiB/s, bevor er bei acht Threads die 1-GiB/s-Marke überschreitet.
Mittlere Blockgrößen zeigen mit steigender Threadanzahl deutlichere Leistungssteigerungen. Bei 32 KB beginnt der Durchsatz bei knapp 1 GiB/s und skaliert bei höheren Threadzahlen auf über 21 GiB/s. Die Bereiche 64 KB und 128 KB setzen diesen Trend fort und erreichen Durchsatzraten von wenigen GiB/s im niedrigen einstelligen Bereich auf Mitte 30 GiB/s bzw. 50 GiB/s, wenn die Arbeitslast parallelisiert wird.
Bei größeren Übertragungsraten pendelt sich das System an seine natürliche maximale Schreibgeschwindigkeit ein. Bei 1 MiB steigt die Leistung von 13.3 GiB/s mit einem einzelnen Thread auf knapp 90 GiB/s bei hoher Threadanzahl. Die Tests mit 5 MiB und 10 MiB zeigen ein ähnliches Muster: Die Ergebnisse erreichen unabhängig von der Threadanzahl (64, 128 oder 256) einen Spitzenwert von etwa 90 GiB/s.
Leistung neu definiert in der Gen5-Ära
Der Dell PowerEdge R7725xd ist mehr als nur ein Speicherserver; er markiert einen Wendepunkt in der Bandbreitenbereitstellung innerhalb des Racks. Durch den Verzicht auf PCIe-Switches und die direkte Anbindung jeder NVMe-SSD an die CPU hat Dell ein System geschaffen, dessen Durchsatz sich nahtlos skalieren lässt, dessen Wärmeentwicklung vorhersehbar bleibt und dessen gleichzeitige Nutzung zum Vorteil statt zur Herausforderung wird.
In Kombination mit Microns 9550 PRO SSDs und der parallelen I/O-Software PEAK:AIO verwandelt sich die R7725xd von einem kompakten NVMe-Gehäuse in eine echte Datenmaschine. Sie kann ihre lokale PCIe-Schnittstelle voll auslasten, GPUs über RDMA mit Leitungsgeschwindigkeit ansteuern oder gleichzeitig als Rechen- und Speichereinheit fungieren – alles innerhalb eines 2U-Gehäuses.
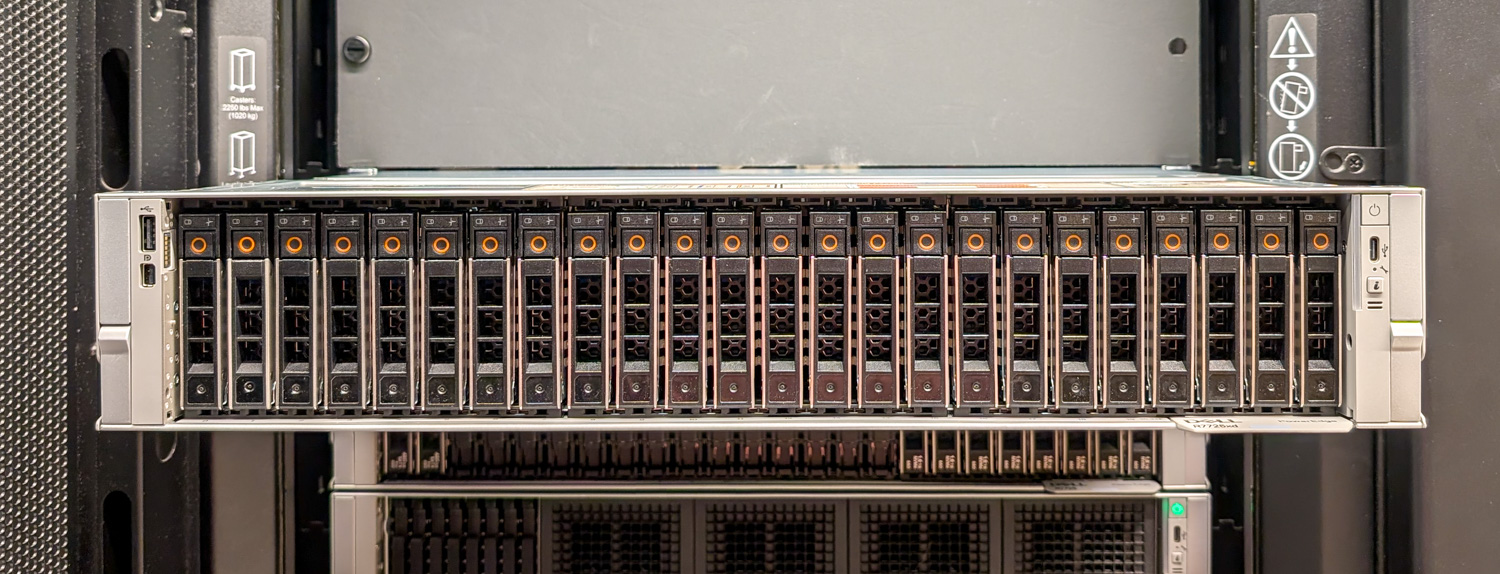
Dell PowerEdge R7225xd
In der Praxis liefert diese Konfiguration einen lokalen Durchsatz von über 300 GB/s und 160 GB/s über das Netzwerk und erreicht damit eine Leistung, die mit der von Multi-Node-Speicherclustern vergleichbar ist – bei einem Bruchteil der Komplexität und Kosten. Sie demonstriert eindrucksvoll, was passiert, wenn alle Ebenen des Systems, von der Hardware bis zur Software, auf Effizienz und dauerhafte Bandbreite ausgerichtet sind.
Der R7725xd setzt neue Maßstäbe für die Speicherleistung einzelner Knoten im Gen5-Zeitalter. Für Unternehmen, die KI-Pipelines der nächsten Generation, Hochgeschwindigkeitsanalysen oder Trainingsumgebungen mit vielen Checkpoints entwickeln, bietet er einen Einblick in das Potenzial, das sich durch die vollständige Beseitigung von Engpässen im System ergibt.
Dieser Bericht wird von Dell Technologies gesponsert. Alle in diesem Bericht geäußerten Ansichten und Meinungen basieren auf unserer unvoreingenommenen Sicht auf das/die betrachtete(n) Produkt(e).


 Amazon