

Hammerspace ha transformado su plataforma de datos definida por software en el sistema de datos Hammerspace y, por primera vez, lo comercializará como un sistema completo con hardware. El componente central es la plataforma de memoria flash abierta (OFP) de Hammerspace, una bandeja de 1U que aloja cinco nodos flash basados en DPU sin servidor de almacenamiento x86. La compañía ofrece velocidades de escritura de 390 GB/s, 15 millones de IOPS por unidad de rack y hasta 9.83 PB de capacidad bruta. El lanzamiento también incorpora una capa de inteligencia de datos y una caché KV para NVMe local de GPU. La OFP ya está disponible para cotización y se lanzará en la primera mitad de 2027.
De la plataforma de datos al sistema de datos
El producto principal de Hammerspace es un sistema de archivos global paralelo que separa los metadatos de la ruta de datos y presenta el almacenamiento NAS, de objetos y en la nube existente como un único espacio de nombres a través de pNFS, NFS, SMB y S3. Los clientes acceden a él mediante el cliente NFSv4.2 integrado en las distribuciones estándar de Linux, sin agente propietario, utilizando el diseño de archivos Flex que, según Hammerspace, diseñó para la especificación NFS. La compañía describe el Sistema de Datos como una extensión de ese software, organizado en torno a cinco capacidades: unificación de datos, inteligencia, orquestación, aceleración y almacenamiento, de las cuales la inteligencia y el almacenamiento son nuevas.
El cambio comercial radica en que ahora se puede adquirir el sistema completo de Hammerspace, con el software, los nodos de metadatos y el almacenamiento instalados y con soporte de la empresa. Los nodos de metadatos, que Hammerspace denomina Anvils, son servidores x86 de 1U en configuraciones M-Series estándar y grandes, con dos puertos de datos de 100 GbE, implementados como un par de alta disponibilidad en cada sitio para ejecutar el plano de control que gestiona el espacio de nombres y aplica las políticas de ubicación. La implementación de software en hardware del cliente continúa, al igual que los Hammerspace Ready Nodes de Dell, Supermicro y Hitachi Vantara, y las imágenes disponibles en AWS, Azure, Google Cloud y Oracle Cloud.
La opción del sistema responde a un patrón que Hammerspace ha observado en sus ventas: el software superó la evaluación técnica, pero el cliente optó por un producto integrado de otro proveedor para simplificar la compra. El software se licencia mediante una suscripción cuyo precio se basa en la capacidad gestionada. El almacenamiento de Hammerspace se suele implementar cuando un nuevo clúster de GPU requiere almacenamiento de alto rendimiento, mientras que los datos existentes del cliente se encuentran en sistemas NetApp, PowerScale o de objetos que el espacio de nombres puede gestionar.
Cada clúster de sitio combina esos Anvils con un conjunto de nodos de servicios de datos, y los clústeres se unen en un sistema de archivos global. Los metadatos se replican continuamente entre sitios, con un retraso de aproximadamente un segundo entre ubicaciones distantes, mientras que los datos en sí solo se mueven cuando una política o una solicitud de acceso lo requiere. Los planificadores de tareas pueden iniciar ese movimiento a través de la API y los conectores nativos. La empresa puso como ejemplo a clientes del sector de las ciencias biológicas que ingieren datos de instrumentos a través de SMB, los procesan a través de pNFS y los distribuyen a través de S3 desde el mismo sistema.
Las evaluaciones suelen ejecutarse como prueba de concepto, utilizando imágenes en la nube con licencia propia como método de autoservicio. La capacidad de disco proviene de JBOD y servidores de almacenamiento fabricados por proveedores de discos duros; OFP es un diseño de Hammerspace fabricado por un proveedor externo, y los sistemas son distribuidos por revendedores e integradores. Un arreglo de bloques se une al espacio de nombres solo cuando puede montarse mediante NFS.
«Añadir más almacenamiento no es la solución», afirmó David Flynn, fundador y director ejecutivo de Hammerspace. Flynn describió el lanzamiento como una forma de aplicar a los datos la consolidación que los diseños de fábricas de IA aportaron a la computación.
Dentro de la plataforma Open Flash
Cada módulo OFP es un nodo de almacenamiento completo, con un ancho equivalente a una quinta parte de una unidad de rack, ocho SSD NVMe U.2 o U.3 en dos paquetes extraíbles de cuatro unidades, dos puertos QSFP-DD de 400 GbE y una DPU Arm de 64 núcleos en lugar de una placa base x86. La DPU es la Xsight Labs E1, que Xsight fabrica con el proceso de 5 nm de TSMC, con 64 núcleos Arm Neoverse N2, dos MAC de 400 Gb, PCIe Gen5 y un consumo típico de 70 W. Ejecuta Linux estándar y cada módulo aparece en el sistema de archivos Hammerspace como un servidor NFS.
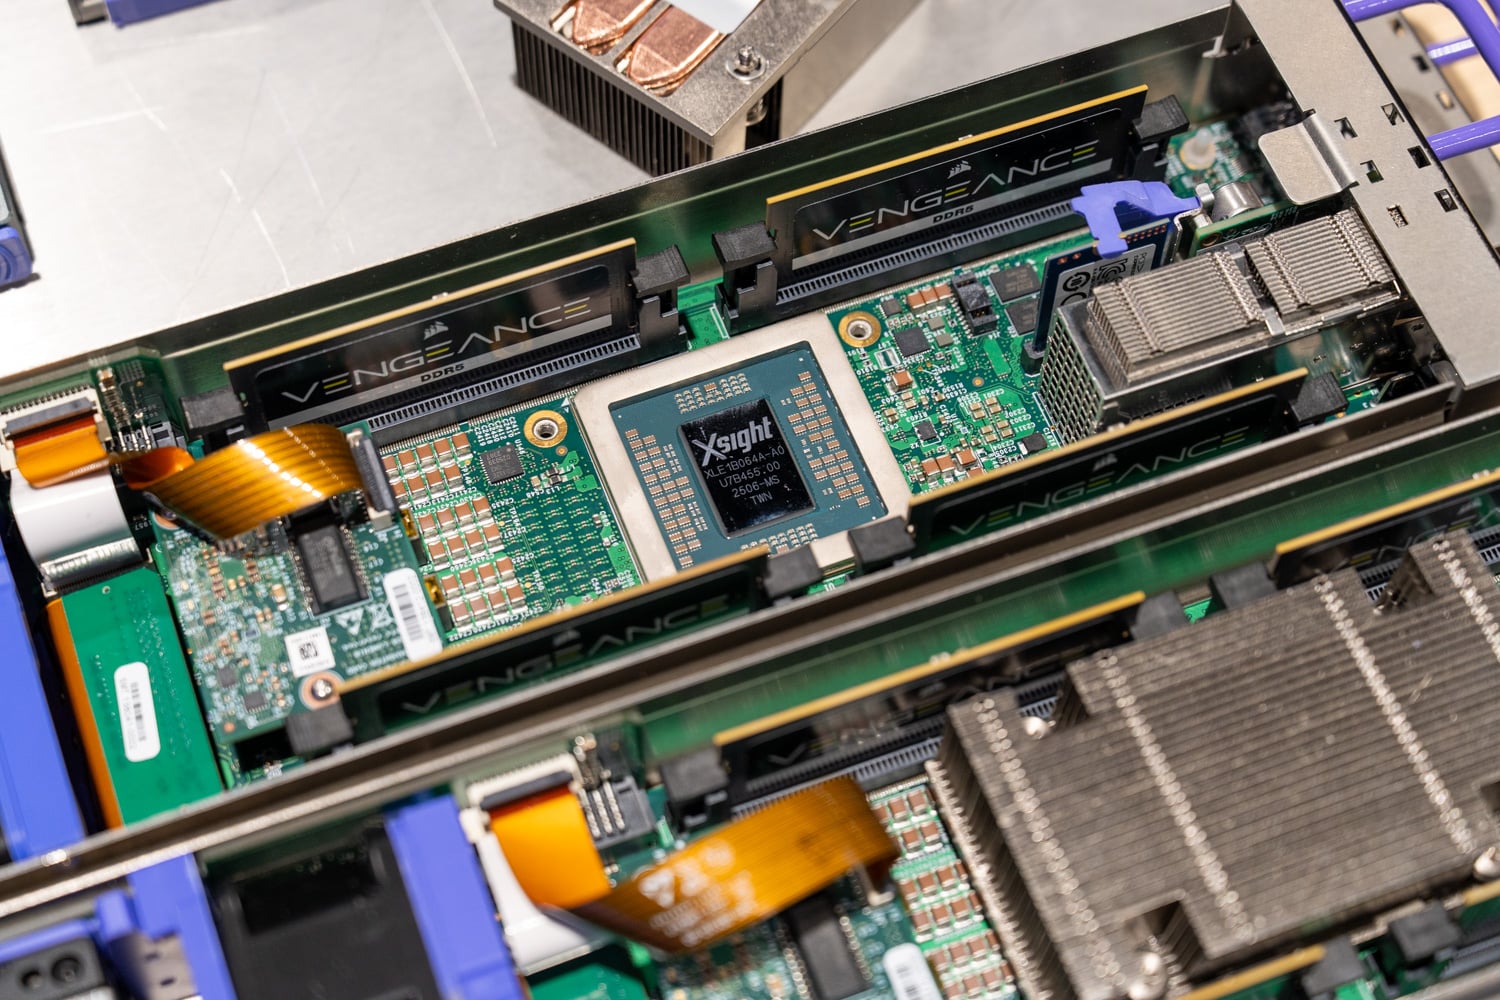
Una bandeja de 1U admite de uno a cinco carros, para hasta 40 unidades, 320 núcleos Arm y diez puertos 400GbE por unidad de rack. Hammerspace indica un máximo de 360 W por carro y 1,800 W por bandeja en fuentes de alimentación Titanium duales de 2,160 W, con servicio sin herramientas para carros y paquetes de unidades e IPMI y Redfish para administración. La bandeja tiene 106.64 cm de profundidad y requiere un rack de 1,200 mm, lo que excluye gabinetes empresariales menos profundos. Hammerspace indica que la densidad de unidades es 3.3 veces mayor que la de un servidor NVMe típico de 2U y 24 bahías, con 160 SSD en 4U frente a 48.
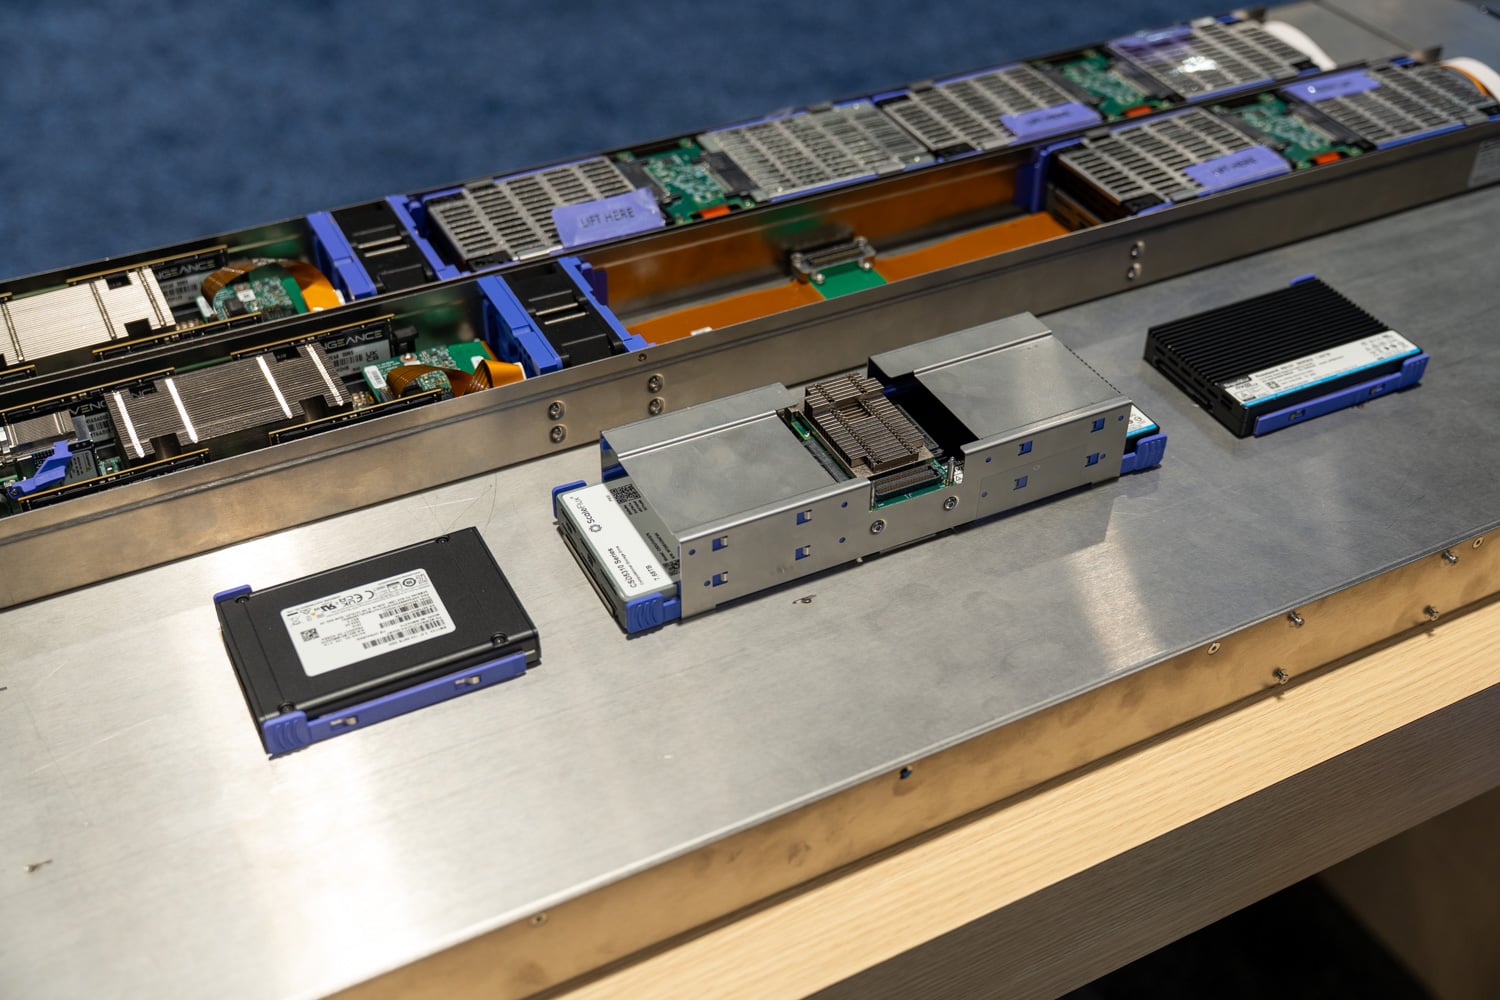
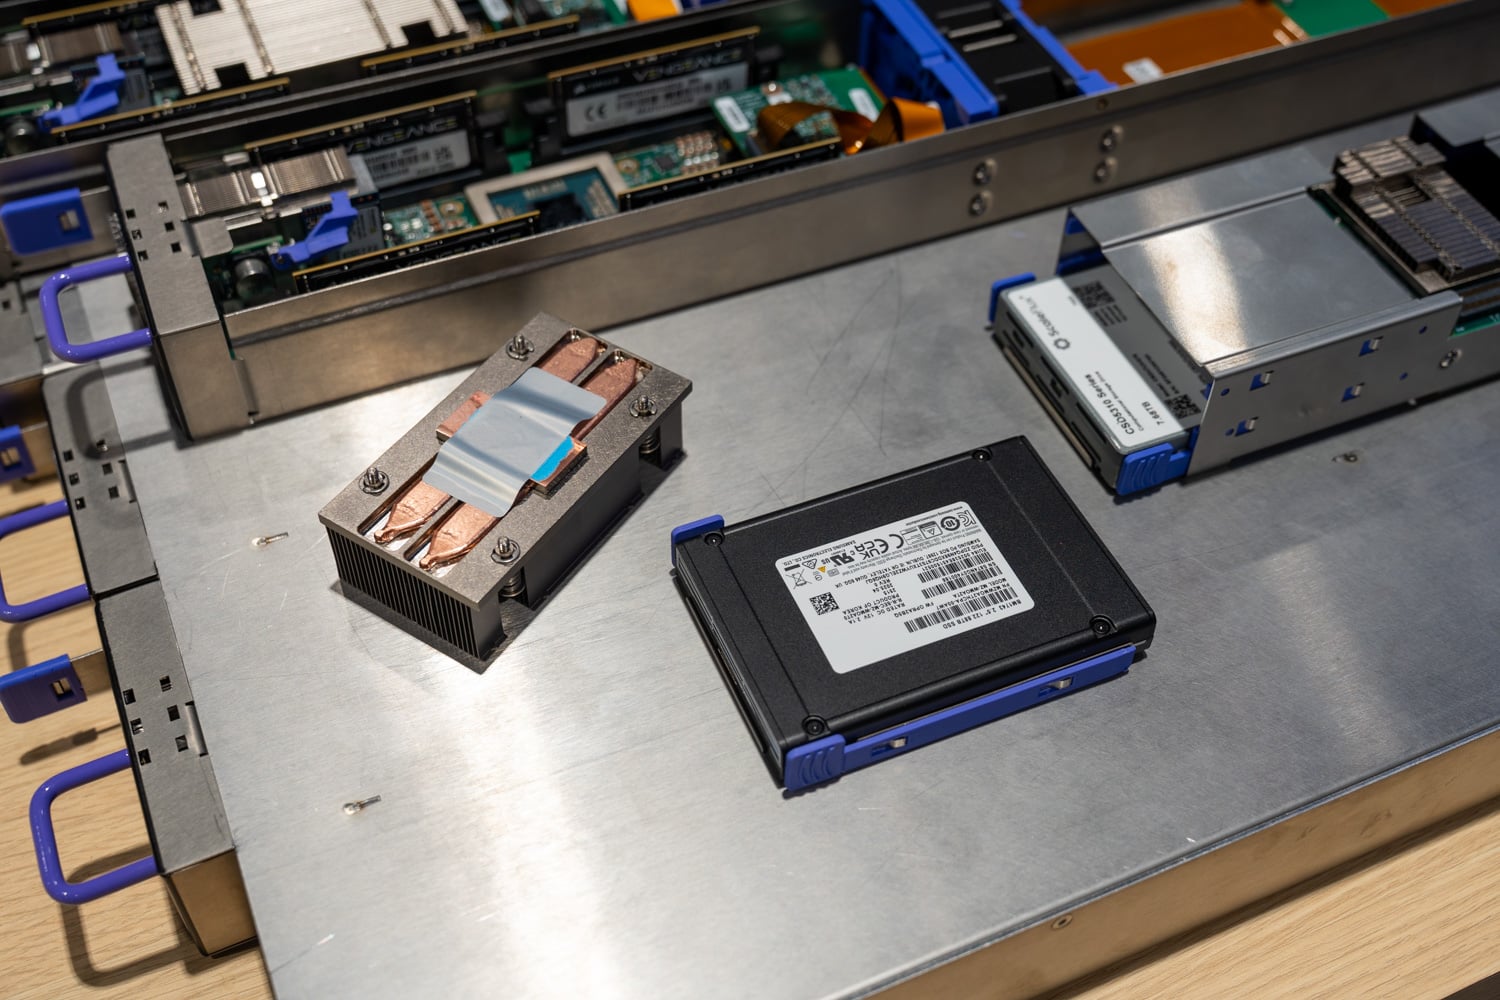
Con ocho SSD QLC de 245.76 TB, la mayor capacidad que ofrece Hammerspace, y la capacidad de unidades como la KIOXIA LC9 , un módulo admite 1.97 PB brutos y una bandeja completa admite 9.83 PB. Con el consumo máximo de la bandeja de 1,800 W, esto equivale a unos 183 W por petabyte bruto. Los módulos admiten unidades TLC o QLC en PCIe Gen5 o anterior, y Hammerspace prioriza las TLC sobre el rendimiento y las QLC sobre la capacidad. Un rack de 42U lleno de bandejas admitiría unos 413 PB y consumiría hasta 75.6 kW.
El diseño se inspira en la iniciativa Open Flash Platform que Hammerspace lanzó en 2025, con Xsight Labs y el Laboratorio Nacional de Los Alamos entre los participantes. En octubre de 2025, Hammerspace anunció que los sistemas de producción estarían disponibles a principios de 2026, por lo que el cronograma se ha retrasado aproximadamente un año. El sistema utiliza unidades U.2 y U.3, ya que actualmente se comercializan en grandes cantidades, y Hammerspace diseñó el sistema pensando en formatos más compactos. Hammerspace y Xsight han descrito una solución para alcanzar un exabyte por rack, más del doble de la capacidad de un rack completo de 42U con las unidades más grandes disponibles actualmente.
Hammerspace indicó que el desarrollo del prototipo comenzó hace aproximadamente dos años, y que su adopción inicial provino de proveedores de servicios en la nube a gran escala que colocan una o dos bandejas en la parte superior de cada rack de GPU, priorizando la densidad de rendimiento sobre el ahorro de energía. En esta configuración, Hammerspace asigna la memoria NVMe dentro de los servidores GPU al nivel G3 de NVIDIA y una bandeja OFP con memoria TLC en cada rack al nivel G4.
Declaraciones de rendimiento y condiciones de prueba
Hammerspace especifica una bandeja de cinco módulos con un rendimiento de escritura de 390 GB/s sin replicación y 15 millones de IOPS de lectura aleatoria de 4K. Las condiciones indicadas son NFSv4.2 con pNFS sobre TCP en una estructura de 400 GbE con SSD TLC Gen5 de nivel empresarial. Las lecturas alcanzan hasta 80 GB/s por módulo, o 400 GB/s por bandeja. Esto equivale a unos 40 GB/s a través de cada uno de los dos puertos de 400 GbE de un módulo, lo que prácticamente satura los enlaces una vez que se tiene en cuenta la sobrecarga del protocolo; por lo tanto, los puertos de red limitan el rendimiento de lectura.
La protección se realiza mediante duplicación, configurada por archivo o directorio según la política y modificable en línea. Las escrituras se reducen a 195 GB/s por bandeja con duplicación bidireccional y a 130 GB/s con duplicación tridireccional. La duplicación bidireccional también reduce a la mitad la capacidad utilizable, a unos 4.9 PB en una bandeja QLC completamente llena. Hammerspace sugiere operar sin duplicación para datos que se pueden regenerar, como la caché KV. La empresa afirma que el rendimiento por unidad de rack es de dos a cinco veces superior al de un competidor más cercano no identificado. No ha publicado datos de latencia, recuento de clientes ni resultados de IO500 y MLPerf Storage para OFP, y nosotros no realizamos ni auditamos estas pruebas.
| Especificación | Plataforma Flash Abierta Hammerspace |
|---|---|
| Descripción general de la plataforma | |
| Arquitectura de interiores | Nodos de almacenamiento flash basados en DPU sin servidor de almacenamiento x86 |
| Trineo | 8 unidades SSD NVMe U.2/U.3 en dos paquetes de 4 unidades. DPU Arm de 64 núcleos (Xsight Labs E1) 2 x 400GbE QSFP-DD |
| Bandeja de 1U | De 1 a 5 trineos Hasta 40 SSD Hasta 320 núcleos Arm Hasta 10 de 400 GbE |
| Soporte de Drive | Unidades SSD U.2/U.3 compatibles, PCIe Gen5 o anterior. TLC o QLC |
| Capacidad bruta máxima | 1.97 libras por trineo 9.83 libras por bandeja Basado en SSD QLC de 245.76 TB |
| Protocolos | NFSv4.2 con pNFS |
| Protección de Datos | Duplicación por política por archivo o directorio: ninguna, bidireccional o tridireccional. |
| Rendimiento (cifras de Hammerspace, SSD TLC Gen5, 400 GbE, TCP) | |
| Rendimiento de lectura | 80 GB/s por trineo 400 GB/s por bandeja |
| Rendimiento de escritura, sin espejo | 78 GB/s por trineo 390 GB/s por bandeja |
| Rendimiento de escritura, espejo de 2 vías | 39 GB/s por trineo 195 GB/s por bandeja |
| Rendimiento de escritura, espejo de 3 vías | 26 GB/s por trineo 130 GB/s por bandeja |
| Lectura aleatoria 4K | 3 millones de IOPS por sled 15 millones de IOPS por bandeja |
| Poder y físico | |
| Poder maximo | 360 W por trineo 1,800 W por bandeja |
| Fuentes de alimentación | Doble 2,160 W de titanio por bandeja |
| Factor de forma | Bandeja de 1U, 106.64 cm de profundidad Requiere un rack de 1,200 mm. |
| Enfriamiento | Aire, temperatura máxima de entrada de 40 °C a nivel del mar. |
| Gestión | IPMI, Redfish |
| Disponibilidad | Cotizando ahora Envíos en la primera mitad de 2027 |
Nivel 0 y caché KV
Hammerspace posiciona OFP como Nivel 1, detrás de un Nivel 0 compuesto por la memoria NVMe ya integrada en los servidores GPU. Exporta los datos a través de NFS y los agrega en un nivel compartido a nivel de clúster, sin cliente ni agente en los nodos de cómputo. Los datos escritos allí se replican en todo el clúster para su protección y se transfieren a otros niveles según las políticas establecidas. Hammerspace indica que un patrón común es escribir puntos de control de entrenamiento localmente y permitir que el sistema transfiera los más antiguos al almacenamiento de objetos. Hammerspace afirma que el Nivel 0 ofrece un ancho de banda secuencial 4.4 veces mayor y una latencia un 56 % menor en comparación con el almacenamiento compartido externo, sin publicar la configuración de prueba.
La función de caché KV utiliza el mismo nivel, partiendo de la base de que un servidor de inferencia que puede recargar el contexto calculado de una conversación desde el almacenamiento compartido no tiene que volver a calcular esos tokens en la GPU. Hammerspace no actúa como gestor de caché, sino que presenta el NVMe de nivel 0 agrupado, con OFP detrás, como almacenamiento POSIX para que lo utilice el gestor de caché del software de inferencia.
Inteligencia de datos: Catálogo, DeepScan y consultas en lenguaje natural.
La capa de inteligencia de datos comienza con un catálogo que indexa los metadatos de archivos y objetos en todos los sistemas de almacenamiento del espacio de nombres sin necesidad de mover los datos. Un segundo nivel, DeepScan, abre los archivos para buscar información personal, financiera y de salud protegida, ya sea bajo demanda o según un cronograma, y sus hallazgos se convierten en etiquetas de búsqueda. Las consultas se pueden escribir en lenguaje natural mediante un modelo de lenguaje natural (LLM) a elección del cliente. Los resultados alimentan el motor de políticas existente, que Hammerspace denomina objetivos, de modo que un administrador puede encontrar todos los archivos etiquetados como aptos para capacitación o restringidos a un país y establecer una regla de ubicación para ese conjunto.
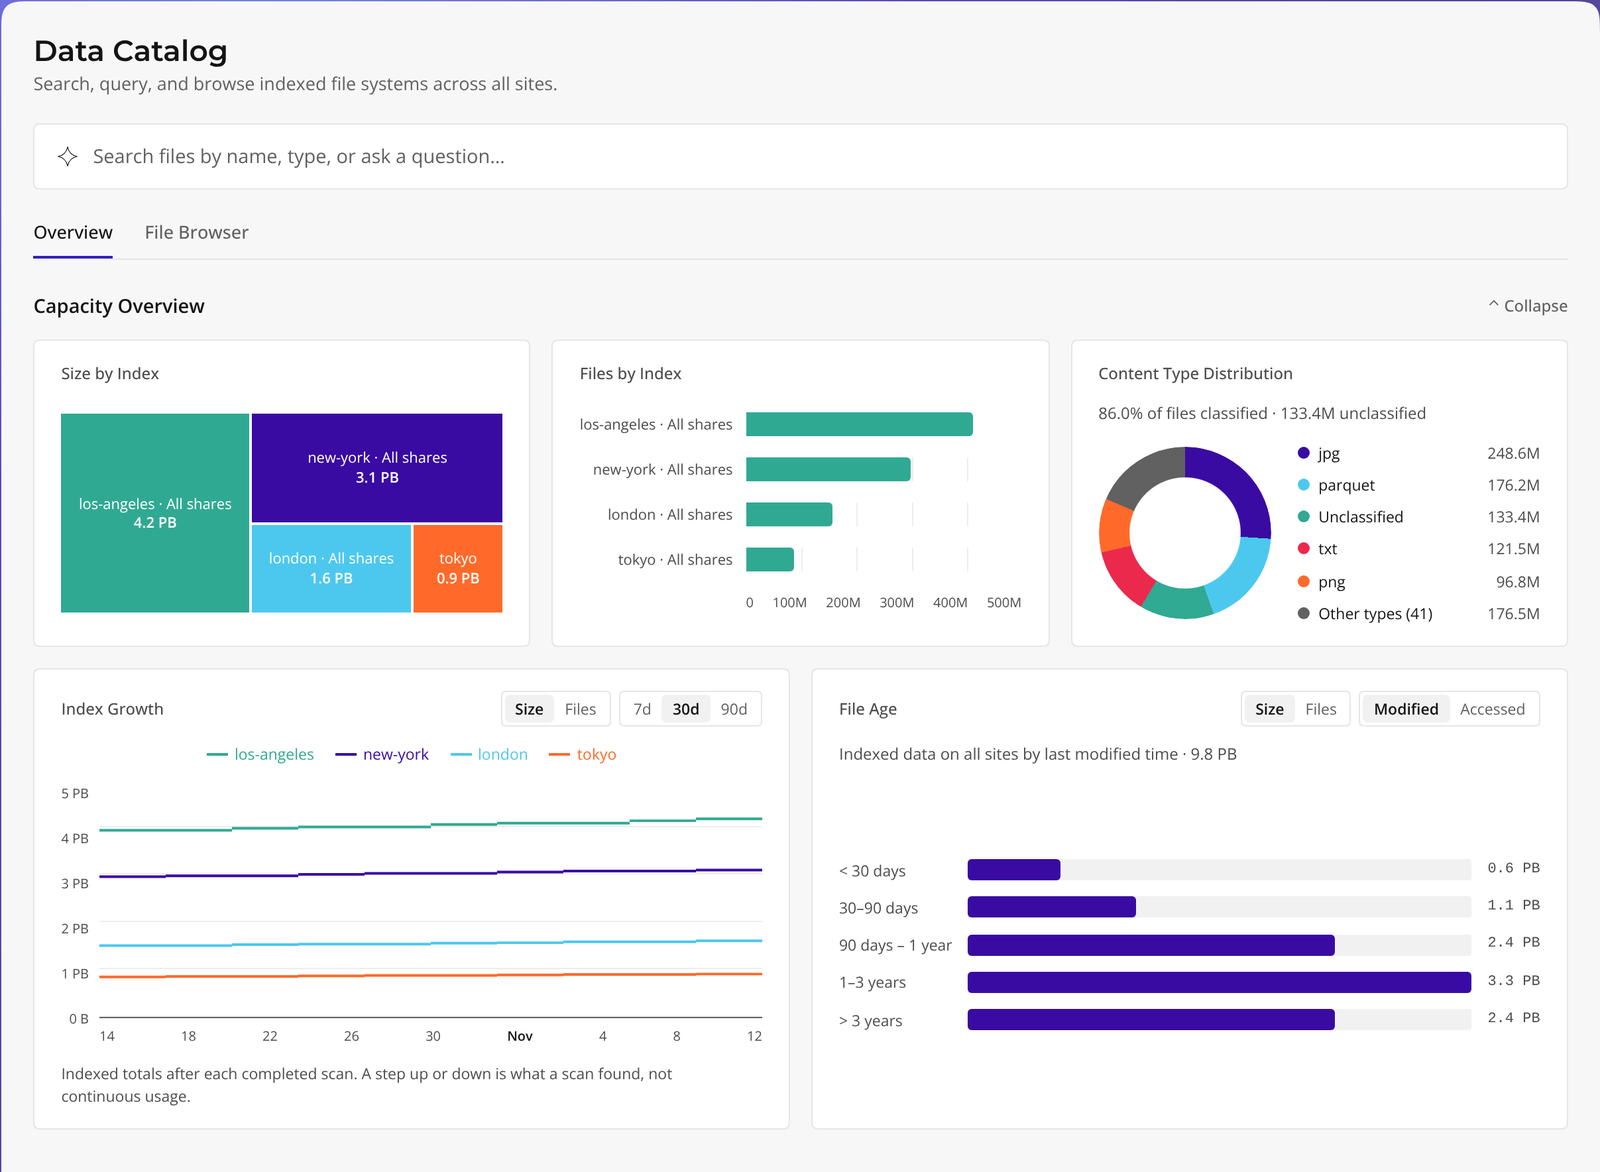
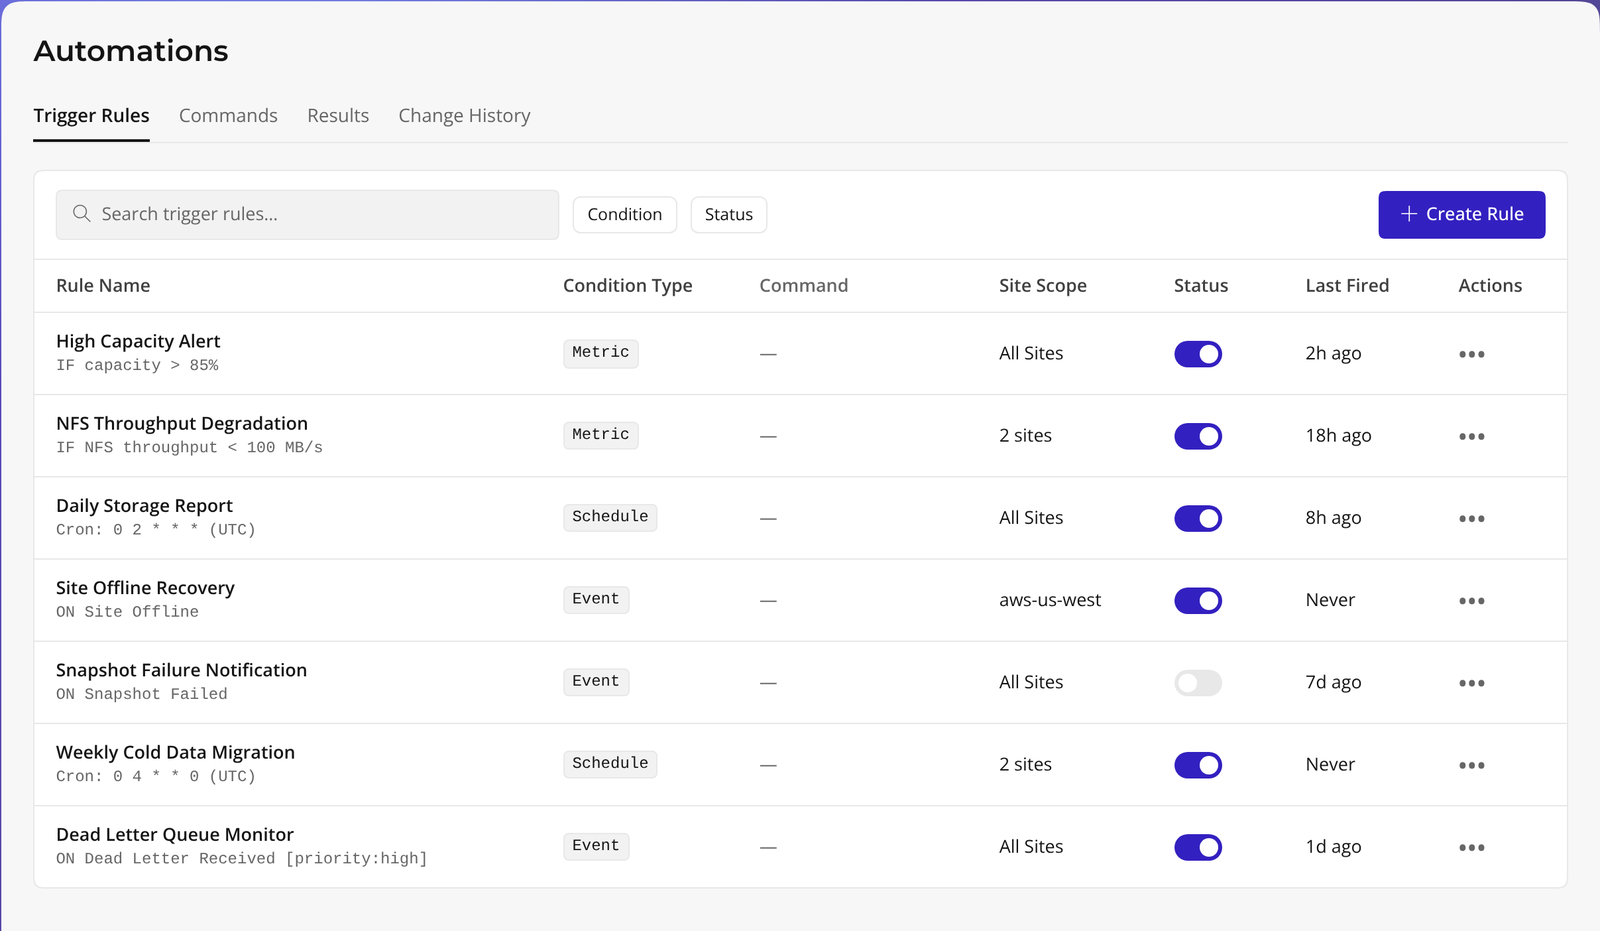
Los objetivos son reglas declarativas asociadas a un recurso compartido, volumen, directorio o archivo, como mover datos sin modificar durante 30 días o mantener tres copias en tres ubicaciones diferentes. Las nuevas automatizaciones los activan mediante condiciones que incluyen umbrales de capacidad, programaciones y eventos, con una fase de previsualización antes de aprobar los cambios. Las etiquetas se heredan a lo largo del árbol de directorios y siguen a los archivos entre sistemas de almacenamiento y la nube. El software es compatible con sistemas de almacenamiento de archivos y objetos de cualquier proveedor y no gestiona datos estructurados.
Primeros clientes y perspectivas
El cliente de referencia en el lanzamiento es kaiko, una empresa de IA clínica con oficinas en Ámsterdam y Zúrich que entrena modelos con datos de imágenes y patología. Kaiko ejecuta Hammerspace en Microsoft Azure y en las nubes de GPU Nebul y Nebius como un único espacio de nombres, utiliza NVMe en sus nodos de GPU como nivel 0 para el entrenamiento y tiene puntos de control ubicados en Azure Blob Storage según la política establecida. Hammerspace afirma que todos los flujos de trabajo de ingeniería de aprendizaje automático de kaiko en esos tres clústeres se han migrado al sistema. El caso de estudio no incluye hardware OFP.
Hammerspace nos informó que Kaiko adoptó el sistema mientras crecía de aproximadamente 128 GPU a más de 1,000 en Nebius, y que su NAS totalmente flash existente en la nube Nebul se integró al espacio de nombres. La compañía también describió un laboratorio de investigación de IA hiperescalable (sin nombre) que reemplazó Amazon FSx para Lustre con un clúster Hammerspace de 30 PB en AWS después de un año en el que Lustre fue su principal fuente de tickets de soporte, y ahora está extendiendo el espacio de nombres a un centro de datos local. Hammerspace afirma que las operaciones con archivos grandes son aproximadamente tres veces más rápidas allí.
OFP se suma a otros diseños que colocan una DPU donde antes se ubicaba el procesador del servidor de almacenamiento, como la arquitectura de referencia BlueField-4 STX que NVIDIA presentó en GTC. La versión de Hammerspace se diferencia por combinarla con un sistema de archivos que también funciona sin su hardware. Hammerspace está presentando el hardware en SC26 y aún no ha publicado los precios.
Grabamos un recorrido por el carro y la bandeja OFP con Hammerspace en SC26, y añadiremos el vídeo a este artículo cuando se publique.


 Amazon