

Intel presentó sus planes de computación de alto rendimiento para SC26, con Diamond Rapids, su arquitectura de servidor Xeon de próxima generación, como eje central. Intel afirma que la plataforma escalará hasta 256 núcleos de alto rendimiento con un ancho de banda de memoria de hasta 1.6 TB/s y hasta 1.28 GB de caché de último nivel. La presentación fue realizada por Jeff McVeigh, vicepresidente y director general de Programas Estratégicos para Centros de Datos, y también abarca la serie D de GPU de Intel, el software HPC, la fotónica de silicio y el desarrollo cuántico. Intel no proporcionó una fecha de lanzamiento para Diamond Rapids.
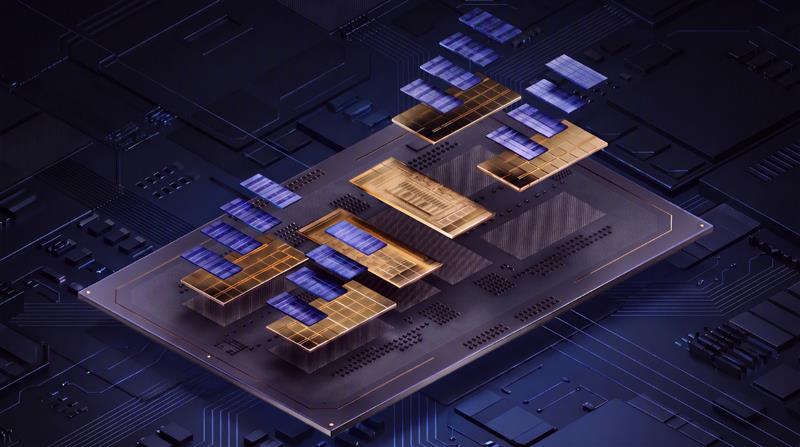
Arquitectura de CPU Diamond Rapids
Intel describe Diamond Rapids , que presentó en Hot Chips como un diseño 18A-P, como una arquitectura que combina una mayor densidad de cómputo con un mayor ancho de banda de memoria, cachés más grandes y una aceleración de CPU ampliada. Las extensiones de rendimiento avanzado (APX) de Intel están orientadas al rendimiento por hilo, y lo que Intel denomina una estructura de memoria unificada ofrece la cifra de 1.6 TB/s. Intel no ha especificado cuántos canales de memoria ni qué velocidad de memoria respaldan esa cifra, ni si se aplica por socket.
La arquitectura también es compatible con Intel AVX 10.2 y las extensiones Intel Advanced Matrix Extensions (Intel AMX) mejoradas. Intel afirma que el procesador Xeon de próxima generación es la única CPU para servidores x86 con computación matricial integrada para cargas de trabajo de computación de alto rendimiento (HPC) e inteligencia artificial (IA). Como referencia en cuanto al número de núcleos, los procesadores AMD EPYC Venice de gama alta que analizamos cuentan con 256 núcleos Zen 6c por socket.
McVeigh diseñó la hoja de ruta en torno a sistemas mixtos en los que las CPU orquestan los flujos de trabajo y ejecutan bibliotecas de comunicación paralelas, mientras que los aceleradores se encargan del trabajo de IA, escribiendo que el futuro de la computación de alto rendimiento es "abierto, heterogéneo y equilibrado".
Software para GPU Intel serie D y computación de alto rendimiento (HPC)
La serie D de GPU de Intel combina la aceleración de IA con la computación de doble precisión (FP64) en una tarjeta PCIe refrigerada por aire, con soporte para tipos de datos que van desde FP4 y MXFP4 hasta FP64. La GPU D270 de la marca Intel cuenta con 160 GB de LPDDR5X con un ancho de banda de memoria de 1.5 TB/s, y las configuraciones diseñadas por socios alcanzan los 480 GB. El argumento de Intel para los centros de investigación se centra en la capacidad de memoria, ya que mantener conjuntos de datos de trabajo más grandes en la tarjeta reduce el particionamiento y las transferencias del host al acelerador que ralentizan los flujos de trabajo científicos. Intel también promociona la tarjeta para agentes de IA siempre activos que generan código y ejecutan tareas de computación.
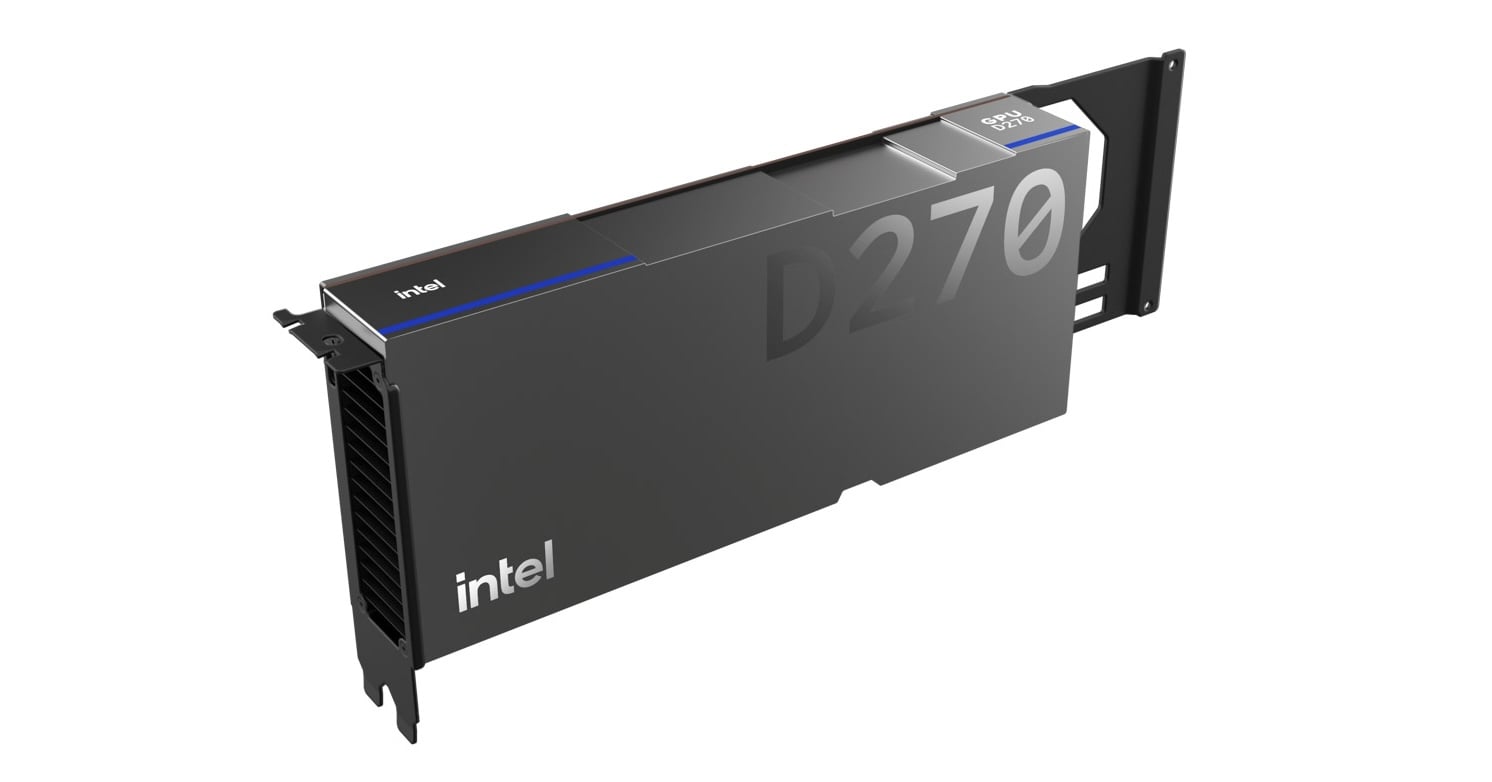
Intel está realizando dos demostraciones en vivo de la GPU D270, la tarjeta de la serie D anteriormente conocida con el nombre en clave Crescent Island, en su stand de SC26. La primera es una miniaplicación de imágenes sísmicas de Veridien que se adaptó de HIP y CUDA a SYCL en menos de un mes, e Intel afirma que el 90 % de sus kernels funcionaron correctamente sin ninguna optimización específica de Intel. La segunda divide una canalización de inferencia entre tarjetas D270 que se encargan del prellenado y unidades SambaNova SN50 que se encargan de la decodificación, con procesadores Xeon 6 y Xeon 6+ orquestando el proceso.
Intel también publicó comparaciones con la NVIDIA RTX PRO 6000 Blackwell Server Edition. En cargas de trabajo financieras FP64, afirma un rendimiento hasta 5.9 veces superior en Monte Carlo europeo, 5.6 veces superior en Black-Scholes europeo, 4.6 veces superior en precios binomiales y 1.92 veces superior en Black-Scholes americano, con la D270 a 350 W y la tarjeta NVIDIA a 600 W. Para la inferencia, Intel afirma una latencia hasta un 29 % menor en Drex v2.0 y un rendimiento de tokens de salida 1.12 veces superior en Qwen3-30B-A3B en FP8.
Estos son resultados del proveedor en silicio de preproducción, y no los ejecutamos ni auditamos. La configuración de prueba financiera de Intel enumera ocho tarjetas NVIDIA frente a una única D270 y no especifica si los resultados están normalizados por tarjeta. Además, las pruebas de inferencia de NVIDIA se realizaron en una máquina virtual de AWS.
En cuanto al software, Intel afirma que seguirá invirtiendo en Intel MPI, Fortran, optimizaciones de compiladores y oneAPI para que las bases de código paralelas existentes sigan funcionando correctamente en sistemas mixtos de CPU y GPU. También está trabajando en la integración con marcos de IA, entornos de ejecución de inferencia y entornos de implementación. El objetivo declarado es que los modelos y herramientas estándar se ejecuten en hardware nuevo, como la serie D, desde el primer día de su implementación.
Conectividad óptica y desarrollo cuántico
Intel también destacó su trabajo en fotónica de silicio, que utiliza luz para transmitir datos a distancias mayores con lo que la compañía describe como una fracción de la energía que consumen los enlaces de cobre. Intel no adjuntó cifras ni un cronograma de producto a esta afirmación.
En el ámbito de la computación cuántica, Intel reiteró su propuesta de adquisición de Classiq , que combinaría la plataforma de síntesis automatizada de algoritmos cuánticos de Classiq con la tecnología de espín-cúbito de silicio y la fabricación de chips de Intel. Intel ha declarado que espera que la operación se cierre en el primer semestre de 2027, una vez obtenida la aprobación regulatoria.


 Amazon