

NVIDIA y Cisco anunciaron hoy sus planes para el módulo óptico enchufable de factor de forma pequeño ultradenso (USFP), un formato diseñado para Ethernet de 400 Gb/s por carril en redes de IA. Los primeros transceptores previstos ofrecen 16 carriles dúplex completos en un tamaño similar al de un módulo OSFP, lo que equivale a 6.4 Tb/s por módulo. El conector está diseñado para ampliarse a 32 carriles y 12.8 Tb/s. NVIDIA y Cisco afirman que el USFP ofrece cuatro veces más ancho de banda y densidad en el panel frontal que los módulos enchufables de 200 Gb/s por carril, con una eficiencia energética aproximadamente 1.3 veces mayor.
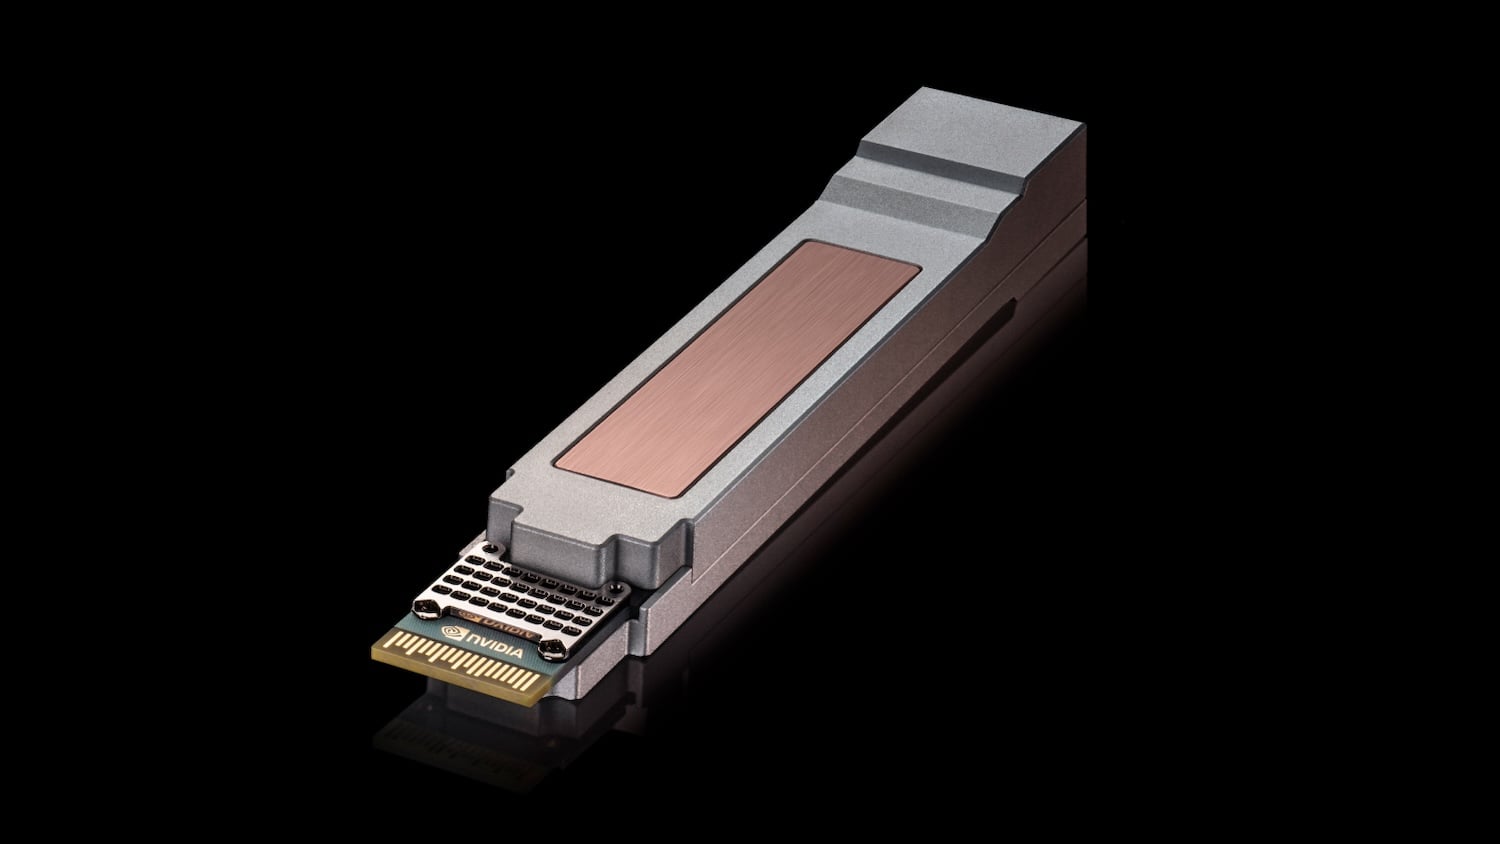
USFP es un plan sin fecha de muestreo ni disponibilidad prevista, y NVIDIA y Cisco pretenden convertir el diseño en una especificación abierta para la industria mediante un acuerdo multisource liderado por la comunidad. Forma parte de un conjunto más amplio de contribuciones de NVIDIA en la Cumbre Global OCP, que también abarca diseños de racks Vera Rubin, software DSX AI Factory, especificaciones de instalaciones y redes, alimentación de 800 VCC y trabajo con Ethernet en colaboración con Meta y Google.
USFP aumenta el número de carriles y la densidad de ancho de banda del panel frontal.
USFP duplica tanto el número de carriles como la velocidad por carril de los módulos actuales, lo que, según NVIDIA y Cisco, permite que un conmutador conecte más puntos finales de 1.6 Tb/s sin añadir una capa de red. Los módulos están diseñados tanto para conmutadores como para SuperNIC. Las empresas consideran que la densidad del panel frontal es el factor limitante en el crecimiento de la arquitectura de IA: una vez que un conmutador se queda sin puertos, el siguiente paso es añadir otra capa de conmutación con más óptica, lo que incrementa la latencia, el consumo de energía y el coste. USFP mantiene el modelo conectable, por lo que los módulos siguen siendo reemplazables y reparables en campo.
«La creación de las mayores fábricas de IA del mundo comienza por repensar hasta las conexiones más pequeñas», afirmó Gilad Shainer, vicepresidente sénior de NVIDIA. Bill Gartner, vicepresidente sénior y director general de sistemas ópticos y óptica de Cisco, señaló que para alcanzar los 400 Gb/s por carril en la óptica conectable se necesita algo más que una simple ampliación de los diseños de módulos actuales.
Un nuevo conector admite señalización de 400 Gb/s.
El conector es una matriz de contactos bidimensional con una secuencia de inserción en dos pasos, en la que los contactos de alta velocidad se activan solo después de que el módulo esté colocado. NVIDIA y Cisco afirman que esto reduce el desgaste de los contactos, mejora la integridad de la señal y hace que la fuerza de inserción sea más predecible. El conector está diseñado para 400 Gb/s por carril y, según las compañías, también mejora el rendimiento a 200 Gb/s por carril.
Un módulo USFP puede disipar hasta 100 W sin un circuito de refrigeración dedicado dentro del transceptor, lo que, según las empresas, simplifica el diseño del conmutador y mejora la fiabilidad. Todas las configuraciones USFP admiten diseños ópticos que simplifican el procesamiento de la señal para reducir la latencia y el consumo de energía, y el formato admite una amplia gama de tecnologías ópticas y clases de alcance. NVIDIA y Cisco están colaborando con TE Connectivity y Amphenol en jaulas, conectores y módulos, y se espera la incorporación de más socios, basándose en su trabajo de interoperabilidad existente entre las redes Ethernet basadas en NVIDIA Spectrum-X y Cisco Silicon One.
MGX 1.2 amplía la infraestructura de racks de Vera Rubin.
NVIDIA aportó sus diseños de racks y bandejas de computación Vera Rubin a OCP a través de su arquitectura abierta MGX, como parte del diseño de referencia MGX de tercera generación en la iniciativa Open DC de OCP, junto con los diseños de refrigeración líquida abiertos MQD y MQDB. La especificación MGX 1.2 añade refrigeración líquida de acoplamiento ciego a escala de rack, infraestructura de interconexión interoperable a escala de rack y una barra colectora refrigerada por líquido de 5,000 A, con soporte nativo para equipos de 19 pulgadas e implementaciones de rack de hasta 250 kW.
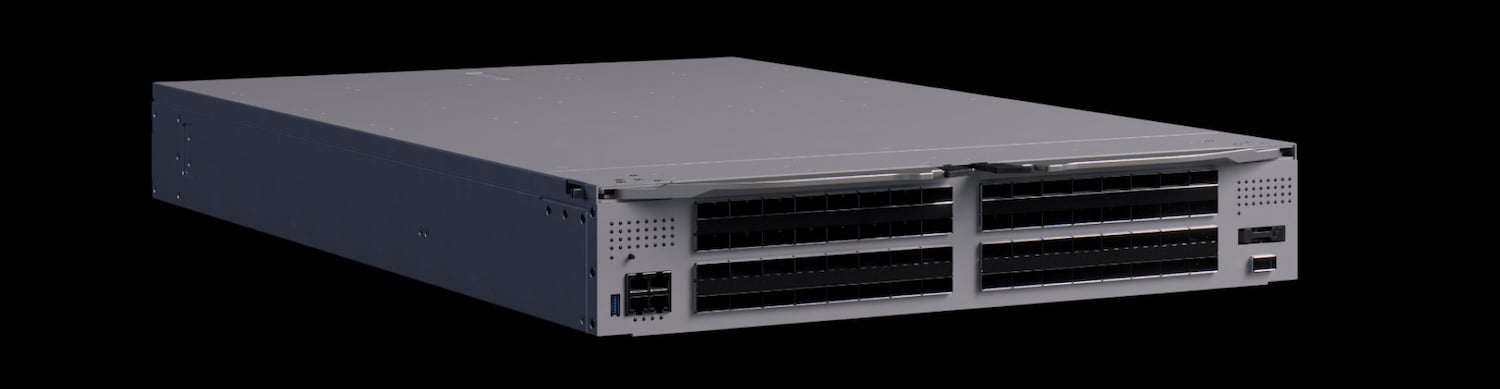
Las bahías de E/S configurables, las bandejas de computación refrigeradas por líquido sin ventilador y las interfaces de alimentación y refrigeración estandarizadas completan la especificación. NVIDIA afirma que las interfaces comunes reducen los tiempos de ensamblaje, prueba y servicio para sus socios. Una especificación de diseño independiente para el rack de CPU Vera extiende MGX más allá de la computación acelerada. NVIDIA posiciona a Vera Rubin NVL72 como la plataforma para el entrenamiento y la inferencia a gran escala, y el rack de CPU Vera para la llamada a herramientas, la orquestación y la ejecución en entornos aislados que aportan las cargas de trabajo basadas en agentes.
DSX OS añade componentes de gestión de red, rack y clúster.
NVIDIA amplió DSX OS, la capa operativa abierta de su plataforma de IA DSX , con cuatro componentes de código abierto. NVIDIA Config Manager automatiza la configuración, validación y mantenimiento de conmutadores en arquitecturas de IA. NVIDIA Cluster Readiness Engine somete a pruebas de estrés los clústeres de GPU con simulaciones de carga de trabajo antes de que comience el entrenamiento, lo que, según NVIDIA, detecta problemas de hardware que de otro modo provocarían fallos en las tareas.

El servicio NVIDIA Rack Management Service trata el rack como la unidad operativa, con abstracción de hardware y gestión de firmware a ese nivel. Cluster API Provider para NVIDIA Infrastructure Controller gestiona el despliegue bare-metal y la incorporación de inquilinos, y NVIDIA afirma que convierte hardware básico en clústeres listos para producción en cuestión de horas. Estos componentes se basan en la experiencia de NVIDIA con DGX Cloud y están diseñados para permitir que los proveedores de servicios en la nube y los socios de software integren las operaciones de las fábricas de IA en plataformas multiusuario.
Las especificaciones abiertas cubren el diseño de las instalaciones y la recuperación de la red.
NVIDIA, AMD, Google y Meta publicaron la Especificación Abierta para Centros de Datos v0.7, un plano compartido de instalaciones que abarca la arquitectura de energía, la refrigeración y la distribución física, que los fabricantes de equipos, los proveedores de coubicación y los operadores pueden utilizar como referencia para sus diseños. Google, Meta, Microsoft y NVIDIA también publicaron la Especificación de Resiliencia de la Red OCP, que define cómo las grandes instalaciones de IA deben gestionar las interrupciones del suministro eléctrico: mantenerse conectadas, responder automáticamente y recuperar casi toda su capacidad en menos de dos segundos. NVIDIA afirma que ambas especificaciones se alinean con su diseño de referencia DSX.
Visionbay presentó sus planes para K-1, una plataforma de fábrica de IA que combina la arquitectura de referencia de 800 VCC de NVIDIA con equipos de alimentación y refrigeración de Vertiv para futuras implementaciones de Vera Rubin. K-1 traslada la conversión de CA a CC a centros de alimentación a nivel de clúster y distribuye 800 VCC más cerca de la computación, con una adopción gradual de 800 VCC, refrigeración líquida y expansión modular. Visionbay aún no ha anunciado una fecha de lanzamiento.
Meta adopta Spectrum-6 y redes multiplano.
Meta adoptará la tecnología Ethernet NVIDIA Spectrum-6 de 102.4 Tb/s para sus fábricas de IA Vera Rubin. NVIDIA afirma que Spectrum-6 duplica la capacidad de conmutación y el ancho de banda por carril de Spectrum-4, funcionando a 200 Gb/s por carril con aislamiento de rendimiento entre tareas. El conmutador N-IceCube de Meta, basado en Spectrum-6, se instala en su rack IcePack 100T con refrigeración líquida y ejecuta FBOSS, el software de conmutación abierto de Meta, que utiliza la interfaz de abstracción de conmutación OCP para un control del hardware independiente del proveedor.
Spectrum-X Multiplane combina conmutadores Spectrum-6 con tarjetas de red ConnectX-9 SuperNIC y distribuye el tráfico de GPU en hardware a través de hasta ocho planos de red independientes. NVIDIA afirma que el diseño permite escalar a más de 100 000 GPU con menos niveles de conmutación, y que, cuando falla un componente, el tráfico se redirige a los planos restantes para que las tareas continúen con un ancho de banda reducido. Meta y NVIDIA aseguran haber validado las mejoras en la resiliencia tanto en entornos locales como en la nube, aunque no han publicado cifras.
Google Falcon Transport apunta al futuro hardware de red de NVIDIA
NVIDIA y Google anunciaron la compatibilidad con Falcon Transport para las futuras tarjetas de red NVIDIA ConnectX-10 SuperNIC y las unidades de procesamiento de datos BlueField. Falcon ofrece datos fiables a través de Ethernet mediante el balanceo de carga multipath, el control de congestión programable, la recuperación de pérdidas basada en hardware y la seguridad por conexión. NVIDIA lo implementa con aceleración por hardware y software DOCA, de modo que las tarjetas de red de NVIDIA y Google utilizan un protocolo de transporte común, mientras que las aplicaciones mantienen las interfaces RDMA estándar. Las compañías afirman que esto mejora la utilización del ancho de banda y la previsibilidad del rendimiento para el tráfico de IA y almacenamiento a medida que las redes Ethernet escalan.
Cisco lanza sistemas Silicon One G300 y añade una pieza de 51.2 T para la parte superior del rack.
Cisco aprovechó el mismo anuncio de OCP para actualizar su propia línea de chips. El Silicon One G300 de 102.4 Tb/s ya está disponible para muestras y los primeros sistemas basados en G300 se están enviando a los clientes. Además, Cisco añadió el G302, un ASIC de conmutación de 51.2 Tb/s con SerDes de 200G diseñado para sistemas de montaje en rack con óptica de 1.6 T y refrigeración líquida directa al chip, cuyo lanzamiento está previsto antes de finales de 2026. Cisco también afirma que su chip de enrutamiento de búfer profundo P200 de 51.2 Tb/s ya está en producción en los proveedores de servicios en la nube a gran escala: Microsoft ha puesto en producción los sistemas P200 y Alibaba Cloud ha desplegado su enrutador Quantum Cat interno en P200 a través de su red troncal eCORE, ejecutando SONiC.
El resto de la lista de Cisco está operativa. El Cisco 8001 es un switch de gestión en el Silicon One A100 en versiones de 10G y 1G que lleva SONiC a la red fuera de banda, de modo que los operadores pueden ejecutar un conjunto de API y automatización desde la estructura hasta el rack. SONiC, validado por Cisco, viene incluido con la arquitectura Nexus One, y la opción Live Protect, que corrige las vulnerabilidades detectadas en tiempo de ejecución antes de la solución definitiva, está prevista para mediados de 2027. Cisco es miembro de ESUN y afirma estar trabajando en la especificación 1.0 para redes escalables.


 Amazon