

NVIDIA anunció Minerva en GTC Berlín, una plataforma AIOps que recopila telemetría de GPU, redes, almacenamiento, planificadores y las cargas de trabajo de IA que se ejecutan en ellos, y luego aplica aprendizaje automático para detectar un componente con bajo rendimiento antes de que ralentice un proceso de entrenamiento. Dell Technologies, Lenovo y Supermicro la ofrecerán en sus carteras de operaciones de fábrica de IA, IREN ya la utiliza, e IBM, Jio, Lambda, Quake AI, Tesla, Aolani y Bitdeer AI planean implementarla. NVIDIA no ha publicado precios ni fecha de disponibilidad general.
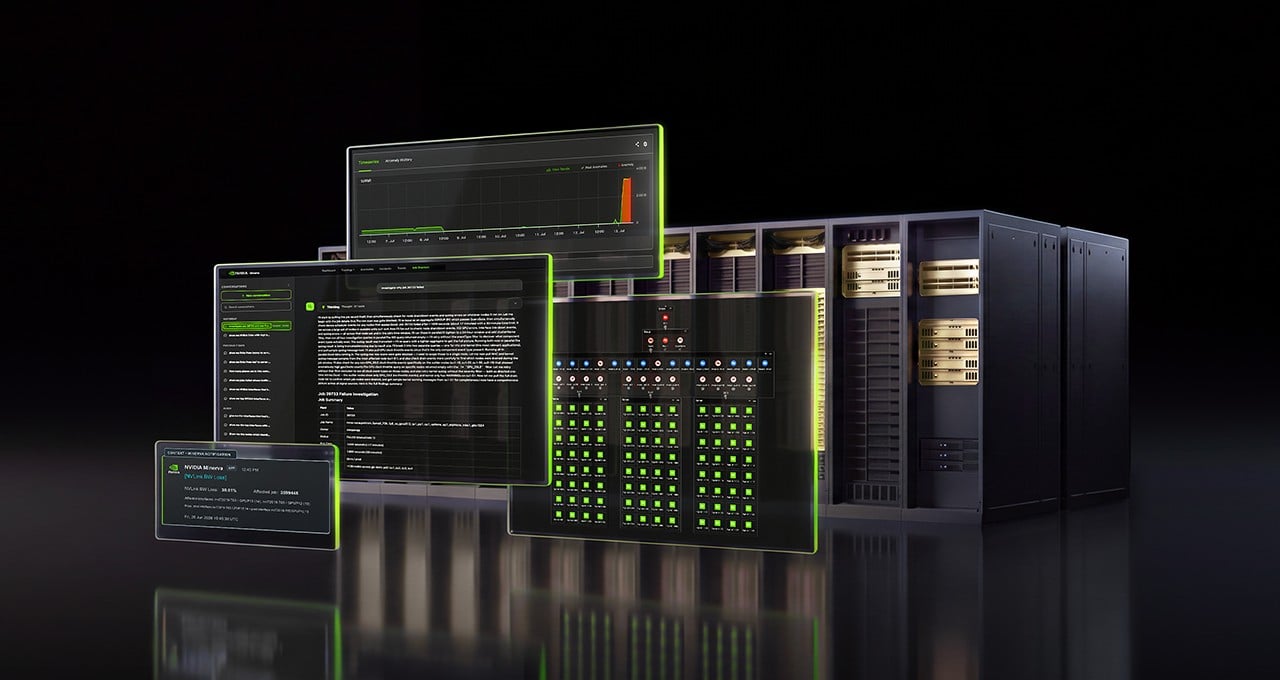
El problema que aborda Minerva es conocido por todos los grandes operadores de clústeres: miles de GPU en una red de alta velocidad se comportan como una sola máquina, por lo que si un componente no cumple con sus especificaciones, todo el proceso se ve afectado. Los ejemplos de NVIDIA son una GPU que se calienta más que sus vecinas y una unidad NVMe que pierde rendimiento bajo carga. Este tipo de datos se encuentra actualmente en una herramienta de red, una herramienta de computación y el panel de control de un equipo de aprendizaje automático, cada uno con una vista independiente del mismo clúster.
Lo que ve Minerva
Minerva crea un grafo de conocimiento dinámico que mapea las GPU, SuperNIC, conmutadores, cables y las tareas programadas en ellos. Luego, analiza miles de millones de puntos de datos por hora, según NVIDIA, mediante aprendizaje automático supervisado y no supervisado. Los modelos aprenden el comportamiento normal de la fábrica, detectan anomalías desconocidas, predicen fallos incipientes y correlacionan eventos relacionados utilizando la topología. De esta forma, se puede rastrear una tarea de entrenamiento lenta hasta el componente responsable en fábricas que NVIDIA dimensiona en cientos de miles de GPU.
La información se organiza en incidentes, agrupando los eventos relacionados en un solo elemento con una posible causa raíz asociada. Según NVIDIA, esto reemplaza una avalancha de alertas con un único elemento de acción. Un asistente integrado responde preguntas en lenguaje natural sobre la telemetría en tiempo real y recomienda una solución. La plataforma se conecta a herramientas externas de gestión de agentes. Los operadores deciden si una persona aplica la corrección o si Minerva la delega a la automatización mediante API de infraestructura y sistemas externos.
NVIDIA presenta la recompensa como un rendimiento de fábrica de IA, que mide en horas de GPU, rendimiento efectivo, tiempo de actividad del clúster y producción de tokens. Los resultados que se afirman son intervalos más largos entre interrupciones, reparaciones más rápidas y menos alertas que priorizar, con el equipo de operaciones pasando de un mantenimiento reactivo a uno proactivo. Estas son afirmaciones del proveedor sin cifras que las respalden; NVIDIA no ha publicado datos sobre el tiempo medio de reparación ni el tiempo de actividad de Minerva.
Dónde se ubica en la pila
NVIDIA ya vende software de operaciones para sus diseños de referencia. Mission Control , presentado en marzo de 2025, gestiona el aprovisionamiento de clústeres mediante Base Command Manager, la gestión de cargas de trabajo mediante Run:ai, la telemetría y la recuperación autónoma de trabajos para los sistemas DGX SuperPOD. La misma semana que Minerva, NVIDIA lanzó tres componentes de código abierto del sistema operativo DSX en versión preliminar para desarrolladores para la gestión del ciclo de vida de la fábrica de IA: Config Manager para la configuración de red, Rack Management Service para la gestión de energía, inventario, firmware y conmutadores a nivel de rack, y Cluster Readiness Engine para validar clústeres de GPU con cargas de trabajo distribuidas.
La magnitud del problema al que apunta Minerva quedó patente en el informe de Meta sobre Prometheus de la semana pasada. Meta gestiona cada dominio NVL72 como una partición de 64 GPU, manteniendo las ocho GPU restantes como repuestos en el rack. Además, conserva aproximadamente el 2 % de los racks en reserva y pone en cuarentena cada sistema reparado hasta que supera la validación. Un año de trabajo de análisis de la causa raíz con ingenieros de NVIDIA in situ redujo las interrupciones en un 99 % y elevó el tiempo medio entre interrupciones a más de 54 000 horas de GPU, con un objetivo de 100 000.
Se trata de un proveedor de servicios en la nube a gran escala que ejecuta una canalización de telemetría diseñada específicamente para ello y un equipo de análisis conjunto con NVIDIA. Minerva parece una versión empaquetada de esa metodología, algo más cercano a una solución lista para usar para una empresa o neocloud que desee una visibilidad a nivel de proveedor de servicios en la nube a gran escala sobre el estado de la GPU, la infraestructura y el almacenamiento, así como el flujo de trabajo de reinicio y reemplazo correspondiente, todo ello a través de los mismos fabricantes de equipos originales que venden los racks.
NVIDIA no ha especificado la relación entre Minerva, Mission Control o DSX OS, si se distribuirá como software, dispositivo o servicio alojado, ni cómo será el empaquetado OEM de Dell, Lenovo y Supermicro. La página de documentación del producto remite a los clientes a su equipo de NVIDIA para obtener la guía del usuario. El cliente de referencia es IREN, que, según NVIDIA, utiliza Minerva para optimizar sus centros de IA.
“NVIDIA Minerva ofrece a nuestro equipo de operaciones una visión unificada de toda la red, las GPU y las tareas que se ejecutan en ellas”, dijo Denis Skrinnikoff, director de tecnología de IREN, quien le atribuyó el mérito de haber permitido que el equipo dedicara más tiempo al mantenimiento proactivo.
En lo que respecta al almacenamiento, lo interesante es que el comportamiento de las unidades bajo carga se considera un dato de entrada junto con la telemetría de la GPU y la interconexión, ya que un dispositivo NVMe que se ralentiza rara vez se refleja en la utilización de la GPU hasta que se detiene un punto de control o una etapa de carga de datos. El alcance de esta telemetría de almacenamiento y qué fabricantes de equipos originales (OEM) y plataformas de matrices la proporcionan es un detalle que será interesante analizar en profundidad cuando esta solución llegue al mercado.



 Amazon