

Históricamente, cada lectura de almacenamiento realizada por una GPU ha pasado por la CPU principal, que administra el sistema de archivos, envía comandos y devuelve los datos. Esta sobrecarga es insignificante para grandes transferencias secuenciales, pero se convierte en un factor limitante al procesar millones de operaciones de 512 bytes por segundo. En FMS 2026, celebrada en Santa Clara, NVIDIA anunció un nuevo software y una iniciativa del sector para eliminar este cuello de botella.
El anuncio principal es cuFile, una API que permite a las GPU leer y escribir directamente en el almacenamiento. NVIDIA está liberando el código fuente de cuFile y su conjunto completo de software de soporte, alojado en la nueva organización XIO-SIG en GitHub. Entre los mantenedores fundadores se encuentran Google, Intel, Meta y NVIDIA. Además, NVIDIA lanzó formalmente Storage-Next, una iniciativa que se ha estado discutiendo públicamente desde al menos GTC 2025. Storage-Next ahora incluye a más de 40 proveedores de almacenamiento y memoria flash, como DDN, KIOXIA y Micron, así como fabricantes de controladores, especialistas en refrigeración y organizaciones de estandarización. Estos participantes están definiendo de forma colaborativa cómo deben comportarse los dispositivos de almacenamiento cuando el cliente es una GPU, en lugar de una CPU.
El problema: E/S mediada por el host
Los sistemas GPU tradicionalmente han operado bajo un modelo de E/S centrado en el host. La CPU programa las tareas de la GPU, prepara los datos e inicia todas las transferencias entre la GPU y la red o el almacenamiento. Cada operación sigue una secuencia: el kernel de la GPU finaliza, el control regresa a la CPU, esta configura la transferencia y se inicia el siguiente kernel. El costo por operación, principalmente la sobrecarga de inicio del kernel y la sincronización CPU-GPU, se mide en microsegundos. Si bien esta sobrecarga es insignificante para transferencias masivas, se vuelve significativa para operaciones de grano fino.
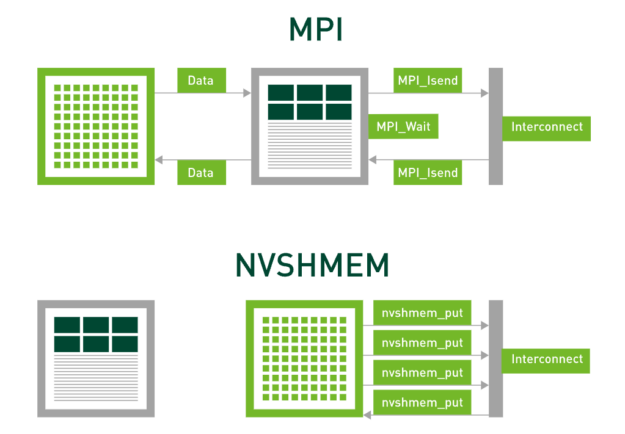
Para la comunicación entre GPU, NVIDIA eliminó la intervención del host mediante NVSHMEM, lo que permite que el código del dispositivo inicie las transferencias directamente y las integre con el cálculo. El impacto es considerable: cuando GROMACS migró su comunicación de intercambio de halo de MPI a NVSHMEM, la comunicación se eliminó de la ruta crítica y se integró completamente con el cálculo.
El almacenamiento mantuvo el modelo mediado por el host. Una lectura desde una unidad NVMe aún devuelve el control a la CPU, ejecuta el sistema de archivos y espera a que finalice. El entrenamiento tolera esto porque sus lecturas son grandes y poco frecuentes. La inferencia no. Servir entradas de caché KV, incrustaciones y resultados de búsqueda vectorial genera millones de pequeñas lecturas aleatorias por segundo, con la CPU en la ruta de cada una.
E/S iniciadas por GPU y SCADA
SCADA (acceso a datos escalado y acelerado) aplica el modelo NVSHMEM al almacenamiento, lo que permite que la GPU inicie y gestione sus propias operaciones de entrada/salida de almacenamiento.
La investigación subyacente es BaM, o Big Accelerator Memory, presentada en ASPLOS 2023 por NVIDIA, IBM, la Universidad de Illinois y la Universidad de Buffalo. BaM demostró una GPU que gestiona directamente las unidades NVMe, consolidando y almacenando en caché las pequeñas solicitudes generadas en sus hilos para mantener colas de gran profundidad sin intervención del host. En hardware idéntico, BaM ejecutó cargas de trabajo de análisis de datos 5.3 veces más rápido que el acceso iniciado por la CPU y ejecutó cargas de trabajo de gráficos desde memoria flash con un coste de hardware hasta 21.7 veces menor que el almacenamiento de los mismos datos en la memoria del host.
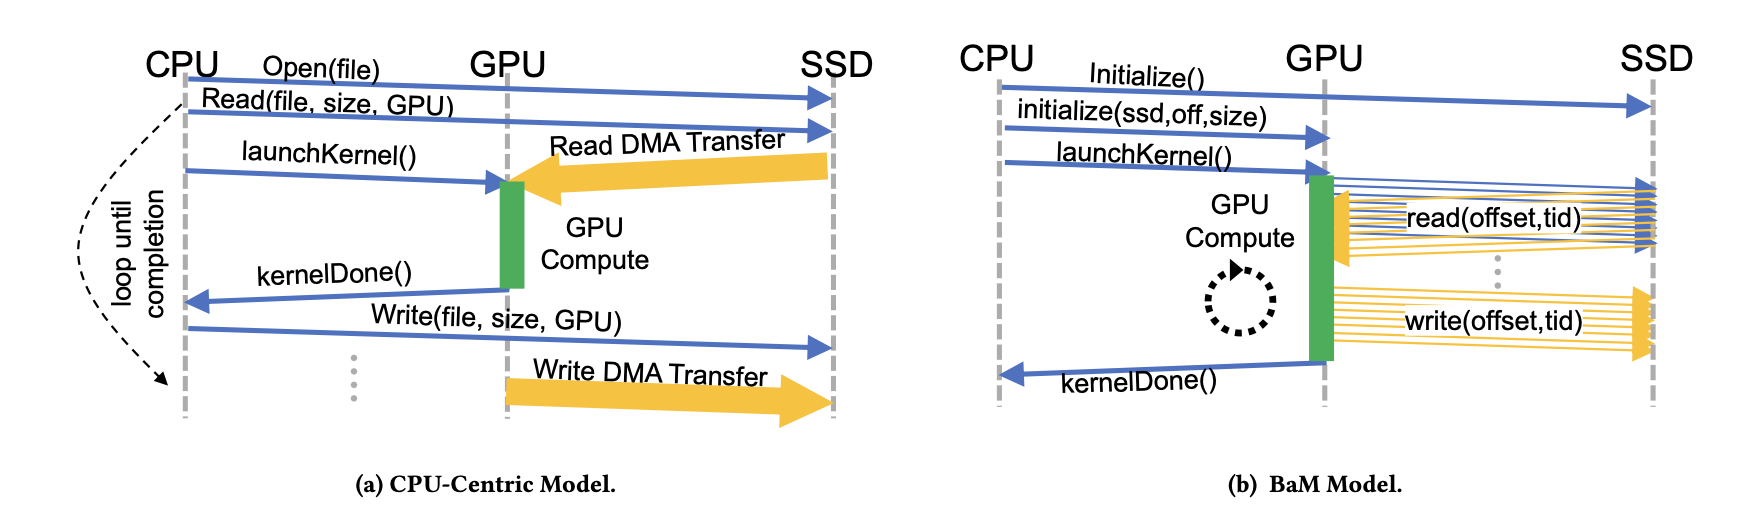
SCADA es la versión comercial. Un entorno de ejecución en la GPU se sitúa entre los subprocesos del kernel y el almacenamiento. Agrupa pequeñas solicitudes dispersas en lecturas que se sirven desde una caché en la GPU o se envían a unidades, que pueden ser NVMe locales o un servidor de almacenamiento remoto.
El acceso directo a los dispositivos debe estar restringido, ya que el acceso sin protección a una unidad compartida podría permitir que una aplicación lea o corrompa los datos de otra. El diseño de NVIDIA separa los niveles de privilegio. Las partes críticas para el rendimiento de una aplicación se ejecutan sin privilegios, fuera de la base de computación confiable. Un componente con privilegios configura el acceso protegido entre cada aplicación y solo su almacenamiento aprobado durante la configuración, utilizando mecanismos de seguridad estándar de Linux. NVIDIA cita esta separación y la interoperabilidad basada en Linux como la razón por la que la pila se publica como código abierto en lugar de un componente CUDA cerrado.
Diferencias entre SCADA y el almacenamiento GPUDirect
Cada operación de almacenamiento tiene una ruta de datos (los bytes movidos) y una ruta de control (construcción, envío y gestión de finalización de la solicitud). GPUDirect Storage (GDS), presentado en 2019 y disponible desde 2021, eliminó la CPU de la ruta de datos: a través de cuFile, los datos se mueven por DMA entre la unidad y la memoria de la GPU sin búfer de rebote en la RAM del host. Los materiales de lanzamiento de NVIDIA establecen el límite de la ruta de la CPU en un DGX-2 en 50 GB/s, con GDS capaz de combinar rutas para un límite superior cercano a 200 GB/s, y DDN, VAST, WEKA, Pure Storage y otros proveedores importantes de almacenamiento de IA lo certificaron para ello. La ruta de control permaneció en la CPU: el software del host sigue decidiendo qué obtener y emite cada solicitud, y la GPU es el destino del DMA en lugar del iniciador.
Para transferencias de gran tamaño, esta distribución es adecuada. Una lectura de 1 MB amortiza el coste de la ruta de control a cero. Con 512 bytes, la proporción se invierte. El coste fijo por solicitud predomina, y la CPU se satura mucho antes que las unidades. SCADA traslada la ruta de control a la GPU, que absorbe la latencia por operación del mismo modo que absorbe la latencia de la memoria, manteniendo cientos de miles de operaciones en curso.
Ambos sistemas coexisten: cuFile para transferencias masivas y SCADA para grandes volúmenes de lecturas aleatorias pequeñas.
Storage-Next y el problema de los 512 bytes
SCADA se encarga del lado de la GPU. Storage-Next se ocupa del lado de la unidad, que actualmente está optimizado para una carga de trabajo diferente.
Las unidades SSD empresariales llevan una década optimizadas para lecturas aleatorias de 4 KB, adaptándose a los patrones de acceso a bases de datos y virtualización. La mayoría de los controladores realizan prácticamente el mismo trabajo para procesar una lectura de 512 bytes que una de 4 KB, por lo que las solicitudes inferiores a 4 KB se ejecutan al mismo coste que las de 4 KB. Los patrones de acceso de inferencia son más pequeños: las incrustaciones ocupan unos pocos cientos de bytes y los bloques de caché KV son muy inferiores a un kilobyte. Procesarlos desde unidades optimizadas para 4 KB impone una amplificación de lectura de 8x, lo que supone un desperdicio de ancho de banda y caché del controlador. Con decenas de terabytes de objetos pequeños, esta amplificación determina si la memoria flash es viable como capa de memoria.
Storage-Next es una iniciativa para rediseñar unidades, controladores y sistemas en torno a unidades más pequeñas. Se presentó públicamente en GTC 2025, que ya está en marcha, con el objetivo declarado de maximizar las IOPS de 512 bytes por GPU bajo restricciones de potencia y latencia. En FMS, NVIDIA presentó un número de miembros, más de 40 proveedores de almacenamiento y memoria flash, y designó SCADA como el marco de referencia para su desarrollo.
El resultado de referencia es la demostración SC25 de Micron, que alcanza 230 millones de IOPS de lectura aleatoria de 512 bytes en un único servidor bajo el modelo de programación SCADA: 44 SSD Micron 9650 PCIe Gen6 conectados a tres conmutadores Broadcom PEX90000 Gen6, controlados por tres H100 en un chasis H3 Platform Falcon 6048. Esta cifra representa aproximadamente el 95 % de las 5.5 millones de IOPS combinadas de las 44 unidades.
La composición de esa cifra es importante. 230 millones de lecturas de 512 bytes equivalen aproximadamente a 118 GB/s de carga útil, que cuatro o cinco de esas unidades podrían entregar secuencialmente. El logro reside en la cantidad de operaciones. Mantenerlo mediante software anfitrión consumiría docenas de núcleos de CPU solo para el procesamiento de envío y finalización, sin embargo, la única CPU de la demostración estaba prácticamente inactiva. Distribuida entre los más de cien mil hilos de una GPU, la carga es de unos pocos miles de operaciones por hilo por segundo.
La capacidad de las SSD es ahora el factor limitante. La 9650 de Micron, la primera SSD PCIe Gen6, tiene una velocidad de lectura secuencial de 28 GB/s y un récord de 5.5 millones de IOPS de lectura aleatoria. Micron informa de una escalabilidad lineal de 1 a 44 unidades en la demostración. La serie GP de Kioxia, una SSD XL-Flash diseñada para acceso de 512 bytes , se está desarrollando bajo Storage-Next. La hoja de ruta Storage-Next de NVIDIA prevé que las SSD PCIe Gen7 soporten 100 millones de IOPS cada una, un objetivo hacia el que los proveedores de controladores, incluido Marvell, están diseñando actualmente. Alcanzar esas cifras requiere un rediseño del controlador, una corrección de errores dimensionada para cargas útiles pequeñas y estándares que definan el comportamiento de la unidad nativa de la GPU.
Mapeo al entrenamiento y la inferencia
Las dos rutas corresponden a dos patrones de acceso. El entrenamiento está limitado por el ancho de banda. Transmite grandes fragmentos secuenciales y escribe periódicamente puntos de control de varios terabytes durante los cuales las GPU permanecen inactivas. La sobrecarga de la CPU es insignificante para esos tamaños de transferencia, por lo que GDS y la pila cuFile, recientemente de código abierto, siguen siendo la interfaz correcta, medida en GB/s por GPU y duración del punto de control.
La inferencia está limitada por las IOPS. La caché KV, el estado de atención para cada token ya procesado en una conversación, crece con la longitud del contexto. Las implementaciones agenciales ejecutan miles de conversaciones concurrentes. Esto supera rápidamente la memoria de la GPU, y recalcular las entradas desalojadas cuesta más tiempo de GPU que leerlas de nuevo. El diseño estándar es una caché escalonada que se desborda de la memoria de la GPU a la memoria del sistema y luego a la memoria flash, y se rellena mediante grandes volúmenes de pequeñas lecturas aleatorias. La búsqueda vectorial y las consultas de incrustación producen el mismo patrón. Esta es la forma de acceso a la que apunta SCADA, y la razón por la que NVIDIA cita 512 bytes de IOPS en lugar de ancho de banda. Servir la caché KV desde la memoria flash en lugar de la memoria aumenta el contexto y el número de usuarios concurrentes que admite cada GPU, lo que establece el coste de servicio por usuario.
El hardware: Vera BlueField-4 STX y CMX
La capa de plataforma es NVIDIA Vera BlueField-4 STX , la arquitectura de almacenamiento a escala de rack presentada en GTC 2026 y ampliada esta semana. STX combina la plataforma Vera Rubin con procesadores de almacenamiento BlueField-4, cada uno de los cuales combina núcleos Vera Arm con 800 Gb/s de red integrada y aproximadamente 6 veces la capacidad de procesamiento de BlueField-3.
En FMS, NVIDIA publicó una prueba de rendimiento para esos núcleos. Una canalización de compresión y cifrado de dos etapas, representativa de los sistemas de almacenamiento de servicios de datos en línea que se aplican a todo el tráfico, alcanzó un rendimiento hasta 3.21 veces superior al de una CPU x86 en Vera. Esto implica que el cifrado, la compresión y la verificación, que actualmente consumen núcleos x86 en los controladores de almacenamiento, pueden trasladarse al silicio Vera con un menor consumo de energía. DOCA, el marco de software de NVIDIA para BlueField, aplica políticas de seguridad en la ruta de datos. CMX Context Memory Storage , basado en STX, agrupa memoria flash detrás de BlueField-4 como una capa de caché KV compartida para inferencia de contexto largo. Los sistemas de socios como DDN, Dell, HPE, IBM, VAST Data, WEKA y otros estarán disponibles en la segunda mitad de 2026.
Pensamientos Finales
La estructura estratégica es clara: NVIDIA publica la interfaz que las GPU usarán para acceder al almacenamiento, libera el código fuente de la implementación y organiza a más de 40 proveedores para estandarizar el comportamiento del hardware subyacente. Abrir cuFile se aparta de la práctica de NVIDIA de mantener esta capa dentro de CUDA. Pero una interfaz de almacenamiento iniciada por la GPU solo resulta rentable si los proveedores de unidades, controladores y matrices la integran en sus sistemas. La incorporación de Intel como mantenedor es una señal importante. Un proveedor líder de silicio x86 en los sistemas de almacenamiento actuales respalda el software diseñado para eliminar ese silicio de la ruta de E/S.
La demostración de Micron confirma su viabilidad. Tres GPU impulsaron 44 unidades Gen6 hasta aproximadamente el 95 % de su límite nominal combinado, con un tamaño de bloque que la industria ha considerado secundario. Lo que queda por implementar: que el código se publique en GitHub, que SCADA madure de un marco de trabajo a un componente CUDA compatible, y que los proveedores comercialicen en masa unidades SSD optimizadas para lecturas pequeñas. Las cifras anteriores corresponden a NVIDIA y sus socios, no a mediciones independientes. Las probaremos cuando los sistemas STX lleguen al laboratorio en la segunda mitad del año.


 Amazon