

NVIDIA, Rebellions y SK Telecom anunciaron un plan para construir una infraestructura de inferencia de IA soberana en Corea del Sur, basada en la unidad de procesamiento neuronal R200 de próxima generación de Rebellions. Esta unidad estará conectada internamente al rack mediante NVIDIA NVLink Fusion y construida sobre la arquitectura de rack NVIDIA MGX. SK Telecom implementará los sistemas en su centro de datos de IA, junto con sus modelos y servicios. Las tres compañías prevén que los sistemas R200 estén listos para su implementación en 2028.
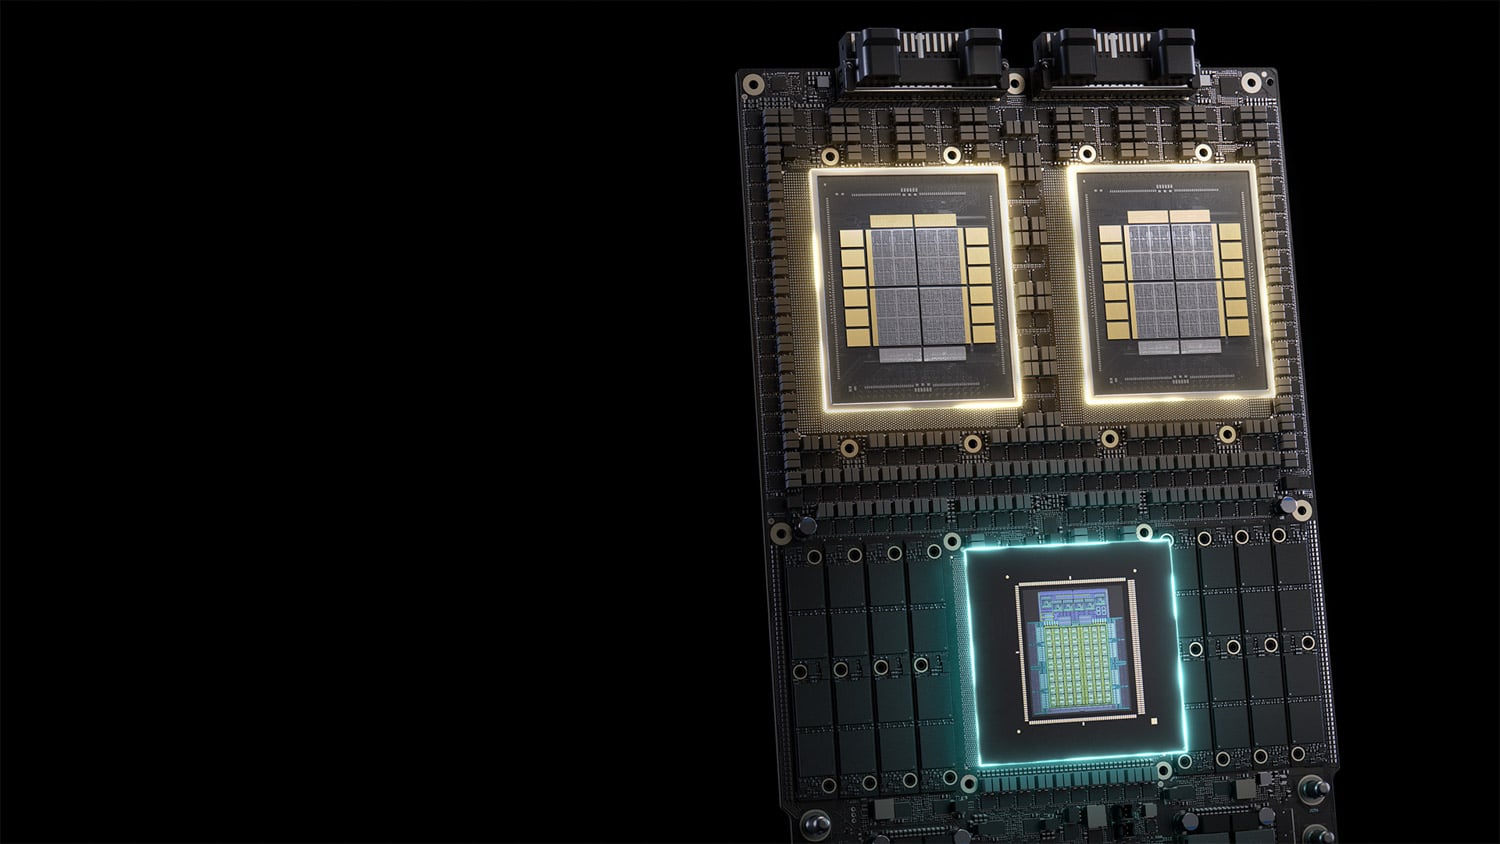
NVLink Fusion conecta las NPU R200
Rebellions está diseñando el R200 para inferencia de baja latencia y eficiencia energética en modelos de vanguardia, incluidos modelos de mezcla de expertos con billones de parámetros. NVLink Fusion es el programa de NVIDIA para integrar silicio personalizado en su arquitectura de escalado: un fabricante de chips integra NVLink en su procesador y obtiene acceso a la conmutación NVLink de NVIDIA, su red de alto ancho de banda y baja latencia, y el ecosistema de infraestructura circundante. Rebellions planea usarlo para conectar las NPU R200 dentro de un rack a través de la red de escalado NVLink y para integrar esos procesadores en la plataforma NVIDIA como parte de un sistema a escala de rack.
Las empresas no han revelado las especificaciones del R200, el ancho de banda de NVLink por NPU ni los resultados de rendimiento de la configuración prevista. Rebellions menciona el Rebel100 como su chip actual, y el anuncio del R200 no menciona nada sobre la memoria, el proceso de fabricación ni el consumo de energía, por lo que se desconoce el salto entre ambas generaciones.
La arquitectura de rack MGX admite el desarrollo de sistemas.
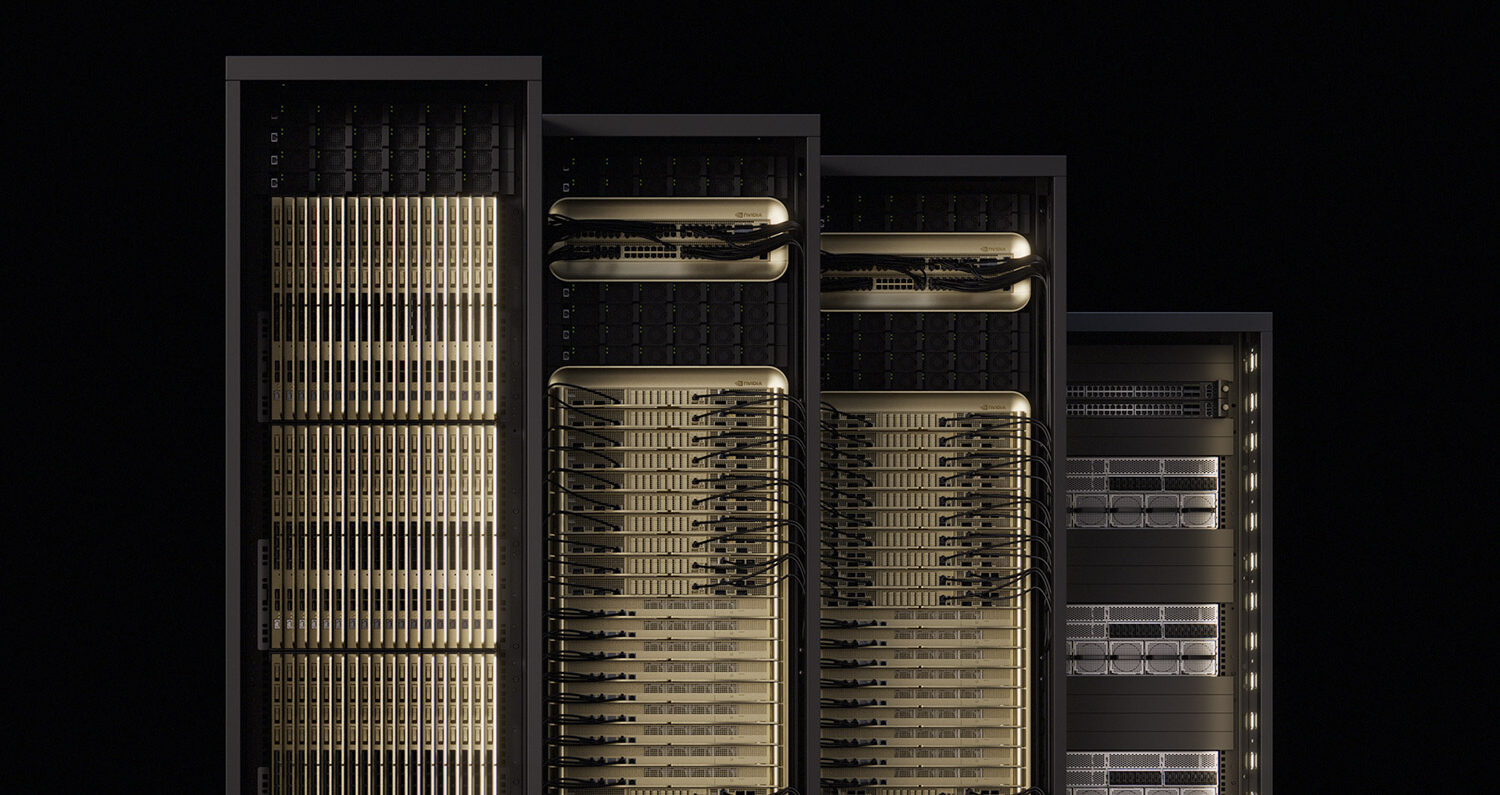
La arquitectura de rack MGX de NVIDIA y sus diseños de referencia proporcionan a Rebellion un punto de partida para el sistema, además de acceso a los fabricantes de diseño original y a los proveedores de componentes que ya fabrican hardware MGX. MGX define los componentes compartidos de un rack, incluyendo el espacio físico, la alimentación y la refrigeración, de modo que los sistemas GPU y NPU pueden ocupar el mismo centro de datos. SK Telecom planea implementar los sistemas R200 en su centro de datos de IA sobre el rack MGX estandarizado, lo que le permite planificar la alimentación y la refrigeración antes de que el procesador esté finalizado.
GPU para prellenado, NPU para decodificación
El detalle técnico más interesante es la división del proceso de inferencia que las tres compañías planean desarrollar. La inferencia consta de dos fases con diferentes requisitos de hardware: precarga, que procesa la solicitud y suele estar limitada por la capacidad de cómputo, y decodificación, que genera tokens uno a uno y suele estar limitada por el ancho de banda de la memoria y la latencia. La configuración propuesta ejecuta la precarga en GPU de NVIDIA y la decodificación en NPU de Rebellion, conectadas ambas a través de la red NVLink.
Los objetivos declarados son un mayor rendimiento de inferencia y una mejor eficiencia energética. La ventaja de delegar la decodificación a una NPU sigue siendo una intención de diseño hasta que existan sistemas, pero la lógica tiene sentido en teoría. El prellenado y la decodificación desagregados ya son una práctica común en los grupos de GPU, incluido el marco de servicio Dynamo de NVIDIA; la novedad reside en separar las dos fases entre diferentes arquitecturas de procesador a través de NVLink.
Sunghyun Park, cofundador y director ejecutivo de Rebellions, afirmó que la colaboración combina el silicio de IA y el diseño de sistemas de la compañía con las capacidades de interconexión y a escala de rack de NVIDIA, así como con los modelos y las operaciones de centros de datos de SK Telecom, con el objetivo de lograr una inferencia de baja latencia y eficiencia energética para modelos de vanguardia a gran escala.
SK Telecom conecta modelos y servicios
SK Telecom aporta los modelos y los clientes. Planea ejecutar sus modelos de base patentados, incluido AX K2, en la infraestructura, junto con servicios de cara al público desarrollados a través del proyecto IA para Todos del gobierno coreano. Las operaciones, los modelos y los servicios del centro de datos de SK Telecom completan lo que las empresas describen como una estrategia integral de IA soberana, y este trabajo se basa en la alianza más amplia entre SK y NVIDIA presentada en la Cumbre de IA de Corea en julio.
El Ministerio de Ciencia y TIC de Corea respalda la colaboración entre NVIDIA y las empresas coreanas de NPU, comenzando con Rebellions y SK Telecom, y ha anunciado una cooperación más amplia que abarca la IA física y el suministro de GPU. El objetivo es ofrecer servicios de IA adaptados al idioma, las industrias y las prioridades de Corea, tanto en el sector público como en el privado.
Disponibilidad
Se prevé que los sistemas Rebellion R200 estén listos para su despliegue en 2028. No hay calendario de muestras, programa de acceso anticipado, fecha de disponibilidad general ni precios.


 Amazon