

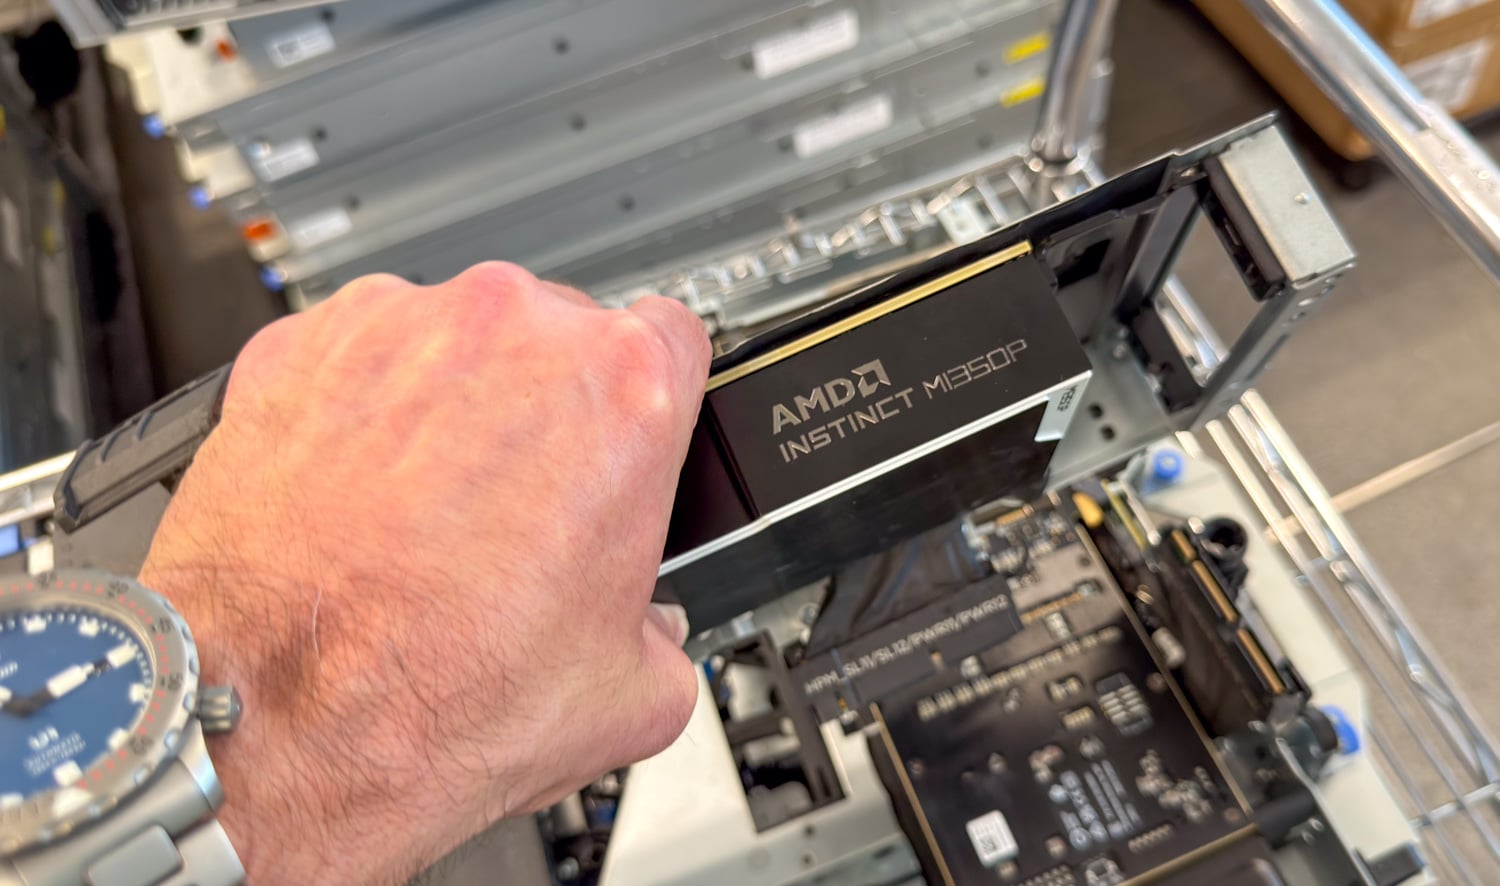
La AMD Instinct MI350P es la primera GPU Instinct PCIe nueva de AMD en cuatro años, tras la MI210 lanzada en 2022. Incorpora la arquitectura CDNA 4 de la compañía a una tarjeta de expansión convencional, con un rendimiento MXFP4 de hasta 4.6 PFLOPS, 144 GB de HBM3E y un ancho de banda de memoria de 4 TB/s. Todo esto se integra en una tarjeta de doble ranura con refrigeración por aire de 600 W, lo que ofrece a los clientes otra forma de implementar GPU Instinct sin tener que recurrir a la plataforma OAM MI350/5X de 8 GPU.
Puntos Clave
- La principal novedad es su capacidad de 144 GB en una ranura PCIe. La MI350P cuenta con la mayor cantidad de memoria de cualquier acelerador PCIe actual, 3 GB más que la H200 NVL y 48 GB más que la RTX PRO 6000 Blackwell, con 4 TB/s de HBM3E como respaldo, y diez de las catorce combinaciones de modelo y precisión en esta reseña funcionaron con una sola tarjeta.
- Se midieron las áreas de procesamiento entre las dos tarjetas NVIDIA. Con 450 W, MAMF alcanzó 580 TFLOPS en BF16, 1,120 en FP8 y 2,228 en FP4 con escalado de bloques, entre un 36 y un 38 por ciento por encima de una RTX PRO 6000 de 600 W en todos los niveles de precisión y por detrás de la H200 NVL en BF16 y FP8, que no tiene ruta FP4.
- GPT-OSS es el mejor resultado del MI350P. En AMDGPU 31.60, ROCm 10.1.0 y vLLM 0.32.0, GPT-OSS-120B alcanzó 5,057 tokens de salida por segundo con 128 flujos en la carga de trabajo de chat, un 65 por ciento por delante de la RTX PRO 6000 y un 50 por ciento por delante de la H200 NVL, y la curva sigue ascendiendo a través de 128 flujos en ambas formas de aviso.
- Las indicaciones breves para chats dan mejores resultados en el MI350P; las indicaciones largas generan opiniones encontradas. En las solicitudes de 512 tokens, la tarjeta supera a la RTX PRO 6000 en todos los modelos FP8, BF16 y GPT-OSS entre un 35 y un 65 por ciento en 128 flujos, y los dos enfrentamientos FP4 contra NVFP4 están dentro de un 5 y un 21 por ciento, mientras que en las solicitudes de 8,192 tokens lidera en GPT-OSS y Mistral Small y se queda atrás en Llama, Qwen FP8 y MiniMax-M2.7, donde su curva se aplana pronto.
- Los resultados de dos tarjetas están en ROCm 7.2.3. DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2, and GLM-5.3 Flash are reported from runs on that stack, because the ROCm 10.1 passes on those models used CPU expert offload and, on DeepSeek, a speculative decoder the NVIDIA runs did not.
- La cuestión de los 600 W sigue abierta. Dell documenta el funcionamiento de ocho fuentes de alimentación MI350P a 600 W en el PowerEdge XE7745, y está previsto realizar una prueba posterior a plena potencia.
AMD también presentó el MI350P en la IFA 2026 en su prototipo Threadripper Halo Station, donde los mismos aceleradores contaban con refrigeración líquida. El concepto de estación de trabajo admite hasta cuatro MI350P junto con un procesador Threadripper PRO de 96 núcleos, lo que proporciona una capacidad agregada de 576 GB de HBM3E en una sola máquina; la página de producto de AMD, actualizada en octubre, ahora indica que el sistema estará disponible en 2027. Esto nos da dos maneras de ver el MI350P: como un acelerador PCIe para servidores y como el componente básico para un sistema de IA de escritorio más grande que compita con máquinas como la estación GB300 DGX.
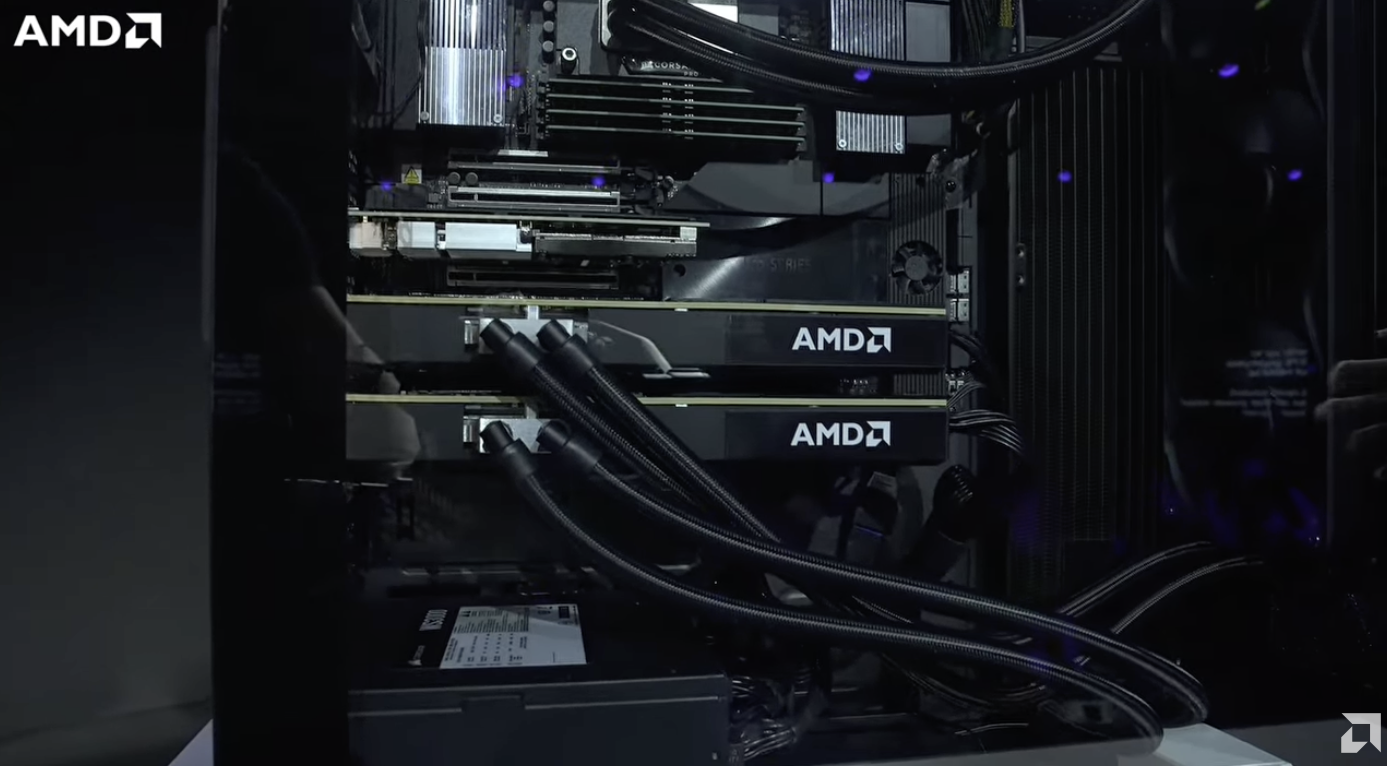
Este primer análisis se centra en la perspectiva del servidor, por lo que la comparación relevante para un comprador que especifica un acelerador PCIe es la NVIDIA RTX PRO 6000 Blackwell, la tarjeta que se encuentra en la misma clase de potencia y en las mismas ranuras, y la H200 NVL aparece en las tablas como la tarjeta de expansión NVIDIA más capaz para las cargas de trabajo donde el ancho de banda de la memoria determina el resultado. Una única estación GB300 DGX representa la perspectiva del escritorio; es una máquina de una clase diferente a un precio diferente, y está ahí para mostrar qué tan lejos se sitúa una GPU Blackwell Ultra completa por encima de cualquiera de las tarjetas PCIe.
Especificaciones del AMD Instinct MI350P
Las cifras publicadas por AMD hacen que la MI350P destaque por su baja precisión: 4.6 PFLOPS en MXFP4 y MXFP6, 2.3 PFLOPS en FP8 y 1.15 PFLOPS en FP16 o BF16, cifras muy elevadas. El sistema de memoria es la otra mitad de la tarjeta: 144 GB de HBM3E en una interfaz de 4,096 bits a 4 TB/s, detrás de una Infinity Cache de 128 MB, en la que se basan los resultados de flujo único que se muestran a continuación. El consumo de la placa es de 600 W con un modo configurable de 450 W; nuestra unidad de prueba funcionó a 450 W.
La MI350P utiliza la misma arquitectura CDNA 4 que las GPU MI350/5X, de mayor tamaño y potencia. La MI350P puede considerarse, en esencia, como la mitad de una MI350X. Para comprender el porqué, conviene analizar cómo se ensambla la GPU de mayor tamaño.
El MI350X es un diseño de chiplets apilados en 3D basado en el empaquetado CoWoS (Chip-on-Wafer-on-Substrate) de TSMC, sin un único chip monolítico. Ocho chips aceleradores (XCD) se sitúan sobre dos chips de E/S, con cuatro XCD en cada chip de E/S. La tecnología Infinity Fabric de AMD conecta los chiplets, mientras que ocho pilas HBM3E proporcionan la memoria de la GPU. CoWoS describe la integración a nivel de paquete; la configuración de computación sobre E/S es el componente vertical apilado en 3D del diseño.

La MI350P utiliza la mitad de esa configuración: cuatro XCD, un chip de E/S y cuatro pilas HBM3E. Cada XCD tiene 32 unidades de cómputo activas, lo que le da a la tarjeta 128 CU en comparación con las 256 de la MI350X. Los recursos de memoria también se reducen a la mitad: 144 GB de HBM3E frente a 288 GB, 4 TB/s de ancho de banda frente a 8 TB/s y 128 MB de Infinity Cache frente a 256 MB.

| Especificación | AMD Instinct MI350P |
|---|---|
| Descripción general de la plataforma | |
| Arquitectura de interiores | ADNC 4 |
| Calcular unidades | 128 |
| Procesadores de flujo | 8,192 |
| Núcleos de matriz | 512 |
| Proceso | TSMC de 3 nm y 6 nm |
| Transistores | 73 mil millones |
| Reloj de motor de máxima potencia | 2,200MHz |
| Salud Cerebral | |
| CAPACIDAD | HBM3E de 144 GB |
| Fácil de usar | 4,096 bits |
| Ancho de banda | 4 TB / s |
| caché de último nivel | 128MB |
| ECC | Chip completo |
| Rendimiento máximo (según AMD) | |
| MXFP4 | 4.6 PFLOPS |
| MXFP6 | 4.6 PFLOPS |
| MXFP8 | 2.3 PFLOPS |
| OCP FP8 | 2.3 PFLOPS; 4.6 PFLOPS con escasez estructurada |
| FP16 | 1.15 PFLOPS; 2.3 PFLOPS con escasez |
| BF16 | 1.15 PFLOPS; 2.3 PFLOPS con escasez |
| FP32 | 72 TFLOPS |
| FP64 | 36 TFLOPS |
| Potencia, refrigeración y factor de forma | |
| Potencia de tablero típica | 600 W máximo; 450 W configurable |
| Conector de alimentación | 12V-2×6 |
| Enfriamiento | Pasiva |
| Factor de forma | Tarjeta de expansión PCIe, de altura completa, doble ranura |
| Longitud del tablero | 10.5 pulgadas (267 mm) |
| Interfaz de host | PCIe 5.0 x16 |
| Caracteristicas | |
| SR-IOV | Sí: |
| Caché infinito | Sí: |
| RAS | Sí: |
| Página de jubilación y evitación | Sí: |
La cifra de 600 W es el máximo, y AMD permite configurar la tarjeta hasta 450 W, que es donde funcionó en nuestro host 2U. La H200 NVL igualó su consumo a 450 W en el R770, pero la RTX PRO 6000 funcionó a su máxima potencia de 600 W en el XE7740, por lo que la tarjeta NVIDIA tenía 150 W más de margen en todas las comparaciones. Los resultados a plena potencia se obtienen con un chasis que pueda refrigerar una tarjeta pasiva de 600 W, y la guía técnica del Dell XE7745 incluye ocho MI350P a 600 W.
Otro aspecto a destacar es el conector único de 12 V-2×6 y la placa de 10.5 pulgadas con doble ranura, que es lo que permite que la tarjeta se instale en los mismos adaptadores que actualmente alojan una RTX PRO 6000 o una H200 NVL.

La tabla que aparece a continuación sitúa al MI350P junto a los tres sistemas NVIDIA de nuestros gráficos: el RTX PRO 6000 Blackwell Server Edition, que comparte su ranura, su rango de potencia y su enlace de host PCIe 5.0 x16; el H200 NVL, la tarjeta Hopper con el ancho de banda de memoria correspondiente; y la GB300 DGX Station, una única GPU Blackwell Ultra combinada con una CPU Grace a través de NVLink-C2C.
Las filas que hay que leer primero son la capacidad de memoria, donde los 144 GB de la MI350P son la mayor de las tres tarjetas PCIe, 3 GB por encima de la H200 NVL y 48 GB por encima de la RTX PRO 6000; el ancho de banda de la memoria, donde sus 4 TB/s se sitúan entre las dos; y la línea FP4, donde AMD cita una cifra densa y NVIDIA cita una escasa.
| Especificación | AMD Instinct MI350P | NVIDIA RTX PRO 6000 Blackwell Server Edition | NVIDIA H200 NVL PCIe | Estación NVIDIA GB300 DGX |
|---|---|---|---|---|
| Arquitectura GPU | ADNC 4 | Blackwell | Hopper | Blackwell Ultra |
| Factor de forma | acelerador PCIe | acelerador PCIe | acelerador PCIe | Una GPU Blackwell Ultra combinada con una CPU Grace de 72 núcleos. |
| memoria GPU | HBM3E de 144 GB | 96 GB GDDR7 ECC | HBM3E de 141 GB | HBM3E de 252 GB |
| Ancho de banda de la memoria de la GPU | 4 TB / s | 1.6 TB / s | 4.8 TB / s | 7.1 TB / s |
| FP4 | 4.6 PFLOPS MXFP4 (denso) | 4 PFLOPS NVFP4 (disperso) | No hay FP4 nativo | 20 PFLOPS NVFP4 (disperso) |
| FP8 | 2.3 PFLOPS (denso) | 2 PFLOPS (disperso) | 3.3 PFLOPS (disperso) | 10 PFLOPS (disperso) |
| BF16 | 1.15 PFLOPS (denso) | 1 PFLOPS (disperso) | 1.6 PFLOPS (disperso) | 5 PFLOPS (disperso) |
| FP32 | 72 TFLOPS (denso) | 120 TFLOPS (dispersos) | 60 TFLOPS (dispersos) | 80 TFLOPS (dispersos) |
| Conexión con el host | PCIe 5.0 x16 | PCIe 5.0 x16 | PCIe 5.0 x16 | NVLink-C2C entre Grace y la GPU, 900 GB/s (BiDi) |
| Conectividad multi-GPU | Basado en PCIe | Basado en PCIe | NVLink de dos o cuatro vías, hasta 900 GB/s por GPU (BiDi) | Red ConnectX-8 de 800 Gb/s entre estaciones. |
| Potencia | Configurable de 450 a 600 W | Configurable de 300 a 600 W | Configurable de 450 a 600 W | GPU de hasta 1200 W con oscilación de potencia |
En comparación con la RTX PRO 6000, la diferencia más evidente del MI350P reside en su subsistema de memoria. Cuenta con un 50 % más de memoria GPU y aproximadamente 2.5 veces más ancho de banda. Para un modelo que no se ajusta cómodamente a los 96 GB, la capacidad adicional podría determinar si funciona con una sola GPU o si necesita distribuirse entre varias.
La RTX PRO 6000, sin embargo, admite una gama más amplia de cargas de trabajo, con hardware para gráficos, trazado de rayos y vídeo, además de sus capacidades de IA. La elección va más allá de dos cifras de potencia máxima de procesamiento; también depende de las demás tareas que necesite realizar el sistema.
La H200 NVL es la comparación más directa para la MI350P entre los aceleradores PCIe de alta memoria; las GPU Blackwell para centros de datos, de mayor tamaño, pertenecen a una categoría diferente. La capacidad de memoria es casi idéntica, con 144 GB frente a los 141 GB de la H200, ambas con HBM3E, y la H200 ofrece un 20 % más de ancho de banda de memoria, a 4.8 TB/s. Además, su escalabilidad es diferente: las tres tarjetas PCIe se conectan al host mediante PCIe, pero la H200 NVL añade conectividad dedicada entre GPU a través de puentes NVLink que conectan hasta cuatro GPU.
Los modelos MI350X y MI355X, de mayor tamaño, se diseñaron para competir con Blackwell, pero el MI350P reduce a la mitad esa configuración de hardware. Esto lo acerca al H200 NVL en cuanto a características de memoria y posicionamiento general. Un aspecto en el que el MI350P aún se distingue es la compatibilidad nativa con MXFP4 y MXFP6, algo que cobra mayor importancia a medida que la inferencia se orienta hacia una menor precisión.
El subsistema de memoria más pequeño supone otra desventaja, ya que AMD no ha compensado la reducción de pilas HBM con una HBM3E más rápida, lo que deja al MI350P con un ancho de banda de 4 TB/s y por detrás del H200 NVL en este aspecto. Esto puede limitar el rendimiento en cargas de trabajo con limitaciones de ancho de banda de memoria, independientemente de la capacidad de cómputo disponible, como demuestran los resultados de ancho de banda de memoria e inferencia de larga duración que se muestran más adelante en el análisis.
La comparación de la estación DGX se realiza en sentido contrario, ya que la estación GB300 lleva una GPU B300 completa con una pila HBM deshabilitada, un chip de clase de centro de datos con un presupuesto de energía de centro de datos, mientras que la MI350P es la mitad de un chip de clase de centro de datos instalado en el encapsulado de 600 W de una tarjeta de expansión PCIe. AMD necesita dos o cuatro MI350P para igualar esa GPU única, y en teoría dos de ellas lo hacen: 288 GB y 8 TB/s frente a los 252 GB y 7.1 TB/s de la estación. Sin embargo, esos recursos se encuentran en dos tarjetas, y una carga de trabajo que abarca ambas intercambia datos a través de PCIe peer-to-peer, lo que limita lo que la segunda tarjeta puede agregar.
Rendimiento
Plataforma de prueba
La unidad de prueba MI350P es un Dell PowerEdge R7725 con dos procesadores AMD EPYC 9555 (64 núcleos cada uno), 1.5 TB de DDR5-6400 distribuidos en 24 DIMM y dos tarjetas MI350P configuradas a 450 W, el límite para un servidor 2U. Las tarjetas RTX PRO 6000 Blackwell Server Edition (600 W) se ejecutaron en el Dell PowerEdge XE7740 que aloja nuestra configuración de inferencia de cuatro tarjetas, una sola H200 NVL (450 W) se ejecutó en el Dell PowerEdge R770 de nuestra prueba, y las cifras de GB300 provienen de la estación ASUS ExpertCenter Pro ET900N G3 DGX que analizamos en septiembre.

El inventario de iDRAC que se muestra a continuación ilustra cómo están instaladas las dos tarjetas. Se ubican en las ranuras PCIe 2 y 7, ambas Gen5 x16 y con estado correcto. Las claves de dispositivo, 0-139-0 y 1-199-0, indican que hay una tarjeta detrás de cada zócalo EPYC, por lo que el tráfico en paralelo tensorial entre las dos MI350P atraviesa el enlace del zócalo en su recorrido entre los complejos raíz. Esta es la configuración predeterminada para una implementación de dos tarjetas en un servidor 2U, y conviene tenerla en cuenta en los resultados posteriores.

La vista de memoria muestra el resto del host: 24 módulos DIMM de 64 GB DDR5-6400, de doble rango, para un total de 1,536 GB en un servidor que alcanza un máximo de 6 TB, todos con ECC multibit. El espacio disponible es importante para la ejecución de GLM-5.2, donde el punto de control MXFP4 no cabe en los 288 GB de dos tarjetas y vLLM descarga parte de los pesos del experto a la memoria del host.

Máximos FLOPS alcanzables de Matmul (MAMF)
Para contextualizar el rendimiento computacional del MI350P, ejecutamos MAMF en los cuatro sistemas. MAMF (Maximum Achievable Matmul FLOPS) es una métrica de rendimiento práctica diseñada para medir el pico realista de operaciones de punto flotante por segundo que alcanza un acelerador durante la multiplicación de matrices, un punto de referencia más útil que el pico teórico de FLOPS que aparece en la hoja de especificaciones. Analizamos cada sistema en BF16, FP8 y FP4 con escalado de bloques, e informamos del mejor resultado denso sostenido por precisión; las barras rayadas multiplican el resultado de cada tarjeta PCIe por el número de tarjetas utilizadas en las ejecuciones de servicio de modelos grandes y se calculan sin ninguna medición previa.

Con un consumo de 450 W, una MI350P alcanza los 580 TFLOPS en BF16, 1,120 en FP8 y 2,228 en FP4. La RTX PRO 6000 Blackwell le sigue con 419, 820 y 1,634, por lo que la MI350P mantiene una ventaja de entre el 36 y el 38 por ciento sobre la tarjeta NVIDIA en todos los niveles de precisión, a pesar de consumir 150 W menos, con la mayor diferencia en BF16, del 38.4 por ciento.
Los 652 TFLOPS de la H200 NVL en BF16 y 1,205 en FP8 la sitúan por delante de la MI350P en ambos, y no dispone de una ruta FP4. La GB300 DGX Station supera a las tres tarjetas PCIe con 1,924, 3,802 y 6,024, aproximadamente 3.3 veces la MI350P en BF16 y 2.7 veces en FP4; dos MI350P, sobre el papel, alcanzan cerca de 1,160 y 4,456, aún por debajo de la GPU única de la Station. Las cifras de NVIDIA MAMF de esta reseña provienen de nuestras últimas pruebas en cada tarjeta y sustituyen los resultados de nuestras pruebas anteriores.
Ancho de banda de memoria GPU
El rendimiento de cálculo bruto solo es útil si el acelerador puede suministrar datos a sus unidades de ejecución. Esto es especialmente importante para la inferencia, donde la generación de tokens durante la fase de decodificación está más limitada por el ancho de banda de la memoria que por los FLOPS disponibles. La prueba de ancho de banda lee, escribe y copia la memoria de la GPU a través de los núcleos de cálculo y el motor de copia, mostrando el ancho de banda disponible en cada GPU en comparación con su valor nominal.

Una MI350P lee su HBM3E a 3,291 GB/s y escribe a 3,204 GB/s, aproximadamente el 80 % de la velocidad nominal de 4 TB/s, con copias a velocidades de entre 1,276 y 1,283 GB/s; una copia consume ancho de banda dos veces, una para leer el origen y otra para escribir el destino. La GDDR7 de la RTX PRO 6000 alcanza 1,540 GB/s en lectura y 1,483 GB/s en escritura, por lo que la MI350P ofrece aproximadamente 2.1 veces el ancho de banda utilizable por tarjeta.
Las cifras de lectura de 4,472 GB/s y de escritura de 4,156 GB/s del H200 NVL superan en un 36 % y un 30 % respectivamente a las del MI350P, en línea con su clasificación de 4.8 TB/s frente a los 4 TB/s, mientras que la estación GB300 DGX alcanza los 6,869 GB/s. Dos MI350P medidas conjuntamente alcanzan los 6,529 GB/s en lectura, cerca de la estación, pero ese ancho de banda se encuentra en dos ranuras PCIe, y un modelo que abarque ambas paga por cada intercambio a través de PCIe.
Inferencia
Una vez cubiertas las pruebas de bajo nivel, pasamos a la inferencia LLM. Nuestra prueba de servicio en línea vLLM impulsa un punto final compatible con OpenAI con un número fijo de flujos concurrentes y registra tokens de salida por segundo durante la ejecución. Informamos dos formas: 512 tokens de entrada y 512 de salida, que es del tamaño de un chat y requiere mucha decodificación, y 8,192 de entrada y 1,024 de salida, que es del tamaño de un RAG y un documento y se apoya en el prellenado. La concurrencia se duplica a partir de un flujo, y cada gráfico se detiene en la concurrencia más alta en la que se completaron todas las tarjetas en él. Cada punto son dos solicitudes por flujo, por lo que las cifras de un solo flujo se basan en dos solicitudes y tienen más varianza entre ejecuciones que los puntos de mayor concurrencia.
Cada modelo se ejecutó en la menor cantidad de tarjetas que podían soportarlo: una MI350P para todo hasta GPT-OSS-120B y MiniMax-M2.7, y dos para DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2 y GLM-5.3 Flash. Las ejecuciones de RTX PRO 6000 siguen la misma regla, que coloca dos tarjetas RTX contra una MI350P en MiniMax-M2.7 y cuatro contra dos en MiniMax-M3 y GLM-5.2. Las compilaciones de baja precisión difieren según el fabricante: las de AMD son MXFP4 hasta Quark, las de NVIDIA son NVFP4, y los pares FP4 están etiquetados de esa manera en todo el documento. GPT-OSS se envía como MXFP4 y ejecuta los mismos pesos en cada tarjeta. Las compilaciones H200 NVFP4 no están incluidas.
| Modelo | MI350P | RTX PRO 6000 Blackwell | H200 NVL | Estación GB300 DGX |
|---|---|---|---|---|
| GLM-5.3 Flash | 2 tarjetas, MXFP4 | No se ejecuta | No se ejecuta | NVFP4 |
| GLM-5.2 | 2 tarjetas, MXFP4 (descarga a la memoria del host) | 4 tarjetas, NVFP4 | No se ejecuta | NVFP4 (aproximadamente 215 GB de memoria Grace para expertos) |
| MiniMax-M3 | 2 tarjetas, MXFP4 | 4 tarjetas, NVFP4 | No se ejecuta | NVFP4 (un grupo de expertos en memoria de Grace) |
| Flash DeepSeek-V4 | 2 tarjetas, FP8 | 2 tarjetas, FP8 | No se ejecuta | FP8 |
| MiniMax-M2.7 | 1 tarjeta, MXFP4 | 2 tarjetas, NVFP4 | No se ejecuta | NVFP4 |
| GPT-OSS-120B | 1 tarjeta, MXFP4 | 1 tarjeta, MXFP4 | 1 tarjeta, MXFP4 | MXFP4 |
| GPT-OSS-20B | 1 tarjeta, MXFP4 | 1 tarjeta, MXFP4 | 1 tarjeta, MXFP4 | MXFP4 |
| Codificador Qwen3-30B-A3B | 1 tarjeta, FP8 y BF16 | 1 tarjeta, FP8 y BF16 | 1 tarjeta, FP8 y BF16 | FP8 y BF16 |
| Mistral Pequeño 3.1 24B | 1 tarjeta, FP8 y BF16 | 1 tarjeta, FP8 y BF16 | 1 tarjeta, FP8 y BF16 | FP8 y BF16 |
| Llama 3.1 8B | 1 tarjeta, MXFP4, FP8 y BF16 | 1 tarjeta, NVFP4, FP8 y BF16 | 1 tarjeta, FP8 y BF16 | NVFP4, FP8 y BF16 |
Si lees la columna MI350P, lo primero que te ofrece 144 GB es la cantidad de tarjetas. Seis de los diez modelos funcionan con un MI350P, donde los 96 GB de la RTX PRO 6000 necesitan una segunda tarjeta para MiniMax-M2.7, y los dos puntos de control MXFP4 que se quedan en un par de MI350P, MiniMax-M3 y GLM-5.2, necesitan cuatro RTX PRO 6000. GLM-5.2 es el que supera incluso los 288 GB, y vLLM descarga parte de sus pesos expertos a la memoria host del R7725 para esa ejecución; el GB300 hace lo mismo con unos 215 GB de expertos en memoria Grace.
Las cifras del MI350P para los modelos de una sola tarjeta se obtuvieron el 27 de octubre con AMDGPU 31.60, ROCm 10.1.0 y vLLM 0.32.0. La combinación validada por Dell es vLLM 0.27 con ROCm 10.0 y AMDGPU 31.5, y nosotros fuimos un paso más allá con la versión ROCm 10.1 del 5 de octubre. Las tarjetas NVIDIA ejecutaron el contenedor vLLM 26.08 en CUDA 13.4.1 en todo momento. La tabla muestra la compilación de cada ejecución.
| Modelo | Imagen vLLM |
|---|---|
| AMD Instinct MI350P | |
| DeepSeek-V4-Flash-0731 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GLM-5.2 MXFP4 | vllm/vllm-openai-rocm:v0.27.1 (ROCm 7.2.3) |
| GLM-5.3 Flash MXFP4 | vllm/vllm-openai-rocm@sha256:a78d3e91404e7875aa650a61dea580a9e26d72553bee9ae5b93dbdef7107594d (ROCm 7.2.3) |
| GPT-OSS-120B MXFP4 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| GPT-OSS-20B MXFP4 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| Llama 3.1 8B BF16 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| Llama 3.1 8B FP8 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| Llama 3.1 8B MXFP4 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| MiniMax-M2.7 MXFP4 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| MiniMax-M3 MXFP4 | vllm/vllm-openai-rocm:nightly-2a02f6efe319c885e3ccbcecde402e0028f9ec1e (ROCm 7.2.3) |
| Mistral Pequeño 3.1 24B BF16 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| Mistral Pequeño 3.1 24B FP8 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| Qwen3-Coder-30B BF16 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| Qwen3-Coder-30B FP8 | vLLM 0.32.0 en ROCm 10.1.0, AMDGPU 31.60 (27 de octubre) |
| NVIDIA RTX PRO 6000 Blackwell Server Edition (CUDA 13.4.1.012) | |
| DeepSeek-V4-Flash-0731 | nvcr.io/nvidia/vllm:26.08-py3 |
| GLM-5.2 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M2.7 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| MiniMax-M3 NVFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Pequeño 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Pequeño 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| NVIDIA H200 NVL (CUDA 13.4.1.012) | |
| GPT-OSS-120B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| GPT-OSS-20B MXFP4 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Llama 3.1 8B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Pequeño 3.1 24B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Mistral Pequeño 3.1 24B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B BF16 | nvcr.io/nvidia/vllm:26.08-py3 |
| Qwen3-Coder-30B FP8 | nvcr.io/nvidia/vllm:26.08-py3 |
The four two-card models, DeepSeek-V4-Flash, MiniMax-M3, GLM-5.2, and GLM-5.3 Flash, are reported from runs on ROCm 7.2.3. Our ROCm 10.1 passes on those models used CPU expert offload throughout and, on DeepSeek-V4-Flash, a speculative decoder the NVIDIA runs did not, which makes them a different test, so they are held for a clean pass on the current stack, and the tables label every MI350P row with its stack.
La opción preferida de AMD para estos modelos son sus contenedores AIM; la versión 2.5 de Enterprise AI Suite, lanzada el 9 de octubre, está validada en ROCm 10 e incluye AIM para GPT-OSS-120B, Llama 3.3 70B y Gemma 3 27B, pero la tabla de aceleradores de AMD solo muestra un perfil MI350P optimizado para Wan2.2 hasta el momento. Por lo tanto, vLLM estándar sigue siendo la opción que elige un comprador de MI350P hoy en día, y es lo que medimos.
Resultados de la inferencia de un vistazo
A continuación se muestran 28 gráficos, así que aquí está la versión corta en dos tablas: tokens de salida por segundo para cada modelo con la concurrencia más alta para cada tarjeta completada, con la carga de trabajo de tamaño chat de 512 entradas y 512 salidas primero. Las cifras del MI350P corresponden a una tarjeta de 450 W a menos que la fila indique lo contrario, con una columna para la pila de la que proviene cada fila; la estación GB300 DGX es una sola B300.
| Modelo | Tarjetas (MI350P / RTX PRO 6000) | Pila MI350P | MI350P | RTX PRO 6000 | H200 NVL | Estación GB300 DGX | |
|---|---|---|---|---|---|---|---|
| Memoria Flash GLM-5.3 (MXFP4 frente a NVFP4) | 2 / ninguno | ROCm 7.2.3 | 32 | 1,462 | No se ejecuta | No se ejecuta | 828 |
| GLM-5.2 (MXFP4 frente a NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 59 | 40 | No se ejecuta | 139 |
| MiniMax-M3 (MXFP4 frente a NVFP4) | 2 / 4 | ROCm 7.2.3 | 32 | 1,509 | 759 | No se ejecuta | 1,041 |
| Flash DeepSeek-V4 | 2 / 2 | ROCm 7.2.3 | 32 | 1,081 | 829 | No se ejecuta | 1,766 |
| MiniMax-M2.7 (MXFP4 frente a NVFP4) | 1 / 2 | ROCm 10.1 | 128 | 1,524 | 1,932 | No se ejecuta | 4,793 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 5,057 | 3,064 | 3,376 | 9,280 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 10,726 | 7,937 | 6,022 | 22,041 |
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 6,451 | 3,995 | 7,459 | 12,439 |
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 4,696 | 2,881 | 5,240 | 10,000 |
| Mistral Pequeño 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 4,458 | 3,242 | 4,624 | 11,075 |
| Mistral Pequeño 24B BF16 | 1 / 1 | ROCm 10.1 | 128 | 3,065 | 2,026 | 3,373 | 7,861 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 8,383 | 8,869 | No se ejecuta | 28,400 |
| Llama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 11,045 | 8,073 | 11,054 | 25,602 |
| Llama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 6,819 | 4,740 | 8,069 | 17,074 |
En la tabla de resultados destacan dos aspectos: la MI350P supera a la RTX PRO 6000 en todos los modelos FP8, BF16 y GPT-OSS, entre un 35 y un 65 por ciento a 128 flujos, solo se queda atrás de las compilaciones NVFP4 de NVIDIA en la parte superior de las curvas Llama y MiniMax-M2.7, y prácticamente duplica el rendimiento de la tarjeta NVIDIA en un solo flujo en Llama 3.1 8B y Mistral Small 24B, donde la memoria HBM3E de 4 TB/s realiza el trabajo.
El H200 NVL, con un 20 por ciento más de ancho de banda, se mantiene entre un 4 y un 18 por ciento por delante en los modelos FP8 y BF16 densos a 128 flujos y empata en Llama 3.1 8B FP8; en los dos modelos GPT-OSS el orden se invierte, y el MI350P termina con un 50 y un 78 por ciento de ventaja.
La segunda tabla repite el ejercicio con las indicaciones de 8,192 tokens, donde el prellenado domina la ejecución y el equilibrio entre el ancho de banda de cómputo y de memoria se desplaza hacia las tarjetas NVIDIA.
| Modelo | Tarjetas (MI350P / RTX PRO 6000) | Pila MI350P | MI350P | RTX PRO 6000 | H200 NVL | Estación GB300 DGX | |
|---|---|---|---|---|---|---|---|
| Memoria Flash GLM-5.3 (MXFP4 frente a NVFP4) | 2 / ninguno | ROCm 7.2.3 | 32 | 760 | No se ejecuta | No se ejecuta | 1,219 |
| GLM-5.2 (MXFP4 frente a NVFP4) | 2 / 4 | ROCm 7.2.3 | 16 | 6 | 9 | No se ejecuta | 87 |
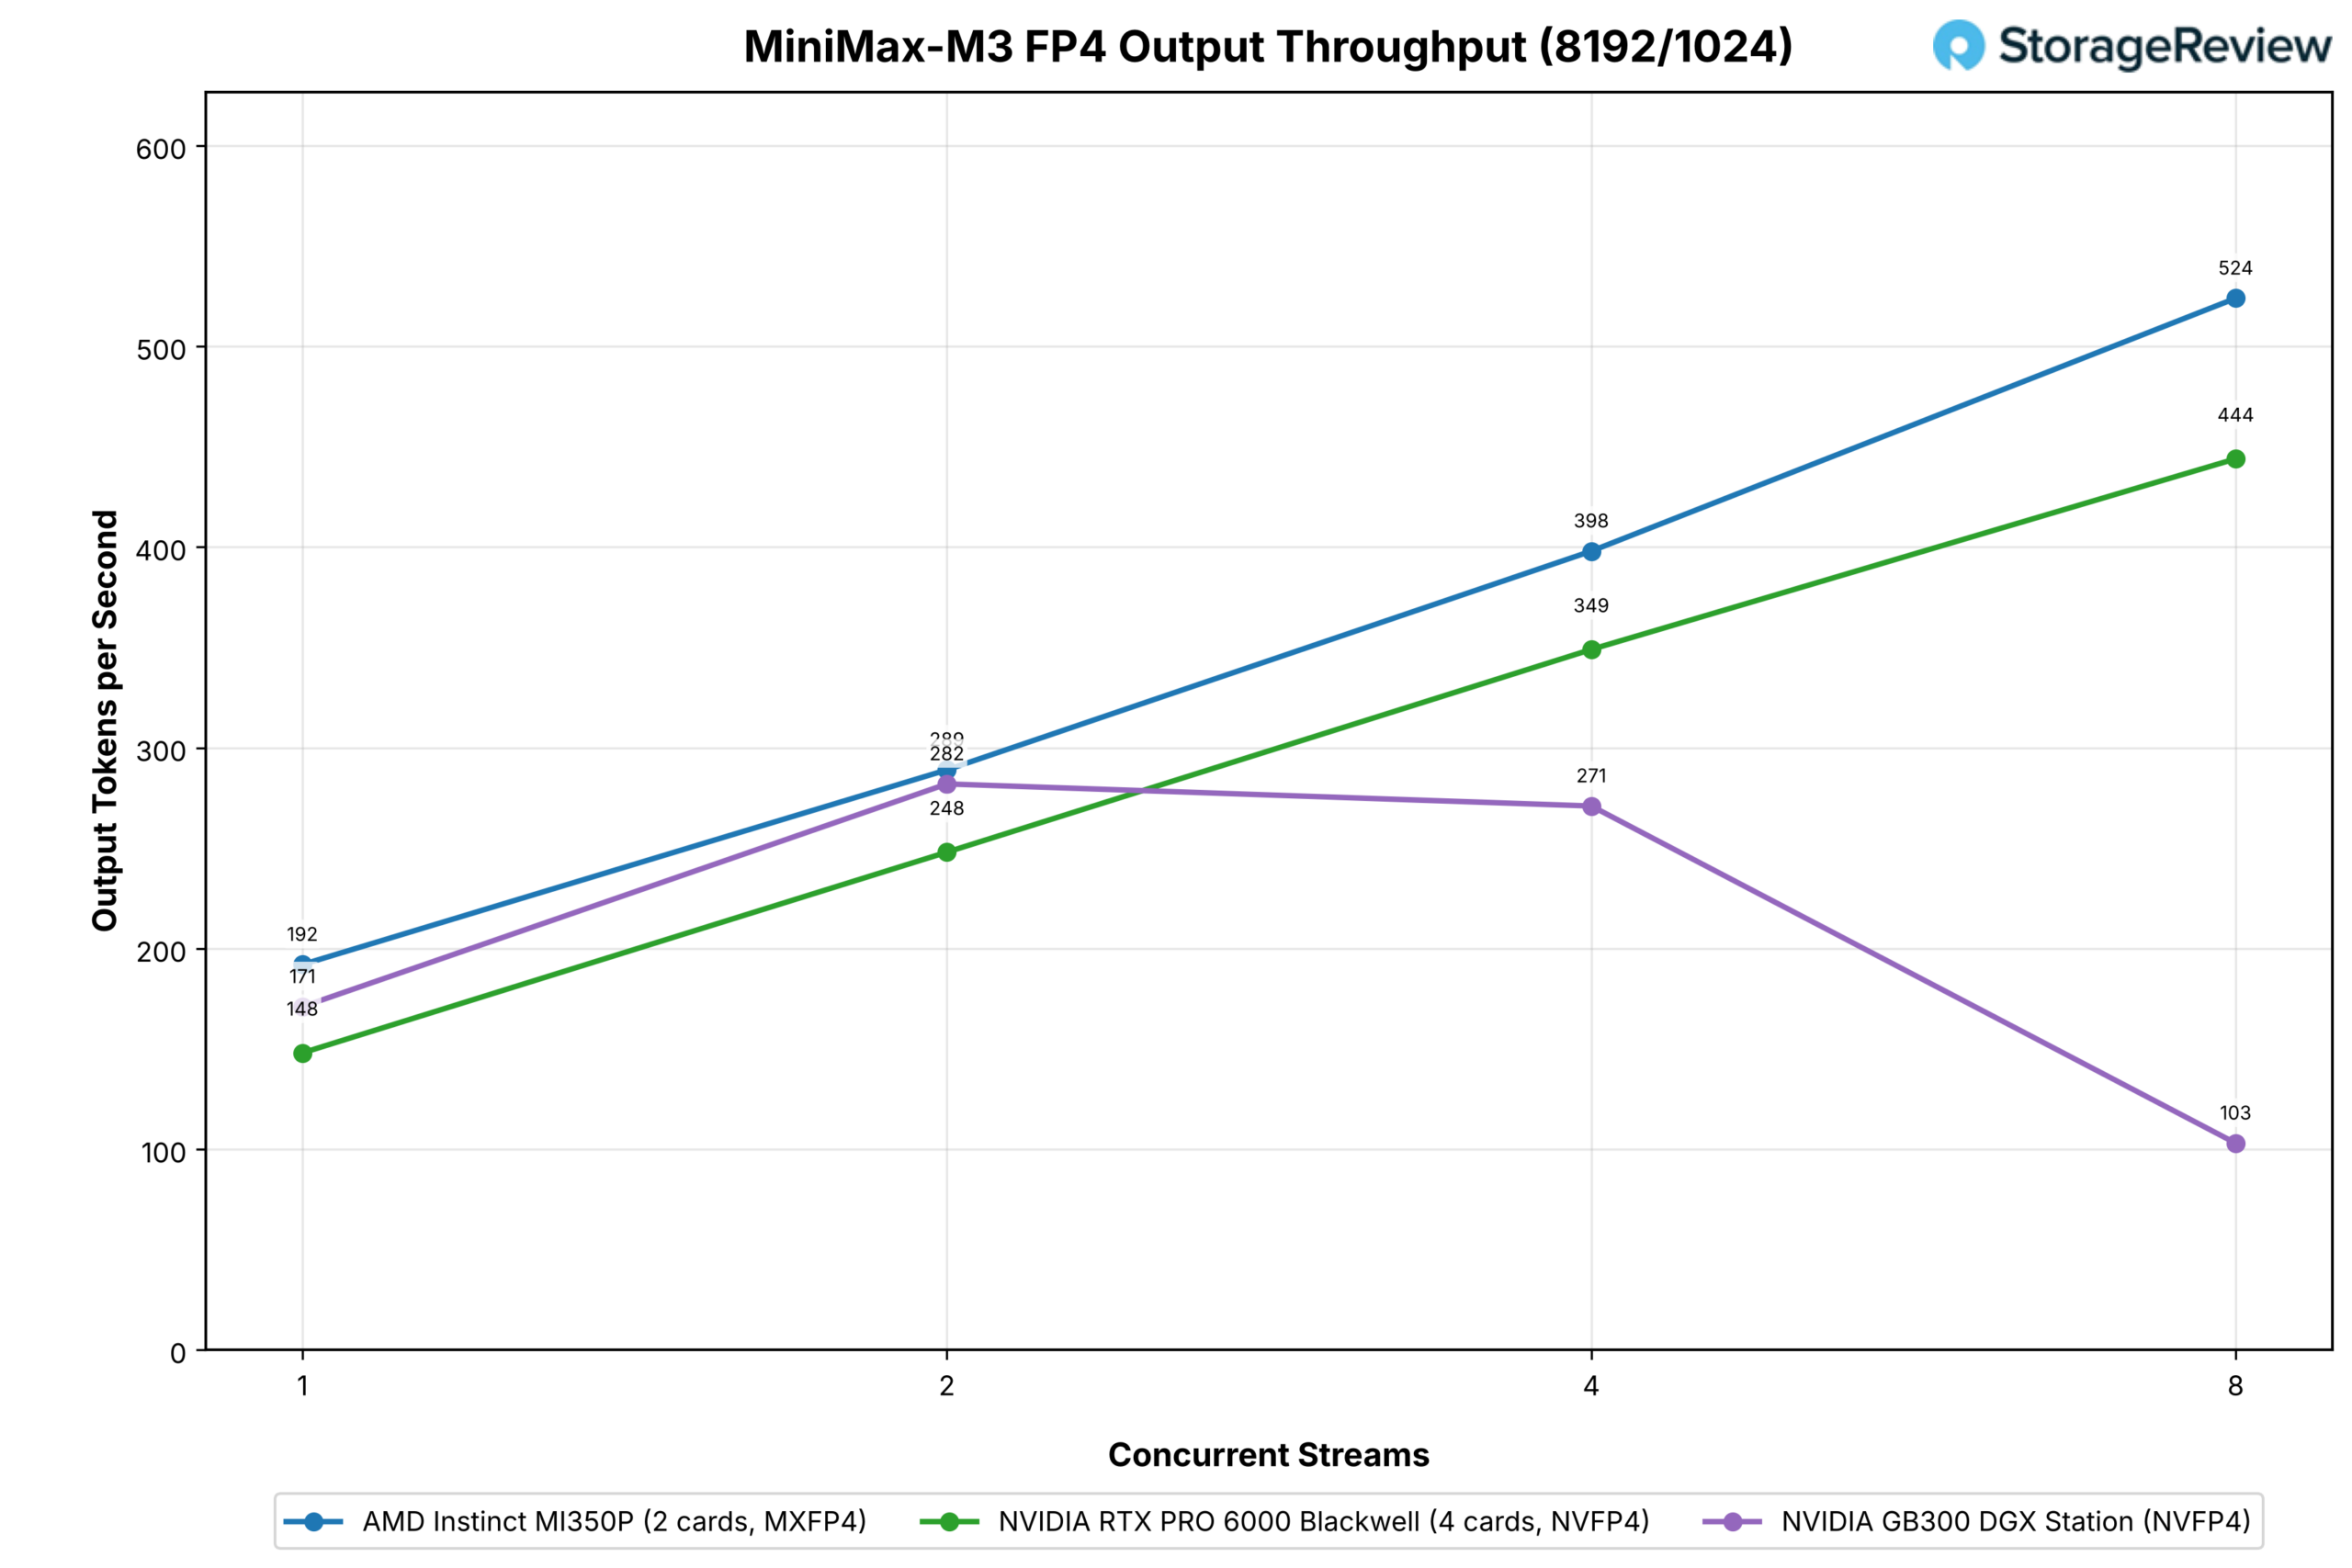
| MiniMax-M3 (MXFP4 frente a NVFP4) | 2 / 4 | ROCm 7.2.3 | 8 | 524 | 444 | No se ejecuta | 103 |
| Flash DeepSeek-V4 | 2 / 2 | ROCm 7.2.3 | 32 | 621 | 345 | No se ejecuta | 954 |
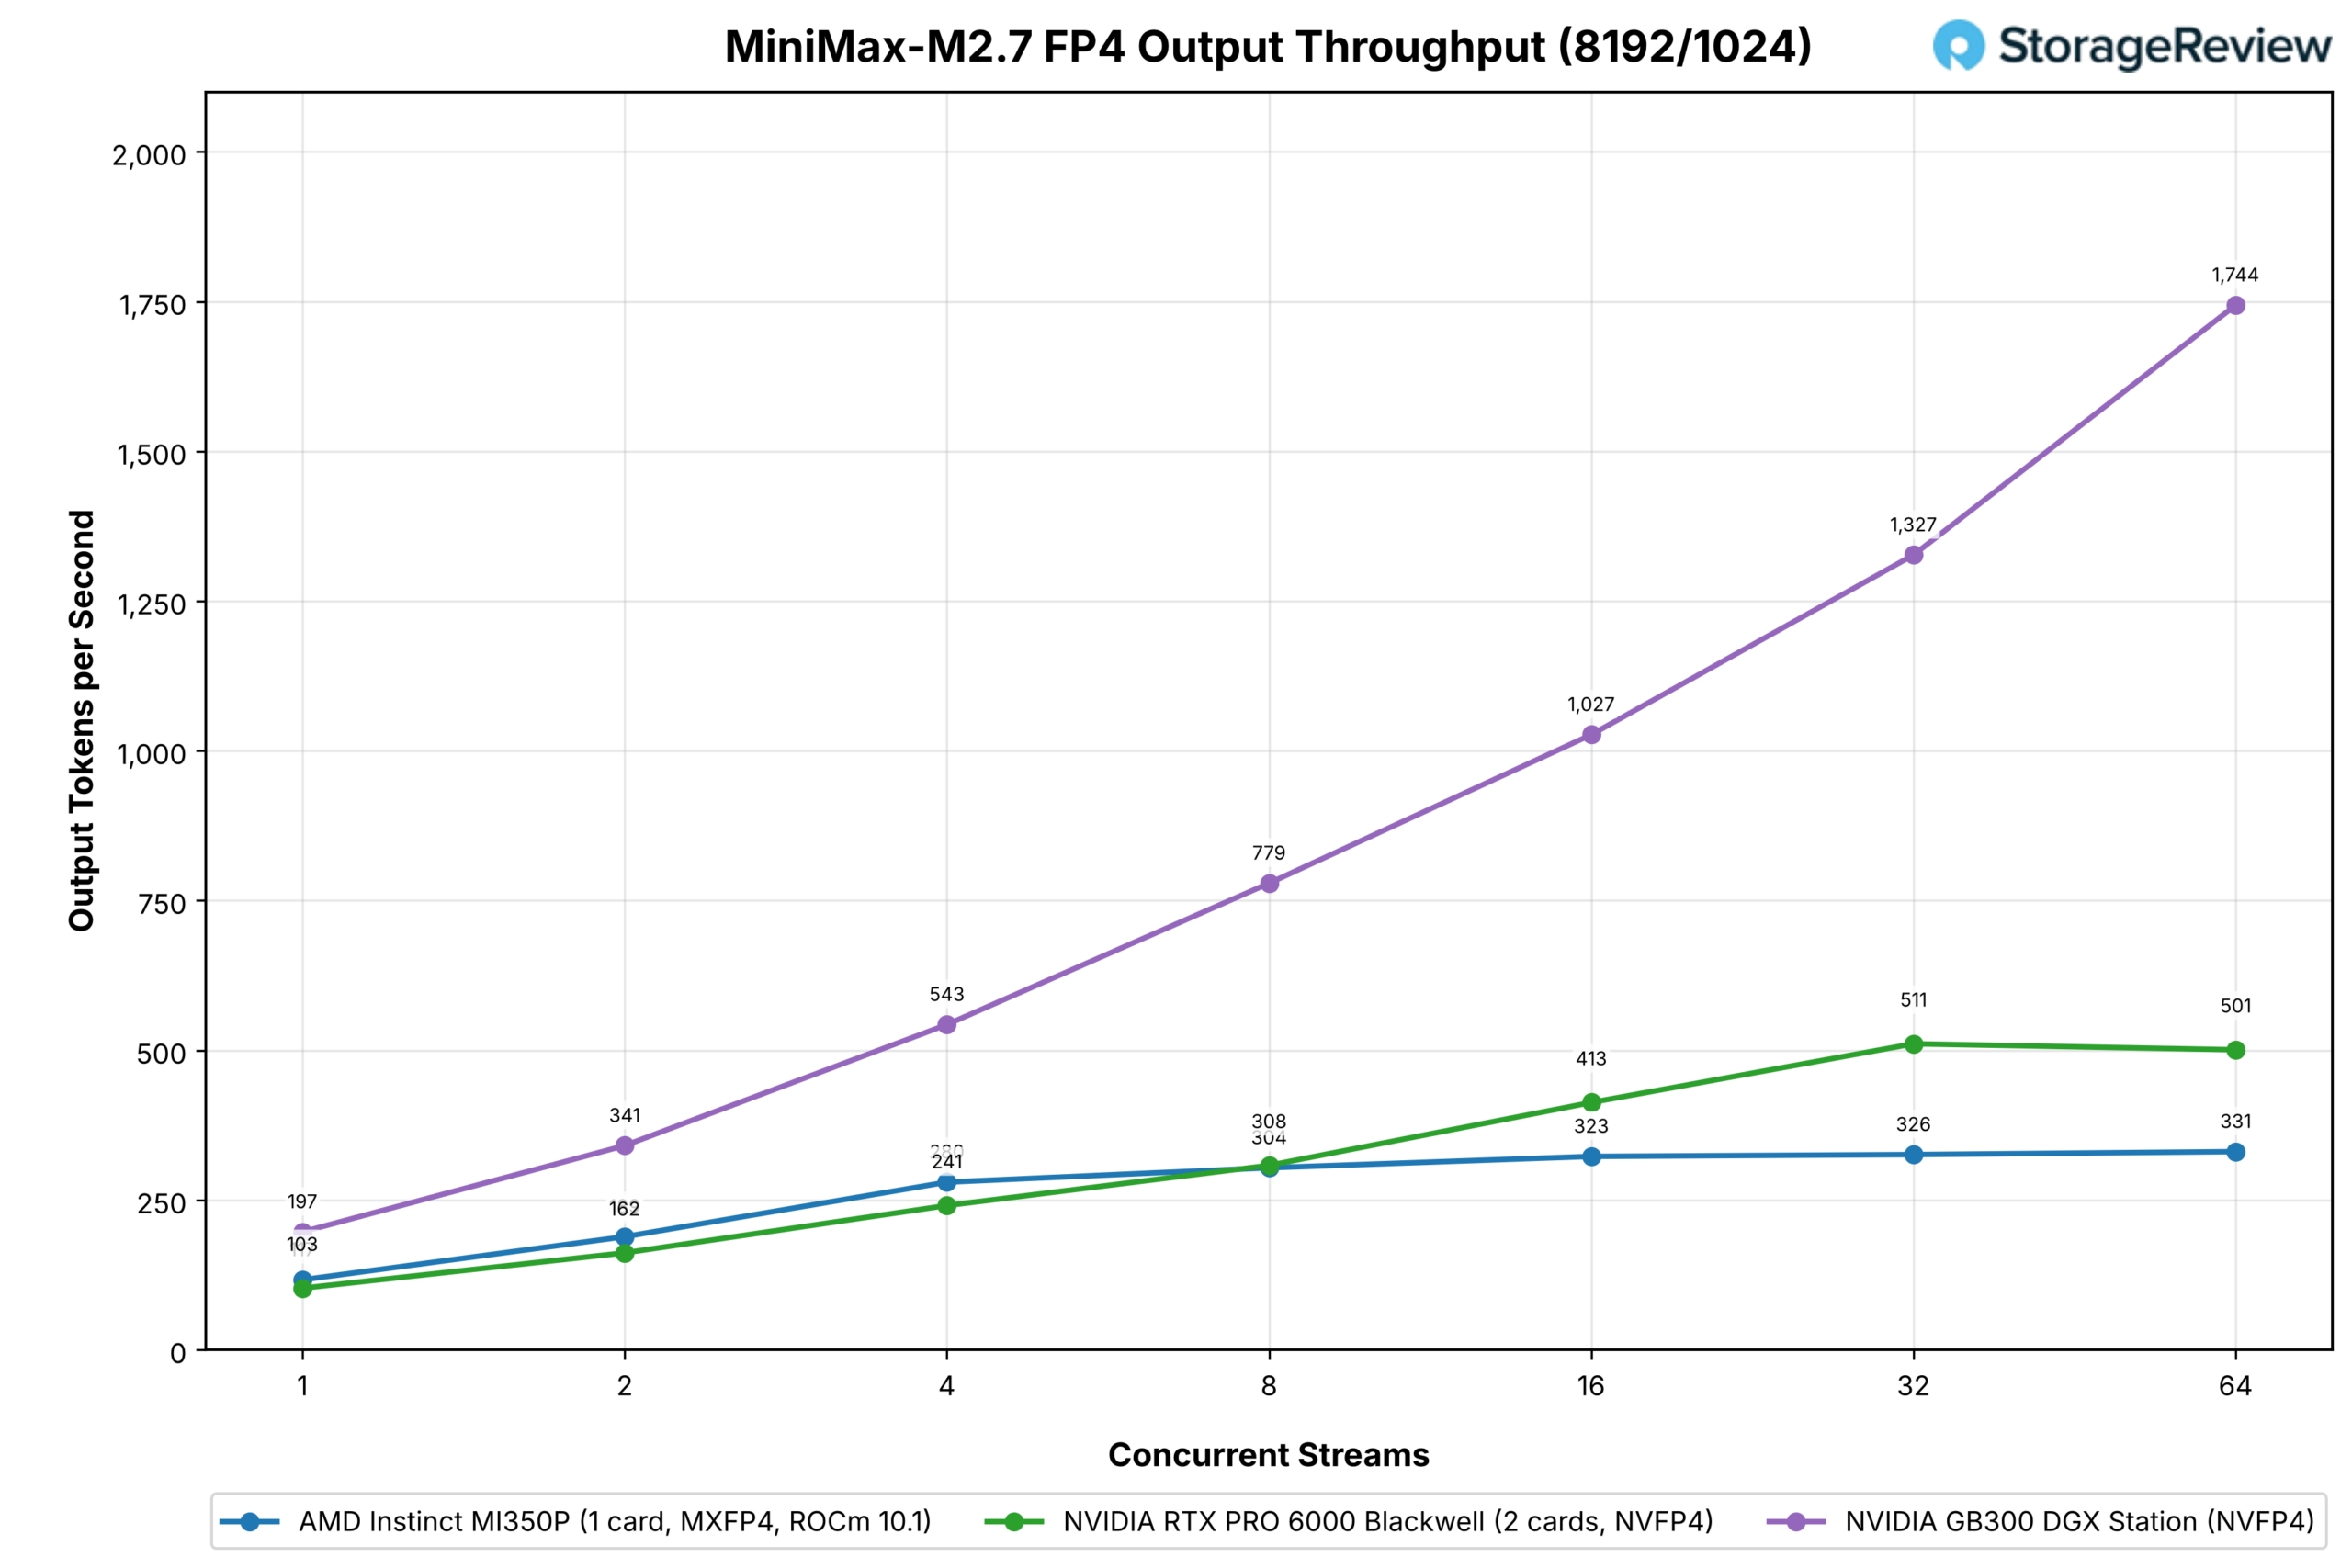
| MiniMax-M2.7 (MXFP4 frente a NVFP4) | 1 / 2 | ROCm 10.1 | 64 | 331 | 501 | No se ejecuta | 1,744 |
| GPT-OSS-120B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 2,101 | 1,169 | 1,825 | 5,023 |
| GPT-OSS-20B MXFP4 | 1 / 1 | ROCm 10.1 | 128 | 3,603 | 2,482 | 3,419 | 9,555 |
| Qwen3-Coder-30B FP8 | 1 / 1 | ROCm 10.1 | 128 | 759 | 823 | 1,820 | 3,837 |
| Qwen3-Coder-30B BF16 | 1 / 1 | ROCm 10.1 | 128 | 728 | 588 | 1,592 | 3,749 |
| Mistral Pequeño 24B FP8 | 1 / 1 | ROCm 10.1 | 128 | 599 | 482 | 799 | 2,302 |
| Mistral Pequeño 24B BF16 | 1 / 1 | ROCm 10.1 | 64 | 425 | 299 | 632 | 1,633 |
| Llama 3.1 8B (MXFP4 vs NVFP4) | 1 / 1 | ROCm 10.1 | 128 | 964 | 1,644 | No se ejecuta | 6,737 |
| Llama 3.1 8B FP8 | 1 / 1 | ROCm 10.1 | 128 | 1,211 | 1,481 | 2,045 | 6,164 |
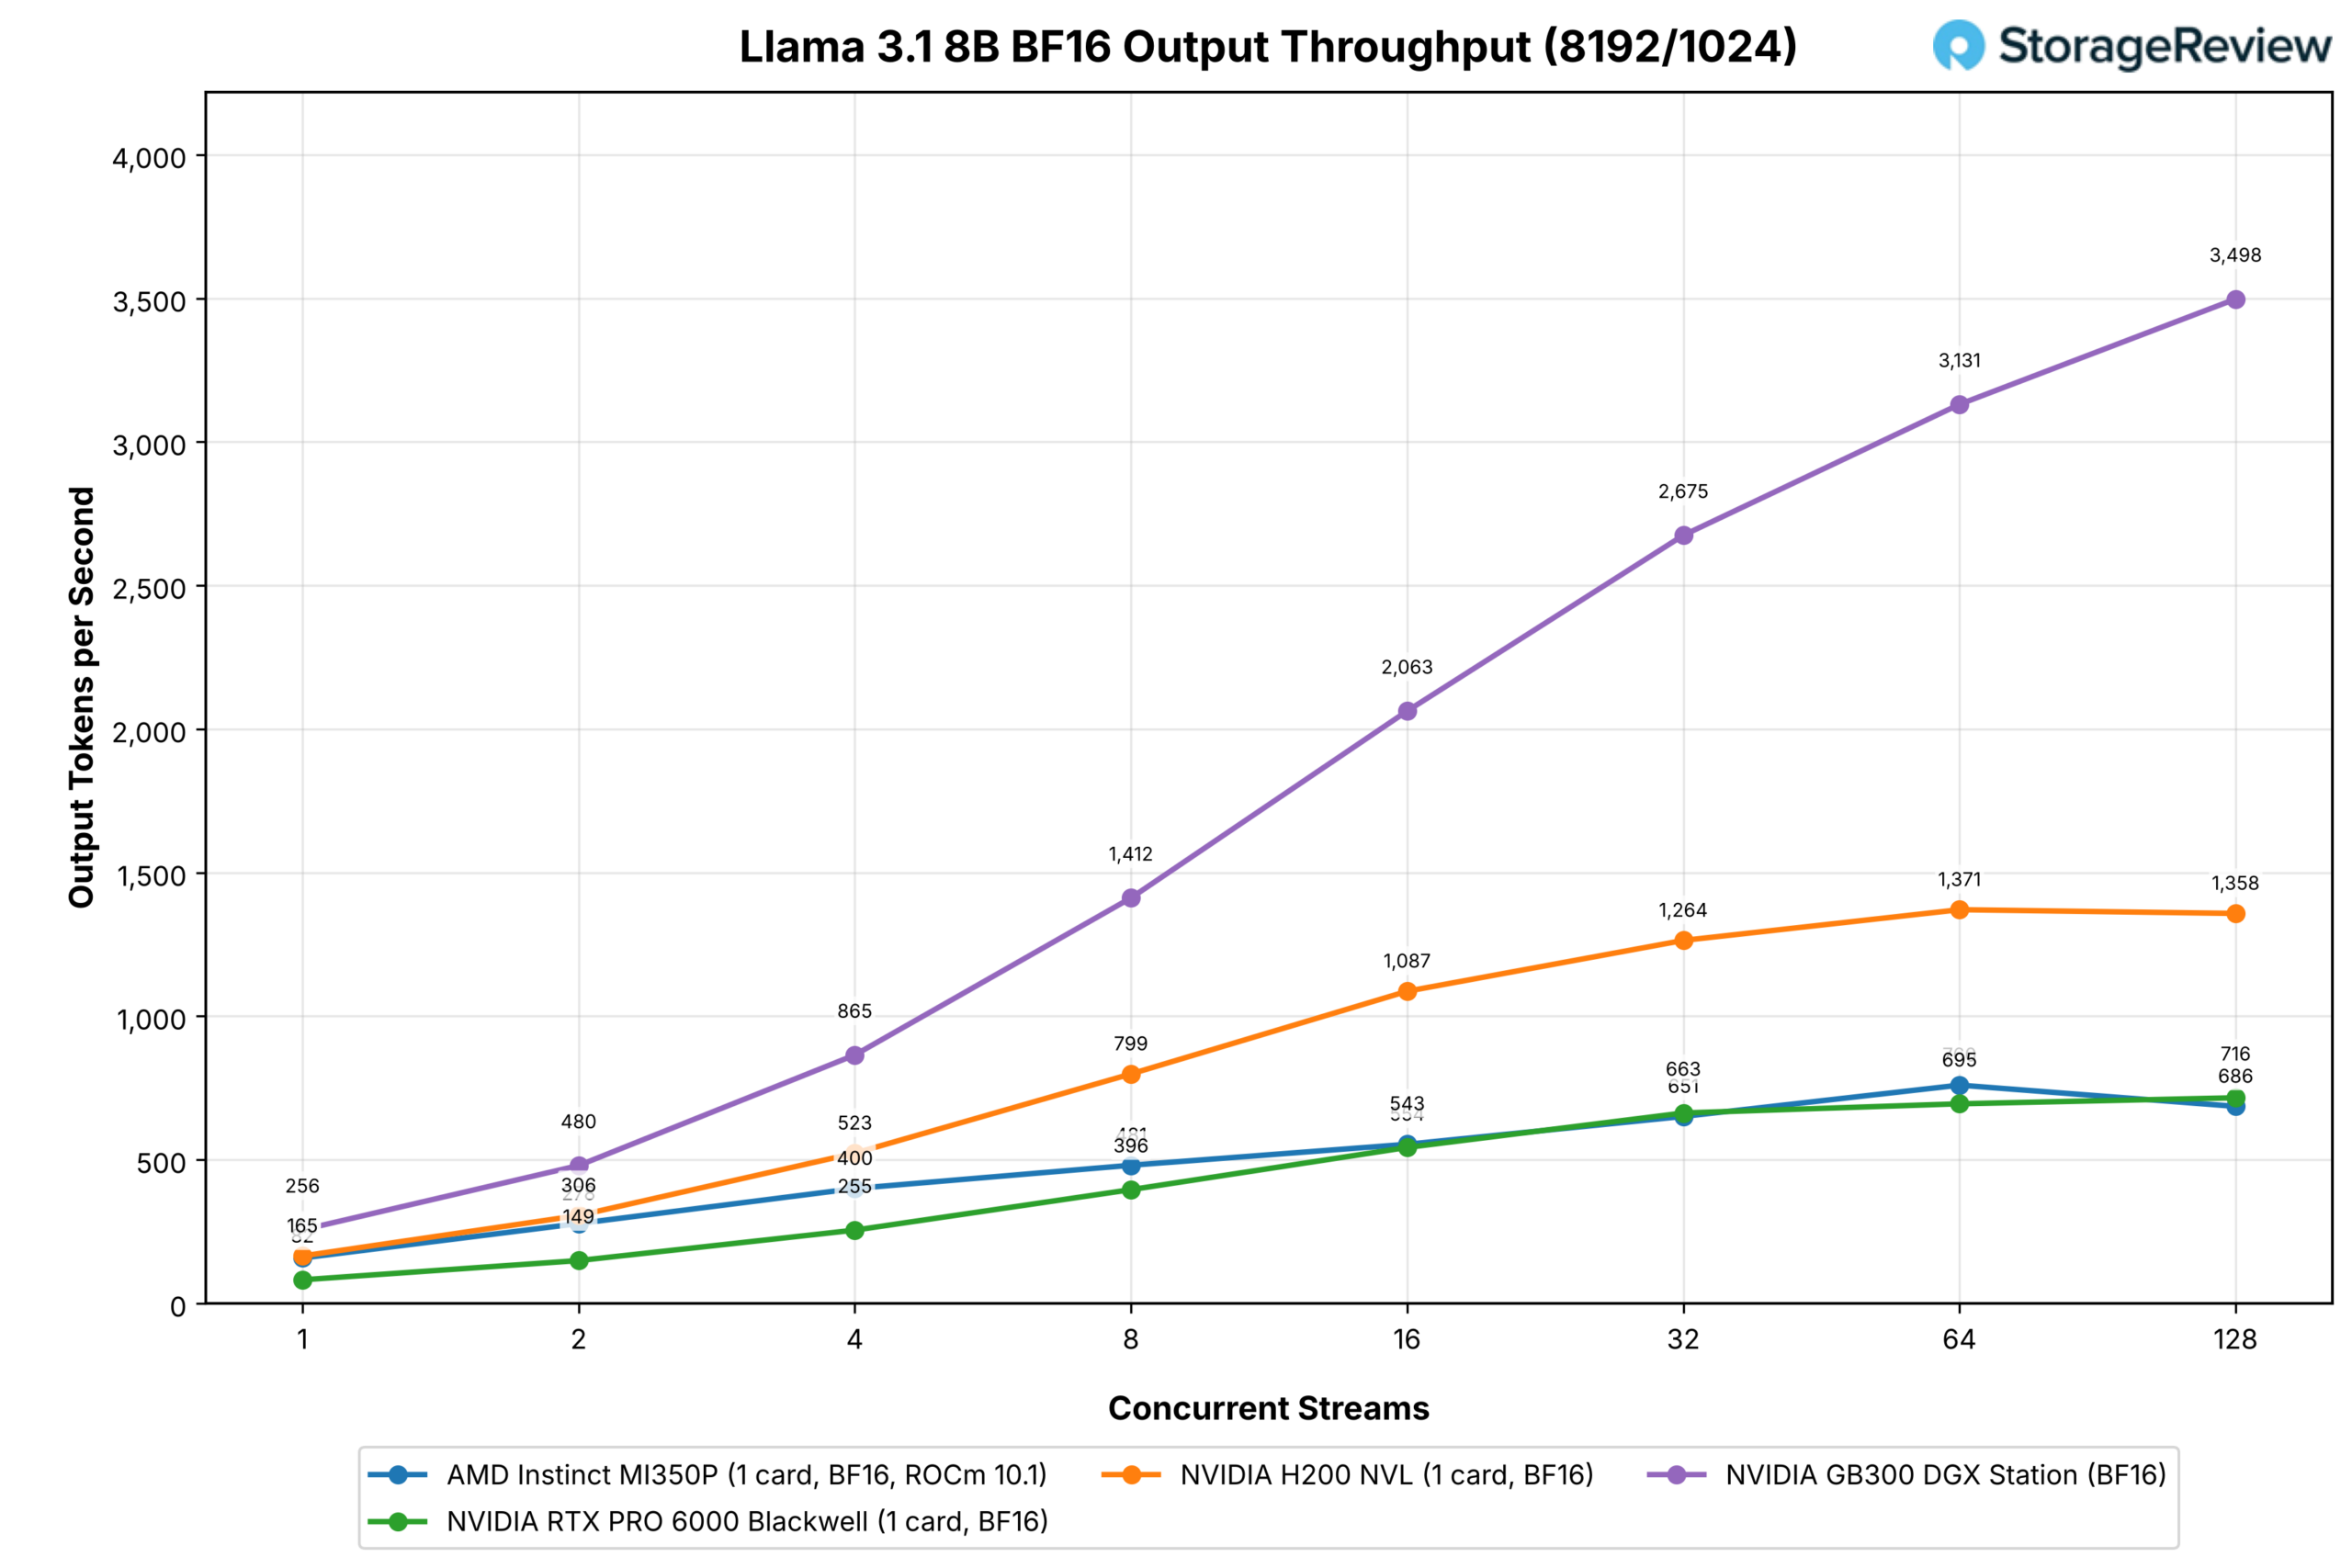
| Llama 3.1 8B BF16 | 1 / 1 | ROCm 10.1 | 128 | 686 | 716 | 1,358 | 3,498 |
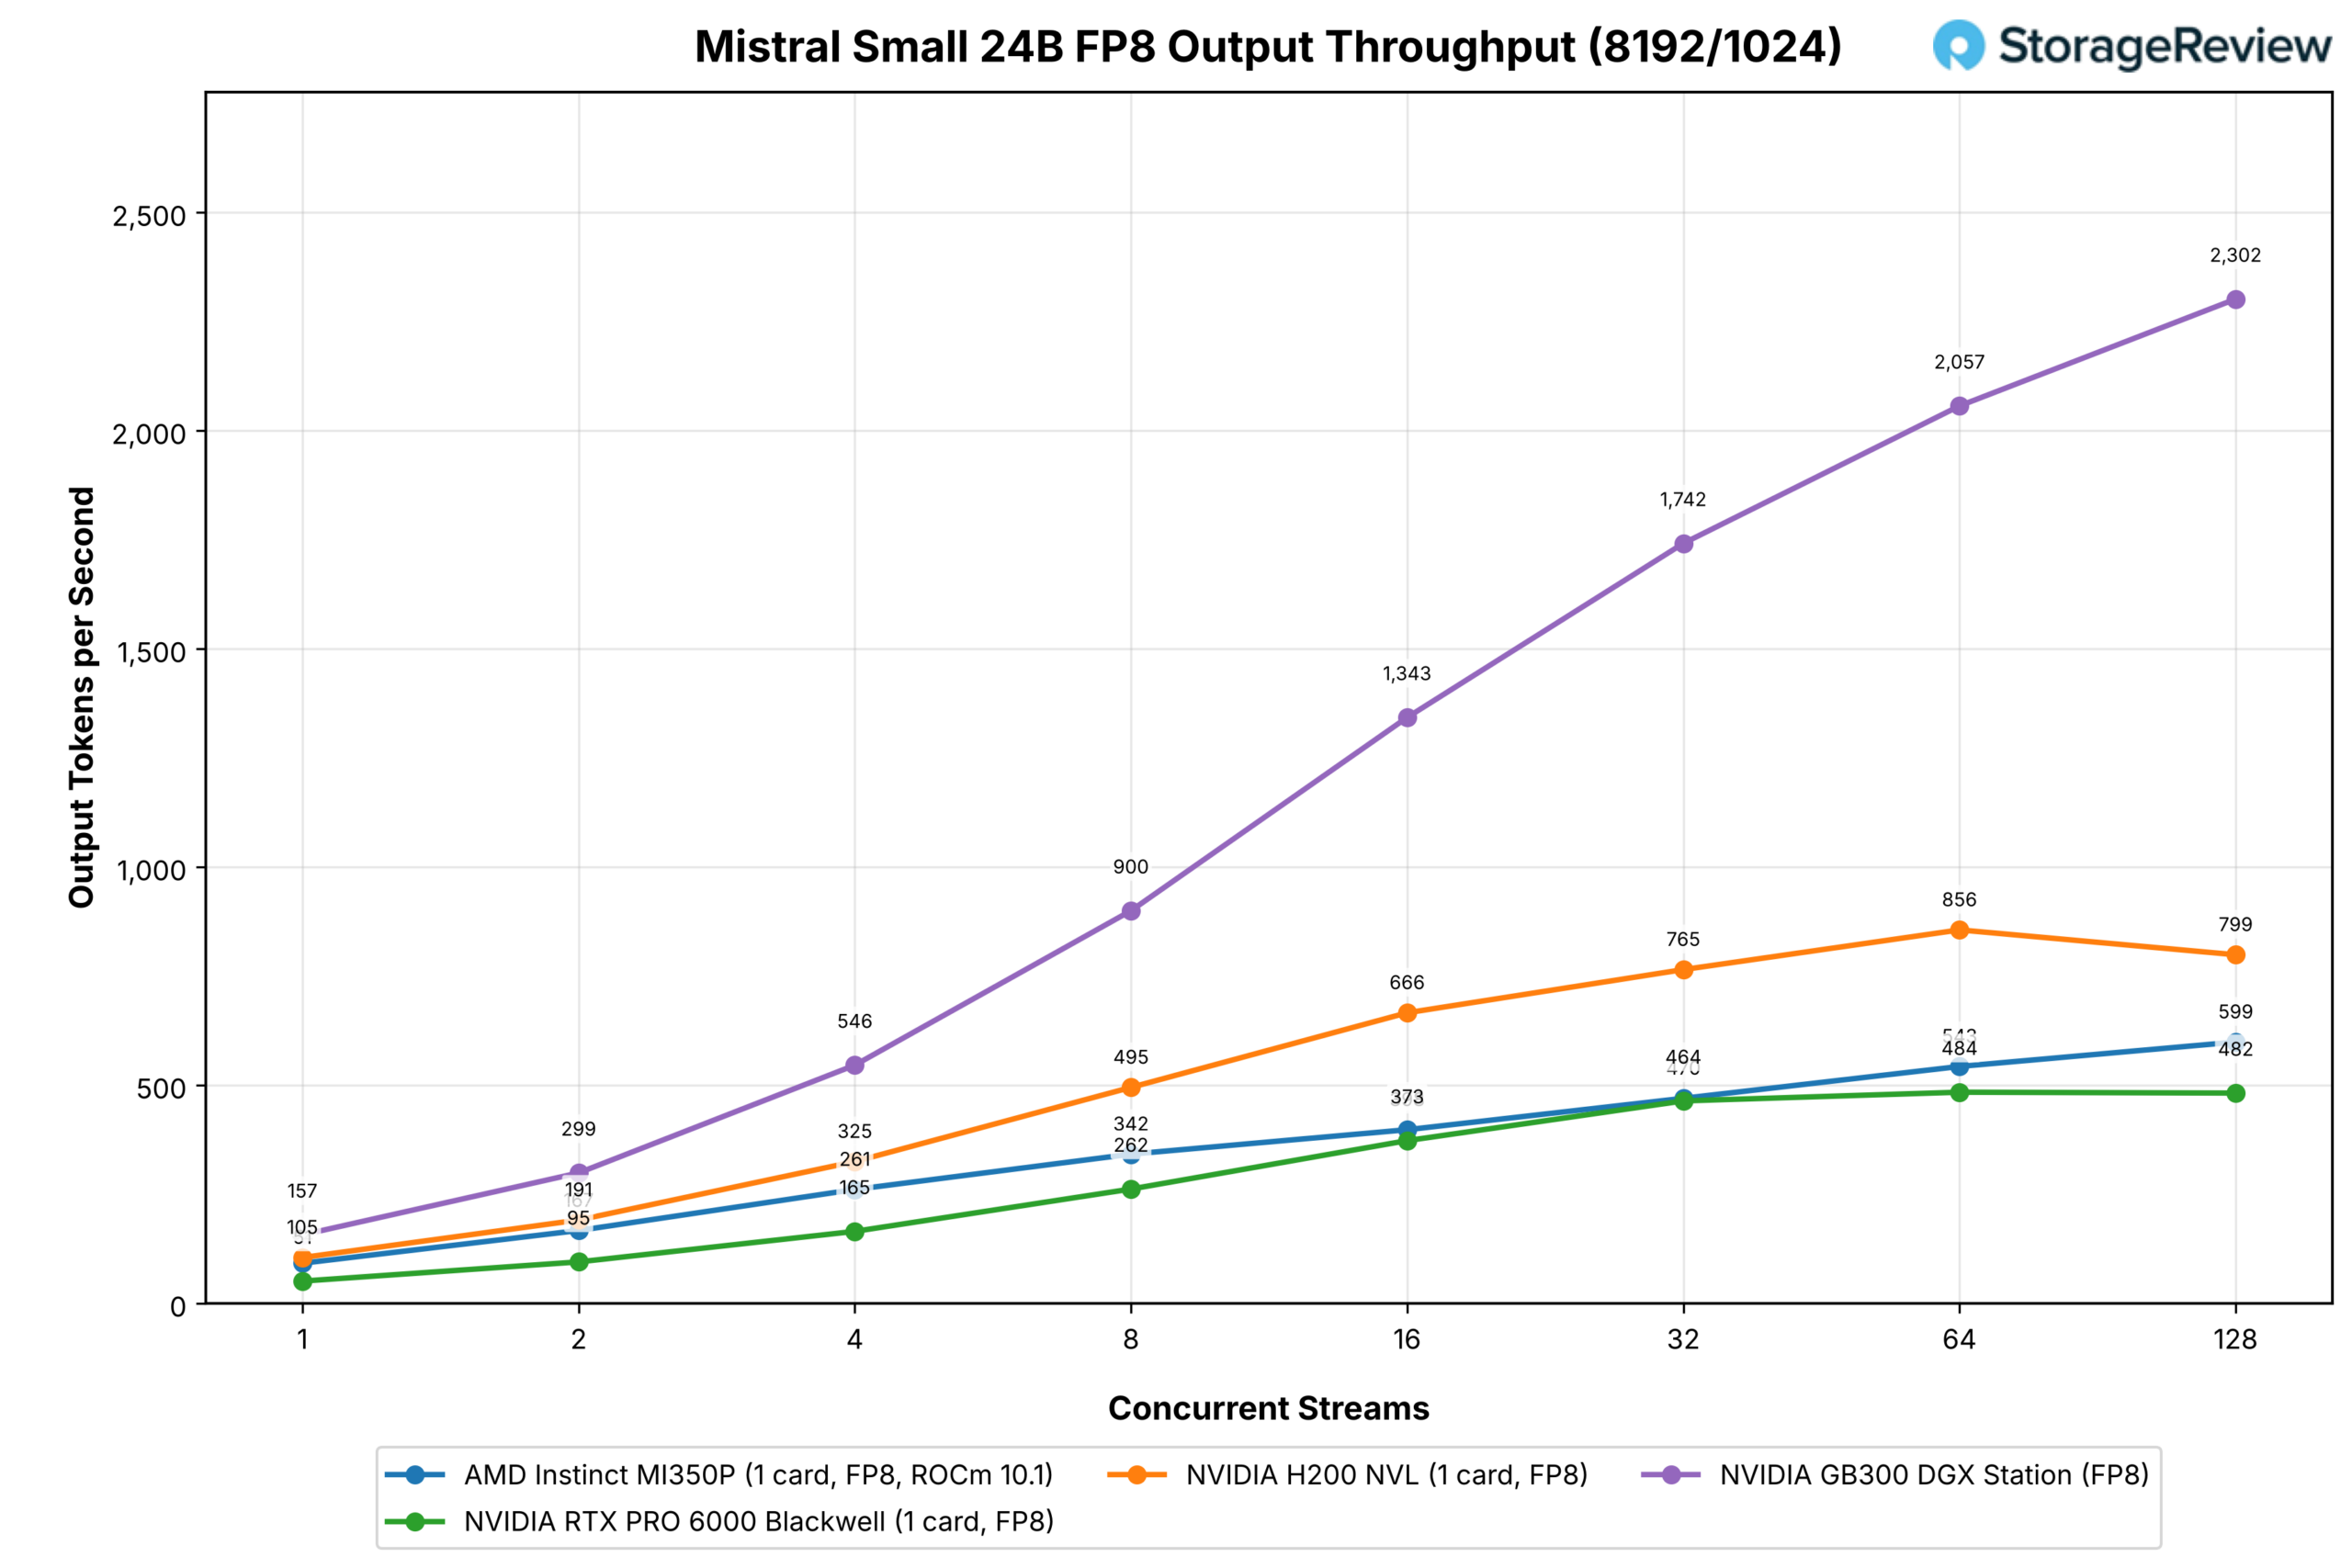
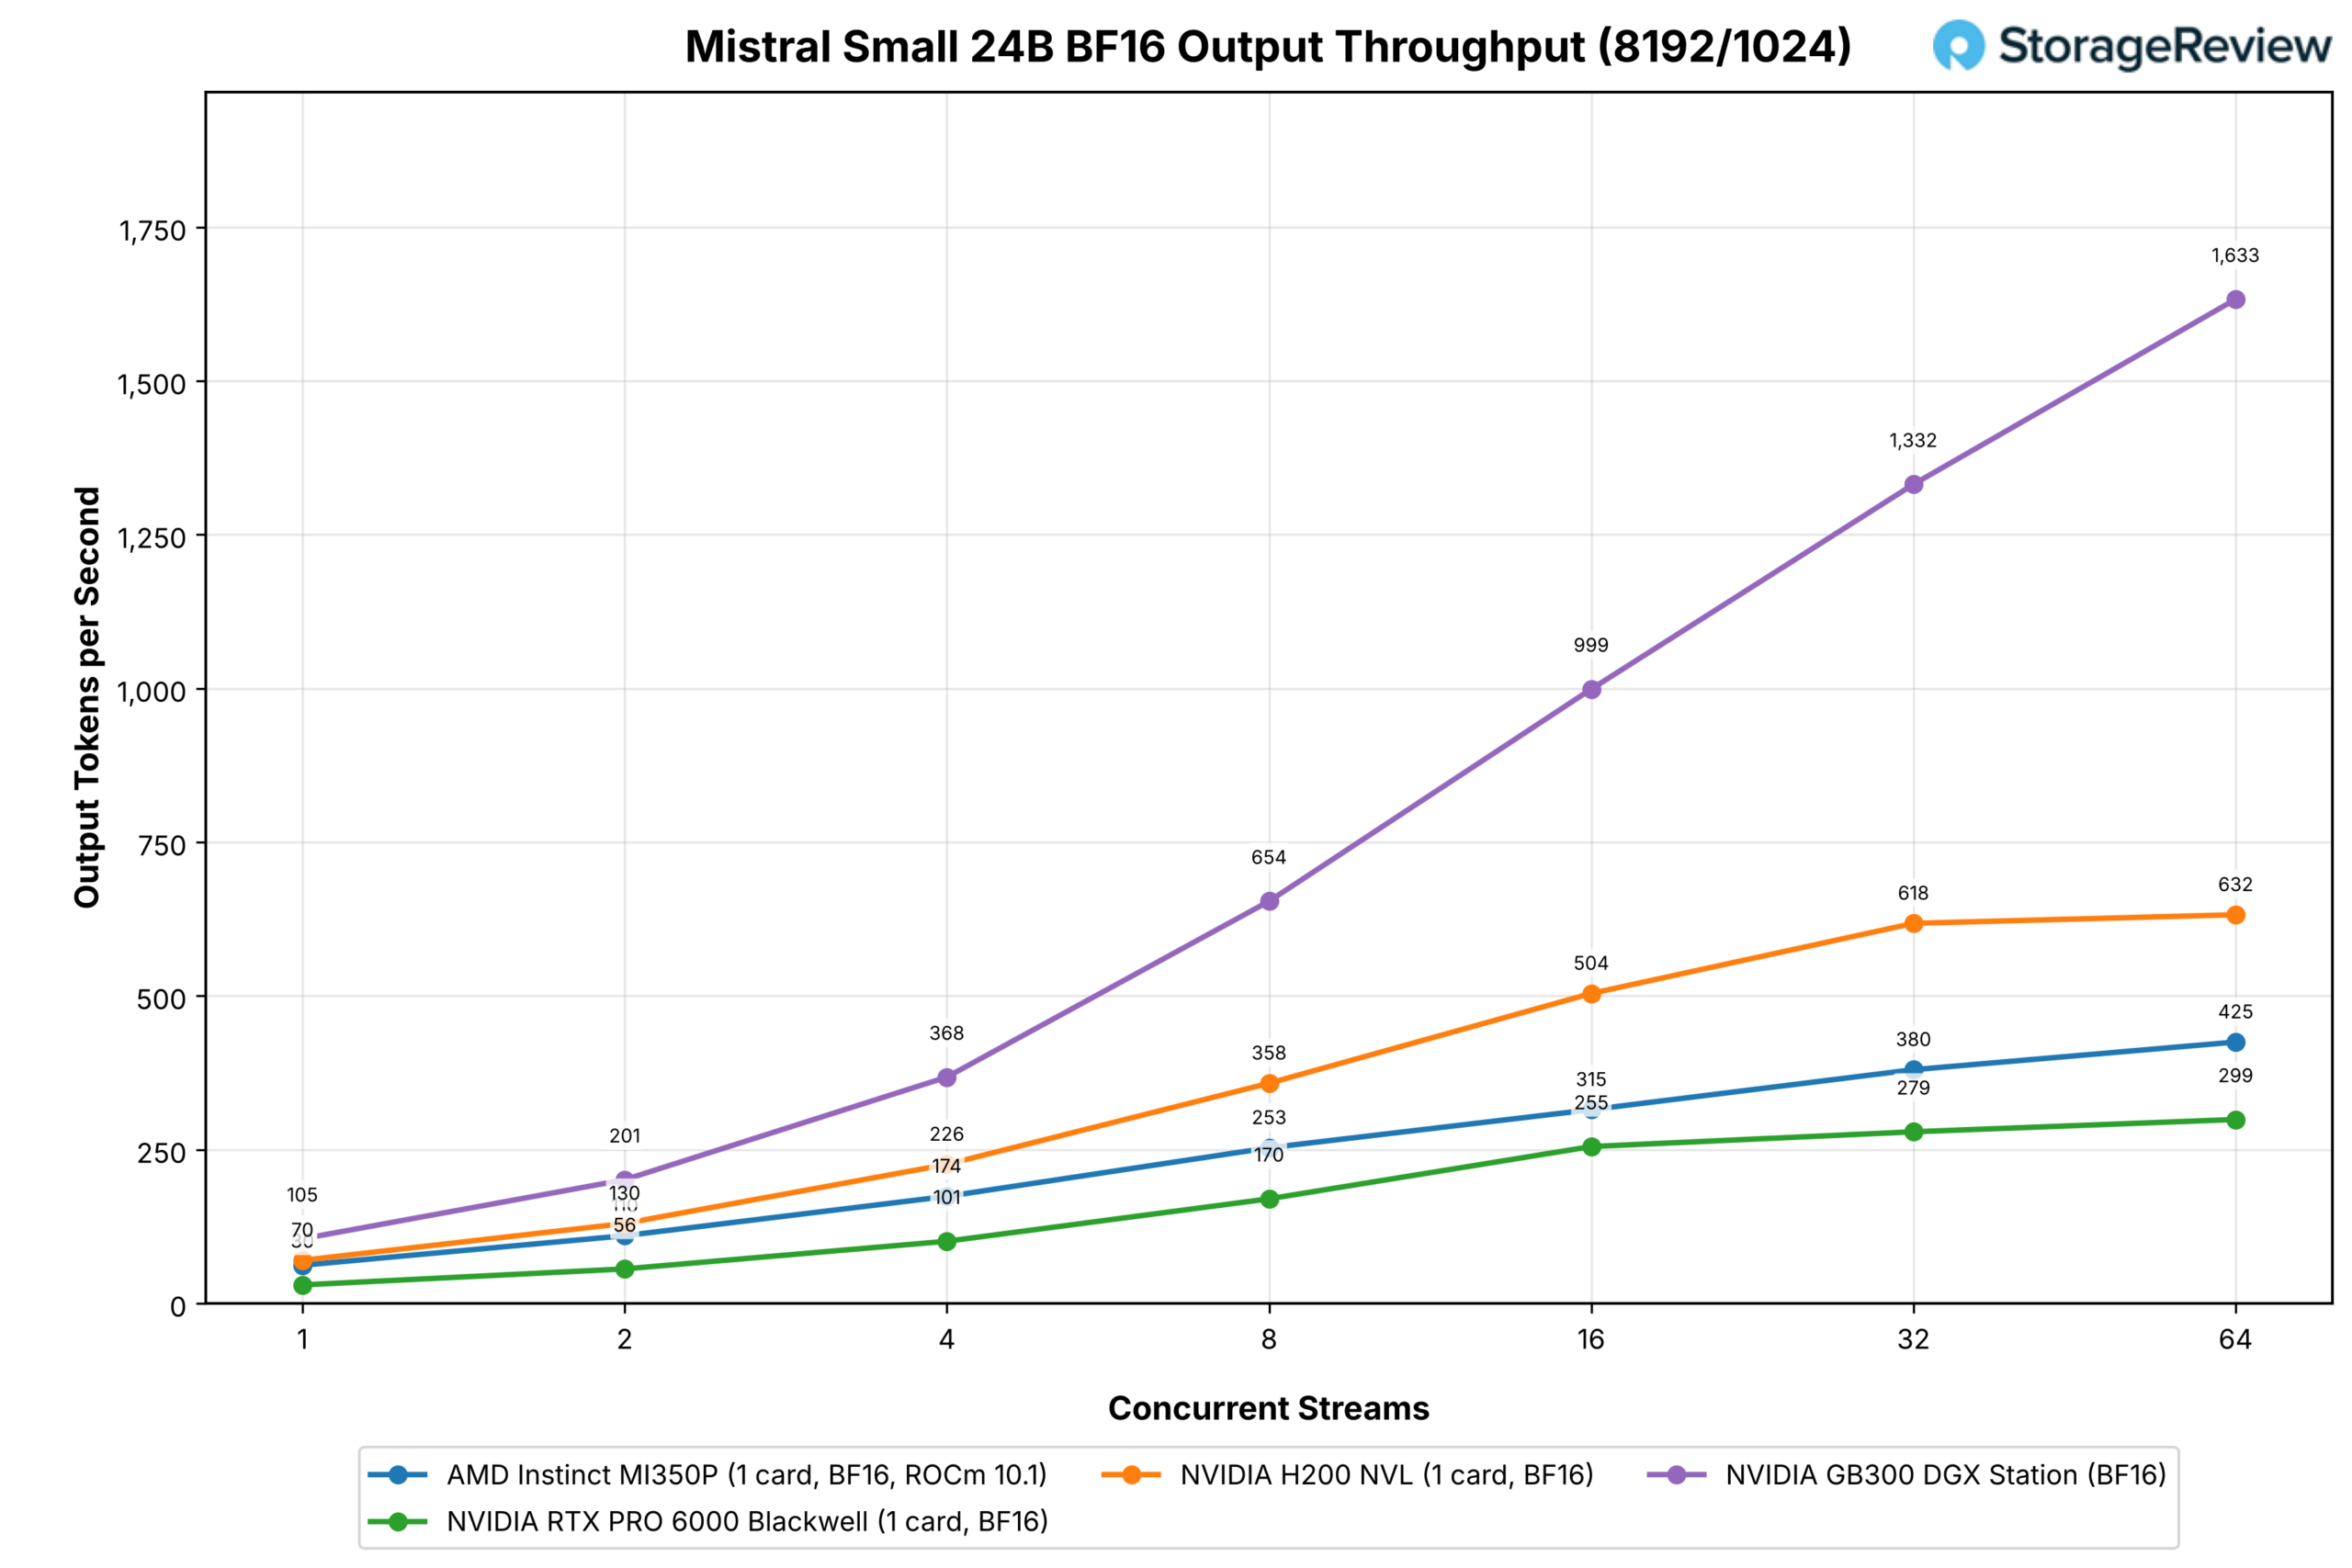
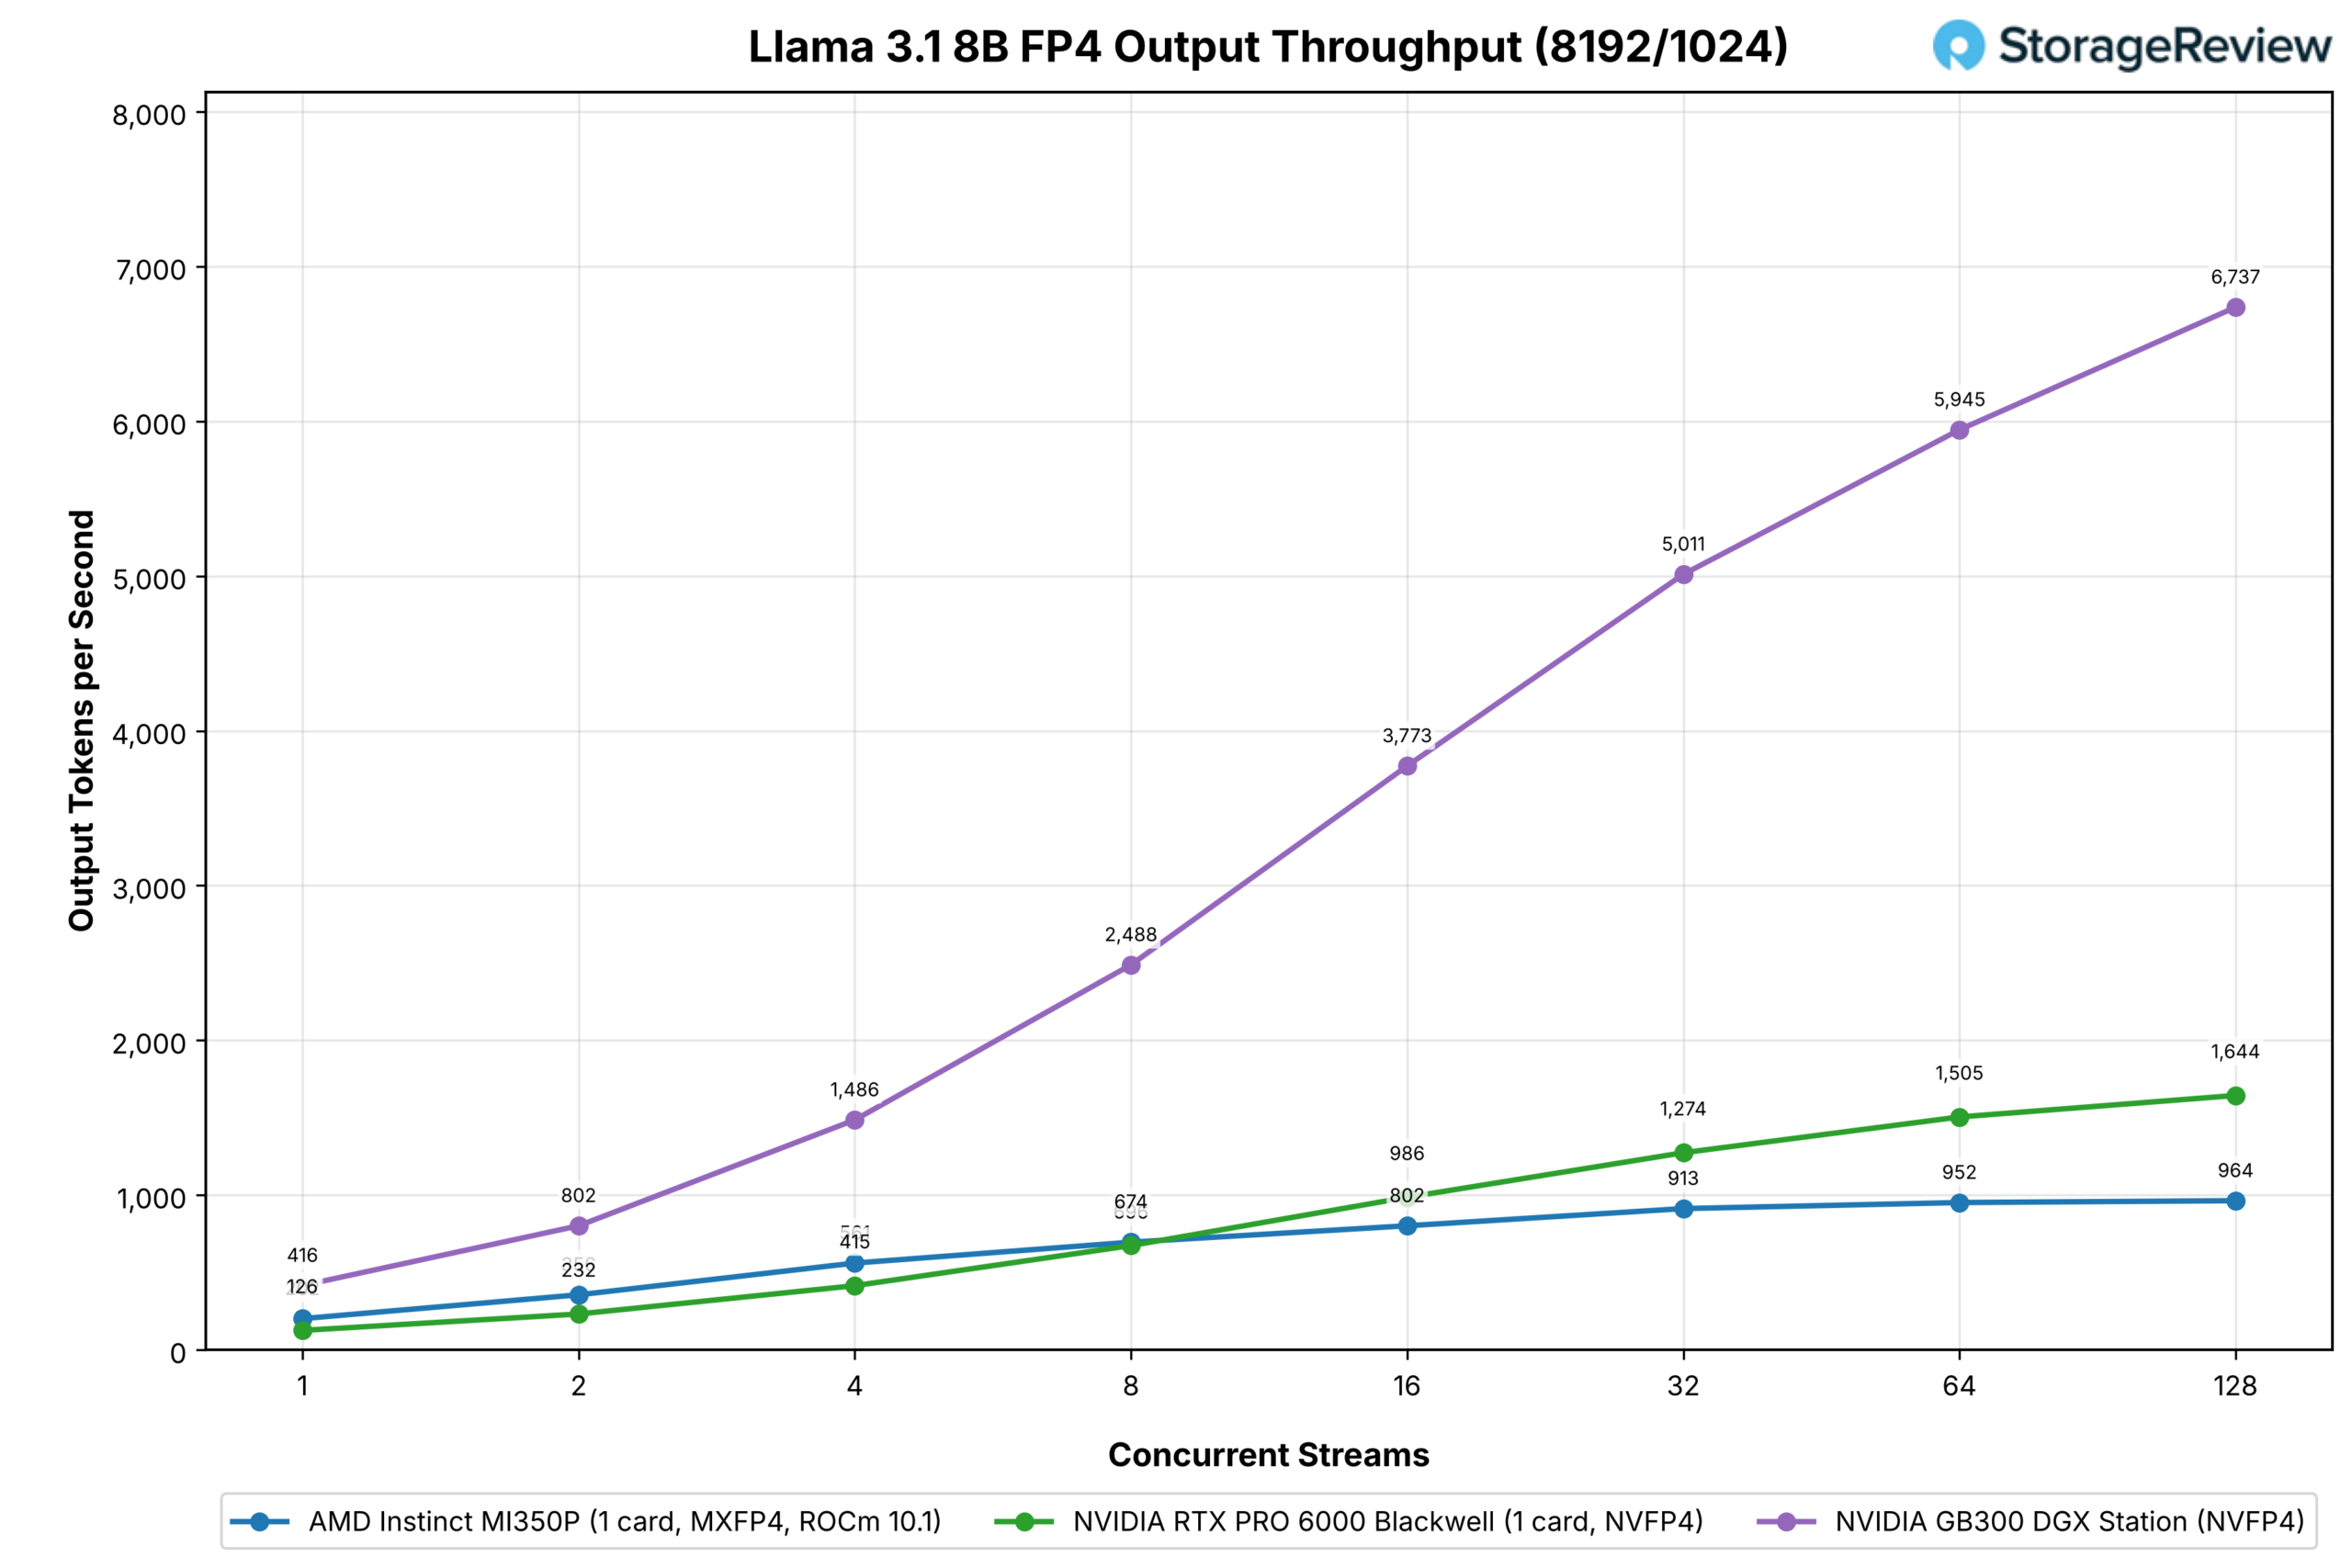
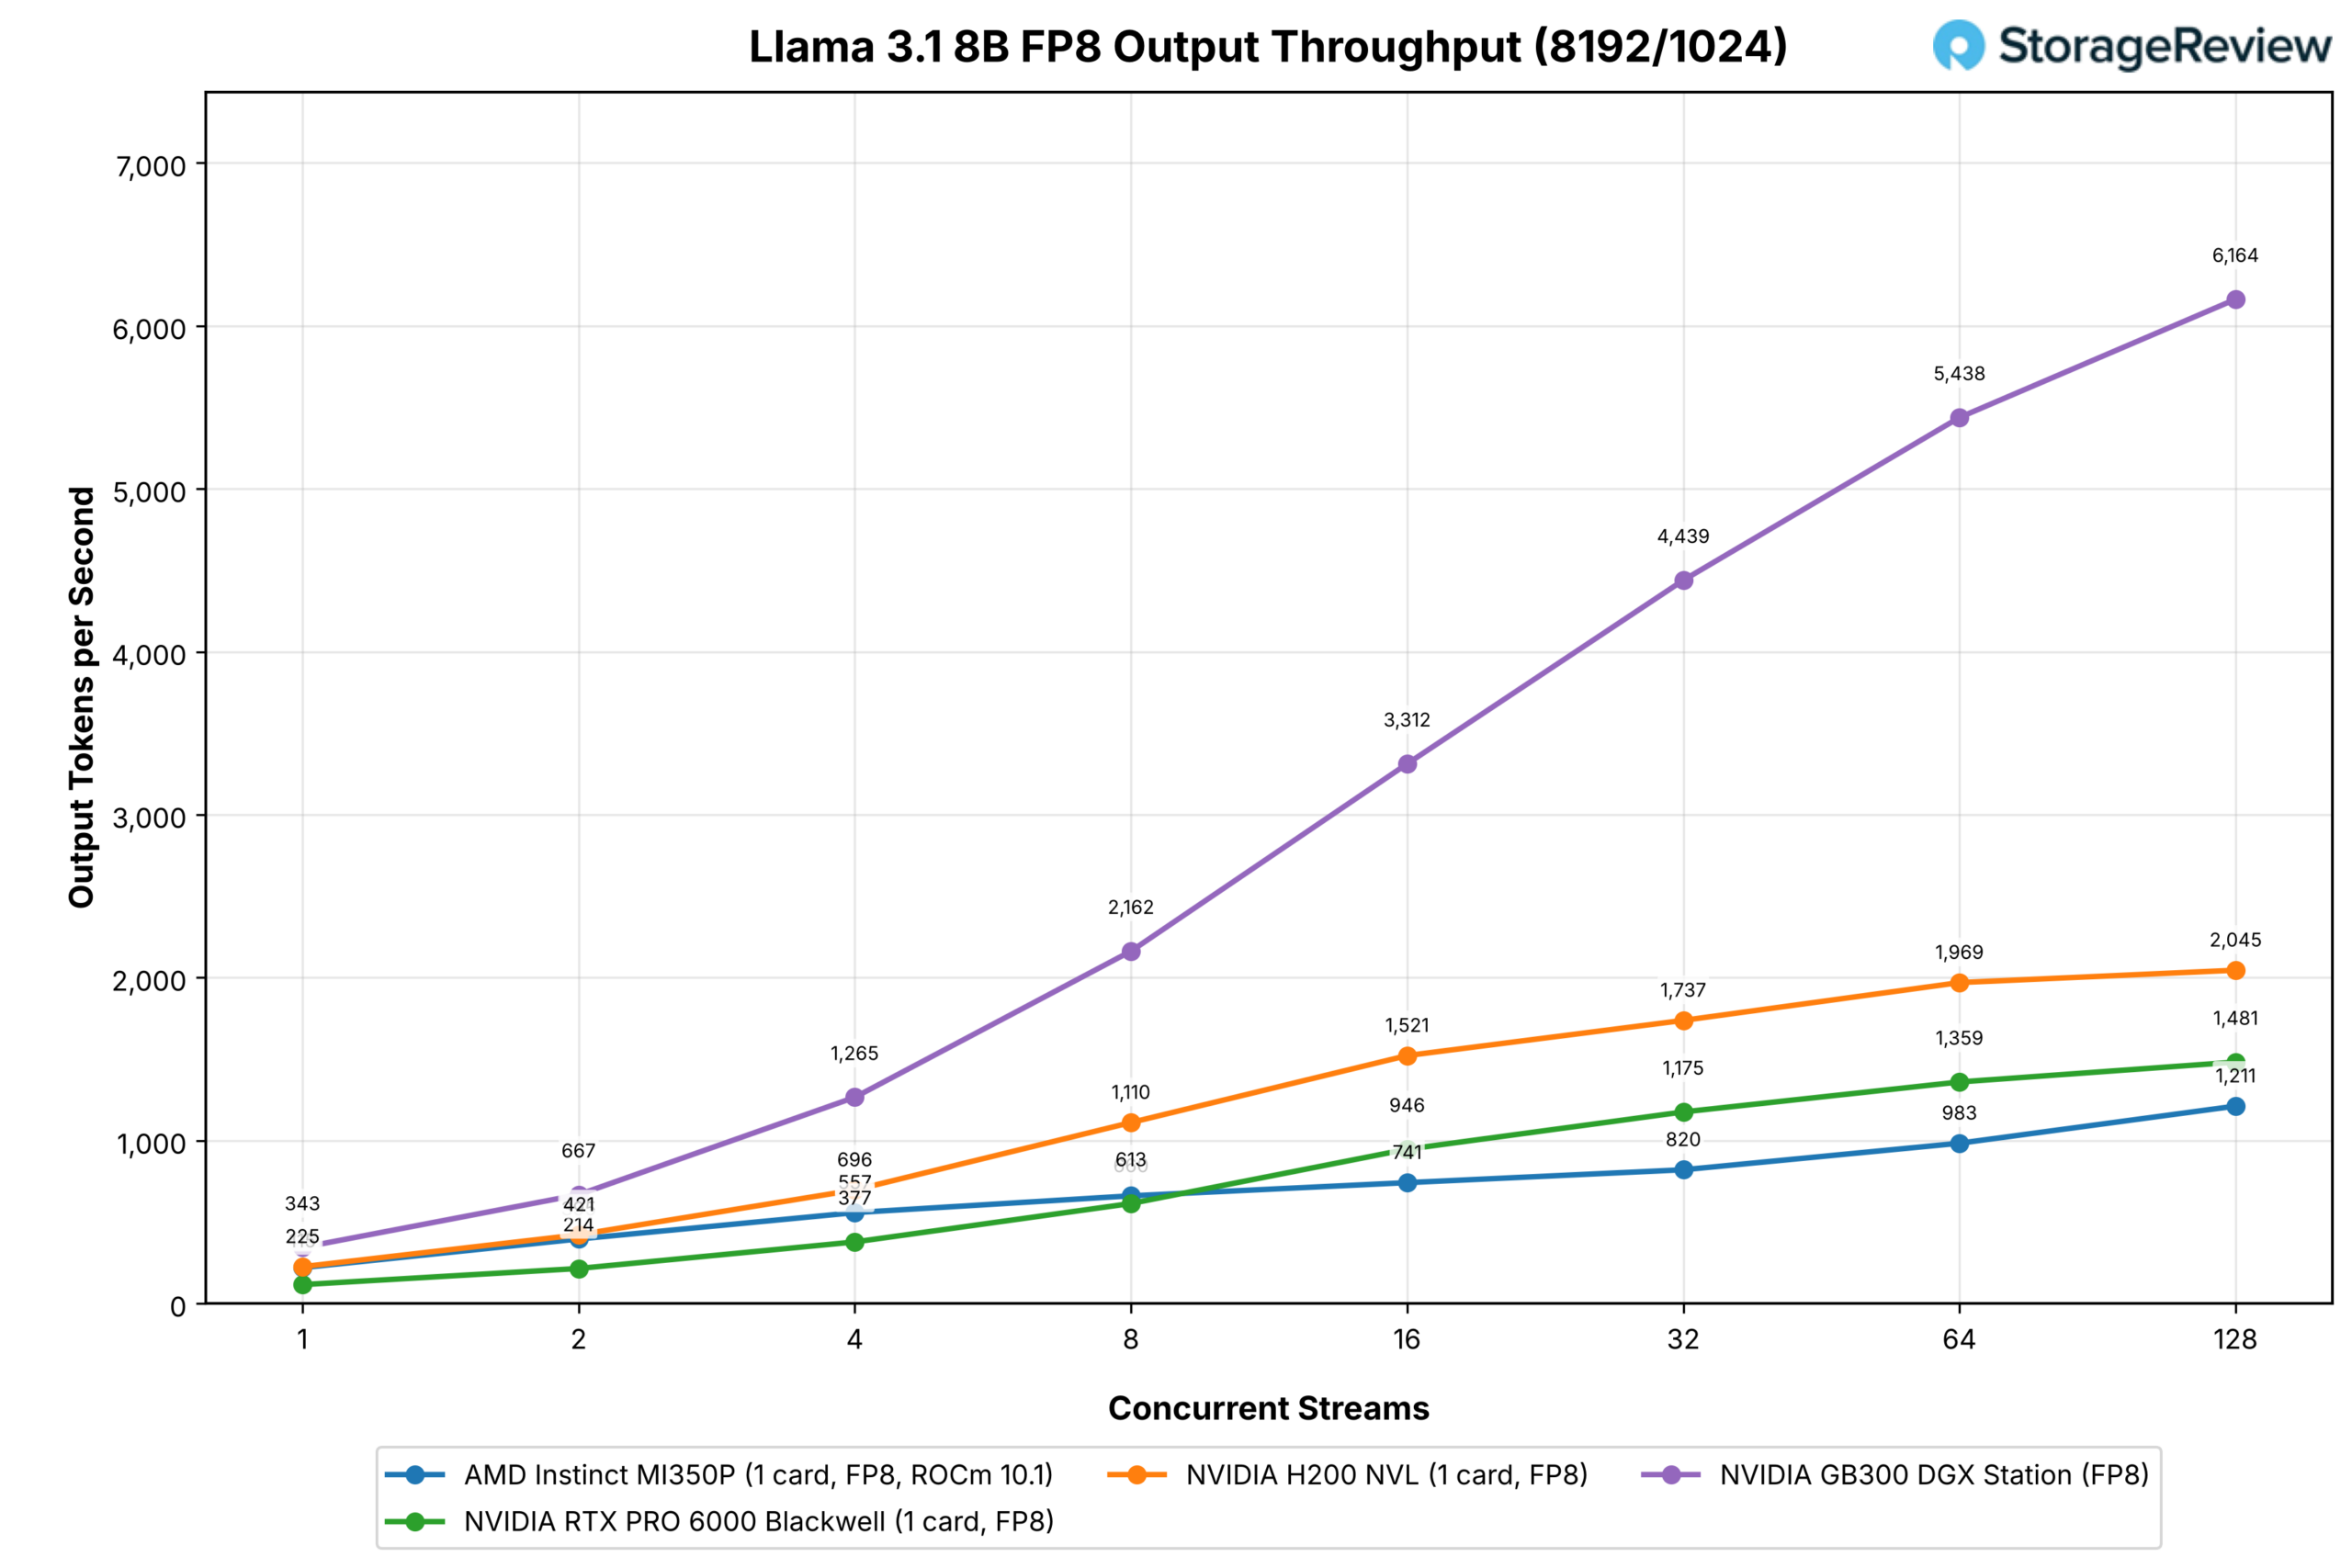
En las indicaciones con muchos prefill, el panorama es mixto: la MI350P supera a la RTX PRO 6000 en ambos modelos GPT-OSS en todos los recuentos de flujos y en Mistral Small, divide Qwen3-Coder en 128 flujos (24 por ciento por delante en BF16, 8 por ciento por detrás en FP8), y se iguala por 16 flujos en Llama y MiniMax-M2.7, donde termina detrás de la tarjeta NVIDIA. Frente a la H200, lidera en GPT-OSS por un 15 por ciento en el modelo 120B y un 5 por ciento en el 20B en 128 flujos y se queda atrás por un 25 a 58 por ciento en los modelos densos.
En los modelos más grandes, donde dos MI350P se enfrentan a cuatro RTX PRO 6000, el conjunto NVIDIA lidera GLM-5.2 a través de 16 transmisiones en la carga de trabajo de chat con 384 GB de GDDR7 frente a 288 GB de HBM3E, mientras que en MiniMax-M3 las tres configuraciones se mantienen dentro de un 10 por ciento a través de ocho transmisiones antes de que el cuádruple RTX tome la delantera en 16. El único GB300 supera a todas las configuraciones PCIe por un amplio margen en todo lo que cabe en sus 252 GB.
GLM-5.3 Flash
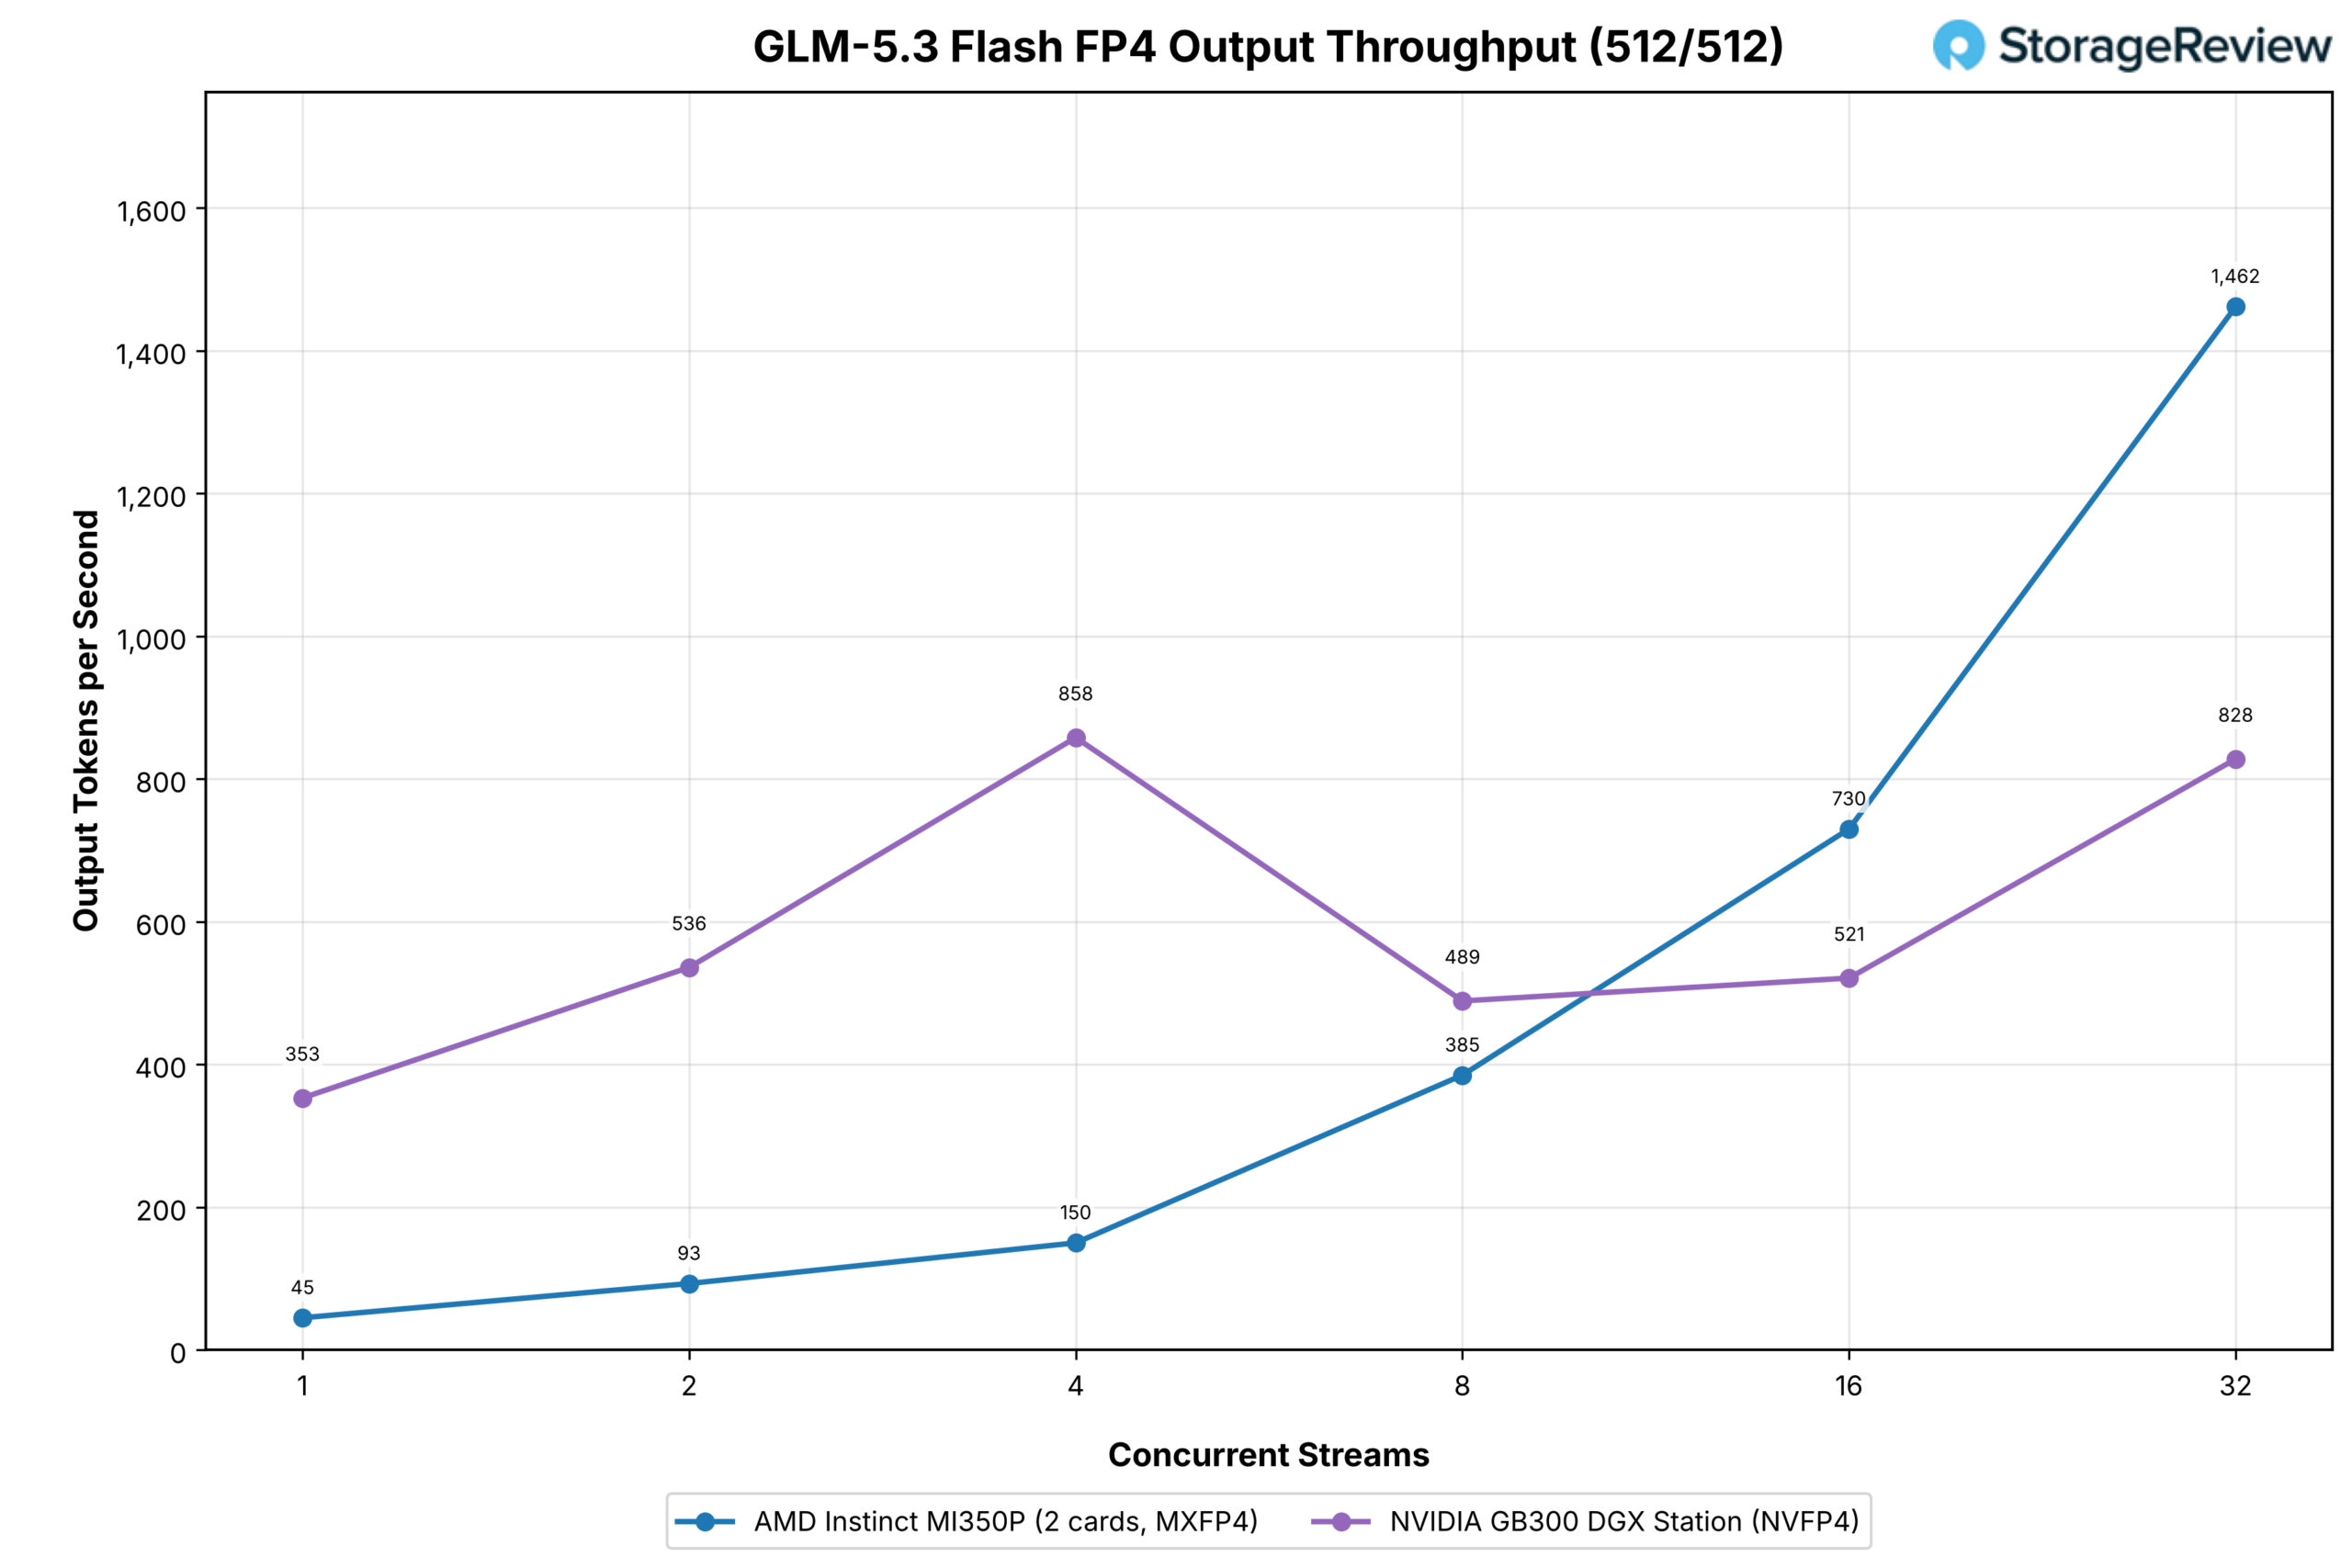
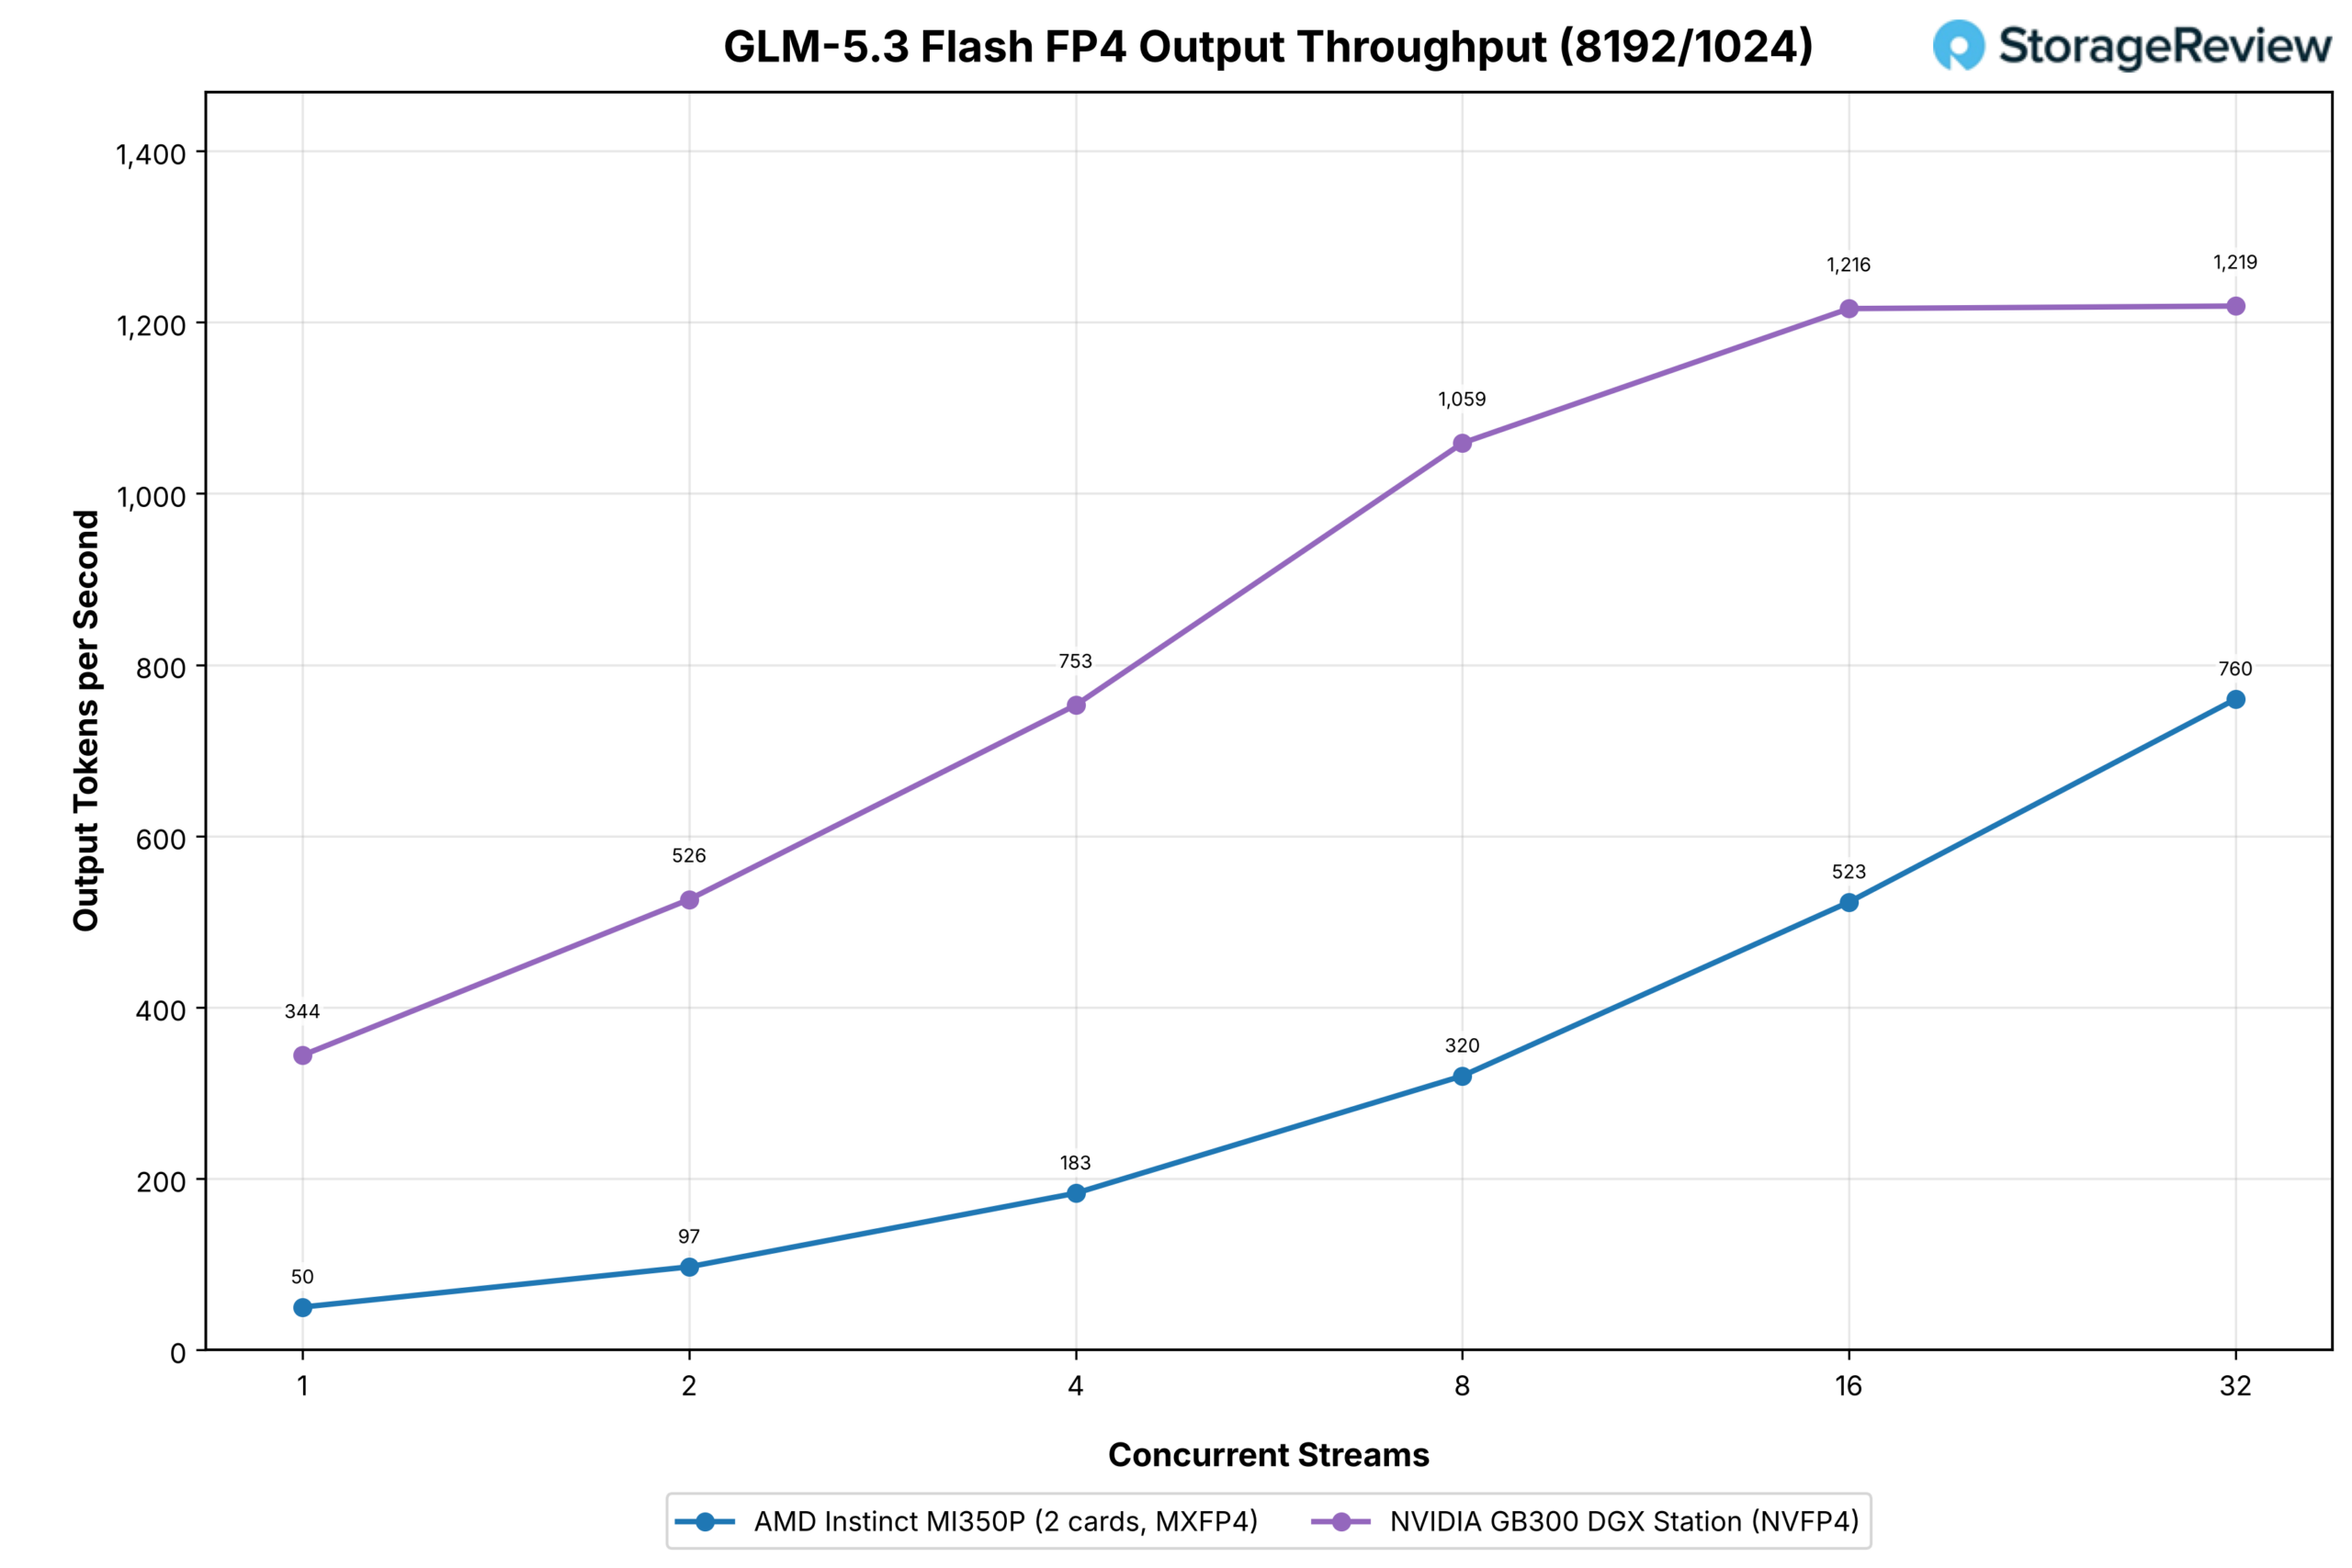
GLM-5.3 Flash no se ejecutó en la RTX PRO 6000, por lo que la comparación es de dos tarjetas MI350P contra una sola GB300 Station a través de 32 flujos. En la carga de trabajo de chat, el par MI350P comienza por detrás, 45 contra 353 tokens de salida por segundo en un flujo, y supera a la Station en ocho flujos camino a 1,462 en 32, contra 828 para la Station. En la carga de trabajo con mucho prefill, la Station lidera en todo momento, 1,219 contra 760 en 32 flujos, donde el prefill del par tiene que cruzar PCIe entre las dos tarjetas y la B300 lo hace todo en una sola pieza de HBM.
GLM-5.2
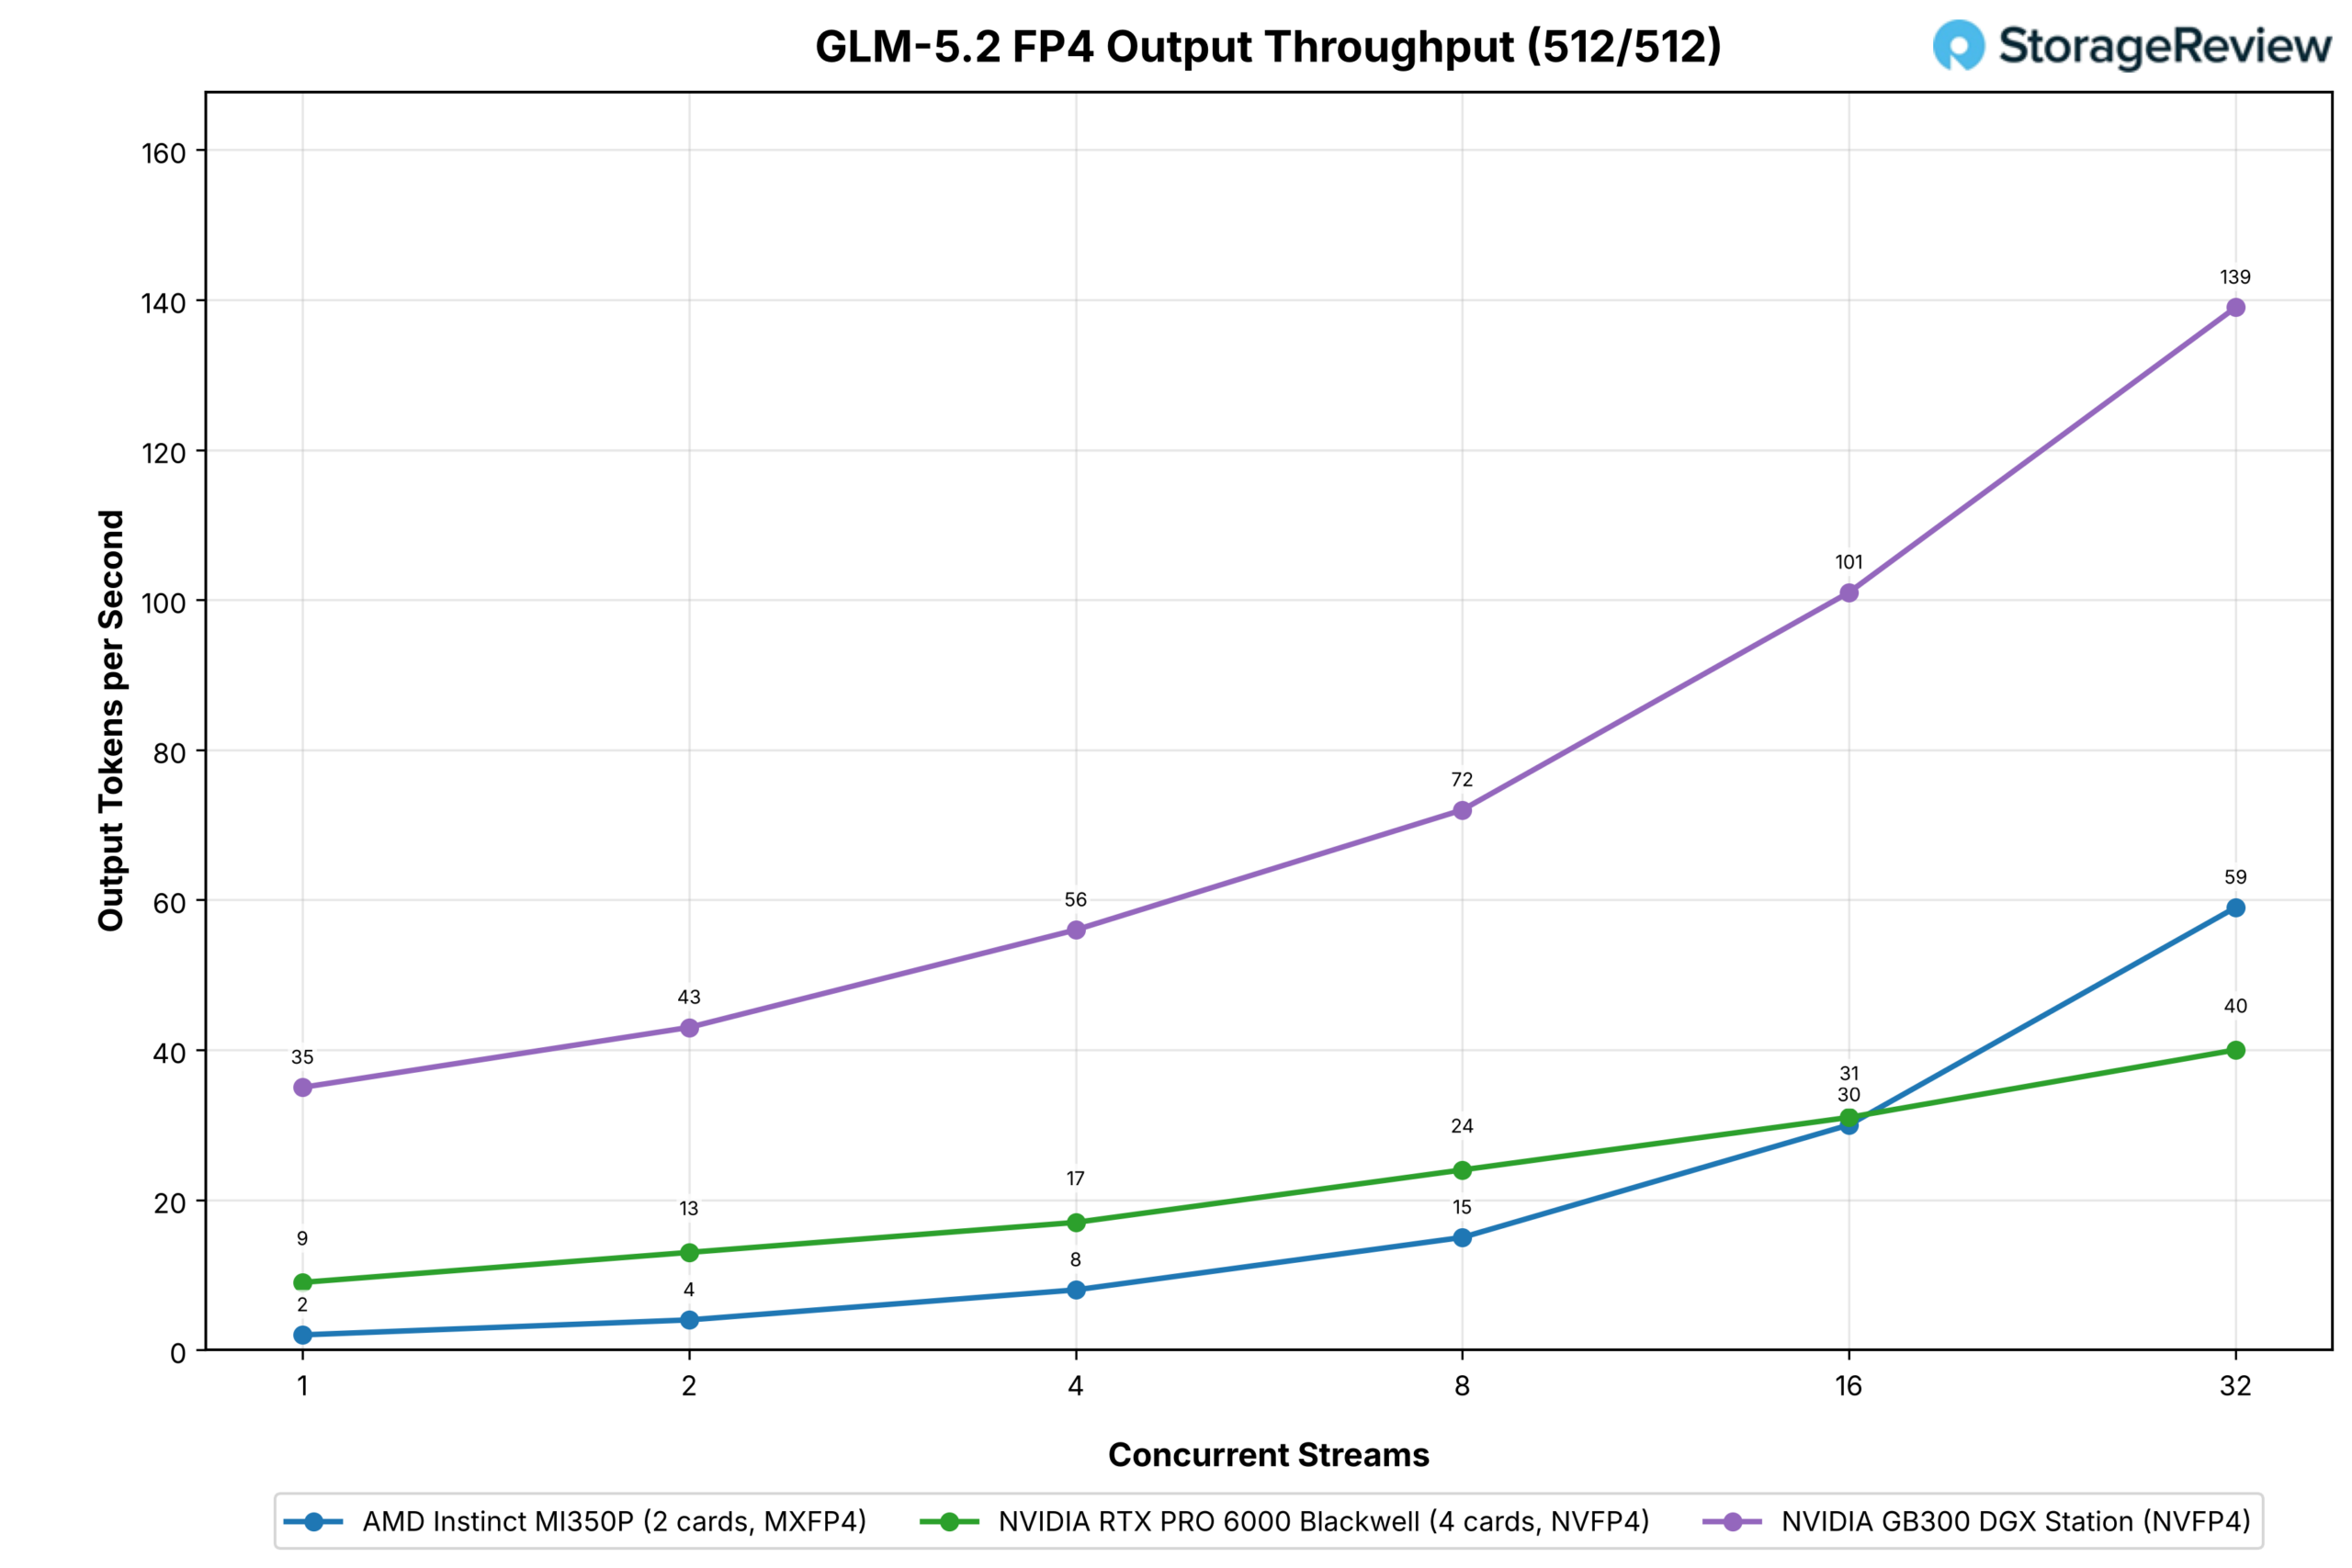
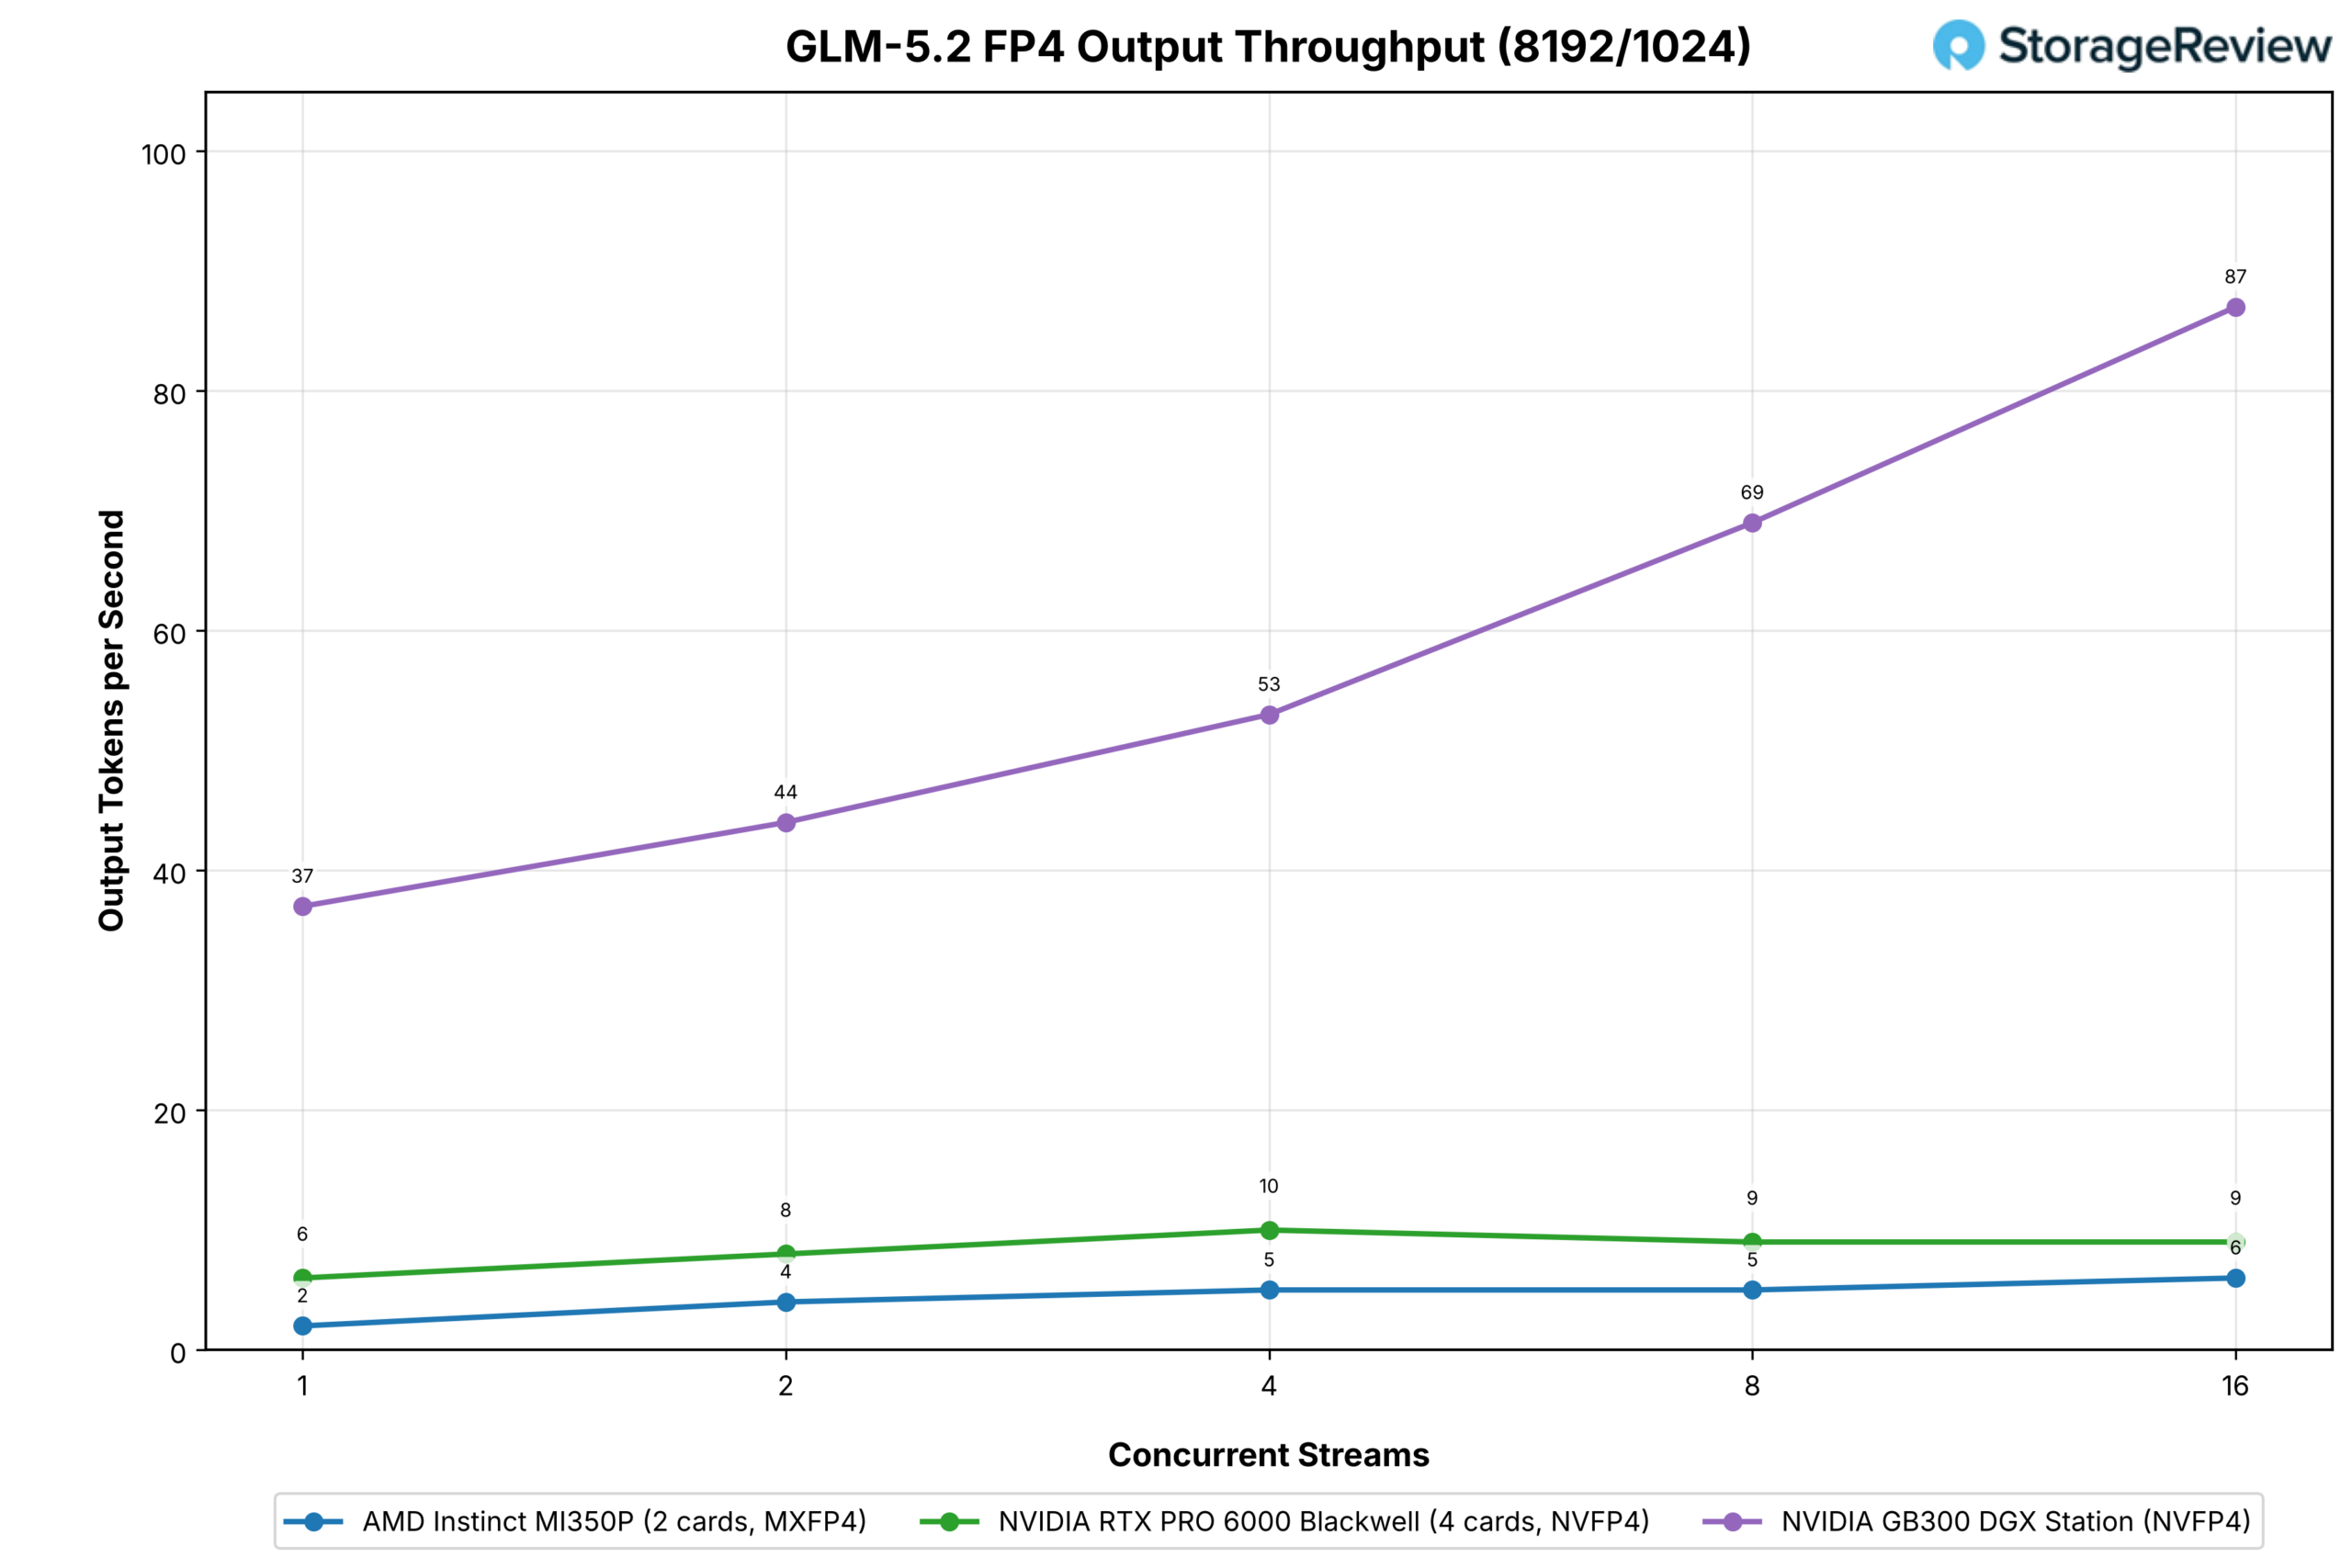
GLM-5.2 es la historia de la memoria en este conjunto. El punto de control MXFP4 se desborda más allá de los 288 GB de las dos tarjetas MI350P hacia la memoria del host, por lo que el rendimiento de flujo único es de 2 tokens de salida por segundo en el par frente a 9 para cuatro tarjetas RTX PRO 6000 que tienen la construcción NVFP4 en 384 GB de GDDR7 y 35 para la Estación, que descarga alrededor de 215 GB de pesos expertos a la memoria Grace. El cuádruple RTX lidera a través de 16 flujos en la carga de trabajo de chat; a 32 el par MI350P llega a 59 frente a 40, y la Estación llega a 139. En indicaciones con mucho prellenado, ninguna configuración PCIe pasa de un solo dígito a través de 16 flujos, frente a 87 para la Estación.
MiniMax-M3
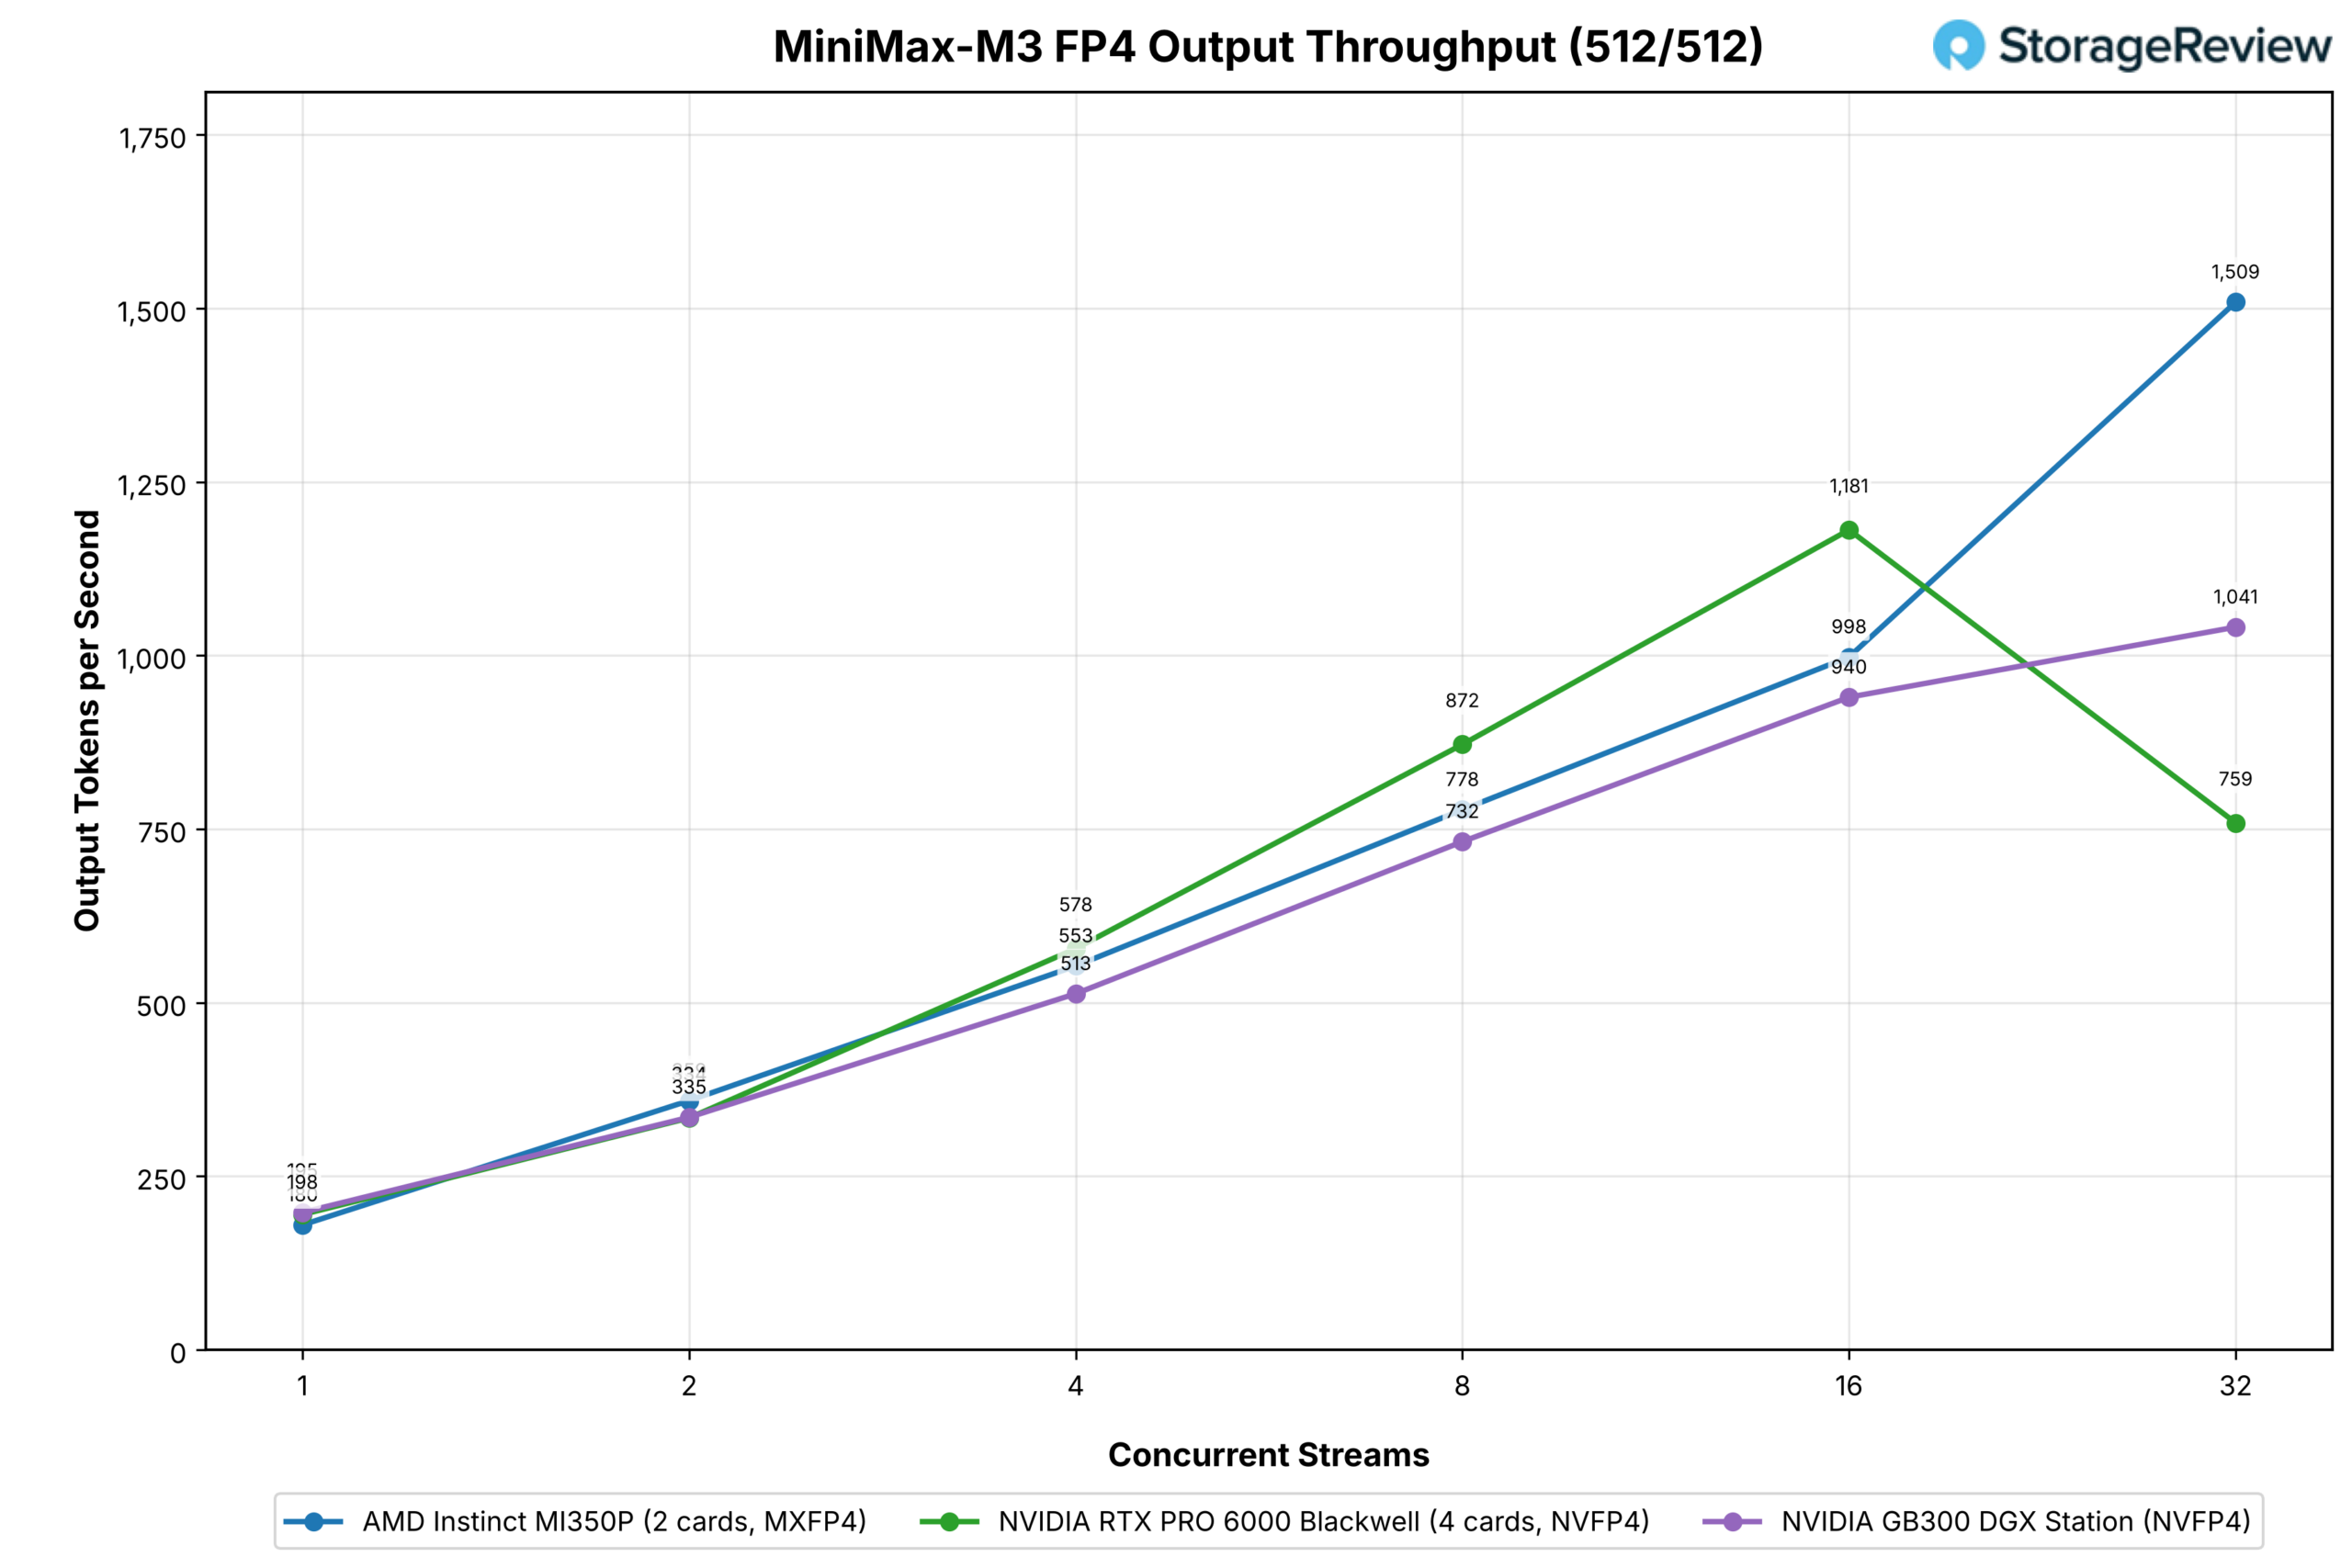
Dos MI350P contienen la compilación MXFP4 de MiniMax-M3 en 288 GB; el lado de NVIDIA necesita cuatro tarjetas RTX PRO 6000. Las tres configuraciones funcionan con una diferencia de menos del 10 por ciento entre sí a través de ocho transmisiones en la carga de trabajo de chat; el cuádruple RTX toma la delantera en 16 (1,181 frente a 998 para el par y 940 para la Estación), y en 32 el par MI350P lee 1,509 frente a 759 para el cuádruple y 1,041 para la Estación.
En las solicitudes con mucha precarga, el par MI350P lidera en todos los puntos a través de ocho flujos, 524 frente a 444 para el cuádruple, mientras que la Estación, que mantiene una parte de los expertos de este modelo en la memoria Grace, cae a 103.
Flash DeepSeek-V4
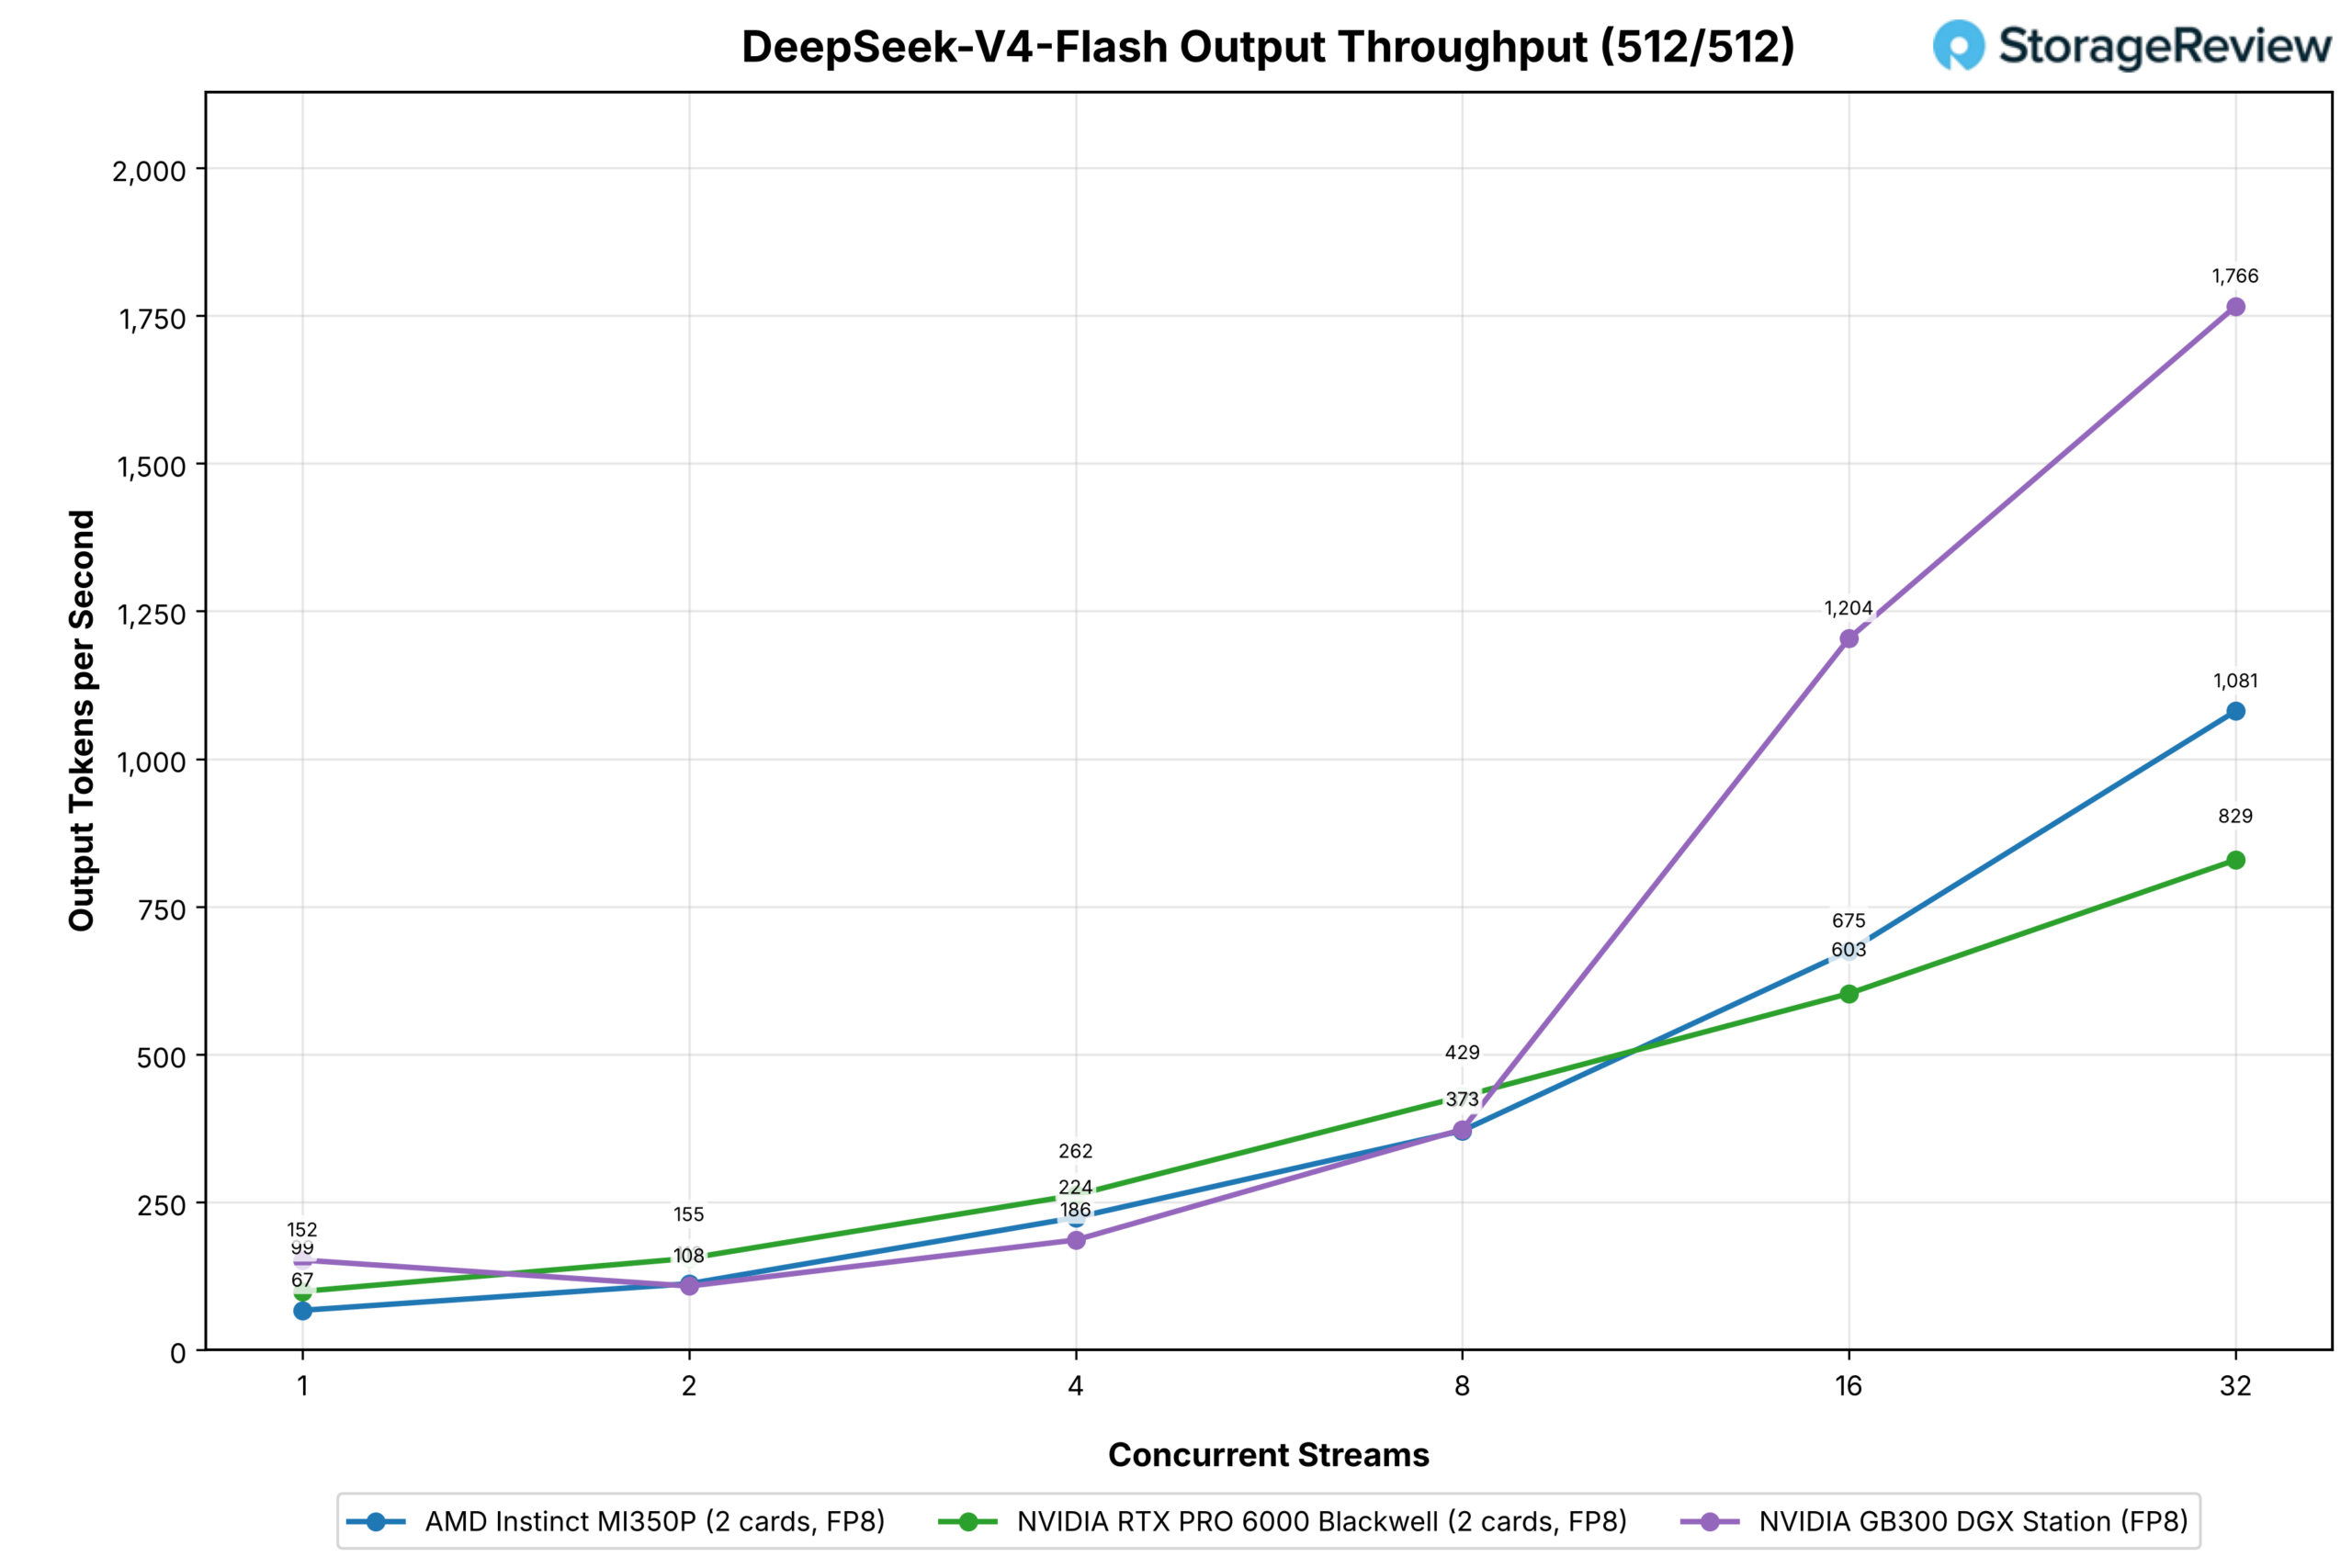
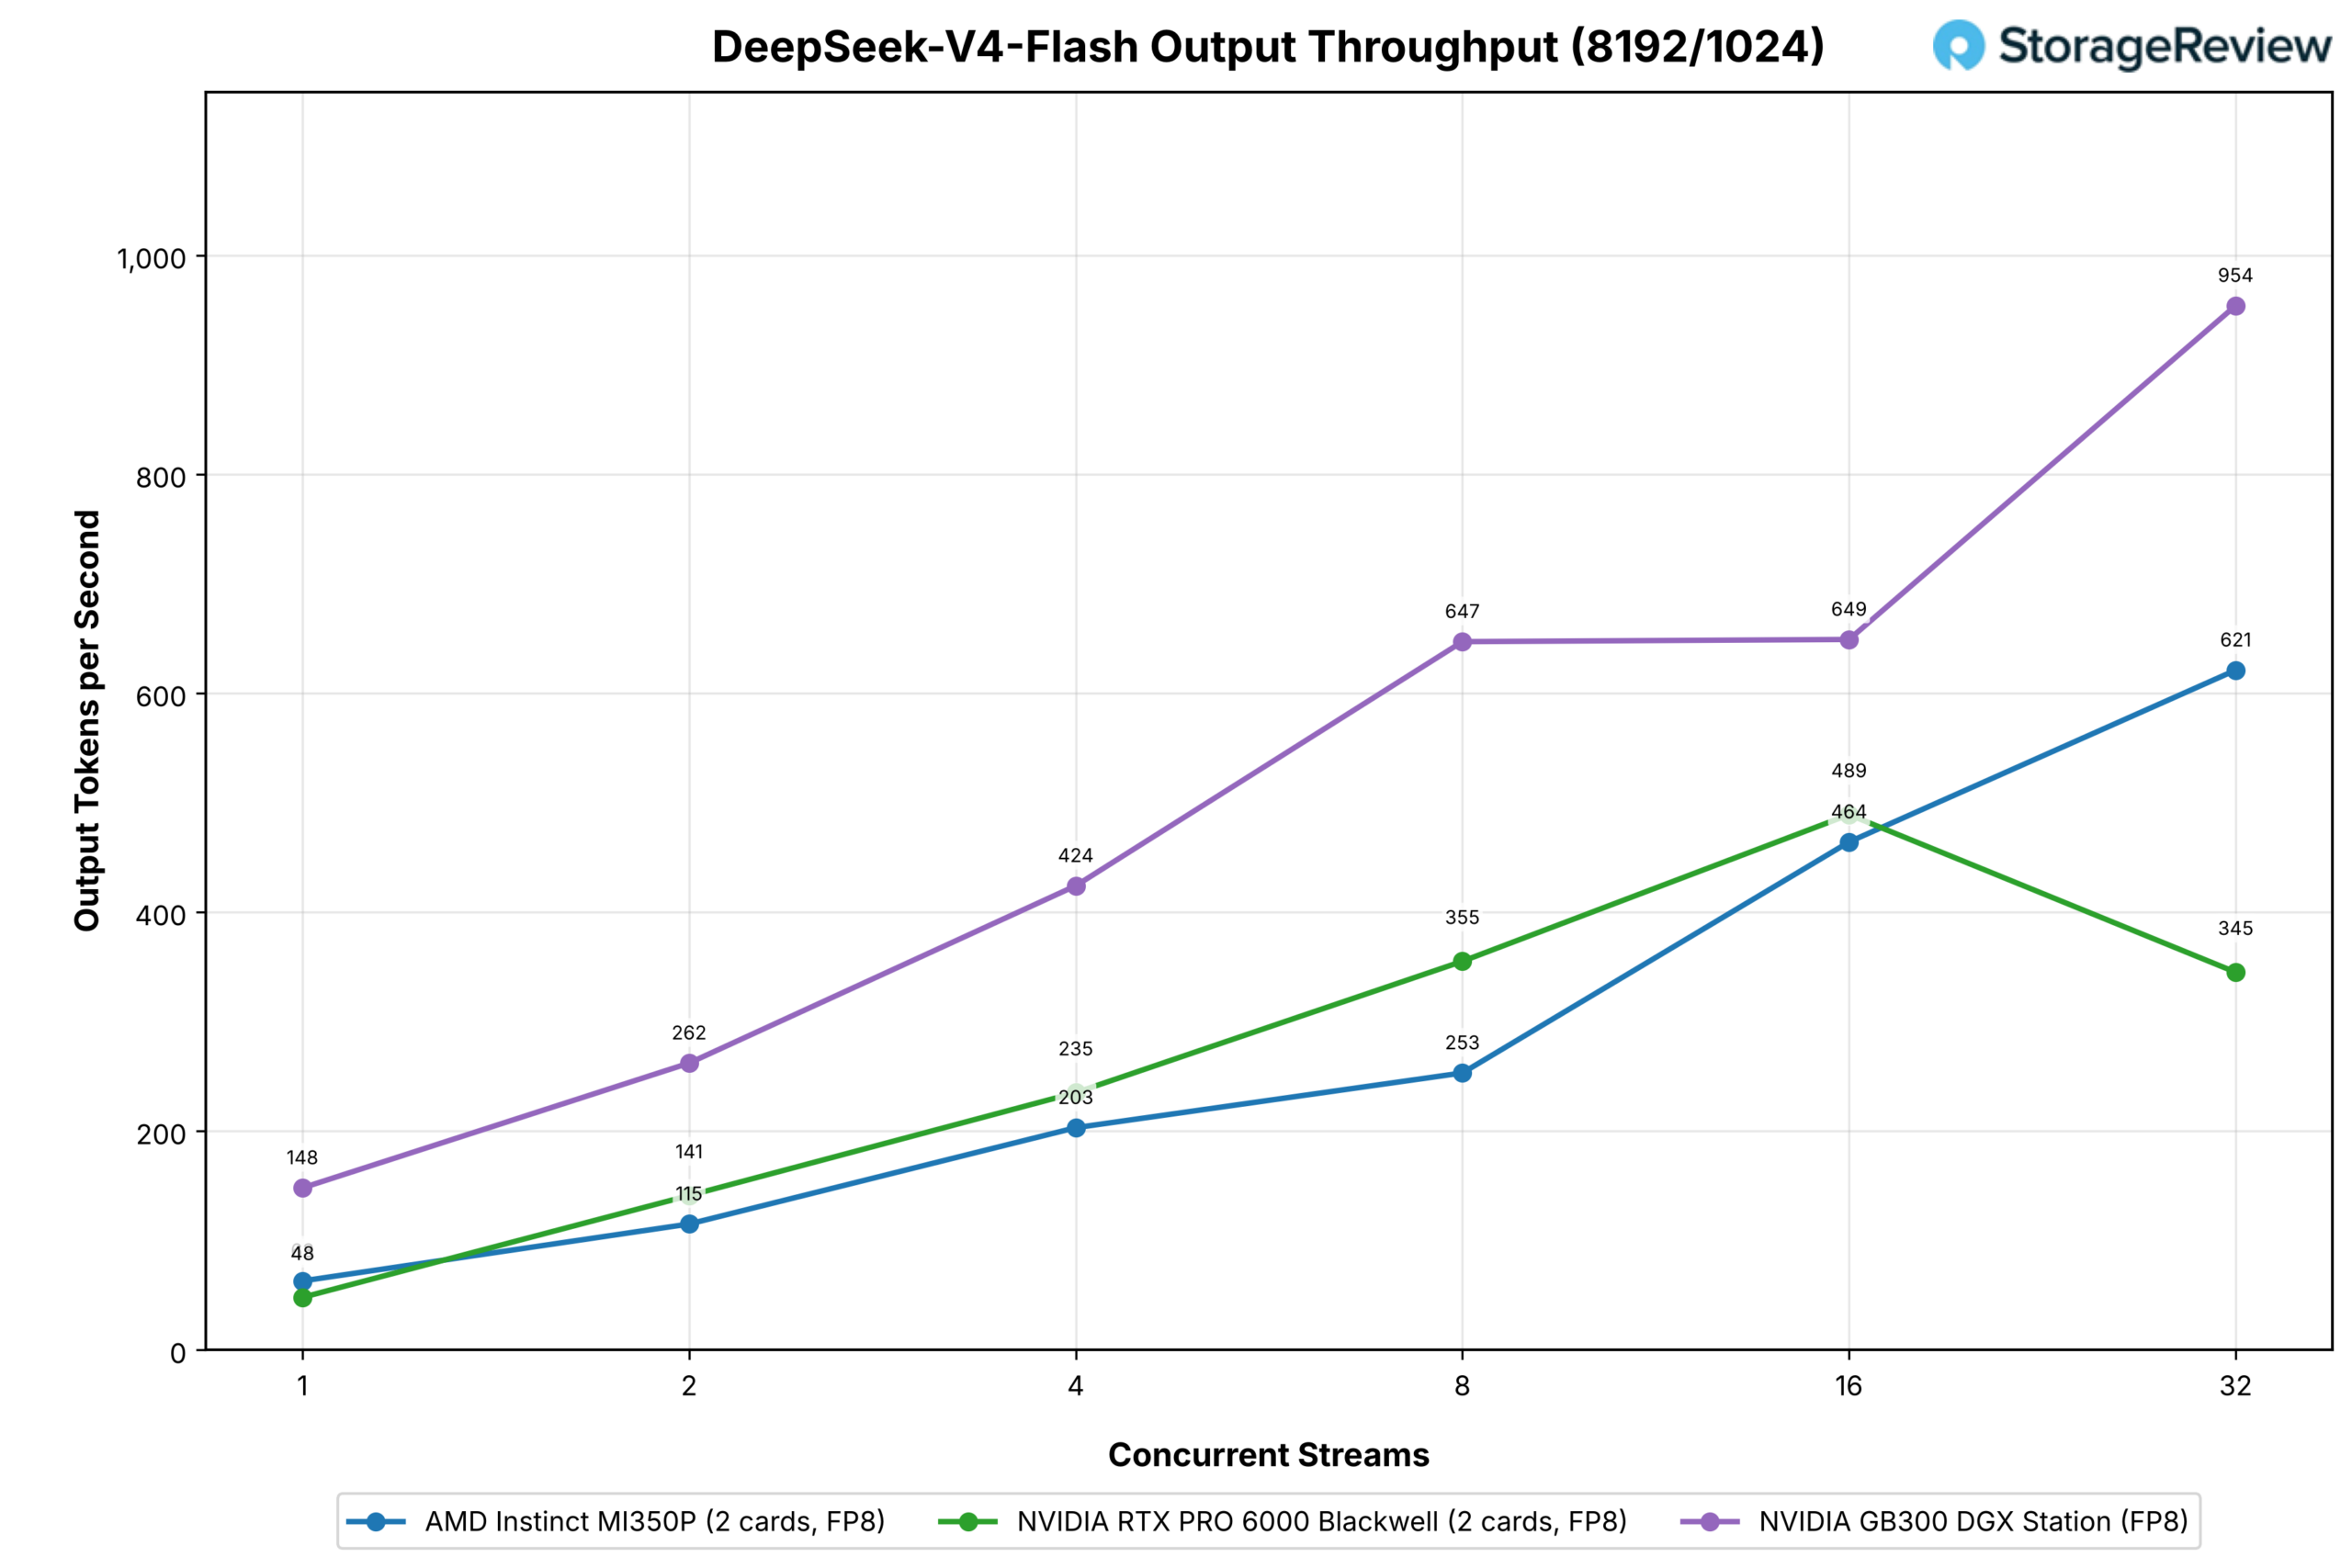
Con dos tarjetas en cada lado y el punto de control FP8 nativo, el par RTX PRO 6000 lidera a través de ocho transmisiones en la carga de trabajo de chat y el par MI350P toma el relevo desde 16, terminando en 1,081 frente a 829 en 32 transmisiones; la única Station alcanza 1,766 en el mismo punto. La ejecución con prellenado intensivo sigue el mismo patrón, el par MI350P en 621 frente a 345 para el par RTX en 32 transmisiones y 954 para la Station.
MiniMax-M2.7
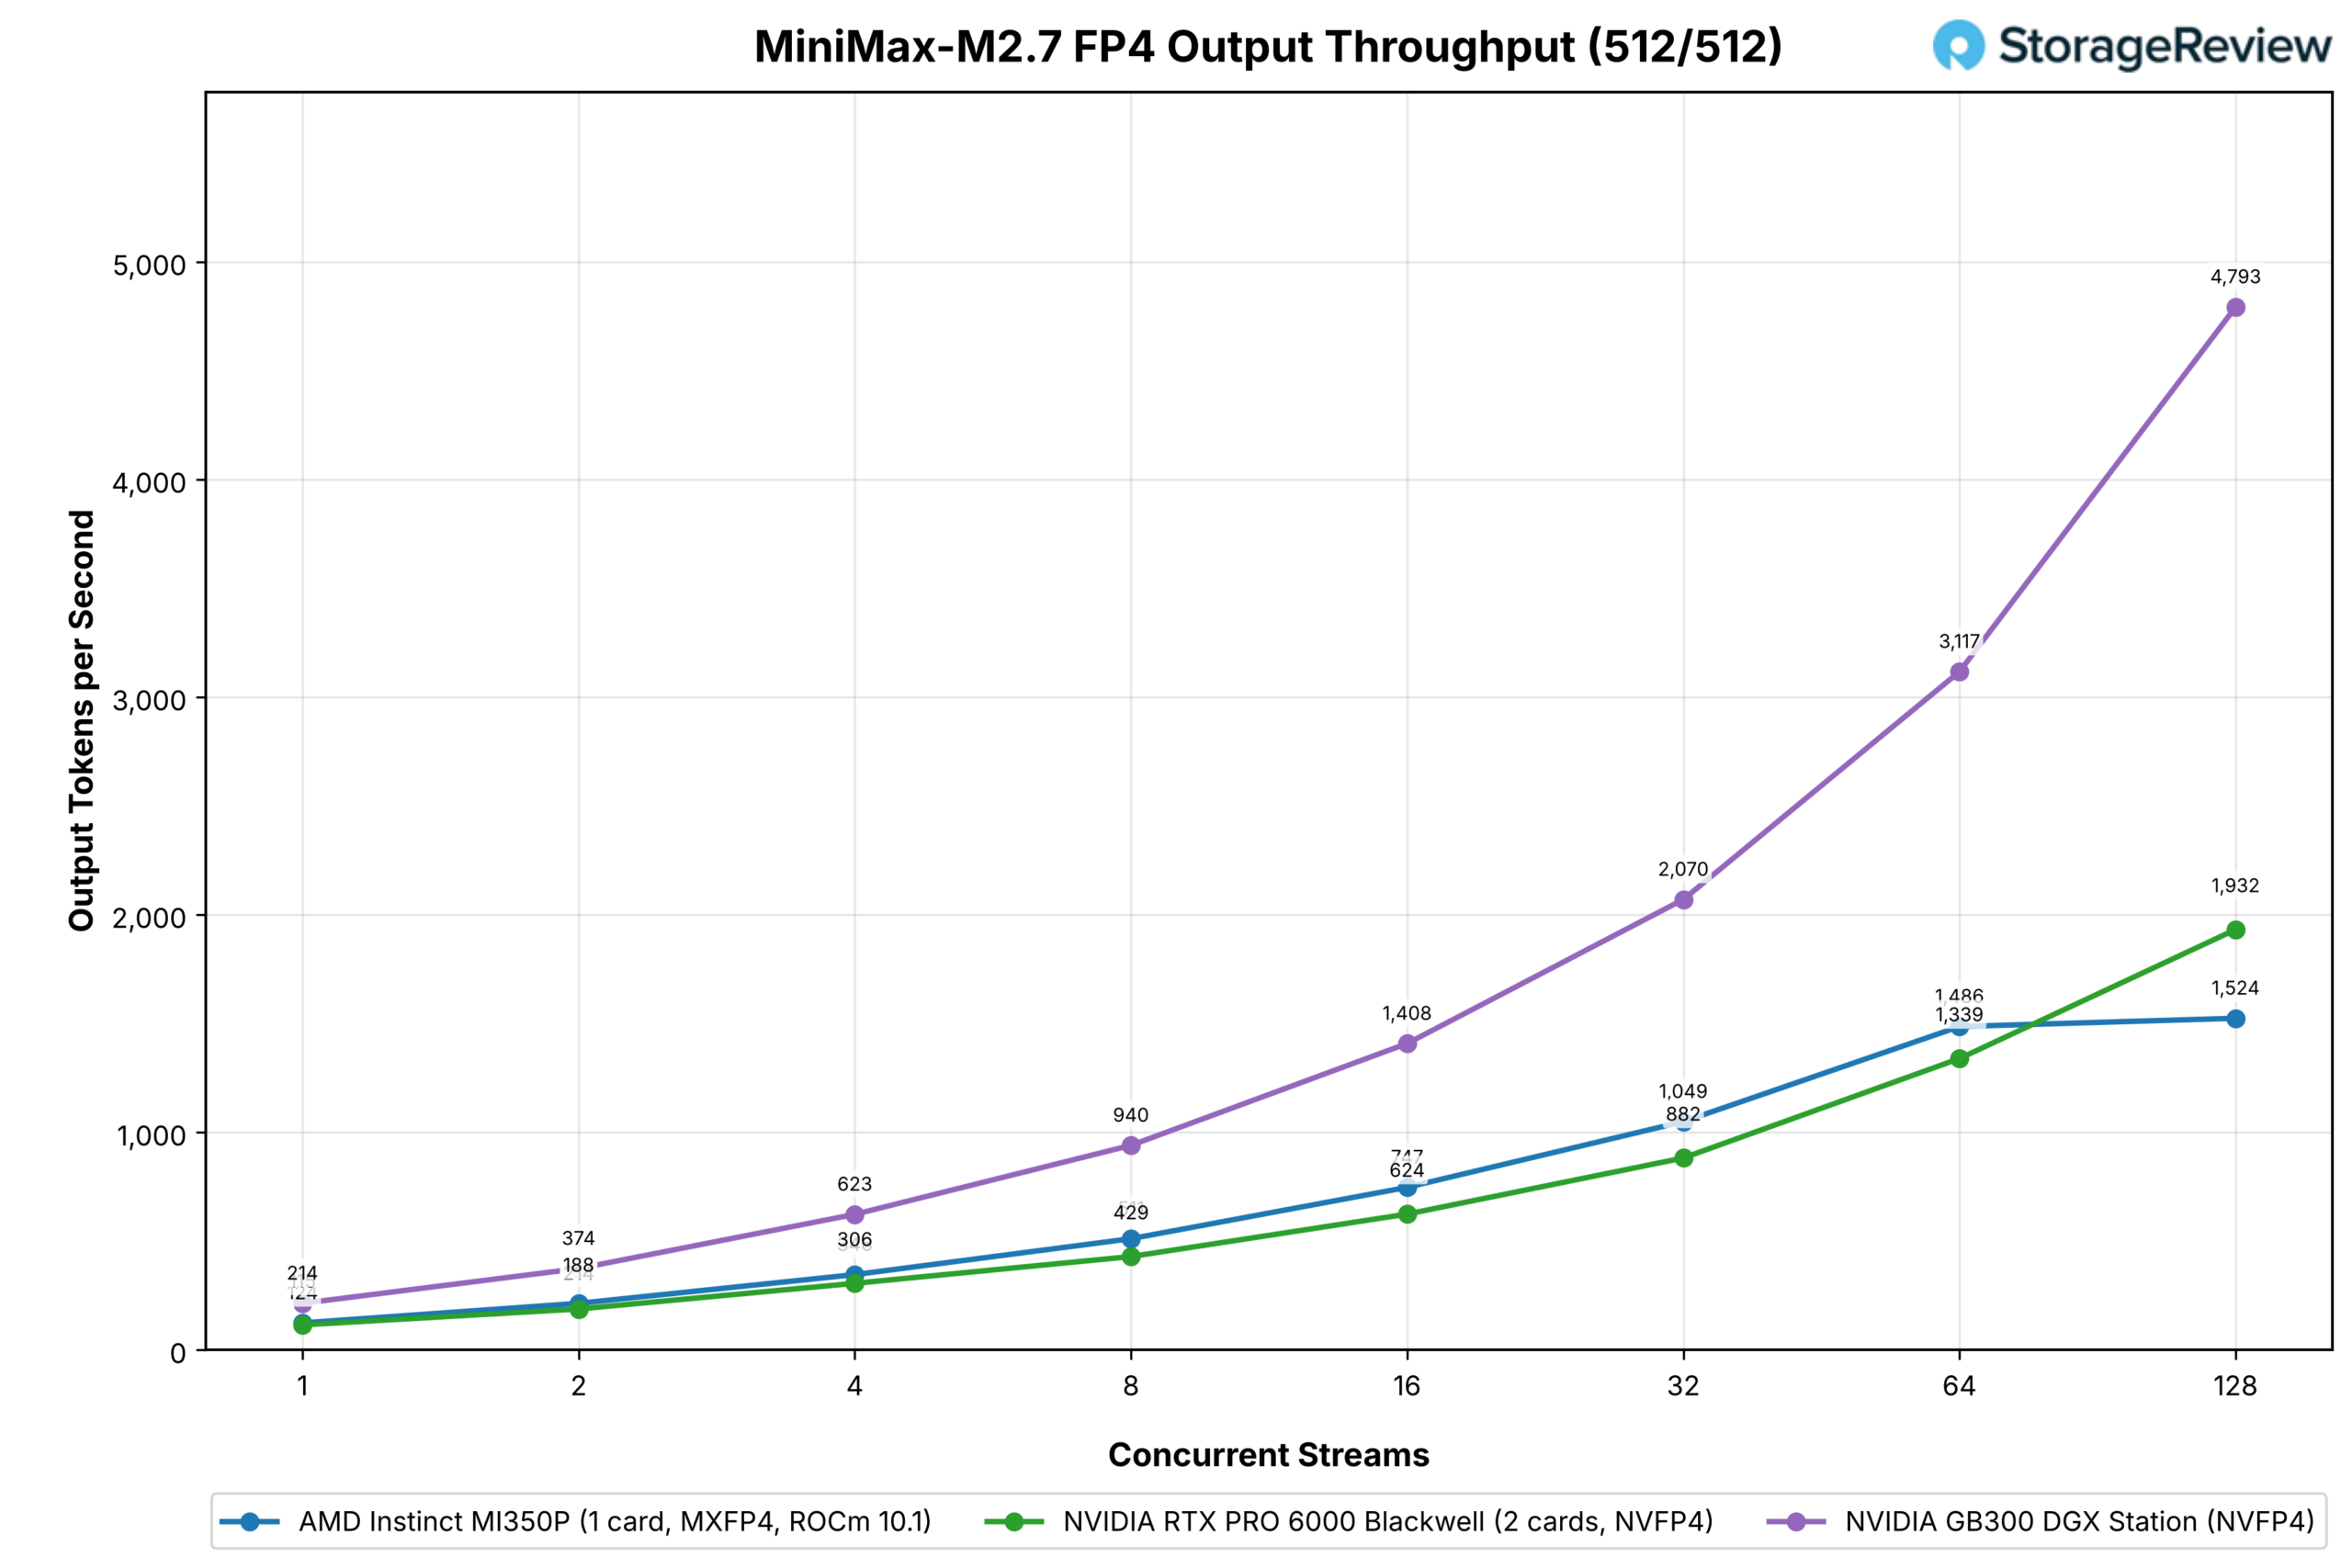
Una MI350P lleva la compilación MXFP4 de MiniMax-M2.7 frente a dos tarjetas RTX PRO 6000 en NVFP4. La MI350P individual lidera al par en una transmisión (124 frente a 115), se mantiene entre un 8 y un 20 por ciento por delante hasta 64 transmisiones 1,486 frente a 1,339, luego se estabiliza en 1,524 en 128 y 1,557 en 256, mientras que el par RTX continúa hasta 1,932 y 2,842; la Station alcanza 4,793.
En cargas de trabajo con gran cantidad de precarga, el MI350P mantiene un rendimiento de entre 304 y 331 tokens de salida por segundo desde ocho flujos hasta 64, frente a 501 para el par RTX y 1,744 para la Estación.
GPT-OSS-120B
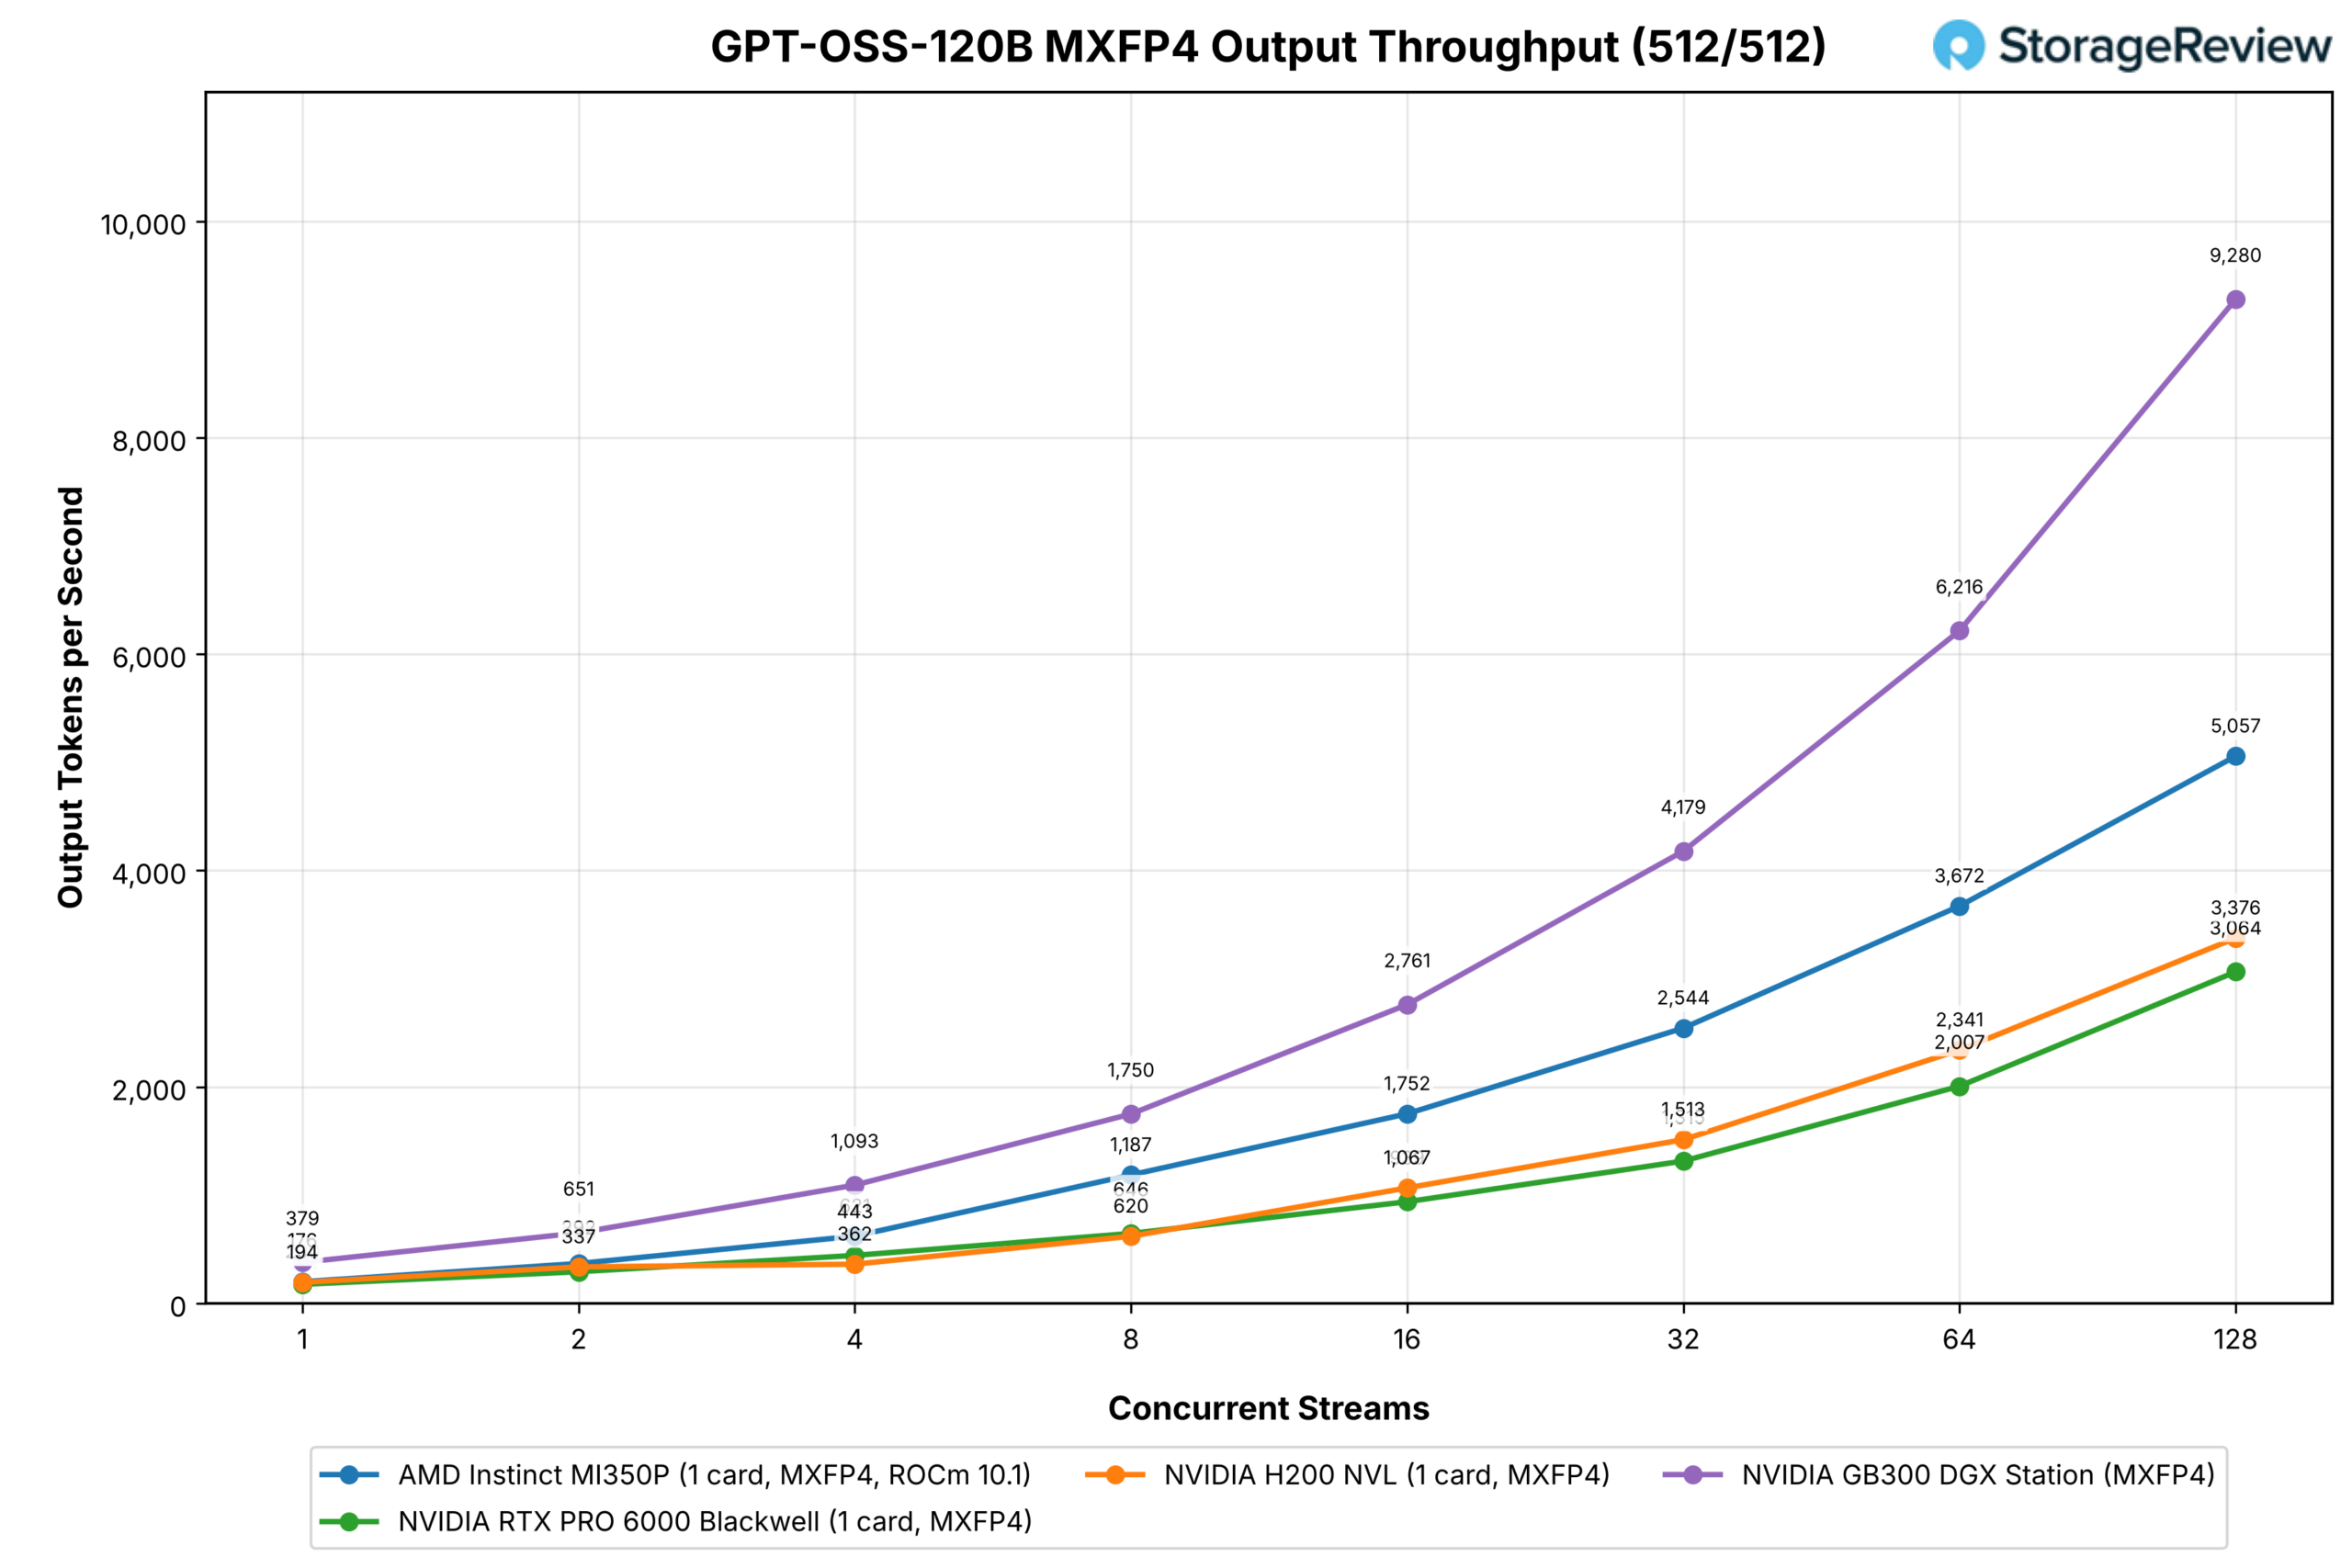
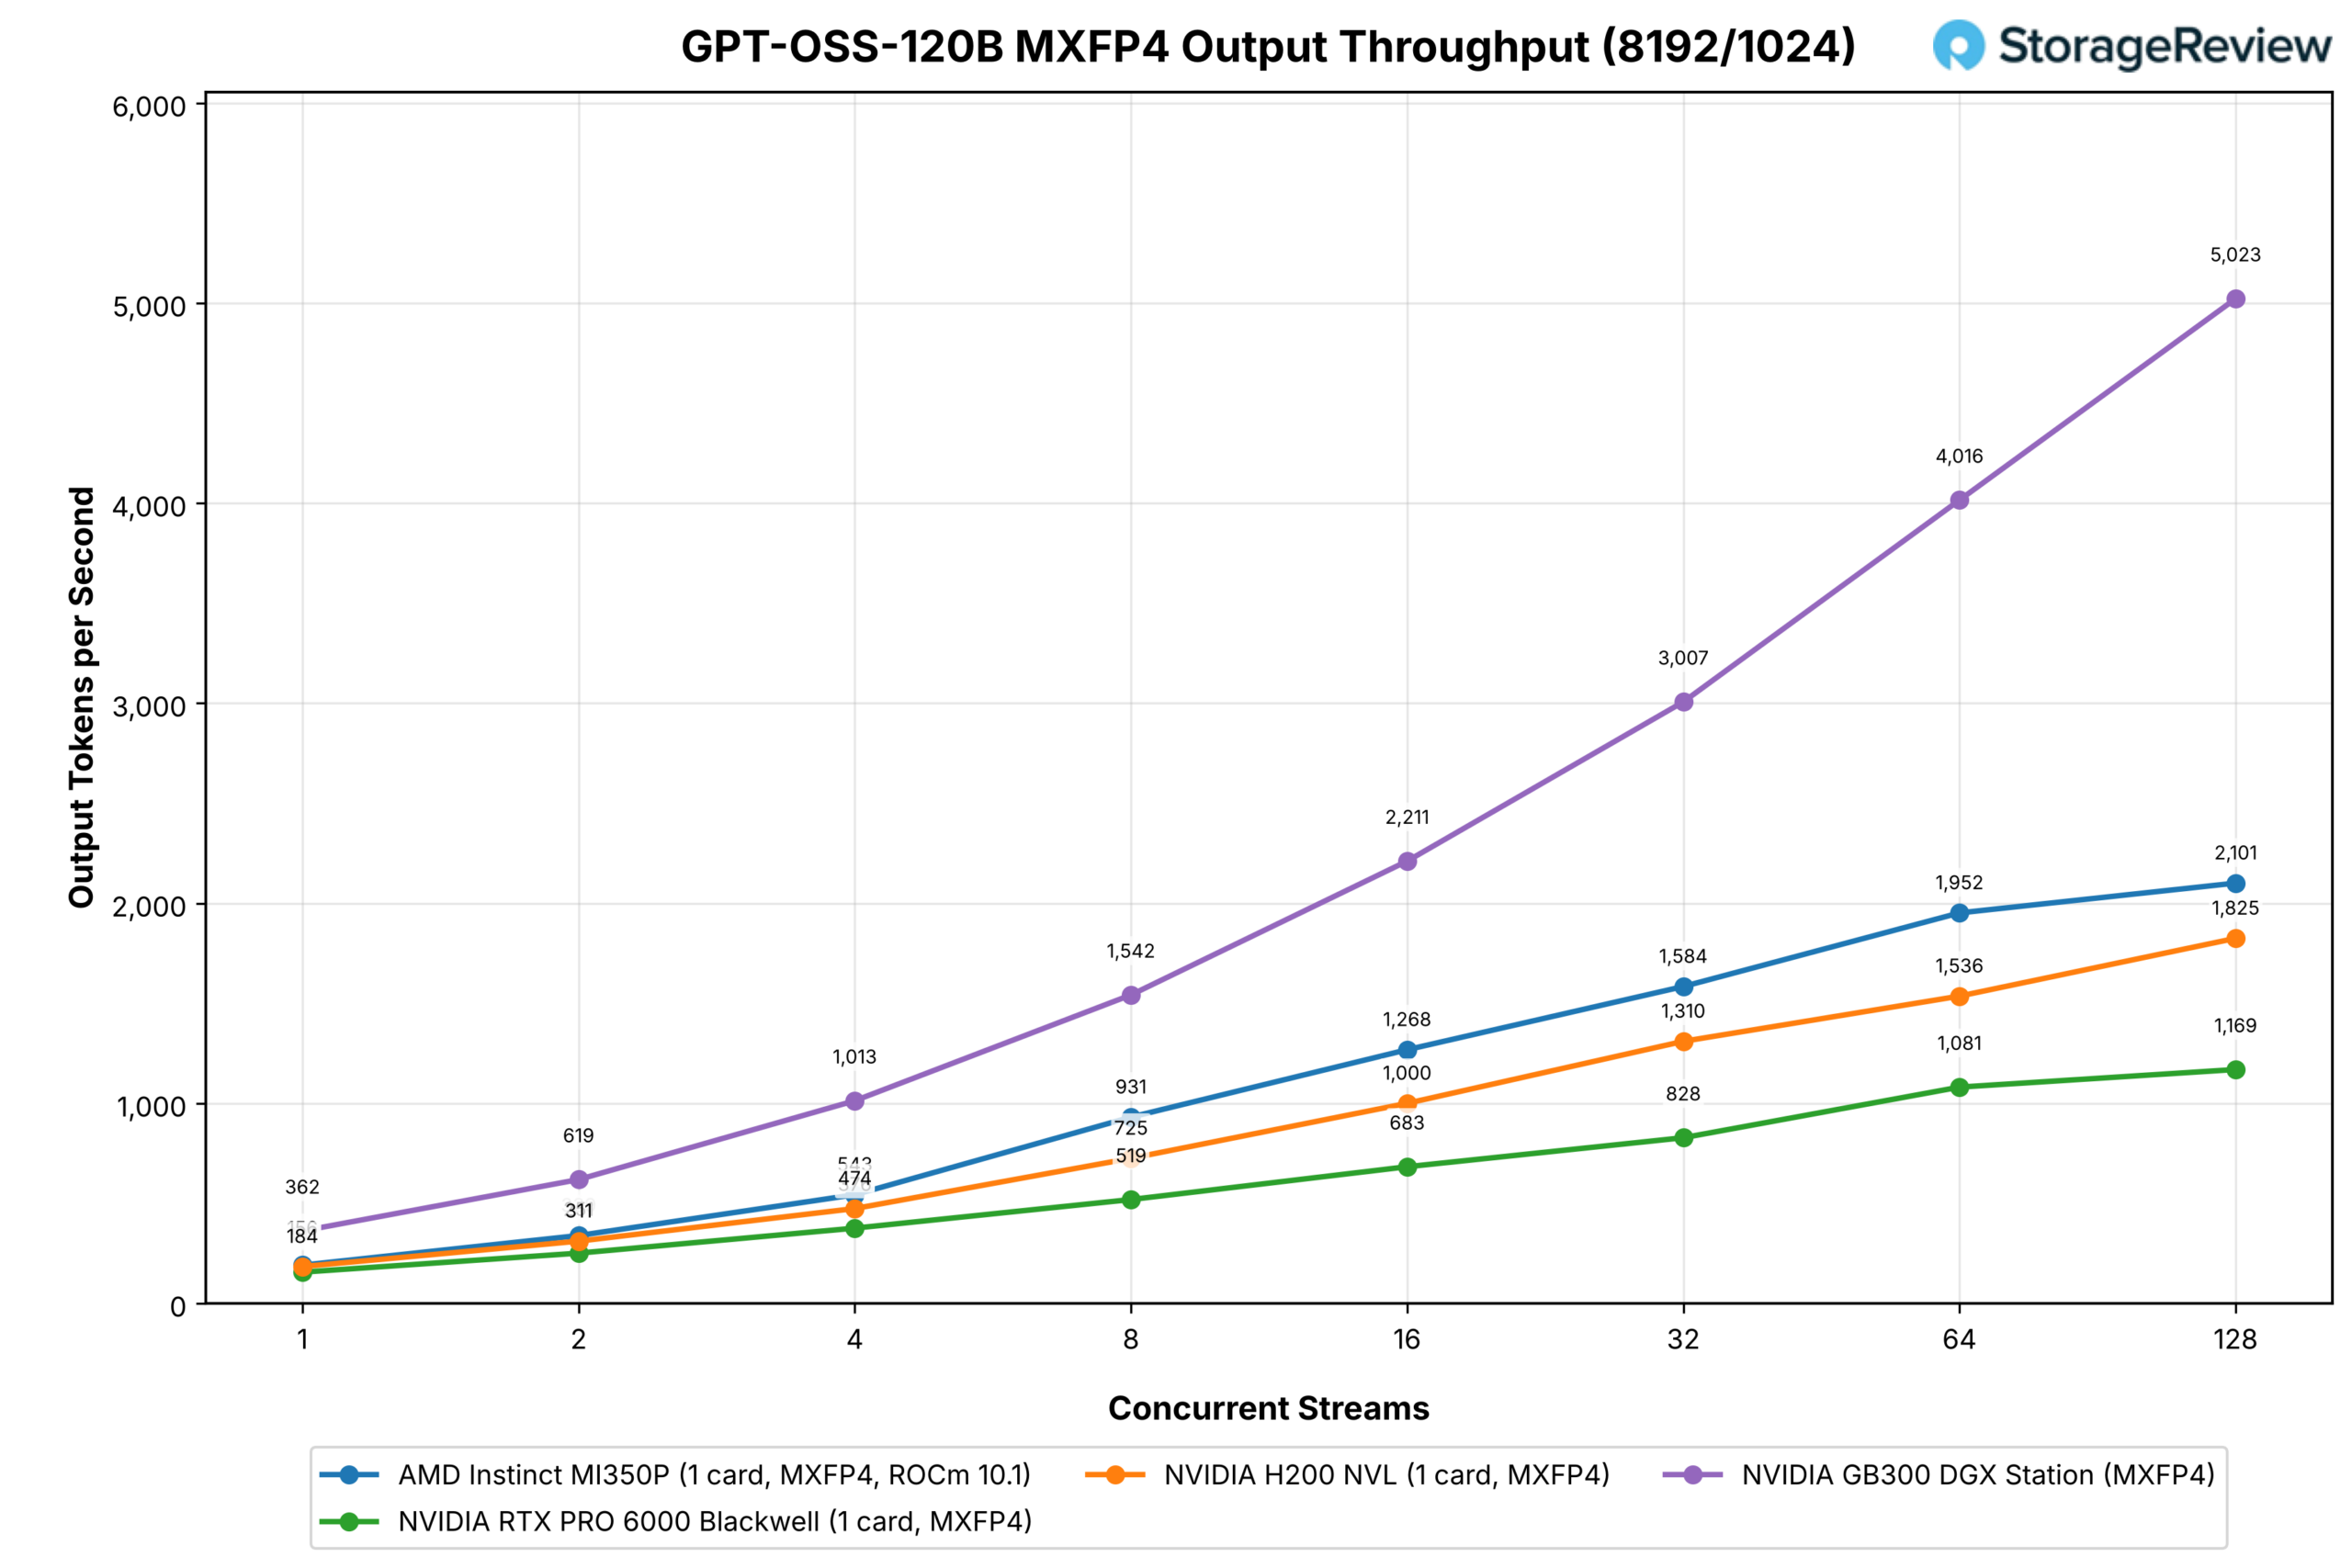
GPT-OSS se envía como MXFP4, por lo que cada tarjeta ejecuta los mismos pesos. Una MI350P supera a una RTX PRO 6000 en cada recuento de flujos en ambas cargas de trabajo, entre un 40 y un 93 por ciento a partir de cuatro flujos, y termina en 5,057 tokens de salida por segundo en la carga de trabajo de chat y 2,101 en indicaciones con mucho prellenado en 128 flujos, frente a 3,064 y 1,169 para la RTX PRO 6000 y 3,376 y 1,825 para la H200 NVL; la Station alcanza 9,280 y 5,023.
La prueba MLPerf Inference v6.1 de AMD y Dell, presentada el 16 de septiembre, establece un límite para el mismo modelo: ocho MI350P en un PowerEdge XE7745 produjeron 48,971 tokens por segundo sin conexión y 40,868 en el escenario de servidor con GPT-OSS-120B, lo que equivale a 6,121 y 5,108 por GPU, en una configuración optimizada. Si bien la nuestra y la de este sistema no son idénticas, los 5,057 tokens que medimos con 128 flujos en la versión estándar de vLLM se sitúan en el extremo inferior de ese rango.
GPT-OSS-20B
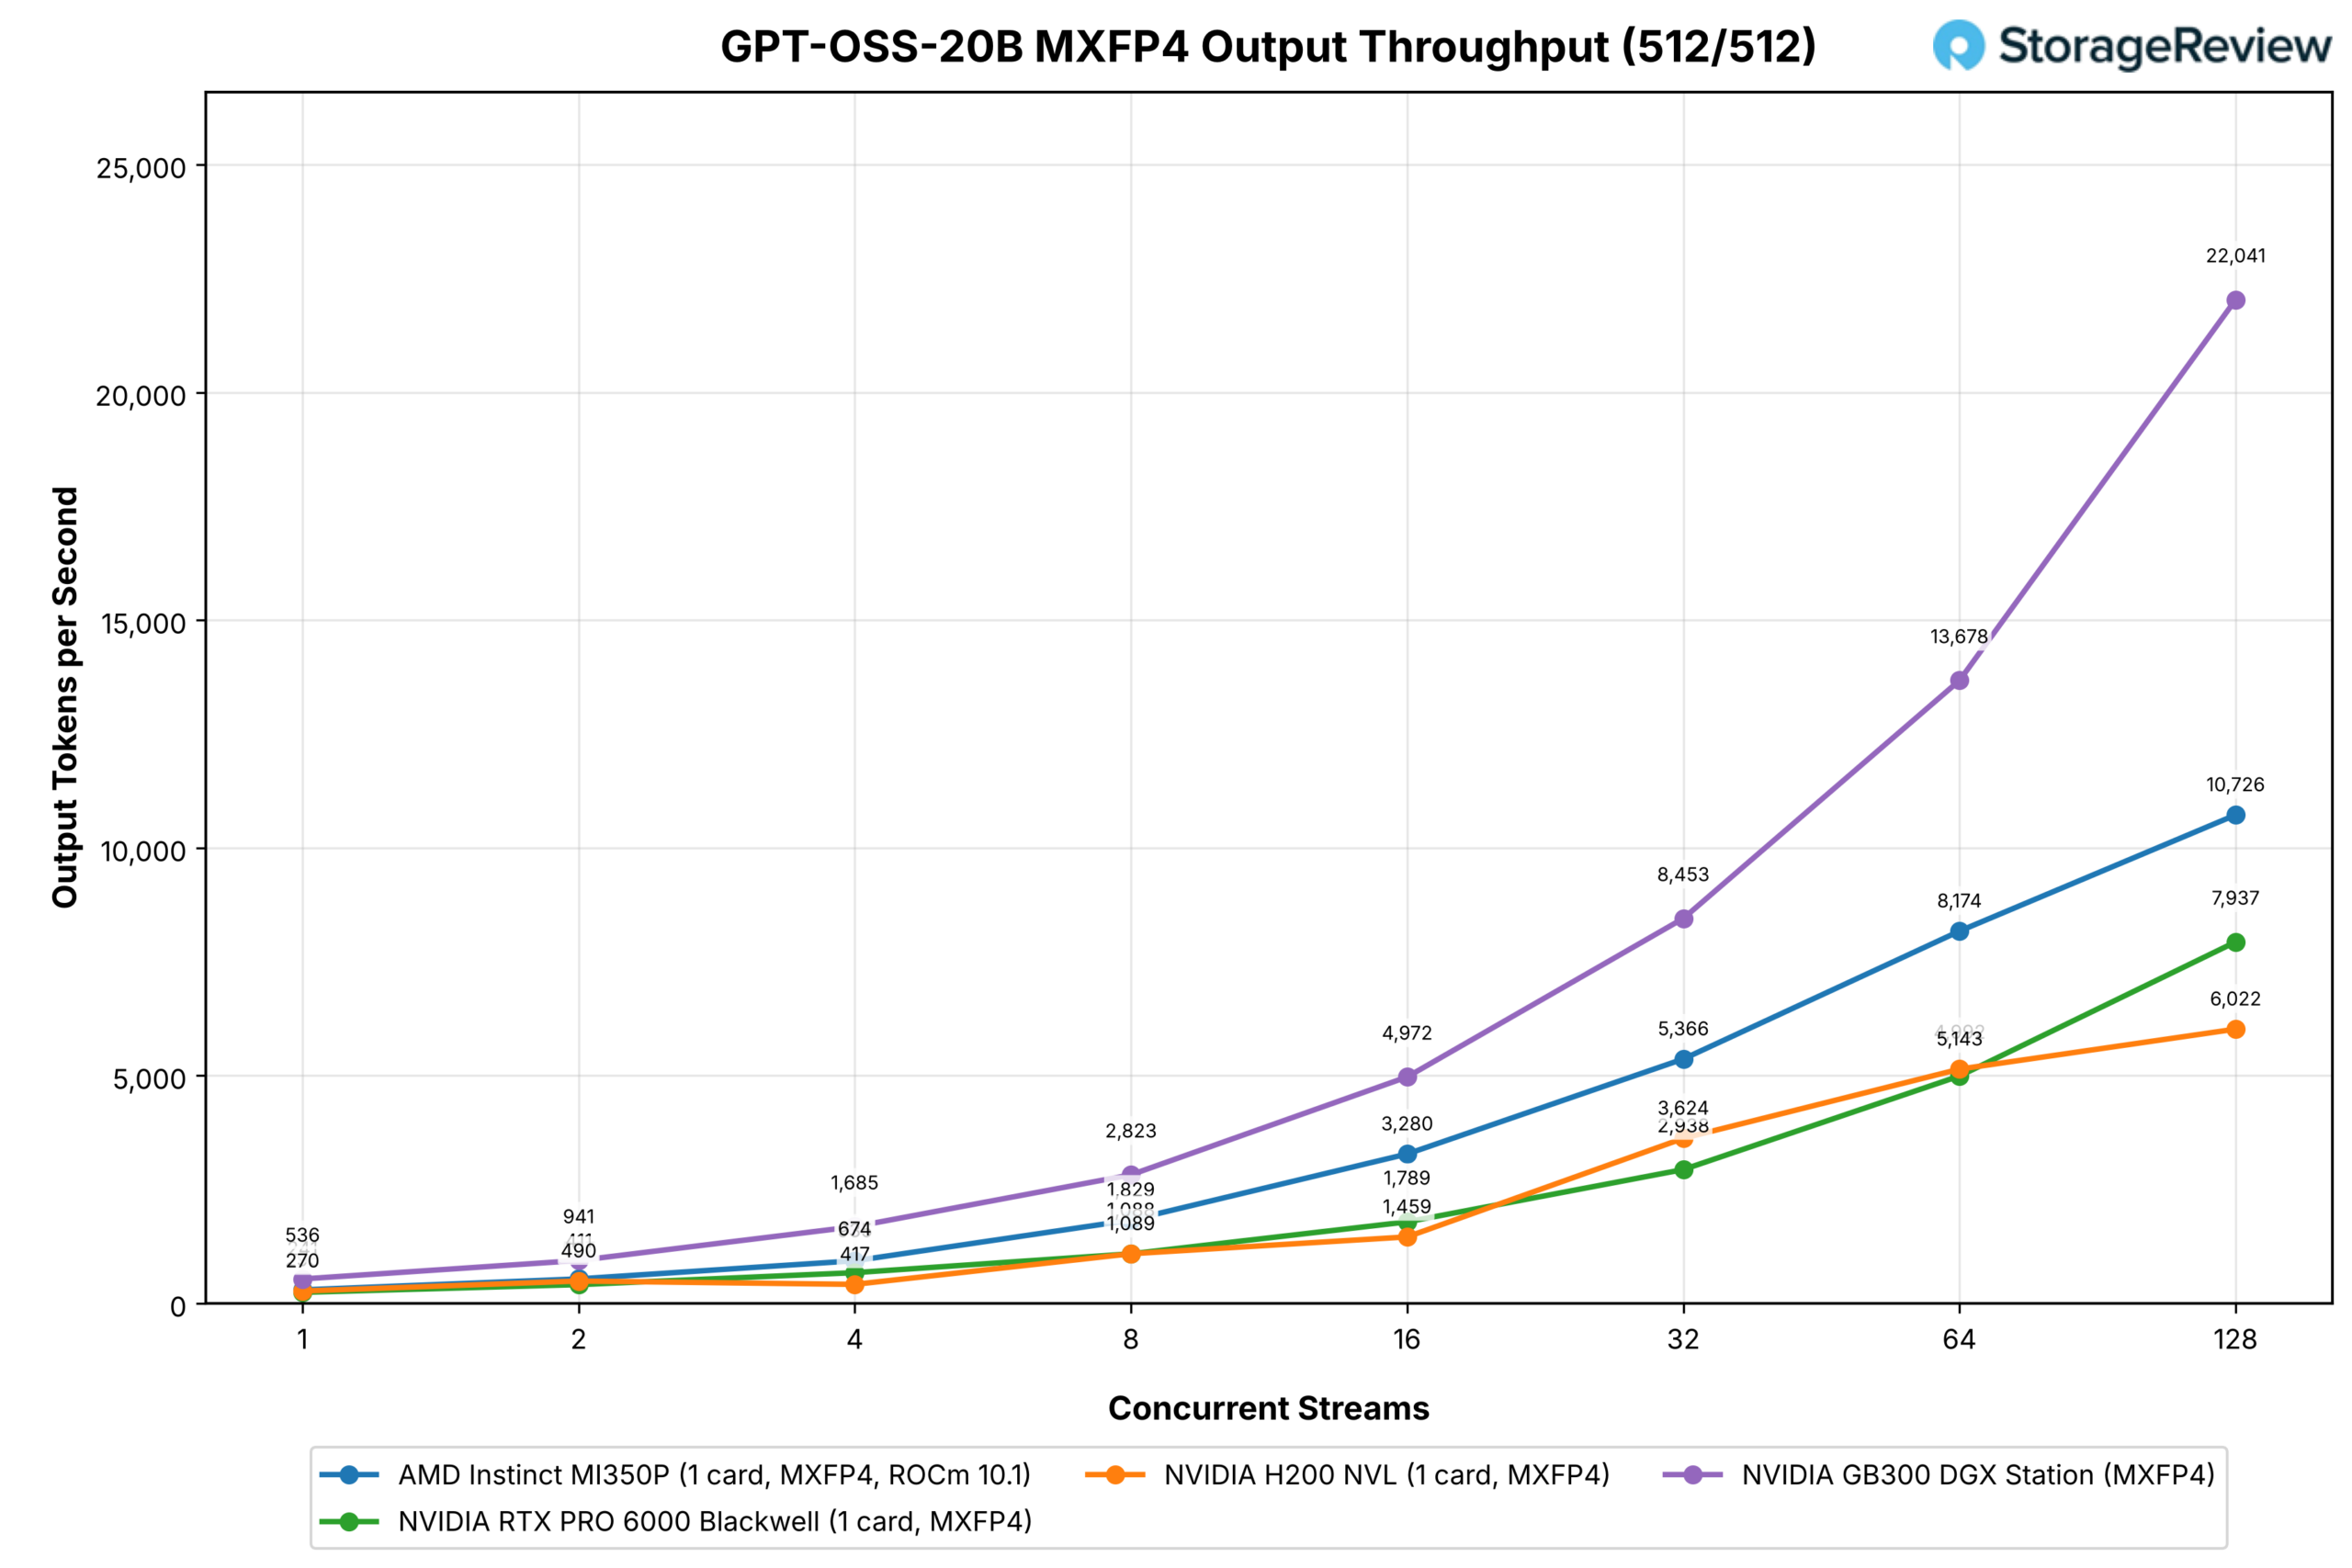
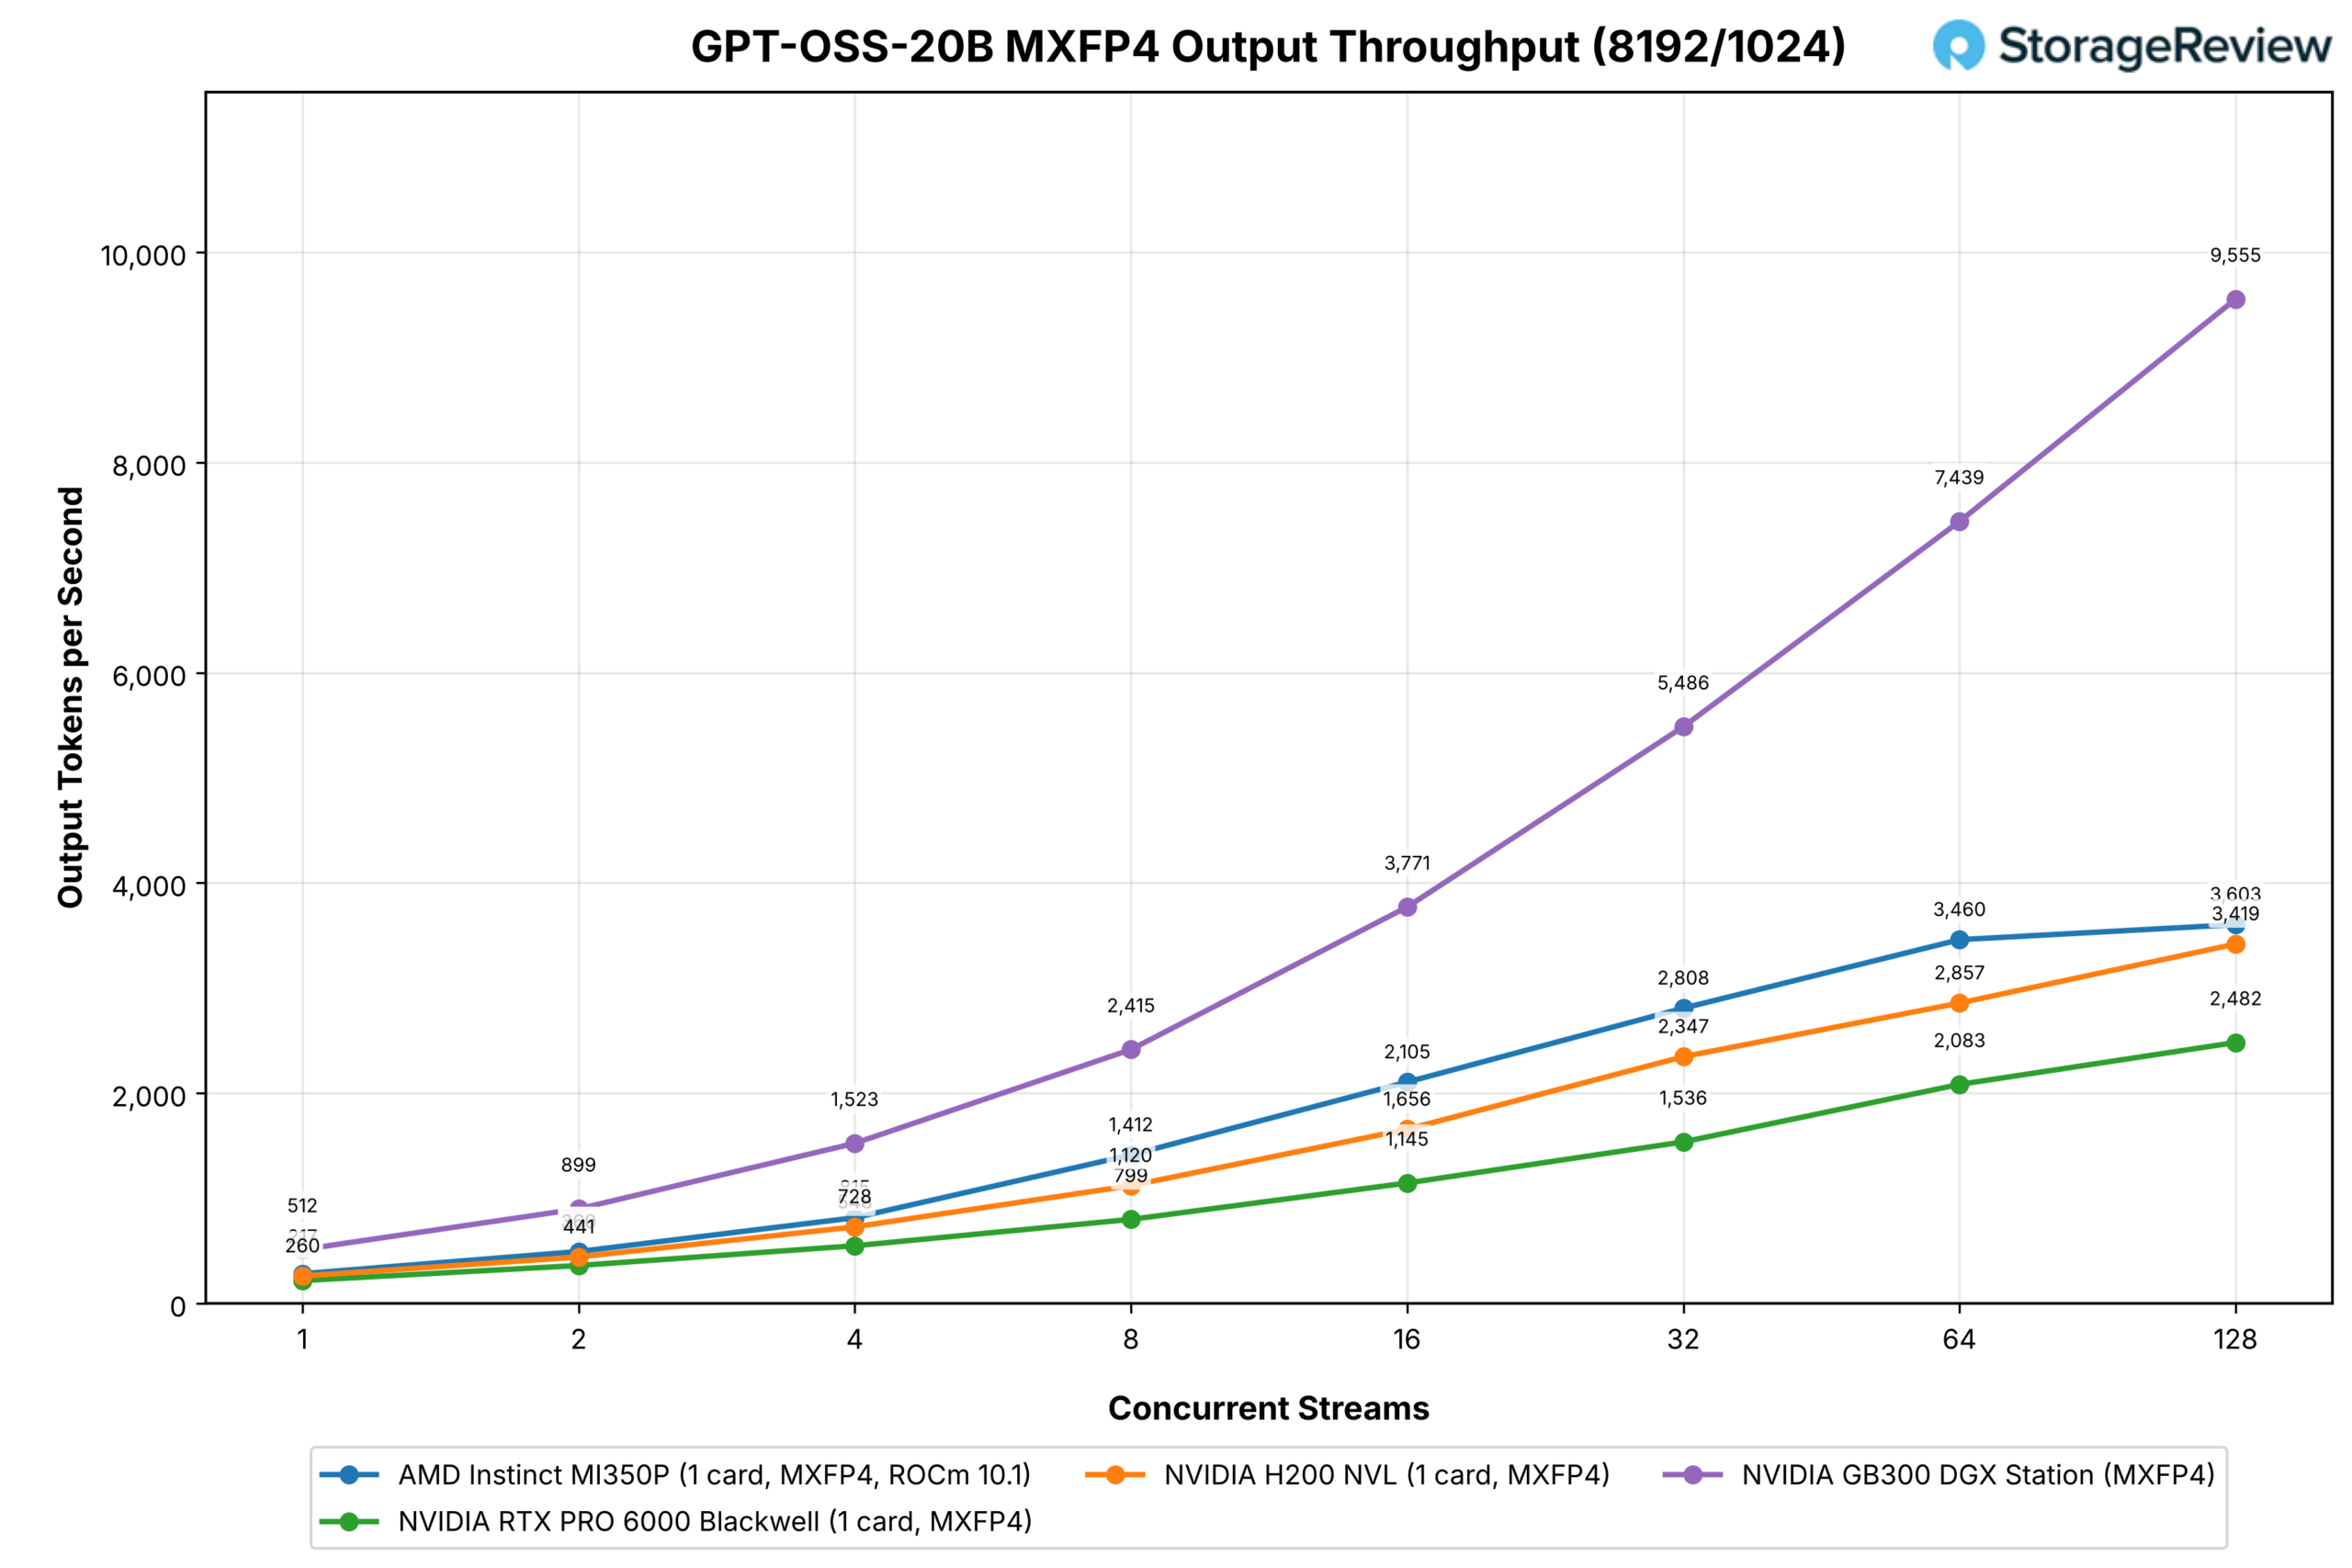
El modelo OpenAI más pequeño sigue la misma curva. El MI350P supera al RTX PRO 6000 en todos los puntos, 8,174 frente a 4,992 en 64 flujos y 10,726 frente a 7,937 en 128 en la carga de trabajo de chat, y 3,460 frente a 2,083 y 3,603 frente a 2,482 en indicaciones con mucho prellenado, y llega a 16,406 en 256 flujos donde el RTX PRO 6000 lee 11,077. El H200 NVL se queda atrás del MI350P en ambas formas, en 6,022 y 3,419 en 128 flujos, y la Estación se sitúa en 22,041 y 9,555.
Codificador Qwen3-30B-A3B
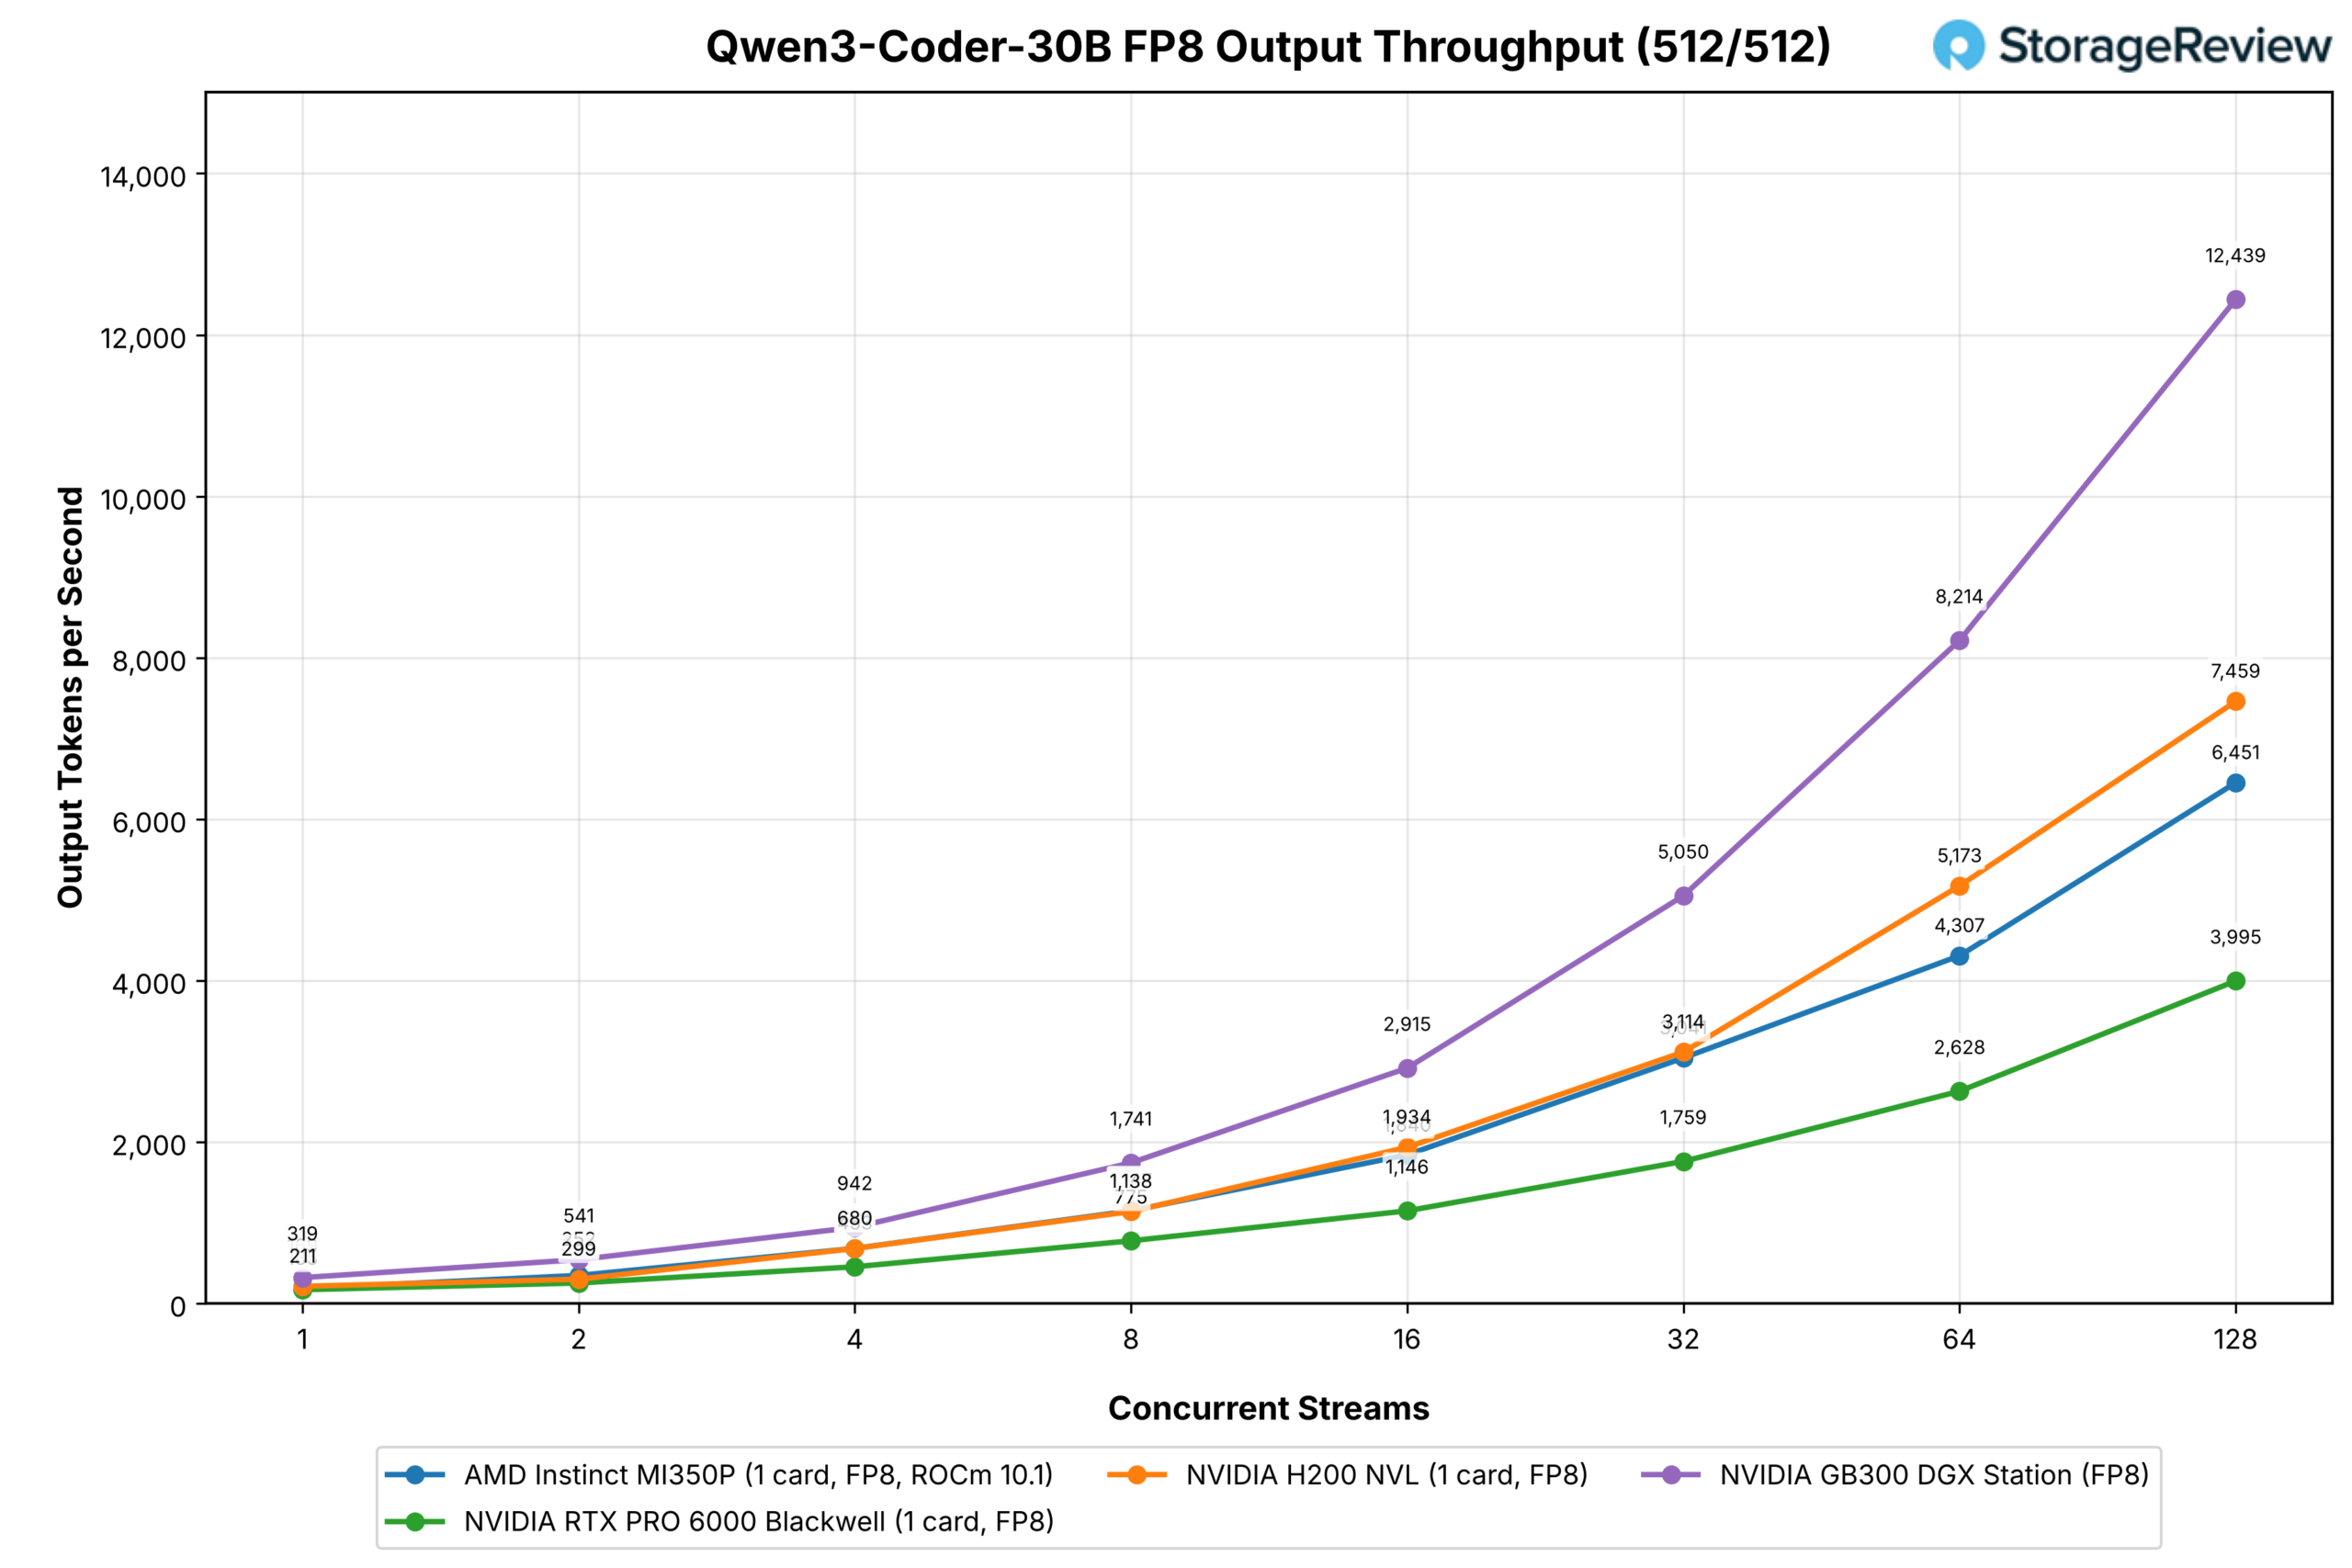
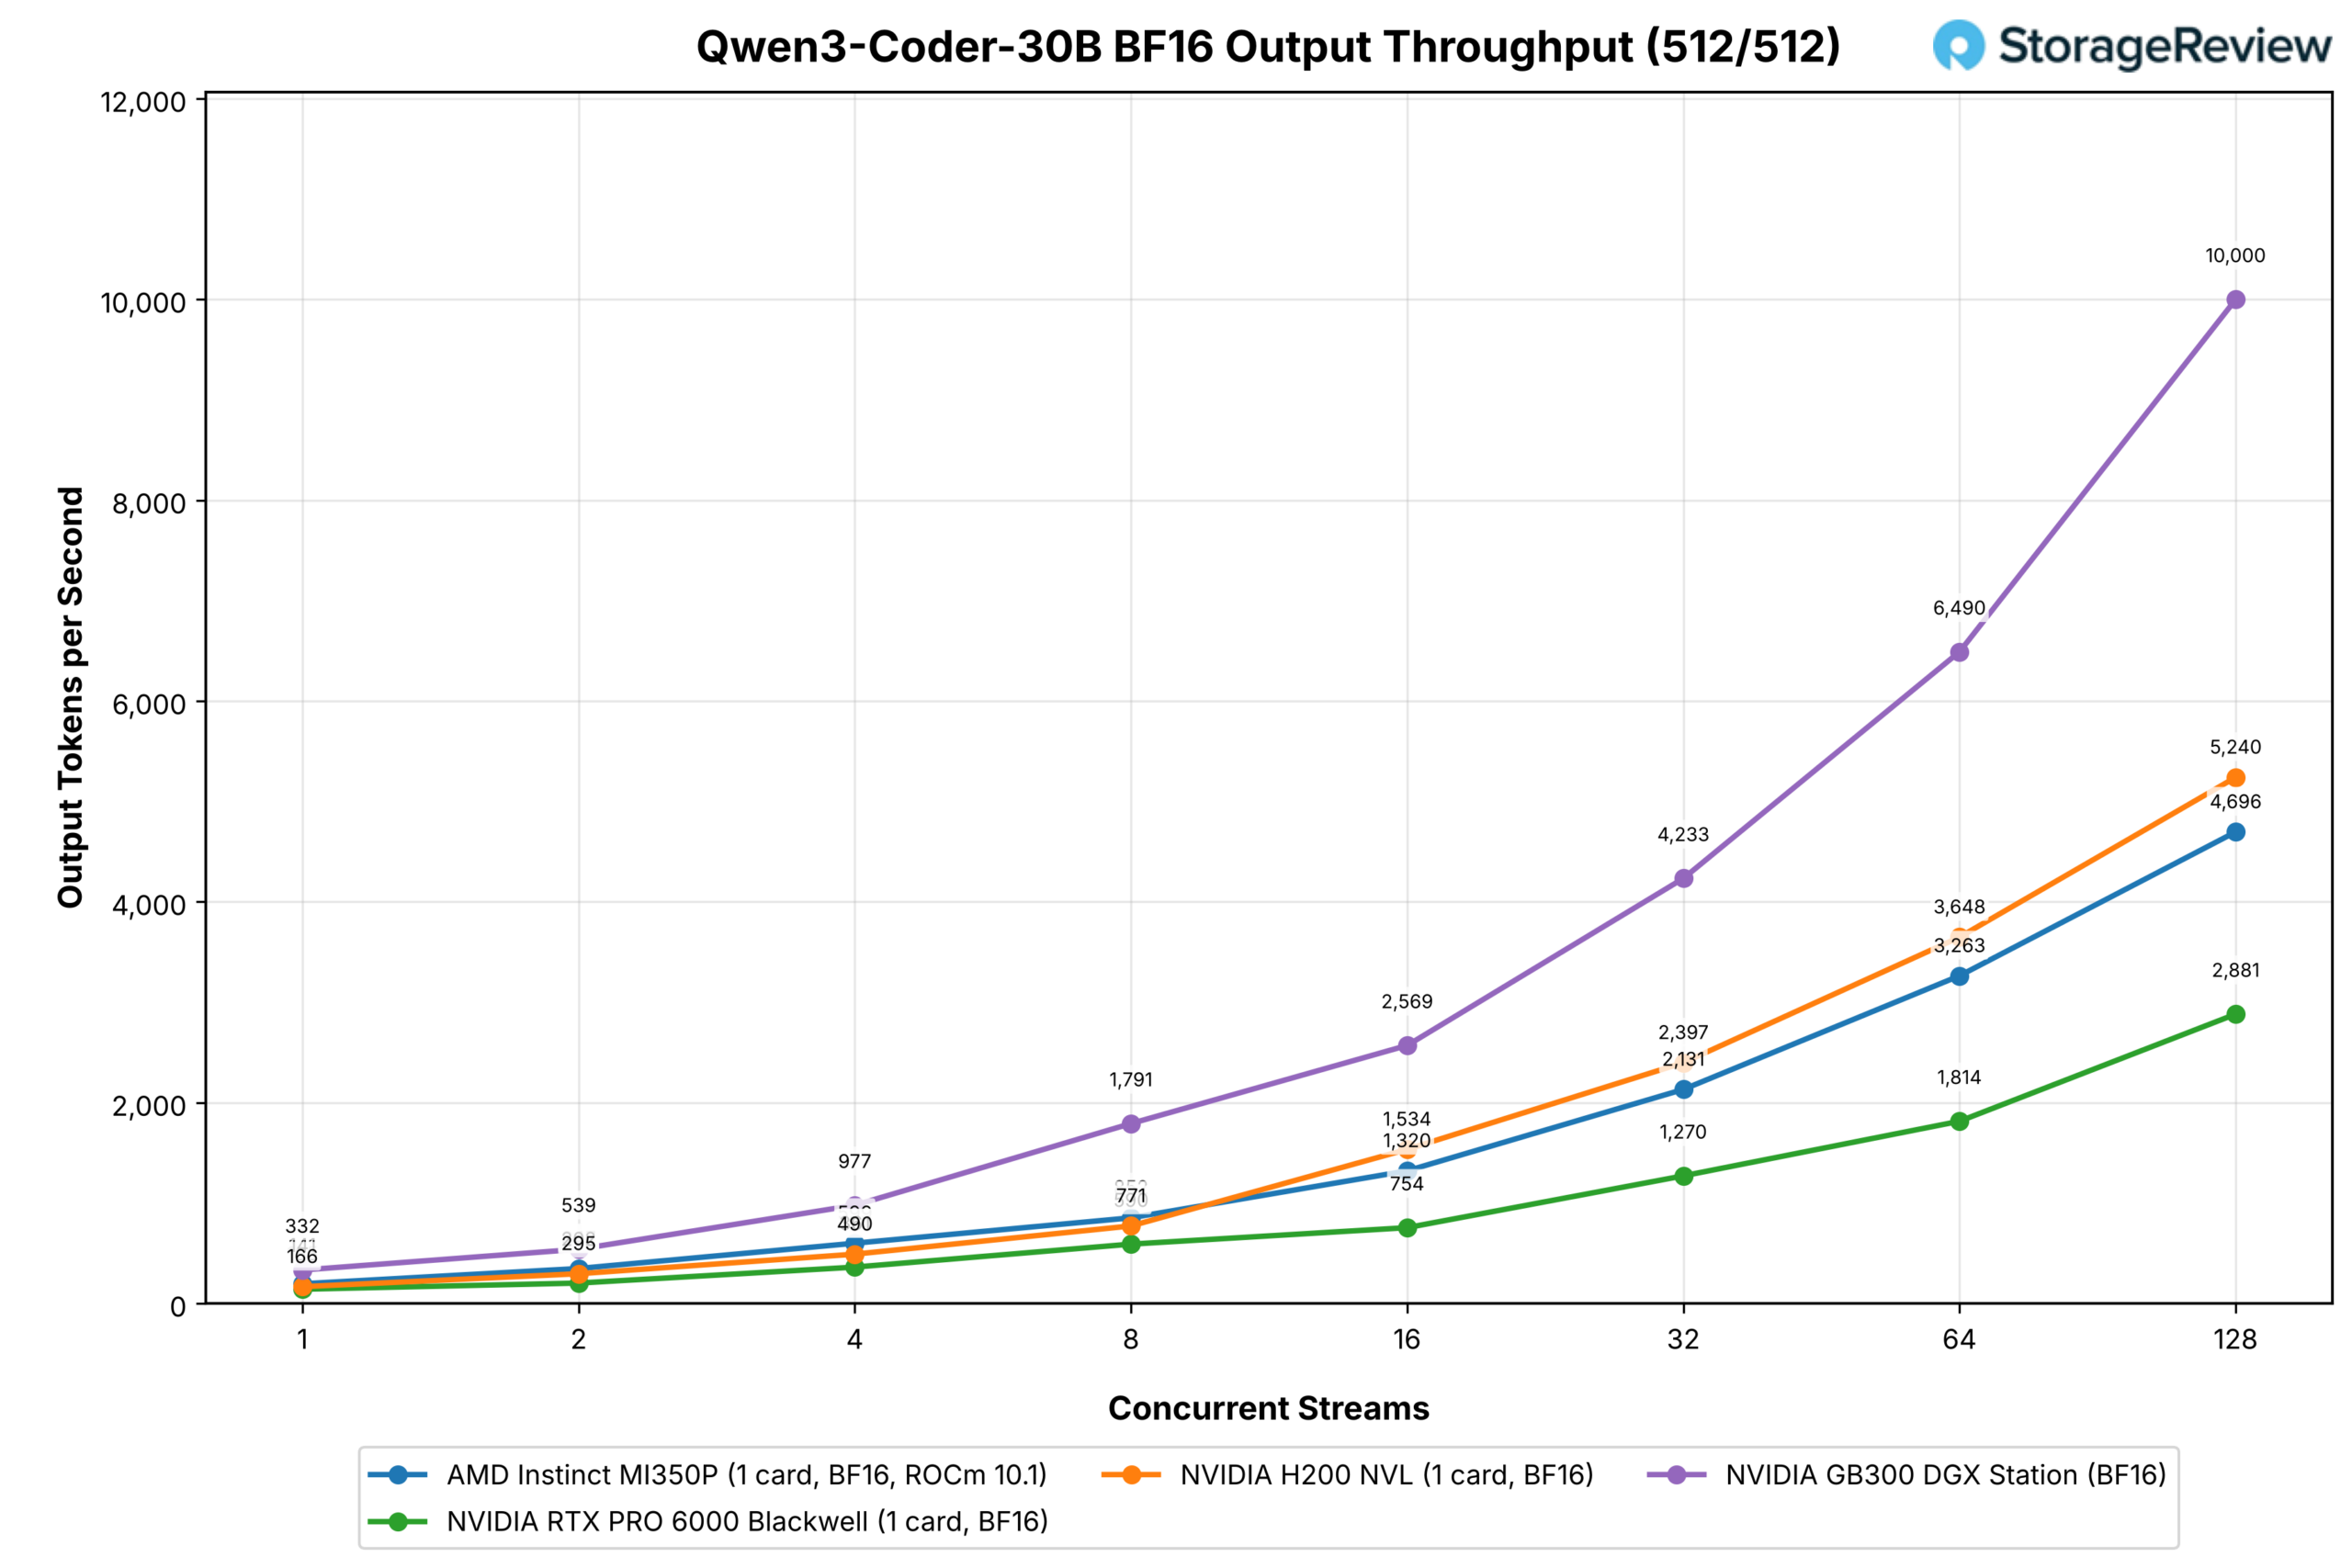
La memoria MoE de 30B con parámetros activos de 3B le da a la MI350P una ventaja sobre la RTX PRO 6000 en todas las concurrencias en la carga de trabajo de chat, terminando en 6,451 frente a 3,995 en FP8 y 4,696 frente a 2,881 en BF16 con 128 transmisiones, con la H200 en 7,459 y 5,240.
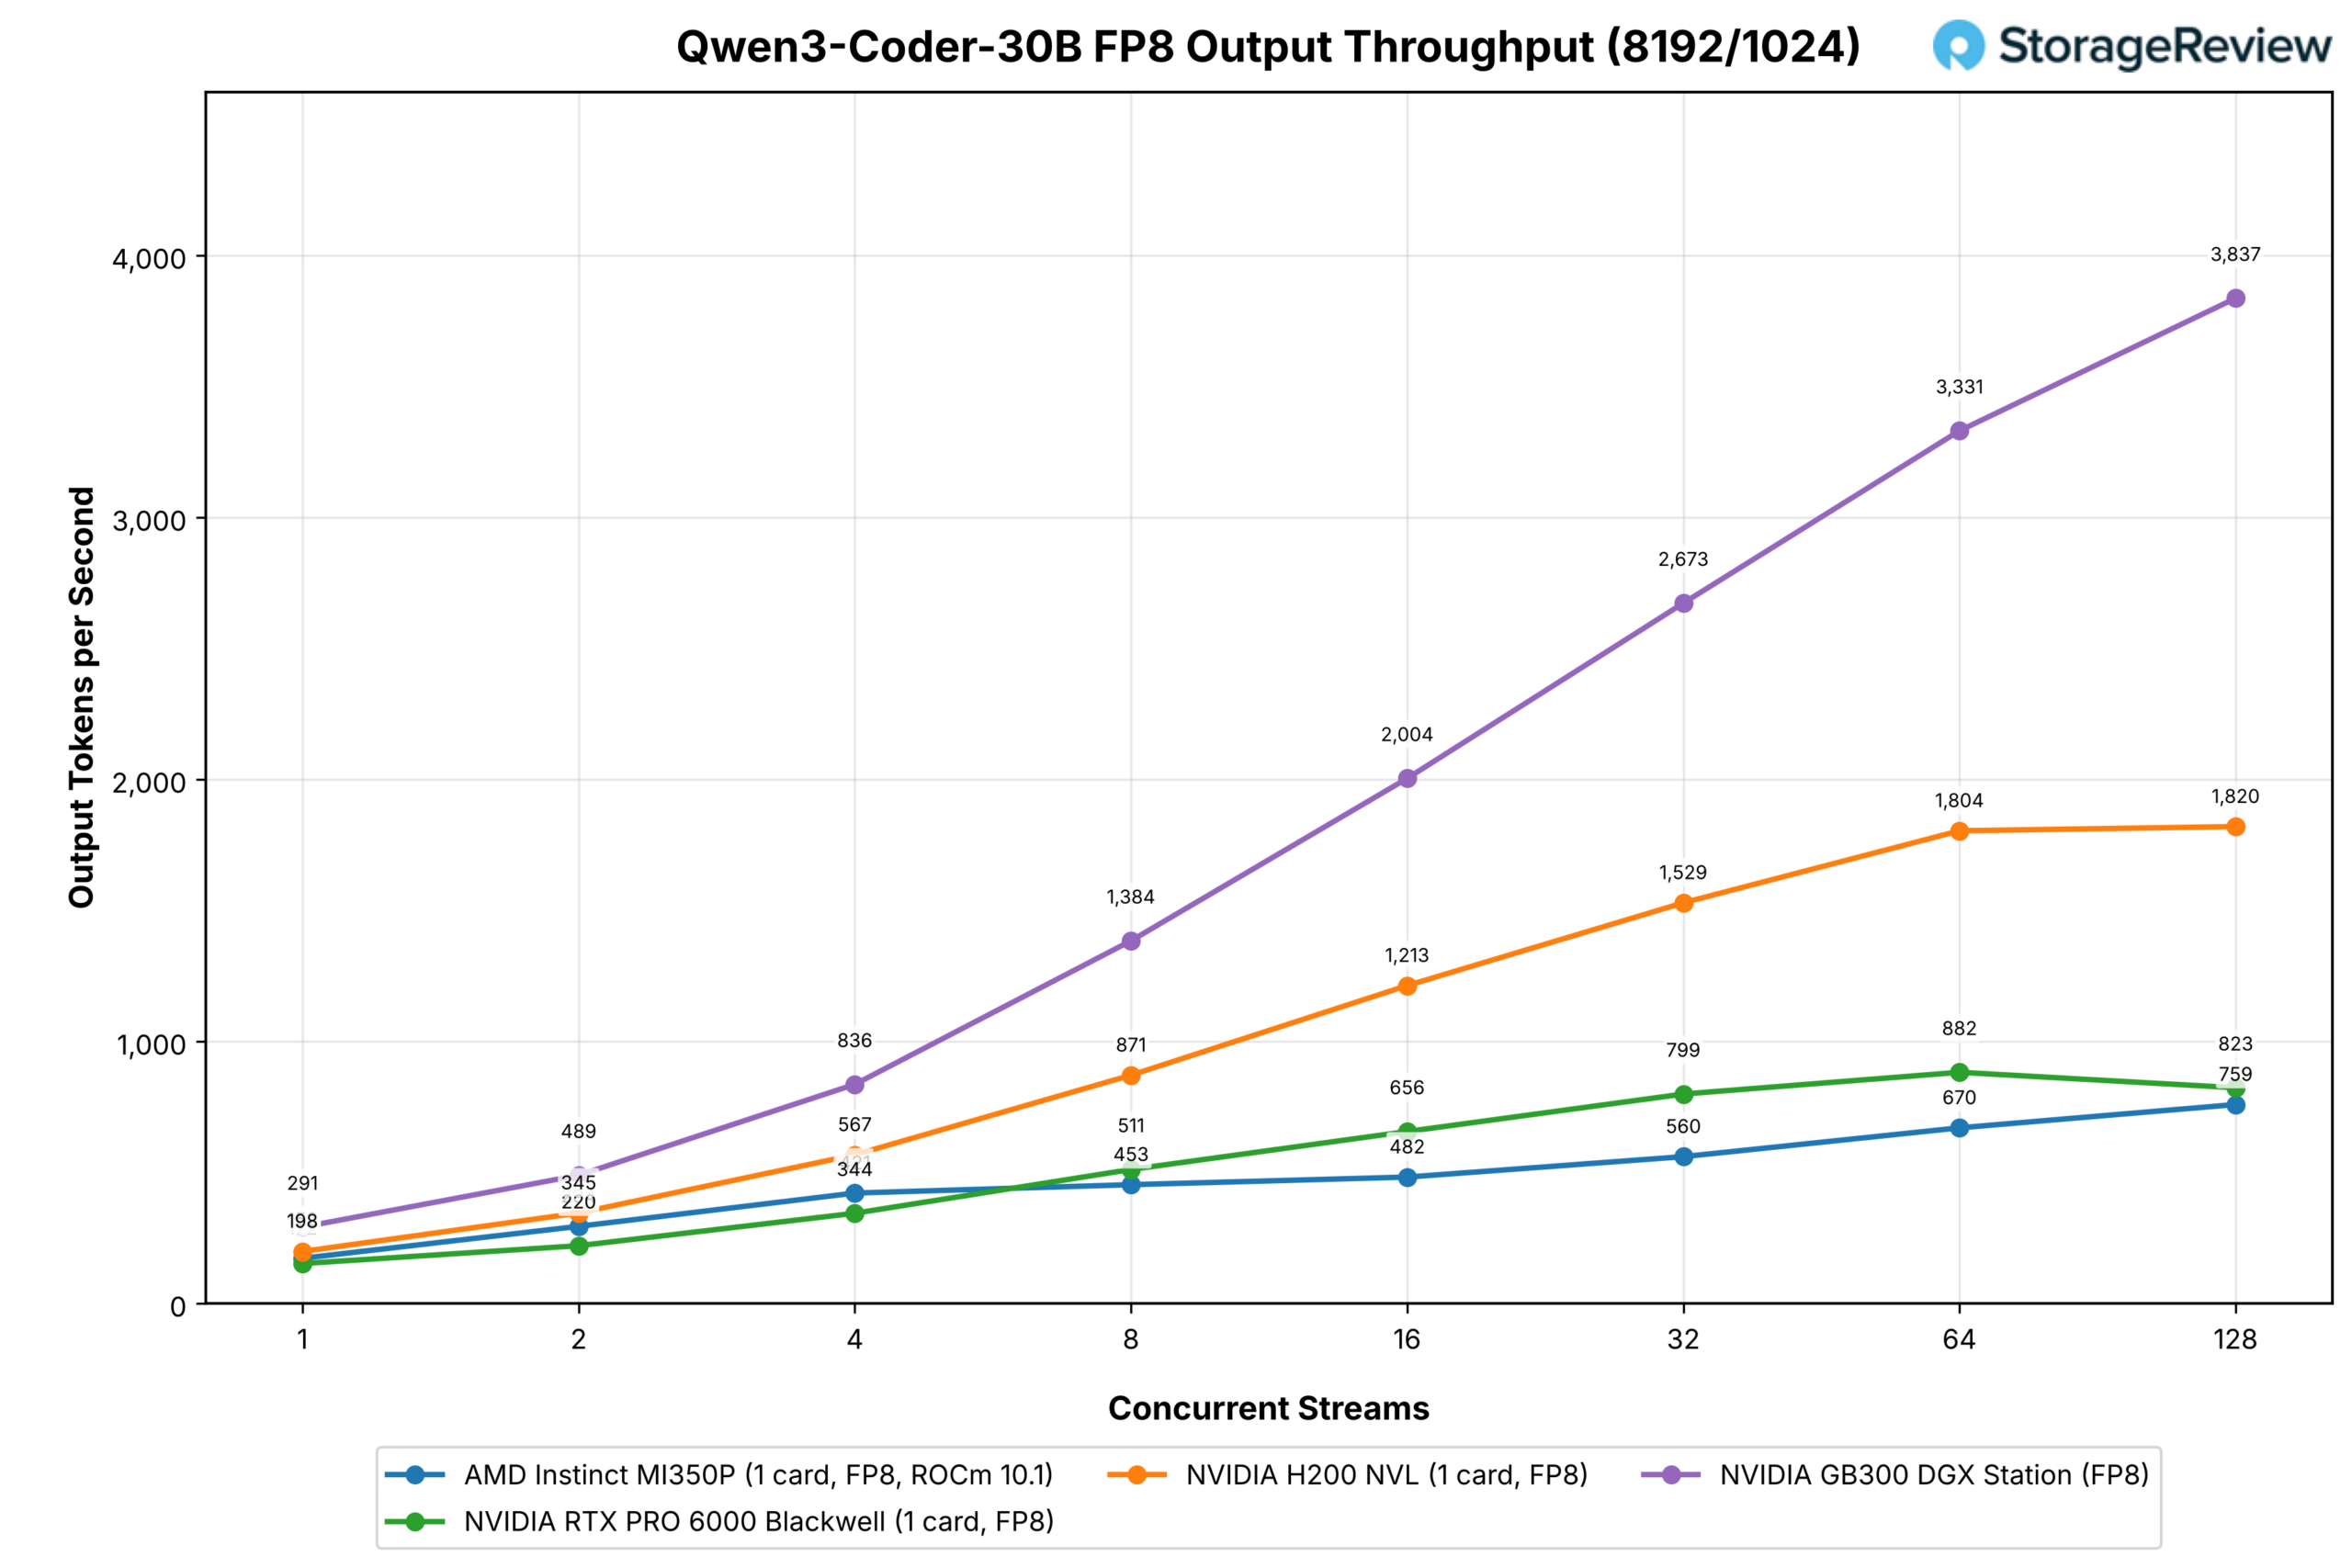
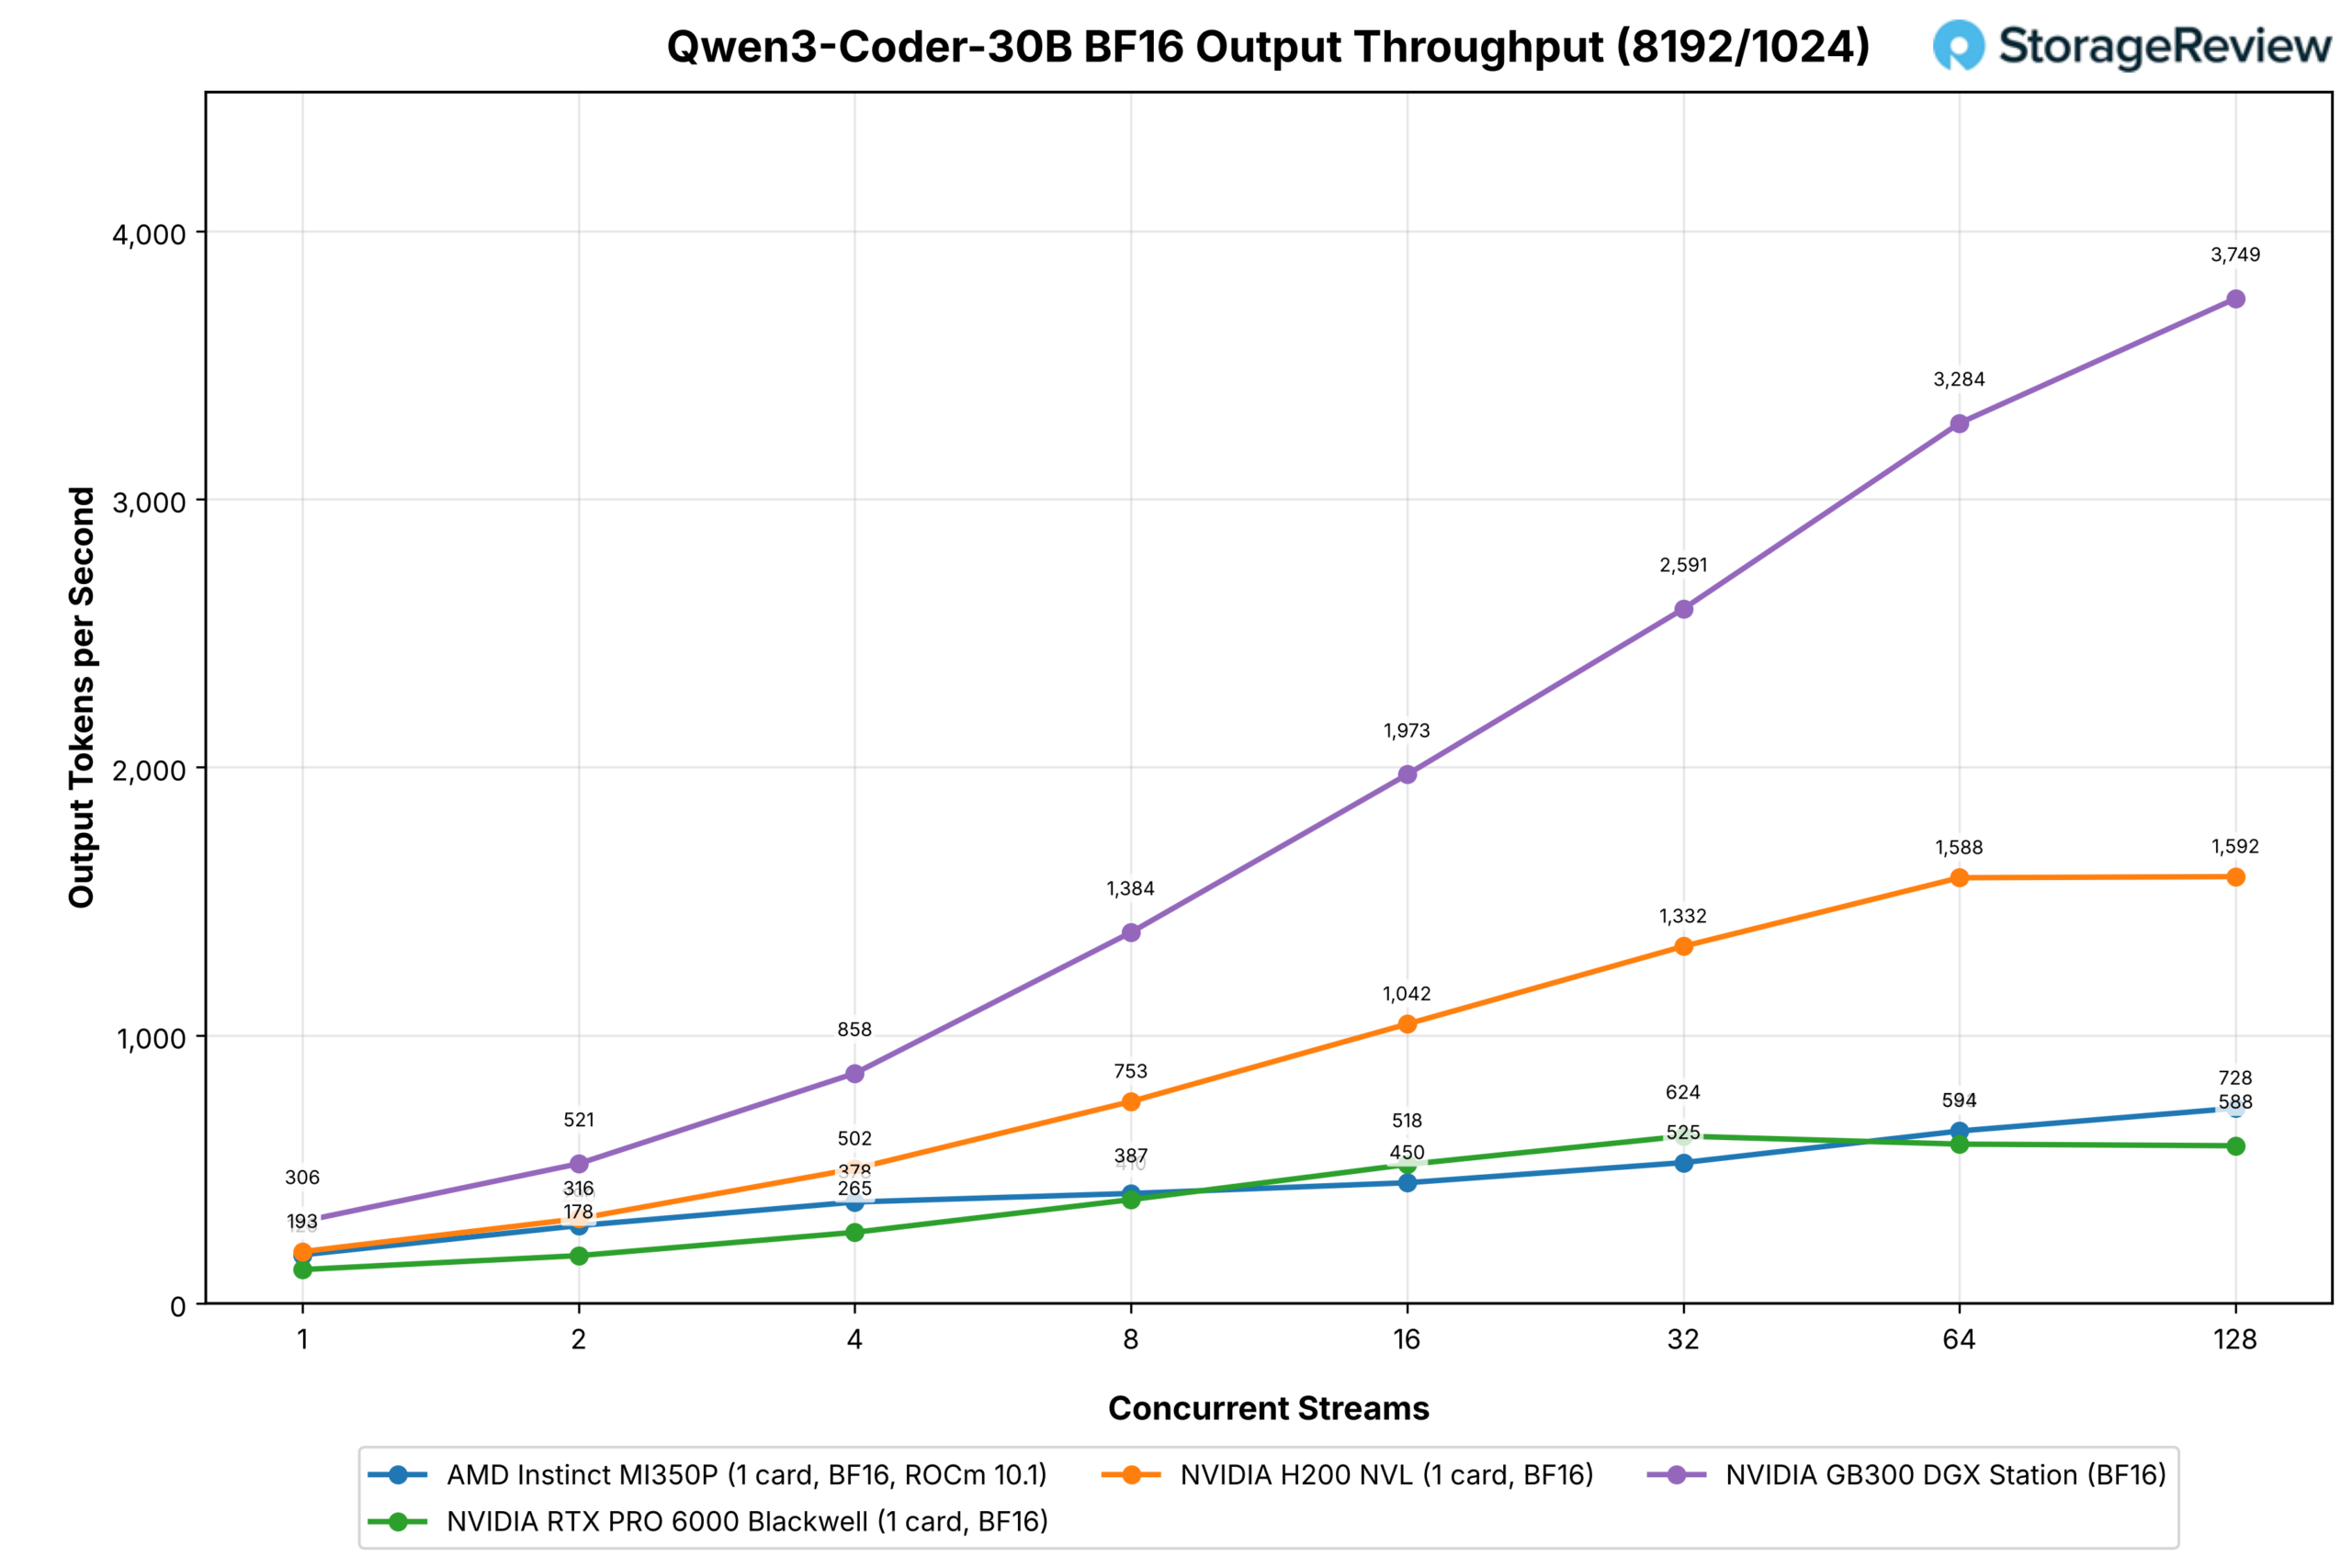
En las indicaciones con mucho prellenado, la ejecución de FP8 lidera solo durante cuatro flujos y luego se queda atrás de la RTX PRO 6000 desde ocho hasta 128, 759 contra 823 en la cima, con la H200 en 1,820; la ejecución de BF16 sube a 728 en 128 flujos contra 588 y 1,592.
Mistral Pequeño 3.1 24B
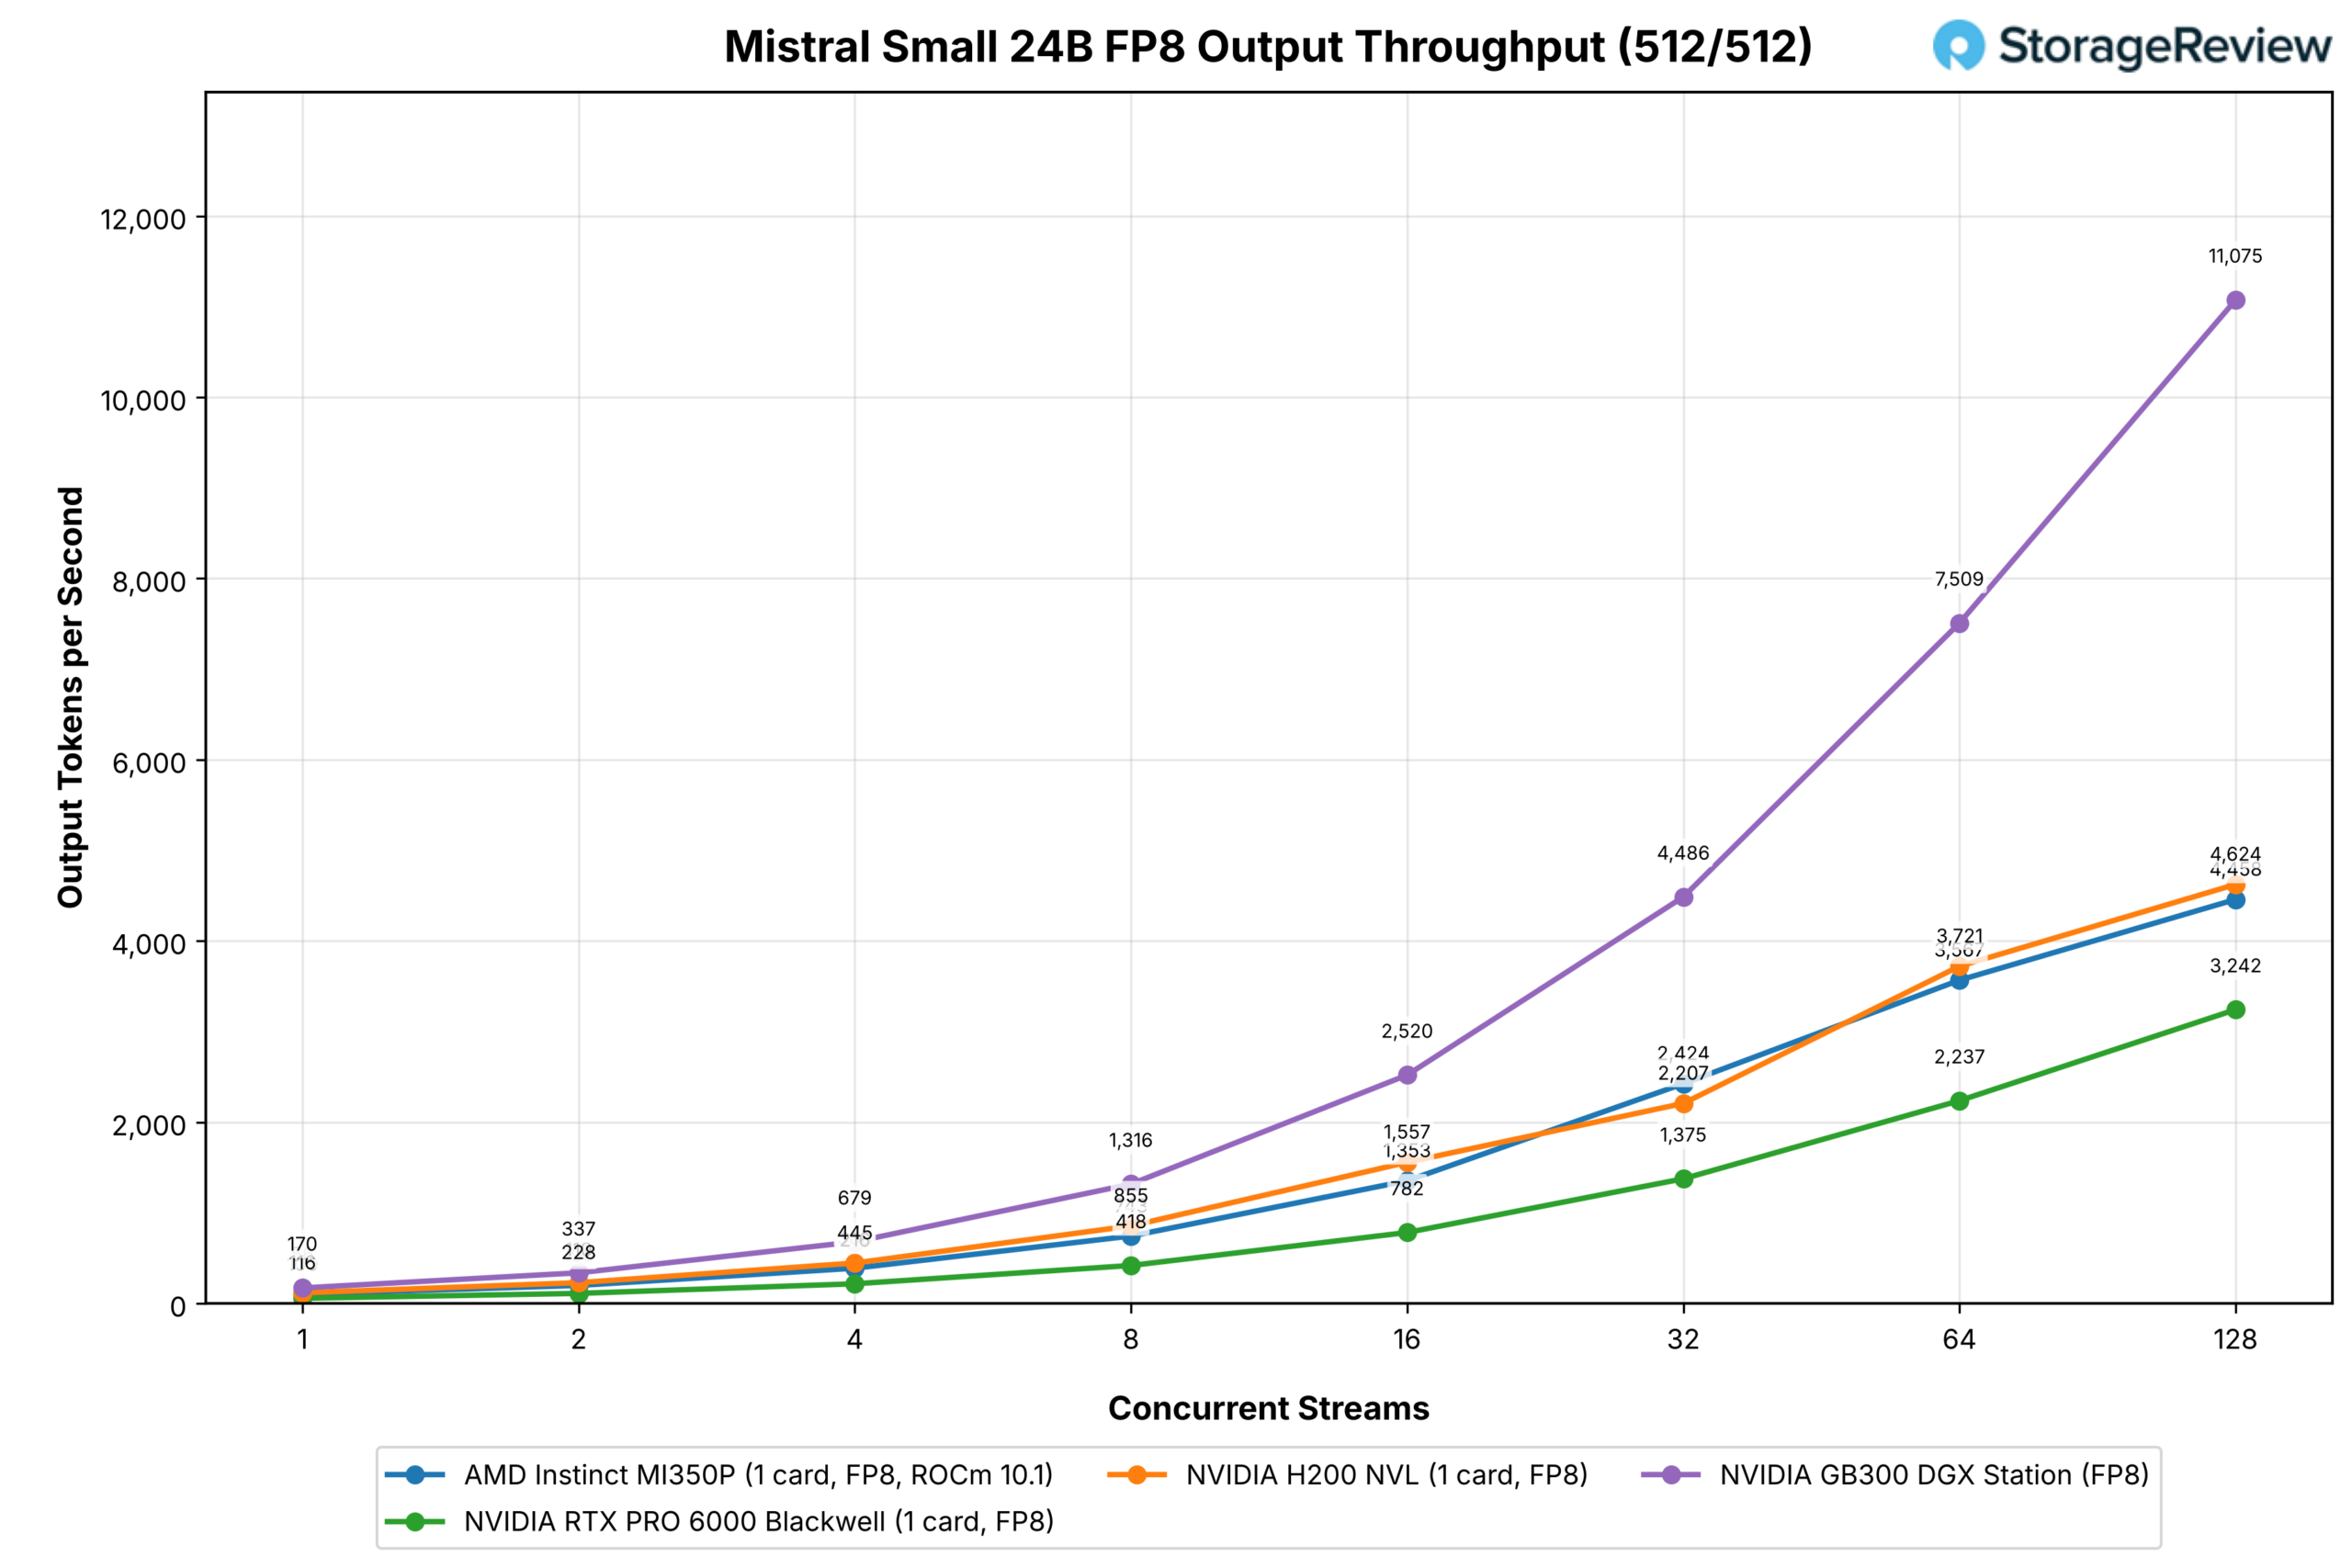
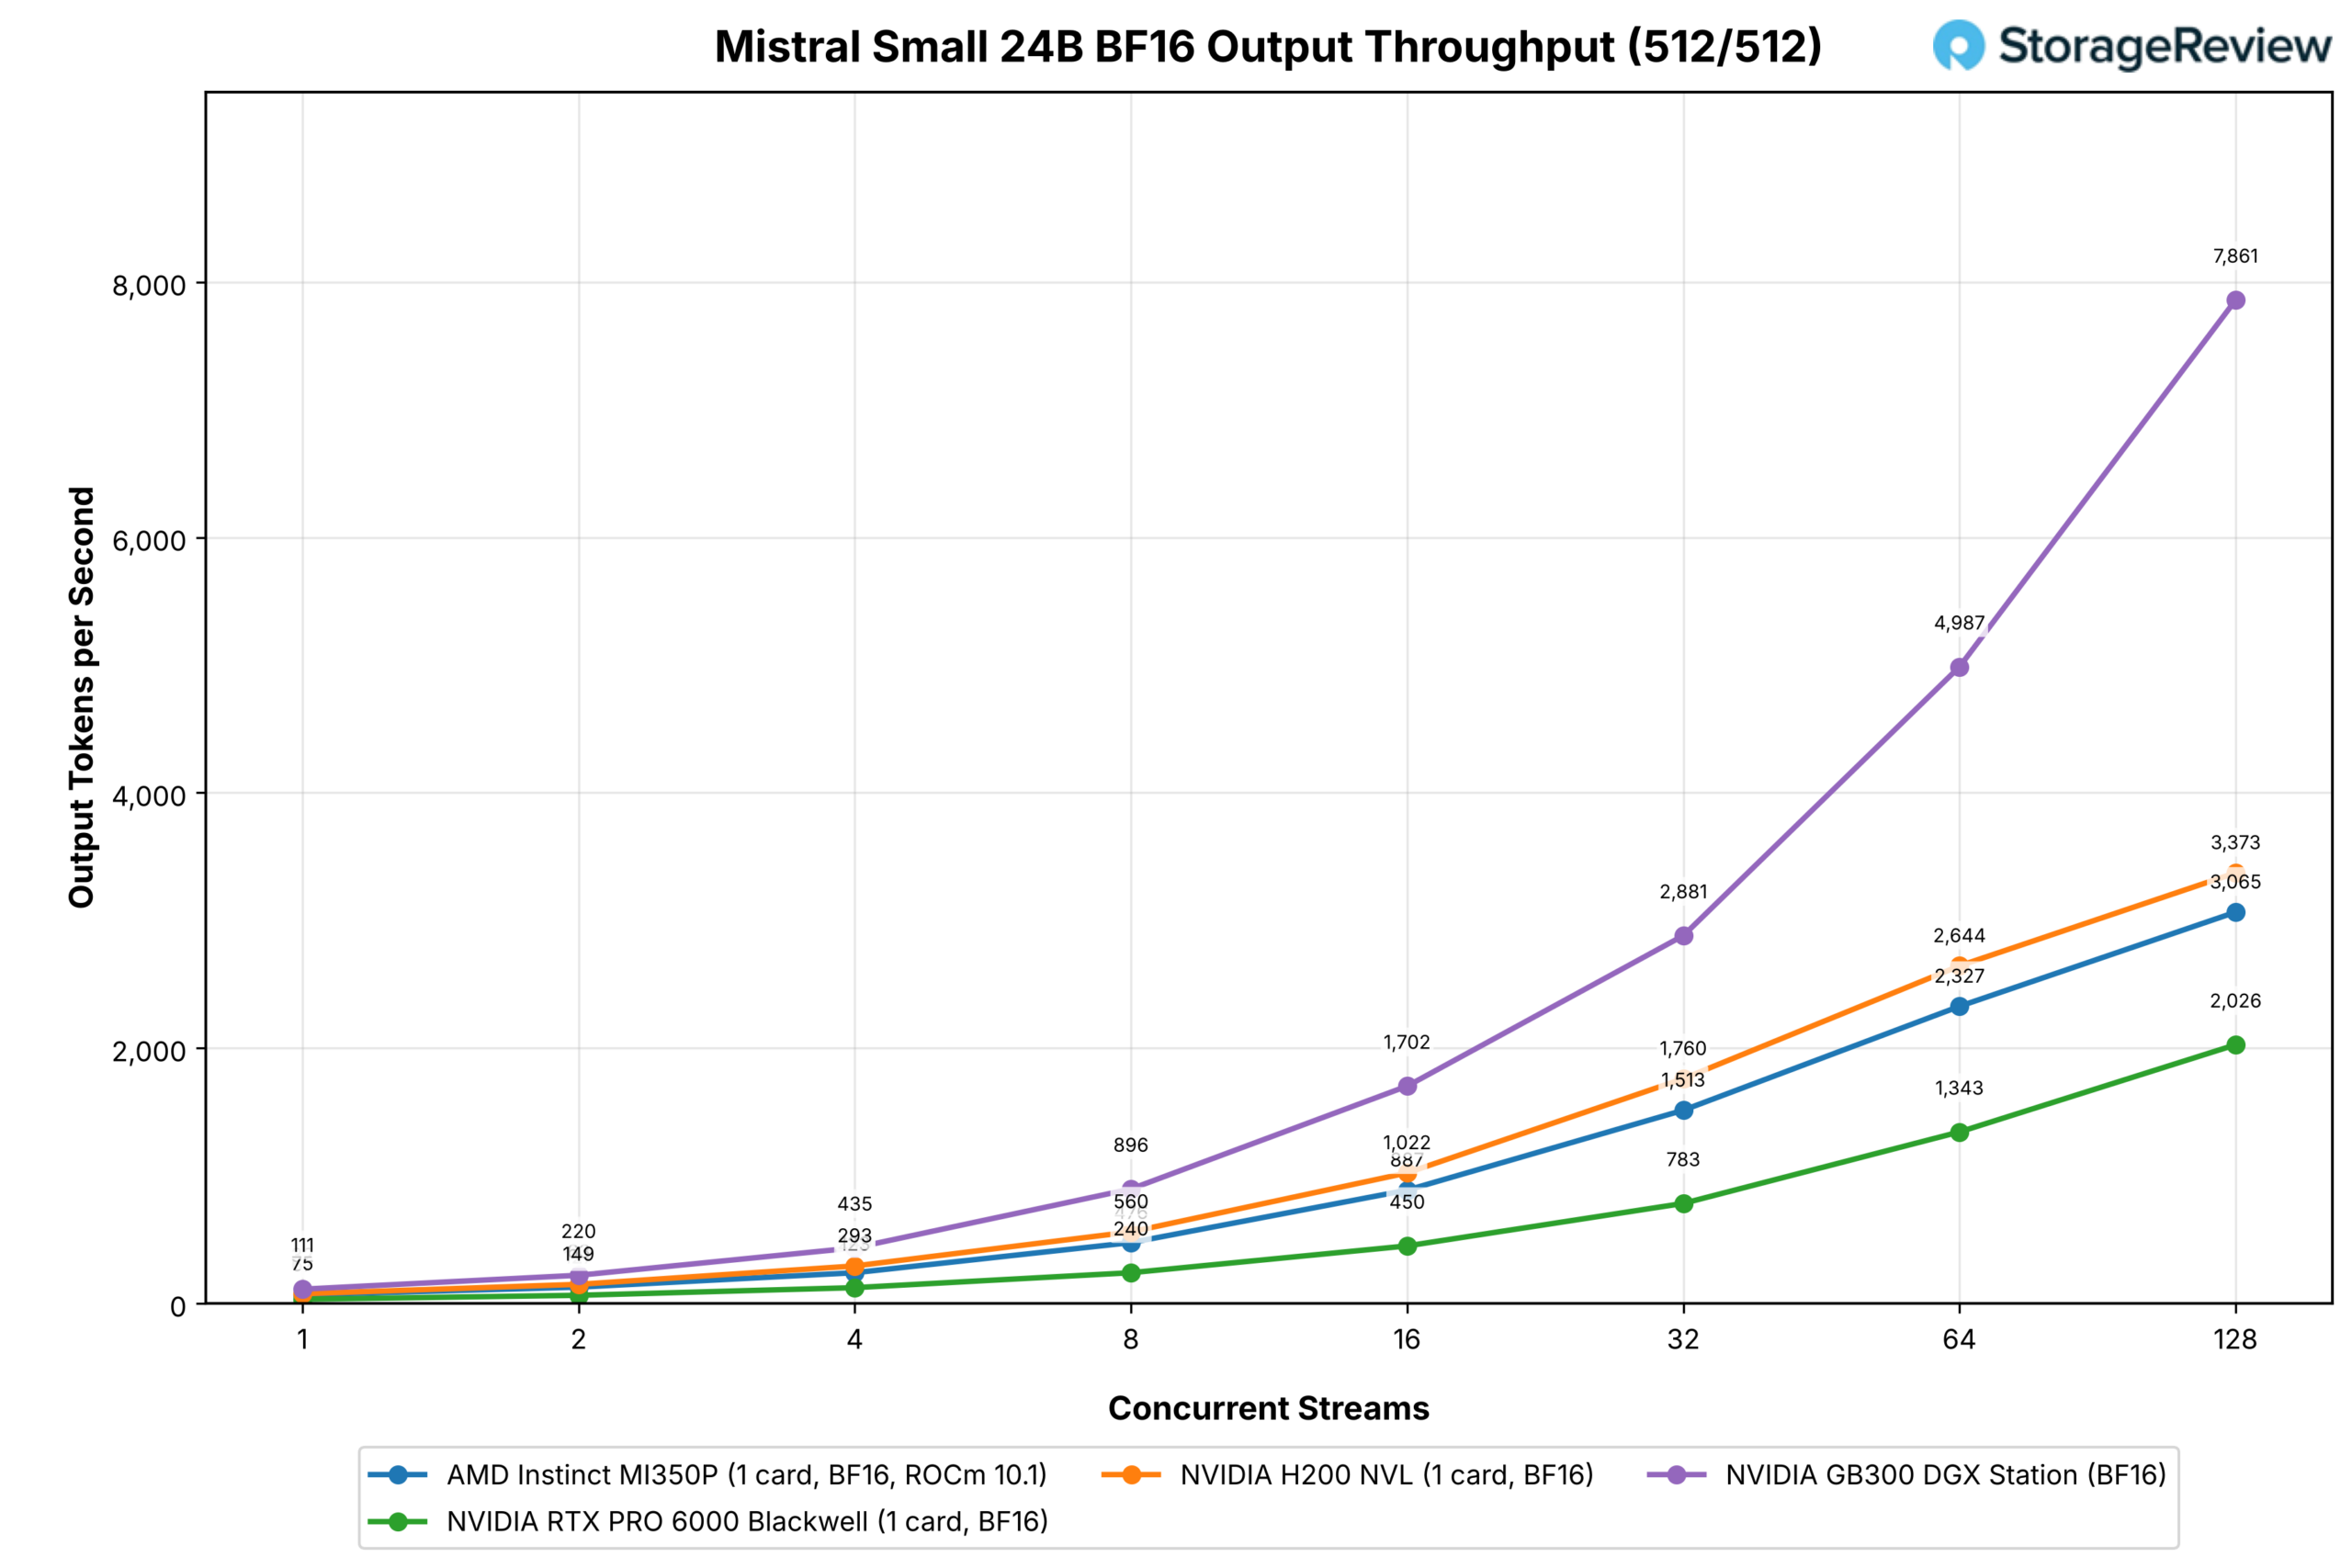
Mistral Small es el mejor resultado denso de la MI350P frente a la RTX PRO 6000: 4,458 frente a 3,242 en FP8 y 3,065 frente a 2,026 en BF16 con 128 transmisiones en la carga de trabajo del chat, y en una transmisión la MI350P prácticamente duplica a la tarjeta NVIDIA (100 frente a 56 en FP8, 67 frente a 32 en BF16).
También es el modelo denso donde el MI350P lidera en indicaciones con mucho prellenado, 599 frente a 482 en FP8 a 128 flujos y 425 frente a 299 en BF16 a 64, aunque el H200 alcanza 799 y 632 en los mismos puntos.
Llama 3.1 8B
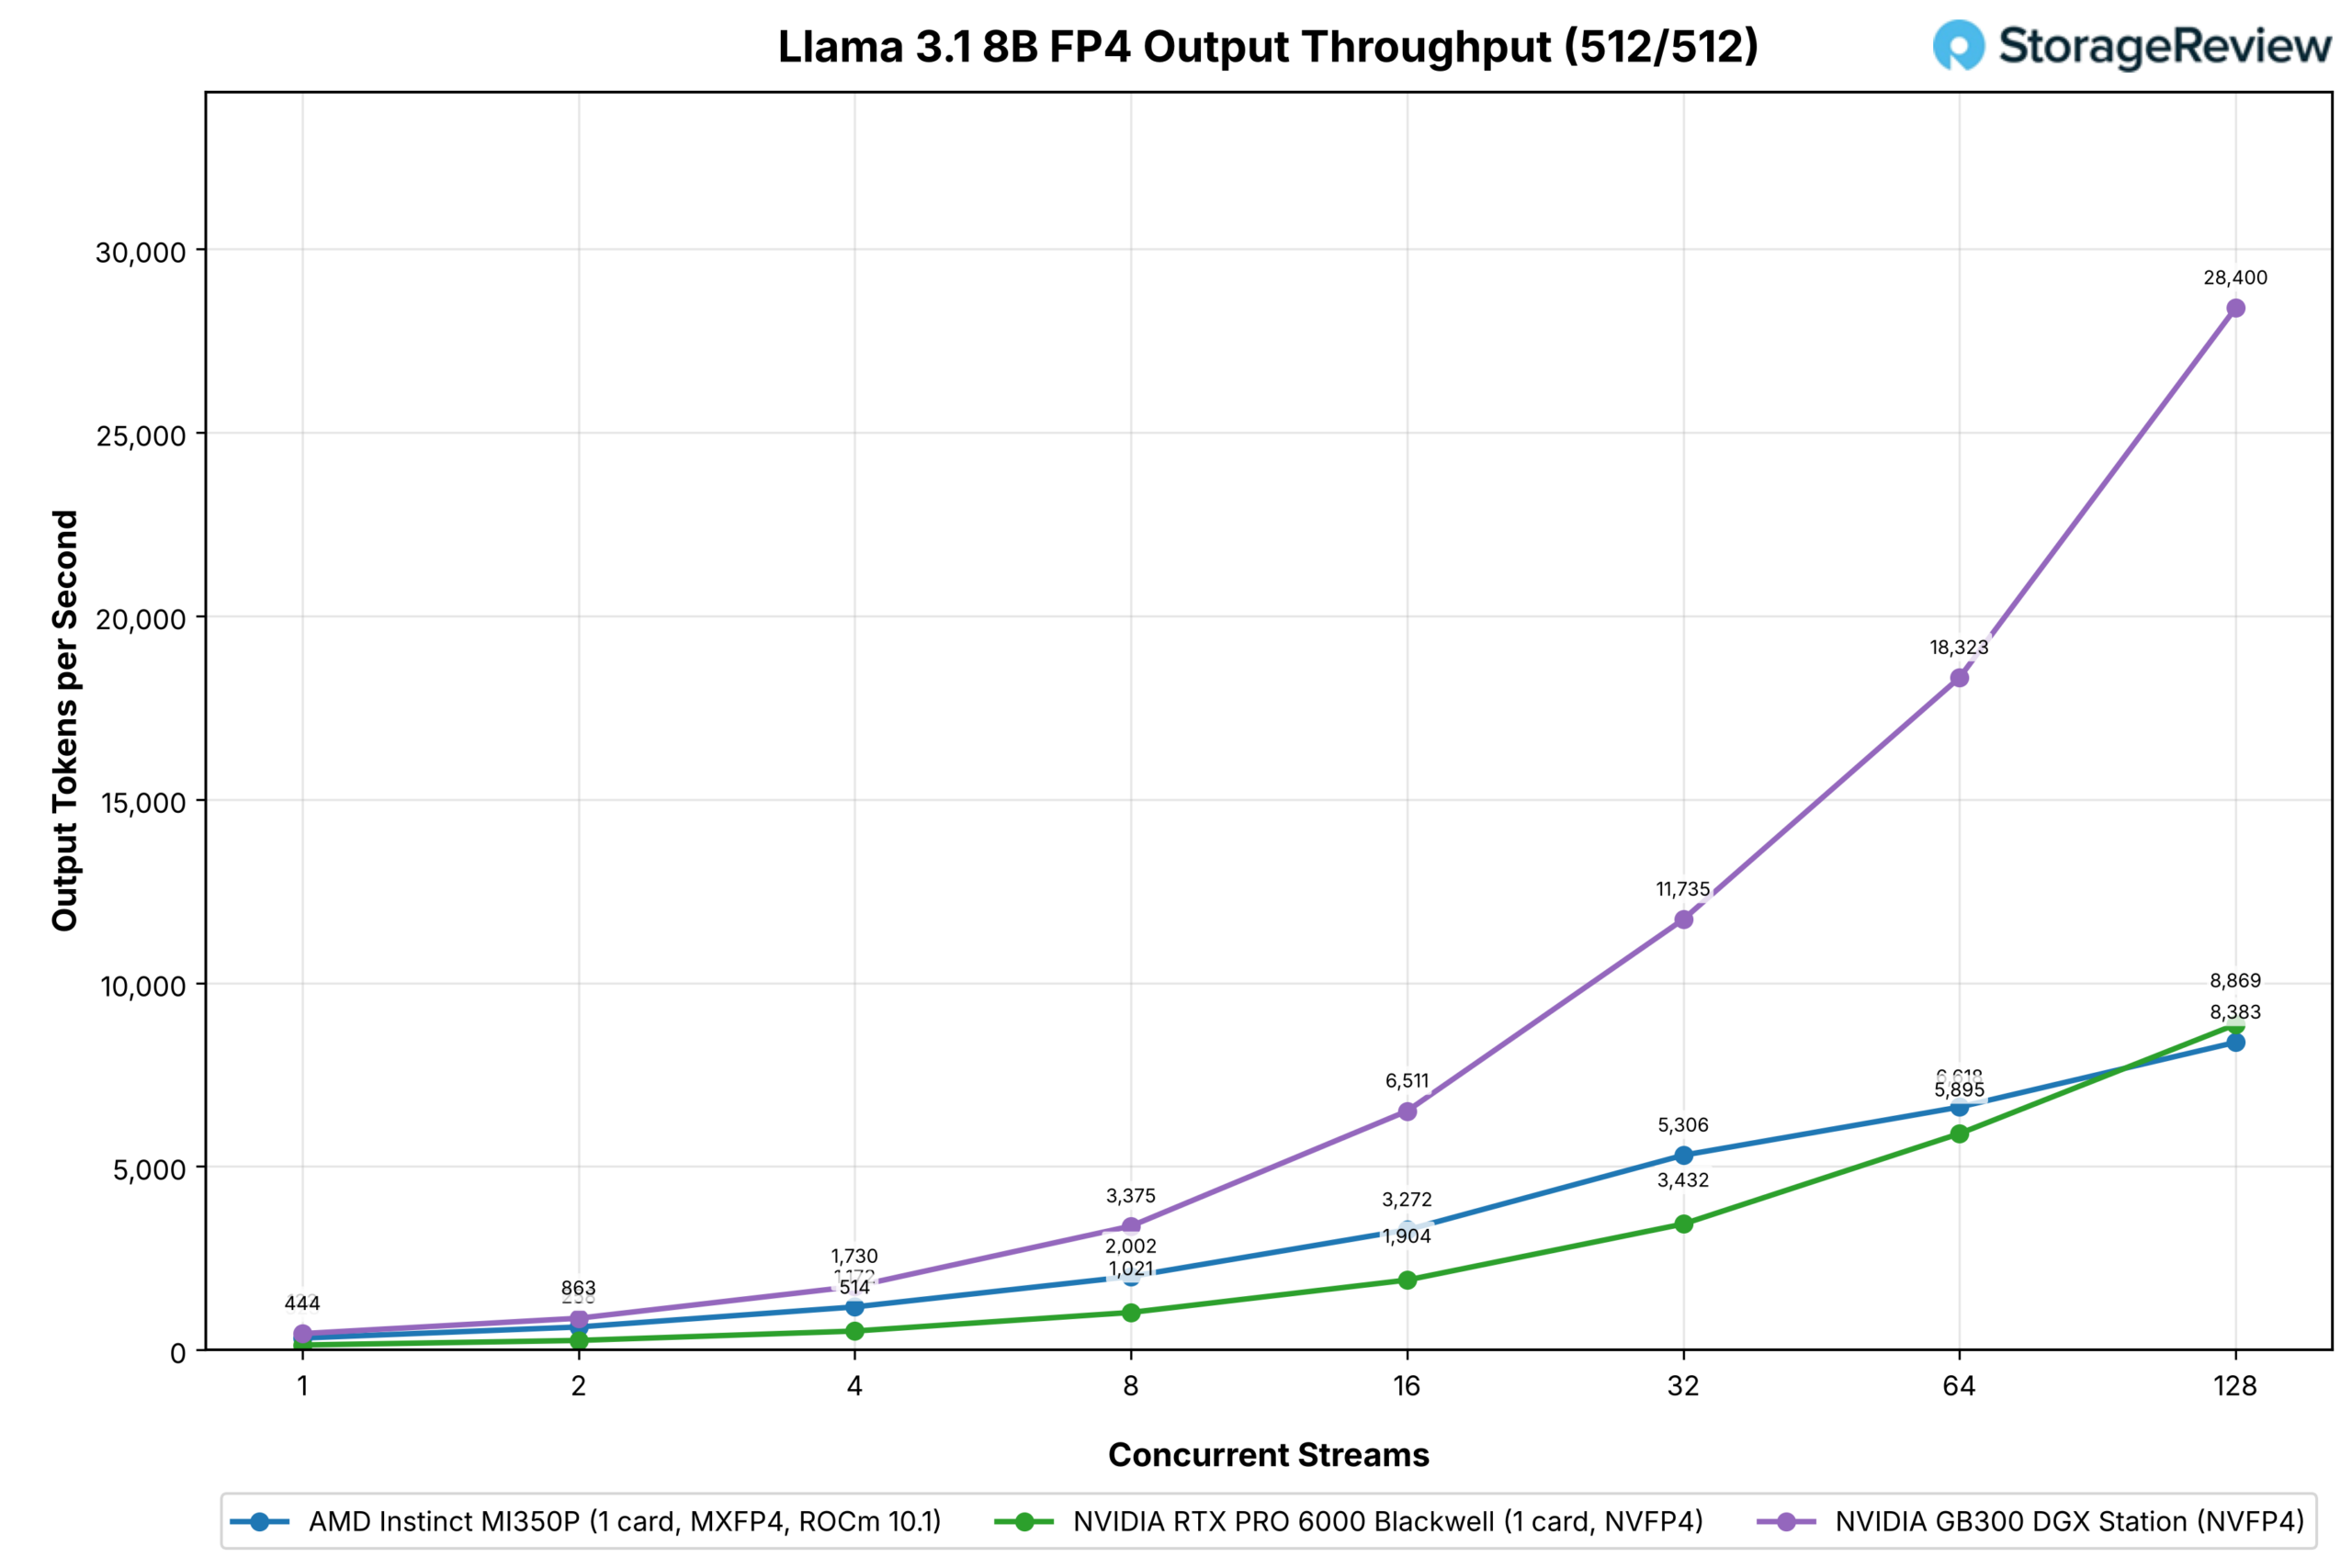
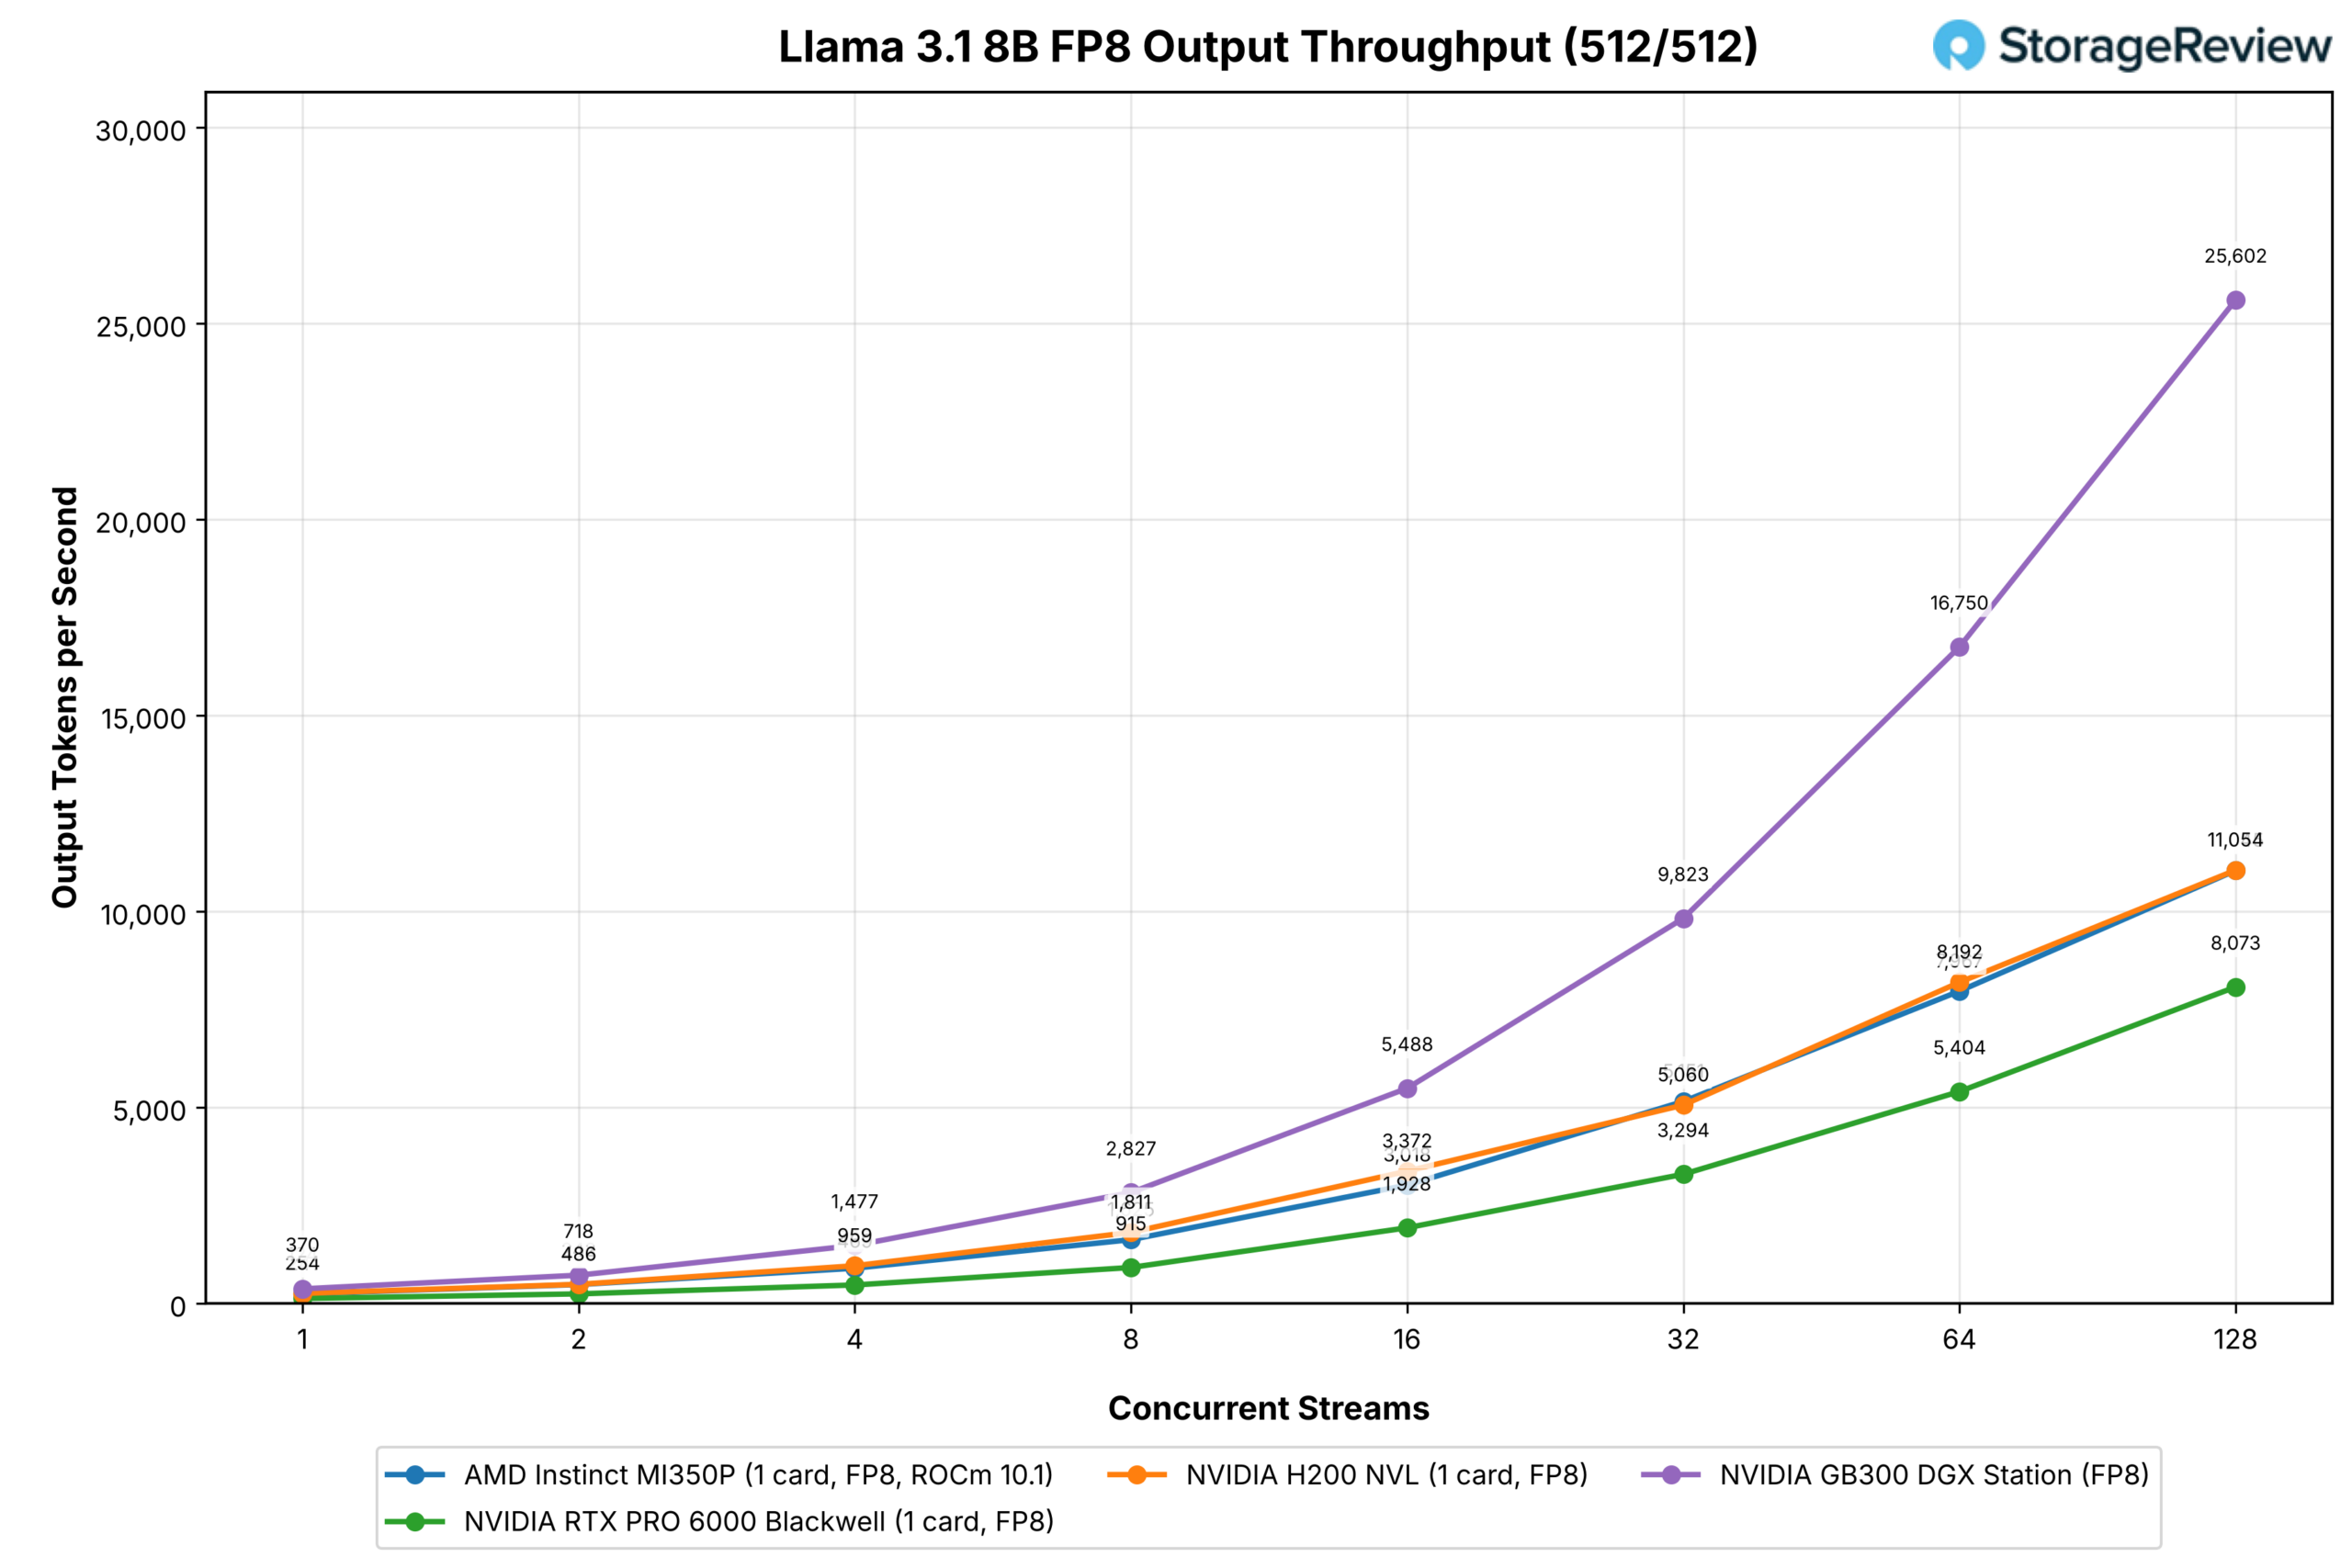
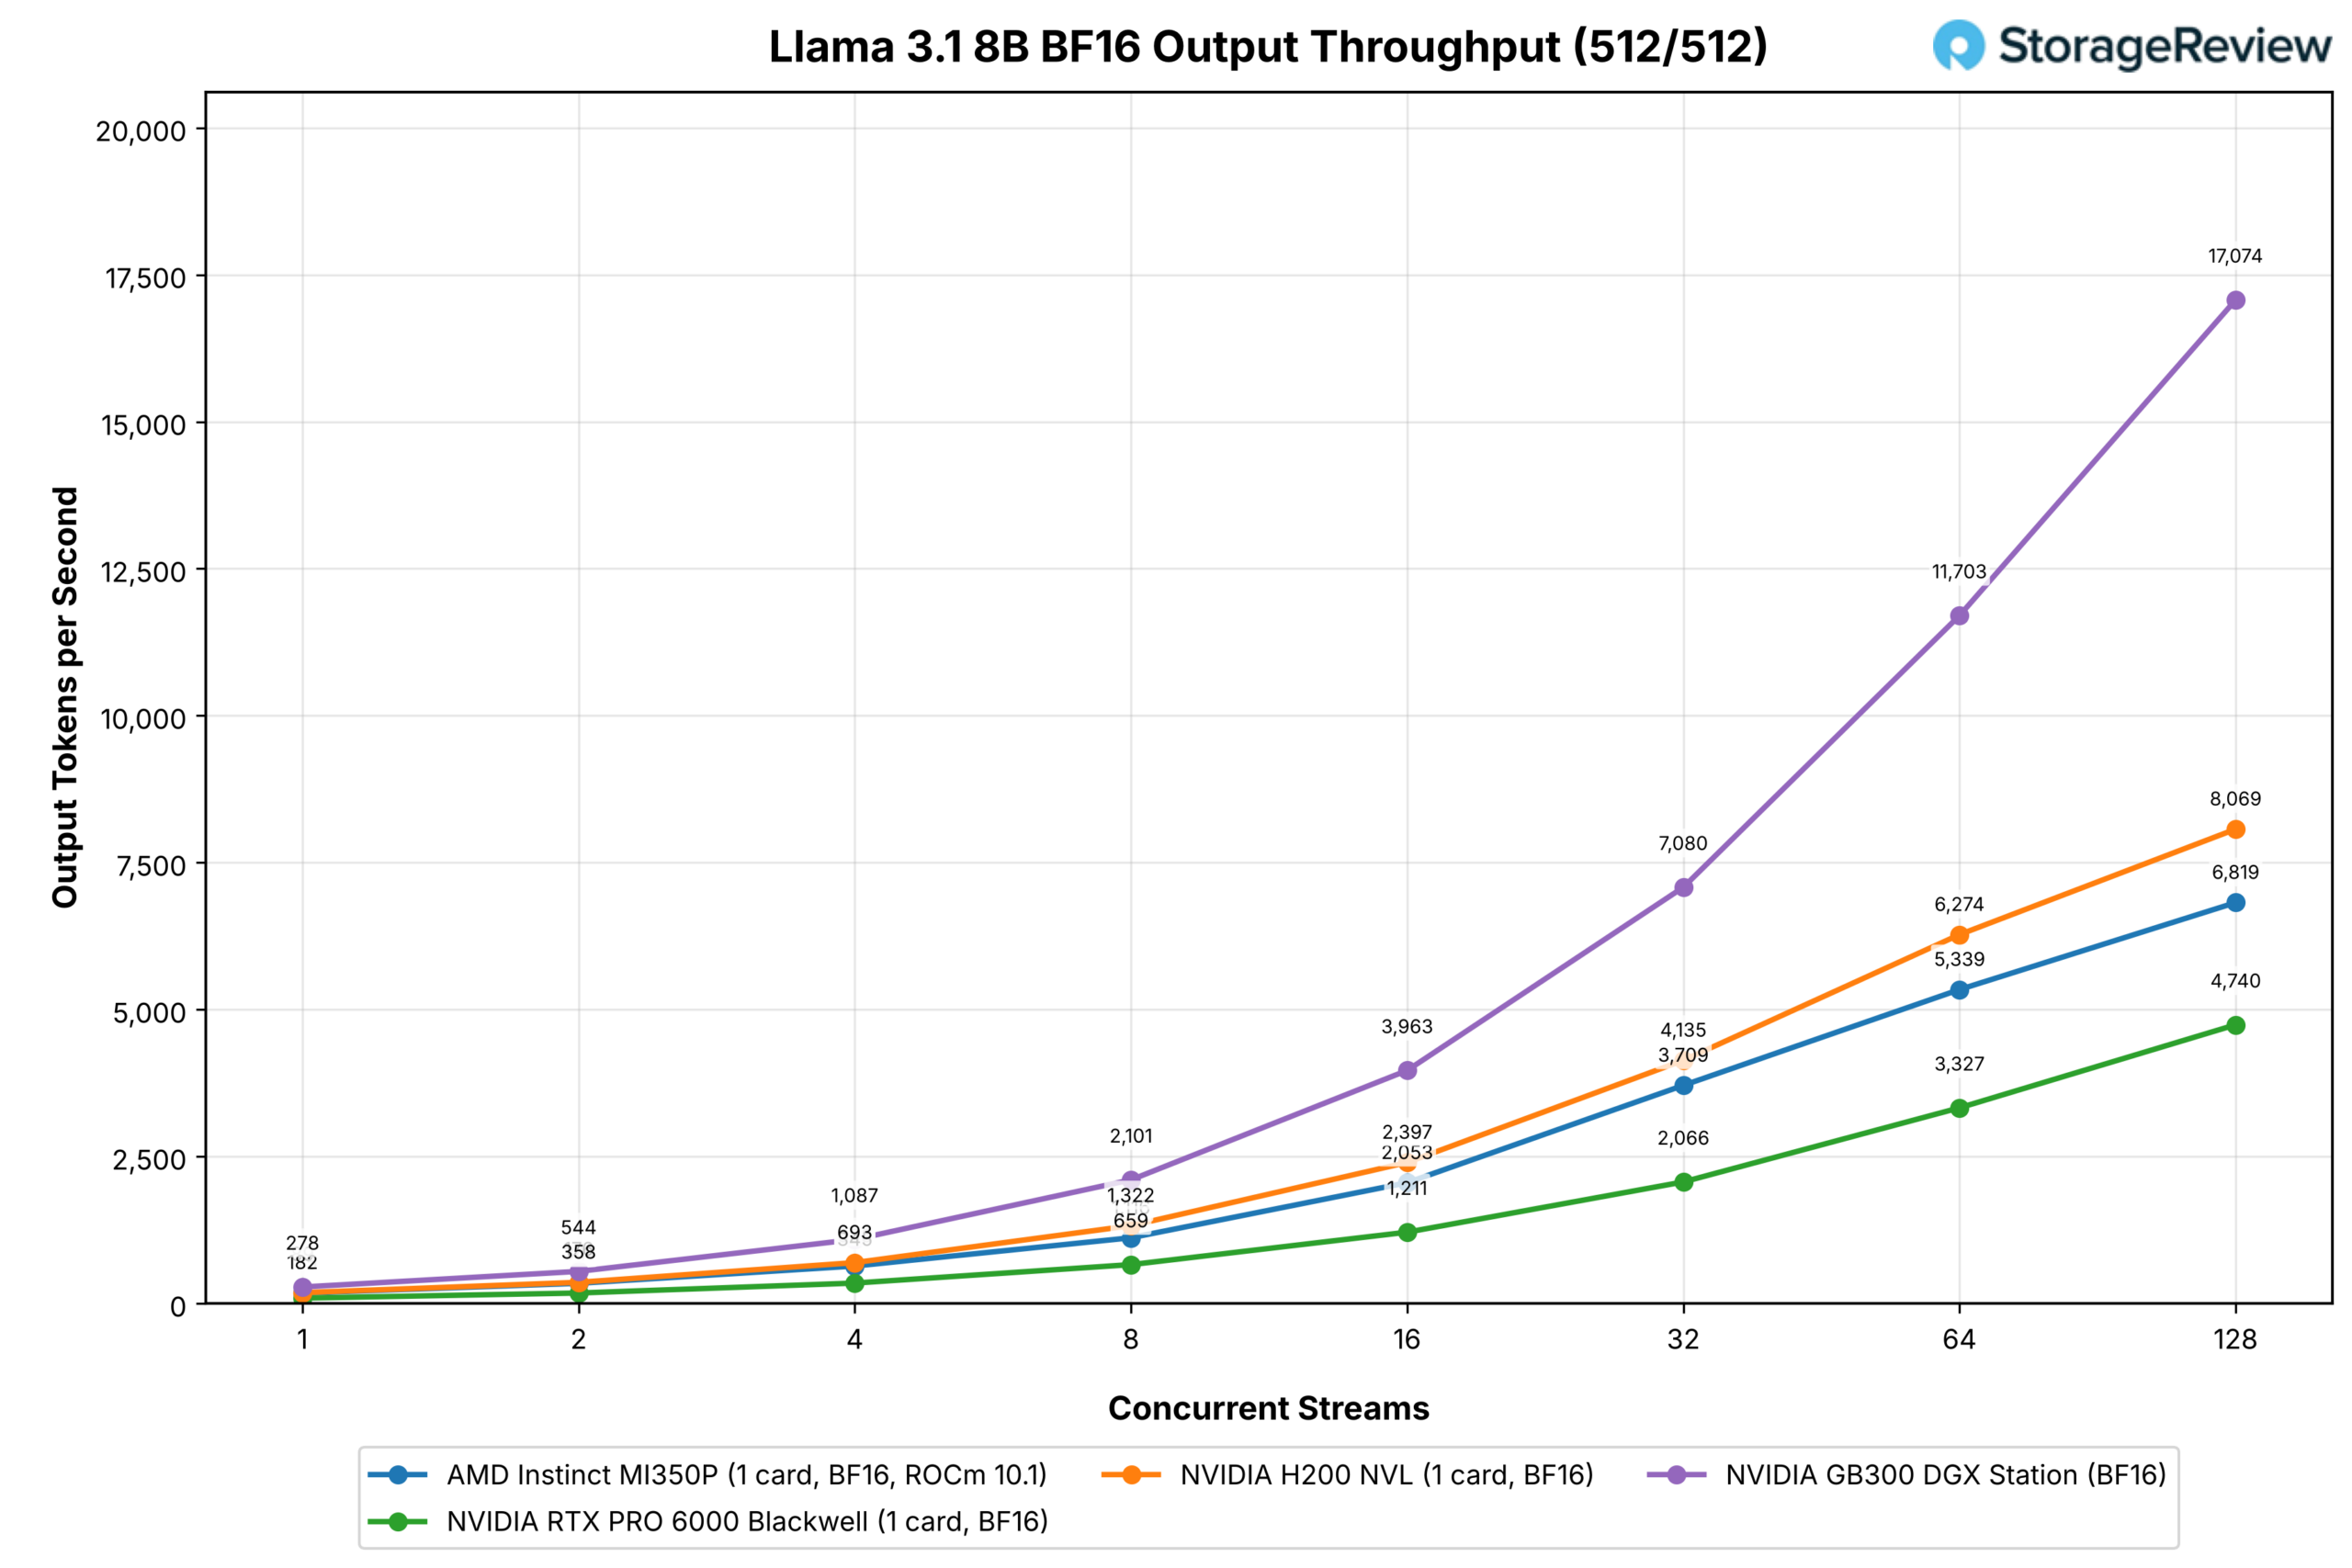
Llama 3.1 8B está aquí para dar continuidad a nuestra cobertura anterior de GPU. En 128 transmisiones en la carga de trabajo de chat, la MI350P entrega 11,045 tokens de salida por segundo en FP8 frente a 8,073 para la RTX PRO 6000 y 11,054 para la H200, un empate con la tarjeta Hopper, y 6,819 en BF16 frente a 4,740 y 8,069. La compilación MXFP4 de AMD alcanza 8,383 en 128 transmisiones, un 5 por ciento por debajo de la compilación NVFP4 de NVIDIA en la RTX PRO 6000 (8,869), después de superarla por un 12 a 143 por ciento en cada recuento de transmisiones más bajo; en una sola transmisión, la ejecución MXFP4 lee 323 frente a 133.
Las ejecuciones con precarga invierten el resultado: MI350P FP8 se estanca en 16 flujos y termina en 1,211 frente a 1,481 para la RTX PRO 6000 y 2,045 para la H200, a pesar de que la MI350P comienza un 90 por ciento por delante de la RTX PRO 6000 en un flujo, y la compilación MXFP4 está un 41 por ciento por detrás de NVFP4 en 128 flujos.
Conclusión
La MI350P es la primera tarjeta Instinct en cuatro años que se instala en un servidor estándar, y con 450 W en una caja de 2U se comporta como un acelerador PCIe: 144 GB de HBM3E a 4 TB/s, 1,120 TFLOPS de FP8 y 2,228 de FP4 con escalado de bloques en MAMF frente a 820 y 1,634 para la RTX PRO 6000 Blackwell, y aproximadamente 2.1 veces el ancho de banda de memoria utilizable de la tarjeta NVIDIA.

Frente a la RTX PRO 6000, la MI350P fue más rápida en mensajes de chat en todos los modelos FP8, BF16 y GPT-OSS, entre un 35 y un 65 por ciento a 128 flujos, donde el ancho de banda y la capacidad de HBM3E superaron a una tarjeta GDDR7 de 96 GB, y lidera en ambos modelos GPT-OSS en cada recuento de flujos en ambas formas de mensajes.
La H200 NVL aún la superó en las pruebas densas FP8 y BF16, entre un 4 y un 18 por ciento en 128 flujos en indicaciones de chat y aún más en indicaciones largas, con un 20 por ciento más de ancho de banda y sin ruta FP4; en GPT-OSS, la MI350P terminó un 50 y un 78 por ciento por delante de la tarjeta Hopper. Los modelos más grandes son menos estables, ya que cuatro RTX PRO 6000 superan al par MI350P en GLM-5.2 a través de 16 flujos, con 384 GB frente a 288 GB y más ancho de banda agregado y capacidad de cómputo para aprovechar.
MiniMax-M3 se acerca más: las tres configuraciones se mantienen dentro del 10 por ciento a través de ocho transmisiones en indicaciones de chat, el cuádruple RTX se adelanta a 16, y el par MI350P lidera en indicaciones largas a través de ocho transmisiones. Por tarjeta, la tasa FP4 medida de MI350P es un 36 por ciento más alta que la de RTX PRO 6000, por lo que la ventaja es la cantidad de tarjetas. Estos resultados de dos tarjetas están en la pila ROCm 7.2.3 y se ejecutarán nuevamente en ROCm 10.1 junto con las pruebas de 600W.
Todavía no podemos emitir una opinión definitiva sobre el MI350P sin probarlo a su máximo potencial a 600 W, lo cual planeamos hacer en un chasis PowerEdge XE7745; Dell admite ocho MI350P a 600 W en ese chasis. Según las estimaciones de AMD, los 150 W adicionales representan un aumento de rendimiento de aproximadamente un 10 %.
AMD ha avanzado mucho, y la línea MI350/5X demuestra la capacidad de su arquitectura. En nuestro laboratorio utilizamos un equipo MI300X para desarrollo, y la velocidad del conjunto de software se reflejó en la fluidez con la que se ejecutó gran parte de la suite con vLLM estándar sin problemas.
Con lo que hemos visto en esta configuración, el MI350P está dirigido a compradores que buscan una alternativa a las GPU de NVIDIA, ya sea por los plazos de entrega, el precio o para evitar depender de un solo fabricante, y el soporte de Dell para esta tecnología en la línea PowerEdge proporciona esa diversidad de silicio a los servidores convencionales para satisfacer la necesidad.
Para ser justos, nuestro trabajo aquí está lejos de haber terminado. Si bien muchos compradores pueden instalar estas tarjetas en servidores 2U, se obtiene un mayor rendimiento al instalarlas en un chasis más grande diseñado para tarjetas de 600 W. Independientemente de cómo se implementen, este es un excelente primer vistazo al regreso de AMD al mercado de tarjetas de expansión para servidores, y a medida que el conjunto de software continúa madurando, la MI350P, y lo que venga después, tiene un futuro prometedor. Hoy, para un comprador cuyos modelos se encuentran en el rango de 96 GB a 144 GB, la MI350P es una de las dos tarjetas PCIe que los mantienen en una sola GPU, y la única que supera los 141 GB.
Tabla de clasificación: The AMD Instinct MI350P appears under Also Tested on our Las mejores GPU para empresas leaderboard, with its two-card results under Scale-Out Configurations.



 Amazon