

La Dell Pro Max 16 Plus presenta dos propuestas que apuntan en direcciones opuestas. Una es la de una estación de trabajo móvil de gama alta: procesador Intel Core Ultra 9 285HX de 24 núcleos, hasta 256 GB de memoria CAMM2, tres ranuras M.2, gráficos NVIDIA RTX PRO Blackwell de hasta la serie 5000 con 24 GB de GDDR7, construcción con certificación MIL-STD-810H y un chasis en el que Dell ha invertido claramente en ingeniería.
El otro es el modelo que estamos analizando, que reemplaza la GPU por una tarjeta de inferencia Qualcomm AIC100 PC, un módulo de doble SoC basado en el chip Cloud AI 100 de 2019, y un conjunto de software que convierte la mayoría de las cargas de trabajo de inferencia modernas en una tarea ardua. Esto sirve como advertencia sobre lo que sucede cuando un chasis de gama alta se combina con el acelerador incorrecto, y por qué los clientes deben comprender el conjunto de software detrás de una solución de IA antes de firmar el pedido. Antes de entrar en detalles, veamos la computadora portátil en su conjunto.
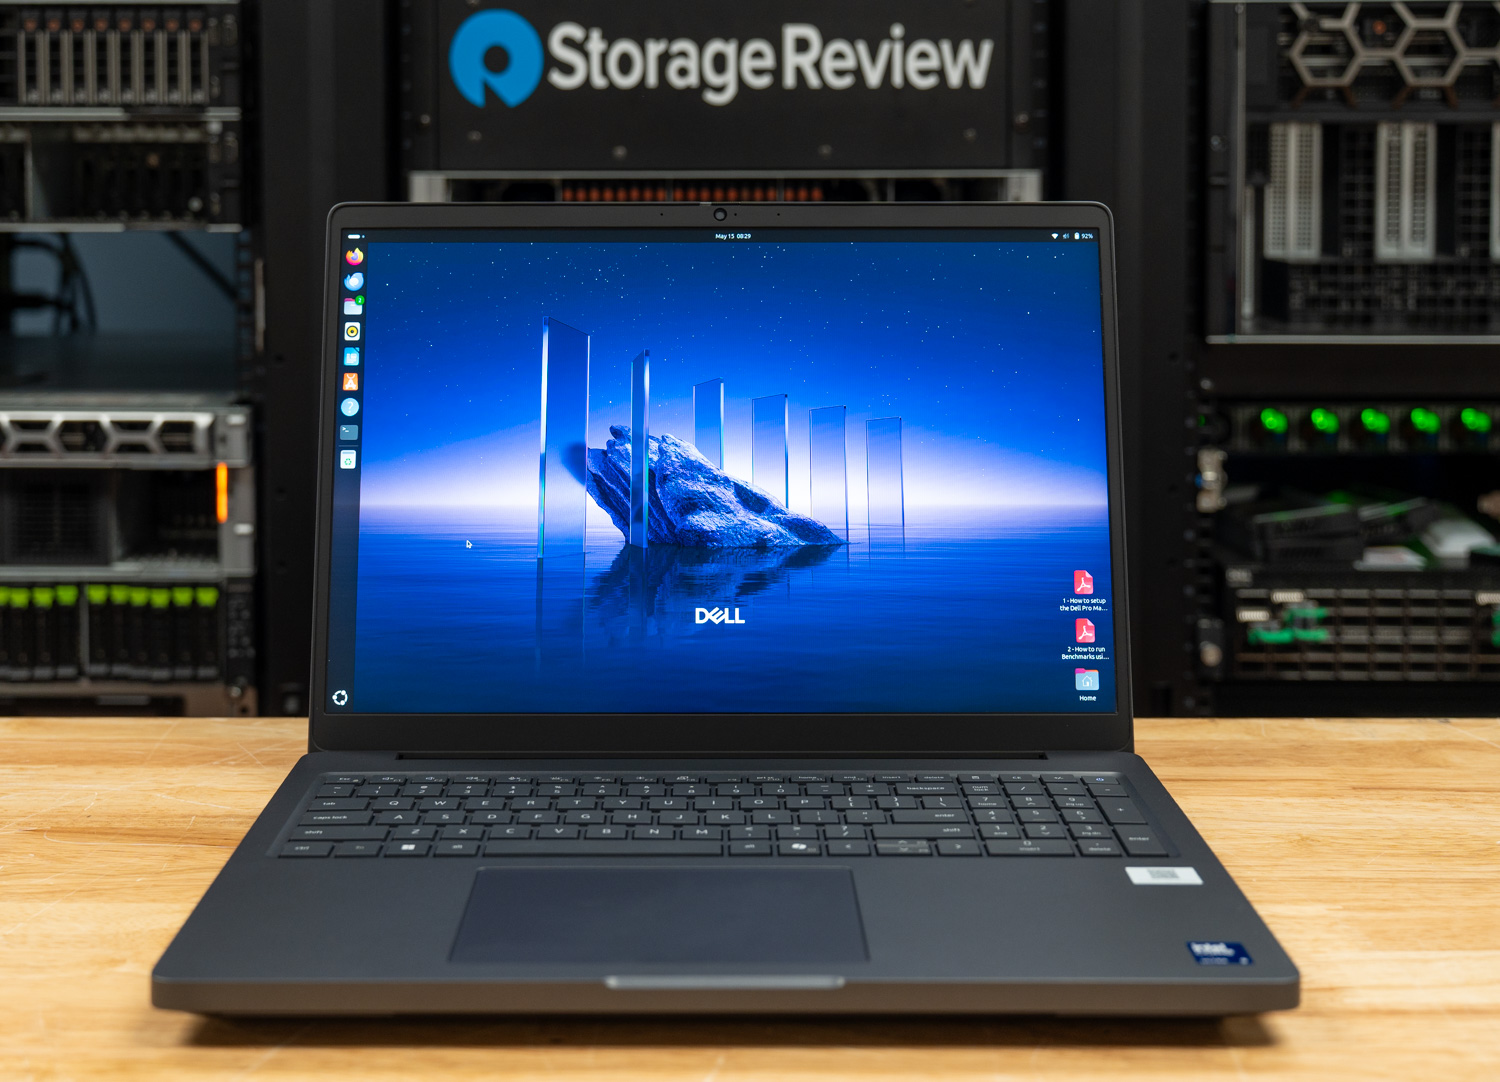
La Dell Pro Max 16 Plus se sitúa en lo más alto de la gama de estaciones de trabajo Pro Max, ofreciendo mayor potencia bruta que la Pro Max 16 de entrada y la más delgada Pro Max 16 Premium. Su núcleo es el procesador Intel Core Ultra 9 285HX, un chip de 24 núcleos y 55 vatios con una frecuencia turbo de 5.5 GHz. Todas las configuraciones de CPU son compatibles con Intel vPro Enterprise, lo que refuerza las credenciales empresariales del portátil. Su precio inicial es de 2,779 dólares.
Las opciones gráficas abarcan desde los gráficos integrados de Intel hasta la RTX PRO 1000 de NVIDIA basada en Blackwell, llegando incluso a la RTX PRO 5000 que analizamos anteriormente , la cual cuenta con una impresionante memoria GDDR7 de 24 GB. Las configuraciones de almacenamiento y memoria son igualmente generosas: hasta 12 TB distribuidos en tres ranuras M.2 Gen5 y hasta 128 GB de memoria DDR5-6400 mediante el módulo CAMM2 de Dell.
Las opciones de pantalla van desde un panel IPS básico de 1920 x 1200 hasta la vibrante pantalla táctil OLED de 3840 x 2400. Una opción intermedia de 1920 x 1200 ofrece 500 nits de brillo, una frecuencia de actualización variable de 120 Hz y cobertura completa del espacio de color DCI-P3. Con más de 100 certificaciones de proveedores de software independientes (ISV), los profesionales creativos pueden esperar que sus aplicaciones funcionen sin problemas.
Las funciones de seguridad están preparadas para entornos empresariales, incluyendo un lector de huellas dactilares, compatibilidad con tarjetas inteligentes, NFC, una cámara infrarroja de 8 MP para reconocimiento facial y Dell Control Vault 3. Una garantía estándar de tres años completa el paquete, lo que subraya el papel de este portátil como una herramienta seria para el trabajo exigente.
Especificaciones del Dell Pro Max 16 Plus
| Especificación | Dell Pro Max 16 Plus |
|---|---|
| Plataforma | |
| Procesador | Intel Core Ultra 5 245HX Intel Core Ultra 7 265HX Intel Core Ultra 9 285HX |
| Sistema operativo | Ventanas 11 Pro Ubuntu Linux 24.04 LTS |
| Salud Cerebral | 16 GB-128 GB CSoDIMM o CAMM2, 1 ranura |
| Gráficos y aceleración de IA | |
| Tarjeta gráfica | Intel Integrated Graphics NVIDIA RTX PRO 1000 de 8 GB NVIDIA RTX PRO 2000 de 8 GB NVIDIA RTX PRO 3000 de 12 GB NVIDIA RTX PRO 4000 de 16 GB NVIDIA RTX PRO 5000 de 24 GB Qualcomm AI Cloud 100 64GB (2x 32GB) |
| Almacenamiento y exhibición | |
| Almacenaje | Hasta 3 SSD M.2 de 4 TB cada uno RAID 0/1/5 disponible |
| Mostrar | 16 pulgadas 16:10 1920×1200, 300 nits, 45 % NTSC, 60 Hz, sin función táctil 1920×1200, 500 nits, 100 % DCI-P3, 120 Hz VRR, sin función táctil 3840×2400, 500 nits, OLED, táctil |
| Conectividad y Energía | |
| Cámara | IR de 8 MP |
| Redes inalámbricas | Intel Wi-Fi 7 BE200, con o sin Bluetooth 5.4 Banda ancha móvil disponible |
| Batería | 6Whr de células 96 |
| Adaptador de corriente | 165W o 280W |
| Seguridad y seguridad física | |
| Características de seguridad | cámara web de infrarrojos Lector de huellas dactilares Lector de tarjetas inteligentes NFC Bóveda de control 3 |
| Dimensiones y peso | 1.22 por 10.18 por 14.17 pulgadas Peso inicial: 5.63 libras |
| Garantía | Reparación estándar en el sitio durante tres años, el siguiente día hábil |
Construcción y Diseño
Al igual que el modelo anterior que analizamos, el Pro Max 16 Plus es robusto y resistente, con certificación MIL-STD-810H que garantiza su durabilidad en entornos exigentes. La combinación de materiales de Dell se centra en la sostenibilidad, incorporando plástico reciclado posconsumo, magnesio y cobalto reciclados, y plásticos de origen biológico. Al sostenerlo, el chasis se siente excepcionalmente rígido, sin ninguna flexión perceptible. En resumen, está construido para durar.
Se trata de un dispositivo robusto. Con un grosor de 1.22 cm (incluidas las patas) y un peso inicial de 5.63 kg, no está diseñado para viajes frecuentes, aunque sus dimensiones de 10.18 x 14.17 cm son bastante compactas para una pantalla de 16 pulgadas con relación de aspecto 16:10. La cámara web se encuentra en la parte superior de la tapa, con una cubierta de privacidad deslizante; nuestra unidad de prueba incluye la versión infrarroja para reconocimiento facial.
Estéticamente, el diseño de Dell es excesivamente sobrio. El exterior gris y negro, junto con la discreta marca, enfatizan que se trata de un producto que prioriza la funcionalidad sobre la estética. La línea Pro Max Premium ofrece un mayor atractivo visual a costa del rendimiento y la capacidad de expansión.
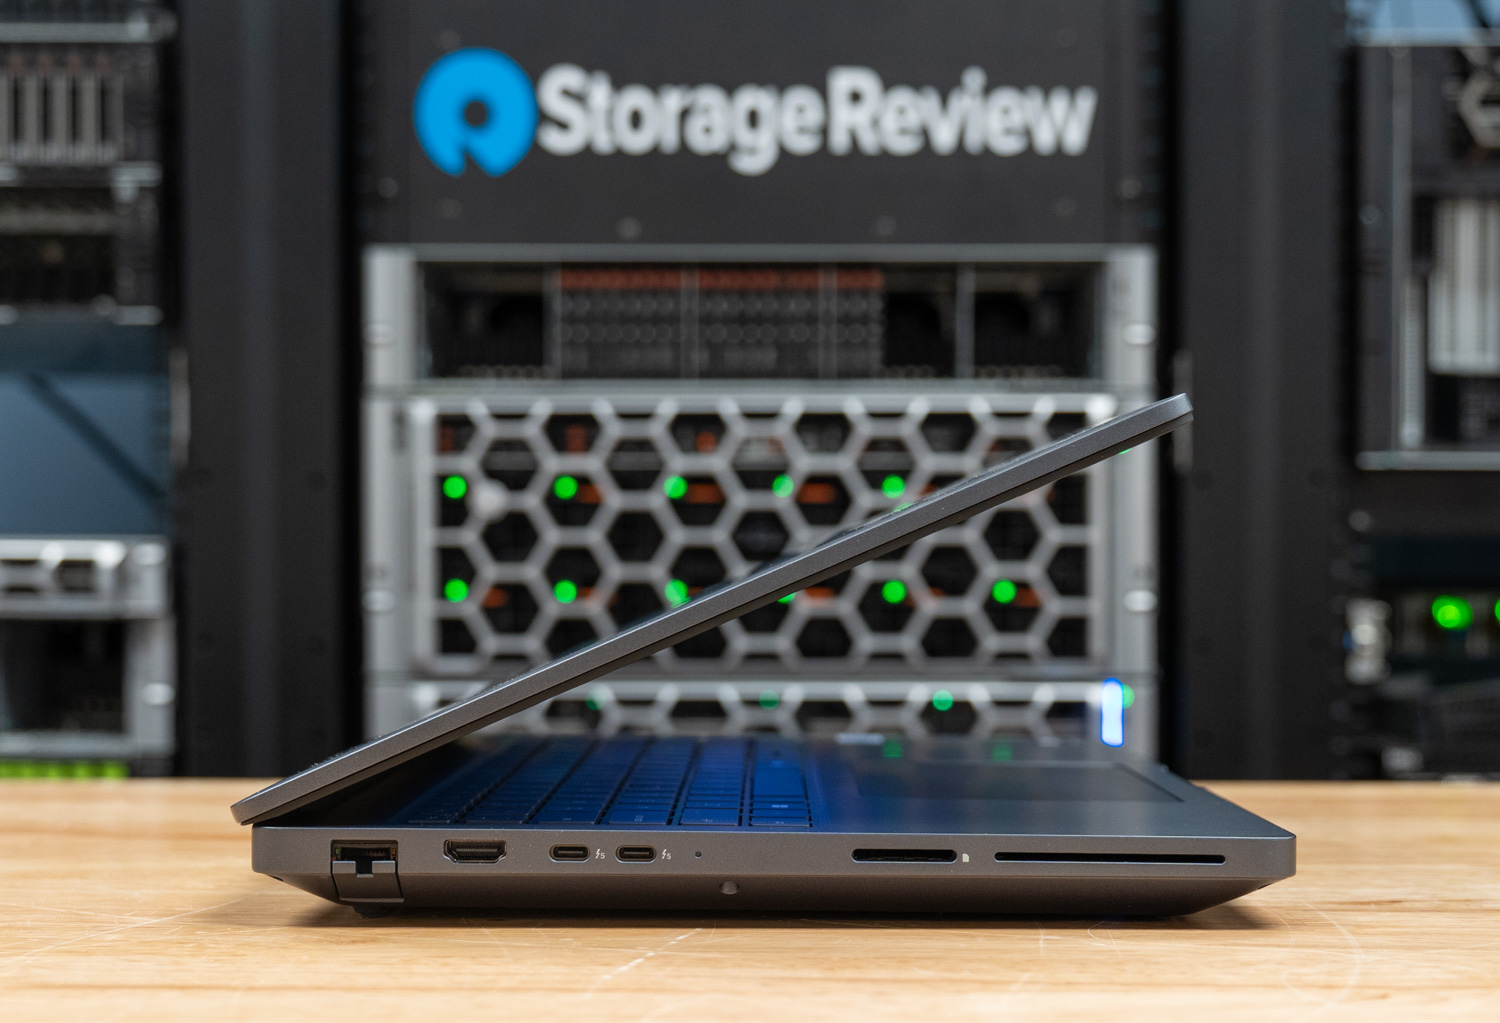
La selección completa de puertos comienza en el borde izquierdo:
- Ethernet RJ45 de 2.5 Gbps
- Salida HDMI 2.1
- Dos puertos Thunderbolt 5 (USB-C)
- lector de tarjetas SD
- Ranura para tarjeta inteligente opcional
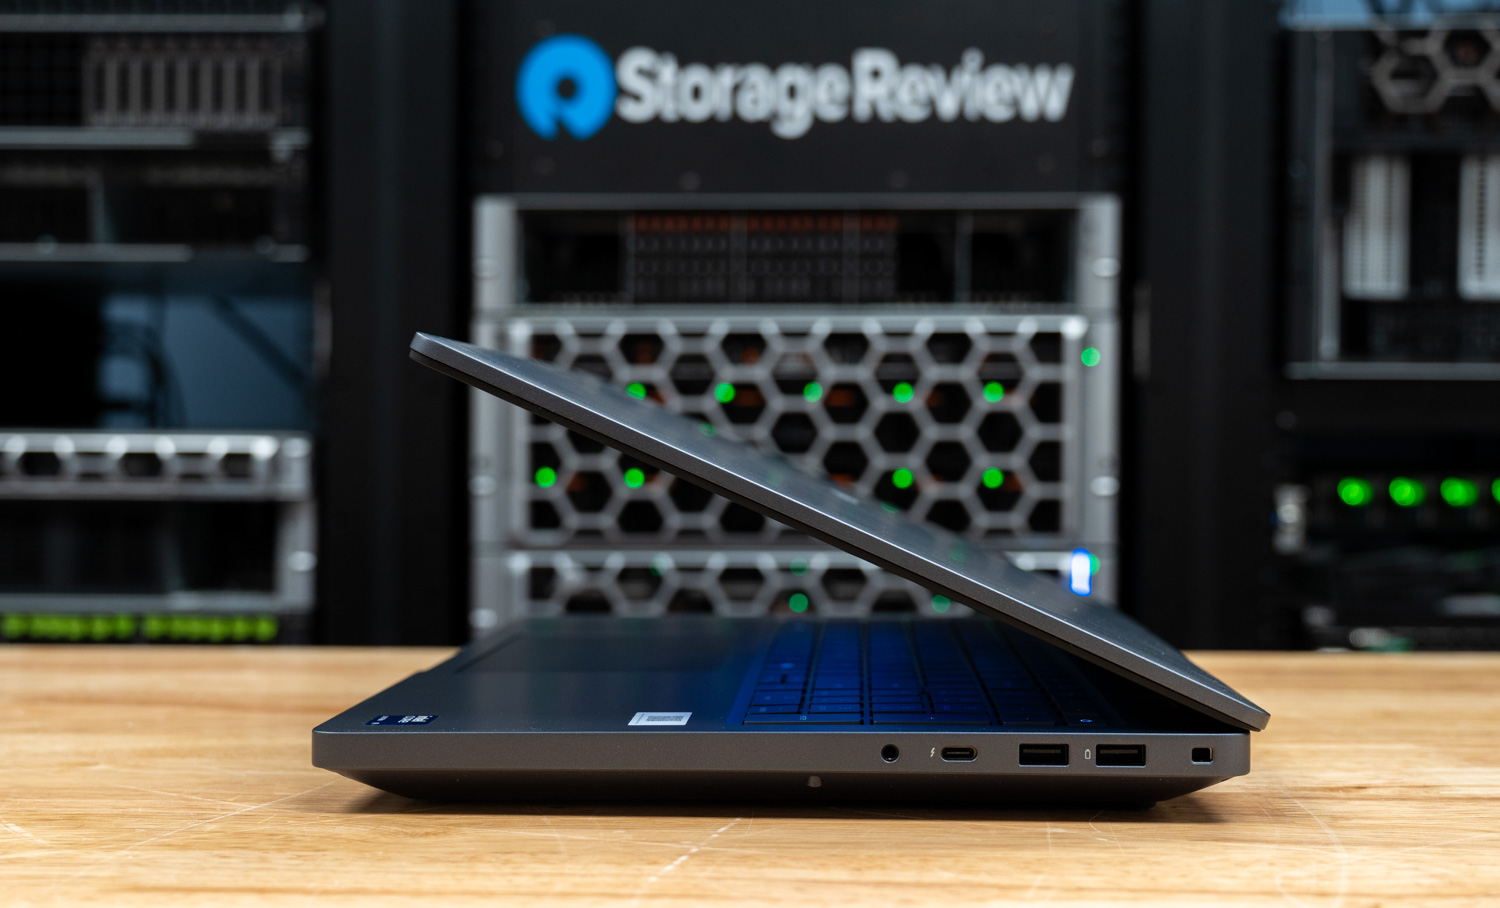
A la derecha:
- 3.5mm jack de audio
- Thunderbolt 4 (USB-C)
- Dos puertos USB 3.2 Gen1 tipo A
- ranura de bloqueo
No hay puertos en el borde posterior. La conectividad inalámbrica se gestiona mediante el módulo BE200 de Intel, compatible con Wi-Fi 7 y Bluetooth 5.4. En configuraciones personalizadas, se puede omitir Bluetooth, y también está disponible la banda ancha móvil 5G.
Pantalla y dispositivos de entrada
La unidad que analizamos cuenta con la pantalla Dell de 16 pulgadas y resolución 1920 × 1200, con un panel VRR de 120 Hz que ofrece una excelente calidad de imagen para el uso diario. Los colores son vibrantes y, con una cobertura del 100 % del espacio de color DCI-P3, resulta ideal para flujos de trabajo que requieren precisión cromática una vez calibrada. El brillo de 500 nits también contribuye a que la pantalla sea cómoda de usar en entornos de oficina o estudio con mucha luz.
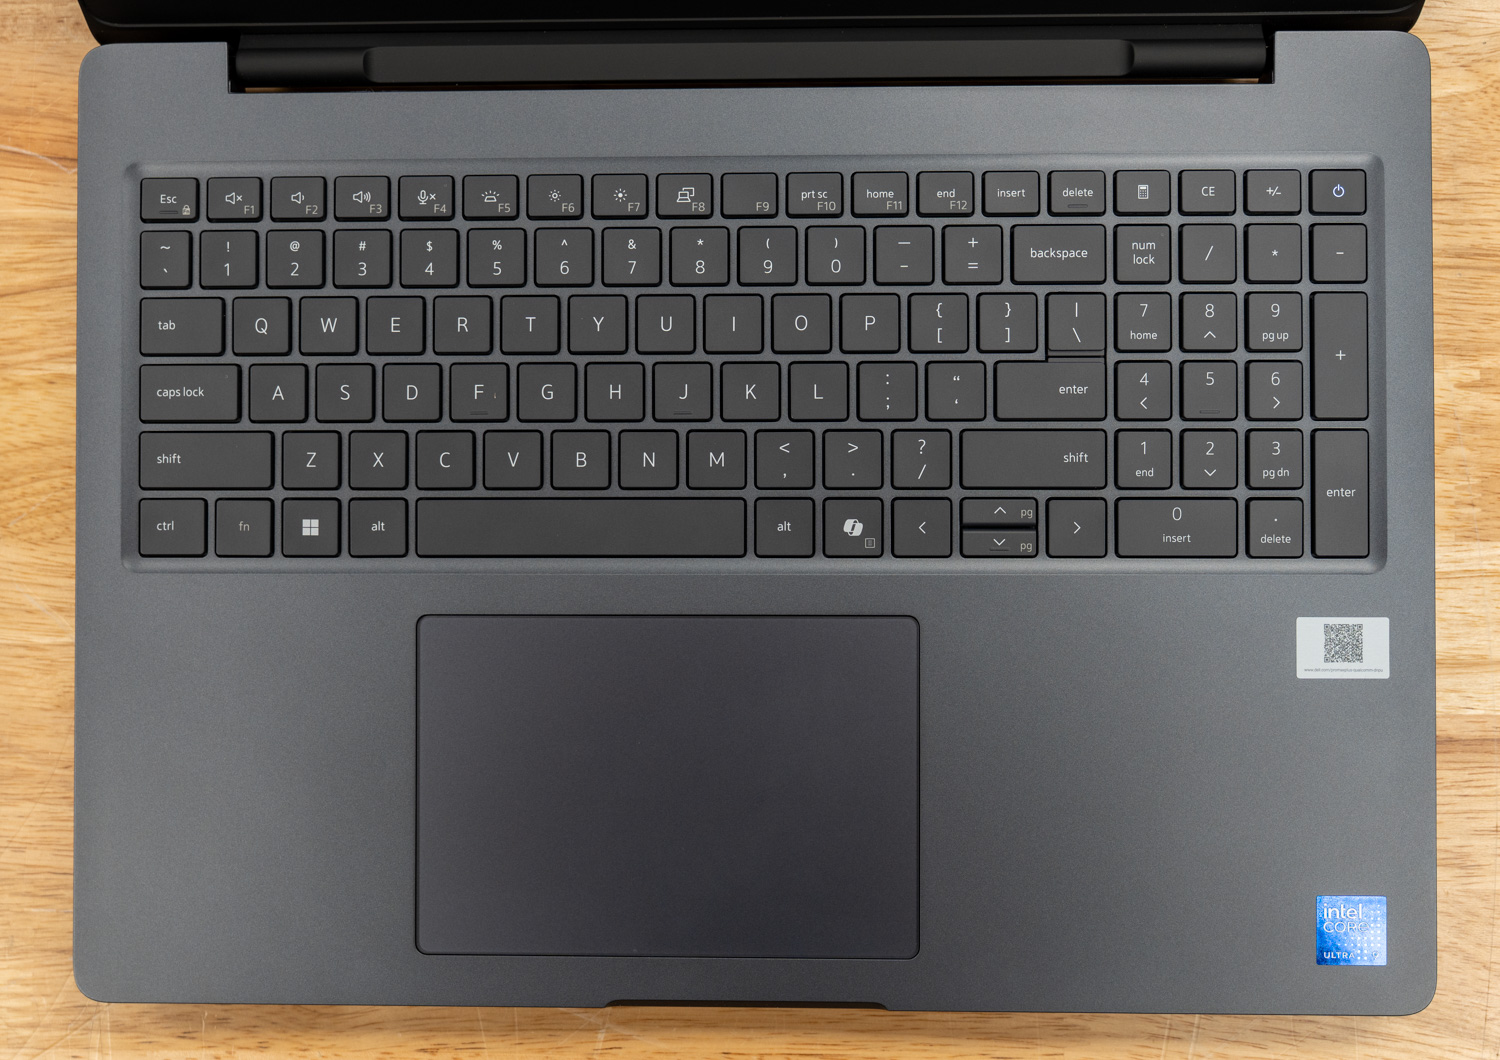
El teclado de Dell es ideal para largas sesiones de escritura, con teclas de tamaño completo que ofrecen una sensación ligera y sensible, además de una respuesta táctil nítida. La retroiluminación blanca lo mantiene visible en entornos con poca luz. La distribución es bastante convencional, pero el tamaño desigual de las teclas de flecha puede provocar pulsaciones accidentales ocasionales, y la ubicación de las teclas Inicio y Fin es un inconveniente particular; comparten espacio con F11 y F12, por lo que activar Fn-Lock (Fn + Esc) para priorizar la fila de funciones obliga a pulsar Fn + F11 o F12 para acceder a ellas. Se agradecerían teclas dedicadas de Av Pág y Re Pág; en su lugar, son funciones secundarias de las flechas arriba y abajo, que ya son las teclas más incómodas del conjunto. El botón de encendido, situado en la parte superior derecha, también funciona como sensor de huellas dactilares.
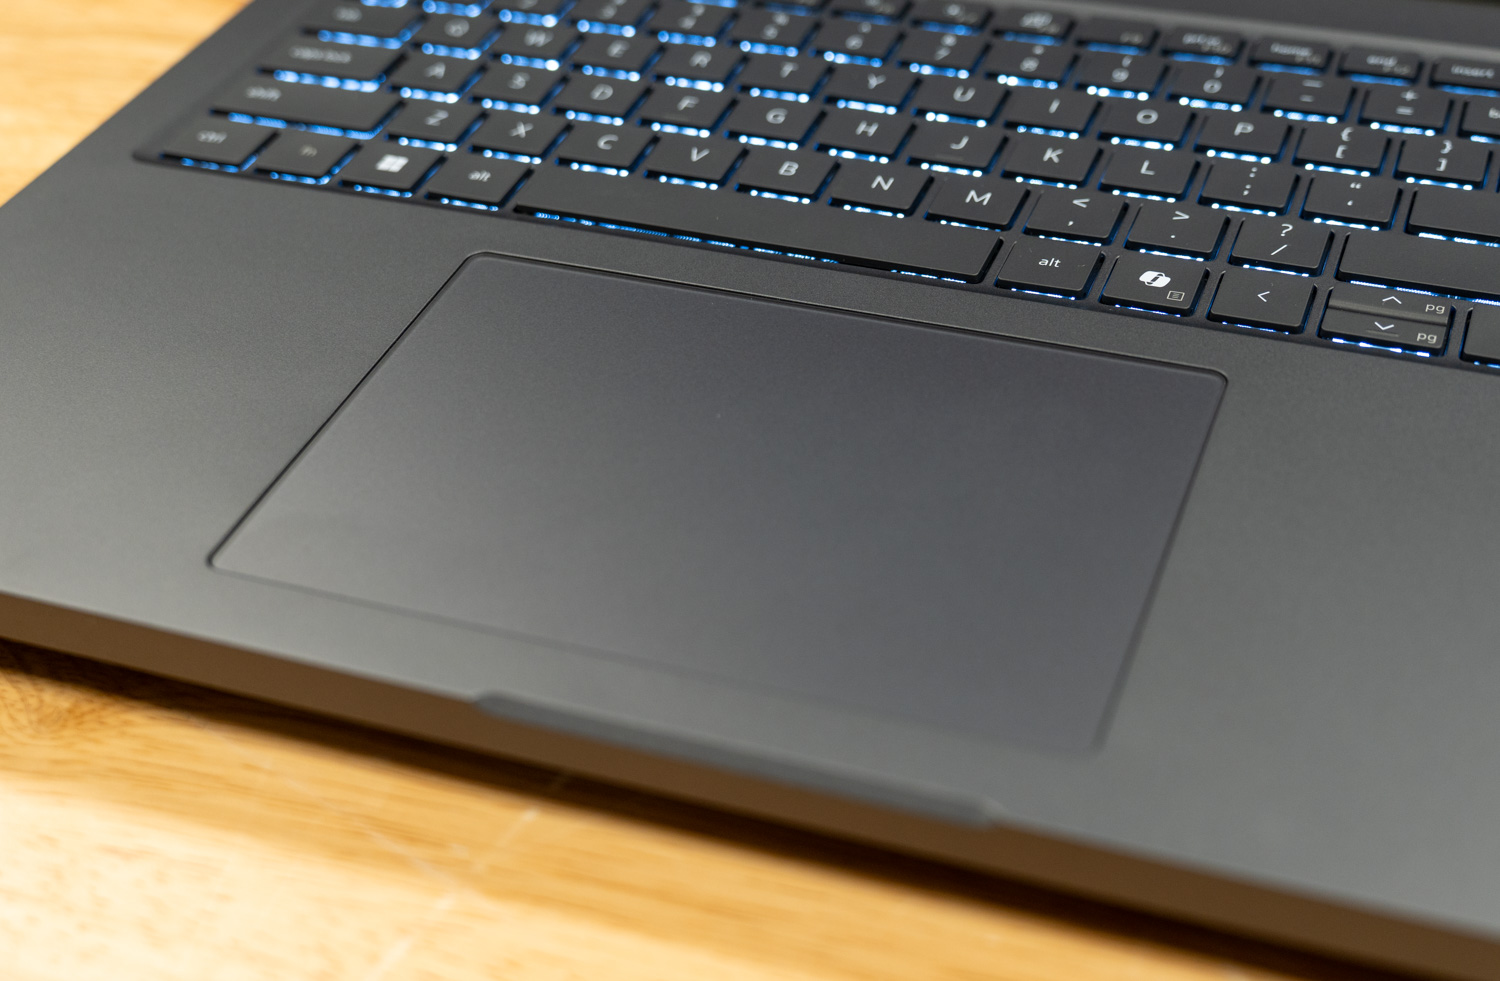
El panel táctil de generosas dimensiones complementa el formato de 16 pulgadas. Su superficie lisa y antirreflejos ofrece un seguimiento preciso, y la función de rechazo de palma funcionó a la perfección durante todas las pruebas.
Capacidad de actualización
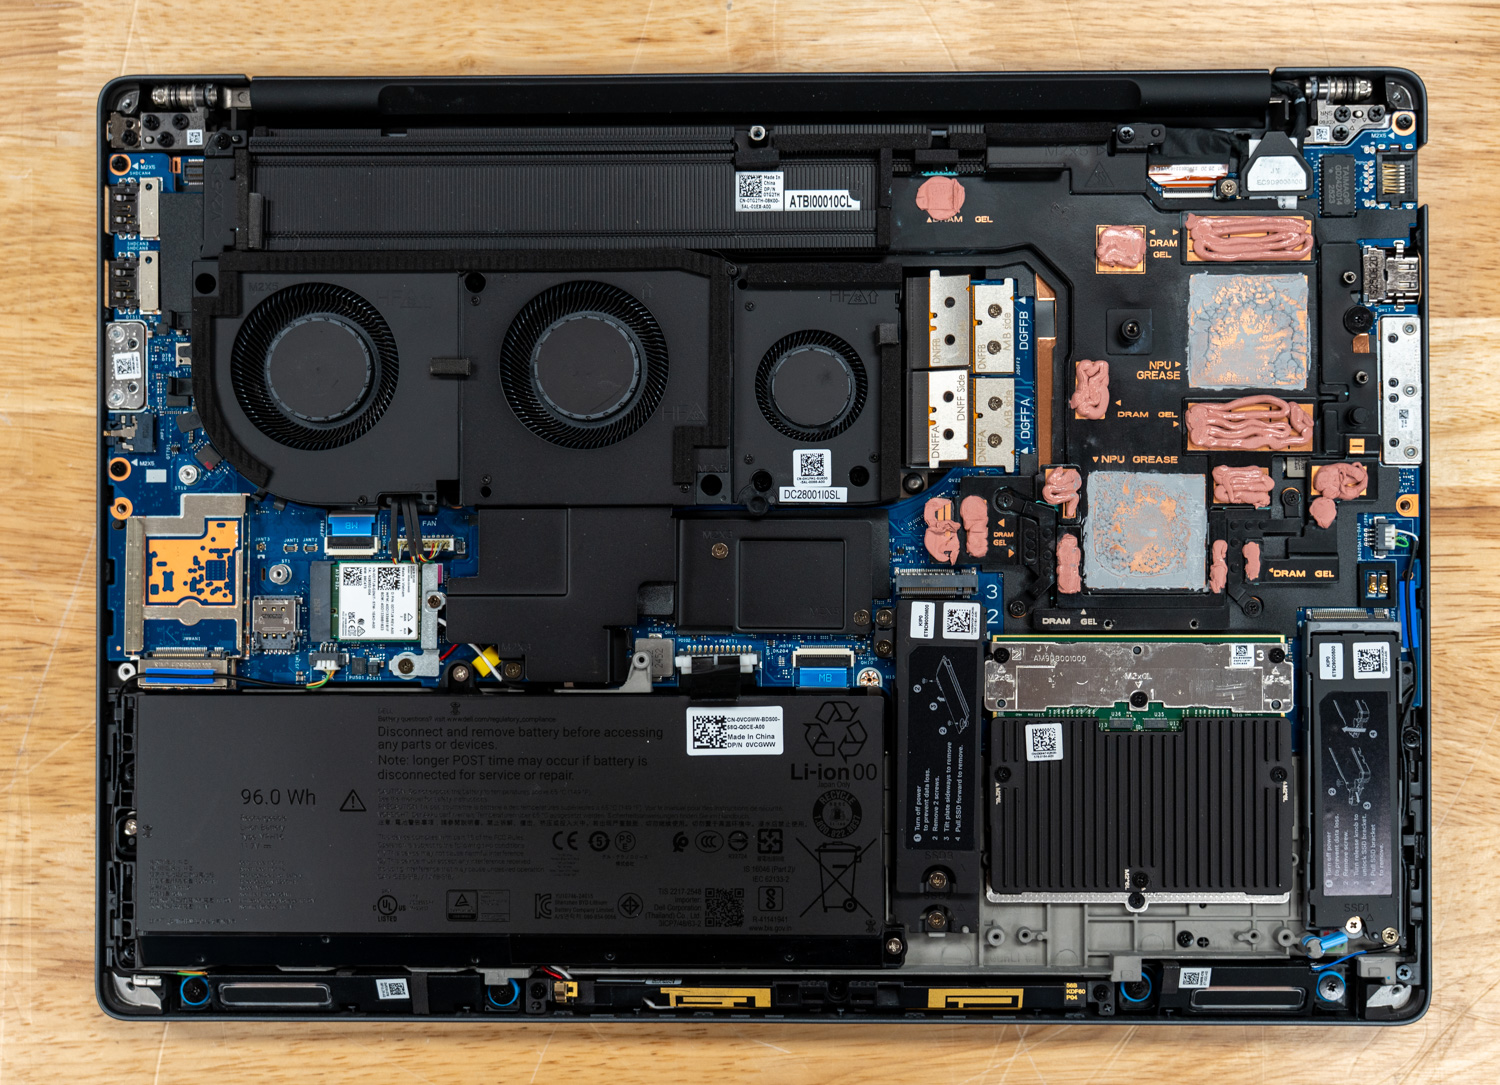
El Pro Max 16 Plus está diseñado pensando en la expansión, ofreciendo un gran potencial de actualización. Cuenta con tres ranuras M.2 Gen5 para almacenamiento, una ranura CAMM2 para ampliar la memoria y varios componentes modulares, incluidos puertos USB-C reemplazables.
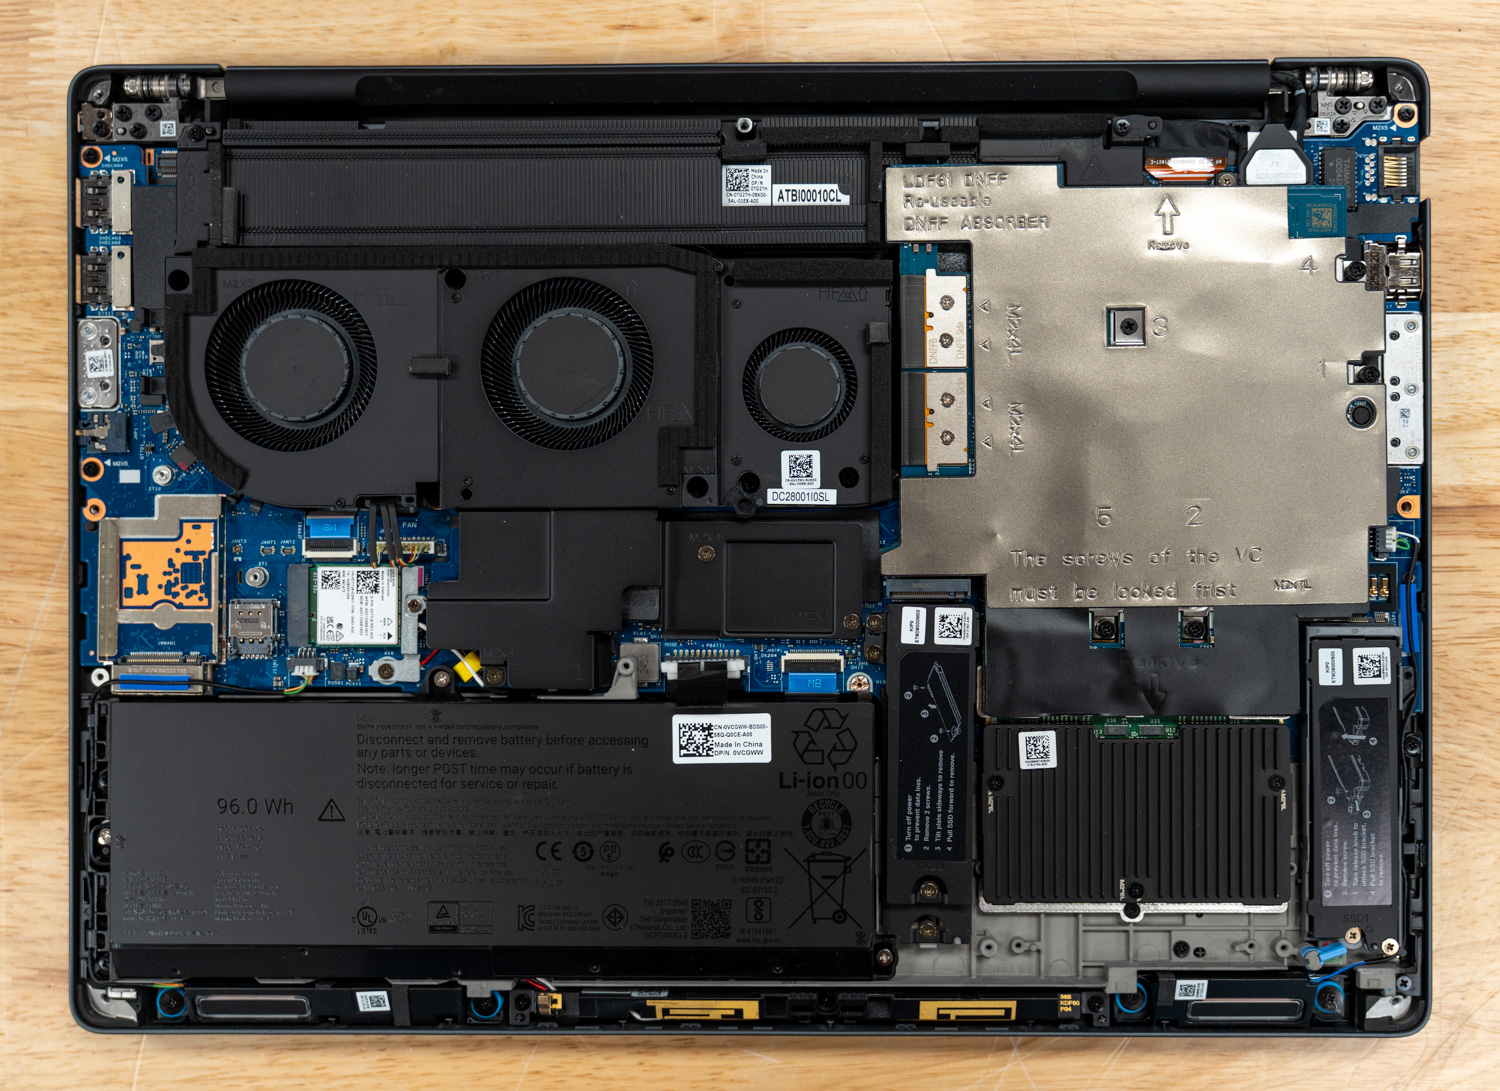
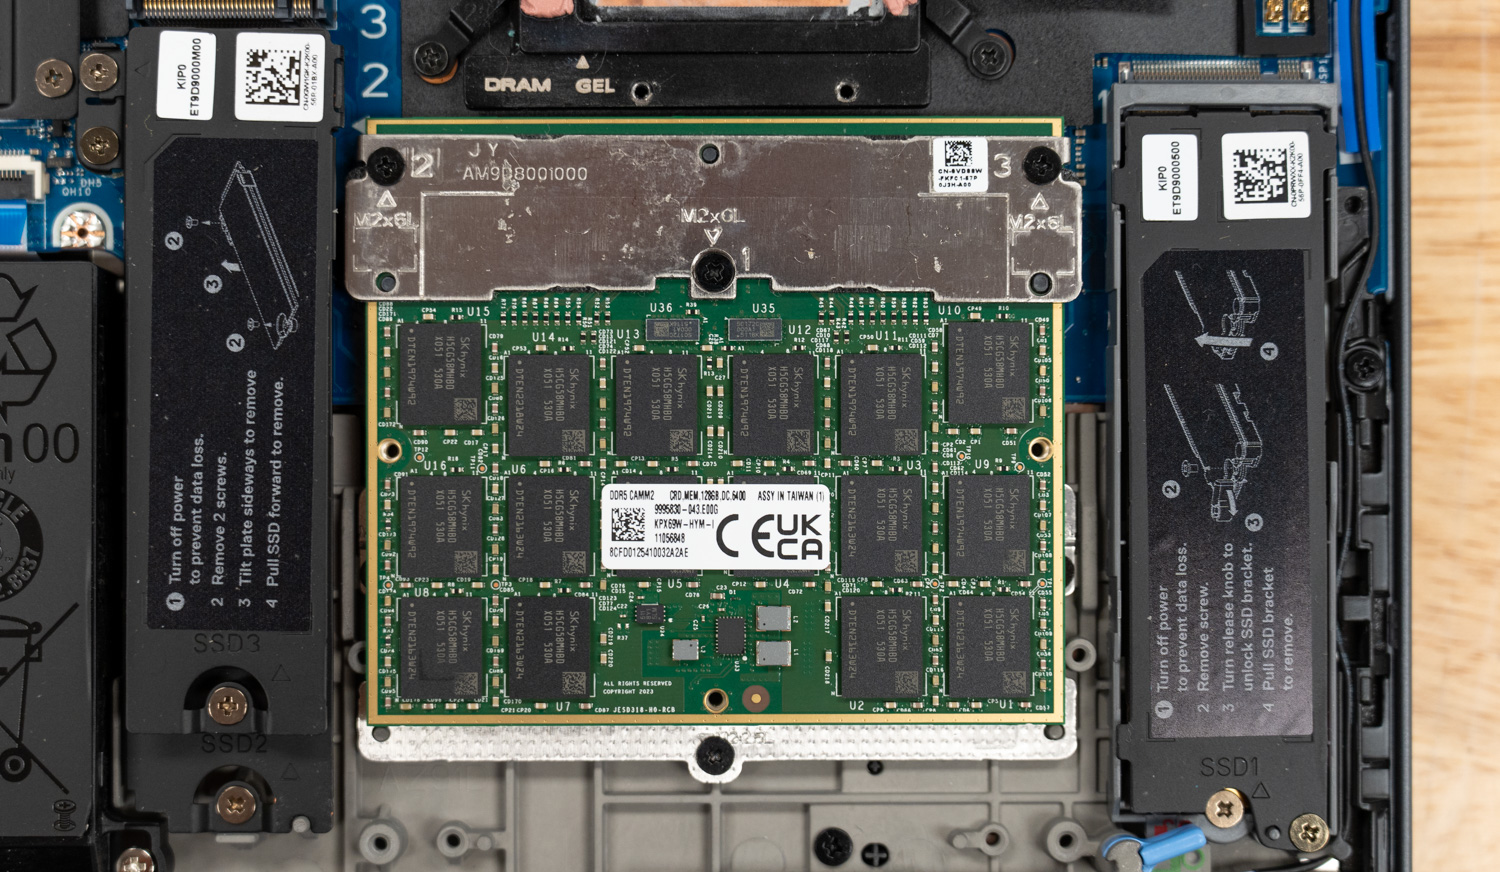
Acceder al interior es sencillo: basta con retirar los tornillos del perímetro y levantar el panel inferior de atrás hacia adelante. En el interior, encontramos un robusto sistema de refrigeración con tres ventiladores y una batería de 96 Wh. El módulo de memoria CAMM2 se ubica en la esquina inferior derecha, bajo un disipador de calor específico y flanqueado por las ranuras M.2. Aunque no se aprecia en la foto, la ranura M.2 de la izquierda es en realidad una ranura apilada que aloja dos unidades en el mismo espacio. La tarjeta inalámbrica M.2, también reemplazable por el usuario, se encuentra justo encima de la batería.
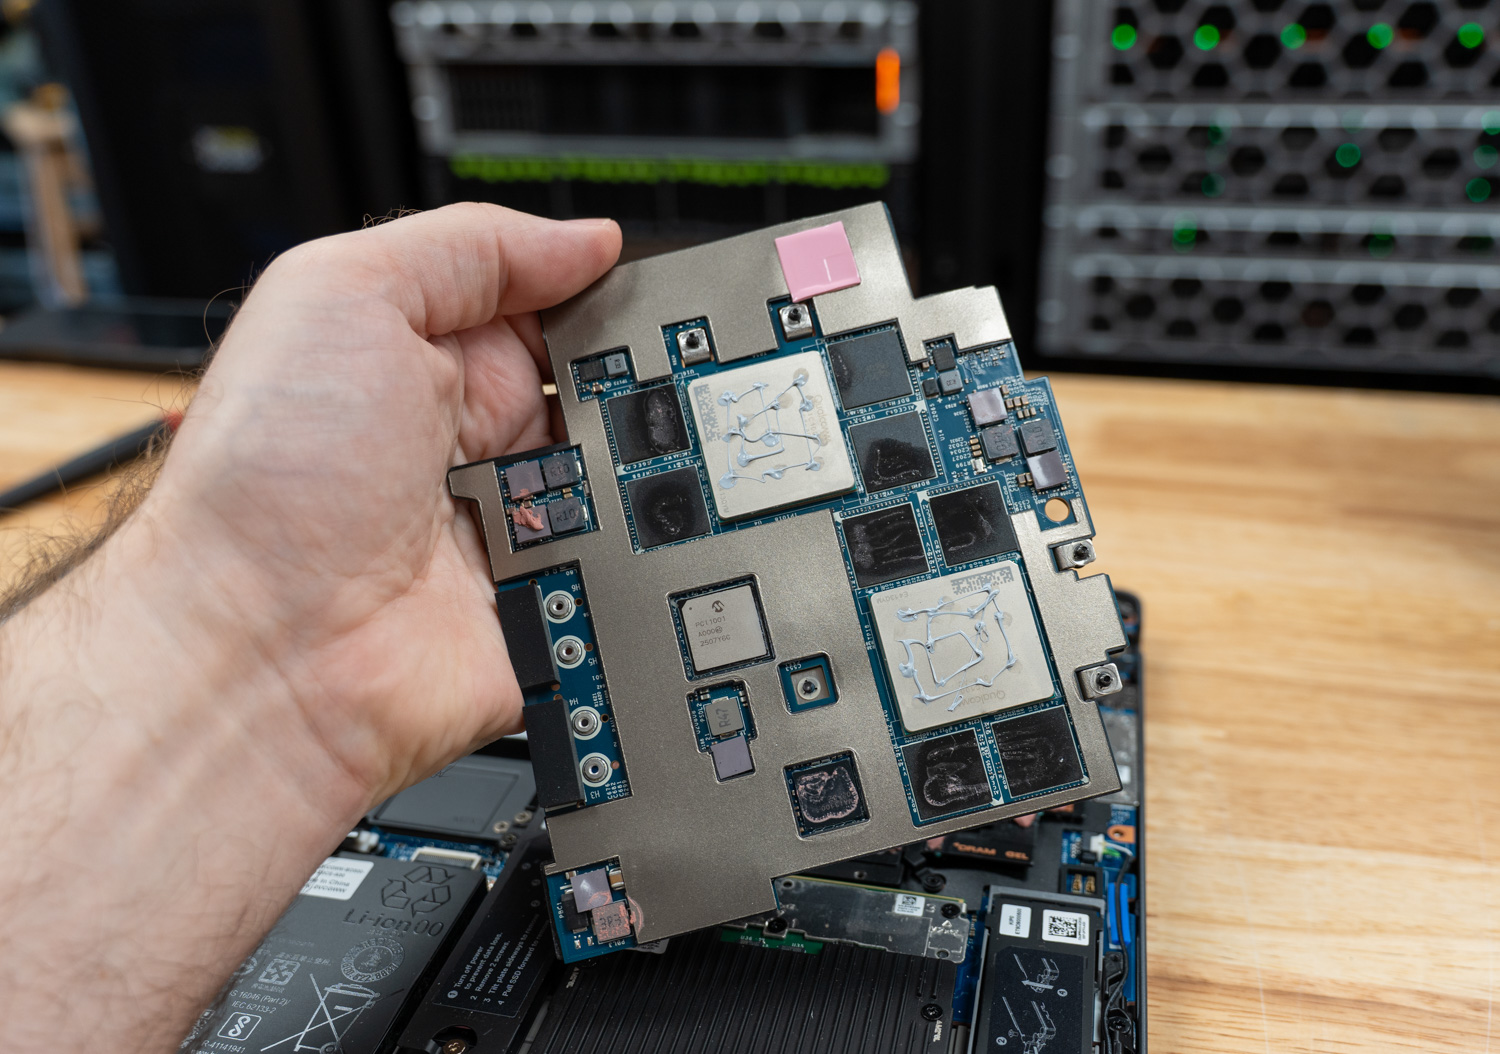
La estrella del espectáculo: Qualcomm AIC100
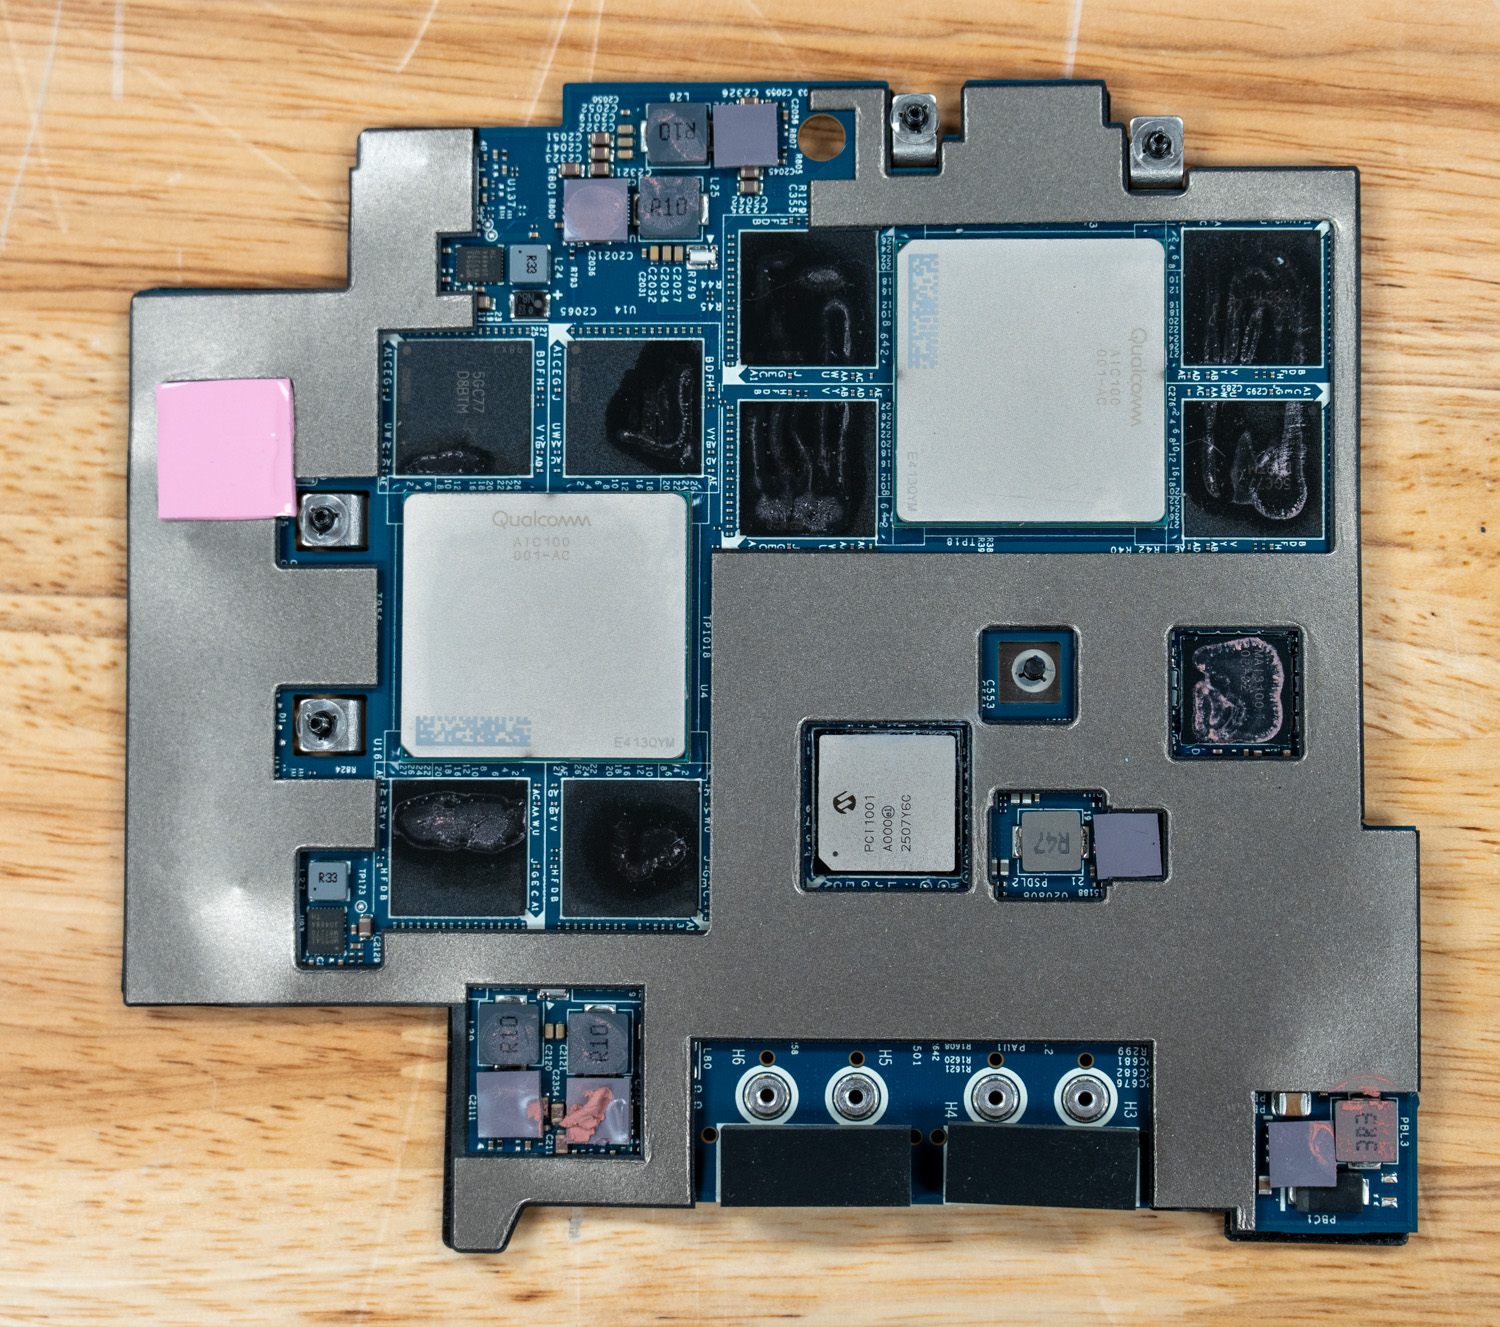
La versión de Dell que se analiza incluye la NPU Qualcomm AI 100, un módulo único que alberga dos SoC Qualcomm Cloud AI 100 uno al lado del otro. Cada SoC aporta 16 núcleos de IA, para un total de 32 en todo el módulo, y cada uno cuenta con sus propios 32 GB de LPDDR4x, que se presentan al host como dos NPU individuales.
Dell y Qualcomm anuncian un rendimiento INT8 de aproximadamente 450 TOPS y la capacidad de ejecutar modelos con un rango de 100 mil millones de parámetros. Dell ha demostrado públicamente que Llama 4 Scout (109 mil millones de parámetros, MoE) se ejecuta localmente en el portátil. Los dos SoC se comunican con el host a través del controlador acelerador QAIC de Linux, y los blobs de firmware se integran en linux-firmware.
Hasta aquí, todo razonable. Las cifras, aisladas, son elevadas. El problema reside en el silicio que hay detrás de esas cifras.
Qualcomm anunció el Cloud AI 100 en abril de 2019, lanzó muestras a finales de 2020 y comenzó a comercializarlo en la primera mitad de 2021. El chip está fabricado con un proceso de 7 nm y utiliza cuatro controladores LPDDR4X de 64 bits que funcionan a 2100 MHz (LPDDR4X-4200), lo que proporciona un ancho de banda de memoria de 136 GB/s por SoC, según la propia documentación de la arquitectura Cloud AI de Qualcomm.
Originalmente, se diseñó teniendo en cuenta el formato PCIe. Integrar dos de estos chips en un módulo personalizado e incorporarlo a un portátil de 2025 no altera las ventajas y desventajas subyacentes. Se trata de silicio de 2019 con tecnología de memoria de 2019, actualizado y renombrado, pero arquitectónicamente perteneciente a la misma familia. Para cuando llegó al Dell Pro Max 16 Plus, el resto de la industria ya había pasado por HBM2e, HBM3, HBM3e y LPDDR5X, y ahora se dirige hacia GDDR7 y HBM4 en aceleradores de IA de alto rendimiento.
Pero el problema de fondo es más importante que el ancho de banda de la memoria. Existen muchos diseños de chips y equipos de ingeniería brillantes en la industria que comprenden el problema de la inferencia de IA a un nivel muy profundo, y la propia arquitectura Cloud AI 100 bien podría ser competente. El problema es que los ingenieros de software que realmente hacen que un producto tenga éxito o fracase ya han invertido mucho en otro ecosistema: CUDA. A menos que haya un fuerte incentivo para cambiar, los desarrolladores se quedan con la cadena de herramientas que ya cuenta con un excelente soporte, documentación y ayuda de la comunidad. NVIDIA captó la base de desarrolladores desde el principio y construyó una enorme comunidad a su alrededor. AMD pasó años rezagada en este aspecto, pero las recientes revisiones de ROCm son realmente excelentes y la brecha se está reduciendo. Soluciones como Mojo y MAX de Modular incluso permiten usar el mismo código para NVIDIA o AMD, y a veces superan a los entornos de ejecución nativos. Sin embargo, todos los demás aceleradores tienen dificultades para lograr la adopción pública debido a la falta de respaldo de software.
La clave está en la adopción pública. Grandes organizaciones como Google pueden invertir miles de millones en XLA y JAX para optimizar el rendimiento de las TPU . Las startups privadas y los laboratorios de IA con buena financiación pueden escribir kernels personalizados para sus propios modelos específicos sin preocuparse de que nadie más pueda replicar la pila que no están creando para un número infinito de casos de uso público; la están creando para los problemas que enfrentan. Para un consumidor público, o incluso para la mayoría de las empresas, un acelerador sin un ecosistema de desarrolladores público próspero es prácticamente inútil. Perderás semanas intentando implementar tu modelo, y en el momento en que Hugging Face lance una nueva arquitectura, te encontrarás con una tarea de recompilación (o un error de modelo no compatible) mientras que todos los que usan CUDA y ROCm tienen soporte desde el primer día.
Permítanme decirlo claramente: el AIC100 de esta computadora portátil está completamente obsoleto. Nadie debería comprarlo. Ninguna organización debería comprarlo a menos que cuente con los recursos de ingeniería y la intención explícita de desarrollar la inferencia desde cero para su carga de trabajo específica, y haya aceptado que se compromete a mantener esa infraestructura por sí misma.
La realidad del software y las herramientas
Para entender por qué esa recomendación es tan severa, hay que analizar qué implica realmente la inferencia de envío en esta tarjeta.
Las partes orientadas al usuario se dividen en dos SDK y una biblioteca de envoltura. El SDK de Qualcomm Cloud AI Platform incluye el controlador del kernel (el controlador accel/qaic upstream en la versión principal de Linux), el firmware del dispositivo, el entorno de ejecución en la tarjeta y las API de bajo nivel. El SDK de aplicaciones se sitúa encima y proporciona el compilador qaic-exec, la CLI de inferencia qaic-runner, la integración de ONNX Runtime a través de un proveedor de ejecución QAIC, enlaces de Python y una bifurcación de vLLM. La biblioteca Qualcomm efficient-transformers, también llamada QEfficient, es una envoltura de Hugging Face Transformers que reimplementa arquitecturas LLM populares con las formas estáticas, diseños de caché KV y transformaciones de grafos requeridas por el AIC100. Qualcomm AI Hub es un catálogo de modelos independiente y un producto de compilación como servicio dirigido más a dispositivos de la clase Snapdragon que al AIC100, aunque comparte la marca.
La ruta de compilación es rígida. Se toma un modelo PyTorch, se exporta usando torch.export o ONNX, y se pasa a qaic-exec con indicadores como -convert-to-fp16, -mxfp6-matmul, un tamaño de lote, una longitud de contexto y un número de SoC objetivo. El compilador realiza la planificación anticipada y la asignación de memoria, luego emite un QPC, un Qualcomm Program Container, un binario sellado que fija la distribución de memoria, la forma de la caché KV, el tamaño del lote, la longitud de la secuencia de prellenado y la longitud del contexto. No hay JIT. Según la propia documentación LLM de Qualcomm, el compilador AI 100 anticipado preasigna recursos del dispositivo en función de la longitud de la solicitud, la longitud de la generación, la caché KV y el tamaño del lote, y Cloud AI 100 solo admite formas de entrada estáticas. Cualquier cambio en esos parámetros de tiempo de compilación activa otra compilación completa, que puede tardar muchos minutos para modelos pequeños y horas para los grandes.
La lista de arquitecturas compatibles es muy corta. La biblioteca QEfficient y el catálogo QPC preconfigurado alojado en Zentree, al que Dell remite a sus clientes, cubren principalmente modelos antiguos, y solo unos pocos merecen la pena utilizarse en 2026.
Los puntos de control nativos de FP8 más recientes requieren una recuantización. Si un modelo se distribuye de forma nativa en MXFP4, como los populares modelos GPT-OSS, se requiere un proceso de conversión y recompilación en lugar de simplemente añadir los pesos. Si bien no es imposible encontrar soluciones alternativas si se está dispuesto a realizar el trabajo necesario, supone un coste constante.
Luego está el problema de la concurrencia, que es donde la laptop falla, incluso para desarrolladores enfocados en el rendimiento inmediato. Las imágenes de contenedor proporcionadas por Dell, que Dell indica a los usuarios que descarguen y ejecuten con vLLM, se basan en QPC que Zentree precompiló con formas específicas, y los contenedores enviados solo se ejecutan con una concurrencia de 1. Independientemente de la forma de la secuencia de entrada o salida, se obtiene un único rendimiento fijo para un modelo dado. Las múltiples solicitudes paralelas no se ejecutan concurrentemente; se ponen en cola y vLLM las procesa en secuencia. No se puede realizar el procesamiento por lotes de forma dinámica. No se puede usar el procesamiento por lotes continuo como lo hacen vLLM o SGLang de forma gratuita en las GPU Team Red o Green. Para obtener cualquier concurrencia superior a 1, hay que recompilar el QPC con un tamaño de lote mayor.
Los ejemplos de Dell presentan este portátil a los desarrolladores, y el caso de uso de IA más popular entre ellos hoy en día es la programación intuitiva con herramientas como Claude Code, OpenCode y similares. Una sola solicitud a estas herramientas puede generar múltiples llamadas LLM paralelas; de forma predeterminada, estas NPU pondrán en cola dichas solicitudes y las procesarán secuencialmente en lugar de en paralelo, por lo que algo que podría tardar segundos en un NVIDIA Spark tardará minutos en esta configuración.
Rendimiento
El sistema que Dell proporcionó para las pruebas tiene la siguiente configuración:
- Procesador Intel Core Ultra 9 285HX
- Tarjeta de inferencia Qualcomm AIC100 para PC
- 128 GB 6400 MTs CAMM2 DDR5
- 4TB SSD
Antes de hablar de cifras, una nota sobre la metodología. Como se describió anteriormente, el AIC100 ejecuta QPCs compilados con antelación, con un tamaño de lote, una longitud de secuencia y una configuración de caché KV fijos. Dell incluye en este portátil un conjunto seleccionado de QPCs precompilados alojados en Zentree y una imagen de contenedor vLLM que los descarga al iniciarlo por primera vez. Este conjunto de QPCs precompilados, que se sirven a través del contenedor de referencia de Dell con una concurrencia de 1, es lo que el usuario final recibe al desempaquetar el equipo y seguir la documentación de Dell, y esa es la configuración que utilizamos para las pruebas de rendimiento.
Tenemos las herramientas para hacerlo de otra manera. Podríamos extraer qaic-exec, crear un punto de control, procesarlo con torch.export, recuantificarlo, recompilar un QPC con un tamaño de lote mayor y volver a procesarlo con vLLM. Podríamos escribir kernels personalizados para el controlador acelerador QAIC si quisiéramos. Decidimos no hacerlo, ya que la gran mayoría de los compradores en el mercado objetivo de esta laptop (desarrolladores, ingenieros interesados en la IA y equipos piloto empresariales) no realizarán ese trabajo. Simplemente descargarán el contenedor, lo ejecutarán y evaluarán el producto según el resultado. Así que eso es lo que medimos.
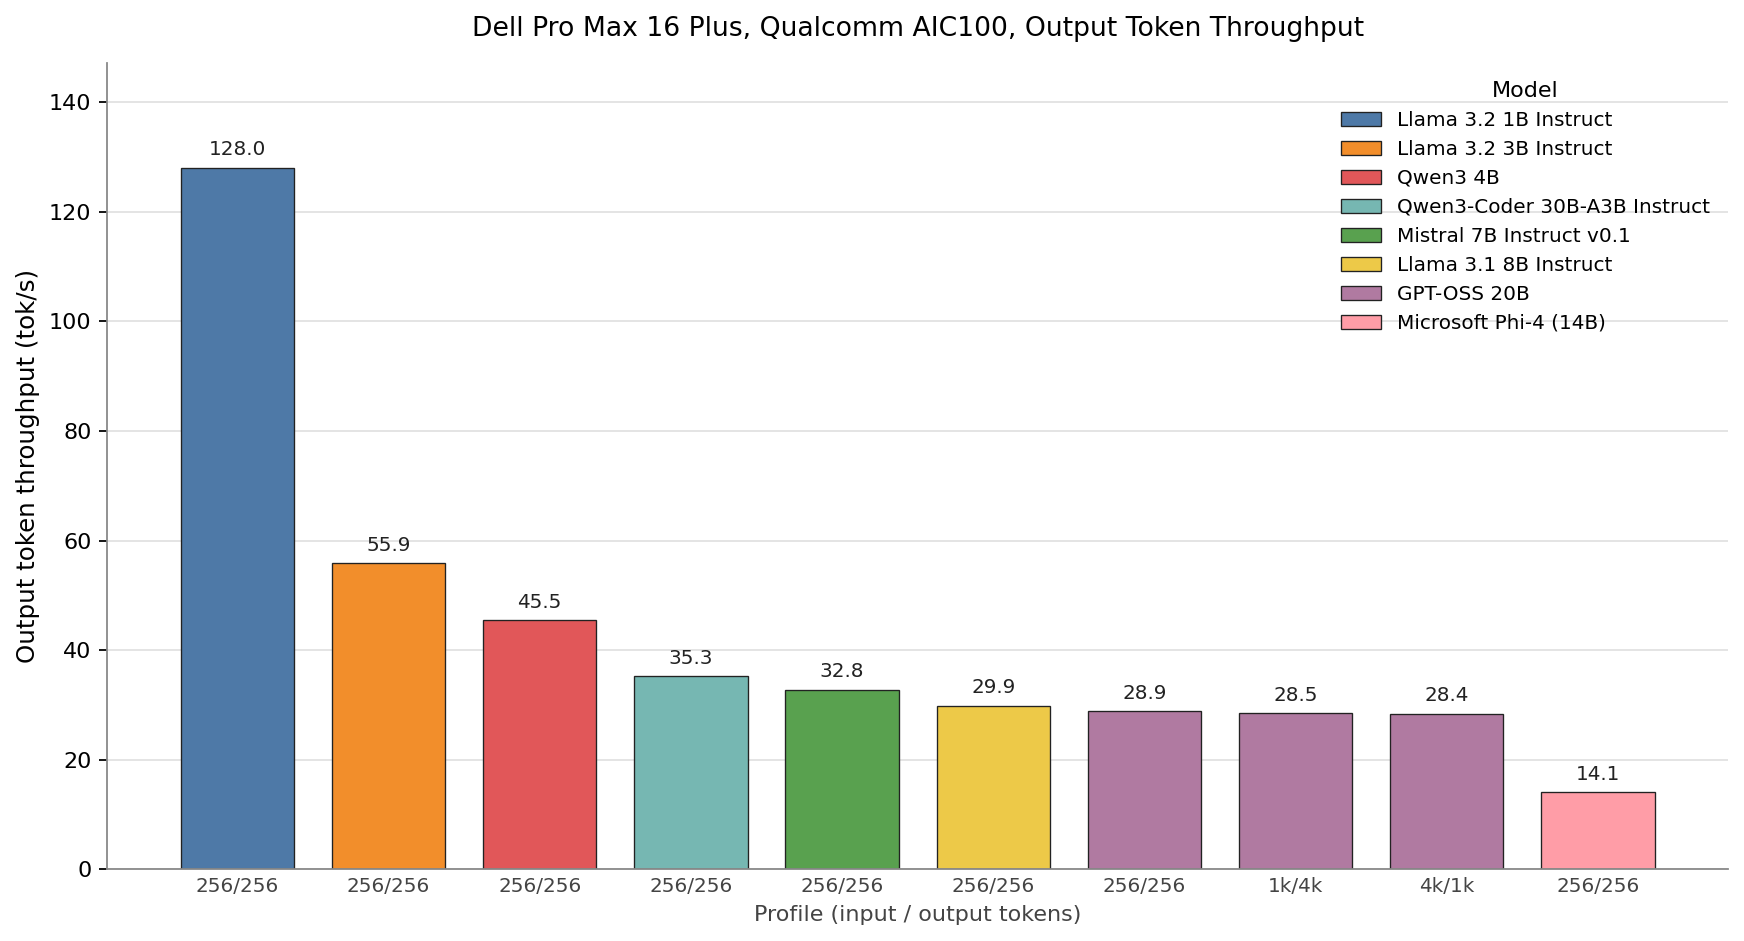
Cada barra representa un QPC compilado por Qualcomm que funciona con pesos MXFP6 y una caché KV MXINT8, la precisión que utilizan los productos de Dell en todos sus dispositivos. El Llama 3.2 1B es el único modelo en la gráfica que supera los 100 TPS, alcanzando los 128 TPS. Le siguen el Llama 3.2 3B con 56 TPS, el Qwen3 4B con 45 TPS, el Qwen3-Coder 30B-A3B con 35 TPS, el Mistral 7B con 33 TPS y el Llama 3.1 8B con 30 TPS. GPT-OSS 20B alcanza 28.9, 28.5 y 28.4 TPS en los perfiles 256/256, 1k/4k y 4k/1k, respectivamente, lo que confirma lo que promete la documentación de Qualcomm sobre el compilador AOT: una vez que se crea un QPC para una forma, la tasa de decodificación es fija y la longitud del mensaje no afecta el costo por token. Phi-4 cierra la tabla con 14 TPS.
Si bien esta tarjeta admite modelos de mayor tamaño que los mencionados anteriormente, no realizamos pruebas de rendimiento con ellos. Por ejemplo, con el modelo Llama 4 Scout, que Dell muestra públicamente, es necesario reducir aún más la precisión a INT4, y en la práctica, un modelo más pequeño y con menor cuantificación tendrá un mejor rendimiento que uno más grande y con mayor cuantificación en muchas cargas de trabajo.
El contenedor vLLM incluido también ejecuta cada QPC con batch_size=1, y hemos confirmado en la práctica que emitir dos solicitudes simultáneas no duplica el rendimiento. La segunda solicitud simplemente espera en la cola del software hasta que finaliza la primera. No hay procesamiento por lotes continuo, procesamiento por lotes en curso ni decodificación especulativa disponibles en la pila incluida. Para agentes de codificación como Claude Code u OpenCode que distribuyen múltiples llamadas LLM paralelas desde un solo turno de usuario, este límite de flujo único convierte lo que debería ser un tiempo de respuesta de unos pocos segundos en una espera de varios minutos. Aumentar la dimensión del lote requiere recompilar el QPC en el host, lo que nos lleva de nuevo a la puerta trasera que ya habíamos decidido cruzar.
Comparemos esto con el NVIDIA Spark. Con una longitud de secuencia de entrada y salida de 256/256, el Spark puede ejecutar el modelo de 120 bits más rápido que el Qualcomm AIC 100 de Dell con el modelo de 20 bits. Y estos ni siquiera son los mejores resultados que puede ofrecer el Spark, ya que se obtuvieron utilizando el kernel Marlin en las versiones de software de lanzamiento.
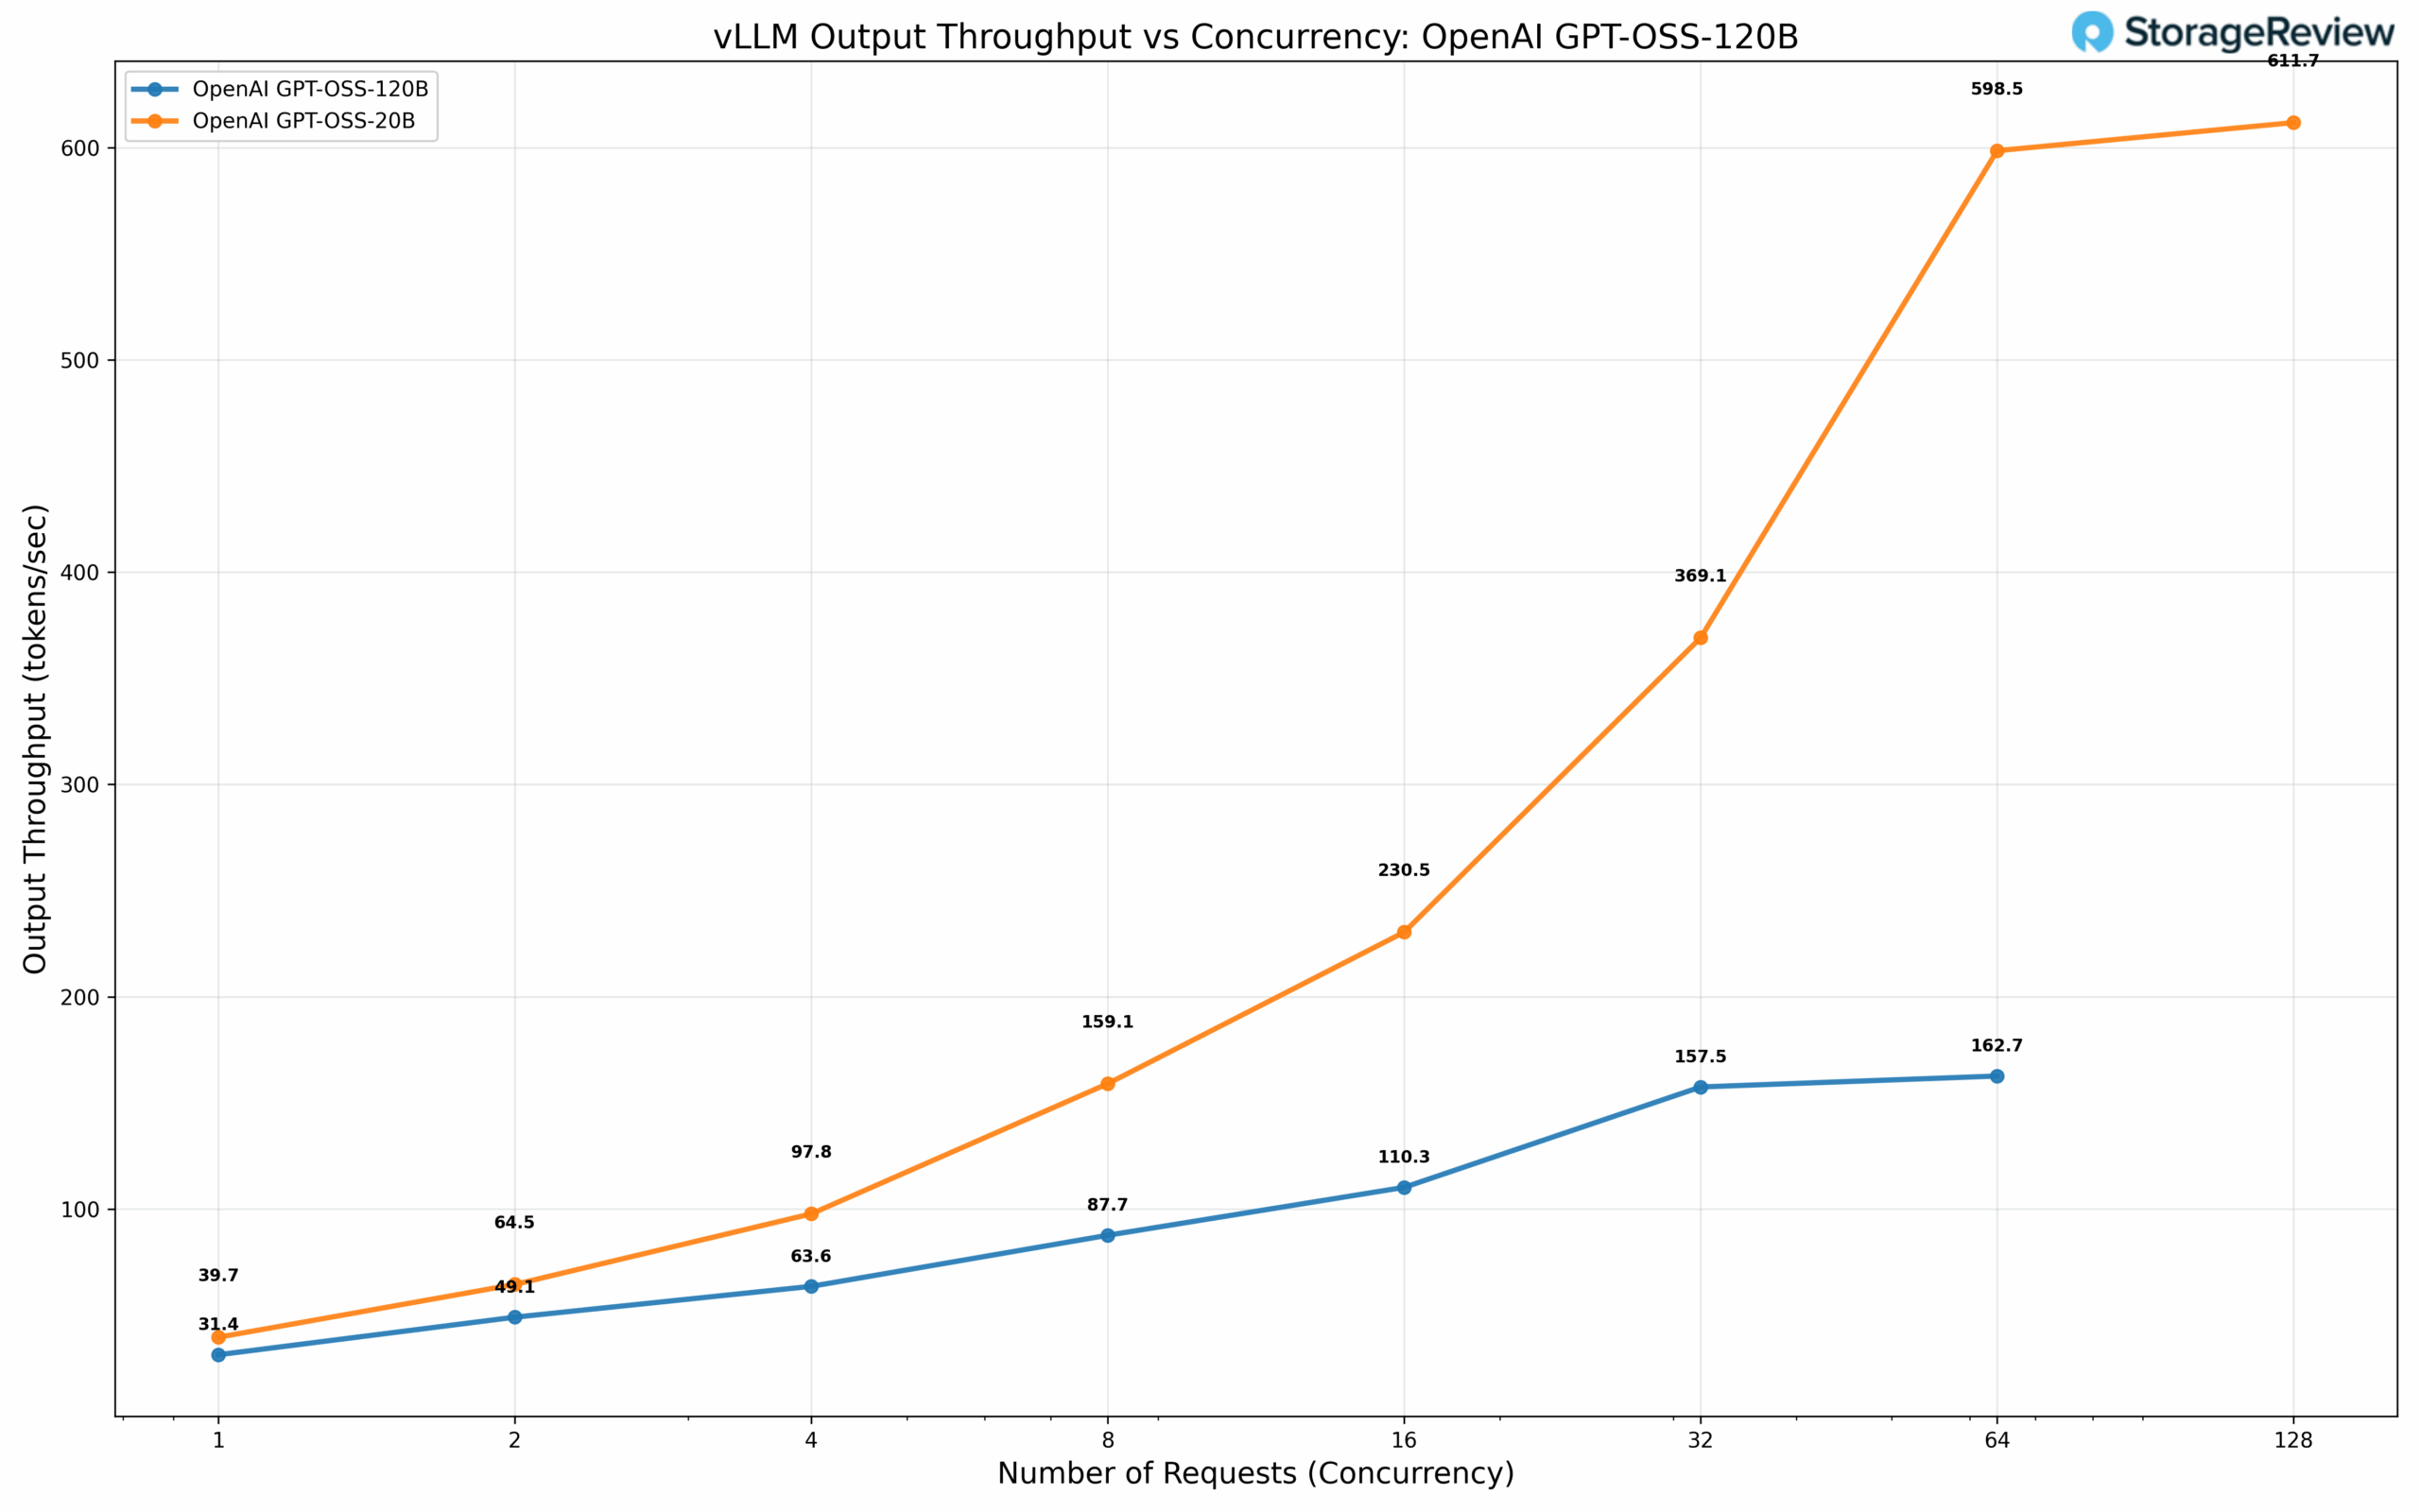
La conclusión es limitada. Para un solo usuario, una sola conversación y un modelo lo suficientemente pequeño como para que 136 GB/s de LPDDR4X por SoC no sean la limitación principal (Llama 3.2 1B y, posiblemente, Llama 3.2 3B), el AIC100 de este portátil es utilizable. Para cualquier configuración mayor, en la configuración que recibe el cliente, la combinación de decodificación de flujo único y una canalización de compilación de forma estática que penaliza cualquier forma que Qualcomm no haya precalculado deja a este acelerador por detrás de la NPU integrada y la GPU integrada del mismo Intel Core Ultra HX con el que se encuentra, por no hablar de las SKU discretas de NVIDIA con las que se puede pedir el mismo chasis.
Si comparamos brevemente las especificaciones técnicas, la NVIDIA Spark ofrece 273 GB/s , y probamos el máximo rendimiento de operaciones de punto flotante (MAMF) en FP8 (E4M3) a 200 TFLOPS en un solo chip. La QAIC, según las especificaciones, ofrece 272 GB/s en dos chips y 435 TFLOPS de INT8. Por lo tanto, en teoría, deberían tener un rendimiento similar, pero la de Qualcomm se queda atrás debido al software.
¿Para quién es esto y deberías comprarlo?
Para cualquiera que intente realizar un trabajo serio de IA hoy en día, la respuesta es no. No compre esta configuración.
La tienda de Dell en EE. UU. ofrece los modelos AIC100 de la Pro Max 16 Plus a $14,871.56 para la configuración superior (Core Ultra 9 285HX, 128 GB de RAM, SSD de 4 TB), $9,661.56 para la configuración intermedia (Core Ultra 7 265HX, 64 GB, 1 TB) y $8,831.56 para el modelo básico AIC100. Todos vienen con Ubuntu Linux preinstalado; próximamente se añadirá compatibilidad con Windows. Según las pruebas realizadas, el precio del equipo se sitúa entre los $14,000 y los $15,000.
Como referencia, el NVIDIA DGX Spark se vende actualmente por 4,699 dólares. Por ese precio, obtienes un GB10 Grace Blackwell Superchip , 128 GB de memoria LPDDR5X unificada, un NVMe de 4 TB, una GPU Blackwell y aproximadamente 1 petaflop de capacidad de cómputo de IA FP4, todo ello respaldado por el conjunto completo de software CUDA, TensorRT-LLM, NIM y todo el ecosistema NVIDIA. Un solo DGX Spark superará al AIC100 de este portátil en prácticamente cualquier carga de trabajo de IA realista, y lo hará con software que cualquier ingeniero de IA contratado este año ya sabe usar. Por el precio de nuestra unidad de prueba, podrías comprar tres DGX Spark, equipar cada uno con un monitor, periféricos y un escritorio, y aún te sobraría dinero. Si la IA a pequeña escala no es lo tuyo, una estación de trabajo Dell Pro Max Tower T2 con procesador Intel 285K, 128 GB de RAM DDR5 y una GPU NVIDIA RTX Pro 6000 también ronda los 15,000 dólares, dependiendo del tamaño de la unidad SSD con la que la combines.
Es difícil evitar la sensación de que Dell ha incorporado prácticamente basura electrónica a un chasis que, por lo demás, es excelente. La Pro Max 16 Plus con una RTX PRO 5000 es una fantástica estación de trabajo móvil. Sin embargo, la misma máquina, con una AIC100, se ha convertido en un experimento fallido bajo la garantía de Dell.
Conclusión
Si dentro de unos años eres un aficionado a la electrónica y te encuentras con uno de estos portátiles en liquidación por doscientos o trescientos dólares, no lo dudes y cómpralo. El sistema es reparable y actualizable, el teclado es bueno, y hacer que los módulos AIC100 realicen alguna función interesante como proyecto de fin de semana es justo el tipo de diversión sin complicaciones que este hardware merece.
Si hoy en día te dedicas a realizar trabajos serios de IA, configura tu Pro Max 16 Plus con prácticamente cualquier otro acelerador. Una GPU móvil NVIDIA RTX PRO, incluso la RTX PRO 1000 de gama básica, te resultará más útil que los módulos AIC100. La NPU integrada del Intel Core Ultra HX te servirá mejor en muchos escenarios prácticos, ya que se integra con Windows ML, OpenVINO y el conjunto de herramientas de IA para PC ya existente.
Una sugerencia que vale la pena ofrecer a Dell: el chasis Pro Max 16 Plus es excelente, y la línea Pro Max es una de las plataformas de estaciones de trabajo móviles más potentes del mercado. El modelo AIC100, tal como se distribuye, no cumple con ese estándar en absoluto. Una línea de productos experimentales o de vista previa para desarrolladores, claramente identificada como tal, le permitiría a Dell ofrecer aceleradores innovadores a los clientes que deseen probarlos, sin asociar la marca Pro Max a una plataforma que aún no está lista. La marca Pro Max merece ser protegida, y existe una manera eficaz de hacerlo, a la vez que se encuentra un espacio para el hardware experimental.


 Amazon