

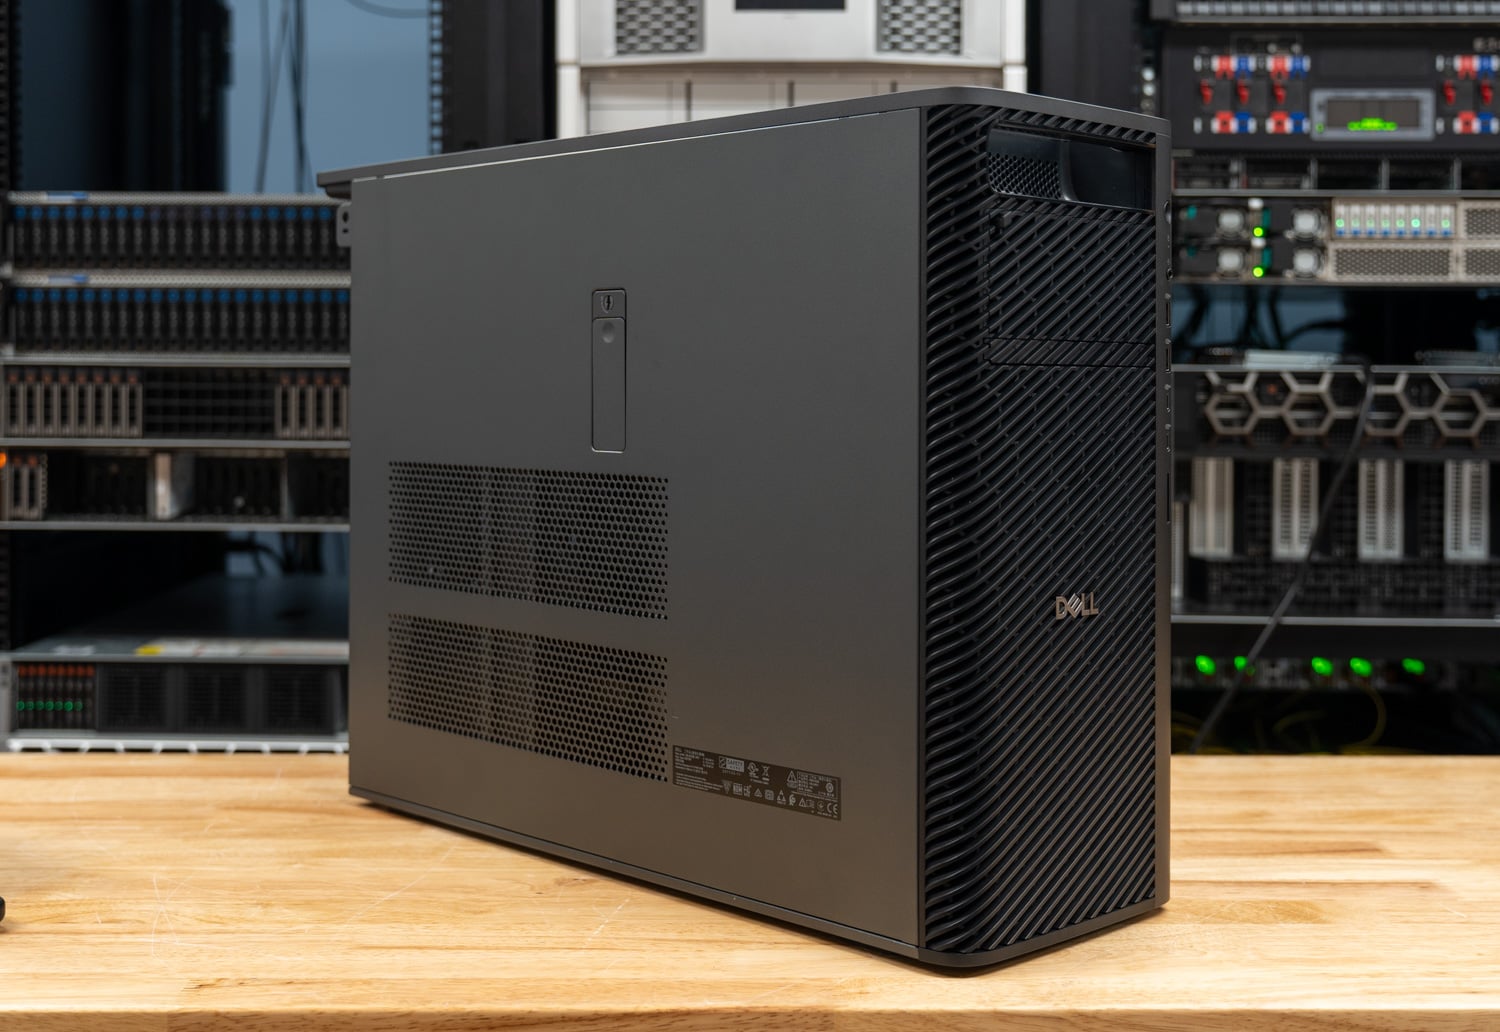
La Dell Pro Precision 9 T4 es la torre de un solo socket que encabeza la gama Pro Precision de Dell, y nuestra unidad de prueba está configurada para IA local a una escala que la mayoría de las estaciones de trabajo no pueden alcanzar. Combina un procesador Intel Xeon 698X de 86 núcleos con 256 GB de memoria DDR5-6400 ECC, dos tarjetas NVIDIA RTX PRO 6000 Blackwell Max-Q de 300 W con 96 GB de GDDR7 cada una, dos SSD Gen5 de 2 TB y un adaptador de 25 GbE de doble puerto, alimentado por una fuente de alimentación de 2400 W. Con la misma configuración en Dell.com, su precio ronda los 66 600 dólares.
Puntos Clave
- Dos GPU convierten un modelo que no cabe en una sola tarjeta en uno utilizable. MiniMax M2.7 de 129.3 GB generó 83.7 tokens por segundo para un usuario cuando se distribuyó entre ambas tarjetas RTX PRO 6000, 2.8 veces los 30.3 tokens por segundo obtenidos con una sola tarjeta y el resto del modelo en la memoria del sistema.
- La segunda GPU aumentó la capacidad de servicio entre 1.85 y 2.02 veces, y la de incrustación en 1.92 veces. La producción máxima de llama.cpp aumentó de 582.5 a 1,176.1 tokens por segundo en Ministral 3 3B y de 424.8 a 787.9 en gpt-oss 120B con un servidor por GPU, y la incrustación de un millón de pasajes de Wikipedia se redujo de 890 a 464 segundos.
- Una segunda GPU redujo el tiempo de una época de LoRA en un 37 por ciento. Una época de LoRA en Ministral 3 8B tardó 31.5 minutos en una GPU y 19.7 minutos en dos, terminando con pérdidas de 1.169 y 1.167.
- El ancho de banda de la memoria es donde el procesador Xeon del T4 toma la delantera. STREAM Triad alcanzó los 328 GB/s, un 53 por ciento por encima del Threadripper PRO 9995WX en el Precision 7875, y el T4 completó la resolución de OpenFOAM drivAer en 293 segundos frente a 556 y una ejecución de y-cruncher de 10 mil millones de dígitos en 53.9 segundos frente a 83.7.
- La Precision 7875 lidera en tareas de CPU que requieren un alto rendimiento del núcleo. El procesador Threadripper de 96 núcleos obtuvo una ventaja del 37 por ciento en 7-Zip y del 30 por ciento en Blender Monster, y finalizó la compilación de LLVM en 43.7 segundos frente a los 58.4 segundos del otro procesador.
¿Dónde se ubica la Pro Precision 9 T4?
Dell posiciona la T4 como su estación de trabajo de torre de un solo socket insignia para organizaciones que requieren máxima densidad de procesamiento y capacidad de expansión, con el desarrollo de IA, la simulación de ingeniería y la computación científica como principales aplicaciones. Se sitúa por encima de la Dell Pro Precision 9 T2 , que utiliza la misma plataforma de estación de trabajo Granite Rapids-WS Xeon 6 en un chasis más pequeño con una GPU. La T4 incorpora procesadores de ocho canales de gama alta, hasta 86 núcleos y espacio para hasta cuatro tarjetas gráficas, según el modelo.
Las opciones de procesador en Dell.com comienzan con el Xeon 634 de 12 núcleos y llegan hasta el Xeon 696X de 64 núcleos y el Xeon 698X de 86 núcleos de nuestra unidad, que cuenta con 336 MB de caché, una frecuencia base de 2.0 GHz, una frecuencia máxima de 4.8 GHz y una potencia nominal de 350 W. La memoria llega hasta 4 TB de DDR5 RDIMM en 16 ranuras, y nuestra unidad ocupa ocho de ellas con módulos de 32 GB a 6400 MT/s. Los gráficos comienzan con una sola RTX A400, y la cantidad de tarjetas depende del modelo: el configurador de Dell muestra cuatro tarjetas RTX A1000, tres tarjetas RTX PRO 4000 Blackwell, dos tarjetas RTX PRO 6000 Max-Q de 300 W o una RTX PRO 6000 de 600 W.
La configuración básica tiene un precio de 5,925 dólares en Dell.com. Nuestra configuración añade 8,300 dólares por el procesador Xeon 698X, 15 000 dólares por los 256 GB de memoria y 30 820 dólares por las dos tarjetas RTX PRO 6000 Max-Q, sin incluir el almacenamiento, la red ni la actualización a ProSupport de 36 meses que Dell añade automáticamente a una configuración de este nivel.
Construcción y Diseño
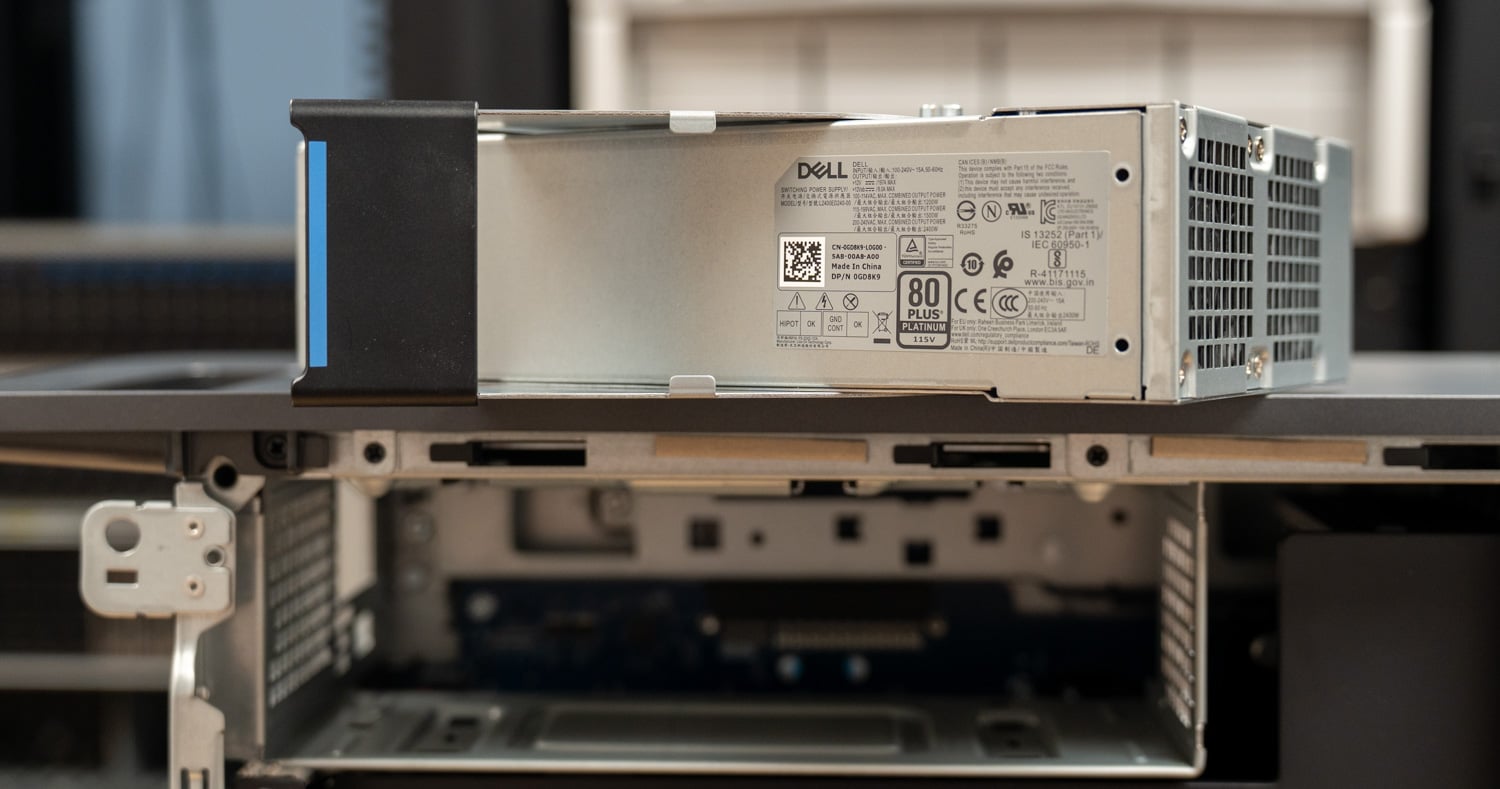
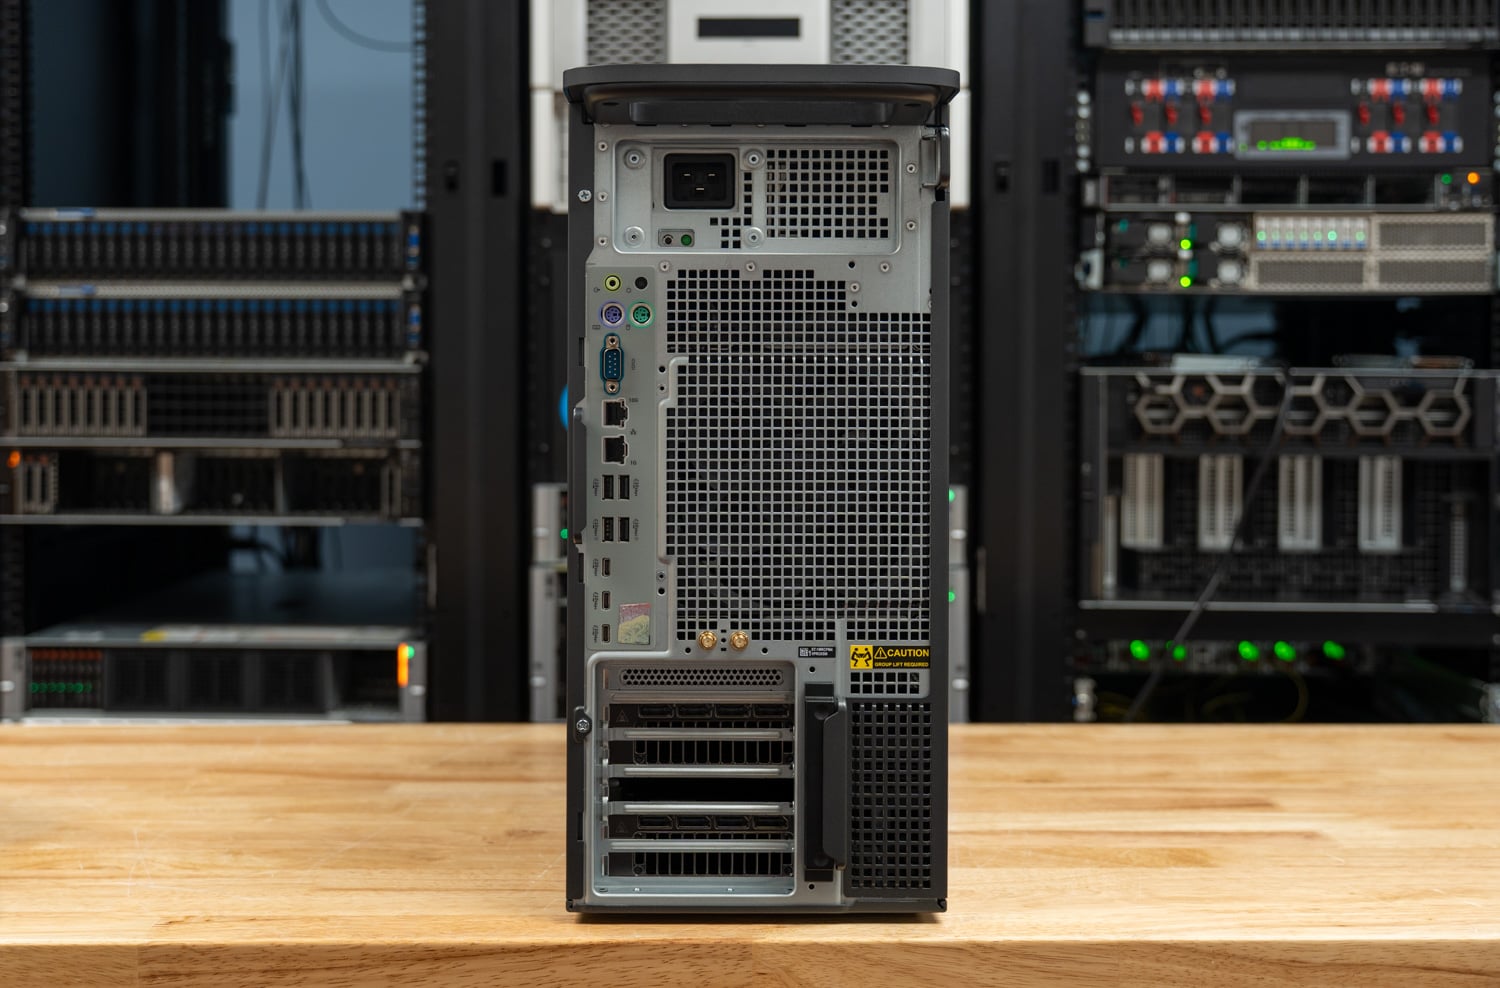
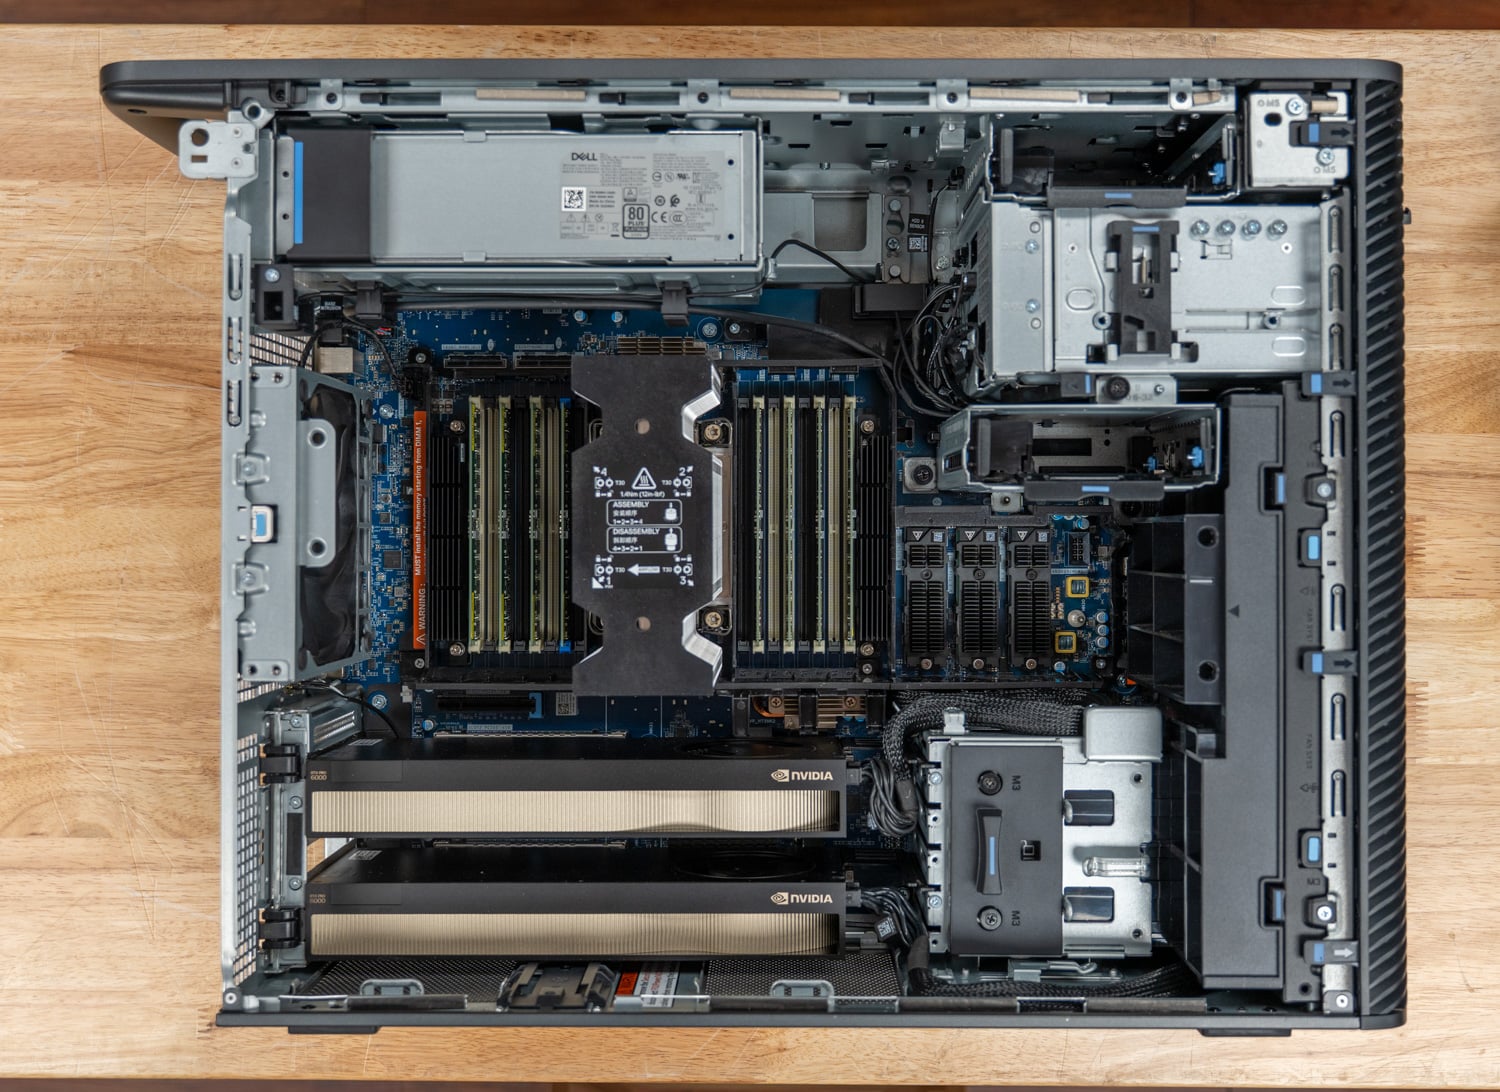
La T4 es una torre completa con unas dimensiones de 449.8 mm de alto, 203.7 mm de ancho y 617.5 mm de profundidad. Dell indica un peso mínimo de 24.1 kg y un máximo de 33.6 kg, según la configuración. Nuestra unidad utiliza la fuente de alimentación Platinum de 2400 W, que el configurador de Dell selecciona para la configuración con dos tarjetas gráficas RTX PRO 6000, mientras que en configuraciones más ligeras se utiliza por defecto una fuente de 1500 W.
La facilidad de mantenimiento es uno de los puntos fuertes del T4, empezando por el acceso sin herramientas mediante un pestillo en el panel lateral y una fuente de alimentación de 2400 W que se extrae manualmente de la parte superior trasera del chasis. El resto de los componentes, incluidas las tarjetas gráficas y las unidades SSD, se extraen con un destornillador Phillips, y los puntos azules de Dell marcan las piezas que se pueden extraer manualmente. En el laboratorio, la plataforma resultó fácil de reparar para el usuario, algo importante para una estación de trabajo de este precio.
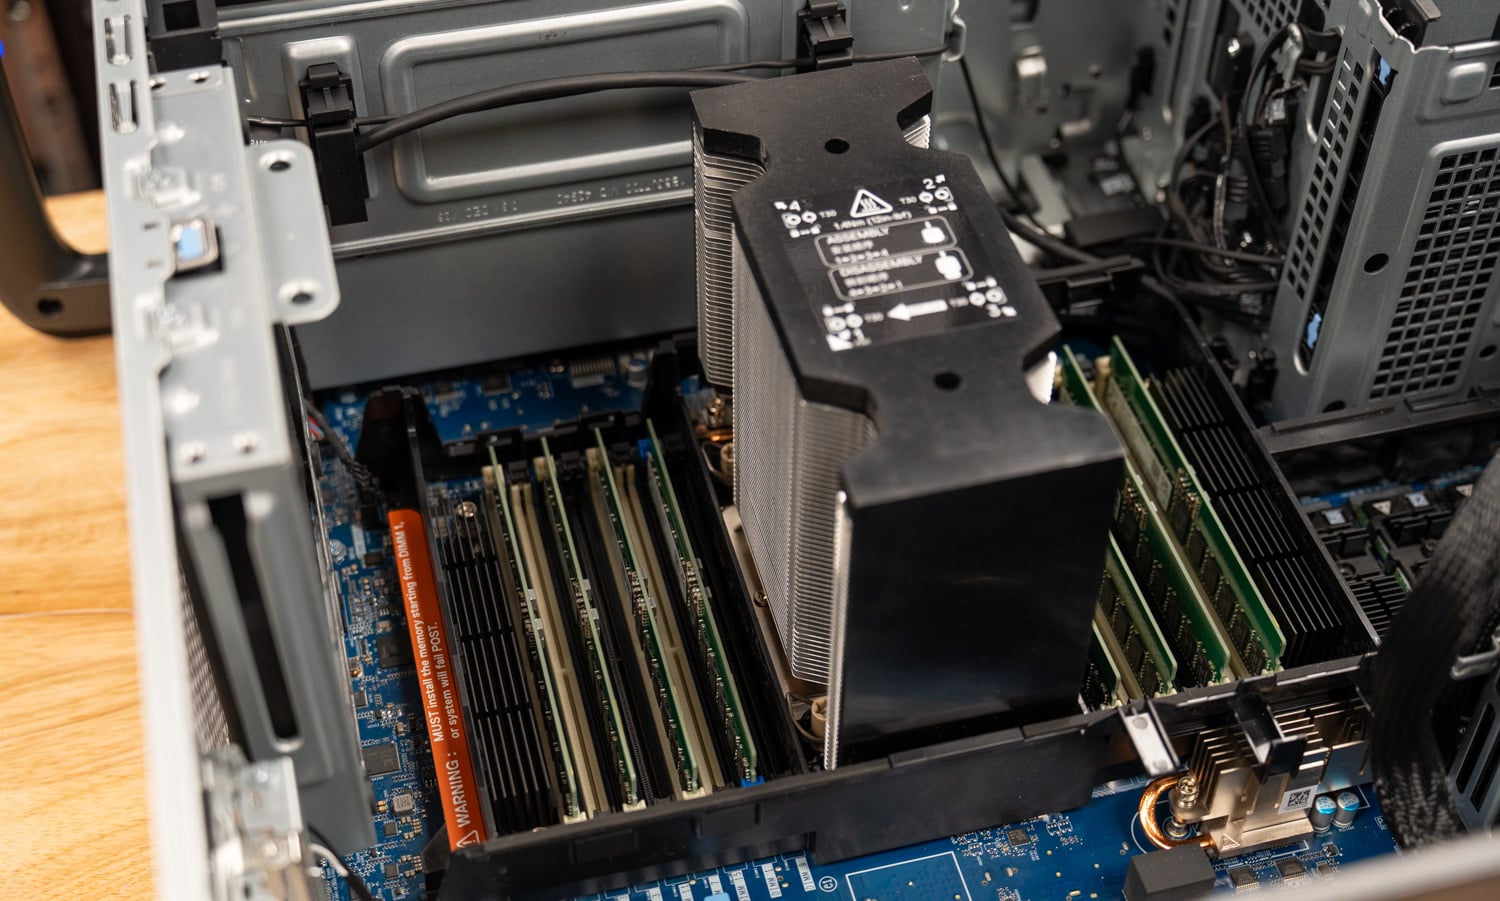
La refrigeración es la mejor que hemos visto en una torre Dell de esta categoría. El aire circula de adelante hacia atrás, y unas grandes cubiertas ajustadas lo dirigen hacia abajo y a través del procesador y la memoria, manteniendo ese canal separado del área PCIe. Por lo tanto, las dos tarjetas gráficas de 300 W extraen aire de un flujo independiente y no heredan el calor del procesador Xeon de 350 W. Con las cubiertas colocadas, dos ventiladores se ubican entre la zona del procesador y la bahía de la tarjeta, y el conjunto presenta los mismos puntos de contacto azules y se puede extraer para acceder a la memoria.
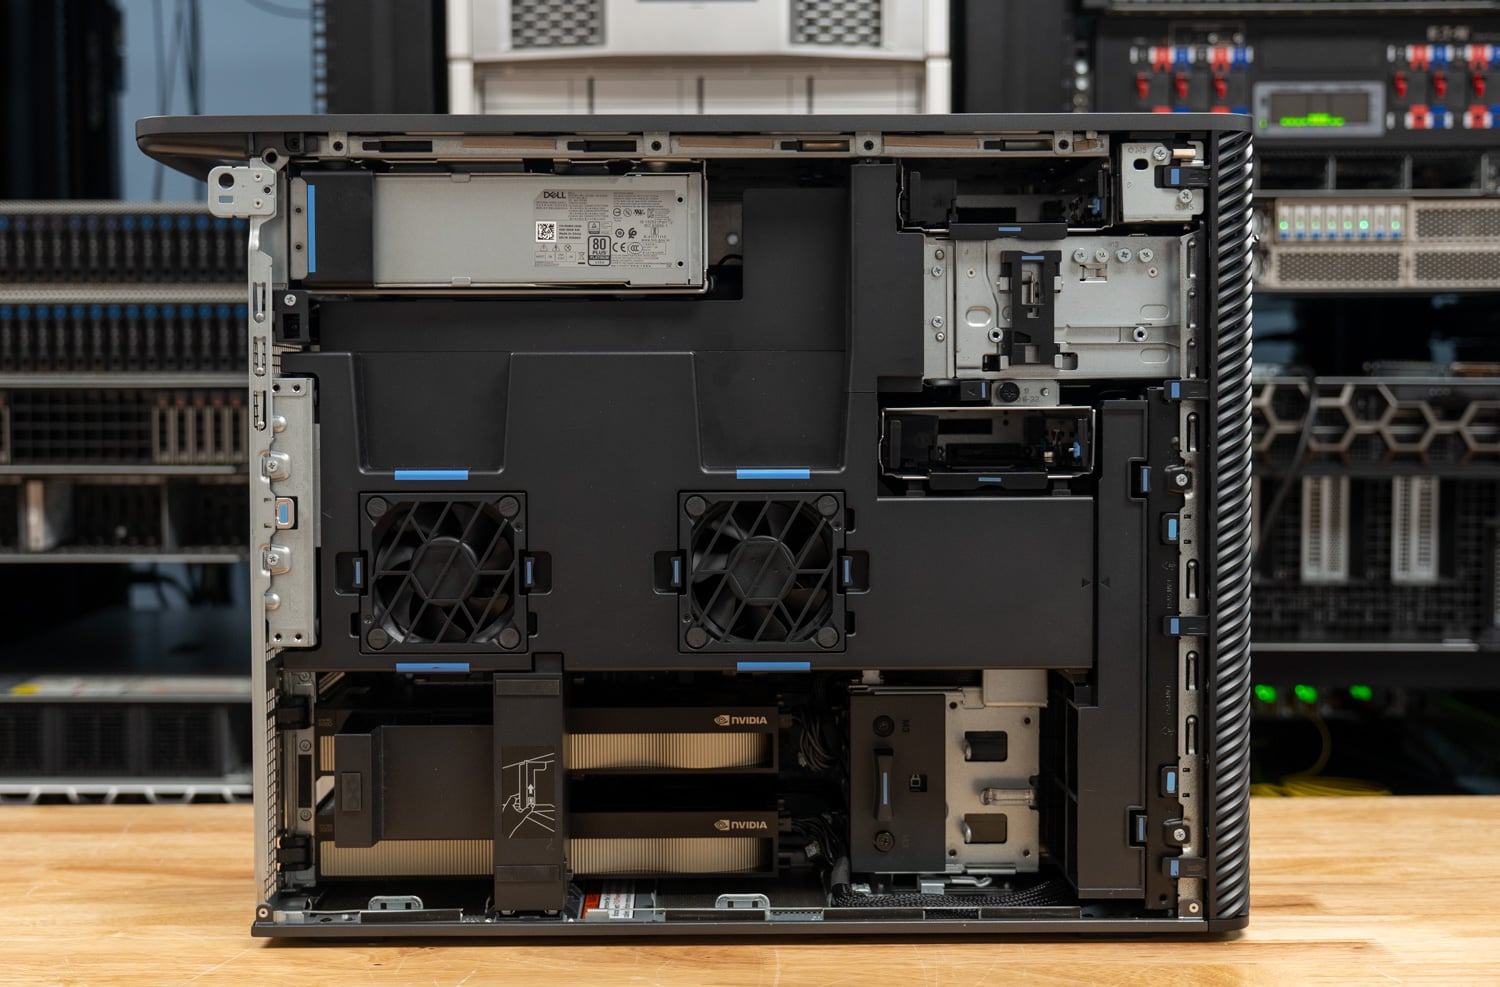
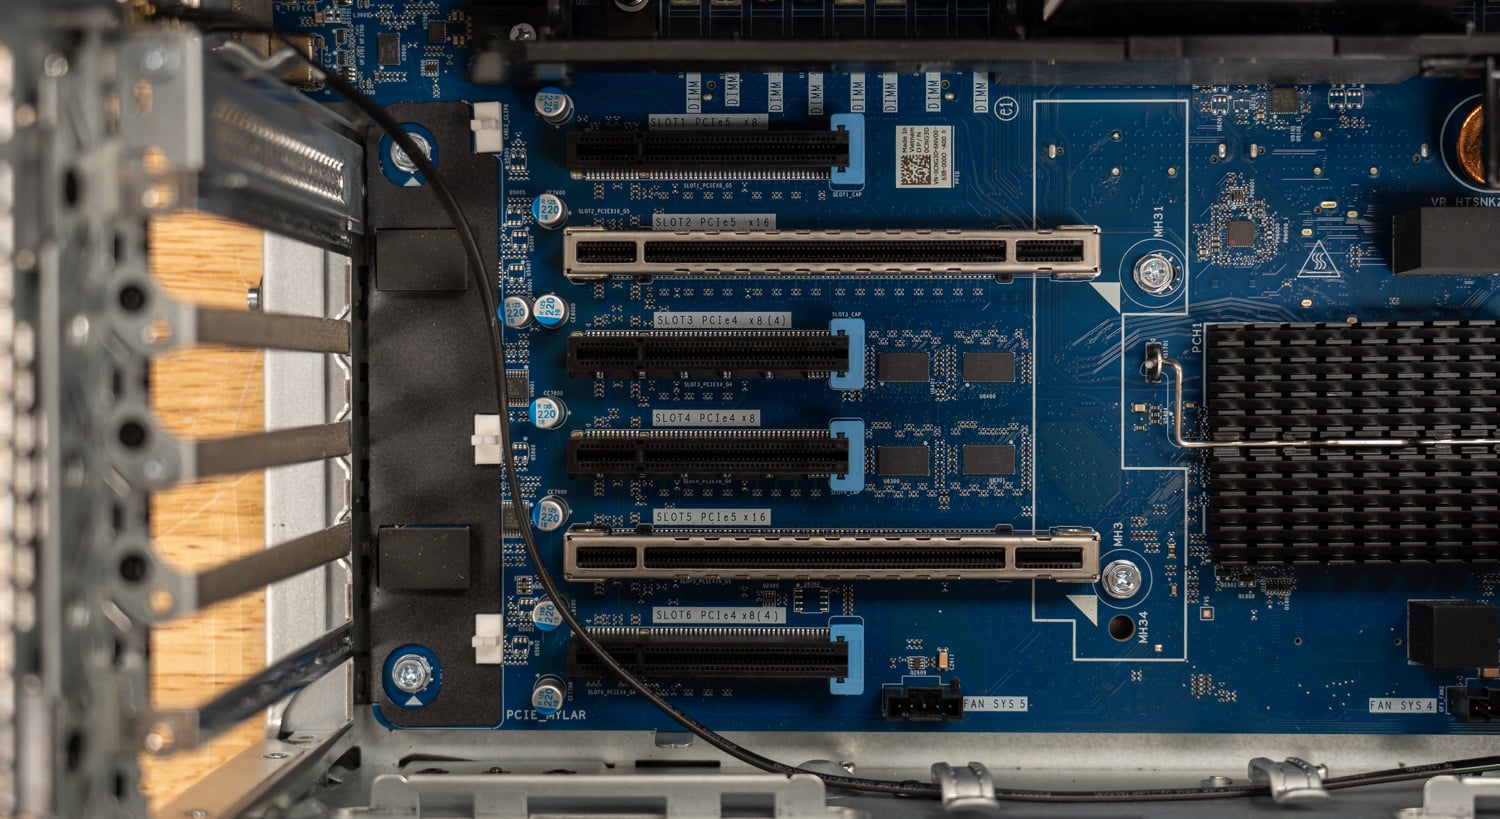
La expansión se realiza mediante seis ranuras PCIe de altura completa: dos ranuras Gen5 x16 que alojan las GPU, una Gen5 x8, una Gen4 x8 y dos ranuras Gen4 con conectores x8 y cableado x4. El almacenamiento incluye tres ranuras M.2 Gen5 internas y una ranura Gen4, dos bahías SATA internas de 3.5 pulgadas y una bahía FlexBay frontal que admite hasta cuatro unidades NVMe o dos unidades de 3.5 pulgadas, con una unidad óptica delgada opcional. Nuestra unidad arranca desde una unidad Gen5 interna de 2 TB y lleva otra unidad Gen5 de 2 TB en una ranura M.2 interna.
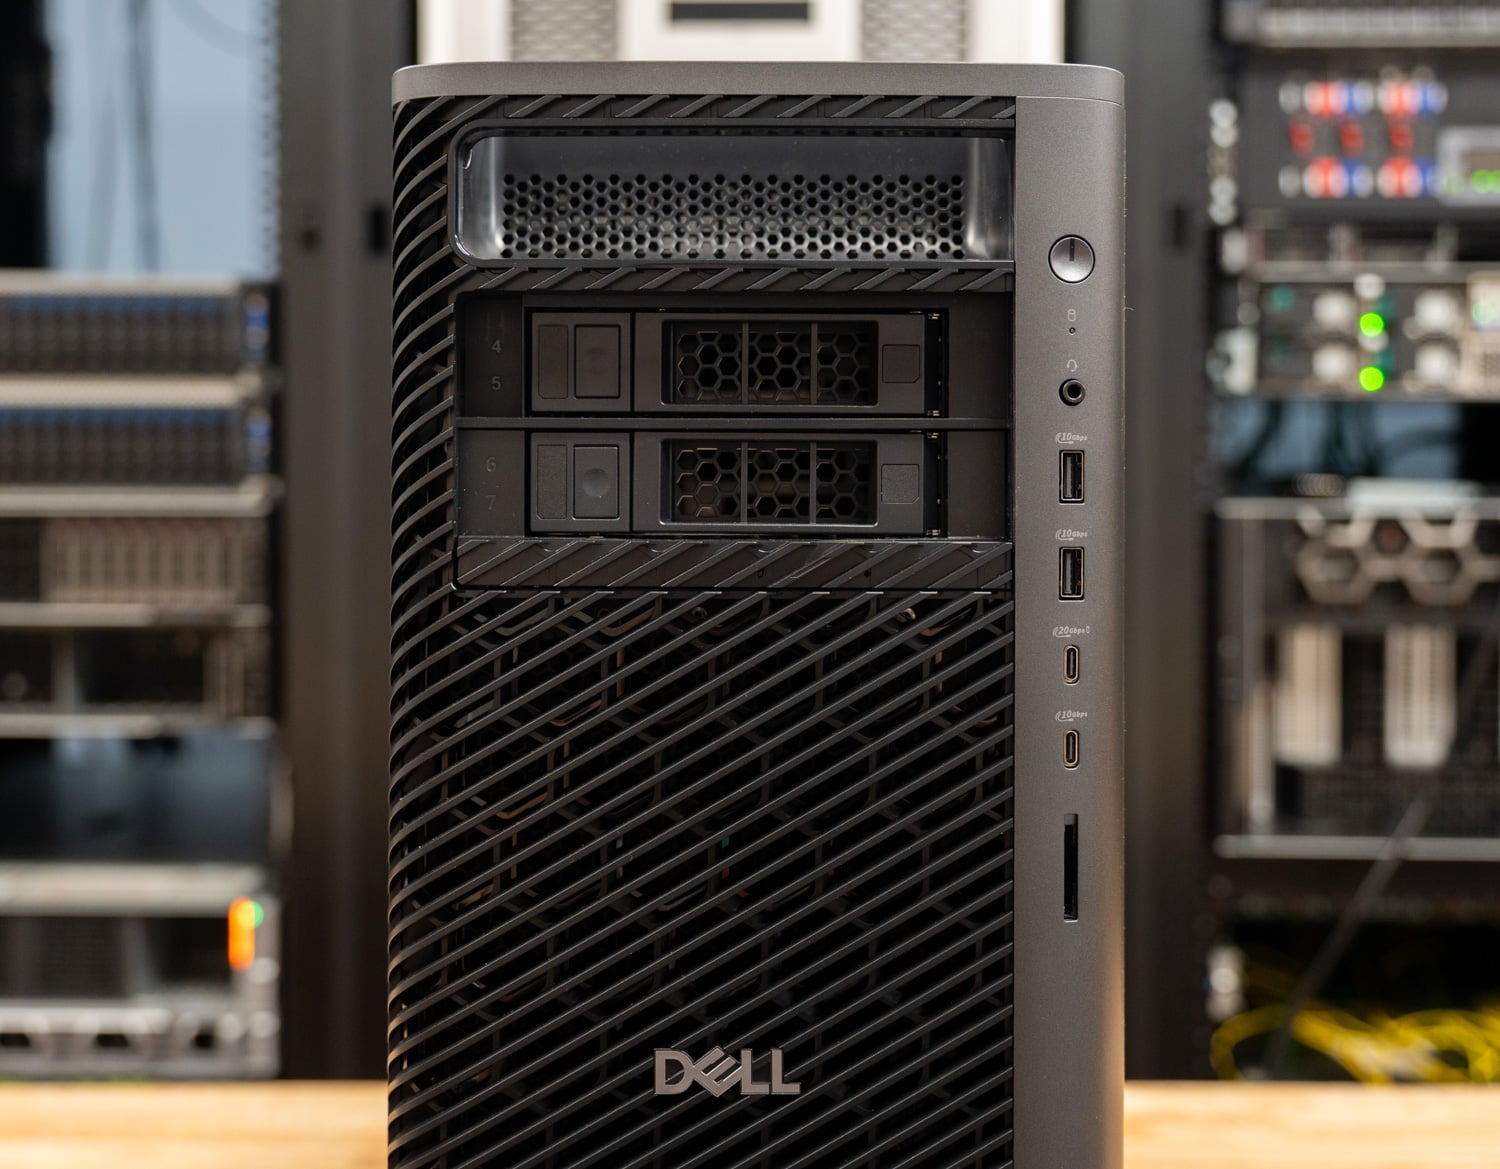
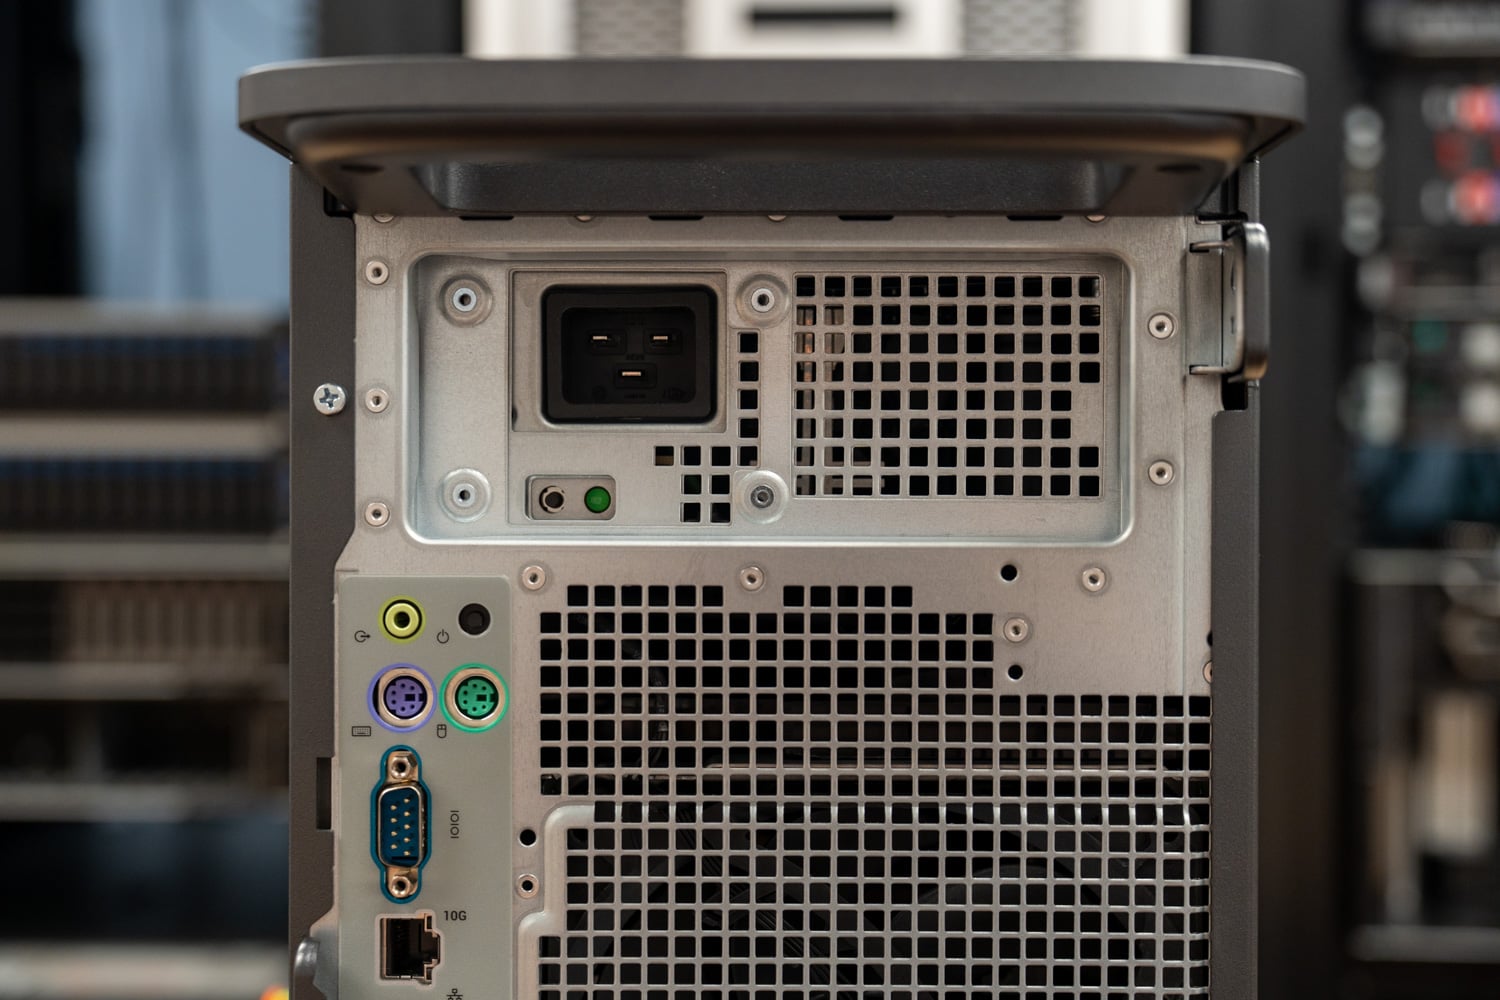
El panel frontal incluye un conector para auriculares, dos puertos USB-A de 10 Gbps, un puerto USB-C de 20 Gbps con PowerShare, un puerto USB-C de 10 Gbps y una ranura para tarjeta SD opcional. La parte posterior añade puertos RJ-45 de 10 GbE y 1 GbE, cuatro puertos USB-A de 10 Gbps, dos puertos USB-C de 10 Gbps, un puerto USB-C de 20 Gbps, puerto serie, dos puertos PS/2 y salida de línea. Nuestra unidad incluye el adaptador Intel E810-XXV de doble puerto 25 GbE SFP28, la tarjeta Wi-Fi 7 MT7925 de MediaTek con Bluetooth 5.4, un lector de tarjetas de memoria y la tarjeta de expansión USB-C doble de Dell.
La seguridad y la gestión incluyen TPM 2.0, Dell SafeBIOS, detección de intrusiones en el chasis, compatibilidad con unidades de autocifrado, borrado seguro de BIOS e Intel vPro Enterprise. Dell indica que el T4 utiliza hasta un 85 % de plástico reciclado en componentes clave, un 90 % de aluminio reciclado en las asas y un 11 % de acero reciclado en el chasis, y cuenta con la certificación ENERGY STAR.
Especificaciones de la Dell Pro Precision 9 T4
| Especificación | Dell Pro Precision 9 T4 (según las pruebas realizadas) |
|---|---|
| Plataforma | |
| Modelo | Dell Pro Precision 9 T4 (PW9T4260) |
| Procesador | Procesador Intel Xeon 698X, 86 núcleos, 172 subprocesos, caché de 336 MB, frecuencia base de 2.0 GHz, hasta 4.8 GHz, 350 W. |
| Opciones de procesador | Procesadores Xeon 634 (12 núcleos) hasta Xeon 698X (86 núcleos) |
| Salud Cerebral | 256 GB (8 x 32 GB) DDR5-6400 RDIMM ECC 16 ranuras, hasta 4 TB |
| DISEÑO | 2x NVIDIA RTX PRO 6000 Blackwell Max-Q Workstation Edition, 96 GB GDDR7 cada una, 300 W cada una |
| Sistema operativo | Windows 11 Pro para estaciones de trabajo (probado en Ubuntu 26.04.1 LTS) |
| Almacenaje | |
| Según la configuración | 2x M.2 2280 Gen5 x4 TLC SED de 2 TB (ambos en ranuras M.2 internas) |
| Ranuras internas | 3x M.2 2230/2280 Gen5 NVMe 1x M.2 2230/2280 Gen4 NVMe 2 SATA de 3.5 pulgadas |
| FlexBay | Hasta 4 unidades NVMe más una unidad óptica delgada opcional, o 2 unidades SATA de 3.5 pulgadas. |
| Expansión y Conectividad | |
| Ranuras PCIe | 2x Gen5 x16 1x Gen5 x8 1x Gen4 x8 2x Gen4 x8 (x4 eléctricos) |
| Networking | Módulo Intel E810-XXV de doble puerto 25GbE SFP28 (complemento) RJ-45 de 10 GbE y 1 GbE integrados MediaTek Wi-Fi 7 MT7925, Bluetooth 5.4 |
| Puertos frontales | 1 puerto USB-C de 20 Gbps con PowerShare 1 puertos USB-C de 10 Gbps 2x USB-A de 10 Gbps conector para auriculares Ranura para tarjeta SD opcional |
| Puertos traseros | 1 puertos USB-C de 20 Gbps 2 puertos USB-C de 10 Gbps 4x USB-A de 10 Gbps Serie, 2x PS/2, salida de línea |
| Poder y físico | |
| Alimentación eléctrica | 2400W Platinum (opción de 1500W) |
| Dimensiones | 449.8 x 203.7 x 617.5mm (17.70 x 8.01 x 24.31in) |
| Peso | De 24.1 kg a 33.6 kg (53.1 a 74.1 lb) según la configuración. |
| Garantía | ProSupport con servicio in situ tras diagnóstico remoto, 36 meses |
| Precio | $ 5,925 base Aproximadamente 66,600 dólares con esta configuración (Dell.com) |
Configuración de prueba y metodología
Probamos estaciones de trabajo de gama alta en Linux, y los cuatro sistemas de esta revisión ejecutaron Ubuntu 26.04.1 LTS en el kernel 7.0.0-43 con el controlador NVIDIA 595.99.02, CUDA 13, llama.cpp build b11716 y Ollama 0.40.3, en el perfil de rendimiento de Linux. Los resultados provienen de tres herramientas: sr-client para cargas de trabajo locales de IA y cliente, sr-harness para compilación, compresión, criptografía, servidor web y y-cruncher, y sr-suite r5.28 para GROMACS, OpenFOAM, ClickHouse, Valkey y ancho de banda de memoria. Cada resultado es la mediana de pasadas repetidas.
Los cuatro sistemas funcionaron con el modo térmico de la BIOS configurado en Ultra Rendimiento, y el T4 usó la BIOS 1.2.0. La prueba con el arnés del T4 usó sr-harness 3.3, la Precision 7875 usó 3.5 y ambos T2 usaron 3.6, con la misma configuración de pruebas en todas esas versiones.
Todos los sistemas de comparación son torres Dell con gráficos RTX PRO 6000 Blackwell. La Dell Precision 7875 combina el Threadripper PRO 9995WX de 96 núcleos con las mismas dos tarjetas RTX PRO 6000 Max-Q y 512 GB de DDR5-5600, lo que la convierte en la más similar. La Dell Pro Precision 9 T2 utiliza el Xeon 658X de 24 núcleos con una tarjeta Max-Q, y la Dell Pro Max Tower T2 utiliza el Core Ultra 9 285K de 24 núcleos con la RTX PRO 6000 de 600 W, lo que demuestra el aumento de potencia por GPU.
| Configuration | CPU | Salud Cerebral | GPU | Test Drive | Modo térmico de la BIOS |
|---|---|---|---|---|---|
| Dell Pro Precision 9 T4 | Xeon 698X, 86 núcleos | 256 GB DDR5-6400 (8 canales) | 2x RTX PRO 6000 Max-Q (300W) | Disco duro SK hynix PCB01 Gen5 de 2 TB | Ultra Performance |
| Dell Precision 7875 | Threadripper PRO 9995WX, 96 núcleos | 512 GB DDR5-5600 (8 canales) | 2x RTX PRO 6000 Max-Q (300W) | Samsung Gen4 de 2 TB | Ultra Performance |
| Dell Pro Precision 9 T2 | Xeon 658X, 24 núcleos | 128 GB DDR5-6400 (4 canales) | 1x RTX PRO 6000 Max-Q (300W) | Unidades Samsung PM9E1 Gen5 de 2 TB en una configuración en franjas. | Ultra Performance |
| Torre Dell Pro Max T2 | Core Ultra 9 285K, 24 núcleos | 128 GB DDR5-4400 (2 canales) | 1x RTX PRO 6000 (600W) | Samsung PM9F1 Gen4 de 2 TB | Ultra Performance |
Rendimiento de la IA local
Cada sistema aquí incluye al menos una RTX PRO 6000 Blackwell con 96 GB de GDDR7, por lo que los resultados de una sola GPU miden la tarjeta, su límite de potencia y la rapidez con la que la plataforma la alimenta. Las dos tarjetas del T4 son lo que lo distingue, y nuestras pruebas de dos GPU ejecutan cada modelo de tres maneras cuando corresponde: dos servidores independientes, uno por GPU, para medir el rendimiento; un modelo dividido por capas en ambas tarjetas; y, para MiniMax M2.7, una tarjeta con el resto del modelo en la memoria del sistema.
LLM funcionando en una GPU
| Servidor llama.cpp, una GPU (salida de tokens/s, cuanto mayor sea la cantidad, mejor). | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Ministral 3 3B, una solicitud | 240.5 | 252.6 | 243.8 | 261.6 |
| Ministral 3 3B, pico | 582.5 | 637.6 | 602.6 | 658.8 |
| Ministral 3 8B, una solicitud | 166.8 | 171.1 | 167.3 | 194.5 |
| Ministral 3 8B, pico | 383.6 | 398.9 | 384.9 | 477.5 |
| Qwen3.8 27B, una solicitud | 54.9 | 55.4 | 53.8 | 64.5 |
| Qwen3.8 27B, pico | 158.1 | 162.8 | 155.8 | 194.7 |
| gpt-oss 120B, una solicitud | 166.9 | 171.2 | 164.5 | 193.0 |
| gpt-oss 120B, pico | 424.8 | 458.4 | 413.1 | 520.7 |
| gpt-oss 120B, una solicitud, tiempo hasta el primer token (ms, cuanto menor sea el valor, mejor) | 1,189 | 1,181 | 1,213 | 844 |
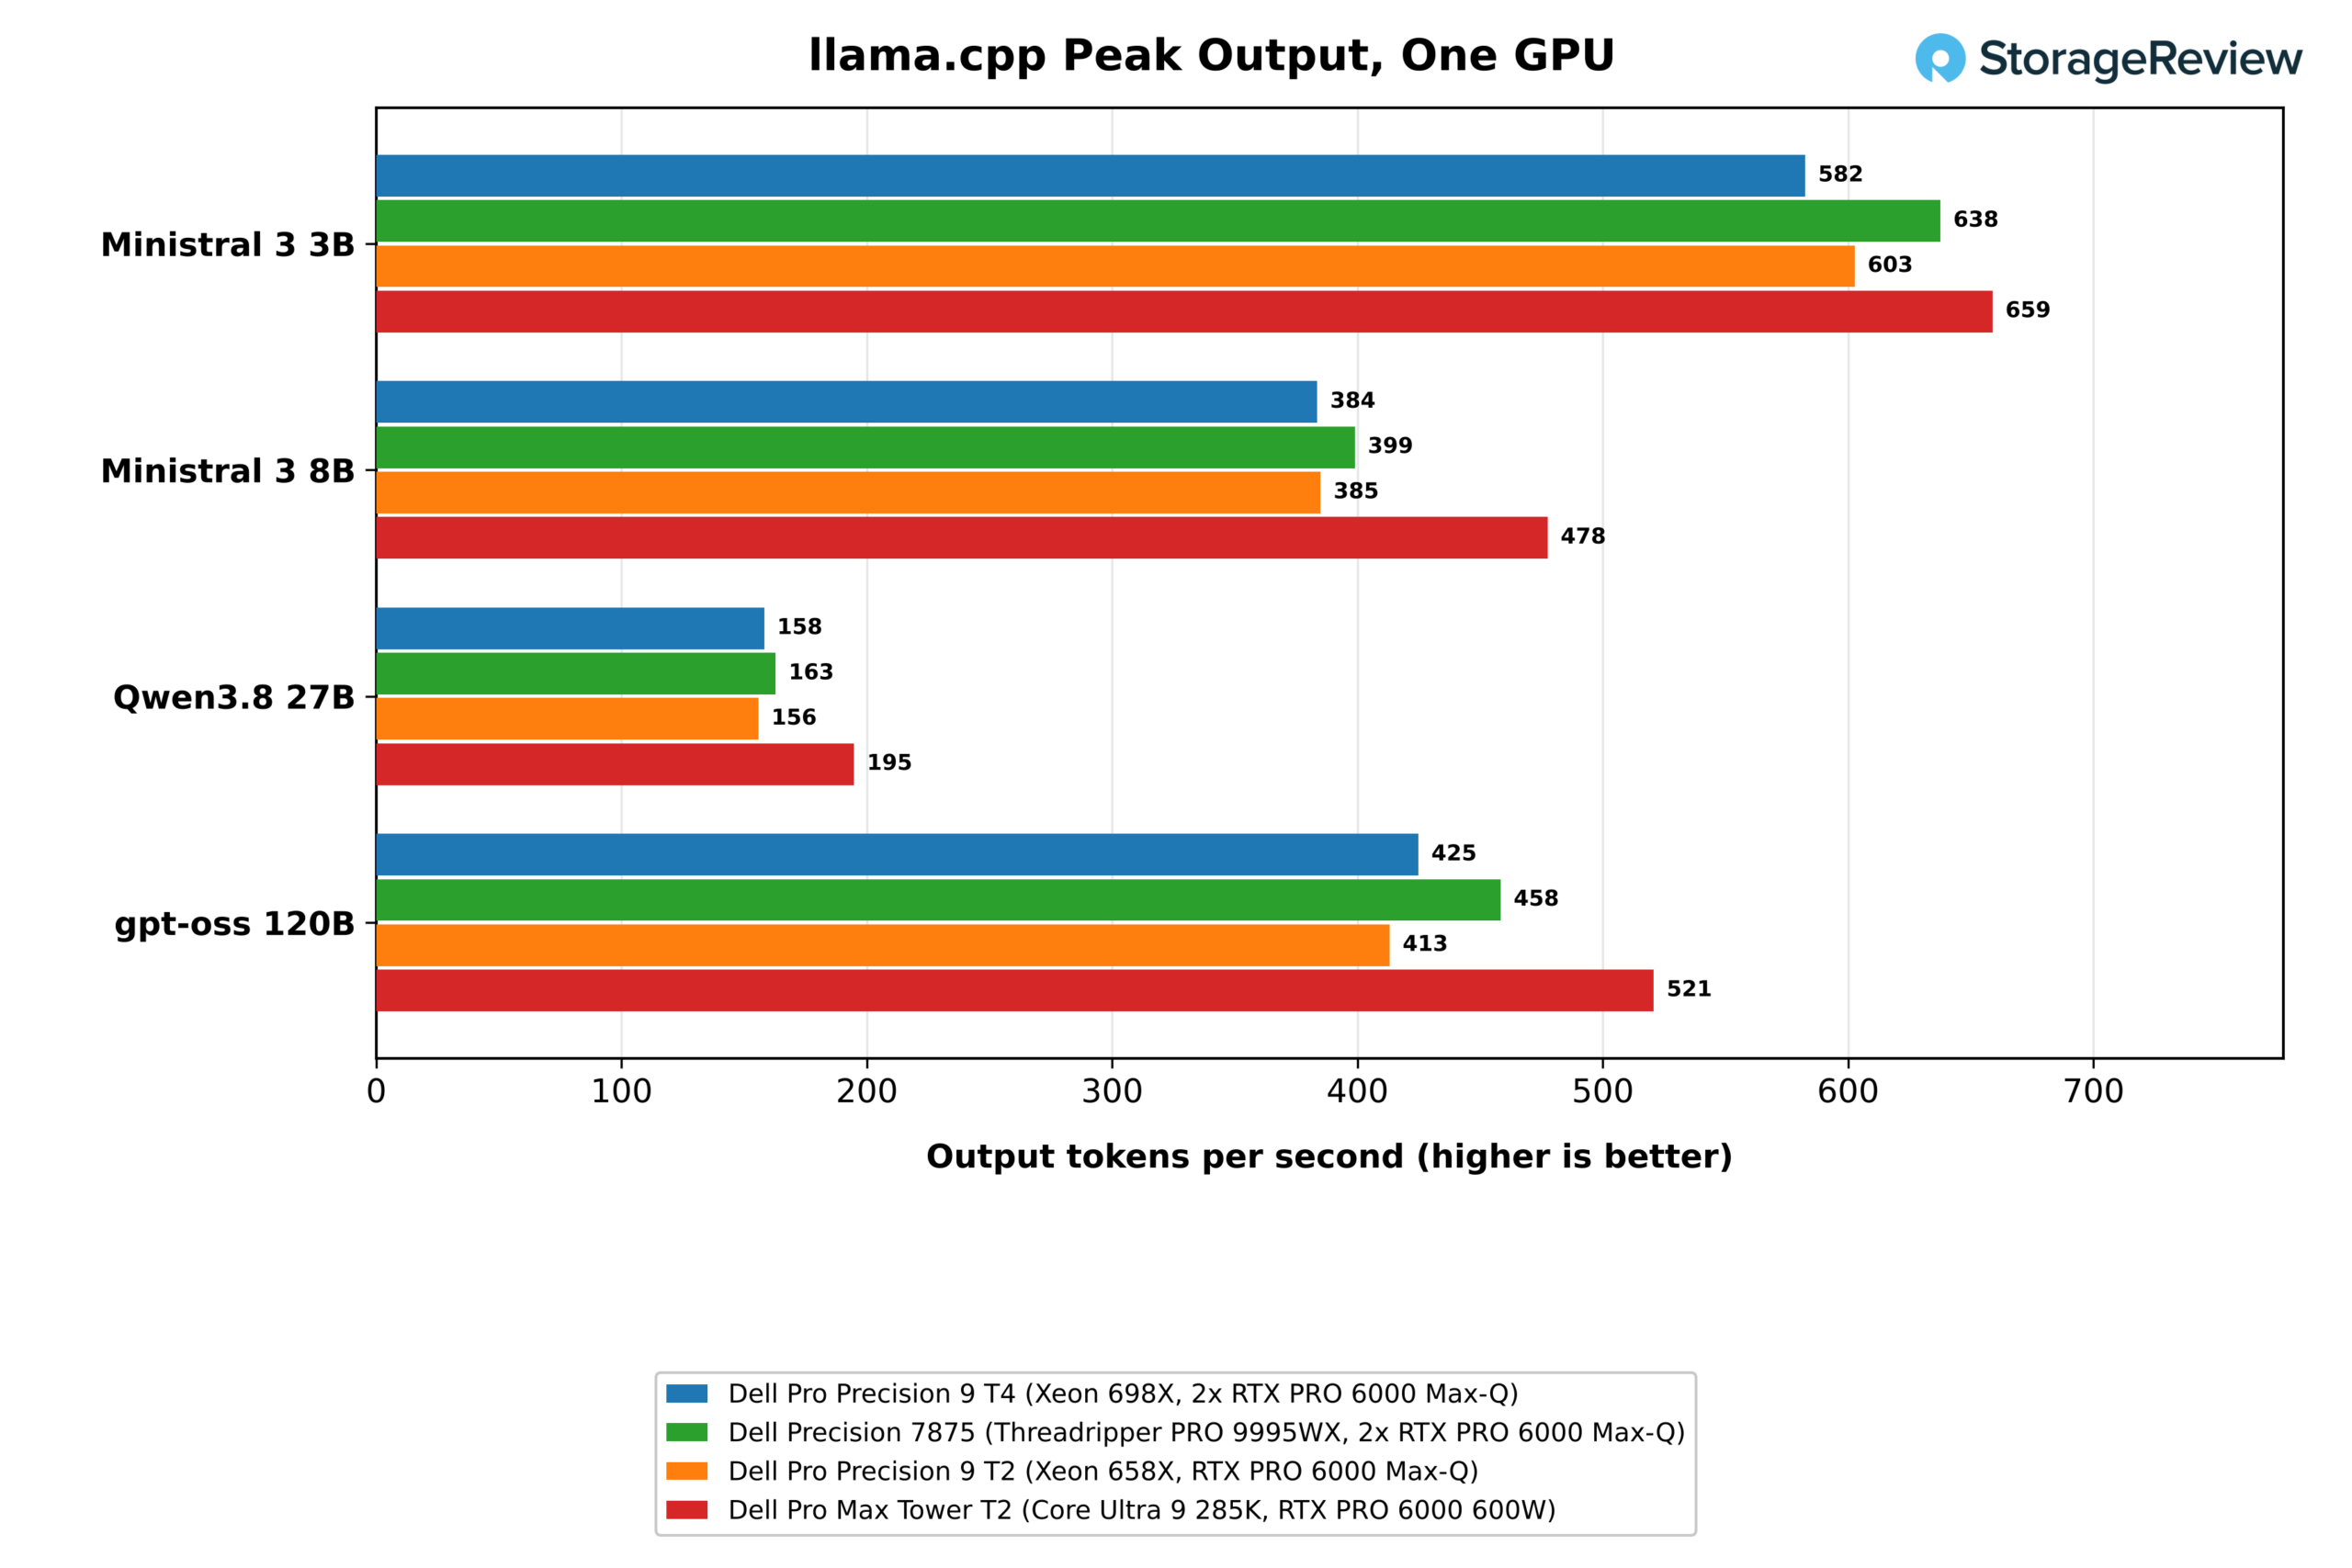
En una GPU, la T4 alcanza el límite de 300 W de la tarjeta. Generó 166.9 tokens por segundo para un usuario en gpt-oss 120B y alcanzó un pico de 424.8 en 64 solicitudes concurrentes, entre un 1 y un 9 por ciento respecto a la tarjeta Max-Q idéntica de la Precision 7875 en los cuatro modelos y al mismo nivel que la Pro Precision 9 T2. La tarjeta de 600 W de la Pro Max Tower T2 es entre un 13 y un 25 por ciento más rápida en su pico en todos los modelos, alcanzando los 520.7 tokens por segundo en gpt-oss 120B.
Dos GPU: Réplicas y Modelos Divididos
| Servidor llama.cpp, dos GPU (salida de tokens/s, cuanto mayor sea el valor, mejor). | Dell Pro Precision 9 T4 | Dell Precision 7875 |
|---|---|---|
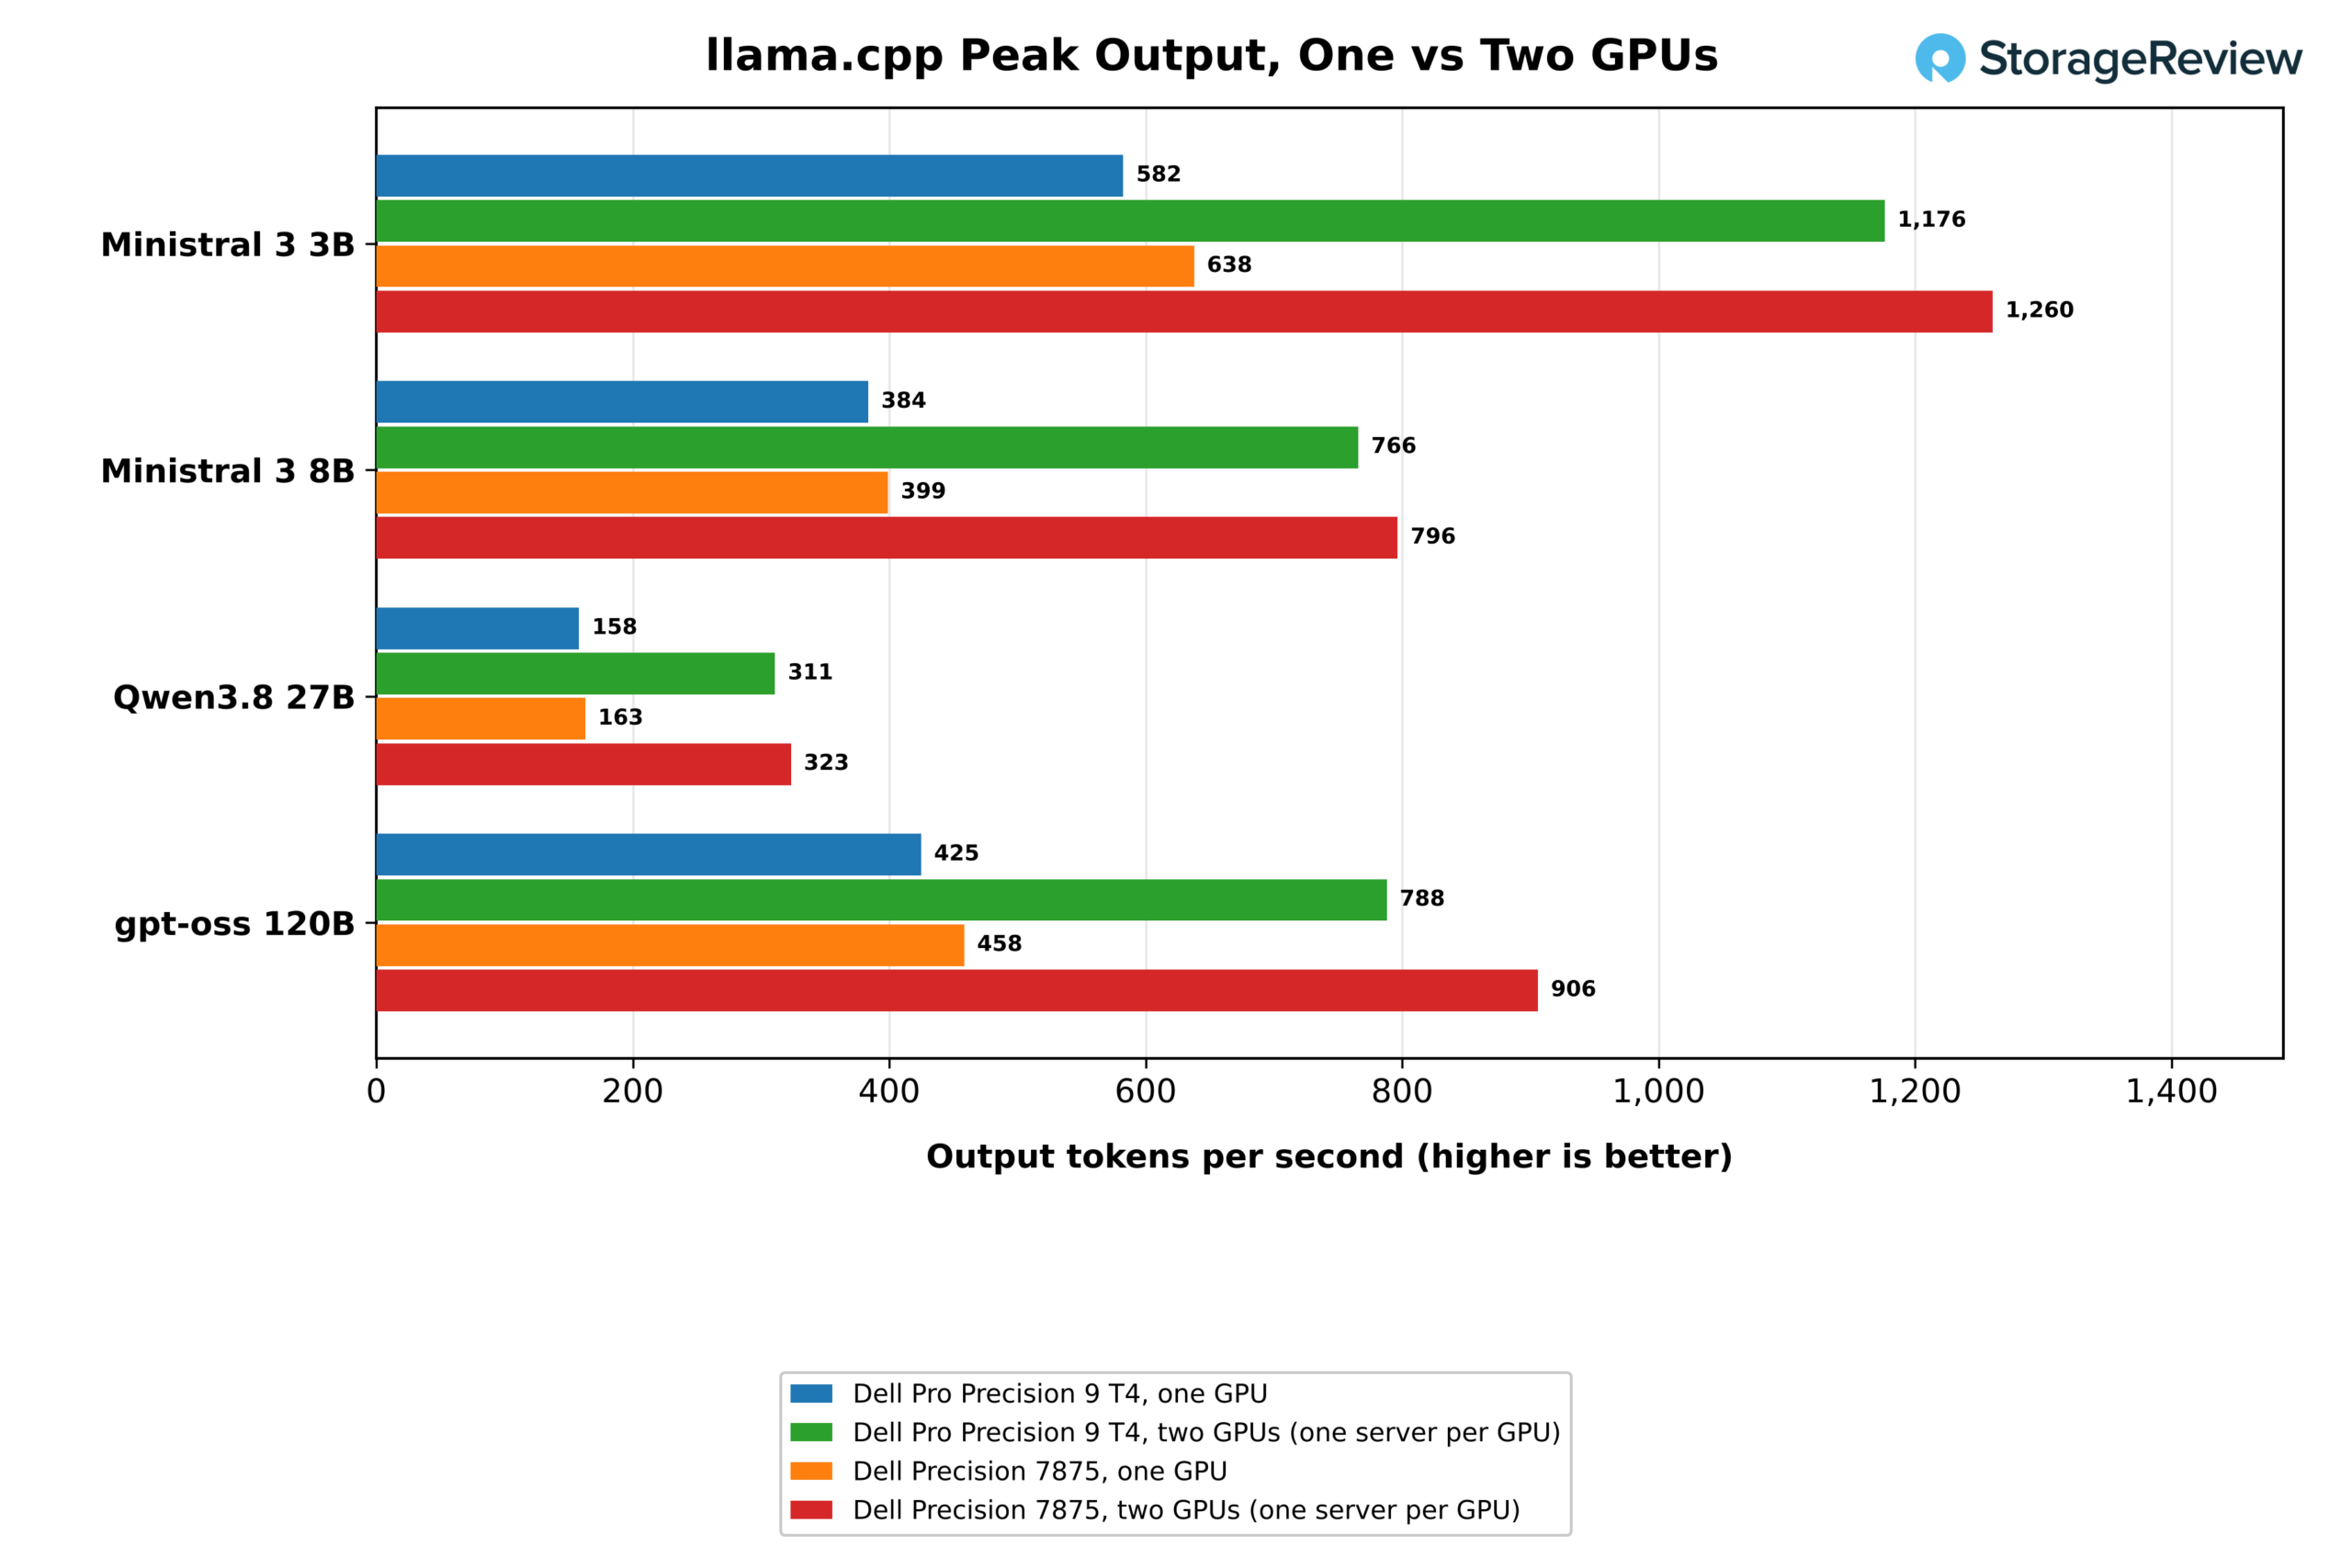
| Ministral 3 3B, pico, un servidor por GPU | 1,176.1 | 1,260.2 |
| Ministral 3 8B, pico, un servidor por GPU | 765.7 | 796.4 |
| Qwen3.8 27B, pico, un servidor por GPU | 310.8 | 323.2 |
| gpt-oss 120B, pico, un servidor por GPU | 787.9 | 905.8 |
| gpt-oss 120B, una solicitud, dividida por capa | 170.6 | 182.4 |
| gpt-oss 120B, pico, dividido por capa | 539.2 | 619.4 |
Ejecutar un servidor por GPU aumentó la producción máxima del T4 entre 1.85 y 2.02 veces en los cuatro modelos. La producción máxima aumentó de 582.5 a 1,176.1 tokens por segundo en Ministral 3 3B, de 383.6 a 765.7 en el modelo 8B y de 158.1 a 310.8 en Qwen3.8 27B, escalando entre 1.97 y 2.02 veces. gpt-oss 120B escaló 1.85 veces a 787.9 tokens por segundo en el T4 y 1.98 veces a 905.8 en el Precision 7875, que alcanzó su pico en 128 solicitudes concurrentes, mientras que el T4 alcanzó un pico de 64.
Dividir gpt-oss 120B por capas entre ambas tarjetas es la forma más lenta de usar la segunda GPU cuando el modelo ya cabe en una. Procesó 170.6 tokens por segundo para un usuario, con una diferencia del 3 % respecto a una sola tarjeta, y alcanzó un pico de 539.2, un 27 % superior al rendimiento de una GPU y muy por debajo de los 787.9 que ofrecieron dos réplicas. El diseño dividido resulta útil para modelos que no caben en una sola tarjeta, como es el caso de MiniMax M2.7.
| Servidor llama.cpp, gpt-oss 120B, 8,192 solicitudes de token, 1,024 salidas de token | T4, una GPU | T4, dos GPU, un servidor por GPU | T4, dos GPU, separadas por capa | Precision 7875, dos GPU, un servidor por GPU. |
|---|---|---|---|---|
| 1 concurrentes: rendimiento total (tokens/s) | 1,502 | 1,504 | 1,536 | 1,530 |
| 1 concurrentes: tiempo hasta el primer token, mediana (ms, cuanto menor sea el valor, mejor) | 1,189 | 1,180 | 719 | 1,189 |
| 8 concurrentes: rendimiento total (tokens/s) | 2,760 | 4,820 | 3,300 | 4,949 |
| 8 concurrentes: salida por usuario (tokens/s) | 38.3 | 66.9 | 45.8 | 68.7 |
| 8 concurrentes: tiempo hasta el primer token, mediana (ms, cuanto menor sea el valor, mejor) | 2,654 | 2,523 | 1,622 | 2,472 |
| 64 concurrentes: rendimiento total (tokens/s) | 3,823 | 7,091 | 4,853 | 7,557 |
| 64 concurrentes: salida por usuario (tokens/s) | 6.6 | 12.3 | 8.4 | 13.1 |
| 64 concurrentes: tiempo hasta el primer token, mediana (ms, cuanto menor sea el valor, mejor) | 3,874 | 3,226 | 2,852 | 2,867 |
El análisis completo en gpt-oss 120B muestra cómo la segunda tarjeta cambia la curva, con un rendimiento total que cuenta los tokens de solicitud y de salida juntos. Una GPU subió de 1,502 tokens por segundo para una sola solicitud a 2,760 en ocho y 3,823 en 64, donde cada usuario recibió 6.6 tokens de salida por segundo. Con un servidor por GPU, ocho solicitudes se ejecutaron a 4,820 y 64 solicitudes alcanzaron 7,091, 1.85 veces una tarjeta, a 12.3 tokens por segundo por usuario. Dividir el modelo alcanzó un pico más bajo en 4,853 pero devolvió el primer token de un solo usuario en 719 ms en comparación con 1,189 ms.

MiniMax M2.7: Un modelo demasiado grande para una sola tarjeta
| MiniMax M2.7 Q4_K_M, 129.3 GB (cuanto mayor sea el valor, mejor, salvo que se indique lo contrario) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Una GPU más la RAM del sistema, una solicitud (tokens/s) | 30.3 | 32.8 | 22.6 | 15.8 |
| Una GPU más la RAM del sistema, pico (tokens/s) | 35.5 | 39.1 | 27.7 | 18.0 |
| Una GPU más la RAM del sistema, tiempo hasta el primer token (ms, cuanto menor sea el valor, mejor) | 16,224 | 16,143 | 16,216 | 18,522 |
| Dos GPU divididas por capas, una solicitud (tokens/s) | 83.7 | 85.0 | GPU única | GPU única |
| Dos GPU divididas por capa, pico (tokens/s) | 127.3 | 129.5 | GPU única | GPU única |
| Dos GPU divididas por capas, tiempo hasta el primer token (ms, cuanto menor sea el valor, mejor). | 3,138 | 3,162 | GPU única | GPU única |
| Carga en frío, una GPU más RAM (s, cuanto menor sea el valor, mejor) | 40.5 | 65.8 | 37.6 | 81.1 |
| Carga en frío, dos GPU divididas (s, cuanto menor sea el valor, mejor) | 27.6 | 50.7 | GPU única | GPU única |
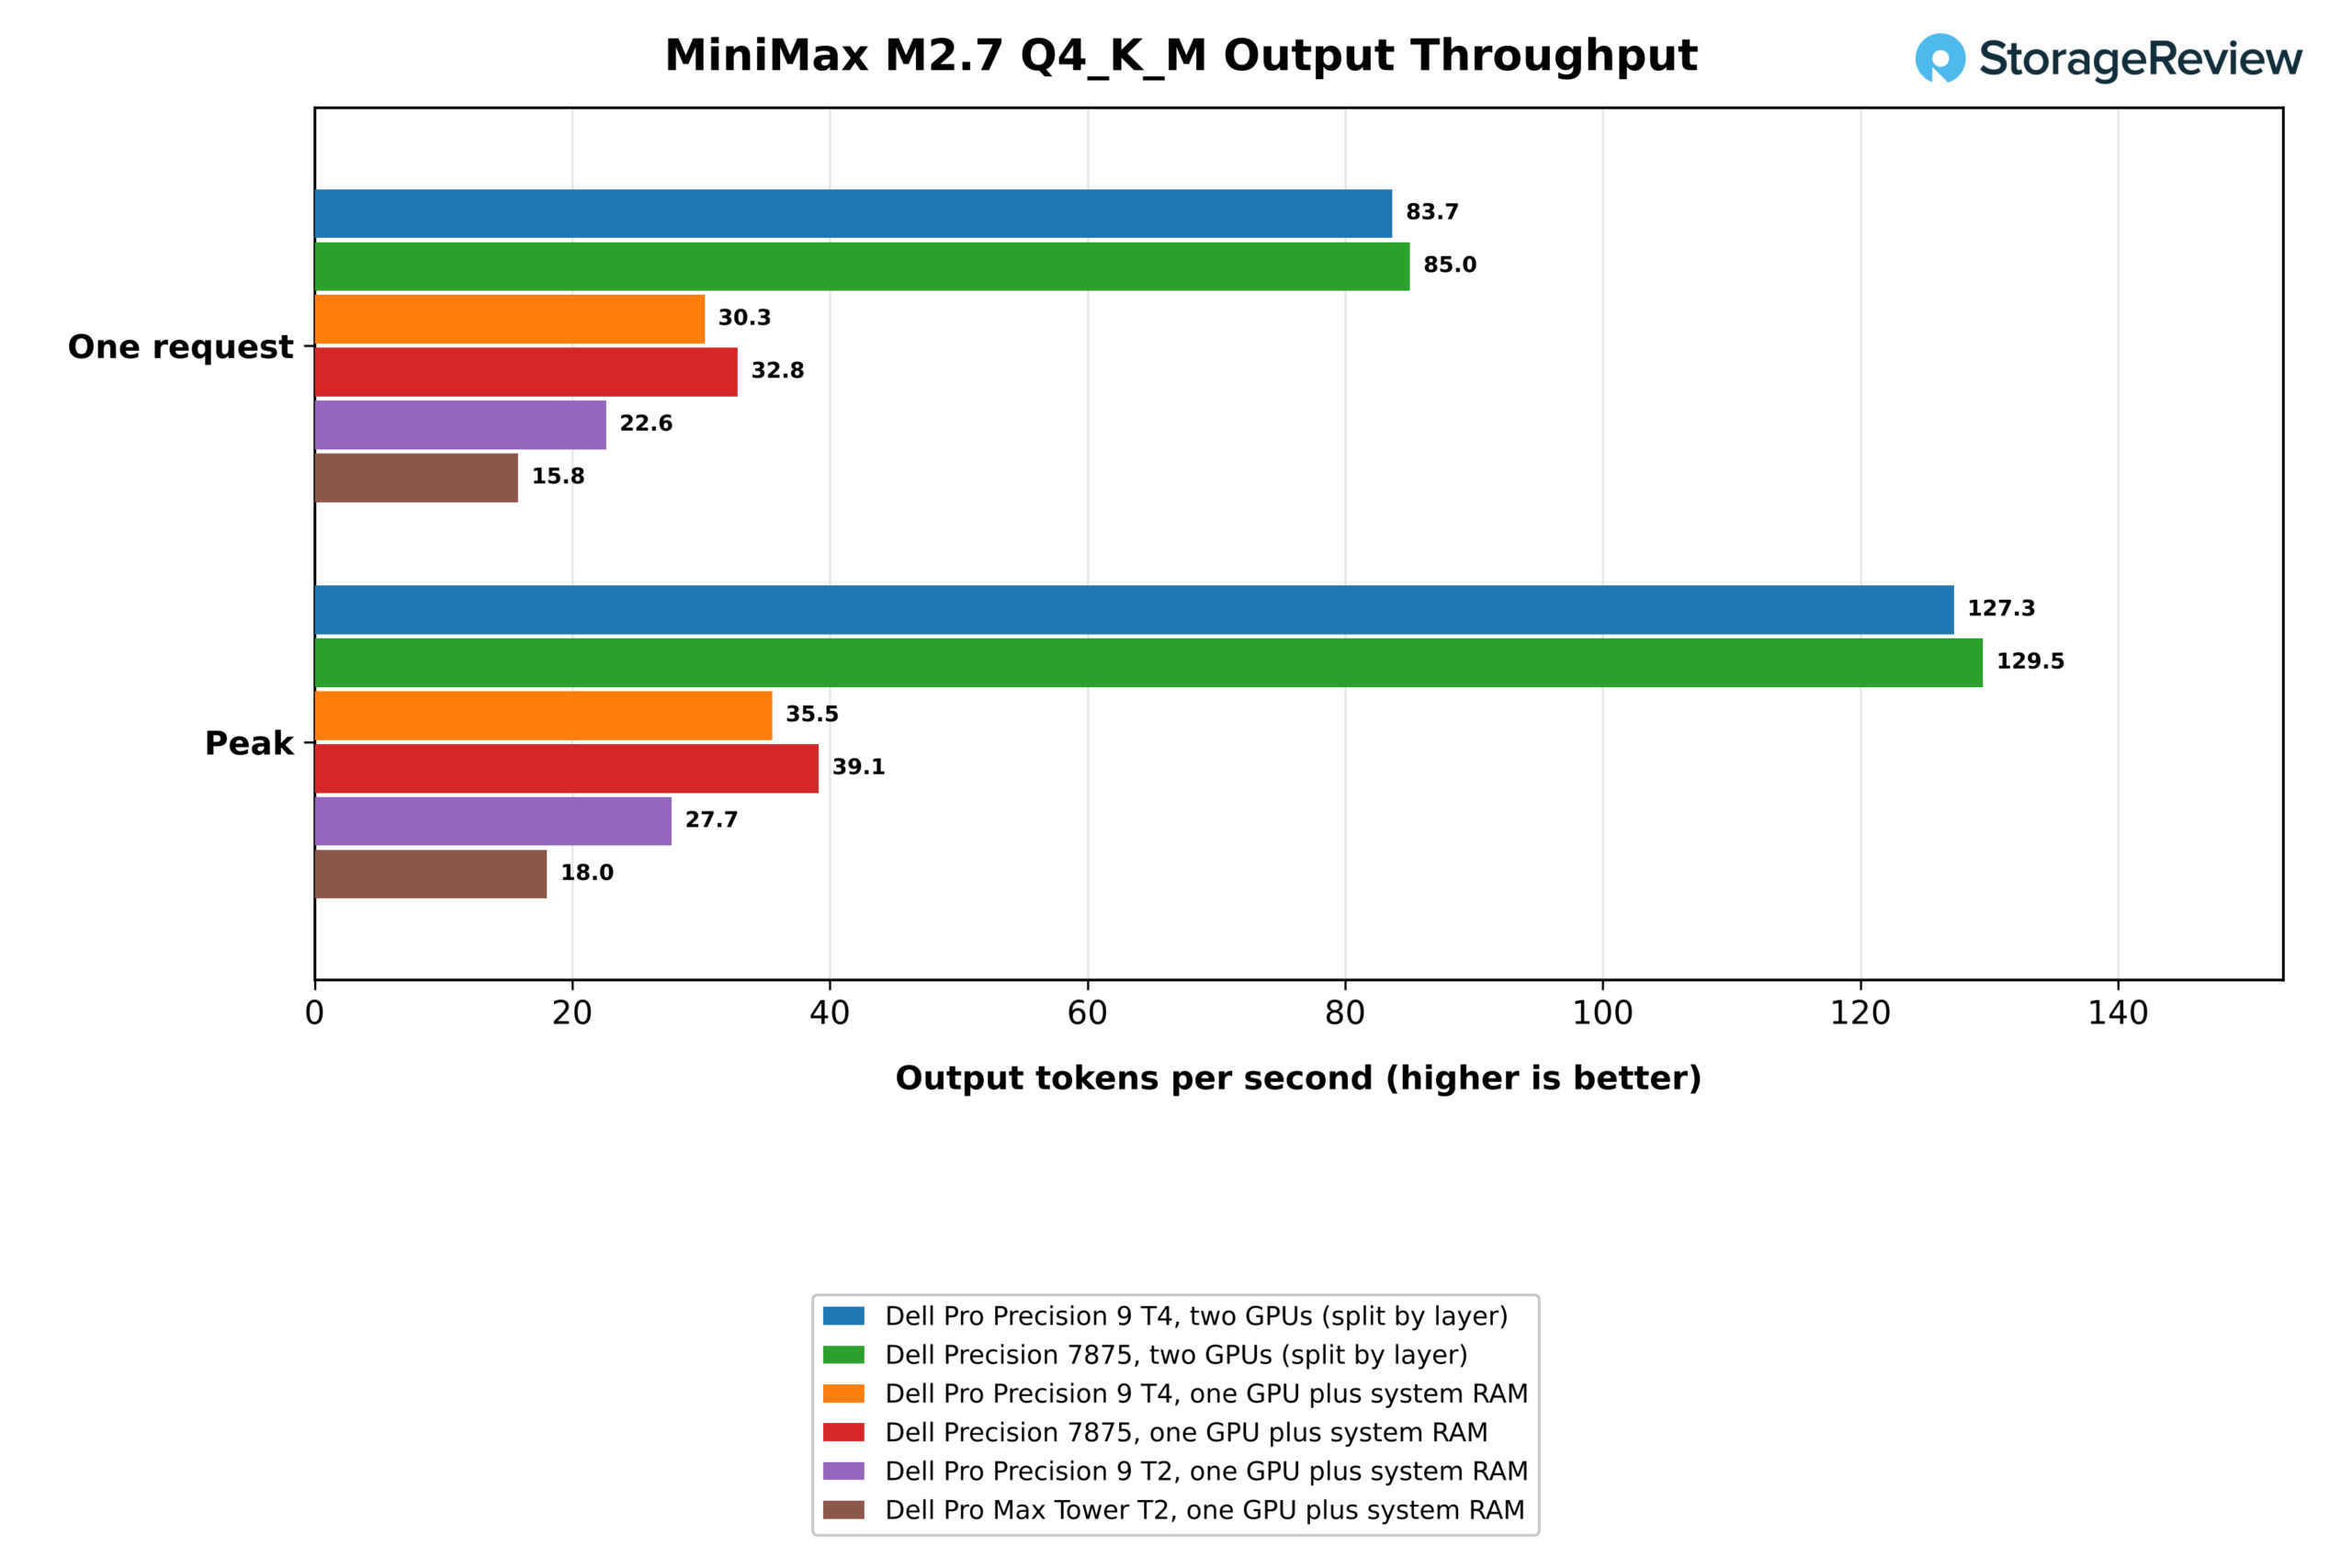
MiniMax M2.7 es un modelo de mezcla de expertos con 230 mil millones de parámetros, y nuestra cuantización de 4 bits ocupa 129.3 GB, más que los 96 GB de una RTX PRO 6000. En una tarjeta, con el resto en la memoria del sistema, el T4 generó 30.3 tokens por segundo para un usuario y tardó 16.2 segundos en devolver el primer token. Dividido entre ambas tarjetas, generó 83.7 tokens por segundo, 2.8 veces más rápido, devolvió el primer token en 3.1 segundos y alcanzó un pico de 127.3 tokens por segundo frente a 35.5.
Los resultados de una sola GPU muestran la importancia de la plataforma anfitriona una vez que un modelo se extiende a la memoria del sistema. Los ocho canales de DDR5-6400 de la T4 la colocan un 34 por ciento por delante de la Pro Precision 9 T2 de cuatro canales a 22.6 tokens por segundo y 1.9 veces por delante de la Pro Max Tower T2 de doble canal a 15.8, a pesar de que la tarjeta de 600 W de la Pro Max Tower T2 es más rápida en todos los modelos que caben. La Precision 7875 superó a la T4 a 32.8 tokens por segundo con un 35 por ciento menos de ancho de banda de memoria, por lo que el ancho de banda por sí solo no determina este resultado. Informamos la ventaja de la 7875 tal como se midió y no hemos aislado su causa.
Cargando modelo
| Carga del modelo Ollama 0.40.3 y llama.cpp (s, cuanto menor sea el valor, mejor) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| gpt-oss:20b (12.8 GB), frío | 5.79 | 7.61 | 5.57 | 7.95 |
| gpt-oss:20b, cálido | 3.45 | 2.50 | 3.47 | 3.05 |
| gpt-oss:120b (60.9 GB), frío | 15.16 | 25.80 | 15.16 | 28.18 |
| gpt-oss:120b, cálido | 7.49 | 5.01 | 7.87 | 6.81 |
| gpt-oss:120b, frío, una copia en cada GPU | 26.47 | 35.55 | GPU única | GPU única |
| MiniMax M2.7 (129.3 GB), en frío, una GPU más RAM | 40.5 | 65.8 | 37.6 | 81.1 |
| MiniMax M2.7, cálido, una GPU más RAM | 28.6 | 15.2 | 36.7 | 80.5 |
Las cargas en frío favorecen a las unidades Gen5, ya que la T4 carga gpt-oss:120b desde su SSD SK hynix Gen5 en 15.2 segundos, igualando a la Pro Precision 9 T2 y muy por delante de los 25.8 y 28.2 segundos de la Precision 7875 y la Pro Max Tower T2 equipadas con Gen4. Las cargas en caliente desde la caché de páginas invierten ese orden, con la 7875 en 5.0 segundos frente a los 7.5 de la T4, y la carga de una copia en cada GPU a la vez tardó 26.5 segundos en la T4.
Generación aumentada por recuperación a gran escala
| RAG sobre 1,002,067 pasajes de Wikipedia | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Integración, una GPU (pasajes/s) | 1,126 | 1,196 | 1,141 | 1,388 |
| Tiempo de ejecución de la incrustación, una GPU (s, cuanto menor sea el valor, mejor) | 890 | 838 | 878 | 722 |
| Integración, dos GPU (pasajes/s) | 2,162 | 2,371 | GPU única | GPU única |
| Tiempo de ejecución integrado, dos GPU (s, cuanto menor sea el valor, mejor) | 464 | 423 | GPU única | GPU única |
| Índice HNSW (s, cuanto menor sea el valor, mejor) | 27.3 | 34.8 | 46.3 | 118.6 |
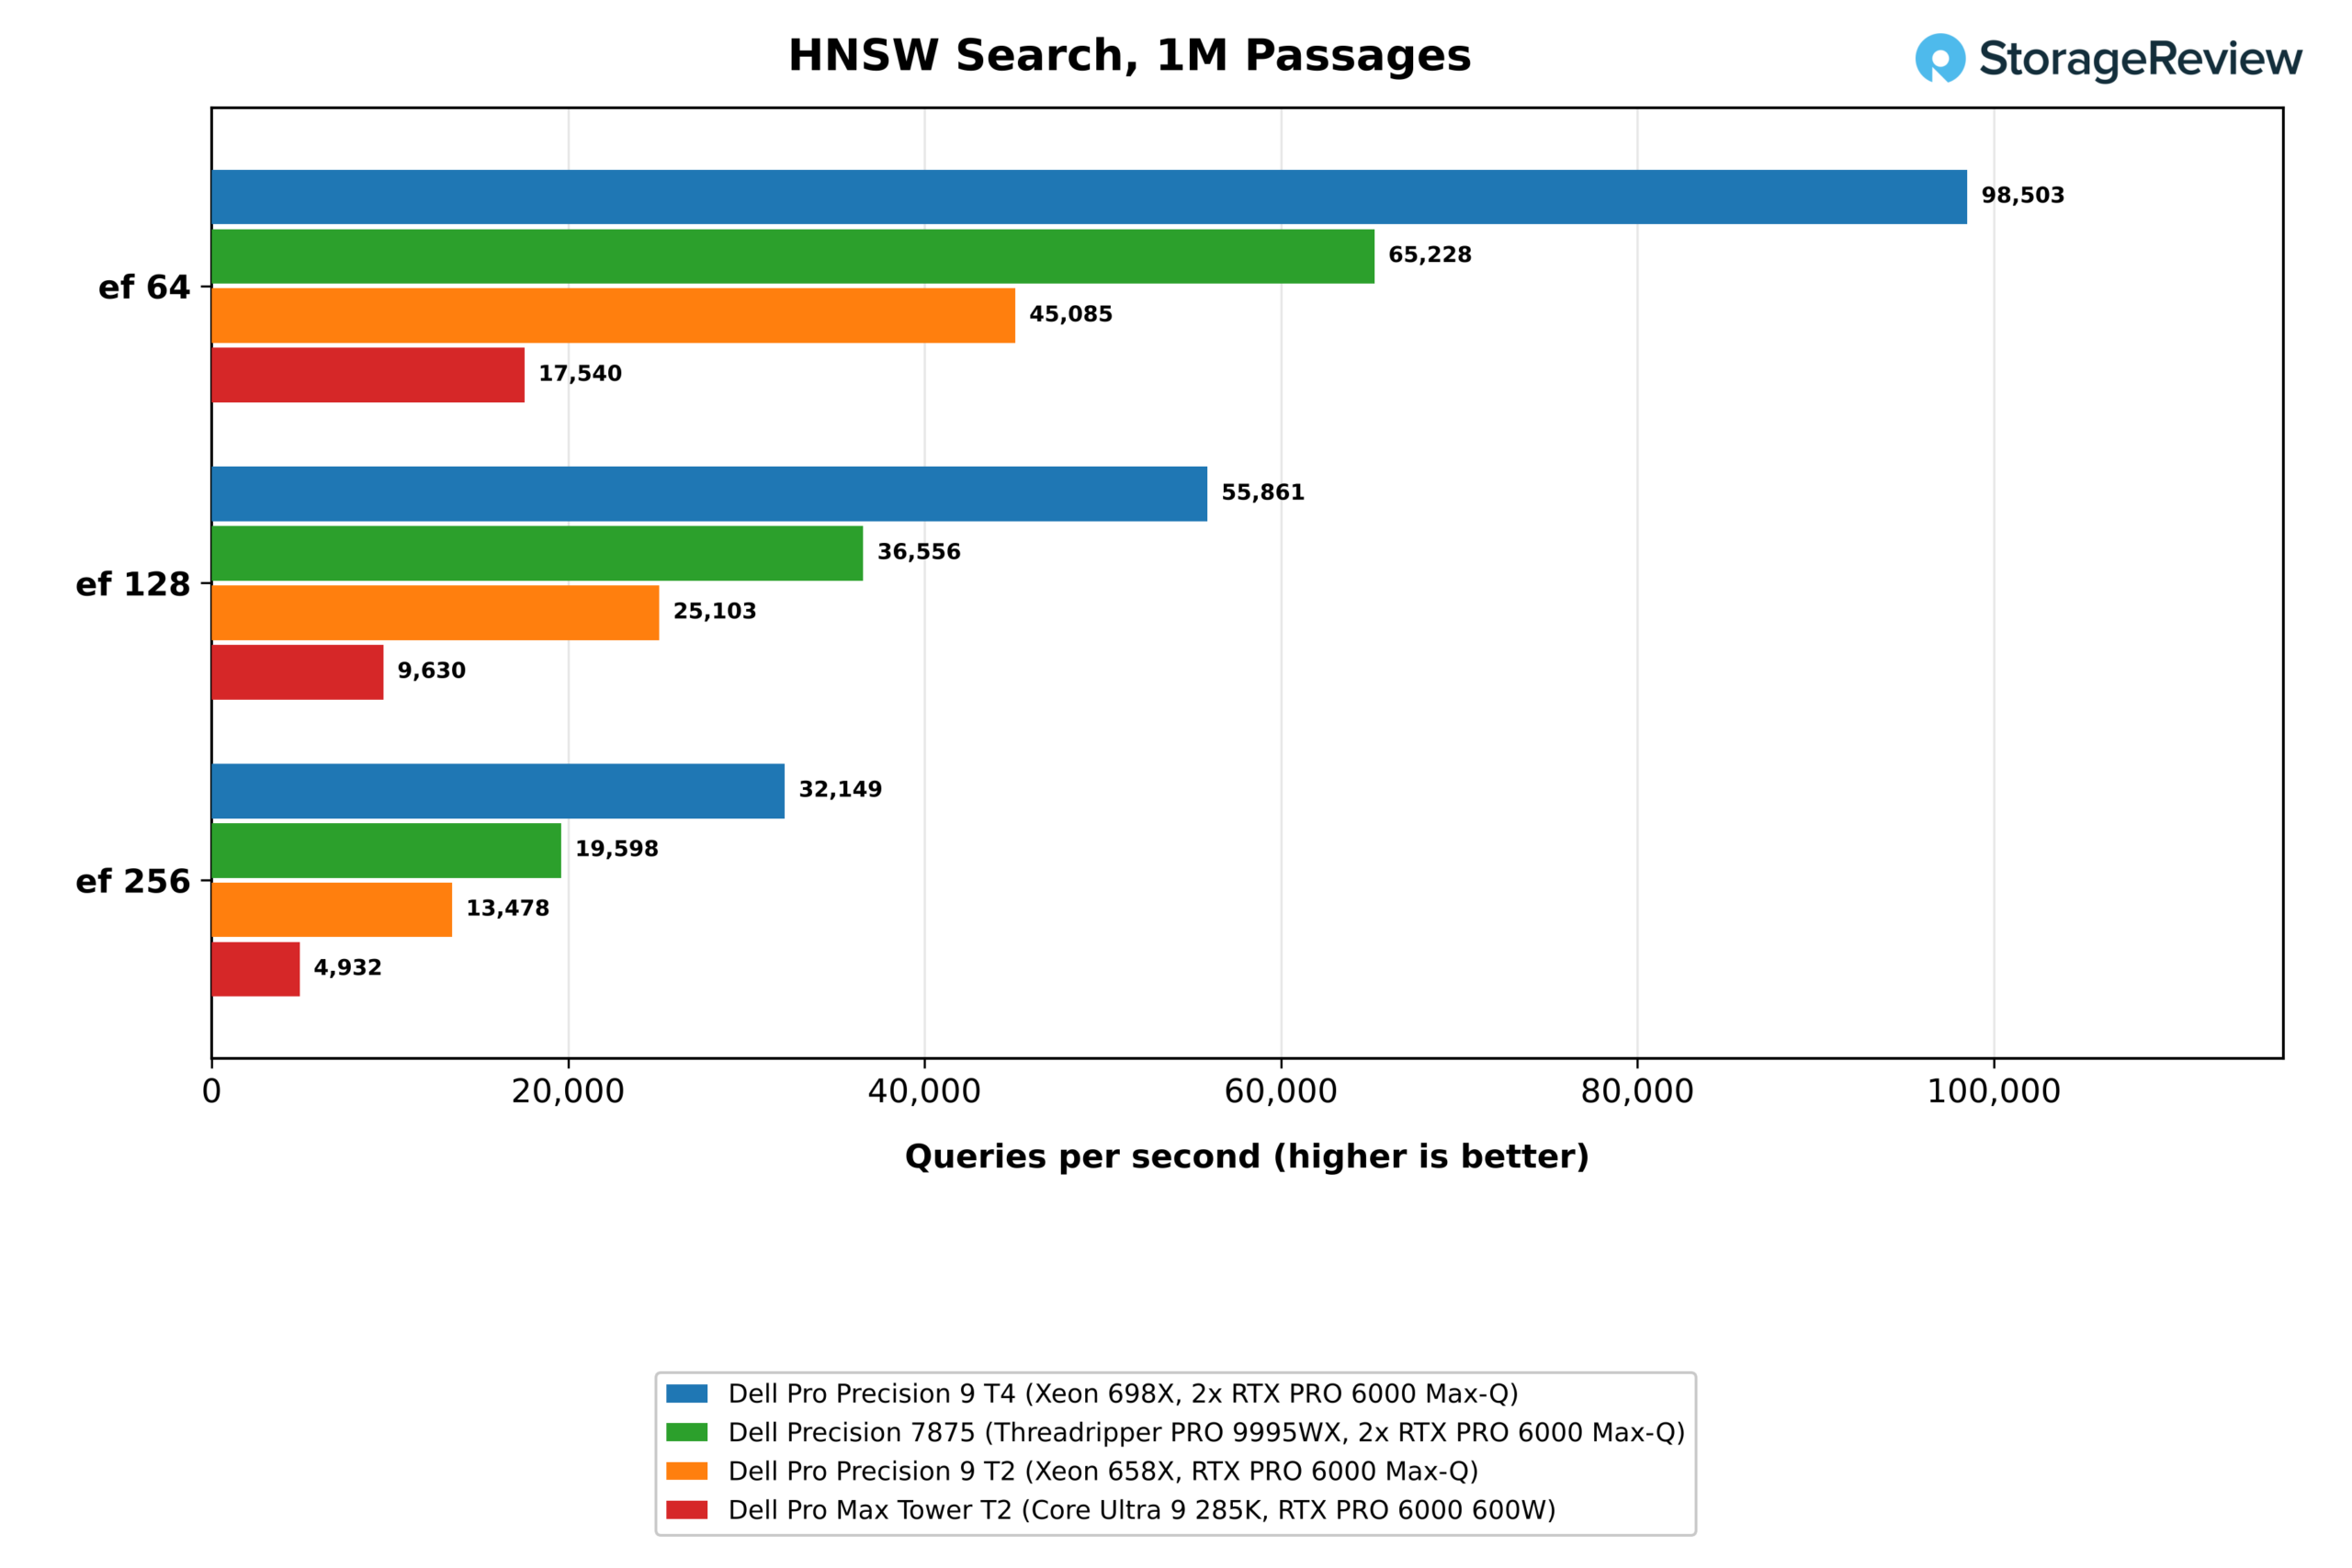
| Búsqueda en HNSW, ef 64 (consultas/s) | 98,503 | 65,228 | 45,085 | 17,540 |
| Búsqueda en HNSW, ef 256 (consultas/s) | 32,149 | 19,598 | 13,478 | 4,932 |
| Recall@5 frente a búsqueda exacta, ef 256 (%) | 97.59 | 97.67 | 97.26 | 97.70 |
| Pregunta para responder p50 (s, cuanto menor sea el valor, mejor) | 0.123 | 0.082 | 0.117 | 0.095 |
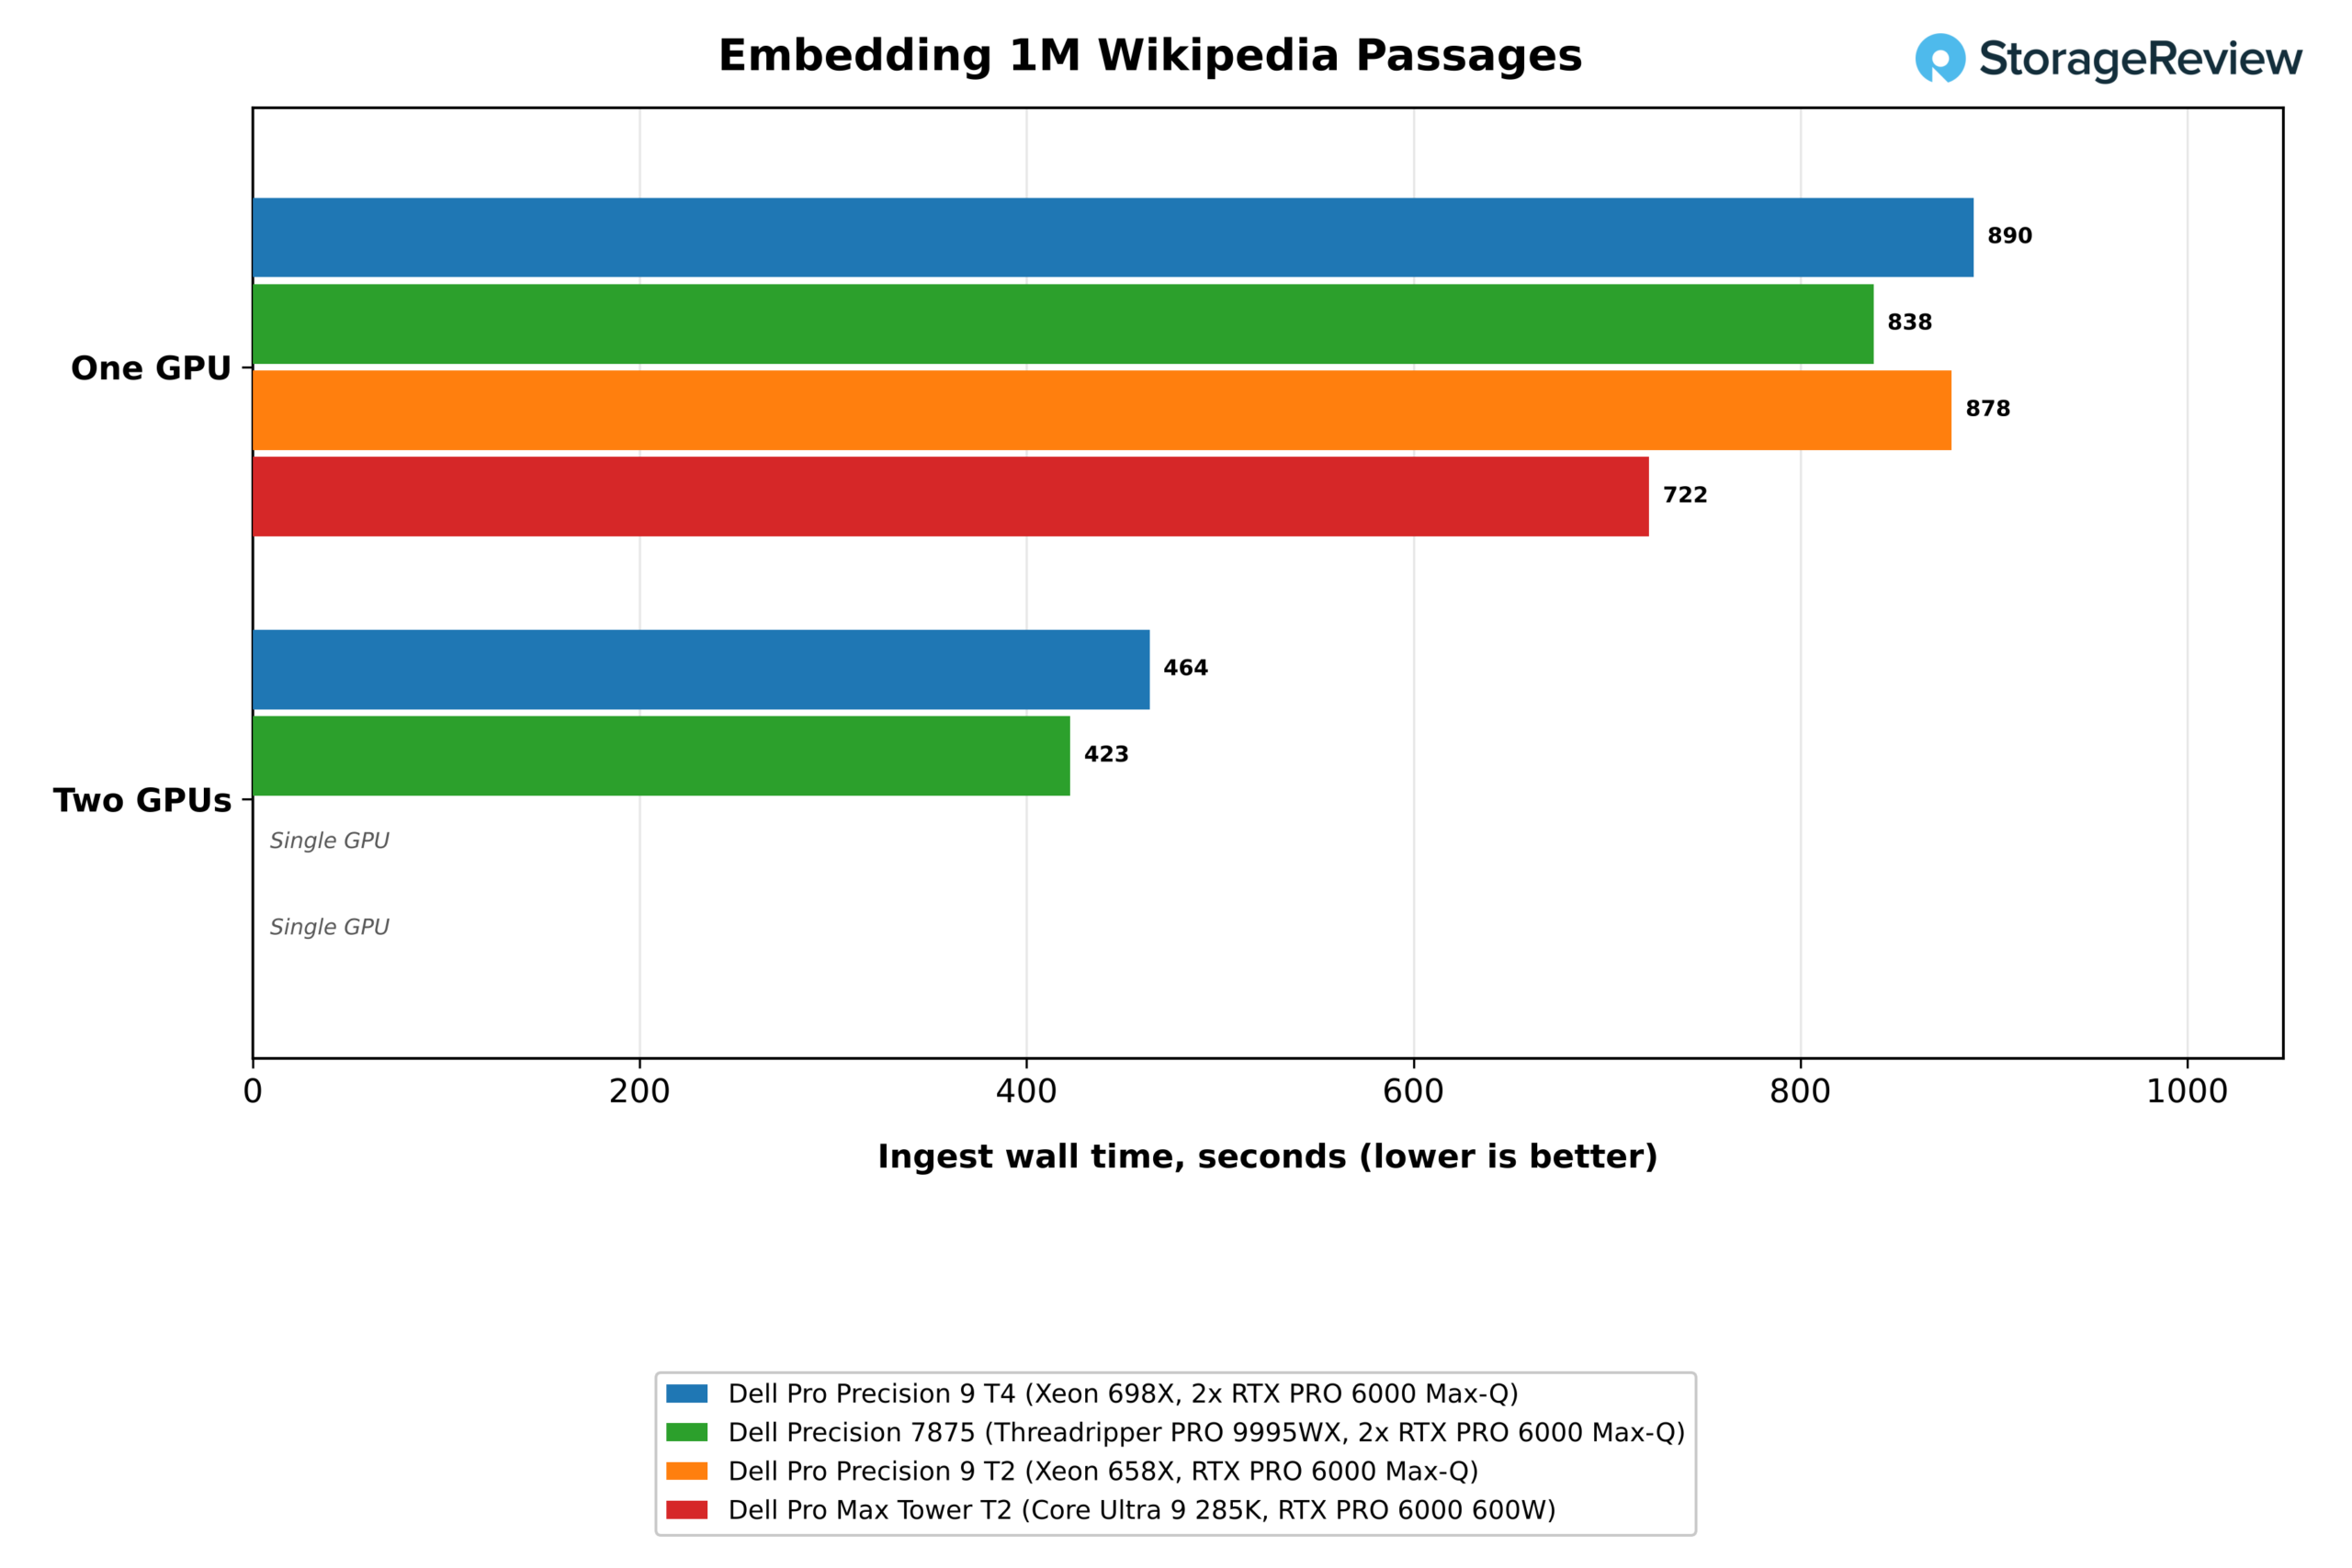
La prueba RAG-at-scale oculta preguntas de SQuAD entre un millón de pasajes de Wikipedia, las integra con nomic-embed-text, crea un índice HNSW y responde con Phi-4-mini. La integración tardó 890 segundos en una GPU T4 y 464 segundos en dos, una aceleración de 1.92x, mientras que la Precision 7875 finalizó en 423 segundos con dos tarjetas. La tarjeta de 600 W de la Pro Max Tower T2 es la GPU individual más rápida, con 722 segundos.
La creación del índice y la búsqueda vectorial se ejecutan en la CPU, y ahí es donde el T4 destaca. Creó el índice HNSW en 27.3 segundos, frente a los 34.8 segundos del Precision 7875 y los 118.6 segundos del Pro Max Tower T2, y realizó búsquedas a 98,503 consultas por segundo con un factor de éxito de 64, 1.51 veces superior al del 7875 y 5.6 veces superior al del sistema Core Ultra. Con un factor de éxito de 256, procesó 32,149 consultas por segundo con una recuperación del 97.6 % frente a la búsqueda exacta, y las respuestas se obtuvieron en una mediana de 0.12 segundos.
Sintonia FINA
| Ministral 3 8B LoRA, BF16, una época de Dolly 15k | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Tiempo de entrenamiento por época, una GPU (minutos, cuanto menor sea el valor, mejor) | 31.5 | 27.2 | 30.6 | 22.3 |
| Rendimiento, una GPU (tokens/s) | 1,584 | 1,834 | 1,631 | 2,236 |
| Pérdida reservada antes y después del entrenamiento, una GPU | 1.534 a 1.169 | 1.534 a 1.172 | 1.534 a 1.167 | 1.534 a 1.167 |
| Tiempo de entrenamiento por época, dos GPU (minutos, cuanto menor sea el valor, mejor) | 19.7 | 18.1 | GPU única | GPU única |
| Rendimiento, dos GPU (tokens/s) | 2,528 | 2,754 | GPU única | GPU única |
| Aceleración gracias a la segunda GPU | 1.60x | 1.50x | GPU única | GPU única |
| Pérdida retenida después del entrenamiento, dos GPU | 1.167 | 1.168 | GPU única | GPU única |
La prueba LoRA de una época ajusta Ministral 3 8B en BF16 en Dolly 15k a lo largo de 1,849 pasos y obtiene 200 ejemplos reservados cada 100 pasos. Cada sistema comenzó con una pérdida reservada de 1.534 y terminó entre 1.167 y 1.172, por lo que el resultado que los separa es el tiempo que tarda la época. Una GPU T4 terminó en 31.5 minutos a 1,584 tokens por segundo, dentro del 3 por ciento de la Pro Precision 9 T2 en la misma tarjeta Max-Q. La Precision 7875 tardó 27.2 minutos, y la tarjeta de 600 W en la Pro Max Tower T2 tardó 22.3.
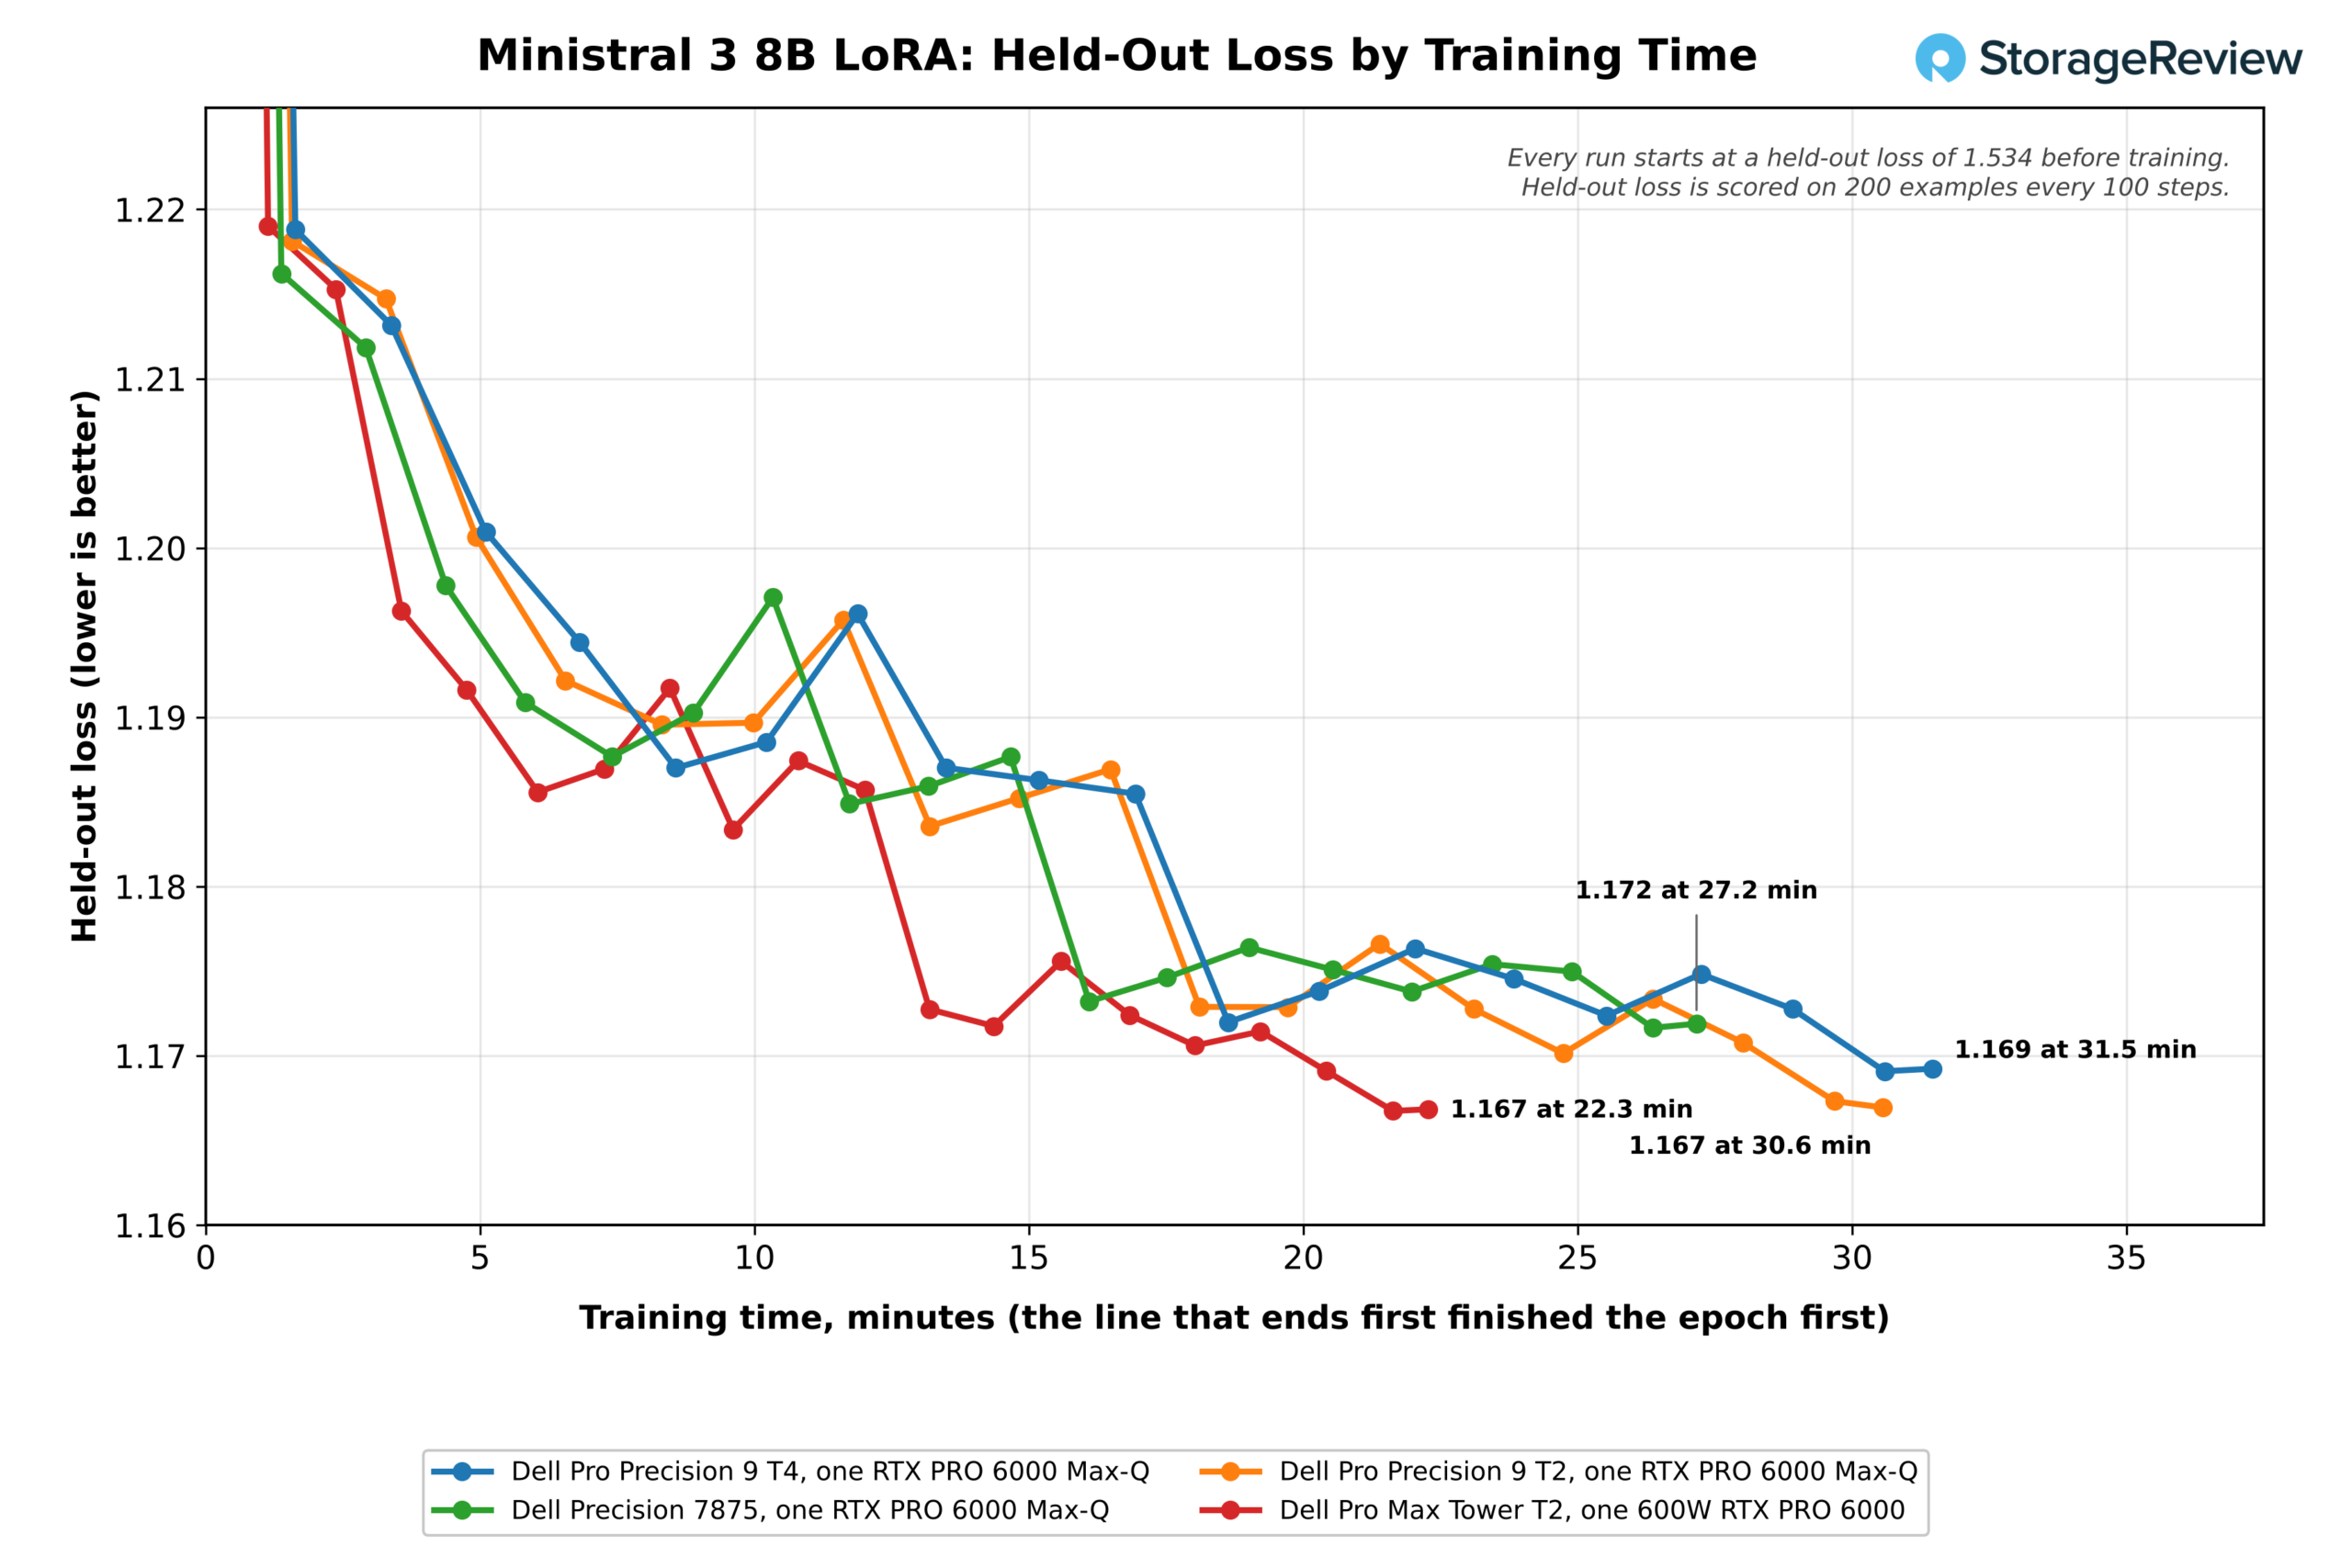
La pérdida retenida en el T4 cayó de 1.534 a 1.219 en los primeros 100 pasos, 1.6 minutos después del inicio del entrenamiento, y luego se redujo a 1.169 durante el resto de la época. Agregar la segunda GPU redujo la época del T4 a 19.7 minutos a 2,528 tokens por segundo, una aceleración de 1.60x que terminó antes de los 22.3 minutos de la tarjeta única de 600 W. El Precision 7875 completó su época de dos GPU en 18.1 minutos, una aceleración de 1.50x, y las ejecuciones de dos GPU terminaron con pérdidas retenidas de 1.167 y 1.168.
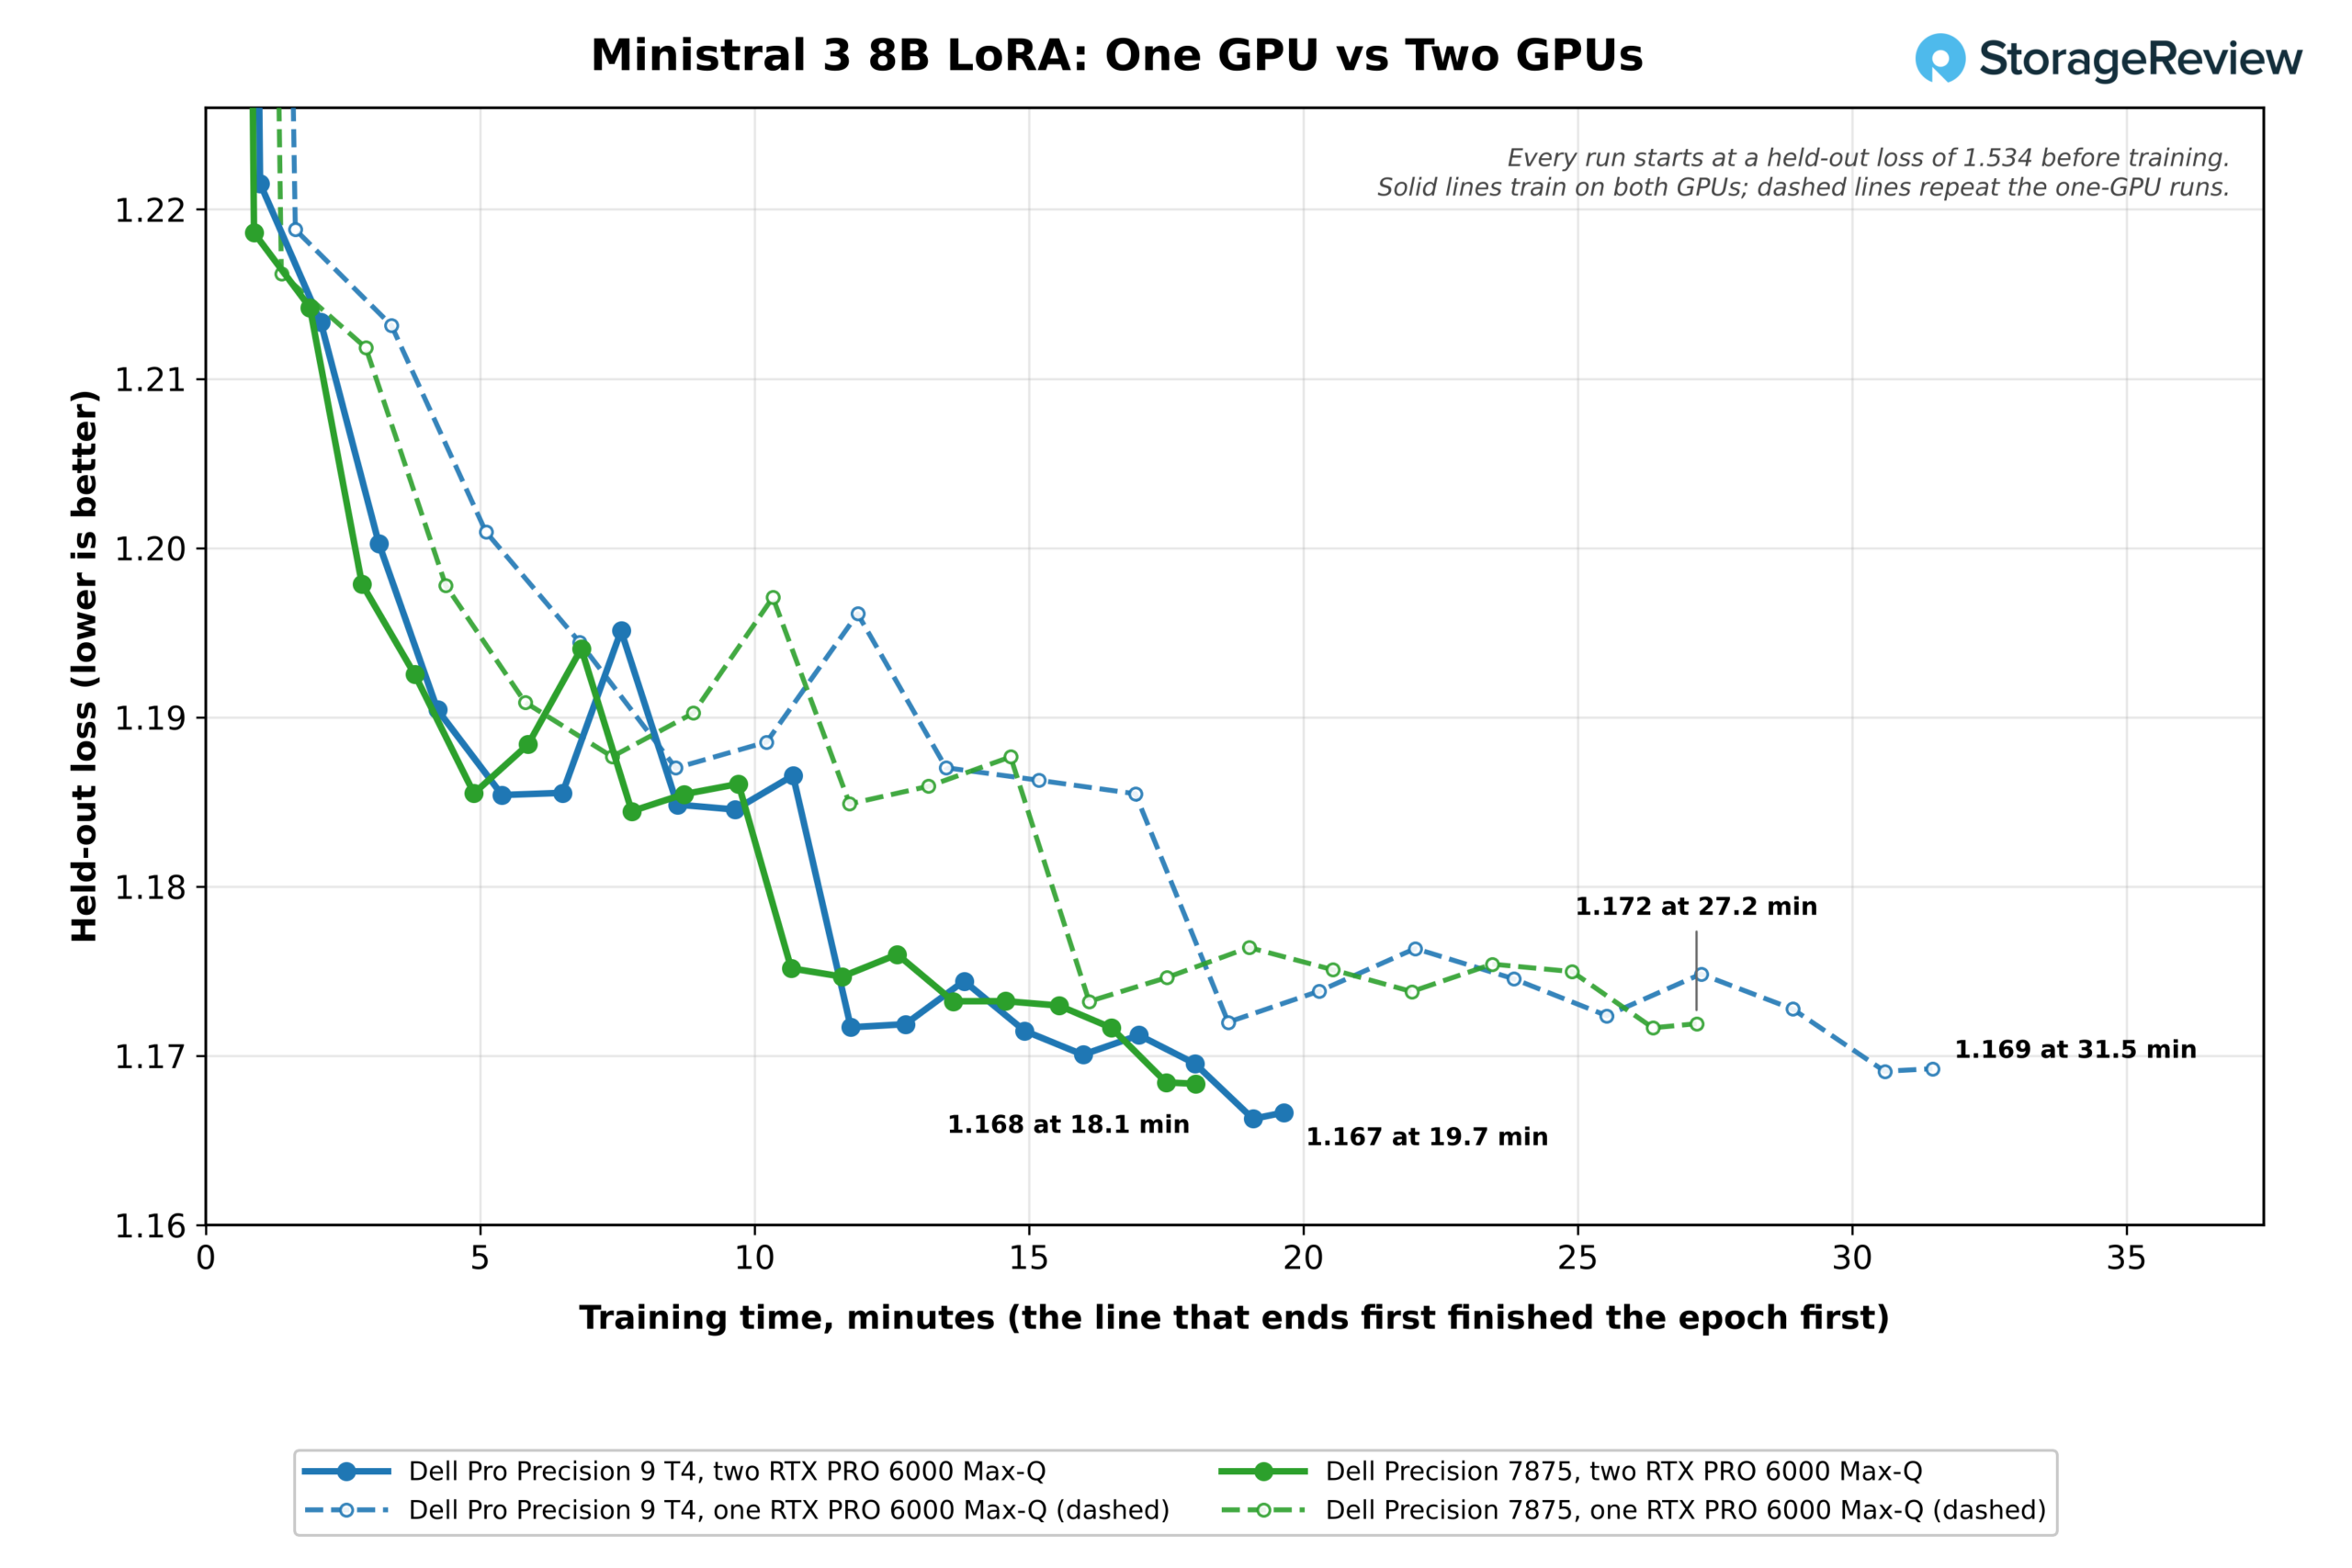
Ambas tarjetas se ejecutan en paralelo de datos con dos ejemplos por GPU y gradientes acumulados en el mismo lote global de ocho, en cuatro pasadas en una GPU y dos pasadas en un par, por lo que la ejecución con dos GPU ve los mismos ejemplos en cada paso y llega a la misma pérdida. Con dos ejemplos cortos por GPU en cada pasada, la segunda tarjeta tiene poco trabajo que absorber y el intercambio de gradientes toma una mayor proporción de cada paso. La época alcanzó un pico de 19.5 GiB de memoria de GPU en una tarjeta y 19.7 GiB por tarjeta en dos, una fracción de los 96 GB de cada RTX PRO 6000.
Agente de codificación, RAG a pequeña escala y generación de imágenes
| Agente de codificación, RAG y generación de imágenes (cuanto mayor sea el valor, mejor, salvo que se indique lo contrario). | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Agente de codificación, gpt-oss:20b 64K, ejecuciones exitosas (de 3) | 3 | 2* | 2* | 2* |
| Agente de codificación, gpt-oss:120b 128K, ejecuciones exitosas (de 3) | 3 | 3 | 3 | 3 |
| Agente de codificación, gpt-oss:120b, tasa de generación (tokens/s) | 161.5 | 167.9 | 166.7 | 183.2 |
| RAG, 20,963 pasajes, ingerir (pasajes/s) | 304.6 | 433.8 | 392.1 | 371.6 |
| Generación de respuestas RAG, Phi-4-mini (tokens/s) | 372.5 | 410.0 | 402.8 | 415.8 |
| FLUX.2 pequeño 4B BF16, 1024×1024 (imágenes/min) | 40.96 | 43.03 | 41.32 | 54.25 |
| Z-Image Turbo 6B BF16 (imágenes/min) | 17.29 | 17.67 | 17.27 | 23.83 |
| Qwen-Image 20B BF16 (imágenes/min) | 2.43 | 2.45 | 2.39 | 3.20 |
*Señalado por el conjunto de pruebas: una de las tres ejecuciones del agente en este sistema no superó las 11 pruebas.
El T4 superó todas las pruebas del agente de codificación en todos los niveles del modelo, incluidas las tres pruebas de gpt-oss:20b en un contexto de 64K, donde los otros tres sistemas superaron dos de tres, y generó 161.5 tokens por segundo en gpt-oss:120b. La generación de imágenes se ejecuta en una GPU, por lo que las 40.96 imágenes por minuto del T4 en FLUX.2 klein en BF16 se sitúan junto con los otros sistemas Max-Q y por detrás de la tarjeta de 600W con 54.25.
Rendimiento de CPU
Los resultados de la CPU compararon los 86 núcleos Xeon de la T4 con los 96 núcleos Threadripper de la Precision 7875, tomando como referencia las dos T2 de 24 núcleos. La Threadripper cuenta con diez núcleos más y ofrece 192 hilos frente a los 172 de la Xeon. La T4 lidera en los aspectos donde el ancho de banda de la memoria determina el resultado, mientras que la 7875 lidera en los aspectos donde el número de núcleos y la frecuencia de reloj son determinantes.
Compresión, renderizado y compilación
| Prueba | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| 7-Zip, todos los subprocesos (GIPS) | 619.8 | 850.0 | 285.1 | 172.7 |
| 7-Zip, un hilo (GIPS) | 8.85 | 10.58 | 9.27 | 11.04 |
| Blender 4.5 Monster (muestras/min) | 961.8 | 1,253.8 | 400.7 | 303.0 |
| Blender 4.5 Junkshop (muestras/min) | 641.9 | 849.7 | 266.9 | 191.9 |
| Blender 4.5 Classroom (muestras/min) | 442.8 | 612.2 | 187.2 | 147.1 |
| HandBrake x265 (fps) | 31.4 | 41.7 | 41.5 | 40.0 |
| Freno de mano SVT-AV1 (fps) | 159.4 | 255.8 | 198.5 | 122.6 |
| Compilación LLVM 21 (s, cuanto menor sea el número, mejor) | 58.4 | 43.7 | 106.4 | 155.9 |
| Núcleo Linux allmodconfig (s, cuanto menor sea el valor, mejor) | 312 | 264 | 537 | 843 |
| OpenSSL AES-256-GCM, todos los hilos (GB/s) | 882.6 | 1,139.1 | 371.2 | 137.0 |
| nginx, 1,000 conexiones (solicitudes/s) | 414,468 | 467,128 | 323,567 | 153,732 |
El T4 obtuvo 619.8 GIPS en 7-Zip y 961.8 muestras por minuto en Blender Monster, 2.2 y 2.4 veces más que el Pro Precision 9 T2 de 24 núcleos. El Precision 7875 fue un 37 por ciento más rápido en 7-Zip y un 30 por ciento más rápido en Blender, y completó la compilación de LLVM en 43.7 segundos frente a 58.4, y la compilación del kernel de Linux allmodconfig en 264 segundos frente a 312. La velocidad por núcleo es el punto débil del T4, con la puntuación más baja de 7-Zip de un solo hilo en este grupo, con 8.85 GIPS.
La codificación x265 de HandBrake es la excepción en esta tabla, y la causa es el codificador más que el procesador. Los otros tres sistemas obtuvieron entre 40.0 y 41.7 fps con 24 o 96 núcleos, por lo que x265 en este preset no escala con el número de núcleos, y los 31.4 fps del T4 son consistentes con su menor velocidad por núcleo en los hilos que x265 sí utiliza. Durante la codificación, el T4 promedió alrededor de 1 GHz en sus 172 hilos a 51C a 64C, lo que muestra que la mayor parte del chip estaba inactivo. SVT-AV1 escaló mejor, a 159.4 fps en el T4 frente a 255.8 en el 7875.


Ancho de banda de memoria, simulación y matemáticas
| Prueba | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Tríada de flujo (MB/s) | 328,329 | 215,177 | 141,832 | 45,102 |
| Controlador OpenFOAM 13, celdas 3M, resolver (s, cuanto menor sea el valor, mejor) | 293 | 556 | 826 | No terminó |
| GROMACS benchPEP, todos los núcleos (ns/día) | 1.243 | 1.034 | No se ejecuta | No se ejecuta |
| GROMACS benchMEM, 16 núcleos (ns/día) | 68.09 | 84.94 | 78.03 | 54.26 |
| OpenBLAS DGEMM, todos los núcleos (GFLOPS) | 3,664 | 4,745 | 2,319 | 1,063 |
| OpenBLAS LU resuelve N=20000 (GFLOPS) | 1,660 | 1,172 | 1,616 | 858 |
| y-cruncher Pi, 1B dígitos (s, cuanto menor sea el valor, mejor) | 4.01 | 7.45 | 8.51 | 24.61 |
| y-cruncher Pi, 10B dígitos (s, cuanto menor sea el valor, mejor) | 53.9 | 83.7 | 119.2 | 347.9 |
| y-cruncher Pi, 25B dígitos (s, cuanto menor sea el valor, mejor) | 155.6 | 259.6 | No se ejecuta | No se ejecuta |
Ocho canales de DDR5-6400 le dan al T4 328 GB/s en STREAM Triad, un 53 por ciento más que la DDR5-5600 de la Precision 7875 y 2.3 veces más que la Pro Precision 9 T2 de cuatro canales. A continuación, se muestran las pruebas limitadas por el ancho de banda: el T4 resolvió el caso OpenFOAM drivAer de 3 millones de celdas en 293 segundos frente a los 556 del 7875 y los 826 de la Pro Precision 9 T2, mientras que la Pro Max Tower T2 no terminó dentro del límite de 150 minutos de la suite. El T4 también ejecutó el caso de 22.6 millones de celdas en 6,851 segundos.

GROMACS benchPEP, el caso de dinámica molecular de gran tamaño que utiliza todos los núcleos, se ejecutó a 1.243 ns/día en el T4 frente a 1.034 en el 7875, y la resolución LU alcanzó 1,660 GFLOPS frente a 1,172. y-cruncher calculó 10 mil millones de dígitos de Pi en 53.9 segundos frente a 83.7 en el 7875 y 25 mil millones en 155.6 segundos frente a 259.6. El cálculo denso que permanece en caché favorece al Threadripper, que lideró OpenBLAS DGEMM con 4,745 GFLOPS frente a 3,664.


Bases de datos y servicios
| Prueba | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Prueba en caliente de ClickBench, 43 consultas (s, cuanto menor sea el valor, mejor). | 3.21 | 2.88 | 4.80 | 10.44 |
| Prueba en frío de ClickBench, 43 consultas (cuanto menor sea el número, mejor). | 6.45 | 7.09 | 6.92 | 14.22 |
| Caché Valkey, CONJUNTO (solicitudes/s) | 666,714 | 1,138,696 | 914,832 | 1,719,108 |
| Caché Valkey, GET (solicitudes/s) | 865,353 | 1,279,429 | 991,576 | 1,648,278 |
| Stockfish, todos los hilos (Mnps) | 68.21 | 168.27 | 45.44 | 37.42 |
| PyPerformance go (ms, cuanto menor sea el valor, mejor) | 74.3 | 66.0 | 72.1 | 56.7 |
ClickHouse ejecutó las 43 consultas de ClickBench en 3.21 segundos en caliente y 6.45 segundos en frío en el T4, 0.33 segundos por detrás del 7875 en la ejecución en caliente y 0.64 segundos por delante en la ejecución en frío. Valkey favorece los núcleos rápidos sobre los núcleos múltiples, y las 666,714 solicitudes SET por segundo del T4 quedan por detrás de los tres sistemas de comparación, con el Core Ultra 9 285K en el Pro Max Tower T2 liderando con 1.72 millones. Este patrón coincide con los resultados de un solo hilo del T4 y es algo que vale la pena considerar para servicios limitados por la latencia.
Con los 172 hilos cargados y el procesador a una temperatura media de 87 °C, el T4 buscó 68.21 millones de nodos por segundo en Stockfish, 1.5 veces más que el Pro Precision 9 T2 de 48 hilos y bastante menos de la mitad de los 168.27 millones del 7875 con 192 hilos. La prueba también se agotó en la primera ejecución completa del T4 antes de que una nueva prueba independiente produjera esta cifra. Presentamos el resultado tal como se midió y no hemos aislado la causa de la baja escalabilidad.
Rendimiento de almacenamiento
| fio, huella de 25 GiB (cuanto mayor, mejor) | Dell Pro Precision 9 T4 | Dell Precision 7875 | Dell Pro Precision 9 T2 | Torre Dell Pro Max T2 |
|---|---|---|---|---|
| Lectura secuencial 128K (MB/s) | 14,152 | 7,089 | 20,914* | 7,234 |
| Escritura secuencial 128K (MB/s) | 10,078 | 5,265 | 12,564 | 6,772 |
| Lectura aleatoria 4K, pico (IOPS) | 2,306,346 | 993,569 | 3,214,066 | 1,538,387 |
| Escritura aleatoria 4K, pico (IOPS) | 1,830,776 | 787,388 | 2,353,766 | 1,326,030 |
*El sistema detectó una variación entre ejecuciones después de una nueva ejecución.
La unidad de arranque SK hynix Gen5 de 2 TB del T4 alcanzó una velocidad de lectura de 14 152 MB/s y de escritura de 10 078 MB/s, aproximadamente el doble de la lectura secuencial de las unidades Gen4 del Precision 7875 y del Pro Max Tower T2, con un pico de 2.31 millones de IOPS de lectura aleatoria y 1.83 millones de IOPS de escritura aleatoria. La lectura secuencial de 20 914 MB/s del Pro Precision 9 T2 supera la capacidad de un enlace Gen5 x4, lo que se ajusta al volumen de prueba del sistema, una matriz de discos Samsung PM9E1 Gen5 distribuidos. Probamos únicamente la unidad de arranque del T4; la segunda unidad de 2 TB no formó parte de esta prueba.

Temperaturas y relojes bajo carga
| Dell Pro Precision 9 T4 | CPU Máx. (C) | Media de CPU (C) | Frecuencia media de la CPU (MHz) |
|---|---|---|---|
| 7-Zip | 93 | 80.6 | 1,967 |
| Batidora de vaso - Blender | 91 | 85.7 | 2,587 |
| GROMACS | 96 | 81.3 | 1,313 |
| Compilación LLVM | 83 | 74.5 | 2,127 |
| AbrirBLAS | 80 | 62.9 | 1,325 |
| LLM al servicio de | 84 | 65.0 | 924 |
| Sintonia FINA | 71 | 61.2 | 854 |
| RAG a escala | 74 | 64.4 | 987 |
| Almacenaje | 64 | 55.4 | 942 |
Con la BIOS en modo Ultra Rendimiento, el Xeon 698X alcanzó un pico de 93 °C en 7-Zip y 96 °C en GROMACS, y las cifras de reloj en la tabla son promedios de las 172 CPU lógicas. Blender y Stockfish cargan todos los hilos y mantuvieron de 2.5 GHz a 2.6 GHz, por encima de la base de 2.0 GHz del chip. GROMACS y OpenBLAS cargan 64 y 86 núcleos físicos y dejan los hilos restantes inactivos cerca de 0.8 GHz, razón por la cual sus promedios leen alrededor de 1.3 GHz. El trabajo liderado por la GPU mantuvo el procesador más frío, con un promedio de 61 °C a 65 °C durante el servicio LLM, el ajuste fino y RAG, ya que esas pruebas dependen de las tarjetas.

Conclusión
El Dell Pro Precision 9 T4 está diseñado para el trabajo local de IA, y la segunda RTX PRO 6000 es donde se nota. Dos tarjetas Max-Q aumentaron el rendimiento máximo de servicio de 1.85 a 2.02 veces en cuatro modelos y el rendimiento de incrustación 1.92 veces, redujeron una época LoRA en Ministral 3 8B de 31.5 a 19.7 minutos, y convirtieron MiniMax M2.7, un modelo demasiado grande para una sola tarjeta, de 30.3 a 83.7 tokens por segundo para un solo usuario. En gpt-oss 120B, un servidor por GPU alcanzó un total de 7,091 tokens por segundo en 64 solicitudes, mientras que dividir el modelo entre ambas tarjetas devolvió el primer token de un solo usuario en 719 ms en lugar de 1,189 ms.

Ocho canales de DDR5-6400 le dieron al Xeon 698X un 53 % más de ancho de banda de memoria que al Threadripper PRO 9995WX. Ese ancho de banda permitió que el T4 obtuviera resultados más rápidos en OpenFOAM, GROMACS benchPEP, y-cruncher y en las búsquedas de HNSW que el Precision 7875, y el almacenamiento Gen5 del T4 cargaba modelos grandes más rápido. El chasis también merece reconocimiento, con el mejor sistema de refrigeración que hemos visto de Dell en esta categoría y acceso sin herramientas a la fuente de alimentación.
El 7875 sigue aventajando en renderizado, compresión y compilación con núcleos limitados entre un 18 y un 38 por ciento, y en un 60 por ciento en SVT-AV1. La velocidad por núcleo del Xeon fue inferior a la de todos los sistemas de este grupo, lo que se evidenció en Valkey y otros servicios con pocos hilos. El ajuste fino en una sola GPU también fue más lento en el T4, donde la época de LoRA tardó 31.5 minutos frente a los 27.2 del 7875 y los 22.3 de la tarjeta de 600 W en la Pro Max Tower T2, con todos los sistemas terminando dentro de 0.005 de la misma pérdida reservada.
Con un precio aproximado de 66,600 dólares en la configuración que se ofrece en Dell.com, la T4 es ideal para equipos que desean ejecutar, integrar y optimizar modelos en sus propias instalaciones, incluyendo modelos que requieren más de 96 GB de memoria GPU, además de realizar simulaciones y análisis que consumen mucha memoria en la misma máquina. Los usuarios cuyo trabajo se centra principalmente en el renderizado y la compilación encontrarán que la plataforma Threadripper es más rápida, y quienes necesiten una sola GPU pueden obtener la misma tarjeta en la Pro Precision 9 T2, de menor tamaño.

Clasificación: La Dell Pro Precision 9 T4 ocupa el primer puesto como la mejor torre Xeon para IA local en nuestra clasificación de los mejores ordenadores de sobremesa para IA local.


 Amazon