

L'événement Advancing AI 2026 a été le plus important jamais organisé par AMD, un lancement si majeur que nous avons dû scinder notre couverture en deux. Notre premier article était consacré à l'Instinct MI455X et au rack Helios à 72 GPU ; ce second article, complémentaire, aborde les éléments qui ne pouvaient être traités simultanément : les processeurs serveurs EPYC de 6e génération, nom de code Venice, et le processeur hôte Verano. Le processeur Venice mérite un article à lui seul. Il offre jusqu'à 256 cœurs et 512 threads par socket, une bande passante mémoire de 1.6 To/s, la première interface PCIe Gen 6 intégrée à un processeur serveur, et un débit 18 fois supérieur à celui de la première génération d'EPYC de 2017.
Venice n'est pas un simple processeur, mais une gamme de processeurs, un point qu'AMD a répété à chaque session : un seul profil de CPU ne peut convenir à tous les besoins. La même génération Zen 6 se décline en un processeur haute densité, un processeur pour entreprises, un processeur HPC à cache empilé et un processeur basse consommation LPDDR. Avant d'aborder les performances et les caractéristiques techniques, examinons donc la gamme.
La programmation de Venise et de Verano
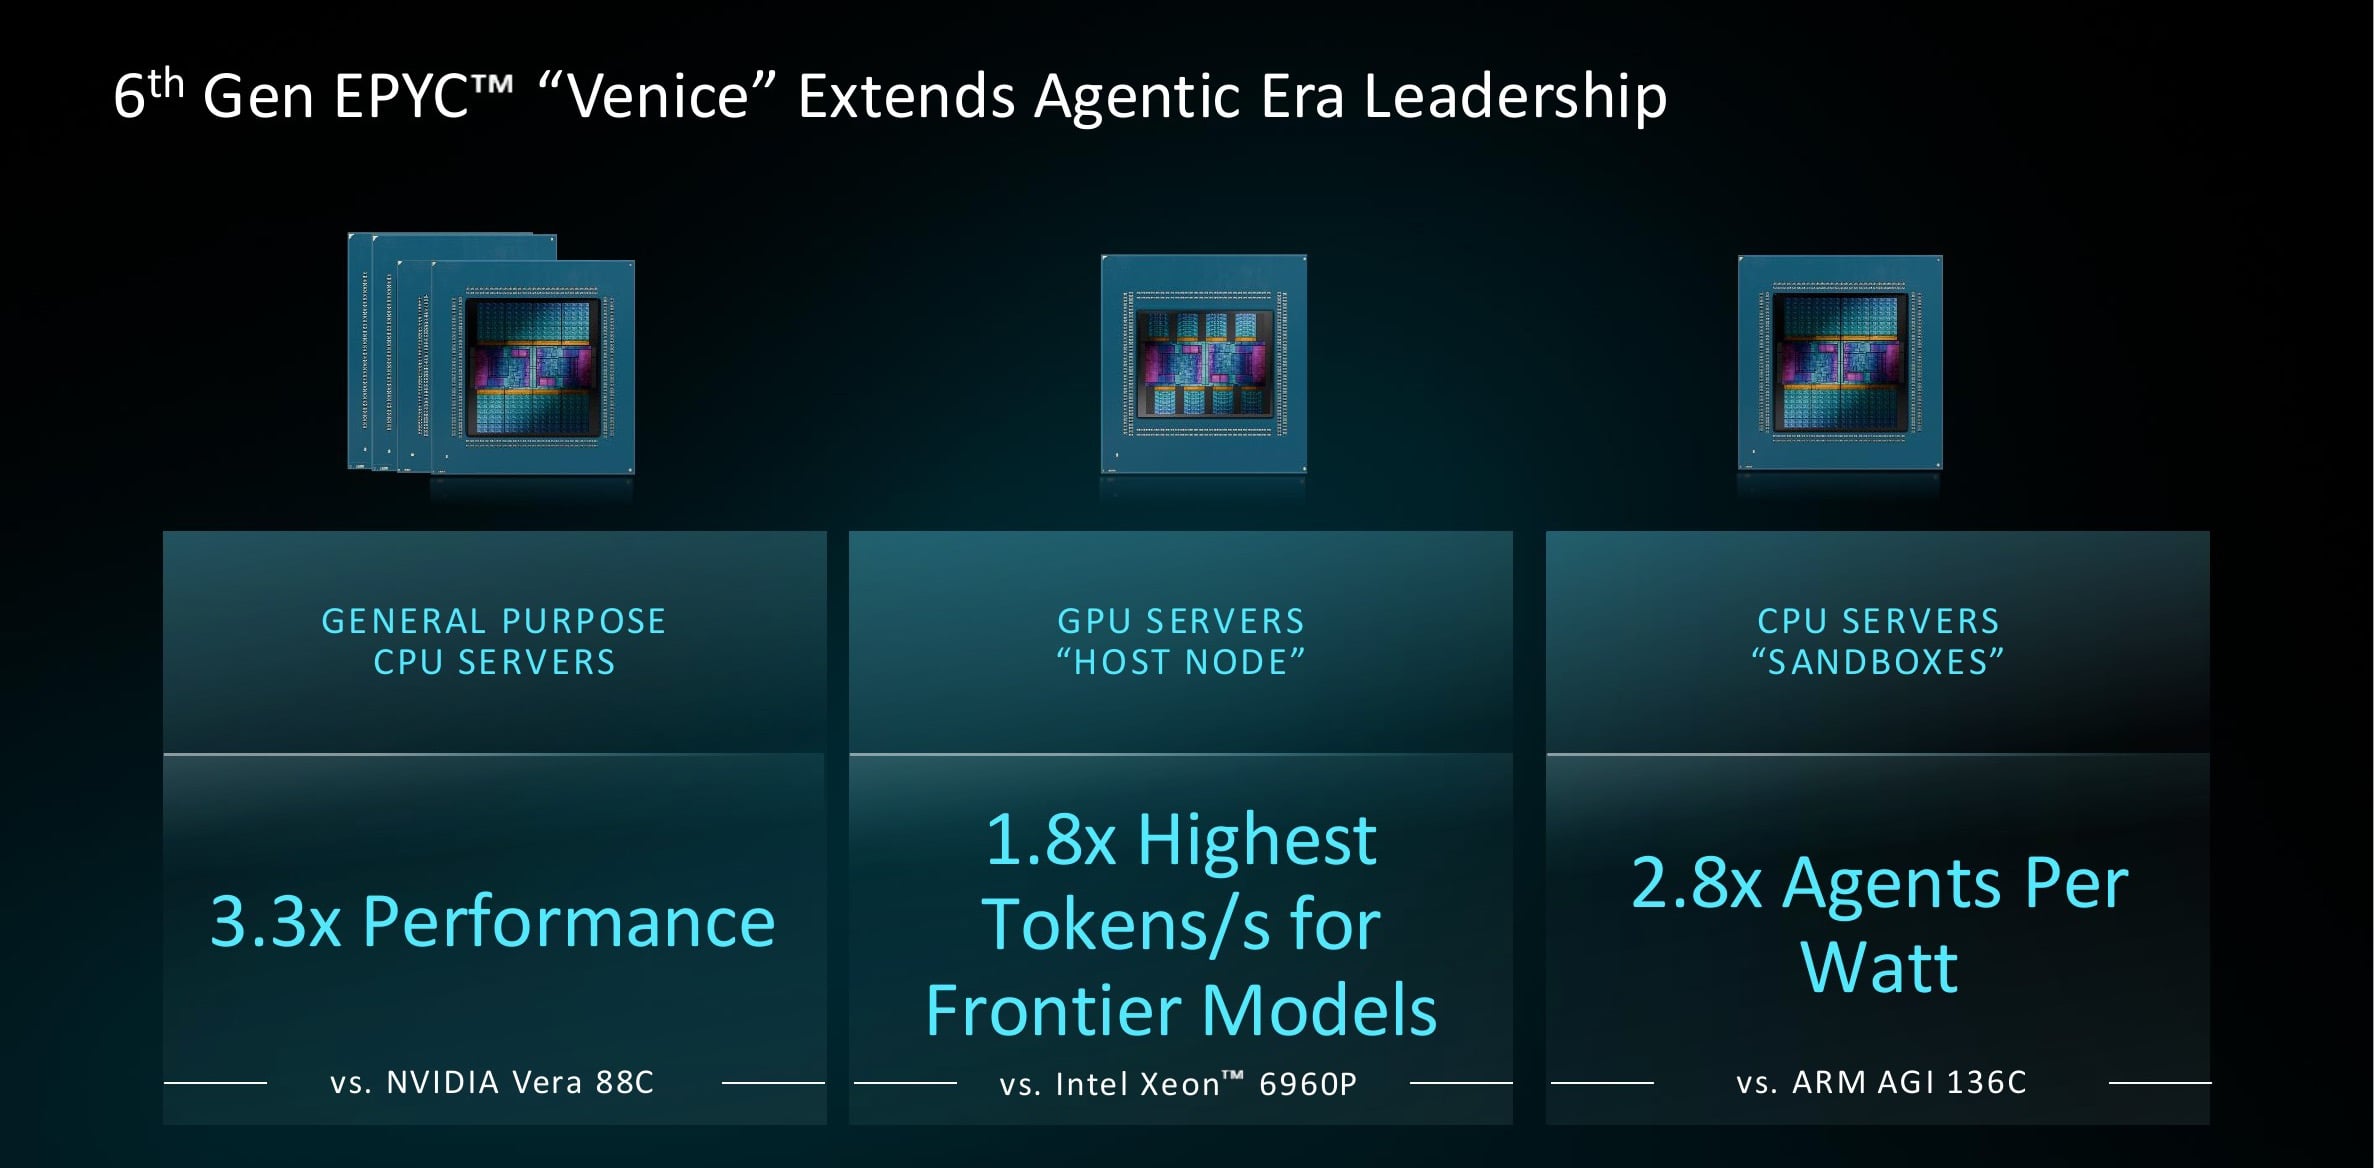
AMD classe les serveurs des datacenters modernes en trois catégories, et son offre est conçue pour répondre à tous les besoins. Les serveurs CPU à usage général gèrent les passerelles web, les caches, les couches applicatives, les bases de données et le stockage, éléments essentiels au fonctionnement de l'ensemble du système. Les serveurs GPU nécessitent un processeur hôte pour alimenter les accélérateurs ; dans ce cas, la vitesse monocœur et la bande passante d'E/S priment sur le nombre de cœurs. La troisième catégorie regroupe les serveurs CPU haute densité destinés à l'orchestration et à l'exécution des outils qui se sont développés autour des services d'IA ; ce code, riche en branches et sujet aux blocages, requiert avant tout un grand nombre de threads.
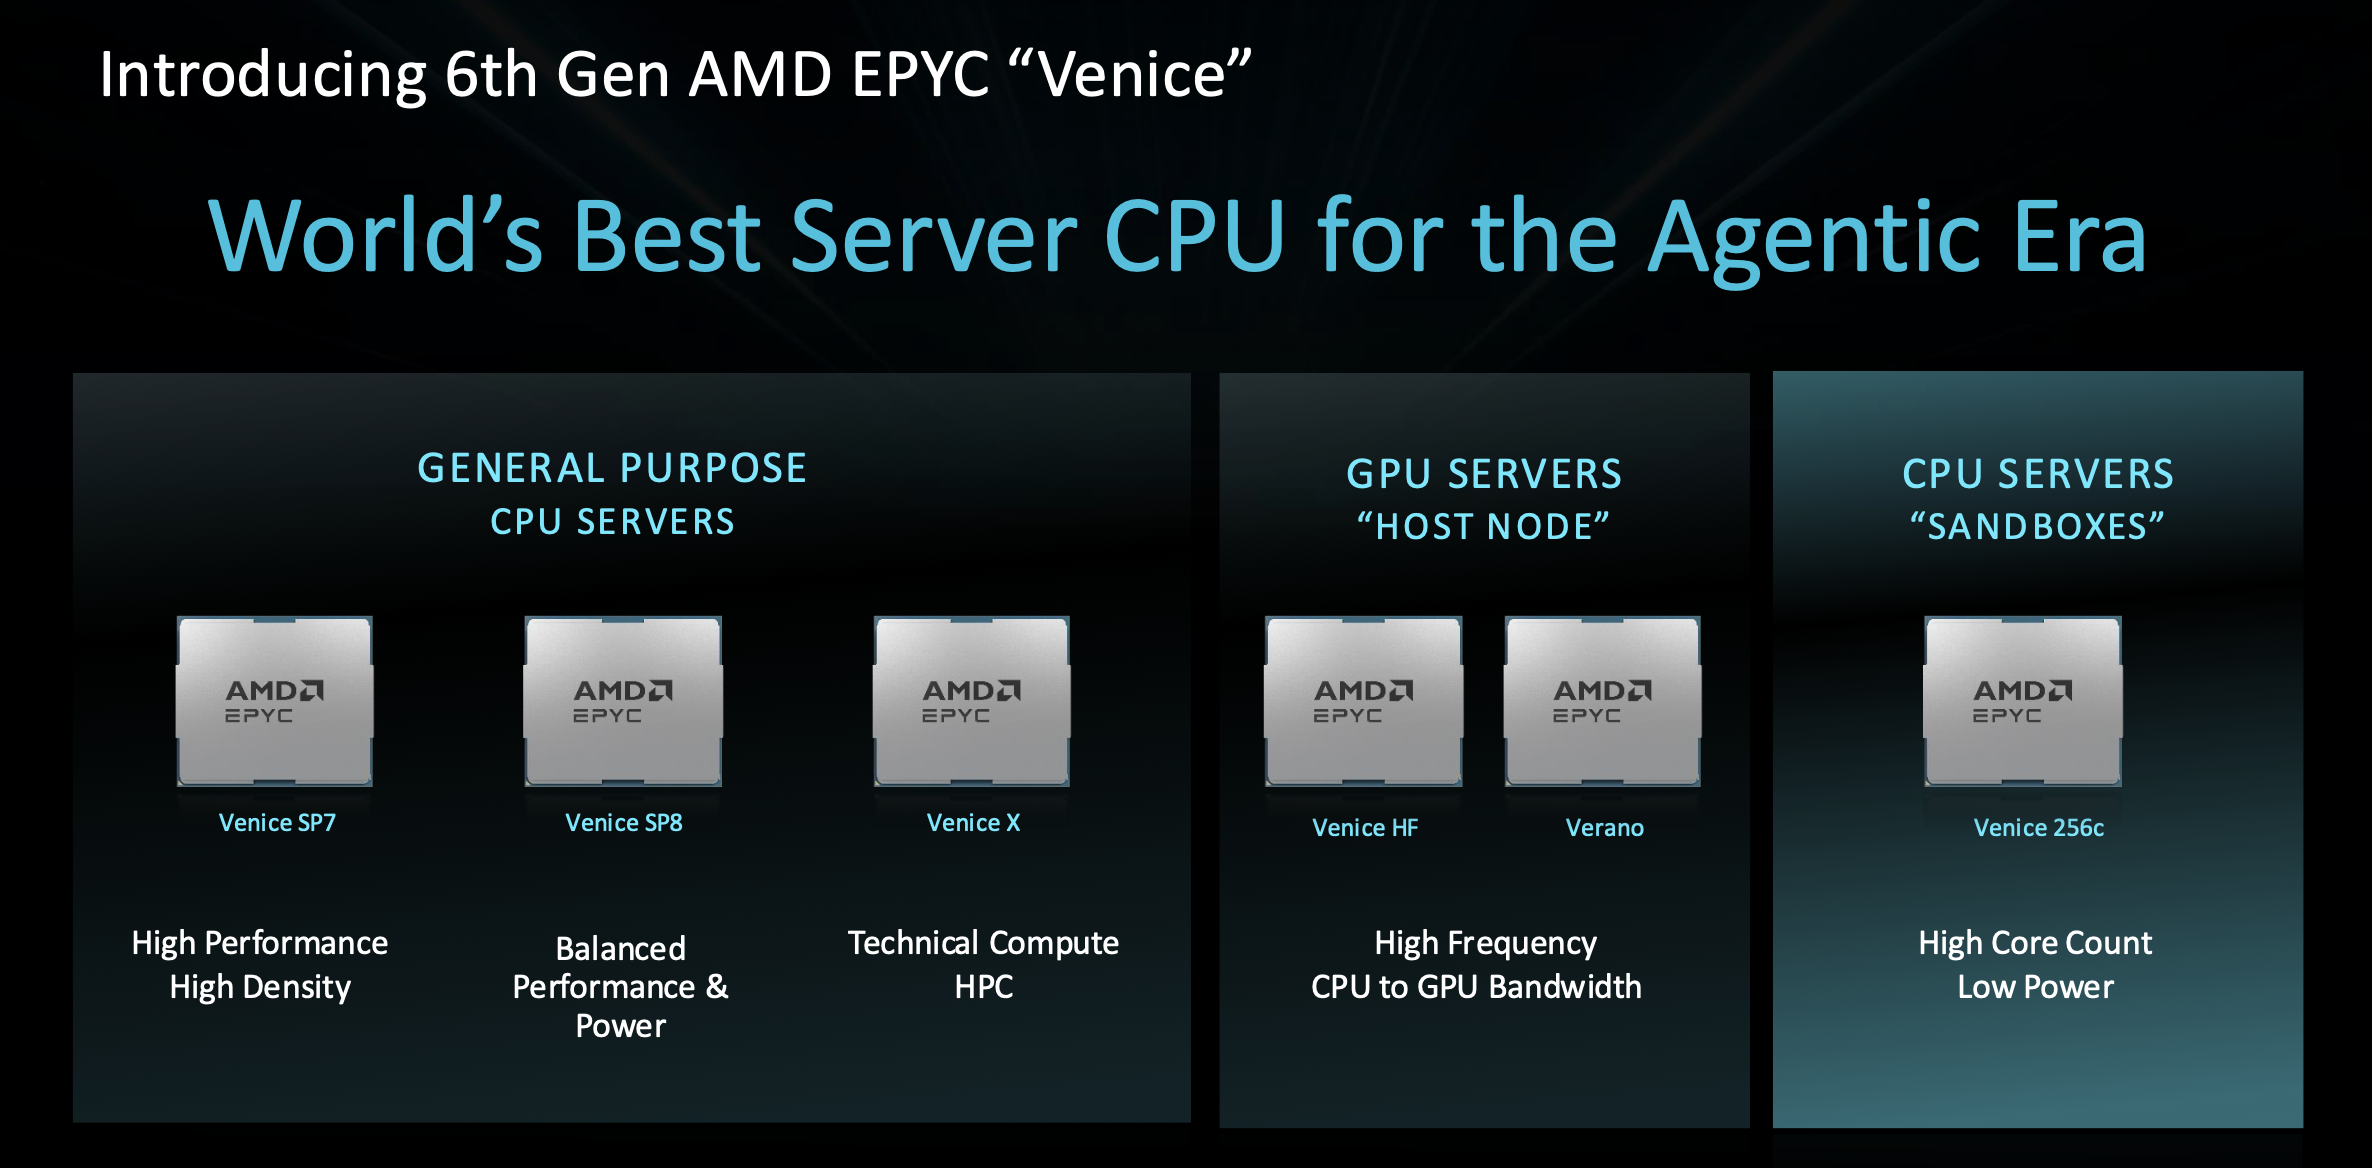
La gamme se compose de quatre produits, déployés progressivement : Venice SP7 au quatrième trimestre 2026, Venice SP8 au premier semestre 2027, et Venice-X et Verano au second semestre. AMD décline la même puce en six versions, les plus performantes étant réparties en trois niveaux. La version à usage général comprend Venice SP7, SP8 et Venice-X. La version hôte associe un processeur Venice haute fréquence à Verano et sa mémoire LPDDR. La version pour le calcul haute densité est équipée du Venice 256c : un processeur à grand nombre de cœurs et faible consommation, conçu pour optimiser le nombre de threads dans un rack en fonction de la consommation énergétique. Verano peut également être utilisé comme processeur à usage général : AMD indique que certains clients l'utiliseront lorsque le rapport performances/watt est un critère déterminant.
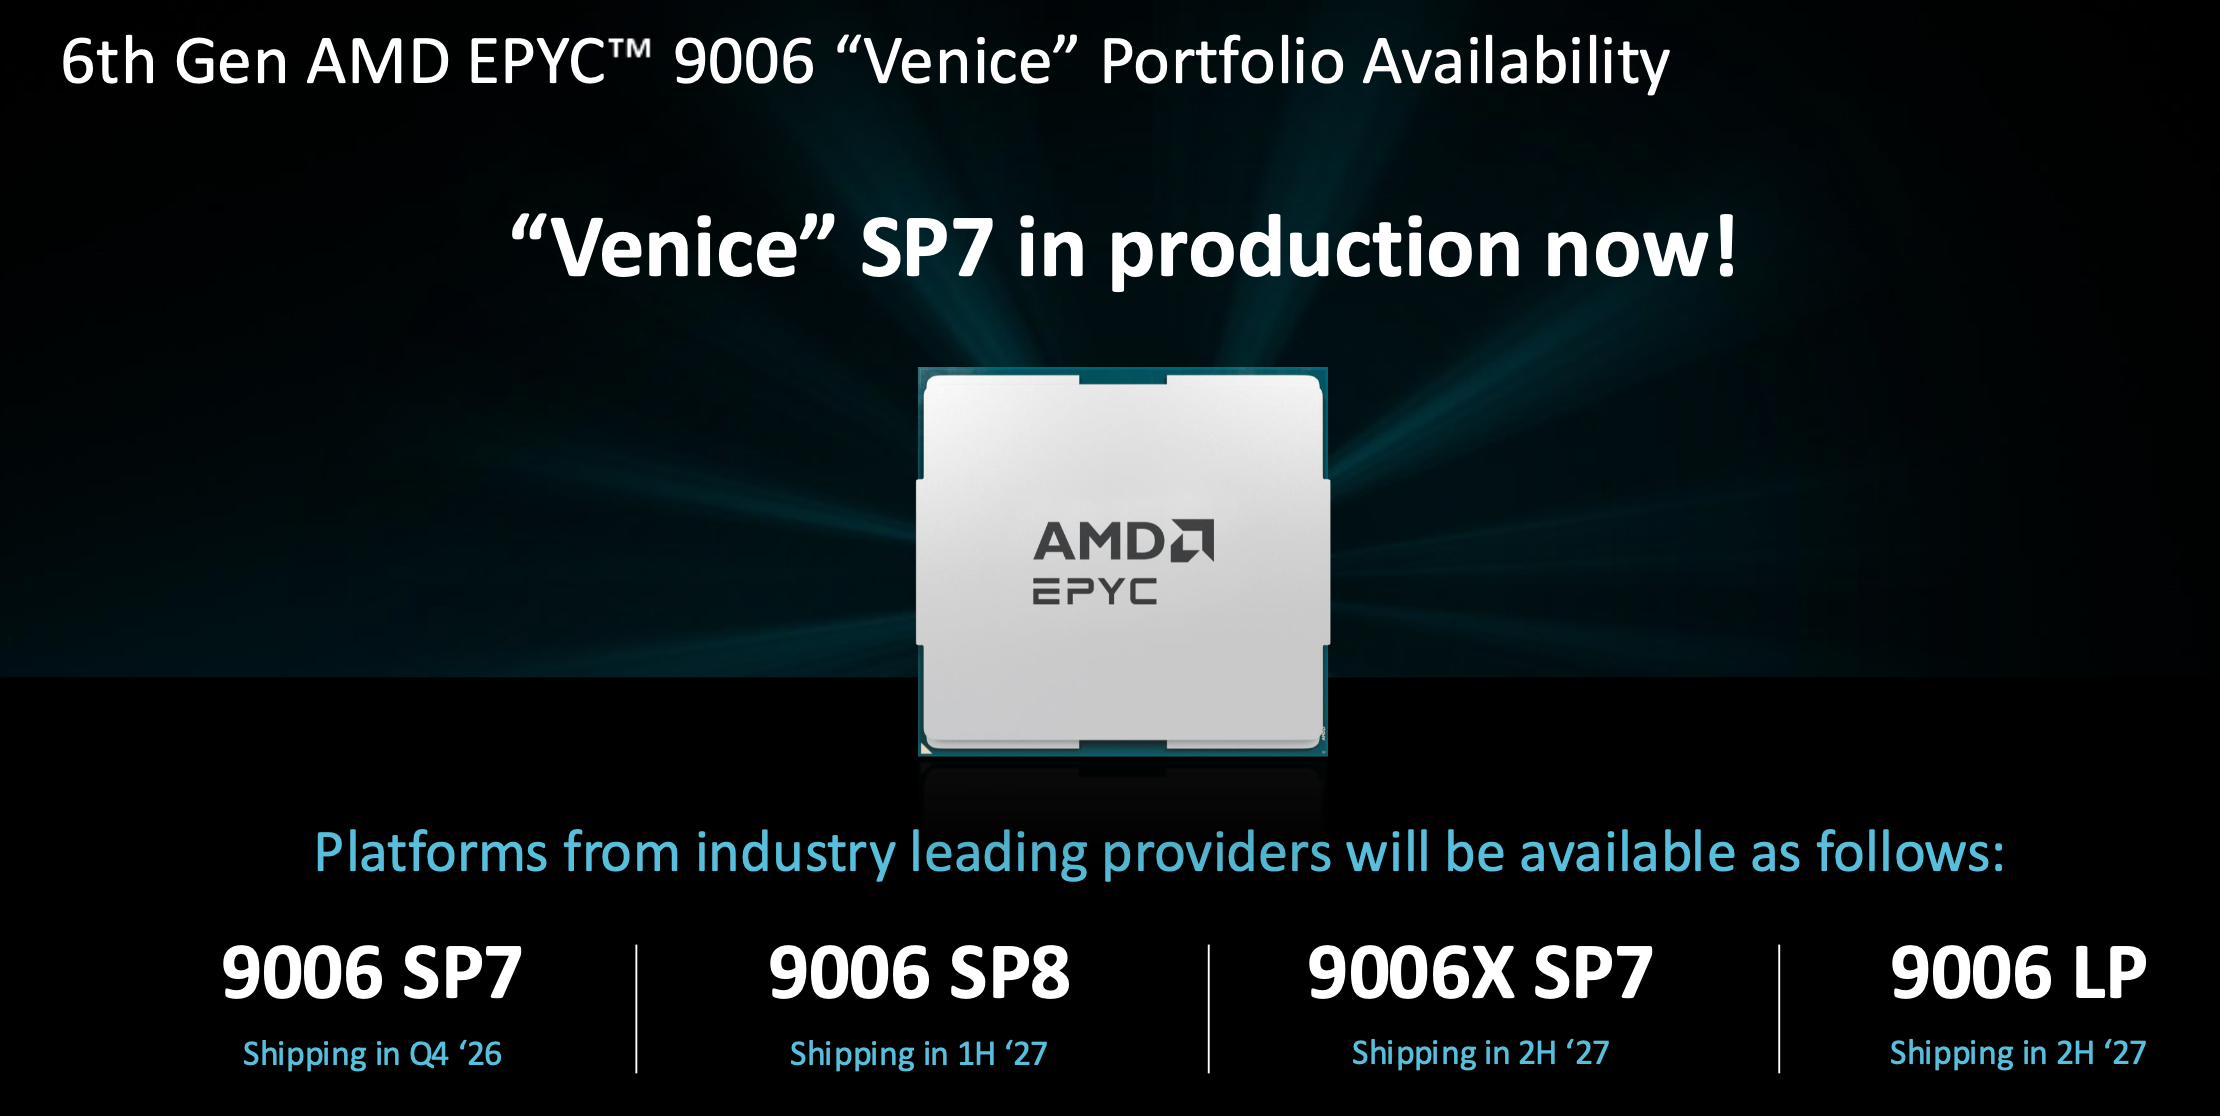
Les notes de bas de page nous donnent un aperçu des références. Le processeur EPYC 9996 à 256 cœurs est le fleuron de la gamme, le 9956 offre le même nombre de cœurs avec une consommation de 400 W, et le 9686F à 96 cœurs est le processeur hôte haute fréquence. Helios intègre sa propre version de ce processeur hôte, l'EPYC 9G76, dans chaque plateau de calcul.
Le niveau sans compromis
Avant de présenter les tableaux de spécifications, un mot sur l'emplacement du socket haut de gamme. Le Venice SP7 est réservé aux performances exceptionnelles sans compromis d'AMD : centres de données, hyperscalers et déploiements de calcul HPC, où le débit par rack est primordial et où aucun effort n'est épargné. Les fabricants de serveurs adaptent déjà leur offre en conséquence. Dell a scindé sa gamme PowerEdge, établie de longue date, pour lui faire une place, et cette catégorie de serveurs est désormais intégrée à la nouvelle série 9000, dont les fleurons sont les PowerEdge R9825 et Rack Scale M9825, équipés de deux puces Venice dans un châssis 3U.
Caractéristiques principales
Toute la famille construit sur une même plateforme, et presque chaque recoin est nouveau depuis Turin.
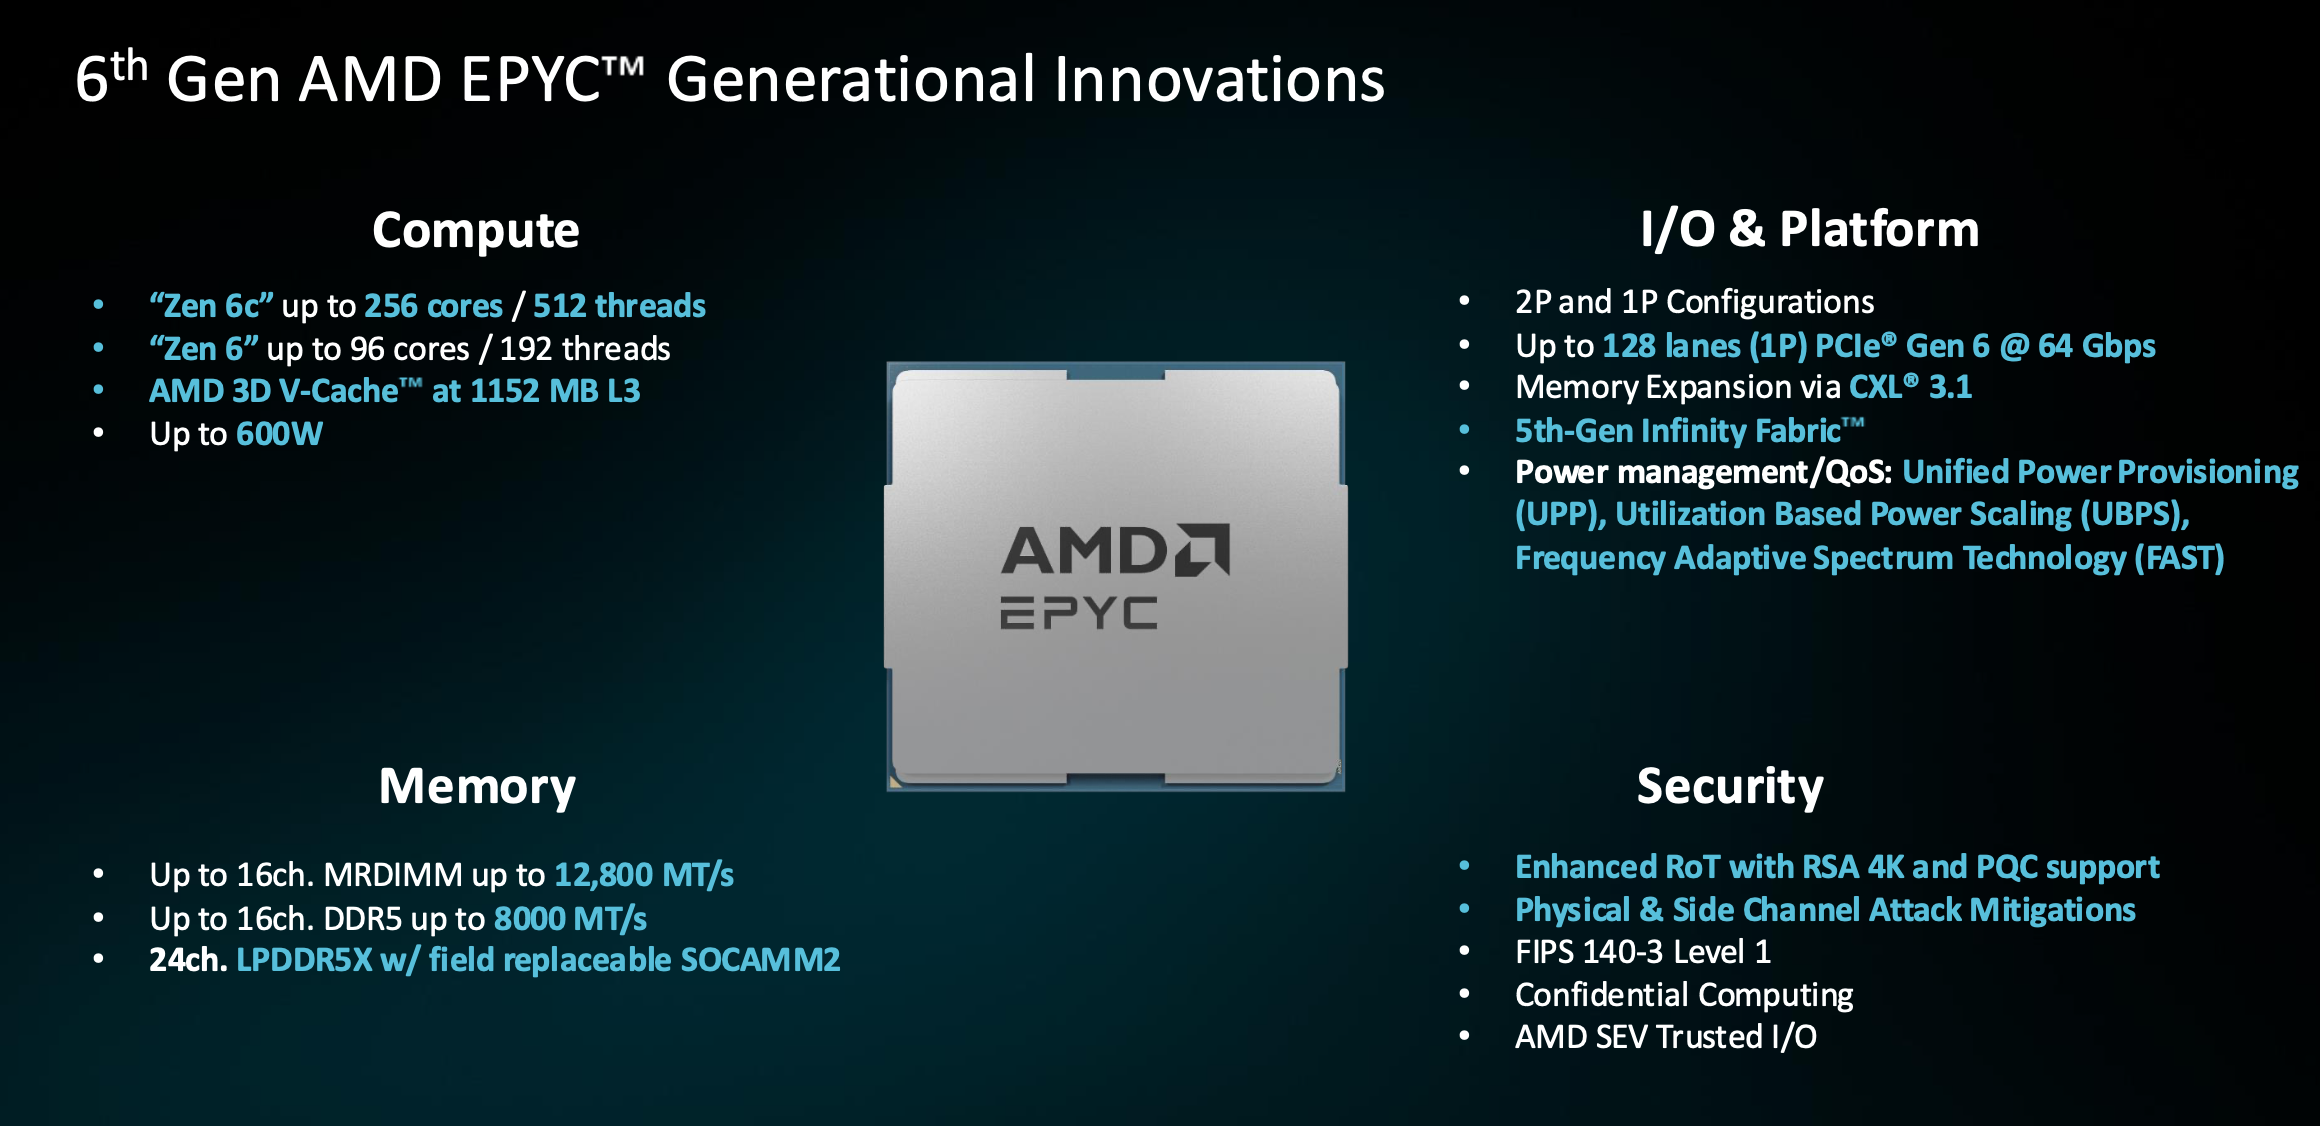
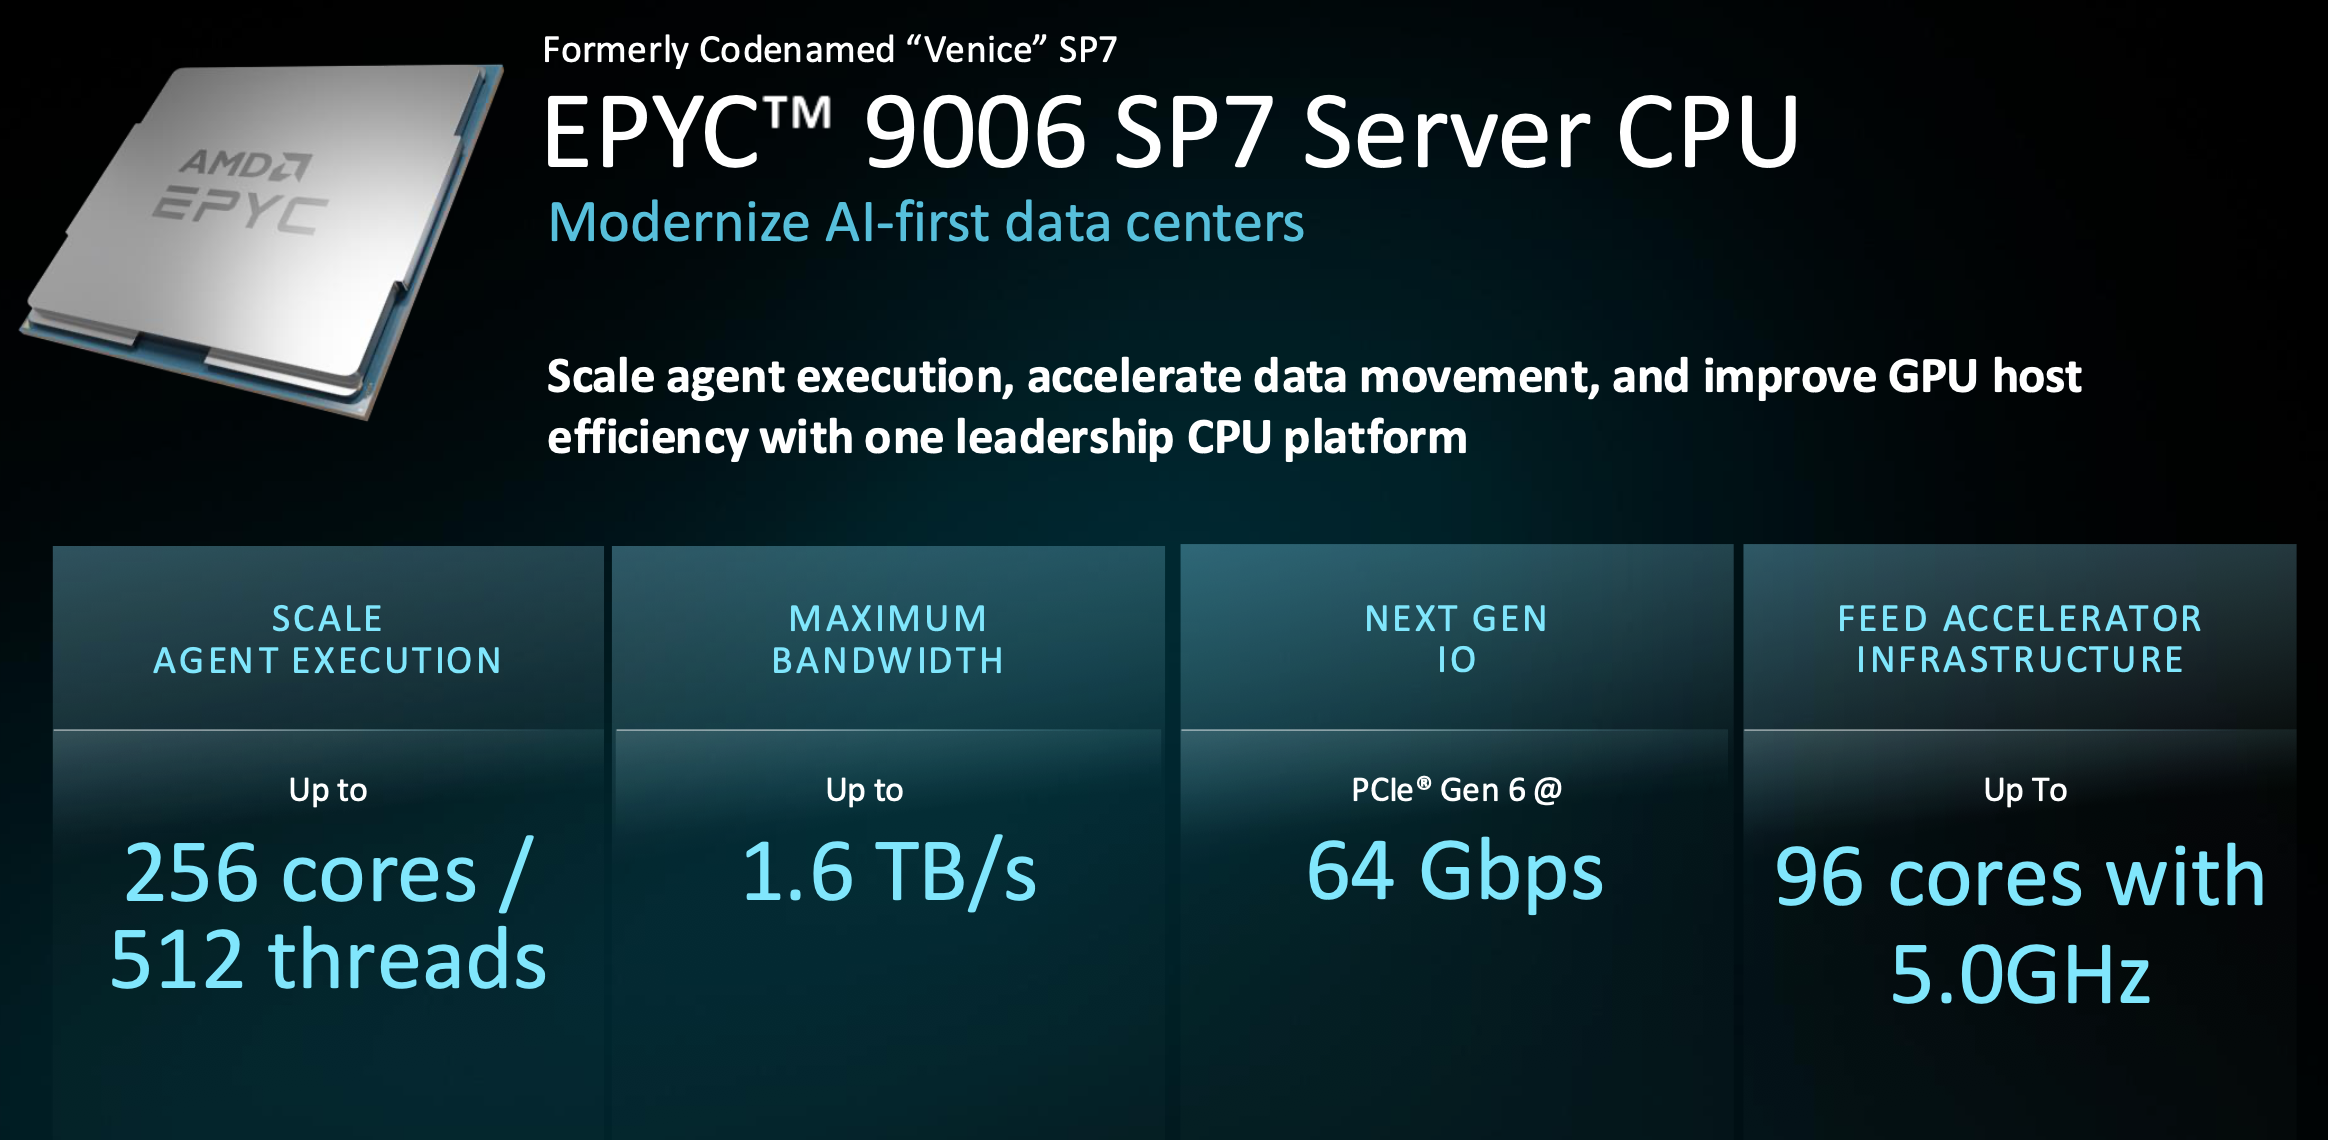
Commençons par les cœurs. Zen 6 se décline en deux versions : le Zen 6c compact intègre 256 cœurs et 512 threads sur un socket, avec une consommation maximale de 600 W, tandis que la version standard se limite à 96 cœurs mais atteint une fréquence de 5 GHz. AMD revendique des performances par cœur supérieures de plus de 20 % à celles des processeurs concurrents à nombre de cœurs égal, et la densité accrue n’affecte pas la taille du cache : même la puce à 256 cœurs conserve environ 4 Mo de cache L3 par cœur, soit un gigaoctet sur le modèle haut de gamme. AVX-512 gère les tokeniseurs et les modèles à 3 à 8 milliards de paramètres qui s’exécutent de plus en plus directement sur le processeur.
L'alimentation de ces cœurs exige un système mémoire bien plus important : 16 canaux DDR5 à 8 000 MT/s, ou MRDIMM à 12 800 MT/s, soit 1.6 To/s par socket, tandis que Turin atteignait 614 Go/s avec 12 canaux. Les E/S connaissent le même bond en avant. Venice est le premier processeur serveur équipé de PCIe Gen 6, avec 128 lignes à 64 GT/s, soit le double de la bande passante par ligne de tout autre processeur connecté à des accélérateurs actuellement disponible. C'est le fondement de l'argument du nœud hôte que nous détaillerons plus loin. CXL 3.1 exploite ces lignes pour l'extension de mémoire, et certaines plateformes hôtes IA bi-sockets sacrifient la largeur xGMI inter-sockets au profit des E/S pour atteindre 160 lignes utilisables. Deux ajouts plus discrets déplacent les données sans solliciter les cœurs : SDXI décharge les copies de mémoire et l’équivalent de 30 à 50 cœurs de chiffrement, et Smart Data Cache Injection dépose les paquets réseau directement dans le cache au lieu de les acheminer via la DRAM.
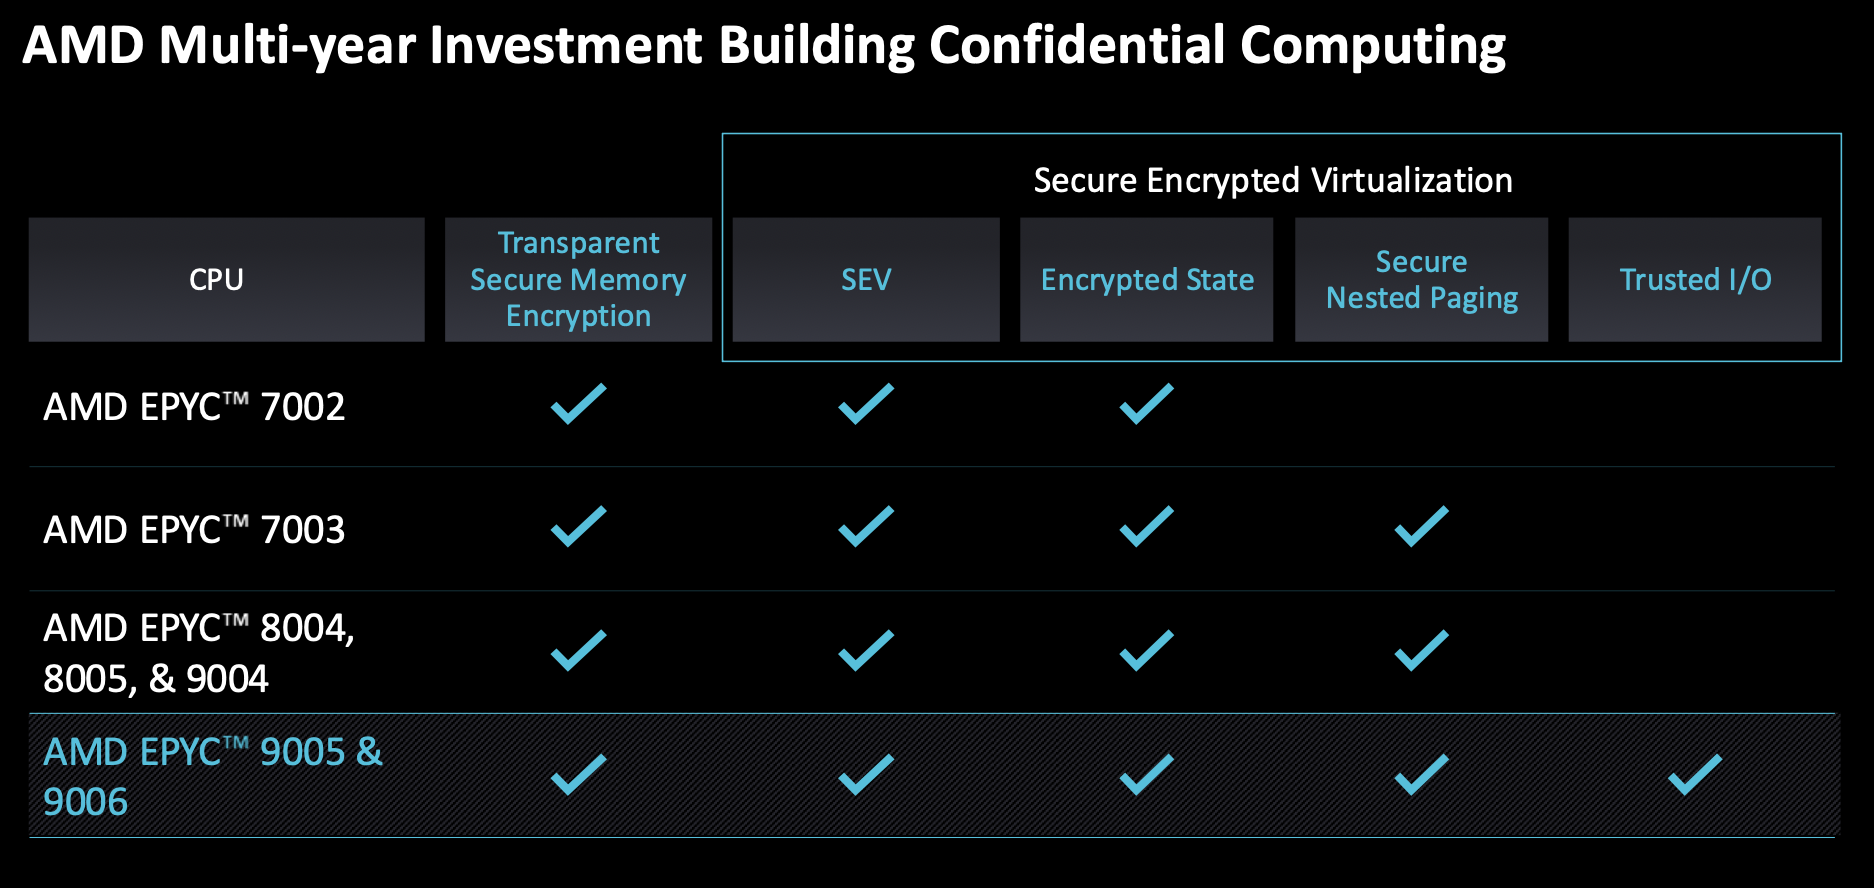
La gestion de l'alimentation bénéficie de trois nouveaux paramètres essentiels, car chaque comparaison de racks effectuée par AMD se fait dans le cadre d'un budget énergétique. UPP fusionne les budgets SoC et DIMM en un seul : une charge de travail gourmande en mémoire transfère de la puissance vers les DIMM, tandis qu'une charge de travail gourmande en calcul la réduit. Ceci permet soit d'améliorer les performances dans un budget donné, soit de libérer de la puissance pour davantage de nœuds. UBPS plafonne la consommation en cas de faible utilisation, privilégiant une courbe de charge stable et prévisible au détriment du gain de performances habituel en charge légère ; les opérateurs qui préfèrent ce gain peuvent le désactiver. FAST divise un SoC en deux : les cœurs prioritaires fonctionnent à haute fréquence tandis que les cœurs d'arrière-plan fonctionnent à une fréquence plus basse, afin que les tâches critiques en termes de latence, partageant un socket avec des traitements par lots, ne soient pas pénalisées.
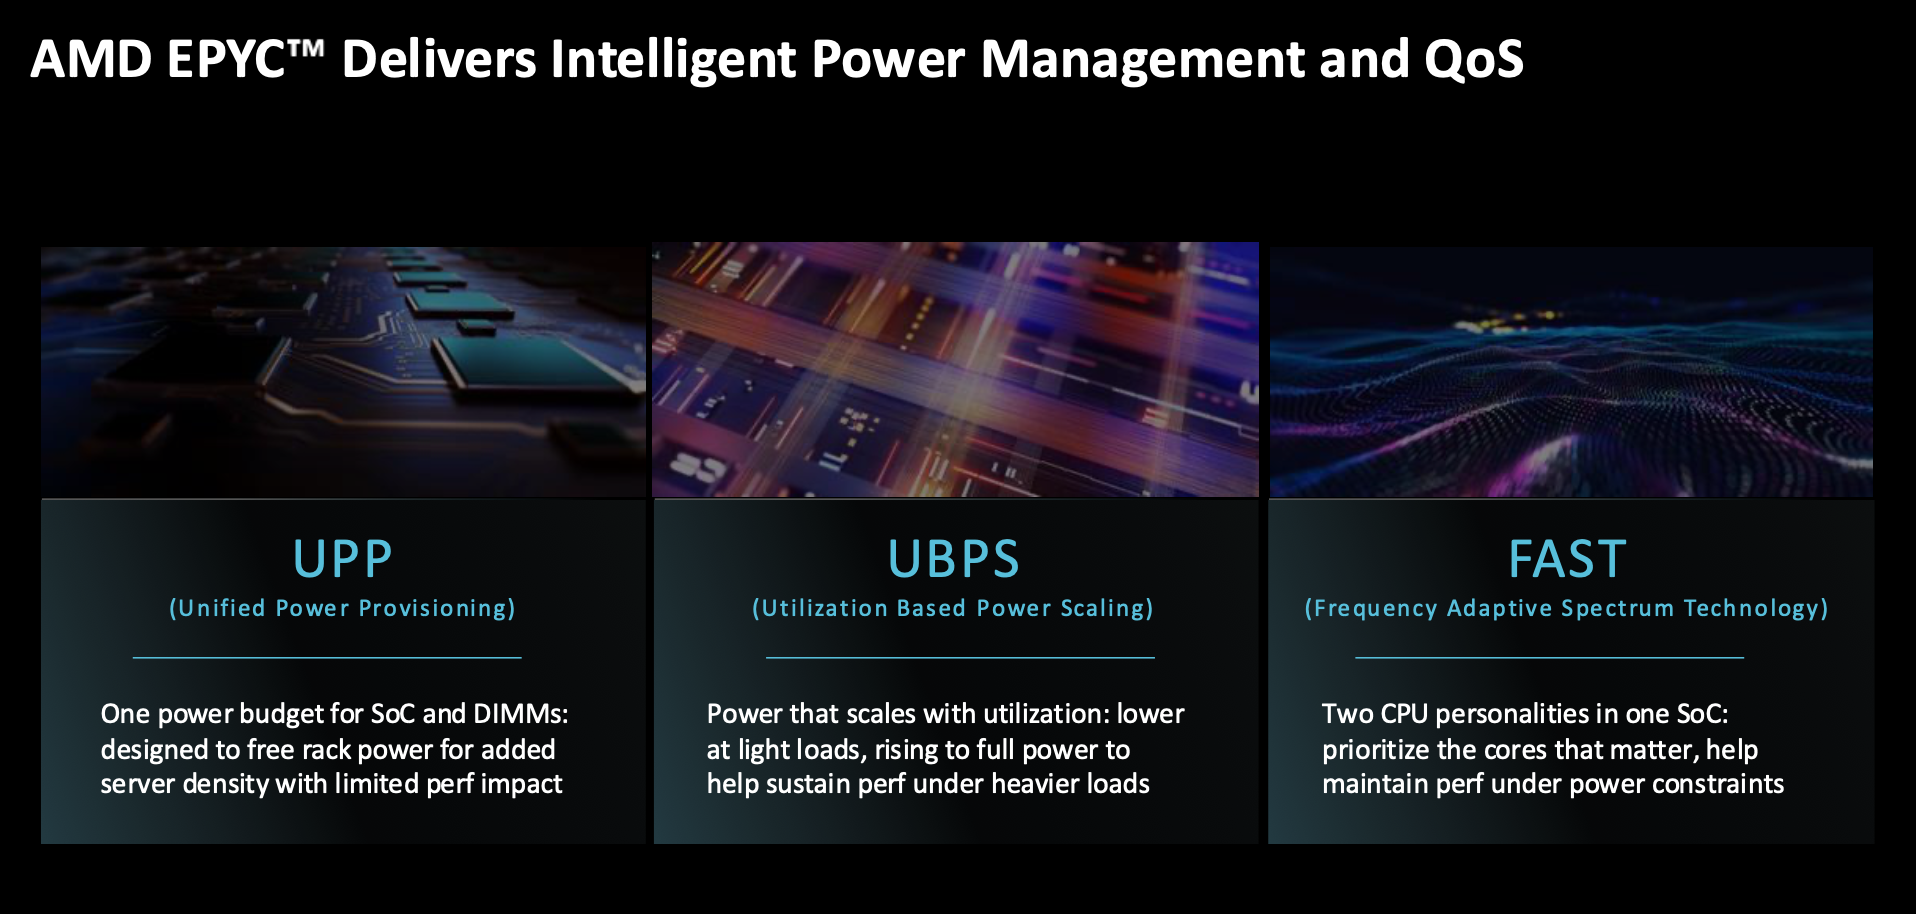
En matière de sécurité, Venice s'inscrit dans la continuité d'une technologie de calcul confidentielle héritée de SEV sur EPYC 7002, en passant par l'état chiffré, la pagination imbriquée sécurisée et les E/S de confiance introduites avec Turin. Nouveautés de cette génération : une racine de confiance renforcée avec RSA-4K et des algorithmes post-quantiques, des protections contre les attaques physiques et par canaux auxiliaires, la certification FIPS 140-3 niveau 1 et Device Provenance, un historique de fabrication traçable dont Venice sera parmi les premiers produits AMD à bénéficier.
À l'intérieur du portefeuille
Les quatre parties diffèrent davantage que leur nom commun ne le suggère.
| Spécifications | 9006 SP7 | 9006 SP8 | 9006X SP7 | 9006 LP « Verano » |
|---|---|---|---|---|
| Coloré | Jusqu'à 256 (512 threads) | 8 à 128 ans, qui | Jusqu'à 96 | Jusqu'à 72 |
| Fréquence de crête | 5.0 GHz avec 96 cœurs (HF) | Options HF proposées | ~ 5.15GHz | Jusqu'à 5.0GHz |
| Mémoire | 16 canaux, jusqu'à 1.6 To/s | 8 canaux avec 2 DIMM par canal | 16 canaux MRDIMM à 12 800 MT/s | 24 canaux LPDDR5X, SOCAMM2 |
| cache L3 | Jusqu'à 1024MB | Dépendance du nombre de carottes | 1152 Mo (cache virtuel 3D) | Dépendance du nombre de carottes |
| I / O | PCIe Gen 6, 128 lignes 1P | 128 lignes PCIe, 1P et 2P | PCIe génération 6 | xGMI amélioré à 112 GT/s |
| Destiné à | Densité hyperscale, hôte IA | Entreprise, périphérie, compatible NEBS | HPC, prétraitement IA | Hôte d'IA à l'échelle du rack |
EPYC 9006 SP7
Le socket SP7 est le modèle phare et celui actuellement en production ; les plateformes partenaires suivront au quatrième trimestre. Ses processeurs haute fréquence succèdent aux composants Turin HF, qui, selon AMD, ont connu une croissance parmi les plus rapides. Leur principal déploiement est Helios, où le processeur hôte de chaque baie de calcul est connecté au domaine mémoire cohérent du rack via Infinity Fabric, avec 1 To de DDR5. Le socket étant standard, tous les processeurs SP7, jusqu'au modèle phare à 256 cœurs, sont compatibles, comme nous l'avons expliqué dans l'article précédent.
EPYC 9006 SP8
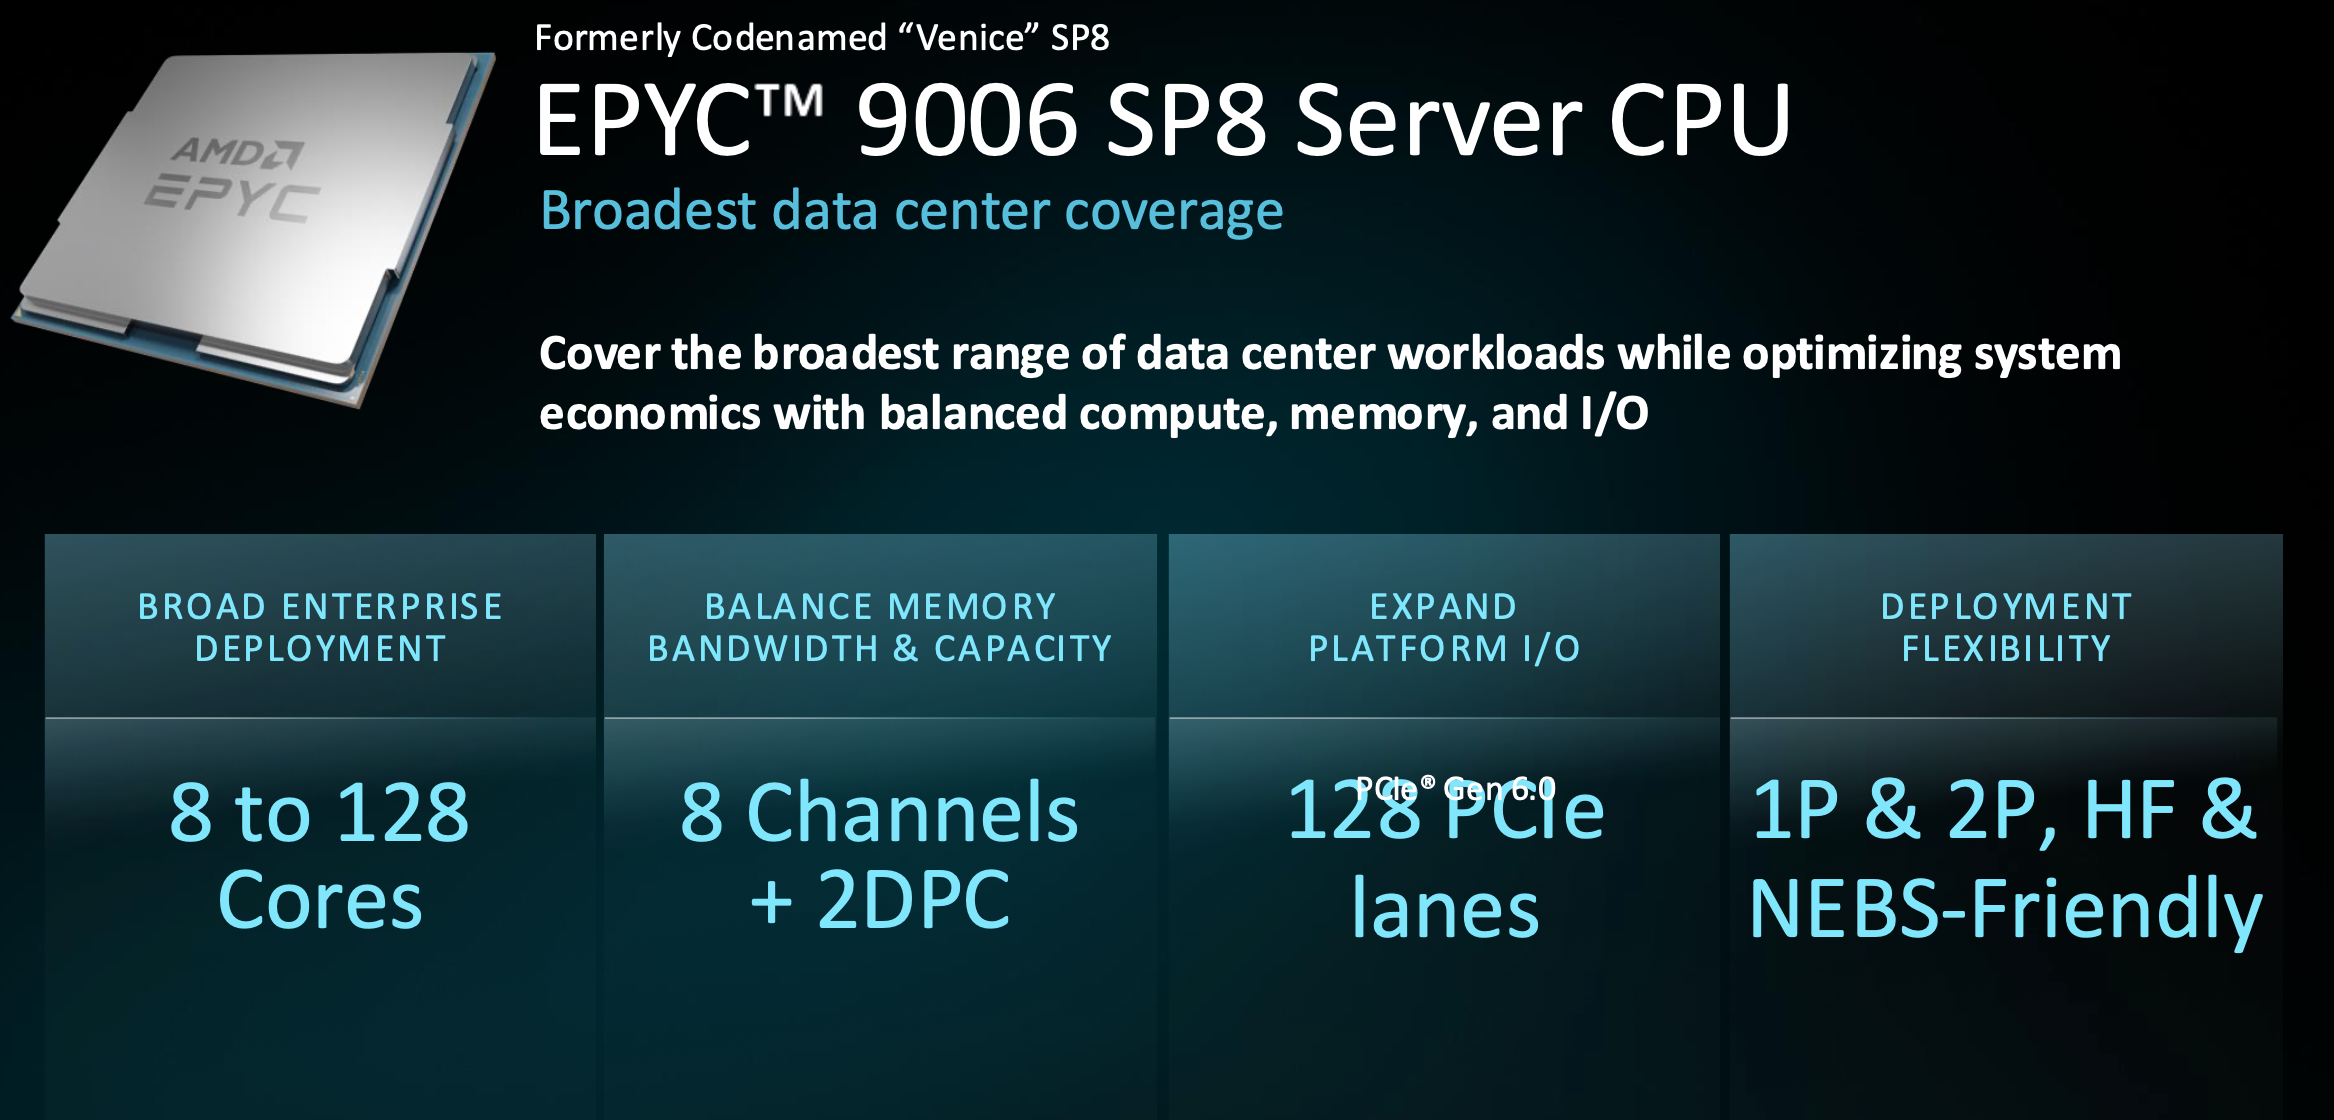
Le SP8 privilégie l'économie d'échelle au détriment du socket géant. Il offre de 8 à 128 cœurs, 8 canaux mémoire avec 2 barrettes DIMM par canal, 128 lignes PCIe et se décline en versions 1P et 2P avec des options haute fréquence et compatibles NEBS pour les déploiements télécoms et en périphérie de réseau. AMD mise sur des performances adaptées aux besoins des entreprises, où le critère déterminant pour conclure des contrats est le rapport performances/prix plutôt que le coût par rack.
EPYC 9006X « Venice-X »
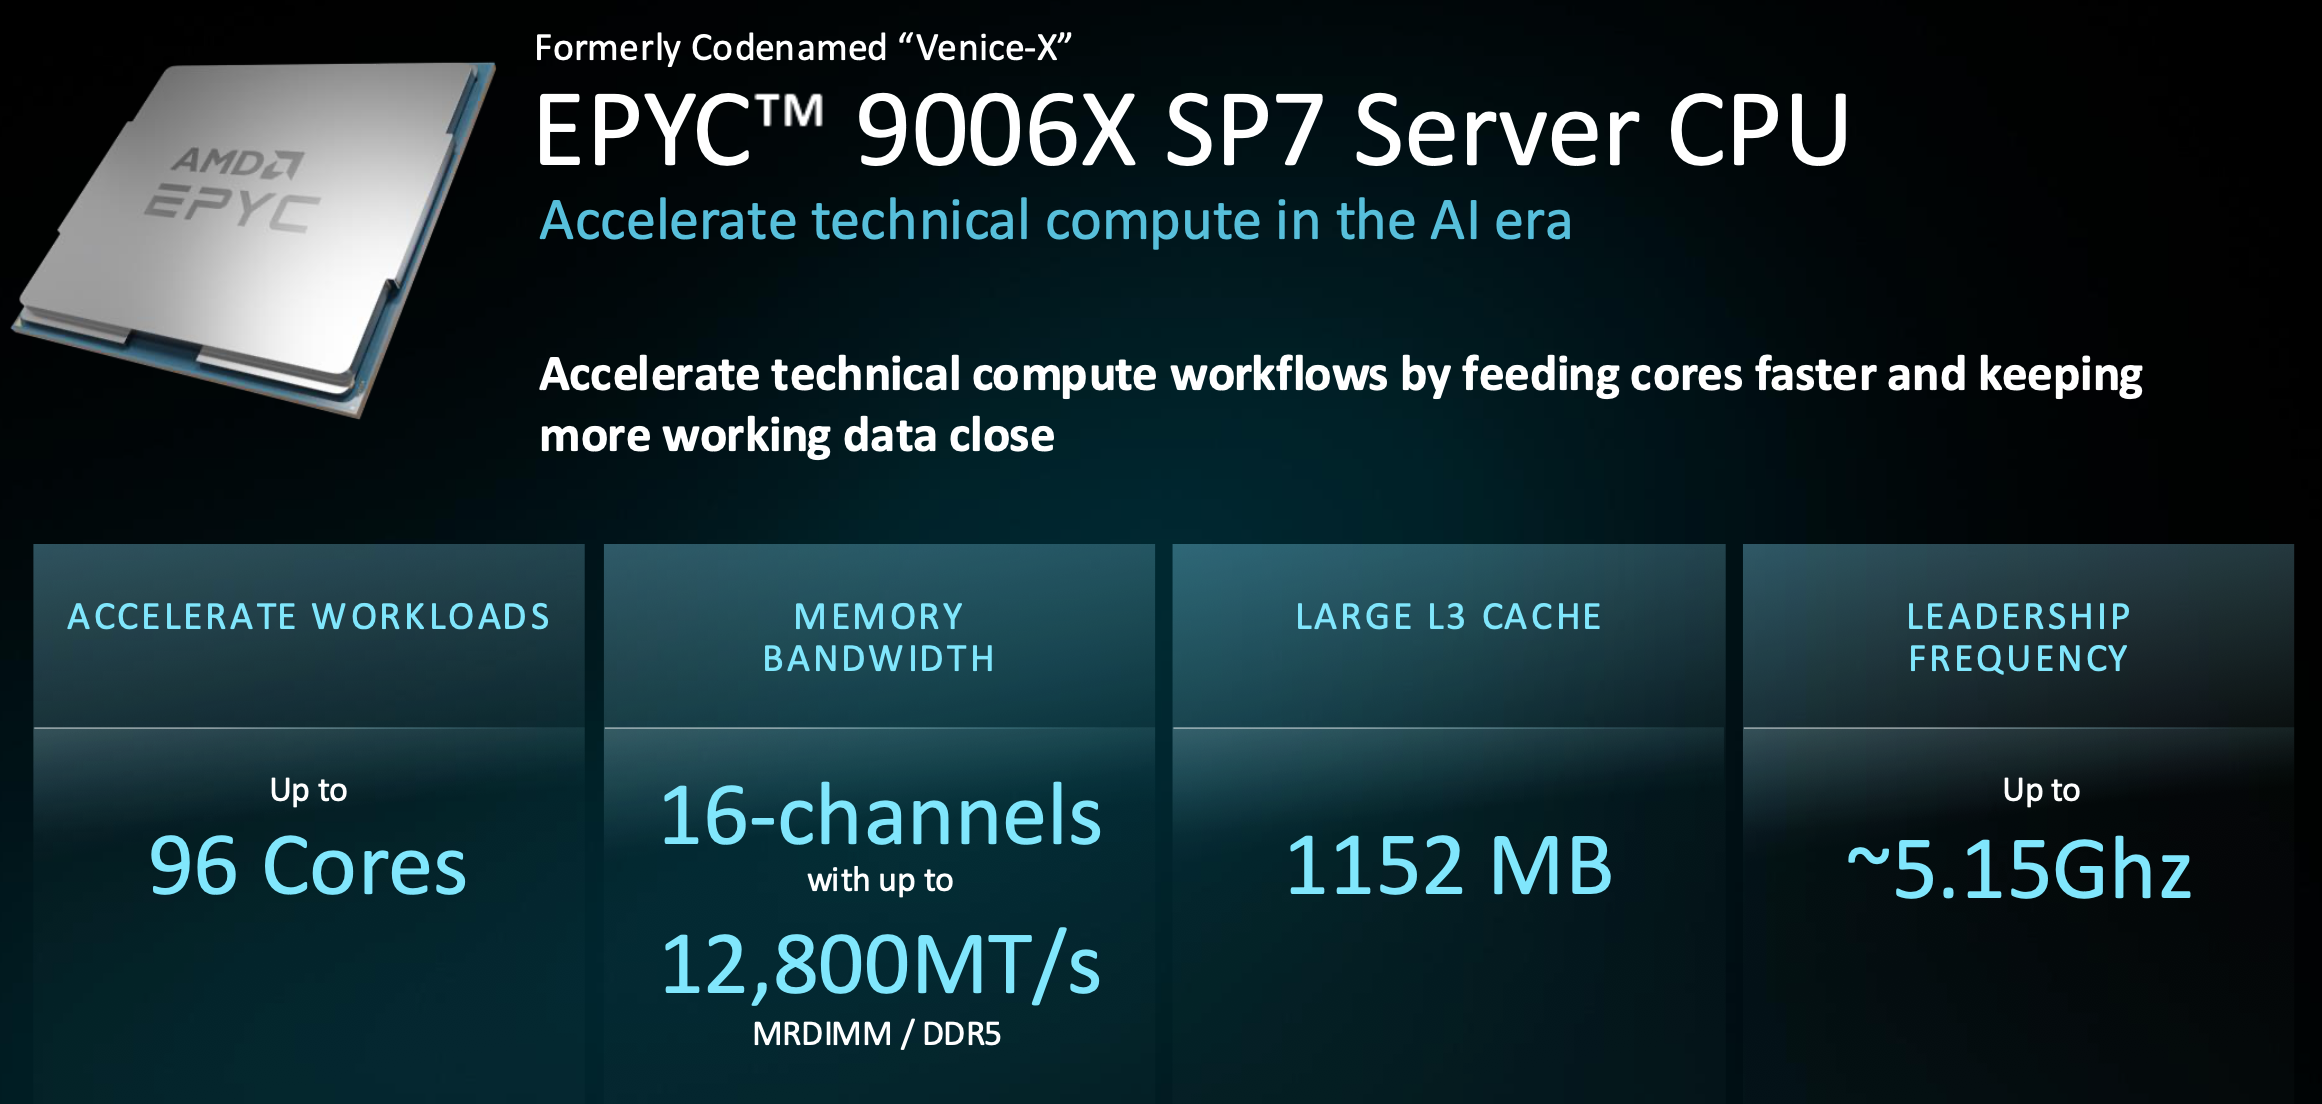
Venice-X intègre un cache virtuel 3D (V-Cache) sur une configuration haute fréquence à 96 cœurs et porte la mémoire L3 à 1 152 Mo, soit environ trois fois plus que les processeurs SP7 standard. La fréquence d'horloge atteint environ 5.15 GHz et le système mémoire complet à 16 canaux et 12 800 MT/s est conservé. Ce processeur est destiné à la simulation et à la modélisation, à l'analyse de données à grande échelle, aux bases de données en mémoire et au prétraitement des processus d'IA alimentant les chaînes de traitement — des charges de travail où la quantité de données stockées en cache est plus importante que le nombre de cœurs supplémentaires.
EPYC 9006 LP « Verano »
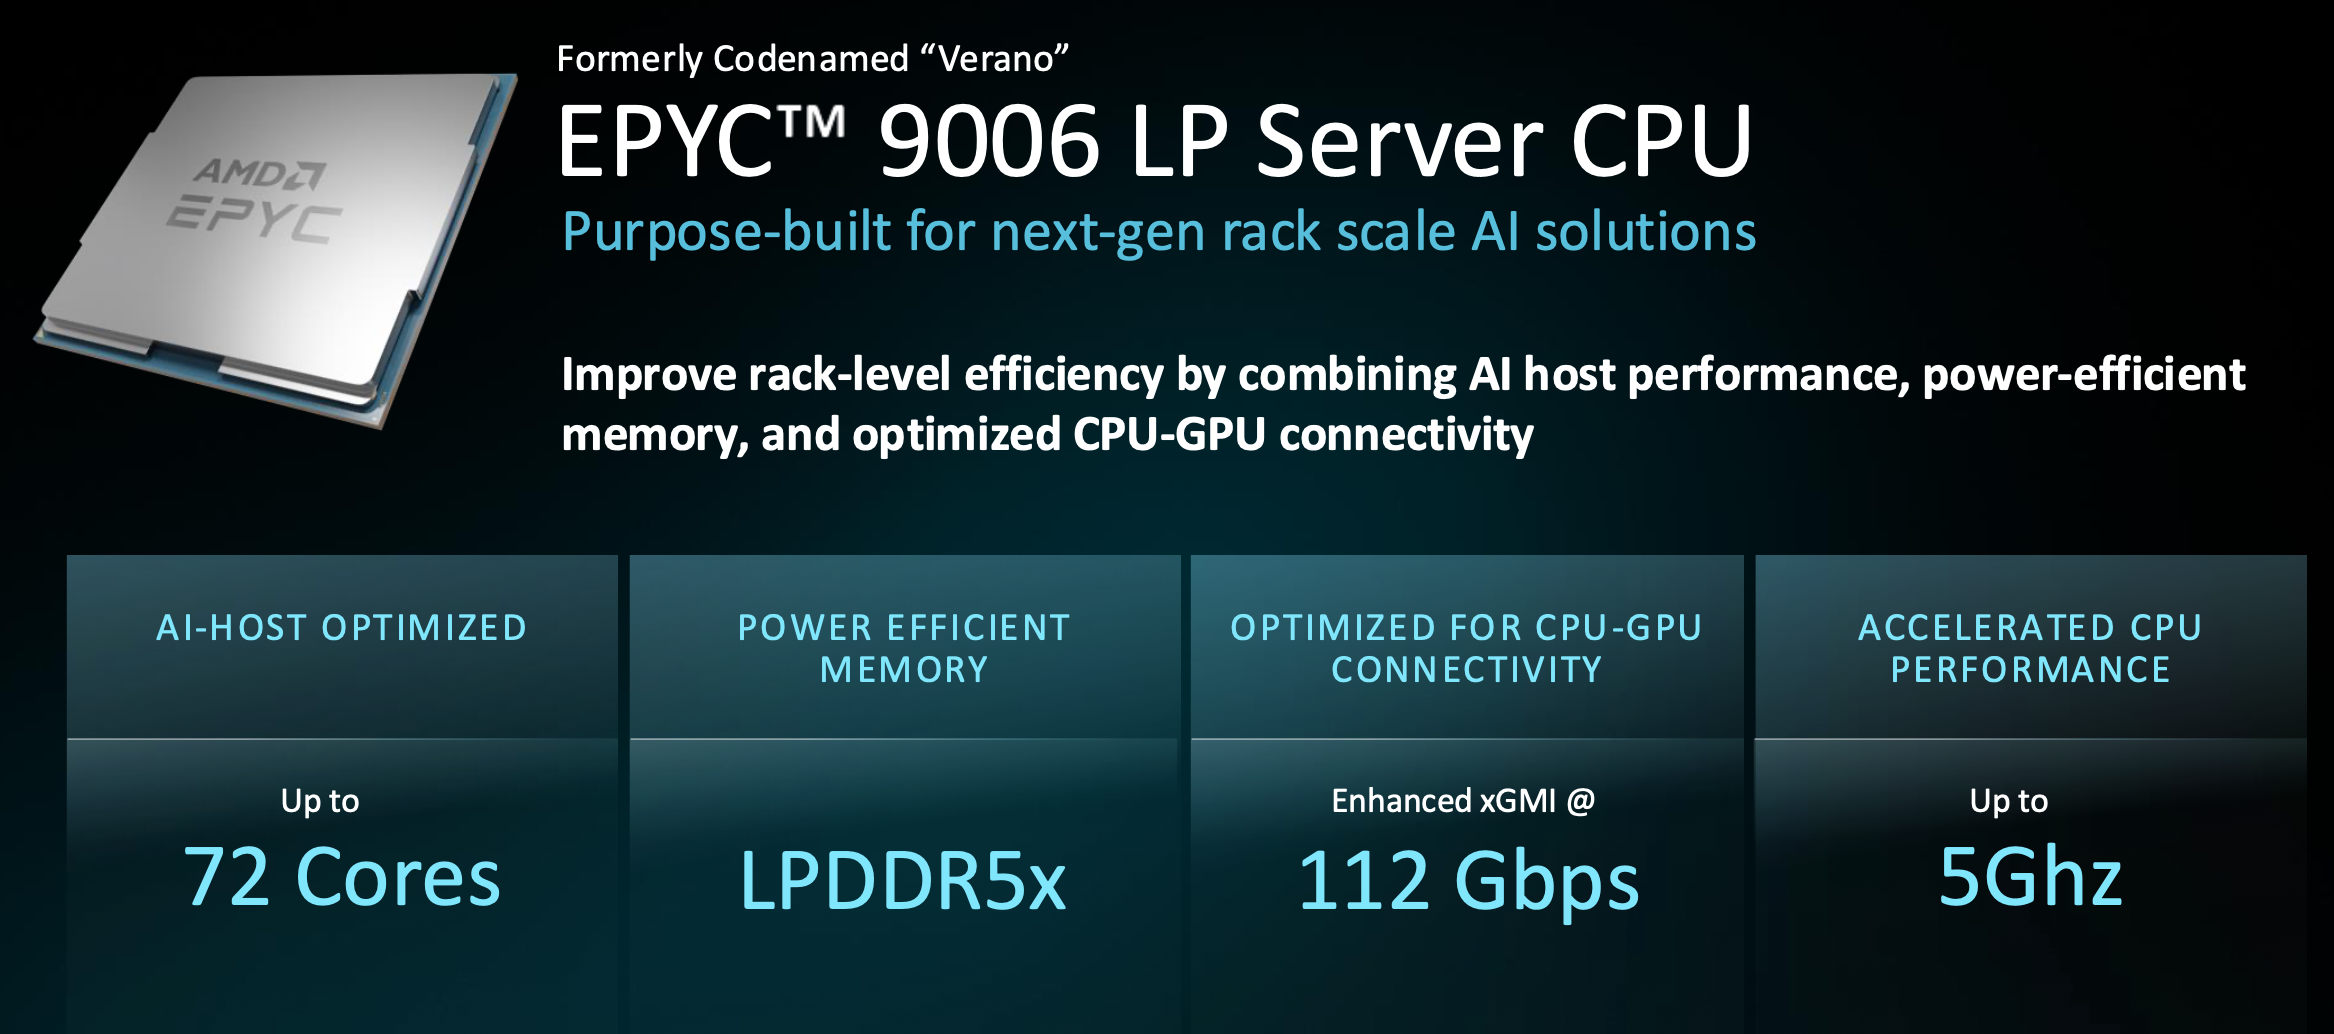
Verano est le modèle le plus spécialisé de la famille : un nœud hôte dédié à l'IA, avec jusqu'à 72 cœurs à 5 GHz, 24 canaux de mémoire LPDDR5X et une liaison xGMI améliorée à 112 GT/s pour le trafic CPU-GPU. La mémoire LPDDR est installée sur des modules SOCAMM2 remplaçables sur site, un atout majeur dans un parc de serveurs où une défaillance de mémoire soudée entraînerait la mise hors service de toute une carte. Il s'agit également de la réponse directe d'AMD à la Vera de NVIDIA, un duel que nous aborderons plus loin, car AMD l'a fait avec brio.
Comment Venise se compare-t-elle ?
AMD a présenté ses arguments en deux temps, en commençant par Turin pour montrer l'avance qu'elle détient déjà, puis Venise pour illustrer l'ampleur de son avance.
Turin mène aujourd'hui
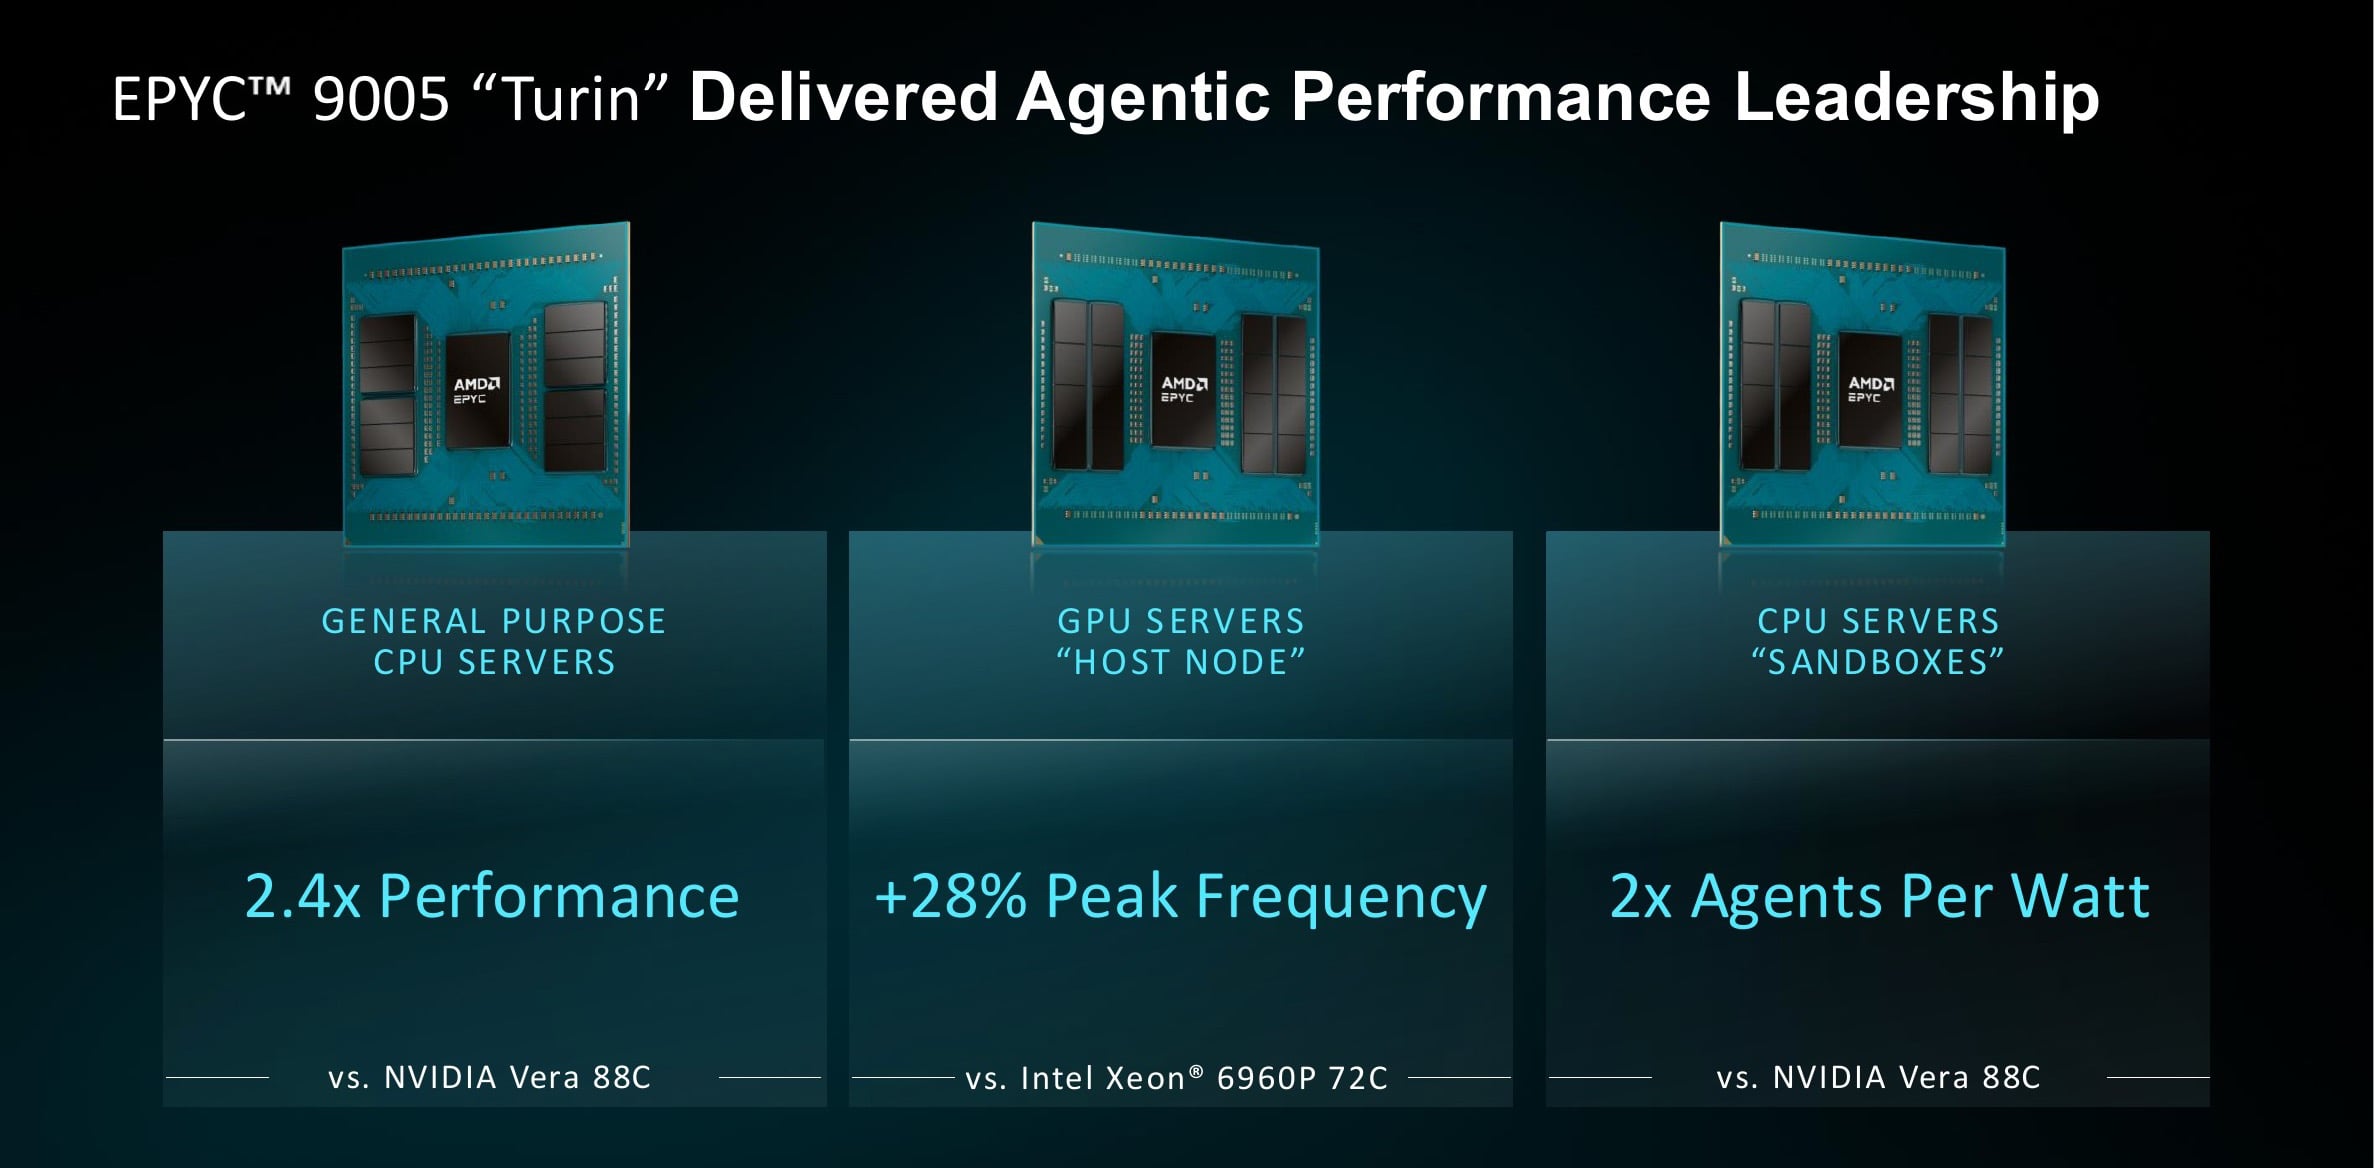
AMD a principalement axé ses comparaisons sur la plateforme Vera Rubin de NVIDIA, équipée d'un processeur Arm, en commençant par la génération qu'elle commercialise déjà. Selon la modélisation d'AMD au niveau du rack, un rack de Turin offre un débit général 2.4 fois supérieur à celui de Vera et deux fois plus d'agents par watt. Le modèle fixe les deux racks à une consommation électrique de 100 kW, compare un EPYC 9965 2P (384 cœurs) à une carte Vera 2P (176 cœurs) et calcule la moyenne des résultats sur six charges de travail : SPECrate 2017 (estimation), Java côté serveur, NGINX, Redis, Memcached et une application dérivée de TPC-C.
Deux réserves s'appliquent ici et pour le reste de cet article. La Vera n'est pas encore commercialisée ; par conséquent, toutes les données la concernant correspondent à une estimation d'AMD pour le processeur 88 cœurs de 450 W décrit par NVIDIA dans sa documentation publique. De plus, en l'absence de benchmark standard pour les charges de travail multi-agents, AMD utilise le nombre de threads matériels comme indicateur du nombre d'agents dans ses calculs de consommation par watt.
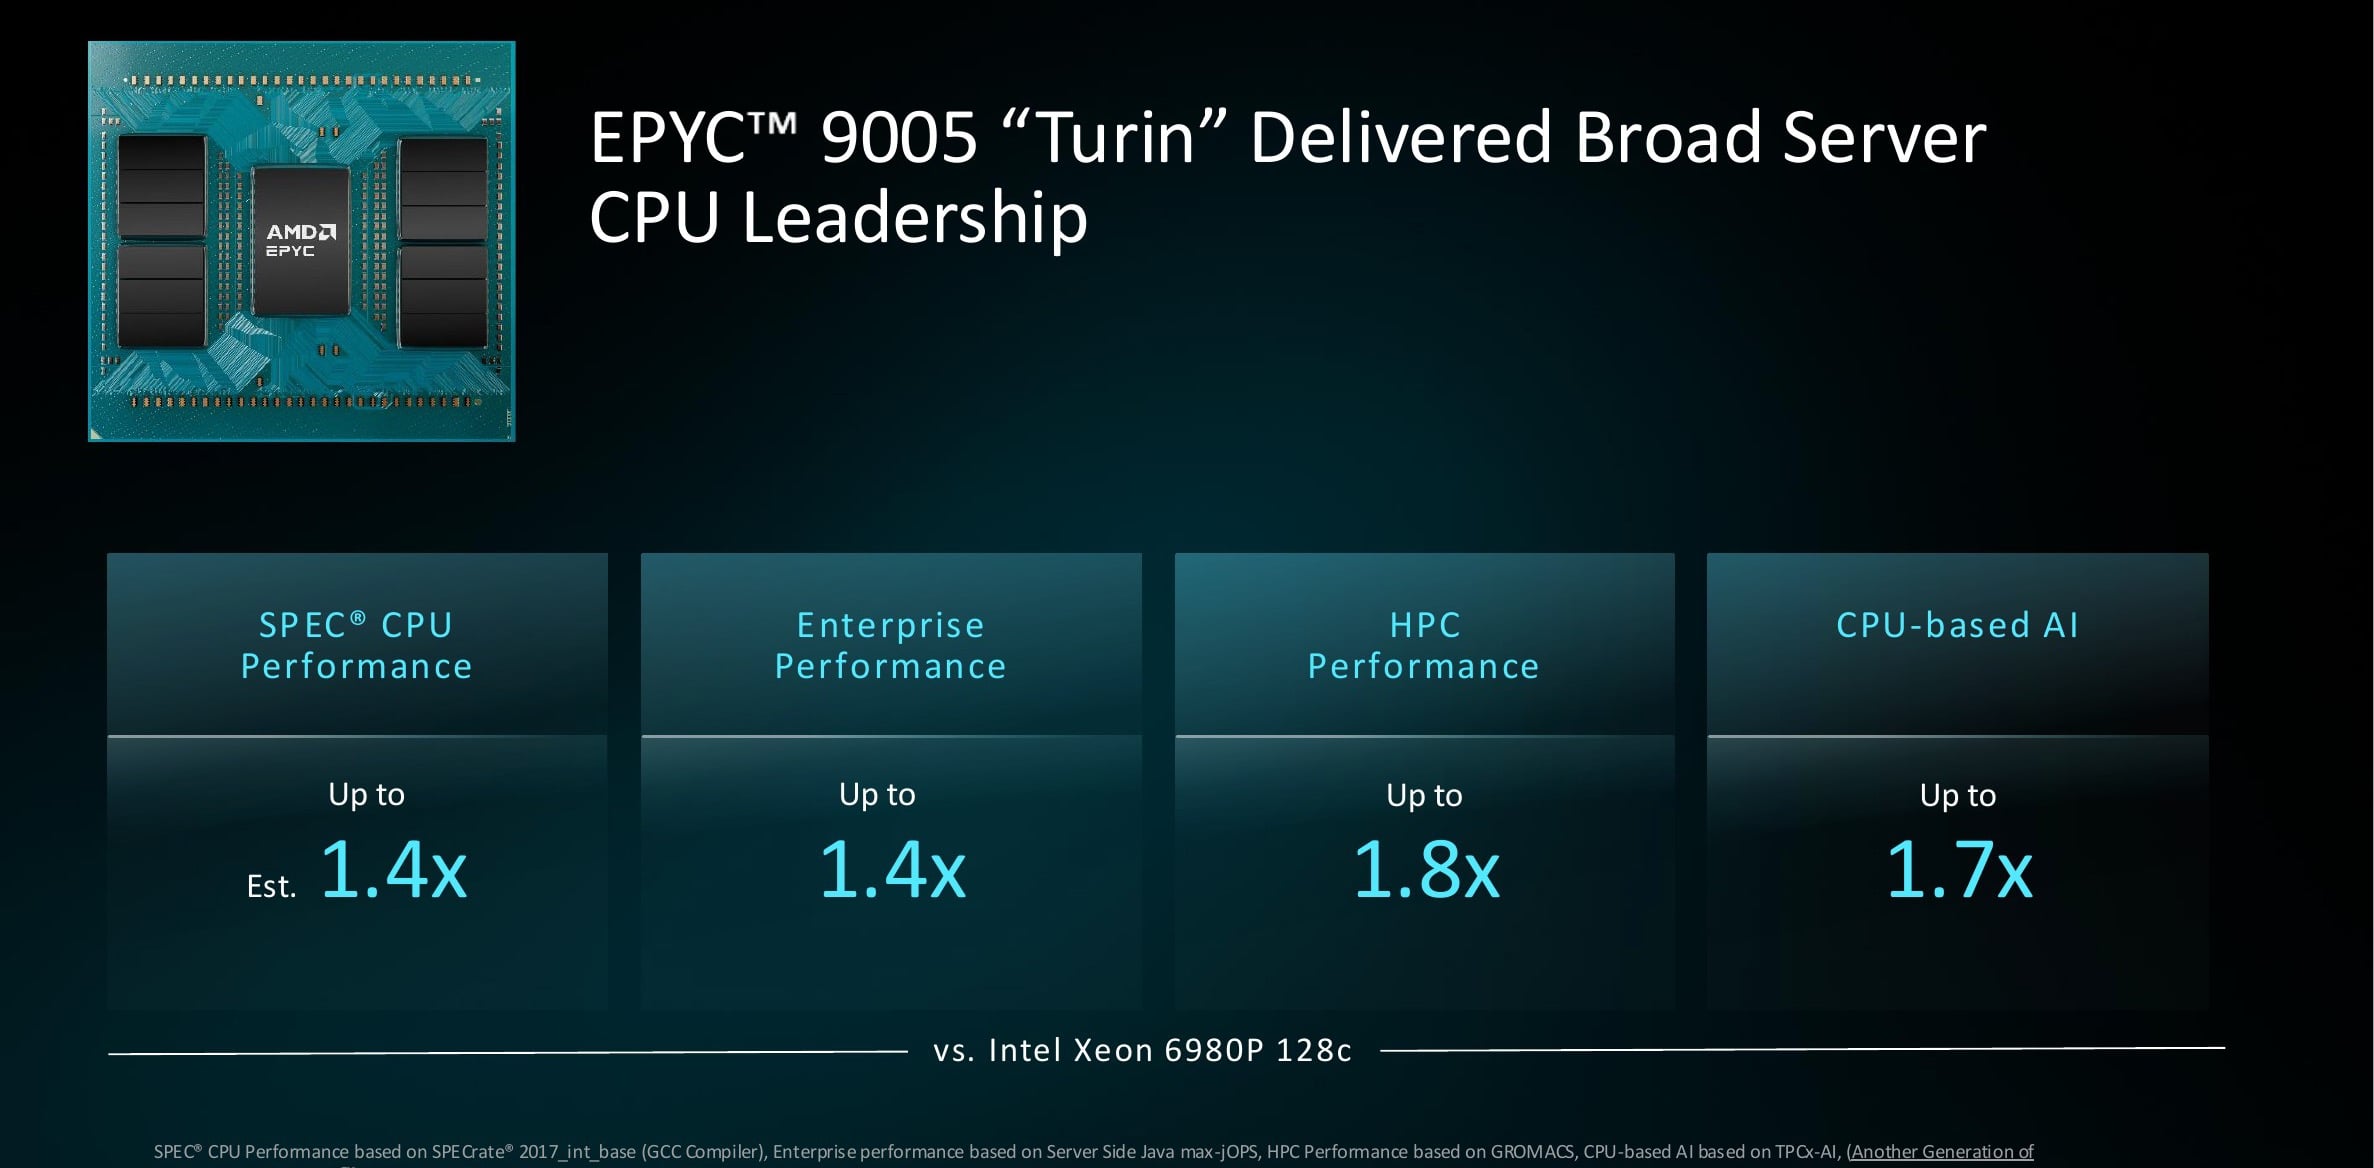
La comparaison avec Intel est plus solide, car les deux fabricants proposent des composants qu'AMD a pu tester directement. Les processeurs hôtes du Turin atteignent 5.0 GHz, tandis que le Xeon équivalent plafonne à 3.9 GHz, soit un avantage de fréquence de 28 % qui se fait sentir lorsque des cœurs uniques alimentent les GPU. À performances égales, face au Xeon 6980P à 128 cœurs, AMD mesure les performances du Turin jusqu'à 1.4 fois supérieures sur SPEC CPU, 1.4 fois supérieures sur Java d'entreprise, 1.8 fois supérieures sur HPC et 1.7 fois supérieures sur l'IA basée sur le processeur.
Venise élargit chaque intervalle
Venice renforce chacune de ces avances. Avec le même modèle de rack de 100 kW, et désormais 512 cœurs Venice contre 176 pour Vera, AMD revendique des performances générales 3.3 fois supérieures à celles de Vera. Venice atteint 2.8 fois plus d'agents par watt que l'architecture Arm AGI à 136 cœurs, et 1.8 fois plus de jetons par seconde sur les modèles de pointe lorsqu'elle intègre des GPU. Ce chiffre de 1.8 concerne un scénario plus restreint que ne le suggère le titre, et nous y reviendrons dans la section consacrée aux nœuds hôtes ci-dessous.
Face à face avec Vera
Sur SPECrate 2026, AMD estime les performances de la Venice 9996 (2P) à une RTX 2070 contre 925 pour la Vera, soit un gain de débit de 2.2 fois. Cette version à 96 cœurs haute fréquence affiche également des performances par cœur environ 1.2 fois supérieures à celles de la Vera. Ces résultats ont été compilés avec GCC 15.2, la même chaîne d'outils que celle utilisée par NVIDIA pour ses chiffres publiés concernant la Vera.
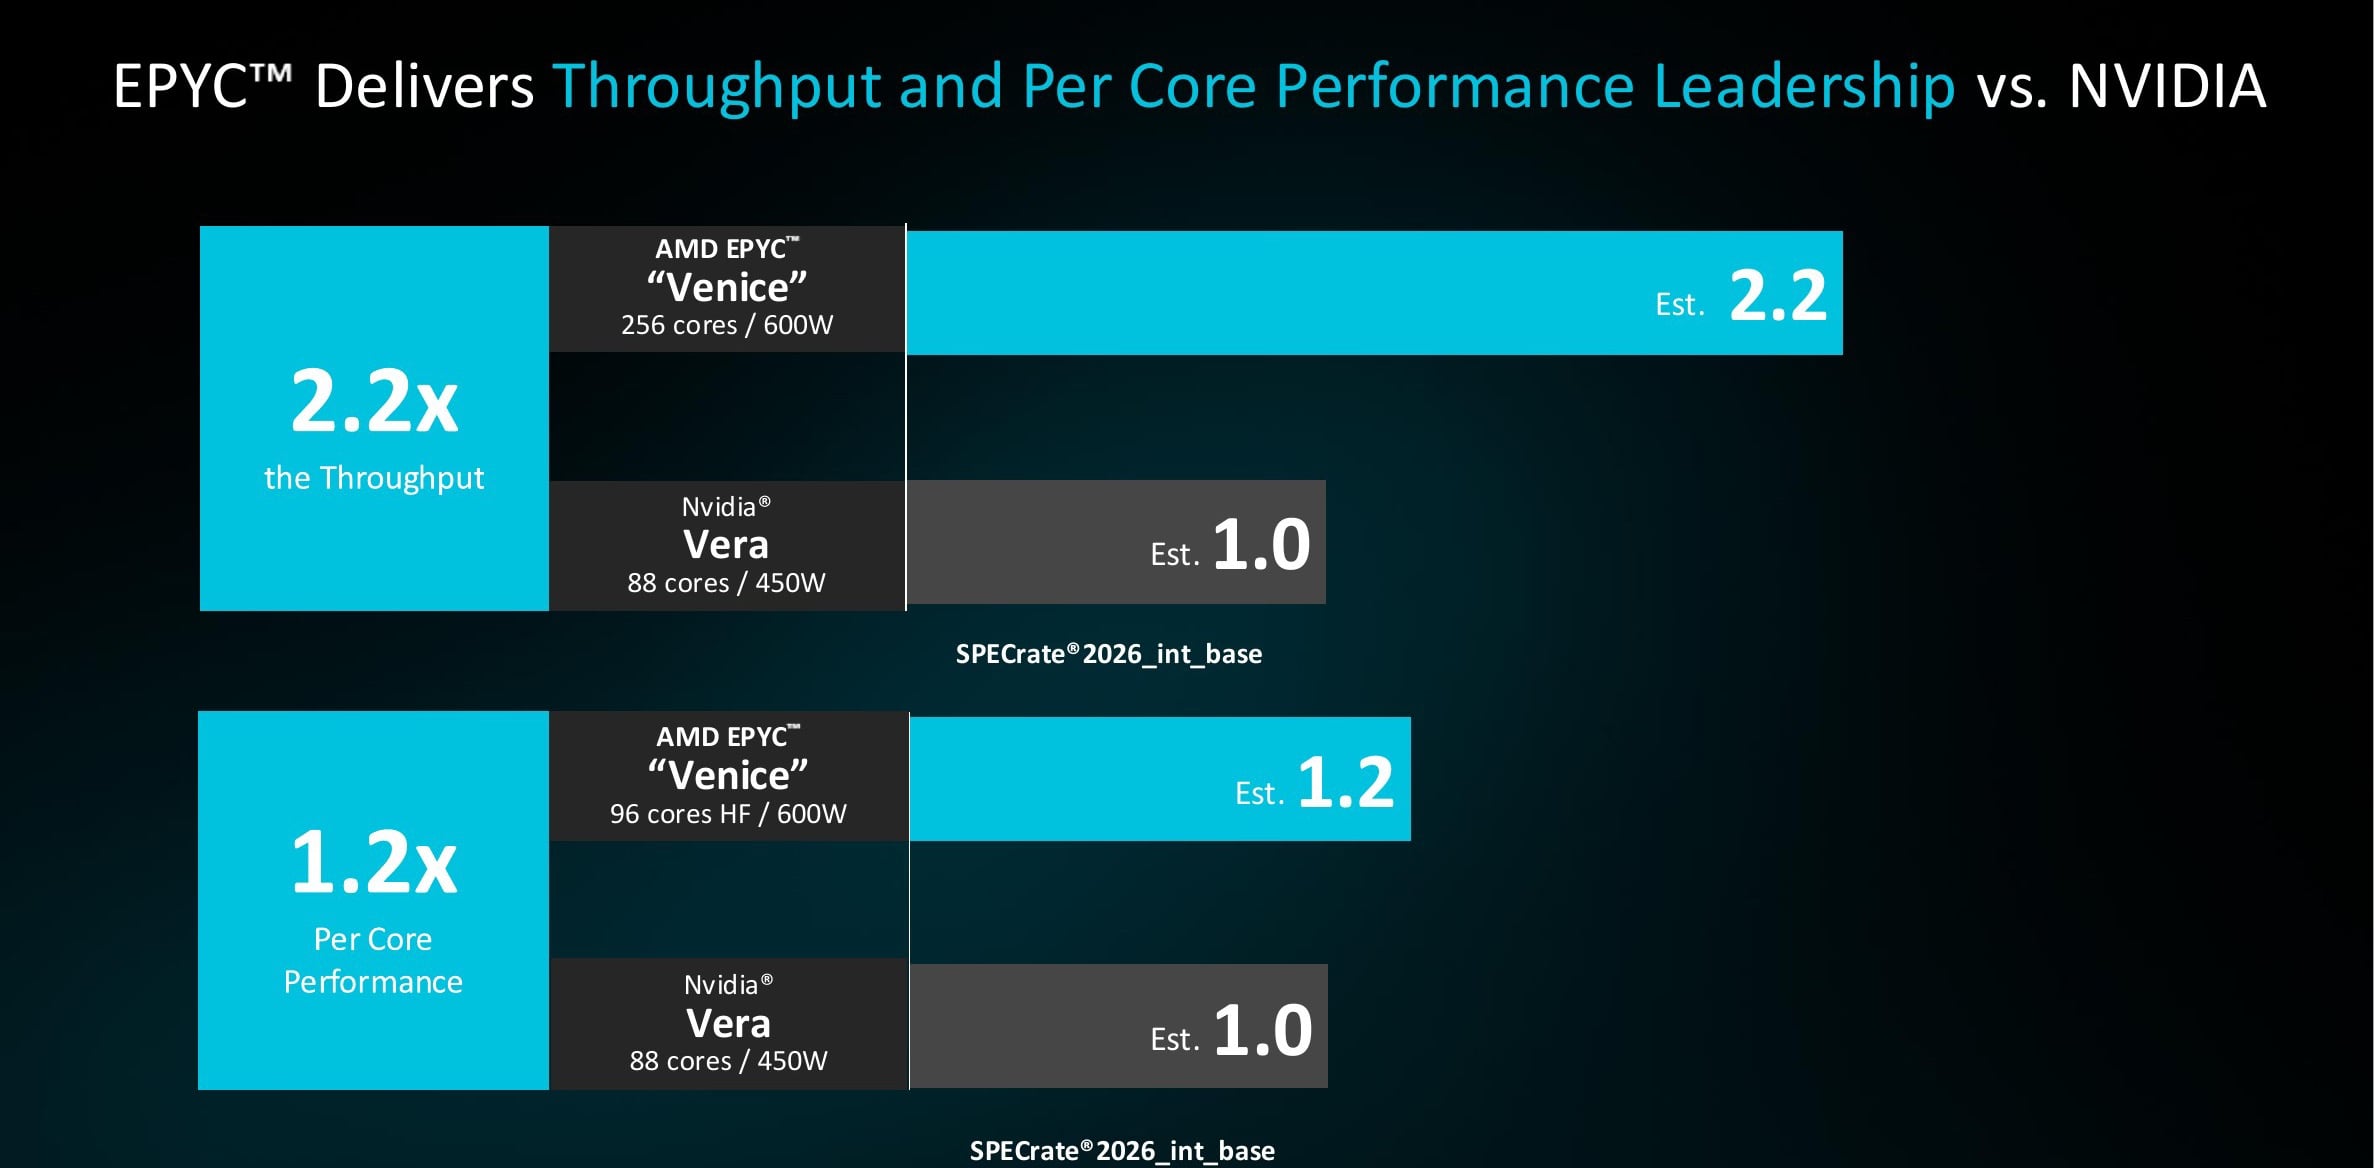
L'avance par cœur annoncée s'est en réalité accrue durant la semaine de lancement. Ravi Kuppuswamy, responsable de l'ingénierie des processeurs chez AMD, a déclaré à la presse qu'AMD avait initialement revendiqué un avantage de 10 % par cœur. Après la publication par NVIDIA de ses propres chiffres Vera en début de semaine, son équipe a relancé la comparaison avec le même compilateur et les mêmes paramètres, et a mesuré une avance de 20 %, alors que l'optimisation n'était pas encore terminée. Cet écart de débit de 2.2×, a-t-il précisé, correspondait aux projections internes d'AMD depuis le début. Une note de bas de page distincte recalcule la comparaison par cœur sur SPECrate 2017 à l'aide du compilateur AOCC d'AMD et aboutit à un résultat de 1.7×, ce qui fait de 20 % l'estimation la plus prudente des deux.
Intel et bras
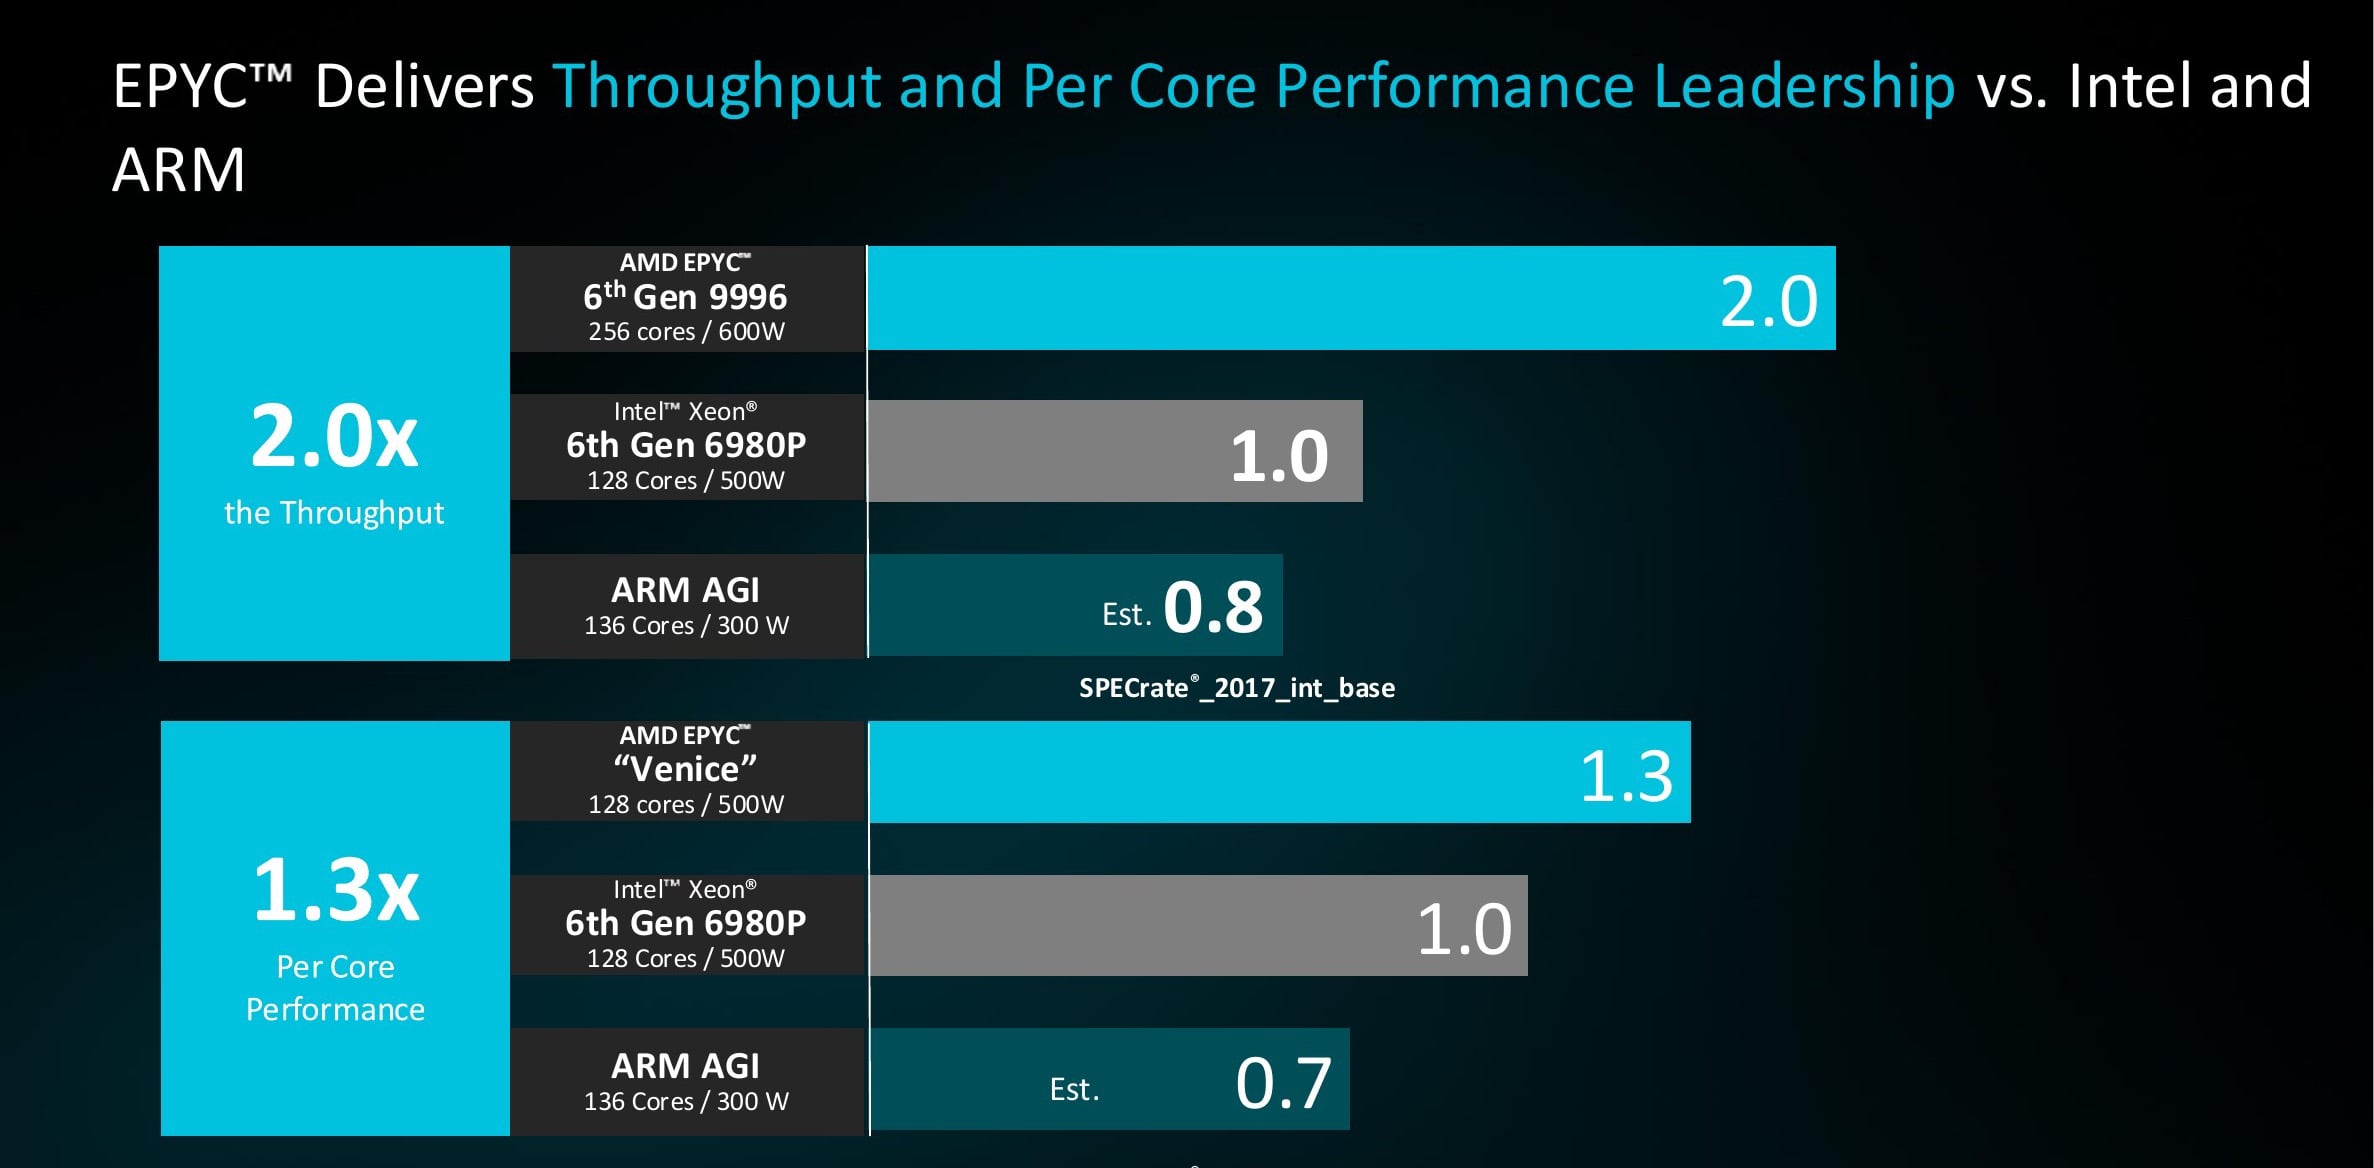
AMD a également présenté un classement SPECrate 2017 plus large. Le Venice 9996 arrive en tête avec un score de 4900 (256 cœurs, 600 W, 14 904 $ chez 1Ku), suivi du Turin 9965 à 3240, du Xeon 6980P d'Intel à 2510 (128 cœurs, 500 W, 1.3 955 $), de l'Arm AGI à 1944 (136 cœurs, 300 W) et du Vera à 1459. Les scores du 9996, de l'AGI et du Vera sont des estimations d'AMD ; ceux du Turin et d'Intel sont des résultats publiés. Par rapport à Intel, cela représente un débit environ deux fois supérieur pour un prix catalogue comparable, soit des performances deux fois plus élevées par dollar dépensé. Par cœur, une configuration Venice de 128 cœurs et 500 W obtient un score 13 fois supérieur à celui du 6980P, tandis que l'Arm AGI atteint 0.7 fois ce score. Contrairement à la comparaison Vera ci-dessus, le score de chaque fournisseur a été produit ici avec sa propre meilleure chaîne d'outils : AOCC pour AMD, OneAPI pour Intel et GCC 13 pour Arm.
Cloud natif et HPC
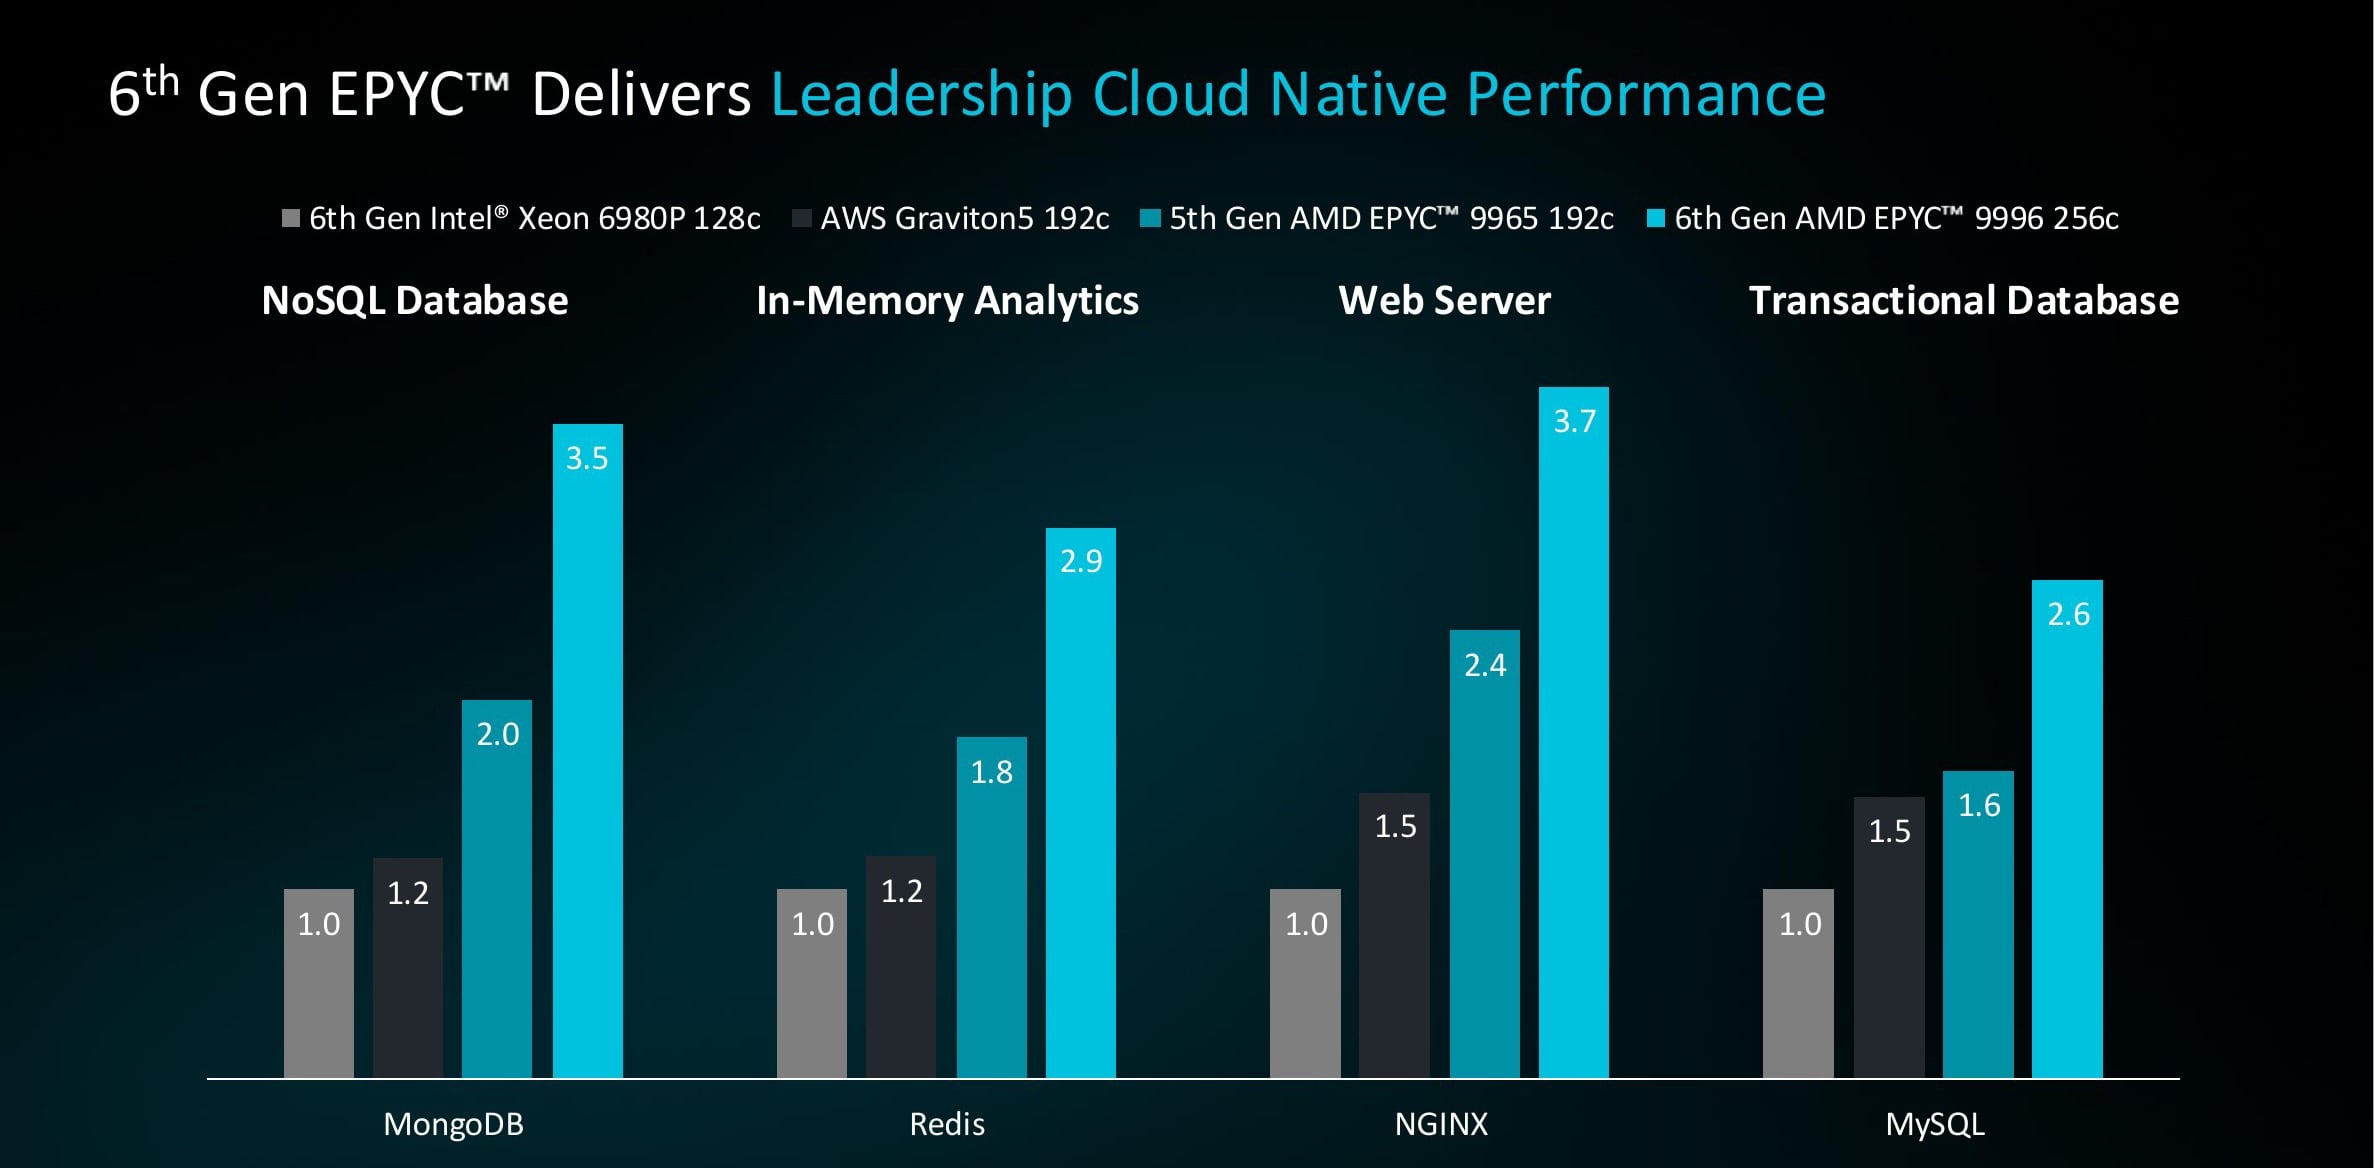
AMD a également ventilé la comparaison par charge de travail, chaque résultat étant indexé sur le 6980P d'Intel (valeur de référence : 1.0). Côté cloud natif, le Venice 9996 à 256 cœurs affiche des performances 3.5 fois supérieures sur MongoDB, 2.9 fois supérieures sur Redis, 3.7 fois supérieures sur NGINX et 2.6 fois supérieures sur MySQL. Turin se situe entre 1.6 et 2.4 fois supérieures sur les mêmes tests, et Graviton5 entre 1.2 et 1.5 fois supérieures.
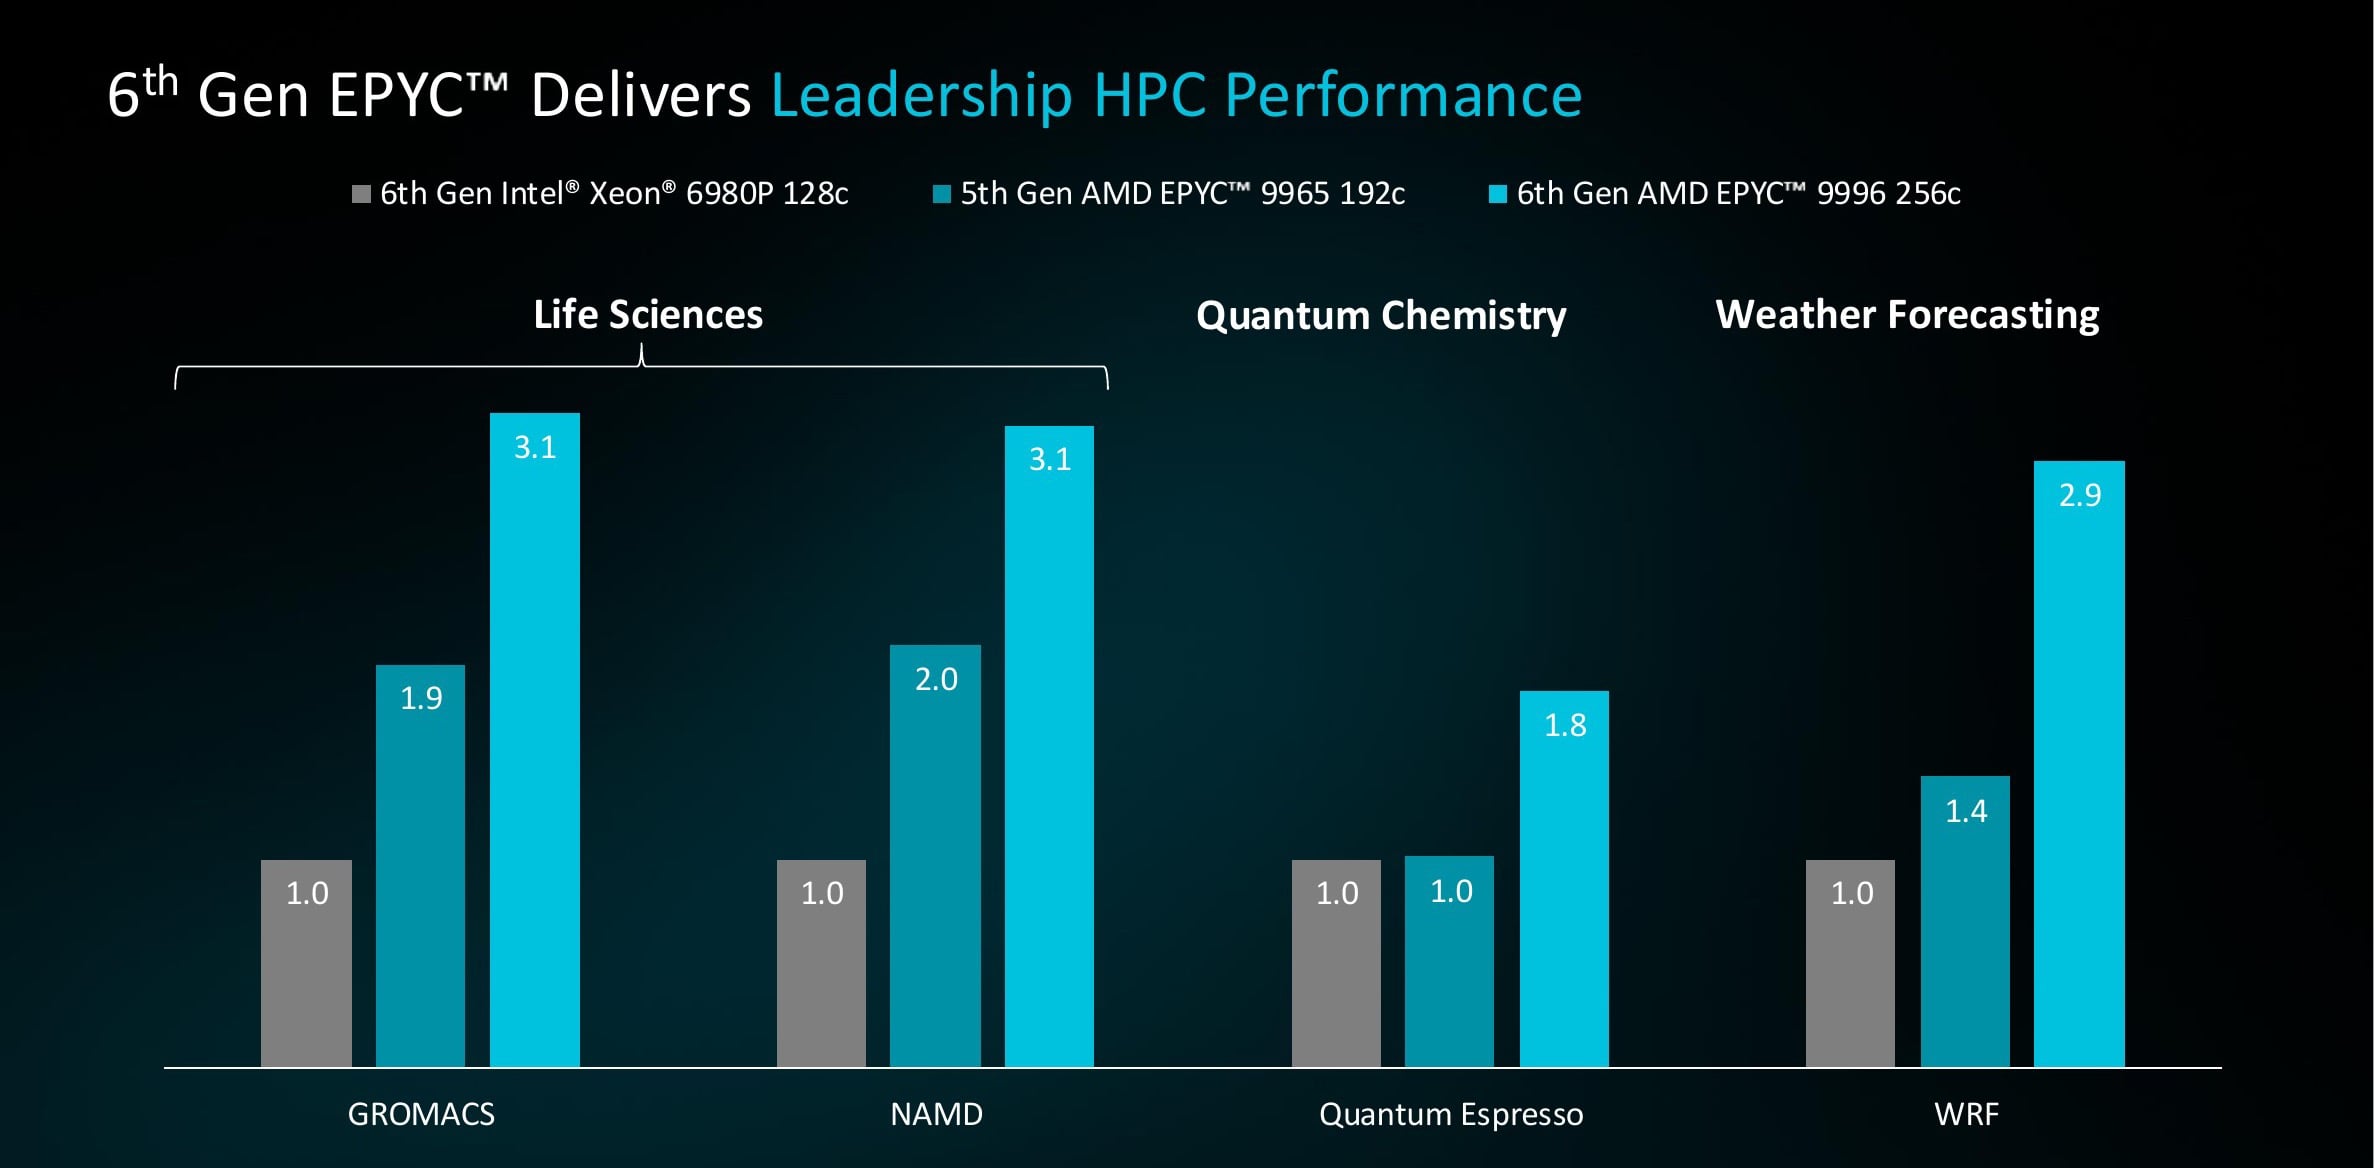
En calcul haute performance (HPC), Venice obtient des scores 3.1 fois supérieurs sur GROMACS et NAMD, 2.9 fois supérieurs sur WRF et 1.8 fois supérieurs sur Quantum Espresso. La configuration mémoire influe considérablement sur ces résultats. Avec des barrettes RDIMM standard de 8 000 MT/s, Venice surpasse de 2.81 fois la performance de référence du Xeon sur GROMACS ; avec des barrettes MRDIMM de 12 800 MT/s, ce score passe à 3.13 fois supérieur, et cette même mise à niveau fait passer la performance sur WRF de 2.25 fois à 2.90 fois supérieure. AMD estime son avance en HPC entre 1.8 et 3.5 fois supérieure selon la charge de travail et la mémoire utilisée. La configuration de référence d'Intel utilisait des barrettes MRDIMM de 8 800 MT/s ; l'écart ne provient donc pas d'une différence de performances entre une mémoire AMD améliorée et une configuration Intel moins performante.
Le nœud hôte et la revendication 1.8×
Ceci nous ramène à l'affirmation d'une augmentation de 1.8 fois le nombre de jetons par seconde. Les améliorations matérielles sous-jacentes sont faciles à énumérer : le processeur cadencé à 5 GHz intègre désormais 96 cœurs au lieu de 64, la bande passante de la mémoire hôte passe de 614 Go/s à 1.6 To/s et la norme PCIe Gen 6 double la bande passante de la liaison entre le processeur et le GPU.
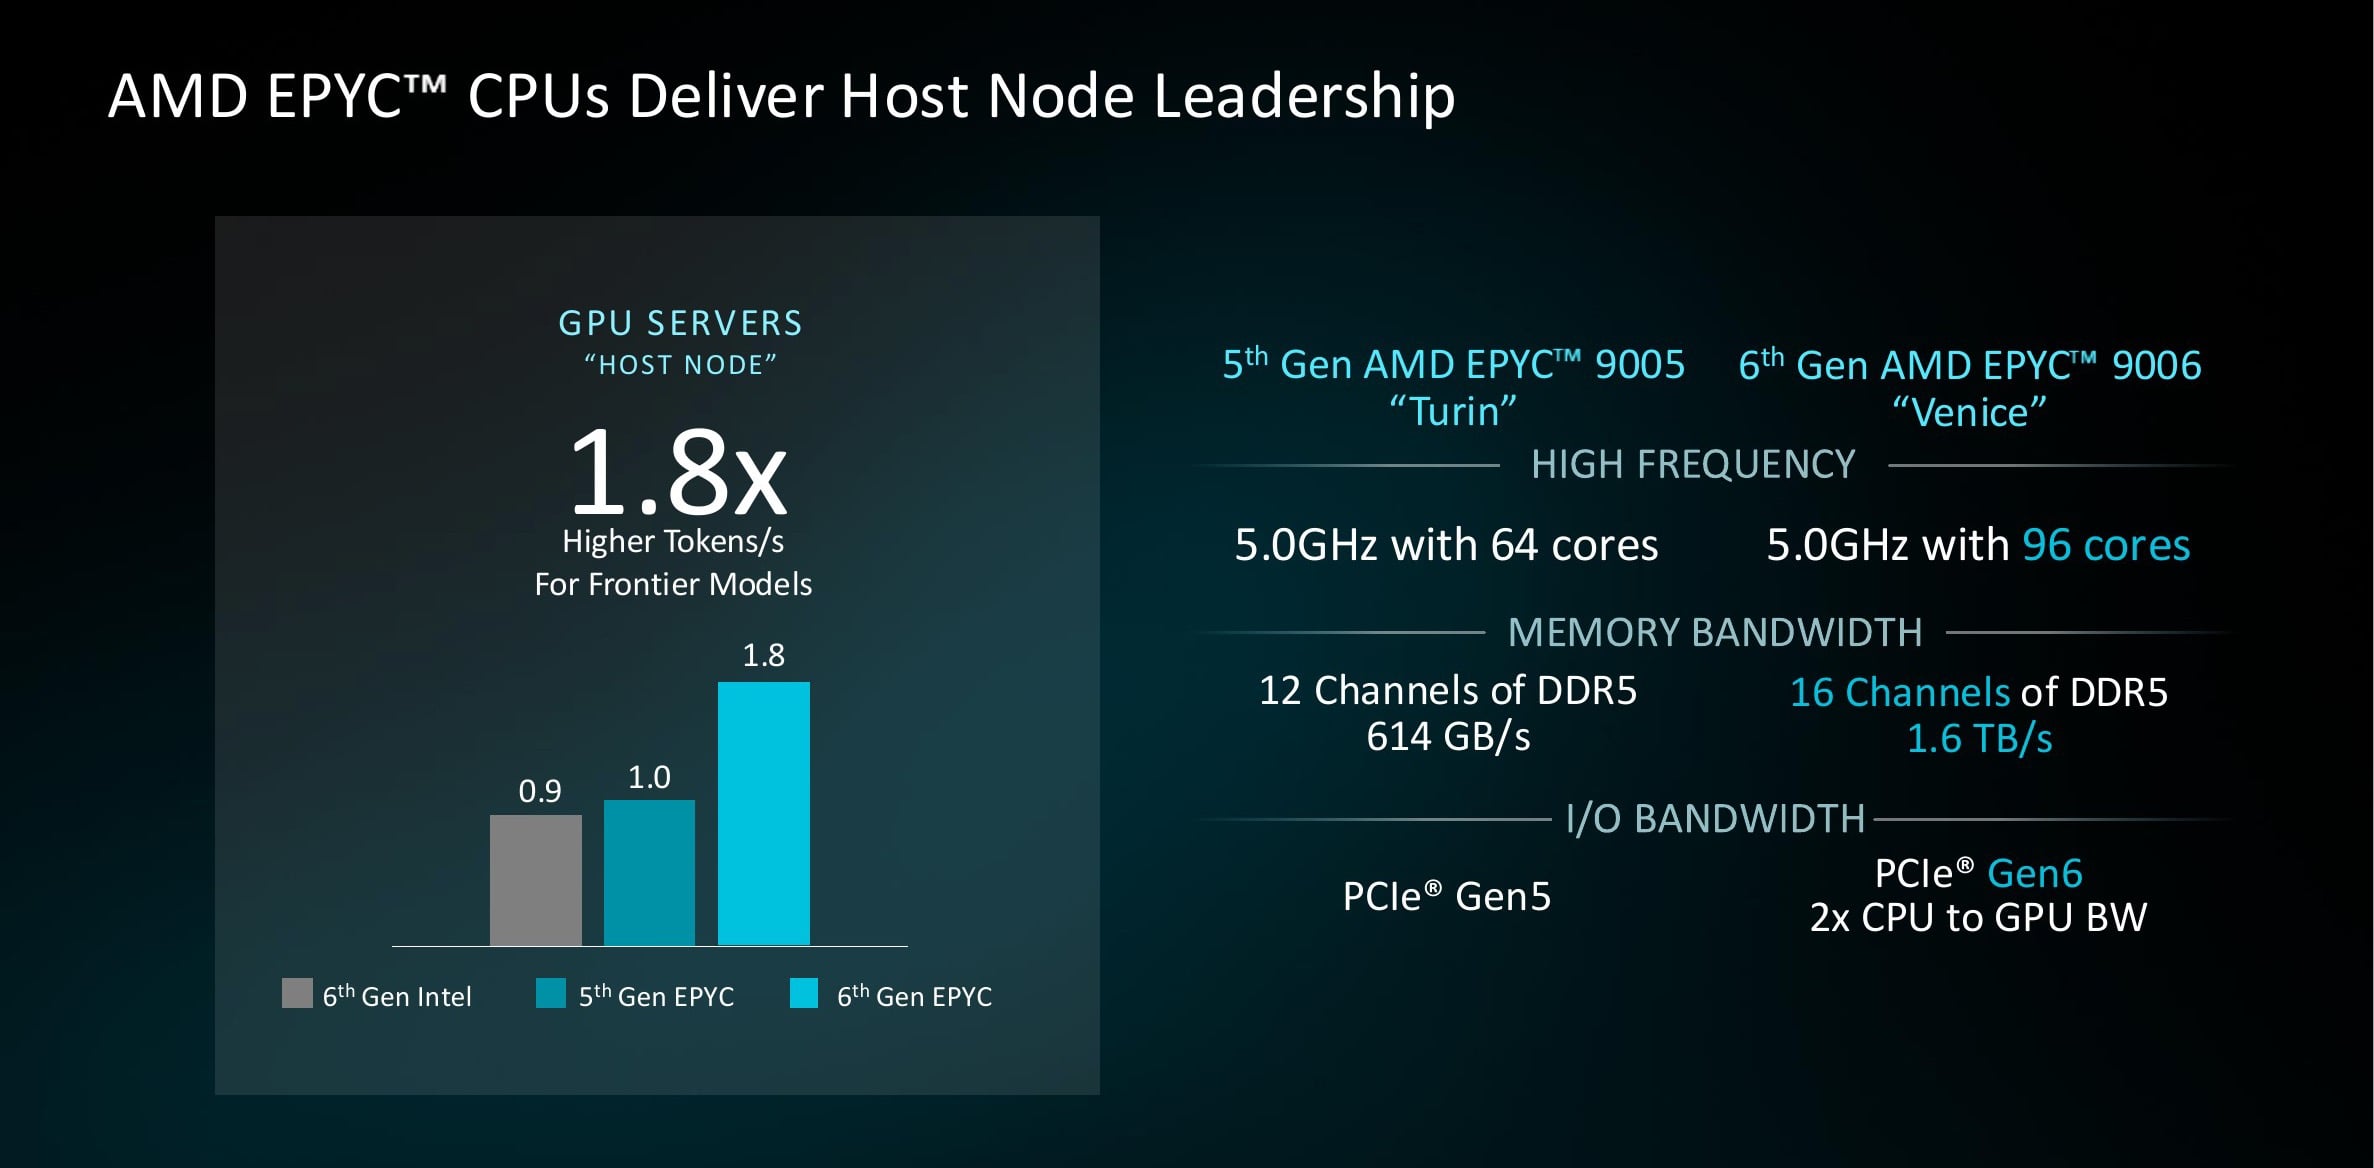
Il convient tout d'abord de vérifier la base de référence. AMD a indexé ce graphique sur Turin (valeur de 1.0) plutôt que sur Intel et a positionné le Xeon de 6e génération à 0.9. C'est pourquoi la même affirmation approche le double lorsqu'elle est reformulée par rapport au Xeon 6960P. Le gain projeté provient presque entièrement de la bande passante d'E/S. AMD a effectué un test de déchargement du processeur en transférant les poids BF16 du Qwen3-30B de la mémoire hôte vers le GPU. Ce test a révélé que le chemin de réception PCIe Gen 5 x16 fonctionnait entre 89 % et 95 % de son potentiel théorique, tandis que les lectures de la DRAM hôte restaient inférieures à 10 % de leur potentiel théorique. La vitesse de décodage étant limitée par le transfert, doubler la liaison avec le PCIe Gen 6 permet d'obtenir une amélioration de 1.8 à 1.9 fois dans ce test. Venice est actuellement le seul processeur serveur à proposer le PCIe Gen 6 aux accélérateurs ; l'avantage est donc réel et, pour l'instant, exclusif. Son champ d'application est toutefois limité : le gain de 1.8x décrit un cas particulier de déchargement limité par la bande passante et ne doit pas être interprété comme une garantie que les GPU seront 1.8 fois plus rapides pour tous les modèles sur les hôtes Venice. Sur le matériel actuellement disponible, un hôte Turin surpasse un Xeon 6960P de 13 % en moyenne géométrique en termes de temps d'obtention du premier jeton (TTF) pour les charges de travail vLLM et NIM sur le même système B200 8X, avec une amélioration maximale de 36 %.
Densité des racks
La dernière affirmation concerne la densité : 49 152 noyaux de Venise dans un rack, contre 36 864 pour Turin et 22 528 pour Vera, chaque partie contenant deux fois plus de fils que de noyaux. De toutes les affirmations du jeu, c’est celle qui change le plus une fois les notes de bas de page prises en compte.
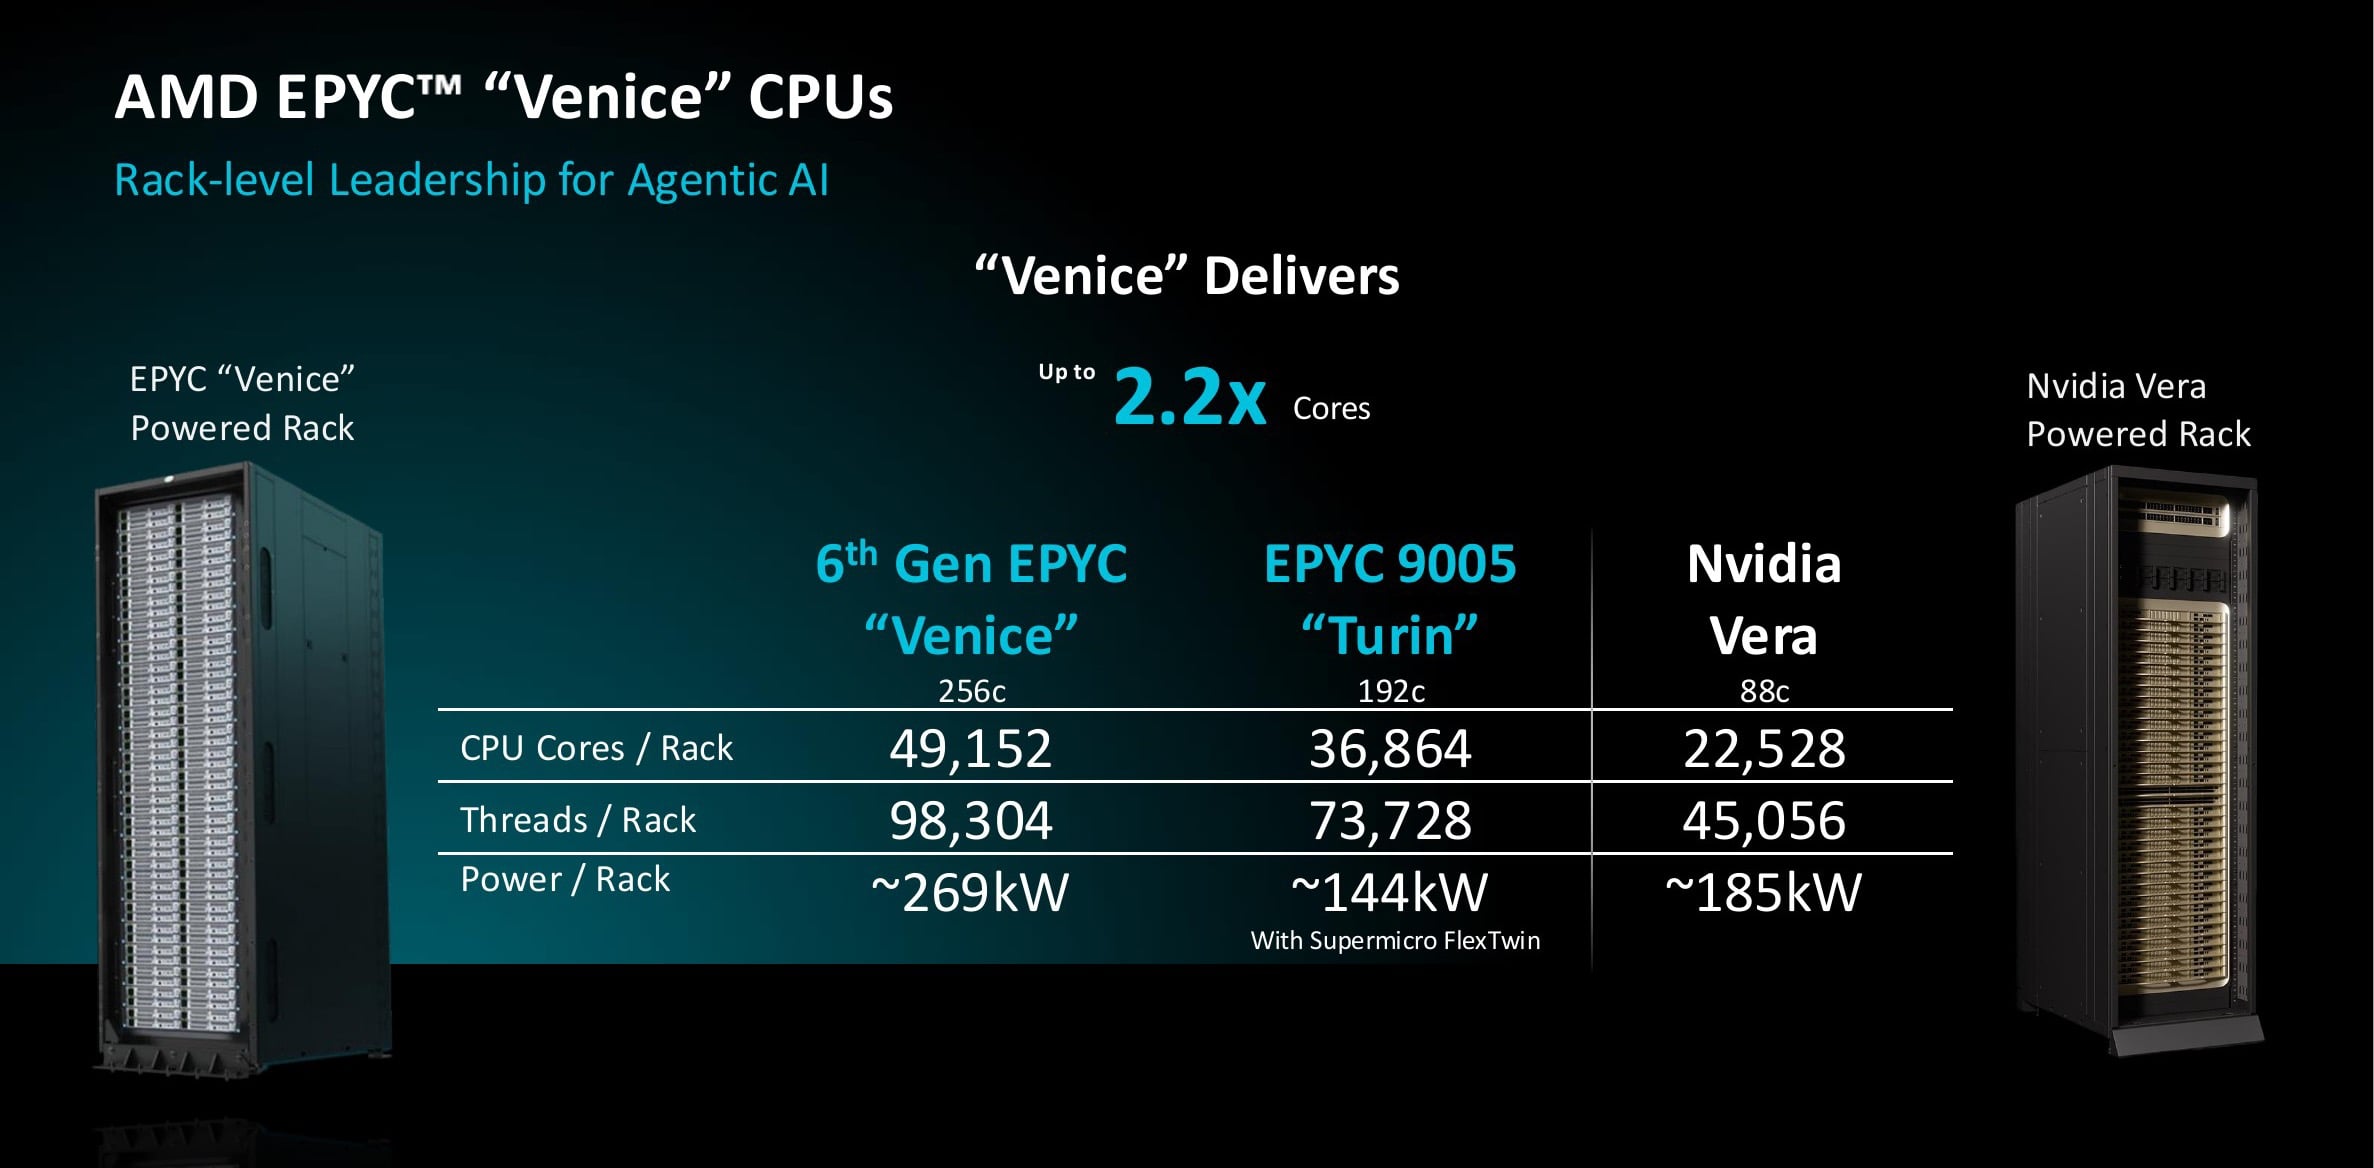
Le principal argument est que le nombre de cœurs est 2.2 fois supérieur à celui de Vera, mais le rack Venice atteint ce chiffre en consommant 269 kW, contre 185 kW pour Vera. Les deux racks ne sont donc pas comparés à puissance égale. Les notes de bas de page d'AMD fournissent des versions normalisées. Avec une enveloppe de 100 kW pour les deux racks, le 9996 offre 2.08 fois plus de cœurs que Vera, 1.86 fois plus que Turin et 1.24 fois plus que le 6980P d'Intel. En remplaçant le modèle phare par l'EPYC 9956 de 400 W, AMD estime que le nombre de cœurs est 1.91 fois supérieur à celui de Vera, pour une consommation réduite de 26 %, ce qui donne 2.57 fois plus de cœurs par watt de rack. Selon le budget énergétique considéré, l'avance se situe entre 1.9 et 2.2 fois. De plus, comme pour toutes les données relatives à Vera présentées dans cet article, le rack NVIDIA est modélisé à partir de spécifications publiées et non de mesures matérielles. L'avantage en termes de densité persiste après normalisation. Il est tout simplement plus petit que le titre 2.2X.
Le grand tyran
Abstraction faite des affirmations individuelles : sur le haut de gamme du marché des processeurs pour serveurs, AMD ne fait actuellement face à aucun concurrent direct. Le meilleur processeur d'Intel est moins performant que Turin, la génération qu'AMD est en train de remplacer. Les processeurs Arm concurrents se situent en dessous de Turin sur tous les graphiques présentés par AMD. Vera n'a pas encore été commercialisé, et selon les estimations d'AMD, son débit est inférieur à la moitié de celui d'un Turin 9965, disponible sur le marché depuis un an et demi, tandis que Venice double quasiment le débit de Turin. Cette position a permis à AMD de capter 46 % du chiffre d'affaires du marché des processeurs pour serveurs, selon Mercury Research. Les données du marché vont dans le même sens. La demande de processeurs EPYC haut de gamme dépasse actuellement l'offre, ce qui a entraîné un allongement des délais de livraison.
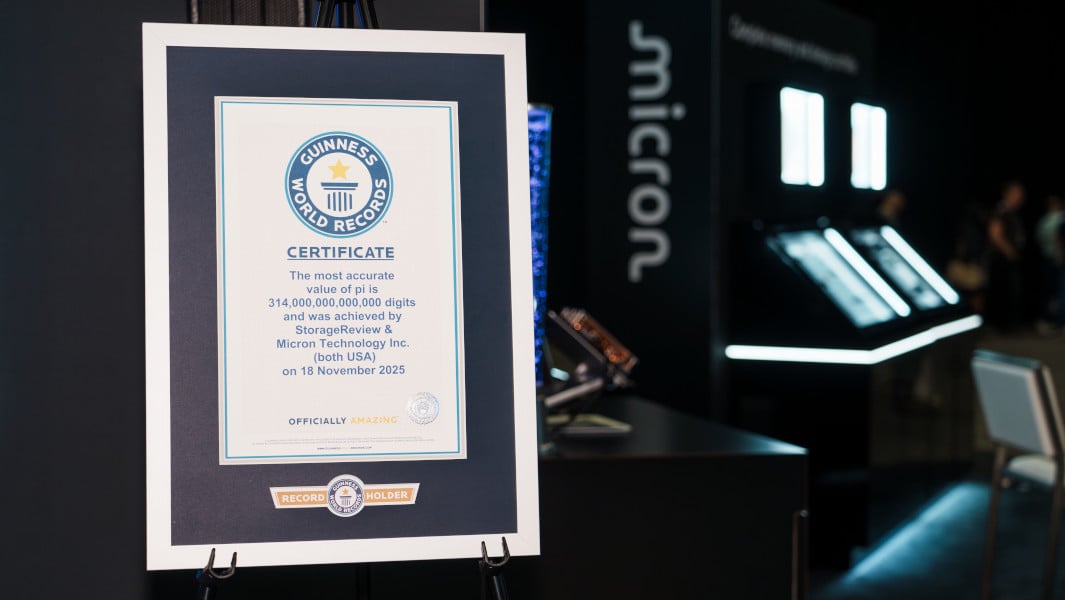
Nous pouvons ajouter ici notre propre donnée. Notre record du monde de calcul de Pi à 314 billions de décimales a été réalisé sur un serveur Dell PowerEdge R7725 équipé de deux processeurs EPYC 9965 à 192 cœurs et de 1.5 To de mémoire DDR5, soit la même configuration à 384 cœurs (2P) que celle utilisée par AMD pour ses serveurs Turin. Le calcul a maintenu chaque cœur sollicité pendant 110 jours et s'est achevé sans la moindre interruption ; une simple erreur de mémoire ou un plantage aurait suffi à faire échouer la tentative. La consommation électrique moyenne était d'environ 1 600 W, et l'exécution complète a consommé 4 305 kWh, soit 13.7 kWh par billion de décimales, contre une consommation estimée à 33 600 kWh sur environ 225 jours pour le précédent record de 300 billions de décimales.
Conclusion
Venice représente le lancement le plus réussi jamais réalisé par AMD en matière de processeurs pour serveurs, et son principal atout réside dans sa polyvalence. Une seule génération Zen 6 couvre une gamme allant d'un processeur à 256 cœurs à un nœud hôte LPDDR, en passant par un socket d'entreprise et une puce HPC avec cache empilé de 1152 Mo. Ainsi, un client peut construire chaque niveau d'un centre de données sur la même architecture et avec la même base logicielle. Les chiffres clés de ce lancement se confirment une fois les détails techniques pris en compte : un débit environ deux fois supérieur à celui d'Intel pour un prix comparable, une avance de 20 % par cœur par rapport à Vera avec un compilateur équivalent, et une densité de rack 1.9 à 2.2 fois supérieure à celle du processeur hôte de NVIDIA, selon la consommation énergétique.
L'aspect commercial de cette histoire ne nécessite aucune prévision. Le SP7 est actuellement en production, et les plateformes partenaires sont attendues au quatrième trimestre ; le SP8 suivra au premier semestre 2027, précédé par Venice-X et Verano. L'entreprise qui les commercialise réalise déjà 46 % du chiffre d'affaires des processeurs pour serveurs, et la demande pour ses composants actuels dépasse largement l'offre, si bien que les acheteurs préfèrent patienter plutôt que de se tourner vers d'autres solutions. Même si Venice était retardé d'un an, les comparaisons de cet article resteraient synonymes de leadership, car Turin surpasse déjà tous les autres produits du classement, qu'ils soient déjà livrés ou non. AMD est tellement en avance que son concurrent le plus proche, pour le moment, est sa propre génération précédente.


 Amazon