

Mise à jour du 13 novembre 2026 : Le Dell Pro Precision 9 T4 rejoint la liste des meilleures tours Xeon pour l’IA locale. La section consacrée aux tours regroupe désormais les choix par plateforme hôte, et notre rubrique « Notre classement » inclut désormais les tours testées avec notre suite llama.cpp sous Linux. Le 24 octobre, la réponse concernant Mac Studio a été mise à jour pour les modèles M5 Max et M5 Ultra qu’Apple a commencé à commercialiser en septembre.
Chaque système présenté sur cette page a été testé dans le laboratoire de StorageReview. Nous évaluons directement les performances d'IA locales : débit de service en ligne vLLM, temps d'obtention du premier jeton et temps par jeton de sortie pour différents modèles, notamment GPT-OSS-120B, Llama 3.1 8B, Mistral Small 3.1 24B et Qwen3 Coder 30B, ainsi que l'efficacité de calcul MAMF et les performances de stockage GDSIO. Aucun système n'est classé à partir de sa fiche technique.
La question cruciale pour un poste de travail IA local en 2026 est celle de la mémoire unifiée par rapport à la VRAM dédiée . Les systèmes de bureau comme le DGX Spark de NVIDIA (basé sur le GB10) et le Ryzen AI Max (Strix Halo) d'AMD intègrent 128 Go de mémoire unifiée sur une seule puce à des prix compétitifs, proposant des modèles qui nécessiteraient autrement plusieurs GPU dédiés.
Les stations de travail offrent un débit brut impressionnant : les cartes RTX PRO 6000 Blackwell délivrent un nombre de jetons par seconde nettement supérieur, pour un coût et une consommation énergétique plusieurs fois plus élevés. Cette page classe les deux types de cartes, selon des catégories distinctes, à partir d'une série de tests identiques, car le choix optimal dépend du modèle le plus gourmand en ressources que vous souhaitez exécuter et de la réactivité requise.
En bref
| Catégories | Système | Mémoire | GPU (Testé / Max) | Revue complète |
|---|---|---|---|---|
| Meilleur système d'IA de bureau global | NVIDIA DGX Spark | 128 Go LPDDR5X unifié | GB10 intégré (fixe) | Test du DGX Spark |
| Meilleure implémentation GB10 | Acer Veriton GN100 | 128 Go LPDDR5X unifié | GB10 intégré (fixe) | Test du Veriton GN100 |
| Meilleure alternative x86 | AMD Ryzen AI Halo (Strix Halo) | Jusqu'à 128 Go de mémoire LPDDR5X unifiée | Radeon 8060S intégrée (fixe) | Test de Ryzen AI Halo |
| Optimisé sans carte graphique dédiée | HP Z2 Mini G1a | LPDDR5X unifiée (exécutée sous GPT-OSS 120B) | Intégré, sans GPU dédié (fixe) | Test du Z2 Mini G1a |
| Meilleur système GB300 | MSI XpertStation WS300 (alternative : ASUS ET900N G3) | 748 Go cohérents (252 Go HBM3e + 496 Go LPDDR5X) | GB300 intégré (fixe) | Test de la station XpertStation WS300 |
| Meilleure tour pour l'IA locale | Dell Precision 7875 | 192 Go GDDR7 (2 × 96 Go) | 2× RTX PRO 6000 / 2 max | Test du Precision 7875 |
| Meilleure tour Xeon pour l'IA locale | Dell Pro Precision 9 T4 | 192 Go GDDR7 (2 × 96 Go) | 2× RTX PRO 6000 Max-Q / 2 max | Test du Pro Precision 9 T4 |
| Meilleure plateforme multi-GPU | HP Z8 Fury G6i | 192 Go GDDR7 (configuration testée) / jusqu'à 384 Go | 2 cartes RTX PRO 6000 testées / 4 max. | Test du Z8 Fury G6i |
| Le choix extrême | Comino Grando RTX PRO 6000 | 768 Go GDDR7 (8 × 96 Go) | 8× RTX PRO 6000 / 8 max | Avis sur Comino Grando |
Appareils d'IA de bureau
La gamme d'appliances, que Dell nomme « IA de bureau » et NVIDIA « supercalculateur d'IA personnel » , privilégie la capacité de modélisation, l'efficacité énergétique et le prix au détriment du débit maximal. Dotés de 128 Go de mémoire unifiée, ces systèmes gèrent aisément des modèles de classe 70 B à haute quantification et peuvent atteindre la classe 120 B, des charges de travail qui exigeraient plusieurs GPU dédiés dans une tour.
Lecture essentielle pour ce niveau de laboratoire : notre test thermique DGX Spark compare les conceptions de refroidissement OEM des systèmes GB10 ci-dessous et s’applique à chaque unité de cette classe jusqu’à ce que ces plateformes fassent l’objet d’une révision.
Meilleur système d'IA de bureau toutes catégories confondues : NVIDIA DGX Spark
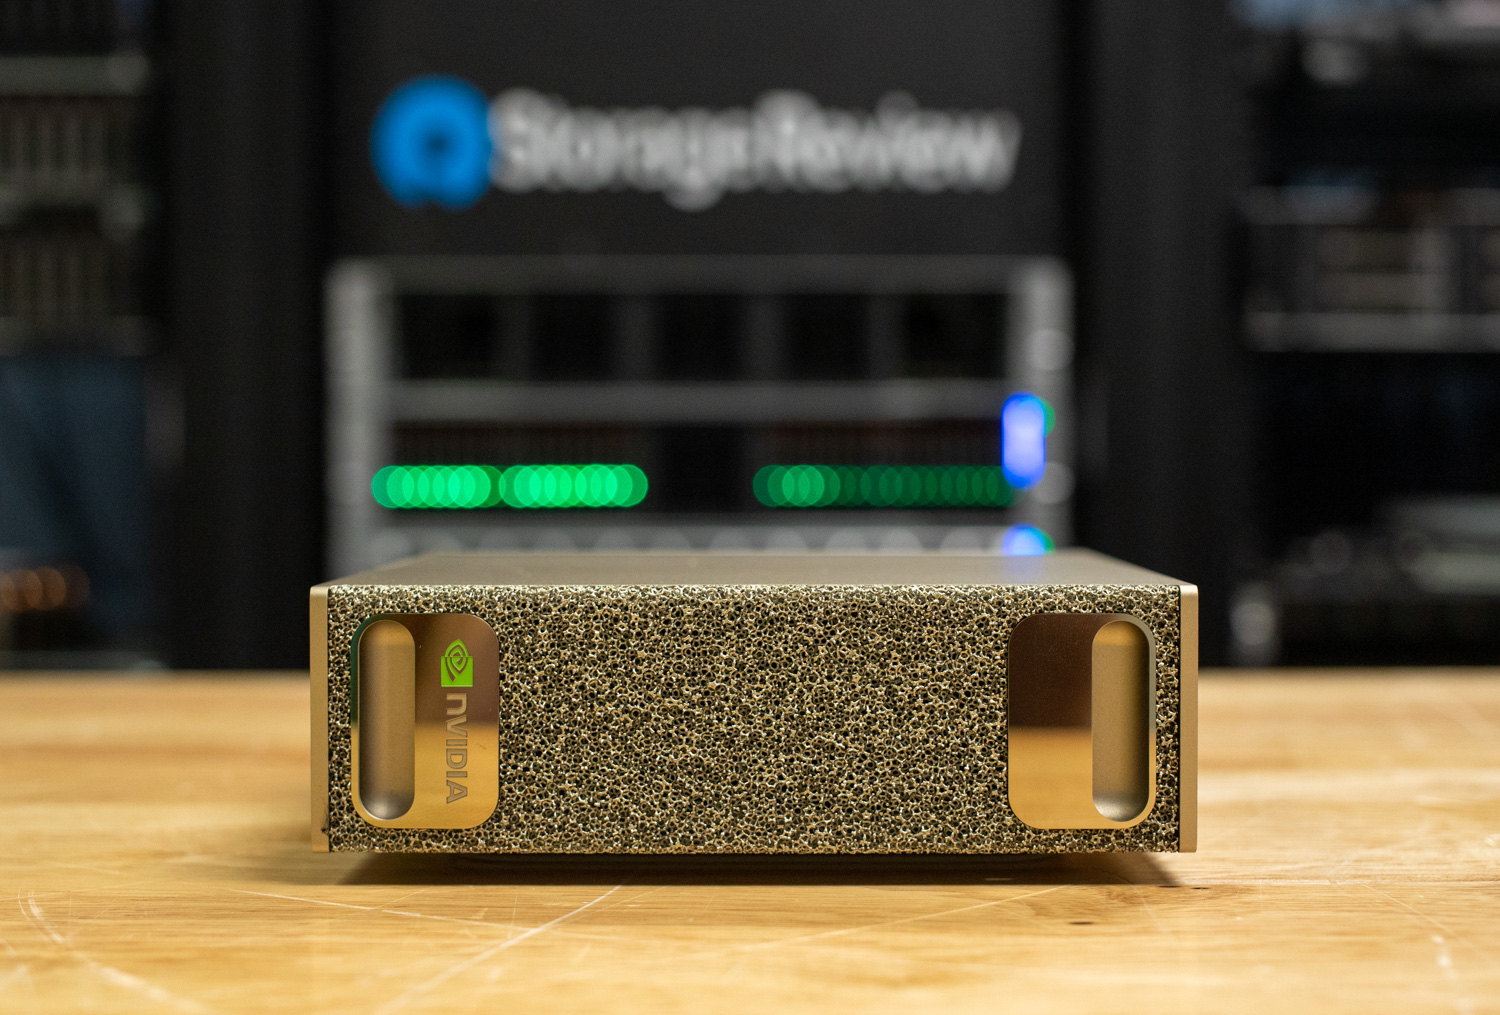
Le DGX Spark est la référence absolue pour tous les autres boîtiers d'IA de bureau. Sa puce GB10 Grace Blackwell associe un processeur Arm à 20 cœurs à 128 Go de mémoire LPDDR5X unifiée et à deux ports ConnectX-7 200 GbE, ce qui en fait le seul appareil que nous avons testé capable de fonctionner en cluster dès sa sortie d'usine : nos tests d'inférence distribuée sur deux nœuds ont exécuté des charges de travail parallèles en pipeline sur des nœuds Dell, GIGABYTE et HP via une connexion 200 GbE.
Cette technologie de clustering est désormais plus accessible : NVIDIA a lancé le 23 octobre une barrette DGX Spark de 64 Go à 4 999 $ , distribuée par les six mêmes constructeurs. Deux de ces barrettes sont appariées via un câble 200 GbE pour atteindre une capacité totale de 128 Go. NVIDIA annonce des performances jusqu’à 1.7 fois supérieures à celles d’une barrette de 128 Go sous Qwen 3.8 27B pour cette paire de barrettes appariées, une affirmation que nous n’avons pas encore vérifiée. La pile logicielle CUDA reste la plus complète du segment.
La seule limite absolue de la plateforme est le stockage : chaque système GB10 plafonne à environ 4 To sur un seul emplacement M.2 court. Notre architecture de stockage partagé à huit Spark constitue la solution idéale : une baie QLC unique, gérée et accessible via les ports 100 GbE déjà présents sur chaque Spark. Un client y atteint une vitesse de lecture de 10.8 Gio/s, égalant ainsi le débit du SSD M.2 interne le plus rapide que nous ayons mesuré sur un système GB10. Un modèle de 78 Go hébergé de manière centralisée affiche des performances équivalentes à 13 % de celles du SSD NVMe local.
Lire le test complet du DGX Spark
Meilleure implémentation GB10 : Acer Veriton GN100
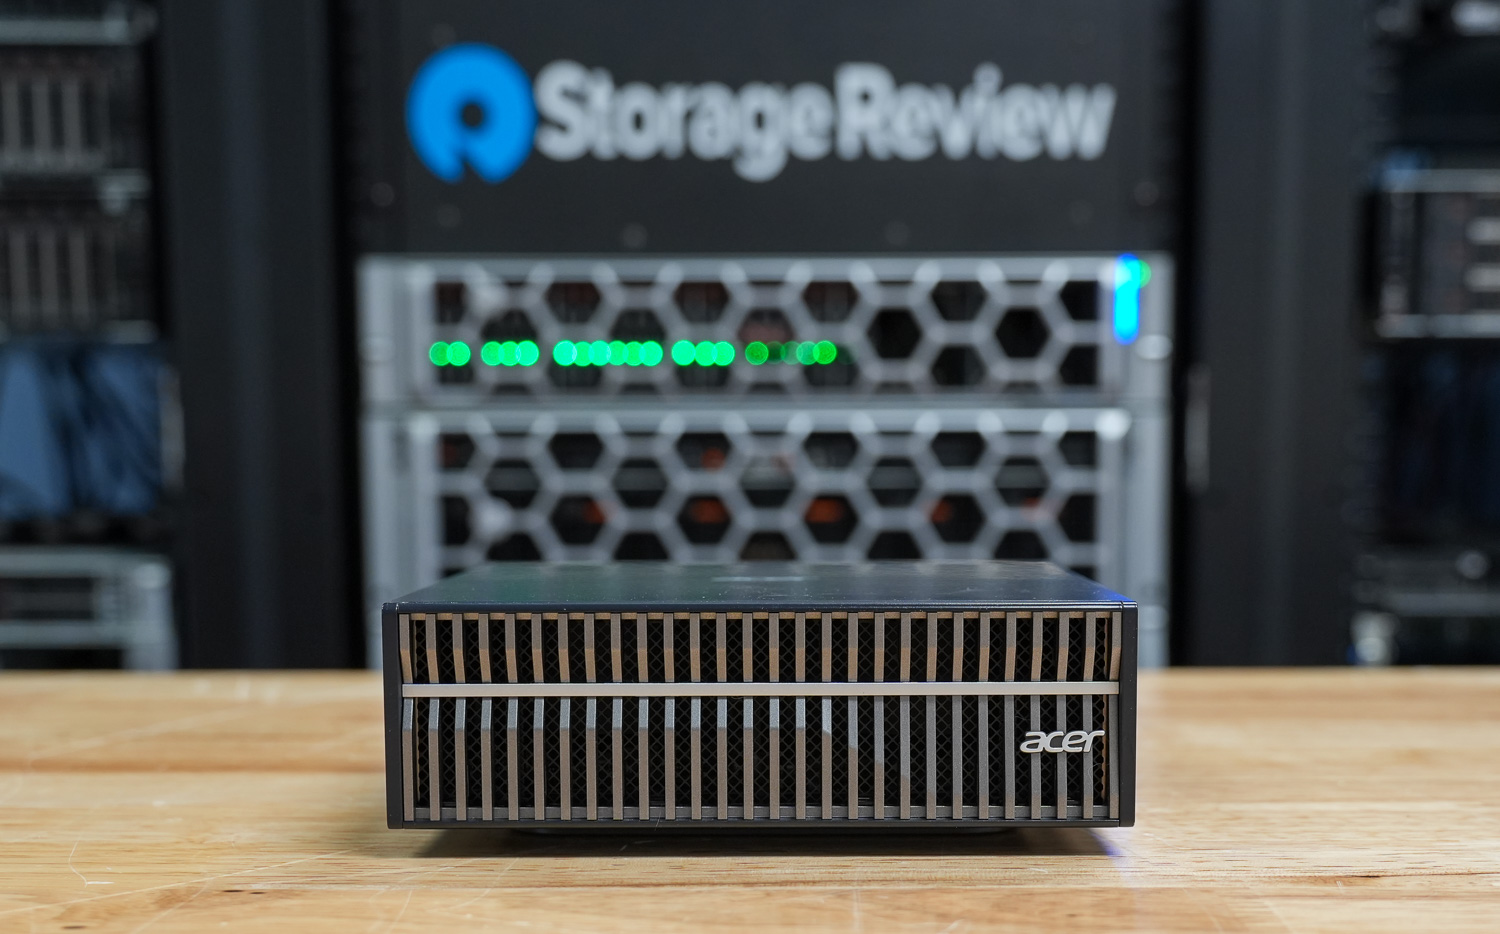
Parmi les systèmes OEM GB10, la conception thermique est le véritable facteur de différenciation, et le Veriton GN100 s'est distingué lors de nos tests. Tous les boîtiers GB10 partagent la même configuration de puce et de mémoire ; les performances soutenues dépendent donc du refroidissement. À notre connaissance, notre comparatif thermique multi-OEM est le seul du genre publié.
Lire le test complet du Veriton GN100
Meilleure alternative x86 : AMD Ryzen AI Halo
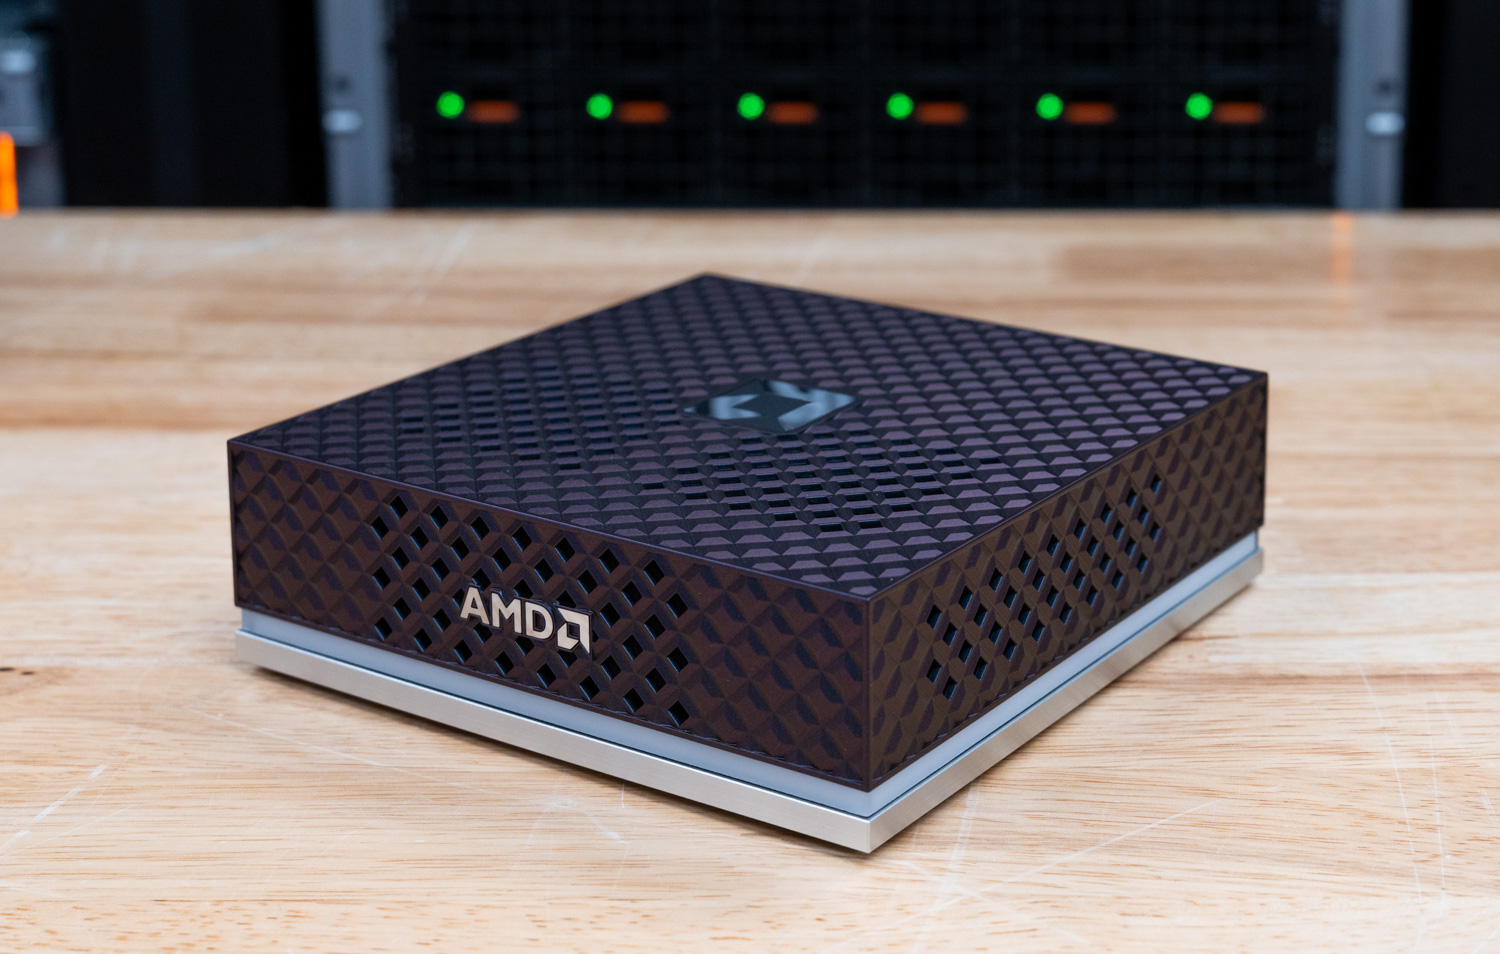
Si vous avez besoin de Windows ou d'une pile logicielle x86 standard, Strix Halo est la solution idéale pour une utilisation au bureau. La plateforme AMD Ryzen AI Max+ 395 associe 128 Go de mémoire unifiée à une configuration à double système d'exploitation. Lors de nos tests, elle a géré des modèles de classe 200 milliards de paramètres, s'attaquant directement au DGX Spark sans l'engagement lié à l'architecture Arm/DGX.
Lire le test complet de Ryzen AI Halo
Meilleur sans carte graphique dédiée : HP Z2 Mini G1a
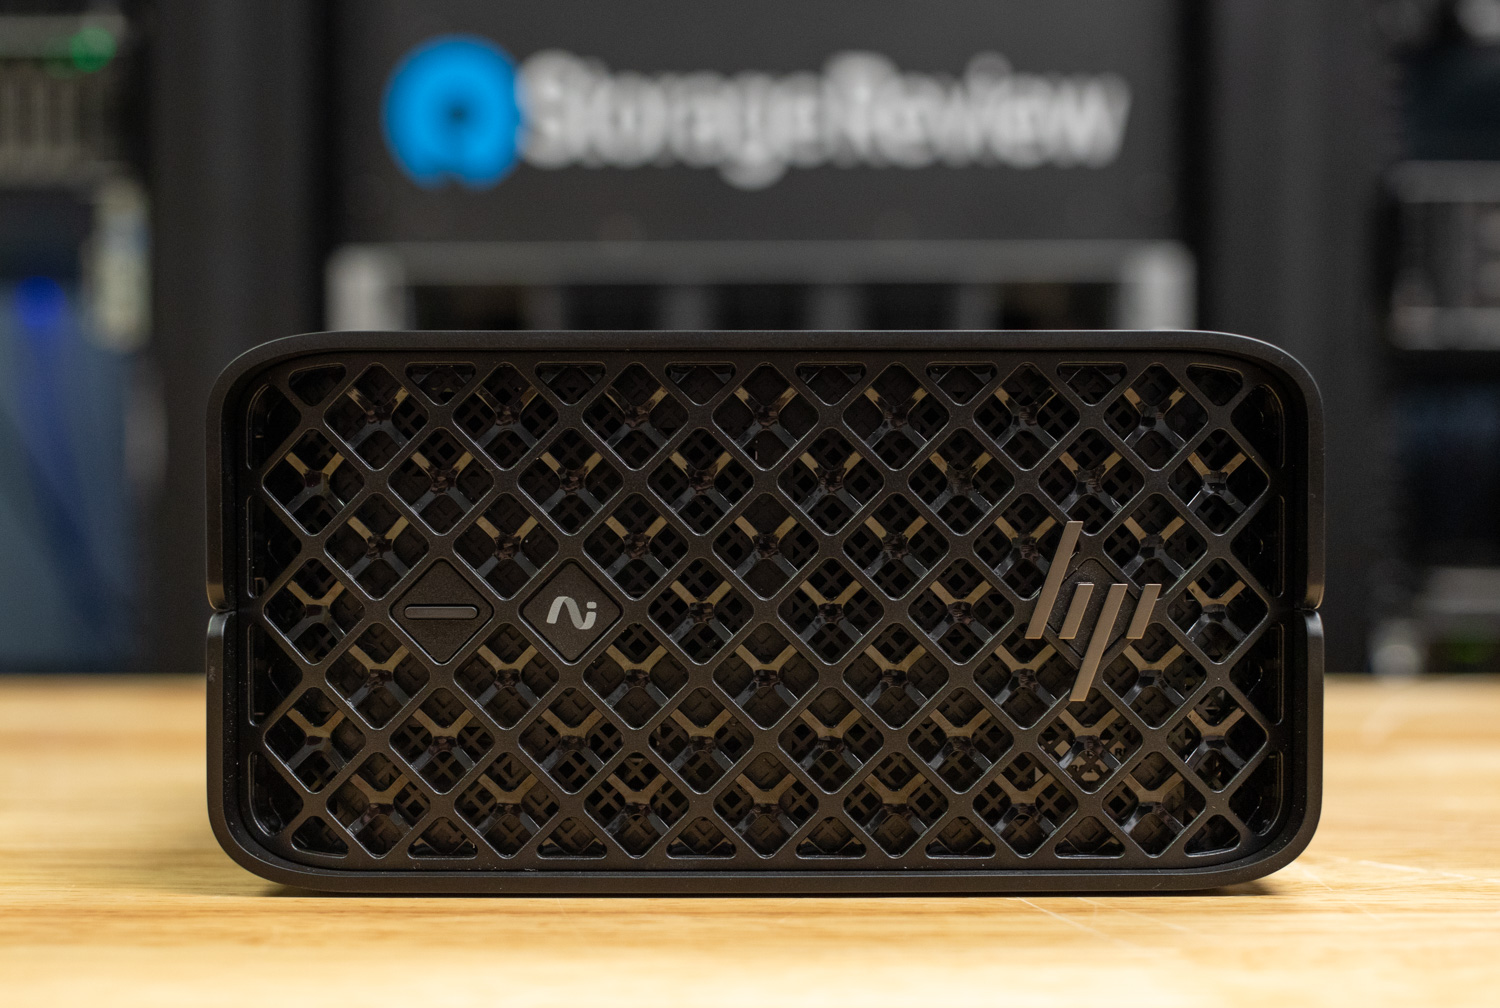
La Z2 Mini G1a prenait en charge GPT-OSS 120B sans carte graphique dédiée. Cette mini-station de travail HP intègre le processeur AMD Ryzen AI Max+ PRO dans un châssis compact, silencieux et idéal pour les environnements informatiques. Elle reste la preuve la plus flagrante que les systèmes x86 à mémoire unifiée ont révolutionné les performances des petits ordinateurs de bureau, les rendant comparables aux modèles plus imposants.
Lire le test complet du Z2 Mini G1a
Meilleur système GB300 : MSI XpertStation WS300
La WS300 est la première station GB300 DGX testée dans notre laboratoire, et elle redéfinit les standards de cette gamme d'appliances. La puce Grace Blackwell Ultra intègre 748 Go de mémoire cohérente (252 Go HBM3e et 496 Go LPDDR5X) et une puissance de calcul FP4 de 20 pétaFLOPS. Lors de nos tests, elle a géré un point de contrôle GLM-5.2 de 433 Go avec 216 Go de poids d'experts stockés dans la mémoire Grace ; un modèle conçu pour une utilisation intensive sur un bureau. Comme tous les systèmes de la gamme DGX, elle fonctionne sous DGX OS et non sous Windows ; une telle quantité de mémoire implique des performances bien supérieures à celles requises.
Son prix et sa consommation le rapprochent davantage des modèles tour que des boîtiers GB10, mais aucun autre appareil de cette catégorie ne propose un modèle aussi imposant. La question qui se posait, à savoir si un processeur de 1 300 W subit une limitation de fréquence dans une tour, trouve désormais une réponse concrète : notre analyse thermique approfondie du WS300 a révélé un fonctionnement continu de 2.8 heures avec la puce Blackwell Ultra maintenue à 60 °C, une fréquence d'horloge stable de 2.07 GHz sans aucune chute de température, et une marge thermique d'environ 20 °C à pleine charge.
Alternative au GB300 : l’ASUS ExpertCenter Pro ET900N G3 est la deuxième station DGX GB300 que nous avons testée, et elle confirme les performances de la plateforme : sur 14 modèles et deux charges de travail, 24 des 28 comparaisons de débit maximal se situent à moins de 2 % du WS300, et les modèles à pool cohérent affichent des performances équivalentes, voire supérieures. ASUS ajoute des poignées de transport à la tour de 27 kg, un ventilateur dédié au-dessus des cages optiques de 400 Go et une alimentation certifiée 80 PLUS Titanium. Les deux tours offrent les mêmes performances ; consultez notre test de l’ET900N G3 pour une comparaison des deux tours.
Mise à l'échelle en cluster : deux de ces tours câblées ensemble via leurs propres ports 400G sont maintenant mesurées, et non promises : notre test de cluster GB300 a associé les stations ASUS et HP à deux DAC, a atteint 98 % du débit de ligne sur les collectifs NCCL et a transformé GLM-5.2, un modèle de 433 Go qu'une seule station ne peut gérer qu'en déversant 215 Go de poids dans la mémoire Grace, de 139 jetons de sortie par seconde à 32 flux à 1 525, en route vers 3 141 à 256.
Les modèles qui s'adaptent à une même station ont des échelles différentes : la désagrégation préremplissage/décodage a triplé le débit à invite courte du GLM-5.3 Flash, et le DeepSeek V4.1 Flash a affiché 5 248 jetons par seconde, le débit le plus élevé de l'ensemble.
Lire le test complet de la XpertStation WS300
Au laboratoire : Station d'IA HP ZGX Fury
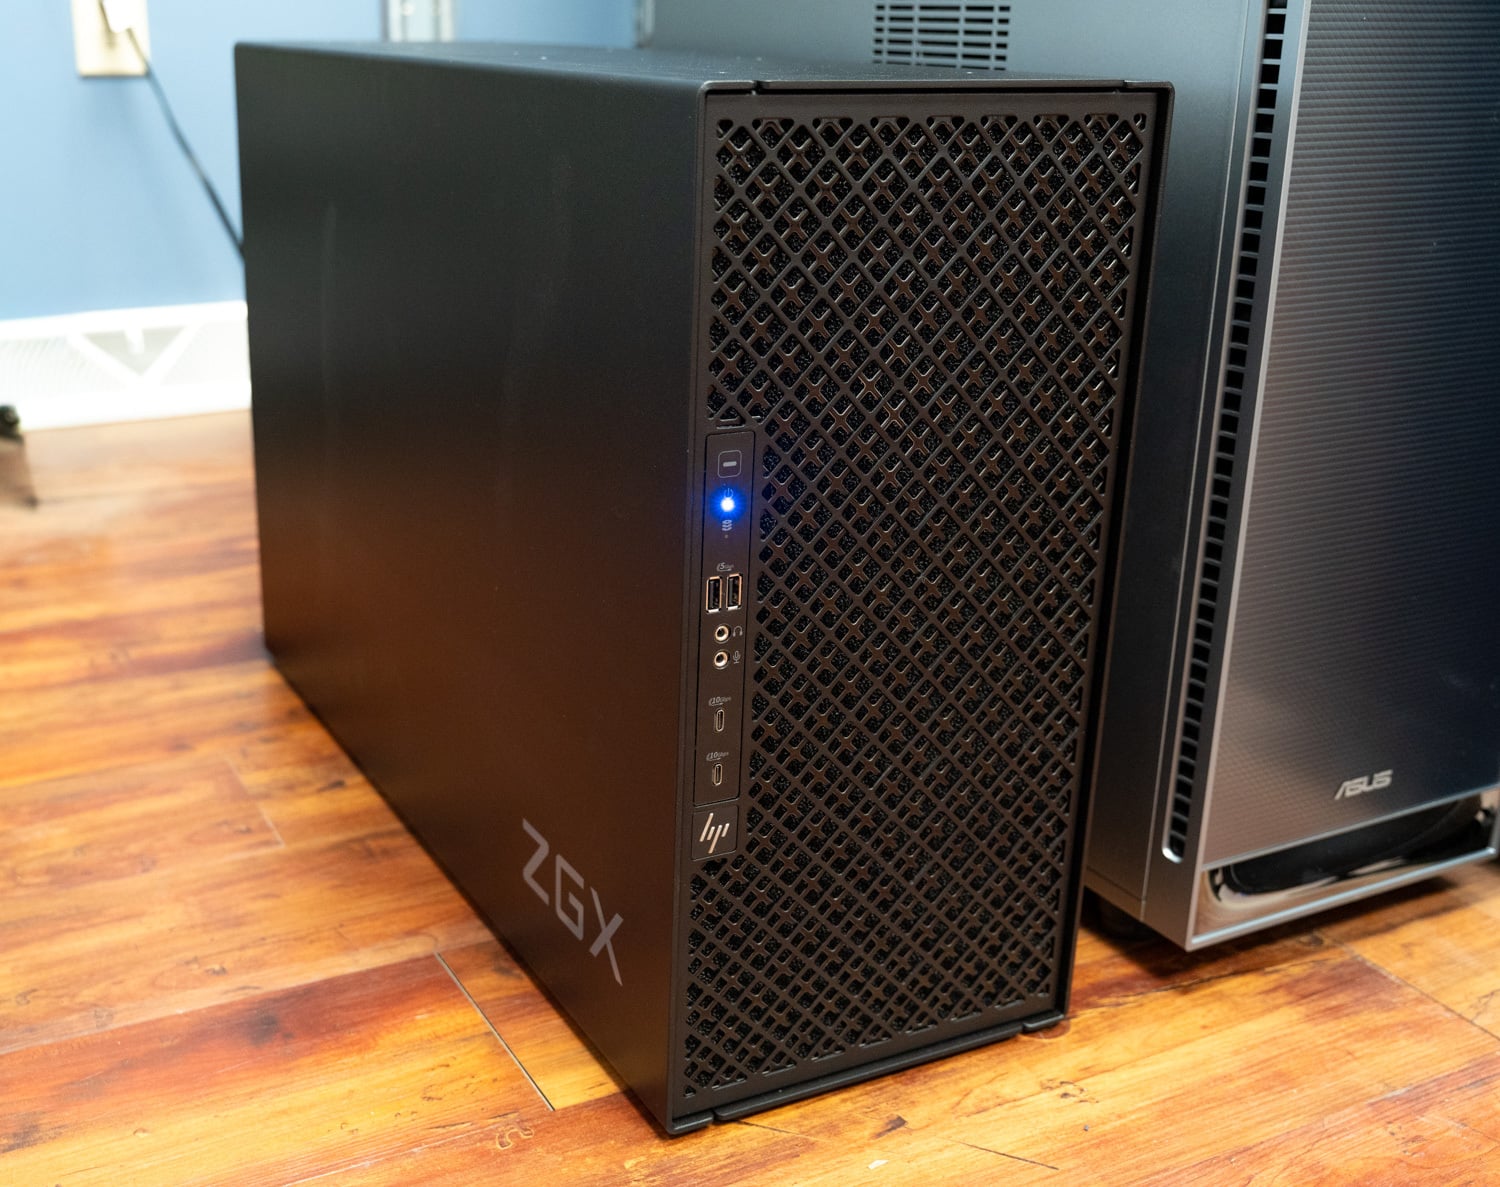
La station d'IA HP ZGX Fury est actuellement dans notre laboratoire. Elle repose sur la même plateforme NVIDIA GB300 Grace Blackwell Ultra que la MSI XpertStation WS300 mentionnée précédemment, ce qui nous offre la première occasion de comparer les performances des deux implémentations de l'architecture DGX Station sur un même banc d'essai : dissipation thermique, acoustique, fréquences d'horloge soutenues et expérience utilisateur au quotidien.
Ses premiers résultats publics sont déjà disponibles : le ZGX Fury a servi de deuxième tour dans notre test de cluster GB300 à deux stations , en effectuant le décodage pour la configuration Flash GLM-5.3 désagrégée et la moitié de chaque exécution parallèle de tenseurs. Le test individuel est en cours, et le ZGX Fury intégrera le classement une fois ses propres résultats de test disponibles.
Le ZGX Fury est également l'un des deux premiers systèmes que Microsoft a nommés pour DGX Station sous Windows , aux côtés du Dell Pro Precision avec GB300. NVIDIA a par ailleurs annoncé la version Windows pour le quatrième trimestre. Le matériel est identique aux tours GB300 que nous avons testées sous Ubuntu ; la question de savoir si les serveurs s'exécuteront nativement sous Windows ou via WSL reste ouverte pour cette version.
À l'horizon : Station d'accueil AMD Threadripper Halo
Annoncée à l'IFA 2026 et non encore testée en laboratoire, la station Threadripper Halo d'AMD est la première réponse directe aux cartes graphiques de la gamme GB300. Son approche inverse celle de NVIDIA : au lieu d'un unique pool de mémoire cohérent, AMD associe un Threadripper PRO à 96 cœurs sur une plateforme offrant jusqu'à 2 To de mémoire DDR5 à huit canaux et 128 lignes PCIe 5.0, à deux accélérateurs Instinct MI350P de 600 W dotés chacun de 144 Go de HBM3E, avec la possibilité d'étendre la capacité à quatre cartes et 576 Go de HBM. L'ensemble du système est refroidi par liquide, et l'architecture x86 contourne les problèmes de compatibilité avec la chaîne d'outils Arm que nous avions relevés lors du test de la WS300.
La question qui reste en suspens est celle de la performance des modèles face aux cartes PCIe et à la cohérence NVLink-C2C. AMD n'a communiqué aucun benchmark, prix ni disponibilité pour le moment ; il s'agit donc d'un produit à suivre de près, et non d'un choix sûr. Plus de détails sont disponibles dans notre article d'annonce ; il intégrera le classement dès que le matériel sera disponible en laboratoire.
Également testés : les appareils d’IA de bureau
Ces systèmes ont subi le même processus de laboratoire et constituent des choix solides qui n'ont pas occupé de place dans une catégorie : Dell Pro Max avec GB10 , ASUS Ascent GX10 , GIGABYTE AI TOP ATOM , HP ZGX Nano G1n et HP EliteDesk 8 Mini G1a.
Tours de postes de travail pour l'IA locale
Lorsque la réactivité prime sur le coût d'acquisition (assistants de programmation interactifs, serveurs multi-utilisateurs, pipelines d'agents avec de longues chaînes d'appels d'outils), la VRAM dédiée reste la solution privilégiée. Ces tours sont classées ici selon leur débit d'inférence et leur capacité mémoire maximale. Pour chacune, nous indiquons la configuration GPU testée ainsi que la capacité maximale du châssis, car celle-ci est tout aussi importante que les composants installés lors de notre test ; une tour doit donc être équipée d'au moins deux GPU pour figurer dans cette section. Les tours mono-GPU, notamment celles dotées d'une RTX PRO 6000 de 96 Go, sont classées sur notre page « Meilleures stations de travail de bureau » de notre suite client Windows, car elles répondent à un besoin différent.
Nous classons également les tours par plateforme hôte, car le processeur et la mémoire associés aux cartes graphiques déterminent la façon dont une tour gère les modèles sortant de la mémoire GPU, la recherche vectorielle et les simulations qui sollicitent souvent la même machine. La Precision 7875 domine la catégorie Threadripper et conserve son titre de meilleure tour, la Pro Precision 9 T4 est en tête pour les processeurs Xeon, et la catégorie Core Ultra s'ouvre lorsqu'une tour Core Ultra bi-GPU arrive dans notre laboratoire.
Meilleure tour pour l'IA locale : Dell Precision 7875
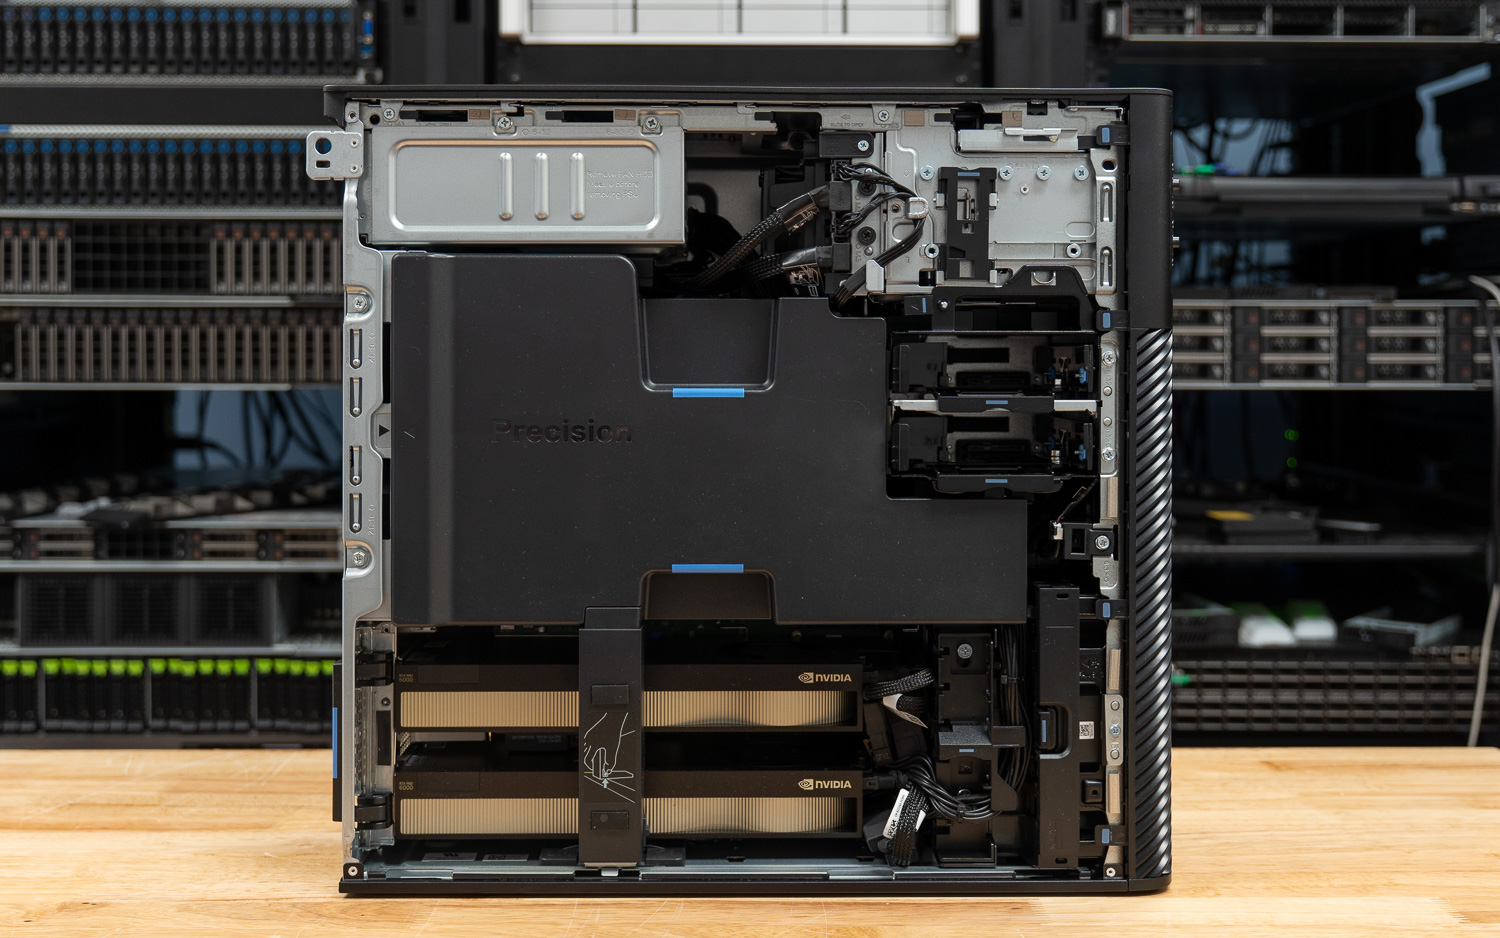
Grâce à ses deux GPU RTX PRO 6000 Blackwell, le Precision 7875 est le système au format standard le plus rapide que nous ayons testé pour l'inférence locale. Avec un Threadripper PRO 9995WX et 192 Go de VRAM combinée répartis sur les deux cartes, il gère les modèles de classe 100B entièrement en mémoire GPU, tout en offrant un temps de réponse du premier jeton (TTIF) digne des systèmes interactifs, qu'aucun autre système à mémoire unifiée n'atteint. Attention cependant : le châssis du 7875 ne supporte que deux cartes double largeur au maximum. Notre configuration à deux GPU représente donc la limite maximale ; il est impossible d'en ajouter un troisième ultérieurement.
Lire le test complet du Precision 7875
Meilleure tour Xeon pour l'IA locale : Dell Pro Precision 9 T4
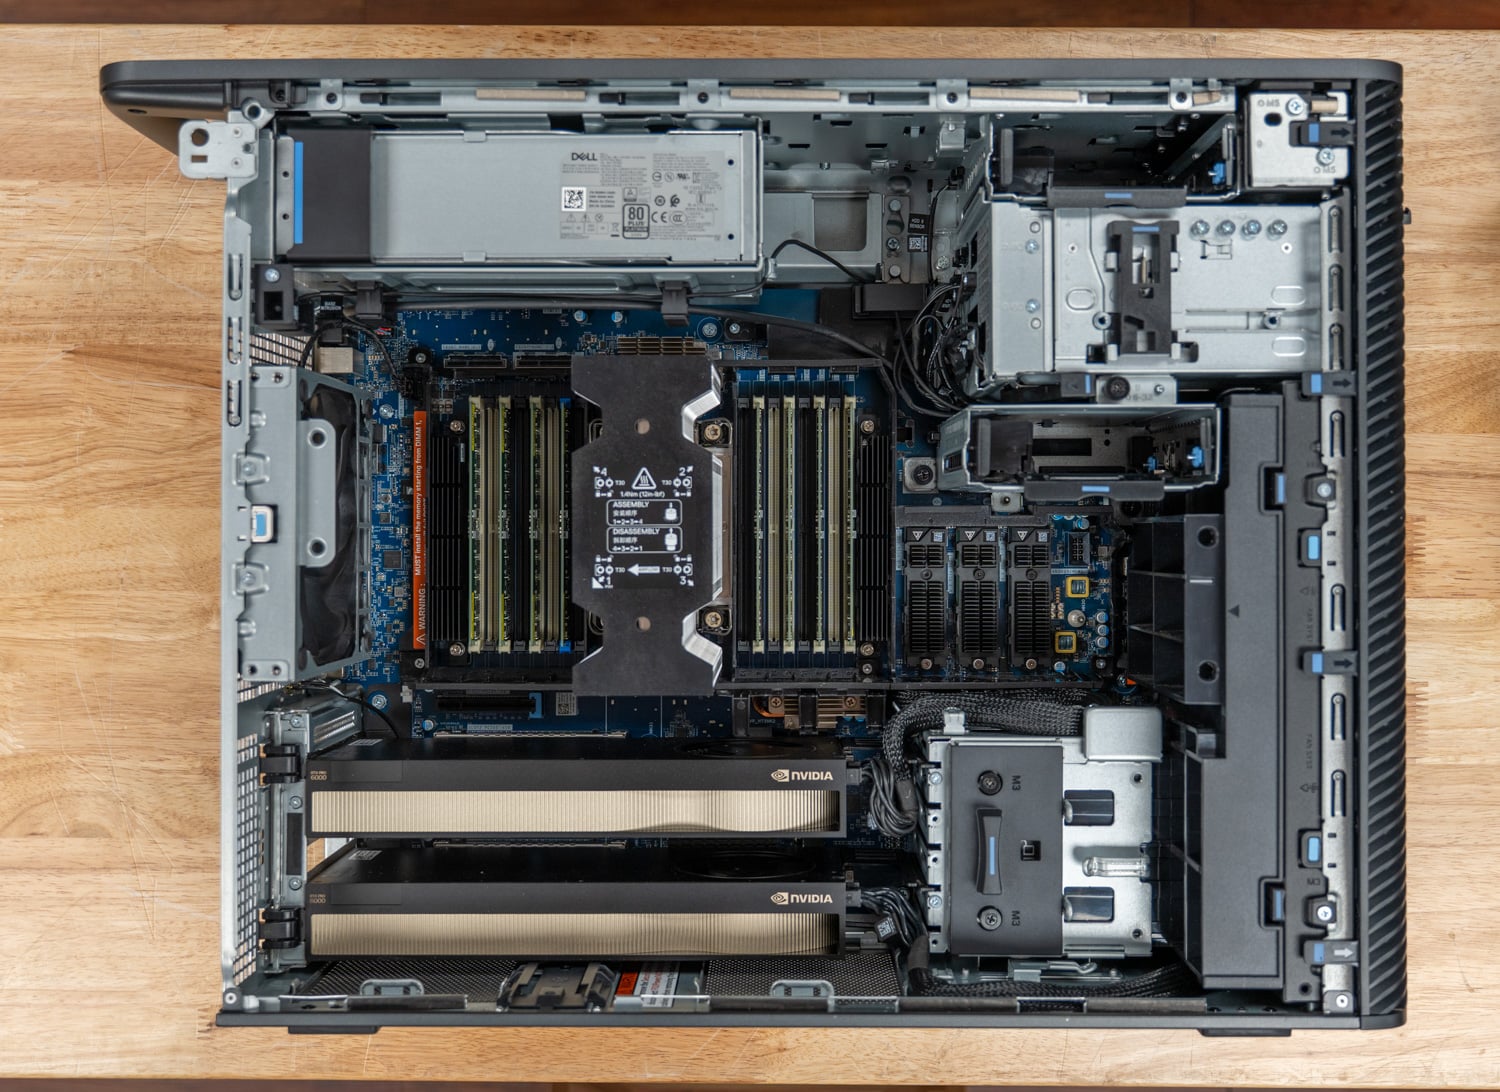
Le Pro Precision 9 T4 égale le Precision 7875 au niveau des GPU et le surpasse pour toutes les applications gérées par le Xeon. Ses deux cartes RTX PRO 6000 Max-Q affichent des performances similaires à celles de la paire identique du 7875 (de 1 à 9 % en configuration mono-GPU) et inférieures à 10 % en configuration bi-GPU avec optimisation fine. Réparti sur les deux cartes, le MiniMax M2.7, un modèle de 129.3 Go trop volumineux pour une seule carte, a généré 83.7 jetons par seconde pour un utilisateur, contre 85.0 pour le 7875.
La différence réside dans le processeur : huit canaux de DDR5-6400 offrent au Xeon 698X à 86 cœurs une bande passante mémoire de 328 Go/s, soit 53 % de plus que le 7875, ce qui se traduit par des performances nettement supérieures. La recherche vectorielle HNSW s'est effectuée 1.51 fois plus rapidement qu'avec le 7875, la création de l'index a pris 27.3 secondes contre 34.8, et la résolution OpenFOAM drivAer s'est achevée en 293 secondes contre 556. Son disque de démarrage Gen5 a également chargé à froid gpt-oss:120b en 15.2 secondes contre 25.8.
Le 7875 conserve sa place de choix car il surpasse le T4 dans tous les tests de débit liés au GPU, et son processeur Threadripper exécute les tâches de rendu et de compilation gourmandes en ressources 18 à 38 % plus rapidement. Le T4 est la tour idéale pour les équipes qui déploient et intègrent des modèles, ainsi que des fonctions de simulation et d'analyse, sur une seule machine. Le configurateur Dell le limite à deux cartes RTX PRO 6000. Son prix affiché sur Dell.com, dans cette configuration, était d'environ 66 600 $ au moment de ce test.
Lire le test complet du Pro Precision 9 T4
Meilleure plateforme multi-GPU : HP Z8 Fury G6i
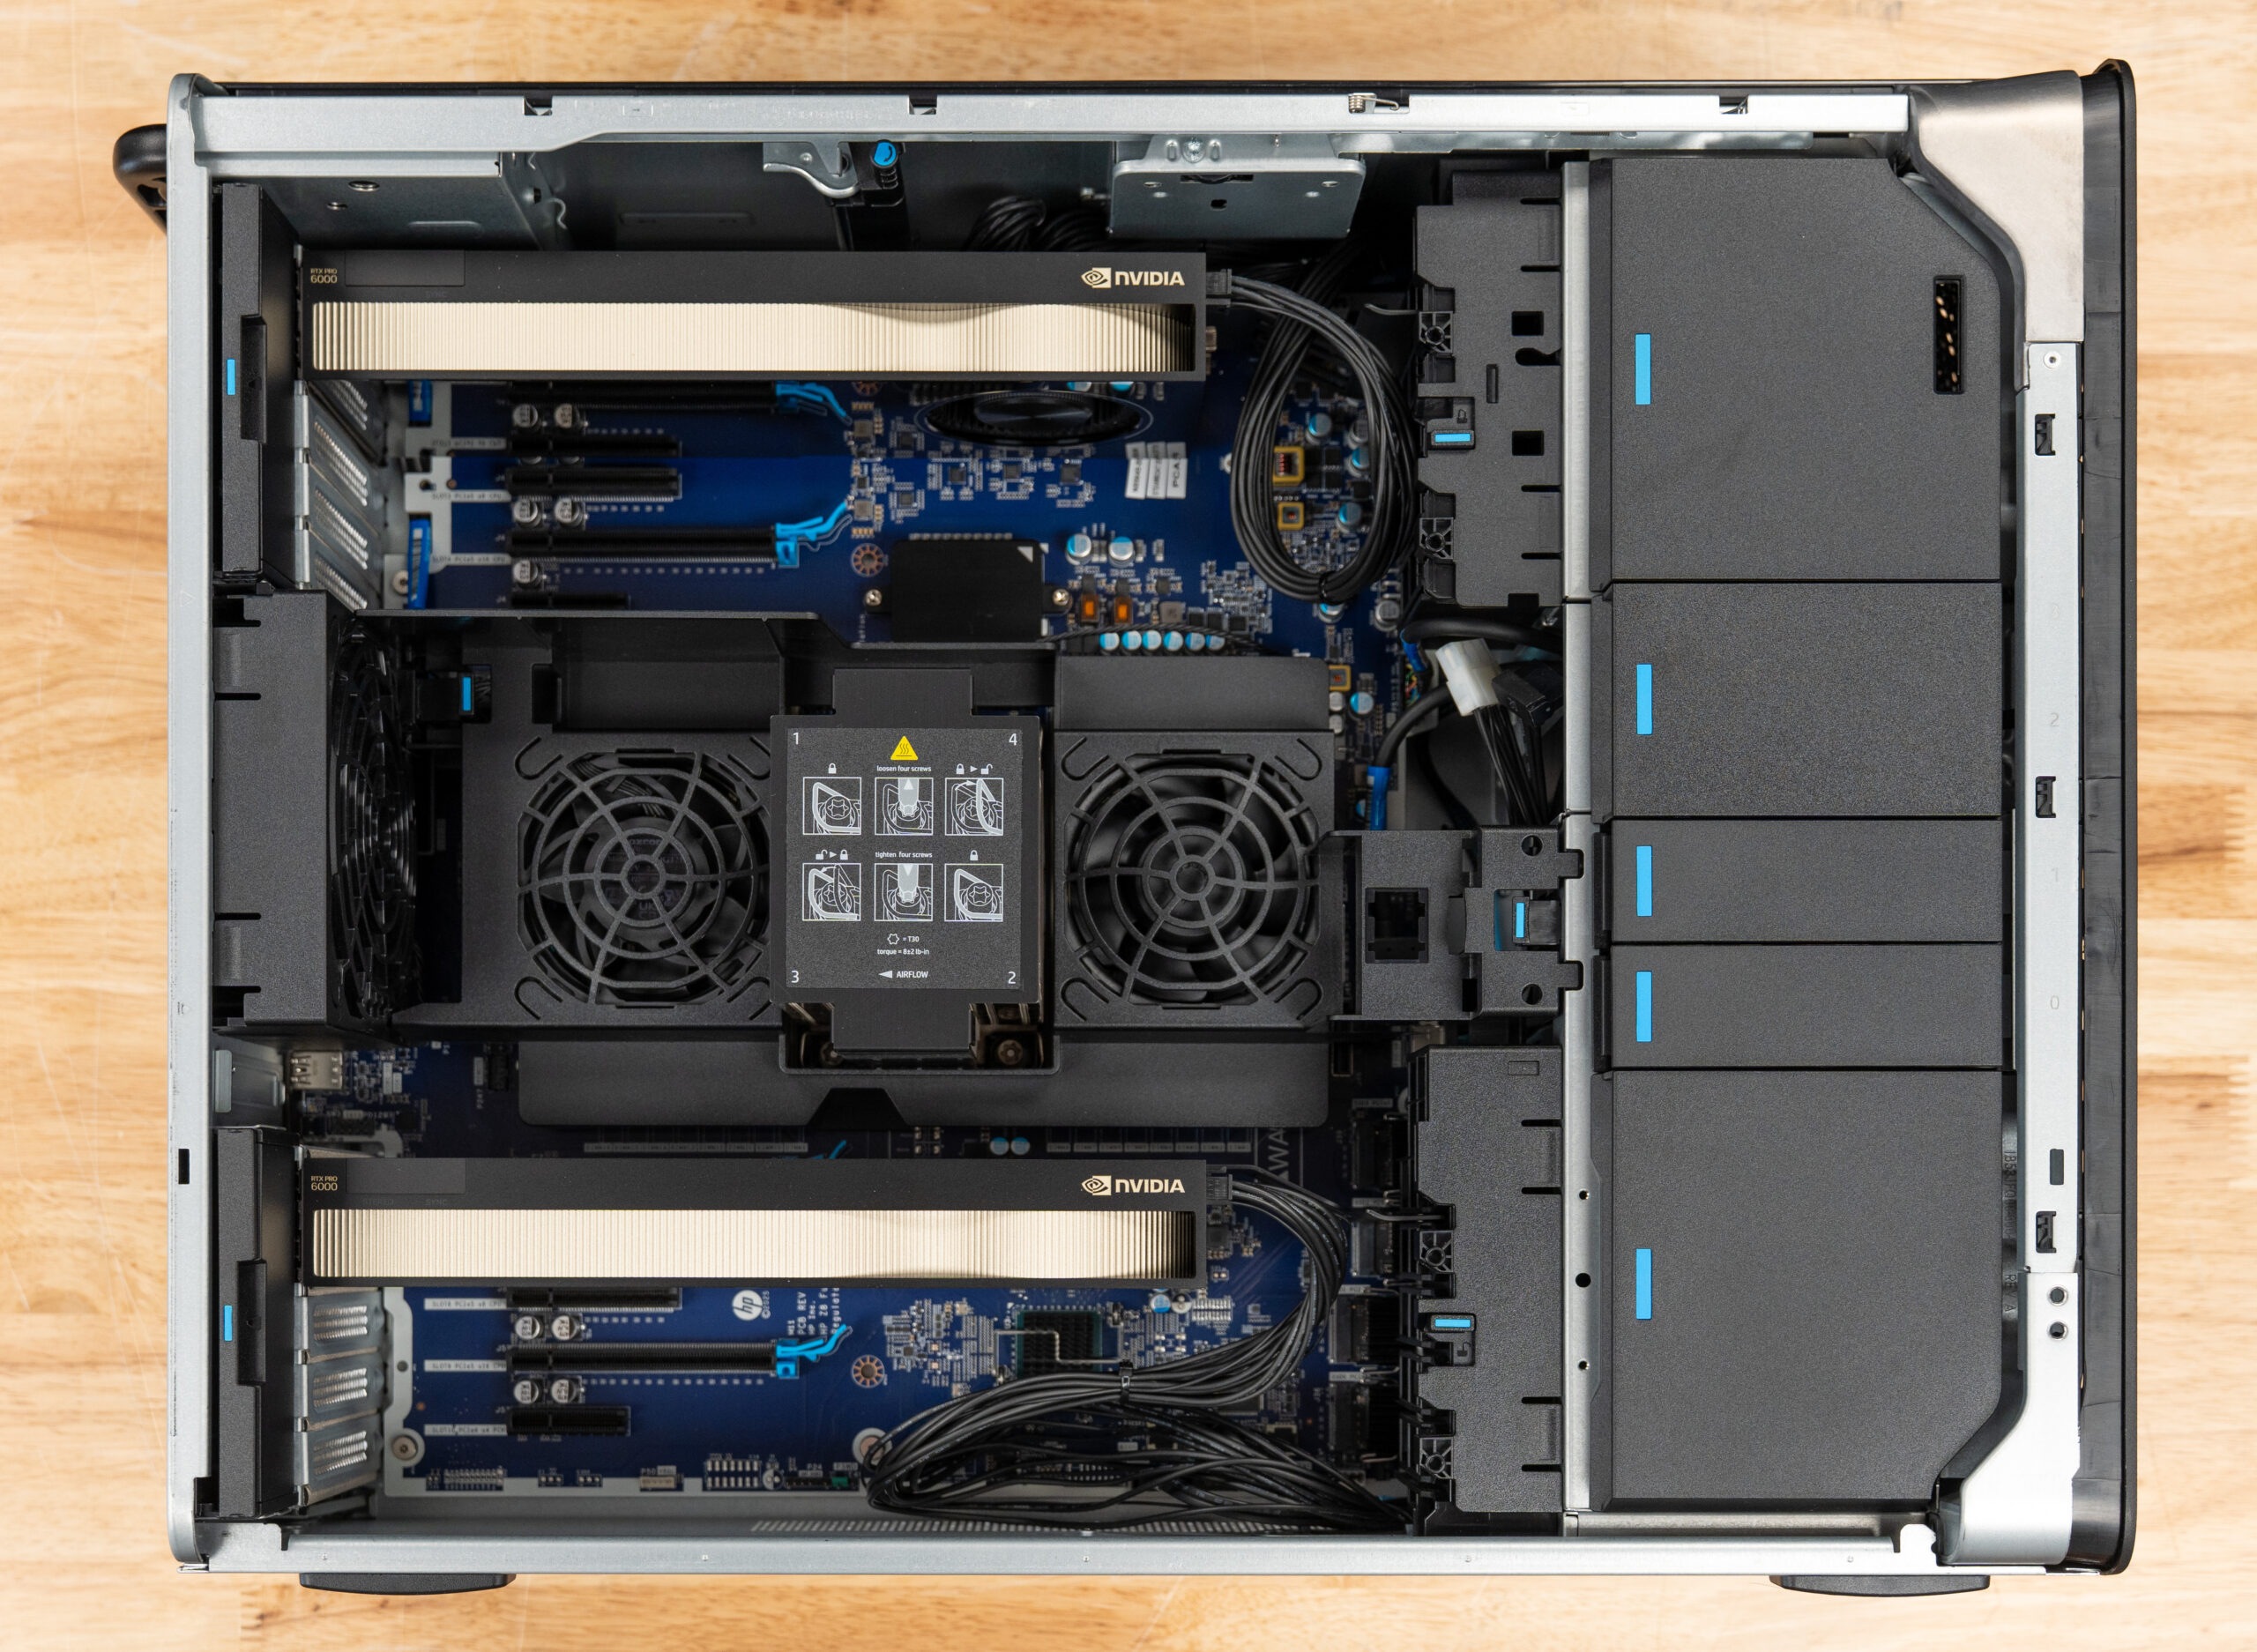
La Z8 Fury G6i est la tour idéale si vous prévoyez d'ajouter des cartes graphiques. Notre configuration de test était équipée de deux cartes RTX PRO 6000 Max-Q pour une capacité totale de 192 Go de VRAM, mais le châssis, alimenté par deux blocs d'alimentation d'une puissance maximale de 2 700 W, peut accueillir jusqu'à quatre cartes Blackwell et 384 Go de VRAM. Cet écart entre la configuration testée et la capacité maximale est révélateur : aucune tour standard de constructeur que nous avons testée n'offre une telle marge de manœuvre pour les cartes graphiques, et passer de deux à quatre cartes ne nécessite aucun changement de châssis.
Lire le test complet du Z8 Fury G6i
Le choix extrême : Comino Grando RTX PRO 6000
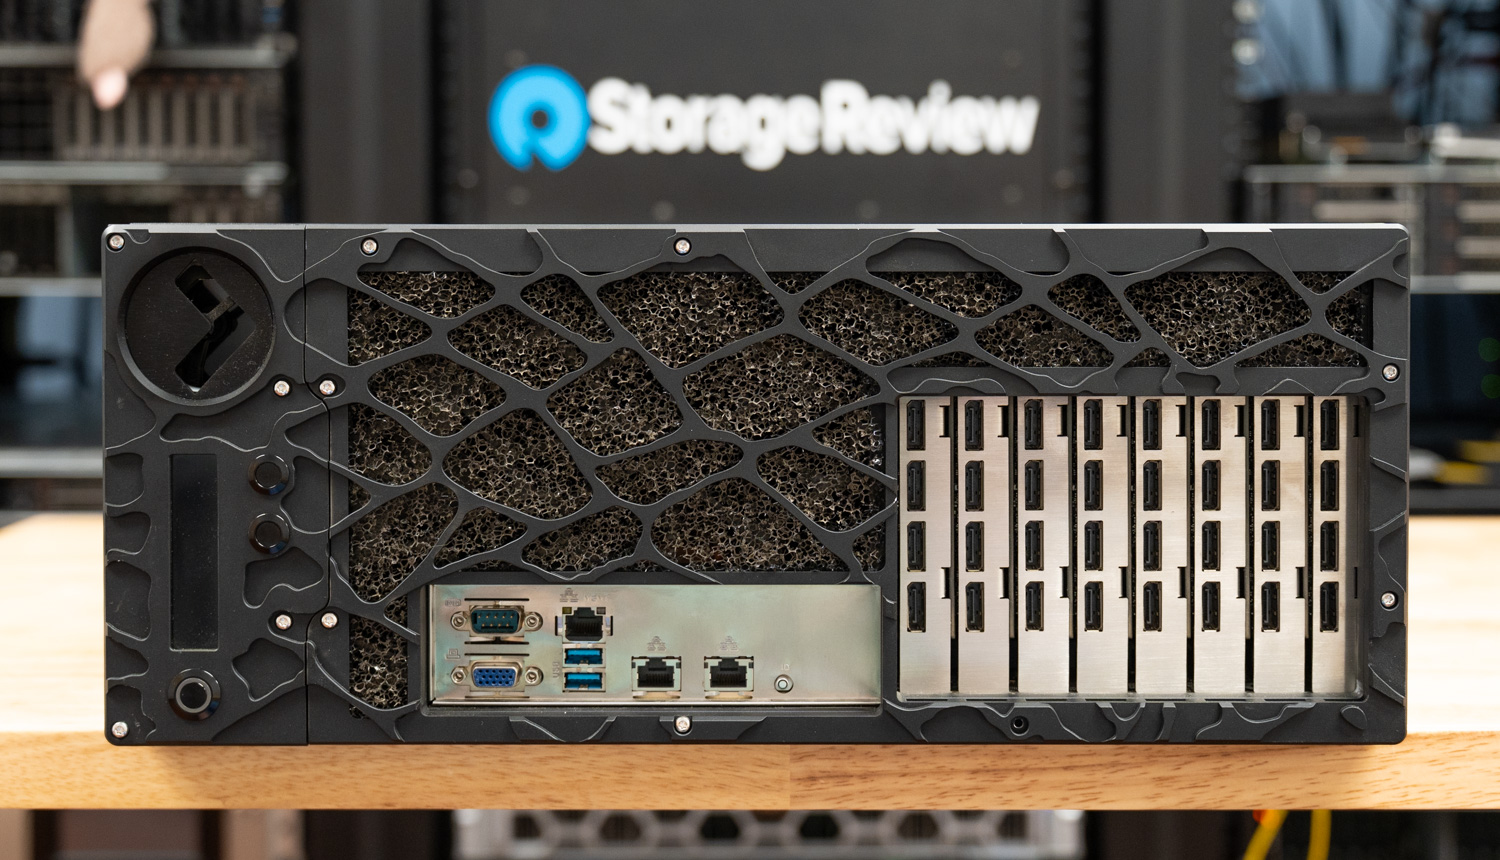
768 Go de VRAM dans un châssis 4U à refroidissement liquide : le Grando est conçu pour l’utilisateur dont le gabarit ne rentre nulle part ailleurs. Notre modèle de test était équipé de huit cartes RTX PRO 6000 Blackwell de 96 Go chacune, la capacité maximale du châssis, et le système de refroidissement liquide de Comino maintient les huit cartes à pleine consommation (TDP) 24 h/24 sans bridage. C’est plus de mémoire GPU que de nombreux serveurs rack, dans un format qui peut encore être installé à côté d’un bureau. Son prix est élevé, pas ses performances acoustiques, et il se positionne volontairement comme une exception dans cette sélection : la preuve que les performances graphiques ne sont plus à la hauteur des standards actuels.
Lire la critique complète du Comino Grando
Comment nous classons
Trois règles régissent chaque classement de StorageReview. Premièrement, seuls les systèmes testés en laboratoire sont classés : si nous n'avons pas effectué de test de performance, un système peut être mentionné, mais ne peut pas figurer dans une catégorie. Deuxièmement, les systèmes sont classés une seule fois par critère de mesure. Les tours mentionnées ci-dessus figuraient également dans notre classement des stations de travail de bureau selon les performances SPECworkstation et de rendu jusqu'en octobre 2026, date à laquelle cette page a été déplacée vers les systèmes mono-GPU ; leurs résultats dans ce classement restent disponibles dans leurs évaluations respectives, et ici, elles sont classées selon le débit d'inférence et la capacité mémoire maximale.
Troisièmement, une condition d'accès est requise : le système doit comporter au moins deux GPU, testés avec le serveur vLLM ou notre suite llama.cpp sous Linux, ou disposer d'une mémoire partagée d'au moins 96 Go. Les tours mono-GPU, même avec une carte de 96 Go, figurent dans notre classement des meilleures stations de travail de bureau pour Windows.
Le classement est établi à partir d'une combinaison de facteurs : débit de service en ligne vLLM, délai d'obtention du premier jeton, temps par jeton de sortie, efficacité de calcul MAMF, performances de stockage GDSIO et prix du marché. En cas d'égalité, l'équipe éditoriale tranche. Les tours testées sur notre suite llama.cpp la plus récente sont classées selon leur débit de service, leur délai d'obtention du premier jeton, la charge du modèle, le RAG et les résultats de l'optimisation. Nous testons à nouveau les tours de comparaison sur cette suite lors de l'ajout d'une nouvelle tour au classement. Les fournisseurs n'ont pas accès au classement avant sa publication et aucun placement sur cette page n'est payant.
FAQ sur l'IA locale pour ordinateur de bureau
Quel est le meilleur ordinateur de bureau pour l'IA agentielle ?
Les charges de travail d'IA, telles que le développement d'agents, les pipelines d'appel d'outils et les tâches autonomes en plusieurs étapes, sont sensibles au débit et à la latence, contrairement à l'utilisation d'une seule conversation, car les agents enchaînent de nombreux appels de modèles avec un contexte étendu. Cela favorise les serveurs tour : la VRAM dédiée du Dell Precision 7875 garantit un temps d'accès au premier jeton constant, assurant ainsi la réactivité des longues chaînes d'agents. Pour des expérimentations d'IA à budget limité, un boîtier de classe GB10 exécute les mêmes piles logicielles à une vitesse inférieure. Nos recommandations complètes de dimensionnement sont disponibles dans la section « RAM, GPU et stockage pour l'IA ».
De combien de mémoire ai-je besoin pour exécuter un modèle 70B en local ?
En règle générale, un modèle 70 octets quantifié sur 4 bits nécessite environ 40 à 48 Go de mémoire accessible avant le contexte ; une utilisation interactive confortable avec un contexte étendu requiert davantage de mémoire. C’est pourquoi les serveurs dotés de 128 Go de mémoire unifiée gèrent parfaitement les modèles de classe 70 octets, et pourquoi les tours mono-GPU figurent dans notre classement des meilleures stations de travail de bureau.
Ai-je besoin d'une alimentation électrique spéciale pour faire fonctionner ces systèmes ?
Pour les équipements de bureau, la réponse est non : les boîtiers GB10 et les systèmes Strix Halo fonctionnent sans problème sur une prise de courant standard. En revanche, pour les tours, il est indispensable de discuter sérieusement avec le propriétaire du bâtiment. Un HP Z8 Fury G6i entièrement configuré peut gérer deux alimentations totalisant jusqu'à 2 700 W, soit plus qu'un circuit standard de 15 A et 120 V ne peut fournir. Le Comino Grando, quant à lui, nécessite des alimentations remplaçables à chaud de 2 000 W avec une tension d'entrée de 180 à 264 V, et des alimentations de 1 000 W sur une alimentation de 110 V.
Avant d'acheter un composant en haut de cette page, vérifiez la tension admissible par votre installation électrique ; un circuit dédié ou une alimentation 208/240 V peut représenter une part importante du coût total d'une configuration GPU complète. La chaleur dégagée par la carte graphique est tout aussi importante, car chaque watt consommé est dissipé dans la pièce.
Et un Mac Studio ?
Pas encore, car nous n'en avons pas testé un en laboratoire. Apple a commencé à livrer le Mac Studio avec les processeurs M5 Max et M5 Ultra le 22 septembre. Le M5 Max offre jusqu'à 128 Go de mémoire unifiée à partir de 2 499 $ et le M5 Ultra jusqu'à 512 Go à partir de 5 499 $. La configuration 512 Go, la plus importante pour les modèles de grande capacité, est prévue pour fin octobre à un prix non communiqué par Apple. Si nous en testons un, il sera classé selon des résultats mesurés, comme tous les autres systèmes présentés sur cette page.
Quelle est la meilleure station de travail Xeon pour l'IA locale ?
Le Dell Pro Precision 9 T4 , notre meilleure tour Xeon pour l'IA locale, a affiché des performances similaires (de 1 à 9 % en mono-GPU) au Precision 7875 (basé sur Threadripper) avec deux cartes RTX PRO 6000 Max-Q. Il a également distribué un SSD MiniMax M2.7 de 129.3 Go entre les deux cartes à 83.7 jetons par seconde, tandis que ses huit canaux DDR5-6400 ont offert une bande passante mémoire supérieure de 53 % pour la recherche vectorielle et la simulation. Le Precision 7875 reste notre tour de référence en termes de débit GPU.


 Amazon