StorageReview.com
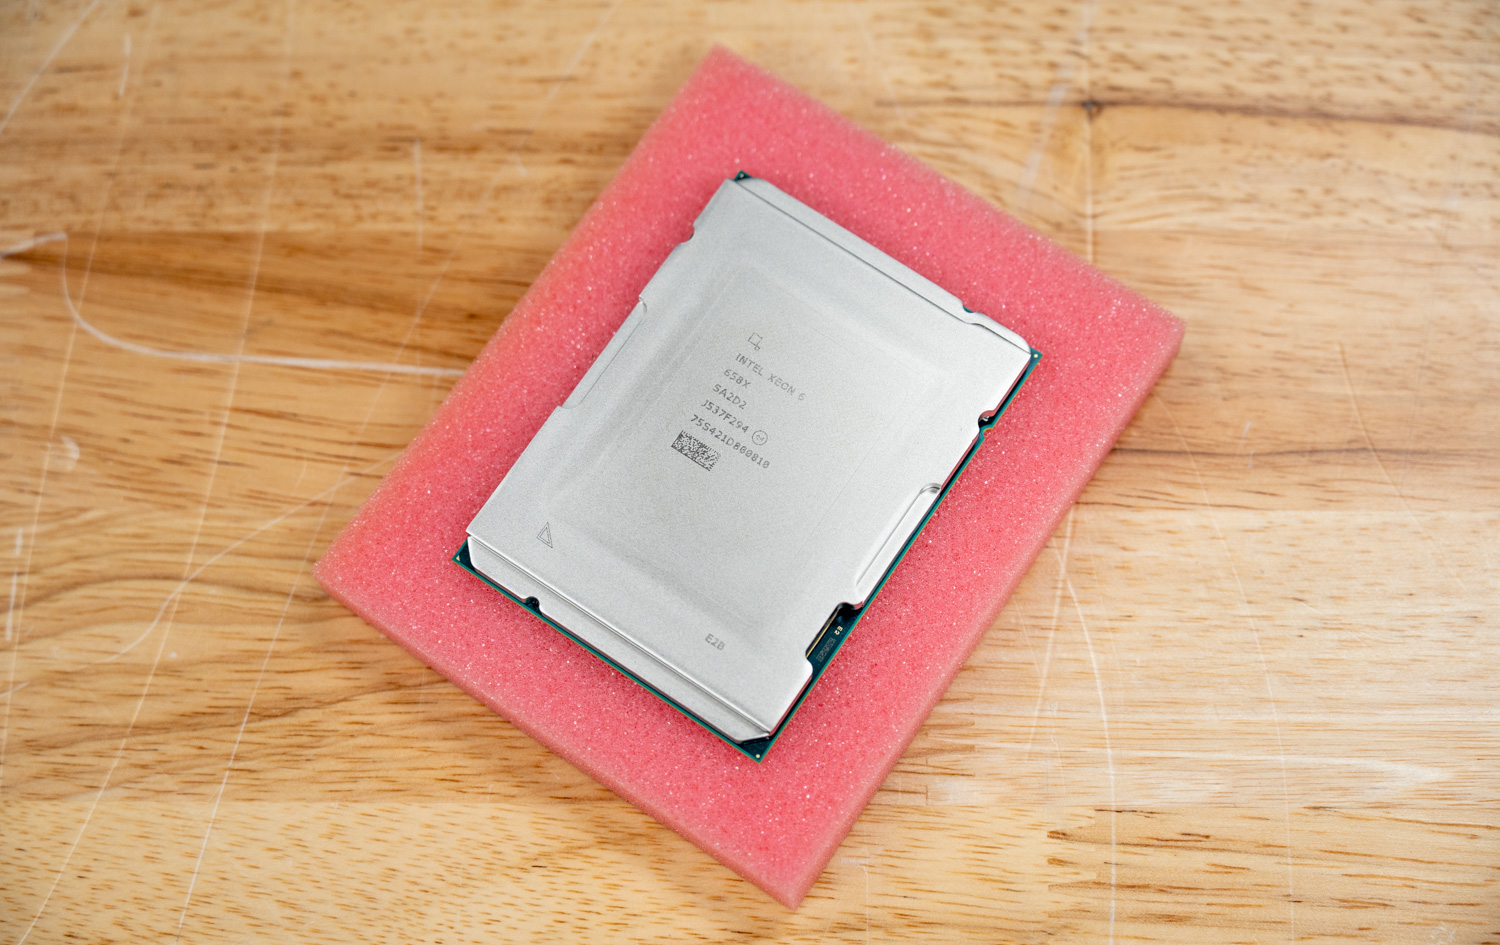
Processeur Intel Xeon 6 sur mousse antistatique dans le laboratoire de StorageReview, l'une des deux familles de processeurs x86 que oneDNN couvrira pour PyTorch
Entreprise  ◇  Logiciels

AMD et Intel font de oneDNN le chemin x86 par défaut dans PyTorch, intègrent Folding ZenDNN et alignent les extensions de calcul IA

AMD et Intel ont annoncé qu'ils allaient fusionner leurs travaux d'optimisation pour processeurs x86 destinés à PyTorch au sein de oneDNN, la bibliothèque open source d'apprentissage profond gérée par l'Unified Acceleration Foundation (UXL). Ils se sont également accordés sur oneDNN comme bibliothèque open source par défaut pour l'accélération x86 dans PyTorch. AMD intègre ses optimisations ZenDNN à oneDNN et a rejoint l'UXL.
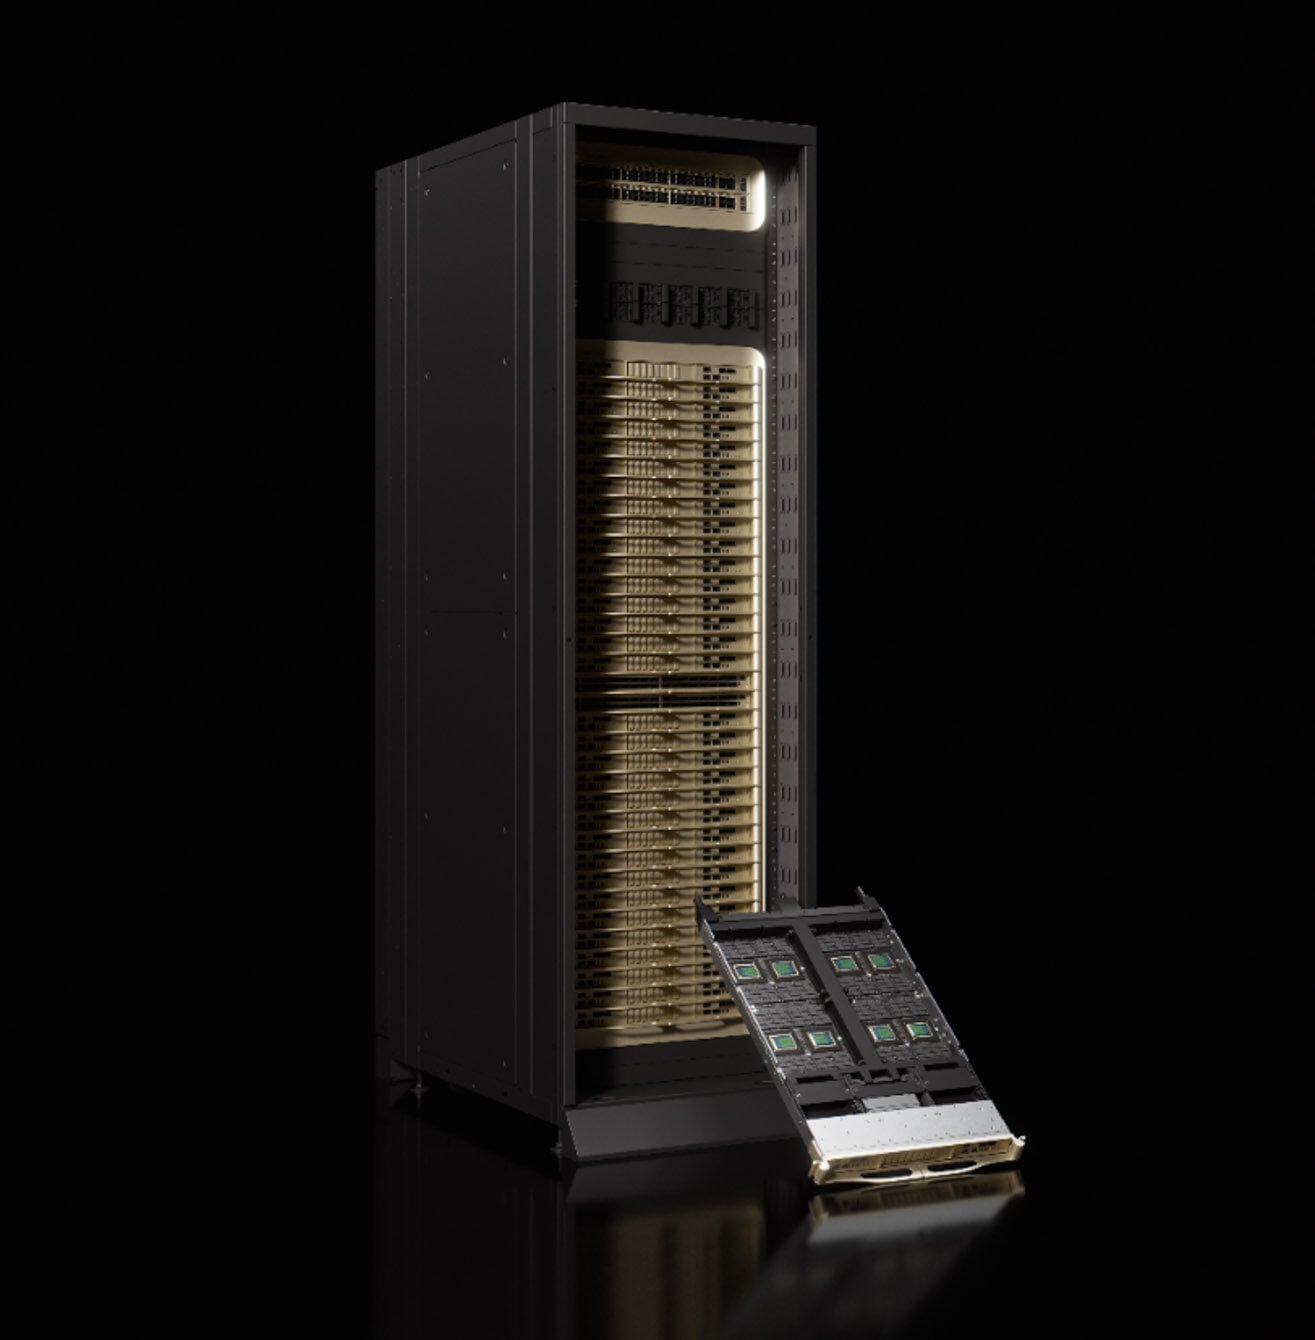
Rendu NVIDIA d'un rack CPU Vera avec un plateau de calcul déployé à l'avant, montrant les sockets du processeur sur le plateau.
AI  ◇  Entreprise

Baie de processeurs Supermicro NVIDIA Vera : 256 processeurs Vera, 400 To de mémoire LPDDR5X et 22 500 environnements sandbox d’agents dans un boîtier 48U refroidi par liquide avec une puissance de 208 kW.

Supermicro a annoncé aujourd'hui le rack pour processeurs NVIDIA Vera, un rack 48U refroidi intégralement par liquide, pouvant accueillir 256 processeurs NVIDIA Vera, soit 22 528 cœurs et 45 056 threads. Supermicro annonce également une capacité de 22 500 environnements sandbox d'agents simultanés. Ce rack est le dernier-né de la gamme Data Center Building Block Solutions (DCBBS), conçu pour fonctionner en parallèle avec les infrastructures existantes.

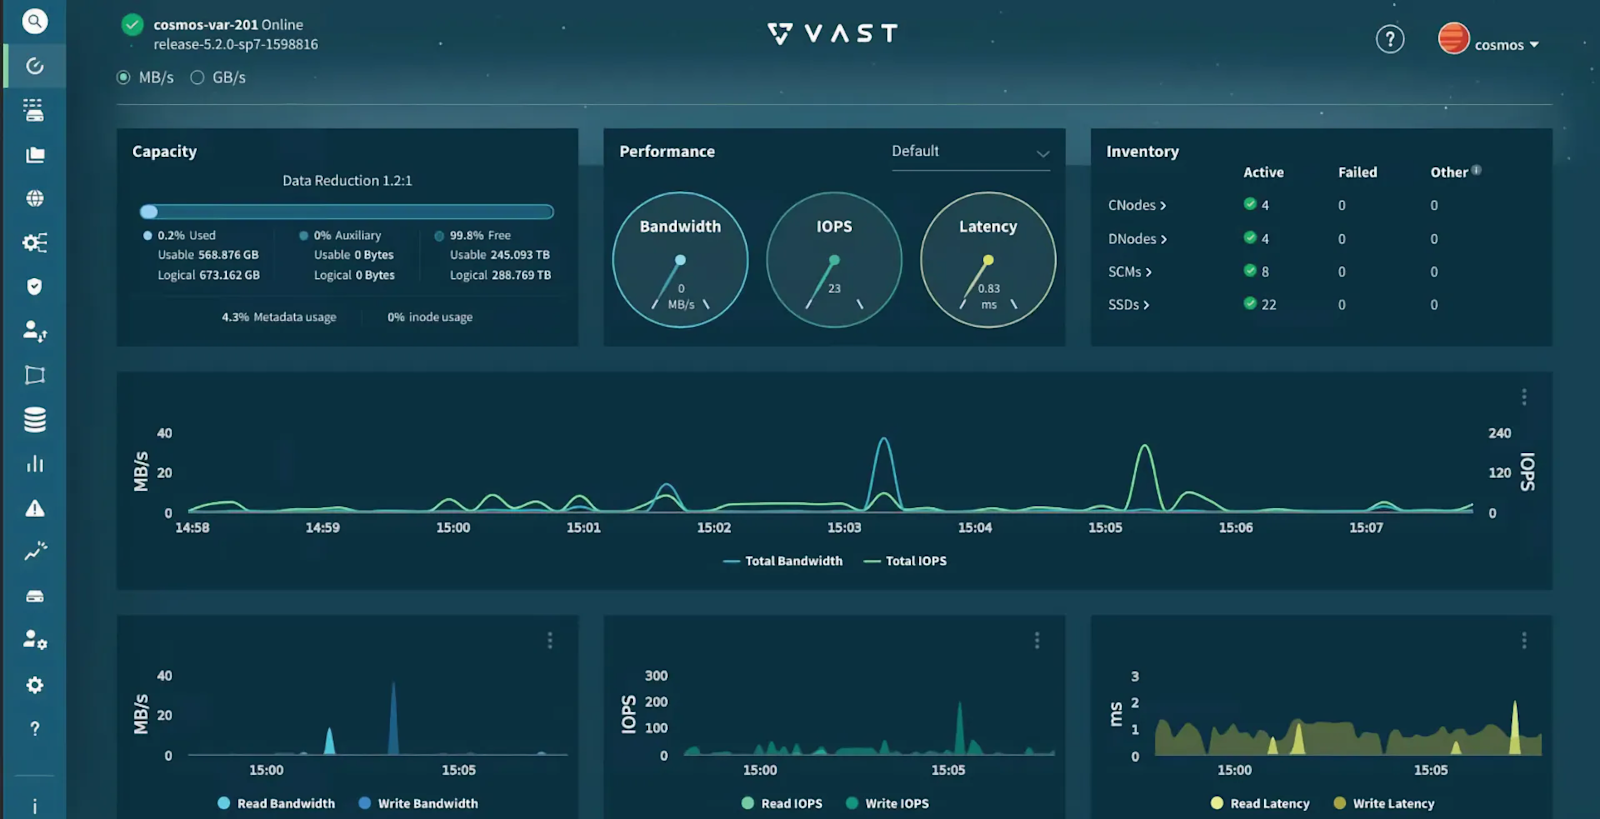
Tableau de bord du système de gestion VAST sur un cluster de laboratoire StorageReview affichant la capacité, la bande passante, les IOPS et la latence ; il s'agit de la couche de télémétrie de la pile VAST Agent Sandbox Foundation.
AI  ◇  Entreprise

La pile VAST Agent Sandbox Foundation Stack place les environnements sandbox NVIDIA OpenShell sur des clones sans copie et enregistre chaque appel d'outil.

VAST Data a annoncé, lors de la NVIDIA GTC Berlin, l'Agent Sandbox Foundation Stack en collaboration avec NVIDIA. Cette architecture de référence exécute les agents NVIDIA NemoClaw dans des environnements sandbox NVIDIA OpenShell sur le système d'exploitation d'IA VAST. OpenShell gère l'exécution isolée et l'application des politiques pour chaque agent, tandis que VAST prend en charge les composants qui doivent survivre à l'environnement sandbox : l'agent lui-même.

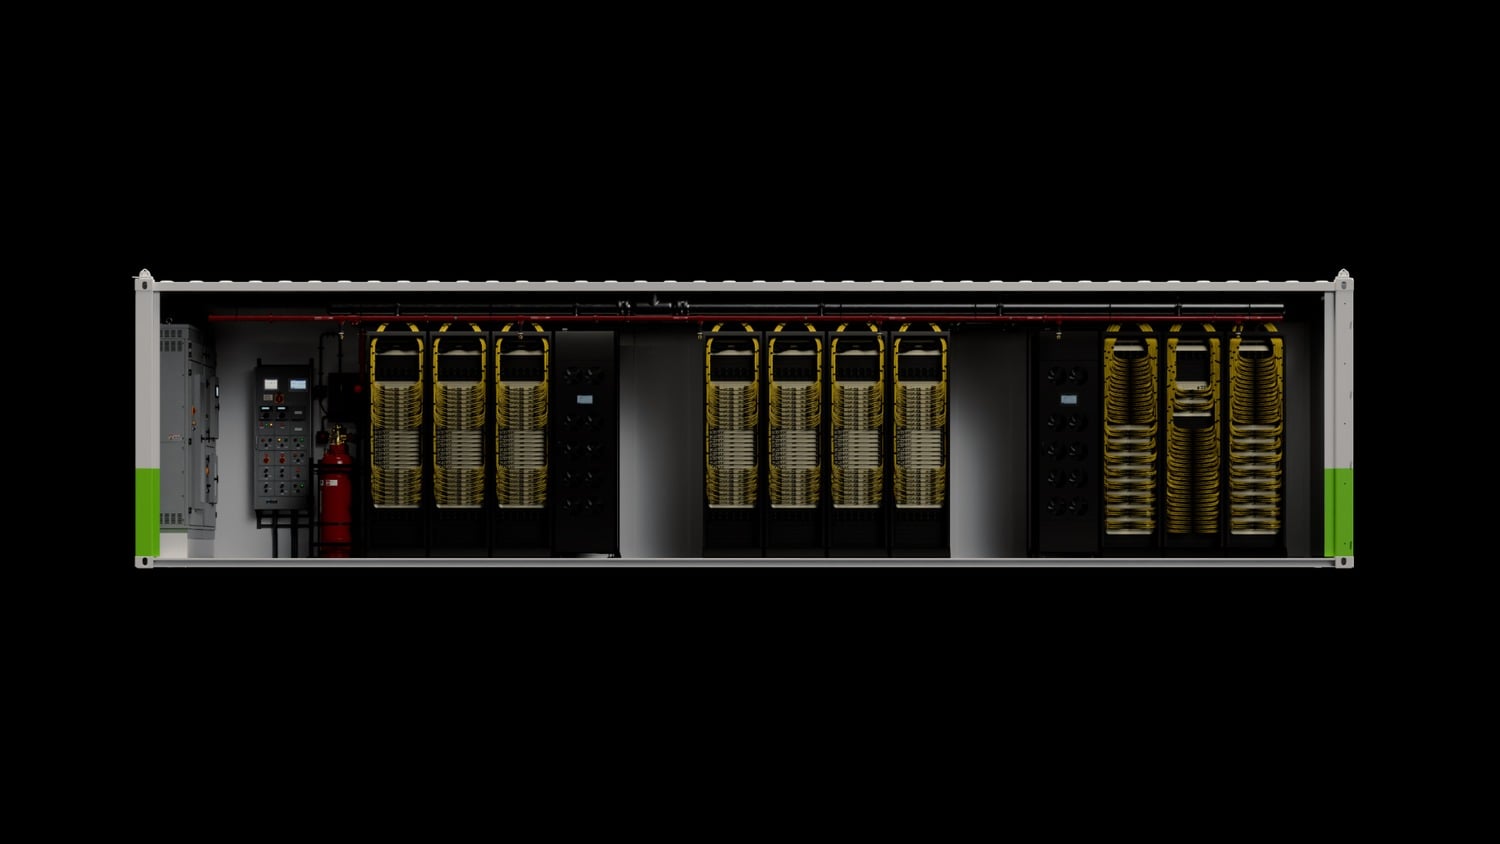
Rendu NVIDIA DSX POD : un conteneur maritime coupé en deux révélant trois groupes de baies Vera Rubin avec câblage jaune, distribution électrique et armoires d'extinction d'incendie à l'extrémité gauche.
AI  ◇  Entreprise

NVIDIA GTC Berlin : Usines d’IA DSX POD de 14 jours, déploiement de Substrate multiplié par 2.5 et architecture de référence OpenShell

Les annonces faites aujourd'hui par NVIDIA au GTC de Berlin concernent l'infrastructure conteneurisée Vera Rubin, une multiplication par 2.5 de son approvisionnement en substrats, et des logiciels pour la gestion de l'alimentation et la sécurité des agents des usines d'IA, ainsi que des programmes pour les télécommunications, les véhicules autonomes, la robotique et la santé. Le chiffre clé est un objectif de déploiement : NVIDIA affirme que sa nouvelle conception de référence DSX POD réduit la taille d'une usine d'IA.

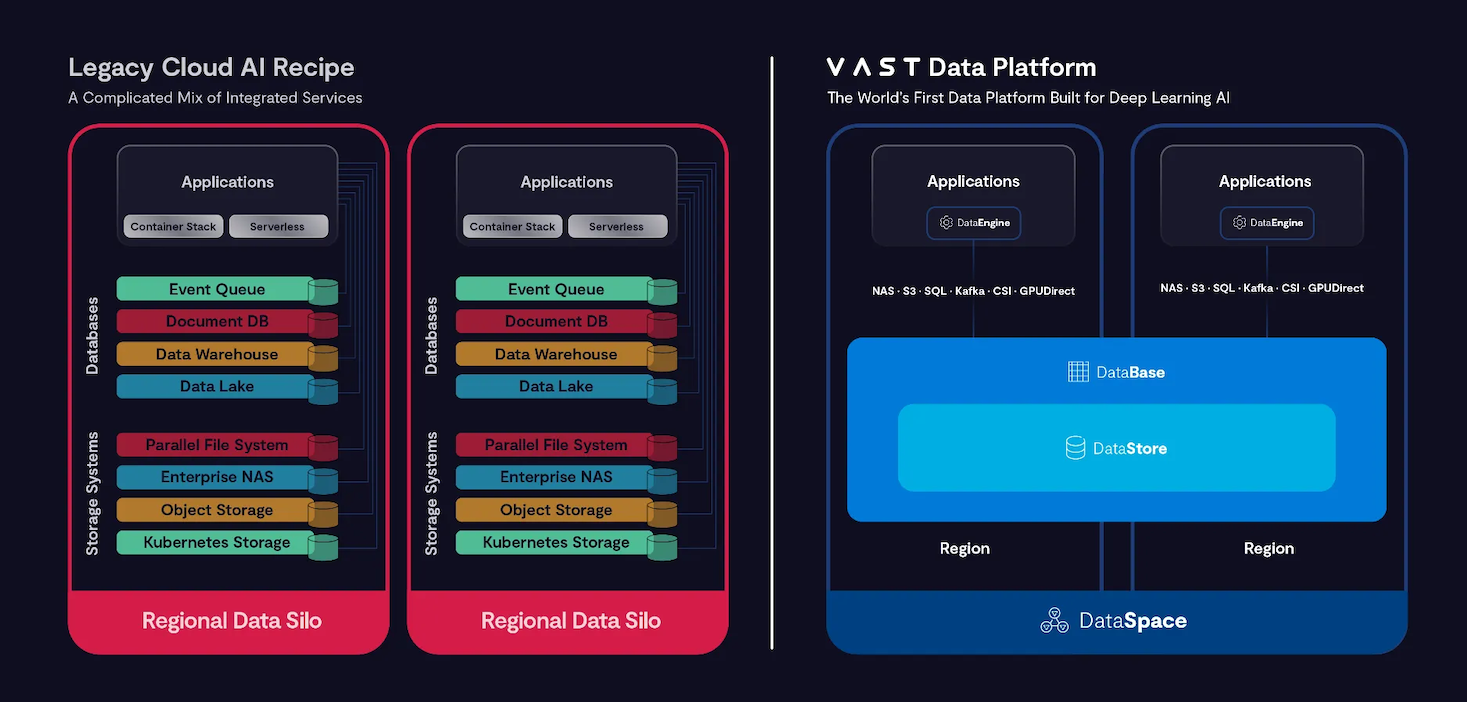
Diagramme de données VAST comparant une architecture d'IA cloud traditionnelle composée de bases de données et de systèmes de stockage cloisonnés dans des silos régionaux, avec les couches DataBase, DataStore et DataSpace de la plateforme de données VAST, couvrant plusieurs régions.
AI  ◇  Entreprise

DeepL déploie le système d'exploitation VAST AI pour l'entraînement à la traduction vocale, anticipant une capacité trois fois supérieure grâce à son système NVMe existant.

VAST Data a annoncé que DeepL déploie le système d'exploitation d'IA VAST comme base de données pour les environnements de recherche de sa traduction vocale écrite et en temps réel. Selon les plans de déploiement actuels, DeepL prévoit une capacité de stockage environ trois fois supérieure à celle du matériel NVMe qu'il utilise déjà, et s'appuiera sur SyncEngine de VAST pour la migration.

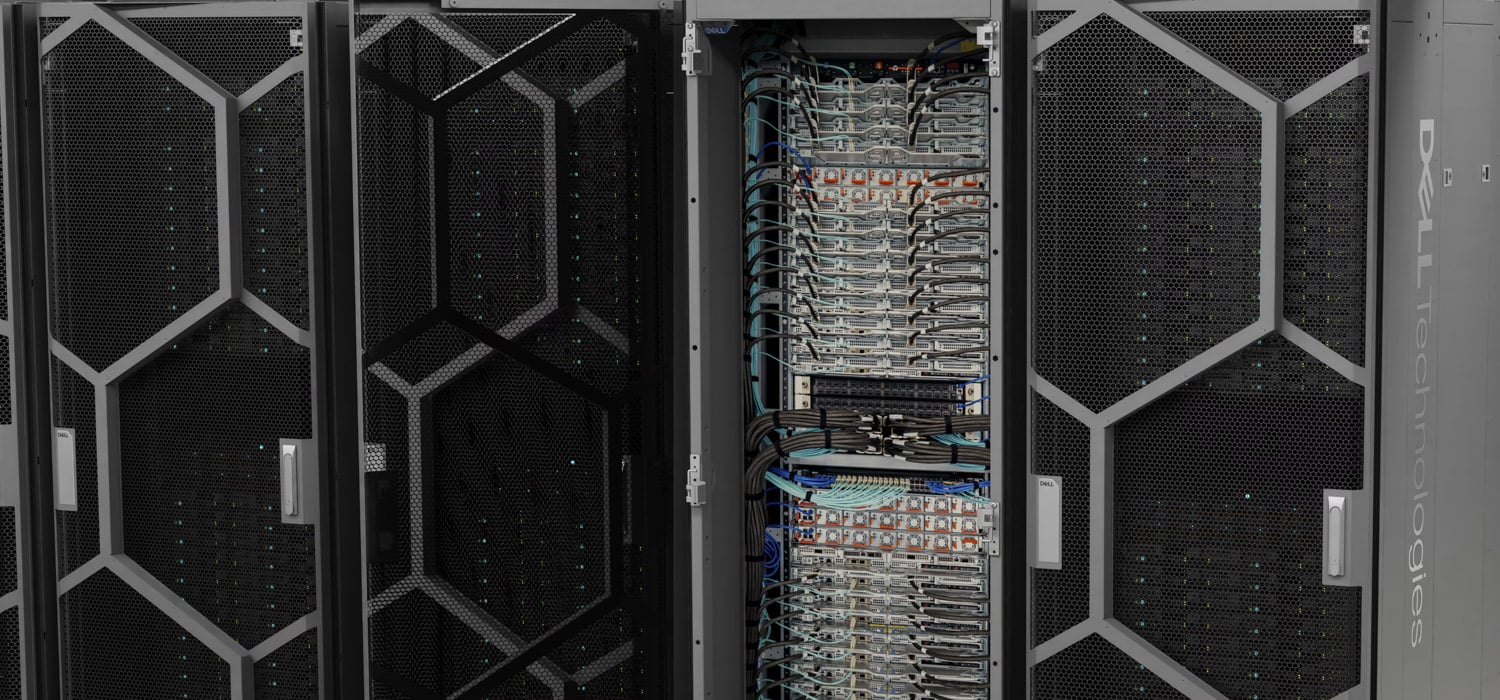
Baies Dell Integrated Rack Scalable Systems avec le rack central ouvert, révélant une colonne de châssis PowerEdge M7725 et le câblage ; le matériel à l'échelle du rack se trouve derrière la Dell AI Factory avec NVIDIA.
AI  ◇  Entreprise

Dell AI Factory avec NVIDIA ajoute un rack Vera à 256 processeurs, un rack d'inférence Groq 3 LPU et un PC de bureau GB10 de 64 Go

Dell Technologies a étendu aujourd'hui sa Dell AI Factory en collaboration avec NVIDIA lors du NVIDIA GTC de Berlin, avec un rack PowerEdge M9882 48U équipé de 256 processeurs NVIDIA Vera pour l'exécution de charges de travail d'agents, le système d'inférence à l'échelle du rack PowerEdge XE9810 basé sur des LPU Groq 3, un serveur Vera biprocesseur refroidi par air, un Dell Pro Precision de 64 Go avec GB10, et un ensemble de périphériques.

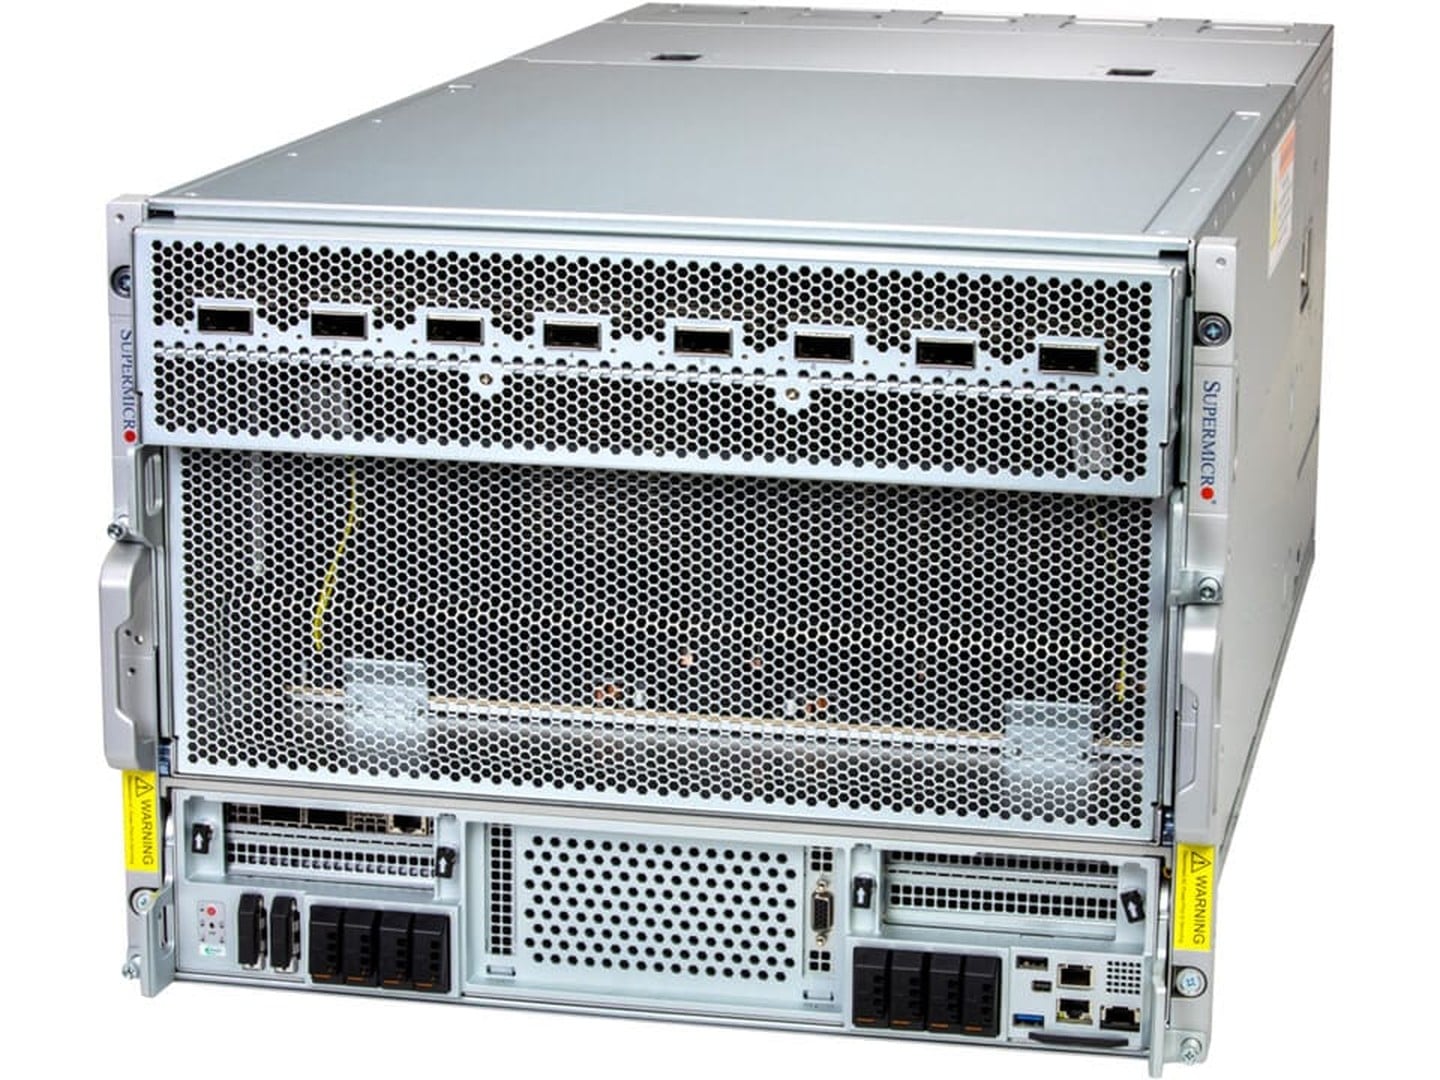
Serveur GPU Supermicro AS-8126GS-NB3RT 8U avec carte mère NVIDIA HGX B300 à huit GPU, vue de face montrant les baies E1.S et M.2, l'une des classes de serveurs utilisées par le système d'inférence privé Nutanix.
AI  ◇  Entreprise

Le système d'inférence privé Nutanix, développé en collaboration avec Supermicro, intègre huit GPU NVIDIA B300 Blackwell Ultra par nœud pour la gestion et le stockage NX dédiés. Livraison prévue début 2027.

Nutanix a annoncé aujourd'hui trois collaborations lors de la NVIDIA GTC Berlin : un système d'inférence privé conçu conjointement avec Supermicro et basé sur des serveurs dotés de huit GPU NVIDIA B300 Blackwell Ultra par nœud, une prise en charge dès le premier jour des processeurs NVIDIA Vera à partir de NKP Bare Metal, et une pile multilocataire avec Netris qui étend l'isolation des locataires au réseau physique.

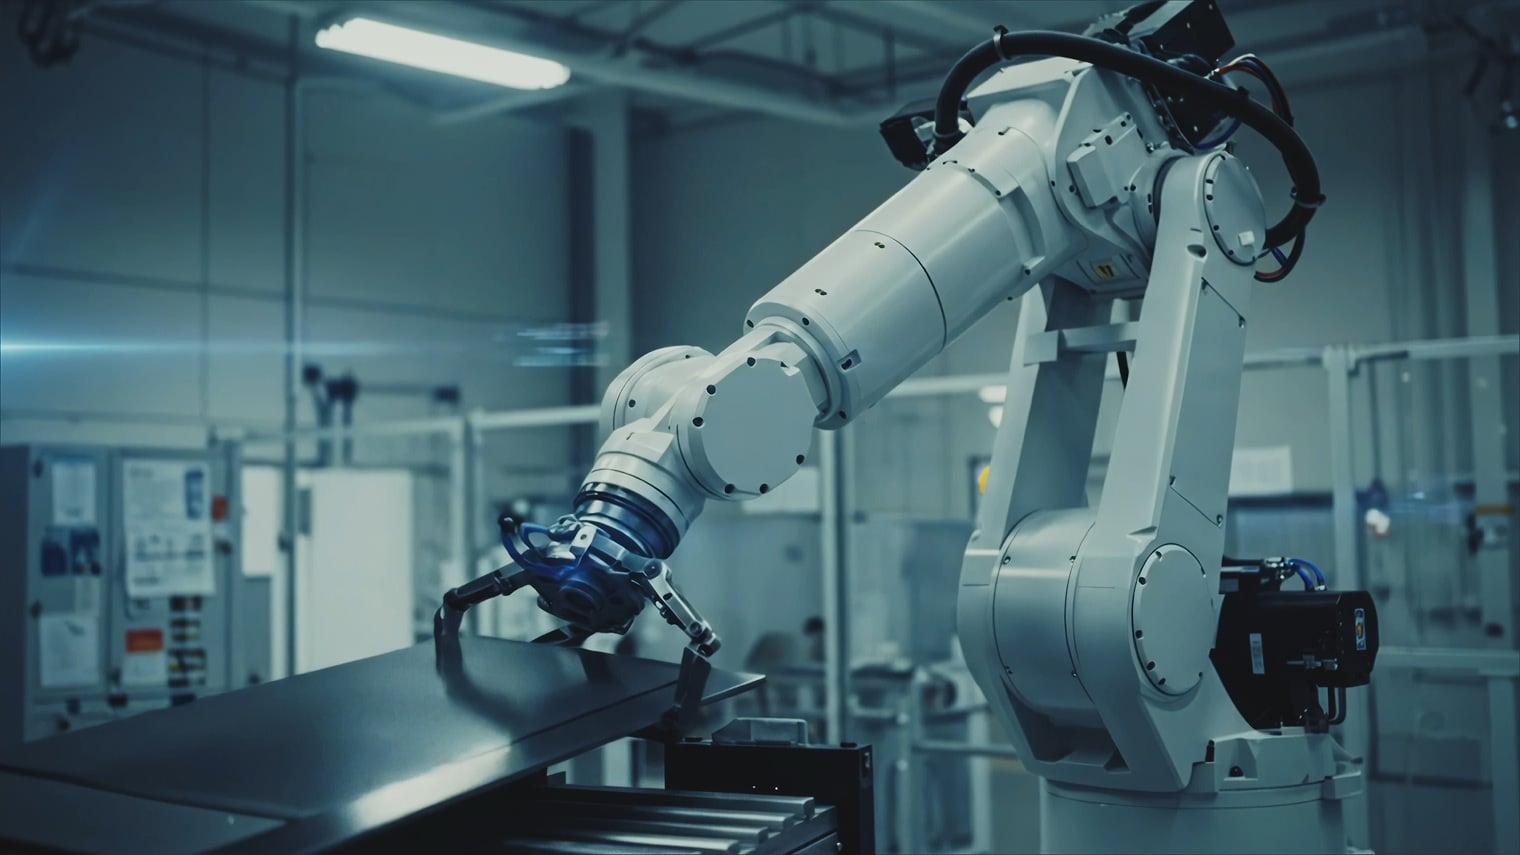
Bras robotisé industriel prélevant une pièce sur une table dans une cellule de production : image principale de CoreWeave pour Physical AI Launchables
AI  ◇  Entreprise

Les modules de lancement d'IA physique de CoreWeave regroupent Isaac Sim, CARLA et MuJoCo sous une seule commande, grâce à un cadre d'IA Zero Trust à six couches.

CoreWeave a lancé aujourd'hui, lors de la NVIDIA GTC Berlin, Physical AI Launchables et le framework d'IA CoreWeave Zero Trust. Launchables est un catalogue de modèles testés et prêts à l'emploi pour les outils de robotique et de véhicules autonomes. Chaque modèle, lancé par une simple commande, associe des environnements pour NVIDIA Isaac Sim, CARLA, MuJoCo, NVIDIA AlpaSim et NVIDIA Cosmos 3 à des compétences d'agent de programmation optimisées.

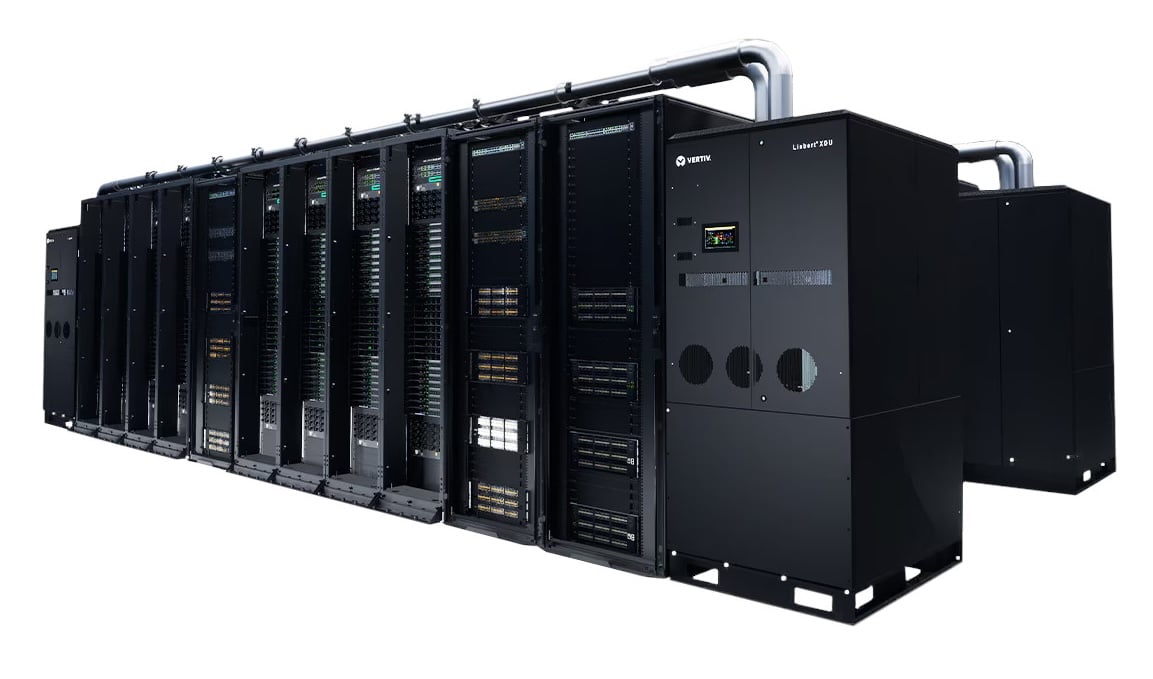
HPE AI Factory avec rendu NVIDIA d'une rangée de racks de calcul avec des unités de distribution de liquide de refroidissement Vertiv Liebert XDU en bout de rangée.
AI  ◇  Entreprise

HPE Private Cloud AI ajoute des serveurs MCP, des clusters mixtes H200 et RTX PRO 6000, et un rack NVIDIA Vera de 256 processeurs

HPE a annoncé aujourd'hui, lors de la NVIDIA GTC de Berlin, des mises à jour de HPE AI Factory en collaboration avec NVIDIA. La plupart des modifications concernent HPE Private Cloud AI. Les développeurs, les éditeurs de logiciels indépendants et les agents d'IA bénéficient d'un accès contrôlé aux fonctionnalités d'inférence, aux modèles et aux pipelines de la plateforme via des API de production et des serveurs MCP (Model Context Protocol). Les clusters peuvent désormais être combinés.

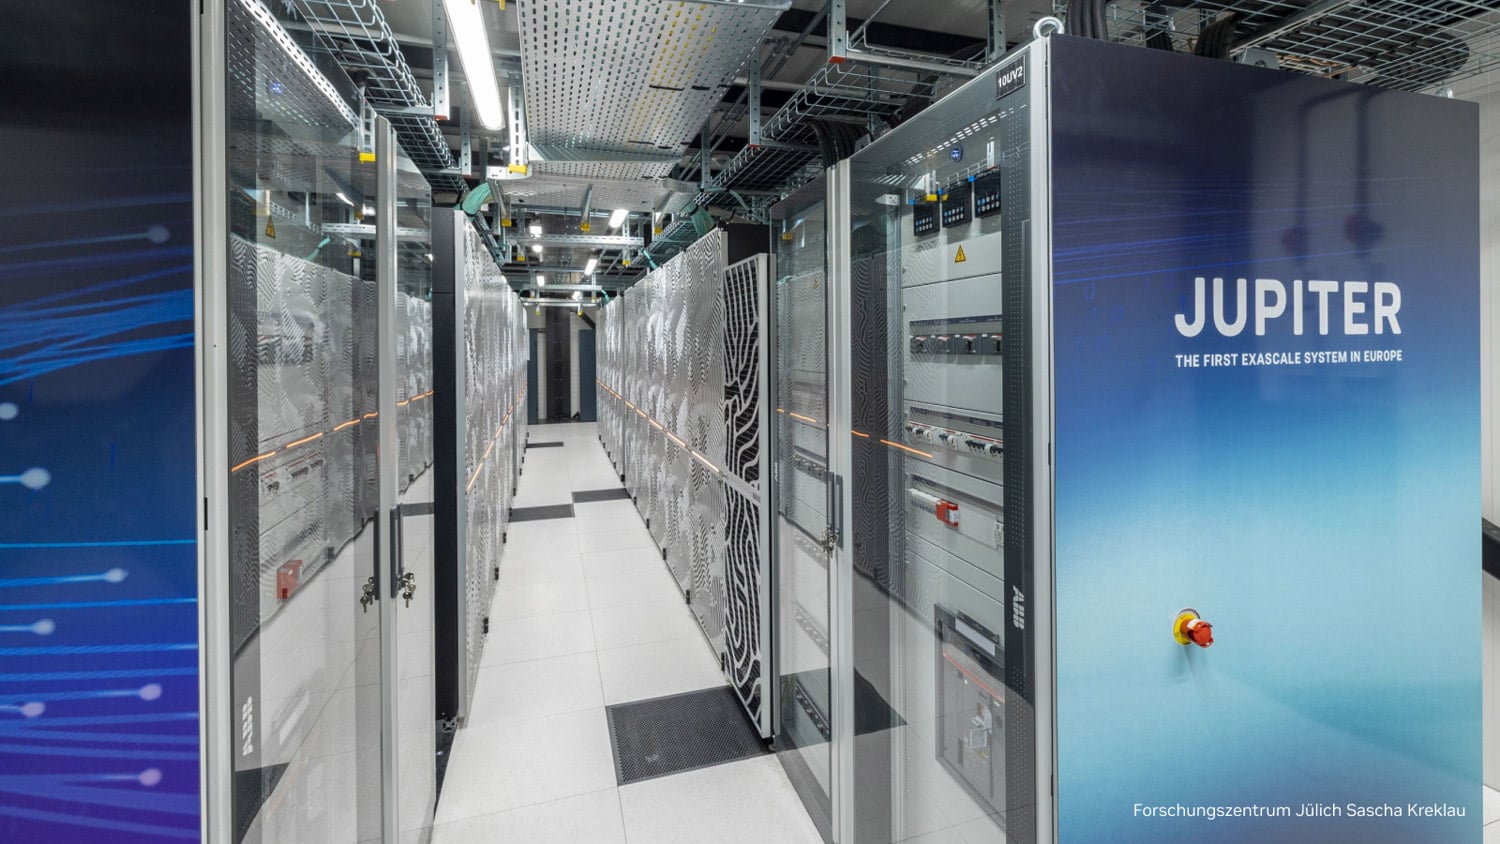
Allée de rack de supercalculateur JUPITER au Forschungszentrum Jülich avec un panneau JUPITER The First Exascale System in Europe sur l'armoire d'extrémité
AI  ◇  Entreprise

NVIDIA JUPITER Quantum Simulation Models un processeur tolérant aux pannes de 104 qubits sur 8 192 GPU GH200 et 512 Tio

NVIDIA a réalisé une simulation à 104 qubits d'un processeur quantique tolérant aux pannes sur JUPITER, le premier supercalculateur exascale d'Europe, hébergé au Centre de supercalcul de Jülich, en utilisant 8 192 GPU GH200. Annoncée avant la GTC Berlin, cette simulation modélise la culture d'états magiques, une méthode permettant de produire les états non-Clifford utilisés par un ordinateur tolérant aux pannes lors d'opérations logiques, dans des conditions de bruit matériel réalistes.